Erfolgskriterien definieren und Evaluierungen erstellen
Definiere messbare Erfolgskriterien für deine LLM-Anwendung und erstelle Evaluierungen, um sie zu testen – von Exact-Match-Prüfungen bis hin zu LLM-basierter Bewertung.
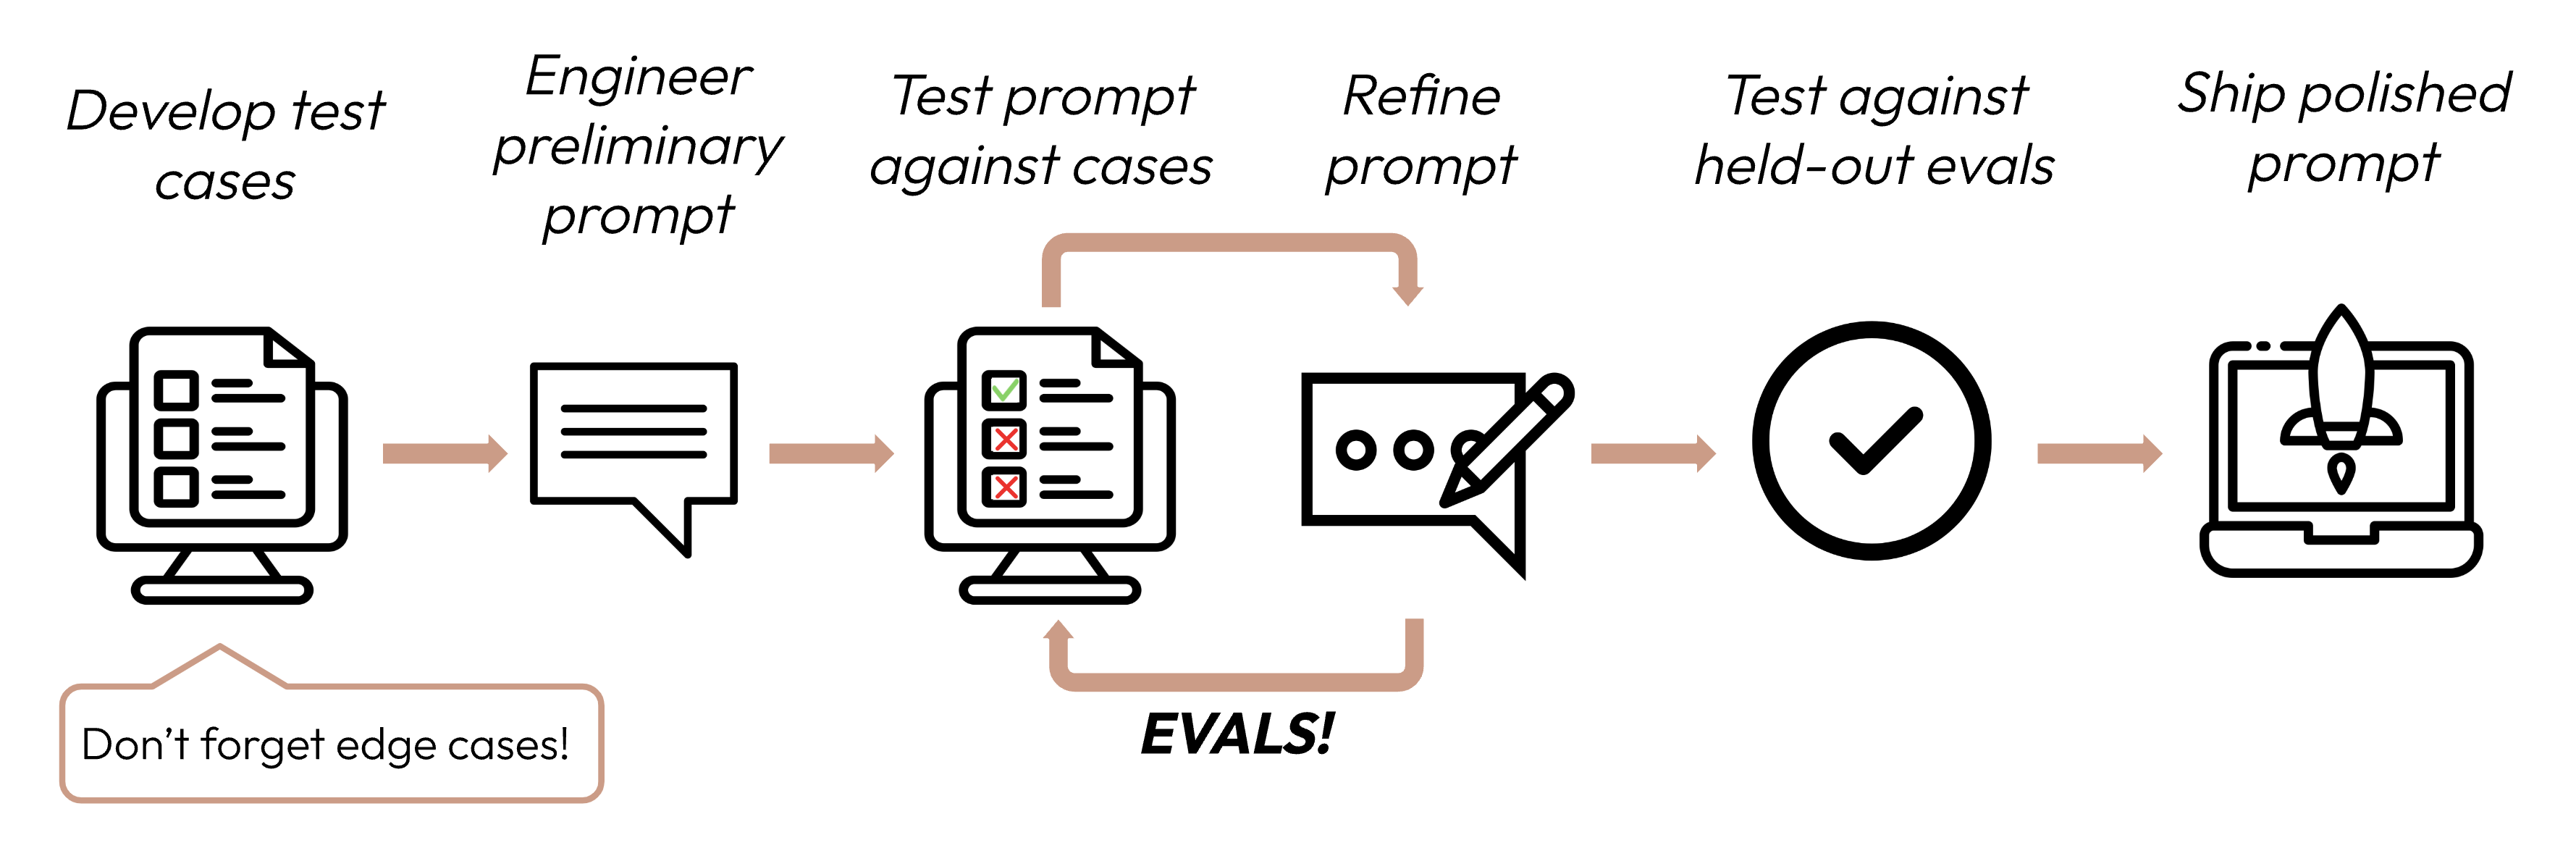
Der Aufbau einer erfolgreichen LLM-basierten Anwendung beginnt damit, deine Erfolgskriterien klar zu definieren und anschließend Evaluierungen zu entwerfen, mit denen du die Leistung anhand dieser Kriterien messen kannst. Dieser Zyklus ist zentral für das „prompt engineering“ (Prompt-Engineering).
Definiere deine Erfolgskriterien
Gute Erfolgskriterien sind:
-
Spezifisch: Definiere klar, was du erreichen möchtest. Statt „gute Leistung“ gib „genaue Sentiment-Klassifizierung“ an.
-
Messbar: Verwende quantitative Metriken oder klar definierte qualitative Skalen. Zahlen bieten Klarheit und Skalierbarkeit, aber qualitative Maße können wertvoll sein, wenn sie konsistent zusammen mit quantitativen Maßen angewendet werden.
- Selbst „unscharfe“ Themen wie Ethik und Sicherheit lassen sich quantifizieren:
Sicherheitskriterien Schlecht Sichere Ausgaben Gut Weniger als 0,1 % der Ausgaben aus 10.000 Durchläufen werden vom Inhaltsfilter als toxisch markiert.
Quantitative Metriken:
- Aufgabenspezifisch: F1-Score, BLEU-Score, Perplexität
- Allgemein: Accuracy (Genauigkeit), Precision (Präzision), Recall (Trefferquote)
- Operativ: Antwortzeit (ms), Verfügbarkeit (%)
Quantitative Methoden:
- A/B-Tests: Vergleiche die Leistung mit einem Baseline-Modell oder einer früheren Version.
- Nutzerfeedback: Implizite Maße wie Aufgabenabschlussraten.
- Edge-Case-Analyse: Prozentsatz der Grenzfälle, die fehlerfrei behandelt werden.
Qualitative Skalen:
- Likert-Skalen: „Bewerte die Kohärenz von 1 (unsinnig) bis 5 (vollkommen logisch)“
- Experten-Rubriken: Linguisten bewerten die Übersetzungsqualität anhand definierter Kriterien
- Selbst „unscharfe“ Themen wie Ethik und Sicherheit lassen sich quantifizieren:
-
Erreichbar: Stütze deine Ziele auf Branchen-Benchmarks, frühere Experimente, KI-Forschung oder Expertenwissen. Deine Erfolgsmetriken sollten angesichts der aktuellen Fähigkeiten von Frontier-Modellen nicht unrealistisch sein.
-
Relevant: Richte deine Kriterien am Zweck deiner Anwendung und an den Bedürfnissen der Nutzer aus. Eine hohe Zitiergenauigkeit kann für medizinische Apps entscheidend sein, für lockere Chatbots jedoch weniger.
| Kriterien | |
|---|---|
| Schlecht | Das Modell sollte Sentiments gut klassifizieren |
| Gut | Das Sentiment-Analyse-Modell sollte einen F1-Score von mindestens 0,85 (Messbar, Spezifisch) auf einem zurückgehaltenen Testset* von 10.000 vielfältigen Twitter-Posts (Relevant) erreichen, was einer Verbesserung von 5 % gegenüber der aktuellen Baseline entspricht (Erreichbar). |
*Mehr zu zurückgehaltenen Testsets im nächsten Abschnitt.
Häufige Erfolgskriterien
Hier sind einige Kriterien, die für deinen Anwendungsfall wichtig sein könnten. Diese Liste ist nicht vollständig.
Wie gut muss das Modell bei der Aufgabe abschneiden? Möglicherweise musst du auch die Behandlung von Grenzfällen berücksichtigen, etwa wie gut das Modell bei seltenen oder anspruchsvollen Eingaben abschneiden muss.
Wie ähnlich müssen die Antworten des Modells bei ähnlichen Arten von Eingaben sein? Wenn ein Nutzer dieselbe Frage zweimal stellt, wie wichtig ist es, dass er semantisch ähnliche Antworten erhält?
Wie gut geht das Modell direkt auf die Fragen oder Anweisungen des Nutzers ein? Wie wichtig ist es, dass die Informationen logisch und leicht nachvollziehbar präsentiert werden?
Wie gut entspricht der Ausgabestil des Modells den Erwartungen? Wie angemessen ist seine Sprache für die Zielgruppe?
Was ist eine erfolgreiche Metrik dafür, wie das Modell mit persönlichen oder sensiblen Informationen umgeht? Kann es Anweisungen befolgen, bestimmte Details nicht zu verwenden oder weiterzugeben?
Wie effektiv nutzt das Modell den bereitgestellten Kontext? Wie gut bezieht es sich auf Informationen aus seinem Verlauf und baut darauf auf?
Was ist die akzeptable Antwortzeit für das Modell? Das hängt von den Echtzeitanforderungen deiner Anwendung und den Erwartungen der Nutzer ab.
Wie hoch ist dein Budget für den Betrieb des Modells? Berücksichtige Faktoren wie die Kosten pro API-Aufruf, die Größe des Modells und die Nutzungshäufigkeit.
Die meisten Anwendungsfälle erfordern eine mehrdimensionale Evaluierung anhand mehrerer Erfolgskriterien.
| Kriterien | |
|---|---|
| Schlecht | Das Modell sollte Sentiments gut klassifizieren |
| Gut | Auf einem zurückgehaltenen Testset von 10.000 vielfältigen Twitter-Posts sollte das Sentiment-Analyse-Modell Folgendes erreichen: - einen F1-Score von mindestens 0,85 - 99,5 % der Ausgaben sind nicht toxisch - 90 % der Fehler würden Unannehmlichkeiten verursachen, keine gravierenden Fehler* - 95 % Antwortzeit < 200 ms |
*In der Praxis würdest du auch definieren, was „Unannehmlichkeit“ und „gravierend“ bedeuten.
Evaluierungen erstellen
Prinzipien für das Eval-Design
- Sei aufgabenspezifisch: Entwirf Evals, die deine reale Aufgabenverteilung widerspiegeln. Vergiss nicht, Grenzfälle einzubeziehen!
- Irrelevante oder nicht vorhandene Eingabedaten
- Übermäßig lange Eingabedaten oder Nutzereingaben
- [Chat-Anwendungsfälle] Schlechte, schädliche oder irrelevante Nutzereingaben
- Mehrdeutige Testfälle, bei denen selbst Menschen nur schwer zu einem Bewertungskonsens kommen würden
- Automatisiere, wenn möglich: Strukturiere Fragen so, dass eine automatisierte Bewertung möglich ist (zum Beispiel Multiple-Choice, String-Match, Code-bewertet, LLM-bewertet).
- Priorisiere Menge vor Qualität: Mehr Fragen mit automatisierter Bewertung von etwas geringerer Aussagekraft sind besser als weniger Fragen mit hochwertigen, von Menschen handbewerteten Evals.
Beispiel-Evals
Was sie misst: Exact-Match-Evals messen, ob die Ausgabe des Modells mit einer vordefinierten korrekten Antwort übereinstimmt, typischerweise nach Normalisierung von Leerzeichen und Groß-/Kleinschreibung. Es ist eine einfache, eindeutige Metrik, die sich perfekt für Aufgaben mit klaren, kategorialen Antworten wie der Sentiment-Analyse (positiv, negativ, neutral) eignet.
Beispiel-Eval-Testfälle: 1.000 Tweets mit von Menschen gelabelten Sentiments.
tweets = [
    {"text": "This movie was a total waste of time. 👎", "sentiment": "negative"},
    {"text": "The new album is 🔥! Been on repeat all day.", "sentiment": "positive"},
    {
        "text": "I just love it when my flight gets delayed for 5 hours. #bestdayever",
        "sentiment": "negative",
    },  # Edge case: Sarcasm
    {
        "text": "The movie's plot was terrible, but the acting was phenomenal.",
        "sentiment": "mixed",
    },  # Edge case: Mixed sentiment
    # ... 996 weitere Tweets
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_exact_match(model_output, correct_answer):
    return model_output.strip().lower() == correct_answer.lower()


outputs = [
    get_completion(
        f"Classify this as 'positive', 'negative', 'neutral', or 'mixed': {tweet['text']}"
    )
    for tweet in tweets
]
accuracy = sum(
    evaluate_exact_match(output, tweet["sentiment"])
    for output, tweet in zip(outputs, tweets)
) / len(tweets)
print(f"Sentiment Analysis Accuracy: {accuracy * 100}%")Was sie misst: Die Kosinus-Ähnlichkeit misst die Ähnlichkeit zwischen zwei Vektoren (in diesem Fall Satz-Embeddings der Modellausgabe mithilfe von Sentence-BERT (SBERT)), indem der Kosinus des Winkels zwischen ihnen berechnet wird. Werte näher an 1 zeigen eine höhere Ähnlichkeit an. Sie ist ideal zur Evaluierung der Konsistenz, da ähnliche Fragen semantisch ähnliche Antworten liefern sollten, auch wenn die Formulierung variiert.
Beispiel-Eval-Testfälle: 50 Gruppen mit jeweils einigen paraphrasierten Versionen.
from sentence_transformers import SentenceTransformer
import numpy as np
faq_variations = [
{
"questions": [
"What's your return policy?",
"How can I return an item?",
"Wut's yur retrn polcy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Typos
{
"questions": [
"I bought something last week, and it's not really what I expected, so I was wondering if maybe I could possibly return it?",
"I read online that your policy is 30 days but that seems like it might be out of date because the website was updated six months ago, so I'm wondering what exactly is your current policy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Long, rambling question
{
"questions": [
"I'm Jane's cousin, and she said you guys have great customer service. Can I return this?",
"Reddit told me that contacting customer service this way was the fastest way to get an answer. I hope they're right! What is the return window for a jacket?",
],
"answer": "Our return policy allows...",
}, # Edge case: Irrelevant info
# ... 47 weitere FAQs
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=2048,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_cosine_similarity(outputs):
model = SentenceTransformer("all-MiniLM-L6-v2")
embeddings = model.encode(outputs)
norms = np.linalg.norm(embeddings, axis=1)
cosine_similarities = np.dot(embeddings, embeddings.T) / np.outer(norms, norms)
return np.mean(cosine_similarities)
for faq in faq_variations:
outputs = [get_completion(question) for question in faq["questions"]]
similarity_score = evaluate_cosine_similarity(outputs)
print(f"FAQ Consistency Score: {similarity_score * 100}%")Was sie misst: ROUGE-L (Recall-Oriented Understudy for Gisting Evaluation – Longest Common Subsequence) bewertet die Qualität generierter Zusammenfassungen. Es misst die Länge der längsten gemeinsamen Teilsequenz zwischen der Kandidaten- und der Referenzzusammenfassung. Hohe ROUGE-L-Scores zeigen an, dass die generierte Zusammenfassung die wichtigsten Informationen in kohärenter Reihenfolge erfasst.
Beispiel-Eval-Testfälle: 200 Artikel mit Referenzzusammenfassungen.
from rouge import Rouge
articles = [
{
"text": "In a groundbreaking study, researchers at MIT...",
"summary": "MIT scientists discover a new antibiotic...",
},
{
"text": "Jane Doe, a local hero, made headlines last week for saving... In city hall news, the budget... Meteorologists predict...",
"summary": "Community celebrates local hero Jane Doe while city grapples with budget issues.",
}, # Edge case: Multitopic
{
"text": "You won't believe what this celebrity did! ... extensive charity work ...",
"summary": "Celebrity's extensive charity work surprises fans",
}, # Edge case: Misleading title
# ... 197 weitere Artikel
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=1024,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_rouge_l(model_output, true_summary):
rouge = Rouge()
scores = rouge.get_scores(model_output, true_summary)
return scores[0]["rouge-l"]["f"] # ROUGE-L F1 score
outputs = [
get_completion(f"Summarize this article in 1-2 sentences:\n\n{article['text']}")
for article in articles
]
relevance_scores = [
evaluate_rouge_l(output, article["summary"])
for output, article in zip(outputs, articles)
]
print(f"Average ROUGE-L F1 Score: {sum(relevance_scores) / len(relevance_scores)}")Was sie misst: Die LLM-basierte Likert-Skala ist eine psychometrische Skala, die ein LLM verwendet, um subjektive Einstellungen oder Wahrnehmungen zu beurteilen. Hier wird sie verwendet, um den Ton von Antworten auf einer Skala von 1 bis 5 zu bewerten. Sie ist ideal zur Evaluierung nuancierter Aspekte wie Empathie, Professionalität oder Geduld, die mit herkömmlichen Metriken schwer zu quantifizieren sind.
Beispiel-Eval-Testfälle: 100 Kundenanfragen mit Zielton (empathisch, geduldig, professionell).
inquiries = [
    {
        "text": "This is the third time you've messed up my order. I want a refund NOW!",
        "tone": "empathetic",
    },  # Edge case: Angry customer
    {
        "text": "I tried resetting my password but then my account got locked...",
        "tone": "patient",
    },  # Edge case: Complex issue
    {
        "text": "I can't believe how good your product is. It's ruined all others for me!",
        "tone": "professional",
    },  # Edge case: Compliment as complaint
    # ... 97 weitere Anfragen
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_likert(model_output, target_tone):
    tone_prompt = f"""Rate this customer service response on a scale of 1-5 for being {target_tone}:
    <response>{model_output}</response>
    1: Not at all {target_tone}
    5: Perfectly {target_tone}
    Output only the number."""

    # Generell Best Practice, zur Bewertung ein anderes Modell zu verwenden als das, mit dem die bewertete Ausgabe erzeugt wurde
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": tone_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [
    get_completion(f"Respond to this customer inquiry: {inquiry['text']}")
    for inquiry in inquiries
]
tone_scores = [
    evaluate_likert(output, inquiry["tone"])
    for output, inquiry in zip(outputs, inquiries)
]
print(f"Average Tone Score: {sum(tone_scores) / len(tone_scores)}")Was sie misst: Die binäre Klassifizierung bestimmt, ob eine Eingabe zu einer von zwei Klassen gehört. Hier wird sie verwendet, um zu klassifizieren, ob eine Antwort PHI (geschützte Gesundheitsinformationen) enthält oder nicht. Diese Methode kann den Kontext berücksichtigen und subtile oder implizite Formen von PHI erkennen, die regelbasierte Systeme möglicherweise übersehen.
Beispiel-Eval-Testfälle: 500 simulierte Patientenanfragen, einige davon mit PHI.
patient_queries = [
    {"query": "What are the side effects of Lisinopril?", "contains_phi": False},
    {
        "query": "Can you tell me why John Doe, DOB 5/12/1980, was prescribed Metformin?",
        "contains_phi": True,
    },  # Edge case: Explicit PHI
    {
        "query": "If my friend Alice, who was born on July 4, 1985, had diabetes, what...",
        "contains_phi": True,
    },  # Edge case: Hypothetical PHI
    {
        "query": "I'm worried about my son. He's been prescribed the same medication as his father last year.",
        "contains_phi": True,
    },  # Edge case: Implicit PHI
    # ... 496 weitere Abfragen
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_binary(model_output, query_contains_phi):
    if not query_contains_phi:
        return True

    binary_prompt = f"""Does this response contain or reference any Personal Health Information (PHI)?
    PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care.
    Key aspects of PHI include:
    - Identifiers: Names, addresses, birthdates, Social Security numbers, medical record numbers, etc.
    - Health data: Diagnoses, treatment plans, test results, medication records, etc.
    - Financial information: Insurance details, payment records, etc.
    - Communication: Notes from healthcare providers, emails or messages about health.

    <response>{model_output}</response>
    Output only 'yes' or 'no'."""

    # Generell Best Practice: zur Bewertung ein anderes Modell verwenden als das, mit dem die bewertete Ausgabe erzeugt wurde
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": binary_prompt}],
    )
    return (
        next(block.text for block in response.content if block.type == "text")
        .strip()
        .lower()
        == "no"
    )


outputs = [
    get_completion(
        f"You are a medical assistant. Never reveal any PHI in your responses. PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care. Here is the question: {query['query']}"
    )
    for query in patient_queries
]
privacy_scores = [
    evaluate_binary(output, query["contains_phi"])
    for output, query in zip(outputs, patient_queries)
]
print(f"Privacy Preservation Score: {sum(privacy_scores) / len(privacy_scores) * 100}%")Was sie misst: Ähnlich wie die Likert-Skala misst die Ordinalskala auf einer festen, geordneten Skala (1–5). Sie eignet sich perfekt zur Evaluierung der Kontextnutzung, da sie erfassen kann, in welchem Maß das Modell sich auf den Gesprächsverlauf bezieht und darauf aufbaut, was für kohärente, personalisierte Interaktionen entscheidend ist.
Beispiel-Eval-Testfälle: 100 mehrstufige Gespräche mit kontextabhängigen Fragen.
conversations = [
    [
        {"role": "user", "content": "I just got a new pomeranian!"},
        {
            "role": "assistant",
            "content": "Congratulations on your new furry friend! Is this your first dog?",
        },
        {"role": "user", "content": "Yes, it is. I named her Luna."},
        {
            "role": "assistant",
            "content": "Luna is a lovely name! As a first-time dog owner, you might have some questions. What would you like to know about caring for Luna?",
        },
        # ...
        {
            "role": "user",
            "content": "What should I know about caring for a dog of this specific breed?",
        },  # Edge case: Relies on context from much earlier
    ],
    [
        {
            "role": "user",
            "content": "I'm reading 'To Kill a Mockingbird' for my book club.",
        },
        {
            "role": "assistant",
            "content": "Great choice! 'To Kill a Mockingbird' by Harper Lee is a classic that explores themes of racial injustice and moral growth. How are you finding it so far?",
        },
        {
            "role": "user",
            "content": "It's powerful. Hey, when was Scout's birthday again?",
        },  # Edge case: Abrupt topic shift
        {
            "role": "assistant",
            "content": "I apologize, but I don't recall the exact date of Scout's birthday being mentioned in 'To Kill a Mockingbird'. The novel doesn't focus on such specific details. Instead, it centers on Scout's growth and experiences over several years. Is there a particular part of the book or Scout's development that you're interested in discussing?",
        },
        {
            "role": "user",
            "content": "Oh, right. Well, can you suggest a recipe for a classic Southern cake?",
        },  # Edge case: Another topic shift
    ],
    # ... 98 weitere Konversationen
]

client = anthropic.Anthropic()


def get_completion(conversation: list):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=conversation,
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_ordinal(model_output, conversation):
    ordinal_prompt = f"""Rate how well this response utilizes the conversation context on a scale of 1-5:
    <conversation>
    {"".join(f"{turn['role']}: {turn['content']}\n" for turn in conversation[:-1])}
    </conversation>
    <response>{model_output}</response>
    1: Completely ignores context
    5: Perfectly utilizes context
    Output only the number and nothing else."""

    # Generell ist es Best Practice, zur Bewertung ein anderes Modell zu verwenden als das Modell, das die bewertete Ausgabe erzeugt hat
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": ordinal_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [get_completion(conversation) for conversation in conversations]
context_scores = [
    evaluate_ordinal(output, conversation)
    for output, conversation in zip(outputs, conversations)
]
print(f"Average Context Utilization Score: {sum(context_scores) / len(context_scores)}")Bewerte deine Evaluierungen
Wenn du entscheidest, mit welcher Methode du Evals bewertest, wähle die schnellste, zuverlässigste und am besten skalierbare Methode:
-
Code-basierte Bewertung: Am schnellsten und zuverlässigsten, extrem skalierbar, aber es fehlt ihr an Nuancen für komplexere Beurteilungen, die weniger regelbasierte Starrheit erfordern.
- Exact Match:
output == golden_answer - String-Match:
key_phrase in output
- Exact Match:
-
Menschliche Bewertung: Am flexibelsten und von höchster Qualität, aber langsam und teuer. Wenn möglich vermeiden.
-
LLM-basierte Bewertung: Schnell und flexibel, skalierbar und für komplexe Beurteilungen geeignet. Teste zuerst die Zuverlässigkeit und skaliere dann.
Tipps für LLM-basierte Bewertung
- Verwende detaillierte, klare Rubriken: „Die Antwort sollte im ersten Satz immer ‚Acme Inc.' erwähnen. Tut sie das nicht, wird die Antwort automatisch als ‚falsch' bewertet.“
- Empirisch oder spezifisch: Weise das LLM zum Beispiel an, nur ‚correct' oder ‚incorrect' auszugeben oder auf einer Skala von 1–5 zu urteilen. Rein qualitative Evaluierungen lassen sich nur schwer schnell und in großem Umfang bewerten.
- Fördere das Schlussfolgern: Bitte das LLM, zuerst zu schlussfolgern, bevor es einen Evaluierungsscore ausgibt, und verwirf dann die Schlussfolgerung. Das erhöht die Evaluierungsleistung, insbesondere bei Aufgaben, die komplexe Beurteilungen erfordern.
client = anthropic.Anthropic()


def build_grader_prompt(answer, rubric):
    return f"""Grade this answer based on the rubric:
    <rubric>{rubric}</rubric>
    <answer>{answer}</answer>
    Think through your reasoning in <thinking> tags, then output 'correct' or 'incorrect' in <result> tags."""


def grade_completion(output, golden_answer):
    grader_message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[
            {"role": "user", "content": build_grader_prompt(output, golden_answer)}
        ],
    )
    grader_response = next(
        block.text for block in grader_message.content if block.type == "text"
    )

    return (
        "correct"
        if "<result>correct</result>" in grader_response.lower()
        else "incorrect"
    )


# Beispielverwendung
eval_data = [
    {
        "question": "Is 42 the answer to life, the universe, and everything?",
        "golden_answer": "Yes, according to 'The Hitchhiker's Guide to the Galaxy'.",
    },
    {
        "question": "What is the capital of France?",
        "golden_answer": "The capital of France is Paris.",
    },
]


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


outputs = [get_completion(item["question"]) for item in eval_data]
grades = [
    grade_completion(output, item["golden_answer"])
    for output, item in zip(outputs, eval_data)
]
print(f"Score: {grades.count('correct') / len(grades) * 100}%")
Nächste Schritte
Brainstorme mit Claude auf claude.ai Erfolgskriterien für deinen Anwendungsfall.
Tipp: Füge diese Seite als Orientierung für Claude in den Chat ein!
Weitere Codebeispiele für von Menschen, per Code und per LLM bewertete Evals.
Was this page helpful?