Best Practices für das Erstellen von Skills
Erfahre, wie du effektive Skills schreibst, die Claude entdecken und erfolgreich nutzen kann.
Gute Skills sind prägnant, gut strukturiert und mit realer Nutzung getestet. Dieser Leitfaden liefert praktische Entscheidungshilfen für das Erstellen von Skills, die Claude entdecken und effektiv nutzen kann.
Konzeptionelle Hintergründe zur Funktionsweise von Skills findest du in der Skills-Übersicht.
Grundprinzipien
Prägnanz ist entscheidend
Das „context window“ (Kontextfenster) ist ein öffentliches Gut. Dein Skill teilt sich das Kontextfenster mit allem anderen, was Claude wissen muss, darunter:
- Der System-Prompt
- Der Gesprächsverlauf
- Die Metadaten anderer Skills
- Deine eigentliche Anfrage
Nicht jedes Token in deinem Skill verursacht unmittelbare Kosten. Beim Start werden nur die Metadaten (Name und Beschreibung) aller Skills vorab geladen. Claude liest SKILL.md erst, wenn der Skill relevant wird, und liest zusätzliche Dateien nur bei Bedarf. Dennoch ist Prägnanz in SKILL.md wichtig: Sobald Claude die Datei lädt, konkurriert jedes Token mit dem Gesprächsverlauf und anderem Kontext.
Standardannahme: Claude ist bereits sehr intelligent
Füge nur Kontext hinzu, den Claude nicht bereits hat. Hinterfrage jede einzelne Information:
- „Braucht Claude diese Erklärung wirklich?“
- „Kann ich davon ausgehen, dass Claude das weiß?“
- „Rechtfertigt dieser Absatz seine Token-Kosten?“
Gutes Beispiel: Prägnant (ungefähr 50 Token):
## Extract PDF text

Use pdfplumber for text extraction:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```Schlechtes Beispiel: Zu ausführlich (ungefähr 150 Token):
## Extract PDF text

PDF (Portable Document Format) files are a common file format that contains
text, images, and other content. To extract text from a PDF, you'll need to
use a library. There are many libraries available for PDF processing, but
pdfplumber is recommended because it's easy to use and handles most cases well.
First, you'll need to install it using pip. Then you can use the code below...Die prägnante Version geht davon aus, dass Claude bereits Informationen über PDFs und die Funktionsweise von Bibliotheken hat.
Angemessene Freiheitsgrade festlegen
Passe den Grad der Spezifität an die Fragilität und Variabilität der Aufgabe an.
Hohe Freiheit (textbasierte Anweisungen):
Verwende dies, wenn:
- Mehrere Ansätze gültig sind
- Entscheidungen vom Kontext abhängen
- Heuristiken den Ansatz leiten
Beispiel:
## Code review process

1. Analyze the code structure and organization
2. Check for potential bugs or edge cases
3. Suggest improvements for readability and maintainability
4. Verify adherence to project conventionsMittlere Freiheit (Pseudocode oder Skripte mit Parametern):
Verwende dies, wenn:
- Ein bevorzugtes Muster existiert
- Eine gewisse Variation akzeptabel ist
- Die Konfiguration das Verhalten beeinflusst
Beispiel:
## Generate report

Use this template and customize as needed:

```python
def generate_report(data, format="markdown", include_charts=True):
    # Process data
    # Generate output in specified format
    # Optionally include visualizations
```Geringe Freiheit (spezifische Skripte, wenige oder keine Parameter):
Verwende dies, wenn:
- Operationen fragil und fehleranfällig sind
- Konsistenz entscheidend ist
- Eine bestimmte Reihenfolge eingehalten werden muss
Beispiel:
## Database migration

Run exactly this script:

```bash
python scripts/migrate.py --verify --backup
```

Do not modify the command or add additional flags.Analogie: Stell dir Claude als Roboter vor, der einen Weg erkundet:
- Schmale Brücke mit Klippen auf beiden Seiten: Es gibt nur einen sicheren Weg nach vorn. Gib spezifische Leitplanken und exakte Anweisungen vor (geringe Freiheit). Beispiel: Datenbankmigrationen, die in exakter Reihenfolge ausgeführt werden müssen.
- Offenes Feld ohne Gefahren: Viele Wege führen zum Erfolg. Gib eine allgemeine Richtung vor und vertraue darauf, dass Claude die beste Route findet (hohe Freiheit). Beispiel: Code-Reviews, bei denen der Kontext den besten Ansatz bestimmt.
Mit allen Modellen testen, die du verwenden möchtest
Skills fungieren als Ergänzungen zu Modellen, daher hängt ihre Wirksamkeit vom zugrunde liegenden Modell ab. Teste deinen Skill mit allen Modellen, mit denen du ihn verwenden möchtest.
Testüberlegungen nach Modell:
- Claude Haiku (schnell, wirtschaftlich): Bietet der Skill genügend Anleitung?
- Claude Sonnet (ausgewogen): Ist der Skill klar und effizient?
- Claude Opus (leistungsstarkes Reasoning): Vermeidet der Skill übermäßige Erklärungen?
Was für Opus perfekt funktioniert, braucht für Haiku möglicherweise mehr Details. Wenn du deinen Skill mit mehreren Modellen verwenden möchtest, strebe Anweisungen an, die mit allen gut funktionieren.
Skill-Struktur
Namenskonventionen
Verwende konsistente Benennungsmuster, damit Skills leichter referenziert und besprochen werden können. Erwäge die Verwendung der Gerundium-Form (Verb + -ing) für Skill-Namen, da diese die Aktivität oder Fähigkeit, die der Skill bereitstellt, klar beschreibt.
Denke daran, dass das Feld name nur Kleinbuchstaben, Zahlen und Bindestriche verwenden darf.
Gute Benennungsbeispiele (Gerundium-Form):
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
Akzeptable Alternativen:
- Nominalphrasen:
pdf-processing,spreadsheet-analysis - Handlungsorientiert:
process-pdfs,analyze-spreadsheets
Vermeide:
- Vage Namen:
helper,utils,tools - Zu generisch:
documents,data,files - Reservierte Wörter:
anthropic-helper,claude-tools - Inkonsistente Muster innerhalb deiner Skill-Sammlung
Konsistente Benennung erleichtert es:
- Skills in Dokumentation und Gesprächen zu referenzieren
- Auf einen Blick zu verstehen, was ein Skill tut
- Mehrere Skills zu organisieren und zu durchsuchen
- Eine professionelle, kohärente Skill-Bibliothek zu pflegen
Effektive Beschreibungen schreiben
Das Feld description ermöglicht die Skill-Erkennung und sollte sowohl enthalten, was der Skill tut, als auch, wann er verwendet werden soll.
Sei spezifisch und verwende Schlüsselbegriffe. Gib sowohl an, was der Skill tut, als auch spezifische Auslöser/Kontexte, wann er verwendet werden soll.
Jeder Skill hat genau ein Beschreibungsfeld. Die Beschreibung ist entscheidend für die Skill-Auswahl: Claude nutzt sie, um aus potenziell über 100 verfügbaren Skills den richtigen auszuwählen. Deine Beschreibung muss genügend Details liefern, damit Claude weiß, wann dieser Skill ausgewählt werden soll, während der Rest von SKILL.md die Implementierungsdetails bereitstellt.
Effektive Beispiele:
PDF-Verarbeitungs-Skill:
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.Excel-Analyse-Skill:
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.Git-Commit-Helfer-Skill:
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.Vermeide vage Beschreibungen wie diese:
description: Helps with documentsdescription: Processes datadescription: Does stuff with filesMuster für progressive Offenlegung
SKILL.md dient als Übersicht, die Claude bei Bedarf auf detaillierte Materialien verweist, ähnlich einem Inhaltsverzeichnis in einem Onboarding-Leitfaden. Eine Erklärung, wie „progressive disclosure“ (progressive Offenlegung) funktioniert, findest du unter Wie Skills funktionieren in der Übersicht.
Praktische Hinweise:
- Halte den SKILL.md-Body für optimale Leistung unter 500 Zeilen
- Teile Inhalte in separate Dateien auf, wenn du dich dieser Grenze näherst
- Verwende die folgenden Muster, um Anweisungen, Code und Ressourcen effektiv zu organisieren
Visuelle Übersicht: Von einfach bis komplex
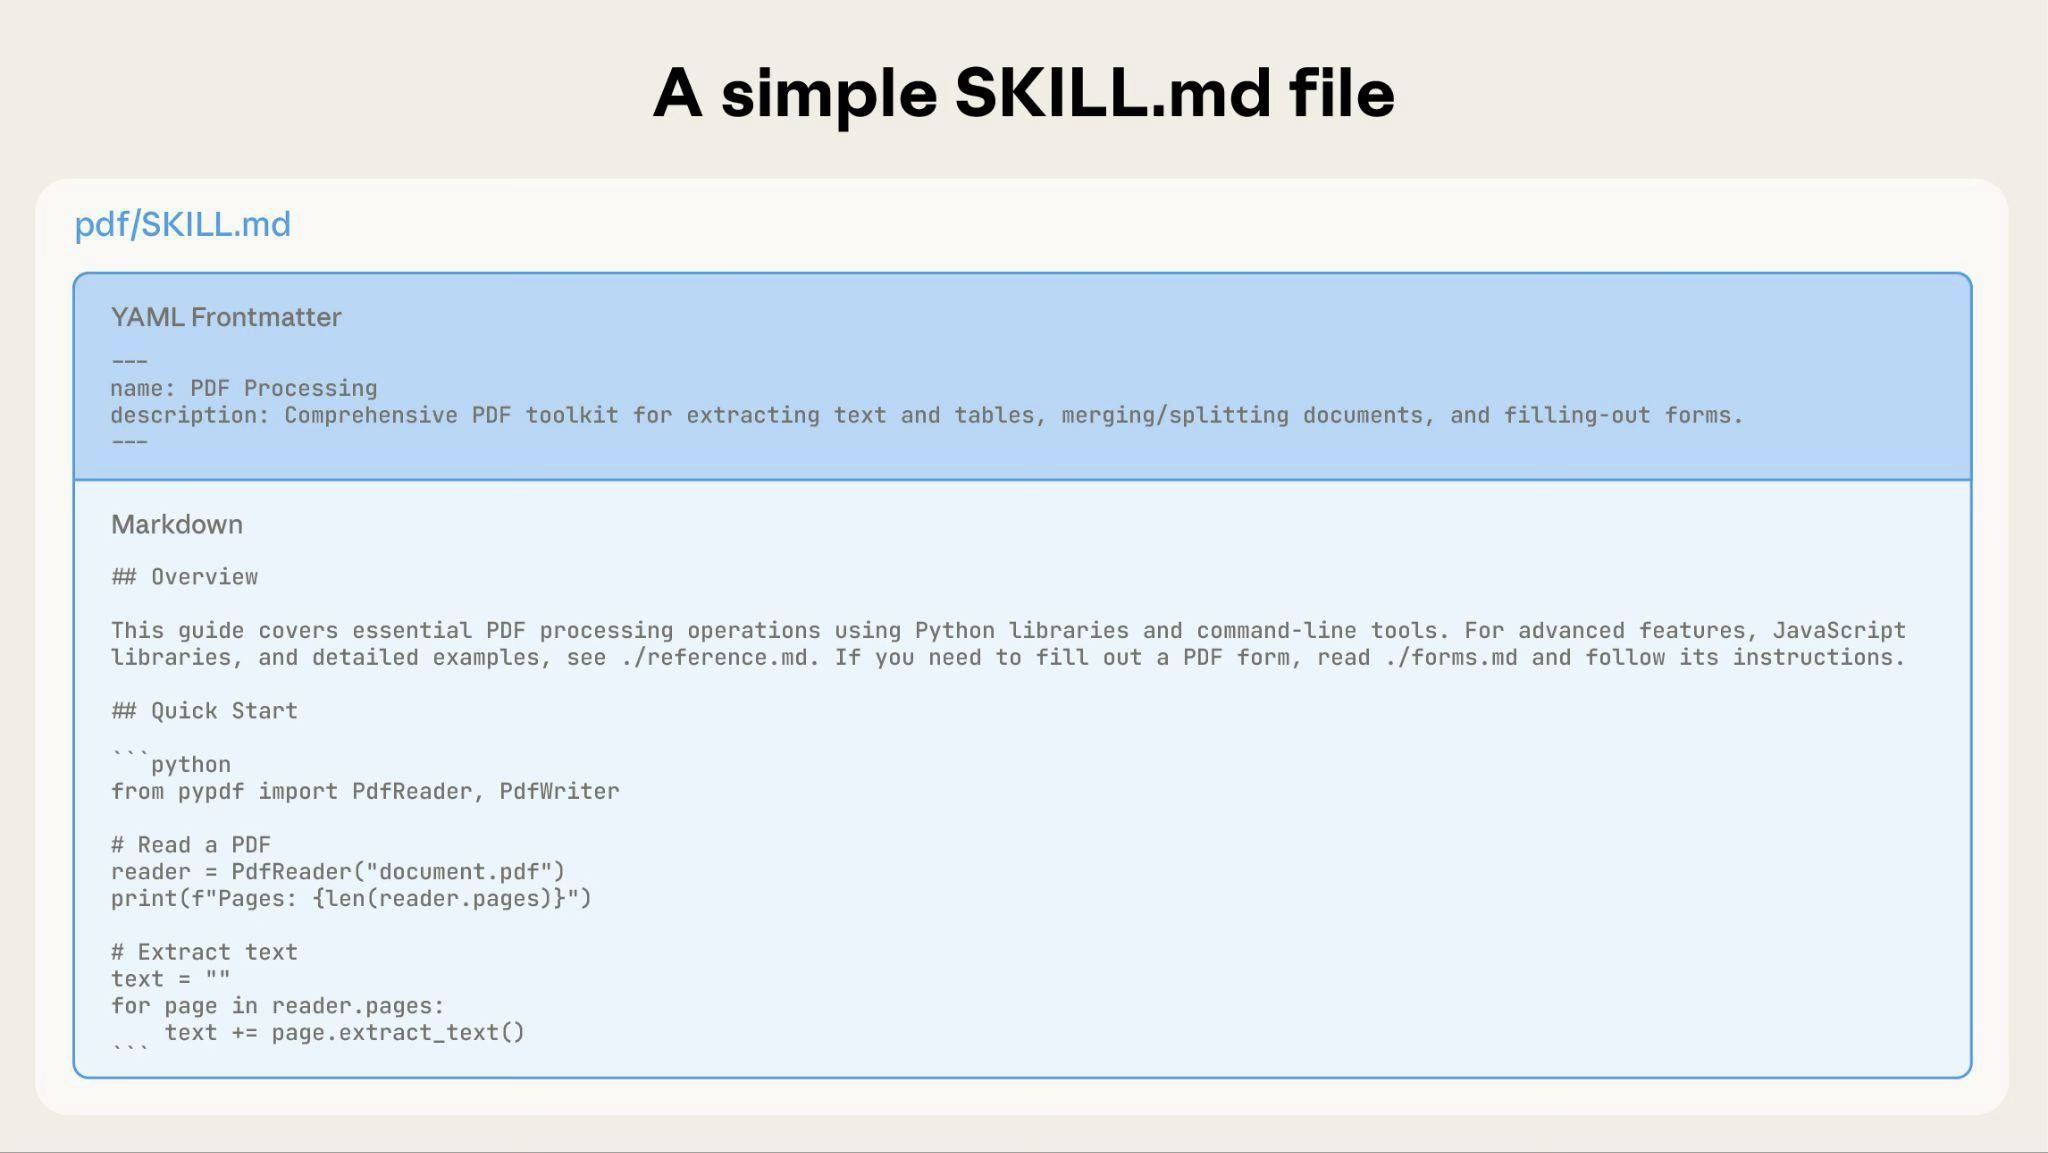
Ein einfacher Skill beginnt mit nur einer SKILL.md-Datei, die Metadaten und Anweisungen enthält:
Wenn dein Skill wächst, kannst du zusätzliche Inhalte bündeln, die Claude nur bei Bedarf lädt:
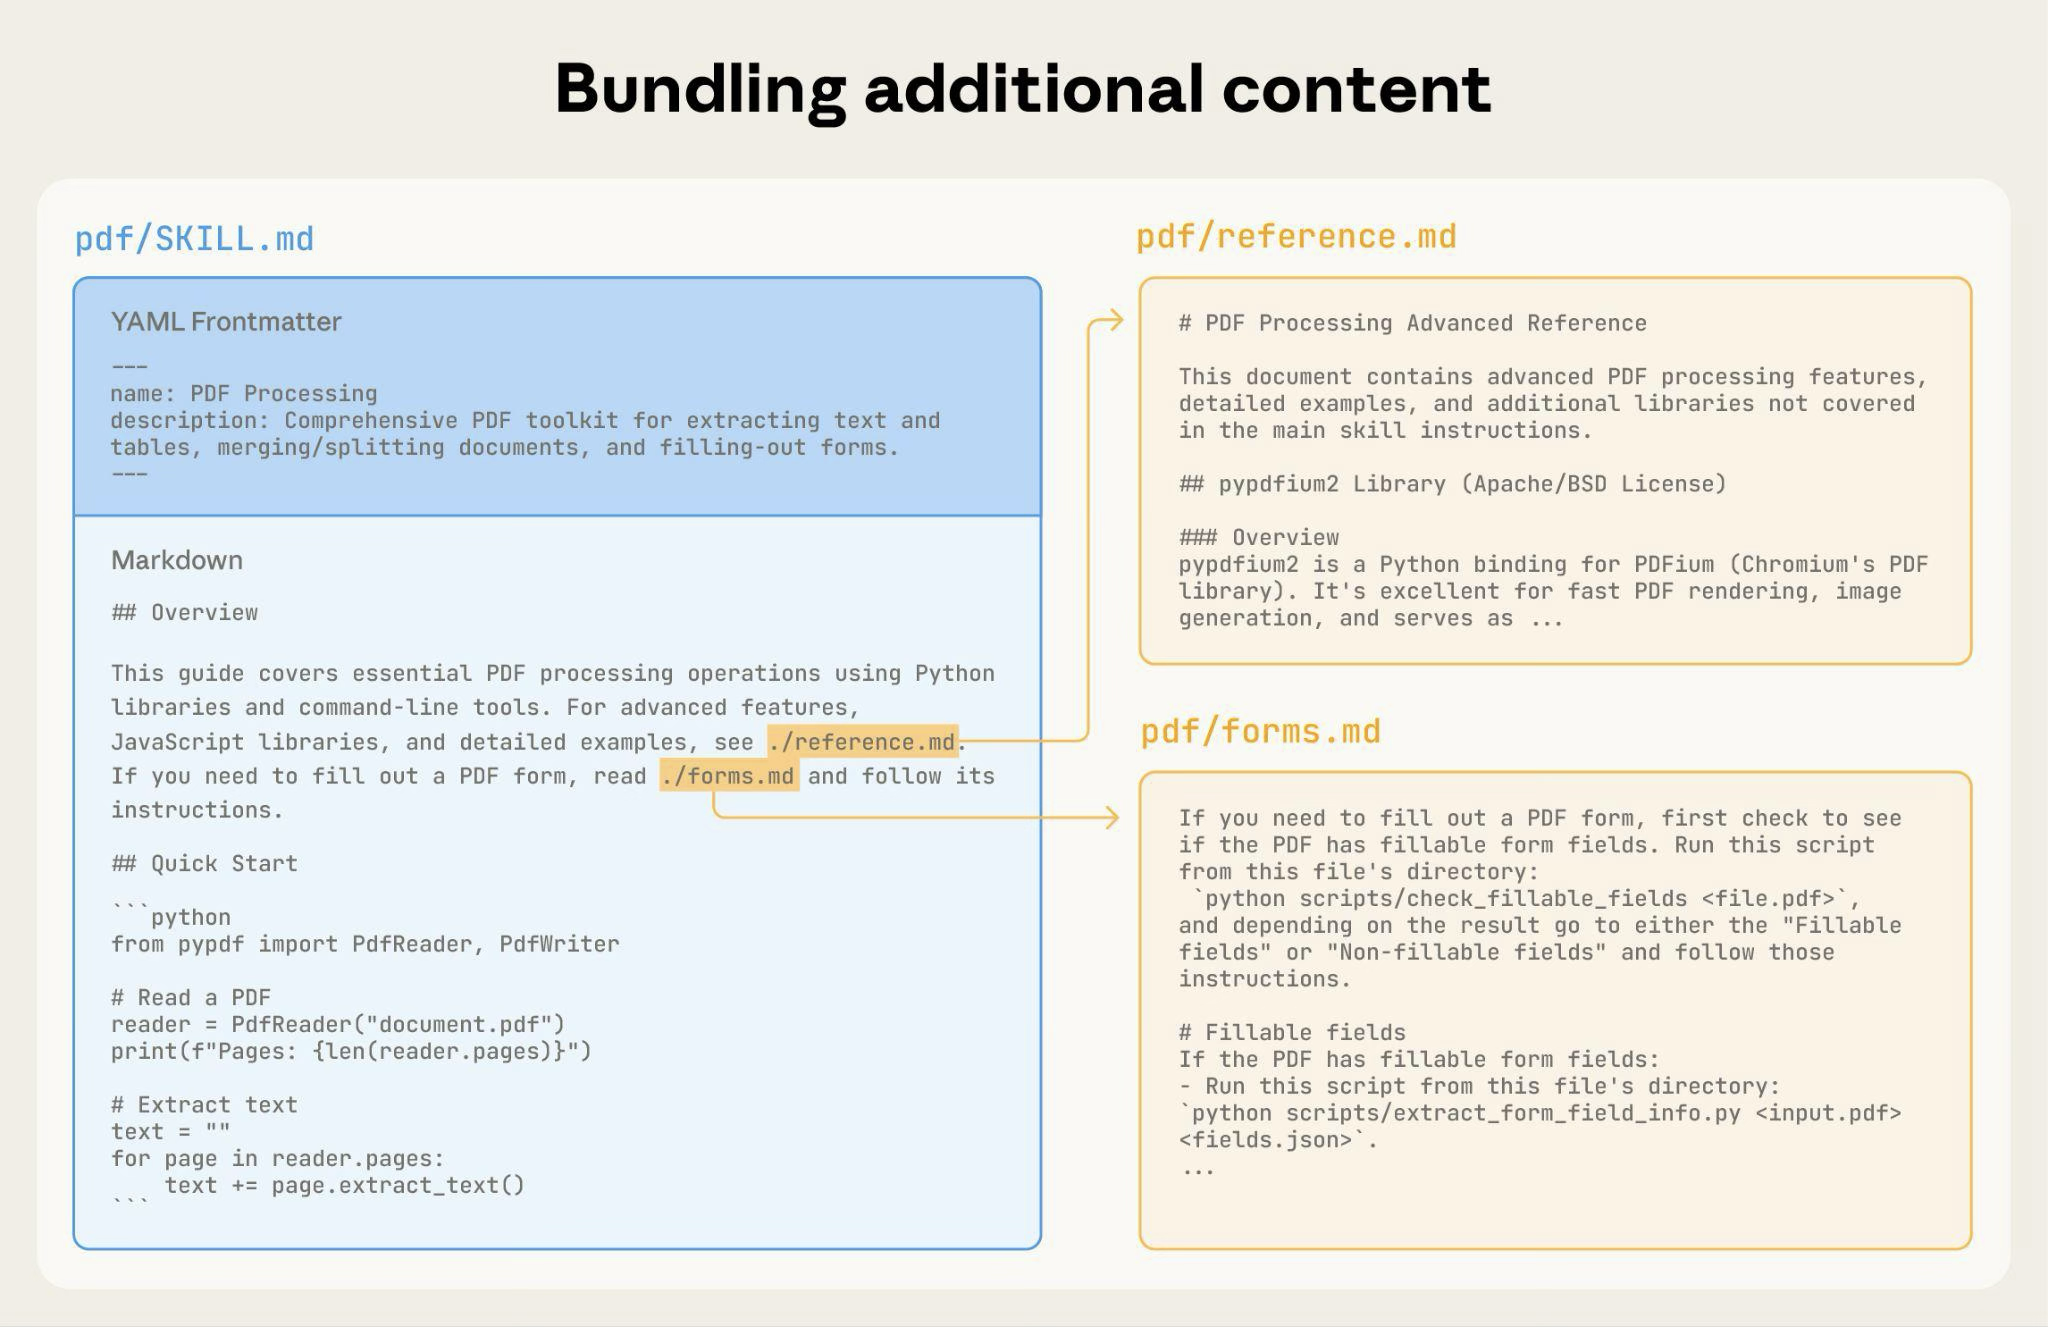
Die vollständige Skill-Verzeichnisstruktur könnte so aussehen:
pdf/SKILL.md: Hauptanweisungen (wird beim Auslösen geladen)FORMS.md: Leitfaden zum Ausfüllen von Formularen (wird bei Bedarf geladen)reference.md: API-Referenz (wird bei Bedarf geladen)examples.md: Nutzungsbeispiele (wird bei Bedarf geladen)scripts/analyze_form.py: Hilfsskript (wird ausgeführt, nicht geladen)fill_form.py: Skript zum Ausfüllen von Formularenvalidate.py: Validierungsskript
Muster 1: Übergeordneter Leitfaden mit Referenzen
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
---

# PDF Processing

## Quick start

Extract text with pdfplumber:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## Advanced features

**Form filling**: See [FORMS.md](FORMS.md) for complete guide
**API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
**Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patternsClaude lädt FORMS.md, REFERENCE.md oder EXAMPLES.md nur bei Bedarf.
Muster 2: Domänenspezifische Organisation
Organisiere bei Skills mit mehreren Domänen die Inhalte nach Domäne, um das Laden irrelevanten Kontexts zu vermeiden. Wenn ein Nutzer nach Vertriebskennzahlen fragt, muss Claude nur vertriebsbezogene Schemata lesen, nicht Finanz- oder Marketingdaten. Das hält den Token-Verbrauch niedrig und den Kontext fokussiert.
bigquery-skill/SKILL.md(Übersicht und Navigation)reference/finance.md(Umsatz, Abrechnungskennzahlen)sales.md(Opportunities, Pipeline)product.md(API-Nutzung, Features)marketing.md(Kampagnen, Attribution)
# BigQuery Data Analysis

## Available datasets

**Finance**: Revenue, ARR, billing → See [reference/finance.md](reference/finance.md)
**Sales**: Opportunities, pipeline, accounts → See [reference/sales.md](reference/sales.md)
**Product**: API usage, features, adoption → See [reference/product.md](reference/product.md)
**Marketing**: Campaigns, attribution, email → See [reference/marketing.md](reference/marketing.md)

## Quick search

Find specific metrics using grep:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md
```
Muster 3: Bedingte Details
Zeige grundlegende Inhalte, verlinke auf fortgeschrittene Inhalte:
# DOCX Processing

## Creating documents

Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).

## Editing documents

For simple edits, modify the XML directly.

**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)Claude liest REDLINING.md oder OOXML.md nur, wenn der Nutzer diese Funktionen benötigt.
Tief verschachtelte Referenzen vermeiden
Claude liest Dateien möglicherweise nur teilweise, wenn sie aus anderen referenzierten Dateien heraus referenziert werden. Bei verschachtelten Referenzen verwendet Claude möglicherweise Befehle wie head -100, um Inhalte vorab anzusehen, anstatt ganze Dateien zu lesen, was zu unvollständigen Informationen führt.
Halte Referenzen eine Ebene tief ausgehend von SKILL.md. Alle Referenzdateien sollten direkt von SKILL.md aus verlinkt sein, um sicherzustellen, dass Claude bei Bedarf vollständige Dateien liest.
Schlechtes Beispiel: Zu tief:
# SKILL.md
See [advanced.md](advanced.md)...

# advanced.md
See [details.md](details.md)...

# details.md
Here's the actual information...Gutes Beispiel: Eine Ebene tief:
# SKILL.md

**Basic usage**: [instructions in SKILL.md]
**Advanced features**: See [advanced.md](advanced.md)
**API reference**: See [reference.md](reference.md)
**Examples**: See [examples.md](examples.md)Längere Referenzdateien mit Inhaltsverzeichnis strukturieren
Füge bei Referenzdateien mit mehr als 100 Zeilen oben ein Inhaltsverzeichnis ein. So kann Claude den vollen Umfang der verfügbaren Informationen sehen, selbst bei einer Vorschau mit teilweisem Lesen.
Beispiel:
# API Reference

## Contents
- Authentication and setup
- Core methods (create, read, update, delete)
- Advanced features (batch operations, webhooks)
- Error handling patterns
- Code examples

## Authentication and setup
...

## Core methods
...Claude kann dann die vollständige Datei lesen oder bei Bedarf zu bestimmten Abschnitten springen.
Details dazu, wie diese dateisystembasierte Architektur progressive Offenlegung ermöglicht, findest du im Abschnitt Laufzeitumgebung weiter unten in diesem Leitfaden.
Workflows und Feedbackschleifen
Workflows für komplexe Aufgaben verwenden
Zerlege komplexe Operationen in klare, aufeinanderfolgende Schritte. Stelle bei besonders komplexen Workflows eine Checkliste bereit, die Claude in seine Antwort kopieren und beim Fortschreiten abhaken kann.
Beispiel 1: Workflow zur Recherche-Synthese (für Skills ohne Code):
## Research synthesis workflow

Copy this checklist and track your progress:

```
Research Progress:
- [ ] Step 1: Read all source documents
- [ ] Step 2: Identify key themes
- [ ] Step 3: Cross-reference claims
- [ ] Step 4: Create structured summary
- [ ] Step 5: Verify citations
```

**Step 1: Read all source documents**

Review each document in the `sources/` directory. Note the main arguments and supporting evidence.

**Step 2: Identify key themes**

Look for patterns across sources. What themes appear repeatedly? Where do sources agree or disagree?

**Step 3: Cross-reference claims**

For each major claim, verify it appears in the source material. Note which source supports each point.

**Step 4: Create structured summary**

Organize findings by theme. Include:
- Main claim
- Supporting evidence from sources
- Conflicting viewpoints (if any)

**Step 5: Verify citations**

Check that every claim references the correct source document. If citations are incomplete, return to Step 3.Dieses Beispiel zeigt, wie Workflows auf Analyseaufgaben angewendet werden, die keinen Code erfordern. Das Checklisten-Muster funktioniert für jeden komplexen, mehrstufigen Prozess.
Beispiel 2: Workflow zum Ausfüllen von PDF-Formularen (für Skills mit Code):
## PDF form filling workflow

Copy this checklist and check off items as you complete them:

```
Task Progress:
- [ ] Step 1: Analyze the form (run analyze_form.py)
- [ ] Step 2: Create field mapping (edit fields.json)
- [ ] Step 3: Validate mapping (run validate_fields.py)
- [ ] Step 4: Fill the form (run fill_form.py)
- [ ] Step 5: Verify output (run verify_output.py)
```

**Step 1: Analyze the form**

Run: `python scripts/analyze_form.py input.pdf`

This extracts form fields and their locations, saving to `fields.json`.

**Step 2: Create field mapping**

Edit `fields.json` to add values for each field.

**Step 3: Validate mapping**

Run: `python scripts/validate_fields.py fields.json`

Fix any validation errors before continuing.

**Step 4: Fill the form**

Run: `python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: Verify output**

Run: `python scripts/verify_output.py output.pdf`

If verification fails, return to Step 2.Klare Schritte verhindern, dass Claude kritische Validierungen überspringt. Die Checkliste hilft sowohl Claude als auch dir, den Fortschritt durch mehrstufige Workflows zu verfolgen.
Feedbackschleifen implementieren
Gängiges Muster: Validator ausführen → Fehler beheben → wiederholen
Dieses Muster verbessert die Ausgabequalität erheblich.
Beispiel 1: Einhaltung des Styleguides (für Skills ohne Code):
## Content review process

1. Draft your content following the guidelines in STYLE_GUIDE.md
2. Review against the checklist:
   - Check terminology consistency
   - Verify examples follow the standard format
   - Confirm all required sections are present
3. If issues found:
   - Note each issue with specific section reference
   - Revise the content
   - Review the checklist again
4. Only proceed when all requirements are met
5. Finalize and save the documentDies zeigt das Validierungsschleifen-Muster mit Referenzdokumenten anstelle von Skripten. Der „Validator“ ist STYLE_GUIDE.md, und Claude führt die Prüfung durch Lesen und Vergleichen durch.
Beispiel 2: Dokumentbearbeitungsprozess (für Skills mit Code):
## Document editing process

1. Make your edits to `word/document.xml`
2. **Validate immediately**: `python ooxml/scripts/validate.py unpacked_dir/`
3. If validation fails:
   - Review the error message carefully
   - Fix the issues in the XML
   - Run validation again
4. **Only proceed when validation passes**
5. Rebuild: `python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. Test the output documentDie Validierungsschleife fängt Fehler frühzeitig ab.
Inhaltsrichtlinien
Zeitabhängige Informationen vermeiden
Nimm keine Informationen auf, die veralten werden:
Schlechtes Beispiel: Zeitabhängig (wird falsch werden):
If you're doing this before August 2025, use the old API.
After August 2025, use the new API.Gutes Beispiel (Abschnitt „alte Muster“ verwenden):
## Current method

Use the v2 API endpoint: `api.example.com/v2/messages`

## Old patterns

<details>
<summary>Legacy v1 API (deprecated 2025-08)</summary>

The v1 API used: `api.example.com/v1/messages`

This endpoint is no longer supported.
</details>Der Abschnitt mit alten Mustern liefert historischen Kontext, ohne den Hauptinhalt zu überladen.
Konsistente Terminologie verwenden
Wähle einen Begriff und verwende ihn im gesamten Skill:
Gut – Konsistent:
- Immer „API endpoint“
- Immer „field“
- Immer „extract“
Schlecht – Inkonsistent:
- Mischung aus „API endpoint“, „URL“, „API route“, „path“
- Mischung aus „field“, „box“, „element“, „control“
- Mischung aus „extract“, „pull“, „get“, „retrieve“
Konsistenz hilft Claude, Anweisungen zu parsen und zu befolgen.
Gängige Muster
Template-Muster
Stelle Templates für das Ausgabeformat bereit. Passe den Grad der Strenge an deine Bedürfnisse an.
Für strenge Anforderungen (wie API-Antworten oder Datenformate):
## Report structure

ALWAYS use this exact template structure:

```markdown
# [Analysis Title]

## Executive summary
[One-paragraph overview of key findings]

## Key findings
- Finding 1 with supporting data
- Finding 2 with supporting data
- Finding 3 with supporting data

## Recommendations
1. Specific actionable recommendation
2. Specific actionable recommendation
```Für flexible Anleitung (wenn Anpassung sinnvoll ist):
## Report structure

Here is a sensible default format, but use your best judgment based on the analysis:

```markdown
# [Analysis Title]

## Executive summary
[Overview]

## Key findings
[Adapt sections based on what you discover]

## Recommendations
[Tailor to the specific context]
```

Adjust sections as needed for the specific analysis type.Beispiel-Muster
Stelle bei Skills, bei denen die Ausgabequalität vom Sehen von Beispielen abhängt, Eingabe/Ausgabe-Paare bereit, genau wie beim regulären Prompting:
## Commit message format

Generate commit messages following these examples:

**Example 1:**
Input: Added user authentication with JWT tokens
Output:
```
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware
```

**Example 2:**
Input: Fixed bug where dates displayed incorrectly in reports
Output:
```
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation
```

**Example 3:**
Input: Updated dependencies and refactored error handling
Output:
```
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints
```

Follow this style: type(scope): brief description, then detailed explanation.Beispiele vermitteln Claude den gewünschten Stil und Detailgrad klarer als Beschreibungen allein.
Muster für bedingte Workflows
Führe Claude durch Entscheidungspunkte:
## Document modification workflow

1. Determine the modification type:

   **Creating new content?** → Follow "Creation workflow" below
   **Editing existing content?** → Follow "Editing workflow" below

2. Creation workflow:
   - Use docx-js library
   - Build document from scratch
   - Export to .docx format

3. Editing workflow:
   - Unpack existing document
   - Modify XML directly
   - Validate after each change
- Repack when completeEvaluierung und Iteration
Zuerst Evaluierungen erstellen
Erstelle Evaluierungen, BEVOR du umfangreiche Dokumentation schreibst. So stellst du sicher, dass dein Skill reale Probleme löst, anstatt eingebildete zu dokumentieren.
Evaluierungsgetriebene Entwicklung:
- Lücken identifizieren: Lass Claude repräsentative Aufgaben ohne Skill ausführen. Dokumentiere spezifische Fehler oder fehlenden Kontext
- Evaluierungen erstellen: Erstelle drei Szenarien, die diese Lücken testen
- Baseline festlegen: Miss Claudes Leistung ohne den Skill
- Minimale Anweisungen schreiben: Erstelle gerade genug Inhalt, um die Lücken zu schließen und die Evaluierungen zu bestehen
- Iterieren: Führe Evaluierungen aus, vergleiche mit der Baseline und verfeinere
Dieser Ansatz stellt sicher, dass du tatsächliche Probleme löst, anstatt Anforderungen vorwegzunehmen, die möglicherweise nie eintreten.
Evaluierungsstruktur:
{
  "skills": ["pdf-processing"],
  "query": "Extract all text from this PDF file and save it to output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "Successfully reads the PDF file using an appropriate PDF processing library or command-line tool",
    "Extracts text content from all pages in the document without missing any pages",
    "Saves the extracted text to a file named output.txt in a clear, readable format"
  ]
}Skills iterativ mit Claude entwickeln
Der effektivste Skill-Entwicklungsprozess bezieht Claude selbst ein. Arbeite mit einer Instanz von Claude („Claude A“), um einen Skill zu erstellen, der von anderen Instanzen („Claude B“) verwendet wird. Claude A hilft dir, Anweisungen zu entwerfen und zu verfeinern, während Claude B sie in realen Aufgaben testet. Das funktioniert, weil Claude-Modelle sowohl verstehen, wie man effektive Agenten-Anweisungen schreibt, als auch, welche Informationen Agenten benötigen.
Einen neuen Skill erstellen:
-
Eine Aufgabe ohne Skill erledigen: Arbeite ein Problem mit Claude A mittels normalem Prompting durch. Dabei wirst du ganz natürlich Kontext liefern, Präferenzen erklären und prozedurales Wissen teilen. Achte darauf, welche Informationen du wiederholt bereitstellst.
-
Das wiederverwendbare Muster identifizieren: Identifiziere nach Abschluss der Aufgabe, welchen Kontext du bereitgestellt hast, der für ähnliche zukünftige Aufgaben nützlich wäre.
Beispiel: Wenn du eine BigQuery-Analyse durchgearbeitet hast, hast du möglicherweise Tabellennamen, Felddefinitionen, Filterregeln (wie „Testkonten immer ausschließen“) und gängige Abfragemuster bereitgestellt.
-
Claude A bitten, einen Skill zu erstellen: „Erstelle einen Skill, der dieses BigQuery-Analysemuster erfasst, das wir gerade verwendet haben. Nimm die Tabellenschemata, Namenskonventionen und die Regel zum Filtern von Testkonten auf."
-
Auf Prägnanz prüfen: Prüfe, dass Claude A keine unnötigen Erklärungen hinzugefügt hat. Frage: „Entferne die Erklärung, was Win-Rate bedeutet – Claude weiß das bereits.“
-
Informationsarchitektur verbessern: Bitte Claude A, den Inhalt effektiver zu organisieren. Zum Beispiel: „Organisiere das so, dass das Tabellenschema in einer separaten Referenzdatei liegt. Wir fügen später vielleicht weitere Tabellen hinzu.“
-
An ähnlichen Aufgaben testen: Verwende den Skill mit Claude B (einer frischen Instanz mit geladenem Skill) für verwandte Anwendungsfälle. Beobachte, ob Claude B die richtigen Informationen findet, Regeln korrekt anwendet und die Aufgabe erfolgreich bewältigt.
-
Auf Basis von Beobachtungen iterieren: Wenn Claude B Schwierigkeiten hat oder etwas übersieht, kehre mit konkreten Angaben zu Claude A zurück: „Als Claude diesen Skill verwendet hat, hat es vergessen, für Q4 nach Datum zu filtern. Sollten wir einen Abschnitt über Datumsfiltermuster hinzufügen?“
An bestehenden Skills iterieren:
Dasselbe hierarchische Muster setzt sich beim Verbessern von Skills fort. Du wechselst zwischen:
- Arbeit mit Claude A (dem Experten, der beim Verfeinern des Skills hilft)
- Testen mit Claude B (dem Agenten, der den Skill für reale Arbeit verwendet)
- Beobachten des Verhaltens von Claude B und Zurückbringen der Erkenntnisse zu Claude A
-
Den Skill in realen Workflows verwenden: Gib Claude B (mit geladenem Skill) tatsächliche Aufgaben, keine Testszenarien
-
Das Verhalten von Claude B beobachten: Notiere, wo es Schwierigkeiten hat, erfolgreich ist oder unerwartete Entscheidungen trifft
Beispielbeobachtung: „Als ich Claude B um einen regionalen Vertriebsbericht bat, schrieb es die Abfrage, vergaß aber, Testkonten herauszufiltern, obwohl der Skill diese Regel erwähnt."
-
Für Verbesserungen zu Claude A zurückkehren: Teile die aktuelle SKILL.md und beschreibe, was du beobachtet hast. Frage: „Mir ist aufgefallen, dass Claude B vergessen hat, Testkonten zu filtern, als ich nach einem regionalen Bericht fragte. Der Skill erwähnt das Filtern, aber vielleicht ist es nicht prominent genug?"
-
Die Vorschläge von Claude A prüfen: Claude A könnte vorschlagen, umzustrukturieren, um Regeln prominenter zu machen, stärkere Formulierungen wie „MUSS filtern“ statt „immer filtern“ zu verwenden oder den Workflow-Abschnitt neu zu gliedern.
-
Änderungen anwenden und testen: Aktualisiere den Skill mit den Verfeinerungen von Claude A und teste dann erneut mit Claude B an ähnlichen Anfragen
-
Auf Basis der Nutzung wiederholen: Setze diesen Beobachten-Verfeinern-Testen-Zyklus fort, wenn du auf neue Szenarien stößt. Jede Iteration verbessert den Skill auf Basis realen Agentenverhaltens, nicht auf Basis von Annahmen.
Team-Feedback einholen:
- Teile Skills mit Teamkollegen und beobachte deren Nutzung
- Frage: Wird der Skill wie erwartet aktiviert? Sind die Anweisungen klar? Was fehlt?
- Arbeite Feedback ein, um Lücken in deinen eigenen Nutzungsmustern zu schließen
Warum dieser Ansatz funktioniert: Claude A versteht die Bedürfnisse von Agenten, du bringst Domänenexpertise ein, Claude B deckt durch reale Nutzung Lücken auf, und iterative Verfeinerung verbessert Skills auf Basis beobachteten Verhaltens statt Annahmen.
Beobachten, wie Claude durch Skills navigiert
Achte beim Iterieren an Skills darauf, wie Claude sie in der Praxis tatsächlich verwendet. Achte auf:
- Unerwartete Erkundungspfade: Liest Claude Dateien in einer Reihenfolge, die du nicht erwartet hast? Das könnte darauf hindeuten, dass deine Struktur nicht so intuitiv ist, wie du dachtest
- Verpasste Verbindungen: Folgt Claude Referenzen auf wichtige Dateien nicht? Deine Links müssen möglicherweise expliziter oder prominenter sein
- Übermäßige Abhängigkeit von bestimmten Abschnitten: Wenn Claude wiederholt dieselbe Datei liest, überlege, ob dieser Inhalt stattdessen in der Haupt-SKILL.md stehen sollte
- Ignorierte Inhalte: Wenn Claude nie auf eine gebündelte Datei zugreift, ist sie möglicherweise unnötig oder in den Hauptanweisungen schlecht signalisiert
Iteriere auf Basis dieser Beobachtungen statt auf Basis von Annahmen. Der ‚name' und die ‚description' in den Metadaten deines Skills sind besonders entscheidend. Claude verwendet diese, um zu bestimmen, ob der Skill als Reaktion auf die aktuelle Aufgabe ausgelöst werden soll. Stelle sicher, dass sie klar beschreiben, was der Skill tut und wann er verwendet werden soll.
Zu vermeidende Anti-Patterns
Windows-Pfade vermeiden
Verwende in Dateipfaden immer Schrägstriche, auch unter Windows:
- ✓ Gut:
scripts/helper.py,reference/guide.md - ✗ Vermeide:
scripts\helper.py,reference\guide.md
Unix-Pfade funktionieren auf allen Plattformen, während Windows-Pfade auf Unix-Systemen Fehler verursachen.
Nicht zu viele Optionen anbieten
Präsentiere nicht mehrere Ansätze, sofern es nicht notwendig ist:
**Bad example: Too many choices** (confusing):
"You can use pypdf, or pdfplumber, or PyMuPDF, or pdf2image, or..."

**Good example: Provide a default** (with escape hatch):
"Use pdfplumber for text extraction:
```python
import pdfplumber
```

For scanned PDFs requiring OCR, use pdf2image with pytesseract instead."Fortgeschritten: Skills mit ausführbarem Code
Die folgenden Abschnitte konzentrieren sich auf Skills, die ausführbare Skripte enthalten. Wenn dein Skill nur Markdown-Anweisungen verwendet, springe zur Checkliste für effektive Skills.
Lösen, nicht delegieren
Behandle beim Schreiben von Skripten für Skills Fehlerbedingungen selbst, anstatt sie an Claude zu delegieren.
Gutes Beispiel: Fehler explizit behandeln:
def process_file(path):
    """Process a file, creating it if it doesn't exist."""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # Datei mit Standardinhalt erstellen, statt fehlzuschlagen
        print(f"File {path} not found, creating default")
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # Alternative bereitstellen, statt fehlzuschlagen
        print(f"Cannot access {path}, using default")
return ""Schlechtes Beispiel: An Claude delegieren:
def process_file(path):
    # Einfach fehlschlagen und Claude das Problem lösen lassen
return open(path).read()Konfigurationsparameter sollten ebenfalls begründet und dokumentiert sein, um „Voodoo-Konstanten“ zu vermeiden (Ousterhouts Gesetz). Wenn du den richtigen Wert nicht kennst, wie soll Claude ihn bestimmen?
Gutes Beispiel: Selbstdokumentierend:
# HTTP-Anfragen werden in der Regel innerhalb von 30 Sekunden abgeschlossen
# Längeres Timeout berücksichtigt langsame Verbindungen
REQUEST_TIMEOUT = 30

# Drei Wiederholungsversuche balancieren Zuverlässigkeit und Geschwindigkeit
# Die meisten sporadischen Fehler lösen sich beim zweiten Wiederholungsversuch
MAX_RETRIES = 3Schlechtes Beispiel: Magische Zahlen:
TIMEOUT = 47  # Why 47?
RETRIES = 5 # Why 5?Hilfsskripte bereitstellen
Selbst wenn Claude ein Skript schreiben könnte, bieten vorgefertigte Skripte Vorteile:
Vorteile von Hilfsskripten:
- Zuverlässiger als generierter Code
- Sparen Token (Code muss nicht in den Kontext aufgenommen werden)
- Sparen Zeit (keine Codegenerierung erforderlich)
- Stellen Konsistenz über Verwendungen hinweg sicher
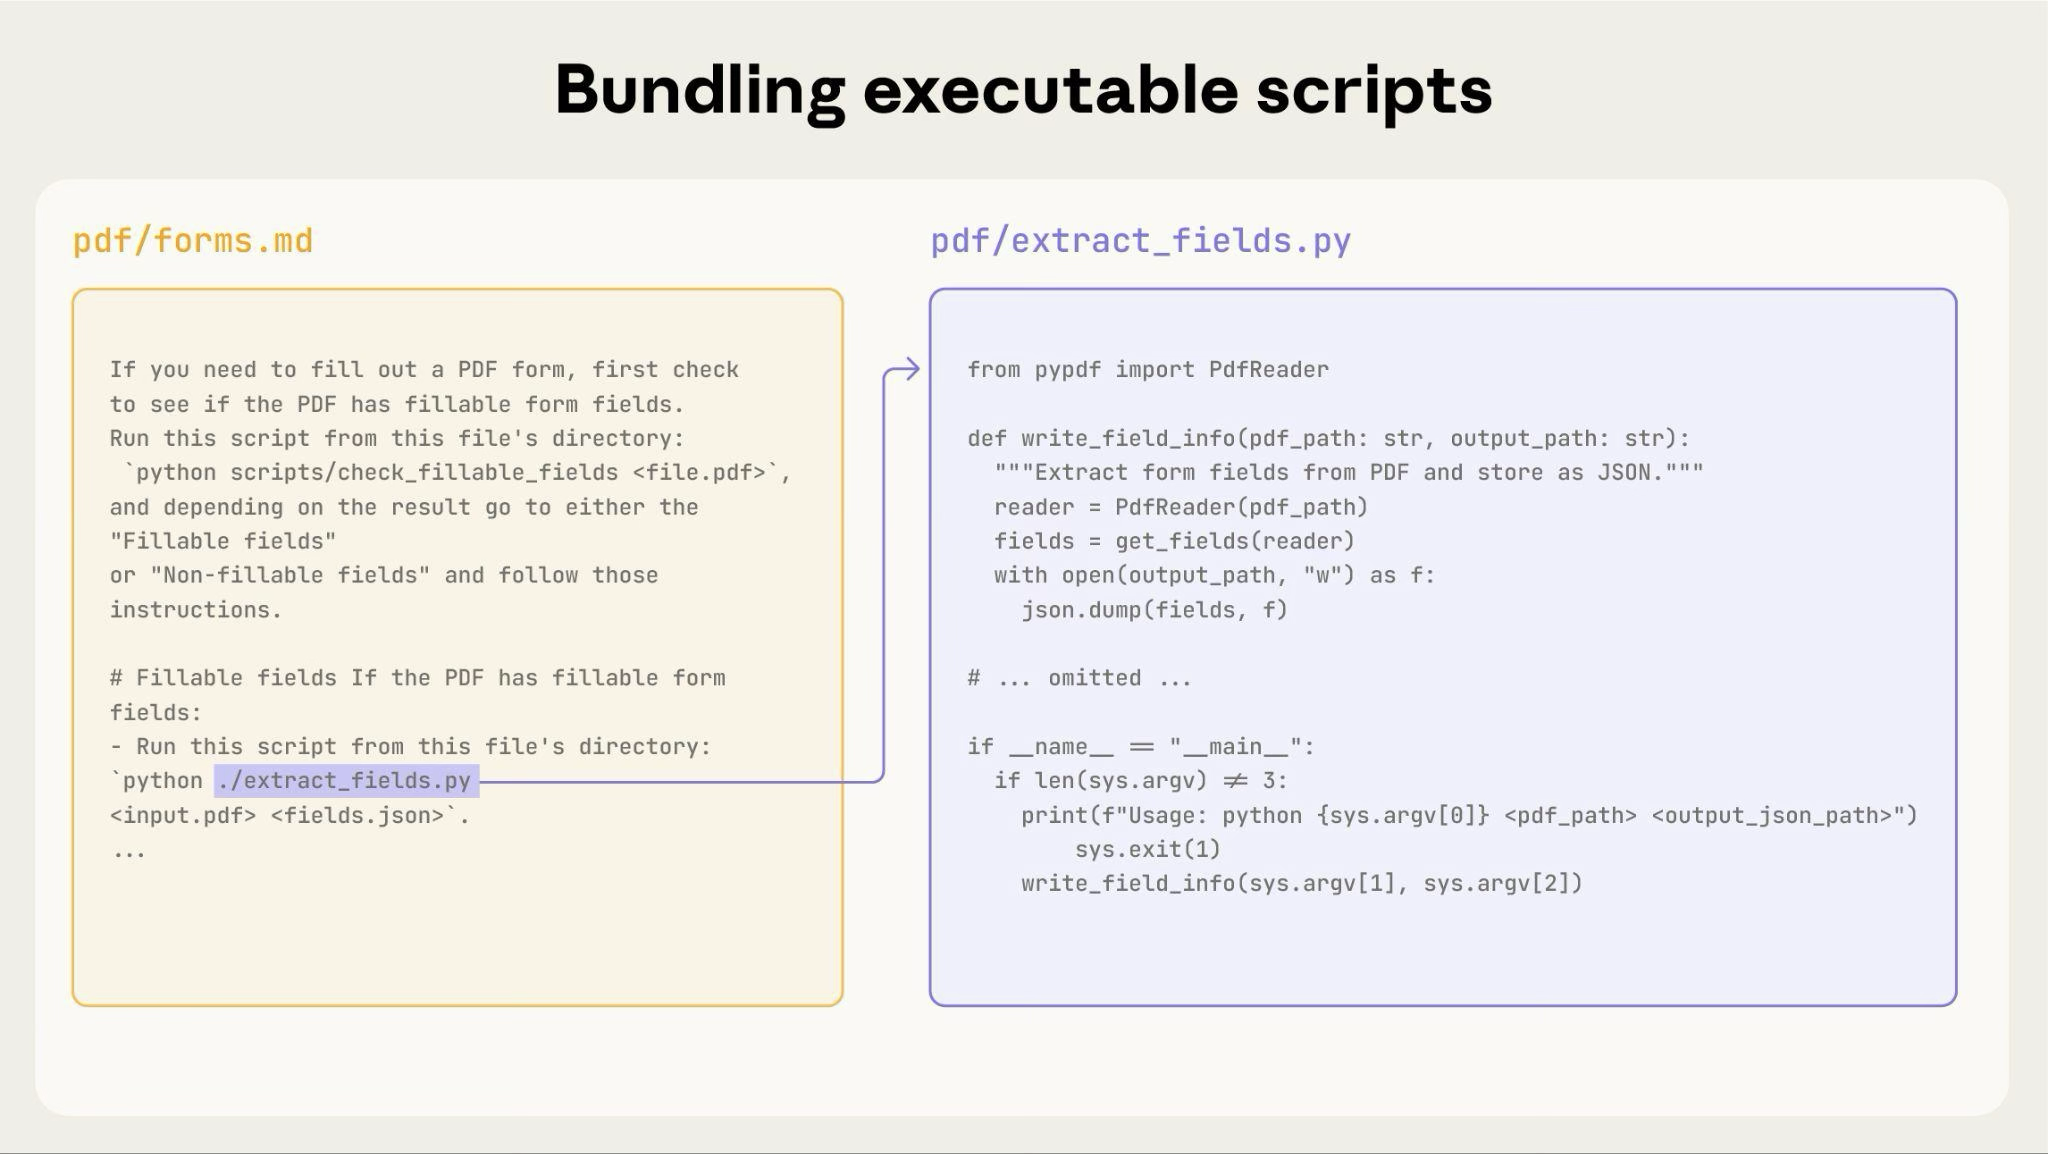
Das vorstehende Diagramm zeigt, wie „executable scripts“ (ausführbare Skripte) neben „instruction files“ (Anweisungsdateien) funktionieren. Die Anweisungsdatei (forms.md) referenziert das Skript, und Claude kann es ausführen, ohne seinen Inhalt in den Kontext zu laden.
Wichtige Unterscheidung: Mache in deinen Anweisungen deutlich, ob Claude:
- Das Skript ausführen soll (am häufigsten): „Führe
analyze_form.pyaus, um Felder zu extrahieren" - Es als Referenz lesen soll (für komplexe Logik): „Siehe
analyze_form.pyfür den Feldextraktionsalgorithmus"
Für die meisten Hilfsskripte ist die Ausführung vorzuziehen, da sie zuverlässiger und effizienter ist. Details zur Funktionsweise der Skriptausführung findest du im folgenden Abschnitt Laufzeitumgebung.
Beispiel:
## Utility scripts

**analyze_form.py**: Extract all form fields from PDF

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

Output format:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**: Check for overlapping bounding boxes

```bash
python scripts/validate_boxes.py fields.json
# Returns: "OK" or lists conflicts
```

**fill_form.py**: Apply field values to PDF

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```Visuelle Analyse verwenden
Wenn Eingaben als Bilder gerendert werden können, lass Claude sie analysieren:
## Form layout analysis

1. Convert PDF to images:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. Analyze each page image to identify form fields
3. Claude can see field locations and types visuallyClaudes Vision-Fähigkeiten helfen bei der Analyse von Layouts und Strukturen.
Überprüfbare Zwischenergebnisse erstellen
Wenn Claude komplexe, offene Aufgaben ausführt, kann es Fehler machen. Das Muster „Planen-Validieren-Ausführen“ fängt Fehler frühzeitig ab, indem Claude zuerst einen Plan in einem strukturierten Format erstellt und diesen Plan dann mit einem Skript validiert, bevor er ausgeführt wird.
Beispiel: Stell dir vor, du bittest Claude, 50 Formularfelder in einem PDF auf Basis einer Tabelle zu aktualisieren. Ohne Validierung könnte Claude nicht existierende Felder referenzieren, widersprüchliche Werte erzeugen, Pflichtfelder übersehen oder Aktualisierungen falsch anwenden.
Lösung: Verwende das zuvor gezeigte Workflow-Muster (Ausfüllen von PDF-Formularen), füge aber eine Zwischendatei changes.json hinzu, die vor dem Anwenden der Änderungen validiert wird. Der Workflow wird zu: analysieren → Plandatei erstellen → Plan validieren → ausführen → verifizieren.
Warum dieses Muster funktioniert:
- Fängt Fehler frühzeitig ab: Die Validierung findet Probleme, bevor Änderungen angewendet werden
- Maschinell überprüfbar: Skripte liefern objektive Verifizierung
- Umkehrbare Planung: Claude kann am Plan iterieren, ohne die Originale anzufassen
- Klares Debugging: Fehlermeldungen weisen auf spezifische Probleme hin
Wann verwenden: Batch-Operationen, destruktive Änderungen, komplexe Validierungsregeln, Operationen mit hohem Risiko.
Implementierungstipp: Gestalte Validierungsskripte ausführlich mit spezifischen Fehlermeldungen wie „Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed“, um Claude beim Beheben von Problemen zu helfen.
Paketabhängigkeiten
Skills laufen in der Codeausführungsumgebung mit plattformspezifischen Einschränkungen:
- claude.ai: Kann Pakete von npm und PyPI installieren und aus GitHub-Repositories pullen
- Claude API: Hat keinen Netzwerkzugriff und keine Paketinstallation zur Laufzeit
Liste erforderliche Pakete in deiner SKILL.md auf und überprüfe in der Dokumentation zum Codeausführungs-Tool, ob sie verfügbar sind.
Laufzeitumgebung
Skills laufen in einer Codeausführungsumgebung mit Dateisystemzugriff, Bash-Befehlen und Codeausführungsfähigkeiten. Die konzeptionelle Erklärung dieser Architektur findest du unter Die Skills-Architektur in der Übersicht.
Wie sich das auf dein Erstellen auswirkt:
Wie Claude auf Skills zugreift:
- Metadaten vorab geladen: Beim Start werden Name und Beschreibung aus dem YAML-Frontmatter aller Skills in den System-Prompt geladen
- Dateien bei Bedarf gelesen: Claude verwendet Bash-Read-Tools, um bei Bedarf auf SKILL.md und andere Dateien im Dateisystem zuzugreifen
- Skripte effizient ausgeführt: Hilfsskripte können über Bash ausgeführt werden, ohne ihren vollständigen Inhalt in den Kontext zu laden. Nur die Ausgabe des Skripts verbraucht Token
- Keine Kontextkosten für große Dateien: Referenzdateien, Daten oder Dokumentation verbrauchen keine Kontext-Token, bis sie tatsächlich gelesen werden
- Dateipfade sind wichtig: Claude navigiert durch dein Skill-Verzeichnis wie durch ein Dateisystem. Verwende Schrägstriche (
reference/guide.md), keine Backslashes - Dateien aussagekräftig benennen: Verwende Namen, die auf den Inhalt hinweisen:
form_validation_rules.md, nichtdoc2.md - Für Auffindbarkeit organisieren: Strukturiere Verzeichnisse nach Domäne oder Feature
- Gut:
reference/finance.md,reference/sales.md - Schlecht:
docs/file1.md,docs/file2.md
- Gut:
- Umfassende Ressourcen bündeln: Nimm vollständige API-Dokumentation, umfangreiche Beispiele, große Datensätze auf; keine Kontextkosten bis zum Zugriff
- Skripte für deterministische Operationen bevorzugen: Schreibe
validate_form.py, anstatt Claude zu bitten, Validierungscode zu generieren - Ausführungsabsicht deutlich machen:
- „Führe
analyze_form.pyaus, um Felder zu extrahieren" (ausführen) - „Siehe
analyze_form.pyfür den Extraktionsalgorithmus" (als Referenz lesen)
- „Führe
- Dateizugriffsmuster testen: Überprüfe durch Tests mit realen Anfragen, dass Claude durch deine Verzeichnisstruktur navigieren kann
Beispiel:
bigquery-skill/SKILL.md(Übersicht, verweist auf Referenzdateien)reference/finance.md(Umsatzkennzahlen)sales.md(Pipeline-Daten)product.md(Nutzungsanalysen)
Wenn der Nutzer nach Umsatz fragt, liest Claude SKILL.md, sieht den Verweis auf reference/finance.md und ruft Bash auf, um nur diese Datei zu lesen. Die Dateien sales.md und product.md verbleiben im Dateisystem und verbrauchen null Kontext-Token, bis sie benötigt werden. Dieses dateisystembasierte Modell ist es, was progressive Offenlegung ermöglicht. Claude kann navigieren und selektiv genau das laden, was jede Aufgabe erfordert.
Vollständige Details zur technischen Architektur findest du unter Wie Skills funktionieren in der Skills-Übersicht.
MCP-Tool-Referenzen
Wenn dein Skill Tools des „Model Context Protocol“, oder MCP, verwendet, verwende immer vollqualifizierte Tool-Namen, um „tool not found“-Fehler zu vermeiden.
Format: ServerName:tool_name
Beispiel:
Use the BigQuery:bigquery_schema tool to retrieve table schemas.
Use the GitHub:create_issue tool to create issues.Dabei gilt:
BigQueryundGitHubsind MCP-Servernamenbigquery_schemaundcreate_issuesind die Tool-Namen innerhalb dieser Server
Ohne das Server-Präfix findet Claude das Tool möglicherweise nicht, insbesondere wenn mehrere MCP-Server verfügbar sind.
Nicht davon ausgehen, dass Tools installiert sind
Gehe nicht davon aus, dass Pakete verfügbar sind:
**Bad example: Assumes installation**:
"Use the pdf library to process the file."

**Good example: Explicit about dependencies**:
"Install required package: `pip install pypdf`

Then use it:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```"Technische Hinweise
Anforderungen an das YAML-Frontmatter
Das SKILL.md-Frontmatter erfordert die Felder name und description mit spezifischen Validierungsregeln:
name: Maximal 64 Zeichen, nur Kleinbuchstaben/Zahlen/Bindestriche, keine XML-Tags, keine reservierten Wörterdescription: Maximal 1.024 Zeichen, nicht leer, keine XML-Tags
Vollständige Strukturdetails findest du in der Skills-Übersicht.
Token-Budgets
Halte den SKILL.md-Body für optimale Leistung unter 500 Zeilen. Wenn dein Inhalt dies überschreitet, teile ihn mithilfe der zuvor beschriebenen Muster für progressive Offenlegung in separate Dateien auf. Architekturdetails findest du in der Skills-Übersicht.
Checkliste für effektive Skills
Überprüfe vor dem Teilen eines Skills:
Kernqualität
- Beschreibung ist spezifisch und enthält Schlüsselbegriffe
- Beschreibung enthält sowohl, was der Skill tut, als auch, wann er verwendet werden soll
- SKILL.md-Body ist unter 500 Zeilen
- Zusätzliche Details befinden sich in separaten Dateien (falls nötig)
- Keine zeitabhängigen Informationen (oder im Abschnitt „alte Muster“)
- Durchgehend konsistente Terminologie
- Beispiele sind konkret, nicht abstrakt
- Dateireferenzen sind eine Ebene tief
- Progressive Offenlegung angemessen eingesetzt
- Workflows haben klare Schritte
Code und Skripte
- Skripte lösen Probleme, anstatt sie an Claude zu delegieren
- Fehlerbehandlung ist explizit und hilfreich
- Keine „Voodoo-Konstanten“ (alle Werte begründet)
- Erforderliche Pakete in den Anweisungen aufgelistet und als verfügbar verifiziert
- Skripte haben klare Dokumentation
- Keine Windows-Pfade (nur Schrägstriche)
- Validierungs-/Verifizierungsschritte für kritische Operationen
- Feedbackschleifen für qualitätskritische Aufgaben enthalten
Testen
- Mindestens drei Evaluierungen erstellt
- Mit Haiku, Sonnet und Opus getestet
- Mit realen Nutzungsszenarien getestet
- Team-Feedback eingearbeitet (falls zutreffend)
Nächste Schritte
Erstelle deinen ersten Skill
Erstelle und verwalte Skills in Claude Code
Lade Skills hoch und verwende sie programmatisch
Was this page helpful?