スキル作成のベストプラクティス
Claudeが発見し、うまく活用できる効果的なスキルの書き方を学びます。
優れたスキルは簡潔で、構造が整っており、実際の使用でテストされています。このガイドでは、Claudeが発見して効果的に使用できるスキルを書くための、実践的な作成上の判断基準を提供します。
スキルの仕組みに関する概念的な背景については、スキルの概要を参照してください。
基本原則
簡潔さが鍵
「context window」(コンテキストウィンドウ)は公共財です。コンテキストウィンドウは、あなたのスキルと、Claudeが知る必要のある他のすべてのものとの間で共有されます。これには以下が含まれます。
- システムプロンプト
- 会話履歴
- 他のスキルのメタデータ
- 実際のリクエスト
スキル内のすべてのトークンに即座にコストがかかるわけではありません。起動時には、すべてのスキルのメタデータ(name と description)のみが事前に読み込まれます。Claudeはスキルが関連するようになったときにのみSKILL.mdを読み、追加のファイルは必要に応じてのみ読みます。しかし、SKILL.mdを簡潔にすることは依然として重要です。Claudeが一度読み込むと、すべてのトークンが会話履歴や他のコンテキストと競合するからです。
デフォルトの前提: Claudeはすでに非常に賢い
Claudeがまだ持っていないコンテキストのみを追加してください。それぞれの情報について問い直してください。
- 「Claudeは本当にこの説明を必要としているか?」
- 「Claudeがこれを知っていると仮定できるか?」
- 「この段落はそのトークンコストに見合うか?」
良い例:簡潔(約50トークン):
## Extract PDF text

Use pdfplumber for text extraction:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```悪い例:冗長すぎる(約150トークン):
## Extract PDF text

PDF (Portable Document Format) files are a common file format that contains
text, images, and other content. To extract text from a PDF, you'll need to
use a library. There are many libraries available for PDF processing, but
pdfplumber is recommended because it's easy to use and handles most cases well.
First, you'll need to install it using pip. Then you can use the code below...簡潔なバージョンは、ClaudeがすでにPDFやライブラリの仕組みについての情報を持っていることを前提としています。
適切な自由度を設定する
具体性のレベルを、タスクの壊れやすさと変動性に合わせてください。
高い自由度(テキストベースの指示):
使用する場面:
- 複数のアプローチが有効である
- 判断がコンテキストに依存する
- ヒューリスティクスがアプローチを導く
例:
## Code review process

1. Analyze the code structure and organization
2. Check for potential bugs or edge cases
3. Suggest improvements for readability and maintainability
4. Verify adherence to project conventions中程度の自由度(疑似コードまたはパラメータ付きスクリプト):
使用する場面:
- 推奨されるパターンが存在する
- ある程度のバリエーションが許容される
- 設定が動作に影響する
例:
## Generate report

Use this template and customize as needed:

```python
def generate_report(data, format="markdown", include_charts=True):
    # Process data
    # Generate output in specified format
    # Optionally include visualizations
```低い自由度(特定のスクリプト、パラメータがほとんどまたはまったくない):
使用する場面:
- 操作が壊れやすくエラーが起きやすい
- 一貫性が極めて重要である
- 特定の順序に従う必要がある
例:
## Database migration

Run exactly this script:

```bash
python scripts/migrate.py --verify --backup
```

Do not modify the command or add additional flags.たとえ: Claudeを道を探索するロボットと考えてください。
- 両側が崖の狭い橋: 安全に進む方法は1つしかありません。具体的なガードレールと正確な指示を提供してください(低い自由度)。例:正確な順序で実行しなければならないデータベースマイグレーション。
- 危険のない開けた野原: 多くの道が成功につながります。大まかな方向を示し、Claudeが最適なルートを見つけることを信頼してください(高い自由度)。例:コンテキストによって最適なアプローチが決まるコードレビュー。
使用予定のすべてのモデルでテストする
スキルはモデルへの追加として機能するため、その効果は基盤となるモデルに依存します。使用予定のすべてのモデルでスキルをテストしてください。
モデル別のテストの考慮事項:
- Claude Haiku(高速、経済的):スキルは十分なガイダンスを提供しているか?
- Claude Sonnet(バランス型):スキルは明確で効率的か?
- Claude Opus(強力な推論):スキルは過剰な説明を避けているか?
Opusで完璧に機能するものでも、Haikuではより詳細が必要になる場合があります。複数のモデルでスキルを使用する予定がある場合は、すべてのモデルでうまく機能する指示を目指してください。
スキルの構造
命名規則
スキルを参照したり議論したりしやすくするために、一貫した命名パターンを使用してください。スキル名には動名詞形(動詞 + -ing)の使用を検討してください。これはスキルが提供する活動や能力を明確に表現します。
name フィールドには小文字、数字、ハイフンのみを使用する必要があることを忘れないでください。
良い命名例(動名詞形):
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
許容される代替案:
- 名詞句:
pdf-processing、spreadsheet-analysis - アクション指向:
process-pdfs、analyze-spreadsheets
避けるべきもの:
- 曖昧な名前:
helper、utils、tools - 一般的すぎる名前:
documents、data、files - 予約語:
anthropic-helper、claude-tools - スキルコレクション内での一貫性のないパターン
一貫した命名により、以下が容易になります。
- ドキュメントや会話でスキルを参照する
- スキルが何をするかを一目で理解する
- 複数のスキルを整理・検索する
- プロフェッショナルでまとまりのあるスキルライブラリを維持する
効果的な説明を書く
description フィールドはスキルの発見を可能にするもので、スキルが何をするかと、いつ使用するかの両方を含めるべきです。
具体的に書き、主要な用語を含めてください。スキルが何をするかと、いつ使用するかの具体的なトリガー/コンテキストの両方を含めてください。
各スキルには説明フィールドが1つだけあります。説明はスキル選択において極めて重要です。Claudeはこれを使用して、100以上になる可能性のある利用可能なスキルの中から適切なスキルを選択します。説明は、Claudeがいつこのスキルを選択すべきかを判断できるだけの十分な詳細を提供する必要があり、SKILL.mdの残りの部分が実装の詳細を提供します。
効果的な例:
PDF処理スキル:
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.Excel分析スキル:
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.Gitコミットヘルパースキル:
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.次のような曖昧な説明は避けてください。
description: Helps with documentsdescription: Processes datadescription: Does stuff with files段階的開示パターン
SKILL.mdは、オンボーディングガイドの目次のように、必要に応じてClaudeを詳細な資料へ導く概要として機能します。「progressive disclosure」(段階的開示)の仕組みの説明については、概要のスキルの仕組みを参照してください。
実践的なガイダンス:
- 最適なパフォーマンスのために、SKILL.md本文を500行未満に保つ
- この制限に近づいたらコンテンツを別ファイルに分割する
- 以下のパターンを使用して、指示、コード、リソースを効果的に整理する
視覚的な概要:シンプルから複雑へ
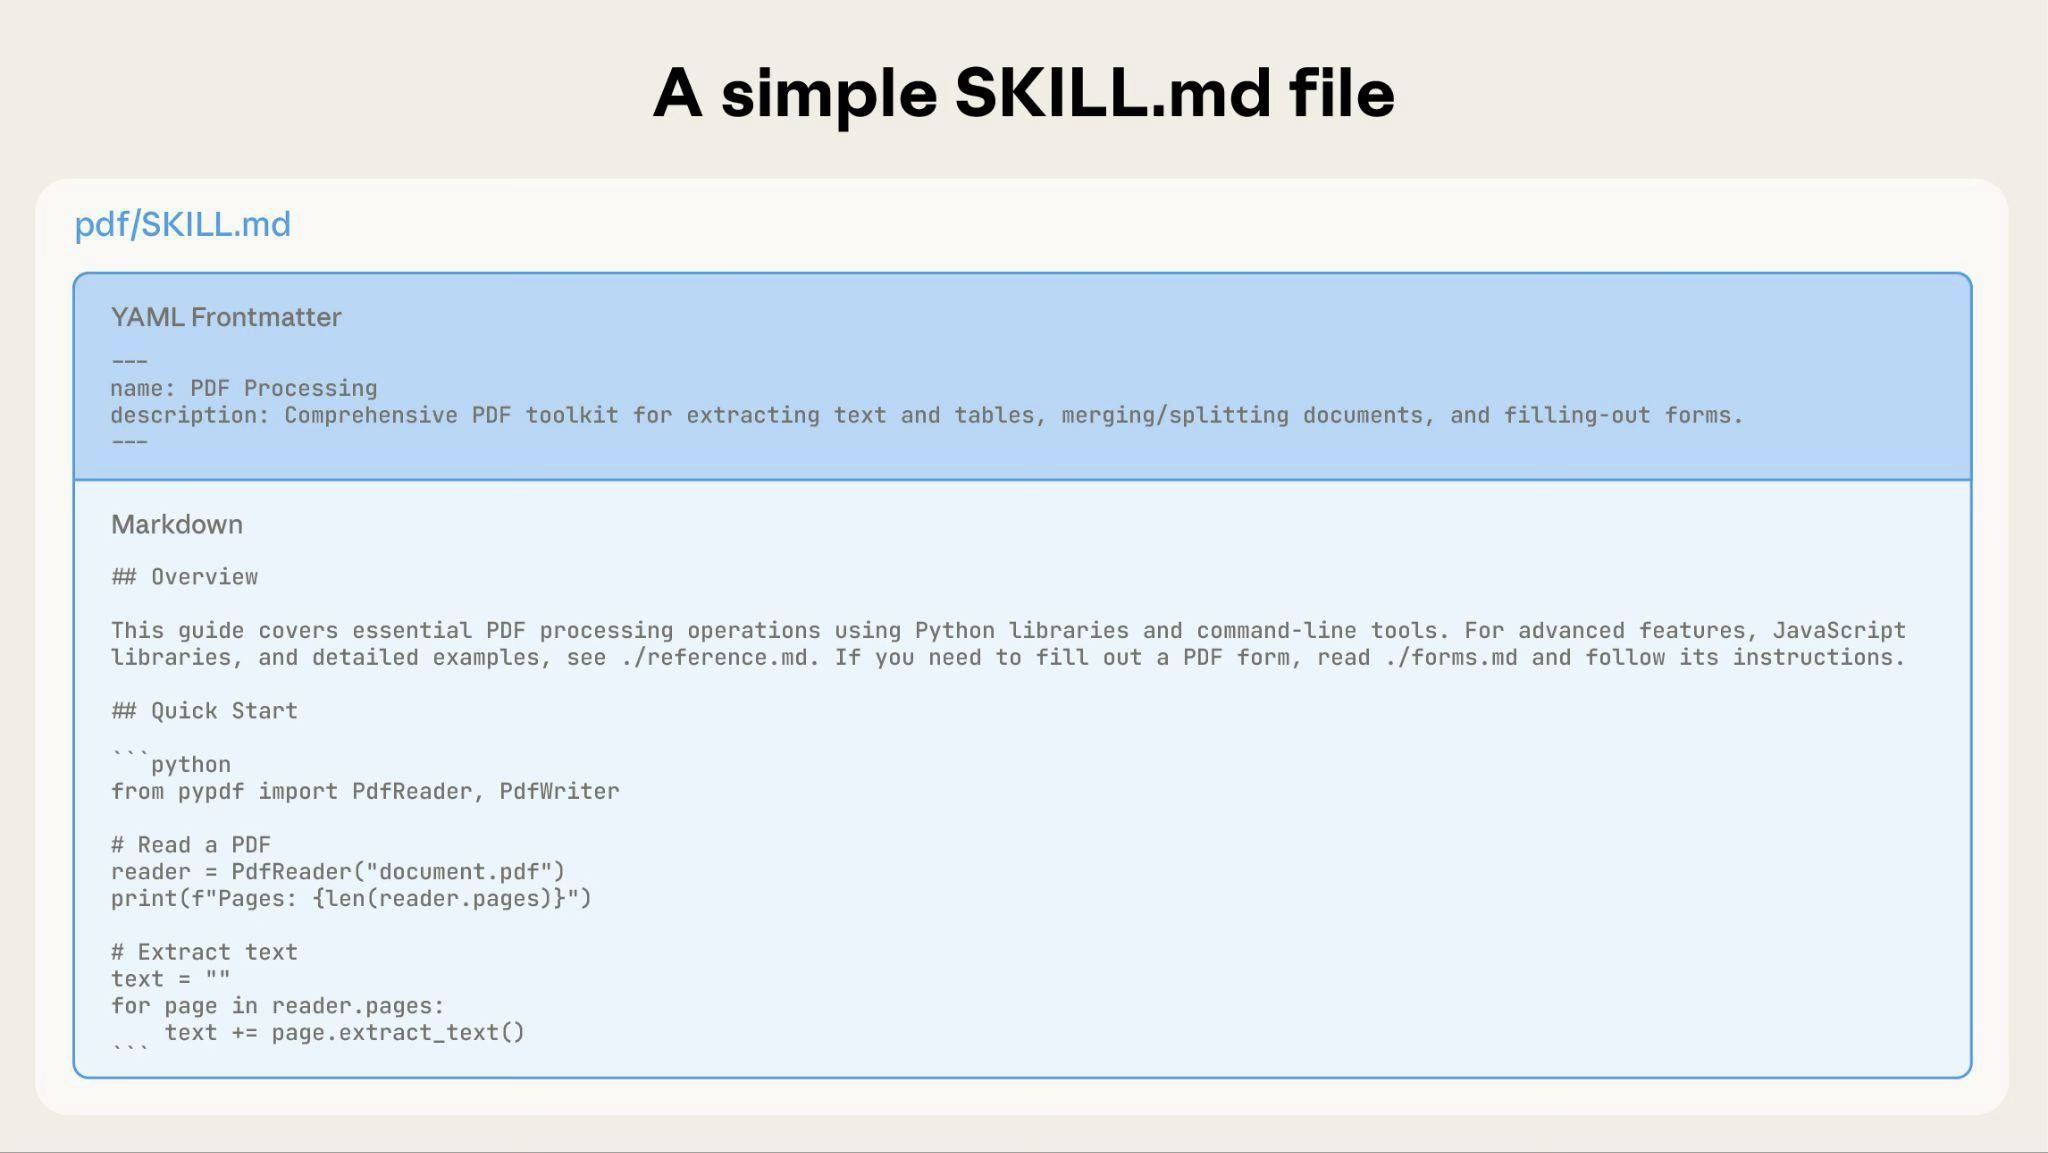
基本的なスキルは、メタデータと指示を含むSKILL.mdファイルだけから始まります。
スキルが成長するにつれて、Claudeが必要なときにのみ読み込む追加コンテンツをバンドルできます。
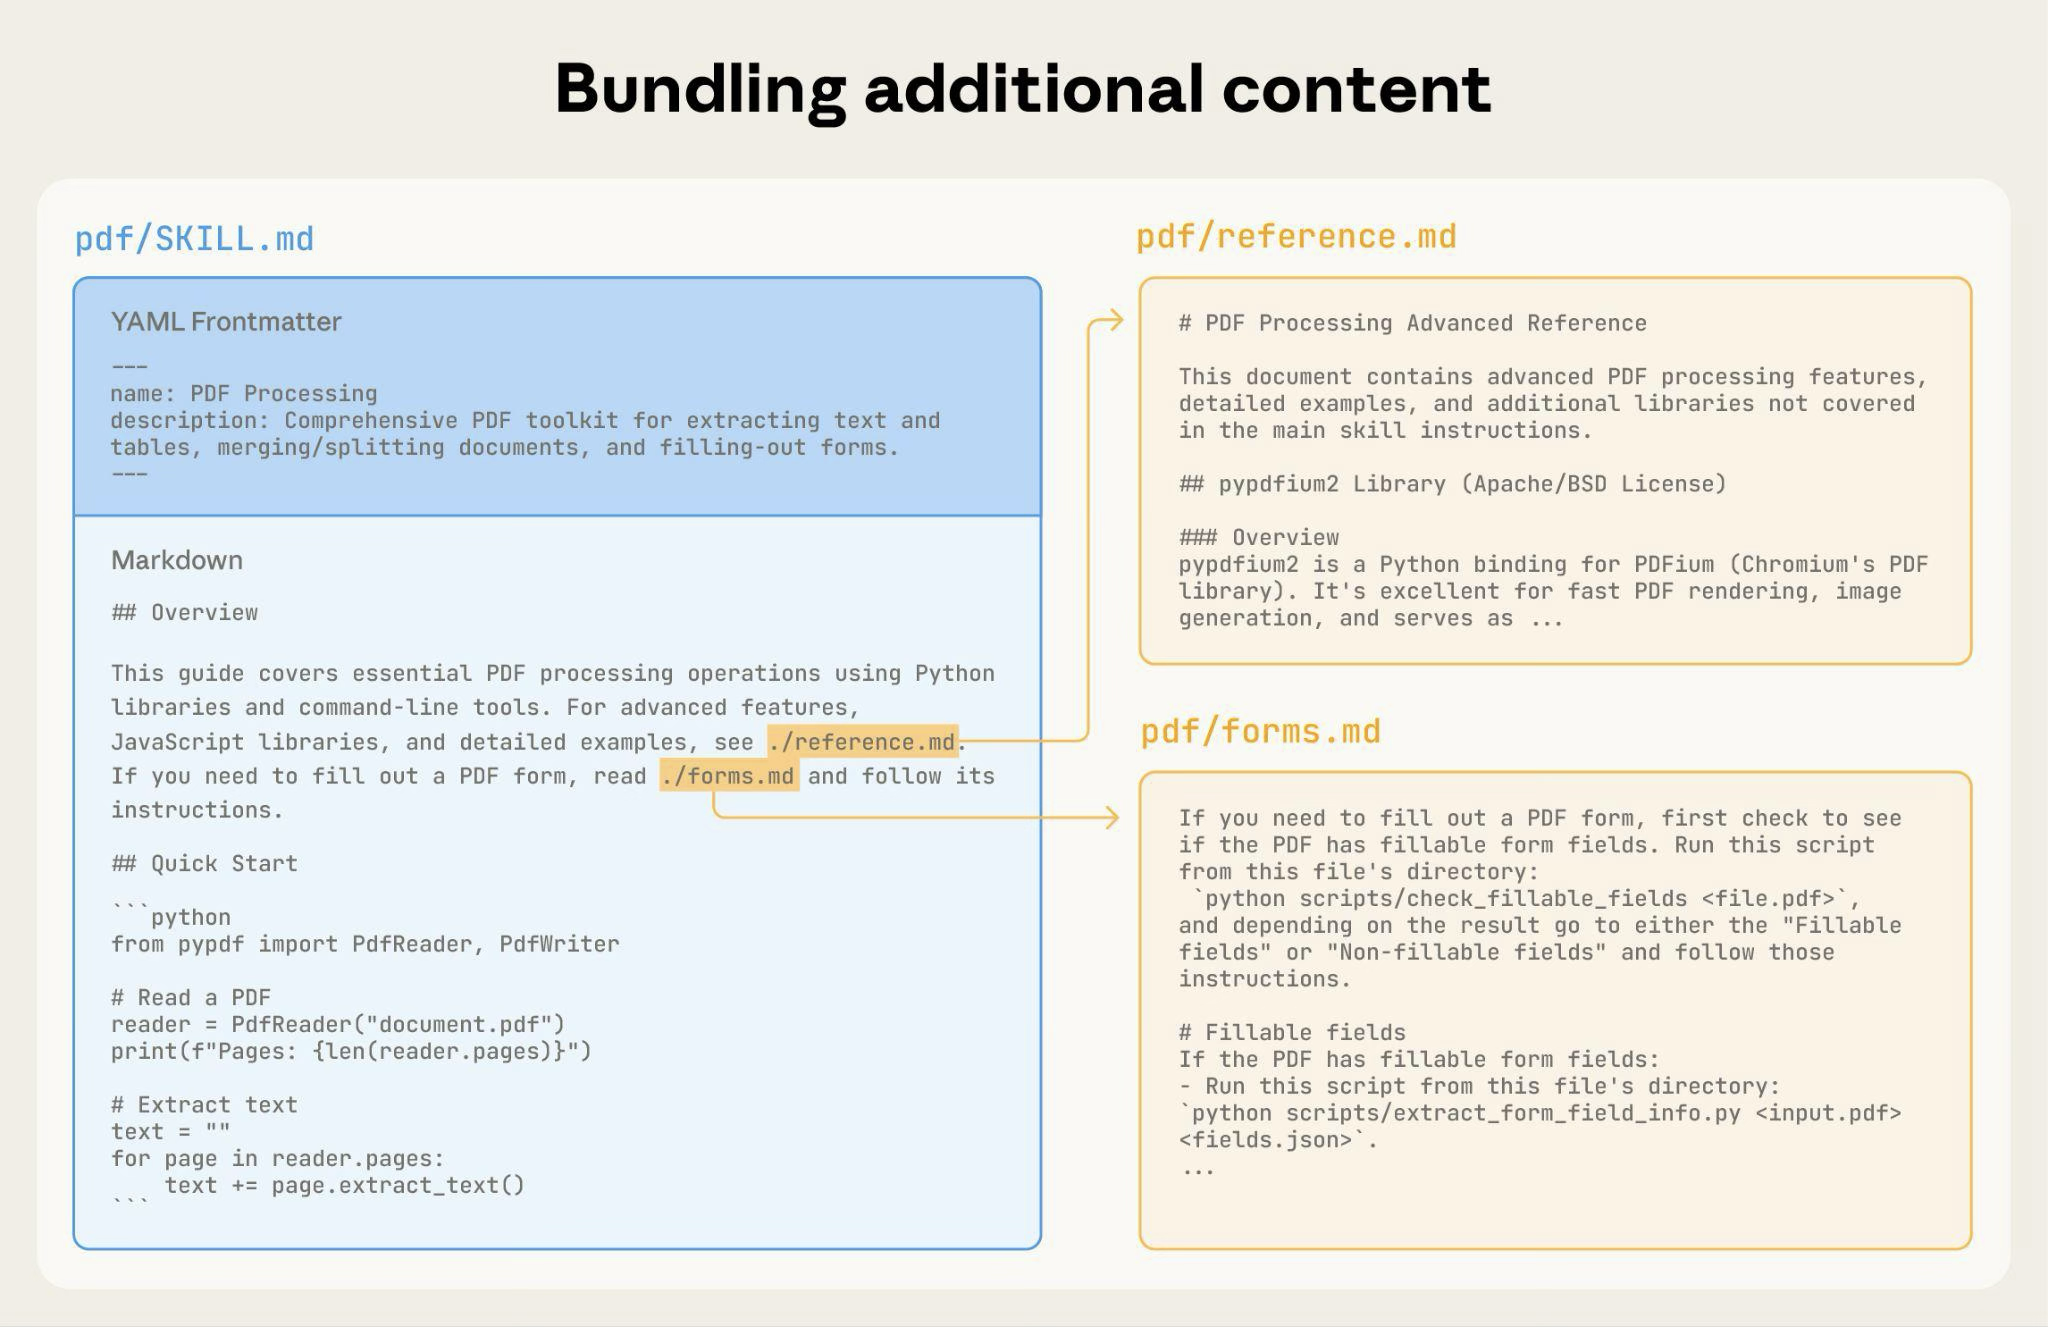
完全なスキルディレクトリ構造は次のようになります。
pdf/SKILL.md:メインの指示(トリガー時に読み込まれる)FORMS.md:フォーム入力ガイド(必要に応じて読み込まれる)reference.md:APIリファレンス(必要に応じて読み込まれる)examples.md:使用例(必要に応じて読み込まれる)scripts/analyze_form.py:ユーティリティスクリプト(実行される、読み込まれない)fill_form.py:フォーム入力スクリプトvalidate.py:検証スクリプト
パターン1:参照付きの高レベルガイド
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
---

# PDF Processing

## Quick start

Extract text with pdfplumber:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## Advanced features

**Form filling**: See [FORMS.md](FORMS.md) for complete guide
**API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
**Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patternsClaudeはFORMS.md、REFERENCE.md、EXAMPLES.mdを必要なときにのみ読み込みます。
パターン2:ドメイン別の整理
複数のドメインを持つスキルでは、無関係なコンテキストの読み込みを避けるために、コンテンツをドメインごとに整理してください。ユーザーが売上指標について尋ねた場合、Claudeは財務やマーケティングのデータではなく、売上関連のスキーマだけを読めば済みます。これによりトークン使用量が低く抑えられ、コンテキストが集中した状態に保たれます。
bigquery-skill/SKILL.md(概要とナビゲーション)reference/finance.md(収益、請求指標)sales.md(商談、パイプライン)product.md(API使用状況、機能)marketing.md(キャンペーン、アトリビューション)
# BigQuery Data Analysis

## Available datasets

**Finance**: Revenue, ARR, billing → See [reference/finance.md](reference/finance.md)
**Sales**: Opportunities, pipeline, accounts → See [reference/sales.md](reference/sales.md)
**Product**: API usage, features, adoption → See [reference/product.md](reference/product.md)
**Marketing**: Campaigns, attribution, email → See [reference/marketing.md](reference/marketing.md)

## Quick search

Find specific metrics using grep:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md
```
パターン3:条件付きの詳細
基本的なコンテンツを表示し、高度なコンテンツにリンクします。
# DOCX Processing

## Creating documents

Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).

## Editing documents

For simple edits, modify the XML directly.

**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)ClaudeはユーザーがそれらのFeatureを必要とするときにのみREDLINING.mdまたはOOXML.mdを読みます。
深くネストされた参照を避ける
他の参照ファイルから参照されているファイルの場合、Claudeはファイルを部分的にしか読まないことがあります。ネストされた参照に遭遇すると、Claudeはファイル全体を読むのではなく head -100 のようなコマンドを使用してコンテンツをプレビューすることがあり、結果として情報が不完全になります。
参照はSKILL.mdから1階層の深さに保ってください。必要なときにClaudeが完全なファイルを読むことを確実にするため、すべての参照ファイルはSKILL.mdから直接リンクすべきです。
悪い例:深すぎる:
# SKILL.md
See [advanced.md](advanced.md)...

# advanced.md
See [details.md](details.md)...

# details.md
Here's the actual information...良い例:1階層の深さ:
# SKILL.md

**Basic usage**: [instructions in SKILL.md]
**Advanced features**: See [advanced.md](advanced.md)
**API reference**: See [reference.md](reference.md)
**Examples**: See [examples.md](examples.md)長い参照ファイルは目次で構造化する
100行を超える参照ファイルには、先頭に目次を含めてください。これにより、部分的な読み取りでプレビューする場合でも、Claudeが利用可能な情報の全範囲を把握できます。
例:
# API Reference

## Contents
- Authentication and setup
- Core methods (create, read, update, delete)
- Advanced features (batch operations, webhooks)
- Error handling patterns
- Code examples

## Authentication and setup
...

## Core methods
...Claudeはその後、必要に応じてファイル全体を読むか、特定のセクションにジャンプできます。
このファイルシステムベースのアーキテクチャがどのように段階的開示を可能にするかの詳細については、このガイド後半のランタイム環境セクションを参照してください。
ワークフローとフィードバックループ
複雑なタスクにはワークフローを使用する
複雑な操作を明確で順序立ったステップに分解してください。特に複雑なワークフローでは、Claudeが応答にコピーして進行に合わせてチェックできるチェックリストを提供してください。
例1:リサーチ統合ワークフロー(コードを含まないスキル向け):
## Research synthesis workflow

Copy this checklist and track your progress:

```
Research Progress:
- [ ] Step 1: Read all source documents
- [ ] Step 2: Identify key themes
- [ ] Step 3: Cross-reference claims
- [ ] Step 4: Create structured summary
- [ ] Step 5: Verify citations
```

**Step 1: Read all source documents**

Review each document in the `sources/` directory. Note the main arguments and supporting evidence.

**Step 2: Identify key themes**

Look for patterns across sources. What themes appear repeatedly? Where do sources agree or disagree?

**Step 3: Cross-reference claims**

For each major claim, verify it appears in the source material. Note which source supports each point.

**Step 4: Create structured summary**

Organize findings by theme. Include:
- Main claim
- Supporting evidence from sources
- Conflicting viewpoints (if any)

**Step 5: Verify citations**

Check that every claim references the correct source document. If citations are incomplete, return to Step 3.この例は、コードを必要としない分析タスクにワークフローがどのように適用されるかを示しています。チェックリストパターンは、あらゆる複雑な複数ステップのプロセスに有効です。
例2:PDFフォーム入力ワークフロー(コードを含むスキル向け):
## PDF form filling workflow

Copy this checklist and check off items as you complete them:

```
Task Progress:
- [ ] Step 1: Analyze the form (run analyze_form.py)
- [ ] Step 2: Create field mapping (edit fields.json)
- [ ] Step 3: Validate mapping (run validate_fields.py)
- [ ] Step 4: Fill the form (run fill_form.py)
- [ ] Step 5: Verify output (run verify_output.py)
```

**Step 1: Analyze the form**

Run: `python scripts/analyze_form.py input.pdf`

This extracts form fields and their locations, saving to `fields.json`.

**Step 2: Create field mapping**

Edit `fields.json` to add values for each field.

**Step 3: Validate mapping**

Run: `python scripts/validate_fields.py fields.json`

Fix any validation errors before continuing.

**Step 4: Fill the form**

Run: `python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: Verify output**

Run: `python scripts/verify_output.py output.pdf`

If verification fails, return to Step 2.明確なステップにより、Claudeが重要な検証をスキップすることを防ぎます。チェックリストは、Claudeとあなたの両方が複数ステップのワークフローの進捗を追跡するのに役立ちます。
フィードバックループを実装する
一般的なパターン: バリデーターを実行 → エラーを修正 → 繰り返す
このパターンは出力品質を大幅に向上させます。
例1:スタイルガイド準拠(コードを含まないスキル向け):
## Content review process

1. Draft your content following the guidelines in STYLE_GUIDE.md
2. Review against the checklist:
   - Check terminology consistency
   - Verify examples follow the standard format
   - Confirm all required sections are present
3. If issues found:
   - Note each issue with specific section reference
   - Revise the content
   - Review the checklist again
4. Only proceed when all requirements are met
5. Finalize and save the documentこれは、スクリプトの代わりに参照ドキュメントを使用した検証ループパターンを示しています。「バリデーター」はSTYLE_GUIDE.mdであり、Claudeは読んで比較することでチェックを実行します。
例2:ドキュメント編集プロセス(コードを含むスキル向け):
## Document editing process

1. Make your edits to `word/document.xml`
2. **Validate immediately**: `python ooxml/scripts/validate.py unpacked_dir/`
3. If validation fails:
   - Review the error message carefully
   - Fix the issues in the XML
   - Run validation again
4. **Only proceed when validation passes**
5. Rebuild: `python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. Test the output document検証ループはエラーを早期に捕捉します。
コンテンツガイドライン
時間に依存する情報を避ける
古くなる情報を含めないでください。
悪い例:時間に依存する(いずれ誤りになる):
If you're doing this before August 2025, use the old API.
After August 2025, use the new API.良い例(「古いパターン」セクションを使用):
## Current method

Use the v2 API endpoint: `api.example.com/v2/messages`

## Old patterns

<details>
<summary>Legacy v1 API (deprecated 2025-08)</summary>

The v1 API used: `api.example.com/v1/messages`

This endpoint is no longer supported.
</details>古いパターンのセクションは、メインコンテンツを乱雑にすることなく歴史的なコンテキストを提供します。
一貫した用語を使用する
1つの用語を選び、スキル全体でそれを使用してください。
良い - 一貫している:
- 常に「API endpoint」
- 常に「field」
- 常に「extract」
悪い - 一貫していない:
- 「API endpoint」「URL」「API route」「path」を混在させる
- 「field」「box」「element」「control」を混在させる
- 「extract」「pull」「get」「retrieve」を混在させる
一貫性はClaudeが指示を解析して従うのに役立ちます。
一般的なパターン
テンプレートパターン
出力形式のテンプレートを提供してください。厳密さのレベルをニーズに合わせてください。
厳密な要件の場合(APIレスポンスやデータ形式など):
## Report structure

ALWAYS use this exact template structure:

```markdown
# [Analysis Title]

## Executive summary
[One-paragraph overview of key findings]

## Key findings
- Finding 1 with supporting data
- Finding 2 with supporting data
- Finding 3 with supporting data

## Recommendations
1. Specific actionable recommendation
2. Specific actionable recommendation
```柔軟なガイダンスの場合(適応が有用な場合):
## Report structure

Here is a sensible default format, but use your best judgment based on the analysis:

```markdown
# [Analysis Title]

## Executive summary
[Overview]

## Key findings
[Adapt sections based on what you discover]

## Recommendations
[Tailor to the specific context]
```

Adjust sections as needed for the specific analysis type.例示パターン
出力品質が例を見ることに依存するスキルでは、通常のプロンプティングと同様に入力/出力のペアを提供してください。
## Commit message format

Generate commit messages following these examples:

**Example 1:**
Input: Added user authentication with JWT tokens
Output:
```
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware
```

**Example 2:**
Input: Fixed bug where dates displayed incorrectly in reports
Output:
```
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation
```

**Example 3:**
Input: Updated dependencies and refactored error handling
Output:
```
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints
```

Follow this style: type(scope): brief description, then detailed explanation.例は、説明だけよりも、望ましいスタイルと詳細レベルをClaudeにより明確に伝えます。
条件付きワークフローパターン
判断ポイントを通じてClaudeを導きます。
## Document modification workflow

1. Determine the modification type:

   **Creating new content?** → Follow "Creation workflow" below
   **Editing existing content?** → Follow "Editing workflow" below

2. Creation workflow:
   - Use docx-js library
   - Build document from scratch
   - Export to .docx format

3. Editing workflow:
   - Unpack existing document
   - Modify XML directly
   - Validate after each change
- Repack when complete評価と反復
まず評価を構築する
広範なドキュメントを書く前に評価を作成してください。 これにより、スキルが想像上の問題を文書化するのではなく、実際の問題を解決することが保証されます。
評価駆動開発:
- ギャップを特定する: スキルなしで代表的なタスクをClaudeに実行させます。具体的な失敗や不足しているコンテキストを記録します
- 評価を作成する: これらのギャップをテストする3つのシナリオを構築します
- ベースラインを確立する: スキルなしでのClaudeのパフォーマンスを測定します
- 最小限の指示を書く: ギャップに対処し評価に合格するのに十分なだけのコンテンツを作成します
- 反復する: 評価を実行し、ベースラインと比較し、改良します
このアプローチにより、決して実現しないかもしれない要件を予測するのではなく、実際の問題を解決していることが保証されます。
評価の構造:
{
  "skills": ["pdf-processing"],
  "query": "Extract all text from this PDF file and save it to output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "Successfully reads the PDF file using an appropriate PDF processing library or command-line tool",
    "Extracts text content from all pages in the document without missing any pages",
    "Saves the extracted text to a file named output.txt in a clear, readable format"
  ]
}Claudeと共にスキルを反復的に開発する
最も効果的なスキル開発プロセスにはClaude自身が関わります。Claudeの1つのインスタンス(「Claude A」)と協力して、他のインスタンス(「Claude B」)が使用するスキルを作成します。Claude Aは指示の設計と改良を支援し、Claude Bは実際のタスクでそれらをテストします。これが機能するのは、Claudeモデルが効果的なエージェント指示の書き方と、エージェントが必要とする情報の両方を理解しているからです。
新しいスキルの作成:
-
スキルなしでタスクを完了する: 通常のプロンプティングを使用してClaude Aと問題に取り組みます。作業中、自然にコンテキストを提供し、好みを説明し、手順に関する知識を共有することになります。繰り返し提供している情報に注目してください。
-
再利用可能なパターンを特定する: タスク完了後、将来の類似タスクに役立つであろう、提供したコンテキストを特定します。
例: BigQuery分析に取り組んだ場合、テーブル名、フィールド定義、フィルタリングルール(「常にテストアカウントを除外する」など)、一般的なクエリパターンを提供したかもしれません。
-
Claude Aにスキルの作成を依頼する: 「今使ったこのBigQuery分析パターンを捉えたスキルを作成してください。テーブルスキーマ、命名規則、テストアカウントのフィルタリングに関するルールを含めてください。」
-
簡潔さをレビューする: Claude Aが不要な説明を追加していないか確認します。次のように依頼します:「勝率の意味についての説明を削除してください。Claudeはすでにそれを知っています。」
-
情報アーキテクチャを改善する: Claude Aにコンテンツをより効果的に整理するよう依頼します。例:「テーブルスキーマが別の参照ファイルになるように整理してください。後でテーブルを追加するかもしれません。」
-
類似タスクでテストする: 関連するユースケースで、Claude B(スキルが読み込まれた新しいインスタンス)と共にスキルを使用します。Claude Bが正しい情報を見つけ、ルールを正しく適用し、タスクをうまく処理するかどうかを観察します。
-
観察に基づいて反復する: Claude Bが苦戦したり何かを見落としたりした場合は、具体的な内容を持ってClaude Aに戻ります:「Claudeがこのスキルを使ったとき、Q4の日付でフィルタリングするのを忘れました。日付フィルタリングパターンに関するセクションを追加すべきでしょうか?」
既存のスキルの反復:
スキルを改善する際も、同じ階層的パターンが続きます。以下を交互に行います。
- Claude Aとの作業(スキルの改良を支援する専門家)
- Claude Bでのテスト(スキルを使用して実際の作業を行うエージェント)
- Claude Bの動作の観察と、得られた洞察のClaude Aへの持ち帰り
-
実際のワークフローでスキルを使用する: Claude B(スキルが読み込まれた状態)に、テストシナリオではなく実際のタスクを与えます
-
Claude Bの動作を観察する: どこで苦戦し、成功し、予期しない選択をするかを記録します
観察例: 「Claude Bに地域別売上レポートを依頼したとき、クエリは書いたものの、スキルにこのルールが記載されているにもかかわらず、テストアカウントを除外するのを忘れました。」
-
改善のためにClaude Aに戻る: 現在のSKILL.mdを共有し、観察したことを説明します。次のように尋ねます:「地域別レポートを依頼したとき、Claude Bがテストアカウントのフィルタリングを忘れたことに気づきました。スキルにはフィルタリングについて記載されていますが、十分に目立っていないのかもしれません。」
-
Claude Aの提案をレビューする: Claude Aは、ルールをより目立たせるための再構成、「always filter」の代わりに「MUST filter」のようなより強い表現の使用、またはワークフローセクションの再構築を提案するかもしれません。
-
変更を適用してテストする: Claude Aの改良でスキルを更新し、類似のリクエストでClaude Bと再度テストします
-
使用状況に基づいて繰り返す: 新しいシナリオに遭遇するたびに、この観察・改良・テストのサイクルを続けます。各反復は、仮定ではなく実際のエージェントの動作に基づいてスキルを改善します。
チームのフィードバックを集める:
- スキルをチームメイトと共有し、彼らの使用状況を観察します
- 次のことを尋ねます:スキルは期待どおりに起動するか?指示は明確か?何が足りないか?
- フィードバックを取り入れて、自分自身の使用パターンにおけるギャップに対処します
このアプローチが機能する理由: Claude Aはエージェントのニーズを理解し、あなたはドメインの専門知識を提供し、Claude Bは実際の使用を通じてギャップを明らかにし、反復的な改良は仮定ではなく観察された動作に基づいてスキルを改善します。
Claudeがスキルをどのようにナビゲートするかを観察する
スキルを反復する際は、Claudeが実際にそれらをどのように使用するかに注意を払ってください。以下に注目してください。
- 予期しない探索経路: Claudeは予想していなかった順序でファイルを読んでいますか?これは、構造が思っていたほど直感的でないことを示しているかもしれません
- 見落とされた関連: Claudeは重要なファイルへの参照をたどれていませんか?リンクをより明示的または目立つようにする必要があるかもしれません
- 特定のセクションへの過度の依存: Claudeが同じファイルを繰り返し読む場合、そのコンテンツをメインのSKILL.mdに含めるべきかどうかを検討してください
- 無視されたコンテンツ: Claudeがバンドルされたファイルに一度もアクセスしない場合、それは不要であるか、メインの指示での示し方が不十分である可能性があります
仮定ではなく、これらの観察に基づいて反復してください。スキルのメタデータ内の「name」と「description」は特に重要です。Claudeは現在のタスクに応じてスキルをトリガーするかどうかを判断する際にこれらを使用します。スキルが何をするか、いつ使用すべきかを明確に記述していることを確認してください。
避けるべきアンチパターン
Windowsスタイルのパスを避ける
Windows上であっても、ファイルパスには常にスラッシュを使用してください。
- ✓ 良い:
scripts/helper.py、reference/guide.md - ✗ 避ける:
scripts\helper.py、reference\guide.md
Unixスタイルのパスはすべてのプラットフォームで機能しますが、WindowsスタイルのパスはUnixシステムでエラーを引き起こします。
選択肢を多く提示しすぎない
必要でない限り、複数のアプローチを提示しないでください。
**Bad example: Too many choices** (confusing):
"You can use pypdf, or pdfplumber, or PyMuPDF, or pdf2image, or..."

**Good example: Provide a default** (with escape hatch):
"Use pdfplumber for text extraction:
```python
import pdfplumber
```

For scanned PDFs requiring OCR, use pdf2image with pytesseract instead."上級:実行可能コードを含むスキル
以下のセクションは、実行可能なスクリプトを含むスキルに焦点を当てています。スキルがマークダウンの指示のみを使用する場合は、効果的なスキルのためのチェックリストに進んでください。
先送りせず、解決する
スキル用のスクリプトを書く際は、Claudeに委ねるのではなく、エラー条件を処理してください。
良い例:エラーを明示的に処理する:
def process_file(path):
    """Process a file, creating it if it doesn't exist."""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # 失敗させる代わりにデフォルトの内容でファイルを作成
        print(f"File {path} not found, creating default")
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # 失敗させる代わりに代替手段を提供
        print(f"Cannot access {path}, using default")
return ""悪い例:Claudeに委ねる:
def process_file(path):
    # 単に失敗させて、Claudeに対処を任せる
return open(path).read()設定パラメータも、「ブードゥー定数」(Ousterhoutの法則)を避けるために、根拠を示し文書化すべきです。あなたが正しい値を知らないなら、Claudeはどうやってそれを判断するのでしょうか?
良い例:自己文書化:
# HTTPリクエストは通常30秒以内に完了します
# 長めのタイムアウトで低速な接続に対応します
REQUEST_TIMEOUT = 30

# 3回のリトライで信頼性と速度のバランスを取ります
# 断続的な障害の多くは2回目のリトライまでに解消します
MAX_RETRIES = 3悪い例:マジックナンバー:
TIMEOUT = 47  # Why 47?
RETRIES = 5 # Why 5?ユーティリティスクリプトを提供する
Claudeがスクリプトを書けるとしても、あらかじめ用意されたスクリプトには利点があります。
ユーティリティスクリプトの利点:
- 生成されたコードよりも信頼性が高い
- トークンを節約できる(コンテキストにコードを含める必要がない)
- 時間を節約できる(コード生成が不要)
- 使用間での一貫性を確保できる
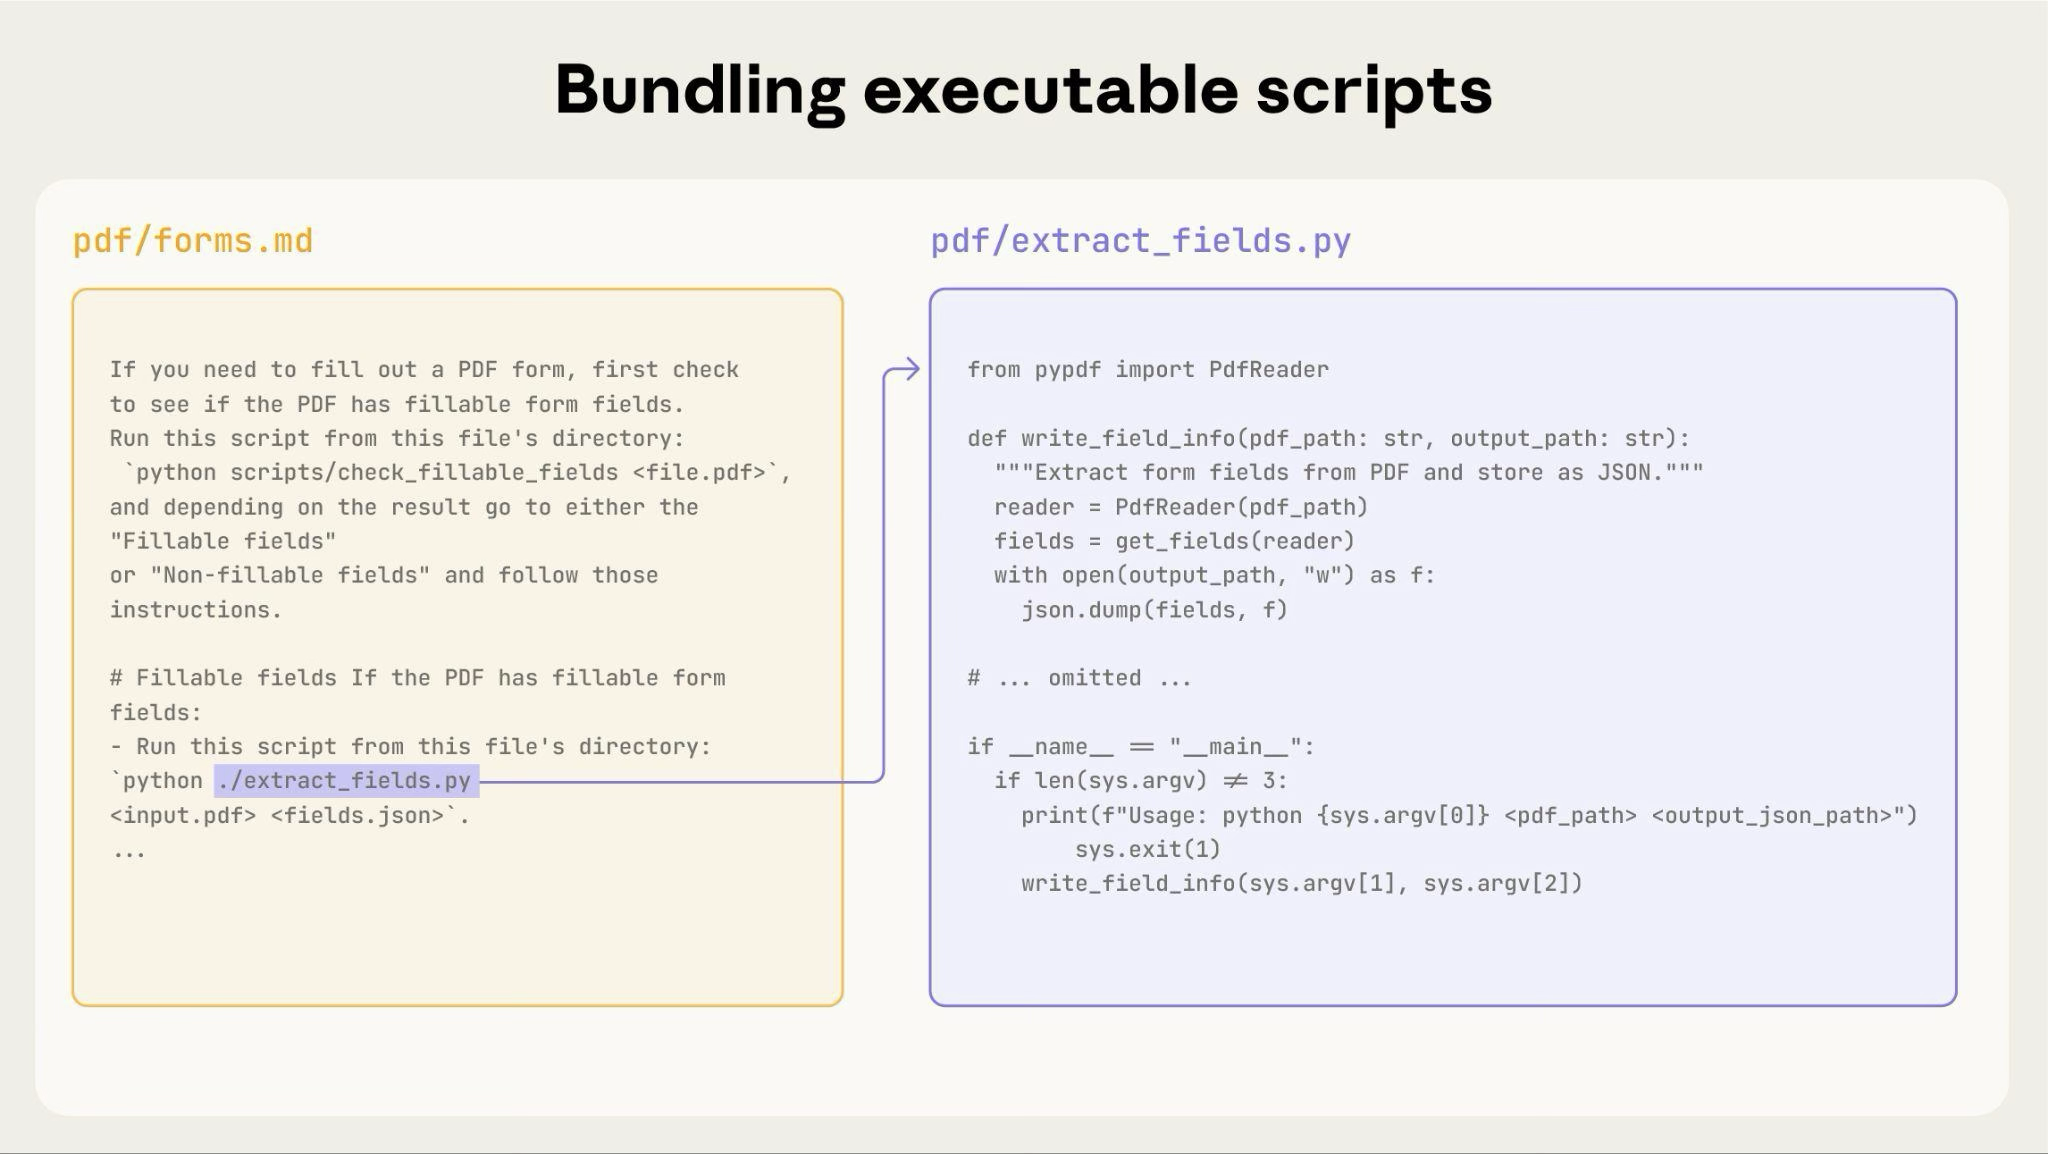
上の図は、実行可能スクリプトが指示ファイルとどのように連携するかを示しています。指示ファイル(forms.md)がスクリプトを参照し、Claudeはその内容をコンテキストに読み込むことなく実行できます。
重要な区別: 指示の中で、Claudeが次のどちらをすべきかを明確にしてください。
- スクリプトを実行する(最も一般的):「
analyze_form.pyを実行してフィールドを抽出する」 - 参照として読む(複雑なロジックの場合):「フィールド抽出アルゴリズムについては
analyze_form.pyを参照」
ほとんどのユーティリティスクリプトでは、より信頼性が高く効率的であるため、実行が推奨されます。スクリプト実行の仕組みの詳細については、後述のランタイム環境セクションを参照してください。
例:
## Utility scripts

**analyze_form.py**: Extract all form fields from PDF

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

Output format:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**: Check for overlapping bounding boxes

```bash
python scripts/validate_boxes.py fields.json
# Returns: "OK" or lists conflicts
```

**fill_form.py**: Apply field values to PDF

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```視覚的分析を使用する
入力を画像としてレンダリングできる場合は、Claudeにそれらを分析させてください。
## Form layout analysis

1. Convert PDF to images:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. Analyze each page image to identify form fields
3. Claude can see field locations and types visuallyClaudeのビジョン機能は、レイアウトや構造の分析に役立ちます。
検証可能な中間出力を作成する
Claudeが複雑でオープンエンドなタスクを実行する際、ミスをすることがあります。「計画・検証・実行」パターンは、Claudeにまず構造化された形式で計画を作成させ、実行前にその計画をスクリプトで検証することで、エラーを早期に捕捉します。
例: スプレッドシートに基づいてPDF内の50個のフォームフィールドを更新するようClaudeに依頼することを想像してください。検証がなければ、Claudeは存在しないフィールドを参照したり、矛盾する値を作成したり、必須フィールドを見落としたり、更新を誤って適用したりするかもしれません。
解決策: 前述のワークフローパターン(PDFフォーム入力)を使用しますが、変更を適用する前に検証される中間ファイル changes.json を追加します。ワークフローは次のようになります:分析 → 計画ファイルを作成 → 計画を検証 → 実行 → 確認。
このパターンが機能する理由:
- エラーを早期に捕捉: 検証により、変更が適用される前に問題が見つかる
- 機械的に検証可能: スクリプトが客観的な検証を提供する
- 可逆的な計画: Claudeはオリジナルに触れることなく計画を反復できる
- 明確なデバッグ: エラーメッセージが具体的な問題を指し示す
使用する場面: バッチ操作、破壊的な変更、複雑な検証ルール、リスクの高い操作。
実装のヒント: Claudeが問題を修正しやすくするために、検証スクリプトは「Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed」のような具体的なエラーメッセージを出す詳細なものにしてください。
パッケージの依存関係
スキルはコード実行環境で実行され、プラットフォーム固有の制限があります。
- claude.ai: npmおよびPyPIからパッケージをインストールでき、GitHubリポジトリからプルできる
- Claude API: ネットワークアクセスがなく、ランタイムでのパッケージインストールもできない
必要なパッケージをSKILL.mdに記載し、コード実行ツールのドキュメントでそれらが利用可能であることを確認してください。
ランタイム環境
スキルは、ファイルシステムアクセス、bashコマンド、コード実行機能を備えたコード実行環境で実行されます。このアーキテクチャの概念的な説明については、概要のスキルのアーキテクチャを参照してください。
これが作成にどう影響するか:
Claudeがスキルにアクセスする方法:
- メタデータの事前読み込み: 起動時に、すべてのスキルのYAMLフロントマターからnameとdescriptionがシステムプロンプトに読み込まれます
- ファイルのオンデマンド読み取り: Claudeは必要に応じてbashのReadツールを使用して、ファイルシステムからSKILL.mdやその他のファイルにアクセスします
- スクリプトの効率的な実行: ユーティリティスクリプトは、その全内容をコンテキストに読み込むことなくbash経由で実行できます。スクリプトの出力のみがトークンを消費します
- 大きなファイルに対するコンテキストのペナルティなし: 参照ファイル、データ、ドキュメントは、実際に読まれるまでコンテキストトークンを消費しません
- ファイルパスが重要: Claudeはスキルディレクトリをファイルシステムのようにナビゲートします。バックスラッシュではなくスラッシュ(
reference/guide.md)を使用してください - ファイルに説明的な名前を付ける: 内容を示す名前を使用してください:
doc2.mdではなくform_validation_rules.md - 発見しやすいように整理する: ディレクトリをドメインまたは機能ごとに構造化してください
- 良い:
reference/finance.md、reference/sales.md - 悪い:
docs/file1.md、docs/file2.md
- 良い:
- 包括的なリソースをバンドルする: 完全なAPIドキュメント、豊富な例、大規模なデータセットを含めてください。アクセスされるまでコンテキストのペナルティはありません
- 決定論的な操作にはスクリプトを優先する: Claudeに検証コードを生成させるのではなく、
validate_form.pyを書いてください - 実行の意図を明確にする:
- 「
analyze_form.pyを実行してフィールドを抽出する」(実行) - 「抽出アルゴリズムについては
analyze_form.pyを参照」(参照として読む)
- 「
- ファイルアクセスパターンをテストする: 実際のリクエストでテストして、Claudeがディレクトリ構造をナビゲートできることを確認してください
例:
bigquery-skill/SKILL.md(概要、参照ファイルを指し示す)reference/finance.md(収益指標)sales.md(パイプラインデータ)product.md(使用状況分析)
ユーザーが収益について尋ねると、ClaudeはSKILL.mdを読み、reference/finance.md への参照を見て、bashを呼び出してそのファイルだけを読みます。sales.mdとproduct.mdのファイルはファイルシステム上に残り、必要になるまでコンテキストトークンを一切消費しません。このファイルシステムベースのモデルこそが段階的開示を可能にするものです。Claudeは各タスクが必要とするものを正確にナビゲートし、選択的に読み込むことができます。
技術的アーキテクチャの完全な詳細については、スキルの概要のスキルの仕組みを参照してください。
MCPツールの参照
スキルが「Model Context Protocol」、すなわちMCPのツールを使用する場合は、「tool not found」エラーを避けるために、常に完全修飾ツール名を使用してください。
形式: ServerName:tool_name
例:
Use the BigQuery:bigquery_schema tool to retrieve table schemas.
Use the GitHub:create_issue tool to create issues.ここで:
BigQueryとGitHubはMCPサーバー名ですbigquery_schemaとcreate_issueはそれらのサーバー内のツール名です
サーバーのプレフィックスがないと、特に複数のMCPサーバーが利用可能な場合、Claudeがツールを見つけられない可能性があります。
ツールがインストールされていると仮定しない
パッケージが利用可能であると仮定しないでください。
**Bad example: Assumes installation**:
"Use the pdf library to process the file."

**Good example: Explicit about dependencies**:
"Install required package: `pip install pypdf`

Then use it:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```"技術的な注意事項
YAMLフロントマターの要件
SKILL.mdのフロントマターには、特定の検証ルールを持つ name と description フィールドが必要です。
name:最大64文字、小文字/数字/ハイフンのみ、XMLタグなし、予約語なしdescription:最大1,024文字、空でないこと、XMLタグなし
構造の完全な詳細については、スキルの概要を参照してください。
トークン予算
最適なパフォーマンスのために、SKILL.md本文を500行未満に保ってください。コンテンツがこれを超える場合は、前述の段階的開示パターンを使用して別ファイルに分割してください。アーキテクチャの詳細については、スキルの概要を参照してください。
効果的なスキルのためのチェックリスト
スキルを共有する前に、以下を確認してください。
コア品質
- 説明が具体的で主要な用語を含んでいる
- 説明にスキルが何をするかといつ使用するかの両方が含まれている
- SKILL.md本文が500行未満である
- 追加の詳細が別ファイルにある(必要な場合)
- 時間に依存する情報がない(または「古いパターン」セクションにある)
- 全体で用語が一貫している
- 例が抽象的ではなく具体的である
- ファイル参照が1階層の深さである
- 段階的開示が適切に使用されている
- ワークフローに明確なステップがある
コードとスクリプト
- スクリプトがClaudeに委ねるのではなく問題を解決している
- エラー処理が明示的で役に立つ
- 「ブードゥー定数」がない(すべての値に根拠がある)
- 必要なパッケージが指示に記載され、利用可能であることが確認されている
- スクリプトに明確なドキュメントがある
- Windowsスタイルのパスがない(すべてスラッシュ)
- 重要な操作に検証/確認ステップがある
- 品質が重要なタスクにフィードバックループが含まれている
テスト
- 少なくとも3つの評価が作成されている
- Haiku、Sonnet、Opusでテスト済み
- 実際の使用シナリオでテスト済み
- チームのフィードバックが取り入れられている(該当する場合)
次のステップ
最初のスキルを作成する
Claude Codeでスキルを作成・管理する
プログラムでスキルをアップロードして使用する
Was this page helpful?