Pensamento preservado
O pensamento preservado permite que um modelo use um bloco de pensamento de um turno anterior somente se esse modelo ou um anterior o tiver produzido e nada antes do bloco tiver mudado.
O "preserved thinking" (pensamento preservado) é uma propriedade dos modelos Claude mais recentes que protege contra "distillation" (destilação). Ele decide se o modelo pode usar um "thinking block" (bloco de pensamento) que você envia de volta de um turno anterior. A partir do Claude Fable 5.1, quando um bloco thinking ou redacted_thinking volta em uma requisição, a API verifica duas coisas na signature do bloco:
- O modelo é o que produziu o bloco, ou um mais recente. Um modelo lê seus próprios blocos de pensamento e os de modelos anteriores. O Claude Fable 5.1 lê blocos do Claude Opus 5, mas o Claude Opus 5 não consegue ler blocos do Claude Fable 5.1. Se o modelo atual não consegue ler um bloco, a API o descarta dessa requisição sem erro. Consulte Trocar de modelo no meio da conversa.
- Nada antes do bloco de pensamento mudou. O prompt do sistema de nível superior (
system), astoolse asmessagesantes do bloco formam o seu "prefix" (prefixo). Se o prefixo for diferente do que você enviou quando o bloco foi produzido, esse bloco e todos os blocos de pensamento posteriores são inválidos, e a API rejeita a requisição com um erro 400 ou descarta os blocos inválidos, conforme a sua escolha. Consulte Manter o prefixo inalterado.
A verificação de modelo se aplica a todas as contas. A API aplica a verificação de prefixo por padrão para contas criadas em ou após 31 de agosto de 2026, 00:00 UTC. Em contas mais antigas, ela aplica a verificação de prefixo somente em requisições que definem thinking.block_binding.prefix_mismatch_behavior. Modelos futuros aplicarão a verificação de prefixo para todas as contas, então torne sua integração "append-only" (somente acréscimo) agora.
Quem precisa mudar alguma coisa
Nada muda para você se o Claude Code, o claude.ai, o Claude Managed Agents ou o Claude Agent SDK montam suas requisições, ou se o seu código mantém system e tools fixos durante uma sessão e apenas acrescenta itens a messages. O Claude Mythos 5.1 e os modelos anteriores ao Claude Fable 5.1 não executam a verificação de prefixo. Se você nunca envia blocos de pensamento de volta, a verificação de prefixo não tem nada a rejeitar, e o modelo não recebe nada do seu raciocínio anterior.
Verifique sua integração se, entre duas requisições de uma mesma conversa, ela fizer qualquer uma das ações a seguir. Cada item leva ao que fazer em vez disso:
- Reconstrói o prompt
system: a data, uma flag de modo, instruções de projeto relidas, ou um plugin ou servidor MCP que se conecta após o primeiro turno - Renderiza novamente o contexto na primeira mensagem do usuário
- Limpa ou encurta resultados de ferramentas antigos, ou recodifica imagens antigas
- Resume ou descarta turnos antigos no cliente e mantém os turnos recentes com seu pensamento
- Adiciona, remove ou edita entradas em
tools - Adiciona um lembrete a um turno do usuário e depois o remove ou reescreve
- Descarta alguns blocos
thinkinge mantém os posteriores, ou os remove e depois os coloca de volta - Reconstrói uma sessão salva a partir de templates em vez de reproduzir o que enviou
Em uma conta mais antiga, nenhuma dessas ações produz erro, a menos que a requisição defina prefix_mismatch_behavior, então uma execução sem erros com a sua própria chave não mostra se o seu código é afetado. Se pessoas executam sua ferramenta com suas próprias chaves de API, aquelas com contas mais novas recebem o erro 400 antes de você. Defina prefix_mismatch_behavior nos seus testes para ver o que elas veem.
Trocar de modelo no meio da conversa
O Claude Fable 5.1 e o Claude Mythos 5.1 leem blocos de pensamento produzidos um pelo outro e por modelos Claude anteriores. Nenhum modelo anterior lê blocos de pensamento do Claude Fable 5.1 ou do Claude Mythos 5.1.
- Uma conversa que sobe para o Claude Fable 5.1 mantém seu raciocínio. Os blocos de pensamento do modelo anterior continuam legíveis, então o modelo pensa normalmente desde o primeiro turno após a troca.
- Uma conversa que desce para um modelo anterior perde o raciocínio do Claude Fable 5.1 nessa requisição. Isso acontece quando um roteador envia um turno para um modelo mais barato, após um fallback por recusa do classificador, ou durante um fallback no lado do servidor. A API remove os blocos ilegíveis antes que o prompt chegue ao modelo. Eles não são cobrados e não contam para
input_tokens.
Continue enviando o histórico completo em toda requisição, incluindo os blocos de pensamento, e deixe a API descartar o que o modelo atual não consegue ler. A API nunca edita o seu array messages, então os blocos descartados permanecem no seu histórico. Quando o mesmo histórico volta para o Claude Fable 5.1, seus blocos ficam legíveis novamente, junto com o pensamento do modelo anterior. O raciocínio só se perde definitivamente se o seu cliente remover os blocos por conta própria, por exemplo, um harness que remove o pensamento em uma troca de modelo ou reconstrói o histórico a partir do que cada modelo usou.
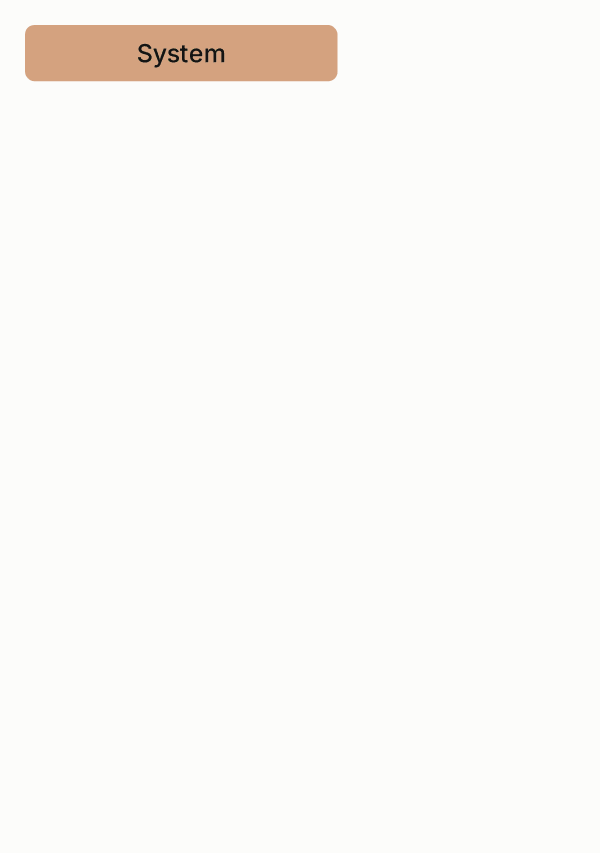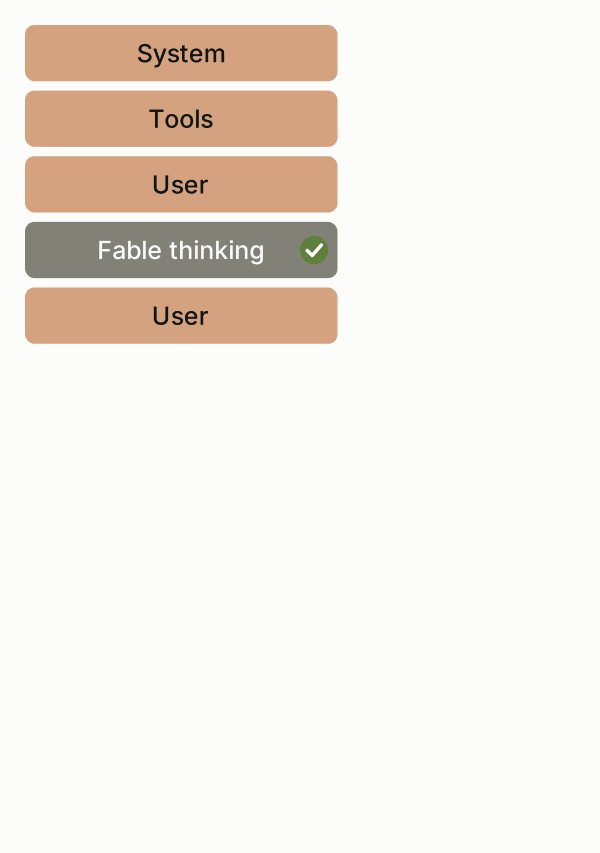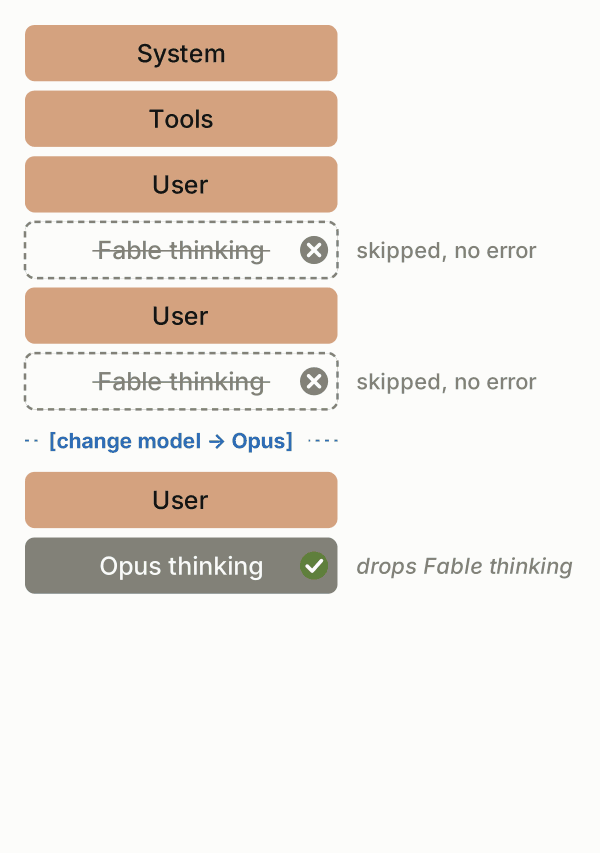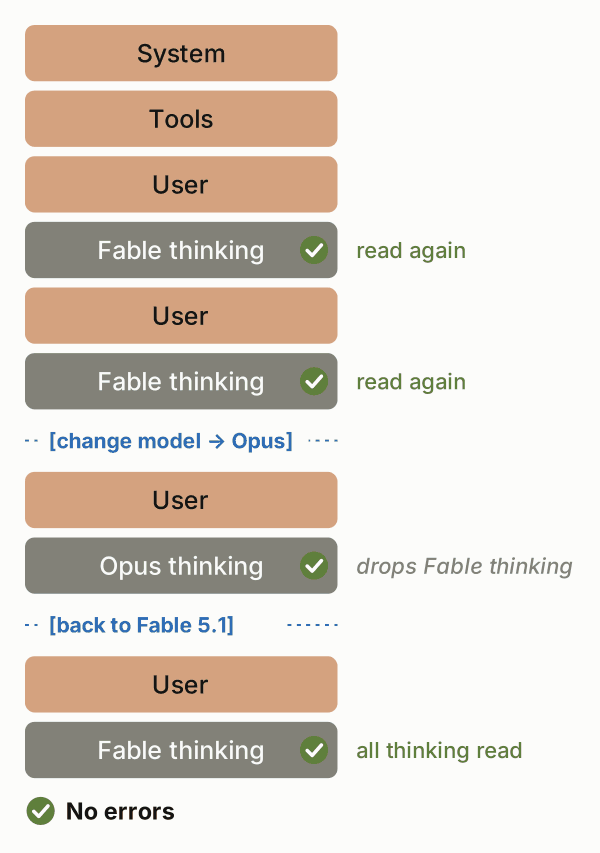
Com o cabeçalho beta thinking-binding-controls-2026-08-01, a resposta lista cada bloco descartado em um array input_transformations de nível superior com reason: "model_binding_mismatch":
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.3.content.0",
      "reason": "model_binding_mismatch"
    }
  ]
}Sem o cabeçalho, o descarte é silencioso. Essa entrada não é um bug na sua integração, e prefix_mismatch_behavior não tem efeito sobre ela: um bloco que o modelo atual não consegue ler é sempre descartado.
Manter o prefixo inalterado
No Claude Fable 5.1, um bloco de pensamento permanece válido somente enquanto tudo o que você enviou antes dele permanecer inalterado nas requisições posteriores. O prefixo verificado tem três partes:
- O prompt do sistema de nível superior (
system) - O conjunto de
tools - Cada
messageantes do bloco
Observação: com a compactação no lado do servidor, o prefixo verificado começa no bloco de compactação mais recente.
Parâmetros da requisição fora desses três campos, como effort, max_tokens, output_config, tool_choice e metadata, não fazem parte da verificação de prefixo, e os marcadores cache_control também não. O que conta como edição traz a lista completa.
Blocos de pensamento anteriores não estão no prefixo, mas cada bloco de pensamento registra qual bloco de pensamento veio antes dele, entre turnos. Você pode remover blocos de pensamento do início do histórico (os mais antigos primeiro), do final, ou todos eles. O que falha é uma lacuna: os blocos de pensamento que você mantém devem ser uma sequência ininterrupta da sequência original, então remover um do meio invalida os blocos de pensamento posteriores a ele. Depois de remover um bloco, deixe-o de fora. Colocá-lo de volta invalida os blocos de pensamento produzidos enquanto ele estava ausente.
Mantenha system e tools fixos durante a sessão e trate messages como somente acréscimo. A mesma disciplina mantém o prefixo estável para o cache de prompt: as edições que invalidam o pensamento são as mesmas que reiniciam o cache.
O que a API faz com um bloco inválido
Você escolhe com thinking.block_binding.prefix_mismatch_behavior:
"error"(o padrão): a API rejeita a requisição com um 400invalid_request_errorque nomeia o primeiro bloco com falha."drop_block": a API descarta cada bloco com falha e todos os blocos de pensamento posteriores a ele, e a requisição é bem-sucedida. Blocos descartados não são cobrados. O modelo responde a esse turno sem usar o raciocínio dos blocos descartados, e o cache de prompt reinicia no ponto da edição. A resposta lista cada bloco descartado eminput_transformations(no eventomessage_startao usar streaming) comreason: "prefix_binding_mismatch".
"drop_block" mantém as requisições funcionando, mas não corrige a edição. Conte as respostas em cada sessão cujo input_transformations tenha uma entrada prefix_binding_mismatch e crie alertas para elas. Na Message Batches API, um item que deixa o campo sem definir descarta os blocos com falha em vez de gerar erro, então defina "error" explicitamente ali se quiser que os itens do lote falhem.
Tanto o campo quanto o array input_transformations exigem o cabeçalho beta thinking-binding-controls-2026-08-01. Definir o comportamento de incompatibilidade e ler input_transformations mostra a requisição em cada SDK.
A mensagem do 400 começa assim:
messages.1.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block".Se a requisição não enviou o cabeçalho beta, a mensagem continua:
That setting requires the `thinking-binding-controls-2026-08-01` value in the `anthropic-beta` header.Ela geralmente termina com uma frase que nomeia o que mudou, por exemplo, que o prompt system ou a lista tools difere de quando o bloco foi criado. Solução de problemas de pensamento descreve o que essa frase pode nomear.
Uma assinatura adulterada ou impossível de descriptografar é uma falha diferente. Ela sempre retorna um 400 (Invalid `signature` in `thinking` block sem nenhuma frase sobre a conversa), e prefix_mismatch_behavior não se aplica a ela.
Tratar o erro no código
Este é o 400 invalid_request_error mostrado anteriormente nesta seção. Não reenvie o mesmo corpo: ele falha da mesma forma todas as vezes. Tente novamente uma vez com o cabeçalho beta e prefix_mismatch_behavior: "drop_block", e armazene essa escolha com a sessão para que todas as requisições posteriores também a enviem, inclusive após uma reinicialização. Se você não puder enviar o cabeçalho beta, remova todos os blocos thinking e redacted_thinking do histórico uma vez, deixe-os de fora e continue. Depois, corrija a edição que causou a incompatibilidade.
Definir o comportamento de incompatibilidade e ler input_transformations
O cabeçalho beta thinking-binding-controls-2026-08-01 adiciona:
- Um array
input_transformationsde nível superior em toda resposta - Um objeto
block_bindingna configuraçãothinking, cujo único campo éprefix_mismatch_behavior
block_binding é aceito junto com thinking.type: "adaptive" e thinking.type: "enabled". Enviá-lo sem o cabeçalho beta retorna um erro 400 cuja mensagem termina com block_binding: Extra inputs are not permitted. Modelos que não executam a verificação de prefixo aceitam o objeto e relatam apenas descartes da verificação de modelo, então um mesmo corpo de requisição funciona entre modelos. A referência da API chama a verificação de prefixo de verificação de conversa.
A requisição a seguir opta por descartar em vez de rejeitar. Em um primeiro turno não há nada a reproduzir, então input_transformations volta vazio:
client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    thinking={
        "type": "adaptive",
        "block_binding": {"prefix_mismatch_behavior": "drop_block"},
    },
    messages=[
        {
            "role": "user",
            "content": "What is the greatest common divisor of 1071 and 462?",
        }
    ],
    betas=["thinking-binding-controls-2026-08-01"],
)

for block in response.content:
    if block.type == "text":
        print(block.text)

print(f"Input transformations: {len(response.input_transformations or [])}")The greatest common divisor of 1071 and 462 is 21.
Input transformations: 0Com o cabeçalho beta, toda resposta de um modelo com capacidade de pensamento traz input_transformations. Ele fica vazio quando nada foi descartado. Cada entrada tem type: "thinking_dropped", o path do bloco descartado (por exemplo, messages.1.content.0) e um reason igual a prefix_binding_mismatch ou model_binding_mismatch (consulte Trocar de modelo no meio da conversa). Ignore entradas cujo type ou reason você não reconheça, porque verificações futuras adicionam valores.
Ao usar streaming, o array chega no objeto message do evento message_start. Após um fallback no lado do servidor no meio do stream, o evento message_delta final o traz novamente com as entradas do modelo que está atendendo. Em um lote de mensagens, um item cujo bloco falha na verificação de prefixo com "error" explícito é resolvido como errored, e um item que deixa o campo sem definir descarta os blocos com falha. O endpoint de contagem de tokens executa a mesma verificação de prefixo e retorna o mesmo 400.
Quando a API aplica a verificação
A verificação de prefixo é executada no Claude Fable 5.1 para contas novas.
- Contas criadas em ou após 31 de agosto de 2026, 00:00 UTC: a API verifica as requisições ao Claude Fable 5.1 e aplica
"error", a menos que você defina"drop_block". A mesma definição de conta nova se aplica à Claude API e às plataformas de nuvem. - Contas mais antigas: a API verifica as requisições que definem
prefix_mismatch_behavior. Esse parâmetro inclui a requisição na verificação, então você pode ver o que uma conta nova vê sem precisar criar uma. - Modelos futuros: todas as contas, em todas as requisições.
Para descobrir em qual grupo sua conta está, pegue uma conversa do Claude Fable 5.1 que contenha um bloco de pensamento, altere algo antes desse bloco e envie-a ao Claude Fable 5.1 sem o cabeçalho beta nem o campo block_binding. Uma resposta 400 que nomeia o cabeçalho significa que a verificação é aplicada por padrão na sua conta.
O que conta como edição
Cada linha compara duas requisições consecutivas:
| Mudança entre requisições | Blocos de pensamento posteriores |
|---|---|
| Acrescentar mensagens no final | Válidos |
Adicionar uma ferramenta com defer_loading: true que nada referenciou ainda | Válidos |
Remover blocos thinking do início do histórico, do final, ou todos eles | Válidos (o modelo perde esse raciocínio) |
Alterar qualquer parâmetro da requisição fora de system, tools e messages (effort, max_tokens, output_config, tool_choice, metadata, thinking.display e assim por diante) | Válidos |
Adicionar, mover ou remover marcadores cache_control | Válidos |
| Uma URL assinada rotativa que retorna os mesmos bytes | Válidos |
| A compactação ou a edição de contexto no lado do servidor remove ou substitui conteúdo | Válidos (a verificação compara o que você enviou, não a cópia editada pelo servidor) |
| Uma mensagem do sistema com escopo de turno já limpa, mantida no lugar | Válidos |
Editar, reordenar ou excluir qualquer mensagem user, assistant ou system anterior | Inválidos, exceto quando o bloco assinado da compactação sob demanda substitui as mensagens que ele resume, nas condições descritas em Compactação com preservação da cauda |
| Renderizar novamente, com um valor alterado, o contexto que você colocou na primeira mensagem do usuário | Inválidos para todos os blocos de pensamento |
Limpar ou encurtar um tool_result anterior, recodificar uma imagem anterior ou alterar a entrada de um tool_use anterior | Inválidos para todos os blocos de pensamento posteriores |
| Adicionar um bloco de texto a um turno do usuário anterior, ou remover um que você adicionou da última vez | Inválidos |
Alterar a string ou os blocos do system de nível superior | Inválidos |
Adicionar, remover, renomear ou editar uma ferramenta em tools | Inválidos |
Remover um bloco thinking do meio do histórico e manter os posteriores | Inválidos para todos os blocos de pensamento posteriores |
Colocar de volta um bloco thinking que você removeu em uma requisição anterior | Inválidos para os blocos de pensamento produzidos enquanto ele estava ausente |
| Uma URL de imagem ou documento que retorna bytes diferentes na próxima requisição | Inválidos |
| A mesma mensagem com escopo de turno excluída ou reescrita em uma requisição posterior | Inválidos |
Verificar se o seu código edita o prefixo
Primeiro, compare o que você envia. Capture os corpos das requisições que sua integração envia ao longo de alguns turnos normais, incluindo uma compactação ou uma mudança de ferramenta. Para cada par de requisições consecutivas, compare system, tools e as messages que elas compartilham. Elas devem ser idênticas até os turnos recém-acrescentados.
Depois, confirme com a API. Adicione o cabeçalho beta thinking-binding-controls-2026-08-01, defina prefix_mismatch_behavior como "drop_block" e execute uma sessão normal de vários turnos pela sua integração no . O exemplo a seguir executa dois turnos da forma como sua integração deveria: messages apenas cresce, cada turno do assistente volta exatamente como a API o retornou, incluindo os blocos thinking, e block_binding é definido em toda requisição. Após cada turno, ele imprime o número de blocos thinking na resposta e o número de blocos descartados:
client = anthropic.Anthropic()

user_turns = [
    "How many positive integers below 500 have exactly 6 positive divisors?",
    "How many of those are odd?",
]

# messages cresce a cada turno: cada turno do assistente é reenviado exatamente como foi retornado
messages = []
for user_turn in user_turns:
    messages.append({"role": "user", "content": user_turn})
    response = client.beta.messages.create(
        model="claude-fable-5-1",
        max_tokens=16000,
        thinking={
            "type": "adaptive",
            "block_binding": {"prefix_mismatch_behavior": "drop_block"},
        },
        messages=messages,
        betas=["thinking-binding-controls-2026-08-01"],
    )
    messages.append({"role": "assistant", "content": response.content})
    thinking_blocks = sum(block.type == "thinking" for block in response.content)
    dropped = len(response.input_transformations or [])
print(f"thinking blocks: {thinking_blocks}, dropped: {dropped}")thinking blocks: 1, dropped: 0
thinking blocks: 1, dropped: 0Nenhum dos turnos descarta um bloco, porque nada anterior mudou. Verifique se a primeira resposta contém um bloco thinking. Com o pensamento adaptativo, algumas respostas não têm nenhum. Se nenhuma resposta da sessão tiver um, não há nada a verificar e a contagem de descartes é 0 independentemente do que você alterar, então execute o exemplo novamente.
Registre input_transformations em todos os turnos da sua própria integração. Quando a API descarta um bloco, a entrada tem a seguinte aparência:
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.1.content.0",
      "reason": "prefix_binding_mismatch"
    }
  ]
}- Vazio em todos os turnos de uma sessão que contém blocos
thinking: sua integração mantém o prefixo intacto. reason: "prefix_binding_mismatch": algo antes do bloco empathmudou desde a requisição anterior. Comparesystem,toolsemessagesaté esse turno para encontrá-lo, ou reenvie a requisição com"error": o 400 geralmente termina com uma frase que nomeia o que mudou. Depois, encontre a substituição correspondente em Fazer mudanças sem editar o prefixo.reason: "model_binding_mismatch": a conversa passou para um modelo que não consegue ler os blocos do modelo anterior. Isso não é uma edição de prefixo. Consulte Trocar de modelo no meio da conversa.
Para ver uma falha de propósito, envie um terceiro turno a partir do exemplo anterior e adicione um prompt system somente a essa requisição, de modo que ela seja diferente das duas primeiras requisições, que não tinham nenhum. Com "drop_block", a contagem de descartes deixa de ser 0: a resposta tem uma entrada para cada bloco de pensamento no histórico, cada uma com reason: "prefix_binding_mismatch". Com "error", a requisição retorna o 400 descrito em O que a API faz com um bloco inválido, e sua última frase nomeia o prompt system. Nas abas cURL e CLI, remova o filtro jq para ver o corpo do erro. Se a contagem ainda for 0, não havia nada a verificar: confirme que o modelo é o , que a requisição define block_binding, que o histórico enviado contém blocos thinking e que as duas primeiras requisições não tinham prompt system.
Dois turnos simples raramente mostram o problema. Execute uma sessão passando por cada um dos itens a seguir, com "error" definido para que uma regressão faça seu CI falhar:
- A primeira compactação ou corte no lado do cliente
- Uma ferramenta, plugin ou servidor MCP que se conecta após o primeiro turno
- Uma mudança de modo ou de instrução
- Um loop longo de ferramentas, se você adiciona lembretes ou encurta resultados de ferramentas antigos
- Uma troca para outro modelo e de volta
- Um salvamento, uma reinicialização e uma retomada em uma data posterior
Fazer mudanças sem editar o prefixo
Cada edição de prefixo comum tem uma substituição que fornece ao modelo a mesma informação e deixa os bytes anteriores inalterados, para que o pensamento posterior permaneça válido. Encontre na primeira coluna a edição que o seu código faz hoje:
| Em vez de | Use | Cabeçalho beta |
|---|---|---|
Reconstruir o prompt do sistema de nível superior (system) | Uma mensagem do sistema no meio da conversa | Nenhum |
| Renderizar novamente o contexto na sua primeira mensagem do usuário (ambiente, data, memória, instruções de projeto) a cada requisição | Renderize-o uma vez e reenvie-o inalterado. Quando algo mudar, coloque a nova versão no turno mais recente | Nenhum |
Limpar ou encurtar conteúdo de tool_result antigo, ou recodificar imagens antigas, no próprio lugar | Encurte um resultado de ferramenta ou reduza uma imagem antes da primeira vez que você a enviar, não depois. Para limpar resultados antigos mais tarde, corte o contexto no servidor com clear_tool_uses_20250919 | context-management-2025-06-27 |
| Injetar um lembrete e excluí-lo na próxima requisição | Uma mensagem do sistema com escopo de turno (clear_at: "next_user_message") | mid-conversation-system-clear-at-2026-08-21 |
Adicionar ou remover entradas em tools | Blocos tool_addition e tool_removal | mid-conversation-tool-changes-2026-07-01 |
Alterar output_config.effort de nível superior (reinicia o cache, não afeta o pensamento) | Um output_config por mensagem | mid-conversation-output-config-2026-07-01 |
| Descartar ou resumir turnos antigos no cliente | Compactação sob demanda para manter os turnos recentes com seu pensamento, outra compactação ou edição de contexto no lado do servidor, ou compactação no lado do cliente que não mantém pensamento obsoleto | compact-2026-09-04 (não disponível no Amazon Bedrock nem no Google Cloud) |
| Uma URL de imagem ou documento cujos bytes mudam entre requisições | Um file_id da Files API, ou base64 | Nenhum |
Todas essas opções pressupõem que você envia os turnos do assistente de volta exatamente como foram retornados. Mensagens do sistema no meio da conversa, mensagens do sistema com escopo de turno e mudanças de ferramentas não estão disponíveis em todos os modelos: Mensagens do sistema e mudanças de ferramentas no meio da conversa lista os modelos que as aceitam. Se o seu código atende vários modelos, continue editando o prompt do sistema de nível superior (system) para os modelos que não as aceitam.
Para usar vários betas em uma requisição, combine os valores em um único cabeçalho anthropic-beta. Os nomes dos betas são os mesmos no Amazon Bedrock e no Google Cloud onde quer que o beta esteja disponível (consulte Cabeçalhos beta):
anthropic-beta: thinking-binding-controls-2026-08-01,mid-conversation-system-clear-at-2026-08-21,mid-conversation-tool-changes-2026-07-01Enviar os turnos do assistente de volta exatamente como foram retornados
Armazene o array content de cada resposta e envie-o de volta inalterado como o turno do assistente: todos os tipos de bloco, na ordem recebida, incluindo blocos thinking cujo campo thinking está vazio. Um serializador que descarta tipos de bloco desconhecidos, descarta campos vazios ou reordena blocos edita o prefixo para todos os turnos posteriores.
No Claude Fable 5.1, o campo thinking fica vazio por padrão e a signature carrega o raciocínio, então um serializador que ignora blocos vazios remove o pensamento. Se ele remover todos, nada falha e o modelo perde seu raciocínio anterior em todos os turnos. Se você mesmo faz o parsing do stream, mantenha o bloco mesmo quando nenhum texto de pensamento chegar: ele abre, recebe sua signature em um evento signature_delta e fecha. Um bloco enviado de volta com uma signature vazia falha.
Adicionar instruções com uma mensagem do sistema no meio da conversa
Alguns harnesses reconstroem o prompt do sistema de nível superior (system) a cada requisição para incluir a hora atual, um orçamento de tokens, uma flag de modo ou contexto de projeto recém-descoberto. Isso invalida todos os blocos de pensamento da conversa. Em vez disso, congele system no início da sessão. Quando algo mudar, acrescente uma mensagem role: "system" no ponto de messages em que a mudança passa a valer:
{
  "role": "system",
  "content": "The user switched the workspace to read-only mode. Do not write files until told otherwise."
}O modelo trata essa mensagem com autoridade de prompt do sistema, e tudo antes dela permanece inalterado. Em um loop de ferramentas, coloque a mensagem após a mensagem do usuário com o tool_result, nunca entre um tool_use do assistente e seu tool_result (consulte Limitações). Depois de enviada, a mensagem faz parte do prefixo para o pensamento posterior: mantenha-a no lugar nas requisições posteriores.
Colocar o contexto que muda no turno mais recente
Alguns harnesses colocam um bloco de ambiente na primeira mensagem do usuário (diretório de trabalho, branch, data, memória, instruções de projeto) e o renderizam novamente a cada requisição. Quando qualquer valor muda, messages[0] muda, e todos os blocos de pensamento da conversa ficam inválidos. Renderize esse bloco uma vez e reenvie-o como estava. Quando um valor mudar, informe isso no turno mais recente: adicione um bloco de texto à mensagem do usuário que você está prestes a enviar, ou acrescente uma mensagem do sistema no meio da conversa se a mudança vier de você como operador.
{
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "Environment update: the current branch is now release-2."
    },
    { "type": "text", "text": "Run the tests again." }
  ]
}Depois de enviado, esse bloco de texto faz parte do prefixo para o pensamento posterior: mantenha-o no lugar nas requisições posteriores.
Envie lembretes por turno como mensagens de sistema com escopo de turno
Uma edição de prefixo comum é o lembrete por turno: uma linha como "solicite leituras independentes em conjunto" ou "você não atualiza o usuário há algum tempo" que o seu código acrescenta após cada lote de resultados de ferramentas. Para evitar que os lembretes se acumulem, envie cada lembrete como uma mensagem do sistema no meio da conversa com clear_at: "next_user_message", colocada após a mensagem do usuário com o tool_result. clear_at exige o cabeçalho beta mid-conversation-system-clear-at-2026-08-21. O array messages a seguir é a requisição após duas chamadas de ferramenta e seus resultados. messages[3] é o lembrete da requisição anterior, mantido no lugar, e messages[6] é a cópia desta requisição:
[
  { "role": "user", "content": "Fix the failing test." },
  {
    "role": "assistant",
    "content": [
      { "type": "thinking", "thinking": "", "signature": "..." },
      {
        "type": "tool_use",
        "id": "toolu_01",
        "name": "read_file",
        "input": { "path": "tests/test_auth.py" }
      }
    ]
  },
  {
    "role": "user",
    "content": [{ "type": "tool_result", "tool_use_id": "toolu_01", "content": "..." }]
  },
  {
    "role": "system",
    "clear_at": "next_user_message",
    "content": "Request every independent read in one turn."
  },
  {
    "role": "assistant",
    "content": [
      { "type": "thinking", "thinking": "", "signature": "..." },
      {
        "type": "tool_use",
        "id": "toolu_02",
        "name": "read_file",
        "input": { "path": "src/auth.py" }
      }
    ]
  },
  {
    "role": "user",
    "content": [{ "type": "tool_result", "tool_use_id": "toolu_02", "content": "..." }]
  },
  {
    "role": "system",
    "clear_at": "next_user_message",
    "content": "Request every independent read in one turn."
  }
]Uma mensagem do usuário que contém apenas blocos tool_result conta como a "próxima mensagem do usuário", então messages[3] já está limpa. Ela não acrescenta nada ao que o modelo vê e não custa tokens de entrada, mas, como ainda está no array, o pensamento em messages[4] permanece válido. messages[6] é a cópia que o modelo vê neste turno. Nas requisições posteriores, mantenha ambas onde estão e acrescente uma nova cópia após a próxima mensagem com tool_result.
Adicionar ou remover ferramentas com tool_addition e tool_removal
Editar o array tools no meio da sessão invalida os blocos de pensamento preservados. Em vez disso, declare em tools, na primeira requisição, todas as ferramentas de que a sessão possa precisar e nunca altere o array. Para mudar quais ferramentas o modelo pode usar a partir de certo ponto, acrescente uma mensagem role: "system" que carrega um bloco tool_removal ou tool_addition. Essas são mudanças de ferramentas no meio da conversa e precisam do cabeçalho beta mid-conversation-tool-changes-2026-07-01. Por exemplo, para retirar uma ferramenta perigosa após uma troca de modo:
{
  "role": "system",
  "content": [
    { "type": "tool_removal", "tool": { "type": "tool_reference", "name": "delete_branch" } },
    { "type": "text", "text": "Branch deletion is disabled for the rest of this session." }
  ]
}Para oferecer uma ferramenta mais tarde, declare-a em tools com defer_loading: true para que o modelo não a veja no início. Quando ela ficar disponível, acrescente um bloco tool_addition:
{
  "role": "system",
  "content": [
    { "type": "tool_addition", "tool": { "type": "tool_reference", "name": "deploy" } },
    { "type": "text", "text": "Authentication succeeded. Deployment is now available." }
  ]
}Às vezes você não consegue declarar uma ferramenta de antemão porque ainda não conhece seu schema. Um servidor MCP descoberto em tempo de execução é o caso comum. Acrescente essa ferramenta a tools com defer_loading: true e depois ofereça-a com um bloco tool_addition. Adicionar uma ferramenta adiada é seguro: a verificação de prefixo ignora uma ferramenta adiada até que um bloco tool_addition a referencie, então o pensamento anterior permanece válido. Adicionar uma ferramenta sem defer_loading: true altera o prefixo e invalida o pensamento anterior.
As mensagens role: "system" que carregam esses blocos passam a fazer parte do prefixo para o pensamento posterior. Mantenha-as no lugar nas requisições posteriores.
Alterar o esforço com um output_config por mensagem
Alterar output_config.effort de nível superior entre requisições não invalida o pensamento, porque o esforço não faz parte do prefixo. Mas alterar o esforço de nível superior reinicia o cache de prompt. No Claude Fable 5.1, use o esforço por mensagem em vez disso: acrescente uma mensagem role: "system" com content vazio e o novo nível. Isso exige o cabeçalho beta mid-conversation-output-config-2026-07-01.
{ "role": "system", "content": [], "output_config": { "effort": "low" } }O novo nível entra em vigor a partir do próximo turno user. Depois de enviada, a mensagem faz parte de messages e, portanto, do prefixo para o pensamento posterior: mantenha-a no lugar nas requisições posteriores e acrescente outra para alterar o esforço novamente.
Cortar o contexto no servidor
Outra edição de prefixo comum é o corte no lado do cliente: descartar ou resumir os turnos mais antigos e manter os recentes literalmente. Os blocos de pensamento dos turnos mantidos foram produzidos enquanto o histórico removido ainda estava presente, então eles falham na verificação. Os equivalentes no lado do servidor não contam como edições, porque a verificação compara a conversa como você a enviou:
- A compactação resume turnos mais antigos em um bloco de compactação quando o contexto se aproxima de um limite que você define, e o prefixo verificado recomeça a partir desse bloco. Seu parâmetro
instructionsaceita o seu próprio prompt de resumo, como "preserve cada ticker, tamanho de posição e premissa declarada". A compactação sob demanda (beta) retorna o resumo a partir de uma requisição separada, que pode ser executada em segundo plano. Envie"compaction": {"type": "summarize"}no corpo da requisição, e a resposta traz um único blococompaction, contendo o resumo e uma assinatura, em vez de uma resposta. A compactação sob demanda está disponível na Claude API, mas não no Amazon Bedrock nem no Google Cloud, e exige o cabeçalho betacompact-2026-09-04na requisição de resumo e em todas as requisições posteriores que carregam o bloco. Você envia o bloco no lugar das mensagens que ele resume. A verificação aceita essa troca, então os turnos que você mantém podem permanecer válidos com seu pensamento, nas condições descritas em Compactação com preservação da cauda. - A edição de contexto limpa resultados de ferramentas antigos ou blocos de pensamento antigos por regra, os mais antigos primeiro. As estratégias são
clear_tool_uses_20250919eclear_thinking_20251015.
Compactar no cliente
Você ainda pode fazer a "compaction" (compactação) no cliente. Se você mesmo escrever o resumo, não envie de volta um bloco de thinking que foi produzido antes da reescrita. Se a API o escrever com a compactação sob demanda, a seção Compactação keep-tail lista quando o thinking mantido continua válido.
Compactação simples (recomendada)
Quando a conversa ficar longa demais, resuma a sessão inteira em uma única mensagem de usuário e envie apenas essa mensagem mais a próxima instrução. Nada anterior é reenviado, então não sobra nenhum thinking que possa falhar na verificação, e o modelo raciocina do zero a partir do resumo.
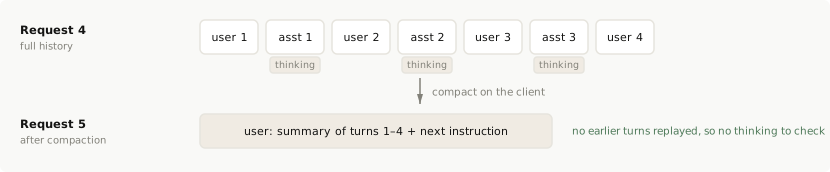
[
  {
    "role": "user",
    "content": "<summary of the session so far>\n\n<the next instruction>"
  }
]Os modelos Claude são treinados em tarefas de longo horizonte com esse esquema, e ele tem bom desempenho na maioria das cargas de trabalho.
Compactação keep-tail
A "keep-tail compaction" (compactação com preservação da cauda) resume os turnos mais antigos e mantém os turnos mais recentes literalmente, de modo que o modelo ainda vê as últimas trocas palavra por palavra. Se você mesmo escrever o resumo, isso quebra a regra: os turnos do assistente mantidos ainda carregam blocos de thinking que foram produzidos quando os turnos originais, e não o resumo, vinham antes deles. Esses blocos falham.
Para manter esse thinking, faça a API escrever o resumo com a compactação sob demanda. Envie apenas os turnos mais antigos em uma requisição com o parâmetro compaction e o cabeçalho beta compact-2026-09-04. Em seguida, envie o bloco assinado que ela retorna no lugar desses turnos, seguido pelos turnos mantidos exatamente como foram retornados. O thinking mantido continua válido enquanto todas estas condições forem verdadeiras:
- A requisição de compactação é executada em um modelo com pensamento preservado. O próprio modelo da conversa é a escolha simples.
- Os turnos mantidos vêm imediatamente após as mensagens resumidas, e a primeira mensagem mantida não é uma que a API mesclaria com a última mensagem resumida: uma mensagem com o mesmo papel, ou uma mensagem
role: "system". systeme suastoolsnão adiadas correspondem às da requisição de compactação.
A maneira mais simples de atender à segunda condição é compactar exatamente as messages de uma requisição que você já fez. Mensagens de sistema no meio da conversa dentro dos turnos resumidos também são resumidas, então suas instruções e alterações de ferramentas deixam de se aplicar após a troca. Para manter uma delas em vigor, declare-a novamente em uma mensagem role: "system" logo após o primeiro novo turno user que vem depois dos turnos mantidos. Uma mensagem de sistema colocada entre o bloco e os turnos mantidos invalida o thinking deles.
O restante desta seção trata de um resumo que você mesmo escreve.
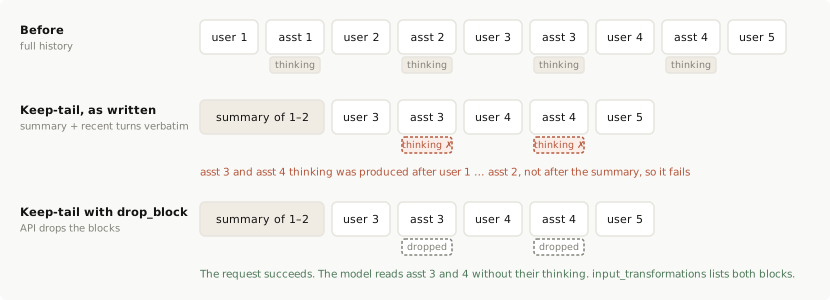
Correção: mantenha os turnos exatamente como estão e envie prefix_mismatch_behavior: "drop_block". A API descarta os blocos de thinking obsoletos, o modelo lê os blocos text e tool_use dos turnos mantidos, e a requisição é bem-sucedida.
Passe o histórico compactado como messages e defina block_binding na configuração thinking. No exemplo a seguir, compacted_messages é o array que sua etapa de compactação produziu: a mensagem de resumo seguida pelos turnos mantidos exatamente como a API os retornou, incluindo os blocos thinking:
client = anthropic.Anthropic()

# compacted_messages: a mensagem de resumo e, em seguida, os turnos mantidos conforme retornados
response = client.beta.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    thinking={
        "type": "adaptive",
        "block_binding": {"prefix_mismatch_behavior": "drop_block"},
    },
    messages=compacted_messages,
    betas=["thinking-binding-controls-2026-08-01"],
)

print(response.input_transformations)
A resposta traz o novo turno do assistente como de costume, mais uma entrada input_transformations por bloco descartado. Para o histórico do diagrama, isso corresponde ao thinking nos turnos 3 e 4 do assistente:
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.2.content.0",
      "reason": "prefix_binding_mismatch"
    },
    {
      "type": "thinking_dropped",
      "path": "messages.4.content.0",
      "reason": "prefix_binding_mismatch"
    }
  ]
}Continue enviando "drop_block" nas requisições seguintes enquanto esses dois turnos permanecerem no histórico. O thinking que o modelo produz a partir desta requisição segue o resumo e continua válido. Se você preferir não depender do cabeçalho beta, a alternativa é remover você mesmo os blocos thinking e redacted_thinking dos turnos do assistente mantidos ao construir o histórico compactado.
Compactação em segundo plano (assíncrona)
A compactação em segundo plano constrói o resumo fora do caminho crítico enquanto a conversa continua e, em seguida, faz a troca algumas requisições depois. Faça a API escrever o resumo com a compactação sob demanda:
- Envie a conversa até o momento em uma requisição separada com o parâmetro
compactione o cabeçalho betacompact-2026-09-04. - Continue trabalhando com o histórico completo enquanto essa requisição é executada.
- Na primeira requisição após a chegada do bloco, envie-o no lugar das mensagens que a requisição de compactação continha, seguido por todos os turnos adicionados desde então.
O thinking produzido enquanto o resumo estava sendo construído continua válido nas mesmas condições descritas em Compactação keep-tail.
Um resumo que você mesmo constrói quebra a regra da mesma forma que a compactação keep-tail, só que com atraso: cada turno do assistente produzido enquanto o resumo estava sendo construído carrega thinking anterior à troca, e todo ele falha no momento em que o resumo entra. Se você usar um, trate a troca como na compactação keep-tail e envie "drop_block" a partir da troca, ou compacte de forma síncrona.
Padrões que não funcionam com pensamento preservado
- Cortar turnos do meio. Remover turnos individuais invalida todos os blocos de thinking posteriores a eles, e nenhum esquema de compactação evita isso. Se você estava cortando um turno para alterar uma instrução, adicione uma mensagem de sistema no meio da conversa em vez disso. Para remover resultados de ferramentas antigos ou thinking antigo de forma seletiva, use a edição de contexto no lado do servidor.
- Compactar no meio de uma rodada de ferramentas. Não compacte entre o
tool_usede um turno do assistente e otool_resultque o responde. Envie esse turno do assistente de volta com seu thinking intacto para que o modelo conclua a rodada com seu raciocínio. Consulte Preservando blocos de thinking.
Referencie arquivos por ID, não por uma URL cujo conteúdo muda
Para um bloco image ou document com uma fonte url, a verificação abrange os bytes obtidos, não a string da URL. Uma URL cujo conteúdo muda invalida o thinking posterior: um endpoint de "captura de tela mais recente", ou um documento que alguém edita entre os turnos. Uma URL assinada rotativa para o mesmo arquivo não invalida. Para conteúdo que você referencia ao longo dos turnos, faça o upload uma vez com a Files API e use o file_id, ou envie em base64.
Bibliotecas, proxies e gateways
Uma biblioteca, proxy ou gateway fica entre o histórico de outra pessoa e a API, então suas próprias reescritas contam como edições, e seus usuários não conseguem vê-las nem corrigi-las.
- Repasse o que você não reconhece. Encaminhe os valores
anthropic-betaethinking.block_bindingdo chamador sem alterações e retorneinput_transformationspara ele. Um schema de opções que rejeita chaves desconhecidas impede que seus usuários escolham"drop_block". - Deixe uma mensagem
role: "system"onde o chamador a colocou. Movê-la para o camposystemde nível superior alterasystemnessa requisição e invalida todos os blocos de thinking da conversa. - Para desativar o uso de ferramentas em uma requisição, envie
tool_choice: {"type": "none"}. Não removatools. - Não oculte o 400. Se o seu código o captura, remove o thinking e tenta novamente em nome do chamador, registre em log que fez isso: o histórico dele continua editado, e o modelo perde seu raciocínio anterior em todas as requisições seguintes.
Perguntas frequentes
Não. Envie o cabeçalho beta thinking-binding-controls-2026-08-01 e defina thinking.block_binding.prefix_mismatch_behavior. Definir o campo inclui essa requisição na aplicação da regra, independentemente da idade da conta. "error" rejeita um histórico editado com o mesmo 400 que uma conta nova recebe, e "drop_block" deixa a requisição passar e lista o que foi descartado em input_transformations. Consulte Verifique se o seu código edita o prefixo.
Não. O que falha é o thinking que já está no histórico após o ponto que você alterou, e você escolhe o que acontece com ele. Com prefix_mismatch_behavior: "drop_block", a API descarta esses blocos e a requisição é bem-sucedida: o modelo responde a esse turno sem aquele raciocínio, e o cache de prompt recomeça a partir da edição. Com o padrão "error", a API rejeita a requisição com um 400 até que você desfaça a edição ou reenvie com "drop_block". Consulte O que a API faz com um bloco inválido. O que conta como edição lista quais alterações importam.
Não. output_config.effort, max_tokens e a configuração thinking não fazem parte do prefixo verificado, que abrange apenas system, tools e messages. Uma alteração de effort no nível superior invalida a maior parte do cache de prompt. No Claude Fable 5.1, uma alteração de effort por mensagem mantém o cache de prompt e é usada como o novo nível de effort até ser alterada novamente.
Não edite tools. Declare o conjunto completo no início da sessão, marque as ferramentas que ainda não estão disponíveis com defer_loading: true e ofereça-as ou retire-as com blocos tool_addition e tool_removal. Se você só conhecer o schema de uma ferramenta no meio da sessão, como de um servidor MCP descoberto em tempo de execução, ainda pode adicioná-la a tools com defer_loading: true e oferecê-la da mesma forma. Isso é seguro porque uma ferramenta adiada não referenciada não faz parte do prefixo. As mensagens role: "system" que carregam esses blocos passam a fazer parte do prefixo para o thinking posterior, então não as mova, reescreva nem exclua depois. Consulte Adicionar ou remover ferramentas com tool_addition e tool_removal.
Sim, se a API escrever o resumo. A compactação sob demanda (cabeçalho beta compact-2026-09-04) resume os turnos mais antigos em um bloco assinado que você envia no lugar deles. Os turnos recentes mantêm seu thinking nas condições descritas em Compactação keep-tail.
Se você mesmo escrever o resumo, o thinking dos turnos mantidos falha na verificação, porque esses blocos foram produzidos com base no histórico que você substituiu. Remova os blocos thinking e redacted_thinking dos turnos que você transfere e mantenha seus blocos text e tool_use, ou envie prefix_mismatch_behavior: "drop_block" e deixe a API descartá-los. A compactação simples não deixa nenhum thinking para trás que possa falhar e é a abordagem recomendada: uma mensagem de resumo mais o próximo turno do usuário, sem reenviar turnos anteriores. A compactação e a edição de contexto no lado do servidor não contam como edições. Consulte Compactar no cliente.
Carregue-os uma vez no início da sessão e mantenha fixos o prompt system de nível superior e tools. Quando um arquivo mudar, adicione a nova versão naquele ponto em messages em vez de editar o original. Use uma mensagem de sistema no meio da conversa para instruções que vêm de você como operador. Para texto de arquivo que você trata como não confiável, que não deve ter a autoridade de um prompt do sistema, coloque o conteúdo no próximo turno user. Consulte Adicionar instruções com uma mensagem de sistema no meio da conversa e Limitações.
Sim. Uma sessão retomada é uma requisição de continuação comum: system, tools e as messages anteriores devem ter o mesmo conteúdo que você enviou por último. A formatação JSON e a ordem das chaves não importam; os valores, sim. Persista exatamente o que você enviou e recebeu, e reenvie isso: o prompt do sistema renderizado, as definições de ferramentas e cada turno do assistente como foi retornado. Não renderize novamente a partir de entradas que possam ter mudado desde então, como a data, um arquivo de instruções atualizado ou uma nova versão de ferramenta. Qualquer coisa nova vai em uma mensagem adicionada. Consulte Envie os turnos do assistente de volta exatamente como foram retornados.
O histórico armazenado contém uma edição, então reenviá-lo não pode ter sucesso. Envie essa sessão com prefix_mismatch_behavior: "drop_block" daqui em diante, ou remova seus blocos thinking e redacted_thinking uma vez e continue. O thinking que o modelo produz a partir desse ponto continua válido desde que nada antes dele mude novamente. Em seguida, encontre a edição para que novas sessões não a encontrem. Consulte Tratar o erro no código.
Não, desde que sejam adicionados após o histórico existente e nada anterior mude: uma mensagem do assistente sem blocos de thinking é uma mensagem adicionada como qualquer outra. Envie a saída do outro modelo como conteúdo text e tool_use.
Não para uma conversa diferente. Um bloco de thinking só pode ser usado quando segue exatamente os system, tools e messages a partir dos quais foi produzido. Uma ramificação que reenvia esse histórico sem alterações até o ponto de bifurcação mantém seu thinking. Uma conversa que começa a partir de qualquer outra coisa não pode usá-lo, então inicie essa conversa a partir de um resumo do estado da tarefa, como na compactação simples: o objetivo, as decisões tomadas, os arquivos e resultados até o momento e o próximo passo.
Próximos passos
Diagnostique e corrija as falhas de pensamento mais comuns: erros 400 de configuração, blocos de pensamento vazios ou ausentes, paradas por max_tokens e falhas de cache.
Altere instruções do sistema ou a disponibilidade de ferramentas no meio de uma conversa sem invalidar o prefixo em cache que veio antes delas.
Compactação de contexto no lado do servidor para gerenciar conversas longas que se aproximam dos limites da janela de contexto.
Armazene prefixos de prompt em cache com cache_control para reduzir custos e latência, usando cache automático ou pontos de interrupção explícitos com TTLs de 5 minutos ou 1 hora.
Was this page helpful?