Best practice per la creazione di Skills
Scopri come scrivere Skills efficaci che Claude possa individuare e utilizzare con successo.
Le buone Skills sono concise, ben strutturate e testate con un utilizzo reale. Questa guida fornisce decisioni pratiche di authoring per aiutarti a scrivere Skills che Claude possa individuare e utilizzare in modo efficace.
Per il contesto concettuale su come funzionano le Skills, consulta la panoramica delle Skills.
Principi fondamentali
La concisione è fondamentale
La "context window" (finestra di contesto) è un bene pubblico. La tua Skill condivide la finestra di contesto con tutto il resto che Claude deve sapere, tra cui:
- Il "system prompt" (prompt di sistema)
- La cronologia della conversazione
- I metadati delle altre Skills
- La tua richiesta effettiva
Non ogni token nella tua Skill ha un costo immediato. All'avvio, vengono precaricati solo i metadati (nome e descrizione) di tutte le Skills. Claude legge SKILL.md solo quando la Skill diventa rilevante e legge i file aggiuntivi solo quando necessario. Tuttavia, essere concisi in SKILL.md è comunque importante: una volta che Claude lo carica, ogni token compete con la cronologia della conversazione e con il resto del contesto.
Presupposto predefinito: Claude è già molto intelligente
Aggiungi solo il contesto che Claude non possiede già. Metti in discussione ogni informazione:
- "Claude ha davvero bisogno di questa spiegazione?"
- "Posso presumere che Claude lo sappia già?"
- "Questo paragrafo giustifica il suo costo in token?"
Buon esempio: Conciso (circa 50 token):
## Extract PDF text

Use pdfplumber for text extraction:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```Cattivo esempio: Troppo prolisso (circa 150 token):
## Extract PDF text

PDF (Portable Document Format) files are a common file format that contains
text, images, and other content. To extract text from a PDF, you'll need to
use a library. There are many libraries available for PDF processing, but
pdfplumber is recommended because it's easy to use and handles most cases well.
First, you'll need to install it using pip. Then you can use the code below...La versione concisa presuppone che Claude abbia già informazioni sui PDF e su come funzionano le librerie.
Imposta gradi di libertà appropriati
Adatta il livello di specificità alla fragilità e alla variabilità del compito.
Alta libertà (istruzioni testuali):
Usala quando:
- Sono validi più approcci
- Le decisioni dipendono dal contesto
- Le euristiche guidano l'approccio
Esempio:
## Code review process

1. Analyze the code structure and organization
2. Check for potential bugs or edge cases
3. Suggest improvements for readability and maintainability
4. Verify adherence to project conventionsMedia libertà (pseudocodice o script con parametri):
Usala quando:
- Esiste un pattern preferito
- Una certa variazione è accettabile
- La configurazione influenza il comportamento
Esempio:
## Generate report

Use this template and customize as needed:

```python
def generate_report(data, format="markdown", include_charts=True):
    # Process data
    # Generate output in specified format
    # Optionally include visualizations
```Bassa libertà (script specifici, pochi o nessun parametro):
Usala quando:
- Le operazioni sono fragili e soggette a errori
- La coerenza è critica
- Deve essere seguita una sequenza specifica
Esempio:
## Database migration

Run exactly this script:

```bash
python scripts/migrate.py --verify --backup
```

Do not modify the command or add additional flags.Analogia: Pensa a Claude come a un robot che esplora un percorso:
- Ponte stretto con precipizi su entrambi i lati: C'è un solo modo sicuro per procedere. Fornisci protezioni specifiche e istruzioni esatte (bassa libertà). Esempio: migrazioni di database che devono essere eseguite in una sequenza esatta.
- Campo aperto senza pericoli: Molti percorsi portano al successo. Dai una direzione generale e fidati di Claude per trovare la strada migliore (alta libertà). Esempio: revisioni del codice in cui il contesto determina l'approccio migliore.
Testa con tutti i modelli che prevedi di usare
Le Skills agiscono come aggiunte ai modelli, quindi l'efficacia dipende dal modello sottostante. Testa la tua Skill con tutti i modelli con cui prevedi di usarla.
Considerazioni di test per modello:
- Claude Haiku (veloce, economico): La Skill fornisce indicazioni sufficienti?
- Claude Sonnet (bilanciato): La Skill è chiara ed efficiente?
- Claude Opus (ragionamento potente): La Skill evita di spiegare troppo?
Ciò che funziona perfettamente per Opus potrebbe richiedere più dettagli per Haiku. Se prevedi di usare la tua Skill con più modelli, punta a istruzioni che funzionino bene con tutti.
Struttura della Skill
Convenzioni di denominazione
Usa pattern di denominazione coerenti per rendere le Skills più facili da referenziare e discutere. Considera l'uso della forma in gerundio (verbo + -ing) per i nomi delle Skills, poiché descrive chiaramente l'attività o la capacità che la Skill fornisce.
Ricorda che il campo name deve usare solo lettere minuscole, numeri e trattini.
Buoni esempi di denominazione (forma in gerundio):
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
Alternative accettabili:
- Sintagmi nominali:
pdf-processing,spreadsheet-analysis - Orientati all'azione:
process-pdfs,analyze-spreadsheets
Evita:
- Nomi vaghi:
helper,utils,tools - Eccessivamente generici:
documents,data,files - Parole riservate:
anthropic-helper,claude-tools - Pattern incoerenti all'interno della tua raccolta di skill
Una denominazione coerente rende più facile:
- Referenziare le Skills nella documentazione e nelle conversazioni
- Capire a colpo d'occhio cosa fa una Skill
- Organizzare e cercare tra più Skills
- Mantenere una libreria di skill professionale e coesa
Scrivere descrizioni efficaci
Il campo description abilita l'individuazione della Skill e dovrebbe includere sia cosa fa la Skill sia quando usarla.
Sii specifico e includi i termini chiave. Includi sia cosa fa la Skill sia i trigger/contesti specifici per quando usarla.
Ogni Skill ha esattamente un campo description. La descrizione è critica per la selezione della skill: Claude la usa per scegliere la Skill giusta tra potenzialmente oltre 100 Skills disponibili. La tua descrizione deve fornire dettagli sufficienti perché Claude sappia quando selezionare questa Skill, mentre il resto di SKILL.md fornisce i dettagli di implementazione.
Esempi efficaci:
Skill di elaborazione PDF:
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.Skill di analisi Excel:
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.Skill di supporto ai commit Git:
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.Evita descrizioni vaghe come queste:
description: Helps with documentsdescription: Processes datadescription: Does stuff with filesPattern di progressive disclosure
SKILL.md funge da panoramica che indirizza Claude verso materiali dettagliati quando necessario, come l'indice di una guida di onboarding. Per una spiegazione di come funziona la "progressive disclosure" (divulgazione progressiva), consulta Come funzionano le Skills nella panoramica.
Indicazioni pratiche:
- Mantieni il corpo di SKILL.md sotto le 500 righe per prestazioni ottimali
- Suddividi il contenuto in file separati quando ti avvicini a questo limite
- Usa i seguenti pattern per organizzare istruzioni, codice e risorse in modo efficace
Panoramica visiva: dal semplice al complesso
Una Skill di base inizia con un solo file SKILL.md contenente metadati e istruzioni:
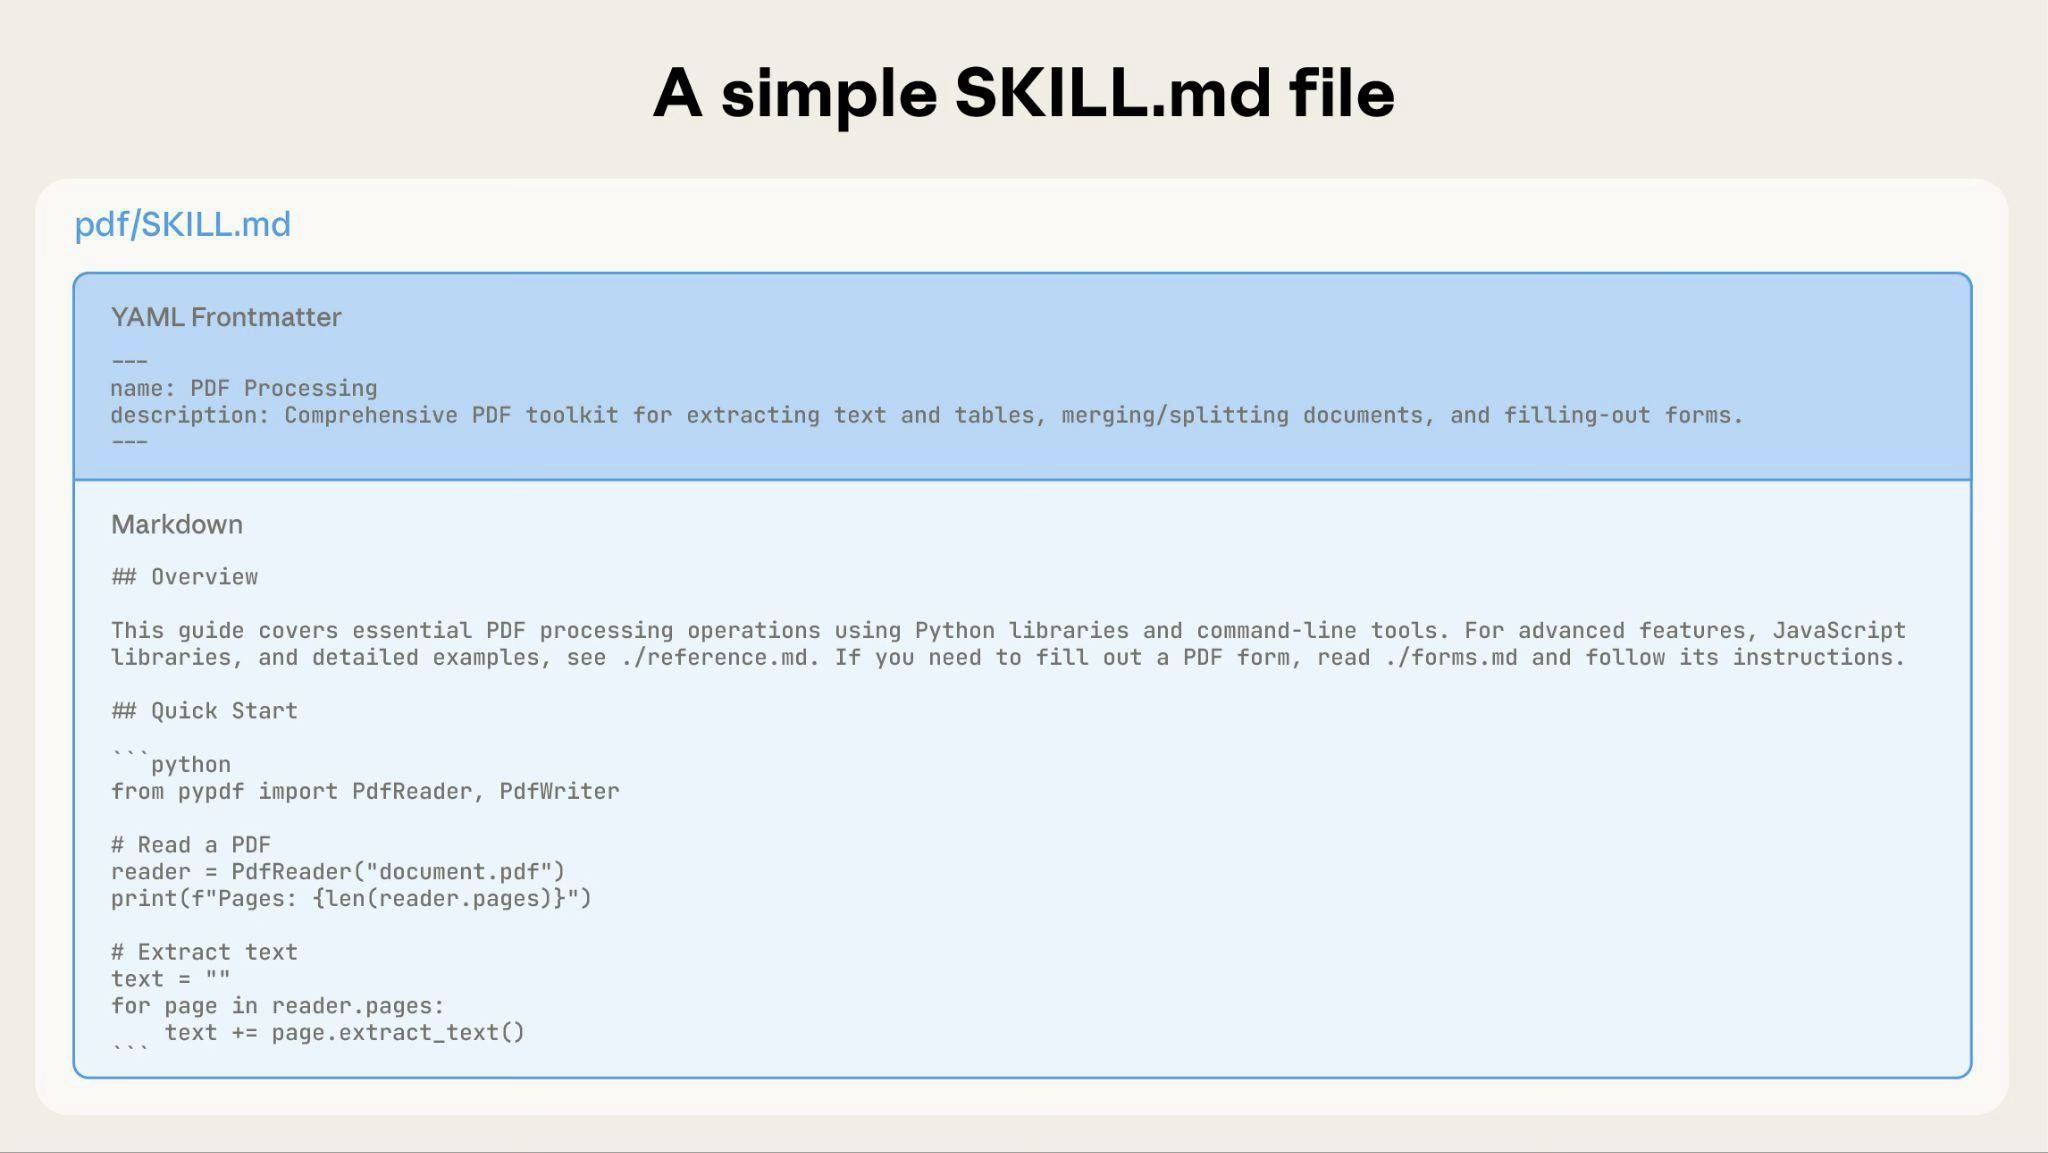
Man mano che la tua Skill cresce, puoi includere contenuti aggiuntivi che Claude carica solo quando necessario:
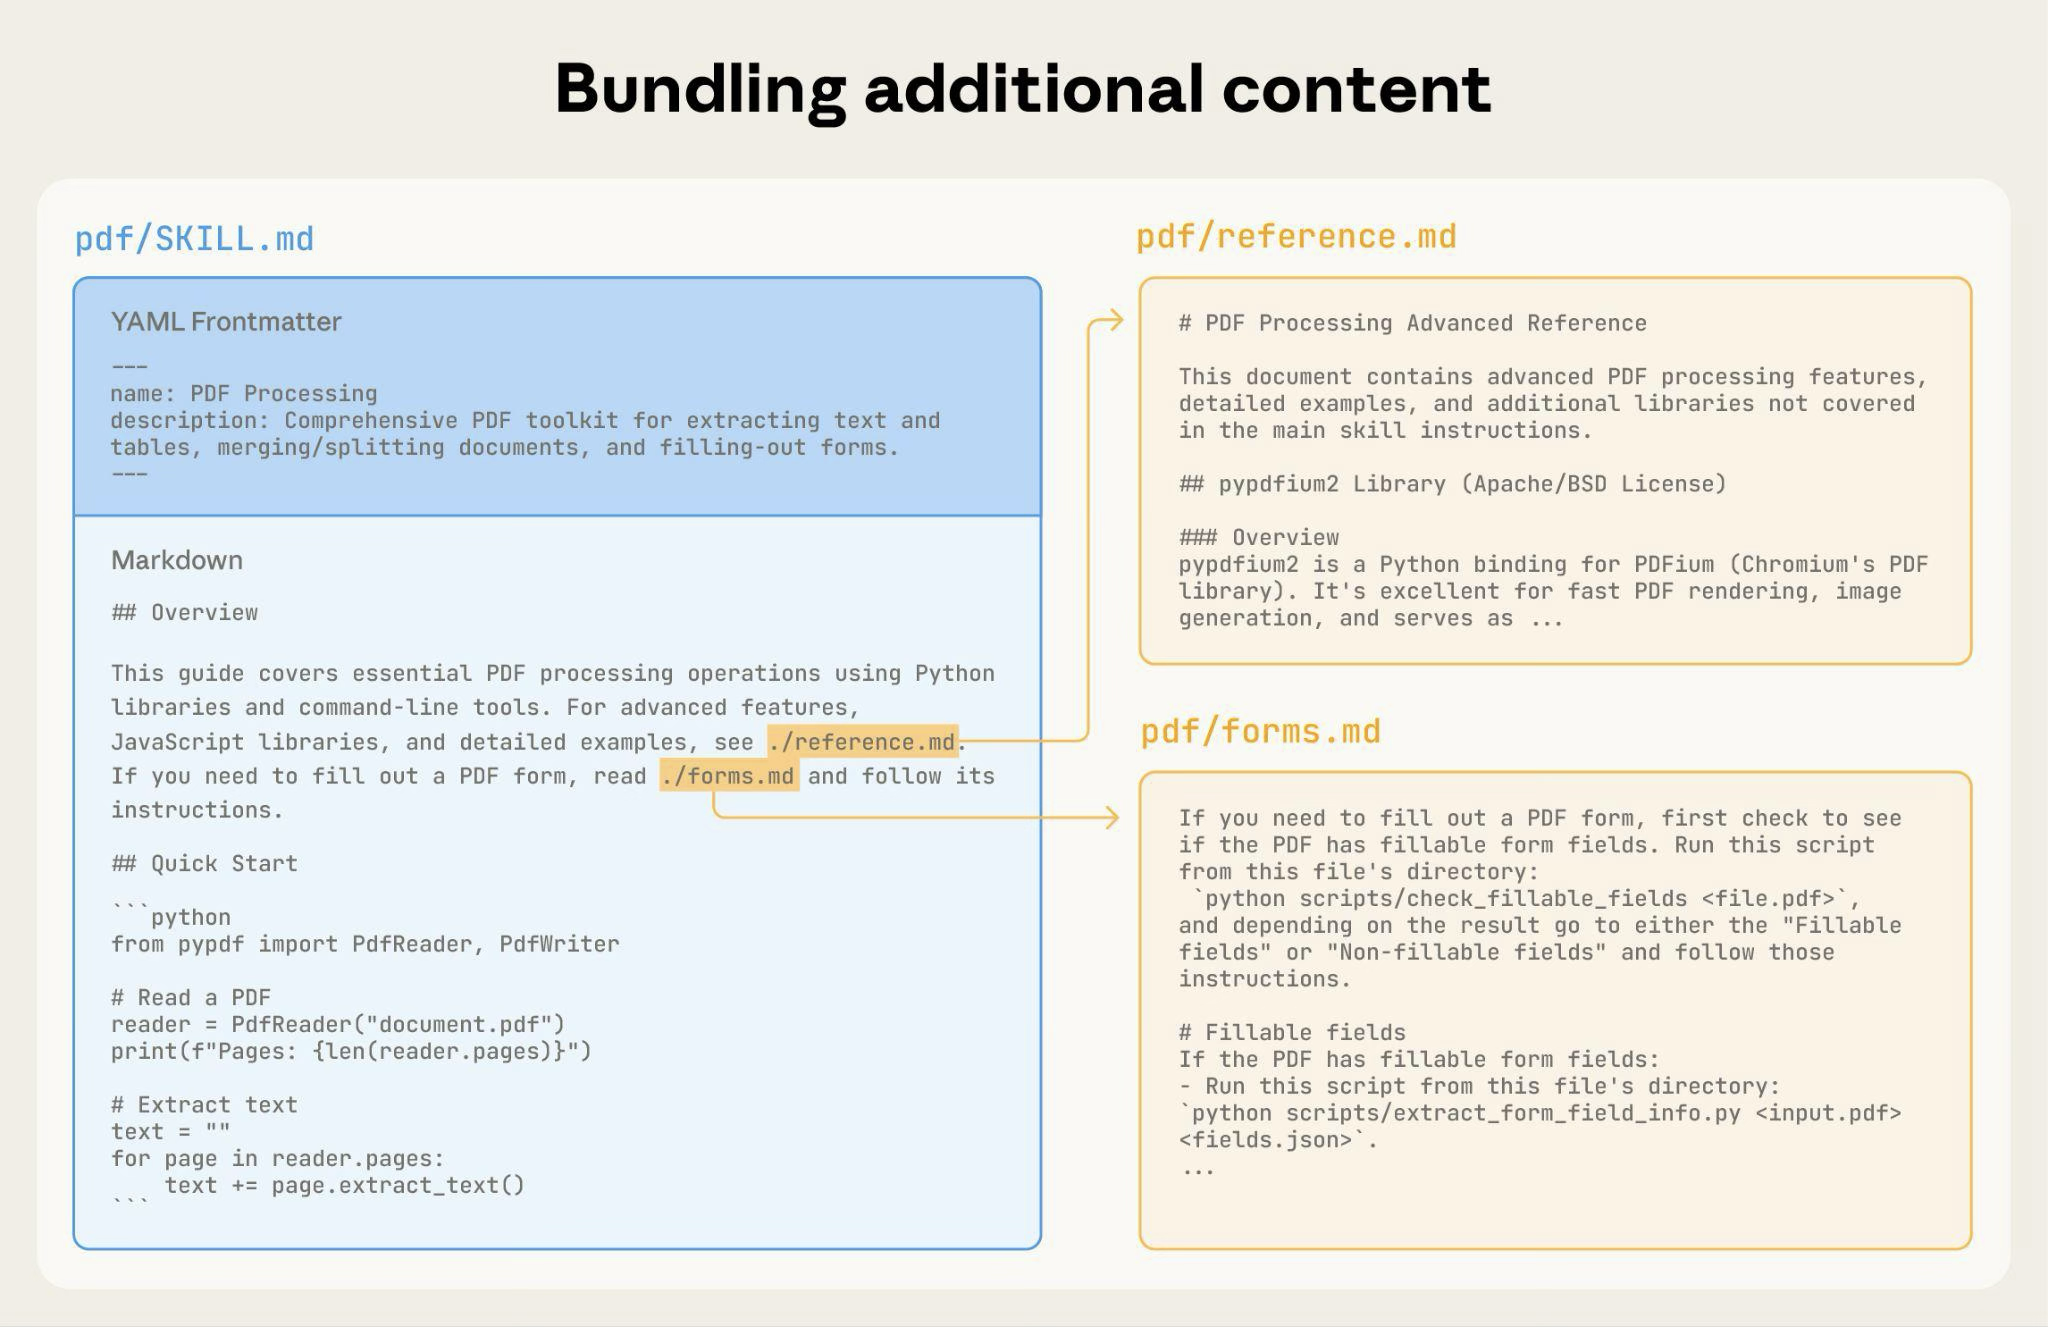
La struttura completa della directory della Skill potrebbe apparire così:
pdf/SKILL.md: Istruzioni principali (caricate quando attivata)FORMS.md: Guida alla compilazione dei moduli (caricata quando necessario)reference.md: Riferimento API (caricato quando necessario)examples.md: Esempi di utilizzo (caricati quando necessario)scripts/analyze_form.py: Script di utilità (eseguito, non caricato)fill_form.py: Script di compilazione modulivalidate.py: Script di validazione
Pattern 1: Guida di alto livello con riferimenti
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
---

# PDF Processing

## Quick start

Extract text with pdfplumber:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## Advanced features

**Form filling**: See [FORMS.md](FORMS.md) for complete guide
**API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
**Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patternsClaude carica FORMS.md, REFERENCE.md o EXAMPLES.md solo quando necessario.
Pattern 2: Organizzazione per dominio
Per le Skills con più domini, organizza il contenuto per dominio per evitare di caricare contesto irrilevante. Quando un utente chiede delle metriche di vendita, Claude deve leggere solo gli schemi relativi alle vendite, non i dati di finanza o marketing. Questo mantiene basso l'uso di token e il contesto focalizzato.
bigquery-skill/SKILL.md(panoramica e navigazione)reference/finance.md(ricavi, metriche di fatturazione)sales.md(opportunità, pipeline)product.md(utilizzo API, funzionalità)marketing.md(campagne, attribuzione)
# BigQuery Data Analysis

## Available datasets

**Finance**: Revenue, ARR, billing → See [reference/finance.md](reference/finance.md)
**Sales**: Opportunities, pipeline, accounts → See [reference/sales.md](reference/sales.md)
**Product**: API usage, features, adoption → See [reference/product.md](reference/product.md)
**Marketing**: Campaigns, attribution, email → See [reference/marketing.md](reference/marketing.md)

## Quick search

Find specific metrics using grep:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md
```
Pattern 3: Dettagli condizionali
Mostra il contenuto di base, collega al contenuto avanzato:
# DOCX Processing

## Creating documents

Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).

## Editing documents

For simple edits, modify the XML directly.

**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)Claude legge REDLINING.md o OOXML.md solo quando l'utente ha bisogno di quelle funzionalità.
Evita riferimenti profondamente annidati
Claude potrebbe leggere parzialmente i file quando sono referenziati da altri file referenziati. Quando incontra riferimenti annidati, Claude potrebbe usare comandi come head -100 per visualizzare un'anteprima del contenuto invece di leggere i file interi, ottenendo informazioni incomplete.
Mantieni i riferimenti a un solo livello di profondità da SKILL.md. Tutti i file di riferimento dovrebbero essere collegati direttamente da SKILL.md per garantire che Claude legga i file completi quando necessario.
Cattivo esempio: Troppo profondo:
# SKILL.md
See [advanced.md](advanced.md)...

# advanced.md
See [details.md](details.md)...

# details.md
Here's the actual information...Buon esempio: Un solo livello di profondità:
# SKILL.md

**Basic usage**: [instructions in SKILL.md]
**Advanced features**: See [advanced.md](advanced.md)
**API reference**: See [reference.md](reference.md)
**Examples**: See [examples.md](examples.md)Struttura i file di riferimento più lunghi con un indice
Per i file di riferimento più lunghi di 100 righe, includi un indice all'inizio. Questo garantisce che Claude possa vedere l'intera portata delle informazioni disponibili anche quando visualizza un'anteprima con letture parziali.
Esempio:
# API Reference

## Contents
- Authentication and setup
- Core methods (create, read, update, delete)
- Advanced features (batch operations, webhooks)
- Error handling patterns
- Code examples

## Authentication and setup
...

## Core methods
...Claude può quindi leggere il file completo o saltare a sezioni specifiche secondo necessità.
Per i dettagli su come questa architettura basata su filesystem abilita la progressive disclosure, consulta la sezione Ambiente di runtime più avanti in questa guida.
Workflow e cicli di feedback
Usa i workflow per compiti complessi
Suddividi le operazioni complesse in passaggi chiari e sequenziali. Per workflow particolarmente complessi, fornisci una checklist che Claude possa copiare nella sua risposta e spuntare man mano che procede.
Esempio 1: Workflow di sintesi della ricerca (per Skills senza codice):
## Research synthesis workflow

Copy this checklist and track your progress:

```
Research Progress:
- [ ] Step 1: Read all source documents
- [ ] Step 2: Identify key themes
- [ ] Step 3: Cross-reference claims
- [ ] Step 4: Create structured summary
- [ ] Step 5: Verify citations
```

**Step 1: Read all source documents**

Review each document in the `sources/` directory. Note the main arguments and supporting evidence.

**Step 2: Identify key themes**

Look for patterns across sources. What themes appear repeatedly? Where do sources agree or disagree?

**Step 3: Cross-reference claims**

For each major claim, verify it appears in the source material. Note which source supports each point.

**Step 4: Create structured summary**

Organize findings by theme. Include:
- Main claim
- Supporting evidence from sources
- Conflicting viewpoints (if any)

**Step 5: Verify citations**

Check that every claim references the correct source document. If citations are incomplete, return to Step 3.Questo esempio mostra come i workflow si applicano a compiti di analisi che non richiedono codice. Il pattern della checklist funziona per qualsiasi processo complesso a più passaggi.
Esempio 2: Workflow di compilazione di moduli PDF (per Skills con codice):
## PDF form filling workflow

Copy this checklist and check off items as you complete them:

```
Task Progress:
- [ ] Step 1: Analyze the form (run analyze_form.py)
- [ ] Step 2: Create field mapping (edit fields.json)
- [ ] Step 3: Validate mapping (run validate_fields.py)
- [ ] Step 4: Fill the form (run fill_form.py)
- [ ] Step 5: Verify output (run verify_output.py)
```

**Step 1: Analyze the form**

Run: `python scripts/analyze_form.py input.pdf`

This extracts form fields and their locations, saving to `fields.json`.

**Step 2: Create field mapping**

Edit `fields.json` to add values for each field.

**Step 3: Validate mapping**

Run: `python scripts/validate_fields.py fields.json`

Fix any validation errors before continuing.

**Step 4: Fill the form**

Run: `python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: Verify output**

Run: `python scripts/verify_output.py output.pdf`

If verification fails, return to Step 2.Passaggi chiari impediscono a Claude di saltare validazioni critiche. La checklist aiuta sia Claude sia te a tenere traccia dei progressi nei workflow a più passaggi.
Implementa cicli di feedback
Pattern comune: Esegui il validatore → correggi gli errori → ripeti
Questo pattern migliora notevolmente la qualità dell'output.
Esempio 1: Conformità alla guida di stile (per Skills senza codice):
## Content review process

1. Draft your content following the guidelines in STYLE_GUIDE.md
2. Review against the checklist:
   - Check terminology consistency
   - Verify examples follow the standard format
   - Confirm all required sections are present
3. If issues found:
   - Note each issue with specific section reference
   - Revise the content
   - Review the checklist again
4. Only proceed when all requirements are met
5. Finalize and save the documentQuesto mostra il pattern del ciclo di validazione usando documenti di riferimento invece di script. Il "validatore" è STYLE_GUIDE.md e Claude esegue il controllo leggendo e confrontando.
Esempio 2: Processo di modifica dei documenti (per Skills con codice):
## Document editing process

1. Make your edits to `word/document.xml`
2. **Validate immediately**: `python ooxml/scripts/validate.py unpacked_dir/`
3. If validation fails:
   - Review the error message carefully
   - Fix the issues in the XML
   - Run validation again
4. **Only proceed when validation passes**
5. Rebuild: `python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. Test the output documentIl ciclo di validazione intercetta gli errori precocemente.
Linee guida sui contenuti
Evita informazioni sensibili al tempo
Non includere informazioni che diventeranno obsolete:
Cattivo esempio: Sensibile al tempo (diventerà errato):
If you're doing this before August 2025, use the old API.
After August 2025, use the new API.Buon esempio (usa una sezione "vecchi pattern"):
## Current method

Use the v2 API endpoint: `api.example.com/v2/messages`

## Old patterns

<details>
<summary>Legacy v1 API (deprecated 2025-08)</summary>

The v1 API used: `api.example.com/v1/messages`

This endpoint is no longer supported.
</details>La sezione dei vecchi pattern fornisce contesto storico senza appesantire il contenuto principale.
Usa una terminologia coerente
Scegli un termine e usalo in tutta la Skill:
Buono - Coerente:
- Sempre "API endpoint"
- Sempre "field"
- Sempre "extract"
Cattivo - Incoerente:
- Mescolare "API endpoint", "URL", "API route", "path"
- Mescolare "field", "box", "element", "control"
- Mescolare "extract", "pull", "get", "retrieve"
La coerenza aiuta Claude ad analizzare e seguire le istruzioni.
Pattern comuni
Pattern del template
Fornisci template per il formato di output. Adatta il livello di rigidità alle tue esigenze.
Per requisiti rigidi (come risposte API o formati di dati):
## Report structure

ALWAYS use this exact template structure:

```markdown
# [Analysis Title]

## Executive summary
[One-paragraph overview of key findings]

## Key findings
- Finding 1 with supporting data
- Finding 2 with supporting data
- Finding 3 with supporting data

## Recommendations
1. Specific actionable recommendation
2. Specific actionable recommendation
```Per indicazioni flessibili (quando l'adattamento è utile):
## Report structure

Here is a sensible default format, but use your best judgment based on the analysis:

```markdown
# [Analysis Title]

## Executive summary
[Overview]

## Key findings
[Adapt sections based on what you discover]

## Recommendations
[Tailor to the specific context]
```

Adjust sections as needed for the specific analysis type.Pattern degli esempi
Per le Skills in cui la qualità dell'output dipende dal vedere esempi, fornisci coppie input/output proprio come nel prompting normale:
## Commit message format

Generate commit messages following these examples:

**Example 1:**
Input: Added user authentication with JWT tokens
Output:
```
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware
```

**Example 2:**
Input: Fixed bug where dates displayed incorrectly in reports
Output:
```
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation
```

**Example 3:**
Input: Updated dependencies and refactored error handling
Output:
```
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints
```

Follow this style: type(scope): brief description, then detailed explanation.Gli esempi trasmettono a Claude lo stile e il livello di dettaglio desiderati più chiaramente delle sole descrizioni.
Pattern del workflow condizionale
Guida Claude attraverso i punti di decisione:
## Document modification workflow

1. Determine the modification type:

   **Creating new content?** → Follow "Creation workflow" below
   **Editing existing content?** → Follow "Editing workflow" below

2. Creation workflow:
   - Use docx-js library
   - Build document from scratch
   - Export to .docx format

3. Editing workflow:
   - Unpack existing document
   - Modify XML directly
   - Validate after each change
- Repack when completeValutazione e iterazione
Costruisci prima le valutazioni
Crea le valutazioni PRIMA di scrivere documentazione estesa. Questo garantisce che la tua Skill risolva problemi reali invece di documentare problemi immaginari.
Sviluppo guidato dalle valutazioni:
- Identifica le lacune: Esegui Claude su compiti rappresentativi senza una Skill. Documenta i fallimenti specifici o il contesto mancante
- Crea le valutazioni: Costruisci tre scenari che testino queste lacune
- Stabilisci una baseline: Misura le prestazioni di Claude senza la Skill
- Scrivi istruzioni minime: Crea solo il contenuto sufficiente per colmare le lacune e superare le valutazioni
- Itera: Esegui le valutazioni, confronta con la baseline e perfeziona
Questo approccio garantisce che tu stia risolvendo problemi reali invece di anticipare requisiti che potrebbero non materializzarsi mai.
Struttura della valutazione:
{
  "skills": ["pdf-processing"],
  "query": "Extract all text from this PDF file and save it to output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "Successfully reads the PDF file using an appropriate PDF processing library or command-line tool",
    "Extracts text content from all pages in the document without missing any pages",
    "Saves the extracted text to a file named output.txt in a clear, readable format"
  ]
}Sviluppa le Skills in modo iterativo con Claude
Il processo di sviluppo delle Skills più efficace coinvolge Claude stesso. Lavora con un'istanza di Claude ("Claude A") per creare una Skill che viene usata da altre istanze ("Claude B"). Claude A ti aiuta a progettare e perfezionare le istruzioni, mentre Claude B le testa in compiti reali. Questo funziona perché i modelli Claude comprendono sia come scrivere istruzioni efficaci per agenti sia quali informazioni servono agli agenti.
Creare una nuova Skill:
-
Completa un compito senza una Skill: Affronta un problema con Claude A usando il prompting normale. Mentre lavori, fornirai naturalmente contesto, spiegherai preferenze e condividerai conoscenze procedurali. Nota quali informazioni fornisci ripetutamente.
-
Identifica il pattern riutilizzabile: Dopo aver completato il compito, identifica quale contesto hai fornito che sarebbe utile per compiti futuri simili.
Esempio: Se hai affrontato un'analisi BigQuery, potresti aver fornito nomi di tabelle, definizioni di campi, regole di filtraggio (come "escludi sempre gli account di test") e pattern di query comuni.
-
Chiedi a Claude A di creare una Skill: "Crea una Skill che catturi questo pattern di analisi BigQuery che abbiamo appena usato. Includi gli schemi delle tabelle, le convenzioni di denominazione e la regola sul filtraggio degli account di test."
-
Rivedi per la concisione: Controlla che Claude A non abbia aggiunto spiegazioni non necessarie. Chiedi: "Rimuovi la spiegazione su cosa significa win rate - Claude lo sa già."
-
Migliora l'architettura dell'informazione: Chiedi a Claude A di organizzare il contenuto in modo più efficace. Per esempio: "Organizza questo in modo che lo schema delle tabelle sia in un file di riferimento separato. Potremmo aggiungere altre tabelle in seguito."
-
Testa su compiti simili: Usa la Skill con Claude B (un'istanza nuova con la Skill caricata) su casi d'uso correlati. Osserva se Claude B trova le informazioni giuste, applica correttamente le regole e gestisce il compito con successo.
-
Itera in base all'osservazione: Se Claude B fatica o tralascia qualcosa, torna da Claude A con dettagli specifici: "Quando Claude ha usato questa Skill, ha dimenticato di filtrare per data per il Q4. Dovremmo aggiungere una sezione sui pattern di filtraggio per data?"
Iterare su Skills esistenti:
Lo stesso pattern gerarchico continua quando si migliorano le Skills. Alterni tra:
- Lavorare con Claude A (l'esperto che aiuta a perfezionare la Skill)
- Testare con Claude B (l'agente che usa la Skill per svolgere lavoro reale)
- Osservare il comportamento di Claude B e riportare le osservazioni a Claude A
-
Usa la Skill in workflow reali: Dai a Claude B (con la Skill caricata) compiti reali, non scenari di test
-
Osserva il comportamento di Claude B: Nota dove fatica, dove ha successo o dove fa scelte inaspettate
Esempio di osservazione: "Quando ho chiesto a Claude B un report sulle vendite regionali, ha scritto la query ma ha dimenticato di filtrare gli account di test, anche se la Skill menziona questa regola."
-
Torna da Claude A per i miglioramenti: Condividi l'attuale SKILL.md e descrivi cosa hai osservato. Chiedi: "Ho notato che Claude B ha dimenticato di filtrare gli account di test quando ho chiesto un report regionale. La Skill menziona il filtraggio, ma forse non è abbastanza in evidenza?"
-
Rivedi i suggerimenti di Claude A: Claude A potrebbe suggerire di riorganizzare per rendere le regole più evidenti, di usare un linguaggio più forte come "DEVE filtrare" invece di "filtra sempre", o di ristrutturare la sezione del workflow.
-
Applica e testa le modifiche: Aggiorna la Skill con i perfezionamenti di Claude A, poi testa di nuovo con Claude B su richieste simili
-
Ripeti in base all'utilizzo: Continua questo ciclo osserva-perfeziona-testa man mano che incontri nuovi scenari. Ogni iterazione migliora la Skill in base al comportamento reale dell'agente, non a supposizioni.
Raccogliere feedback dal team:
- Condividi le Skills con i colleghi e osserva il loro utilizzo
- Chiedi: La Skill si attiva quando previsto? Le istruzioni sono chiare? Cosa manca?
- Incorpora il feedback per colmare le lacune nei tuoi pattern di utilizzo
Perché questo approccio funziona: Claude A comprende le esigenze degli agenti, tu fornisci la competenza di dominio, Claude B rivela le lacune attraverso l'utilizzo reale e il perfezionamento iterativo migliora le Skills in base al comportamento osservato invece che a supposizioni.
Osserva come Claude naviga le Skills
Mentre iteri sulle Skills, presta attenzione a come Claude le usa effettivamente nella pratica. Fai attenzione a:
- Percorsi di esplorazione inaspettati: Claude legge i file in un ordine che non avevi previsto? Questo potrebbe indicare che la tua struttura non è intuitiva come pensavi
- Collegamenti mancati: Claude non segue i riferimenti a file importanti? I tuoi link potrebbero dover essere più espliciti o evidenti
- Eccessiva dipendenza da certe sezioni: Se Claude legge ripetutamente lo stesso file, considera se quel contenuto dovrebbe invece trovarsi nel SKILL.md principale
- Contenuto ignorato: Se Claude non accede mai a un file incluso, potrebbe essere non necessario o segnalato male nelle istruzioni principali
Itera in base a queste osservazioni invece che a supposizioni. Il 'name' e la 'description' nei metadati della tua Skill sono particolarmente critici. Claude li usa per determinare se attivare la Skill in risposta al compito corrente. Assicurati che descrivano chiaramente cosa fa la Skill e quando dovrebbe essere usata.
Anti-pattern da evitare
Evita i percorsi in stile Windows
Usa sempre le barre (forward slash) nei percorsi dei file, anche su Windows:
- ✓ Buono:
scripts/helper.py,reference/guide.md - ✗ Evita:
scripts\helper.py,reference\guide.md
I percorsi in stile Unix funzionano su tutte le piattaforme, mentre i percorsi in stile Windows causano errori sui sistemi Unix.
Evita di offrire troppe opzioni
Non presentare più approcci a meno che non sia necessario:
**Bad example: Too many choices** (confusing):
"You can use pypdf, or pdfplumber, or PyMuPDF, or pdf2image, or..."

**Good example: Provide a default** (with escape hatch):
"Use pdfplumber for text extraction:
```python
import pdfplumber
```

For scanned PDFs requiring OCR, use pdf2image with pytesseract instead."Avanzato: Skills con codice eseguibile
Le sezioni seguenti si concentrano sulle Skills che includono script eseguibili. Se la tua Skill usa solo istruzioni markdown, passa alla Checklist per Skills efficaci.
Risolvi, non delegare
Quando scrivi script per le Skills, gestisci le condizioni di errore invece di delegarle a Claude.
Buon esempio: Gestisci gli errori esplicitamente:
def process_file(path):
    """Process a file, creating it if it doesn't exist."""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # Crea il file con contenuto predefinito invece di fallire
        print(f"File {path} not found, creating default")
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # Fornisci un'alternativa invece di fallire
        print(f"Cannot access {path}, using default")
return ""Cattivo esempio: Delega a Claude:
def process_file(path):
    # Fallisci semplicemente e lascia che Claude se la sbrighi
return open(path).read()Anche i parametri di configurazione dovrebbero essere giustificati e documentati per evitare "costanti voodoo" (legge di Ousterhout). Se tu non conosci il valore giusto, come lo determinerà Claude?
Buon esempio: Auto-documentante:
# Le richieste HTTP in genere si completano entro 30 secondi
# Un timeout più lungo tiene conto delle connessioni lente
REQUEST_TIMEOUT = 30

# Tre tentativi bilanciano affidabilità e velocità
# La maggior parte degli errori intermittenti si risolve al secondo tentativo
MAX_RETRIES = 3Cattivo esempio: Numeri magici:
TIMEOUT = 47  # Why 47?
RETRIES = 5 # Why 5?Fornisci script di utilità
Anche se Claude potrebbe scrivere uno script, gli script già pronti offrono vantaggi:
Vantaggi degli script di utilità:
- Più affidabili del codice generato
- Risparmiano token (non serve includere il codice nel contesto)
- Risparmiano tempo (nessuna generazione di codice richiesta)
- Garantiscono coerenza tra gli utilizzi
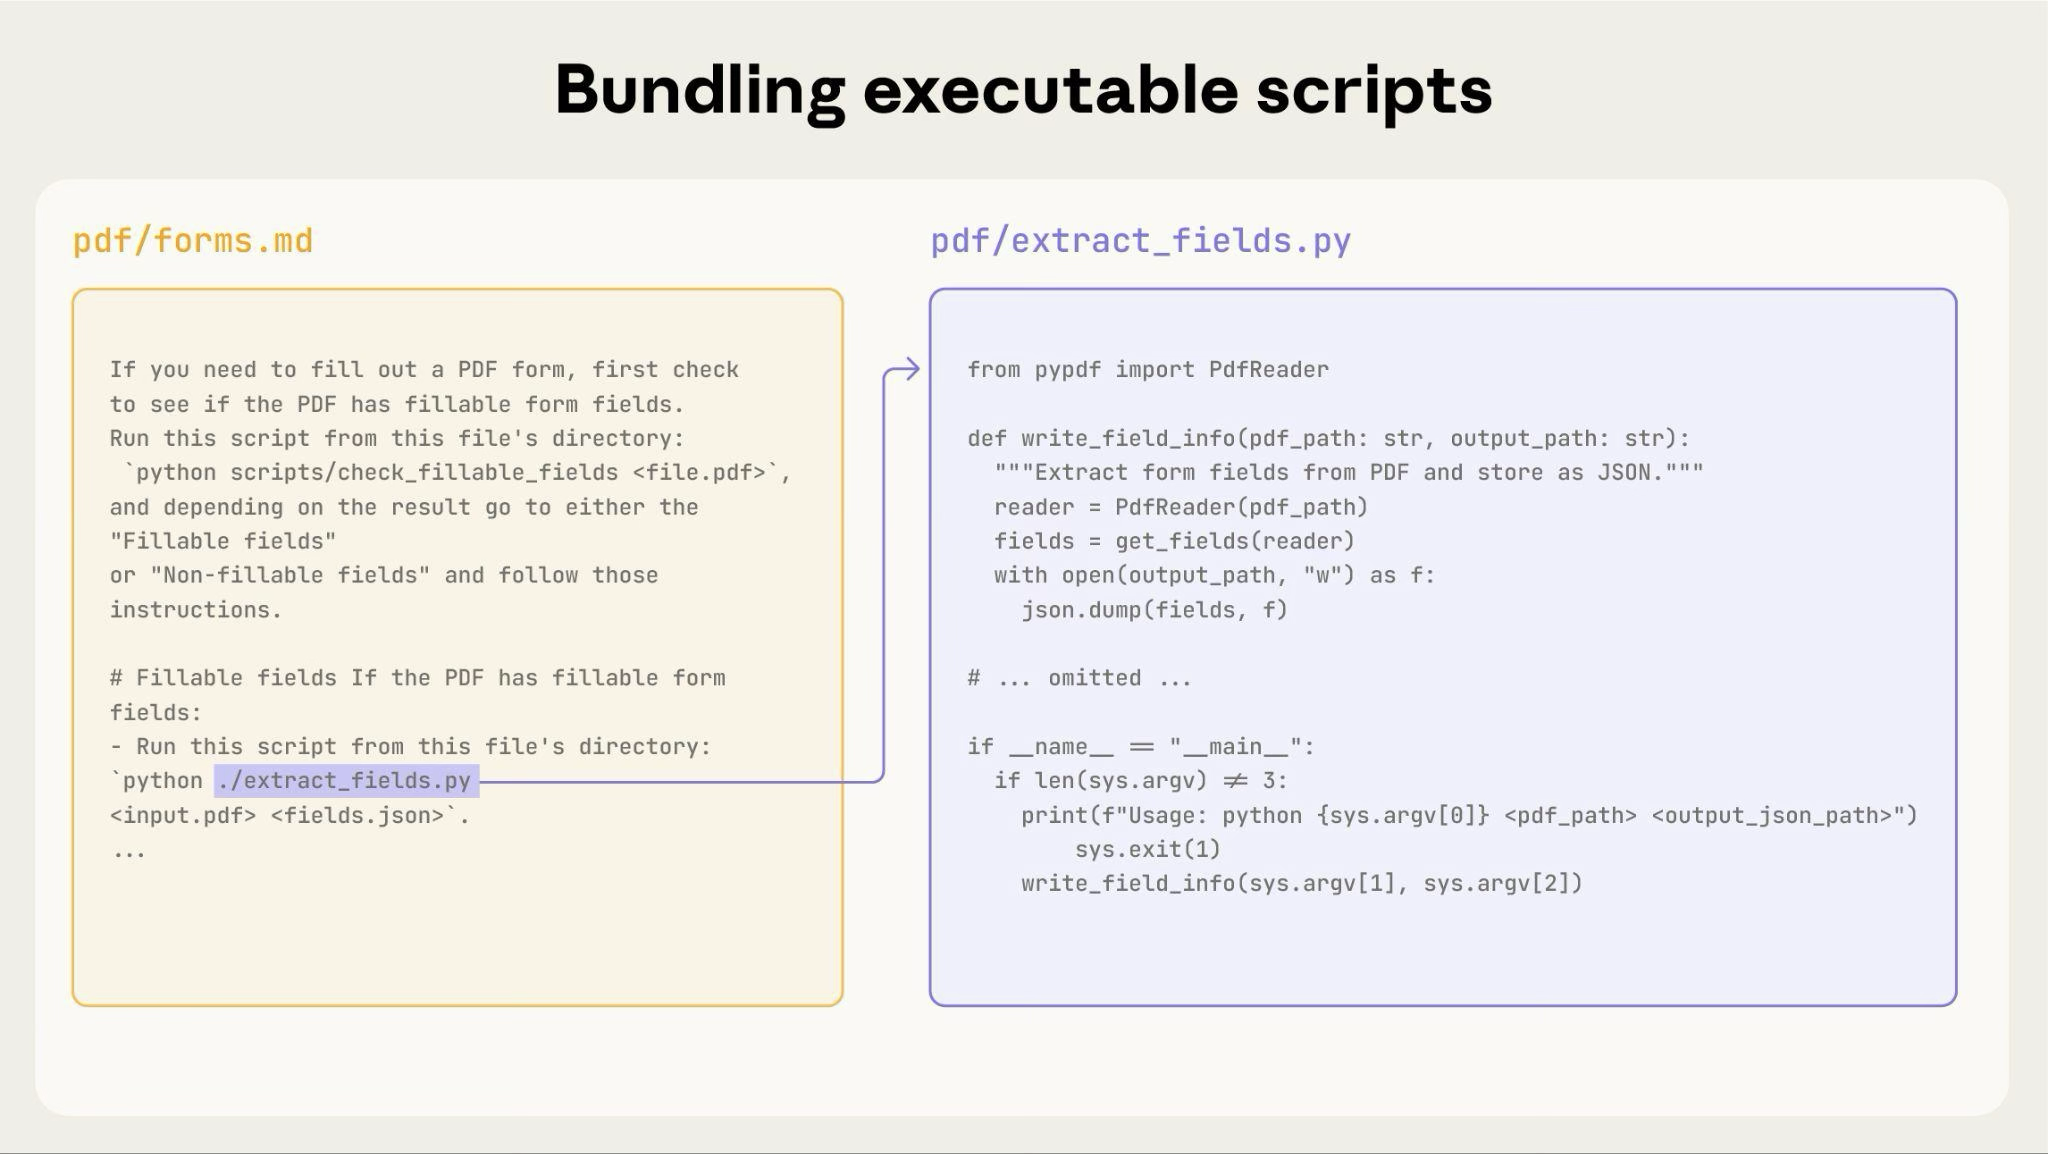
Il diagramma precedente mostra come gli script eseguibili funzionano insieme ai file di istruzioni. Il file di istruzioni (forms.md) referenzia lo script e Claude può eseguirlo senza caricarne il contenuto nel contesto.
Distinzione importante: Chiarisci nelle tue istruzioni se Claude deve:
- Eseguire lo script (più comune): "Esegui
analyze_form.pyper estrarre i campi" - Leggerlo come riferimento (per logica complessa): "Vedi
analyze_form.pyper l'algoritmo di estrazione dei campi"
Per la maggior parte degli script di utilità, l'esecuzione è preferibile perché è più affidabile ed efficiente. Consulta la seguente sezione Ambiente di runtime per i dettagli su come funziona l'esecuzione degli script.
Esempio:
## Utility scripts

**analyze_form.py**: Extract all form fields from PDF

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

Output format:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**: Check for overlapping bounding boxes

```bash
python scripts/validate_boxes.py fields.json
# Returns: "OK" or lists conflicts
```

**fill_form.py**: Apply field values to PDF

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```Usa l'analisi visiva
Quando gli input possono essere renderizzati come immagini, fai in modo che Claude li analizzi:
## Form layout analysis

1. Convert PDF to images:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. Analyze each page image to identify form fields
3. Claude can see field locations and types visuallyLe capacità di visione di Claude aiutano ad analizzare layout e strutture.
Crea output intermedi verificabili
Quando Claude esegue compiti complessi e aperti, può commettere errori. Il pattern "pianifica-valida-esegui" intercetta gli errori precocemente facendo prima creare a Claude un piano in un formato strutturato, poi validando quel piano con uno script prima di eseguirlo.
Esempio: Immagina di chiedere a Claude di aggiornare 50 campi di un modulo in un PDF in base a un foglio di calcolo. Senza validazione, Claude potrebbe referenziare campi inesistenti, creare valori in conflitto, tralasciare campi obbligatori o applicare gli aggiornamenti in modo errato.
Soluzione: Usa il pattern di workflow mostrato in precedenza (compilazione di moduli PDF), ma aggiungi un file intermedio changes.json che viene validato prima di applicare le modifiche. Il workflow diventa: analizza → crea il file del piano → valida il piano → esegui → verifica.
Perché questo pattern funziona:
- Intercetta gli errori precocemente: La validazione trova i problemi prima che le modifiche vengano applicate
- Verificabile dalla macchina: Gli script forniscono una verifica oggettiva
- Pianificazione reversibile: Claude può iterare sul piano senza toccare gli originali
- Debug chiaro: I messaggi di errore indicano problemi specifici
Quando usarlo: Operazioni batch, modifiche distruttive, regole di validazione complesse, operazioni ad alto rischio.
Suggerimento di implementazione: Rendi gli script di validazione verbosi con messaggi di errore specifici come "Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed" per aiutare Claude a correggere i problemi.
Dipendenze dei pacchetti
Le Skills vengono eseguite nell'ambiente di esecuzione del codice con limitazioni specifiche della piattaforma:
- claude.ai: Può installare pacchetti da npm e PyPI e scaricare da repository GitHub
- Claude API: Non ha accesso alla rete né installazione di pacchetti a runtime
Elenca i pacchetti richiesti nel tuo SKILL.md e verifica che siano disponibili nella documentazione dello strumento di esecuzione del codice.
Ambiente di runtime
Le Skills vengono eseguite in un ambiente di esecuzione del codice con accesso al filesystem, comandi bash e capacità di esecuzione del codice. Per la spiegazione concettuale di questa architettura, consulta L'architettura delle Skills nella panoramica.
Come questo influenza il tuo authoring:
Come Claude accede alle Skills:
- Metadati precaricati: All'avvio, il nome e la descrizione dal frontmatter YAML di tutte le Skills vengono caricati nel prompt di sistema
- File letti su richiesta: Claude usa gli strumenti bash Read per accedere a SKILL.md e ad altri file dal filesystem quando necessario
- Script eseguiti in modo efficiente: Gli script di utilità possono essere eseguiti tramite bash senza caricarne il contenuto completo nel contesto. Solo l'output dello script consuma token
- Nessuna penalità di contesto per file grandi: File di riferimento, dati o documentazione non consumano token di contesto finché non vengono effettivamente letti
- I percorsi dei file contano: Claude naviga la directory della tua skill come un filesystem. Usa le barre (
reference/guide.md), non le barre rovesciate - Dai ai file nomi descrittivi: Usa nomi che indichino il contenuto:
form_validation_rules.md, nondoc2.md - Organizza per l'individuazione: Struttura le directory per dominio o funzionalità
- Buono:
reference/finance.md,reference/sales.md - Cattivo:
docs/file1.md,docs/file2.md
- Buono:
- Includi risorse complete: Includi documentazione API completa, esempi estesi, grandi dataset; nessuna penalità di contesto finché non vi si accede
- Preferisci gli script per operazioni deterministiche: Scrivi
validate_form.pyinvece di chiedere a Claude di generare codice di validazione - Rendi chiara l'intenzione di esecuzione:
- "Esegui
analyze_form.pyper estrarre i campi" (esegui) - "Vedi
analyze_form.pyper l'algoritmo di estrazione" (leggi come riferimento)
- "Esegui
- Testa i pattern di accesso ai file: Verifica che Claude possa navigare la struttura della tua directory testando con richieste reali
Esempio:
bigquery-skill/SKILL.md(panoramica, rimanda ai file di riferimento)reference/finance.md(metriche dei ricavi)sales.md(dati della pipeline)product.md(analisi di utilizzo)
Quando l'utente chiede dei ricavi, Claude legge SKILL.md, vede il riferimento a reference/finance.md e chiama bash per leggere solo quel file. I file sales.md e product.md rimangono sul filesystem, consumando zero token di contesto finché non servono. Questo modello basato su filesystem è ciò che abilita la progressive disclosure. Claude può navigare e caricare selettivamente esattamente ciò che ogni compito richiede.
Per i dettagli completi sull'architettura tecnica, consulta Come funzionano le Skills nella panoramica delle Skills.
Riferimenti agli strumenti MCP
Se la tua Skill usa strumenti MCP (Model Context Protocol), usa sempre nomi di strumenti completamente qualificati per evitare errori "tool not found".
Formato: ServerName:tool_name
Esempio:
Use the BigQuery:bigquery_schema tool to retrieve table schemas.
Use the GitHub:create_issue tool to create issues.Dove:
BigQueryeGitHubsono nomi di server MCPbigquery_schemaecreate_issuesono i nomi degli strumenti all'interno di quei server
Senza il prefisso del server, Claude potrebbe non riuscire a localizzare lo strumento, specialmente quando sono disponibili più server MCP.
Evita di presumere che gli strumenti siano installati
Non presumere che i pacchetti siano disponibili:
**Bad example: Assumes installation**:
"Use the pdf library to process the file."

**Good example: Explicit about dependencies**:
"Install required package: `pip install pypdf`

Then use it:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```"Note tecniche
Requisiti del frontmatter YAML
Il frontmatter di SKILL.md richiede i campi name e description con regole di validazione specifiche:
name: Massimo 64 caratteri, solo lettere minuscole/numeri/trattini, nessun tag XML, nessuna parola riservatadescription: Massimo 1.024 caratteri, non vuoto, nessun tag XML
Consulta la panoramica delle Skills per i dettagli completi sulla struttura.
Budget di token
Mantieni il corpo di SKILL.md sotto le 500 righe per prestazioni ottimali. Se il tuo contenuto supera questo limite, suddividilo in file separati usando i pattern di progressive disclosure descritti in precedenza. Per i dettagli architetturali, consulta la panoramica delle Skills.
Checklist per Skills efficaci
Prima di condividere una Skill, verifica:
Qualità di base
- La descrizione è specifica e include i termini chiave
- La descrizione include sia cosa fa la Skill sia quando usarla
- Il corpo di SKILL.md è sotto le 500 righe
- I dettagli aggiuntivi sono in file separati (se necessario)
- Nessuna informazione sensibile al tempo (o nella sezione "vecchi pattern")
- Terminologia coerente in tutto il documento
- Gli esempi sono concreti, non astratti
- I riferimenti ai file sono a un solo livello di profondità
- Progressive disclosure usata in modo appropriato
- I workflow hanno passaggi chiari
Codice e script
- Gli script risolvono i problemi invece di delegarli a Claude
- La gestione degli errori è esplicita e utile
- Nessuna "costante voodoo" (tutti i valori giustificati)
- Pacchetti richiesti elencati nelle istruzioni e verificati come disponibili
- Gli script hanno una documentazione chiara
- Nessun percorso in stile Windows (tutte barre)
- Passaggi di validazione/verifica per le operazioni critiche
- Cicli di feedback inclusi per i compiti critici per la qualità
Test
- Almeno tre valutazioni create
- Testata con Haiku, Sonnet e Opus
- Testata con scenari di utilizzo reali
- Feedback del team incorporato (se applicabile)
Prossimi passi
Crea la tua prima Skill
Crea e gestisci le Skills in Claude Code
Carica e usa le Skills in modo programmatico
Was this page helpful?