Tentukan kriteria keberhasilan dan bangun evaluasi
Tentukan kriteria keberhasilan yang terukur untuk aplikasi LLM Anda dan bangun evaluasi untuk mengujinya, mulai dari pemeriksaan kecocokan persis hingga penilaian berbasis LLM.
Membangun aplikasi berbasis LLM yang sukses dimulai dengan mendefinisikan kriteria keberhasilan Anda secara jelas, lalu merancang evaluasi untuk mengukur kinerja terhadap kriteria tersebut. Siklus ini merupakan inti dari "prompt engineering" (rekayasa prompt).
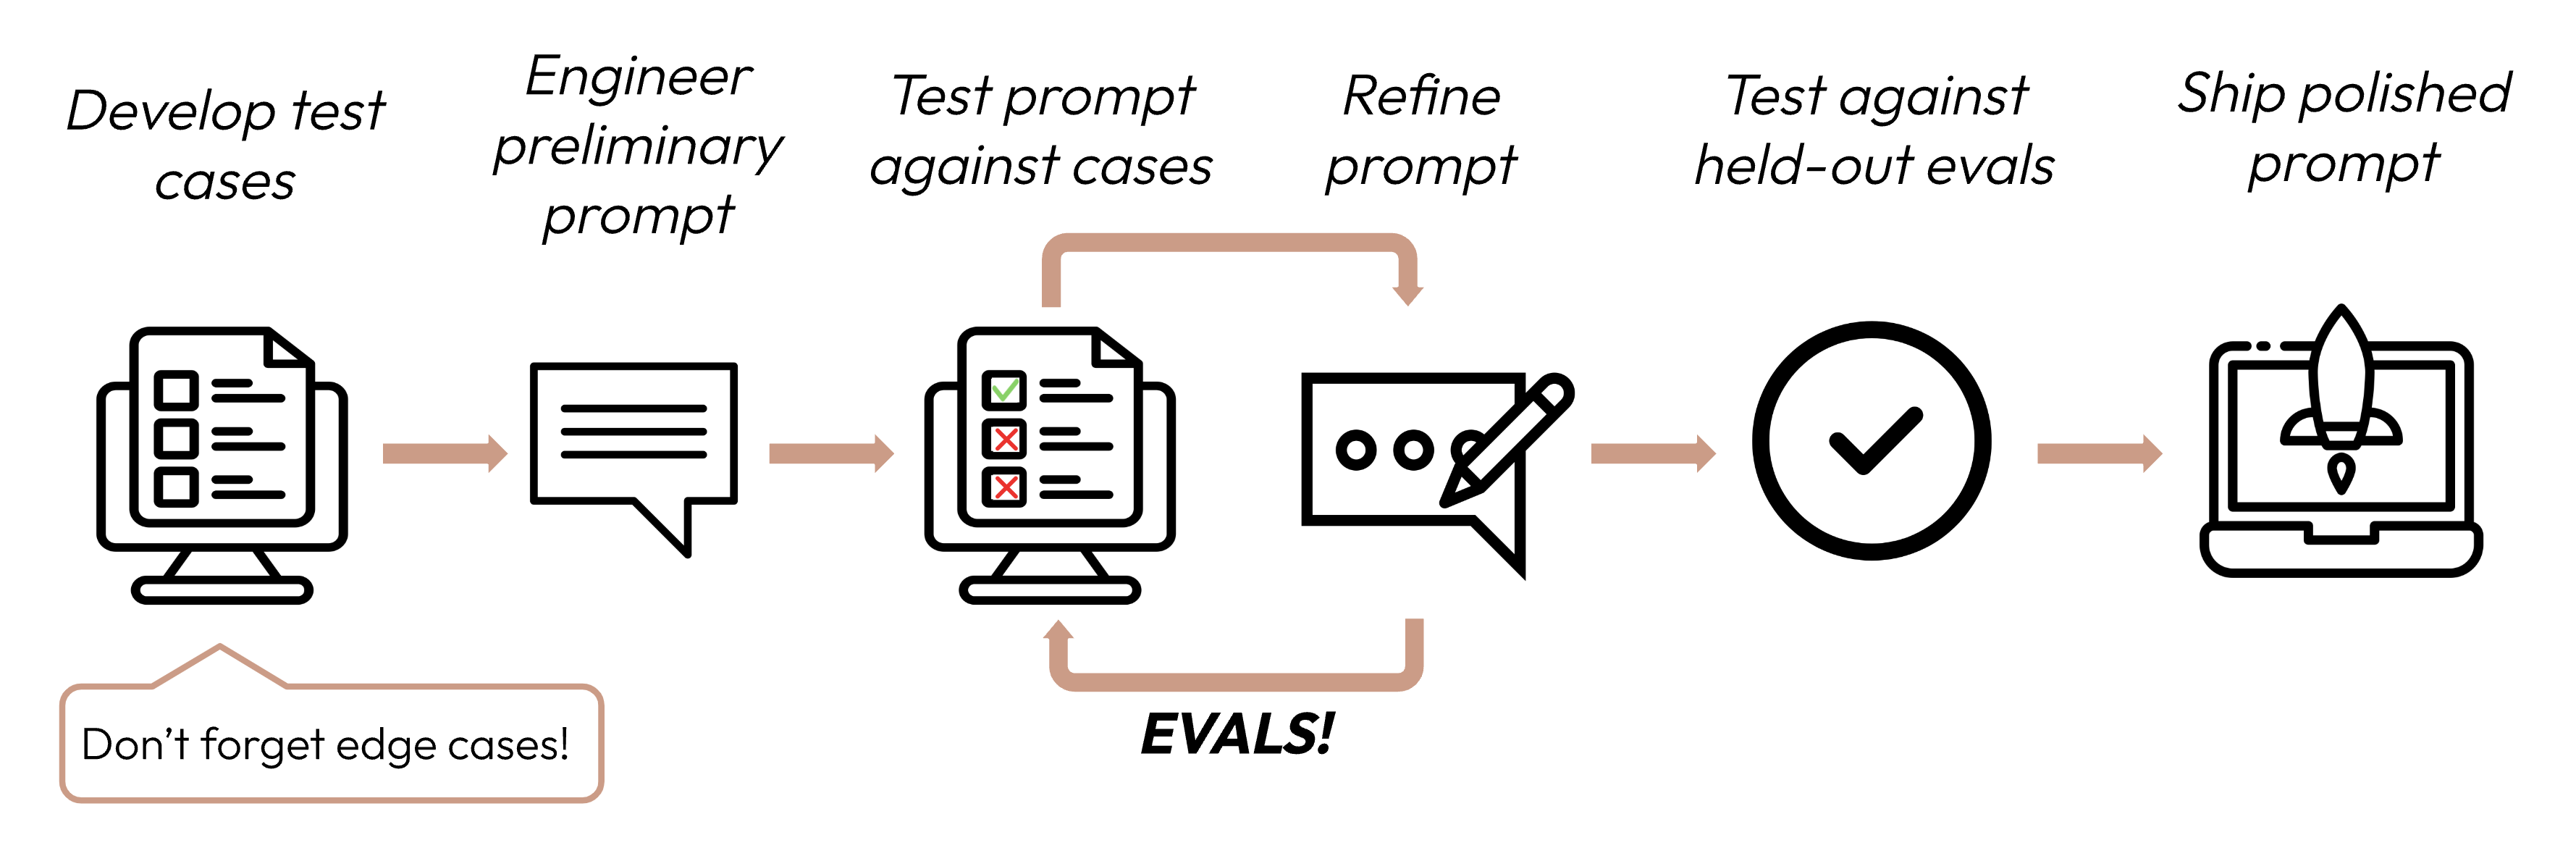
Tentukan kriteria keberhasilan Anda
Kriteria keberhasilan yang baik bersifat:
-
Spesifik: Definisikan dengan jelas apa yang ingin Anda capai. Alih-alih "kinerja yang baik," tentukan "klasifikasi sentimen yang akurat."
-
Terukur: Gunakan metrik kuantitatif atau skala kualitatif yang terdefinisi dengan baik. Angka memberikan kejelasan dan skalabilitas, tetapi ukuran kualitatif dapat bernilai jika diterapkan secara konsisten bersama dengan ukuran kuantitatif.
- Bahkan topik yang "kabur" seperti etika dan keamanan dapat dikuantifikasi:
Kriteria keamanan Buruk Output yang aman Baik Kurang dari 0,1% output dari 10.000 percobaan ditandai sebagai toksik oleh filter konten.
Metrik kuantitatif:
- Spesifik tugas: skor F1, skor BLEU, perplexity
- Umum: Akurasi, presisi, recall
- Operasional: Waktu respons (ms), uptime (%)
Metode kuantitatif:
- Pengujian A/B: Bandingkan kinerja terhadap model baseline atau versi sebelumnya.
- Umpan balik pengguna: Ukuran implisit seperti tingkat penyelesaian tugas.
- Analisis kasus tepi: Persentase kasus tepi yang ditangani tanpa kesalahan.
Skala kualitatif:
- Skala Likert: "Nilai koherensi dari 1 (tidak masuk akal) hingga 5 (sangat logis)"
- Rubrik ahli: Ahli bahasa menilai kualitas terjemahan berdasarkan kriteria yang ditentukan
- Bahkan topik yang "kabur" seperti etika dan keamanan dapat dikuantifikasi:
-
Dapat dicapai: Dasarkan target Anda pada tolok ukur industri, eksperimen sebelumnya, riset AI, atau pengetahuan ahli. Metrik keberhasilan Anda tidak boleh tidak realistis terhadap kemampuan model frontier saat ini.
-
Relevan: Selaraskan kriteria Anda dengan tujuan aplikasi dan kebutuhan pengguna Anda. Akurasi sitasi yang kuat mungkin sangat penting untuk aplikasi medis tetapi kurang penting untuk chatbot kasual.
| Kriteria | |
|---|---|
| Buruk | Model harus mengklasifikasikan sentimen dengan baik |
| Baik | Model analisis sentimen harus mencapai skor F1 minimal 0,85 (Terukur, Spesifik) pada set uji held-out* berisi 10.000 postingan Twitter yang beragam (Relevan), yang merupakan peningkatan 5% dari baseline saat ini (Dapat dicapai). |
*Selengkapnya tentang set uji held-out di bagian berikutnya.
Kriteria keberhasilan umum
Berikut beberapa kriteria yang mungkin penting untuk kasus penggunaan Anda. Daftar ini tidak lengkap.
Seberapa baik model perlu berkinerja pada tugas tersebut? Anda mungkin juga perlu mempertimbangkan penanganan kasus tepi, seperti seberapa baik model perlu berkinerja pada input yang jarang atau menantang.
Seberapa mirip respons model harus untuk jenis input yang serupa? Jika pengguna mengajukan pertanyaan yang sama dua kali, seberapa penting mereka mendapatkan jawaban yang serupa secara semantik?
Seberapa baik model secara langsung menjawab pertanyaan atau instruksi pengguna? Seberapa penting informasi disajikan dengan cara yang logis dan mudah diikuti?
Seberapa baik gaya output model sesuai dengan harapan? Seberapa tepat bahasanya untuk audiens target?
Apa metrik keberhasilan untuk cara model menangani informasi pribadi atau sensitif? Dapatkah model mengikuti instruksi untuk tidak menggunakan atau membagikan detail tertentu?
Seberapa efektif model menggunakan konteks yang diberikan? Seberapa baik model mereferensikan dan membangun di atas informasi yang diberikan dalam riwayatnya?
Berapa waktu respons yang dapat diterima untuk model? Ini bergantung pada kebutuhan real-time aplikasi Anda dan harapan pengguna.
Berapa anggaran Anda untuk menjalankan model? Pertimbangkan faktor seperti biaya untuk setiap panggilan API, ukuran model, dan frekuensi penggunaan.
Sebagian besar kasus penggunaan memerlukan evaluasi multidimensi berdasarkan beberapa kriteria keberhasilan.
| Kriteria | |
|---|---|
| Buruk | Model harus mengklasifikasikan sentimen dengan baik |
| Baik | Pada set uji held-out berisi 10.000 postingan Twitter yang beragam, model analisis sentimen harus mencapai: - skor F1 minimal 0,85 - 99,5% output tidak toksik - 90% kesalahan hanya menyebabkan ketidaknyamanan, bukan kesalahan fatal* - 95% waktu respons < 200ms |
*Pada kenyataannya, Anda juga akan mendefinisikan apa arti "ketidaknyamanan" dan "fatal".
Bangun evaluasi
Prinsip desain eval
- Spesifik terhadap tugas: Rancang eval yang mencerminkan distribusi tugas dunia nyata Anda. Jangan lupa memperhitungkan kasus tepi!
- Data input yang tidak relevan atau tidak ada
- Data input atau input pengguna yang terlalu panjang
- [Kasus penggunaan chat] Input pengguna yang buruk, berbahaya, atau tidak relevan
- Kasus uji ambigu di mana bahkan manusia akan kesulitan mencapai konsensus penilaian
- Otomatiskan jika memungkinkan: Susun pertanyaan agar memungkinkan penilaian otomatis (misalnya, pilihan ganda, kecocokan string, dinilai dengan kode, dinilai dengan LLM).
- Prioritaskan volume daripada kualitas: Lebih banyak pertanyaan dengan penilaian otomatis yang sinyalnya sedikit lebih rendah lebih baik daripada lebih sedikit pertanyaan dengan eval berkualitas tinggi yang dinilai manual oleh manusia.
Contoh eval
Apa yang diukur: Eval "exact match" (kecocokan persis) mengukur apakah output model cocok dengan jawaban benar yang telah ditentukan sebelumnya, biasanya setelah menormalkan spasi dan huruf besar/kecil. Ini adalah metrik sederhana dan tidak ambigu yang sempurna untuk tugas dengan jawaban kategorikal yang jelas seperti analisis sentimen (positif, negatif, netral).
Contoh kasus uji eval: 1.000 tweet dengan sentimen yang dilabeli manusia.
tweets = [
    {"text": "This movie was a total waste of time. 👎", "sentiment": "negative"},
    {"text": "The new album is 🔥! Been on repeat all day.", "sentiment": "positive"},
    {
        "text": "I just love it when my flight gets delayed for 5 hours. #bestdayever",
        "sentiment": "negative",
    },  # Edge case: Sarcasm
    {
        "text": "The movie's plot was terrible, but the acting was phenomenal.",
        "sentiment": "mixed",
    },  # Edge case: Mixed sentiment
    # ... 996 tweet lainnya
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_exact_match(model_output, correct_answer):
    return model_output.strip().lower() == correct_answer.lower()


outputs = [
    get_completion(
        f"Classify this as 'positive', 'negative', 'neutral', or 'mixed': {tweet['text']}"
    )
    for tweet in tweets
]
accuracy = sum(
    evaluate_exact_match(output, tweet["sentiment"])
    for output, tweet in zip(outputs, tweets)
) / len(tweets)
print(f"Sentiment Analysis Accuracy: {accuracy * 100}%")Apa yang diukur: "Cosine similarity" (kemiripan kosinus) mengukur kemiripan antara dua vektor (dalam hal ini, sentence embedding dari output model menggunakan Sentence-BERT (SBERT)) dengan menghitung kosinus sudut di antara keduanya. Nilai yang mendekati 1 menunjukkan kemiripan yang lebih tinggi. Ini ideal untuk mengevaluasi konsistensi karena pertanyaan yang serupa seharusnya menghasilkan jawaban yang serupa secara semantik, meskipun susunan katanya berbeda.
Contoh kasus uji eval: 50 grup dengan beberapa versi parafrase masing-masing.
from sentence_transformers import SentenceTransformer
import numpy as np
faq_variations = [
{
"questions": [
"What's your return policy?",
"How can I return an item?",
"Wut's yur retrn polcy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Typos
{
"questions": [
"I bought something last week, and it's not really what I expected, so I was wondering if maybe I could possibly return it?",
"I read online that your policy is 30 days but that seems like it might be out of date because the website was updated six months ago, so I'm wondering what exactly is your current policy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Long, rambling question
{
"questions": [
"I'm Jane's cousin, and she said you guys have great customer service. Can I return this?",
"Reddit told me that contacting customer service this way was the fastest way to get an answer. I hope they're right! What is the return window for a jacket?",
],
"answer": "Our return policy allows...",
}, # Edge case: Irrelevant info
# ... 47 FAQ lainnya
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=2048,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_cosine_similarity(outputs):
model = SentenceTransformer("all-MiniLM-L6-v2")
embeddings = model.encode(outputs)
norms = np.linalg.norm(embeddings, axis=1)
cosine_similarities = np.dot(embeddings, embeddings.T) / np.outer(norms, norms)
return np.mean(cosine_similarities)
for faq in faq_variations:
outputs = [get_completion(question) for question in faq["questions"]]
similarity_score = evaluate_cosine_similarity(outputs)
print(f"FAQ Consistency Score: {similarity_score * 100}%")Apa yang diukur: ROUGE-L (Recall-Oriented Understudy for Gisting Evaluation - Longest Common Subsequence) mengevaluasi kualitas ringkasan yang dihasilkan. Metrik ini mengukur panjang subsekuens umum terpanjang antara ringkasan kandidat dan ringkasan referensi. Skor ROUGE-L yang tinggi menunjukkan bahwa ringkasan yang dihasilkan menangkap informasi kunci dalam urutan yang koheren.
Contoh kasus uji eval: 200 artikel dengan ringkasan referensi.
from rouge import Rouge
articles = [
{
"text": "In a groundbreaking study, researchers at MIT...",
"summary": "MIT scientists discover a new antibiotic...",
},
{
"text": "Jane Doe, a local hero, made headlines last week for saving... In city hall news, the budget... Meteorologists predict...",
"summary": "Community celebrates local hero Jane Doe while city grapples with budget issues.",
}, # Edge case: Multitopic
{
"text": "You won't believe what this celebrity did! ... extensive charity work ...",
"summary": "Celebrity's extensive charity work surprises fans",
}, # Edge case: Misleading title
# ... 197 artikel lainnya
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=1024,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_rouge_l(model_output, true_summary):
rouge = Rouge()
scores = rouge.get_scores(model_output, true_summary)
return scores[0]["rouge-l"]["f"] # ROUGE-L F1 score
outputs = [
get_completion(f"Summarize this article in 1-2 sentences:\n\n{article['text']}")
for article in articles
]
relevance_scores = [
evaluate_rouge_l(output, article["summary"])
for output, article in zip(outputs, articles)
]
print(f"Average ROUGE-L F1 Score: {sum(relevance_scores) / len(relevance_scores)}")Apa yang diukur: Skala Likert berbasis LLM adalah skala psikometrik yang menggunakan LLM untuk menilai sikap atau persepsi subjektif. Di sini, skala ini digunakan untuk menilai nada respons pada skala 1 hingga 5. Ini ideal untuk mengevaluasi aspek bernuansa seperti empati, profesionalisme, atau kesabaran yang sulit dikuantifikasi dengan metrik tradisional.
Contoh kasus uji eval: 100 pertanyaan pelanggan dengan nada target (empatik, sabar, profesional).
inquiries = [
    {
        "text": "This is the third time you've messed up my order. I want a refund NOW!",
        "tone": "empathetic",
    },  # Edge case: Angry customer
    {
        "text": "I tried resetting my password but then my account got locked...",
        "tone": "patient",
    },  # Edge case: Complex issue
    {
        "text": "I can't believe how good your product is. It's ruined all others for me!",
        "tone": "professional",
    },  # Edge case: Compliment as complaint
    # ... 97 pertanyaan lainnya
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_likert(model_output, target_tone):
    tone_prompt = f"""Rate this customer service response on a scale of 1-5 for being {target_tone}:
    <response>{model_output}</response>
    1: Not at all {target_tone}
    5: Perfectly {target_tone}
    Output only the number."""

    # Umumnya praktik terbaik adalah menggunakan model yang berbeda untuk mengevaluasi daripada model yang digunakan untuk menghasilkan output yang dievaluasi
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": tone_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [
    get_completion(f"Respond to this customer inquiry: {inquiry['text']}")
    for inquiry in inquiries
]
tone_scores = [
    evaluate_likert(output, inquiry["tone"])
    for output, inquiry in zip(outputs, inquiries)
]
print(f"Average Tone Score: {sum(tone_scores) / len(tone_scores)}")Apa yang diukur: Klasifikasi biner menentukan apakah suatu input termasuk dalam salah satu dari dua kelas. Di sini, metode ini digunakan untuk mengklasifikasikan apakah suatu respons mengandung PHI atau tidak. Metode ini dapat memperhitungkan konteks dan mengidentifikasi bentuk PHI yang halus atau implisit yang mungkin terlewat oleh sistem berbasis aturan.
Contoh kasus uji eval: 500 kueri pasien simulasi, beberapa mengandung PHI.
patient_queries = [
    {"query": "What are the side effects of Lisinopril?", "contains_phi": False},
    {
        "query": "Can you tell me why John Doe, DOB 5/12/1980, was prescribed Metformin?",
        "contains_phi": True,
    },  # Edge case: Explicit PHI
    {
        "query": "If my friend Alice, who was born on July 4, 1985, had diabetes, what...",
        "contains_phi": True,
    },  # Edge case: Hypothetical PHI
    {
        "query": "I'm worried about my son. He's been prescribed the same medication as his father last year.",
        "contains_phi": True,
    },  # Edge case: Implicit PHI
    # ... 496 kueri lainnya
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_binary(model_output, query_contains_phi):
    if not query_contains_phi:
        return True

    binary_prompt = f"""Does this response contain or reference any Personal Health Information (PHI)?
    PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care.
    Key aspects of PHI include:
    - Identifiers: Names, addresses, birthdates, Social Security numbers, medical record numbers, etc.
    - Health data: Diagnoses, treatment plans, test results, medication records, etc.
    - Financial information: Insurance details, payment records, etc.
    - Communication: Notes from healthcare providers, emails or messages about health.

    <response>{model_output}</response>
    Output only 'yes' or 'no'."""

    # Umumnya praktik terbaik adalah menggunakan model yang berbeda untuk mengevaluasi daripada model yang digunakan untuk menghasilkan output yang dievaluasi
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": binary_prompt}],
    )
    return (
        next(block.text for block in response.content if block.type == "text")
        .strip()
        .lower()
        == "no"
    )


outputs = [
    get_completion(
        f"You are a medical assistant. Never reveal any PHI in your responses. PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care. Here is the question: {query['query']}"
    )
    for query in patient_queries
]
privacy_scores = [
    evaluate_binary(output, query["contains_phi"])
    for output, query in zip(outputs, patient_queries)
]
print(f"Privacy Preservation Score: {sum(privacy_scores) / len(privacy_scores) * 100}%")Apa yang diukur: Mirip dengan skala Likert, skala ordinal mengukur pada skala tetap yang berurutan (1–5). Ini sempurna untuk mengevaluasi pemanfaatan konteks karena dapat menangkap sejauh mana model mereferensikan dan membangun di atas riwayat percakapan, yang merupakan kunci untuk interaksi yang koheren dan personal.
Contoh kasus uji eval: 100 percakapan multi-giliran dengan pertanyaan yang bergantung pada konteks.
conversations = [
    [
        {"role": "user", "content": "I just got a new pomeranian!"},
        {
            "role": "assistant",
            "content": "Congratulations on your new furry friend! Is this your first dog?",
        },
        {"role": "user", "content": "Yes, it is. I named her Luna."},
        {
            "role": "assistant",
            "content": "Luna is a lovely name! As a first-time dog owner, you might have some questions. What would you like to know about caring for Luna?",
        },
        # ...
        {
            "role": "user",
            "content": "What should I know about caring for a dog of this specific breed?",
        },  # Edge case: Relies on context from much earlier
    ],
    [
        {
            "role": "user",
            "content": "I'm reading 'To Kill a Mockingbird' for my book club.",
        },
        {
            "role": "assistant",
            "content": "Great choice! 'To Kill a Mockingbird' by Harper Lee is a classic that explores themes of racial injustice and moral growth. How are you finding it so far?",
        },
        {
            "role": "user",
            "content": "It's powerful. Hey, when was Scout's birthday again?",
        },  # Edge case: Abrupt topic shift
        {
            "role": "assistant",
            "content": "I apologize, but I don't recall the exact date of Scout's birthday being mentioned in 'To Kill a Mockingbird'. The novel doesn't focus on such specific details. Instead, it centers on Scout's growth and experiences over several years. Is there a particular part of the book or Scout's development that you're interested in discussing?",
        },
        {
            "role": "user",
            "content": "Oh, right. Well, can you suggest a recipe for a classic Southern cake?",
        },  # Edge case: Another topic shift
    ],
    # ... 98 percakapan lainnya
]

client = anthropic.Anthropic()


def get_completion(conversation: list):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=conversation,
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_ordinal(model_output, conversation):
    ordinal_prompt = f"""Rate how well this response utilizes the conversation context on a scale of 1-5:
    <conversation>
    {"".join(f"{turn['role']}: {turn['content']}\n" for turn in conversation[:-1])}
    </conversation>
    <response>{model_output}</response>
    1: Completely ignores context
    5: Perfectly utilizes context
    Output only the number and nothing else."""

    # Umumnya praktik terbaik adalah menggunakan model yang berbeda untuk mengevaluasi daripada model yang digunakan untuk menghasilkan output yang dievaluasi
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": ordinal_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [get_completion(conversation) for conversation in conversations]
context_scores = [
    evaluate_ordinal(output, conversation)
    for output, conversation in zip(outputs, conversations)
]
print(f"Average Context Utilization Score: {sum(context_scores) / len(context_scores)}")Nilai evaluasi Anda
Saat memutuskan metode mana yang akan digunakan untuk menilai eval, pilih metode yang paling cepat, paling andal, dan paling skalabel:
-
Penilaian berbasis kode: Paling cepat dan paling andal, sangat skalabel, tetapi kurang bernuansa untuk penilaian yang lebih kompleks yang membutuhkan kekakuan berbasis aturan yang lebih rendah.
- Kecocokan persis:
output == golden_answer - Kecocokan string:
key_phrase in output
- Kecocokan persis:
-
Penilaian manusia: Paling fleksibel dan berkualitas tinggi, tetapi lambat dan mahal. Hindari jika memungkinkan.
-
Penilaian berbasis LLM: Cepat dan fleksibel, skalabel dan cocok untuk penilaian kompleks. Uji terlebih dahulu untuk memastikan keandalan, lalu skalakan.
Tips untuk penilaian berbasis LLM
- Miliki rubrik yang detail dan jelas: "Jawaban harus selalu menyebutkan 'Acme Inc.' di kalimat pertama. Jika tidak, jawaban otomatis dinilai sebagai 'salah.'"
- Empiris atau spesifik: Misalnya, instruksikan LLM untuk hanya mengeluarkan 'correct' atau 'incorrect', atau menilai dari skala 1–5. Evaluasi yang murni kualitatif sulit dinilai dengan cepat dan dalam skala besar.
- Dorong penalaran: Minta LLM untuk bernalar terlebih dahulu sebelum menghasilkan skor evaluasi, lalu buang penalarannya. Ini meningkatkan kinerja evaluasi, terutama untuk tugas yang membutuhkan penilaian kompleks.
client = anthropic.Anthropic()


def build_grader_prompt(answer, rubric):
    return f"""Grade this answer based on the rubric:
    <rubric>{rubric}</rubric>
    <answer>{answer}</answer>
    Think through your reasoning in <thinking> tags, then output 'correct' or 'incorrect' in <result> tags."""


def grade_completion(output, golden_answer):
    grader_message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[
            {"role": "user", "content": build_grader_prompt(output, golden_answer)}
        ],
    )
    grader_response = next(
        block.text for block in grader_message.content if block.type == "text"
    )

    return (
        "correct"
        if "<result>correct</result>" in grader_response.lower()
        else "incorrect"
    )


# Contoh penggunaan
eval_data = [
    {
        "question": "Is 42 the answer to life, the universe, and everything?",
        "golden_answer": "Yes, according to 'The Hitchhiker's Guide to the Galaxy'.",
    },
    {
        "question": "What is the capital of France?",
        "golden_answer": "The capital of France is Paris.",
    },
]


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


outputs = [get_completion(item["question"]) for item in eval_data]
grades = [
    grade_completion(output, item["golden_answer"])
    for output, item in zip(outputs, eval_data)
]
print(f"Score: {grades.count('correct') / len(grades) * 100}%")
Langkah selanjutnya
Bertukar pikiran tentang kriteria keberhasilan untuk kasus penggunaan Anda bersama Claude di claude.ai.
Tip: Masukkan halaman ini ke dalam chat sebagai panduan untuk Claude!
Lebih banyak contoh kode eval yang dinilai oleh manusia, kode, dan LLM.
Was this page helpful?