Bonnes pratiques de rédaction de Skills
Apprenez à rédiger des Skills efficaces que Claude peut découvrir et utiliser avec succès.
Les bonnes Skills sont concises, bien structurées et testées en conditions réelles d'utilisation. Ce guide fournit des décisions de rédaction pratiques pour vous aider à écrire des Skills que Claude peut découvrir et utiliser efficacement.
Pour le contexte conceptuel sur le fonctionnement des Skills, consultez la présentation des Skills.
Principes fondamentaux
La concision est essentielle
La « context window » (fenêtre de contexte) est un bien commun. Votre Skill partage la fenêtre de contexte avec tout ce que Claude doit savoir par ailleurs, notamment :
- L'invite système
- L'historique de la conversation
- Les métadonnées des autres Skills
- Votre requête proprement dite
Tous les tokens de votre Skill n'ont pas un coût immédiat. Au démarrage, seules les métadonnées (nom et description) de toutes les Skills sont préchargées. Claude ne lit SKILL.md que lorsque la Skill devient pertinente, et ne lit les fichiers supplémentaires qu'en cas de besoin. Cependant, la concision dans SKILL.md reste importante : une fois que Claude l'a chargé, chaque token entre en concurrence avec l'historique de la conversation et le reste du contexte.
Hypothèse par défaut : Claude est déjà très intelligent
N'ajoutez que le contexte dont Claude ne dispose pas déjà. Remettez en question chaque information :
- « Claude a-t-il vraiment besoin de cette explication ? »
- « Puis-je supposer que Claude sait cela ? »
- « Ce paragraphe justifie-t-il son coût en tokens ? »
Bon exemple : concis (environ 50 tokens) :
## Extract PDF text

Use pdfplumber for text extraction:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```Mauvais exemple : trop verbeux (environ 150 tokens) :
## Extract PDF text

PDF (Portable Document Format) files are a common file format that contains
text, images, and other content. To extract text from a PDF, you'll need to
use a library. There are many libraries available for PDF processing, but
pdfplumber is recommended because it's easy to use and handles most cases well.
First, you'll need to install it using pip. Then you can use the code below...La version concise suppose que Claude dispose déjà d'informations sur les PDF et sur le fonctionnement des bibliothèques.
Définir des degrés de liberté appropriés
Adaptez le niveau de spécificité à la fragilité et à la variabilité de la tâche.
Liberté élevée (instructions textuelles) :
À utiliser lorsque :
- Plusieurs approches sont valables
- Les décisions dépendent du contexte
- Des heuristiques guident l'approche
Exemple :
## Code review process

1. Analyze the code structure and organization
2. Check for potential bugs or edge cases
3. Suggest improvements for readability and maintainability
4. Verify adherence to project conventionsLiberté moyenne (pseudocode ou scripts avec paramètres) :
À utiliser lorsque :
- Un modèle préféré existe
- Une certaine variation est acceptable
- La configuration influence le comportement
Exemple :
## Generate report

Use this template and customize as needed:

```python
def generate_report(data, format="markdown", include_charts=True):
    # Process data
    # Generate output in specified format
    # Optionally include visualizations
```Liberté faible (scripts spécifiques, peu ou pas de paramètres) :
À utiliser lorsque :
- Les opérations sont fragiles et sujettes aux erreurs
- La cohérence est critique
- Une séquence spécifique doit être suivie
Exemple :
## Database migration

Run exactly this script:

```bash
python scripts/migrate.py --verify --backup
```

Do not modify the command or add additional flags.Analogie : Imaginez Claude comme un robot explorant un chemin :
- Pont étroit bordé de falaises des deux côtés : Il n'existe qu'une seule façon sûre d'avancer. Fournissez des garde-fous spécifiques et des instructions exactes (liberté faible). Exemple : des migrations de base de données qui doivent s'exécuter dans un ordre précis.
- Champ ouvert sans danger : De nombreux chemins mènent au succès. Donnez une direction générale et faites confiance à Claude pour trouver le meilleur itinéraire (liberté élevée). Exemple : des revues de code où le contexte détermine la meilleure approche.
Tester avec tous les modèles que vous prévoyez d'utiliser
Les Skills agissent comme des compléments aux modèles, leur efficacité dépend donc du modèle sous-jacent. Testez votre Skill avec tous les modèles avec lesquels vous prévoyez de l'utiliser.
Considérations de test par modèle :
- Claude Haiku (rapide, économique) : la Skill fournit-elle suffisamment d'indications ?
- Claude Sonnet (équilibré) : la Skill est-elle claire et efficace ?
- Claude Opus (raisonnement puissant) : la Skill évite-t-elle les explications excessives ?
Ce qui fonctionne parfaitement pour Opus peut nécessiter plus de détails pour Haiku. Si vous prévoyez d'utiliser votre Skill avec plusieurs modèles, visez des instructions qui fonctionnent bien avec chacun d'eux.
Structure d'une Skill
Conventions de nommage
Utilisez des modèles de nommage cohérents pour faciliter la référence aux Skills et les discussions à leur sujet. Envisagez d'utiliser la forme gérondive (verbe + -ing) pour les noms de Skills, car elle décrit clairement l'activité ou la capacité fournie par la Skill.
N'oubliez pas que le champ name ne doit utiliser que des lettres minuscules, des chiffres et des tirets.
Bons exemples de nommage (forme gérondive) :
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
Alternatives acceptables :
- Groupes nominaux :
pdf-processing,spreadsheet-analysis - Orientés action :
process-pdfs,analyze-spreadsheets
À éviter :
- Noms vagues :
helper,utils,tools - Trop génériques :
documents,data,files - Mots réservés :
anthropic-helper,claude-tools - Modèles incohérents au sein de votre collection de Skills
Un nommage cohérent facilite :
- La référence aux Skills dans la documentation et les conversations
- La compréhension en un coup d'œil de ce que fait une Skill
- L'organisation et la recherche parmi plusieurs Skills
- Le maintien d'une bibliothèque de Skills professionnelle et cohérente
Rédiger des descriptions efficaces
Le champ description permet la découverte des Skills et doit inclure à la fois ce que fait la Skill et quand l'utiliser.
Soyez précis et incluez des termes clés. Incluez à la fois ce que fait la Skill et les déclencheurs/contextes spécifiques indiquant quand l'utiliser.
Chaque Skill possède exactement un champ de description. La description est essentielle pour la sélection de la Skill : Claude l'utilise pour choisir la bonne Skill parmi potentiellement plus de 100 Skills disponibles. Votre description doit fournir suffisamment de détails pour que Claude sache quand sélectionner cette Skill, tandis que le reste de SKILL.md fournit les détails d'implémentation.
Exemples efficaces :
Skill de traitement de PDF :
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.Skill d'analyse Excel :
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.Skill d'aide aux commits Git :
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.Évitez les descriptions vagues comme celles-ci :
description: Helps with documentsdescription: Processes datadescription: Does stuff with filesModèles de divulgation progressive
SKILL.md sert de vue d'ensemble qui oriente Claude vers des ressources détaillées selon les besoins, comme la table des matières d'un guide d'intégration. Pour une explication du fonctionnement de la divulgation progressive, consultez Fonctionnement des Skills dans la présentation.
Conseils pratiques :
- Maintenez le corps de SKILL.md sous 500 lignes pour des performances optimales
- Répartissez le contenu dans des fichiers séparés à l'approche de cette limite
- Utilisez les modèles suivants pour organiser efficacement les instructions, le code et les ressources
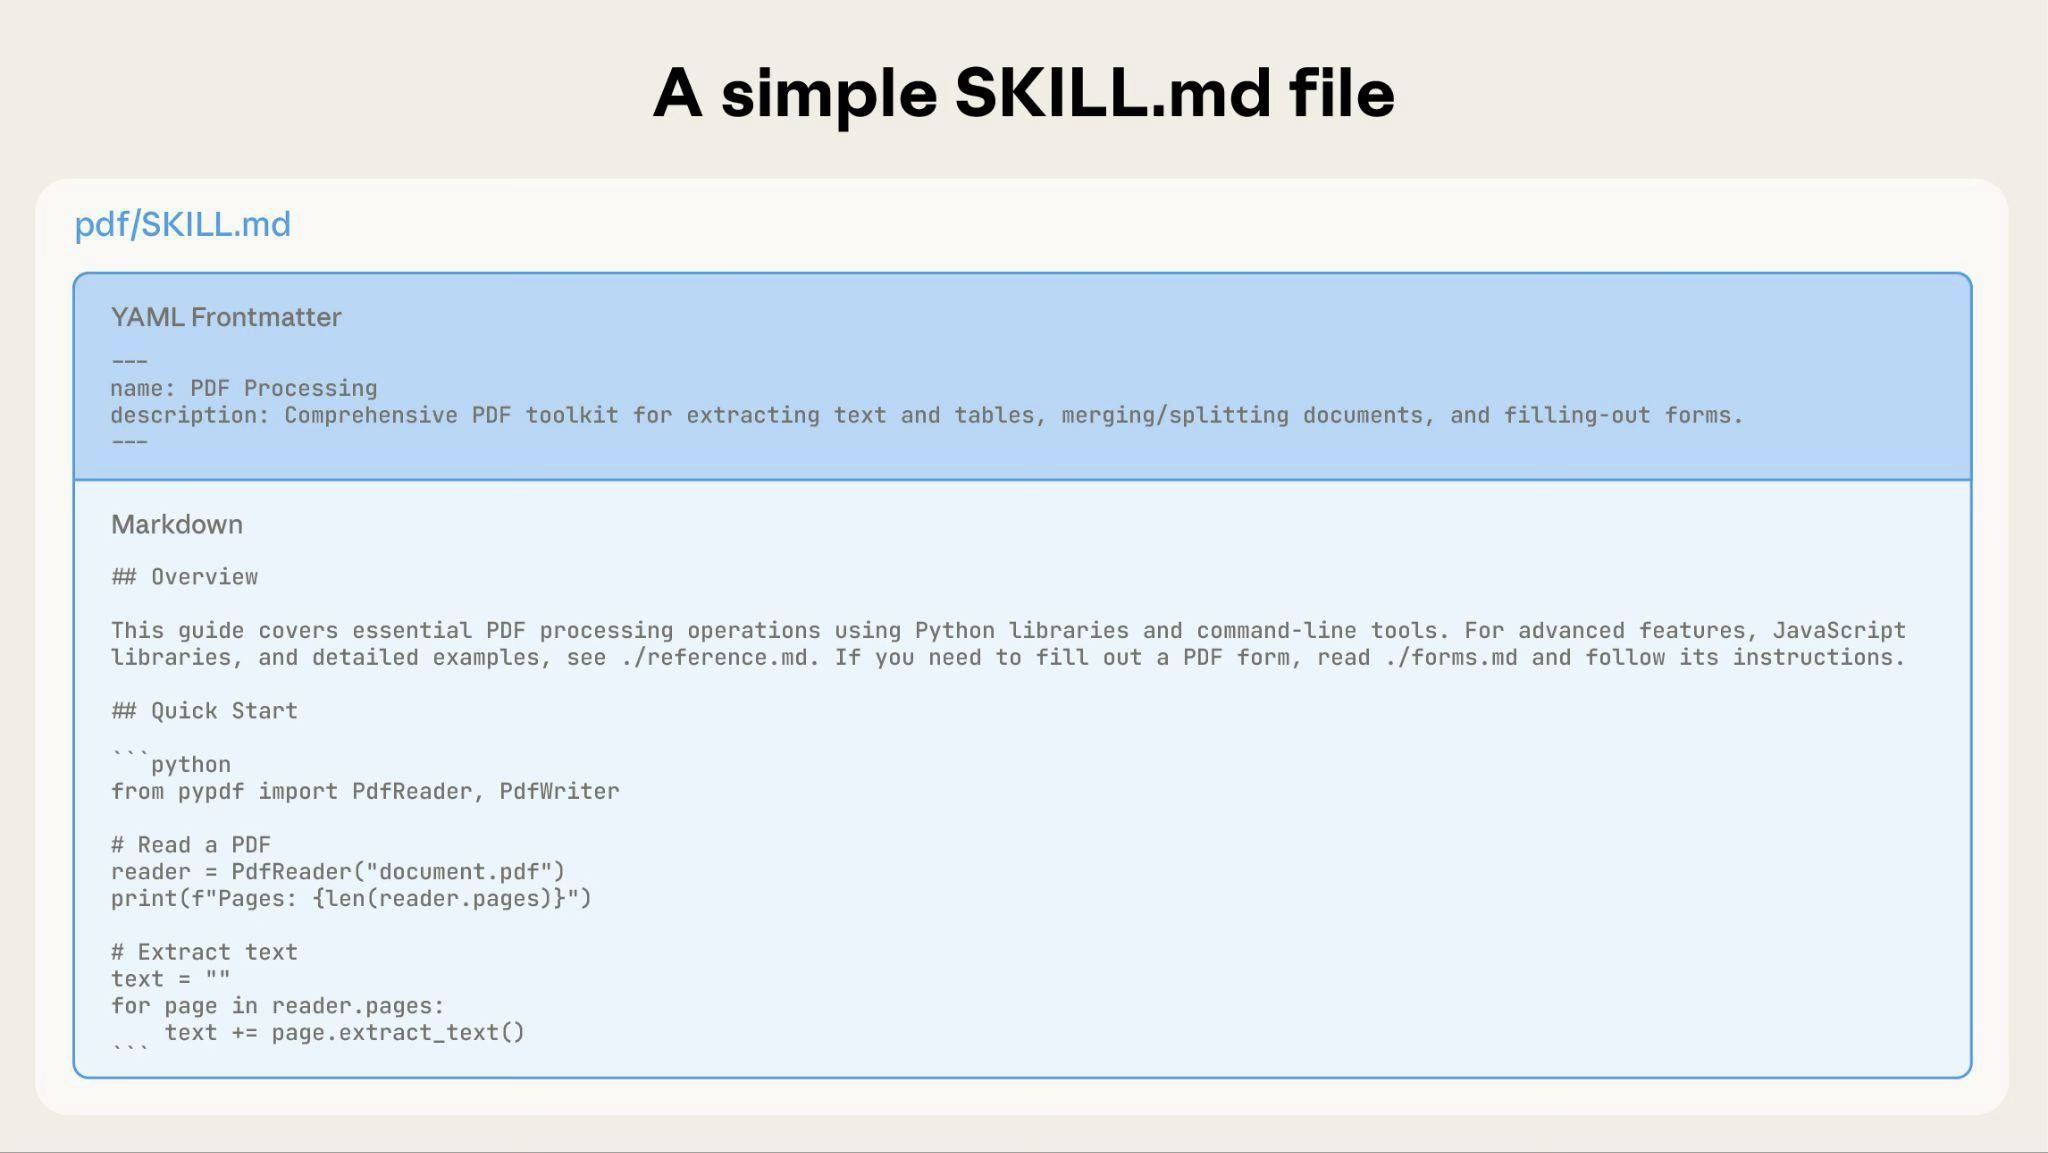
Vue d'ensemble visuelle : du simple au complexe
Une Skill de base commence par un simple fichier SKILL.md contenant des métadonnées et des instructions :
À mesure que votre Skill grandit, vous pouvez regrouper du contenu supplémentaire que Claude ne charge qu'en cas de besoin :
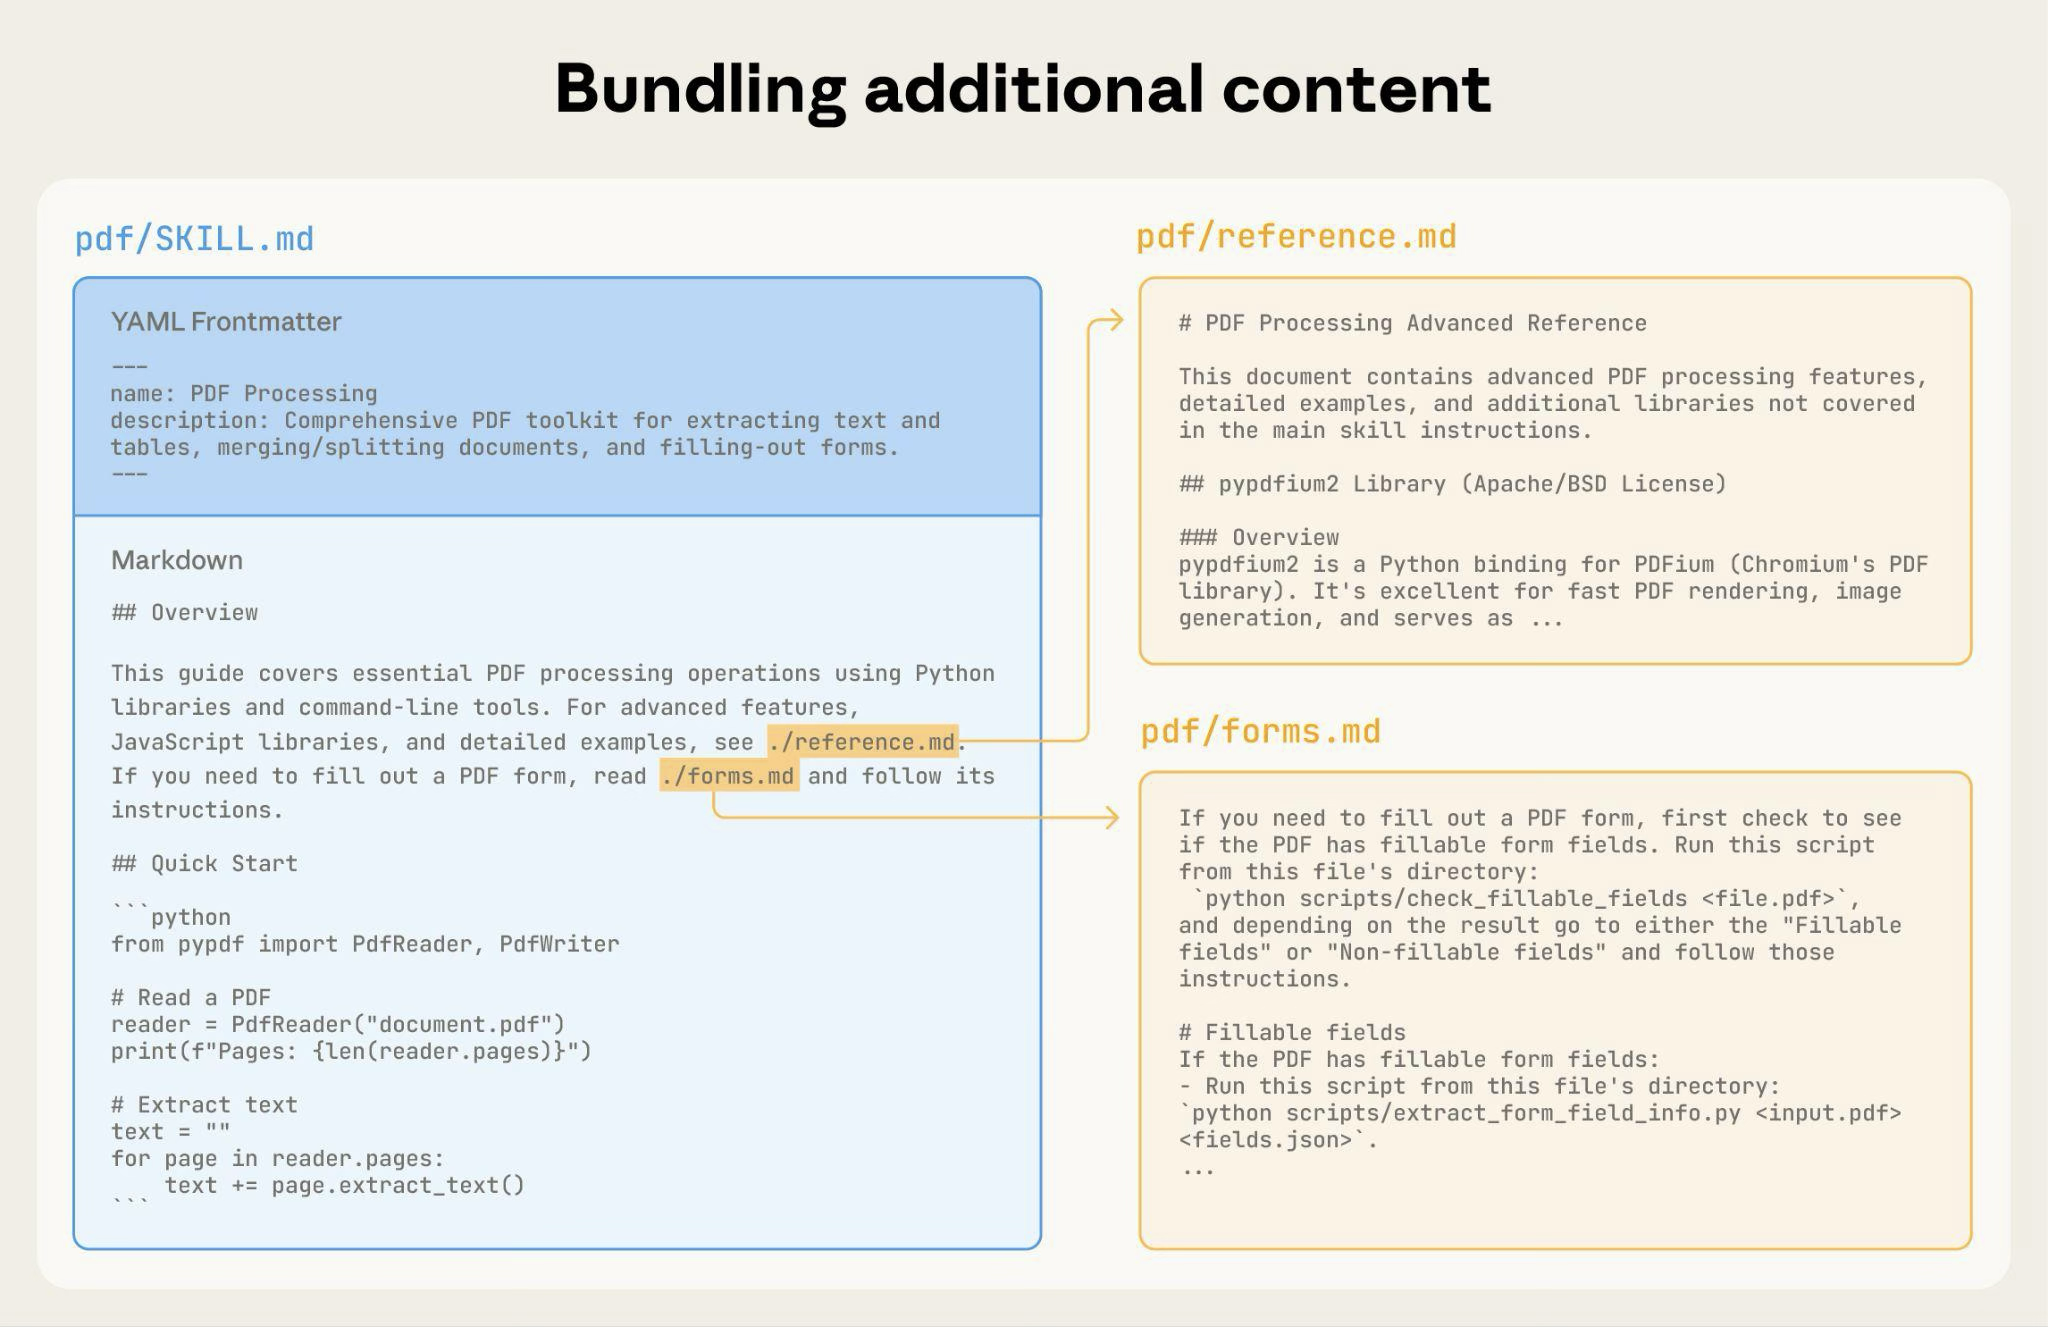
La structure complète du répertoire d'une Skill pourrait ressembler à ceci :
pdf/SKILL.md: instructions principales (chargées au déclenchement)FORMS.md: guide de remplissage de formulaires (chargé selon les besoins)reference.md: référence de l'API (chargée selon les besoins)examples.md: exemples d'utilisation (chargés selon les besoins)scripts/analyze_form.py: script utilitaire (exécuté, non chargé)fill_form.py: script de remplissage de formulairesvalidate.py: script de validation
Modèle 1 : guide de haut niveau avec références
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
---

# PDF Processing

## Quick start

Extract text with pdfplumber:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## Advanced features

**Form filling**: See [FORMS.md](FORMS.md) for complete guide
**API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
**Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patternsClaude ne charge FORMS.md, REFERENCE.md ou EXAMPLES.md qu'en cas de besoin.
Modèle 2 : organisation par domaine
Pour les Skills couvrant plusieurs domaines, organisez le contenu par domaine afin d'éviter de charger du contexte non pertinent. Lorsqu'un utilisateur pose une question sur les indicateurs de vente, Claude n'a besoin de lire que les schémas liés aux ventes, et non les données financières ou marketing. Cela maintient une faible consommation de tokens et un contexte ciblé.
bigquery-skill/SKILL.md(vue d'ensemble et navigation)reference/finance.md(revenus, indicateurs de facturation)sales.md(opportunités, pipeline)product.md(utilisation de l'API, fonctionnalités)marketing.md(campagnes, attribution)
# BigQuery Data Analysis

## Available datasets

**Finance**: Revenue, ARR, billing → See [reference/finance.md](reference/finance.md)
**Sales**: Opportunities, pipeline, accounts → See [reference/sales.md](reference/sales.md)
**Product**: API usage, features, adoption → See [reference/product.md](reference/product.md)
**Marketing**: Campaigns, attribution, email → See [reference/marketing.md](reference/marketing.md)

## Quick search

Find specific metrics using grep:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md
```
Modèle 3 : détails conditionnels
Affichez le contenu de base, renvoyez vers le contenu avancé :
# DOCX Processing

## Creating documents

Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).

## Editing documents

For simple edits, modify the XML directly.

**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)Claude ne lit REDLINING.md ou OOXML.md que lorsque l'utilisateur a besoin de ces fonctionnalités.
Éviter les références profondément imbriquées
Claude peut lire partiellement les fichiers lorsqu'ils sont référencés depuis d'autres fichiers référencés. Face à des références imbriquées, Claude peut utiliser des commandes comme head -100 pour prévisualiser le contenu plutôt que de lire les fichiers en entier, ce qui aboutit à des informations incomplètes.
Limitez les références à un seul niveau de profondeur depuis SKILL.md. Tous les fichiers de référence doivent être liés directement depuis SKILL.md afin de garantir que Claude lise les fichiers complets lorsque c'est nécessaire.
Mauvais exemple : trop profond :
# SKILL.md
See [advanced.md](advanced.md)...

# advanced.md
See [details.md](details.md)...

# details.md
Here's the actual information...Bon exemple : un seul niveau de profondeur :
# SKILL.md

**Basic usage**: [instructions in SKILL.md]
**Advanced features**: See [advanced.md](advanced.md)
**API reference**: See [reference.md](reference.md)
**Examples**: See [examples.md](examples.md)Structurer les fichiers de référence longs avec une table des matières
Pour les fichiers de référence de plus de 100 lignes, incluez une table des matières en tête. Cela garantit que Claude peut voir l'étendue complète des informations disponibles, même lors d'une prévisualisation par lecture partielle.
Exemple :
# API Reference

## Contents
- Authentication and setup
- Core methods (create, read, update, delete)
- Advanced features (batch operations, webhooks)
- Error handling patterns
- Code examples

## Authentication and setup
...

## Core methods
...Claude peut ensuite lire le fichier complet ou accéder directement à des sections spécifiques selon les besoins.
Pour plus de détails sur la façon dont cette architecture basée sur le système de fichiers permet la divulgation progressive, consultez la section Environnement d'exécution plus loin dans ce guide.
Flux de travail et boucles de rétroaction
Utiliser des flux de travail pour les tâches complexes
Décomposez les opérations complexes en étapes claires et séquentielles. Pour les flux de travail particulièrement complexes, fournissez une liste de contrôle que Claude peut copier dans sa réponse et cocher au fur et à mesure de sa progression.
Exemple 1 : flux de travail de synthèse de recherche (pour les Skills sans code) :
## Research synthesis workflow

Copy this checklist and track your progress:

```
Research Progress:
- [ ] Step 1: Read all source documents
- [ ] Step 2: Identify key themes
- [ ] Step 3: Cross-reference claims
- [ ] Step 4: Create structured summary
- [ ] Step 5: Verify citations
```

**Step 1: Read all source documents**

Review each document in the `sources/` directory. Note the main arguments and supporting evidence.

**Step 2: Identify key themes**

Look for patterns across sources. What themes appear repeatedly? Where do sources agree or disagree?

**Step 3: Cross-reference claims**

For each major claim, verify it appears in the source material. Note which source supports each point.

**Step 4: Create structured summary**

Organize findings by theme. Include:
- Main claim
- Supporting evidence from sources
- Conflicting viewpoints (if any)

**Step 5: Verify citations**

Check that every claim references the correct source document. If citations are incomplete, return to Step 3.Cet exemple montre comment les flux de travail s'appliquent aux tâches d'analyse qui ne nécessitent pas de code. Le modèle de liste de contrôle fonctionne pour tout processus complexe en plusieurs étapes.
Exemple 2 : flux de travail de remplissage de formulaire PDF (pour les Skills avec code) :
## PDF form filling workflow

Copy this checklist and check off items as you complete them:

```
Task Progress:
- [ ] Step 1: Analyze the form (run analyze_form.py)
- [ ] Step 2: Create field mapping (edit fields.json)
- [ ] Step 3: Validate mapping (run validate_fields.py)
- [ ] Step 4: Fill the form (run fill_form.py)
- [ ] Step 5: Verify output (run verify_output.py)
```

**Step 1: Analyze the form**

Run: `python scripts/analyze_form.py input.pdf`

This extracts form fields and their locations, saving to `fields.json`.

**Step 2: Create field mapping**

Edit `fields.json` to add values for each field.

**Step 3: Validate mapping**

Run: `python scripts/validate_fields.py fields.json`

Fix any validation errors before continuing.

**Step 4: Fill the form**

Run: `python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: Verify output**

Run: `python scripts/verify_output.py output.pdf`

If verification fails, return to Step 2.Des étapes claires empêchent Claude de sauter une validation critique. La liste de contrôle aide à la fois Claude et vous-même à suivre la progression dans les flux de travail en plusieurs étapes.
Mettre en place des boucles de rétroaction
Modèle courant : exécuter le validateur → corriger les erreurs → répéter
Ce modèle améliore considérablement la qualité des résultats.
Exemple 1 : conformité au guide de style (pour les Skills sans code) :
## Content review process

1. Draft your content following the guidelines in STYLE_GUIDE.md
2. Review against the checklist:
   - Check terminology consistency
   - Verify examples follow the standard format
   - Confirm all required sections are present
3. If issues found:
   - Note each issue with specific section reference
   - Revise the content
   - Review the checklist again
4. Only proceed when all requirements are met
5. Finalize and save the documentCeci illustre le modèle de boucle de validation utilisant des documents de référence plutôt que des scripts. Le « validateur » est STYLE_GUIDE.md, et Claude effectue la vérification en lisant et en comparant.
Exemple 2 : processus d'édition de document (pour les Skills avec code) :
## Document editing process

1. Make your edits to `word/document.xml`
2. **Validate immediately**: `python ooxml/scripts/validate.py unpacked_dir/`
3. If validation fails:
   - Review the error message carefully
   - Fix the issues in the XML
   - Run validation again
4. **Only proceed when validation passes**
5. Rebuild: `python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. Test the output documentLa boucle de validation détecte les erreurs tôt.
Directives de contenu
Éviter les informations sensibles au temps
N'incluez pas d'informations qui deviendront obsolètes :
Mauvais exemple : sensible au temps (deviendra faux) :
If you're doing this before August 2025, use the old API.
After August 2025, use the new API.Bon exemple (utiliser une section « anciens modèles ») :
## Current method

Use the v2 API endpoint: `api.example.com/v2/messages`

## Old patterns

<details>
<summary>Legacy v1 API (deprecated 2025-08)</summary>

The v1 API used: `api.example.com/v1/messages`

This endpoint is no longer supported.
</details>La section des anciens modèles fournit un contexte historique sans encombrer le contenu principal.
Utiliser une terminologie cohérente
Choisissez un terme et utilisez-le dans toute la Skill :
Bien - Cohérent :
- Toujours « API endpoint »
- Toujours « field »
- Toujours « extract »
Mauvais - Incohérent :
- Mélanger « API endpoint », « URL », « API route », « path »
- Mélanger « field », « box », « element », « control »
- Mélanger « extract », « pull », « get », « retrieve »
La cohérence aide Claude à analyser et à suivre les instructions.
Modèles courants
Modèle de gabarit
Fournissez des gabarits pour le format de sortie. Adaptez le niveau de rigueur à vos besoins.
Pour des exigences strictes (comme des réponses d'API ou des formats de données) :
## Report structure

ALWAYS use this exact template structure:

```markdown
# [Analysis Title]

## Executive summary
[One-paragraph overview of key findings]

## Key findings
- Finding 1 with supporting data
- Finding 2 with supporting data
- Finding 3 with supporting data

## Recommendations
1. Specific actionable recommendation
2. Specific actionable recommendation
```Pour des indications flexibles (lorsque l'adaptation est utile) :
## Report structure

Here is a sensible default format, but use your best judgment based on the analysis:

```markdown
# [Analysis Title]

## Executive summary
[Overview]

## Key findings
[Adapt sections based on what you discover]

## Recommendations
[Tailor to the specific context]
```

Adjust sections as needed for the specific analysis type.Modèle d'exemples
Pour les Skills dont la qualité de sortie dépend de la consultation d'exemples, fournissez des paires entrée/sortie comme dans le prompting classique :
## Commit message format

Generate commit messages following these examples:

**Example 1:**
Input: Added user authentication with JWT tokens
Output:
```
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware
```

**Example 2:**
Input: Fixed bug where dates displayed incorrectly in reports
Output:
```
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation
```

**Example 3:**
Input: Updated dependencies and refactored error handling
Output:
```
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints
```

Follow this style: type(scope): brief description, then detailed explanation.Les exemples transmettent à Claude le style et le niveau de détail souhaités plus clairement que de simples descriptions.
Modèle de flux de travail conditionnel
Guidez Claude à travers les points de décision :
## Document modification workflow

1. Determine the modification type:

   **Creating new content?** → Follow "Creation workflow" below
   **Editing existing content?** → Follow "Editing workflow" below

2. Creation workflow:
   - Use docx-js library
   - Build document from scratch
   - Export to .docx format

3. Editing workflow:
   - Unpack existing document
   - Modify XML directly
   - Validate after each change
- Repack when completeÉvaluation et itération
Construire d'abord les évaluations
Créez des évaluations AVANT de rédiger une documentation détaillée. Cela garantit que votre Skill résout de vrais problèmes plutôt que de documenter des problèmes imaginaires.
Développement piloté par les évaluations :
- Identifier les lacunes : Exécutez Claude sur des tâches représentatives sans Skill. Documentez les échecs spécifiques ou le contexte manquant
- Créer des évaluations : Construisez trois scénarios qui testent ces lacunes
- Établir une référence : Mesurez les performances de Claude sans la Skill
- Rédiger des instructions minimales : Créez juste assez de contenu pour combler les lacunes et réussir les évaluations
- Itérer : Exécutez les évaluations, comparez à la référence et affinez
Cette approche garantit que vous résolvez des problèmes réels plutôt que d'anticiper des exigences qui pourraient ne jamais se concrétiser.
Structure d'une évaluation :
{
  "skills": ["pdf-processing"],
  "query": "Extract all text from this PDF file and save it to output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "Successfully reads the PDF file using an appropriate PDF processing library or command-line tool",
    "Extracts text content from all pages in the document without missing any pages",
    "Saves the extracted text to a file named output.txt in a clear, readable format"
  ]
}Développer les Skills de manière itérative avec Claude
Le processus de développement de Skills le plus efficace implique Claude lui-même. Travaillez avec une instance de Claude (« Claude A ») pour créer une Skill qui sera utilisée par d'autres instances (« Claude B »). Claude A vous aide à concevoir et à affiner les instructions, tandis que Claude B les teste sur des tâches réelles. Cela fonctionne parce que les modèles Claude comprennent à la fois comment rédiger des instructions d'agent efficaces et quelles informations les agents nécessitent.
Créer une nouvelle Skill :
-
Accomplir une tâche sans Skill : Résolvez un problème avec Claude A en utilisant le prompting habituel. Au fil du travail, vous fournirez naturellement du contexte, expliquerez vos préférences et partagerez des connaissances procédurales. Remarquez quelles informations vous fournissez de manière répétée.
-
Identifier le modèle réutilisable : Une fois la tâche terminée, identifiez le contexte que vous avez fourni et qui serait utile pour des tâches futures similaires.
Exemple : Si vous avez mené une analyse BigQuery, vous avez peut-être fourni des noms de tables, des définitions de champs, des règles de filtrage (comme « toujours exclure les comptes de test ») et des modèles de requêtes courants.
-
Demander à Claude A de créer une Skill : « Crée une Skill qui capture ce modèle d'analyse BigQuery que nous venons d'utiliser. Inclus les schémas de tables, les conventions de nommage et la règle concernant le filtrage des comptes de test. »
-
Vérifier la concision : Vérifiez que Claude A n'a pas ajouté d'explications inutiles. Demandez : « Supprime l'explication sur ce que signifie le taux de réussite - Claude le sait déjà. »
-
Améliorer l'architecture de l'information : Demandez à Claude A d'organiser le contenu plus efficacement. Par exemple : « Organise cela de sorte que le schéma de table soit dans un fichier de référence séparé. Nous pourrions ajouter d'autres tables plus tard. »
-
Tester sur des tâches similaires : Utilisez la Skill avec Claude B (une nouvelle instance avec la Skill chargée) sur des cas d'usage connexes. Observez si Claude B trouve les bonnes informations, applique correctement les règles et accomplit la tâche avec succès.
-
Itérer à partir des observations : Si Claude B rencontre des difficultés ou oublie quelque chose, revenez vers Claude A avec des précisions : « Lorsque Claude a utilisé cette Skill, il a oublié de filtrer par date pour le T4. Devrions-nous ajouter une section sur les modèles de filtrage par date ? »
Itérer sur des Skills existantes :
Le même modèle hiérarchique se poursuit lors de l'amélioration des Skills. Vous alternez entre :
- Travailler avec Claude A (l'expert qui aide à affiner la Skill)
- Tester avec Claude B (l'agent qui utilise la Skill pour effectuer un travail réel)
- Observer le comportement de Claude B et rapporter les enseignements à Claude A
-
Utiliser la Skill dans des flux de travail réels : Confiez à Claude B (avec la Skill chargée) des tâches réelles, et non des scénarios de test
-
Observer le comportement de Claude B : Notez où il rencontre des difficultés, réussit ou fait des choix inattendus
Exemple d'observation : « Lorsque j'ai demandé à Claude B un rapport de ventes régional, il a écrit la requête mais a oublié d'exclure les comptes de test, alors que la Skill mentionne cette règle. »
-
Revenir vers Claude A pour des améliorations : Partagez le SKILL.md actuel et décrivez ce que vous avez observé. Demandez : « J'ai remarqué que Claude B a oublié de filtrer les comptes de test lorsque j'ai demandé un rapport régional. La Skill mentionne le filtrage, mais peut-être n'est-il pas assez mis en évidence ? »
-
Examiner les suggestions de Claude A : Claude A pourrait suggérer de réorganiser pour rendre les règles plus visibles, d'utiliser un langage plus fort comme « DOIT filtrer » au lieu de « toujours filtrer », ou de restructurer la section du flux de travail.
-
Appliquer et tester les modifications : Mettez à jour la Skill avec les améliorations de Claude A, puis testez à nouveau avec Claude B sur des requêtes similaires
-
Répéter en fonction de l'utilisation : Poursuivez ce cycle observer-affiner-tester à mesure que vous rencontrez de nouveaux scénarios. Chaque itération améliore la Skill sur la base du comportement réel de l'agent, et non d'hypothèses.
Recueillir les retours de l'équipe :
- Partagez les Skills avec vos collègues et observez leur utilisation
- Demandez : la Skill s'active-t-elle au moment attendu ? Les instructions sont-elles claires ? Que manque-t-il ?
- Intégrez les retours pour combler les lacunes de vos propres modèles d'utilisation
Pourquoi cette approche fonctionne : Claude A comprend les besoins des agents, vous apportez l'expertise métier, Claude B révèle les lacunes par une utilisation réelle, et l'affinement itératif améliore les Skills sur la base du comportement observé plutôt que d'hypothèses.
Observer comment Claude navigue dans les Skills
Au fil de vos itérations sur les Skills, prêtez attention à la façon dont Claude les utilise réellement en pratique. Surveillez :
- Les chemins d'exploration inattendus : Claude lit-il les fichiers dans un ordre que vous n'aviez pas anticipé ? Cela peut indiquer que votre structure n'est pas aussi intuitive que vous le pensiez
- Les connexions manquées : Claude ne suit-il pas les références vers des fichiers importants ? Vos liens doivent peut-être être plus explicites ou plus visibles
- La dépendance excessive à certaines sections : Si Claude lit de manière répétée le même fichier, demandez-vous si ce contenu ne devrait pas plutôt figurer dans le SKILL.md principal
- Le contenu ignoré : Si Claude n'accède jamais à un fichier regroupé, celui-ci est peut-être inutile ou mal signalé dans les instructions principales
Itérez à partir de ces observations plutôt que d'hypothèses. Les champs « name » et « description » dans les métadonnées de votre Skill sont particulièrement critiques. Claude les utilise pour déterminer s'il doit déclencher la Skill en réponse à la tâche en cours. Assurez-vous qu'ils décrivent clairement ce que fait la Skill et quand elle doit être utilisée.
Anti-modèles à éviter
Éviter les chemins de style Windows
Utilisez toujours des barres obliques dans les chemins de fichiers, même sous Windows :
- ✓ Bien :
scripts/helper.py,reference/guide.md - ✗ À éviter :
scripts\helper.py,reference\guide.md
Les chemins de style Unix fonctionnent sur toutes les plateformes, tandis que les chemins de style Windows provoquent des erreurs sur les systèmes Unix.
Éviter de proposer trop d'options
Ne présentez pas plusieurs approches sauf si nécessaire :
**Bad example: Too many choices** (confusing):
"You can use pypdf, or pdfplumber, or PyMuPDF, or pdf2image, or..."

**Good example: Provide a default** (with escape hatch):
"Use pdfplumber for text extraction:
```python
import pdfplumber
```

For scanned PDFs requiring OCR, use pdf2image with pytesseract instead."Avancé : Skills avec code exécutable
Les sections suivantes se concentrent sur les Skills qui incluent des scripts exécutables. Si votre Skill n'utilise que des instructions markdown, passez directement à la Liste de contrôle pour des Skills efficaces.
Résoudre, ne pas déléguer
Lorsque vous écrivez des scripts pour des Skills, gérez les conditions d'erreur plutôt que de les déléguer à Claude.
Bon exemple : gérer les erreurs explicitement :
def process_file(path):
    """Process a file, creating it if it doesn't exist."""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # Créer le fichier avec un contenu par défaut au lieu d'échouer
        print(f"File {path} not found, creating default")
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # Proposer une alternative au lieu d'échouer
        print(f"Cannot access {path}, using default")
return ""Mauvais exemple : déléguer à Claude :
def process_file(path):
    # Échouer simplement et laisser Claude se débrouiller
return open(path).read()Les paramètres de configuration doivent également être justifiés et documentés pour éviter les « constantes vaudou » (loi d'Ousterhout). Si vous ne connaissez pas la bonne valeur, comment Claude la déterminera-t-il ?
Bon exemple : auto-documenté :
# Les requêtes HTTP se terminent généralement en moins de 30 secondes
# Un délai d'expiration plus long tient compte des connexions lentes
REQUEST_TIMEOUT = 30

# Trois tentatives équilibrent fiabilité et rapidité
# La plupart des échecs intermittents se résolvent dès la deuxième tentative
MAX_RETRIES = 3Mauvais exemple : nombres magiques :
TIMEOUT = 47  # Why 47?
RETRIES = 5 # Why 5?Fournir des scripts utilitaires
Même si Claude pourrait écrire un script, les scripts préfabriqués offrent des avantages :
Avantages des scripts utilitaires :
- Plus fiables que le code généré
- Économisent des tokens (pas besoin d'inclure le code dans le contexte)
- Économisent du temps (aucune génération de code requise)
- Garantissent la cohérence entre les utilisations
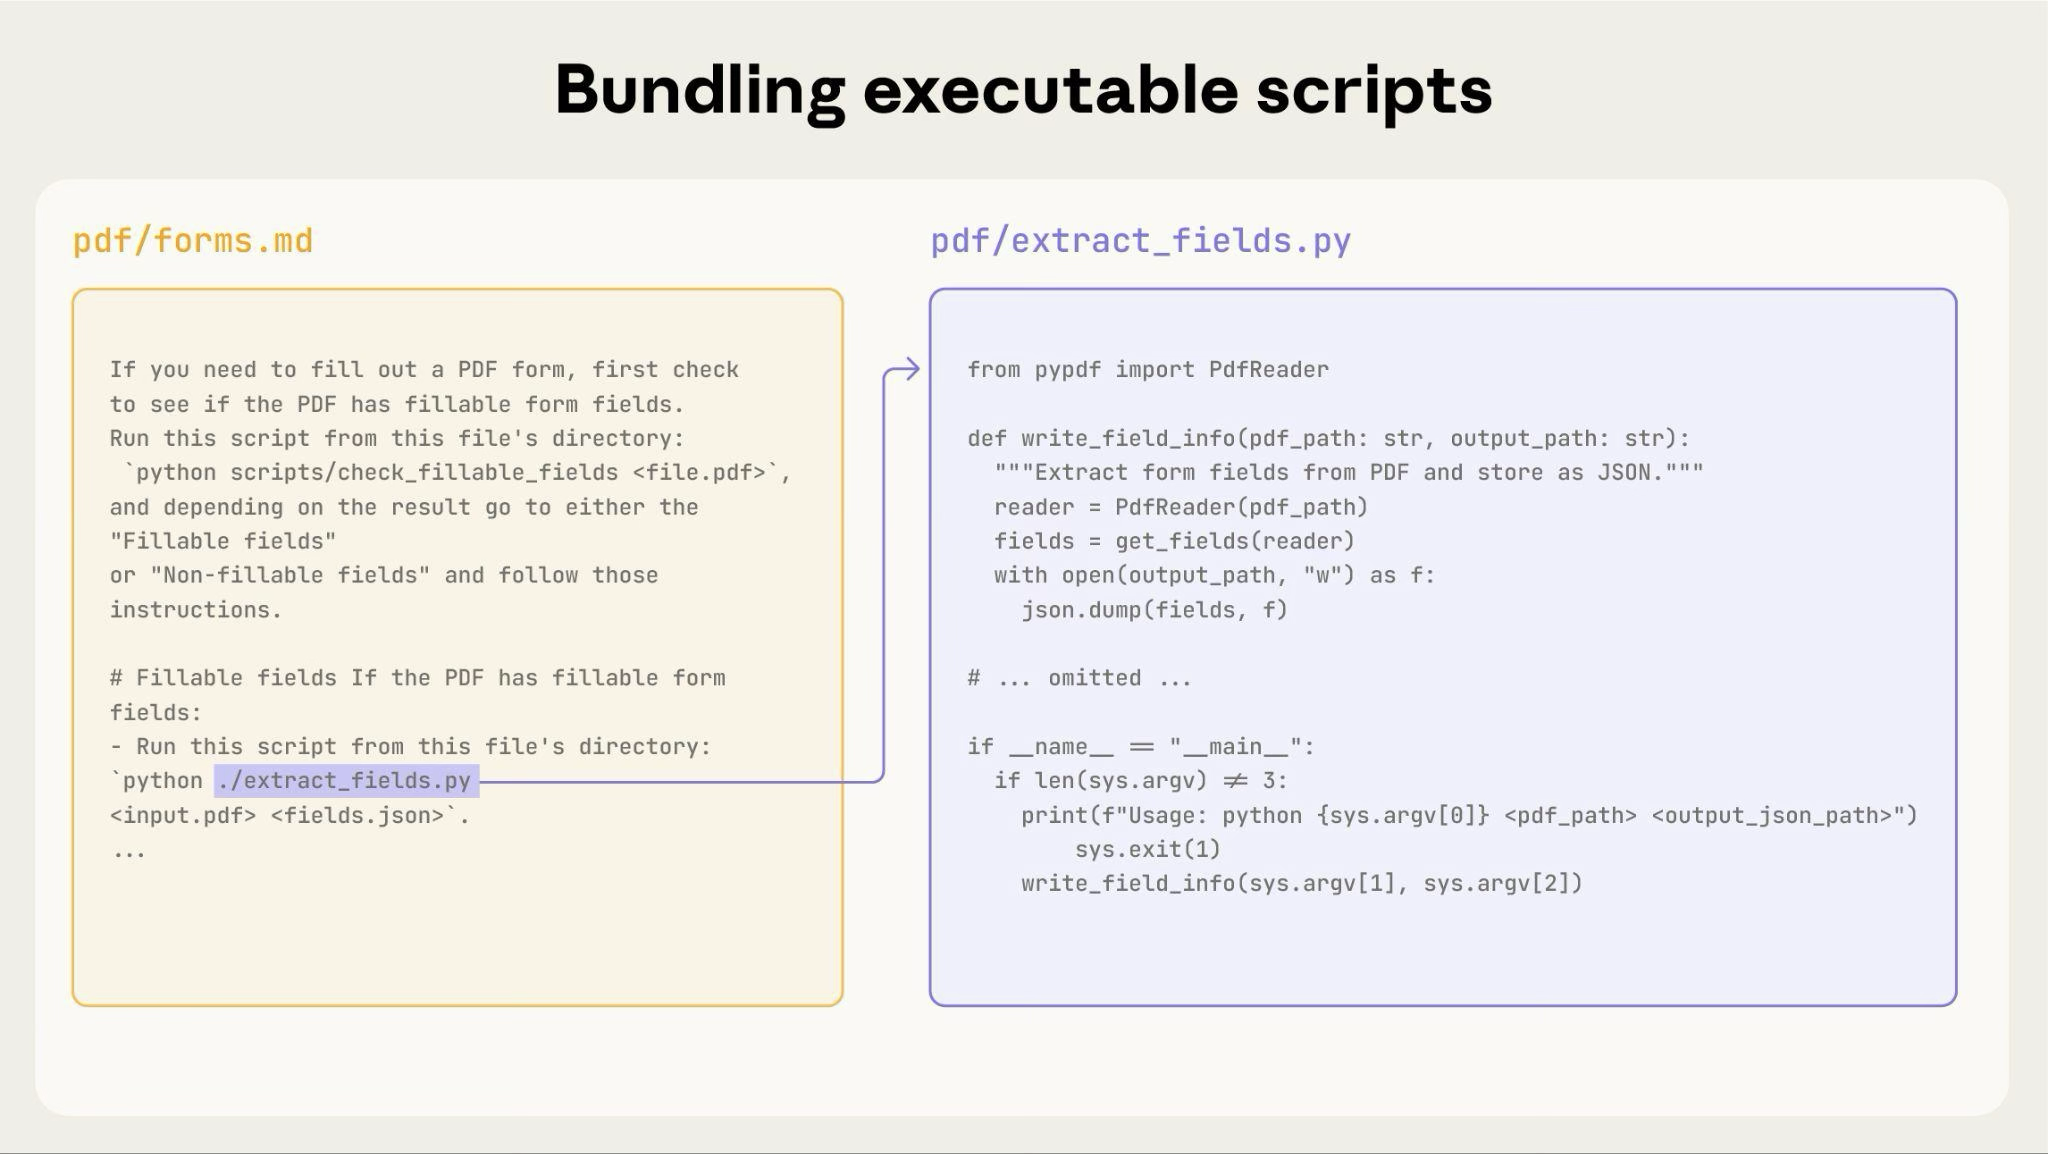
Le diagramme précédent montre comment les scripts exécutables fonctionnent aux côtés des fichiers d'instructions. Le fichier d'instructions (forms.md) référence le script, et Claude peut l'exécuter sans charger son contenu dans le contexte.
Distinction importante : Indiquez clairement dans vos instructions si Claude doit :
- Exécuter le script (le plus courant) : « Exécute
analyze_form.pypour extraire les champs » - Le lire comme référence (pour une logique complexe) : « Consulte
analyze_form.pypour l'algorithme d'extraction des champs »
Pour la plupart des scripts utilitaires, l'exécution est préférable car elle est plus fiable et plus efficace. Consultez la section Environnement d'exécution ci-dessous pour plus de détails sur le fonctionnement de l'exécution des scripts.
Exemple :
## Utility scripts

**analyze_form.py**: Extract all form fields from PDF

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

Output format:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**: Check for overlapping bounding boxes

```bash
python scripts/validate_boxes.py fields.json
# Returns: "OK" or lists conflicts
```

**fill_form.py**: Apply field values to PDF

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```Utiliser l'analyse visuelle
Lorsque les entrées peuvent être rendues sous forme d'images, faites-les analyser par Claude :
## Form layout analysis

1. Convert PDF to images:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. Analyze each page image to identify form fields
3. Claude can see field locations and types visuallyLes capacités de vision de Claude aident à analyser les mises en page et les structures.
Créer des sorties intermédiaires vérifiables
Lorsque Claude effectue des tâches complexes et ouvertes, il peut commettre des erreurs. Le modèle « planifier-valider-exécuter » détecte les erreurs tôt en demandant à Claude de créer d'abord un plan dans un format structuré, puis de valider ce plan avec un script avant de l'exécuter.
Exemple : Imaginez que vous demandiez à Claude de mettre à jour 50 champs de formulaire dans un PDF à partir d'une feuille de calcul. Sans validation, Claude pourrait référencer des champs inexistants, créer des valeurs contradictoires, oublier des champs obligatoires ou appliquer les mises à jour de manière incorrecte.
Solution : Utilisez le modèle de flux de travail présenté plus haut (remplissage de formulaire PDF), mais ajoutez un fichier intermédiaire changes.json qui est validé avant l'application des modifications. Le flux de travail devient : analyser → créer le fichier de plan → valider le plan → exécuter → vérifier.
Pourquoi ce modèle fonctionne :
- Détecte les erreurs tôt : La validation trouve les problèmes avant que les modifications ne soient appliquées
- Vérifiable par machine : Les scripts fournissent une vérification objective
- Planification réversible : Claude peut itérer sur le plan sans toucher aux originaux
- Débogage clair : Les messages d'erreur pointent vers des problèmes spécifiques
Quand l'utiliser : opérations par lots, modifications destructrices, règles de validation complexes, opérations à enjeux élevés.
Conseil d'implémentation : Rendez les scripts de validation verbeux avec des messages d'erreur spécifiques tels que « Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed » pour aider Claude à corriger les problèmes.
Dépendances de paquets
Les Skills s'exécutent dans l'environnement d'exécution de code avec des limitations propres à chaque plateforme :
- claude.ai : peut installer des paquets depuis npm et PyPI et récupérer du contenu depuis des dépôts GitHub
- API Claude : n'a pas d'accès réseau ni d'installation de paquets à l'exécution
Listez les paquets requis dans votre SKILL.md et vérifiez qu'ils sont disponibles dans la documentation de l'outil d'exécution de code.
Environnement d'exécution
Les Skills s'exécutent dans un environnement d'exécution de code disposant d'un accès au système de fichiers, de commandes bash et de capacités d'exécution de code. Pour l'explication conceptuelle de cette architecture, consultez L'architecture des Skills dans la présentation.
Comment cela affecte votre rédaction :
Comment Claude accède aux Skills :
- Métadonnées préchargées : Au démarrage, le nom et la description issus du frontmatter YAML de toutes les Skills sont chargés dans l'invite système
- Fichiers lus à la demande : Claude utilise les outils de lecture bash pour accéder à SKILL.md et aux autres fichiers du système de fichiers lorsque c'est nécessaire
- Scripts exécutés efficacement : Les scripts utilitaires peuvent être exécutés via bash sans charger leur contenu complet dans le contexte. Seule la sortie du script consomme des tokens
- Aucune pénalité de contexte pour les fichiers volumineux : Les fichiers de référence, les données ou la documentation ne consomment pas de tokens de contexte tant qu'ils ne sont pas effectivement lus
- Les chemins de fichiers comptent : Claude navigue dans le répertoire de votre Skill comme dans un système de fichiers. Utilisez des barres obliques (
reference/guide.md), pas des barres obliques inverses - Nommez les fichiers de manière descriptive : Utilisez des noms qui indiquent le contenu :
form_validation_rules.md, et nondoc2.md - Organisez pour la découverte : Structurez les répertoires par domaine ou par fonctionnalité
- Bien :
reference/finance.md,reference/sales.md - Mauvais :
docs/file1.md,docs/file2.md
- Bien :
- Regroupez des ressources complètes : Incluez la documentation complète de l'API, de nombreux exemples, de grands jeux de données ; aucune pénalité de contexte tant qu'ils ne sont pas consultés
- Préférez les scripts pour les opérations déterministes : Écrivez
validate_form.pyplutôt que de demander à Claude de générer du code de validation - Rendez l'intention d'exécution claire :
- « Exécute
analyze_form.pypour extraire les champs » (exécuter) - « Consulte
analyze_form.pypour l'algorithme d'extraction » (lire comme référence)
- « Exécute
- Testez les modèles d'accès aux fichiers : Vérifiez que Claude peut naviguer dans votre structure de répertoires en testant avec des requêtes réelles
Exemple :
bigquery-skill/SKILL.md(vue d'ensemble, renvoie vers les fichiers de référence)reference/finance.md(indicateurs de revenus)sales.md(données de pipeline)product.md(analyses d'utilisation)
Lorsque l'utilisateur pose une question sur les revenus, Claude lit SKILL.md, voit la référence à reference/finance.md et appelle bash pour lire uniquement ce fichier. Les fichiers sales.md et product.md restent sur le système de fichiers, ne consommant aucun token de contexte tant qu'ils ne sont pas nécessaires. Ce modèle basé sur le système de fichiers est ce qui permet la divulgation progressive. Claude peut naviguer et charger de manière sélective exactement ce que chaque tâche requiert.
Pour tous les détails sur l'architecture technique, consultez Fonctionnement des Skills dans la présentation des Skills.
Références aux outils MCP
Si votre Skill utilise des outils MCP (Model Context Protocol), utilisez toujours des noms d'outils pleinement qualifiés pour éviter les erreurs « tool not found ».
Format : ServerName:tool_name
Exemple :
Use the BigQuery:bigquery_schema tool to retrieve table schemas.
Use the GitHub:create_issue tool to create issues.Où :
BigQueryetGitHubsont des noms de serveurs MCPbigquery_schemaetcreate_issuesont les noms des outils au sein de ces serveurs
Sans le préfixe du serveur, Claude peut ne pas réussir à localiser l'outil, en particulier lorsque plusieurs serveurs MCP sont disponibles.
Éviter de supposer que les outils sont installés
Ne supposez pas que les paquets sont disponibles :
**Bad example: Assumes installation**:
"Use the pdf library to process the file."

**Good example: Explicit about dependencies**:
"Install required package: `pip install pypdf`

Then use it:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```"Notes techniques
Exigences du frontmatter YAML
Le frontmatter de SKILL.md requiert les champs name et description avec des règles de validation spécifiques :
name: 64 caractères maximum, lettres minuscules/chiffres/tirets uniquement, pas de balises XML, pas de mots réservésdescription: 1 024 caractères maximum, non vide, pas de balises XML
Consultez la présentation des Skills pour tous les détails sur la structure.
Budgets de tokens
Maintenez le corps de SKILL.md sous 500 lignes pour des performances optimales. Si votre contenu dépasse cette limite, répartissez-le dans des fichiers séparés en utilisant les modèles de divulgation progressive décrits plus haut. Pour les détails architecturaux, consultez la présentation des Skills.
Liste de contrôle pour des Skills efficaces
Avant de partager une Skill, vérifiez :
Qualité fondamentale
- La description est précise et inclut des termes clés
- La description inclut à la fois ce que fait la Skill et quand l'utiliser
- Le corps de SKILL.md fait moins de 500 lignes
- Les détails supplémentaires sont dans des fichiers séparés (si nécessaire)
- Aucune information sensible au temps (ou dans une section « anciens modèles »)
- Terminologie cohérente dans l'ensemble
- Les exemples sont concrets, pas abstraits
- Les références de fichiers sont à un seul niveau de profondeur
- Divulgation progressive utilisée de manière appropriée
- Les flux de travail ont des étapes claires
Code et scripts
- Les scripts résolvent les problèmes plutôt que de les déléguer à Claude
- La gestion des erreurs est explicite et utile
- Pas de « constantes vaudou » (toutes les valeurs sont justifiées)
- Les paquets requis sont listés dans les instructions et leur disponibilité vérifiée
- Les scripts ont une documentation claire
- Pas de chemins de style Windows (uniquement des barres obliques)
- Étapes de validation/vérification pour les opérations critiques
- Boucles de rétroaction incluses pour les tâches où la qualité est critique
Tests
- Au moins trois évaluations créées
- Testé avec Haiku, Sonnet et Opus
- Testé avec des scénarios d'utilisation réels
- Retours de l'équipe intégrés (le cas échéant)
Prochaines étapes
Créez votre première Skill
Créez et gérez des Skills dans Claude Code
Téléversez et utilisez des Skills par programmation
Was this page helpful?