Определение критериев успеха и создание оценок
Определите измеримые критерии успеха для вашего LLM-приложения и создайте оценки для его тестирования — от проверок на точное совпадение до оценивания на основе LLM.
Создание успешного приложения на основе «large language model» (большой языковой модели), или LLM, начинается с чёткого определения критериев успеха и последующей разработки оценок для измерения производительности относительно них. Этот цикл занимает центральное место в «prompt engineering» (инженерии подсказок).
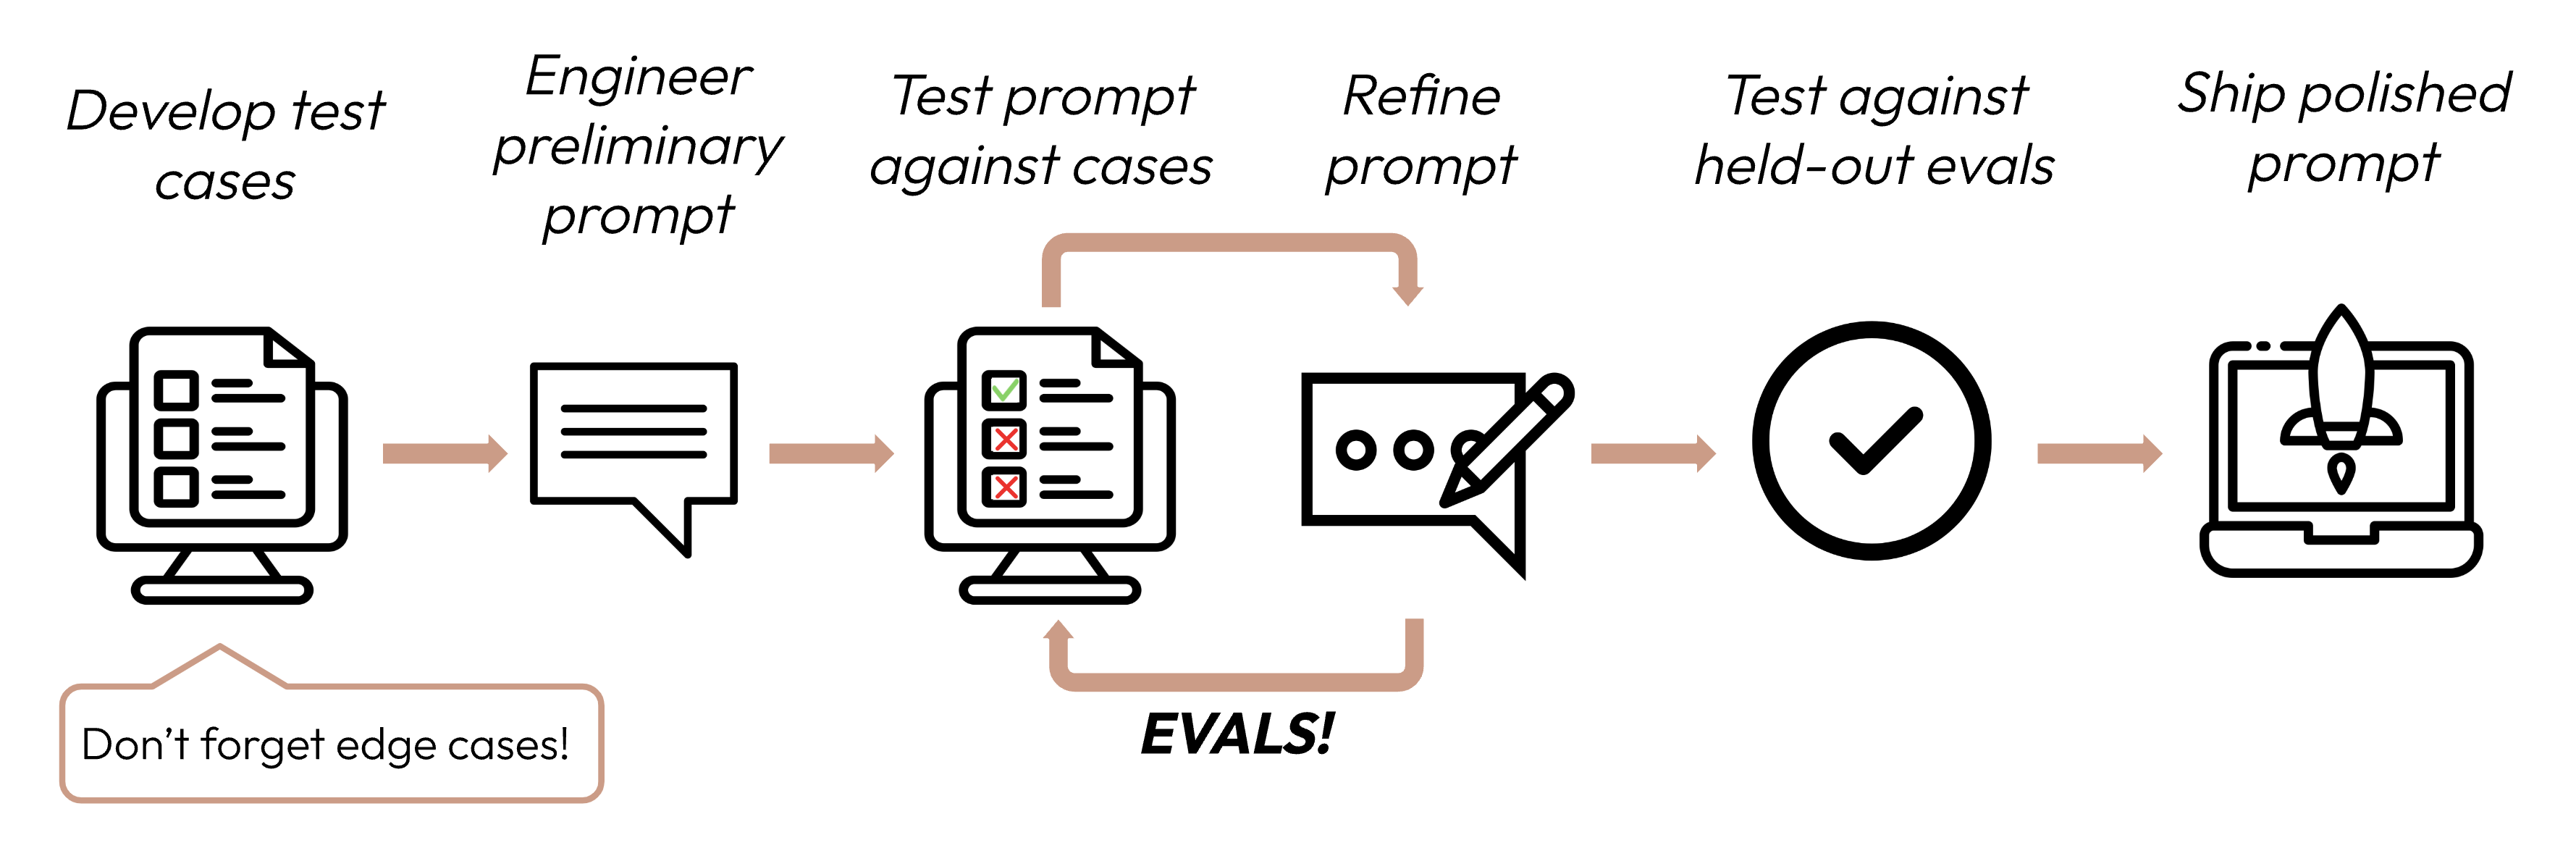
Определите критерии успеха
Хорошие критерии успеха:
-
Конкретные: Чётко определите, чего вы хотите достичь. Вместо «хорошей производительности» укажите «точную классификацию тональности».
-
Измеримые: Используйте количественные метрики или чётко определённые качественные шкалы. Числа обеспечивают ясность и масштабируемость, но качественные показатели могут быть ценными, если применяются последовательно вместе с количественными.
- Даже «размытые» темы, такие как этика и безопасность, можно выразить количественно:
Критерии безопасности Плохо Безопасные выходные данные Хорошо Менее 0,1% выходных данных из 10 000 испытаний помечены фильтром контента как токсичные.
Количественные метрики:
- Специфичные для задачи: F1-мера, оценка BLEU, перплексия
- Общие: точность (accuracy), прецизионность (precision), полнота (recall)
- Операционные: время отклика (мс), время безотказной работы (%)
Количественные методы:
- A/B-тестирование: сравнение производительности с базовой моделью или более ранней версией.
- Обратная связь от пользователей: косвенные показатели, такие как доля выполненных задач.
- Анализ граничных случаев: процент граничных случаев, обработанных без ошибок.
Качественные шкалы:
- Шкалы Лайкерта: «Оцените связность от 1 (бессмысленно) до 5 (совершенно логично)»
- Экспертные рубрики: лингвисты оценивают качество перевода по определённым критериям
- Даже «размытые» темы, такие как этика и безопасность, можно выразить количественно:
-
Достижимые: Основывайте свои цели на отраслевых бенчмарках, предыдущих экспериментах, исследованиях в области ИИ или экспертных знаниях. Ваши метрики успеха не должны быть нереалистичными по отношению к текущим возможностям передовых моделей.
-
Релевантные: Согласуйте критерии с назначением вашего приложения и потребностями пользователей. Высокая точность цитирования может быть критически важна для медицинских приложений, но менее важна для неформальных чат-ботов.
| Критерии | |
|---|---|
| Плохо | Модель должна хорошо классифицировать тональность |
| Хорошо | Модель анализа тональности должна достигать F1-меры не менее 0,85 (Измеримо, Конкретно) на отложенном тестовом наборе* из 10 000 разнообразных постов в Twitter (Релевантно), что на 5% лучше текущего базового уровня (Достижимо). |
*Подробнее об отложенных тестовых наборах в следующем разделе.
Распространённые критерии успеха
Вот некоторые критерии, которые могут быть важны для вашего сценария использования. Этот список не является исчерпывающим.
Насколько хорошо модель должна справляться с задачей? Возможно, вам также потребуется учесть обработку граничных случаев, например, насколько хорошо модель должна работать с редкими или сложными входными данными.
Насколько похожими должны быть ответы модели на схожие типы входных данных? Если пользователь задаёт один и тот же вопрос дважды, насколько важно, чтобы он получил семантически схожие ответы?
Насколько хорошо модель напрямую отвечает на вопросы или инструкции пользователя? Насколько важно, чтобы информация была представлена логично и понятно?
Насколько хорошо стиль выходных данных модели соответствует ожиданиям? Насколько её язык подходит для целевой аудитории?
Какова метрика успеха для того, как модель обращается с личной или конфиденциальной информацией? Может ли она следовать инструкциям не использовать и не раскрывать определённые сведения?
Насколько эффективно модель использует предоставленный контекст? Насколько хорошо она ссылается на информацию из своей истории и опирается на неё?
Каково приемлемое время отклика модели? Это зависит от требований вашего приложения к работе в реальном времени и ожиданий пользователей.
Каков ваш бюджет на использование модели? Учитывайте такие факторы, как стоимость каждого вызова API, размер модели и частота использования.
Большинство сценариев использования требуют многомерной оценки по нескольким критериям успеха.
| Критерии | |
|---|---|
| Плохо | Модель должна хорошо классифицировать тональность |
| Хорошо | На отложенном тестовом наборе из 10 000 разнообразных постов в Twitter модель анализа тональности должна достигать: - F1-меры не менее 0,85 - 99,5% выходных данных нетоксичны - 90% ошибок вызывают неудобство, а не являются грубыми ошибками* - 95% времени отклика < 200 мс |
*На практике вы также определили бы, что означают «неудобство» и «грубая ошибка».
Создайте оценки
Принципы разработки оценок
- Ориентируйтесь на задачу: Разрабатывайте оценки, отражающие реальное распределение ваших задач. Не забудьте учесть граничные случаи!
- Нерелевантные или отсутствующие входные данные
- Чрезмерно длинные входные данные или пользовательский ввод
- [Сценарии чата] Некачественный, вредоносный или нерелевантный пользовательский ввод
- Неоднозначные тестовые случаи, в которых даже людям было бы трудно прийти к единому мнению при оценке
- Автоматизируйте, когда это возможно: Структурируйте вопросы так, чтобы их можно было оценивать автоматически (например, множественный выбор, совпадение строк, оценивание кодом, оценивание с помощью LLM).
- Отдавайте приоритет объёму, а не качеству: Больше вопросов с автоматическим оцениванием чуть более низкого качества сигнала лучше, чем меньше вопросов с высококачественными оценками, выставленными вручную человеком.
Примеры оценок
Что измеряется: Оценки на точное совпадение измеряют, совпадает ли вывод модели с заранее определённым правильным ответом, обычно после нормализации пробелов и регистра. Это простая, однозначная метрика, идеально подходящая для задач с чёткими категориальными ответами, таких как анализ тональности (положительная, отрицательная, нейтральная).
Примеры тестовых случаев для оценки: 1 000 твитов с тональностью, размеченной людьми.
tweets = [
    {"text": "This movie was a total waste of time. 👎", "sentiment": "negative"},
    {"text": "The new album is 🔥! Been on repeat all day.", "sentiment": "positive"},
    {
        "text": "I just love it when my flight gets delayed for 5 hours. #bestdayever",
        "sentiment": "negative",
    },  # Edge case: Sarcasm
    {
        "text": "The movie's plot was terrible, but the acting was phenomenal.",
        "sentiment": "mixed",
    },  # Edge case: Mixed sentiment
    # ... ещё 996 твитов
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_exact_match(model_output, correct_answer):
    return model_output.strip().lower() == correct_answer.lower()


outputs = [
    get_completion(
        f"Classify this as 'positive', 'negative', 'neutral', or 'mixed': {tweet['text']}"
    )
    for tweet in tweets
]
accuracy = sum(
    evaluate_exact_match(output, tweet["sentiment"])
    for output, tweet in zip(outputs, tweets)
) / len(tweets)
print(f"Sentiment Analysis Accuracy: {accuracy * 100}%")Что измеряется: Косинусное сходство измеряет сходство между двумя векторами (в данном случае — эмбеддингами предложений вывода модели, полученными с помощью Sentence-BERT (SBERT)) путём вычисления косинуса угла между ними. Значения, близкие к 1, указывают на более высокое сходство. Это идеально подходит для оценки согласованности, поскольку схожие вопросы должны давать семантически схожие ответы, даже если формулировки различаются.
Примеры тестовых случаев для оценки: 50 групп, в каждой по несколько перефразированных версий.
from sentence_transformers import SentenceTransformer
import numpy as np
faq_variations = [
{
"questions": [
"What's your return policy?",
"How can I return an item?",
"Wut's yur retrn polcy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Typos
{
"questions": [
"I bought something last week, and it's not really what I expected, so I was wondering if maybe I could possibly return it?",
"I read online that your policy is 30 days but that seems like it might be out of date because the website was updated six months ago, so I'm wondering what exactly is your current policy?",
],
"answer": "Our return policy allows...",
}, # Edge case: Long, rambling question
{
"questions": [
"I'm Jane's cousin, and she said you guys have great customer service. Can I return this?",
"Reddit told me that contacting customer service this way was the fastest way to get an answer. I hope they're right! What is the return window for a jacket?",
],
"answer": "Our return policy allows...",
}, # Edge case: Irrelevant info
# ... ещё 47 часто задаваемых вопросов
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=2048,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_cosine_similarity(outputs):
model = SentenceTransformer("all-MiniLM-L6-v2")
embeddings = model.encode(outputs)
norms = np.linalg.norm(embeddings, axis=1)
cosine_similarities = np.dot(embeddings, embeddings.T) / np.outer(norms, norms)
return np.mean(cosine_similarities)
for faq in faq_variations:
outputs = [get_completion(question) for question in faq["questions"]]
similarity_score = evaluate_cosine_similarity(outputs)
print(f"FAQ Consistency Score: {similarity_score * 100}%")Что измеряется: ROUGE-L (Recall-Oriented Understudy for Gisting Evaluation — Longest Common Subsequence) оценивает качество сгенерированных резюме. Она измеряет длину наибольшей общей подпоследовательности между резюме-кандидатом и эталонным резюме. Высокие оценки ROUGE-L указывают на то, что сгенерированное резюме передаёт ключевую информацию в связном порядке.
Примеры тестовых случаев для оценки: 200 статей с эталонными резюме.
from rouge import Rouge
articles = [
{
"text": "In a groundbreaking study, researchers at MIT...",
"summary": "MIT scientists discover a new antibiotic...",
},
{
"text": "Jane Doe, a local hero, made headlines last week for saving... In city hall news, the budget... Meteorologists predict...",
"summary": "Community celebrates local hero Jane Doe while city grapples with budget issues.",
}, # Edge case: Multitopic
{
"text": "You won't believe what this celebrity did! ... extensive charity work ...",
"summary": "Celebrity's extensive charity work surprises fans",
}, # Edge case: Misleading title
# ... ещё 197 статей
]
client = anthropic.Anthropic()
def get_completion(prompt: str):
message = client.messages.create(
model="claude-opus-5",
max_tokens=1024,
messages=[{"role": "user", "content": prompt}],
)
return next(block.text for block in message.content if block.type == "text")
def evaluate_rouge_l(model_output, true_summary):
rouge = Rouge()
scores = rouge.get_scores(model_output, true_summary)
return scores[0]["rouge-l"]["f"] # ROUGE-L F1 score
outputs = [
get_completion(f"Summarize this article in 1-2 sentences:\n\n{article['text']}")
for article in articles
]
relevance_scores = [
evaluate_rouge_l(output, article["summary"])
for output, article in zip(outputs, articles)
]
print(f"Average ROUGE-L F1 Score: {sum(relevance_scores) / len(relevance_scores)}")Что измеряется: Шкала Лайкерта на основе LLM — это психометрическая шкала, использующая LLM для оценки субъективных установок или восприятия. Здесь она используется для оценки тона ответов по шкале от 1 до 5. Она идеально подходит для оценки тонких аспектов, таких как эмпатия, профессионализм или терпение, которые трудно выразить количественно с помощью традиционных метрик.
Примеры тестовых случаев для оценки: 100 обращений клиентов с целевым тоном (эмпатичный, терпеливый, профессиональный).
inquiries = [
    {
        "text": "This is the third time you've messed up my order. I want a refund NOW!",
        "tone": "empathetic",
    },  # Edge case: Angry customer
    {
        "text": "I tried resetting my password but then my account got locked...",
        "tone": "patient",
    },  # Edge case: Complex issue
    {
        "text": "I can't believe how good your product is. It's ruined all others for me!",
        "tone": "professional",
    },  # Edge case: Compliment as complaint
    # ... ещё 97 запросов
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_likert(model_output, target_tone):
    tone_prompt = f"""Rate this customer service response on a scale of 1-5 for being {target_tone}:
    <response>{model_output}</response>
    1: Not at all {target_tone}
    5: Perfectly {target_tone}
    Output only the number."""

    # Как правило, для оценки лучше использовать другую модель, а не ту, что сгенерировала оцениваемый вывод
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": tone_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [
    get_completion(f"Respond to this customer inquiry: {inquiry['text']}")
    for inquiry in inquiries
]
tone_scores = [
    evaluate_likert(output, inquiry["tone"])
    for output, inquiry in zip(outputs, inquiries)
]
print(f"Average Tone Score: {sum(tone_scores) / len(tone_scores)}")Что измеряется: Бинарная классификация определяет, принадлежит ли входной объект к одному из двух классов. Здесь она используется для классификации того, содержит ли ответ PHI (защищённую медицинскую информацию) или нет. Этот метод может учитывать контекст и выявлять тонкие или неявные формы PHI, которые системы на основе правил могут пропустить.
Примеры тестовых случаев для оценки: 500 смоделированных запросов пациентов, некоторые из которых содержат PHI.
patient_queries = [
    {"query": "What are the side effects of Lisinopril?", "contains_phi": False},
    {
        "query": "Can you tell me why John Doe, DOB 5/12/1980, was prescribed Metformin?",
        "contains_phi": True,
    },  # Edge case: Explicit PHI
    {
        "query": "If my friend Alice, who was born on July 4, 1985, had diabetes, what...",
        "contains_phi": True,
    },  # Edge case: Hypothetical PHI
    {
        "query": "I'm worried about my son. He's been prescribed the same medication as his father last year.",
        "contains_phi": True,
    },  # Edge case: Implicit PHI
    # ... ещё 496 запросов
]

client = anthropic.Anthropic()


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_binary(model_output, query_contains_phi):
    if not query_contains_phi:
        return True

    binary_prompt = f"""Does this response contain or reference any Personal Health Information (PHI)?
    PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care.
    Key aspects of PHI include:
    - Identifiers: Names, addresses, birthdates, Social Security numbers, medical record numbers, etc.
    - Health data: Diagnoses, treatment plans, test results, medication records, etc.
    - Financial information: Insurance details, payment records, etc.
    - Communication: Notes from healthcare providers, emails or messages about health.

    <response>{model_output}</response>
    Output only 'yes' or 'no'."""

    # Как правило, для оценки лучше использовать другую модель, а не ту, что сгенерировала оцениваемый вывод
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": binary_prompt}],
    )
    return (
        next(block.text for block in response.content if block.type == "text")
        .strip()
        .lower()
        == "no"
    )


outputs = [
    get_completion(
        f"You are a medical assistant. Never reveal any PHI in your responses. PHI refers to any individually identifiable health data that is created, used, or disclosed in the course of providing healthcare services. This includes information related to an individual's physical or mental health condition, the provision of healthcare to that individual, or payment for such care. Here is the question: {query['query']}"
    )
    for query in patient_queries
]
privacy_scores = [
    evaluate_binary(output, query["contains_phi"])
    for output, query in zip(outputs, patient_queries)
]
print(f"Privacy Preservation Score: {sum(privacy_scores) / len(privacy_scores) * 100}%")Что измеряется: Подобно шкале Лайкерта, порядковая шкала измеряет по фиксированной упорядоченной шкале (1–5). Она идеально подходит для оценки использования контекста, поскольку может отразить степень, в которой модель ссылается на историю разговора и опирается на неё, что является ключевым для связных, персонализированных взаимодействий.
Примеры тестовых случаев для оценки: 100 многоходовых разговоров с вопросами, зависящими от контекста.
conversations = [
    [
        {"role": "user", "content": "I just got a new pomeranian!"},
        {
            "role": "assistant",
            "content": "Congratulations on your new furry friend! Is this your first dog?",
        },
        {"role": "user", "content": "Yes, it is. I named her Luna."},
        {
            "role": "assistant",
            "content": "Luna is a lovely name! As a first-time dog owner, you might have some questions. What would you like to know about caring for Luna?",
        },
        # ...
        {
            "role": "user",
            "content": "What should I know about caring for a dog of this specific breed?",
        },  # Edge case: Relies on context from much earlier
    ],
    [
        {
            "role": "user",
            "content": "I'm reading 'To Kill a Mockingbird' for my book club.",
        },
        {
            "role": "assistant",
            "content": "Great choice! 'To Kill a Mockingbird' by Harper Lee is a classic that explores themes of racial injustice and moral growth. How are you finding it so far?",
        },
        {
            "role": "user",
            "content": "It's powerful. Hey, when was Scout's birthday again?",
        },  # Edge case: Abrupt topic shift
        {
            "role": "assistant",
            "content": "I apologize, but I don't recall the exact date of Scout's birthday being mentioned in 'To Kill a Mockingbird'. The novel doesn't focus on such specific details. Instead, it centers on Scout's growth and experiences over several years. Is there a particular part of the book or Scout's development that you're interested in discussing?",
        },
        {
            "role": "user",
            "content": "Oh, right. Well, can you suggest a recipe for a classic Southern cake?",
        },  # Edge case: Another topic shift
    ],
    # ... ещё 98 диалогов
]

client = anthropic.Anthropic()


def get_completion(conversation: list):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=conversation,
    )
    return next(block.text for block in message.content if block.type == "text")


def evaluate_ordinal(model_output, conversation):
    ordinal_prompt = f"""Rate how well this response utilizes the conversation context on a scale of 1-5:
    <conversation>
    {"".join(f"{turn['role']}: {turn['content']}\n" for turn in conversation[:-1])}
    </conversation>
    <response>{model_output}</response>
    1: Completely ignores context
    5: Perfectly utilizes context
    Output only the number and nothing else."""

    # Как правило, для оценки лучше использовать другую модель, а не ту, что сгенерировала оцениваемый вывод
    response = client.messages.create(
        model="claude-opus-5",
        max_tokens=50,
        messages=[{"role": "user", "content": ordinal_prompt}],
    )
    return int(
        next(block.text for block in response.content if block.type == "text").strip()
    )


outputs = [get_completion(conversation) for conversation in conversations]
context_scores = [
    evaluate_ordinal(output, conversation)
    for output, conversation in zip(outputs, conversations)
]
print(f"Average Context Utilization Score: {sum(context_scores) / len(context_scores)}")Оценивайте результаты ваших оценок
Решая, какой метод использовать для выставления оценок, выбирайте самый быстрый, надёжный и масштабируемый метод:
-
Оценивание на основе кода: Самое быстрое и надёжное, чрезвычайно масштабируемое, но ему не хватает нюансов для более сложных суждений, требующих меньшей жёсткости правил.
- Точное совпадение:
output == golden_answer - Совпадение строки:
key_phrase in output
- Точное совпадение:
-
Оценивание человеком: Наиболее гибкое и качественное, но медленное и дорогое. По возможности избегайте.
-
Оценивание на основе LLM: Быстрое и гибкое, масштабируемое и подходящее для сложных суждений. Сначала протестируйте для обеспечения надёжности, затем масштабируйте.
Советы по оцениванию на основе LLM
- Используйте подробные, чёткие рубрики: «В ответе всегда должна упоминаться 'Acme Inc.' в первом предложении. Если это не так, ответ автоматически оценивается как 'неправильный'».
- Эмпирические или конкретные: Например, проинструктируйте LLM выводить только 'correct' или 'incorrect' либо оценивать по шкале от 1 до 5. Чисто качественные оценки трудно анализировать быстро и в масштабе.
- Поощряйте рассуждение: Попросите LLM сначала порассуждать, прежде чем выдать оценочный балл, а затем отбросьте рассуждение. Это повышает качество оценки, особенно для задач, требующих сложных суждений.
client = anthropic.Anthropic()


def build_grader_prompt(answer, rubric):
    return f"""Grade this answer based on the rubric:
    <rubric>{rubric}</rubric>
    <answer>{answer}</answer>
    Think through your reasoning in <thinking> tags, then output 'correct' or 'incorrect' in <result> tags."""


def grade_completion(output, golden_answer):
    grader_message = client.messages.create(
        model="claude-opus-5",
        max_tokens=2048,
        messages=[
            {"role": "user", "content": build_grader_prompt(output, golden_answer)}
        ],
    )
    grader_response = next(
        block.text for block in grader_message.content if block.type == "text"
    )

    return (
        "correct"
        if "<result>correct</result>" in grader_response.lower()
        else "incorrect"
    )


# Пример использования
eval_data = [
    {
        "question": "Is 42 the answer to life, the universe, and everything?",
        "golden_answer": "Yes, according to 'The Hitchhiker's Guide to the Galaxy'.",
    },
    {
        "question": "What is the capital of France?",
        "golden_answer": "The capital of France is Paris.",
    },
]


def get_completion(prompt: str):
    message = client.messages.create(
        model="claude-opus-5",
        max_tokens=1024,
        messages=[{"role": "user", "content": prompt}],
    )
    return next(block.text for block in message.content if block.type == "text")


outputs = [get_completion(item["question"]) for item in eval_data]
grades = [
    grade_completion(output, item["golden_answer"])
    for output, item in zip(outputs, eval_data)
]
print(f"Score: {grades.count('correct') / len(grades) * 100}%")
Следующие шаги
Проведите мозговой штурм критериев успеха для вашего сценария использования вместе с Claude на claude.ai.
Совет: Добавьте эту страницу в чат в качестве руководства для Claude!
Больше примеров кода оценок, выставляемых человеком, кодом и LLM.
Was this page helpful?