Pensiero preservato
Il pensiero preservato consente a un modello di usare un blocco di pensiero di un turno precedente solo se è stato prodotto da quel modello o da uno precedente e se nulla prima del blocco è cambiato.
Il "preserved thinking" (pensiero preservato) è una proprietà dei modelli Claude più recenti che protegge dalla "distillation" (distillazione). Determina se il modello può usare un "thinking block" (blocco di pensiero) che rimandi da un turno precedente. A partire da Claude Fable 5.1, quando un blocco thinking o redacted_thinking torna in una richiesta, l'API verifica due aspetti nella signature del blocco:
- Il modello è quello che ha prodotto il blocco, o uno più recente. Un modello legge i propri blocchi di pensiero e quelli dei modelli precedenti. Claude Fable 5.1 legge i blocchi di Claude Opus 5, ma Claude Opus 5 non può leggere i blocchi di Claude Fable 5.1. Se il modello corrente non può leggere un blocco, l'API lo rimuove da quella richiesta senza restituire errori. Consulta Cambiare modello a metà conversazione.
- Nulla prima del blocco di pensiero è cambiato. Il prompt di sistema
systemdi primo livello,toolse imessagesche precedono il blocco costituiscono il suo "prefix" (prefisso). Se il prefisso differisce da ciò che hai inviato quando il blocco è stato prodotto, quel blocco e ogni blocco di pensiero successivo non sono validi, e l'API rifiuta la richiesta con un errore 400 oppure rimuove i blocchi non validi, a tua scelta. Consulta Mantenere invariato il prefisso.
Il controllo del modello si applica a ogni account. L'API applica il controllo del prefisso per impostazione predefinita agli account creati a partire dal 31 agosto 2026, 00:00 UTC. Sugli account meno recenti, applica il controllo del prefisso solo alle richieste che impostano thinking.block_binding.prefix_mismatch_behavior. I modelli futuri applicheranno il controllo del prefisso a tutti gli account, quindi rendi la tua integrazione "append-only" (solo in aggiunta) fin da ora.
Chi deve modificare qualcosa
Per te non cambia nulla se le tue richieste vengono costruite da Claude Code, claude.ai, Claude Managed Agents o dal Claude Agent SDK, oppure se il tuo codice mantiene fissi system e tools per una sessione e si limita ad aggiungere elementi in coda a messages. Claude Mythos 5.1 e i modelli precedenti a Claude Fable 5.1 non eseguono il controllo del prefisso. Se non rimandi mai i blocchi di pensiero, il controllo del prefisso non ha nulla da rifiutare, e il modello non riceve nulla del suo ragionamento precedente.
Controlla la tua integrazione se, tra due richieste della stessa conversazione, fa una delle seguenti cose. Ogni voce rimanda a cosa fare invece:
- Ricostruisce il prompt di sistema
system: la data, un flag di modalità, istruzioni di progetto rilette, oppure un plugin o un server "Model Context Protocol", o MCP, che si connette dopo il primo turno - Rigenera il contesto nel primo messaggio utente
- Cancella o accorcia vecchi risultati degli strumenti, o ricodifica vecchie immagini
- Riassume o elimina vecchi turni sul client e mantiene i turni recenti con il loro pensiero
- Aggiunge, rimuove o modifica voci in
tools - Aggiunge un promemoria a un turno utente e in seguito lo rimuove o lo riscrive
- Rimuove alcuni blocchi
thinkinge mantiene quelli successivi, oppure li rimuove e in seguito li reinserisce - Ricostruisce una sessione salvata a partire da template invece di riprodurre ciò che ha inviato
Su un account meno recente, nessuna di queste produce un errore a meno che la richiesta non imposti prefix_mismatch_behavior, quindi un'esecuzione senza errori con la tua chiave non mostra se il tuo codice è interessato. Se altre persone eseguono il tuo strumento con le proprie "API key" (chiavi API), quelle con account più recenti riceveranno l'errore 400 prima di te. Imposta prefix_mismatch_behavior nei tuoi test per vedere ciò che vedono loro.
Cambiare modello a metà conversazione
Claude Fable 5.1 e Claude Mythos 5.1 leggono i blocchi di pensiero prodotti l'uno dall'altro e dai modelli Claude precedenti. Nessun modello precedente legge i blocchi di pensiero di Claude Fable 5.1 o Claude Mythos 5.1.
- Una conversazione che passa a Claude Fable 5.1 mantiene il suo ragionamento. I blocchi di pensiero del modello precedente restano leggibili, quindi il modello ragiona come di consueto fin dal primo turno dopo il cambio.
- Una conversazione che passa a un modello precedente perde il ragionamento di Claude Fable 5.1 per quella richiesta. Questo accade quando un router invia un turno a un modello più economico, dopo un fallback per rifiuto del classificatore, o durante un fallback lato server. L'API rimuove i blocchi illeggibili prima che il prompt raggiunga il modello. Non vengono fatturati e non contano ai fini di
input_tokens.
Continua a inviare la cronologia completa a ogni richiesta, blocchi di pensiero inclusi, e lascia che l'API rimuova ciò che il modello corrente non può leggere. L'API non modifica mai il tuo array messages, quindi i blocchi rimossi restano nella tua cronologia. Quando la stessa cronologia torna a Claude Fable 5.1, i suoi blocchi sono di nuovo leggibili, insieme al pensiero del modello precedente. Il ragionamento va perso definitivamente solo se è il tuo client a rimuovere i blocchi, ad esempio un "harness" (ambiente di esecuzione dell'agente) che elimina il pensiero a un cambio di modello o ricostruisce la cronologia a partire da ciò che ogni modello ha usato.
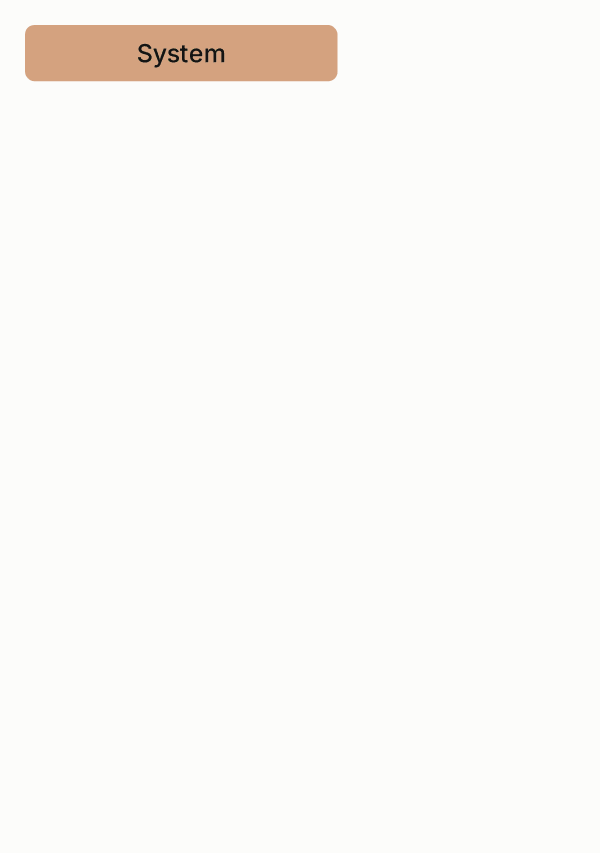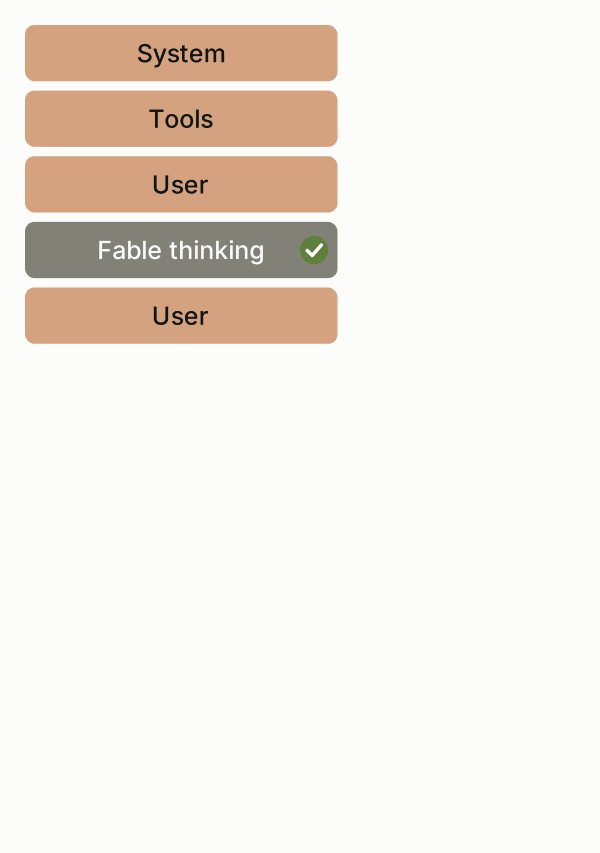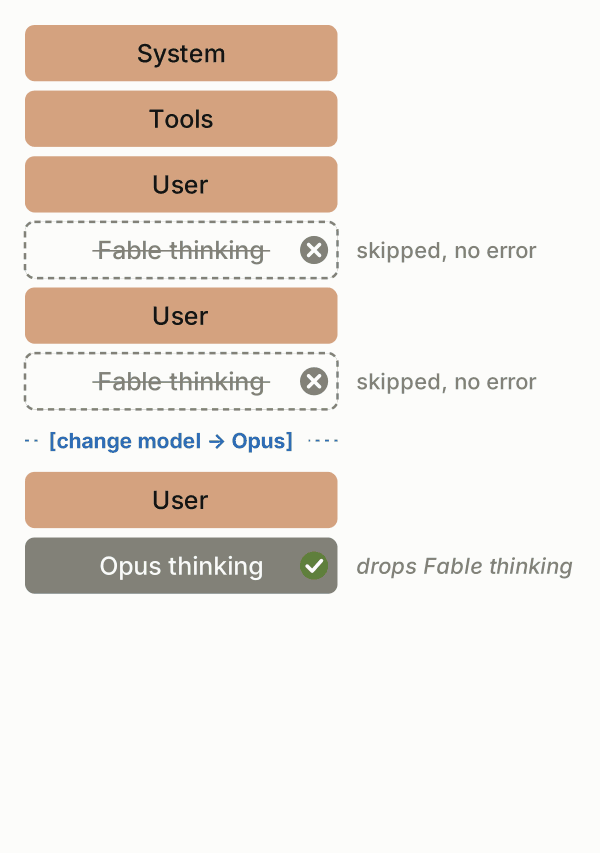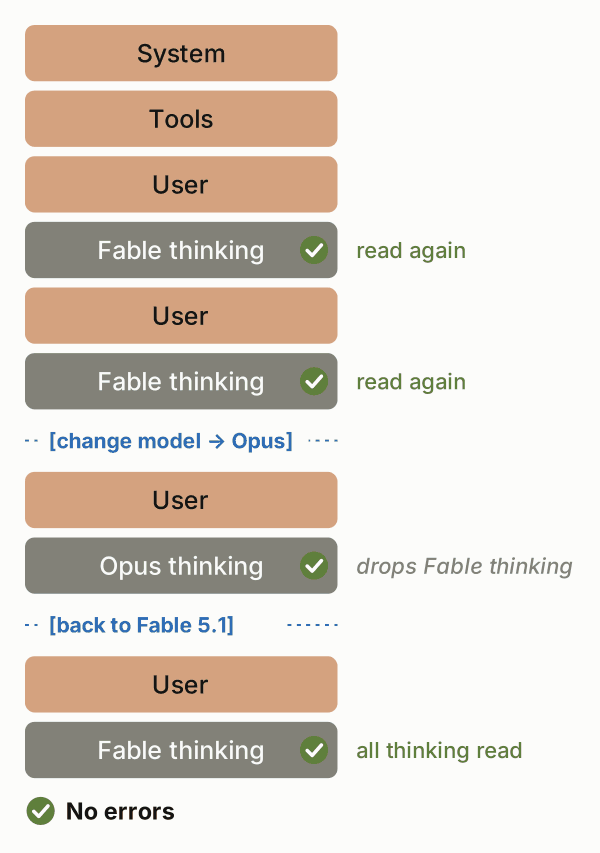
Con il beta header (header beta) thinking-binding-controls-2026-08-01, la risposta elenca ogni blocco rimosso in un array input_transformations di primo livello con reason: "model_binding_mismatch":
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.3.content.0",
      "reason": "model_binding_mismatch"
    }
  ]
}Senza l'header, la rimozione è silenziosa. Questa voce non indica un bug nella tua integrazione, e prefix_mismatch_behavior non ha alcun effetto su di essa: un blocco che il modello corrente non può leggere viene sempre rimosso.
Mantenere invariato il prefisso
Su Claude Fable 5.1, un blocco di pensiero resta valido solo finché tutto ciò che hai inviato prima di esso rimane invariato nelle richieste successive. Il prefisso controllato ha tre parti:
- Il prompt di sistema
systemdi primo livello - L'insieme dei
tools - Ogni
messageprima del blocco
Nota: con la compaction (compattazione) lato server, il prefisso controllato inizia dal blocco di compattazione più recente.
I parametri della richiesta al di fuori di questi tre campi, come effort, max_tokens, output_config, tool_choice e metadata, non fanno parte del controllo del prefisso, e nemmeno i marcatori cache_control. Cosa conta come modifica riporta l'elenco completo.
I blocchi di pensiero precedenti non fanno parte del prefisso, ma ogni blocco di pensiero registra quale blocco di pensiero lo ha preceduto, attraverso i turni. Puoi rimuovere blocchi di pensiero dall'inizio della cronologia (a partire dai più vecchi), dalla fine, oppure tutti. Ciò che fallisce è un buco: i blocchi di pensiero che mantieni devono essere una sequenza ininterrotta di quella originale, quindi rimuoverne uno dal mezzo invalida i blocchi di pensiero successivi. Una volta rimosso un blocco, lascialo fuori. Reinserirlo invalida i blocchi di pensiero prodotti mentre era assente.
Mantieni system e tools fissi per la sessione e tratta messages come append-only. La stessa disciplina mantiene stabile il prefisso per il prompt caching (cache dei prompt): le modifiche che invalidano il pensiero sono le stesse che fanno ripartire la cache.
Cosa fa l'API con un blocco non valido
Lo scegli con thinking.block_binding.prefix_mismatch_behavior:
"error"(predefinito): l'API rifiuta la richiesta con un errore 400invalid_request_errorche indica il primo blocco non valido."drop_block": l'API rimuove ogni blocco non valido e ogni blocco di pensiero successivo, e la richiesta va a buon fine. I blocchi rimossi non vengono fatturati. Il modello risponde a quel turno senza usare il ragionamento dei blocchi rimossi, e la cache dei prompt riparte dal punto della modifica. La risposta elenca ogni blocco rimosso ininput_transformations(nell'eventomessage_startdurante lo streaming) conreason: "prefix_binding_mismatch".
"drop_block" fa sì che le richieste continuino ad andare a buon fine, ma non corregge la modifica. Conta le risposte di ogni sessione il cui input_transformations contiene una voce prefix_binding_mismatch e imposta avvisi su di esse. Nella Message Batches API, un elemento che lascia il campo non impostato rimuove i blocchi non validi invece di restituire un errore, quindi imposta esplicitamente "error" lì se vuoi che gli elementi del batch falliscano.
Sia il campo sia l'array input_transformations richiedono l'header beta thinking-binding-controls-2026-08-01. Imposta il comportamento in caso di mancata corrispondenza e leggi input_transformations mostra la richiesta in ogni "software development kit" (kit di sviluppo software), o SDK.
Il messaggio 400 inizia così:
messages.1.content.0: Invalid `signature` in `thinking` block. The block is bound to a different conversation. Remove the block, or set `thinking.block_binding.prefix_mismatch_behavior` to "drop_block".Se la richiesta non ha inviato l'header beta, il messaggio prosegue:
That setting requires the `thinking-binding-controls-2026-08-01` value in the `anthropic-beta` header.Di solito termina con una frase che indica cosa è cambiato, ad esempio che il prompt di sistema system o l'elenco tools differisce da quando il blocco è stato creato. Risoluzione dei problemi del pensiero descrive cosa può indicare quella frase.
Una firma manomessa o non decifrabile è un errore diverso. Restituisce sempre un 400 (Invalid `signature` in `thinking` block senza alcuna frase sulla conversazione), e prefix_mismatch_behavior non si applica.
Gestisci l'errore nel codice
Questo è l'errore 400 invalid_request_error mostrato in precedenza in questa sezione. Non inviare di nuovo lo stesso body: fallisce allo stesso modo ogni volta. Riprova una volta con l'header beta e prefix_mismatch_behavior: "drop_block", e memorizza questa scelta insieme alla sessione in modo che ogni richiesta successiva la invii, anche dopo un riavvio. Se non puoi inviare l'header beta, rimuovi una volta tutti i blocchi thinking e redacted_thinking dalla cronologia, lasciali fuori e continua. Poi correggi la modifica che ha causato la mancata corrispondenza.
Imposta il comportamento in caso di mancata corrispondenza e leggi input_transformations
L'header beta thinking-binding-controls-2026-08-01 aggiunge:
- Un array
input_transformationsdi primo livello in ogni risposta - Un oggetto
block_bindingnella configurazionethinking, il cui unico campo èprefix_mismatch_behavior
block_binding è accettato insieme a thinking.type: "adaptive" e thinking.type: "enabled". Inviarlo senza l'header beta restituisce un errore 400 il cui messaggio termina con block_binding: Extra inputs are not permitted. I modelli che non eseguono il controllo del prefisso accettano l'oggetto e segnalano solo le rimozioni dovute al controllo del modello, quindi lo stesso body della richiesta funziona con tutti i modelli. Il riferimento API chiama il controllo del prefisso "conversation check" (controllo della conversazione).
La seguente richiesta sceglie la rimozione anziché il rifiuto. Al primo turno non c'è nulla da riprodurre, quindi input_transformations torna vuoto:
client = anthropic.Anthropic()

response = client.beta.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    thinking={
        "type": "adaptive",
        "block_binding": {"prefix_mismatch_behavior": "drop_block"},
    },
    messages=[
        {
            "role": "user",
            "content": "What is the greatest common divisor of 1071 and 462?",
        }
    ],
    betas=["thinking-binding-controls-2026-08-01"],
)

for block in response.content:
    if block.type == "text":
        print(block.text)

print(f"Input transformations: {len(response.input_transformations or [])}")The greatest common divisor of 1071 and 462 is 21.
Input transformations: 0Con l'header beta, ogni risposta di un modello con capacità di pensiero include input_transformations. È vuoto quando non è stato rimosso nulla. Ogni voce ha type: "thinking_dropped", il path del blocco rimosso (ad esempio messages.1.content.0) e un reason pari a prefix_binding_mismatch o model_binding_mismatch (consulta Cambiare modello a metà conversazione). Ignora le voci il cui type o reason non riconosci, perché controlli futuri aggiungeranno nuovi valori.
Durante lo streaming (trasmissione in flusso), l'array arriva nell'oggetto message dell'evento message_start. Dopo un fallback lato server a metà stream, l'evento message_delta finale lo riporta di nuovo con le voci del modello che ha servito la richiesta. In un batch di messaggi, un elemento il cui blocco non supera il controllo del prefisso con "error" esplicito si risolve come errored, mentre un elemento che lascia il campo non impostato rimuove invece i blocchi non validi. L'endpoint di conteggio dei token esegue lo stesso controllo del prefisso e restituisce lo stesso 400.
Quando l'API applica il controllo
Il controllo del prefisso viene eseguito su Claude Fable 5.1 per i nuovi account.
- Account creati a partire dal 31 agosto 2026, 00:00 UTC: l'API controlla le richieste a Claude Fable 5.1 e applica
"error"a meno che tu non imposti"drop_block". La stessa definizione di nuovo account si applica alla Claude API e alle piattaforme cloud. - Account meno recenti: l'API controlla le richieste che impostano
prefix_mismatch_behavior. Questo parametro attiva il controllo per la richiesta, così puoi vedere ciò che vede un nuovo account senza crearne uno. - Modelli futuri: ogni account, a ogni richiesta.
Per scoprire a quale gruppo appartiene il tuo account, prendi una conversazione con Claude Fable 5.1 che contiene un blocco di pensiero, modifica qualcosa prima di quel blocco e inviala a Claude Fable 5.1 senza l'header beta né il campo block_binding. Una risposta 400 che menziona l'header significa che il controllo è applicato al tuo account per impostazione predefinita.
Cosa conta come modifica
Ogni riga confronta due richieste consecutive:
| Modifica tra le richieste | Blocchi di pensiero successivi |
|---|---|
| Aggiungere messaggi in fondo | Validi |
Aggiungere uno strumento con defer_loading: true a cui nulla ha ancora fatto riferimento | Validi |
Rimuovere blocchi thinking dall'inizio della cronologia, dalla fine, oppure tutti | Validi (il modello perde quel ragionamento) |
Modificare qualsiasi parametro della richiesta al di fuori di system, tools e messages (effort, max_tokens, output_config, tool_choice, metadata, thinking.display e così via) | Validi |
Aggiungere, spostare o rimuovere marcatori cache_control | Validi |
| Un URL firmato a rotazione che restituisce gli stessi byte | Validi |
| La compattazione o il "context editing" (modifica del contesto) lato server rimuove o sostituisce contenuto | Validi (il controllo confronta ciò che hai inviato, non la copia modificata dal server) |
| Un messaggio di sistema con ambito di turno cancellato e lasciato al suo posto | Validi |
Modificare, riordinare o eliminare qualsiasi messaggio user, assistant o system precedente | Non validi, tranne quando il blocco firmato della compattazione on demand sostituisce i messaggi che riassume, alle condizioni descritte in Compattazione con coda mantenuta |
| Rigenerare con un valore modificato il contesto che hai inserito nel primo messaggio utente | Non validi per ogni blocco di pensiero |
Cancellare o accorciare un tool_result precedente, ricodificare un'immagine precedente o modificare l'input di un tool_use precedente | Non validi per ogni blocco di pensiero successivo |
| Aggiungere un blocco di testo a un turno utente precedente, o rimuoverne uno aggiunto la volta precedente | Non validi |
Modificare la stringa o i blocchi system di primo livello | Non validi |
Aggiungere, rimuovere, rinominare o modificare uno strumento in tools | Non validi |
Rimuovere un blocco thinking dal mezzo della cronologia e mantenere quelli successivi | Non validi per ogni blocco di pensiero successivo |
Reinserire un blocco thinking rimosso in una richiesta precedente | Non validi per i blocchi di pensiero prodotti mentre era assente |
| Un URL di immagine o documento che restituisce byte diversi alla richiesta successiva | Non validi |
| Lo stesso messaggio con ambito di turno eliminato o riformulato in una richiesta successiva | Non validi |
Verifica se il tuo codice modifica il prefisso
Per prima cosa, confronta ciò che invii. Cattura i body delle richieste che la tua integrazione invia nel corso di alcuni turni normali, inclusa una compattazione o una modifica degli strumenti. Per ogni coppia di richieste consecutive, confronta system, tools e i messages che hanno in comune. Devono essere identici fino ai turni appena aggiunti.
Poi verifica con l'API. Aggiungi l'header beta thinking-binding-controls-2026-08-01, imposta prefix_mismatch_behavior su "drop_block" ed esegui una normale sessione multi-turno tramite la tua integrazione su . L'esempio seguente esegue due turni nel modo in cui dovrebbe farlo la tua integrazione: messages cresce soltanto, ogni turno dell'assistente viene rimandato esattamente come l'API lo ha restituito, blocchi thinking inclusi, e block_binding è impostato in ogni richiesta. Dopo ogni turno stampa il numero di blocchi thinking nella risposta e il numero di blocchi rimossi:
client = anthropic.Anthropic()

user_turns = [
    "How many positive integers below 500 have exactly 6 positive divisors?",
    "How many of those are odd?",
]

# messages cresce a ogni turno: ogni turno dell'assistente viene rinviato esattamente come restituito
messages = []
for user_turn in user_turns:
    messages.append({"role": "user", "content": user_turn})
    response = client.beta.messages.create(
        model="claude-fable-5-1",
        max_tokens=16000,
        thinking={
            "type": "adaptive",
            "block_binding": {"prefix_mismatch_behavior": "drop_block"},
        },
        messages=messages,
        betas=["thinking-binding-controls-2026-08-01"],
    )
    messages.append({"role": "assistant", "content": response.content})
    thinking_blocks = sum(block.type == "thinking" for block in response.content)
    dropped = len(response.input_transformations or [])
print(f"thinking blocks: {thinking_blocks}, dropped: {dropped}")thinking blocks: 1, dropped: 0
thinking blocks: 1, dropped: 0Nessuno dei due turni rimuove un blocco perché nulla di precedente è cambiato. Verifica che la prima risposta contenga un blocco thinking. Con l'"adaptive thinking" (pensiero adattivo), alcune risposte non ne hanno. Se nessuna risposta della sessione ne contiene uno, non c'è nulla da controllare e il conteggio dei blocchi rimossi è 0 qualunque cosa tu modifichi, quindi esegui di nuovo l'esempio.
Registra input_transformations a ogni turno della tua integrazione. Quando l'API rimuove un blocco, la voce ha questo aspetto:
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.1.content.0",
      "reason": "prefix_binding_mismatch"
    }
  ]
}- Vuoto a ogni turno di una sessione che contiene blocchi
thinking: la tua integrazione mantiene intatto il prefisso. reason: "prefix_binding_mismatch": qualcosa prima del blocco inpathè cambiato rispetto alla richiesta precedente. Confrontasystem,toolsemessagesfino a quel turno per trovarlo, oppure invia di nuovo la richiesta con"error": il 400 di solito termina con una frase che indica cosa è cambiato. Poi trova l'alternativa corrispondente in Apportare modifiche senza modificare il prefisso.reason: "model_binding_mismatch": la conversazione è passata a un modello che non può leggere i blocchi del modello precedente. Non si tratta di una modifica del prefisso. Consulta Cambiare modello a metà conversazione.
Per provocare un errore di proposito, invia un terzo turno dall'esempio precedente e aggiungi un prompt di sistema system solo a quella richiesta, in modo che differisca dalle prime due richieste, che non ne avevano. Con "drop_block", il conteggio dei blocchi rimossi non è più 0: la risposta ha una voce per ogni blocco di pensiero nella cronologia, ciascuna con reason: "prefix_binding_mismatch". Con "error", la richiesta restituisce il 400 descritto in Cosa fa l'API con un blocco non valido, e la sua ultima frase indica il prompt di sistema system. Nelle schede cURL e CLI, rimuovi il filtro jq per vedere il body dell'errore. Se il conteggio è ancora 0, non c'era nulla da controllare: verifica che il modello sia , che la richiesta imposti block_binding, che la cronologia inviata contenga blocchi thinking e che le prime due richieste non avessero un prompt di sistema system.
Due semplici turni raramente mostrano il problema. Esegui una sessione per ciascuno dei seguenti casi, con "error" impostato in modo che una regressione faccia fallire la tua "continuous integration" (integrazione continua), o CI:
- La prima compattazione o il primo taglio lato client
- Uno strumento, un plugin o un server MCP che si connette dopo il primo turno
- Un cambio di modalità o di istruzioni
- Un lungo ciclo di strumenti, se aggiungi promemoria o accorci vecchi risultati degli strumenti
- Un passaggio a un altro modello e ritorno
- Un salvataggio, un riavvio e una ripresa in una data successiva
Apportare modifiche senza modificare il prefisso
Ogni modifica comune del prefisso ha un'alternativa che fornisce al modello le stesse informazioni e lascia invariati i byte precedenti, così il pensiero successivo resta valido. Trova nella prima colonna la modifica che il tuo codice fa oggi:
| Invece di | Usa | Header beta |
|---|---|---|
Ricostruire il prompt di sistema system di primo livello | Un messaggio di sistema a metà conversazione | Nessuno |
| Rigenerare a ogni richiesta il contesto nel tuo primo messaggio utente (ambiente, data, memoria, istruzioni di progetto) | Generalo una volta e invialo di nuovo invariato. Quando qualcosa cambia, inserisci la nuova versione nel turno più recente | Nessuno |
Cancellare o accorciare sul posto il contenuto di vecchi tool_result, o ricodificare vecchie immagini | Accorcia un risultato dello strumento o riduci la risoluzione di un'immagine prima di inviarli per la prima volta, non dopo. Per cancellare vecchi risultati in seguito, riduci il contesto sul server con clear_tool_uses_20250919 | context-management-2025-06-27 |
| Inserire un promemoria ed eliminarlo alla richiesta successiva | Un messaggio di sistema con ambito di turno (clear_at: "next_user_message") | mid-conversation-system-clear-at-2026-08-21 |
Aggiungere o rimuovere voci in tools | Blocchi tool_addition e tool_removal | mid-conversation-tool-changes-2026-07-01 |
Modificare output_config.effort di primo livello (fa ripartire la cache, non influisce sul pensiero) | Un output_config per messaggio | mid-conversation-output-config-2026-07-01 |
| Eliminare o riassumere vecchi turni sul client | La compattazione on demand per mantenere i turni recenti con il loro pensiero, altre forme di compattazione o context editing lato server, oppure una compattazione lato client che non mantiene pensiero obsoleto | compact-2026-09-04 (non su Amazon Bedrock o Google Cloud) |
| Un URL di immagine o documento i cui byte cambiano tra le richieste | Un file_id dalla Files API, o base64 | Nessuno |
Tutte queste soluzioni presuppongono che tu rimandi i turni dell'assistente esattamente come restituiti. I messaggi di sistema a metà conversazione, i messaggi di sistema con ambito di turno e le modifiche agli strumenti non sono disponibili su tutti i modelli: Messaggi di sistema e modifiche agli strumenti a metà conversazione elenca i modelli che li accettano. Se il tuo codice serve più modelli, continua a modificare il prompt di sistema system di primo livello per i modelli che non li accettano.
Per usare più beta in una richiesta, combina i valori in un unico header anthropic-beta. I nomi delle beta sono gli stessi su Amazon Bedrock e Google Cloud ovunque la beta sia disponibile (consulta Header beta):
anthropic-beta: thinking-binding-controls-2026-08-01,mid-conversation-system-clear-at-2026-08-21,mid-conversation-tool-changes-2026-07-01Rimanda i turni dell'assistente esattamente come restituiti
Memorizza l'array content di ogni risposta e rimandalo invariato come turno dell'assistente: ogni tipo di blocco, nell'ordine ricevuto, inclusi i blocchi thinking il cui campo thinking è vuoto. Un serializzatore che elimina i tipi di blocco sconosciuti, elimina i campi vuoti o riordina i blocchi modifica il prefisso per ogni turno successivo.
Su Claude Fable 5.1, il campo thinking è vuoto per impostazione predefinita e la signature trasporta il ragionamento, quindi un serializzatore che salta i blocchi vuoti rimuove il pensiero. Se li rimuove tutti, nulla fallisce e il modello perde il suo ragionamento precedente a ogni turno. Se analizzi lo stream autonomamente, mantieni il blocco anche quando non arriva alcun testo di pensiero: si apre, riceve la sua signature in un evento signature_delta e si chiude. Un blocco rimandato con una signature vuota fallisce.
Aggiungi istruzioni con un messaggio di sistema a metà conversazione
Alcuni harness ricostruiscono il prompt di sistema system di primo livello a ogni richiesta per includere l'ora corrente, un budget di token, un flag di modalità o contesto di progetto appena scoperto. Questo invalida ogni blocco di pensiero della conversazione. Invece, congela system all'inizio della sessione. Quando qualcosa cambia, aggiungi un messaggio role: "system" nel punto di messages in cui il cambiamento diventa vero:
{
  "role": "system",
  "content": "The user switched the workspace to read-only mode. Do not write files until told otherwise."
}Il modello tratta questo messaggio con l'autorità di un prompt di sistema, e tutto ciò che lo precede resta invariato. In un ciclo di strumenti, posiziona il messaggio dopo il messaggio utente con il tool_result, mai tra un tool_use dell'assistente e il relativo tool_result (consulta Limitazioni). Una volta inviato, il messaggio fa parte del prefisso per il pensiero successivo: lascialo al suo posto nelle richieste successive.
Inserisci il contesto che cambia nel turno più recente
Alcuni harness inseriscono un blocco di ambiente nel primo messaggio utente (directory di lavoro, branch, data, memoria, istruzioni di progetto) e lo rigenerano a ogni richiesta. Quando un valore cambia, messages[0] cambia, e ogni blocco di pensiero della conversazione non è più valido. Genera quel blocco una volta e invialo di nuovo così com'era. Quando un valore cambia, segnalalo nel turno più recente: aggiungi un blocco di testo al messaggio utente che stai per inviare, oppure aggiungi un messaggio di sistema a metà conversazione se il cambiamento proviene da te in qualità di operatore.
{
  "role": "user",
  "content": [
    {
      "type": "text",
      "text": "Environment update: the current branch is now release-2."
    },
    { "type": "text", "text": "Run the tests again." }
  ]
}Una volta inviato, quel blocco di testo fa parte del prefisso per il pensiero successivo: lascialo al suo posto nelle richieste successive.
Invia i promemoria per turno come messaggi di sistema con ambito di turno
Una modifica comune del prefisso è il promemoria per turno: una riga come "esegui insieme le letture indipendenti" o "non aggiorni l'utente da un po'" che il tuo codice aggiunge dopo ogni gruppo di risultati degli strumenti. Per evitare che i promemoria si accumulino, invia ogni promemoria come messaggio di sistema a metà conversazione con clear_at: "next_user_message", posizionato dopo il messaggio utente con il tool_result. clear_at richiede l'header beta mid-conversation-system-clear-at-2026-08-21. Il seguente array messages è la richiesta dopo due chiamate agli strumenti e i relativi risultati. messages[3] è il promemoria della richiesta precedente, lasciato al suo posto, e messages[6] è la copia di questa richiesta:
[
  { "role": "user", "content": "Fix the failing test." },
  {
    "role": "assistant",
    "content": [
      { "type": "thinking", "thinking": "", "signature": "..." },
      {
        "type": "tool_use",
        "id": "toolu_01",
        "name": "read_file",
        "input": { "path": "tests/test_auth.py" }
      }
    ]
  },
  {
    "role": "user",
    "content": [{ "type": "tool_result", "tool_use_id": "toolu_01", "content": "..." }]
  },
  {
    "role": "system",
    "clear_at": "next_user_message",
    "content": "Request every independent read in one turn."
  },
  {
    "role": "assistant",
    "content": [
      { "type": "thinking", "thinking": "", "signature": "..." },
      {
        "type": "tool_use",
        "id": "toolu_02",
        "name": "read_file",
        "input": { "path": "src/auth.py" }
      }
    ]
  },
  {
    "role": "user",
    "content": [{ "type": "tool_result", "tool_use_id": "toolu_02", "content": "..." }]
  },
  {
    "role": "system",
    "clear_at": "next_user_message",
    "content": "Request every independent read in one turn."
  }
]Un messaggio utente che contiene solo blocchi tool_result conta come "next user message" (messaggio utente successivo), quindi messages[3] è già cancellato. Non aggiunge nulla a ciò che il modello vede e non costa token di input, ma poiché è ancora nell'array, il pensiero in messages[4] resta valido. messages[6] è la copia che il modello vede in questo turno. Nelle richieste successive, mantieni entrambi dove sono e aggiungi una nuova copia dopo il successivo messaggio tool_result.
Aggiungi o rimuovi strumenti con tool_addition e tool_removal
Modificare l'array tools a metà sessione invalida i blocchi di pensiero preservati. Invece, dichiara in tools alla prima richiesta ogni strumento di cui la sessione potrebbe aver bisogno e non modificare mai l'array. Per cambiare gli strumenti che il modello può usare da un certo punto in poi, aggiungi un messaggio role: "system" che contiene un blocco tool_removal o tool_addition. Queste sono modifiche agli strumenti a metà conversazione e richiedono l'header beta mid-conversation-tool-changes-2026-07-01. Ad esempio, per ritirare uno strumento pericoloso dopo un cambio di modalità:
{
  "role": "system",
  "content": [
    { "type": "tool_removal", "tool": { "type": "tool_reference", "name": "delete_branch" } },
    { "type": "text", "text": "Branch deletion is disabled for the rest of this session." }
  ]
}Per offrire invece uno strumento in un secondo momento, dichiaralo in tools con defer_loading: true in modo che il modello inizialmente non lo veda. Quando diventa disponibile, aggiungi un blocco tool_addition:
{
  "role": "system",
  "content": [
    { "type": "tool_addition", "tool": { "type": "tool_reference", "name": "deploy" } },
    { "type": "text", "text": "Authentication succeeded. Deployment is now available." }
  ]
}A volte non puoi dichiarare uno strumento in anticipo perché non ne conosci ancora lo schema. Un server MCP scoperto in fase di esecuzione è il caso tipico. Aggiungi quello strumento a tools con defer_loading: true, poi offrilo con un blocco tool_addition. Aggiungere uno strumento differito è sicuro: il controllo del prefisso ignora uno strumento differito finché un blocco tool_addition non vi fa riferimento, quindi il pensiero precedente resta valido. Aggiungere uno strumento senza defer_loading: true modifica il prefisso e invalida il pensiero precedente.
I messaggi role: "system" che contengono questi blocchi entrano a far parte del prefisso per il pensiero successivo. Lasciali al loro posto nelle richieste successive.
Modifica l'effort con un output_config per messaggio
Modificare output_config.effort di primo livello tra le richieste non invalida il pensiero, perché l'"effort" (livello di impegno) non fa parte del prefisso. Modificare l'effort di primo livello fa però ripartire la cache dei prompt. Su Claude Fable 5.1, usa invece l'effort per messaggio: aggiungi un messaggio role: "system" con content vuoto e il nuovo livello. Richiede l'header beta mid-conversation-output-config-2026-07-01.
{ "role": "system", "content": [], "output_config": { "effort": "low" } }Il nuovo livello ha effetto a partire dal turno user successivo. Una volta inviato, il messaggio fa parte di messages e quindi del prefisso per il pensiero successivo: lascialo al suo posto nelle richieste successive, e aggiungine un altro per modificare di nuovo l'effort.
Riduci il contesto sul server
Un'altra modifica comune del prefisso è il "trimming" (riduzione) lato client: eliminare o riassumere i turni più vecchi mantenendo alla lettera quelli recenti. I blocchi di pensiero dei turni mantenuti sono stati prodotti quando la cronologia rimossa era ancora presente, quindi non superano il controllo. Gli equivalenti lato server non contano come modifiche, perché il controllo confronta la conversazione così come l'hai inviata:
- La compattazione riassume i turni più vecchi in un blocco di compattazione quando il contesto si avvicina a una soglia da te impostata, e il prefisso controllato riparte da quel blocco. Il suo parametro
instructionsaccetta un tuo prompt di riepilogo, come "conserva ogni ticker, dimensione di posizione e ipotesi dichiarata". La compattazione on demand (beta) restituisce il riepilogo da una richiesta separata, che può essere eseguita in background. Invia"compaction": {"type": "summarize"}nel body della richiesta, e la risposta contiene un singolo bloccocompaction, con il riepilogo e una firma, invece di una risposta. La compattazione on demand è disponibile sulla Claude API ma non su Amazon Bedrock o Google Cloud, e richiede l'header betacompact-2026-09-04nella richiesta di riepilogo e in ogni richiesta successiva che contiene il blocco. Invii il blocco al posto dei messaggi che riassume. Il controllo accetta questa sostituzione, quindi i turni che mantieni possono restare validi con il loro pensiero, alle condizioni descritte in Compattazione con coda mantenuta. - Il context editing cancella vecchi risultati degli strumenti o vecchi blocchi di pensiero in base a regole, a partire dai più vecchi. Le strategie sono
clear_tool_uses_20250919eclear_thinking_20251015.
Compattare sul client
Puoi comunque eseguire la "compaction" (compattazione) sul client. Se scrivi tu stesso il riepilogo, non rinviare un blocco di thinking prodotto prima della riscrittura. Se è l'API a scriverlo con la compattazione on-demand, Compattazione keep-tail elenca i casi in cui il thinking mantenuto resta valido.
Compattazione semplice (consigliata)
Quando la conversazione diventa troppo lunga, riassumi l'intera sessione in un unico messaggio utente e invia solo quel messaggio più l'istruzione successiva. Nessun contenuto precedente viene riproposto, quindi non resta alcun thinking che possa non superare il controllo, e il modello ragiona da capo a partire dal riepilogo.
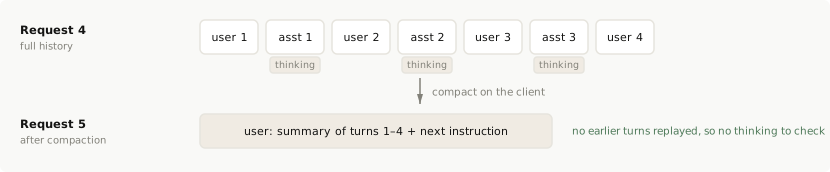
[
  {
    "role": "user",
    "content": "<summary of the session so far>\n\n<the next instruction>"
  }
]I modelli Claude sono addestrati su attività a lungo orizzonte con questo schema, che offre buone prestazioni per la maggior parte dei carichi di lavoro.
Compattazione keep-tail
La "keep-tail compaction" (compattazione con mantenimento della coda) riassume i turni più vecchi e mantiene alla lettera i turni più recenti, così il modello vede ancora parola per parola gli ultimi scambi. Se scrivi tu stesso il riepilogo, la regola viene violata: i turni dell'assistente mantenuti contengono ancora blocchi di thinking prodotti quando a precederli c'erano i turni originali, non il riepilogo. Quei blocchi non superano il controllo.
Per mantenere quel thinking, fai scrivere il riepilogo all'API con la compattazione on-demand. Invia solo i turni più vecchi in una richiesta con il parametro compaction e l'header beta compact-2026-09-04. Poi invia il blocco firmato restituito al posto di quei turni, seguito dai turni mantenuti esattamente come sono stati restituiti. Il thinking mantenuto resta valido finché valgono tutte queste condizioni:
- La richiesta di compattazione viene eseguita su un modello con pensiero preservato. Il modello usato dalla conversazione stessa è la scelta più semplice.
- I turni mantenuti seguono direttamente i messaggi riassunti, e il primo messaggio mantenuto non è uno che l'API unirebbe all'ultimo messaggio riassunto: un messaggio con lo stesso ruolo, o un messaggio
role: "system". systeme i tuoitoolsnon differiti corrispondono a quelli della richiesta di compattazione.
Il modo più semplice per soddisfare la seconda condizione è compattare esattamente i messages di una richiesta che hai già effettuato. Anche i messaggi di sistema a metà conversazione all'interno dei turni riassunti vengono riassunti, quindi le loro istruzioni e modifiche agli strumenti smettono di applicarsi dopo la sostituzione. Per mantenerne uno in vigore, ripetilo in un messaggio role: "system" subito dopo il primo nuovo turno user che segue i turni mantenuti. Un messaggio di sistema posizionato tra il blocco e i turni mantenuti invalida il loro thinking.
Il resto di questa sezione riguarda un riepilogo che scrivi tu stesso.
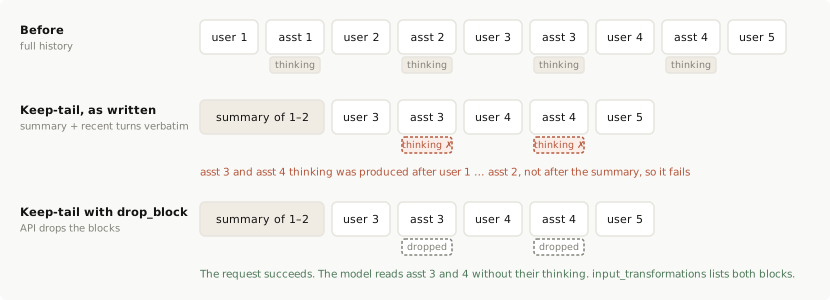
Soluzione: mantieni i turni esattamente come sono e invia prefix_mismatch_behavior: "drop_block". L'API scarta i blocchi di thinking obsoleti, il modello legge i blocchi text e tool_use dei turni mantenuti e la richiesta ha esito positivo.
Passa la cronologia compattata come messages e imposta block_binding nella configurazione thinking. Nell'esempio seguente, compacted_messages è l'array prodotto dal tuo passaggio di compattazione: il messaggio di riepilogo seguito dai turni mantenuti esattamente come li ha restituiti l'API, blocchi thinking inclusi:
client = anthropic.Anthropic()

# compacted_messages: il messaggio di riepilogo, poi i turni mantenuti così come restituiti
response = client.beta.messages.create(
    model="claude-fable-5-1",
    max_tokens=16000,
    thinking={
        "type": "adaptive",
        "block_binding": {"prefix_mismatch_behavior": "drop_block"},
    },
    messages=compacted_messages,
    betas=["thinking-binding-controls-2026-08-01"],
)

print(response.input_transformations)
La risposta contiene il nuovo turno dell'assistente come di consueto, più una voce input_transformations per ogni blocco scartato. Per la cronologia nel diagramma, si tratta del thinking sui turni dell'assistente 3 e 4:
{
  "input_transformations": [
    {
      "type": "thinking_dropped",
      "path": "messages.2.content.0",
      "reason": "prefix_binding_mismatch"
    },
    {
      "type": "thinking_dropped",
      "path": "messages.4.content.0",
      "reason": "prefix_binding_mismatch"
    }
  ]
}Continua a inviare "drop_block" nelle richieste successive finché quei due turni restano nella cronologia. Il thinking che il modello produce da questa richiesta in poi segue il riepilogo e resta valido. Se preferisci non dipendere dall'header beta, l'alternativa è rimuovere tu stesso i blocchi thinking e redacted_thinking dai turni dell'assistente mantenuti quando costruisci la cronologia compattata.
Compattazione in background (asincrona)
La compattazione in background costruisce il riepilogo al di fuori del percorso critico mentre la conversazione prosegue, poi lo sostituisce alcune richieste dopo. Fai scrivere il riepilogo all'API con la compattazione on-demand:
- Invia la conversazione fino a quel momento in una richiesta separata con il parametro
compactione l'header betacompact-2026-09-04. - Continua a lavorare sulla cronologia completa mentre quella richiesta è in esecuzione.
- Nella prima richiesta dopo l'arrivo del blocco, invialo al posto dei messaggi contenuti nella richiesta di compattazione, seguito da ogni turno aggiunto da allora.
Il thinking prodotto mentre il riepilogo veniva costruito resta valido alle stesse condizioni descritte in Compattazione keep-tail.
Un riepilogo che costruisci tu stesso viola la regola allo stesso modo della compattazione keep-tail, ma con un ritardo: ogni turno dell'assistente prodotto mentre il riepilogo veniva costruito contiene thinking antecedente alla sostituzione, e tutto questo thinking non supera il controllo nel momento in cui il riepilogo viene inserito. Se ne usi uno, tratta la sostituzione come nella compattazione keep-tail e invia "drop_block" dalla sostituzione in poi, oppure compatta in modo sincrono.
Schemi che non funzionano con il pensiero preservato
- Tagliare turni dal mezzo. La rimozione di singoli turni invalida ogni blocco di thinking successivo, e nessuno schema di compattazione lo evita. Se stavi tagliando un turno per modificare un'istruzione, aggiungi invece un messaggio di sistema a metà conversazione. Per rimuovere selettivamente vecchi risultati degli strumenti o vecchio thinking, usa il "context editing" (modifica del contesto) lato server: consulta modifica del contesto.
- Compattare nel mezzo di un round di strumenti. Non compattare tra il
tool_usedi un turno dell'assistente e iltool_resultche gli risponde. Rinvia quel turno dell'assistente con il suo thinking intatto, così il modello completa il round con il suo ragionamento. Consulta Preservare i blocchi di thinking.
Fai riferimento ai file tramite ID, non tramite un URL il cui contenuto cambia
Per un blocco image o document con una sorgente url, il controllo riguarda i byte recuperati, non la stringa dell'URL. Un URL il cui contenuto cambia invalida il thinking successivo: ad esempio un endpoint "ultimo screenshot", o un documento che qualcuno modifica tra un turno e l'altro. Un URL firmato a rotazione per lo stesso file non lo invalida. Per i contenuti a cui fai riferimento in più turni, caricali una volta con la Files API e usa il file_id, oppure inviali in base64.
Librerie, proxy e gateway
Una libreria, un proxy o un gateway si trova tra la cronologia di qualcun altro e l'API, quindi le sue riscritture contano come modifiche, e i suoi utenti non possono vederle né correggerle.
- Inoltra ciò che non riconosci. Inoltra invariati i valori
anthropic-betaethinking.block_bindingdel chiamante, e restituiscigliinput_transformations. Uno schema di opzioni che rifiuta le chiavi sconosciute impedisce ai tuoi utenti di scegliere"drop_block". - Lascia un messaggio
role: "system"dove il chiamante lo ha messo. Spostarlo nel camposystemdi primo livello modificasystemin quella richiesta e invalida ogni blocco di thinking nella conversazione. - Per disattivare l'uso degli strumenti per una richiesta, invia
tool_choice: {"type": "none"}. Non rimuoveretools. - Non nascondere il 400. Se il tuo codice lo intercetta, rimuove il thinking e riprova per conto del chiamante, registra che lo ha fatto: la cronologia del chiamante risulta comunque modificata, e il modello perde il suo ragionamento precedente in ogni richiesta successiva.
Domande frequenti
No. Invia l'header beta thinking-binding-controls-2026-08-01 e imposta thinking.block_binding.prefix_mismatch_behavior. Impostando il campo, il controllo viene applicato a quella richiesta indipendentemente dall'anzianità dell'account. "error" rifiuta una cronologia modificata con lo stesso 400 che riceve un nuovo account, mentre "drop_block" lascia passare la richiesta ed elenca ciò che è stato scartato in input_transformations. Consulta Verifica se il tuo codice modifica il prefisso.
No. Ciò che non supera il controllo è il thinking già presente nella cronologia dopo il punto che hai modificato, e sei tu a scegliere cosa succede a quel thinking. Con prefix_mismatch_behavior: "drop_block", l'API scarta quei blocchi e la richiesta ha esito positivo: il modello risponde a quel turno senza quel ragionamento, e la cache dei prompt riparte dal punto della modifica. Con il valore predefinito "error", l'API rifiuta la richiesta con un 400 finché non annulli la modifica o non la reinvii con "drop_block". Consulta Cosa fa l'API con un blocco non valido. Cosa conta come modifica elenca quali modifiche sono rilevanti.
No. output_config.effort, max_tokens e la configurazione thinking non fanno parte del prefisso controllato, che copre solo system, tools e messages. Una modifica dell'effort di primo livello invalida la maggior parte della cache dei prompt. Su Claude Fable 5.1, una modifica dell'effort per messaggio mantiene la cache dei prompt e viene usata come nuovo livello di effort finché non viene modificata di nuovo.
Non modificare tools. Dichiara l'insieme completo all'inizio della sessione, contrassegna gli strumenti non ancora disponibili con defer_loading: true, e offrili o ritirali con i blocchi tool_addition e tool_removal. Se conosci lo schema di uno strumento solo a metà sessione, ad esempio da un server MCP scoperto in fase di esecuzione, puoi comunque aggiungerlo a tools con defer_loading: true e offrirlo allo stesso modo. È sicuro perché uno strumento differito non referenziato non fa parte del prefisso. I messaggi role: "system" che contengono questi blocchi entrano a far parte del prefisso per il thinking successivo, quindi non spostarli, riformularli o eliminarli in seguito. Consulta Aggiungere o rimuovere strumenti con tool_addition e tool_removal.
Sì, se è l'API a scrivere il riepilogo. La compattazione on-demand (header beta compact-2026-09-04) riassume i turni più vecchi in un blocco firmato che invii al loro posto. I turni recenti mantengono il loro thinking alle condizioni descritte in Compattazione keep-tail.
Se scrivi tu stesso il riepilogo, il thinking dei turni mantenuti non supera il controllo, perché quei blocchi sono stati prodotti a partire dalla cronologia che hai sostituito. Rimuovi i blocchi thinking e redacted_thinking dai turni che riporti e mantieni i loro blocchi text e tool_use, oppure invia prefix_mismatch_behavior: "drop_block" e lascia che sia l'API a scartarli. La compattazione semplice non lascia alcun thinking che possa non superare il controllo ed è l'approccio consigliato: un messaggio di riepilogo più il turno utente successivo, senza riproporre turni precedenti. La compattazione lato server e la modifica del contesto non contano come modifiche. Consulta Compattare sul client.
Caricali una volta all'inizio della sessione e mantieni fissi il prompt system di primo livello e tools. Quando un file cambia, aggiungi la nuova versione in quel punto di messages invece di modificare l'originale. Usa un messaggio di sistema a metà conversazione per le istruzioni che provengono da te come operatore. Per il testo dei file che consideri non attendibile, che non dovrebbe avere l'autorità del prompt di sistema, inserisci invece il contenuto nel turno user successivo. Consulta Aggiungere istruzioni con un messaggio di sistema a metà conversazione e Limitazioni.
Sì. Una sessione ripresa è una normale richiesta di follow-up: system, tools e i messages precedenti devono avere lo stesso contenuto di quello che hai inviato l'ultima volta. La formattazione JSON e l'ordine delle chiavi non contano; i valori sì. Salva esattamente ciò che hai inviato e ricevuto, e riproponilo: il prompt di sistema renderizzato, le definizioni degli strumenti e ogni turno dell'assistente così come è stato restituito. Non rigenerare a partire da input che potrebbero essere cambiati nel frattempo, come la data, un file di istruzioni aggiornato o una nuova versione di uno strumento. Qualsiasi novità va in un messaggio aggiunto. Consulta Rinviare i turni dell'assistente esattamente come restituiti.
La cronologia memorizzata contiene una modifica, quindi riproporla non può avere esito positivo. D'ora in poi invia quella sessione con prefix_mismatch_behavior: "drop_block", oppure rimuovi una volta per tutte i suoi blocchi thinking e redacted_thinking e continua. Il thinking che il modello produce da quel punto in poi resta valido finché nulla di ciò che lo precede cambia di nuovo. Poi individua la modifica, in modo che le nuove sessioni non la incontrino. Consulta Gestire l'errore nel codice.
No, a condizione che vengano aggiunti dopo la cronologia esistente e che nulla di precedente cambi: un messaggio dell'assistente senza blocchi di thinking è un messaggio aggiunto come qualsiasi altro. Invia l'output dell'altro modello come contenuto text e tool_use.
Non in una conversazione diversa. Un blocco di thinking è utilizzabile solo quando segue esattamente i system, tools e messages da cui è stato prodotto. Un ramo che ripropone quella cronologia invariata fino al punto di biforcazione mantiene il suo thinking. Una conversazione che parte da qualsiasi altra cosa non può usarlo, quindi avvia quella conversazione da un riepilogo dello stato dell'attività, come nella compattazione semplice: l'obiettivo, le decisioni prese, i file e i risultati ottenuti finora, e il passo successivo.
Passaggi successivi
Diagnostica e correggi i fallimenti più comuni del pensiero: errori 400 di configurazione, blocchi di pensiero vuoti o mancanti, arresti per max_tokens e cache miss.
Modifica le istruzioni di sistema o la disponibilità degli strumenti a metà di una conversazione senza invalidare il prefisso in cache che le precede.
Compattazione del contesto lato server per gestire conversazioni lunghe che si avvicinano ai limiti della finestra di contesto.
Metti in cache i prefissi dei prompt con cache_control per ridurre costi e latenza, usando la cache automatica o breakpoint espliciti con TTL di 5 minuti o 1 ora.
Was this page helpful?