Optimierung von Kosten und Intelligenz
Bringe Kosten und Intelligenz auf der Claude Platform ins Gleichgewicht, mit gemessenen Ergebnissen für Prompt-Caching, Effort, Modellwahl, Budgets und Multi-Modell-Strategien.
Wenn ein Workload vom Prototyp in die Produktion wechselt, werden die Kosten zu einer zentralen Designvorgabe. Das leistungsfähigste Modell kann im großen Maßstab zu teuer sein, und das günstigste Modell kann bei der Qualität zu kurz kommen. Kosten gut zu steuern bedeutet zu verstehen, wie sich jeder Kostenhebel auf die Ausgabequalität auswirkt, denn manche Hebel gehen zulasten der Qualität und manche nicht. Die Claude Platform gibt dir direkte Kontrolle über diese Abwägung. Du wählst für jede Anfrage das Modell, die Effort-Stufe und die Architektur und kannst einen Workload so fast überall auf der „cost-to-intelligence frontier" (Kosten-Intelligenz-Grenze) platzieren.
Kosten und Intelligenz werden meist als Grenze dargestellt, an der das eine das andere erkauft. Die erste Gruppe von Hebeln auf dieser Seite bewegt einen Workload auf diese Grenze zu, indem sie Kosten senkt, ohne die Qualität zu berühren; nur die zweite Gruppe bewegt ihn entlang der Grenze:
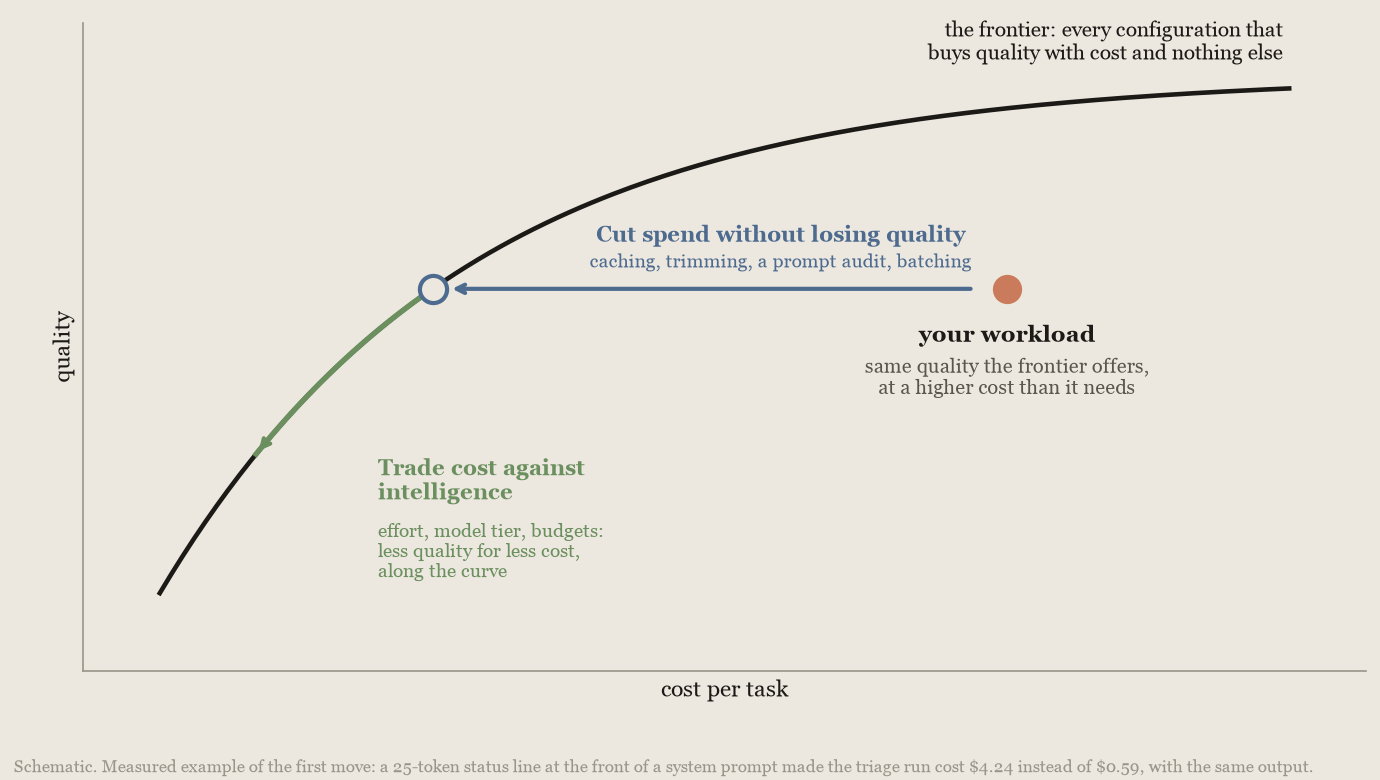
Es gibt zwei Arten von Hebeln:
- Kostenlose Gewinne senken die Ausgaben, ohne die Qualität zu berühren: „prompt caching" (Prompt-Caching), „token hygiene" (Token-Hygiene), ein Prompt-Audit für das Modell, das du verwendest, „batch processing" (Batch-Verarbeitung) mit 50 % Rabatt für Arbeit, die bis zu 24 Stunden warten kann, und Ausgabenlimits für Workspaces als Absicherung.
- Abwägungen tauschen Kosten gegen Intelligenz: Modellwahl, „effort" (Aufwand), Ausgabelimits und Task-Budgets, eine Uhr für die verstrichene Zeit sowie Multi-Modell-Architekturen.
Zu jedem Hebel gibt es gemessene Ergebnisse und die Regel, wann er sich lohnt. In Anthropics Messungen war Prompt-Caching mit großem Abstand der größte Hebel: Es senkte die Kosten von Agent-Schleifen auf den Benchmarks dieses Leitfadens um den Faktor 2,7 bis 5,3 und die Rechnung eines kleinen Triage-Agenten um 83 %, bzw. um 88 % mit zusätzlichem Kürzen der Eingabe. Die Multi-Modell-Hebel sind enger gefasst; ein zweites Modell zahlte sich in zwei Formen aus, als Advisor und als Orchestrator.
Hier beginnen
Ordne deine Situation einer Zeile zu.
| Deine Situation | Tu Folgendes | Wo |
|---|---|---|
| Jeder Workload, jedes Modell | Aktiviere Prompt-Caching und kürze unnötige Token; beides ist kostenlos | Wiederholten Kontext cachen · Token kürzen |
| Eine Person wartet zwischen den Turns | Verwende die 1-Stunden-Cache-Dauer, sobald etwa 1 von 20 Turns auf eine Pause zwischen 5 Minuten und einer Stunde folgt und nur wenige Lücken länger als eine Stunde dauern. Halte auf Claude Fable 5.1 den 5-Minuten-Cache warm, solange Pausen Minuten dauern, und kaufe die 1-Stunden-Dauer, wenn Pausen gegen eine Stunde gehen. Halte auf Claude Opus 5.5 stattdessen den 5-Minuten-Cache warm, wenn nur ein oder zwei von 20 Turns auf eine Pause von bis zu etwa einer halben Stunde folgen | Cache-Dauer wählen |
| Die Kosten sind zu hoch; die Qualität passt | Senke den Effort auf deinem aktuellen Modell schrittweise | Effort abstimmen |
| Du verwendest nicht das neueste Modell | Führe ein Upgrade durch; in Anthropics Messungen löste jedes neuere Modell mindestens so viele Aufgaben wie sein Vorgänger, meist zu geringeren Kosten pro gelöster Aufgabe | Modell upgraden |
| Du wählst oder wechselst Modelle | Vergleiche anhand der Kosten pro abgeschlossener Aufgabe, nicht pro Token | Modelle vergleichen |
| Die Qualität reicht nicht aus | Wenn du den Effort gesenkt hast, stelle ihn wieder her; andernfalls probiere die nächsthöhere Stufe mit low Effort | Effort abstimmen · Modelle vergleichen |
Versuche enden mit stop_reason: max_tokens | Erhöhe max_tokens; 64.000 deckten bis auf 2 alle von 14.000 beim Standard-Effort gemessenen Turns ab, und 128.000 kosteten pro gelöster Aufgabe nichts extra | Budgets festlegen |
| Du kannst Ausgaben prüfen (Tests, ein Verifier) | Führe alles mit niedrigem Effort aus und wiederhole Fehlschläge mit high; auf dem gemessenen Coding-Benchmark blieb die Erfolgsquote bei etwa der Hälfte der Kosten gleich | Fehlschläge wiederholen |
| Agent-Schleifen mit einigen sehr teuren Läufen | Lege ein Task-Budget fest (Beta; prüfe in der Support-Tabelle, welche Modelle es unterstützen), ein Sitzungsbudget für Claude Managed Agents und ein Ausgabenlimit für den Workspace | Budgets festlegen |
| Agent-Läufe sollen schneller fertig werden | Sag dem Modell, dass Zeit wichtig ist, und zeige ihm die verstrichene Zeit; auf DRACO, HLE und einem internen Physik-Set dauerten Läufe 33 % bis 69 % kürzer bei 28 % bis 54 % geringeren Kosten pro Aufgabe, mit bis zu 1,9 Punkten niedrigeren Ergebnissen | Dem Modell die verstrichene Zeit zeigen |
| Ein günstigeres Modell kommt nur bei schwierigen Entscheidungen nicht weiter | Füge einen Frontier-Advisor hinzu. Das lohnt sich, wenn er deutlich teurer als der Executor ist und tatsächlich konsultiert wird; berechne also zuerst die Kosten des Advisor-Modells allein mit niedrigem Effort und miss die Konsultationsrate | Advisor-Strategie |
| Die Arbeit übersteigt ein Kontextfenster | Delegiere Teilbereiche an günstigere Worker | Orchestrator-Strategie |
Diese Ergebnisse sind Anthropic-intern (Referenzierte Benchmarks) und richtungsweisend, keine Garantien; miss also auf deinem eigenen Workload mit der Vier-Schritte-Methode.
Ausgaben senken, ohne Qualität zu verlieren
Prompt-Caching, Token-Hygiene, Batch-Verarbeitung und ein Prompt-Audit gegen dein aktuelles Modell senken alle, was du zahlst, ohne die Ausgabequalität zu senken. Zwei Vorbehalte gelten: Batch-Verarbeitung tauscht Latenz gegen ihren Rabatt, und Context Editing, ein Token-Hygiene-Hebel, kostete im in diesem Abschnitt gemessenen Lauf mehr, als es einsparte.
Wiederholten Kontext cachen
Warum Caching zuerst kommt
Schalte Prompt-Caching vor jedem anderen Hebel ein, denn jeder Turn einer agentischen Aufgabe sendet die gesamte wachsende Konversation erneut: System-Prompt, Tool-Definitionen und jeden vorherigen Turn. Eine 40-Turn-Aufgabe sendet ihren ersten Turn 40-mal, sodass die Aufgabenkosten ungefähr mit dem Quadrat der Turn-Anzahl wachsen. Caching stoppt das erneute Senden nicht, aber jedes erneute Senden kostet etwa ein Zehntel so viel und wird schneller verarbeitet: Das Präfix wird zum Cache-Read-Tarif abgerechnet, einem Zehntel des Input-Preises, und jeder Turn zahlt den 1,25x-Cache-Write-Tarif nur für das, was neu ist.
Wie gut aussieht. Über einen ganzen Tag echten Traffics lasen Agent-Schleifen im Median 84 % ihres Inputs aus dem Cache, und die obersten 10 % der Harnesses, ob Coding oder nicht, lasen 94 % oder mehr17. Tief in einer Aufgabe zahlt eine gut gebaute Schleife den vollen Preis für unter 1 % ihres Inputs. Unter etwa 80 % suche nach etwas, das den Cache bricht (siehe Was den Cache bricht).
Über Anthropics gemessene Läufe hinweg sind Cache-Reads routinemäßig die größte Einzelkomponente der Aufgabenkosten, was Caching wertvoller macht als die meisten Modellwahl-Entscheidungen. Anthropic bepreiste die DeepResearch Bench II7-Läufe mit und ohne Caching:
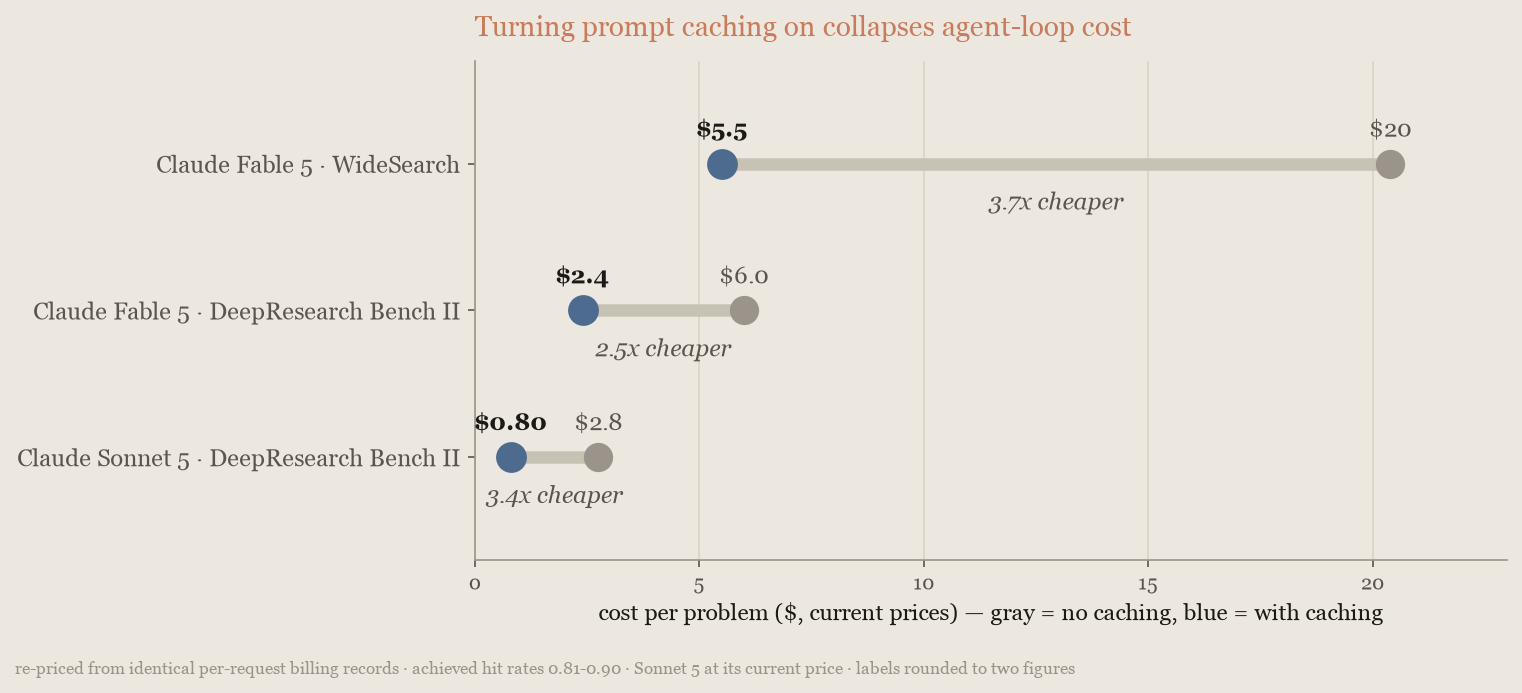
Die Standard-Lebensdauer des Caches beträgt 5 Minuten und die Turns einer Agent-Schleife liegen Sekunden auseinander, sodass der Rabatt bei jedem Turn für die meisten Token gilt. Die Läufe des Caching-Diagramms lasen 79 % bis 90 % ihrer Input-Token aus dem Cache. Die Einsparung variiert mit der Episodentiefe, weil kürzere Schleifen weniger erneut lesen, aber Caching blieb auf jedem gemessenen Modell und Benchmark der größte Einzelhebel.
Cache-Dauer wählen
Wenn deine Schleife zwischen den Turns auf eine Person wartet, verwende die 1-Stunden-Cache-Dauer. Das Schreiben kostet mehr (das 2-Fache des Input-Preises statt des 1,25-Fachen). Ein Cache-Miss bei beiden Dauern rechnet das gesamte Präfix zum Write-Preis statt zum Read-Preis ab, sodass sich die längere Dauer lohnt, sobald einige Turns pro Sitzung auf eine Pause zwischen 5 Minuten und einer Stunde folgen.
Zähle für die Entscheidung die Lücken zwischen aufeinanderfolgenden Anfragen in einer Konversation:
- Mehr als etwa 1 von 20 Lücken liegt zwischen 5 Minuten und einer Stunde, und Lücken über einer Stunde sind selten: Verwende die 1-Stunden-Dauer. Wenn auf Claude Opus 5.5 nur 1 oder 2 von 20 Lücken in diesen Bereich fallen und keine länger als etwa eine halbe Stunde dauert, halte stattdessen den 5-Minuten-Cache warm, mit den unten beschriebenen Keep-alive-Anfragen.
- Turns kommen im Sekundenabstand: Bleib beim 5-Minuten-Standard. Wenn nichts pausierte, kostete er auf Claude Sonnet 5 15 % weniger als die 1-Stunden-Einstellung und auf Claude Opus 5.5 etwa 15 % bis 18 % weniger.
- Lücken über einer Stunde sind häufig: Bleib beim Standard. Eine Lücke über einer Stunde lässt beide Dauern ablaufen, und die 1-Stunden-Einstellung schreibt das Präfix dann zu ihrem höheren Write-Preis neu, sodass sie bei jeder dieser Lücken verliert. Wenn von deinen Pausen über 5 Minuten etwa 60 % oder mehr auch länger als eine Stunde dauern, bleib beim Standard; die 1-Stunden-Dauer lohnt sich nur, wenn mindestens etwa 40 % der langen Pausen innerhalb der Stunde enden.
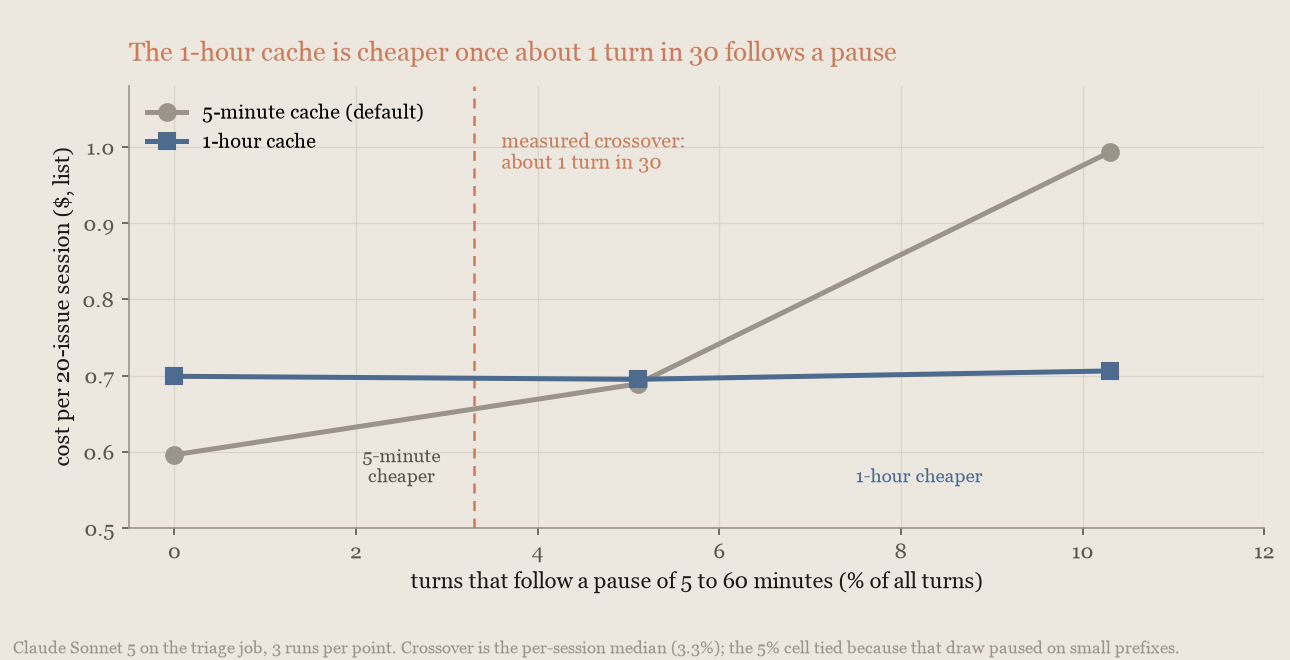
Anthropic hat den Triage-Job aus Input- und Kontext-Token kürzen gemessen, wobei vor einigen Turns Pausen eingefügt wurden, um die Verzögerung durch eine Person zu simulieren16. Auf Claude Sonnet 5 und Claude Opus 5.5 wurde der 1-Stunden-Cache zur günstigeren Einstellung, sobald etwa 1 von 30 Turns auf eine Pause folgte; die 1-von-20-Regel lässt also einen Spielraum, und der Abstand wächst jenseits des Kreuzungspunkts schnell, weil jeder pausierte Turn bei der 5-Minuten-Einstellung das gesamte Präfix neu schreibt. Alle aktuellen Modelle verwenden dieselben Cache-Write-Multiplikatoren, und alle Modelle außer Claude Fable 5.1, Claude Mythos 5.1 und Claude Opus 5.5 denselben Read-Preis, sodass der Kreuzungspunkt bei den anderen Modellen im selben Bereich liegt; Fable 5.1 ist der als Nächstes behandelte Fall. Die Genauigkeit blieb in jeder Zelle innerhalb des Rauschens zwischen Läufen. Der Turn nach einer Pause behielt bei der 1-Stunden-Einstellung seine Latenz mit warmem Cache (gemessen auf Claude Sonnet 5 und Claude Opus 5, nicht auf Claude Opus 5.5). Das folgende Diagramm zeigt die Kosten pro Sitzung in Abhängigkeit vom Anteil pausierter Turns auf Claude Sonnet 5:
Anthropic hat auch zusätzliche Anfragen gemessen, die den 5-Minuten-Cache warm halten. Auf Claude Sonnet 5 kosteten sie etwa 8 % weniger als die 1-Stunden-Dauer, wenn 1 von 20 Turns auf eine Pause folgte, bei 2 von 20 aber etwa gleich viel; auf Claude Opus 5, dem vorherigen Opus-Modell, sparten sie nichts Messbares. Mit einer Pause von 6 Minuten oder mehr vor jedem Turn kosteten sie auf beiden Modellen mehr. Da die Ersparnis auf Claude Sonnet 5 bei 2 von 20 Turns verschwunden war, verwende auf Claude Sonnet 5 und Claude Opus 5 stattdessen die 1-Stunden-Dauer.
Auf Claude Fable 5.1 ist eine andere Einstellung die günstigste. Sein Cache-Read kostet das 0,025-Fache des Input-Preises (0,25 $ pro Million Token), während seine Cache-Writes die Standardmultiplikatoren beibehalten; eine Keep-alive-Anfrage, die das Präfix erneut liest, ist also günstig, und der Write-Aufschlag der 1-Stunden-Dauer ist der größere Posten. Anthropic hat den Triage-Job auf Claude Fable 5.1 mit denselben drei Einstellungen gemessen19. Den 5-Minuten-Cache warm zu halten kostete pro Sitzung 13 % bis 20 % weniger als der 1-Stunden-Cache, wann immer Pausen Minuten dauerten; nur bei Pausen von fast 45 Minuten gewann der 1-Stunden-Cache, um etwa 12 Cent pro Sitzung. Halte auf Claude Fable 5.1 den 5-Minuten-Cache warm, solange eine Person minutenlang abwesend ist, und kaufe die 1-Stunden-Dauer, wenn Pausen gegen eine Stunde gehen:
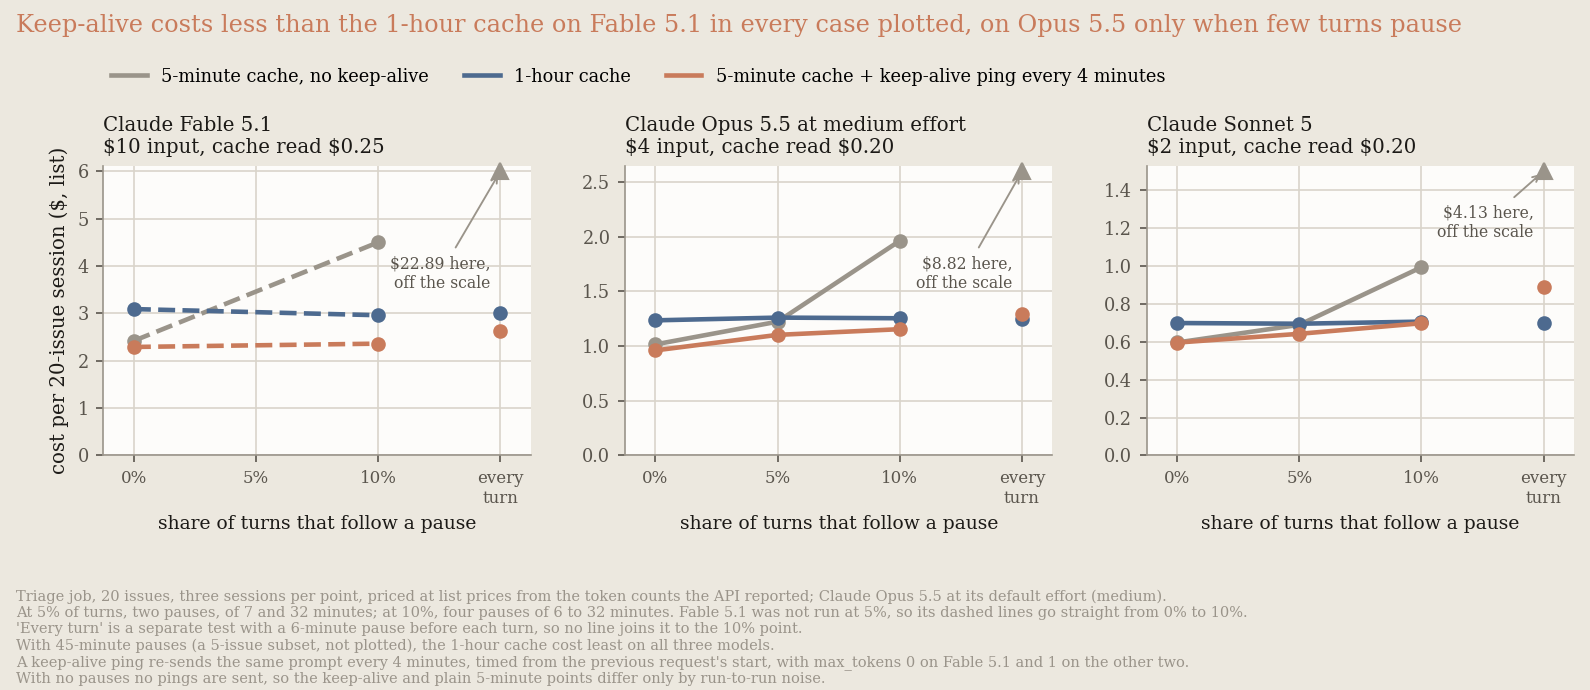
Auf Claude Opus 5.5, dessen Cache-Read das 0,05-Fache des Input-Preises kostet, kosteten Keep-alive-Anfragen 8 % bis 13 % weniger als die 1-Stunden-Dauer, wenn 5 % oder 10 % der Turns auf eine Pause von 6 bis 32 Minuten folgten (beim Standard-Effort medium; 10 % bis 18 % weniger bei high), aber mehr bei einer Pause vor jedem Turn: etwa 4 % bis 6 % mehr bei 6-minütigen Pausen, ansteigend auf über 50 % mehr bei 45-minütigen Pausen. Halte also auf Claude Opus 5.5 den 5-Minuten-Cache warm, wenn nur ein oder zwei von 20 Turns auf eine Pause von bis zu etwa einer halben Stunde folgen, und folge ansonsten der Liste am Anfang dieses Abschnitts. Diese Messungen sendeten Keep-alive-Anfragen mit max_tokens: 1. Für die als Nächstes beschriebene Anfrage mit max_tokens: 0 zeigen Anthropics API-Tests vor dem Launch auf Claude Opus 5.5, dass sie den Cache schreibt und die nächste Anfrage ihn liest; ob sie einen bestehenden Eintrag auffrischt, wurde auf Opus 5.5 nicht gemessen.
Um den Cache warm zu halten, sende die vorherige Anfrage innerhalb von 4 Minuten nach dem Start der vorherigen Anfrage erneut mit max_tokens auf 0 gesetzt, und danach alle 4 Minuten, wobei du stream weglässt, falls es gesetzt war. Zähle ab dem Start der Anfrage, nicht ab dem Ende ihrer Antwort: Die 5-minütige Lebensdauer des Caches läuft ab dem Start der Anfrage, die den Eintrag geschrieben oder aufgefrischt hat, sodass die Zeit, die die Antwort mit der Generierung verbracht hat, davon abgezogen wird. Das ist die Pre-Warming-Anfrage: Sie frischt die Lebensdauer des Caches auf, generiert nichts und rechnet nur den Cache-Read ab. Ändere kein einziges Byte des Präfixes und verwende nicht max_tokens: 1, das grundlos ein Token sampelt. Sende neben dem Body auch die Header der Anfrage erneut: Wenn deine Anfragen einen anthropic-beta-Header tragen (etwa für ein Task-Budget), braucht die Keep-alive-Anfrage denselben Header, sonst werden die beta-geschützten Felder im erneut gesendeten Body abgelehnt. Eine Anfrage mit max_tokens: 0 wird abgelehnt, wenn die Anfrage thinking.type: "enabled" (das standardmäßige adaptive Nachdenken auf Claude Fable 5.1 ist in Ordnung), strukturierte Ausgaben oder eine erzwungene Tool-Auswahl setzt (ihre Einschränkungen); kaufe bei diesen Workloads stattdessen die 1-Stunden-Dauer. Eine Anfrage mit max_tokens: 0 wird auch abgelehnt, wenn sie den Top-Level-Parameter compaction enthält; sende also keine Compaction-Anfrage aus Komprimierung auf Anfrage als Keep-alive-Anfrage erneut.
# Sende innerhalb von 4 Minuten nach dem Start der letzten Anfrage (die Generierungszeit
# zählt zur Lebensdauer des Caches) diese Anfrage erneut, mit max_tokens auf
# 0 gesetzt und ohne stream (eine Anfrage mit max_tokens: 0 kann nicht streamen). Sende dieselben
# Header wie bei der ursprünglichen Anfrage, einschließlich eines etwaigen anthropic-beta-Headers.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Caching einschalten
Die Einrichtung erfordert wenig Arbeit. Automatisches Caching platziert Breakpoints für dich; andernfalls kann der Claude API Skill, der mit Claude Code ausgeliefert wird, Caching mit einem einzigen Prompt zu einer bestehenden Integration hinzufügen. Der folgende Auszug zeigt, wie der Skill es zu dem Harness hinzufügt, der diese Messungen erzeugt hat:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Diese Breakpoint-Platzierungen folgen dem Standardmuster in Explizite Cache-Breakpoints.
Was den Cache bricht
Mehrere Dinge können deinen Cache während einer Aufgabe brechen. Alles, was sich pro Anfrage ändert, etwa ein Zeitstempel oder eine Warteschlangenposition, und vor dem stabilen Präfix steht, macht jede Anfrage zu einem vollständigen Cache-Write: Beim Triage-Lauf in Input- und Kontext-Token kürzen kostete eine 25 Token lange Statuszeile am Anfang des System-Prompts 4,24 $ pro Lauf statt 0,59 $, mehr als ein Lauf mit deaktiviertem Caching. Platziere anfragespezifischen Text im neuesten User-Turn.
Der Cache ist ein byte-genauer Präfixabgleich über die Anfrage in ihrer Reihenfolge (Tools, dann System-Prompt, dann Nachrichten), sodass eine Änderung an beliebiger Stelle alles danach ungültig macht. Eine Änderung von effort oder der Konfiguration für das Nachdenken zwischen Anfragen macht den Cache ab diesem Punkt ungültig, bei manchen Modellen auch die davor liegenden Tools und den System-Prompt; jede Bearbeitung des System-Prompts macht den Cache ab diesem Punkt ungültig; das Setzen oder Ändern eines Ausgabeformats macht den Cache für die gesamte Konversation ungültig; das Hinzufügen, Entfernen oder Umordnen einer Tool-Definition macht alles ungültig. Die Seite zu Prompt-Caching listet diese Fälle auf, abgesehen vom Ausgabeformat, das unter strukturierte Ausgaben behandelt wird. Ändere auf den neuesten Modellen Anweisungen mit einer System-Nachricht mitten im Gespräch, einer an messages angehängten {"role": "system"}-Nachricht, statt das Top-Level-Feld system zu bearbeiten: Das gecachte Präfix bleibt intakt. Prüfe auf dieser Seite, welche Modelle das unterstützen. Auf Modellen, die es unterstützen, lässt auch eine Effort-Änderung pro Nachricht das gecachte Präfix intakt. Am meisten steht auf Claude Fable 5.1 und Claude Mythos 5.1 auf dem Spiel, wo ein Bruch das Präfix zum 1,25-Fachen des Input-Preises neu schreibt, statt es zum 0,025-Fachen zu lesen. Bei einem Präfix von 100.000 Token kostet dort ein gebrochener Turn 1,25 $ statt 0,03 $, das 50-Fache des Reads; auf Claude Opus 5.5 kostet er 0,50 $ statt 0,02 $, das 25-Fache, und auf den anderen aktuellen Modellen das 12,5-Fache.
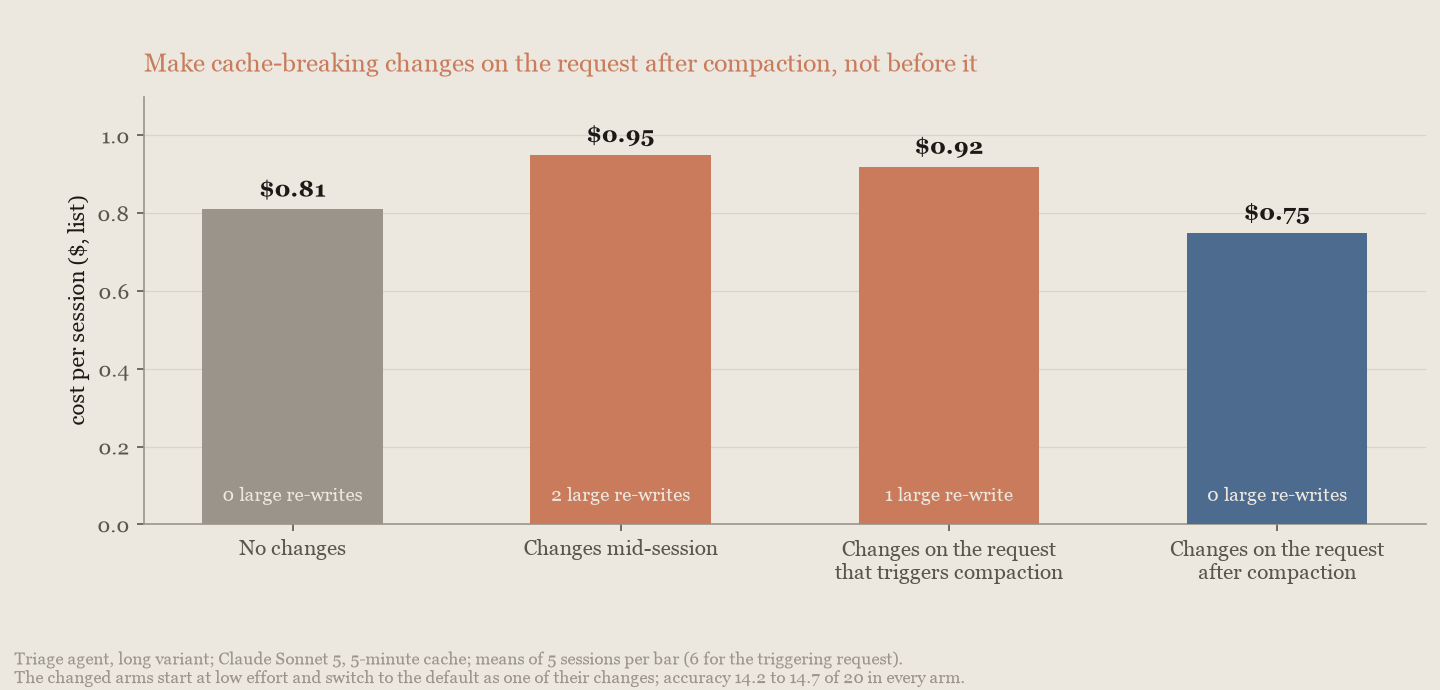
Anthropic hat dies an den langen Sitzungen des Triage-Agenten gemessen18. Eine Effort-Änderung und ein hinzugefügtes Tool mitten in der Sitzung schrieben 39.000 bzw. 60.000 gecachte Token neu, und diese Sitzungen kosteten 0,95 $ pro Sitzung. Dieselben zwei Änderungen bei der ersten Anfrage nach der Compaction kosteten 0,75 $ und bei der Anfrage, die die Compaction auslöste, 0,92 $, weil der Zusammenfassungsdurchlauf der Compaction dann den 81.000 Token großen Kontext zum Cache-Write-Preis erneut verarbeitete: Dieser Zusammenfassungsdurchlauf kostete 0,21 $, gegenüber 0,04 $, wenn dieselben Änderungen eine Anfrage später kamen, bei einer Genauigkeit innerhalb des Rauschens zwischen Läufen in jedem Arm:
Ein Task-Budget mittendrin zu ändern macht jedes gecachte Präfix ungültig, das den Budgetwert enthält; lege es also einmal fest, bei der ersten Anfrage. Jeder Durchlauf der „context editing" (Kontextbearbeitung) macht das Präfix ab dem Punkt ungültig, an dem er löscht, und die nächste Anfrage zahlt dafür, alles danach neu zu cachen; lösche also in wenigen großen Schüben statt in vielen kleinen. Auf Claude Fable 5.1 und Claude Mythos 5.1 kostet jeder dieser Vorgänge das 50-Fache des Read-Preises pro Token, daher sind sie dort am wichtigsten. Nimm jede cache-invalidierende Änderung an natürlichen Unterbrechungen vor und prüfe dann, dass die Cache-Reads nicht gesunken sind; falls doch, zeigt die Cache-Diagnose, wo das Präfix abgewichen ist.
Input- und Kontext-Token kürzen
Die meisten Agent-Anfragen enthalten Token, die die Antwort nie beeinflussen. Sie zu kürzen kostet selten Ausgabequalität, auch wenn nicht jeder Hebel hier in der Messung Geld gespart hat. Es gibt zwei Ansatzpunkte:
- Input-Trimming. Dynamisches Filtern im Web-Fetch-Tool hält Boilerplate aus abgerufenen Seiten heraus. Bildgrößenanpassung bringt Vision-Inputs auf die passende Größe. Tool-Suche mit verzögertem Laden lädt Tool-Definitionen nur bei Bedarf (später in diesem Abschnitt gemessen). Mit programmatischem Tool-Calling führt Claude mehrere Tool-Aufrufe aus Code aus, sodass nur das gefilterte Ergebnis in den Kontext gelangt. Laut seiner Dokumentation spart das auf agentischen Such-Benchmarks 24 % der Input-Token, bei höherer Punktzahl. Tool-Kontext verwalten vergleicht Tool-Suche, programmatisches Tool-Calling, Prompt-Caching und Context Editing.
- Kontext-Lebenszyklus. Context Editing löscht veraltete Tool-Ergebnisse. Automatische Compaction mit ihrem Schwellenwert verhindert, dass lange Schleifen ihren gesamten Verlauf mitschleppen.
Die Hebel wirken auf den Cache und aufeinander. Beurteile sie also nach ihrem Nettoeffekt. Prüfe mit der Cache-Diagnose, ob dein gecachtes Präfix jede Änderung übersteht. Anthropic hat die Hebel an einem Issue-Triage-Agenten gemessen, der 20 echte Fehlerberichte mit Screenshots aus einem öffentlichen Repository abarbeitete. Dazu kam eine längere Variante desselben Jobs mit dem 2,6-Fachen an Token. Bei aktiviertem Caching senkte Input-Trimming (Bildgrößenanpassung und Tool-Suche) die Kosten des kurzen Laufs um weitere 26 % und die des langen um 21 %.
Ungenutzte Tool-Definitionen verzögern
Jede an eine Anfrage angehängte Tool-Definition ist bei jedem Turn Input, und ein paar MCP-Server summieren sich auf Hunderte davon. Anthropic betrieb den Triage-Agenten mit seinen eigenen zwei Tools plus einem Katalog echter Tool-Definitionen von öffentlichen MCP-Servern, für insgesamt bis zu 502 Tools, wobei alle geladen oder die Extras hinter Tool-Suche als defer_loading markiert wurden:
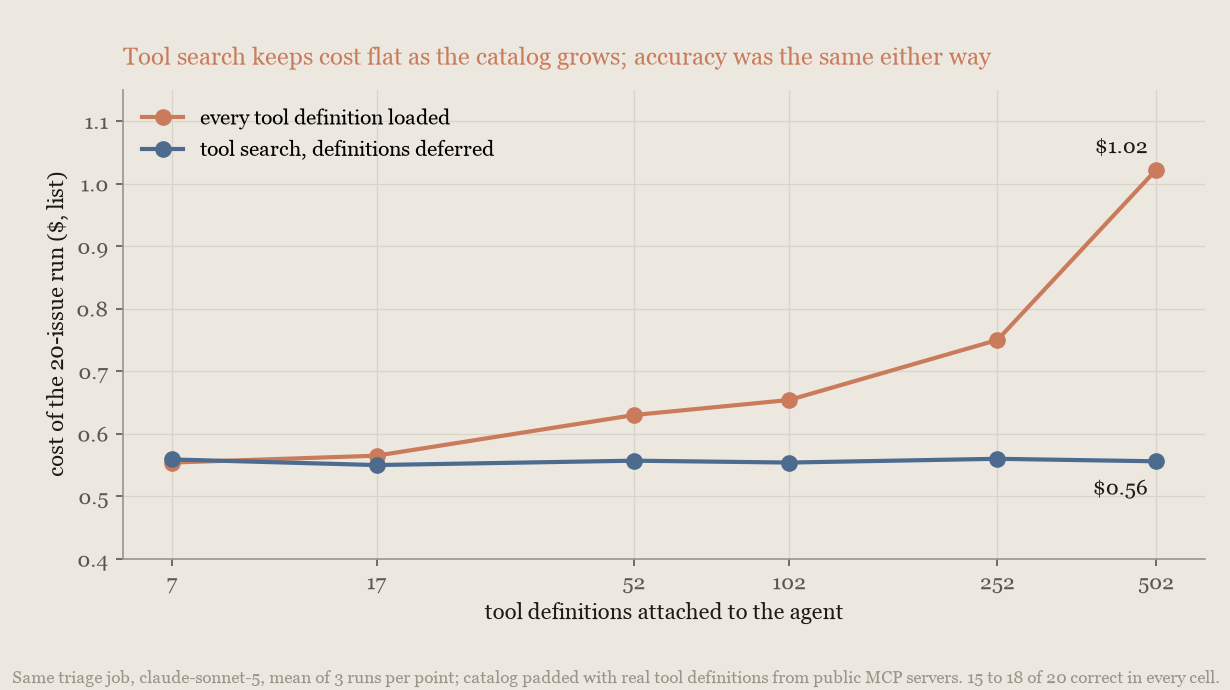
Mit jeder geladenen Definition verdoppelten sich die Laufkosten fast, als der Katalog wuchs, den Schema-Token bei jeder Anfrage folgend. Mit Tool-Suche blieben sie bei jeder Kataloggröße flach, 45 % weniger bei 502 Tools. Die Genauigkeit lag in jeder Zelle so oder so bei 15 bis 18 von 20, und das Modell rief nie ein falsches Tool auf, sodass der Katalog in diesem Maßstab Geld kostet, nicht Korrektheit. Dasselbe gilt für Tools, die über den MCP-Connector kommen: Mit einem angehängten öffentlichen GitHub-MCP-Server senkte das Verzögern seines Toolsets (default_config: {defer_loading: true}) den Lauf um 20 % bei gleicher Genauigkeit.
Datendateien aus dem Prompt heraushalten
Wenn das Modell über eine Tabelle rechnen muss, lade sie mit der Files API hoch und lass das Modell sie mit Code-Ausführung abfragen, statt sie einzufügen. Anthropic stellte 25 Aggregatfragen15 (Summen, gefilterte Zählungen, Group-bys und einen Datumsfilter) über eine öffentliche CSV mit 1.862 Zeilen, wobei die Antworten von pandas berechnet wurden:
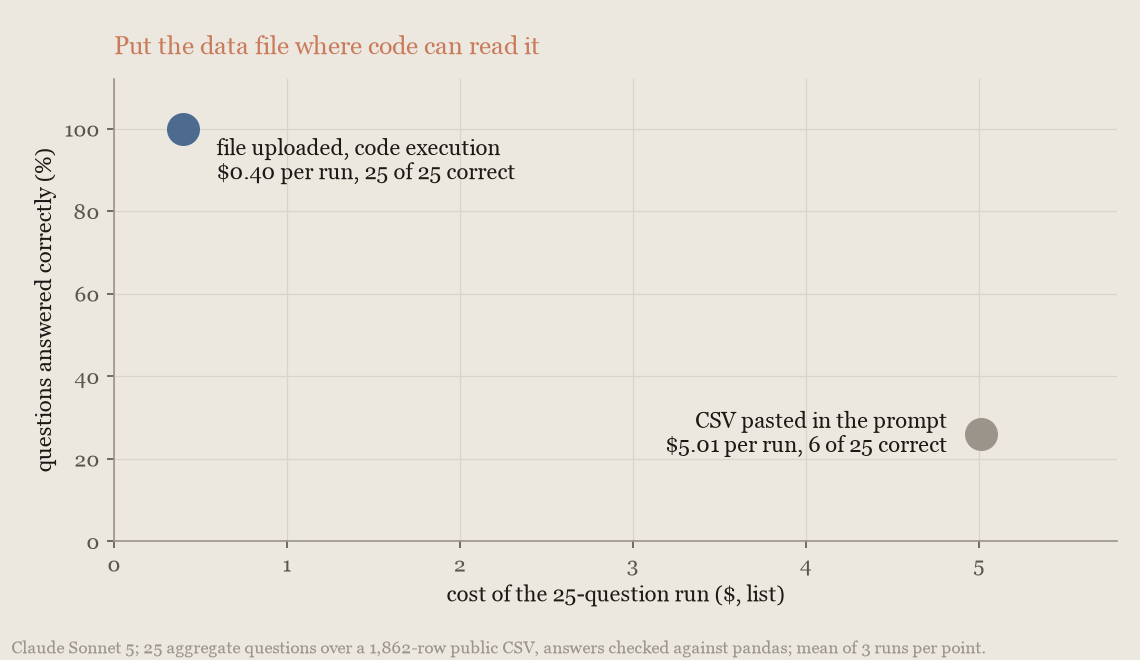
In den Prompt eingefügt umfasst die Tabelle etwa 91.000 Input-Token bei jeder Anfrage, und Claude Sonnet 5 beantwortete 6 von 25 Fragen korrekt. Hochgeladen, mit Code-Ausführung, beantwortete es alle 25, und der Lauf kostete etwa ein Zwölftel so viel. Claude Opus 5 zeigte dasselbe Muster.
Den Kontext-Lebenszyklus verwalten
Die Kontext-Hebel zahlen sich nur bei einer Session aus, die lang genug ist, um sie zu brauchen:
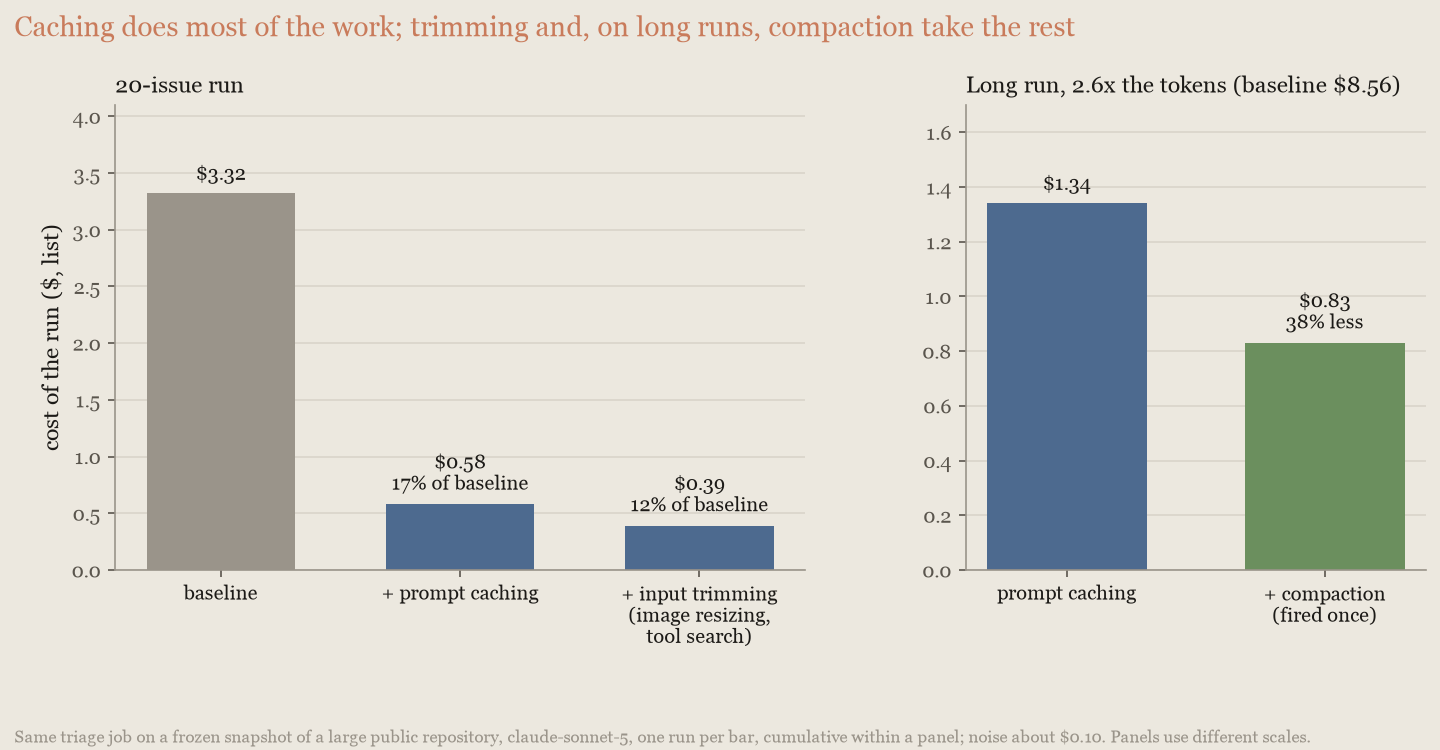
Beim 20-Issue-Lauf sparten sie nichts, und Context Editing kostete 74 % mehr. Beim langen Lauf sparte das Pruning 39 % und Compaction 32 %, während Context Editing nichts änderte. Das Pruning sind ein paar Zeilen, die du selbst schreibst: Ersetze an jeder Aufgabengrenze große veraltete Tool-Ergebnisse durch einen einzeiligen Extrakt. Es cacht gut, weil die Bearbeitungen am Ende der Konversation sitzen, wo die nächste Aufgabe ohnehin neuen Inhalt hinzufügt: 89 % Cache-Reads bei der ersten Anfrage nach einer Grenze und 81 % bei den Anfragen zwischen Grenzen. Über den gesamten Lauf cachen das Pruning und Context Editing etwa gleich gut. Das Pruning ist günstiger, weil Context Editing mitten in der Aufgabe Inhalt neu schreibt, den das Pruning löscht (etwa zwei Drittel des Abstands), und weil es den Kontext etwa halb so groß hält (das andere Drittel). Wenn du Context Editing verwendest, lösche in wenigen großen Batches. Das Pruning, aus dem Harness adaptiert:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # einzeilige Ergebnisse begrenzen, damit der Auszug kurz bleibt
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractArbeit batchen, die warten kann
Die Batch API nimmt 50 % von jedem Token einer Anfrage, einschließlich gecachter, im Austausch dafür, dass Ergebnisse irgendwann innerhalb von 24 Stunden eintreffen. Leite jede Anfrage, auf die niemand wartet, durch einen Batch, und behalte den interaktiven Pfad für den Rest. Batching ist nach Caching der zweitgrößte kostenlose Hebel für unbeaufsichtigte Agent-Arbeit: Evaluierungsläufe, Backfills und geplante Jobs wie ein wiederkehrender Lauf des Issue-Triage-Agenten aus der Token-Trimming-Messung. Es kombiniert sich mit allem auf dieser Seite außer Interaktivität, ist aber nicht für Claude Managed Agents Sessions verfügbar, die von Haus aus interaktiv sind (siehe Claude Managed Agents Preise).
Prompts gegen das aktuelle Modell auditieren
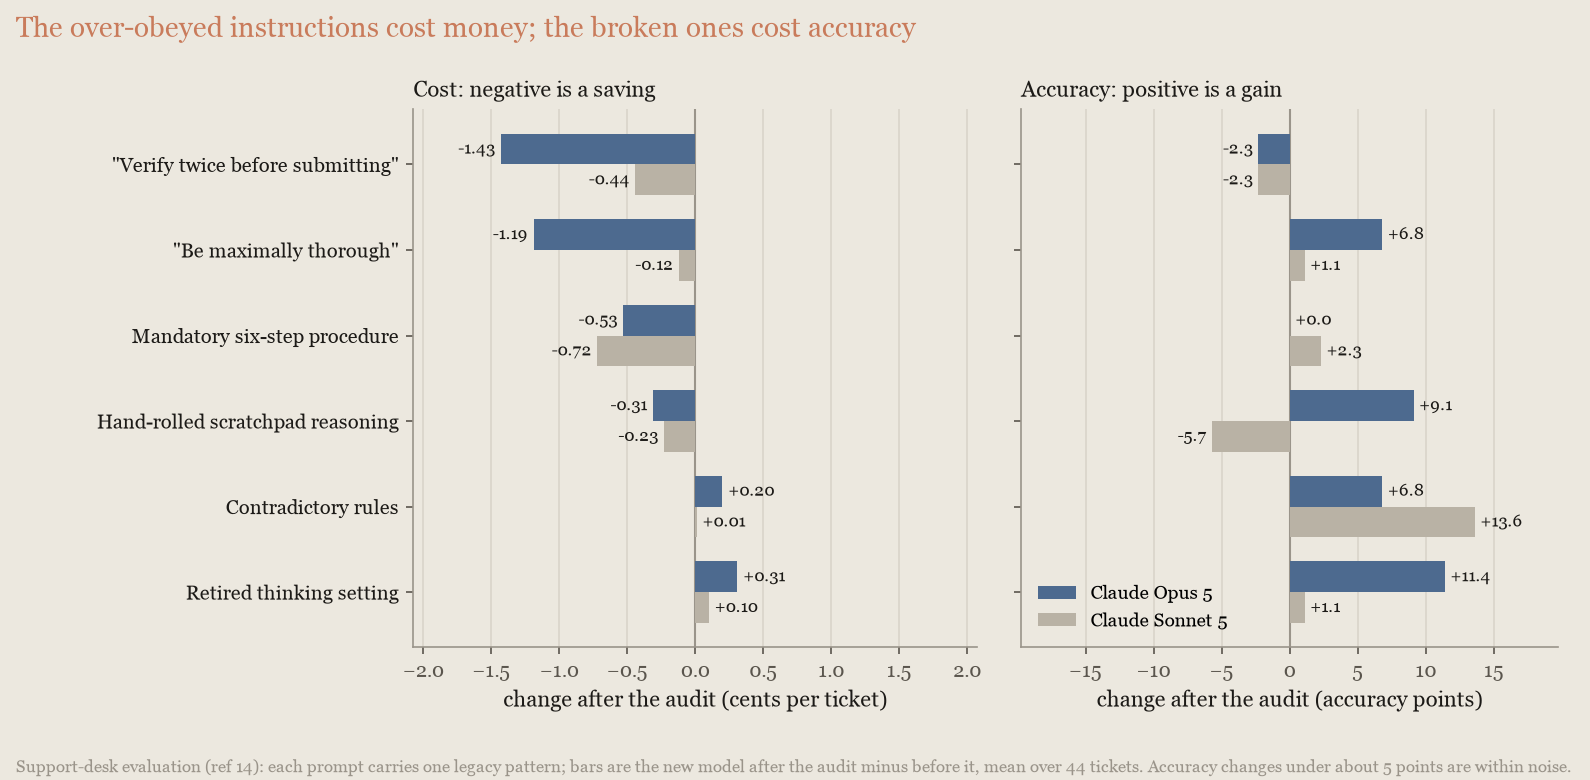
Jede Modellgeneration reagiert anders auf Prompts, sodass ein Prompt Text ansammelt, der für ein Modell geschrieben wurde, das du nicht mehr verwendest. Der übliche Fall ist eine überspezifische Anweisung, die hinzugefügt wurde, um ein älteres Modell zu kompensieren: „verify twice“, „be maximally thorough“, eine verpflichtende Schritt-für-Schritt-Prozedur oder ein selbstgebautes Reasoning-Scratchpad. Ein neueres Modell befolgt diese buchstabengetreu und erzeugt zusätzliche Tool-Runden und zusätzliches Schreiben, sodass die Rechnung steigt, ohne Gewinn an Genauigkeit. Prompts gegen das Modell zu auditieren, das du jetzt betreibst, und erneut, wann immer du Modelle wechselst, ist ein kostenloser Gewinn.
Das Audit ist ein einziger Befehl. Der Claude API Skill, der mit Claude Code ausgeliefert wird, hat einen prompt-audit-Befehl, der die Prompts und den Anfragecode eines Projekts liest und berichtet, was für ein anderes Modell geschrieben wurde. Dieser gekürzte Auszug zeigt ihn, ausgeführt gegen einen Support-Desk-Prompt und Anfragecode, der diese Muster enthält:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.Der Befehl schlägt dann seine Bearbeitungen als Diff vor (ein Hunk gezeigt) und listet auf, was er bewusst unangetastet ließ: das Rückerstattungsfenster, die Tonvorgabe und die Qualitätsmesslatte. Du prüfst einen Patch, keine Neufassung.
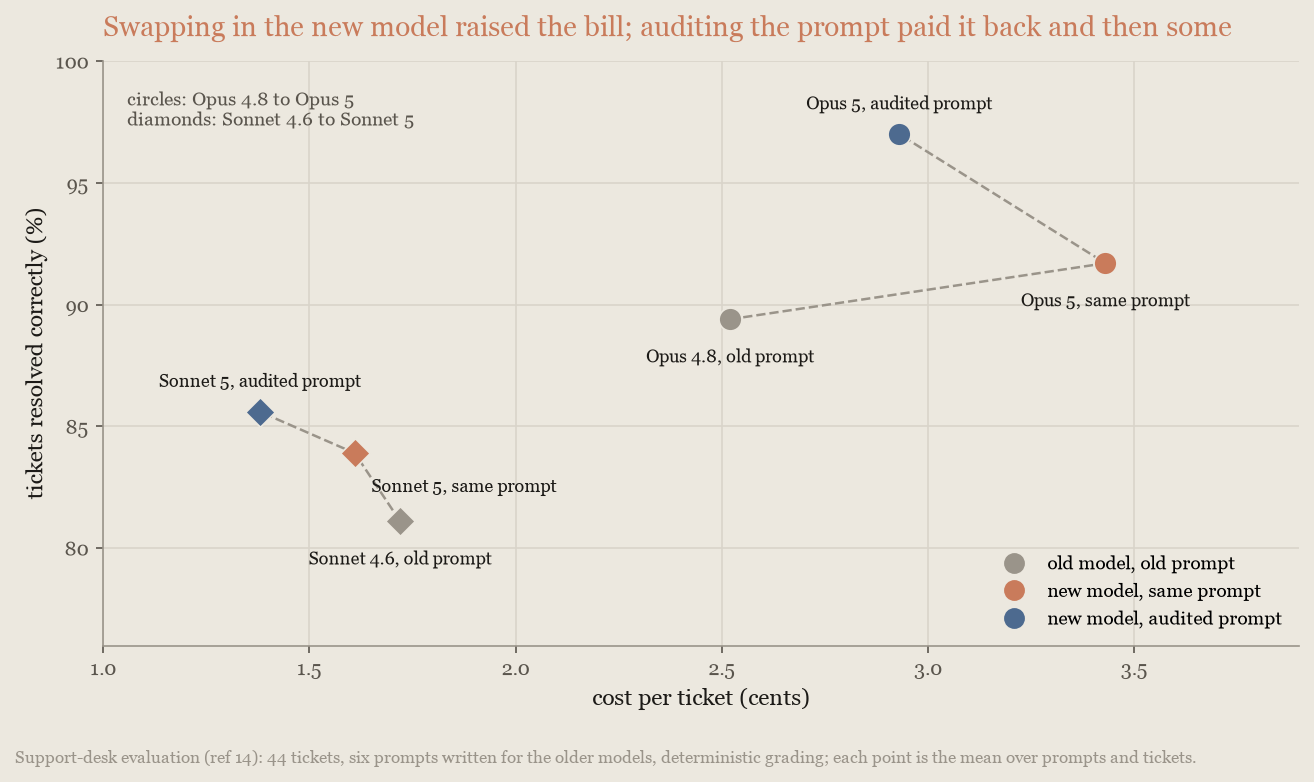
Der Effekt ist messbar. Auf einer Support-Desk-Evaluierung14 kosteten für Claude Opus 4.8 geschriebene Prompts auf Claude Opus 5 36 % mehr pro Ticket ohne Änderung der Genauigkeit. Das Audit über dieselben Prompts laufen zu lassen machte Opus 5 sowohl günstiger als die nicht auditierte Version (um 14 %) als auch genauer (97 % der Tickets, von 92 %, ein Gewinn außerhalb des Rauschens). Bei der Migration von Claude Sonnet 4.6 zu Claude Sonnet 5 nahm das Audit 14 % bei gleicher Genauigkeit weg:
Die zwei Arten veralteten Texts haben unterschiedliche Kosten. Anweisungen, die das neue Modell zu wörtlich befolgt, kosten Geld: Das Entfernen von „verify twice“ senkte die Kosten pro Ticket von Opus 5 um ein Drittel, und das Entfernen von „be maximally thorough“ fast ebenso viel. Text, der nicht mehr zum Modell passt, kostet stattdessen Genauigkeit: Eine eingestellte Thinking-Einstellung, widersprüchliche Regeln und ein selbstgebautes Scratchpad, das mit dem eigenen Nachdenken des Modells kollidiert, stellten beim Entfernen jeweils 7 bis 11 Punkte auf Opus 5 wieder her:
Dieselben Muster tauchen tendenziell in Tool-Beschreibungen und Skills auf, die ebenfalls ein Audit wert sind.
Kosten gegen Intelligenz abwägen
Diese Hebel legen fest, wo ein einzelnes Modell zwischen Kosten und Intelligenz liegt: Modellwahl, Effort, das Wiederholen von Fehlschlägen mit einer höheren Einstellung, die Budgets und Limits, innerhalb derer es arbeitet, und ob es sehen kann, wie viel Zeit vergangen ist. Beginne mit einem Effort-Sweep auf deinem aktuellen Modell (Effort abstimmen). Von den niedrigsten zu den höchsten Kosten und Fähigkeiten sind die aktuellen Modelle Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 und Claude Fable 5.1 (das Frontier-Modell); die Modellübersicht enthält das vollständige Angebot und die Preise.
Modelle anhand der Kosten pro Aufgabe vergleichen
Preislisten sind pro Token angegeben, und pro Token wirkt das Frontier-Modell teuer: Der Preis pro Token von Claude Fable 5.1 beträgt ein Mehrfaches dessen von Claude Sonnet 5. Du zahlst jedoch für abgeschlossene Aufgaben, also vergleiche Modelle anhand der Kosten pro abgeschlossener Aufgabe. Ein leistungsfähigeres Modell erledigt eine Aufgabe mit weniger Arbeit: weniger Turns, weniger Suchen, weniger erneutes Lesen des eigenen Kontexts und weniger Zurückrudern. Der Aufschlag pro Token wird oft dadurch mehr als ausgeglichen, dass von allem weniger anfällt.
Anthropic hat dies auf der Teilmenge von SWE-bench Pro3 gemessen, bepreist so, wie ein Kunde abgerechnet wird:
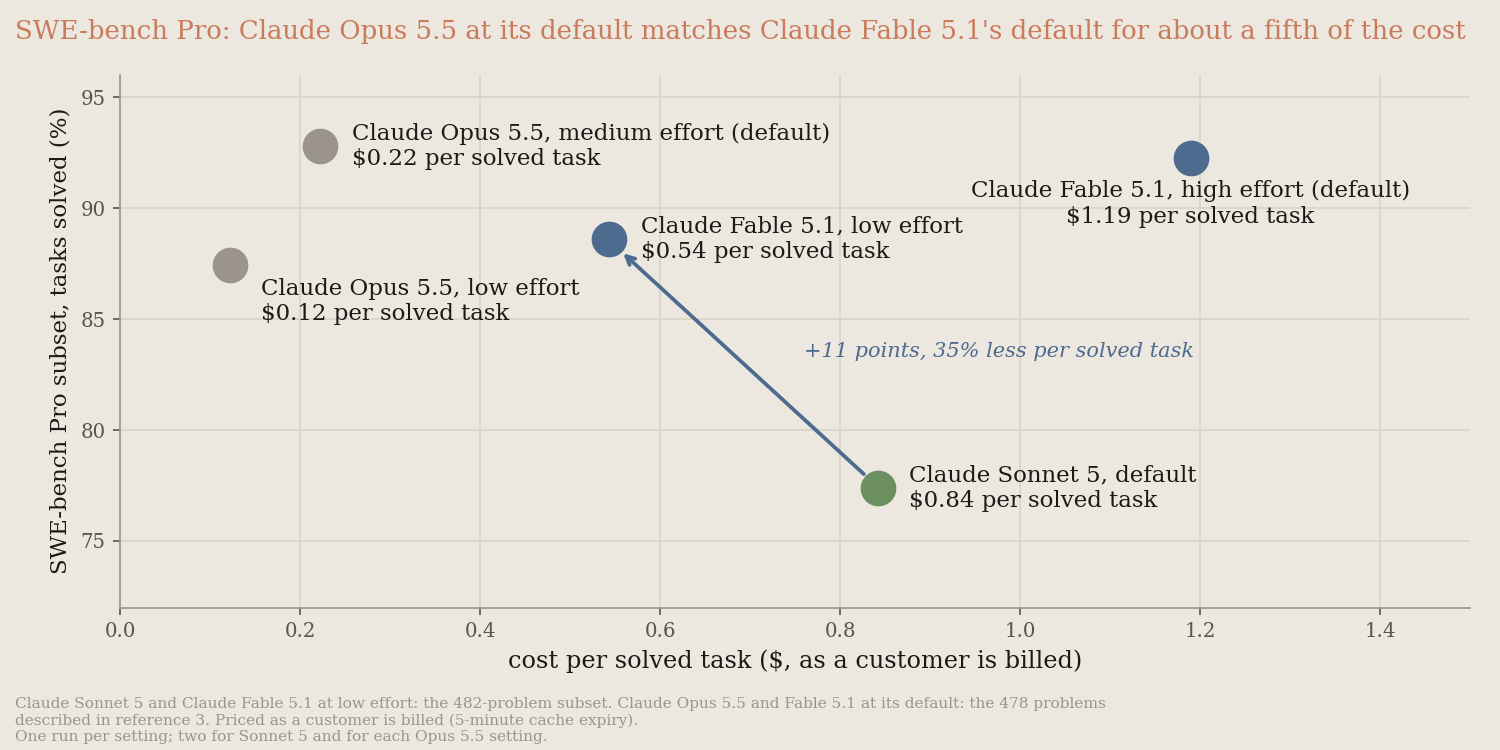
Claude Fable 5.1 mit low Effort löste 88,6 % der Aufgaben für 0,54 $ pro gelöster Aufgabe, gegenüber 77,4 % für 0,84 $ bei Claude Sonnet 5 mit seinem Standard: 11 Punkte mehr für 35 % weniger pro gelöster Aufgabe, trotz eines fünfmal höheren Preises pro Token. Es gewinnt jedoch nicht immer. Auf derselben Teilmenge, die Claude Opus 5.5 und Claude Fable 5.1 beide weitgehend sättigen und deren Ergebnisse nicht mit dem öffentlichen Leaderboard vergleichbar sind, erreichte Opus 5.5 mit seinem Standard medium das Niveau von Fable 5.1 mit dessen Standard (92,8 % gegenüber 92,3 %, innerhalb des Rauschens zwischen Läufen) für etwa ein Fünftel der Kosten pro gelöster Aufgabe (0,22 $ gegenüber 1,19 $). Mit low löste Opus 5.5 87,4 % für 0,12 $. Diese Zahlen verwenden die 478 in Referenz 3 beschriebenen Probleme. Und bei langen Recherche-Schleifen leistet das Frontier-Modell mehr Arbeit, nicht weniger: Auf DeepResearch Bench II7 erzielte Fable 5.1 mit low 10 Punkte mehr als Sonnet 5 (66 % gegenüber 56 %) bei etwa den vierfachen Kosten pro Aufgabe (4,66 $ gegenüber 1,20 $), weil es eine längere Recherche-Schleife über einen größeren Kontext ausführt. Claude Opus 5 erzielte mit seinem Standard auf derselben Grundlage 71 % für 6,71 $ pro Aufgabe, mehr als Fable 5.1 mit dessen Standard (65 % für 7,12 $); auch bei Recherche ist Fable 5.1 seinen Preis also nur mit low wert.
Beginne für die meisten Agent-Workloads mit Claude Opus 5.5 bei seinem Standard-Effort (medium) und verwende Claude Fable 5.1 für anspruchsvolles Reasoning und agentische Arbeit mit langem Horizont oder wenn deine Evals auf Claude Opus 5.5 mit höherem Effort immer noch nicht ausreichen. Auf der Teilmenge von SWE-bench Pro erreichte Opus 5.5 mit seinem Standard, wie bereits erwähnt, das Niveau von Fable 5.1 mit dessen Standard für etwa ein Fünftel der Kosten pro gelöster Aufgabe. Auf dem Coding-Benchmark in Advisor-Strategie erzielte es 86,6 % gegenüber 84,2 % für Fable 5.1 mit medium (ein einzelner Lauf von Fable 5.1), für weniger als ein Drittel der Kosten pro Versuch (0,84 $ gegenüber 2,68 $). Auf Chartography13, einem Benchmark zum Lesen von Diagrammen, erzielte Opus 5.5 mit low 68,7 für etwa 0,03 $ pro Diagramm, gegenüber 62,5 für 0,15 $ bei Fable 5.1 mit low und 49 für 0,16 $ bei Claude Opus 5 mit low. Am anderen Ende beantwortete Claude Haiku 4.5 Fragen aus GPQA Diamond9 für etwa ein Fünftel der Kosten pro Frage von Claude Opus 5.5, mit 63 % Genauigkeit gegenüber 92 % bei Opus 5.5, und fiel bei langen Coding-Aufgaben noch viel weiter zurück. Es eignet sich für Arbeit mit hohem Volumen und prüfbaren Ausgaben, nicht für lange agentische Schleifen.
Die Rangfolge kehrt sich je nach Workload um, und keine Preisliste sagt dir, in welche Richtung. Bepreise jeden Kandidaten in Kosten pro abgeschlossener Aufgabe auf deinem eigenen Traffic, einschließlich Claude Opus 5.5 bei seinem Standard-Effort und des Frontier-Modells mit reduziertem Effort.
Bepreise das Ende der Verteilung deines Workloads, nicht den Median: Vergleiche Modelle anhand des schwierigsten Zehntels deiner Aufgaben, nicht anhand der typischen. Bei der typischen Aufgabe sehen alle Modelle ähnlich aus und das günstigste wirkt am besten, aber die Rechnung wird von den Aufgaben bestimmt, an denen das günstigere Modell scheitert, denn eine gescheiterte Aufgabe rechnet trotzdem ihre Token ab, dann den erneuten Versuch und dann, was auch immer der Fehlschlag nachgelagert kostet. Am Ende der Verteilung fließt das Geld auch dann hin, wenn nichts scheitert. Bei einem WideSearch1-Lauf mit 20 Problemen entfielen auf zwei Probleme 43 % der Ausgaben:
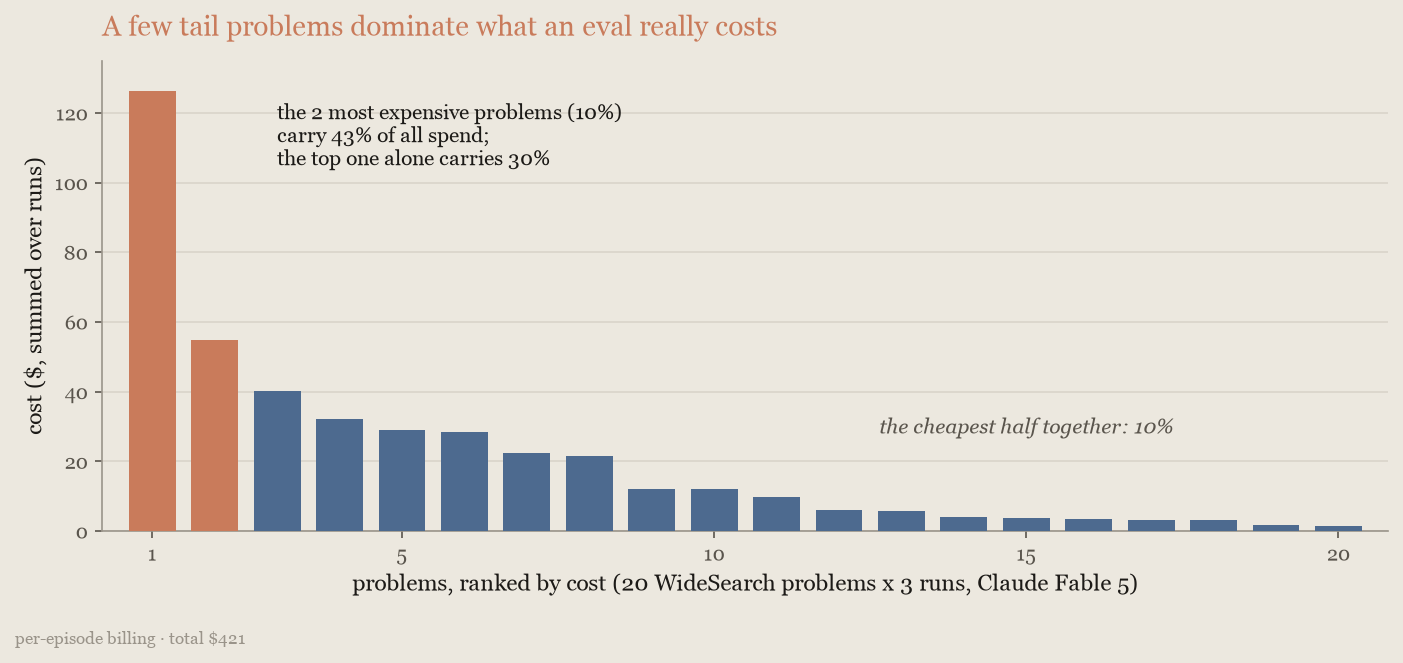
Die Multi-Modell-Strategien existieren, um Frontier-Intelligenz für dieses Ende der Verteilung einzusetzen, ohne für den Rest Frontier-Preise zu zahlen.
Modell upgraden
Wenn du ein oder zwei Modellgenerationen zurückliegst, ist der Modell-String der günstigste Hebel. Anthropic ließ aktuelle Claude Opus-, Claude Sonnet- und Claude Fable-Modelle mit demselben Harness auf der SWE-bench-Pro-Teilmenge3 laufen. Jedes Modell lief mit seinen ausgelieferten Standardeinstellungen und wurde zu Listenpreisen bepreist. Die Opus-Reihe lief zusätzlich auf Terminal-Bench 320:
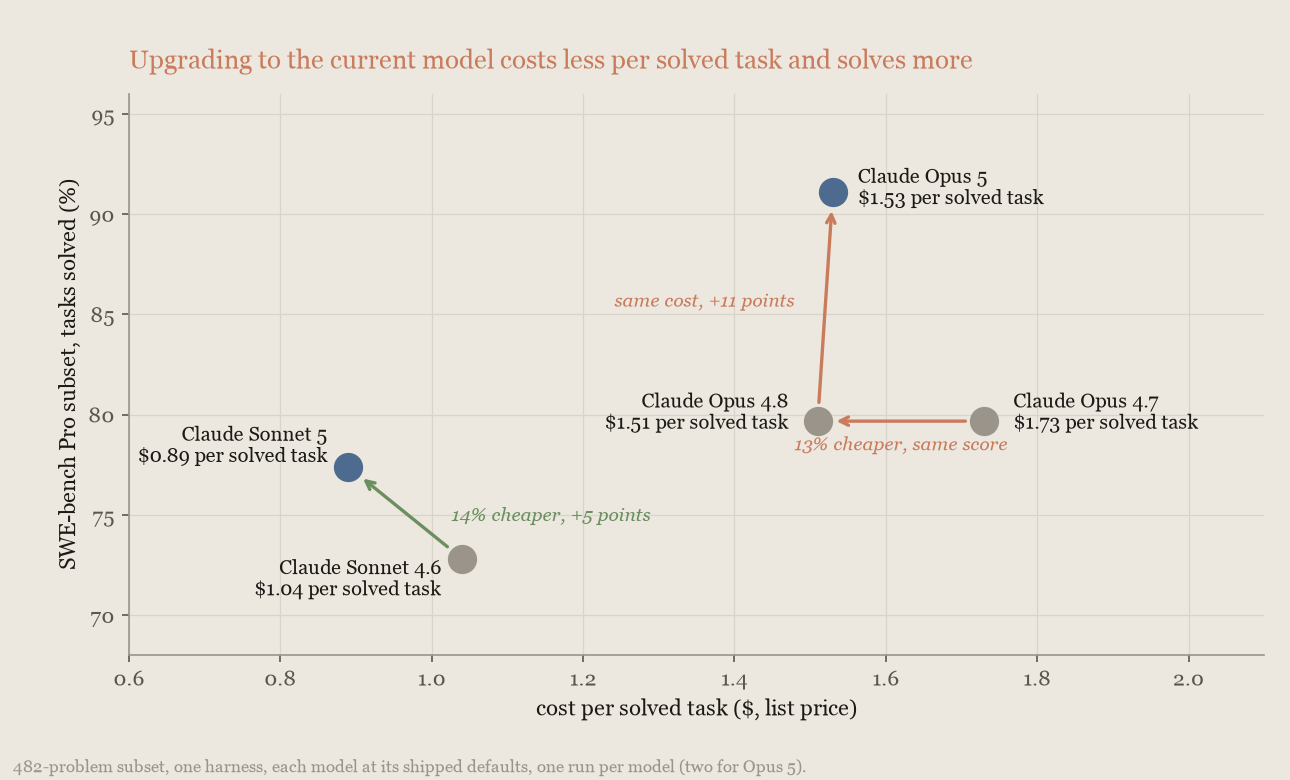
Anthropic bepreist Claude Opus 4.7, Opus 4.8 und Opus 5 pro Token identisch. Jeder Kostenunterschied zwischen ihnen ergibt sich also daraus, wie viel Arbeit jedes Modell pro Aufgabe leistet. Bepreist, wie ein Kunde abgerechnet wird, löst Claude Opus 4.8 denselben Anteil an Aufgaben wie Claude Opus 4.7, für 14 % weniger pro gelöster Aufgabe. Claude Opus 5 löst dann 12 Punkte mehr Aufgaben, für 21 % mehr pro gelöster Aufgabe. Claude Opus 5 mit low-Effort schlägt auf diesem Benchmark Opus 4.8 mit Standard-Effort, für etwa 30 % von dessen Kosten pro gelöster Aufgabe. Das günstigste Upgrade ist also das neue Modell mit einer niedrigeren Einstellung.
Sonnet 5 spart durch seinen niedrigeren Preis pro Token. Dieser gleicht die zusätzlichen Token, die es pro Aufgabe im Vergleich zu Sonnet 4.6 verbraucht, mehr als aus: 15 % weniger pro gelöster Aufgabe bei 5 Punkten mehr. Die Frontier-Stufe hat auf dieselbe Weise gewonnen. Claude Fable 5.1 erreicht die Punktzahl von Claude Fable 5 für 43 % weniger pro gelöster Aufgabe, größtenteils dank des niedrigeren Cache-Read-Preises.
Eine Ersparnis ist aber nicht garantiert. Auf DeepResearch Bench II7 kostet dasselbe Upgrade mit high 41 % mehr pro Aufgabe, mit low sogar 79 % mehr. Dafür bringt es 2 bis 3 zusätzliche Punkte bei den Aufgaben, die in jeder Variante fehlerfrei liefen (Referenz 7). Der Grund: Das neue Modell leistet dort mehr Arbeit pro Aufgabe. Input- und Output-Preise sind gleich, und der Cache-Read ist 4-mal günstiger. Miss das Upgrade trotzdem auf deinem eigenen Workload, bevor du von einer Ersparnis ausgehst.
Bei schwierigerer Arbeit wird der Abstand größer. Auf Terminal-Bench 320 sind die Aufgaben so schwierig, dass die Erfolgsquote die Rechnung bestimmt, nicht die Token. Claude Opus 4.7, Opus 4.8 und Opus 5 geben dort jeweils 8 $ bis 15 $ pro Aufgabe aus, lösen aber 7 %, 15 % bzw. 41 % der Aufgaben. Die Kosten pro gelöster Aufgabe fallen daher mit jeder Generation von 183 $ auf 63 $ und dann auf 28 $. Auf der weitgehend gelösten Coding-Teilmenge kostet Claude Opus 5 21 % mehr als Opus 4.8. Auf Terminal-Bench 3, wo das ältere Modell meist scheitert, wird daraus eine Ersparnis von 56 %. Je öfter dein Workload das alte Modell überfordert, desto mehr spart das Upgrade pro Ergebnis.
Vergleiche anhand der Kosten pro gelöster Aufgabe, nicht pro Token. Derselbe Text ergibt auf Claude Opus 4.7 und neueren Modellen etwa 30 % mehr Token. Ein Vergleich pro Token lässt die neueren Modelle daher zwangsläufig teurer aussehen.
Effort abstimmen
Effort ist der direkteste Weg, ein Modell auf deine Aufgabe abzustimmen. Der Parameter effort steuert, wie viel Nachdenken, „tool calling" (Tool-Aufrufe) und Selbstüberprüfung das Modell durchführt, und high, der Standard bei den meisten Modellen, eignet sich für anspruchsvolle Aufgaben; Claude Opus 5.5 verwendet standardmäßig medium. Die Kosten skalieren mit all dieser Aktivität; die Genauigkeit skaliert nur mit dem Teil, den deine Aufgabe benötigt. Unterhalb der Leistungsgrenze des Modells bezahlen die höchsten Effort-Stufen für Tiefe, die die Aufgabe nie nutzt.
Auf den Benchmarks für Recherche und Wissensarbeit (WideSearch1, DeepWideSearch6, BrowseComp4 und GDPval2, alle mit Claude Fable 5) ist die Kurve der Genauigkeit gegenüber den Kosten nahezu flach: low büßte 1 bis 3 Punkte ein und senkte die Kosten pro Aufgabe um ein Drittel bis die Hälfte, medium erreichte die Genauigkeit des Standards bei etwa 70 % bis 87 % von dessen Kosten, und der Standard brachte auf keinem der vier einen messbaren Vorteil gegenüber medium. Auf DeepWideSearch erreichte low außerdem das Ergebnis eines Orchestrators mit einem Claude Sonnet 5-Worker bei 29 % niedrigeren Kosten: Das Senken des Effort schlug eine Architekturänderung.
Niedrigere Effort-Einstellungen sind oft schneller, was wichtig ist, wenn die „latency" (Latenz) die Einschränkung ist. In diesen Durchläufen benötigte low auf DeepWideSearch 4,5 Minuten pro Problem, verglichen mit 7,9 Minuten beim Standard. Auf dem Korpus-Benchmark, dessen Eingabe in kein einzelnes „context window" (Kontextfenster) passt, benötigte Fable 5.1 bei low, medium und high 15,2, 17,5 und 19,9 Stunden pro Episode.
Beim Coding mit langem Zeithorizont erkauft Effort tatsächlich Genauigkeit. Auf SWE-bench Pro3 erzielte Claude Opus 5.5, gemessen an high, bei seinem Standard medium etwa 2,5 Punkte weniger für etwa 70 % der Kosten und bei low etwa 8 Punkte weniger für etwa ein Drittel der Kosten; xhigh erzielte etwa 1,4 Punkte mehr für das 2,5-Fache der Kosten von high: ein echter Zielkonflikt, den das erneute Ausführen von Fehlschlägen mit höherem Effort wieder in eine Ersparnis verwandelt. Dieses Diagramm stellt die Genauigkeit den Kosten für die Benchmarks für Recherche und Wissensarbeit sowie für SWE-bench Pro gegenüber:
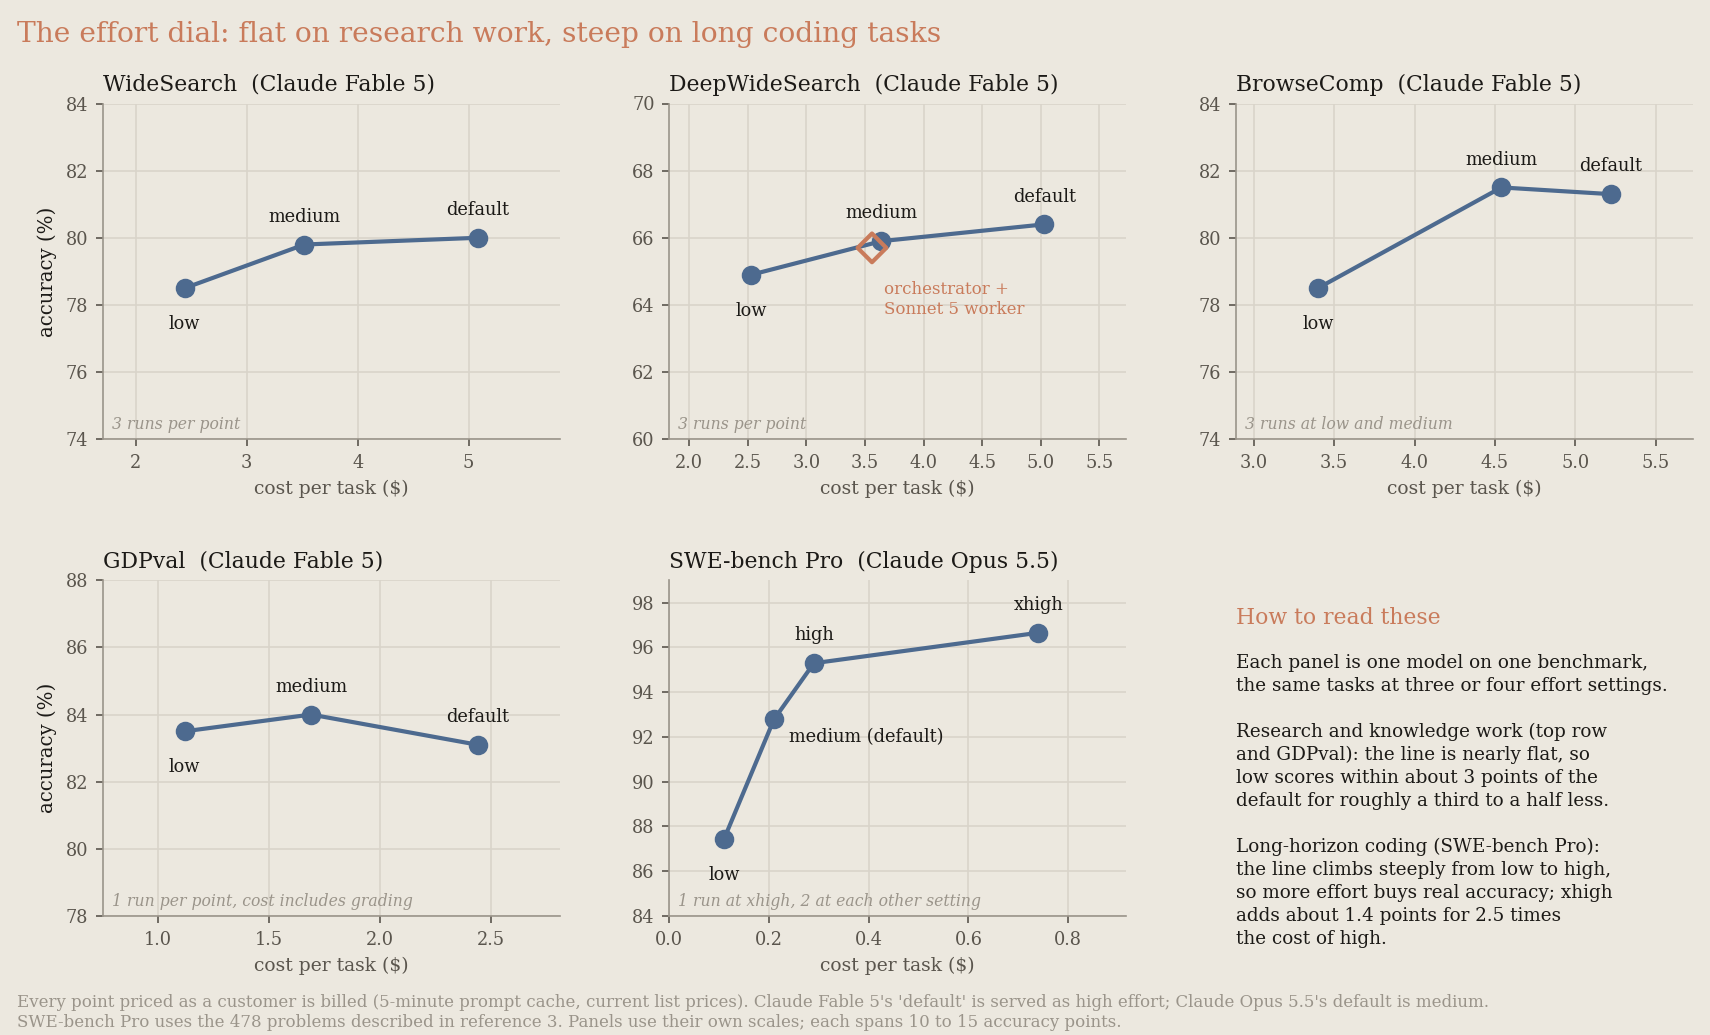
Daraus ergeben sich zwei Konsequenzen. Erstens: Zeichne diese Kurve für deinen eigenen Workload, bevor du ein zweites Modell hinzufügst: In diesen internen Messungen kostete eine Multi-Modell-Konfiguration, die günstiger aussah als das einzelne Modell mit Standardeinstellung, mehr als dasselbe Modell mit niedrigerem Effort. Zweitens ist diese Kurve die Einzelmodell-Baseline, die jede Multi-Modell-Strategie schlagen muss, daher erstellt Schritt 2 der Messung auf deinem eigenen Workload Baselines über alle Effort-Stufen hinweg.
Schwierige Arbeit braucht nicht automatisch hohen Effort. Auf DeepResearch Bench II7 erzielte Claude Fable 5.1 bei low, medium und high nahezu dieselbe Punktzahl, während die Kosten pro Aufgabe von 4,66 $ auf 7,12 $ stiegen; das Erhöhen des Effort steigert in diesem Fall die Qualität der Ausgabe also nicht merklich; bei den 21 Aufgaben, die in jedem Arm sauber durchliefen (Referenz 7), war auch Claude Fable 5 über alle Effort-Stufen hinweg flach, obwohl die 33-Aufgaben-Basis des Diagramms, die die abgebrochenen Versuche des jeweiligen Modells ausschließt, einen Anstieg zeigt. Miss die Kurve an dem Modell, das du auslieferst, nicht an dem, das du zuletzt gemessen hast:
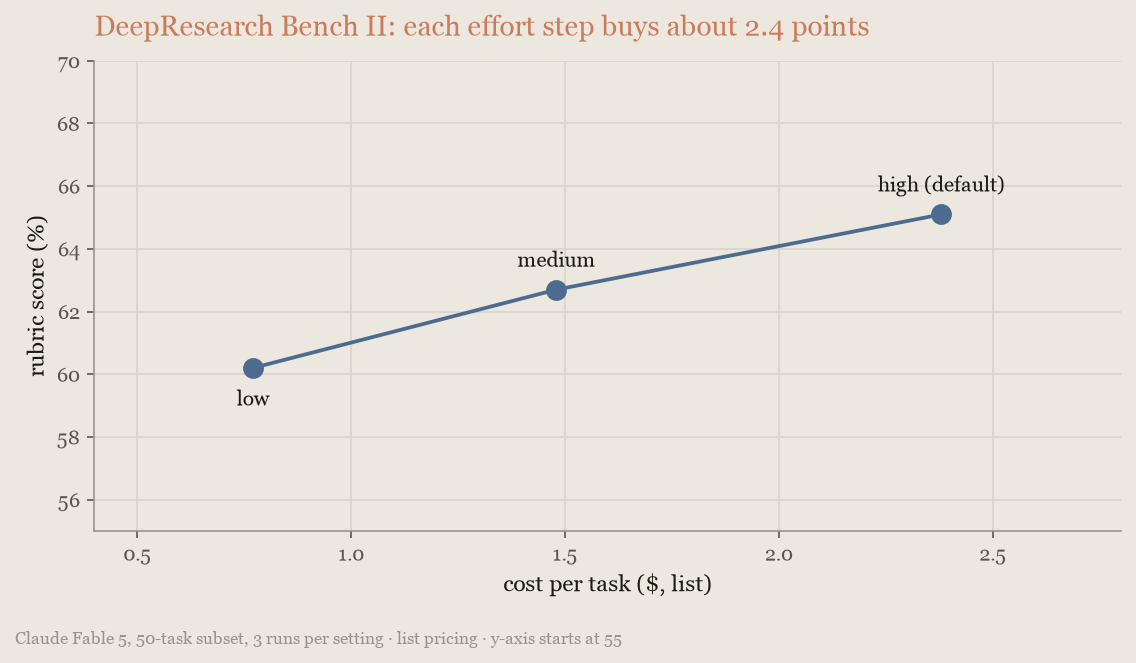
Die Aufgabenbeschreibung allein verrät nicht, welche Art von Workload du hast, also teste zwei oder drei Effort-Stufen an einer Stichprobe deines eigenen Traffics und lies die Antwort an der Kurve ab. Teste jede Stufe in einer separaten Sitzung: Das Ändern des Effort auf oberster Ebene mitten in einer Sitzung invalidiert den Cache (siehe Wiederholten Kontext cachen) und verzerrt den Vergleich. Details zum Parameter findest du unter Effort.
Fehlschläge mit höherem Effort erneut ausführen
Wenn sich das Ergebnis einer Aufgabe überprüfen lässt, ist die günstigste Strategie auf der Effort-Kurve keine feste Einstellung: Führe jede Aufgabe mit einer niedrigen Einstellung aus und führe nur die Fehlschläge mit einer höheren erneut aus.
Anthropic hat diese Strategie Aufgabe für Aufgabe aus den Effort-Durchläufen auf der Teilmenge von SWE-bench Pro3 in Effort abstimmen berechnet. Mit Claude Opus 5.5 bei low schlugen 13 % der Aufgaben fehl; wurden diese bei high erneut ausgeführt, bestanden etwa 97 % für jeweils etwa 0,17 $, gegenüber 95,3 % für 0,29 $, wenn alles bei high ausgeführt wurde: eine etwas höhere Erfolgsquote für etwas mehr als die Hälfte der Kosten, die fehlgeschlagenen günstigen Versuche eingerechnet. Ein Start bei medium löste stattdessen etwa 97 % für etwa 0,24 $. Der größte Teil der kleinen Verbesserung stammt vom zweiten Versuch (das erneute Ausführen der Fehlschläge eines high-Durchlaufs bei high erzielt etwa dasselbe, für mehr Geld), also nutze diese Strategie für die Ersparnis, nicht für die Verbesserung:
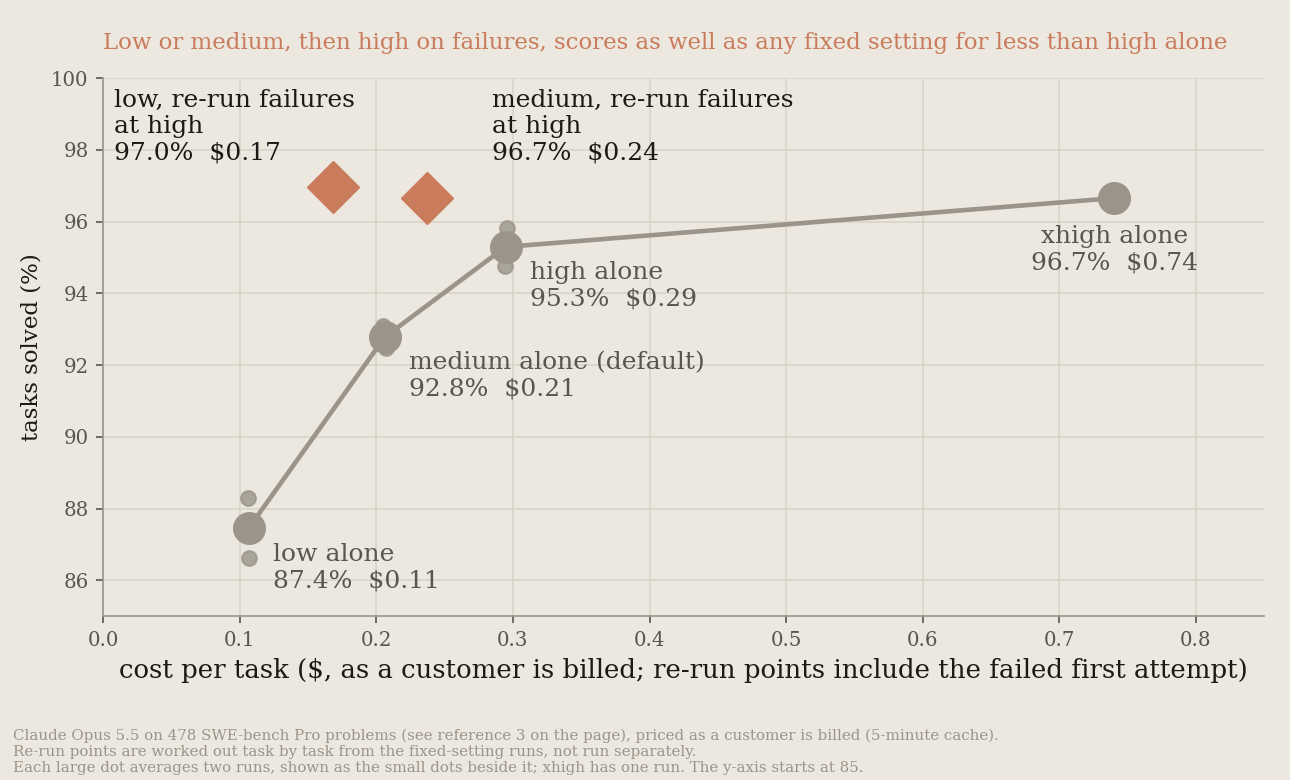
Es gelten zwei Bedingungen. Erstens brauchst du ein Fehlersignal (hier die eigenen Tests des Benchmarks); ein Prüfer, der schlechte Arbeit durchgehen lässt, lässt diese Fehlschläge durch. Zweitens benötigt jeder Fehlschlag im ersten Durchlauf die Echtzeit von zwei Durchläufen, sodass die Ersparnis bei den Fehlschlägen mit Latenz bezahlt wird.
Budgets und Ausgabelimits festlegen
Die meisten agentischen Aufgabendurchläufe sind günstig, aber eine Minderheit gibt ein Vielfaches der Mediankosten für Suchen, erneutes Verifizieren und übermäßiges Testen aus. Ein „task budget" (Task-Budget) zielt auf diesen Ausläufer ab. Das Modell sieht für die gesamte Aufgabe einen laufenden Token-Countdown und reguliert sich selbst: Es kürzt wenig wertvolle Suchen, überspringt redundante Verifizierungen und kommt zum Abschluss, statt sich in Schleifen zu verlieren.
Anthropic hat die Erfolgsquote und die Kosten pro Aufgabe auf SWE-bench Pro3 mit Claude Fable 5.1 gemessen, während das Budget verschärft wurde:
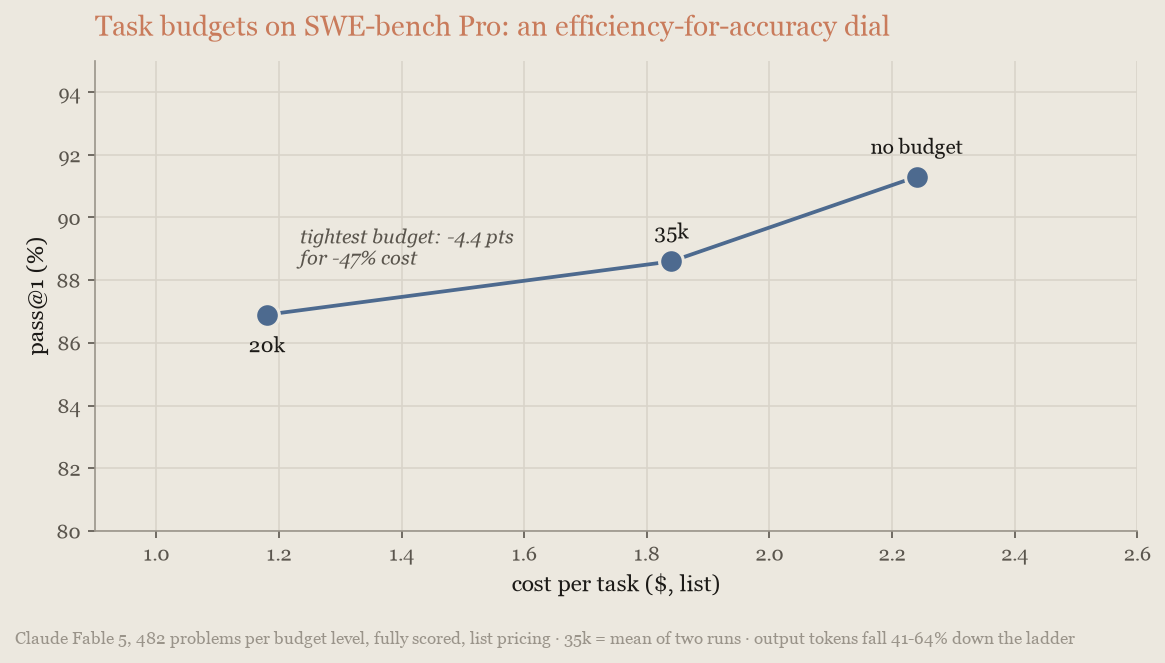
Ein großzügiges Budget senkte die Kosten pro Aufgabe um 44 % bei etwa 3 Punkten Erfolgsquote, am Rand des „run-to-run noise" (Schwankungen zwischen Durchläufen), und das engste zulässige Budget senkte sie um 58 % bei 6 Punkten. Budgets erkauften hier Effizienz, zu einem Preis bei der Erfolgsquote, der mit enger werdendem Budget steigt.
Drei Steuerungen erfüllen drei verschiedene Aufgaben. Ein Task-Budget spart Geld, weil das Modell es sieht. max_tokens ist eine Sicherheitsobergrenze: Eine Senkung reduzierte die Kosten pro Versuch, ohne die Kosten pro gelöster Aufgabe zu senken. Bei Claude Managed Agents ist ein Sitzungsbudget der harte Dollar-Stopp hinter beiden. Lege alle drei fest: ein Task-Budget, einen hohen max_tokens-Wert und eine Sitzungsobergrenze für den Durchlauf, den du nie auf einer Rechnung sehen willst, mit einem Ausgabenlimit für den Workspace als letzter Absicherung.
- Task-Budgets sind auf den neuesten Modellen in der Beta-Phase (Beta-Header
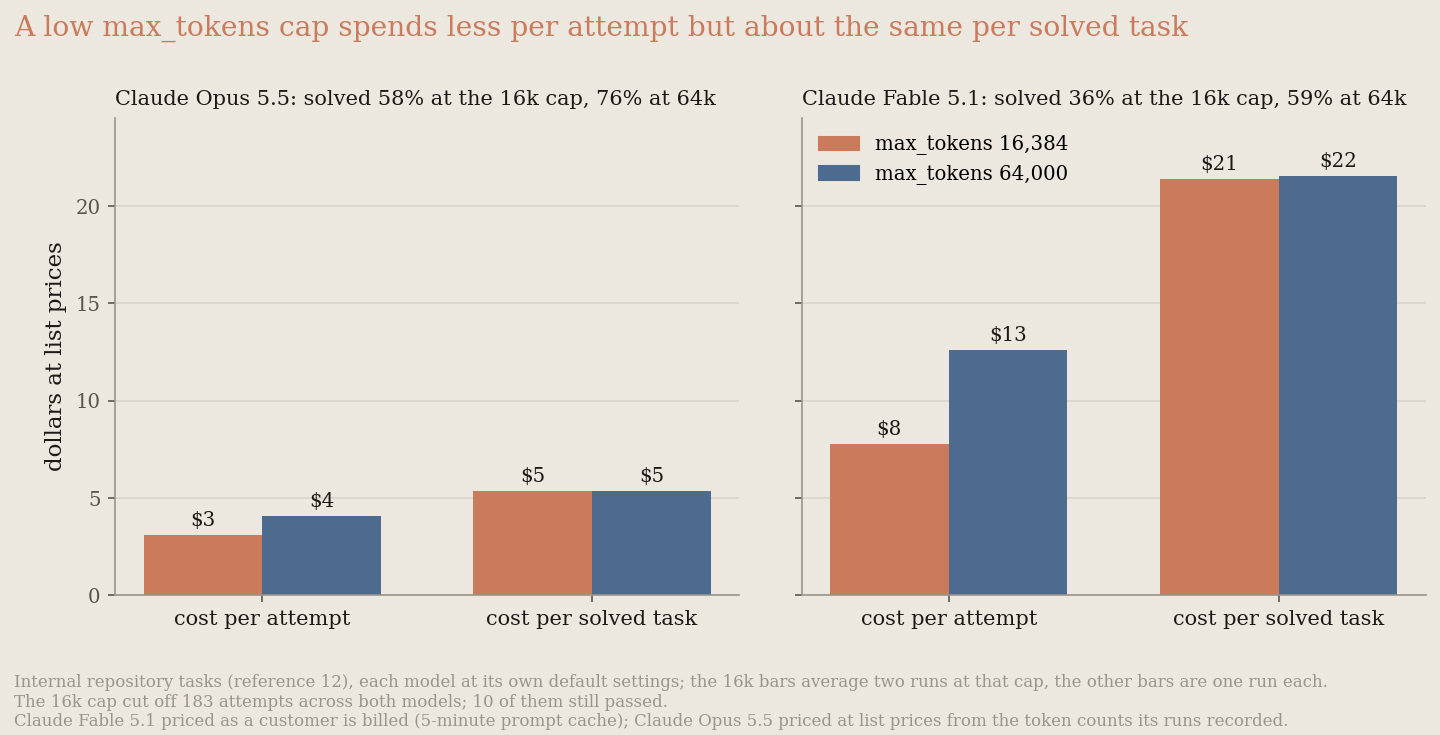
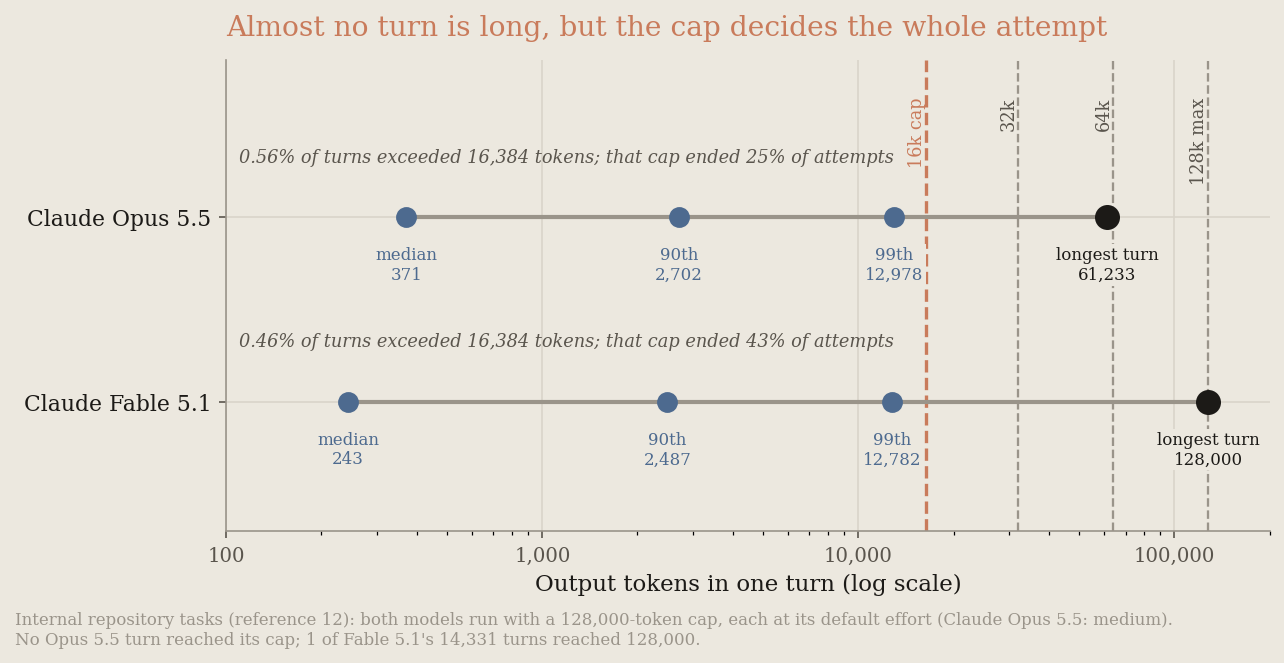
task-budgets-2026-03-13); welche das sind, siehst du in der Support-Tabelle. Beginne in der Nähe des Token-Verbrauchs im 90. Perzentil deiner Schleife und verschärfe dann (Ein Budget wählen zeigt, wie du diese Verteilung erfasst). Budgets unterhalb der aktuellen Untergrenze von 20.000 Token werden abgelehnt, und sehr enge Budgets können ablehnungsähnliches Verhalten hervorrufen. Lege das Budget einmal fest, bei der ersten Anfrage, denn eine Änderung mitten in der Aufgabe invalidiert den Cache. Das Budget ist beratend: Es lenkt das Modell, statt es zu stoppen, also überprüfe die Einhaltung an deinem Workload. max_tokensbegrenzt eine einzelne Antwort, für das Modell unsichtbar, daher bringt eine Senkung das Modell nicht zum Sparen. Die Turns, die den Platz gebraucht hätten, werden verworfen und trotzdem abgerechnet. Auf einem internen Benchmark mit Repository-Aufgaben12 beendete eine Obergrenze von 16.384 Token etwa ein Viertel der Versuche von Claude Opus 5.5 und 43 % der Versuche von Claude Fable 5.1, jeweils mit dem Standard-Effort. Nur 1 der 66 begrenzten Opus 5.5-Versuche und 9 der 117 begrenzten Fable-Versuche bestanden trotzdem. Begrenzte Durchläufe gaben pro Versuch weniger aus, erzielten aber proportional weniger Lösungen, sodass die Kosten pro gelöster Aufgabe etwa gleich waren wie bei 64.000 (bei Fable 5.1 21 $ gegenüber 22 $; bei Opus 5.5 innerhalb von 1 %). Bei 64.000 wurden 2 von etwa 14.000 Turns von Claude Fable 5.1 mit Standard-Effort noch abgeschnitten (bei Claude Opus 5.5 kein einziger), und Fable 5.1 löste 58,5 % der Aufgaben statt 36,3 % (auf einem separaten Ausschnitt der Teilmenge von SWE-bench Pro3, beschrieben in Referenz 12, kein Unterschied: 94 von 100 bei beiden Obergrenzen). Das Wiederholen begrenzter Versuche hilft selten: Bei derselben Obergrenze scheitern die meisten erneut, und bei einer höheren bezahlst du zusätzlich für den verschwendeten Versuch. Setzemax_tokensfür agentische Arbeit auf 64.000 oder auf 128.000, das Maximum, wenn ein einzelner abgeschnittener Versuch teuer ist; bei 128.000 löste Fable 5.1 60,0 % zu denselben Kosten pro gelöster Aufgabe. Streame Antworten dieser Größe, behandlestop_reason: max_tokensals Fehlschlag und spare Geld mit Effort und Task-Budgets, die das Modell sehen kann.- Sitzungsbudgets bei Claude Managed Agents sind der harte Stopp. Ein Sitzungsbudget ist eine Dollar-Obergrenze für eine Sitzung zu Listenpreisen für Token, Suchen und Sitzungszeit. Bei Erreichen der Obergrenze pausiert die Sitzung mit
stop_reason: budget_reached; eine Erhöhung des Budgets setzt sie fort. Es wird von der Plattform durchgesetzt, funktioniert mit jedem Modell mit Listenpreis, einschließlich Modellen, für die Task-Budgets noch nicht verfügbar sind, und lässt sich mit dem beratenden Task-Budget kombinieren. Deployments wenden dasselbe Feld auf jeden Durchlauf an.
Fordere kürzere Antworten an. Output-Token kosten bei Claude Sonnet 5 das Fünffache von Input-Token, und in einer Agentenschleife kommt jedes Token, das das Modell schreibt, in jedem späteren Turn als Eingabe zurück, sodass du für eine lange Antwort immer wieder bezahlst. Anthropic hat den Triage-Job unter drei Anweisungen für die finale Antwort ausgeführt, jeweils drei Durchläufe, mit demselben Modell und denselben Tools. Das Original forderte zwei Zeilen an:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>Die kürzere Variante forderte eine an:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.Die längere Variante forderte ein Memo mit fünf Abschnitten mit Überschriften an: Problemzusammenfassung, Belege, Duplikatprüfung, empfohlenes Label und nächste Schritte. Für ein Issue, einen in die Warteschlange gestellten Prompt, der nach einer übersprungenen Frage nie gesendet wird, lauteten die ersten beiden Antworten:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.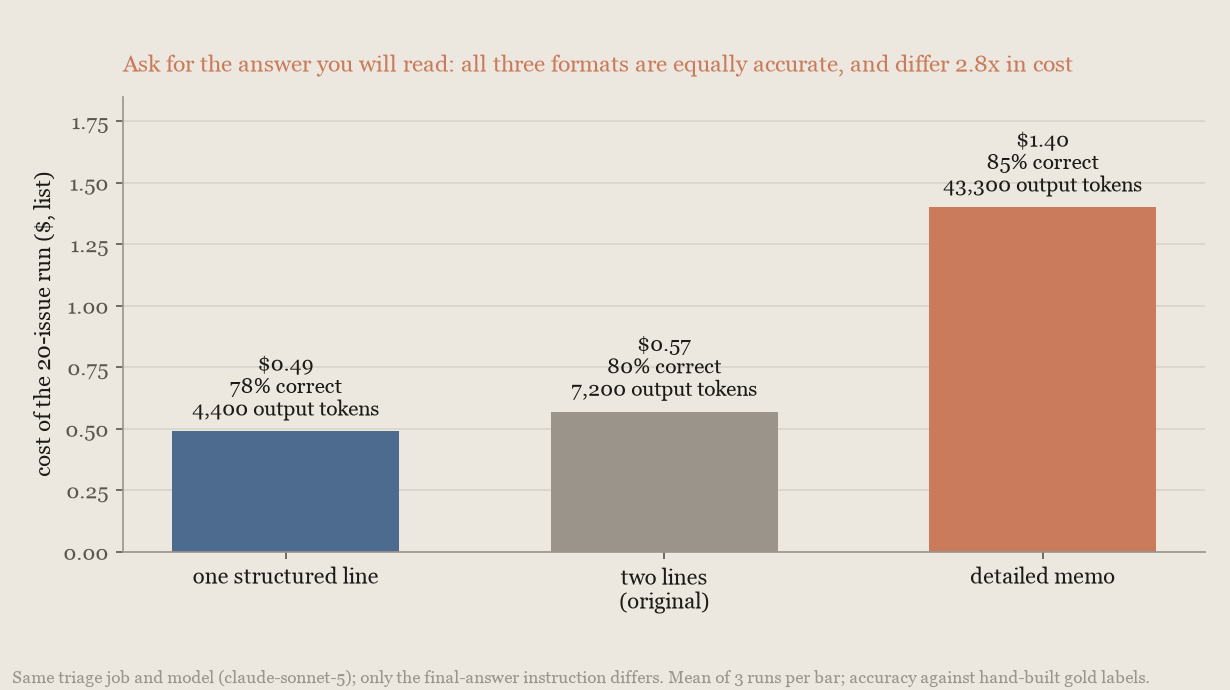
Die einzeilige Antwort verbrauchte 39 % weniger Output-Token als das zweizeilige Original und kostete 14 % weniger pro Durchlauf. Das Memo verbrauchte das Sechsfache an Output-Token und kostete das 2,8-Fache der einzeiligen Antwort. Alle drei lagen gemessen an den Gold-Labels innerhalb der Schwankungen zwischen Durchläufen beieinander, sodass sich die Formate weit mehr darin unterscheiden, was du bezahlst, als darin, was sie richtig machen. Fordere die Antwort an, die du lesen wirst, nicht die, die gründlich aussieht.
Bei der niedrigeren max_tokens-Obergrenze geben beide Modelle pro Versuch weniger aus, lösen aber proportional weniger Aufgaben, sodass sich die Kosten pro gelöster Aufgabe kaum verändern:
Fast jeder Turn endet weit unterhalb beider Obergrenzen. Der seltene lange Turn ist das, was die höhere Obergrenze erkauft:
Dem Modell die verstrichene Zeit zeigen
Ein Modell in einer Agentenschleife kann keine Uhr sehen. Ein Task-Budget zeigt ihm, wie viele Token noch übrig sind, aber standardmäßig zeigt ihm nichts in der Anfrage, wie lange die Arbeit bereits gedauert hat. Zwei kleine Änderungen geben ihm dieses Signal. Füge dem System-Prompt eine Anweisung aus zwei Sätzen hinzu, die besagt, dass Zeit wichtig ist, und sende ab der zweiten Anfrage vor jedem Turn des Modells die verstrichene Zeit.
Anthropic hat beide Änderungen zusammen mit Claude Fable 5.1 bei high-Effort gemessen, auf zwei öffentlichen Benchmarks, DRACO21 und HLE22, sowie auf einem internen Satz von 70 Physikproblemen auf Forschungsniveau, adaptiert vom öffentlichen CritPt-Benchmark23. Diese Seite nennt diesen Satz den Physik-Satz. Jeder der drei lief in zwei Formen: als einzelner Agent und als Team, in dem ein leitender Agent Hilfsagenten desselben Modells startet, die parallel arbeiten. Eine Änderung der Punktzahl gilt als innerhalb der Toleranz, wenn ihr 95-%-Intervall innerhalb einer Grenze bleibt, die Anthropic vor den Durchläufen festgelegt hat: 1,5 Punkte bei DRACO und 2,5 Punkte bei HLE. Das folgende Diagramm stellt für jede Konfiguration die Punktzahl den Kosten pro Aufgabe gegenüber. Eine zweite Balkenreihe gibt die Zeit jeder Konfiguration als Verhältnis zum einzelnen Agenten bei high-Effort an, ohne Wartezeiten für Wiederholungen. Eine dritte Reihe gibt die Änderung der Punktzahl an, die beide Änderungen bewirken, mit ihrem 95-%-Intervall:
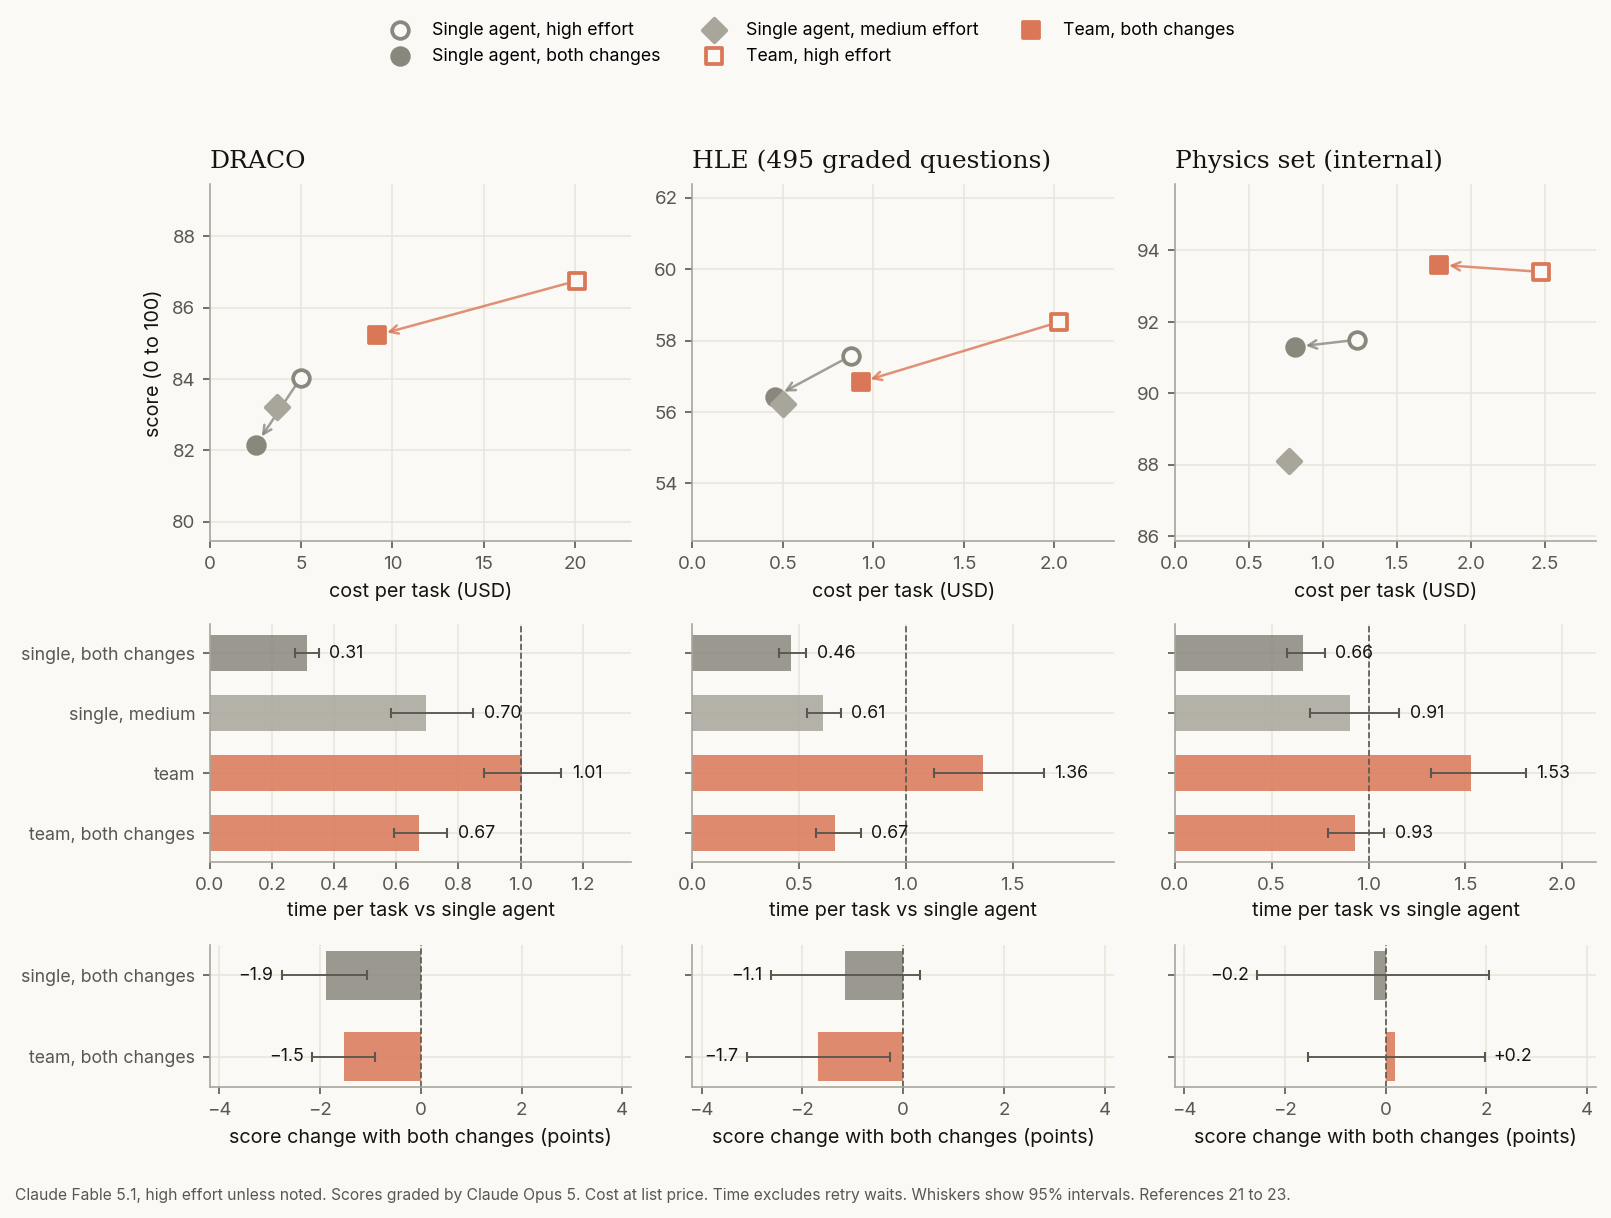
Mit einem Team von Agenten. Ein Team leistet mehr Arbeit als ein einzelner Agent und kostet daher standardmäßig mehr. Auf DRACO kostete das Team das 4,0-Fache des einzelnen Agenten und dauerte etwa gleich lang (95-%-Intervall 12 % weniger bis 13 % mehr). Mit der Anweisung und der Uhr bei jedem Agenten war das Team in 33 % weniger Zeit fertig, bei 54 % niedrigeren Kosten pro Aufgabe. Seine Punktzahl war 1,5 Punkte niedriger (95-%-Intervall 0,9 bis 2,1 niedriger), und das äußere Ende dieses Intervalls, 2,1 Punkte niedriger, liegt jenseits der Toleranz von 1,5 Punkten. Auf HLE war das Team in 51 % weniger Zeit fertig, bei 54 % niedrigeren Kosten pro Aufgabe. Seine Punktzahl war 1,7 Punkte niedriger (95-%-Intervall 0,3 bis 3,1 niedriger), und das äußere Ende dieses Intervalls, 3,1 Punkte niedriger, liegt jenseits der Toleranz von 2,5 Punkten. Auf dem Physik-Satz23 war das Team in 39 % weniger Zeit fertig. Seine Kosten pro Aufgabe waren 28 % niedriger, und diese Ersparnis hängt davon ab, wie oft der Prompt-Cache zwischen Anfragen abgelaufen ist. Ohne Ablauf läge sie bei 23 %. Seine Punktzahl war 0,2 Punkte höher (95-%-Intervall 1,5 niedriger bis 2,0 höher).
Auf DRACO startete der leitende Agent im Median 4 Helfer pro Versuch, daher zeigt das DRACO-Ergebnis ein parallel arbeitendes Team. Auf HLE und dem Physik-Satz startete der leitende Agent im Median 0 Helfer, sodass mindestens die Hälfte dieser Team-Durchläufe nur den leitenden Agenten hatte. Diese Team-Ergebnisse zeigen hauptsächlich das eigene Verhalten des leitenden Agenten, nicht die Wirkung paralleler Helfer.
Mit einem einzelnen Agenten. Auf dem Physik-Satz23 senkten dieselben Änderungen die Zeit eines einzelnen Agenten um 34 % und seine Kosten pro Aufgabe um 34 %. Seine Punktzahl war 0,2 Punkte niedriger (95-%-Intervall 2,5 niedriger bis 2,1 höher). Auf dem Physik-Satz sparte eine niedrigere Effort-Stufe Kosten, aber nicht eindeutig Zeit. Bei medium-Effort kostete der einzelne Agent pro Aufgabe 37 % weniger als bei high, und seine Zeit war 9 % kürzer (95-%-Intervall 30 % weniger bis 16 % mehr). Er erzielte 3,4 Punkte weniger (95-%-Intervall 0,4 bis 6,8 niedriger), und das Intervall reicht nahe an null heran. Mit beiden Änderungen bei high-Effort benötigte der einzelne Agent 27 % weniger Zeit als bei medium-Effort (95-%-Intervall 5 % weniger bis 44 % weniger). Seine Kosten pro Aufgabe waren 6 % höher (95-%-Intervall 12 % weniger bis 27 % mehr), und seine Punktzahl war 3,2 Punkte höher (95-%-Intervall 0,1 niedriger bis 6,5 höher).
Auf HLE senkten dieselben Änderungen die Zeit eines einzelnen Agenten um 54 % und seine Kosten pro Aufgabe um 48 %. Seine Punktzahl war 1,1 Punkte niedriger (95-%-Intervall 2,6 niedriger bis 0,3 höher), und das äußere Ende dieses Intervalls, 2,6 Punkte niedriger, liegt knapp jenseits der Toleranz von 2,5 Punkten. Bei medium-Effort kostete der einzelne Agent pro Aufgabe 43 % weniger als bei high, benötigte 39 % weniger Zeit und erzielte 1,3 Punkte weniger (95-%-Intervall 2,8 niedriger bis 0,1 höher). Mit beiden Änderungen bei high-Effort benötigte der einzelne Agent 25 % weniger Zeit als bei medium-Effort (95-%-Intervall 12 % weniger bis 35 % weniger). Seine Kosten pro Aufgabe waren 9 % niedriger (95-%-Intervall 21 % weniger bis 6 % mehr), und seine Punktzahl war 0,2 Punkte höher (95-%-Intervall 1,3 niedriger bis 1,7 höher).
Auf DRACO senkten dieselben Änderungen die Zeit eines einzelnen Agenten um 69 % und seine Kosten pro Aufgabe um 49 %. Seine Punktzahl war 1,9 Punkte niedriger (95-%-Intervall 1,1 bis 2,8 niedriger), und das äußere Ende dieses Intervalls, 2,8 Punkte niedriger, liegt jenseits der Toleranz von 1,5 Punkten. Bei medium-Effort kostete der einzelne Agent pro Aufgabe 25 % weniger als bei high, benötigte 30 % weniger Zeit und erzielte 0,7 Punkte weniger (95-%-Intervall 0,1 bis 1,3 niedriger). Mit beiden Änderungen bei high-Effort benötigte der einzelne Agent 53 % weniger Zeit als bei medium-Effort (95-%-Intervall 42 % weniger bis 63 % weniger), und seine Kosten pro Aufgabe waren 31 % niedriger (95-%-Intervall 28 % weniger bis 35 % weniger). Seine Punktzahl war 1,2 Punkte niedriger (95-%-Intervall 0,5 bis 1,9 niedriger), und das äußere Ende dieses Intervalls, 1,9 Punkte niedriger, liegt jenseits der Toleranz von 1,5 Punkten.
Auf allen drei Sätzen sparten beide Änderungen bei high-Effort mehr Zeit als medium-Effort. Auf HLE und dem Physik-Satz gab es keinen eindeutigen Unterschied bei den Kosten, und auf DRACO waren die Kosten niedriger. Die Punktzahl war auf HLE etwa gleich. Auf dem Physik-Satz war sie 3,2 Punkte höher, aber dieses Intervall schließt null ein, daher ist der Unterschied nicht eindeutig. Für einen einzelnen Agenten spart die Uhr also mehr Zeit als eine niedrigere Effort-Stufe. Auf DRACO erzielte der einzelne Agent mit beiden Änderungen jedoch 1,2 Punkte weniger als bei medium-Effort (95-%-Intervall 0,5 bis 1,9 niedriger).
Wann du es verwenden solltest.
- Verwende beide Änderungen, wenn die Zeit eines Agenten wichtig ist und eine kleine Änderung der Punktzahl akzeptabel ist. In jeder gemessenen Konfiguration senkten sie die Zeit und die Kosten pro Aufgabe, für Teams und für einzelne Agenten.
- Prüfe die Punktzahl an deinen eigenen Aufgaben, bevor du sie übernimmst. Auf DRACO war die Punktzahl für ein Team 1,5 Punkte und für einen einzelnen Agenten 1,9 Punkte niedriger. Auf HLE war sie für ein Team 1,7 Punkte und für einen einzelnen Agenten 1,1 Punkte niedriger. Auf dem Physik-Satz war keine der beiden Änderungen der Punktzahl eindeutig von null verschieden.
- Wenn du bereits über eine niedrigere Effort-Stufe nachdenkst, um Zeit zu sparen, vergleiche sie mit der Uhr. Ein einzelner Agent mit beiden Änderungen bei
high-Effort benötigte weniger Zeit als beimedium-Effort: 53 % weniger auf DRACO, 25 % weniger auf HLE und 27 % weniger auf dem Physik-Satz. Seine Kosten pro Aufgabe waren auf DRACO 31 % niedriger, ohne eindeutigen Unterschied auf HLE und dem Physik-Satz.
Wie du es hinzufügst. Setze diese Anweisung an den Anfang des System-Prompts jedes Agenten:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.Der zweite Satz teilt dem Modell mit, dass es die Uhr-Nachrichten gibt. Die erste Anfrage enthält keine Uhr, und die gemessenen Durchläufe verwendeten genau diesen Wortlaut.
Hänge dann vor jeder Anfrage nach der ersten eines Agenten eine System-Nachricht mitten im Gespräch an, die die verstrichene Zeit in ganzen Sekunden angibt, etwa Elapsed time: 412 seconds. Zähle ab dem Start der Aufgabe, nicht ab dem Start des Agenten. In einem Team liest jeder Agent dieselbe Uhr, sodass die erste Uhr, die ein Helfer sieht, bereits die Zeit mitzählt, die das Team vor dem Start des Helfers verbracht hat. Setze die Nachricht in einer Tool-Schleife direkt hinter die user-Nachricht, die die Tool-Ergebnisse enthält, wie Platzierung nach Tool-Ergebnissen zeigt. Wenn du dem Agenten stattdessen eine neue user-Nachricht sendest, setze die Uhr hinter diese Nachricht.
Lass frühere Uhr-Nachrichten, wo sie sind. Jede wird Teil des Gesprächsverlaufs, sodass das gecachte Präfix bei der nächsten Anfrage weiterhin übereinstimmt (siehe Kombination mit Prompt-Caching). Anthropic hat diese einfachen System-Nachrichten gemessen, die für das Modell sichtbar bleiben. Eine Turn-bezogene System-Nachricht würde dem Modell nur die neueste Uhr zeigen, und diese Form hat Anthropic nicht gemessen.
Das folgende Beispiel führt die Tool-Schleife eines Agenten mit beiden Änderungen aus. Es fügt die Uhr nach Tool-Ergebnissen hinzu und verarbeitet nur Client-Tools:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Wall-Clock-Sekunden, damit Helfer in anderen Prozessen die Startzeit des Leads teilen können.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Streaming, weil ein Limit von 128.000 Token für eine Anfrage ohne Streaming zu groß ist.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Eine System-Nachricht muss auf einen User-Turn folgen, daher kommt die Uhr nach den Tool-Ergebnissen.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 unterstützt System-Nachrichten mitten im Gespräch. Die Liste der unterstützten Modelle deckt die anderen ab. Bei einem Modell ohne diese Unterstützung, etwa Claude Sonnet 5, kannst du dieselbe Zeile in einen Textblock nach dem letzten tool_result-Block im user-Turn setzen. Anthropic hat nur die Form als System-Nachricht gemessen.
Bei Claude Managed Agents kannst du ein system.message-Event mit einem Tool-Ergebnis oder einer Benutzernachricht senden. Die Nachricht gilt für diesen Turn und jeden späteren Turn. Turns, die auf die integrierten Tools der Plattform folgen, etwa die Websuche, sehen daher die letzte Uhr, die du gesendet hast, nicht die aktuelle Zeit. Eine system.message erreicht außerdem nur den primären Thread der Sitzung. In einer Multi-Agenten-Sitzung ist das der Thread des Koordinators, sodass die Worker-Agenten eine auf diese Weise gesendete Uhr nie sehen. Um die aktuelle Zeit vor jedem Turn und jedem Agenten in einem Team anzuzeigen, führe die Agentenschleife selbst über die Messages API aus.
Modelle kombinieren
Multi-Modell-Architekturen passen zu Workloads, deren Aufgabenkomplexität stark genug variiert, dass verschiedene Schritte am besten von verschiedenen Modellen bedient werden. Wenn dein Traffic Routinearbeit, die ein kleineres Modell zuverlässig erledigt, mit schwierigeren Schritten mischt, die Frontier-Fähigkeiten brauchen, hält das Aufteilen der Arbeit Frontier-Intelligenz dort, wo sie zählt, während die meisten Token zu den Preisen des kleineren Modells abgerechnet werden. Wenn einem Workload diese Mischung fehlt, weil seine Schwierigkeit gleichförmig ist oder er eine einzige abhängige Kette ist, ist ein einzelnes gut abgestimmtes Modell meist die bessere Wahl. Jeder Strategieabschnitt gibt die Regel an, mit der sich die beiden Fälle unterscheiden lassen.
Zwei Strategien decken die meisten Workloads ab, und sie unterscheiden sich darin, welches Modell die Hauptschleife hält:
| Strategie | Kontrollfluss | Rolle des Frontier-Modells | Passt zu | Frontier-Kosten skalieren mit |
|---|---|---|---|---|
| Advisor | Kleineres Modell führt die Schleife aus, eskaliert bei Bedarf | Wird für Pläne und Korrekturen konsultiert | Serielle Arbeit, die stellenweise schwer ist, etwa die vielen Turns eines Coding-Agenten zwischen wenigen echten Entscheidungen | Wie oft der Executor stecken bleibt |
| Orchestrator | Frontier-Modell führt die Schleife aus, delegiert die Massenarbeit | Plant, verteilt und synthetisiert | Arbeit, die sich über wirklich unabhängige Dateien, Dokumente oder Fälle auffächert, besonders mehr als ein Kontextfenster davon | Wie schwer die Teile zu koordinieren sind |
Advisor-Strategie: schwierige Entscheidungen eskalieren
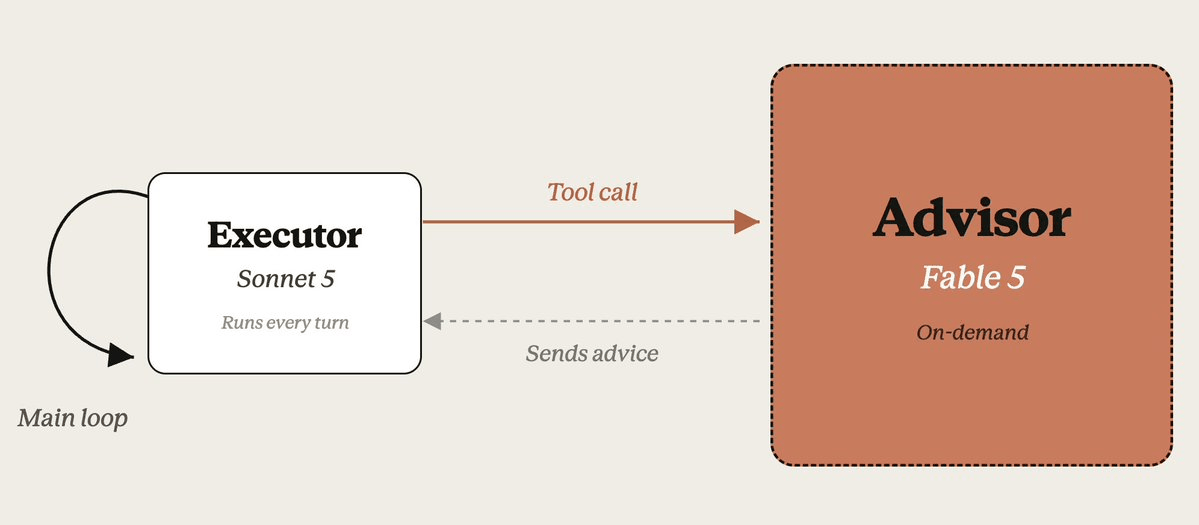
Bei der Advisor-Strategie führt ein kostengünstigeres „executor model" (ausführendes Modell) die Agentenschleife aus und übernimmt die meisten Turns. Wenn es auf eine Entscheidung stößt, die tieferes Urteilsvermögen erfordert, etwa die Wahl eines Ansatzes oder die Erholung von einem Fehlschlag, ruft es ein intelligenteres „advisor model" (beratendes Modell) für strategische Anleitung auf und fährt dann fort. Die meisten Token werden zu Executor-Preisen abgerechnet und nur die gelegentlichen Konsultationen zu Advisor-Preisen.
Um sie zu nutzen, füge deiner Anfrage das Advisor-Tool hinzu. Diese Beta-Funktion führt die gesamte Strategie serverseitig in einer einzigen /v1/messages-Anfrage aus: Der Executor gibt einen Tool-Aufruf aus, Anthropic führt die Advisor-Inferenz aus, und der Executor fährt mit dem Rat fort; du schreibst keinen Orchestrierungscode. Bei Claude Managed Agents gibst du der Sitzung einen Advisor, indem du dem multiagent-Roster des Agenten einen advisor-Eintrag hinzufügst; der primäre Thread der Sitzung konsultiert ihn auf dieselbe Weise. Claude Code unterstützt es ebenfalls; siehe schwierige Entscheidungen mit dem Advisor-Tool eskalieren.
Was den Nutzen bestimmt. Der Advisor sieht die Aufgabe nur über die Aufrufe des Executors, daher entscheiden zwei Dinge darüber, wie sehr er hilft.
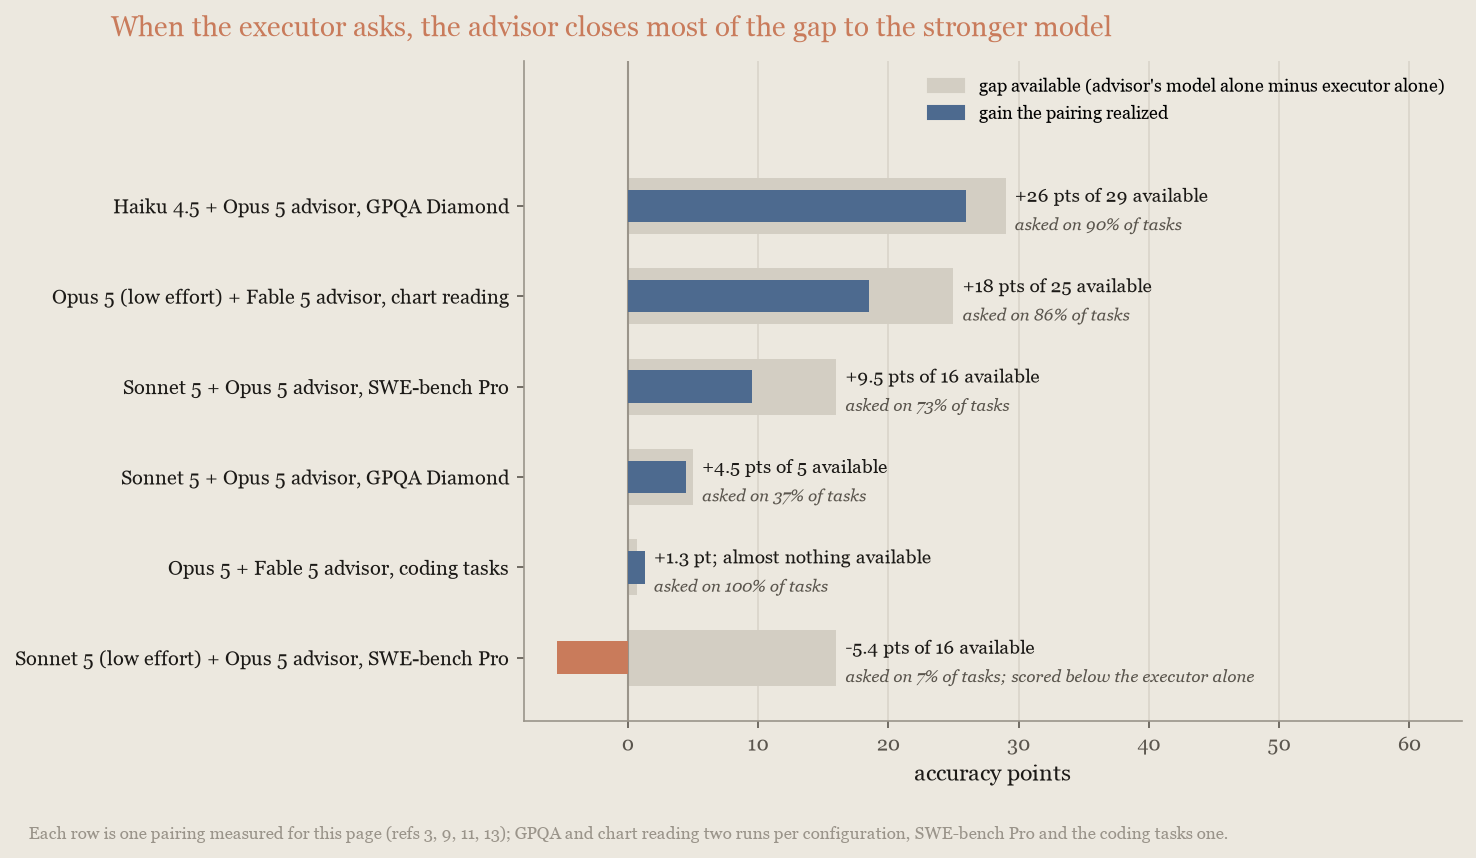
Das erste ist der Abstand zwischen den Modellen. Der Advisor kann nur Fähigkeiten weitergeben, die dem Executor fehlen: Auf GPQA Diamond9 profitierte ein Claude Haiku 4.5-Executor stark von einem Claude Opus 5-Advisor, ein Claude Sonnet 5-Executor gewann einige Punkte und ein Frontier-Executor fast nichts.
Das zweite, und das fragile, ist, ob der Executor tatsächlich fragt (die „consult rate" (Konsultationsrate)). Ein Executor mit niedrigem Effort kann aufhören zu erkennen, dass er feststeckt: Eine Paarung, die beim Standard-Effort bei den meisten Aufgaben konsultiert, kann bei gesenktem Effort auf fast keine Konsultationen zurückfallen und erzielt dann weniger als der Executor allein. Die Rate variiert auch je nach Aufgabe: Auf DeepSWE10 fragte ein Sonnet 5-Executor mit niedrigem Effort weiterhin und gewann 23 Punkte; auf SWE-bench Pro3 hörte derselbe Executor auf. Wenn der Executor fragt, holt er einen Großteil des Abstands auf. Bei den Paarungen im folgenden Diagramm, deren Executor weiterhin fragte, schloss der Advisor mindestens die Hälfte des Abstands zum stärkeren Modell (die Coding-Paarung übertraf das stärkere Modell sogar), und du bezahlst für das stärkere Modell nur bei den Konsultationen, was die Kostenvorteile erst möglich macht:
Die Konsultationsrate reagiert auf Prompting. Nur mit der integrierten Beschreibung des Tools rufen Executors den Advisor zu selten auf, besonders bei Coding-Arbeit, daher enthält die Dokumentation zum Advisor-Tool einen System-Prompt, der einen Aufruf vor substanzieller Arbeit und einen vor dem Abschluss anfordert, etwa zwei bis drei Aufrufe pro Aufgabe. Die als Nächstes gemessene Coding-Paarung lief mit Claude Opus 5 als Executor in diesem Rhythmus, etwa zwei Konsultationen bei jeder Aufgabe; mit Claude Opus 5.5 als Executor bat sie etwa 1,4-mal pro Versuch um Rat, und 4 % ihrer Versuche erhielten keinen Rat. Diese Seite behandelt auch, wie du einen Executor, der zu selten aufruft, anstößt und Aufrufe clientseitig begrenzt, um die Kosten zu deckeln. Behalte also die Konsultationsrate im Blick: Fordere sie per Prompt an, miss sie und stelle den Effort des Executors wieder her, wenn sie einbricht.
Wann es sich bei den Kosten lohnt. Ein Advisor spart Geld, wenn einige kurze Konsultationen, abgerechnet zum Preis des Advisors, das Ausführen des Advisor-Modells für die gesamte Aufgabe ersetzen. Das funktioniert am besten, wenn das Advisor-Modell deutlich teurer ist als das des Executors, daher ist die kosteneffizienteste Konfiguration ein Frontier-Advisor über einem Executor der mittleren Stufe. Eine Paarung am oberen Ende der Spanne kann einen Teil der Kosten für den Rat wieder hereinholen, weil Rat auch Executor-Token spart: Ein Executor, dem der richtige Ansatz genannt wurde, erkundet weniger Sackgassen. In der unten beschriebenen Coding-Paarung mit einem Claude Opus 5-Executor bezahlte diese Ersparnis etwa die Hälfte des Rats: Der Executor gab pro Versuch 1,26 $ weniger aus als Opus 5 allein mit Standardeinstellung, und die Konsultationen kosteten 2,47 $. Mit einem Claude Opus 5.5-Executor sparte der Rat fast keine Executor-Kosten: 1,36 $ pro Versuch gegenüber 1,38 $ für Opus 5.5 allein bei high, während die Konsultationen 1,55 $ kosteten.
Auf einem internen Benchmark für agentisches Coding11, ausgeführt mit einem einfachen API-Agenten, erzielte ein Claude Opus 5.5-Executor bei high mit einem Claude Fable 5.1-Advisor 90,1 % bei 2,92 $ pro Versuch. Das sind 1,7 Punkte mehr als Opus 5.5 allein bei high, der eigenen Einstellung des Executors, ein Abstand am Rand der Schwankungen zwischen Durchläufen bei fünf Versuchen pro Aufgabe, für etwa das 2,1-Fache des Geldes; gegenüber Opus 5.5 mit seinem Standard medium sind es 3,5 Punkte für etwa das 3,5-Fache des Geldes. Das Ergebnis liegt etwa auf der eigenen Effort-Kurve von Opus 5.5, der Advisor erkauft also etwa das, was mehr Effort bewirkt: Opus 5.5 allein bei xhigh erzielte 91,1 % für 4,11 $ pro Versuch (ein Versuch pro Aufgabe). Im August war ein Claude Fable 5.1-Advisor über einem Claude Opus 5-Executor die genaueste gemessene Konfiguration, bei 6,21 $ pro Versuch, etwas mehr als das Doppelte dessen, was die Opus 5.5-Paarung kostet. Das Diagramm stellt die Opus 5.5-Paarung der eigenen Effort-Kurve von Opus 5.5 und der von Claude Fable 5.1 aus dem August gegenüber:
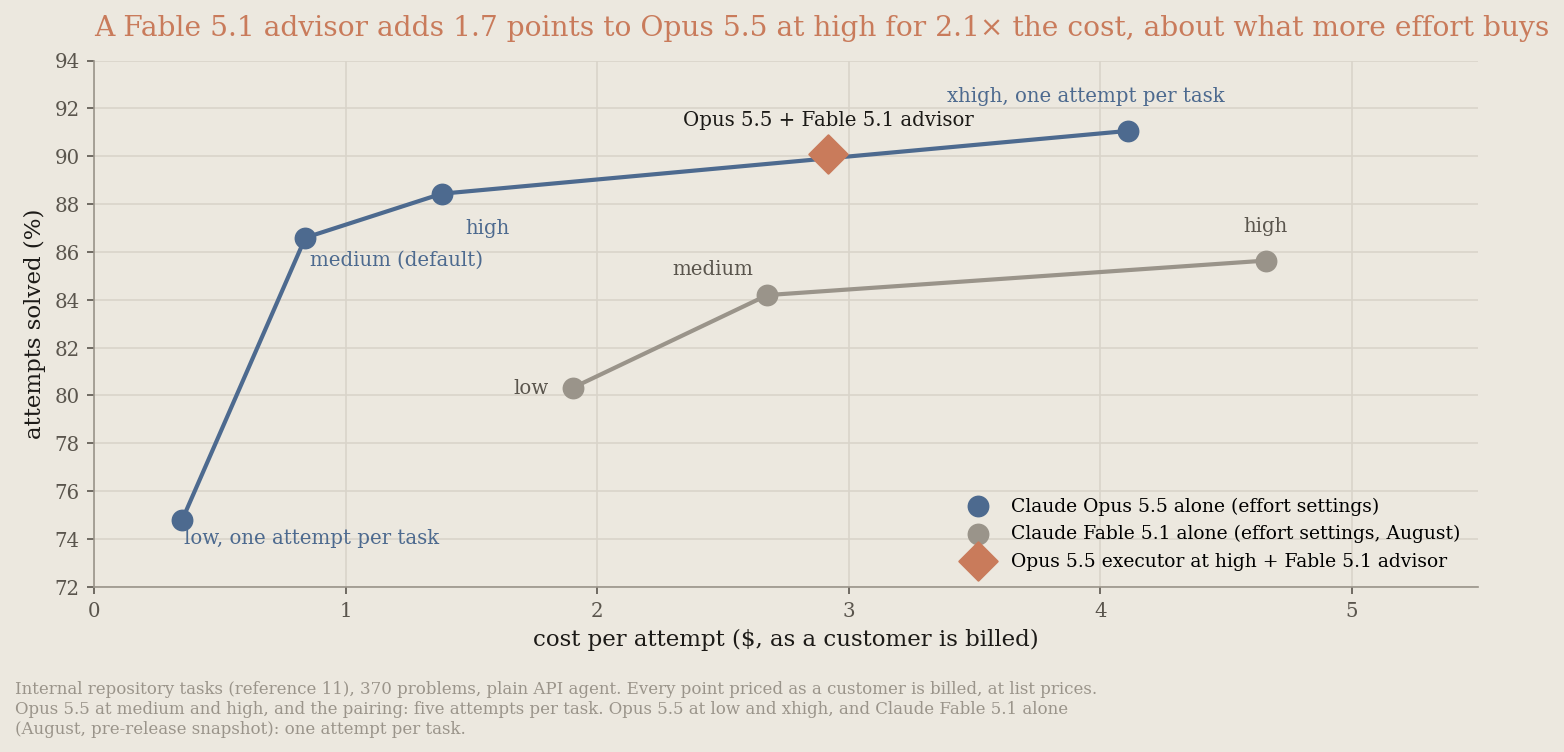
Eine frühere Messung über den Advisor-Modus von Claude Code stufte die dortige Advisor-Paarung ebenfalls über beiden ihrer Modelle allein ein. Betrachte das Ergebnis von Claude Opus 5.5 als Muster, das du an deinem Workload testen solltest: Der Advisor erkauft einige Punkte für etwa das Doppelte dessen, was der Executor allein kostet. Ein größerer Fähigkeitsabstand garantiert kein besseres Geschäft. Die Latenzkosten sind die Konsultationen selbst: etwa ein oder zwei zusätzliche Aufrufe des Frontier-Modells pro Aufgabe auf diesem Benchmark, jeder davon auf dem kritischen Pfad der Aufgabe.
Wann das stärkere Modell allein der bessere Schritt ist. Wenn die Genauigkeit eines Workloads auf Effort reagiert, vergleiche die Paarung vor dem Aufbau mit dem Advisor-Modell allein bei reduzierter Einstellung: Der Advisor wird nur bei Aufgaben bezahlt, die ihn brauchen, aber eine Konsultation, die bei den meisten Aufgaben ausgelöst wird, kostet mehr, als das stärkere Modell selbst auszuführen. Auf Chartography13 konsultierte ein Claude Opus 5.5-Executor bei low mit einem Claude Fable 5.1-Advisor diesen bei 1 von 300 Aufgaben und erzielte 61,7, 7 Punkte weniger als Opus 5.5 allein und jenseits der Schwankungen zwischen Durchläufen, bei etwa gleichen Kosten; im August konsultierte ein Claude Opus 5-Executor bei fast jeder Aufgabe, und diese Paarung erreichte Fable 5.1 allein bei medium innerhalb der Schwankungen zwischen Durchläufen (65,0 gegenüber 67,5) bei etwa dem 1,8-Fachen der Kosten pro Aufgabe. Miss zuerst deine eigene Konsultationsrate: Wenn der Executor bei den meisten seiner Aufgaben fragt, zahlst du Advisor-Preise für den gesamten Workload, und das Advisor-Modell selbst auszuführen ist der günstigere Weg zur selben Punktzahl.
Unabhängig von der Paarung: Ermittle zuerst die Kosten des Advisor-Modells allein bei niedrigem Effort; das ist die Baseline, die es zu schlagen gilt. Prüfe dies bei jedem Modell-Release erneut, denn Releases verschieben sowohl den Fähigkeitsabstand als auch das Preisverhältnis.
Wann sie passt. Die Advisor-Strategie eignet sich für Workloads, bei denen die Turns größtenteils mechanisch sind, ein exzellenter Plan aber wichtig ist: Coding-Agenten, Computer Use und mehrstufige Recherche-Pipelines. Sie passt schlecht, wenn jeder Turn wirklich Frontier-Fähigkeiten benötigt, wenn es nichts zu planen gibt (Q&A mit einem einzigen Turn) oder wenn dein Executor bereits nahe an den Fähigkeiten des Advisors liegt.
Orchestrator-Strategie: Massenarbeit delegieren
Bei der „orchestrator strategy" (Orchestrator-Strategie) steuert das Frontier-Modell die Schleife. Es zerlegt die Aufgabe, verteilt Teilaufgaben an kostengünstigere Worker-Modelle und führt deren Ergebnisse zusammen. Das eigene Transkript des Orchestrators bleibt kurz, weil die Worker die tokenintensive Erkundung übernehmen. Dadurch werden die meisten Token zu Worker-Tarifen abgerechnet, während Plan und Synthese weiterhin vom Frontier-Modell stammen.
Um einen solchen Aufbau zu erstellen, verwende Multiagenten-Orchestrierung in Claude Managed Agents: Konfiguriere einen Koordinator-Agenten (den Orchestrator) und eine Reihe von Worker-Agenten, jeweils mit eigenem Modell. Ein vollständiges, lauffähiges Beispiel mit einem Frontier-Koordinator und Claude Sonnet 5-Workern findest du im Claude Cookbook-Rezept Coordinator pattern: big models for planning, small models for execution.
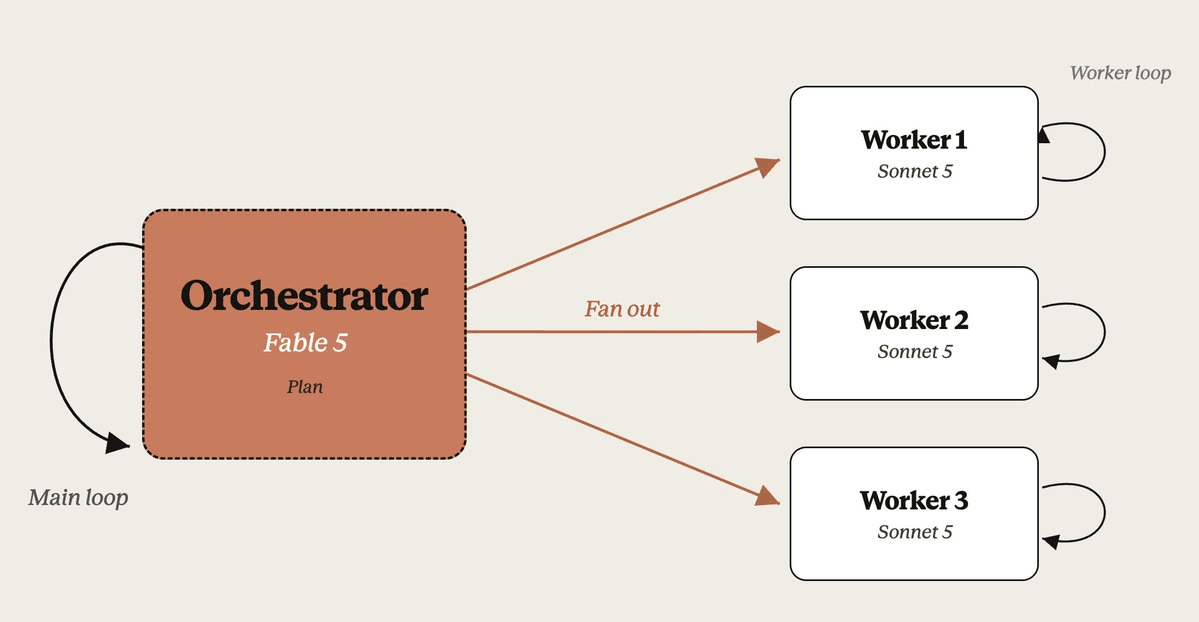
Dieses Muster spart „wall-clock time" (tatsächlich verstrichene Zeit), wenn Worker parallel laufen können. Beim Korpus-Benchmark8 dauerte eine Episode etwa 2,3 Stunden, wobei der Koordinator das dokumentierte Plattformlimit von 25 gleichzeitigen Workern ausschöpfte. Im Alleinbetrieb waren es 15 bis 20 Stunden. Geld sparte das Muster nur in zwei gemessenen Situationen. Bei Arbeit, die ein einzelnes Modell allein bewältigen konnte, war dasselbe Modell mit geringerem Effort jedes Mal günstiger.
Wenn Worker parallel laufen, können eine Zeitanweisung und eine Uhr für die verstrichene Zeit den Lauf verkürzen. Bei DRACO21 wurde ein Team von Agenten mit demselben Modell, das die Anweisung und die Uhr hatte, in 33 % weniger Zeit bei 54 % geringeren Kosten pro Aufgabe fertig und erzielte 1,5 Punkte weniger. Jeder Agent in diesem Team hatte die Anweisung und die Uhr. Anthropic hat die Uhr nicht mit kostengünstigeren Workern gemessen. In Claude Managed Agents erreicht die Uhr nur den Koordinator, sodass die Worker sie nie sehen. Ein Team, in dem nur der Koordinator die Uhr hat, hat Anthropic nicht gemessen. Die Uhr des Koordinators ist außerdem nur in Turns aktuell, die auf deine eigenen Tool-Ergebnisse oder Nachrichten folgen. Unter Dem Modell die verstrichene Zeit zeigen findest du das Rezept für eine Agent-Schleife, die du über die Messages API ausführst.
Fall 1: Absicherung gegen Kostenausreißer bei Routinearbeit. Ein Frontier-Modell, das allein läuft, gerät gelegentlich bei einem Routineproblem in eine Spirale, das es normalerweise lösen würde. Da du nicht im Voraus erkennen kannst, welche Läufe das betrifft, machen einige wenige solcher Läufe den Großteil der Rechnung aus. Ein Koordinator, der Routinearbeit an einen kostengünstigeren Worker übergibt, begrenzt diese Ausreißer, weil jede Spirale nun zu Worker-Tarifen stattfindet.
Anthropic hat dies an einem bewusst einfachen Ausschnitt von BrowseComp4 gemessen (10 Probleme, die das Solo-Modell zuverlässig löst; 50 delegierte und 70 Solo-Läufe). Ein Claude Fable 5-Koordinator mit einem Claude Sonnet 5-Worker kostete im Durchschnitt etwa halb so viel wie Claude Fable 5 allein. Beim 90. Perzentil waren es etwa ein Drittel (12 $ gegenüber 33 $). Der teuerste Einzellauf des Solo-Modells kostete 84 $ und lieferte zudem ein falsches Ergebnis:
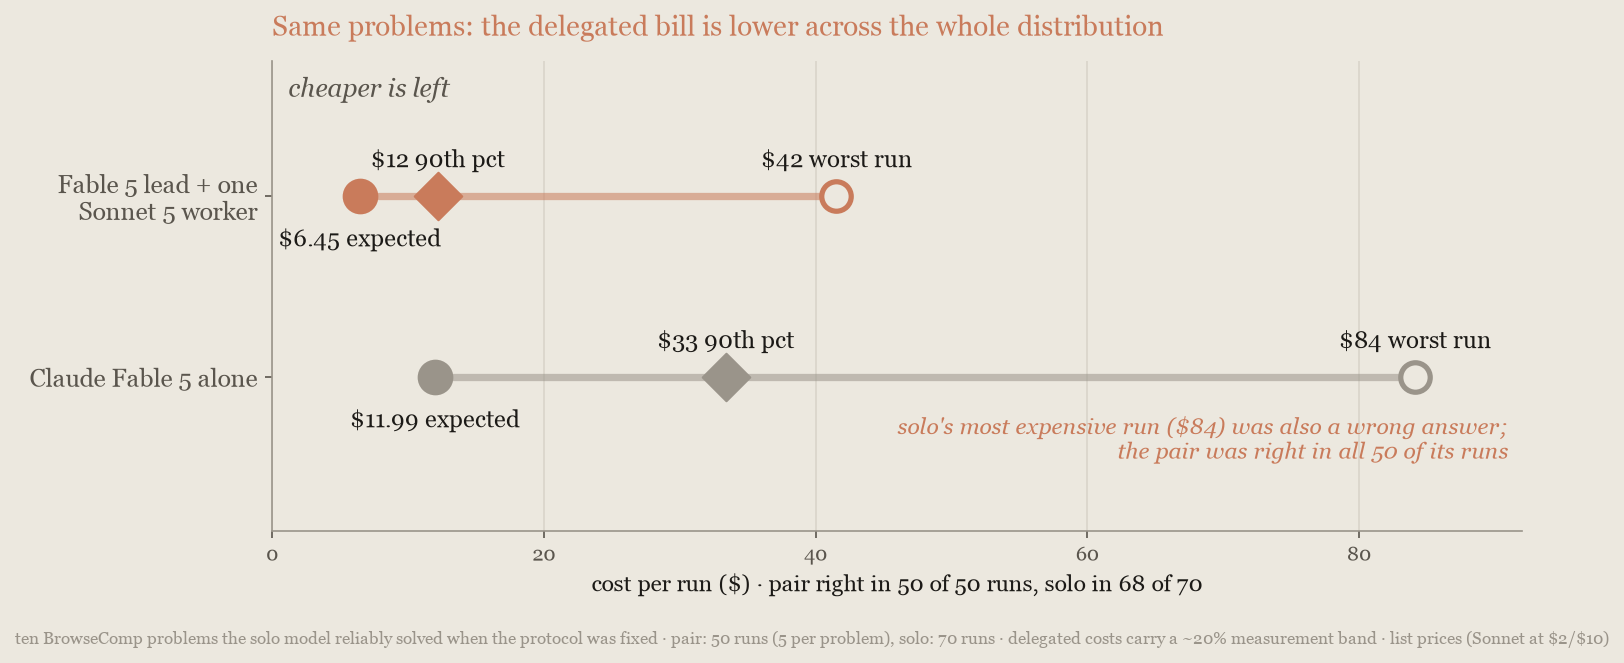
Delegation zahlte sich beim routinemäßigen, normalerweise lösbaren Anteil der Arbeit aus. Das widerspricht der Intuition, dass Worker für schwierige Probleme gedacht sind. Beim vollständigen, schwierigeren BrowseComp-Set kehrte sich die Wirtschaftlichkeit um. Wenn dein Traffic bei Routineaufgaben lange Kostenausreißer aufweist, solltest du diesen Orchestrator-Fall zuerst messen.
Fall 2: Arbeit, die größer ist als ein „context window" (Kontextfenster). Ein Solo-Modell muss eine so große Eingabe seriell durcharbeiten, ein Kontextfenster nach dem anderen. Bei jedem Durchgang bezahlt es dafür, seinen eigenen Zustand erneut zu lesen. Worker lesen dagegen jeweils ihre eigene Partition, parallel und zu Worker-Tarifen. Leseintensive Arbeit, die noch in ein Kontextfenster passt, ist eine Frage der Modellwahl, nicht der Delegation: Allein bei den Lesekosten liegt der Orchestrator nur dann vorn, wenn kein einzelner Kontext die Arbeit fassen kann.
Anthropic hat für diesen Fall einen Benchmark erstellt8: einen Korpus mit 21,6 Millionen Token aus 14 öffentlichen Python-Paketen mit 130 absichtlich eingebauten Defekten, zu groß für jedes Kontextfenster. Ein geringerer Effort hilft hier nicht, weil das Lesen des Korpus selbst die Kosten verursacht. Claude Fable 5.1 solo kostete über die drei Effort-Einstellungen hinweg 468 $ bis 552 $ pro Episode, und nur die Genauigkeit veränderte sich. Die Koordinator-Konfiguration bestand aus einem Claude Fable 5.1-Lead mit 25 Claude Sonnet 5-Workern. Sie kostete etwa halb so viel wie diese Einstellungen (47 % bis 55 % weniger) und erzielte 10 bis 12 Punkte weniger. Dafür brauchte sie etwa 2,3 Stunden pro Episode statt 15 bis 20 und übertraf eine Claude Sonnet 5-Solo-Baseline deutlich:
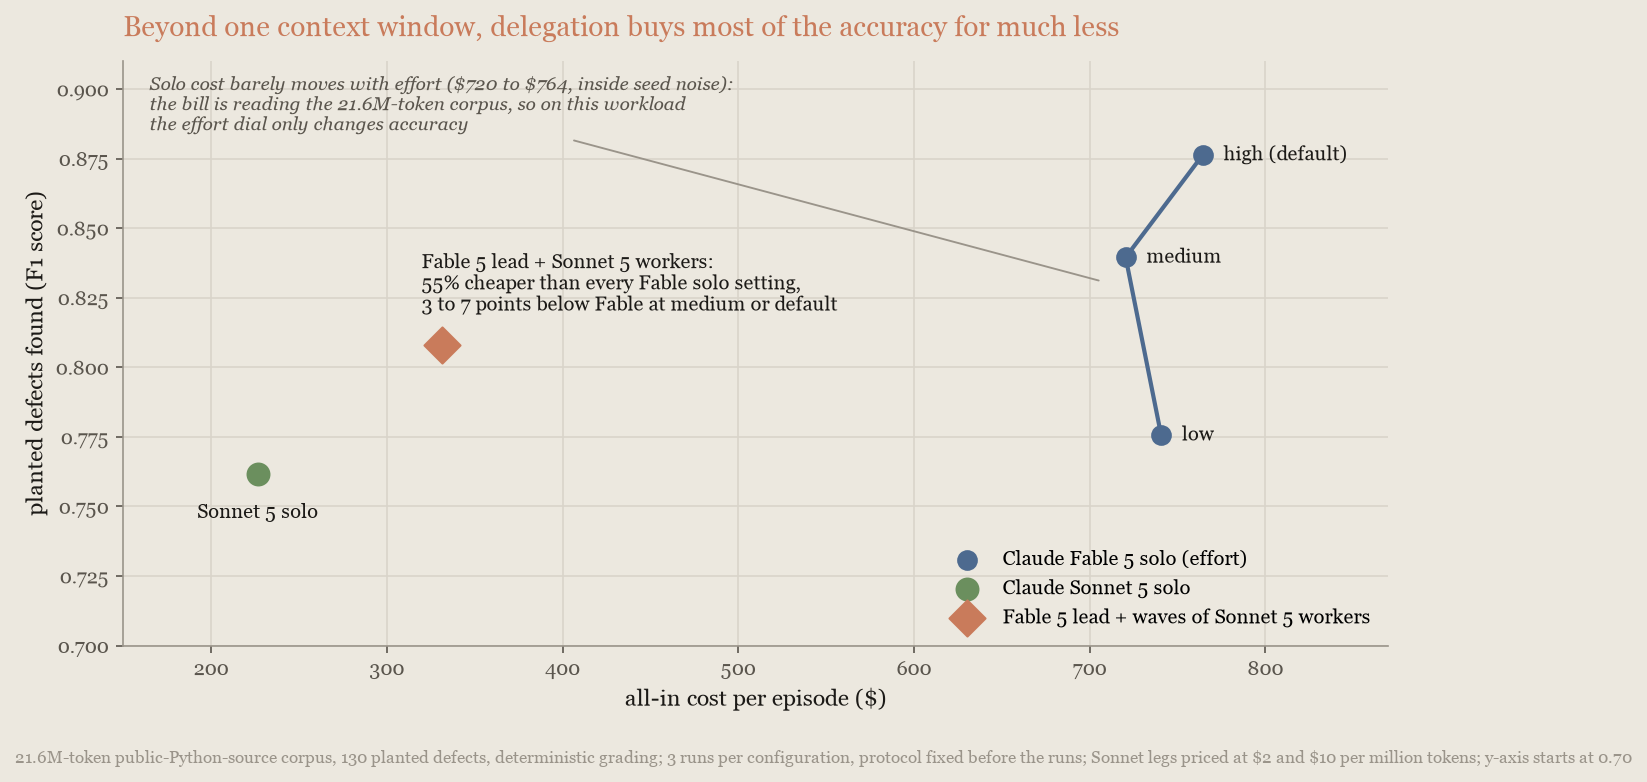
Die Token-Abrechnung zeigt, wie viel gelesen wurde: Die Koordinator-Konfiguration las etwa 560 Millionen gecachte Token pro Episode, etwa das Eineinhalbfache der rund 365 Millionen des Solo-Modells. Fast alle davon wurden zum Cache-Read-Tarif von Claude Sonnet 5 abgerechnet, und insgesamt kostete die Konfiguration dennoch etwa halb so viel. Fable 5.1 mit high-Effort erreicht weiterhin die höchste Genauigkeit, kostet aber etwa das 2,2-Fache der Koordinator-Konfiguration. Delegation bringt hier also den Großteil der Genauigkeit, aber nicht die volle.
Wann sich Delegation nicht lohnt. Ein Orchestrator bringt nur dann etwas, wenn es viel Arbeit zum Übergeben gibt: viele unabhängige Teile, idealerweise zu viele für ein Kontextfenster. Wenn die Arbeit eine einzige Kette abhängiger Schritte ist oder in einen einzelnen Kontext passt, bezahlt der Orchestrator für Plan, Übergabe und Zusammenführung, die ein einzelnes Modell nicht braucht. In jedem gemessenen Fall dieser Art lag das Modell des Koordinators allein mit geringerem Effort vorn.
Entscheidend ist die Schwierigkeit der Aufgabe, nicht der Benchmark: Beim vollständigen, schwierigeren BrowseComp4-Set erreichte Claude Fable 5 allein die Genauigkeit der Koordinator-Konfiguration bei 22 % bis 30 % geringeren Kosten. Unabhängige externe Arbeiten berichten dasselbe Muster5. Baue keinen Orchestrator, wenn einer dieser Fälle zutrifft:
- Die Arbeit ist eine einzige Kette.
- Die Arbeit passt ohne lange Kostenausreißer in einen Kontext.
- Ein einzelnes Modell mit geringerem Effort erfüllt deine Anforderungen bereits.
Zwischen den Strategien wählen
Die meisten Fälle laufen auf eine Frage hinaus: Teilt sich die Arbeit in unabhängige Teile, oder ist sie eine einzige Antwort, die über eine Kette abhängiger Schritte erreicht wird? Die Strategietabelle ordnet die beiden Antworten den beiden Strategien zu.
Wenn du unsicher bist, baue noch nichts:
- Durchlaufe zuerst den Effort auf deinem aktuellen Modell. Es ist das günstigste Experiment auf dieser Seite, und die meisten Workloads enden dort.
- Wenn der Durchlauf eine Lücke zeigt, bepreise das stärkere Modell allein bei niedrigem Effort. Das ist die Zahl, die eine Advisor-Paarung schlagen muss, und die Paarungen auf dieser Seite, die sie schlugen, waren diejenigen, deren Executor tatsächlich konsultierte.
Die Multi-Modell-Ergebnisse auf dieser Seite wurden gegen dasselbe Modell bei niedrigerem Effort und gegen das nächstkleinere Modell allein laufend beurteilt. Das ist der Vergleich, den du auf deinem eigenen Workload durchführen solltest, und der Grund, warum der erste Schritt ein Effort-Durchlauf ist.
Wenn du dann einen Advisor hinzufügst, ist es eine Tool-Definition und keine Neuarchitektur.
Auf deinem eigenen Workload messen
Die Zahlen auf dieser Seite spiegeln die Listenpreise zum Zeitpunkt der Messung wider und werden sich verschieben, wenn sich Modelle und Preise ändern. Auch deine Eskalationsrate, wie sauber sich Aufgaben aufteilen lassen, und die Transkriptlänge beeinflussen sie. Die Methode bleibt dieselbe:
-
Wähle einige Aufgaben aus Produktionslogs aus, gewichtet wie echter Traffic, und schreibe Ergebnisprüfungen für jede davon, zum Beispiel: Tests bestehen, Ticket geschlossen, Zeilenanzahl korrekt. Erfasse neben der Punktzahl die Kosten pro Aufgabe. Die
usagejeder Antwort enthält fünf Token-Zählungen mit eigenen Tarifen:- ungecachter Input
- 5-Minuten-Cache-Writes zum 1,25-Fachen des Input-Preises
- 1-Stunden-Cache-Writes zum 2-Fachen des Input-Preises
- Cache-Reads
- Output
Berechne jede Zählung zu ihrem Tarif und summiere über alle Anfragen der Aufgabe. Die Usage and Cost API meldet den Gesamtwert.
-
Erstelle eine Baseline für jede Modellstufe über alle Effort-Stufen hinweg, nicht nur für den Standardwert, und trage die Punktzahl gegen die Kosten auf. Eine Multi-Modell-Konfiguration muss die gesamte Kurve des Einzelmodells schlagen.
-
Wenn die Kurve eine Lücke zeigt, die sich mit Effort nicht schließen lässt, füge die passende Multi-Modell-Strategie hinzu und führe die Suite erneut aus.
-
Betreibe den Gewinner vor der Umstellung im Shadow-Modus auf einem Teil des Traffics und lass die Suite danach weiterlaufen.
Das folgende Beispiel berechnet die Kosten aus Schritt 1 für eine Anfrage zu den Listenpreisen von Claude Opus 5.5:
# Preise pro Million Token laut Preisseite; ändere diese drei für ein anderes Modell.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0,05x des Eingabepreises bei Claude Opus 5.5; der Multiplikator variiert je nach Modell
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1-Stunden-Cache-Schreibvorgänge kosten 2x den Eingabepreis, 5-Minuten-Schreibvorgänge 1,25x; Lesevorgänge zum Cache-Lesepreis.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
In Agent-Schleifen sollten die meisten Input-Token Cache-Reads sein. Wenn cache_read_input_tokens im Vergleich zu input_tokens plus cache_creation_input_tokens klein ist, prüfe, ob das Caching aktiv ist und ob das Präfix zwischen den Anfragen gleich bleibt. Wenn das Advisor-Tool oder Compaction aktiviert ist, erscheinen einige Token nur in usage.iterations und nicht in den Gesamtwerten auf oberster Ebene. Summiere in diesem Fall über usage.iterations und berechne advisor_message-Einträge zu den Tarifen des Advisor-Modells.
Die folgende Tabelle listet die Hebel in der Reihenfolge auf, in der du sie ausprobieren solltest:
| Hebel | Einsparung in diesen Läufen | Qualitätskosten | Latenz | Wo |
|---|---|---|---|---|
| Prompt-Caching | Kosten bei Agent-Schleifen um den Faktor 2,7 bis 5,3 gesenkt; 83 % beim Triage-Lauf | Keine | Schneller | Wiederholten Kontext cachen |
| 1-Stunden-Cache-Dauer | Günstiger als der 5-Minuten-Standard, sobald etwa 1 von 20 Turns auf eine Pause zwischen 5 Minuten und einer Stunde folgt und nur wenige Lücken länger als eine Stunde dauern. Ausnahmen: Bei Claude Fable 5.1 ist es günstiger, den 5-Minuten-Cache warm zu halten, solange Pausen nur Minuten dauern; die 1-Stunden-Dauer lohnt sich, wenn Pausen an eine Stunde heranreichen. Bei Claude Opus 5.5 ist es günstiger, den 5-Minuten-Cache warm zu halten, wenn nur ein oder zwei von 20 Turns auf eine Pause von bis zu etwa einer halben Stunde folgen. Ohne Pausen kostete der Standard bei Claude Sonnet 5 15 % weniger und bei Claude Opus 5.5 etwa 15 % bis 18 % weniger | Keine | Bleibt nach einer Pause warm | Cache-Dauer wählen |
| Input kürzen | Weitere 5 Prozentpunkte beim Triage-Lauf | Keine | Neutral | Input- und Kontext-Token kürzen |
| Veraltete Tool-Ergebnisse an Aufgabengrenzen entfernen | 39 % beim langen Triage-Lauf (Compaction 32 %); keine bei kurzen Schleifen | Keine gemessen | Neutral | Input- und Kontext-Token kürzen |
| Tool-Suche | 45 % mit 500 angehängten Tool-Definitionen; 20 % mit einem GitHub-MCP-Server | Keine | Neutral | Input- und Kontext-Token kürzen |
| Datendateien über Codeausführung | 92 % bei einer Datenaufgabe mit 25 Fragen | Ein Gewinn: 25 von 25 statt 6 von 25 | Schneller | Input- und Kontext-Token kürzen |
| Batch API | 50 % | Keine | Ergebnisse innerhalb von 24 Stunden | Arbeit batchen, die warten kann |
| Prompts gegen das aktuelle Modell prüfen | 14 % bei beiden gemessenen Migrationen | Keine; bei einer ein Gewinn | Schneller (weniger Tool-Runden) | Prompts gegen das aktuelle Modell auditieren |
| Das Modell upgraden | Opus 4.8 auf Opus 5: 12 Punkte mehr bei 21 % höheren Kosten pro gelöster Aufgabe (Opus 5 mit low schlägt Opus 4.8 für etwa 30 % der Kosten); Sonnet 4.6 auf Sonnet 5: 15 % weniger pro gelöster Aufgabe, 5 Punkte mehr; Fable 5 auf Fable 5.1: 43 % weniger pro gelöster Aufgabe bei etwa gleicher Punktzahl | Ein Gewinn | Neutral | Modell upgraden |
| Geringerer Effort | Wissensarbeit: medium 13 % bis 31 %, low ein Drittel bis die Hälfte; lange Coding-Aufgaben: medium etwa 30 % und low etwa zwei Drittel, jeweils gegenüber high | 1 bis 3 Punkte bei Wissensarbeit, 2 bis 8 bei langen Coding-Aufgaben | Schneller | Effort abstimmen |
| Fehlschläge erneut ausführen | Etwa 40 % gegenüber der Ausführung aller Aufgaben mit high, bei gleicher oder leicht besserer Erfolgsquote | Keine | Zwei Läufe bei den fehlschlagenden Aufgaben | Fehlschläge mit höherem Effort erneut ausführen |
| Task-Budget | 44 % bis 58 % | 3 bis 6 Punkte | Schneller | Budgets und Ausgabelimits festlegen |
| Kürzere Antworten anfordern | 39 % der Output-Token, 14 % der Kosten beim Triage-Lauf | Keine | Schneller | Budgets und Ausgabelimits festlegen |
max_tokens erhöhen | Keine pro gelöster Aufgabe, aber mehr gelöste Aufgaben | Gewinne von bis zu 22 Punkten beim internen Set; keine beim öffentlichen Paar | Neutral | Budgets und Ausgabelimits festlegen |
| Advisor | Hängt von der Fähigkeitslücke und der Konsultationsrate ab. Die Coding-Paarung erzielte 1,7 Punkte mehr als Claude Opus 5.5 allein mit high, zu etwa dem 2,1-Fachen des Preises; das entspricht etwa dem, was mehr Effort bringt. Mit Claude Opus 5.5 konsultierte die Diagrammlese-Paarung den Advisor fast nie und erzielte 7 Punkte weniger als Opus 5.5 allein | Ein Gewinn beim Coding, ein Verlust beim Diagrammlesen | Etwa ein oder zwei zusätzliche Aufrufe pro Aufgabe | Advisor-Strategie |
| Orchestrator | Etwa die Hälfte gegenüber dem Frontier-Modell, sowohl bei Arbeit jenseits eines Kontextfensters als auch bei Kostenausreißern in Routinearbeit (Letzteres gemessen mit Claude Fable 5) | 10 bis 12 Punkte unter dem Frontier-Modell | Viel schneller bei großen Inputs | Orchestrator-Strategie |
Referenzierte Benchmarks
Sofern eine Referenz nichts anderes angibt, handelt es sich bei den Messungen um Anthropic-interne Durchläufe dieser Benchmarks. Sofern nicht anders angegeben, sind Kosten in USD zu den Listenpreisen angegeben, die zum Zeitpunkt des jeweiligen Benchmark-Durchlaufs galten; Zahlen für Claude Sonnet 5 verwenden 2 $ und 10 $ pro Million Input- bzw. Output-Token. Diagramme mit der Beschriftung „notional USD" (fiktive USD) bepreisen die Token-Anzahlen jeder Anfrage zu diesen Sätzen, statt Rechnungen wiederzugeben.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Breit angelegte Web-Recherche-Aufgaben, bewertet nach Vollständigkeit und Genauigkeit einer Tabelle mit vielen Zeilen; 200 Probleme, 3 Durchläufe pro Konfiguration, durchgeführt vom 1. bis 2. August 2026. Das Diagramm zur Kostenkonzentration basiert auf einem separaten Durchlauf mit 20 Problemen, 3 Durchläufe pro Problem, durchgeführt vom 3. bis 4. August 2026, mit Kosten aus den Abrechnungsdatensätzen pro Anfrage.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Arbeitsergebnisse aus der Wissensarbeit, bewertet anhand von Aufgabenrubriken; ein Durchlauf mit 210 Aufgaben des veröffentlichten Gold-Sets, ein Versuch pro Aufgabe, durchgeführt am 2. August 2026. Ein Claude-Modell bewertet, daher können absolute Werte von veröffentlichten Ergebnissen abweichen.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Eine Teilmenge von 482 Problemen, ausgewählt wegen der Kompatibilität mit Anthropics Evaluierungs-Harness; die Werte sind nicht mit dem öffentlichen Leaderboard vergleichbar. Sie sind auch nicht mit den SWE-bench-Pro-Ergebnissen in der System Card von Claude Opus 5.5 vergleichbar, die aus Durchläufen mit Effort
maxauf einem anderen Problemsatz stammen. Die Zahlen für Claude Opus 5.5 mitteln zwei Durchläufe beilow,medium(seinem Standard) undhighund verwenden einen Durchlauf beixhigh, alle durchgeführt vom 19. bis 20. September 2026, mit derselben Obergrenze von 16.384 Token pro Turn wie die Claude-Opus-5-Durchläufe im August; die Obergrenze schnitt 2 Versuche beixhighab und keinen bei anderen Einstellungen. Die Opus-5.5-Durchläufe verwendeten eine Version des Benchmarks, deren Bewertungscontainer nur interne Paket-Mirrors erreichen können. Diese Version lässt ein Problem weg, dessen Test eine Live-Website benötigt, und bei drei weiteren schlägt die Referenzlösung dort fehl, daher verwenden Opus-5.5-Vergleiche und die daneben gestellten Zahlen für Claude Fable 5.1 die verbleibenden 478 Probleme. Die SWE-bench-Pro-Zahlen für Claude Opus 5 in Modell upgraden und im Diagramm zu den Advisor-Paarungen mitteln zwei Durchläufe bei seinem Standard-Effort und verwenden einen Durchlauf beilow, alle durchgeführt am 4. August 2026. Eskalationszahlen stammen Aufgabe für Aufgabe aus den Opus-5.5-Durchläufen: zuerstlow, dannhighbei dessen Fehlschlägen, löste je nach Durchlaufpaarung 96,4 % bis 97,5 % für etwa 0,17 $; zuerstmedium, 96,0 % bis 97,1 % für etwa 0,24 $;higherneut auf den eigenen Fehlschlägen ausgeführt, 96,9 % für 0,31 $; alles beihigh, 94,8 % bis 95,8 % für 0,29 $. Die Kosten auf dieser Teilmenge sind so bepreist, wie die Organisation eines Kunden abgerechnet wird: der vorherige Prompt jeder Anfrage als „cache read" (Cache-Lesevorgang) und ihre neuen Token als 5-Minuten-„cache write" (Cache-Schreibvorgang), aus den eigenen Nutzungsdatensätzen der Durchläufe, abgeglichen mit einem Kundenkonto; die eigene Abrechnung der Evaluierungsorganisation, die bis zum 10. September 2026 Cache-Lesevorgänge für Claude Opus 5, Claude Fable 5, Claude Opus 4.7 und Claude Opus 4.8 in Blöcken von 8.192 Token abrechnete, ergab für die Durchläufe dieser Modelle 1,4- bis 1,8-mal höhere Zahlen; für Claude Fable 5.1, Claude Sonnet 5 und Claude Sonnet 4.6 unterscheiden sich die beiden um höchstens etwa 9 %, und für die Zahlen von Claude Opus 5.5 stimmen sie bei jeder Effort-Einstellung auf 3 % überein. Die Paarungen mit Claude Sonnet 5 als Executor im Advisor-Diagramm stammen aus derselben Messreihe auf dieser Teilmenge: Die Paarung Sonnet plus Opus 5 wurde zweimal ausgeführt (7. und 8. August 2026, ein Durchlauf und eine exakte Replikation), die Low-Effort-Paarung einmal (8. August 2026) und Claude Sonnet 5 allein zweimal (77,4 %, die Baseline für beide Pro-Zeilen). Der Claude-Fable-5-Punkt in „Modell upgraden“ ist der Mittelwert von drei Durchläufen beim Standard-Effort, durchgeführt am 26. August 2026, auf dieselbe Weise bepreist. Die Task-Budget-Zahlen für Claude Fable 5.1 sind ein Durchlauf pro Budget (zwei bei 35.000 Token) auf derselben Teilmenge beim Standard-Effort, durchgeführt am 26. August 2026, mit einem Durchlauf ohne Budget am selben Tag (92,1 %, 1,10 $ pro Aufgabe) als Baseline; ein früherer Satz bei Effortlow, durchgeführt am 21. August 2026, erreichte ohne Budget 88,6 % bei 0,48 $ pro Aufgabe. Der Vergleich in Modelle vergleichen stellt diesen einzelnen Durchlauf den zwei zusammengefassten Claude-Sonnet-5-Durchläufen aus derselben Teilmenge gegenüber; beim Standard-Effort von Fable 5.1 fällt der Vergleich umgekehrt aus, 41 % mehr pro gelöster Aufgabe als Sonnet 5. Die Upgrade-Leiter ist ein Durchlauf pro Modell mit seinen ausgelieferten Standardeinstellungen (je zwei für Opus 5 und Sonnet 5 und der Fable-5-Punkt wie oben beschrieben), wobei die Opus- und Sonnet-Durchläufe in derselben Woche in einem Harness und einer Organisation stattfanden. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Die Effort-Zahlen verwenden einen Ausschnitt von 500 Problemen, ein bis drei Durchläufe pro Einstellung, durchgeführt am 3. August 2026, wobei der Standardpunkt zwei Durchläufe vom 26. bis 27. Juli 2026 zusammenfasst. Das Diagramm zur Kostenabsicherung verwendet 10 zuverlässig gelöste Probleme aus einem Ausschnitt von 26 Problemen, 50 delegierte Durchläufe (1. bis 2. August 2026) und 70 Solo-Durchläufe (50 vom 2. bis 3. August 2026; 20 archivierte vom 12. bis 13. Juli und 1. August 2026), 6,45 $ gegenüber 11,99 $ pro Durchlauf im Erwartungswert; delegierte Zahlen haben eine Messbandbreite von etwa 20 %.
- Skalierung von Agent-Architekturen: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Unabhängige externe Studie, nur für die Richtung des Befunds zitiert, wann sich Delegation nicht lohnt, nicht für irgendeine Zahl.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. Die 220 Fragen umfassen 15 Domänen, die jeweils das Sammeln vieler Zeilen mit Multi-Hop-Retrieval kombinieren; gemessen auf dem festen Zeilensatz des Benchmarks, 3 Durchläufe pro Konfiguration, durchgeführt am 2. August 2026 (der Team-Punkt mit einem einzelnen Worker lief vom 26. bis 27. Juli 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Seine 132 Rechercheaufgaben aus 22 Domänen werden anhand von aus Expertenwissen abgeleiteten binären Rubriken bewertet; gemessen auf einer Teilmenge von 50 Aufgaben, stratifiziert über alle Themen, ein Versuch pro Aufgabe, 3 Durchläufe pro Einstellung, auf Claude Managed Agents mit den plattformeigenen Websuche- und Fetch-Tools (26. bis 27. August 2026); bewertet auf den 33 Aufgaben, die keine Konfiguration verweigerte, wobei Versuche entfernt wurden, die von den Produktions-Sicherheitsklassifikatoren abgebrochen wurden; die Kosten entsprechen dem, was einem Kunden in Rechnung gestellt wird, also den Anfragen der Plattform plus Websuche-Gebühren. Die Werte sind der Mittelwert jedes Modells auf der Basis von 33 Aufgaben, wobei seine eigenen vorzeitig abgebrochenen Aufgaben entfernt wurden; auf den 21 Aufgaben, die in jedem Arm sauber waren, hält Claude Fable 5.1 auf jeder Effort-Stufe einen Vorsprung von 2 bis 3 Punkten gegenüber Claude Fable 5, und beide Modelle bleiben über die Effort-Stufen hinweg konstant. Das Caching-Diagramm bepreist dieselben Anfragen neu, wobei jedes Input-Token zum ungecachten Satz berechnet wird. Claude Opus 4.6 bewertet nach dem Rubrik-Protokoll des Benchmarks; das Original verwendet einen anderen Bewerter, und ein Anthropic-Bewerter könnte den hauseigenen Stil bevorzugen. Claude Opus 5 lief bei seinem Standard-Effort auf derselben Oberfläche und Teilmenge, drei Durchläufe, am 28. August 2026: 68,8 % auf den rohen 50 Aufgaben, 70,8 % auf der Basis von 33 Aufgaben und 71,1 % auf dem Satz von 21 Aufgaben, bei 6,71 $ pro Aufgabe (23,72 $ ohne Caching); keiner seiner Versuche wurde von den Sicherheitsklassifikatoren abgebrochen, unter einem neueren Safeguards-Deployment als dem, unter dem die anderen Modelle liefen.
- Korpus-Defektsuche: Anthropic-intern, für Arbeit, die größer als ein „context window" (Kontextfenster) ist: ein Korpus mit 21,6 Millionen Token aus 14 öffentlichen Python-Paketquellen mit 130 eingebauten Defekten und deterministischer Bewertung; Protokoll vor den Durchläufen festgelegt und intern geprüft; drei Durchläufe pro Konfiguration. Jede Konfiguration lief auf Claude Managed Agents. Die im Diagramm dargestellte Team-Konfiguration ist ein Durchlauf, bei dem der Claude-Fable-5.1-Koordinator die gesamte Suche innerhalb der Plattform an ihrem dokumentierten Limit von 25 gleichzeitigen Claude-Sonnet-5-Workern ausführte, durchgeführt am 30. August 2026; seine drei Episoden erreichten nach der Prüfung der Zusatzfunde F1 0,764, 0,825 und 0,791 (roh 0,751, 0,821 und 0,781) für 225 $, 234 $ und 283 $. Die Solo-Konfiguration mit Claude Sonnet 5 lief vom 3. bis 4. August 2026; die Solo-Konfigurationen mit Claude Fable 5.1 liefen vom 24. bis 25. August 2026 unter den Serving-Einstellungen der Plattform zum Launch, drei Seeds pro Effort-Einstellung, auf demselben Korpus-Build. Das Sandbox-Image enthielt installierte Kopien eines Teils des Korpus, und der abschließende Zusammenführungsschritt von Claude Fable 5.1 verglich in 7 von 9 Episoden mit ihnen; eine Neubewertung ohne diese Ergänzungen veränderte die betroffenen Seeds um bis zu 3 Punkte. Der absolute F1-Wert ist spezifisch für diesen Korpus-Build und nicht über Benchmarks hinweg vergleichbar; Konfigurationsvergleiche erfolgen unter gleichen Bedingungen.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. Die Diamond-Teilmenge mit 198 Fragen, zwei Durchläufe pro Konfiguration, durchgeführt am 7. August 2026 (Claude Opus 5.5: 19. September 2026), modellbewertet anhand von Referenzantworten, Advisor-Token pro Anfrage gemessen. Eine Sicherheitsprüfung der Plattform verweigerte zwei Biologiefragen bei den Claude-Sonnet-5-Executors und eine davon auch bei Claude Opus 5; ihr Ausschluss verändert keinen Vergleich um mehr als einen Punkt. Die 92 % von Claude Opus 5.5 stammen aus zwei Durchläufen, die
fallbacks: "default"setzen, um serverseitiges Fallback zu aktivieren, wobei jeder Versuch, der dennoch mit einer Ablehnung endete, als falsch gezählt wurde. In jedem Durchlauf markierte die Sicherheitsprüfung sechs Biologiefragen, Claude Opus 5 beantwortete fünf davon über das Fallback, und die sechste endete dennoch mit einer Ablehnung. Die Kosten pro Frage von Opus 5.5 enthalten diese Fallback-Antworten. Ohne Ablehnungen als falsch zu zählen, erreichen diese Durchläufe 93 %, weil der Bewerter einem verweigerten Versuch dennoch eine Antwortoption zuordnet, meist die richtige. Mit Ablehnungen als falsch gezählt erreichen die Durchläufe von Claude Opus 5 91 % (eine Ablehnung pro Durchlauf), ebenso wie zwei Durchläufe von Claude Opus 5.5 mit deaktiviertem Fallback, in denen Opus 5.5 fünf oder sechs Biologiefragen pro Durchlauf verweigerte. - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. Der Satz umfasst 113 originale Aufgaben in fünf Sprachen mit programmbasierten Verifizierern. Paarungen sind jeweils zwei Durchläufe, durchgeführt am 7. August 2026, mit pro Anfrage gemessenen Advisor-Token, und verwendeten eine clientseitige Advisor-Schleife statt des Advisor-Tools, mit identischer Abrechnung. Effort-Sweeps mit einem einzelnen Modell sind Einzeldurchläufe, bepreist anhand der Token-Anzahlen, eine cache-bewusste Näherung. Die Kosten pro Aufgabe sind Durchlaufsummen geteilt durch 113.
- Interner Agentic-Coding-Benchmark: Anthropic-intern: 370 Repository-Aufgaben, bewertet durch die eigenen Tests der Repositories. Die API-Zahlen wurden mit einer Output-Obergrenze von 128.000 Token gemessen, ein Durchlauf pro Konfiguration: Opus 5 allein beim Standard-Effort vom 9. bis 10. August 2026 und bei
lowundmediumam 10. August 2026; Claude Fable 5.1 allein bei fünf explizit gesetzten Effort-Werten am 20. August 2026 (das Diagramm zeigt drei davon); und die Paarung vom 24. bis 25. August 2026. Claude Opus 5.5 allein lief auf allen 370 Aufgaben vom 19. bis 20. September 2026: bei seinem Standard-Effort (medium) und beihighmit fünf Versuchen pro Aufgabe und beilowundxhighmit einem (jeweils 369 von 370 bewertet, nach einem Fehlschlag der Setup-Prüfung). Der Claude-Opus-5.5-Executor beihighmit dem veröffentlichten Claude Fable 5.1 als Advisor (die August-Durchläufe verwendeten einen Pre-Release-Snapshot) führte an denselben Tagen fünf Versuche pro Aufgabe aus; eine Aufgabe bestand ihre Setup-Prüfung nicht, daher wurden 1.845 Versuche bewertet. Die 279 Versuche, bei denen der Advisor unter Last abgewiesen wurde, wurden erneut ausgeführt, und Versuche, deren Konsultationen in ein Timeout liefen, wurden beibehalten, wie im August. Die August-Durchläufe hatten fünf Versuche pro Aufgabe für die Paarung und die Claude-Opus-5-Kontrolle und einen für die anderen Punkte. Die August-Paarung hatte durchschnittlich etwa zwei Advisor-Konsultationen pro Versuch; die Claude-Opus-5.5-Paarung forderte 1,39 an und erhielt 1,35. Die Kosten gelten pro Versuch. Die Kosten sind so bepreist, wie die Organisation eines Kunden abgerechnet wird: der vorherige Prompt jeder Agent-Loop-Anfrage als Cache-Lesevorgang und ihre neuen Token als 5-Minuten-Cache-Schreibvorgang, aus den eigenen Nutzungsdatensätzen der Durchläufe, und jeder Advisor-Aufruf, der keinen Cache verwendet, anhand seiner aufgezeichneten Token, alles zu Listenpreisen. Die Claude-Code-Zahlen sind Durchläufe derselben Aufgaben vom 8. bis 23. Juli 2026, ein Durchlauf pro Konfiguration, Kosten näherungsweise. - Interner Repository-Aufgaben-Benchmark (Messung der Obergrenze): Ein separater Anthropic-interner Satz von etwa 130 Repository-Aufgaben, durchgeführt am 20. August 2026 (Claude Fable 5.1) und am 19. September 2026 (Claude Opus 5.5, bei seinem Standard-Effort,
medium), mit einer einfachen API-Agent-Schleife, ein Versuch pro Aufgabe. Die Claude-Fable-5.1-Durchläufe umfassen 135 Aufgaben pro Obergrenze beim explizit gesetzten Standard-Effort: Die Zahl für 16.384 Token mittelt zwei Durchläufe (36,3 % bei beiden); die Zahlen für 64.000 und 128.000 sind Einzeldurchläufe (58,5 % und 60,0 %). Sechs Probleme lösten in jedem Durchlauf eine Sicherheitsablehnung aus und zählen als Fehlschläge. Die Zahl für Claude Opus 5.5 bei 16.384 Token mittelt zwei Durchläufe (134 und 135 bewertete Aufgaben), und seine Zahlen für 64.000 und 128.000 sind Einzeldurchläufe (jeweils 135 Aufgaben); zwei Versuche in jedem 16.384-Token-Durchlauf endeten mit einer Sicherheitsablehnung und zählen als Fehlschläge. Die SWE-bench-Pro-Zahlen zur Obergrenze sind ein Claude-Fable-5.1-Durchlauf pro Obergrenze beim Standard-Effort, durchgeführt am 26. August 2026, auf einer Teilmenge von 100 Problemen, stratifiziert aus dem Satz mit 482 Problemen aus Referenz 3, nicht mit dessen Werten vergleichbar; die beiden Obergrenzen erzielten beim Standard dasselbe Ergebnis. Die Verteilungen pro Turn im Diagramm stammen aus den Durchläufen von Claude Opus 5.5 und Claude Fable 5.1 bei 128.000: Kein Opus-5.5-Turn erreichte die Obergrenze (der längste hatte etwa 61.000 Token, und 0,56 % seiner Turns überschritten 16.384), und ein Fable-5.1-Turn erreichte 128.000 (0,46 % seiner Turns überschritten 16.384). - Chartography: Surge AI, "Chartography," 2026. Der vollständige veröffentlichte Satz mit 100 Fragen, gemessen am 6. und 9. August 2026 (Claude Opus 5 allein) und am 20. September 2026 (Claude Opus 5.5), mit Anthropics Implementierung auf Claude Managed Agents (Standard-Cloud-Sandbox; Advisor-Konfigurationen verwenden den Managed-Agents-Advisor). Claude Sonnet 4.6 bewertet anstelle des Referenzbewerters, und der Benchmark läuft mit Tools, daher sind die Werte hier zwischen Konfigurationen vergleichbar, aber nicht mit dem veröffentlichten Leaderboard. Sie sind auch nicht mit den Chartography-Ergebnissen in der System Card von Claude Opus 5.5 vergleichbar, die einen anderen Bewerter verwenden und mit Effort
maxlaufen. Zwei Durchläufe pro Konfiguration (drei für Claude Opus 5.5), zusammengefasst; die Streuung zwischen Durchläufen betrug bis zu 10 Punkte. Die Kosten entsprechen dem, was einem Kunden, der den Agenten regelmäßig ausführt, in Rechnung gestellt wird: Die erste Anfrage jedes Diagramms liest den gemeinsamen „system prompt" (System-Prompt) und die Tools des Agenten aus dem Cache, wie es der Fall ist, wenn in den vorherigen 5 Minuten eine andere Sitzung desselben Agenten lief. Ein einzeln ausgeführtes Diagramm kostet mit Claude Opus 5 oder Claude Opus 5.5 etwa 0,03 $ mehr und mit Claude Fable 5.1 etwa 0,12 $ mehr. Die August-Zahlen sind auf diese Weise aus den Nutzungsdatensätzen der Durchläufe neu bepreist; die eigene Abrechnung der Evaluierungsorganisation, die bis zum 10. September 2026 die Cache-Lesevorgänge von Claude Opus 5 in Blöcken von 8.192 Token abrechnete, überschätzte die Kosten von Claude Opus 5. Die Kosten schließen Sandbox-Zeit aus, die den August-Durchläufen weniger als 1 % hinzufügte. Die Solo-Durchläufe von Claude Fable 5.1 stammen vom 24. August 2026, unter den Serving-Einstellungen der Plattform zum Launch, zwei Durchläufe pro Einstellung; sechs Versuche erreichten die Sitzungsobergrenze von 15 Minuten und erhalten 0 Punkte, und zwei Diagramme pro Durchlauf wurden nach einer Sicherheitsablehnung von Claude Opus 5 beantwortet. Der Claude-Opus-5-Executor mit niedrigem Effort und einem Claude-Fable-5.1-Advisor lief am 30. August 2026 zweimal unter denselben Einstellungen (63,0 und 67,0, Mittelwert 65,0, bei 0,47 $ pro Diagramm; der Advisor wurde in jedem Durchlauf bei 88 % der Aufgaben konsultiert, und 4 seiner 219 Antworten kamen stattdessen von Claude Opus 5, jeweils nachdem ein Produktions-Sicherheitsfilter die eigene Antwort des Advisors gestoppt hatte). Claude Opus 5.5 lief beilow, mit deaktiviertem serverseitigem Fallback und einem Sicherheitsklassifikator, der jeden Tool-Aufruf beurteilte: drei Durchläufe allein (70, 68 und 68) und drei mit konfiguriertem Claude-Fable-5.1-Advisor (59, 63 und 63), in denen es den Advisor bei 1 von 300 Aufgaben konsultierte. Der Vergleich der Konsultationsrate für die früheren Paarungen stammt aus einer erneuten Ausführung derselben Konfigurationen auf der Messages API mit einem Container-Toolset vom 10. bis 11. August 2026. - Support-Desk-Evaluierung zur Prompt-Prüfung: Ein von Anthropic erstellter Satz von 44 Support-Tickets mit deterministischer Bewertung, durchgeführt Anfang August 2026 und berichtet am 8. August 2026, unter sechs System-Prompts, von denen jeder demselben sauberen Prompt ein Muster hinzufügt, das in für Claude Opus 4.8 und Claude Sonnet 4.6 geschriebenen Prompts häufig vorkommt. Jeder Diagrammpunkt ist einer von drei Fällen (älteres Modell, neueres Modell mit demselben Prompt, neueres Modell nach der Prüfung), gemittelt über die sechs Prompts und 44 Tickets. Der Genauigkeitsgewinn von Opus 5 hat ein 95-%-Konfidenzintervall von 3 bis 8 Punkten; die Genauigkeitsunterschiede bei Sonnet liegen im Rauschen.
- Fragensatz zu Datendateien: Ein von Anthropic erstellter Satz von 25 Aggregatfragen über einen Ausschnitt von 1.862 Zeilen einer öffentlichen CSV-Datei zu Spirituosenverkäufen, mit durch pandas berechneter Ground Truth und Exact-Match-Bewertung, ausgeführt auf Claude Sonnet 5 und Claude Opus 5 mit deaktiviertem „thinking" (Nachdenken) (der In-Context-Arm kann beim Standard nicht abgeschlossen werden), einer Output-Obergrenze von 4.000 Token und ohne „prompt caching" (Prompt-Caching), drei Durchläufe pro Konfiguration, durchgeführt am 19. August 2026. Der Datei-Arm lädt die CSV über die Files API hoch und verwendet das Tool
code_execution_20260120. - Messung der Cache-Dauer: Der Triage-Job mit 20 Issues aus Input- und Kontext-Token kürzen, ausgeführt auf Claude Sonnet 5 am 23. August 2026 und auf Claude Opus 5.5 am 19. und 20. September 2026, bei seinem Standard-Effort (
medium) und beihigh, auf der Messages API mit demselben Harness (für Claude Opus 5.5 eine Portierung davon, die dieselben Request-Bodies sendet), die Claude-Opus-5.5-Zellen mit auf 4.096 erhöhtemmax_tokens, mit Pausen, die vor einem zufällig gewählten Anteil der Turns eingefügt wurden (keine, 5 %, 10 % und jeder Turn bei 6 Minuten auf allen 20 Issues bei beiden Modellen, plus jeder Turn bei 2 Minuten auf Claude Sonnet 5; Pausen von 20 und 45 Minuten auf einer Teilmenge von 5 Issues bei beiden Modellen). Die Keep-alive-Zahlen für Claude Opus 5 unten stammen aus demselben Job am 23. August 2026, mit auf 4.096 erhöhtemmax_tokens, mit denselben Zeitplänen außer den Pausen von 2 und 45 Minuten. Drei Durchläufe pro Zelle, Kosten berechnet aus denusage-Feldern jeder Antwort zu Listenpreisen (für Claude Opus 5.5 4 $ Input, 5 $ 5-Minuten-Schreibvorgang, 8 $ 1-Stunden-Schreibvorgang, 0,20 $ Cache-Lesevorgang und 20 $ Output pro Million Token; Claude Sonnet 5 lief in einer Anthropic-internen Organisation, deren Nutzung auf dieselbe Weise abgerechnet wird wie die einer Kundenorganisation), Genauigkeit anhand derselben Gold-Labels. Die Zahlen für Claude Opus 5.5 auf dieser Seite decken beide Effort-Stufen ab. Der Kreuzungspunkt liegt bei etwa 3,3 % der Turns auf Claude Sonnet 5 und bei 3,1 % bis 3,2 % auf Claude Opus 5.5: der Median des Break-even-Anteils jeder Sitzung, vom Kostenmodell aus den Kontextgrößen Turn für Turn dieser Sitzung berechnet, über alle 45 Claude-Sonnet-5-Sitzungen mit zwanzig Issues und die 36 Claude-Opus-5.5-Sitzungen mit zwanzig Issues auf jeder Effort-Stufe (jeder Pausenplan auf dem vollständigen Job ausgeführt, unter allen drei Cache-Einstellungen, jeweils drei Durchläufe; die 5-Issue-Zellen sind nicht enthalten). In der 5-%-Zelle lagen die 5-Minuten- und 1-Stunden-Einstellungen auf Claude Sonnet 5 gleichauf, weil die Pausen dieser Ziehung auf kleine Präfixe fielen; auf Claude Opus 5.5 lagen sie nahezu gleichauf. Die 1-von-20-Regel der Seite liegt über dem gemessenen Kreuzungspunkt. Die Zeit bis zum ersten Token nach einer Pause wurde für Claude Opus 5.5 nicht gemessen. Anthropic hat Keep-alive-Anfragen, die den 5-Minuten-Cache auffrischen, auf Claude Sonnet 5 und Claude Opus 5 am 23. August 2026 und auf Claude Opus 5.5 in den obigen Durchläufen gemessen, stets mitmax_tokens: 1gesendet. Auf Claude Sonnet 5 kosteten sie bei 5 % pausierten Turns 7,7 % weniger als die 1-Stunden-Einstellung und bei 10 % etwa gleich viel; auf Claude Opus 5 war bei keinem der beiden Anteile ein Unterschied messbar; bei beiden kosteten sie mehr bei einer Pause von 6 Minuten oder mehr vor jedem Turn. Auf Claude Opus 5.5 kosteten sie bei 5 % und 10 % pausierten Turns 8 % bis 18 % weniger als die 1-Stunden-Einstellung (etwa 10 % bis 15 %, wenn das Rauschen zwischen Sitzungen entfernt wird, indem die eigenen Token jeder Keep-alive-Sitzung zu 1-Stunden-Cache-Preisen neu abgerechnet werden), und mehr bei einer Pause vor jedem Turn: 4 % bis 6 % mehr bei 6 Minuten, 9 % bis 10 % bei 20 Minuten und 56 % bis 58 % bei 45 Minuten. Keep-alive sparte auf Claude Opus 5.5 mehr, weil jede Keep-alive-Anfrage das Präfix zum Cache-Lesepreis erneut liest: das 0,05-Fache des Input-Preises, gegenüber dem 0,1-Fachen auf Claude Sonnet 5 und Claude Opus 5; die Sitzungen von Claude Opus 5, zu den Preisen von Claude Opus 5.5 neu abgerechnet, zeigen nahezu dieselben Einsparungen wie Claude Opus 5.5. Anthropics API-Tests vor dem Launch auf Claude Opus 5.5 zeigen, dass eine Anfrage mitmax_tokens: 0den Cache schreibt und dass die nächste Anfrage ihn liest; ob eine solche Anfrage einen bestehenden Eintrag auffrischt, wurde auf Opus 5.5 nicht gemessen. Auf Claude Fable 5.1, beim 0,025-Fachen, war Keep-alive selbst mit einer Pause vor jedem Turn günstiger, außer bei Pausen von 45 Minuten (Referenz 19). - Anteil der Cache-Lesevorgänge in der Produktion: Aggregierte First-Party-Nutzung der Claude API für die 14 Tage bis zum 23. August 2026, nur das direkte API-Produkt, Anthropic-interne Organisationen ausgeschlossen, keine Organisation identifiziert. Ein Organisationstag zählt als Agent-Loop, wenn seine Anfragen Tool-Definitionen und Tool-Ergebnisse enthalten, seine Prompts im Durchschnitt 9 oder mehr vorherige Tool-Aufrufe enthalten, Caching verwendet wurde und er mindestens 10 solcher Anfragen gestellt hat (die API hat keine Konversationskennung, daher dient dies als Ersatz für die Konversationslänge): 303.003 Organisationstage über 106.487 Organisationen, medianer Cache-Lese-Anteil 84,2 % aller Input-Token, oberes Quartil 91,7 %. Use-Case-Labels (der angegebene Use Case der Organisation oder andernfalls ihr klassifizierter) decken 74 % dieser Organisationstage und 99 % ihrer Token ab; Coding-Organisationen liefern 87 % der agentischen Input-Token und lesen im Median 88,5 % (90,9 % bei 25 oder mehr vorherigen Tool-Aufrufen), oberes Quartil 93,4 %, wobei etwa 72 % der Coding-Organisationstage bei 80 % oder mehr liegen; Support-, Recherche- und Daten-Agenten lesen 84 % bis 85 %. Das oberste Dezil der Organisationstage liest 95,9 % oder mehr bei Coding und 94,2 % bis 94,8 % bei Support-, Recherche-, Daten- und anderen Agenten. Die Aufteilung auf Anfrageebene bei 25 oder mehr vorherigen Tool-Aufrufen stammt aus einer sechsstündigen Stichprobe: Coding 92 % gelesen, 7 % geschrieben, unter 1 % ungecacht. Organisationen ohne Label, meist kleine, lesen im Median 11 %. Organisationstage ohne Tool-Definitionen lesen im Median 34,6 %. Eine unabhängige Abfrage über dasselbe Zeitfenster, die Konversationen mit 10 oder mehr Anfragen rekonstruiert, statt Organisationstage zu bewerten, setzt den Median bei 90,2 % an; der Unterschied liegt im Umfang, nicht in den Daten.
- Messung des Compaction-Zeitpunkts: Die lange Variante des Triage-Agenten aus Input- und Kontext-Token kürzen, ausgeführt am 24. August 2026 auf Claude Sonnet 5 mit dem 5-Minuten-Cache, Kosten aus den Usage-Feldern zu Listenpreisen, fünf Sitzungen pro Arm: ein Arm ohne Änderungen durchgehend beim Standard-Effort (0,81 $ pro Sitzung) und zwei Arme, die mit niedrigem Effort beginnen und dieselben zwei cache-brechenden Änderungen vornehmen, einen Wechsel zum Standard-Effort und ein hinzugefügtes Tool, entweder mitten in der Sitzung bei den Anfragen 12 und 17 (0,95 $) oder zusammen bei der ersten Anfrage nach der ersten Compaction (0,75 $). Ein vierter Arm mit sechs Sitzungen, ausgeführt am 25. August 2026, nahm dieselben zwei Änderungen bei der Anfrage vor, die die erste Compaction auslöste (0,92 $ pro Sitzung): Der Zusammenfassungsdurchgang dieser Anfrage schrieb den Kontext von 81.000 Token in den Cache, statt ihn zu lesen, sodass dieser Durchgang 0,21 $ kostete gegenüber 0,04 $ für denselben Durchgang im Grenz-Arm. In den Sitzungen fand die erste Compaction bei Anfrage 21 bis 25 statt (16 der 21 Sitzungen bei Anfrage 22), sobald der Prompt den Compaction-Auslöser von 80.000 Token überschritt, und in zwei Sitzungen ohne Änderungen fand gegen Ende eine zweite Compaction statt. Die niedrigere Gesamtsumme des Grenz-Arms gegenüber dem Arm ohne Änderungen spiegelt seine Anfragen mit niedrigem Effort vor der Änderung und diese zweiten Compactions wider, nicht das Caching: Die Kosten für erneutes Schreiben der beiden Arme unterscheiden sich um weniger als einen Cent. Der Arm mit Änderungen mitten in der Sitzung zahlte 0,23 $ pro Sitzung für erneutes Schreiben in den Cache; der Unterschied zwischen dem Arm mitten in der Sitzung und dem Grenz-Arm betrug 0,20 $ mit einem 95-%-Konfidenzintervall von 0,11 $ bis 0,29 $. Eine Sitzung im Arm mitten in der Sitzung lief günstig (0,82 $), nachdem ihr Modell das Such-Tool nach der Compaction falsch aufgerufen und leere Ergebnisse erhalten hatte; sie ist enthalten, und ohne sie liegt der Durchschnitt des Arms bei 0,98 $. Die Genauigkeit lag im Durchschnitt bei 14,2 von 20 Labels in jedem Arm vom 24. August und bei 14,7 im Arm vom 25. August; Cache-Lesevorgänge machten 91 % der Prompt-Token ohne Änderungen aus, 85 % mitten in der Sitzung, 91 % an der Grenze und 86 % mit den Änderungen bei der auslösenden Anfrage.
- Messung der Cache-Dauer auf Claude Fable 5.1: Derselbe Triage-Job mit 20 Issues und dasselbe Harness wie in Referenz 16, ausgeführt am 23. und 26. August 2026 auf dem Launch-Snapshot von Claude Fable 5.1 zu seinen Launch-Preisen (10 $ Input, 12,50 $ 5-Minuten-Schreibvorgang, 20 $ 1-Stunden-Schreibvorgang, 0,25 $ Cache-Lesevorgang, 50 $ Output pro Million Token), drei Einstellungen pro Zeitplan: der 5-Minuten-Cache, der 1-Stunden-Cache und der 5-Minuten-Cache, der durch eine Anfrage mit
max_tokens: 0auf dem unveränderten Präfix alle 4 Minuten warm gehalten wird, gemessen ab dem Start der vorherigen Anfrage (die Durchläufe vom 23. August sendeten Keep-alive-Anfragen mitmax_tokens: 1; in den hier berichteten Zellen vom 26. August frischte jede Keep-alive-Anfrage den Cache auf und berechnete keinen Output). Zeitpläne: keine Pausen, 10 % der Turns und jeder Turn bei 6 Minuten auf allen 20 Issues sowie Pausen von 45 Minuten auf der Teilmenge von 5 Issues; drei Durchläufe pro Zelle (sechs für die Keep-alive-Zelle vom 26. August mit Pausen von 45 Minuten), Kosten berechnet aus denusage-Feldern jeder Antwort zu Listenpreisen, Genauigkeit anhand derselben Gold-Labels (12 bis 17 exakte Labels von 20). Mittelwerte pro Sitzung am 26. August für die 5-Minuten-, 1-Stunden- und Keep-alive-Einstellungen: keine Pausen 2,42 $, 3,09 $, 2,29 $; 10 % pausiert 4,50 $, 2,96 $, 2,36 $; jeder Turn 22,89 $, 3,01 $, 2,62 $; die Zellen vom 23. August stimmen auf 6 % überein. Die Zahlen für 45 Minuten (1,68 $, 0,59 $ und 0,71 $ pro 5-Issue-Sitzung) stammen aus einer sauberen Wiederholung am 26. August, nachdem ein Cache-Abrechnungsvorfall die ersten Zellen dieses Tages unbrauchbar gemacht hatte; die Durchläufe vom 23. August ergaben 1,67 $, 0,58 $ und 0,70 $. Der Kreuzungspunkt zwischen den 5-Minuten- und 1-Stunden-Einstellungen liegt bei 3,1 % der Turns, nach demselben Maß wie in Referenz 16. - Terminal-Bench 3: die 74 Aufgaben des öffentlichen Terminal-Agent-Benchmarks, ausgeführt auf Claude Managed Agents mit zwei benutzerdefinierten Tools, einer Shell und einem Dateieditor, die das Evaluierungs-Harness im eigenen Container jeder Aufgabe ausführt, anstelle der integrierten Tools der Plattform, und ansonsten mit den Standardeinstellungen der Plattform für externe Konten, zwei Durchläufe pro Modell bei Effort
high, 27. bis 28. August 2026. Diese Durchläufe verwendeten Terminal-Bench Version 3.0, und ihre Werte sind weder mit dem öffentlichen Terminal-Bench-Leaderboard noch mit den Terminal-Bench-4.0-Ergebnissen in der System Card von Claude Opus 5.5 vergleichbar, die aus Durchläufen in Claude Code mit Effortmaxstammen. Die Zeitlimits jeder Aufgabe betragen das 2,5-Fache der eigenen Limits des Benchmarks, was dem Agenten zwischen 75 Minuten und 20 Stunden pro Aufgabe gibt (5 Stunden für die mediane Aufgabe), und jede Aufgabe erhält das Dreifache des von ihr angegebenen Speichers, von 6 GiB bis 96 GiB, mit zusätzlichem Speicher für die 12 Aufgaben, die Hilfsdienste ausführen. Der Agent hatte keinen allgemeinen Internetzugang: Seine Container konnten einen internen Paket-Mirror, eine kurze Liste von Download-Seiten einschließlich GitHub und des Python Package Index sowie einige aufgabenspezifische Seiten erreichen, und acht der Aufgaben hatten überhaupt keinen Netzwerkzugang. Die Werte sind rohe Erfolgsquoten über die 148 Versuche pro Modell; Einzeldurchläufe schwanken um 5 bis 11 Punkte. Die Kosten entsprechen dem, was einem Kunden zu Listenpreisen in Rechnung gestellt würde, Anfrage für Anfrage aus den Nutzungsdatensätzen der Durchläufe mit der 5-Minuten-Cache-Lebensdauer neu bepreist. Claude Opus 4.7 beendete 11 seiner 148 Versuche an seiner Output-Obergrenze. - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. Seine 100 Rechercheaufgaben aus 10 Domänen werden anhand von Experten verfasster Rubriken bewertet, und die Punktzahl ist die normalisierte Punktzahl des Benchmarks. Jede Konfiguration lief auf der Claude API mit Claude Fable 5.1, dem standardmäßigen adaptiven Nachdenken, aktivierten Produktions-Sicherheitsklassifikatoren und
max_tokensbei 128.000: ein einzelner Agent bei Efforthighund beimedium, der einzelne Agent beihighmit der Anweisung und der Uhr sowie ein Team beihighmit und ohne diese. Das Team ist ein Lead-Agent, der über ein Tool Hilfsagenten desselben Modells startet, ohne Obergrenze für deren Anzahl. Bei DRACO startete der Lead im Median 4 Helfer pro Versuch. Jede Konfiguration unternahm drei Versuche pro Aufgabe, durchgeführt vom 8. bis 10. September 2026. Ein Versuch, der das Vier-Stunden-Limit erreichte, wurde erneut ausgeführt, und der neue Versuch zählt. Die einzigen ausgelassenen Versuche sind alle 3 Versuche bei einer Aufgabe für den einzelnen Agenten bei Effortmedium, sodass diese Konfiguration 99 Aufgaben abdeckt. Diese Aufgabe lief bei jedem Versuch in ein Timeout, im ursprünglichen Durchlauf und in der Wiederholung. Diese 3 Versuche mit 0 zu bewerten, wie es die eigene Bewertung des Benchmarks tun würde, betrifft nur die beiden Vergleiche mit Effortmedium. Die Änderung der Punktzahl bei Effortmediumgegenüberhighverschiebt sich von 0,7 auf 1,7 Punkte niedriger, und die Änderung der Punktzahl mit beiden Änderungen gegenüber Effortmediumverschiebt sich von 1,2 auf 0,2 Punkte niedriger. Die Agenten verwendeten ein Such-Tool und ein Fetch-Tool, die das Evaluierungs-Harness über einem fixierten Webindex hostet. Diese Tools bestimmen einen Teil der Zeit, und deine werden mit einer anderen Geschwindigkeit laufen, daher gibt die Seite die Zeit als Verhältnis zwischen Konfigurationen an, nicht in Minuten. Die Zeit ist die Wall-Clock-Zeit pro Aufgabe, von der ersten bis zur letzten Anfrage eines beliebigen Agenten, abzüglich der geschätzten Wartezeit für erneute Anfragen nach Fehlern durch „rate limit" (Ratenlimit) oder Überlastung. Diese Fehler stammten aus den gemeinsamen Limits des Testkontos. Alle Konfigurationen eines Satzes starteten gemeinsam. Die langsameren endeten Stunden später, sodass ein Teil ihrer Zeit unter anderer Last lief. Die Kosten jeder Aufgabe sind ihre Anfragen zu öffentlichen Listenpreisen, wobei Prompt-Caching so abgerechnet wird, wie es für einen Kunden der Fall wäre, der am Ende jeder Anfrage einen Cache-Breakpoint setzt und die 5-Minuten-Cache-Lebensdauer verwendet, nur für Modell-Token. Die Tools des Harness verursachen keine Gebühren. Änderungen der Punktzahl sind gepaarte Differenzen über Aufgaben, mit 95-%-Bootstrap-Intervallen. Eine Änderung gilt als innerhalb der Toleranz, wenn ihr Intervall bei DRACO innerhalb von 1,5 Punkten und bei HLE innerhalb von 2,5 Punkten bleibt. Anthropic hat diese Toleranzen vor den Durchläufen festgelegt. Claude Opus 5 bewertet die Antworten. Gegenüber dem eigenen Bewerter jedes Satzes bewertete Opus 5 in jeder Konfiguration bei DRACO 1,9 bis 2,4 Punkte höher, bei HLE 2,2 bis 2,9 Punkte niedriger (Opus 5 bewertete 495 der 500 Fragen, und der Bewerter des Benchmarks bewertete alle 500) und beim Physik-Satz, dessen eigener Bewerter ebenfalls die Referenzlösungen der Experten verwendet, 1,3 bis 2,0 Punkte niedriger. Die beiden Bewerter stimmen in der Richtung jeder Änderung überein. - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. Von Experten verfasste Fragen mit exakten Antworten, bewertet anhand der Referenzantworten. Gemessen auf den ersten 500 Fragen, wobei die eigenen Quellen des Benchmarks für die Suche gesperrt waren, und mit demselben Setup wie in Referenz 21. Jede Konfiguration unternahm drei Versuche pro Frage, durchgeführt vom 8. bis 10. September 2026. Claude Opus 5 vergleicht jede Antwort mit der Referenzantwort, mit aktiviertem adaptivem Nachdenken, wie es standardmäßig der Fall ist. Der Bewerter bewertete in jeder Konfiguration 495 der 500 Fragen, und die Werte beziehen sich auf diese 495. Bei den anderen 5 lag die Bewertungsanfrage über dem 1M-Token-Limit des Bewerters. Ein Versuch, der das Vier-Stunden-Limit erreichte, wurde erneut ausgeführt, und der neue Versuch zählt, sodass jede Konfiguration alle 1.500 Versuche hat. Die 5 nicht bewerteten Fragen mit 0 zu bewerten, wie es die eigene Bewertung des Benchmarks tun würde, ändert keinen Befund.
- Physik-Satz: Ein interner Satz von 70 Physikproblemen auf Forschungsniveau, adaptiert vom öffentlichen CritPt-Benchmark: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. Fachgutachter korrigierten die Problemstellungen. Claude Opus 5 bewertet jede Antwort anhand nicht öffentlicher Referenzlösungen von Experten, daher können die Werte nicht mit veröffentlichten Ergebnissen verglichen werden. Die Punktzahl ist die mittlere Bewertung über die Versuche eines Problems, gemittelt über die Probleme. Gemessen auf allen 70 Problemen, vier Versuche pro Problem, durchgeführt vom 8. bis 9. September 2026. Jeder Agent hatte ein Python-Tool, eine Shell und einen Dateieditor in einem Sandbox-Container ohne Netzwerkzugang und keine Such- oder Fetch-Tools. Ansonsten entspricht das Setup dem von Referenz 21. Für den Physik-Satz wurde vor den Durchläufen keine Toleranz für die Punktzahl festgelegt, daher gibt die Seite die Änderungen seiner Punktzahl mit ihren 95-%-Intervallen an und beschreibt sie nicht als innerhalb einer Toleranz.
Nächste Schritte
Der größte kostenlose Gewinn auf dieser Seite: Einrichtung, Lebensdauern und Diagnose.
Tausche Intelligenz gegen Latenz und Kosten innerhalb eines einzelnen Modells.
Bewerte Fähigkeit, Geschwindigkeit und Kosten über die gesamte Claude-Modellfamilie hinweg.
Gib Agenten-Schleifen einen Token-Countdown, an dem sie sich selbst regulieren.
Setze eine harte Dollar-Obergrenze für eine Managed Agents-Session.
Sieh dir die aktuellen Preise pro Token für jedes Claude-Modell an.
Wende diese Hebel einzeln nacheinander auf einen funktionierenden Agenten in einem ausführbaren Notebook an, mit Kosten pro Aufgabe nach jedem Schritt.
Sieh dir eine Schritt-für-Schritt-Erklärung der Advisor- und Orchestrator-Muster an.
Was this page helpful?