Optimiser le coût et l'intelligence
Équilibrez coût et intelligence sur la Claude Platform, avec des résultats mesurés pour la mise en cache des prompts, l'effort, le choix du modèle, les budgets et les stratégies multi-modèles.
Lorsqu'une charge de travail passe du prototype à la production, le coût devient une contrainte de conception de premier ordre. Le modèle le plus performant peut s'avérer trop coûteux à grande échelle, et le modèle le moins coûteux peut manquer de qualité. Bien gérer les coûts implique de comprendre comment chaque levier de coût affecte la qualité des résultats, car certains leviers se font au détriment de la qualité et d'autres non. La Claude Platform vous donne un contrôle direct sur ce compromis. Vous choisissez le modèle, le niveau d'effort et l'architecture de chaque requête, ce qui vous permet de placer une charge de travail presque n'importe où sur la frontière coût-intelligence.
Le coût et l'intelligence sont généralement représentés comme une frontière où l'un s'obtient au prix de l'autre. Le premier groupe de leviers de cette page rapproche une charge de travail de cette frontière en réduisant le coût sans toucher à la qualité ; seul le second groupe la déplace le long de celle-ci :
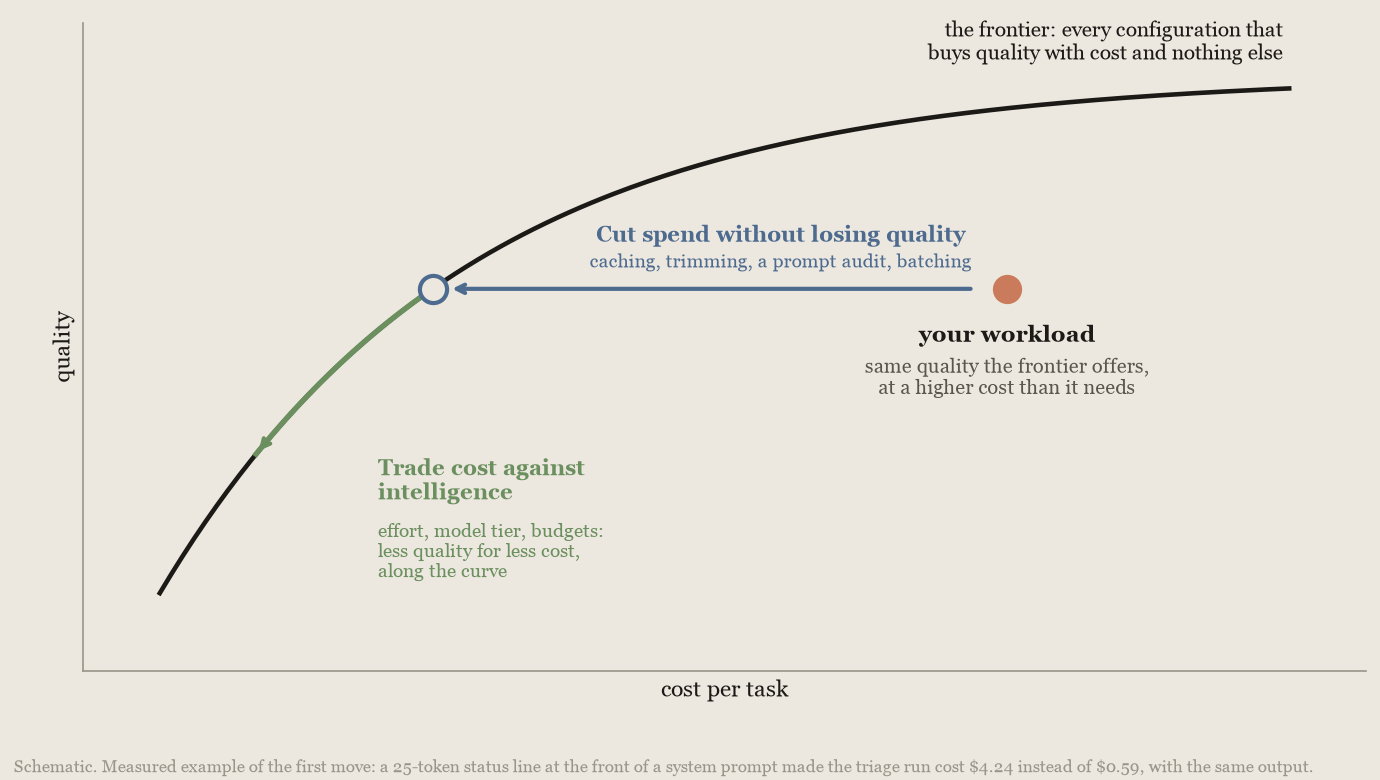
Les leviers sont de deux types :
- Les gains gratuits réduisent les dépenses sans toucher à la qualité : la « prompt caching » (mise en cache des prompts), la « token hygiene » (hygiène des tokens), un audit des prompts par rapport au modèle que vous utilisez, le « batch processing » (traitement par lots) à 50 % de réduction pour le travail qui peut attendre jusqu'à 24 heures, et les limites de dépenses de l'espace de travail comme filet de sécurité.
- Les compromis échangent du coût contre de l'intelligence : le choix du modèle, l'effort, les plafonds de sortie et les budgets de tâche, une horloge du temps écoulé, et les architectures multi-modèles.
Chaque levier s'accompagne de résultats mesurés et de la règle indiquant quand il est rentable. Dans les mesures d'Anthropic, la mise en cache des prompts était de loin le levier le plus important : elle a réduit le coût des boucles d'agent d'un facteur de 2,7 à 5,3 sur les benchmarks de ce guide et a réduit la facture d'un petit agent de triage de 83 %, ou de 88 % en y ajoutant la réduction des entrées. Les leviers multi-modèles ont une portée plus restreinte ; un second modèle s'est avéré rentable sous deux formes, un conseiller et un orchestrateur.
Par où commencer
Trouvez la ligne qui correspond à votre situation.
| Votre situation | Que faire | Où |
|---|---|---|
| Toute charge de travail, tout modèle | Activez la mise en cache des prompts et supprimez les tokens inutiles ; les deux sont gratuits | Mettre en cache le contexte répété · Réduire les tokens |
| Une personne attend entre les tours | Utilisez la durée de cache d'une heure dès qu'environ 1 tour sur 20 suit une pause comprise entre 5 minutes et une heure et que peu d'intervalles dépassent une heure. Sur Claude Fable 5.1, maintenez le cache de 5 minutes actif tant que les pauses durent quelques minutes, et optez pour la durée d'une heure lorsque les pauses approchent l'heure. Sur Claude Opus 5.5, maintenez plutôt le cache de 5 minutes actif lorsque seulement un ou deux tours sur 20 suivent une pause allant jusqu'à environ une demi-heure | Choisir la durée du cache |
| Les coûts sont trop élevés ; la qualité est satisfaisante | Réduisez progressivement l'effort sur votre modèle actuel | Ajuster l'effort |
| Vous n'utilisez pas le dernier modèle | Mettez à niveau ; dans les mesures d'Anthropic, chaque nouveau modèle a résolu au moins autant de tâches que le précédent, généralement pour un coût inférieur par tâche résolue | Mettre à niveau le modèle |
| Vous choisissez ou changez de modèle | Comparez le coût par tâche accomplie, et non par token | Comparer les modèles |
| La qualité n'est pas suffisante | Si vous avez réduit l'effort, rétablissez-le ; sinon, essayez le niveau supérieur avec l'effort low | Ajuster l'effort · Comparer les modèles |
Les tentatives se terminent par stop_reason: max_tokens | Augmentez max_tokens ; 64 000 a couvert tous les tours sauf 2 sur 14 000 mesurés à l'effort par défaut, et 128 000 n'a rien coûté de plus par tâche résolue | Définir des budgets |
| Vous pouvez vérifier les résultats (tests, un vérificateur) | Exécutez tout avec un effort faible et relancez les échecs en high ; sur le benchmark de codage mesuré, le taux de réussite s'est maintenu pour environ la moitié du coût | Relancer les échecs |
| Des boucles d'agent avec quelques exécutions très coûteuses | Définissez un budget de tâche (bêta ; consultez le tableau de prise en charge pour savoir quels modèles), un budget de session Claude Managed Agents et une limite de dépenses de l'espace de travail | Définir des budgets |
| Vous voulez que les exécutions d'agent se terminent plus tôt | Indiquez au modèle que le temps compte et montrez-lui le temps écoulé ; sur DRACO, HLE et un ensemble interne de physique, les exécutions ont pris de 33 % à 69 % de temps en moins pour un coût par tâche inférieur de 28 % à 54 %, avec des scores jusqu'à 1,9 point plus bas | Montrer au modèle le temps écoulé |
| Un modèle moins coûteux ne bloque que sur les décisions difficiles | Ajoutez un conseiller de pointe. Il est rentable lorsque son prix est bien supérieur à celui de l'exécuteur et qu'il est réellement consulté ; évaluez donc d'abord le coût du modèle conseiller seul avec un effort faible et mesurez le taux de consultation | Stratégie du conseiller |
| Le travail dépasse une seule fenêtre de contexte | Déléguez des partitions à des workers moins coûteux | Stratégie de l'orchestrateur |
Ces résultats sont internes à Anthropic (Benchmarks référencés) et indicatifs, et non des garanties ; mesurez donc sur votre propre charge de travail avec la méthode en quatre étapes.
Réduire les dépenses sans perdre en qualité
La mise en cache des prompts, l'hygiène des tokens, le traitement par lots et un audit des prompts par rapport à votre modèle actuel réduisent tous ce que vous payez sans réduire la qualité des résultats. Deux réserves s'appliquent : le traitement par lots échange de la latence contre sa réduction, et l'édition de contexte, un levier d'hygiène des tokens, a coûté plus qu'elle n'a économisé dans l'exécution mesurée dans cette section.
Mettre en cache le contexte répété
Pourquoi la mise en cache vient en premier
Activez la mise en cache des prompts avant tout autre levier, car chaque tour d'une tâche agentique renvoie l'intégralité de la conversation qui s'allonge : l'« system prompt » (invite système), les définitions d'outils et chaque tour précédent. Une tâche de 40 tours envoie son premier tour 40 fois, de sorte que le coût de la tâche croît à peu près avec le carré du nombre de tours. La mise en cache n'arrête pas le renvoi, mais chaque renvoi coûte environ un dixième du prix et est traité plus rapidement : le préfixe est facturé au tarif de lecture du cache, un dixième du prix d'entrée, et chaque tour ne paie le tarif d'écriture en cache de 1,25x que pour ce qui est nouveau.
À quoi ressemble un bon résultat. Sur une journée complète de trafic réel, les boucles d'agent ont lu une médiane de 84 % de leurs entrées depuis le cache, et les 10 % de harnais les plus performants, de codage ou non, ont lu 94 % ou plus17. En profondeur dans une tâche, une boucle bien construite paie le plein tarif sur moins de 1 % de ses entrées. En dessous d'environ 80 %, cherchez ce qui casse le cache (voir Ce qui casse le cache).
Dans l'ensemble des exécutions mesurées par Anthropic, les lectures du cache sont régulièrement la plus grande composante unique du coût d'une tâche, ce qui rend la mise en cache plus précieuse que la plupart des décisions de choix de modèle. Anthropic a évalué le prix des exécutions DeepResearch Bench II7 avec et sans mise en cache :
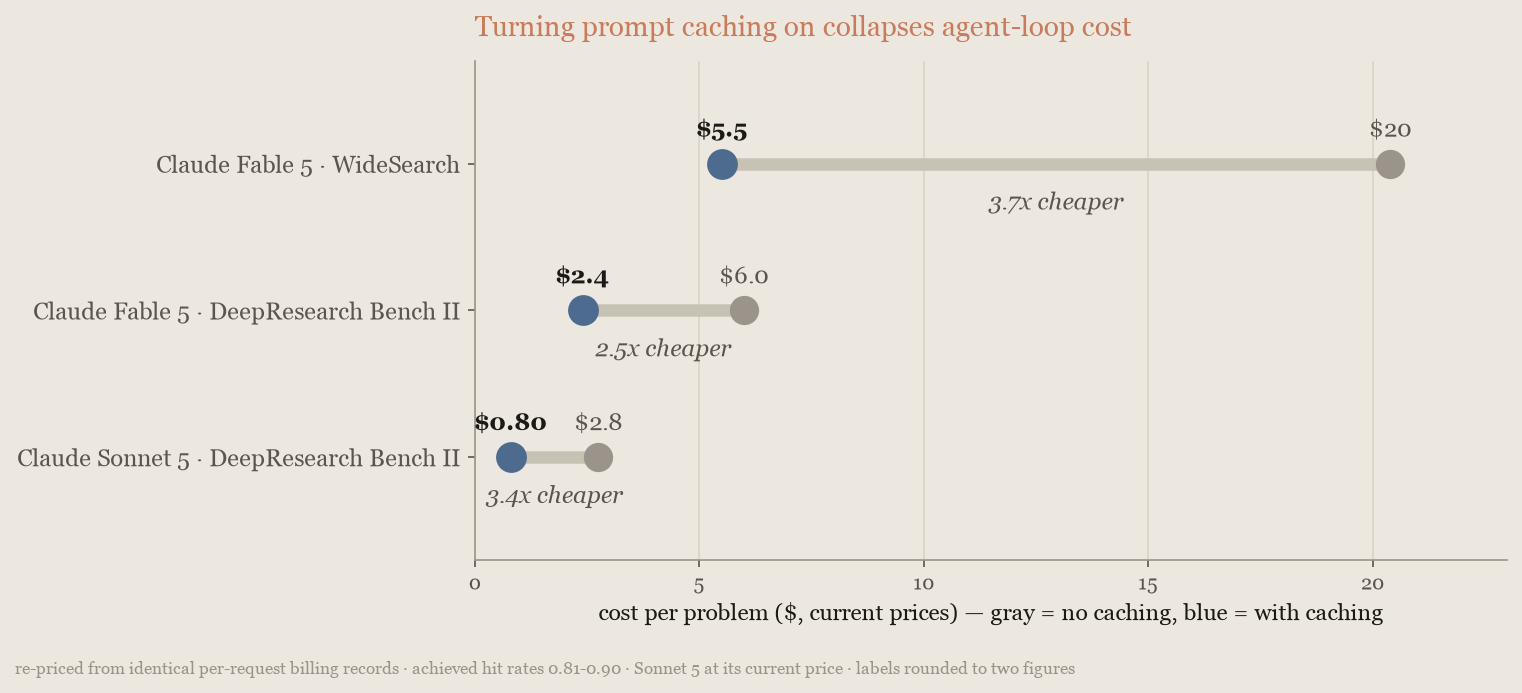
La durée de vie par défaut du cache est de 5 minutes et les tours d'une boucle d'agent sont espacés de quelques secondes, de sorte que la réduction s'applique à la plupart des tokens à chaque tour. Les exécutions du graphique de mise en cache ont lu 79 % à 90 % de leurs tokens d'entrée depuis le cache. L'économie varie avec la profondeur de l'épisode, car les boucles plus courtes relisent moins, mais la mise en cache est restée le levier unique le plus important sur chaque modèle et chaque benchmark mesuré.
Choisir la durée du cache
Si votre boucle attend une personne entre les tours, utilisez la durée de cache d'une heure. Son écriture coûte plus cher (2x le prix d'entrée au lieu de 1,25x). Un « cache miss » (échec de cache), quelle que soit la durée, facture l'intégralité du préfixe au prix d'écriture au lieu du prix de lecture ; la durée plus longue devient donc rentable dès que quelques tours par session suivent une pause comprise entre 5 minutes et une heure.
Pour décider, comptez les intervalles entre les requêtes consécutives d'une conversation :
- Plus d'environ 1 intervalle sur 20 se situe entre 5 minutes et une heure, et les intervalles de plus d'une heure sont rares : utilisez la durée d'une heure. Sur Claude Opus 5.5, lorsque seulement 1 ou 2 intervalles sur 20 se situent dans cette plage et qu'aucun ne dure plus d'environ une demi-heure, maintenez plutôt le cache de 5 minutes actif, avec les requêtes de « keep-alive » (maintien actif) décrites ci-dessous.
- Les tours arrivent à quelques secondes d'intervalle : restez sur la valeur par défaut de 5 minutes. En l'absence de pause, elle a coûté 15 % de moins que le réglage d'une heure sur Claude Sonnet 5 et environ 15 % à 18 % de moins sur Claude Opus 5.5.
- Les intervalles de plus d'une heure sont fréquents : restez sur la valeur par défaut. Un intervalle de plus d'une heure fait expirer les deux durées, et le réglage d'une heure réécrit alors le préfixe à son prix d'écriture plus élevé ; il est donc perdant à chacun de ces intervalles. Parmi vos pauses de plus de 5 minutes, si environ 60 % ou plus dépassent également une heure, restez sur la valeur par défaut ; la durée d'une heure n'est rentable que lorsqu'au moins environ 40 % des longues pauses se terminent dans l'heure.
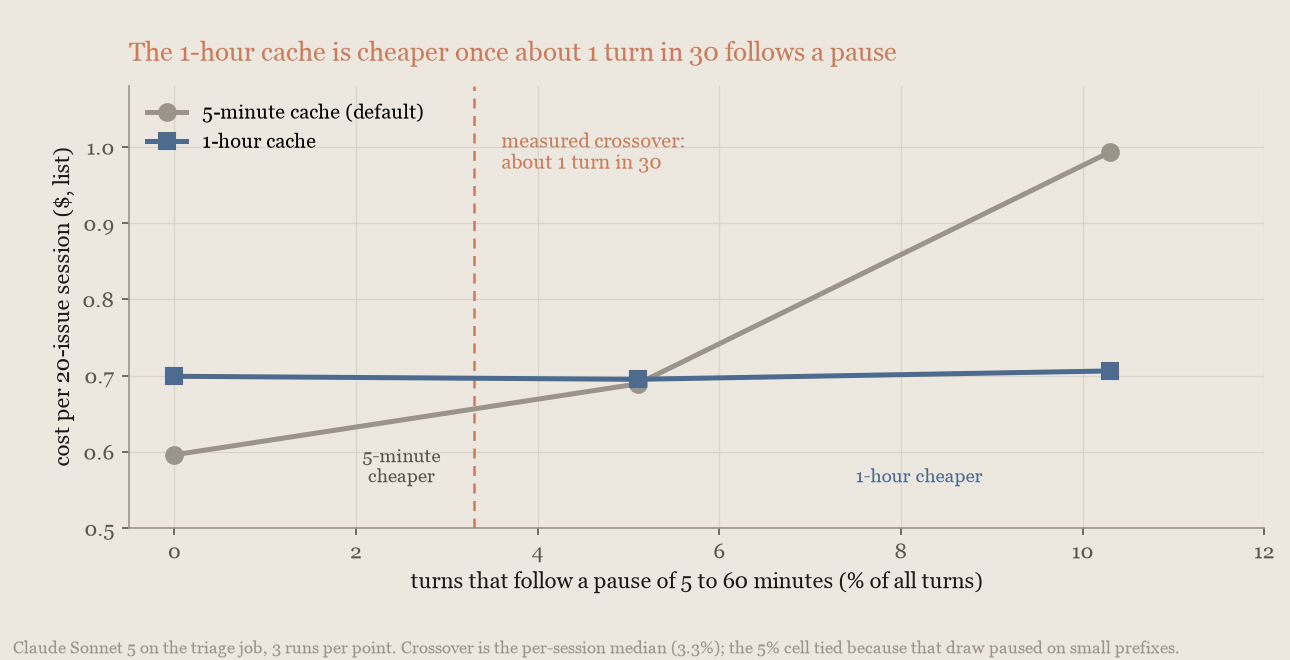
Anthropic a mesuré la tâche de triage de Réduire les tokens d'entrée et de contexte en insérant des pauses avant certains tours pour simuler le délai d'une personne16. Sur Claude Sonnet 5 et Claude Opus 5.5, le cache d'une heure est devenu le réglage le moins coûteux dès qu'environ 1 tour sur 30 suivait une pause ; la règle de 1 sur 20 laisse donc une marge, et l'écart se creuse rapidement au-delà du point de bascule, car chaque tour suivant une pause avec le réglage de 5 minutes réécrit l'intégralité du préfixe. Tous les modèles actuels utilisent les mêmes multiplicateurs d'écriture du cache, et tous les modèles sauf Claude Fable 5.1, Claude Mythos 5.1 et Claude Opus 5.5 le même prix de lecture ; le point de bascule se situe donc dans la même plage sur les autres modèles ; Fable 5.1 est le cas traité ensuite. La précision est restée dans les limites du bruit d'une exécution à l'autre dans chaque cellule. Le tour suivant une pause a conservé sa latence de cache chaud avec le réglage d'une heure (mesuré sur Claude Sonnet 5 et Claude Opus 5, pas sur Claude Opus 5.5). Le graphique suivant représente le coût par session en fonction de la proportion de tours suivant une pause sur Claude Sonnet 5 :
Anthropic a également mesuré des requêtes supplémentaires qui maintiennent le cache de 5 minutes actif. Sur Claude Sonnet 5, elles ont coûté environ 8 % de moins que la durée d'une heure lorsque 1 tour sur 20 suivait une pause, mais à peu près autant à 2 sur 20 ; sur Claude Opus 5, le modèle Opus précédent, elles n'ont rien fait économiser de mesurable. Avec une pause de 6 minutes ou plus avant chaque tour, elles ont coûté plus cher sur les deux modèles. Comme l'économie sur Claude Sonnet 5 avait disparu à 2 tours sur 20, utilisez plutôt la durée d'une heure sur Claude Sonnet 5 et Claude Opus 5.
Sur Claude Fable 5.1, le réglage le moins coûteux est différent. Sa lecture du cache coûte 0,025x le prix d'entrée (0,25 $ par million de tokens) tandis que ses écritures du cache conservent les multiplicateurs standard ; une requête de keep-alive qui relit le préfixe est donc peu coûteuse, et la prime d'écriture de la durée d'une heure représente la facture la plus élevée. Anthropic a mesuré la tâche de triage sur Claude Fable 5.1 avec les trois mêmes réglages19. Maintenir le cache de 5 minutes actif a coûté de 13 % à 20 % de moins par session que le cache d'une heure chaque fois que les pauses duraient quelques minutes ; ce n'est qu'avec des pauses proches de 45 minutes que le cache d'une heure l'a emporté, d'environ 12 cents par session. Sur Claude Fable 5.1, maintenez le cache de 5 minutes actif lorsqu'une personne s'absente quelques minutes, et optez pour la durée d'une heure lorsque les pauses approchent l'heure :
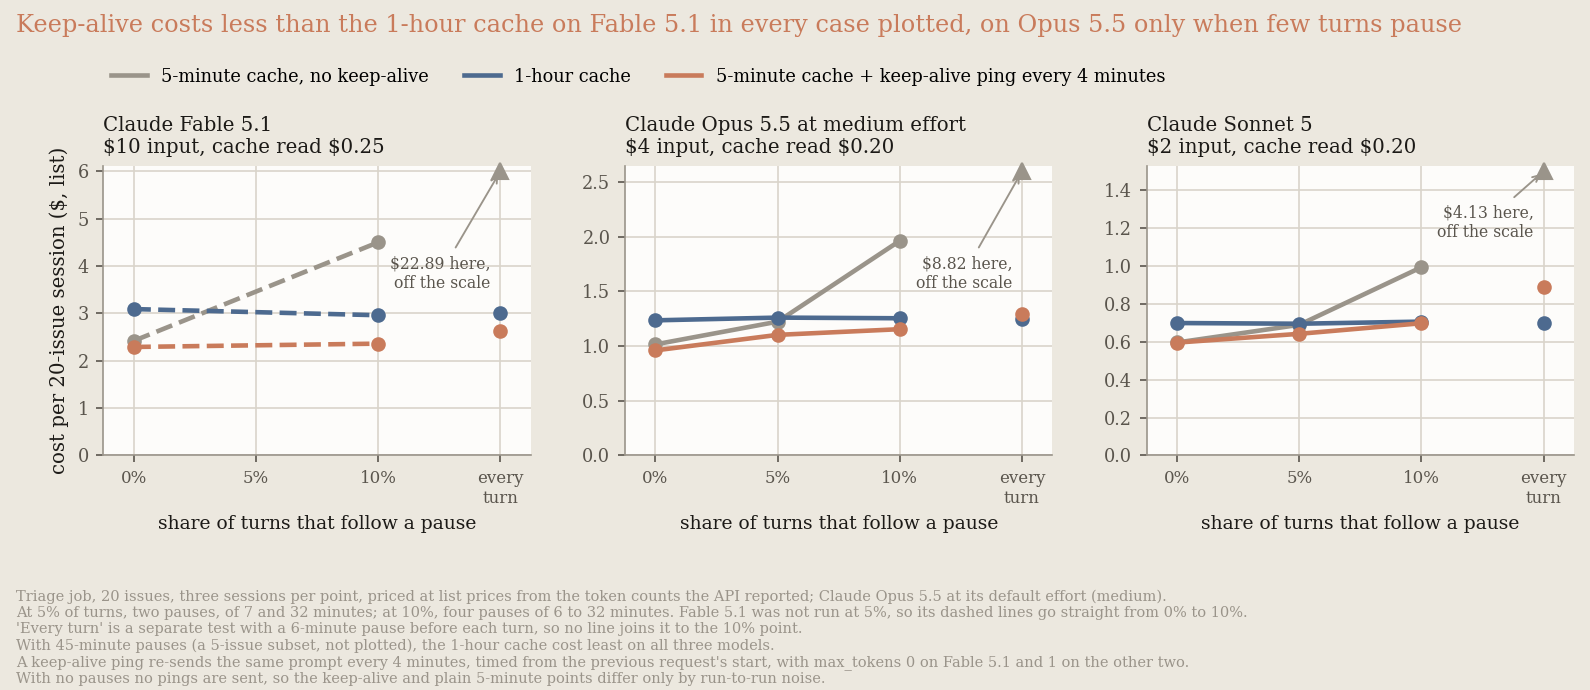
Sur Claude Opus 5.5, dont la lecture du cache coûte 0,05x le prix d'entrée, les requêtes de keep-alive ont coûté de 8 % à 13 % de moins que la durée d'une heure lorsque 5 % ou 10 % des tours suivaient une pause de 6 à 32 minutes (à l'effort par défaut, medium ; de 10 % à 18 % de moins en high), mais davantage avec une pause avant chaque tour : environ 4 % à 6 % de plus avec des pauses de 6 minutes, jusqu'à plus de 50 % de plus avec des pauses de 45 minutes. Ainsi, sur Claude Opus 5.5, maintenez le cache de 5 minutes actif lorsque seulement un ou deux tours sur 20 suivent une pause allant jusqu'à environ une demi-heure, et sinon suivez la liste au début de cette section. Ces mesures envoyaient les requêtes de keep-alive avec max_tokens: 1. Pour la requête max_tokens: 0 décrite ci-après, les tests d'API d'Anthropic antérieurs au lancement sur Claude Opus 5.5 montrent qu'elle écrit le cache et que la requête suivante le lit ; la question de savoir si elle rafraîchit une entrée existante n'a pas été mesurée sur Opus 5.5.
Pour maintenir le cache actif, renvoyez la requête précédente avec max_tokens défini à 0 dans les 4 minutes suivant le début de la requête précédente, puis toutes les 4 minutes, en supprimant stream s'il était défini. Comptez à partir du début de la requête, et non de la fin de sa réponse : la durée de vie de 5 minutes du cache court à partir du début de la requête qui a écrit ou rafraîchi l'entrée, de sorte que le temps passé à générer la réponse est décompté. Il s'agit de la requête de préchauffage : elle rafraîchit la durée de vie du cache, ne génère rien et ne facture que la lecture du cache. Ne modifiez pas un seul octet du préfixe, et n'utilisez pas max_tokens: 1, qui échantillonne un token sans raison. Renvoyez les en-têtes de la requête ainsi que son corps : si vos requêtes comportent un en-tête anthropic-beta (pour un budget de tâche, par exemple), la requête de keep-alive a besoin du même en-tête, sinon les champs soumis à la bêta dans le corps renvoyé sont rejetés. Une requête max_tokens: 0 est rejetée lorsque la requête définit thinking.type: "enabled" (la réflexion adaptative par défaut sur Claude Fable 5.1 ne pose pas de problème), des sorties structurées ou un choix d'outil forcé (ses limitations) ; pour ces charges de travail, optez plutôt pour la durée d'une heure. Une requête max_tokens: 0 est également rejetée lorsqu'elle comporte le paramètre compaction de premier niveau ; ne renvoyez donc pas une requête de compaction issue de la compaction à la demande comme requête de keep-alive.
# Dans les 4 minutes suivant le début de la dernière requête (le temps de génération est décompté
# de la durée de vie du cache), renvoyez cette requête avec max_tokens défini à
# 0, en retirant stream (une requête max_tokens: 0 ne peut pas utiliser le streaming). Envoyez les mêmes
# en-têtes que la requête d'origine, y compris tout en-tête anthropic-beta.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Activer la mise en cache
La configuration demande peu de travail. La mise en cache automatique place les points d'arrêt pour vous ; sinon, la skill Claude API livrée avec Claude Code peut ajouter la mise en cache à une intégration existante à partir d'un seul prompt. L'extrait suivant montre la skill l'ajoutant au harnais qui a produit ces mesures :
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Ces placements de points d'arrêt suivent le modèle standard décrit dans Points d'arrêt de cache explicites.
Ce qui casse le cache
Plusieurs éléments peuvent casser votre cache au cours d'une tâche. Tout ce qui change à chaque requête, comme un horodatage ou une position dans une file d'attente, placé avant le préfixe stable transforme chaque requête en écriture complète du cache : lors de l'exécution de triage de Réduire les tokens d'entrée et de contexte, une ligne d'état de 25 tokens au début de l'invite système a coûté 4,24 $ par exécution au lieu de 0,59 $, soit plus qu'une exécution sans mise en cache. Placez le texte propre à chaque requête dans le tour utilisateur le plus récent.
Le cache est une correspondance de préfixe exacte à l'octet près sur la requête, dans l'ordre (outils, puis invite système, puis messages) ; une modification à n'importe quel endroit invalide donc tout ce qui suit. Modifier effort ou la configuration de réflexion entre les requêtes invalide le cache à partir de ce point, et sur certains modèles également les outils et l'invite système qui le précèdent ; toute modification de l'invite système invalide le cache à partir de ce point ; définir ou modifier un format de sortie invalide le cache pour toute la conversation ; ajouter, supprimer ou réordonner une définition d'outil l'invalide entièrement. La page mise en cache des prompts répertorie ces cas, à l'exception du format de sortie, traité dans sorties structurées. Sur les modèles les plus récents, modifiez les instructions avec un message système en cours de conversation, un message {"role": "system"} ajouté à messages, au lieu de modifier le champ system de premier niveau : le préfixe mis en cache reste intact. Consultez cette page pour savoir quels modèles le prennent en charge. Sur les modèles qui le prennent en charge, un changement d'effort par message laisse également intact le préfixe mis en cache. Les enjeux sont les plus élevés sur Claude Fable 5.1 et Claude Mythos 5.1, où une rupture réécrit le préfixe à 1,25x le prix d'entrée au lieu de le lire à 0,025x. Sur un préfixe de 100 000 tokens, un tour cassé y coûte 1,25 $ au lieu de 0,03 $, soit 50 fois la lecture ; sur Claude Opus 5.5, il coûte 0,50 $ au lieu de 0,02 $, soit 25 fois, et sur les autres modèles actuels 12,5 fois.
Anthropic a mesuré cela sur les longues sessions de l'agent de triage18. Un changement d'effort et un outil ajouté en cours de session ont réécrit 39 000 et 60 000 tokens mis en cache, et ces sessions ont coûté 0,95 $ par session. Les deux mêmes changements sur la première requête après la compaction ont coûté 0,75 $, et sur la requête qui a déclenché la compaction 0,92 $, car la passe de résumé de la compaction a alors retraité le contexte de 81 000 tokens au prix d'écriture du cache : cette passe de résumé a coûté 0,21 $, contre 0,04 $ lorsque les mêmes changements intervenaient une requête plus tard, avec une précision dans les limites du bruit d'une exécution à l'autre dans chaque bras :
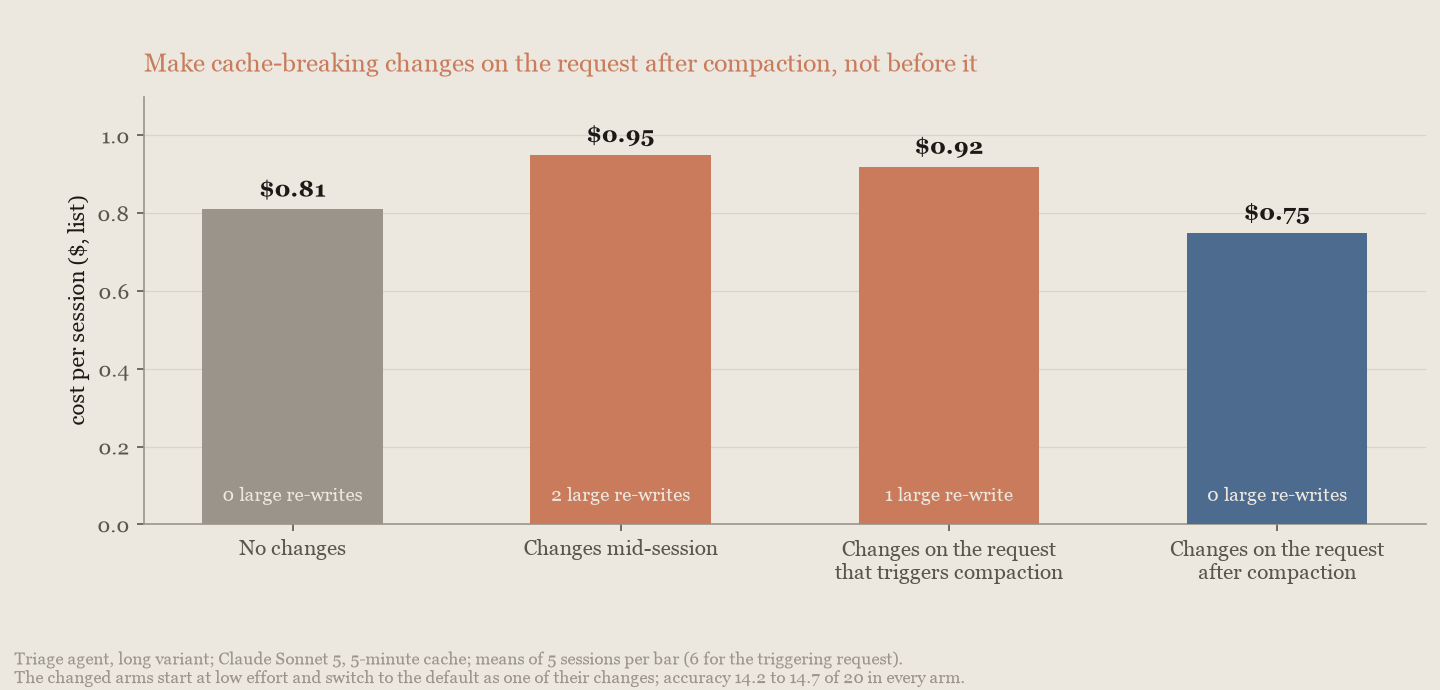
Modifier un budget de tâche en cours de route invalide tout préfixe mis en cache qui contient la valeur du budget ; définissez-le donc une seule fois, sur la première requête. Chaque passe d'édition du contexte invalide le préfixe à partir du point qu'elle efface, et la requête suivante paie pour remettre en cache tout ce qui suit ; effacez donc en quelques grands lots plutôt qu'en de nombreux petits. Sur Claude Fable 5.1 et Claude Mythos 5.1, chacun de ces éléments coûte 50 fois le prix de lecture par token ; c'est donc là qu'ils comptent le plus. Effectuez chaque modification invalidant le cache lors de pauses naturelles, puis vérifiez que les lectures du cache n'ont pas baissé ; si c'est le cas, les diagnostics du cache indiquent où le préfixe a divergé.
Réduire les tokens d'entrée et de contexte
La plupart des requêtes d'agent transportent des tokens qui n'influencent jamais la réponse. Les supprimer coûte rarement en qualité de sortie, même si tous les leviers présentés ici n'ont pas permis d'économiser lors des mesures. Deux endroits à examiner :
- Réduction des entrées. Le filtrage dynamique de l'outil de récupération web écarte le contenu passe-partout (boilerplate) des pages récupérées, le redimensionnement des images ajuste la taille des entrées visuelles, et la « tool search » (recherche d'outils) avec chargement différé ne charge les définitions d'outils qu'en cas de besoin (mesuré plus loin dans cette section). L'appel d'outils programmatique permet à Claude d'exécuter plusieurs appels d'outils depuis du code afin que seul le résultat filtré entre dans le contexte ; sa documentation fait état de 24 % de tokens d'entrée en moins sur les benchmarks de recherche agentique, avec un score plus élevé. Gérer le contexte des outils compare la recherche d'outils, l'appel d'outils programmatique, la mise en cache des prompts et l'édition du contexte.
- Cycle de vie du contexte. L'édition du contexte efface les résultats d'outils obsolètes, et la compaction automatique avec son seuil empêche les longues boucles de transporter tout leur historique.
Les leviers interagissent avec le cache et entre eux ; jugez-les donc sur leur effet net, et utilisez les diagnostics du cache pour vérifier que votre préfixe mis en cache survit à chaque modification. Anthropic les a mesurés sur un agent de triage de tickets traitant 20 rapports de bogues réels avec captures d'écran provenant d'un dépôt public, ainsi que sur une variante plus longue de la même tâche avec 2,6 fois plus de tokens. Avec la mise en cache activée, la réduction des entrées (redimensionnement des images et recherche d'outils) a retranché 26 % supplémentaires sur l'exécution courte et 21 % sur la longue.
Différer les définitions d'outils inutilisées
Chaque définition d'outil attachée à une requête est une entrée à chaque tour, et quelques serveurs MCP en totalisent des centaines. Anthropic a exécuté l'agent de triage avec ses deux propres outils plus un catalogue de définitions d'outils réelles provenant de serveurs MCP publics, pour un total allant jusqu'à 502 outils, en les chargeant tous ou en marquant les extras defer_loading derrière la recherche d'outils :
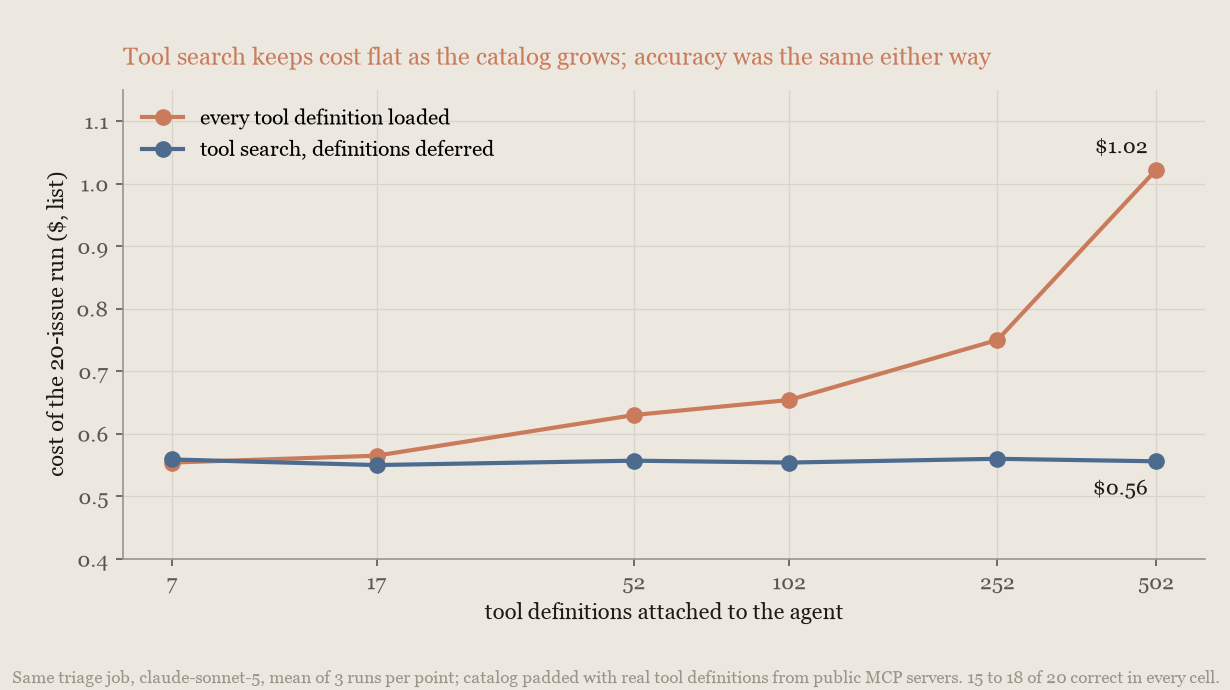
Avec chaque définition chargée, le coût d'exécution a presque doublé à mesure que le catalogue grandissait, suivant les tokens de schéma sur chaque requête. Avec la recherche d'outils, il est resté stable à chaque taille de catalogue, 45 % de moins à 502 outils. La précision était de 15 à 18 sur 20 dans chaque cellule dans les deux cas, et le modèle n'a jamais appelé un mauvais outil, de sorte qu'à cette échelle le catalogue coûte de l'argent, pas de l'exactitude. Il en va de même pour les outils qui passent par le connecteur MCP : avec un serveur MCP GitHub public attaché, différer son jeu d'outils (default_config: {defer_loading: true}) a réduit l'exécution de 20 % à précision égale.
Garder les fichiers de données hors du prompt
Lorsque le modèle doit effectuer des calculs sur un tableau, téléversez-le avec l'API Files et laissez le modèle l'interroger avec l'exécution de code au lieu de le coller. Anthropic a posé 25 questions d'agrégation15 (sommes, comptages filtrés, regroupements et un filtre de date) sur un CSV public de 1 862 lignes, avec les réponses calculées par pandas :
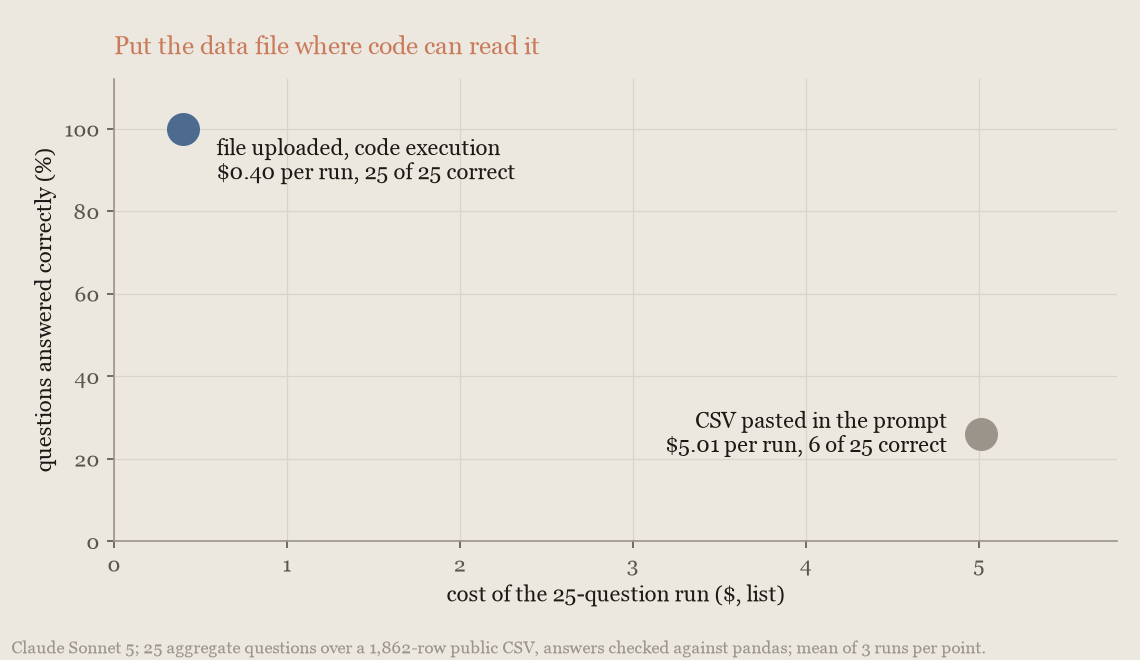
Collé dans le prompt, le tableau représente environ 91 000 tokens d'entrée à chaque requête, et Claude Sonnet 5 a répondu correctement à 6 questions sur 25. Téléversé, avec l'exécution de code, il a répondu aux 25, et l'exécution a coûté environ un douzième du prix. Claude Opus 5 a montré le même schéma.
Gérer le cycle de vie du contexte
Les leviers de contexte ne sont rentables que sur une session assez longue pour en avoir besoin :
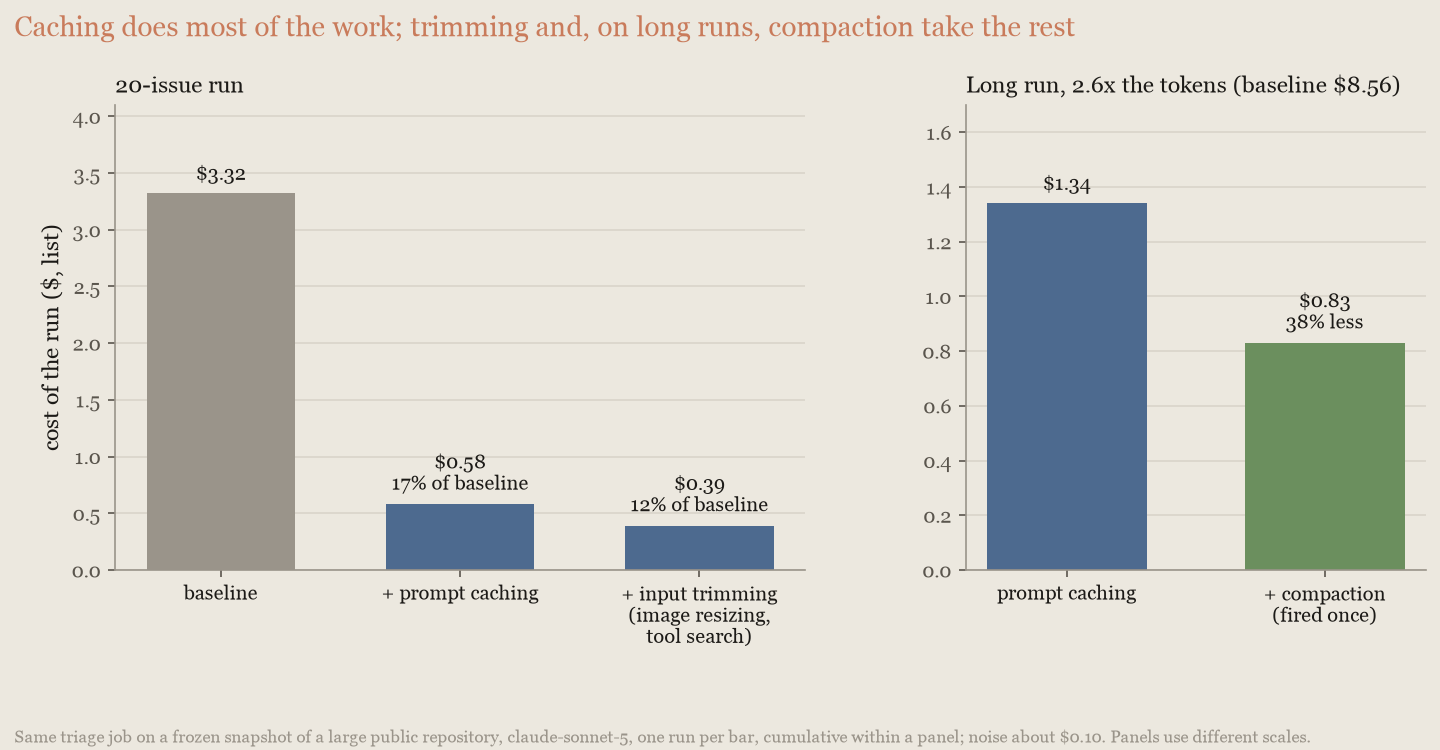
Sur l'exécution de 20 tickets, ils n'ont rien économisé, et l'édition de contexte a coûté 74 % de plus. Sur l'exécution longue, l'élagage a économisé 39 % et la compaction 32 %, tandis que l'édition de contexte n'a rien changé. L'élagage consiste en quelques lignes que vous écrivez vous-même : à chaque frontière de tâche, remplacez les gros résultats d'outils obsolètes par un extrait d'une ligne. Il se met bien en cache car les modifications se trouvent à la fin de la conversation, là où la tâche suivante ajoute de toute façon du nouveau contenu : 89 % de lectures du cache sur la première requête après une frontière et 81 % sur les requêtes entre les frontières. Sur l'ensemble de l'exécution, l'élagage et l'édition de contexte se mettent en cache à peu près aussi bien. L'élagage est moins cher parce que l'édition de contexte réécrit en milieu de tâche du contenu que l'élagage supprime (environ deux tiers de l'écart) et parce qu'il maintient le contexte à environ la moitié de la taille (l'autre tiers). Si vous utilisez l'édition de contexte, effacez en quelques gros lots. L'élagage, adapté du harnais :
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # limiter les résultats sur une ligne pour garder l'extrait court
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractMettre en lots le travail qui peut attendre
L'API Batch retire 50 % sur chaque token d'une requête, y compris ceux mis en cache, en échange de résultats arrivant à tout moment dans les 24 heures. Faites passer par un lot chaque requête que personne n'attend, et gardez le chemin interactif pour le reste. La mise en lots est le deuxième levier gratuit le plus important après la mise en cache pour le travail d'agent sans surveillance : exécutions d'évaluation, rattrapages et tâches planifiées telles qu'une exécution récurrente de l'agent de triage de tickets de la mesure de réduction des tokens. Elle se combine avec tout ce qui figure sur cette page sauf l'interactivité, mais n'est pas disponible pour les sessions Claude Managed Agents, qui sont interactives par conception (voir Tarification de Claude Managed Agents).
Auditer les prompts par rapport au modèle actuel
Chaque génération de modèle répond différemment aux prompts, de sorte qu'un prompt accumule du texte écrit pour un modèle que vous n'utilisez plus. Le cas habituel est une instruction trop spécifique ajoutée pour compenser un modèle plus ancien : « vérifie deux fois », « sois aussi minutieux que possible », une procédure étape par étape obligatoire ou un bloc-notes de raisonnement fait maison. Un modèle plus récent les suit à la lettre, produisant des tours d'outils supplémentaires et de l'écriture supplémentaire, de sorte que la facture augmente sans gain de précision. Auditer les prompts par rapport au modèle que vous exécutez maintenant, et à nouveau chaque fois que vous changez de modèle, est un gain gratuit.
L'audit est une seule commande. La skill Claude API livrée avec Claude Code dispose d'une commande prompt-audit qui lit les prompts et le code de requête d'un projet et signale ce qui a été écrit pour un modèle différent. Cet extrait raccourci la montre exécutée sur un prompt de service d'assistance et un code de requête contenant ces schémas :
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.La commande propose ensuite ses modifications sous forme de diff (un seul bloc affiché) et liste ce qu'elle a délibérément laissé intact : la fenêtre de remboursement, l'exigence de ton et le niveau de qualité. Vous examinez un correctif, pas une réécriture.
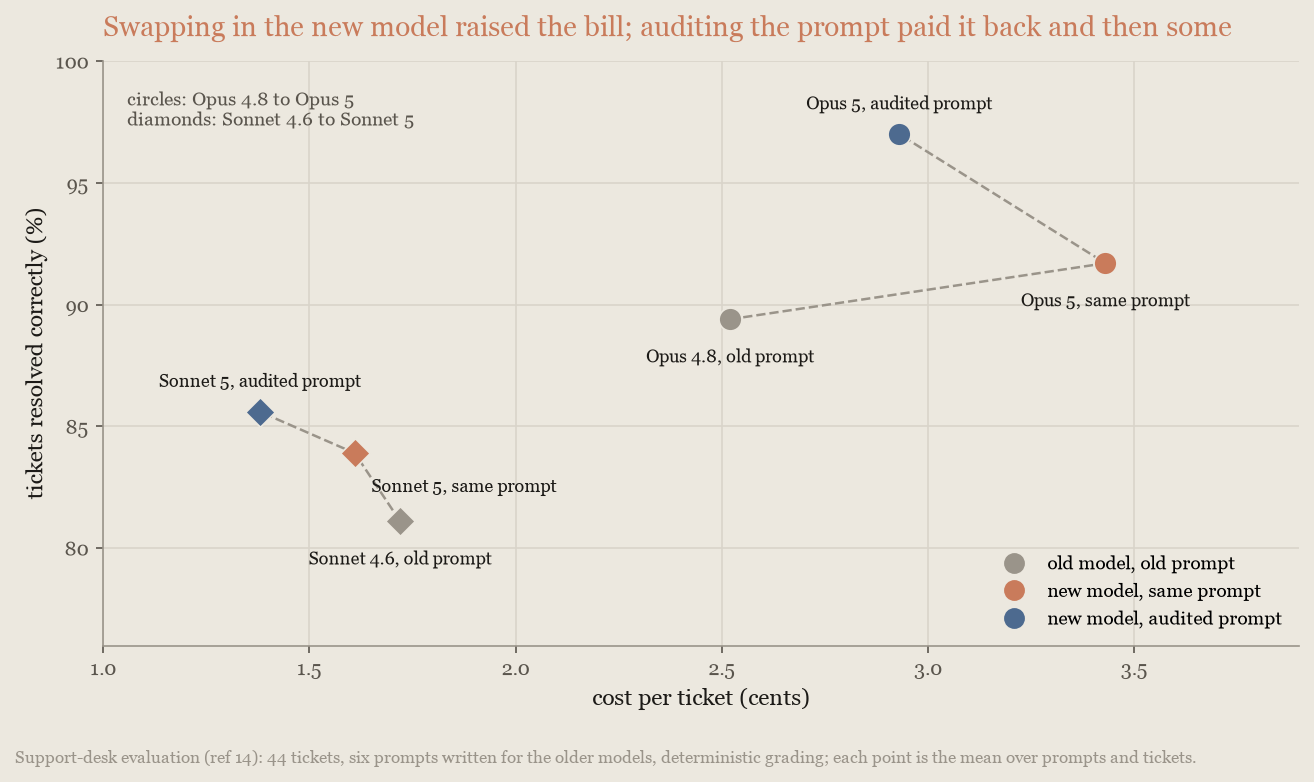
L'effet est mesurable. Sur une évaluation de service d'assistance14, les prompts écrits pour Claude Opus 4.8 ont coûté 36 % de plus par ticket sur Claude Opus 5 sans changement de précision. Exécuter l'audit sur les mêmes prompts a rendu Opus 5 à la fois moins cher que la version non auditée (de 14 %) et plus précis (97 % des tickets, contre 92 %, un gain hors du bruit). Sur la migration de Claude Sonnet 4.6 vers Claude Sonnet 5, l'audit a retiré 14 % à précision égale :
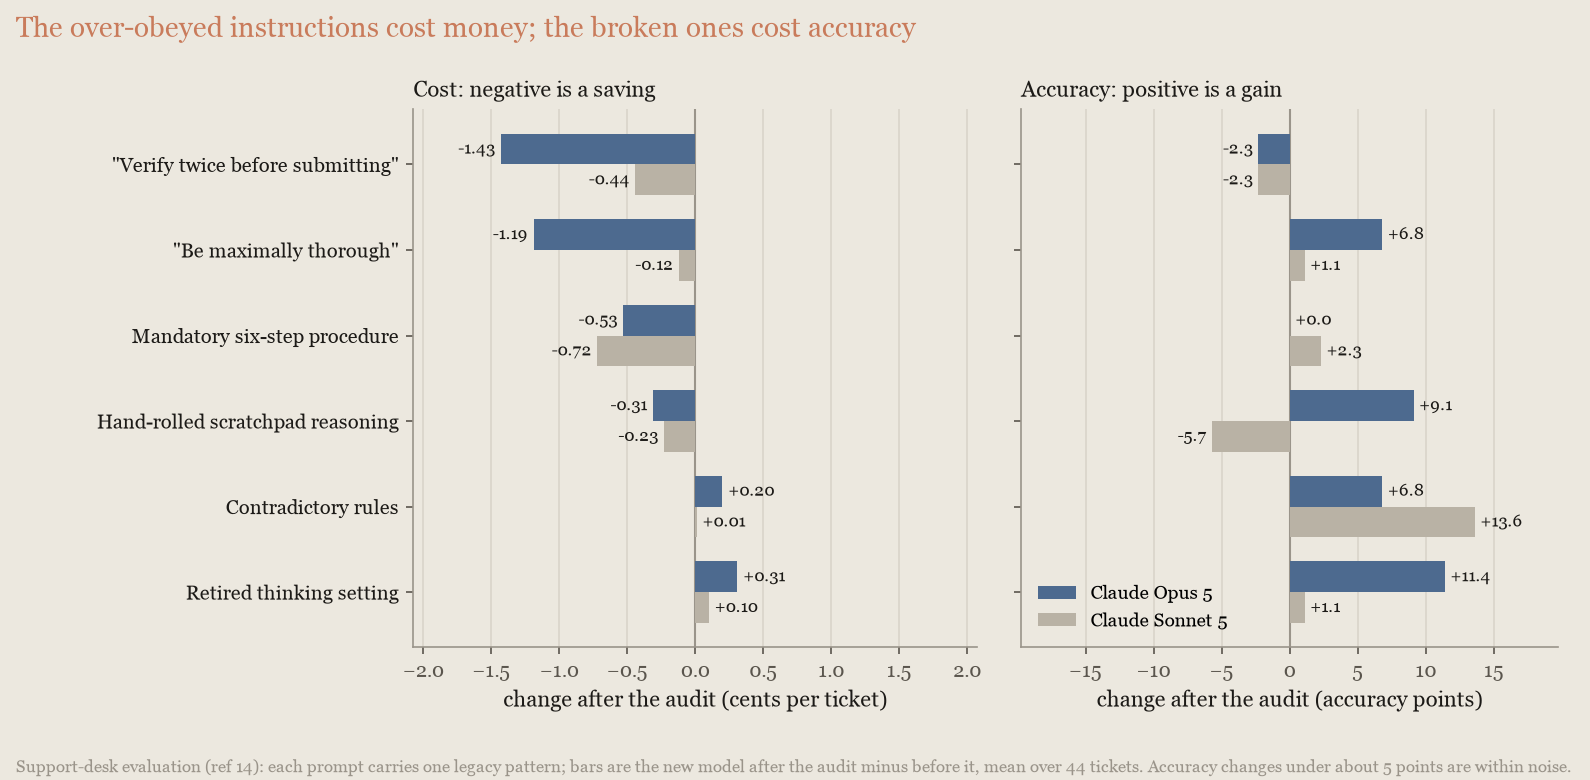
Les deux types de texte obsolète ont des coûts différents. Les instructions que le nouveau modèle suit trop littéralement coûtent de l'argent : supprimer « vérifie deux fois » a réduit d'un tiers le coût par ticket d'Opus 5, et supprimer « sois aussi minutieux que possible » presque autant. Le texte qui ne convient plus au modèle coûte plutôt en précision : un réglage de réflexion retiré, des règles contradictoires et un bloc-notes fait maison qui entre en conflit avec la propre réflexion du modèle ont chacun restauré 7 à 11 points sur Opus 5 une fois supprimés :
Les mêmes schémas ont tendance à apparaître dans les descriptions d'outils et les skills, qui méritent également d'être auditées.
Arbitrer entre coût et intelligence
Ces leviers déterminent où se situe un modèle unique entre coût et intelligence : le choix du modèle, l'effort, la relance des échecs avec un réglage plus élevé, les budgets et plafonds dans lesquels il travaille, et sa capacité à voir combien de temps s'est écoulé. Commencez par un balayage de l'effort sur votre modèle actuel (Ajuster l'effort). Du coût et de la capacité les plus faibles aux plus élevés, les modèles actuels sont Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 et Claude Fable 5.1 (le modèle de pointe) ; la Vue d'ensemble des modèles présente la gamme complète et les prix.
Comparer les modèles sur le coût par tâche
Les grilles tarifaires sont exprimées par token, et par token le modèle de pointe semble coûteux : le prix par token de Claude Fable 5.1 représente plusieurs fois celui de Claude Sonnet 5. Vous payez cependant pour des tâches accomplies ; comparez donc les modèles sur le coût par tâche accomplie. Un modèle plus performant accomplit une tâche avec moins de travail : moins de tours, moins de recherches, moins de relectures de son propre contexte et moins de retours en arrière. La prime par token est souvent largement compensée par le fait de tout faire en moindre quantité.
Anthropic a mesuré cela sur le sous-ensemble SWE-bench Pro3, au prix facturé à un client :
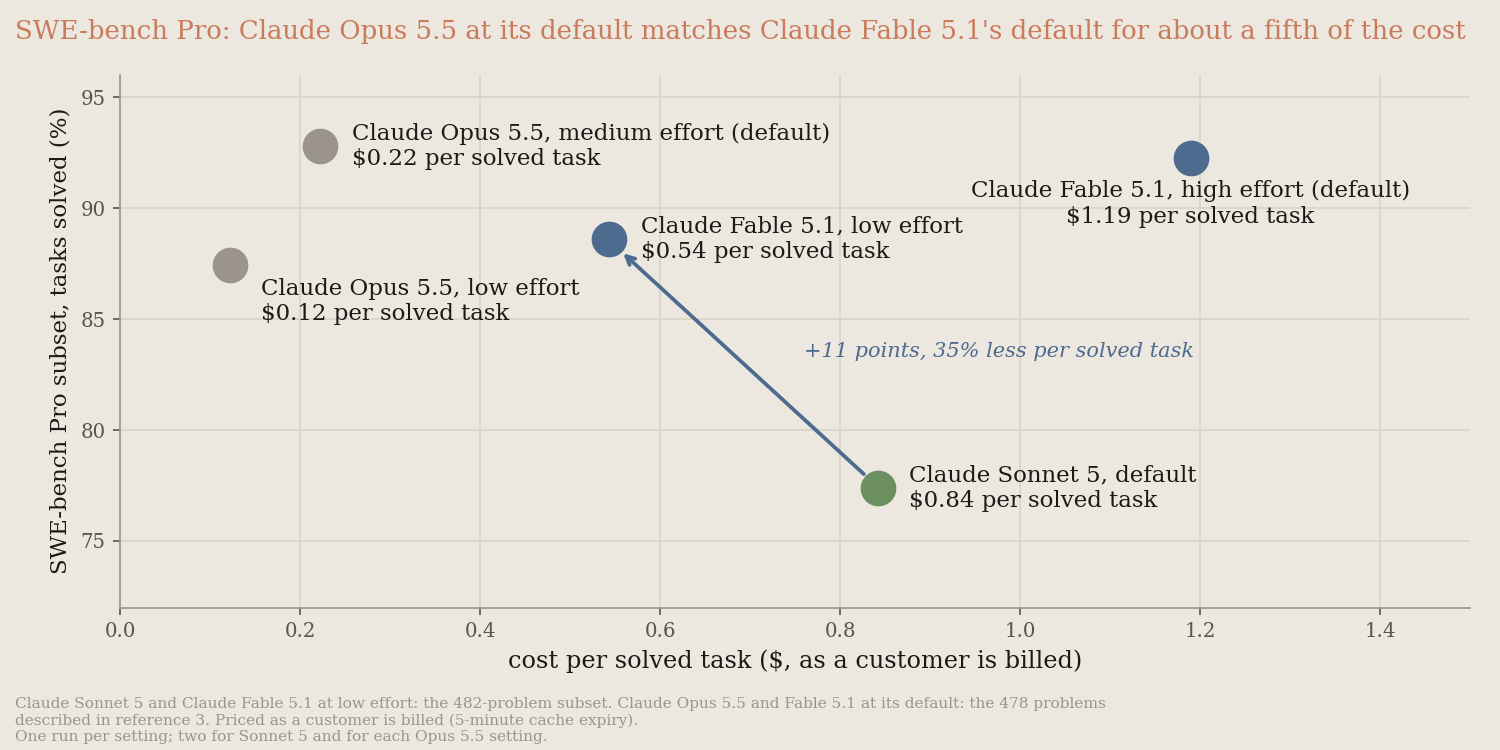
Claude Fable 5.1 avec l'effort low a résolu 88,6 % des tâches pour 0,54 $ par tâche résolue, contre 77,4 % pour 0,84 $ avec Claude Sonnet 5 à son réglage par défaut : 11 points de plus pour 35 % de moins par tâche résolue, malgré un prix par token cinq fois plus élevé. Il ne l'emporte cependant pas toujours. Sur le même sous-ensemble, que Claude Opus 5.5 et Claude Fable 5.1 saturent tous deux en grande partie et dont les scores ne sont pas comparables au classement public, Opus 5.5 à son réglage par défaut, medium, a égalé Fable 5.1 à son réglage par défaut (92,8 % contre 92,3 %, dans les limites du bruit d'une exécution à l'autre) pour environ un cinquième du coût par tâche résolue (0,22 $ contre 1,19 $). En low, Opus 5.5 a résolu 87,4 % des tâches pour 0,12 $. Ces chiffres utilisent les 478 problèmes décrits dans la référence 3. Et sur les longues boucles de recherche, le modèle de pointe fait plus de travail, pas moins : sur DeepResearch Bench II7, Fable 5.1 en low a obtenu 10 points de plus que Sonnet 5 (66 % contre 56 %) pour environ quatre fois le coût par tâche (4,66 $ contre 1,20 $), car il exécute une boucle de recherche plus longue sur un contexte plus large. Claude Opus 5 à son réglage par défaut a obtenu 71 % sur la même base pour 6,71 $ par tâche, au-dessus de Fable 5.1 à son réglage par défaut (65 % pour 7,12 $) ; en recherche aussi, Fable 5.1 ne justifie donc son prix qu'en low.
Pour la plupart des charges de travail d'agent, commencez avec Claude Opus 5.5 à son effort par défaut (medium), et utilisez Claude Fable 5.1 pour le raisonnement exigeant et le travail agentique à long horizon, ou lorsque vos évaluations sur Claude Opus 5.5 avec un effort plus élevé restent insuffisantes. Sur le sous-ensemble SWE-bench Pro, Opus 5.5 à son réglage par défaut a égalé Fable 5.1 à son réglage par défaut pour environ un cinquième du coût par tâche résolue, comme indiqué précédemment. Sur le benchmark de codage de la Stratégie du conseiller, il a obtenu 86,6 % contre 84,2 % pour Fable 5.1 en medium (une seule exécution de Fable 5.1), pour moins d'un tiers du coût par tentative (0,84 $ contre 2,68 $). Sur Chartography13, un benchmark de lecture de graphiques, Opus 5.5 en low a obtenu 68,7 pour environ 0,03 $ par graphique, contre 62,5 pour 0,15 $ avec Fable 5.1 en low et 49 pour 0,16 $ avec Claude Opus 5 en low. À l'autre extrémité, Claude Haiku 4.5 a répondu aux questions de GPQA Diamond9 pour environ un cinquième du coût par question de Claude Opus 5.5, avec une précision de 63 % contre 92 % pour Opus 5.5, et s'est retrouvé bien plus loin derrière sur les longues tâches de codage. Il convient au travail à grand volume dont les résultats sont vérifiables, pas aux longues boucles agentiques.
Le classement s'inverse selon la charge de travail, et aucune grille tarifaire ne vous indique dans quel sens. Évaluez chaque candidat en coût par tâche accomplie sur votre propre trafic, y compris Claude Opus 5.5 à son effort par défaut et le modèle de pointe avec un effort réduit.
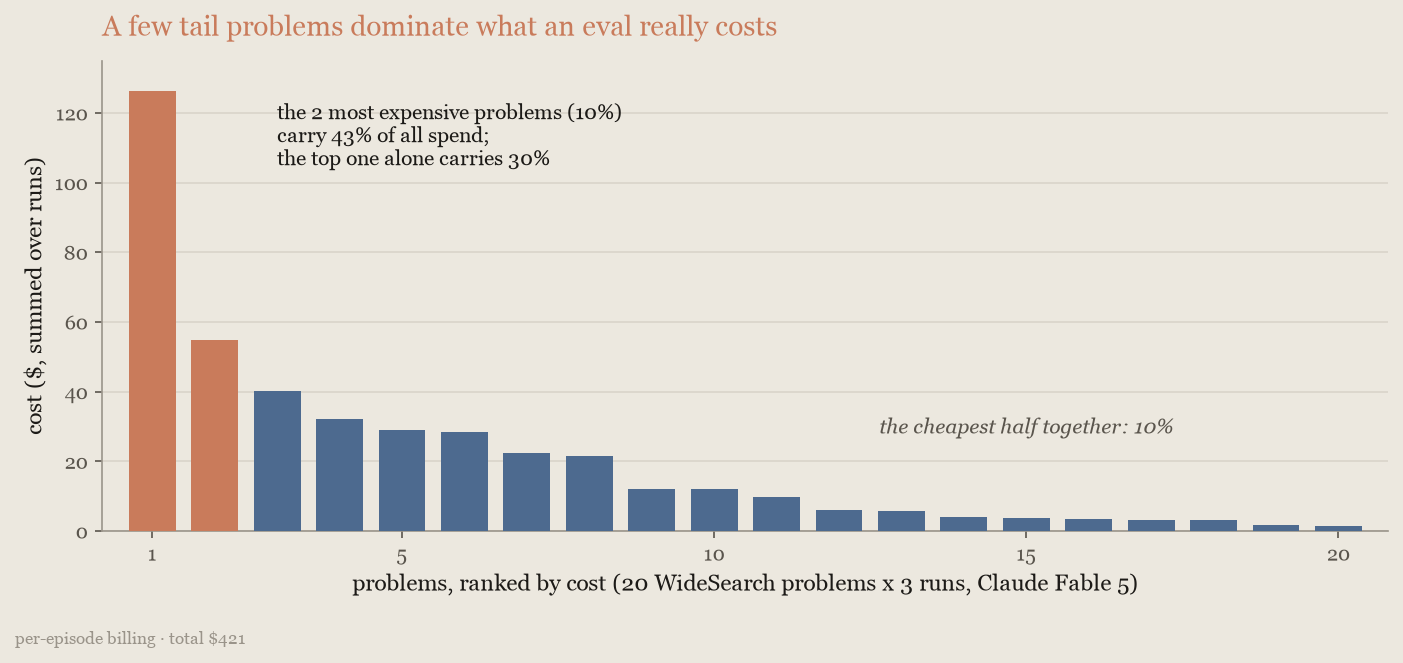
Évaluez le coût de la queue de distribution de votre charge de travail, pas celui de la médiane : comparez les modèles sur le dixième le plus difficile de vos tâches, pas sur la tâche typique. Sur la tâche typique, tous les modèles se ressemblent et le moins coûteux semble le meilleur, mais la facture est déterminée par les tâches sur lesquelles le modèle moins coûteux échoue, car une tâche échouée facture quand même ses tokens, puis la nouvelle tentative, puis tout ce que l'échec coûte en aval. La queue est aussi l'endroit où va l'argent, même lorsque rien n'échoue. Sur une exécution WideSearch1 de 20 problèmes, deux problèmes ont représenté 43 % des dépenses :
Les stratégies multi-modèles existent pour consacrer l'intelligence de pointe à cette queue sans payer les tarifs de pointe pour le reste.
Mettre à niveau le modèle
Si vous avez un ou deux modèles de retard, le levier le moins coûteux est la chaîne du modèle. Anthropic a fait passer les modèles récents Claude Opus, Claude Sonnet et Claude Fable par le même harnais sur le sous-ensemble SWE-bench Pro3, chacun avec ses paramètres par défaut et au tarif catalogue, et a de nouveau exécuté la gamme Opus sur Terminal-Bench 320 :
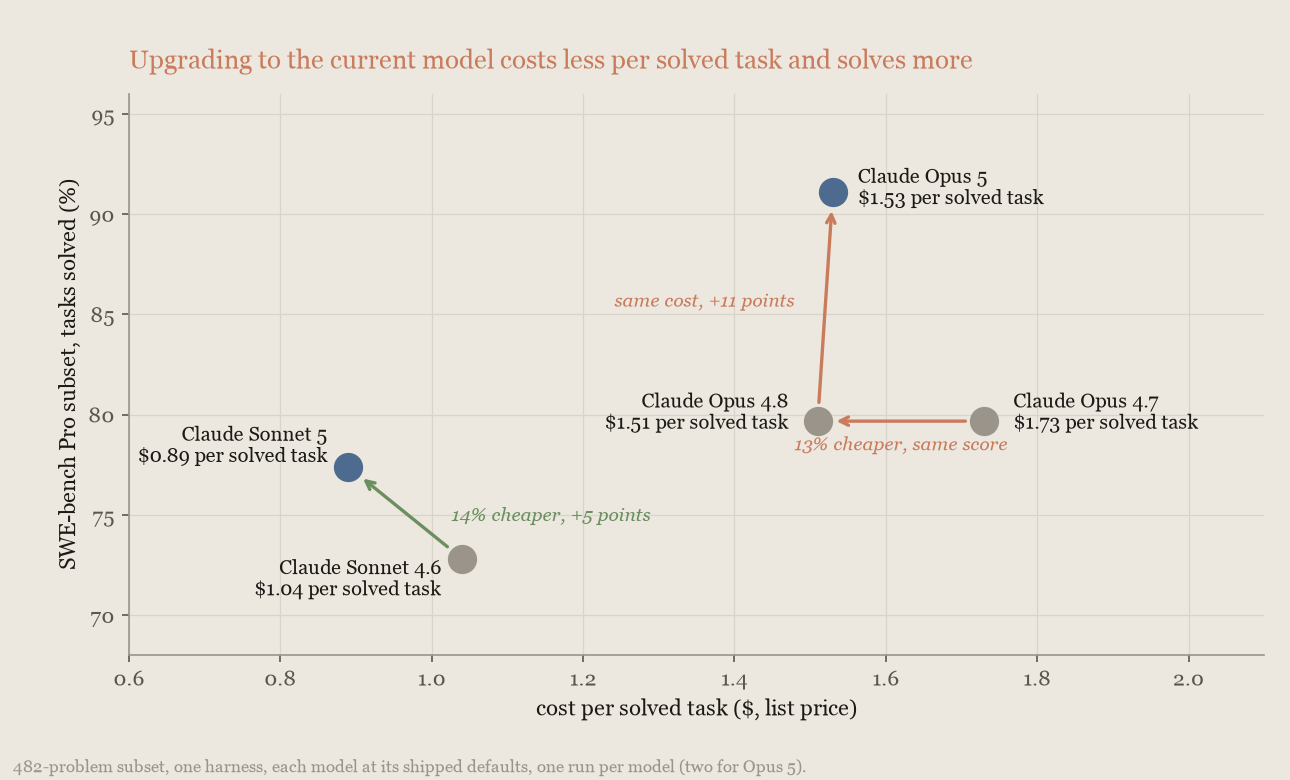
Anthropic applique le même prix par token à Claude Opus 4.7, Opus 4.8 et Opus 5 ; toute différence entre eux provient donc de la quantité de travail que chaque modèle effectue par tâche : au prix facturé à un client, Claude Opus 4.8 résout la même part de tâches que Claude Opus 4.7 pour 14 % de moins par tâche résolue, et Claude Opus 5 résout ensuite 12 points de tâches de plus pour 21 % de plus par tâche résolue. Claude Opus 5 avec l'effort low bat le réglage par défaut d'Opus 4.8 sur ce benchmark pour environ 30 % de son coût par tâche résolue ; la mise à niveau la moins coûteuse est donc le nouveau modèle avec un réglage plus bas. L'économie de Sonnet 5 provient de son prix par token plus bas, qui compense largement les tokens supplémentaires qu'il utilise par tâche par rapport à Sonnet 4.6 : 15 % de moins par tâche résolue pour 5 points de plus. Le niveau de pointe a progressé de la même manière : Claude Fable 5.1 égale le score de Claude Fable 5 pour 43 % de moins par tâche résolue, principalement grâce au prix de lecture du cache plus bas. Cette tendance n'est pas garantie : sur DeepResearch Bench II7, la même mise à niveau coûte 41 % de plus par tâche en high (79 % de plus en low) pour ses 2 à 3 points supplémentaires sur les tâches propres dans chaque bras (référence 7), car le nouveau modèle y effectue plus de travail par tâche. Les prix d'entrée et de sortie sont identiques et la lecture du cache est 4 fois moins chère ; mesurez donc la mise à niveau sur votre propre charge de travail avant de supposer qu'elle fait économiser.
Sur un travail plus difficile, l'écart se creuse. Sur Terminal-Bench 320, où les tâches sont suffisamment difficiles pour que ce soit le taux de réussite plutôt que les tokens qui détermine la facture, Claude Opus 4.7, Opus 4.8 et Opus 5 dépensent chacun de 8 $ à 15 $ par tâche mais résolvent respectivement 7 %, 15 % et 41 % des tâches ; le coût par tâche résolue passe donc de 183 $ à 63 $ puis à 28 $ en montant dans la gamme. La prime de 21 % que Claude Opus 5 présente par rapport à Opus 4.8 sur le sous-ensemble de codage saturé devient une économie de 56 % sur Terminal-Bench 3, où l'ancien modèle échoue la plupart du temps : plus votre charge de travail met en échec l'ancien modèle, plus la mise à niveau fait économiser par résultat.
Comparez sur le coût par tâche résolue, et non par token : le même texte représente environ 30 % de tokens en plus sur Claude Opus 4.7 et les versions ultérieures ; une comparaison par token fait donc, par construction, paraître les modèles plus récents plus coûteux.
Ajuster l'effort
L'effort est le moyen le plus direct d'adapter un modèle à votre tâche. Le paramètre effort détermine la quantité de réflexion, de « tool calling » (appel d'outils) et d'auto-vérification qu'effectue le modèle. high, la valeur par défaut sur la plupart des modèles, convient aux tâches exigeantes ; Claude Opus 5.5 utilise medium par défaut. Le coût augmente avec toute cette activité, mais la précision n'augmente qu'avec la part dont votre tâche a besoin. En dessous du plafond du modèle, les niveaux d'effort les plus élevés paient pour une profondeur que la tâche n'utilise jamais.
Sur les benchmarks de recherche et de travail intellectuel (WideSearch1, DeepWideSearch6, BrowseComp4 et GDPval2, tous avec Claude Fable 5), la courbe de précision en fonction du coût est presque plate : low a cédé 1 à 3 points pour une réduction d'un tiers à la moitié du coût par tâche, medium a égalé la précision du réglage par défaut pour environ 70 % à 87 % de son coût, et le réglage par défaut n'a rien apporté de mesurable par rapport à medium sur aucun des quatre. Sur DeepWideSearch, low a également égalé un orchestrateur doté d'un « worker » (agent subordonné) Claude Sonnet 5, pour un coût inférieur de 29 %. Réduire l'effort a donc fait mieux qu'un changement d'architecture.
Les réglages d'effort plus bas sont souvent plus rapides, ce qui compte lorsque la « latency » (latence) est la contrainte. Dans ces exécutions, low a pris 4,5 minutes par problème sur DeepWideSearch, contre 7,9 minutes avec le réglage par défaut. Le benchmark de corpus a une entrée qui ne tient dans aucune « context window » (fenêtre de contexte) unique. Sur ce benchmark, Fable 5.1 a pris 15,2, 17,5 et 19,9 heures par épisode à low, medium et high.
Le codage à long horizon est le domaine où l'effort améliore réellement la précision. Sur SWE-bench Pro3, par rapport à high, Claude Opus 5.5 a obtenu environ 2,5 points de moins avec son réglage par défaut, medium, pour environ 70 % du coût, et environ 8 points de moins à low pour environ un tiers du coût. À xhigh, il a obtenu environ 1,4 point de plus pour 2,5 fois le coût de high. C'est un véritable compromis, que la relance des échecs avec un effort plus élevé transforme à nouveau en économie. Ce graphique représente la précision en fonction du coût pour les benchmarks de recherche et de travail intellectuel et pour SWE-bench Pro :
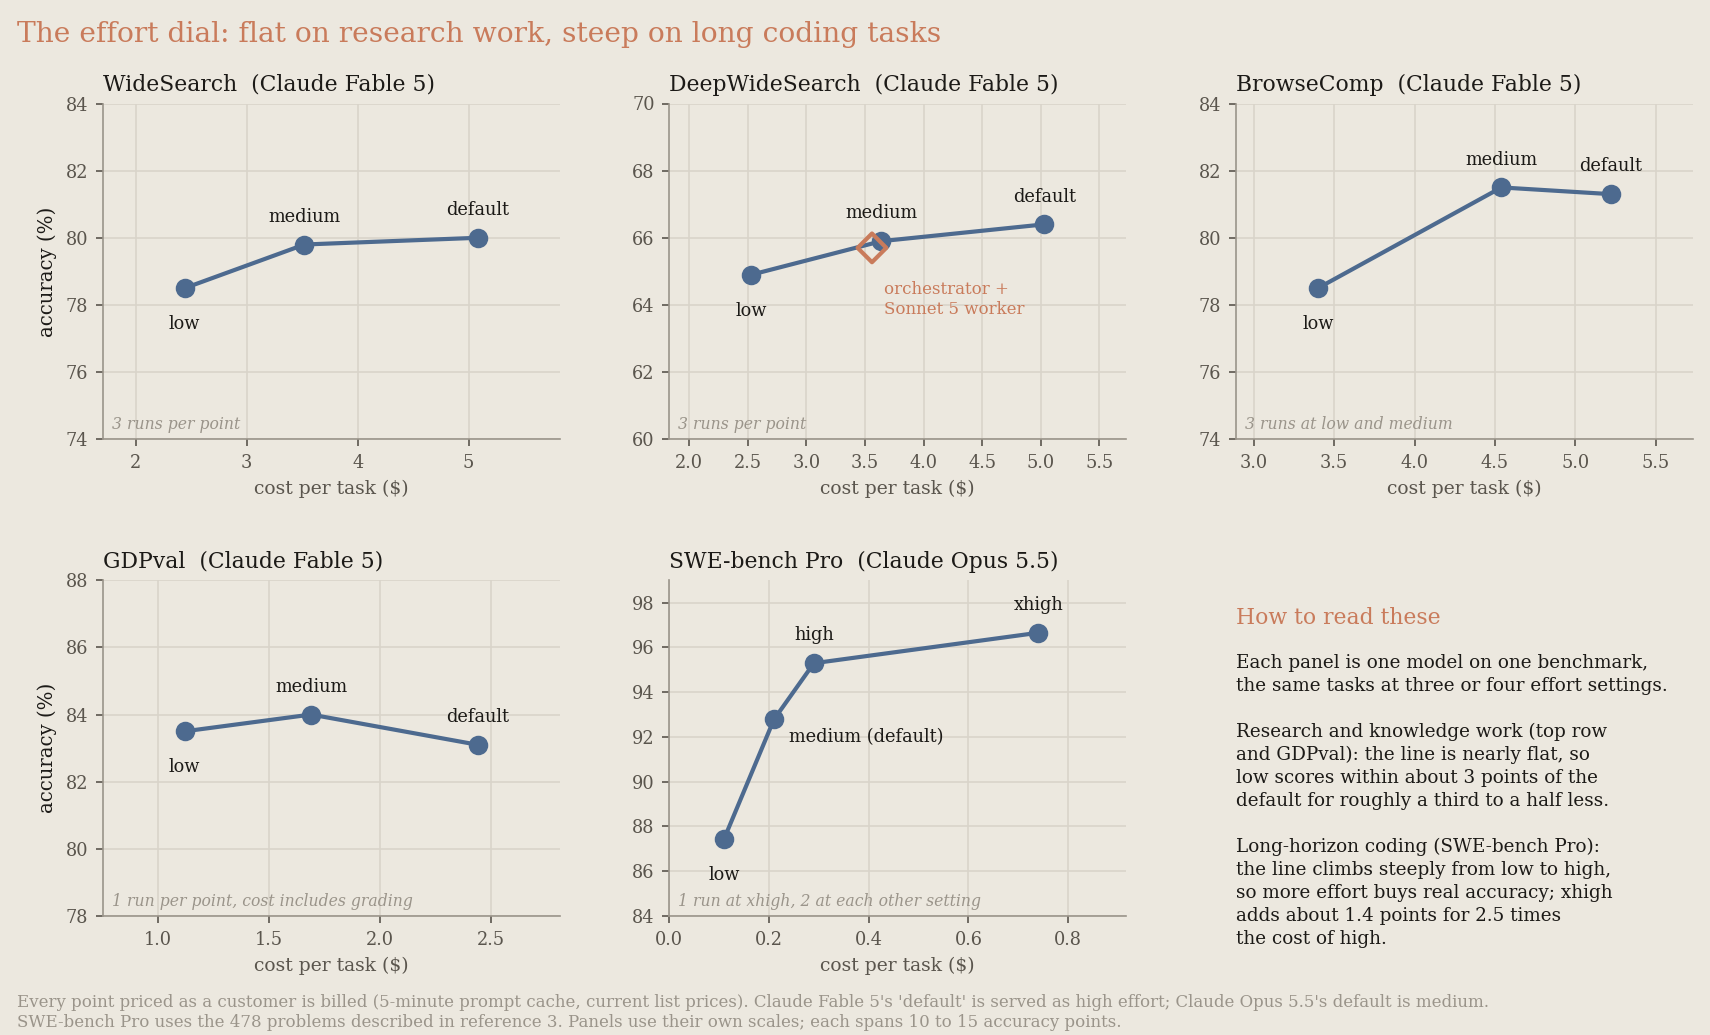
Deux conséquences en découlent. Premièrement, tracez cette courbe pour votre propre charge de travail avant d'ajouter un second modèle. Dans ces mesures internes, une configuration multi-modèles semblait moins chère que le modèle unique par défaut. Elle coûtait pourtant plus que ce même modèle avec un effort plus faible. Deuxièmement, cette courbe constitue la référence à modèle unique que toute stratégie multi-modèles doit battre. C'est pourquoi l'étape 2 de la mesure sur votre propre charge de travail établit la référence sur plusieurs niveaux d'effort.
Un travail difficile ne nécessite pas automatiquement un effort élevé. Sur DeepResearch Bench II7, Claude Fable 5.1 a obtenu presque le même score à low, medium et high, tandis que le coût par tâche passait de 4,66 $ à 7,12 $. Dans ce cas, augmenter l'effort n'améliore donc pas sensiblement la qualité du résultat. Sur les 21 tâches propres dans chaque bras (référence 7), Claude Fable 5 était également stable quel que soit l'effort. Le graphique le montre pourtant en progression, car sa base de 33 tâches exclut les tentatives interrompues de chaque modèle. Mesurez la courbe sur le modèle que vous déployez, et non sur celui que vous avez mesuré en dernier :
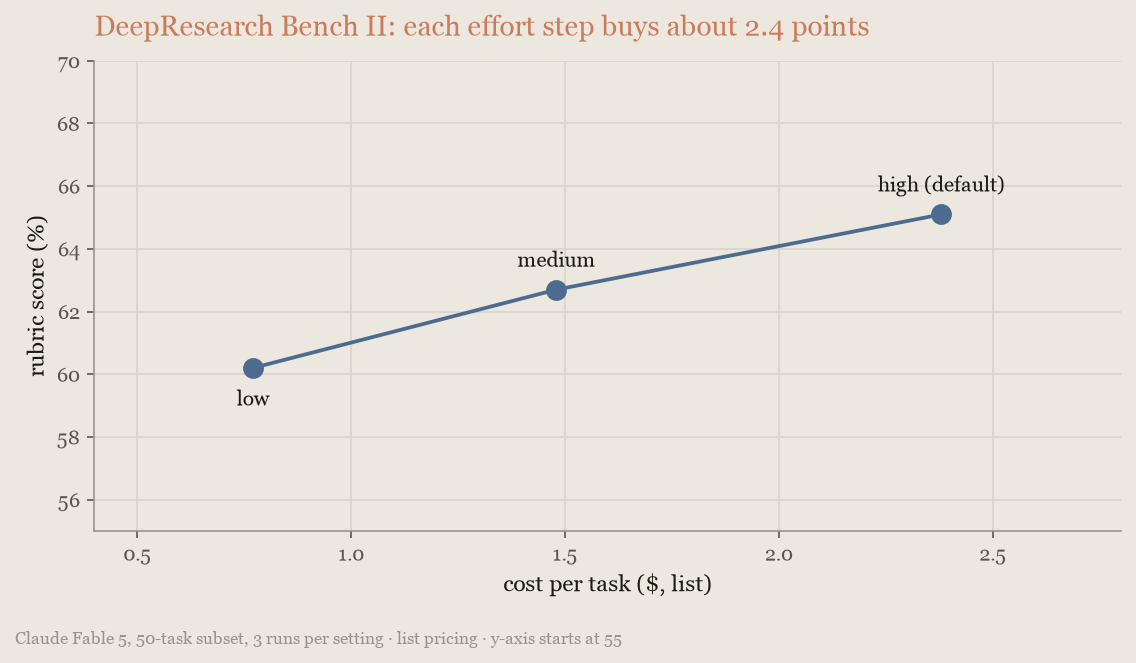
La description de la tâche ne suffit pas à révéler le type de charge de travail dont vous disposez. Balayez donc deux ou trois niveaux d'effort sur un échantillon de votre propre trafic et lisez la réponse sur la courbe. Testez chaque niveau dans une session distincte. Modifier l'effort de niveau supérieur en cours de session invalide le cache (voir Mettre en cache le contexte répété) et fausse la comparaison. Pour les détails du paramètre, consultez Effort.
Relancer les échecs avec un effort plus élevé
Lorsque le résultat d'une tâche est vérifiable, la politique la moins coûteuse sur la courbe d'effort n'est pas un réglage fixe. Exécutez chaque tâche à un réglage bas et réexécutez uniquement les échecs à un réglage plus élevé.
Anthropic a calculé cette politique tâche par tâche à partir des exécutions d'effort sur le sous-ensemble SWE-bench Pro3 de la section Ajuster l'effort. Avec Claude Opus 5.5 à low, 13 % des tâches ont échoué. En réexécutant celles-ci à high, environ 97 % des tâches ont réussi pour environ 0,17 $ chacune. En exécutant tout à high, 95,3 % ont réussi pour 0,29 $. La politique donne donc un taux de réussite légèrement supérieur pour un peu plus de la moitié du coût, en comptant les tentatives bon marché ayant échoué. En commençant plutôt à medium, environ 97 % des tâches ont été résolues pour environ 0,24 $. L'essentiel de ce léger gain provient de la seconde tentative. Réexécuter à high les échecs d'une exécution à high donne à peu près le même score, pour plus d'argent. Utilisez donc cette politique pour l'économie, et non pour le gain :
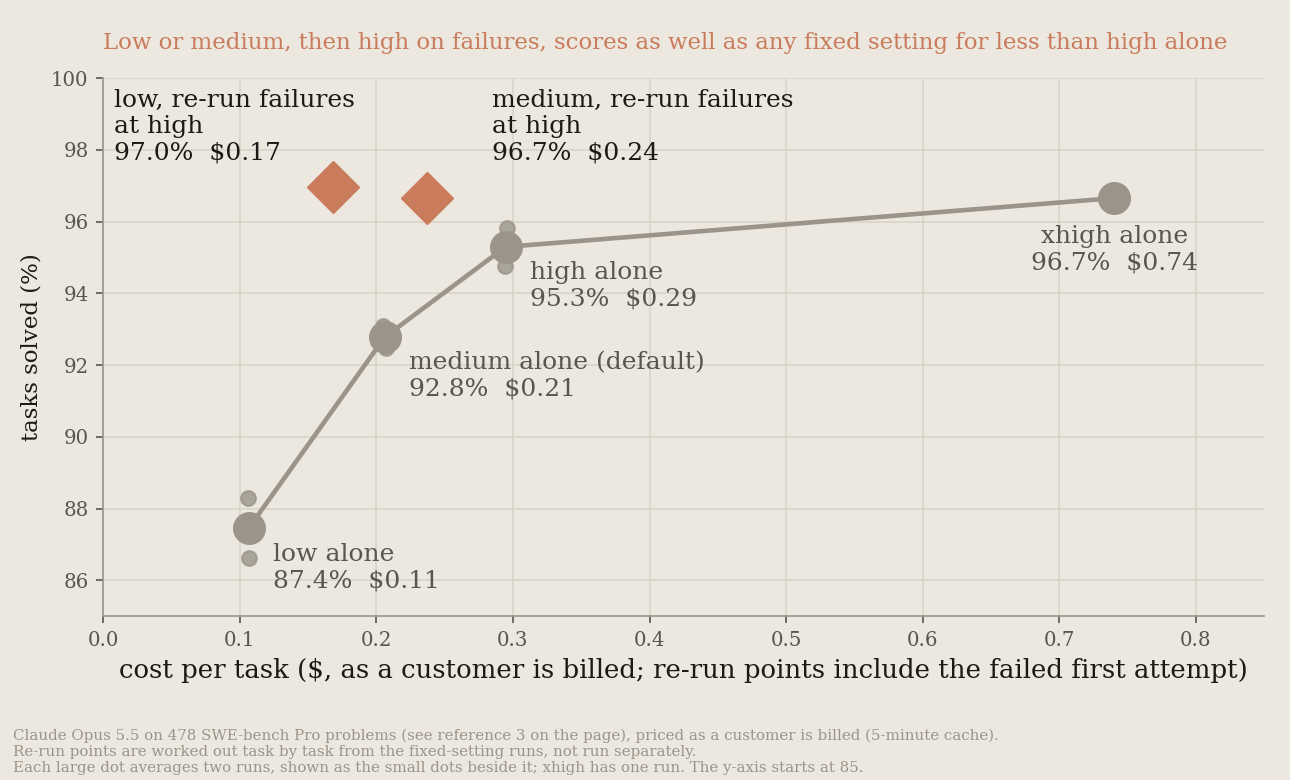
Deux conditions s'appliquent. Premièrement, vous avez besoin d'un signal d'échec (ici, les propres tests du benchmark). Un vérificateur qui valide un mauvais travail laisse passer ces échecs. Deuxièmement, chaque échec de première passe prend le « wall-clock time » (temps réel écoulé) de deux exécutions. L'économie se paie donc en latence sur les échecs.
Définir des budgets et des plafonds de sortie
La plupart des exécutions de tâches agentiques sont peu coûteuses. Une minorité dépense pourtant plusieurs fois le coût médian en recherches, revérifications et tests excessifs. Un « task budget » (budget de tâche) cible cette queue de distribution. Le modèle voit un compte à rebours de tokens en direct pour l'ensemble de la tâche et s'autorégule. Il réduit les recherches peu utiles, saute les vérifications redondantes et conclut au lieu de s'emballer.
Anthropic a mesuré le taux de réussite et le coût par tâche sur SWE-bench Pro3 avec Claude Fable 5.1, à mesure que le budget se resserrait :
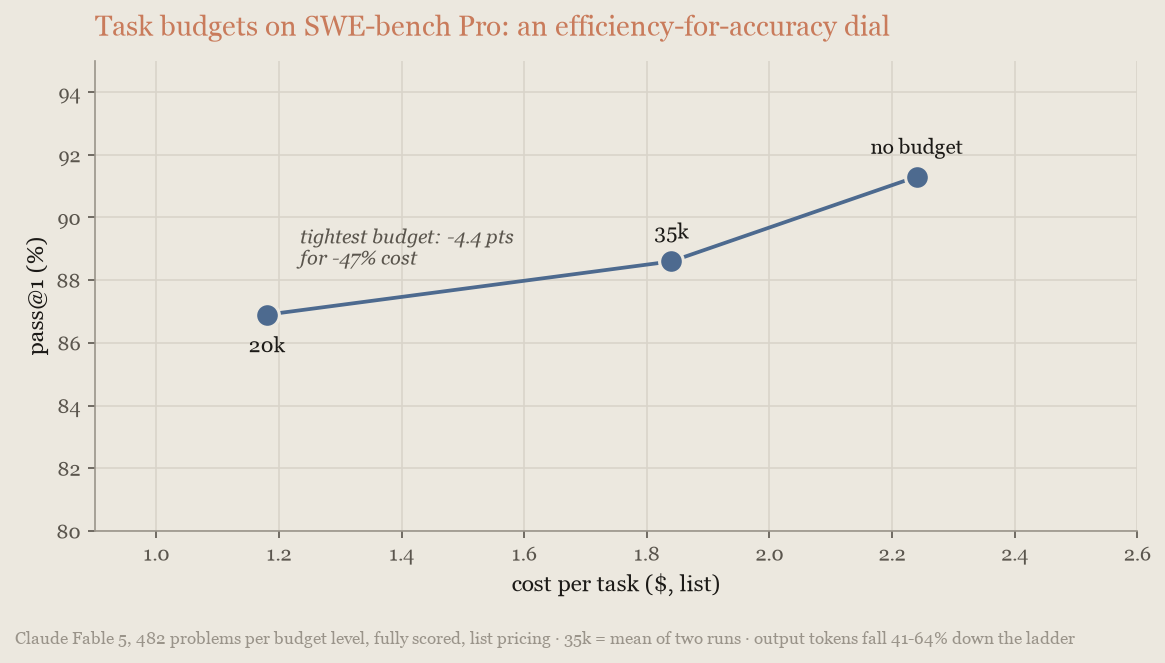
Un budget généreux a réduit le coût par tâche de 44 % pour environ 3 points de taux de réussite, à la limite du bruit d'une exécution à l'autre. Le budget le plus serré autorisé l'a réduit de 58 % pour 6 points. Les budgets ont ici apporté de l'efficacité, au prix d'une perte de taux de réussite qui augmente à mesure que le budget se resserre.
Trois contrôles remplissent trois rôles différents. Un budget de tâche fait économiser de l'argent, car le modèle le voit. max_tokens est un plafond de sécurité : l'abaisser a réduit le coût par tentative sans réduire le coût par tâche résolue. Sur Claude Managed Agents, un budget de session est l'arrêt ferme en dollars derrière les deux. Définissez les trois : un budget de tâche, un max_tokens élevé et un plafond de session pour l'exécution que vous ne voulez jamais voir sur une facture. Ajoutez une limite de dépenses de l'espace de travail comme ultime filet de sécurité.
- Les budgets de tâche sont en bêta (en-tête bêta
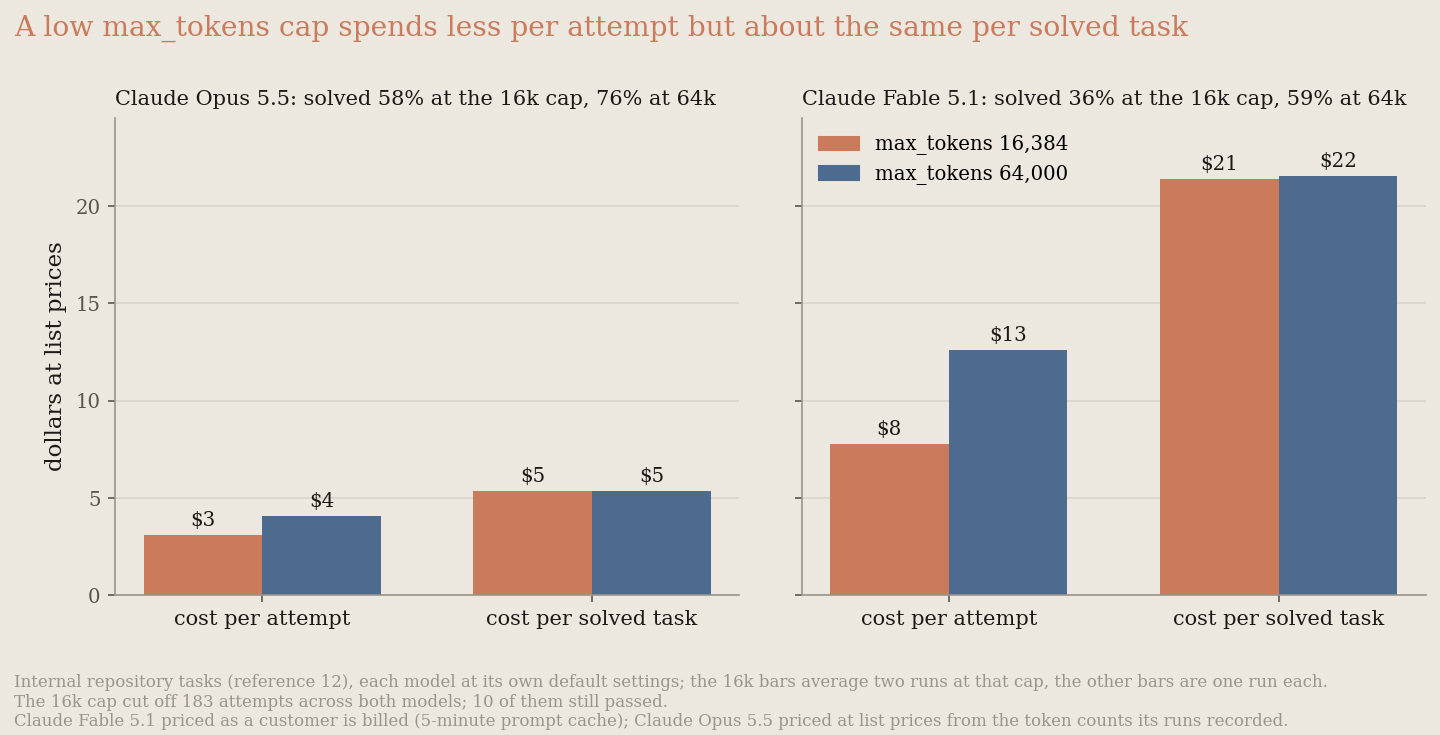
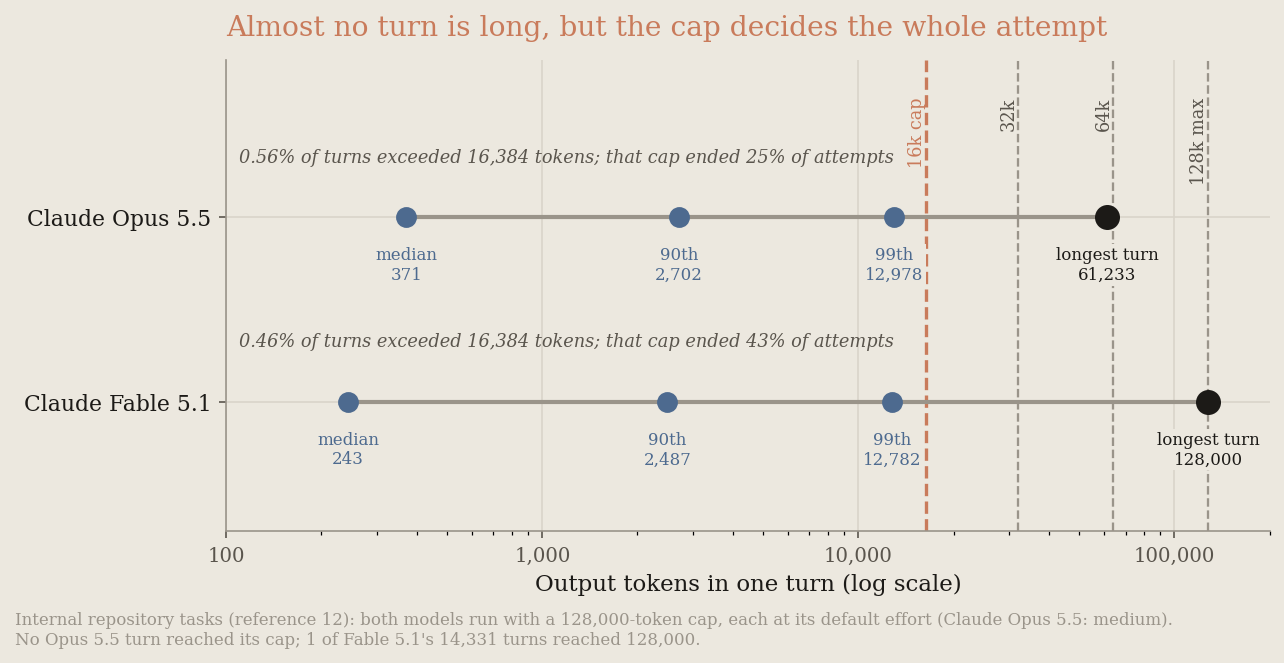
task-budgets-2026-03-13) sur les modèles les plus récents. Consultez le tableau de prise en charge pour savoir lesquels. Commencez près du 90e centile de l'utilisation de tokens de votre boucle, puis resserrez. Choisir un budget montre comment collecter cette distribution. Les budgets inférieurs au plancher actuel de 20 000 tokens sont rejetés, et des budgets très serrés peuvent produire un comportement proche du refus. Définissez le budget une seule fois, dans la première requête, car une modification en cours de tâche invalide le cache. Le budget est indicatif : il oriente le modèle plutôt que de l'arrêter. Vérifiez donc son respect sur votre charge de travail. max_tokensplafonne une réponse unique, de manière invisible pour le modèle. L'abaisser n'incite donc pas le modèle à économiser. Les tours qui avaient besoin de cette marge sont abandonnés et tout de même facturés. Sur un benchmark interne de tâches sur dépôt12, un plafond de 16 384 tokens a interrompu environ un quart des tentatives de Claude Opus 5.5 et 43 % de celles de Claude Fable 5.1, chacun à son effort par défaut. Seules 1 des 66 tentatives plafonnées d'Opus 5.5 et 9 des 117 tentatives plafonnées de Fable ont tout de même réussi. Les exécutions plafonnées ont dépensé moins par tentative, mais ont obtenu proportionnellement moins de résolutions. Le coût par tâche résolue était donc à peu près le même qu'à 64 000 : 21 $ contre 22 $ sur Fable 5.1, et à 1 % près sur Opus 5.5. À 64 000, 2 tours sur environ 14 000 de Claude Fable 5.1 à son effort par défaut étaient encore interrompus, et aucun tour de Claude Opus 5.5 ne l'était. Fable 5.1 a résolu 58,5 % des tâches au lieu de 36,3 %. Sur une autre découpe du sous-ensemble SWE-bench Pro3, décrite dans la référence 12, il n'y a eu aucune différence : 94 sur 100 avec l'un ou l'autre plafond. Réessayer les tentatives plafonnées aide rarement. Avec le même plafond, la plupart échouent à nouveau. Avec un plafond plus élevé, vous payez en plus la tentative gaspillée. Définissezmax_tokensà 64 000 pour le travail agentique. Utilisez 128 000, le maximum, lorsqu'une seule tentative interrompue coûte cher. À 128 000, Fable 5.1 a résolu 60,0 % des tâches pour le même coût par tâche résolue. Utilisez le streaming pour des réponses aussi volumineuses et traitezstop_reason: max_tokenscomme un échec. Pour économiser, utilisez l'effort et les budgets de tâche, que le modèle peut voir.- Les budgets de session sur Claude Managed Agents constituent l'arrêt ferme. Un budget de session est un plafond en dollars sur une session, aux tarifs catalogue, pour les tokens, les recherches et la durée de session. Au plafond, la session se met en pause avec
stop_reason: budget_reached. Augmenter le budget permet de la reprendre. Il est appliqué par la plateforme et fonctionne sur tout modèle ayant un prix catalogue, y compris les modèles pour lesquels les budgets de tâche ne sont pas encore disponibles. Il se combine avec le budget de tâche indicatif. Les déploiements appliquent le même champ à chaque exécution.
Demandez des réponses plus courtes. Les tokens de sortie coûtent cinq fois plus que les tokens d'entrée sur Claude Sonnet 5. Dans une boucle d'agent, chaque token écrit par le modèle revient en entrée à chaque tour suivant. Vous payez donc une longue réponse encore et encore. Anthropic a exécuté la tâche de triage avec trois instructions de réponse finale, à raison de trois exécutions chacune, avec le même modèle et les mêmes outils. L'original demandait deux lignes :
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>La variante plus courte en demandait une :
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.La variante plus longue demandait un mémo avec cinq sections titrées : résumé du problème, éléments probants, vérification des doublons, étiquette recommandée et prochaines étapes. Prenons un ticket décrivant un prompt en file d'attente qui n'est jamais envoyé après une question ignorée. Pour ce ticket, les deux premières réponses étaient :
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.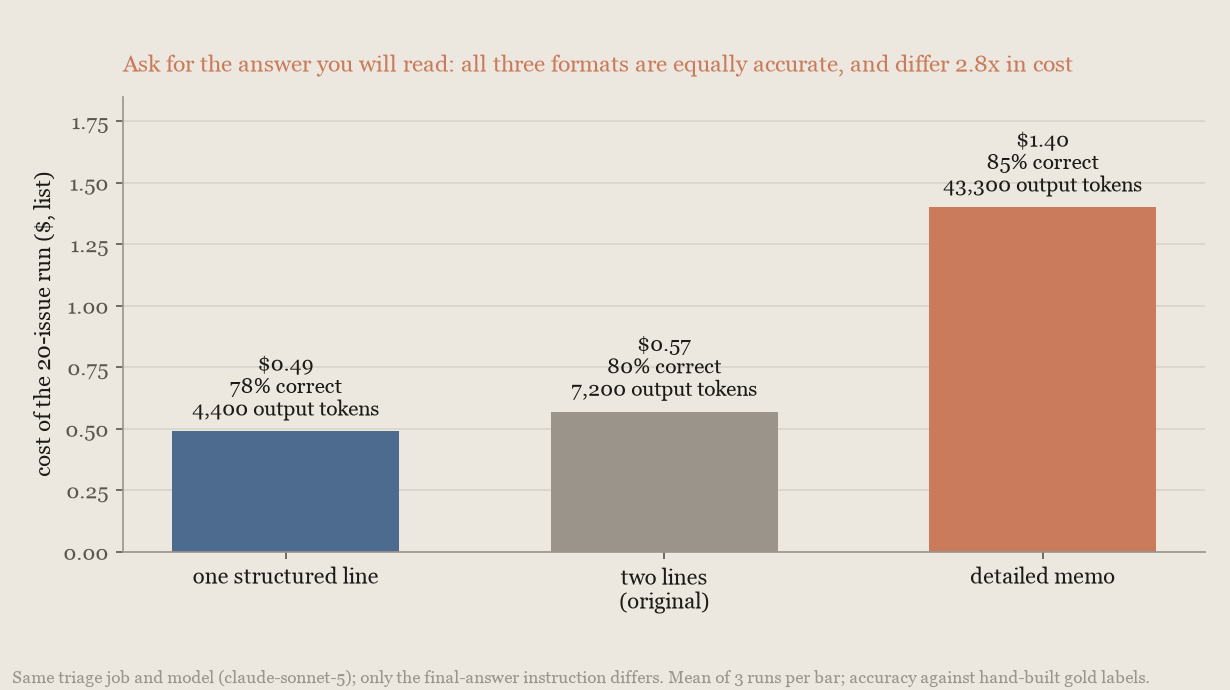
La réponse sur une ligne a utilisé 39 % de tokens de sortie en moins que l'original sur deux lignes et a coûté 14 % de moins par exécution. Le mémo a utilisé six fois plus de tokens de sortie et a coûté 2,8 fois plus que la réponse sur une ligne. Par rapport aux étiquettes de référence, les trois formats ont obtenu des scores dans la marge du bruit d'une exécution à l'autre. Les formats diffèrent donc bien plus par ce que vous payez que par ce qu'ils réussissent. Demandez la réponse que vous lirez, et non celle qui paraît exhaustive.
Avec le plafond max_tokens plus bas, les deux modèles dépensent moins par tentative, mais résolvent proportionnellement moins de tâches. Le coût par tâche résolue bouge donc à peine :
Presque tous les tours se terminent bien en dessous de l'un ou l'autre plafond. Le plafond plus élevé sert aux rares tours longs :
Montrer au modèle le temps écoulé
Un modèle dans une boucle d'agent ne peut pas voir d'horloge. Un budget de tâche lui indique combien de tokens il reste. Par défaut, en revanche, rien dans la requête ne lui indique depuis combien de temps le travail dure. Deux petites modifications lui donnent ce signal. Ajoutez à l'invite système une instruction de deux phrases indiquant que le temps compte et, à partir de la deuxième requête, envoyez le temps écoulé avant chacun des tours du modèle.
Anthropic a mesuré les deux modifications ensemble avec Claude Fable 5.1 à l'effort high, sur deux benchmarks publics, DRACO21 et HLE22, ainsi que sur un ensemble interne de 70 problèmes de physique de niveau recherche, adaptés du benchmark public CritPt23. Cette page appelle cet ensemble l'ensemble de physique. Chacun des trois a été exécuté sous deux formes : un agent unique, et une équipe dans laquelle un agent principal lance des agents auxiliaires du même modèle qui travaillent en parallèle. Une variation de score est considérée comme comprise dans la marge lorsque son intervalle à 95 % reste dans une limite fixée par Anthropic avant les exécutions : 1,5 point sur DRACO et 2,5 points sur HLE. Le graphique suivant représente le score en fonction du coût par tâche pour chaque configuration. Une deuxième rangée de barres donne la durée de chaque configuration sous forme de ratio par rapport à l'agent unique à l'effort high, sans les attentes de nouvelle tentative. Une troisième rangée donne la variation de score produite par les deux modifications, avec son intervalle à 95 % :
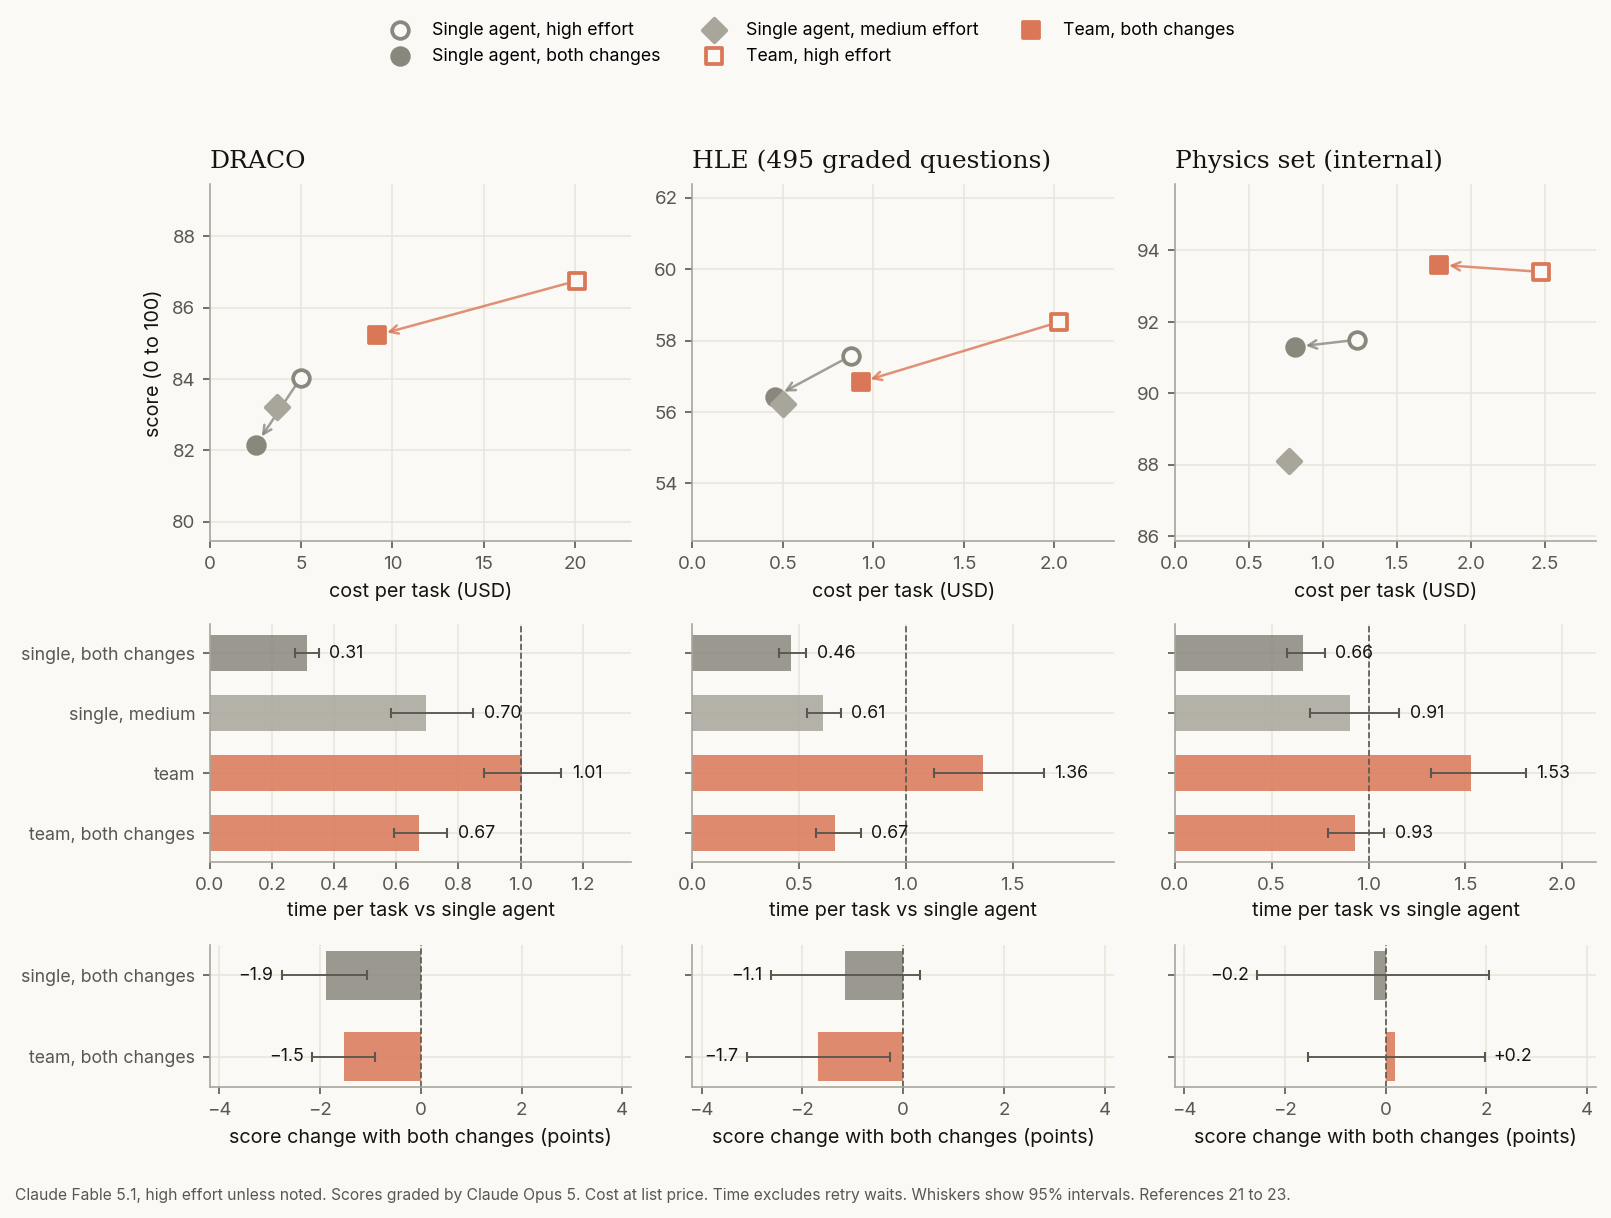
Avec une équipe d'agents. Une équipe effectue plus de travail qu'un agent unique ; par défaut, elle coûte donc plus cher. Sur DRACO, l'équipe a coûté 4,0 fois plus que l'agent unique et a pris à peu près autant de temps (intervalle à 95 % de 12 % de moins à 13 % de plus). Avec l'instruction et l'horloge sur chaque agent, l'équipe a terminé en 33 % de temps en moins, pour un coût par tâche inférieur de 54 %. Son score était inférieur de 1,5 point (intervalle à 95 % de 0,9 à 2,1 de moins), et l'extrémité de cet intervalle, 2,1 points de moins, dépasse la marge de 1,5 point. Sur HLE, l'équipe a terminé en 51 % de temps en moins, pour un coût par tâche inférieur de 54 %. Son score était inférieur de 1,7 point (intervalle à 95 % de 0,3 à 3,1 de moins), et l'extrémité de cet intervalle, 3,1 points de moins, dépasse la marge de 2,5 points. Sur l'ensemble de physique23, l'équipe a terminé en 39 % de temps en moins. Son coût par tâche était inférieur de 28 %, et cette économie dépend de la fréquence à laquelle le cache de prompts a expiré entre les requêtes. Sans expiration, elle serait de 23 %. Son score était supérieur de 0,2 point (intervalle à 95 % de 1,5 de moins à 2,0 de plus).
Sur DRACO, l'agent principal a lancé une médiane de 4 auxiliaires par tentative. Le résultat DRACO montre donc une équipe travaillant en parallèle. Sur HLE et l'ensemble de physique, l'agent principal a lancé une médiane de 0 auxiliaire. Au moins la moitié de ces exécutions en équipe ne comportaient donc que l'agent principal. Ces résultats d'équipe reflètent surtout le comportement propre de l'agent principal, et non l'effet d'auxiliaires en parallèle.
Avec un agent unique. Sur l'ensemble de physique23, les mêmes modifications ont réduit la durée d'un agent unique de 34 % et son coût par tâche de 34 %. Son score était inférieur de 0,2 point (intervalle à 95 % de 2,5 de moins à 2,1 de plus). Sur l'ensemble de physique, un niveau d'effort plus bas a permis d'économiser sur le coût, mais pas clairement sur la durée. À l'effort medium, l'agent unique a coûté 37 % de moins par tâche qu'à high, et sa durée était inférieure de 9 % (intervalle à 95 % de 30 % de moins à 16 % de plus). Il a obtenu 3,4 points de moins (intervalle à 95 % de 0,4 à 6,8 de moins), et l'intervalle s'approche de zéro. Avec les deux modifications à l'effort high, l'agent unique a pris 27 % de temps en moins qu'à l'effort medium (intervalle à 95 % de 5 % à 44 % de moins). Son coût par tâche était supérieur de 6 % (intervalle à 95 % de 12 % de moins à 27 % de plus), et son score était supérieur de 3,2 points (intervalle à 95 % de 0,1 de moins à 6,5 de plus).
Sur HLE, les mêmes modifications ont réduit la durée d'un agent unique de 54 % et son coût par tâche de 48 %. Son score était inférieur de 1,1 point (intervalle à 95 % de 2,6 de moins à 0,3 de plus), et l'extrémité de cet intervalle, 2,6 points de moins, dépasse tout juste la marge de 2,5 points. À l'effort medium, l'agent unique a coûté 43 % de moins par tâche qu'à high, a pris 39 % de temps en moins et a obtenu 1,3 point de moins (intervalle à 95 % de 2,8 de moins à 0,1 de plus). Avec les deux modifications à l'effort high, l'agent unique a pris 25 % de temps en moins qu'à l'effort medium (intervalle à 95 % de 12 % à 35 % de moins). Son coût par tâche était inférieur de 9 % (intervalle à 95 % de 21 % de moins à 6 % de plus), et son score était supérieur de 0,2 point (intervalle à 95 % de 1,3 de moins à 1,7 de plus).
Sur DRACO, les mêmes modifications ont réduit la durée d'un agent unique de 69 % et son coût par tâche de 49 %. Son score était inférieur de 1,9 point (intervalle à 95 % de 1,1 à 2,8 de moins), et l'extrémité de cet intervalle, 2,8 points de moins, dépasse la marge de 1,5 point. À l'effort medium, l'agent unique a coûté 25 % de moins par tâche qu'à high, a pris 30 % de temps en moins et a obtenu 0,7 point de moins (intervalle à 95 % de 0,1 à 1,3 de moins). Avec les deux modifications à l'effort high, l'agent unique a pris 53 % de temps en moins qu'à l'effort medium (intervalle à 95 % de 42 % à 63 % de moins), et son coût par tâche était inférieur de 31 % (intervalle à 95 % de 28 % à 35 % de moins). Son score était inférieur de 1,2 point (intervalle à 95 % de 0,5 à 1,9 de moins), et l'extrémité de cet intervalle, 1,9 point de moins, dépasse la marge de 1,5 point.
Sur les trois ensembles, les deux modifications à l'effort high ont fait gagner plus de temps que l'effort medium. Sur HLE et l'ensemble de physique, il n'y a pas eu de différence nette de coût, et sur DRACO le coût était inférieur. Le score était à peu près le même sur HLE. Sur l'ensemble de physique, il était supérieur de 3,2 points, mais cet intervalle inclut zéro ; la différence n'est donc pas nette. Ainsi, pour un agent unique, l'horloge fait gagner plus de temps qu'un niveau d'effort plus bas. Sur DRACO, cependant, l'agent unique avec les deux modifications a obtenu 1,2 point de moins qu'à l'effort medium (intervalle à 95 % de 0,5 à 1,9 de moins).
Quand l'utiliser.
- Utilisez les deux modifications lorsque la durée d'un agent compte et qu'une légère variation de score est acceptable. Sur chaque configuration mesurée, elles ont réduit la durée et le coût par tâche, pour les équipes comme pour les agents uniques.
- Vérifiez le score sur vos propres tâches avant de les adopter. Sur DRACO, le score était inférieur de 1,5 point pour une équipe et de 1,9 point pour un agent unique. Sur HLE, il était inférieur de 1,7 point pour une équipe et de 1,1 point pour un agent unique. Sur l'ensemble de physique, aucune des variations de score n'était nettement différente de zéro.
- Si vous envisagez déjà un niveau d'effort plus bas pour gagner du temps, comparez-le avec l'horloge. Un agent unique avec les deux modifications à l'effort
higha pris moins de temps qu'à l'effortmedium: 53 % de moins sur DRACO, 25 % de moins sur HLE et 27 % de moins sur l'ensemble de physique. Son coût par tâche était inférieur de 31 % sur DRACO, sans différence nette sur HLE et l'ensemble de physique.
Comment l'ajouter. Placez cette instruction au début de l'invite système de chaque agent :
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.La seconde phrase indique au modèle que les messages d'horloge existent. La première requête ne comporte pas d'horloge, et les exécutions mesurées ont utilisé exactement cette formulation.
Ensuite, avant chaque requête d'un agent à partir de la deuxième, ajoutez un message système en cours de conversation qui indique le temps écoulé en secondes entières, par exemple Elapsed time: 412 seconds. Comptez à partir du début de la tâche, et non du début de l'agent. Dans une équipe, chaque agent lit la même horloge. La première horloge que voit un auxiliaire compte donc déjà le temps passé par l'équipe avant son lancement. Dans une boucle d'outils, placez le message juste après le message user qui contient les résultats d'outils, comme le montre Placement après les résultats d'outils. Si vous envoyez plutôt un nouveau message user à l'agent, placez l'horloge après ce message.
Laissez les messages d'horloge précédents à leur place. Chacun fait partie de l'historique de la conversation. Le préfixe mis en cache correspond donc toujours à la requête suivante (voir Combinaison avec la mise en cache des prompts). Anthropic a mesuré ces messages système simples, qui restent visibles pour le modèle. Un message système limité au tour ne montrerait au modèle que l'horloge la plus récente. Anthropic n'a pas mesuré cette forme.
L'exemple suivant exécute la boucle d'outils d'un agent avec les deux modifications. Il ajoute l'horloge après les résultats d'outils et ne gère que les outils client :
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Secondes en temps réel (wall-clock), pour que les processus auxiliaires puissent partager l'heure de début du processus principal.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Streaming, car un plafond de 128 000 tokens est trop élevé pour une requête sans streaming.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Un message système doit suivre un tour utilisateur, donc l'horloge est placée après les résultats d'outils.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 prend en charge les messages système en cours de conversation. La liste des modèles pris en charge couvre les autres. Certains modèles, comme Claude Sonnet 5, ne les prennent pas en charge. Sur ces modèles, vous pouvez placer la même ligne dans un bloc de texte après le dernier bloc tool_result du tour user. Anthropic n'a mesuré que la forme par message système.
Sur Claude Managed Agents, vous pouvez envoyer un événement system.message avec un résultat d'outil ou un message utilisateur. Le message s'applique à ce tour et à tous les tours suivants. Les tours qui suivent les outils intégrés de la plateforme, comme la recherche web, voient donc la dernière horloge que vous avez envoyée, et non l'heure actuelle. De plus, un system.message n'atteint que le fil principal de la session. Dans une session multiagent, il s'agit du fil du coordinateur. Les agents workers ne voient donc jamais une horloge envoyée de cette manière. Pour afficher l'heure actuelle avant chaque tour, et à chaque agent d'une équipe, exécutez vous-même la boucle d'agent sur l'API Messages.
Combiner des modèles
Les architectures multi-modèles conviennent aux charges de travail dont la complexité des tâches varie suffisamment pour que différentes étapes soient mieux servies par différents modèles. Lorsque votre trafic mélange du travail routinier qu'un modèle plus petit gère de manière fiable avec des étapes plus difficiles qui nécessitent une capacité de pointe, répartir le travail maintient l'intelligence de pointe là où elle compte tandis que la plupart des tokens sont facturés aux tarifs du modèle plus petit. Lorsqu'une charge de travail ne présente pas ce mélange, parce que sa difficulté est uniforme ou qu'il s'agit d'une seule chaîne dépendante, un modèle unique bien ajusté est généralement le meilleur choix. Chaque section de stratégie donne la règle pour distinguer les deux cas.
Deux stratégies couvrent la plupart des charges de travail, et elles diffèrent par le modèle qui tient la boucle principale :
| Stratégie | Flux de contrôle | Rôle du modèle de pointe | Convient à | Le coût de pointe évolue avec |
|---|---|---|---|---|
| Conseiller | Le modèle plus petit exécute la boucle, fait remonter à la demande | Consulté pour les plans et les corrections | Travail en série difficile par endroits, comme les nombreux tours d'un agent de codage entre quelques vraies décisions | La fréquence à laquelle l'exécuteur se retrouve bloqué |
| Orchestrateur | Le modèle de pointe exécute la boucle, délègue le travail de masse | Planifie, répartit et synthétise | Travail qui se déploie sur des fichiers, documents ou cas réellement indépendants, surtout au-delà d'une fenêtre de contexte | La difficulté de coordination des morceaux |
Stratégie du conseiller : faire remonter les décisions difficiles
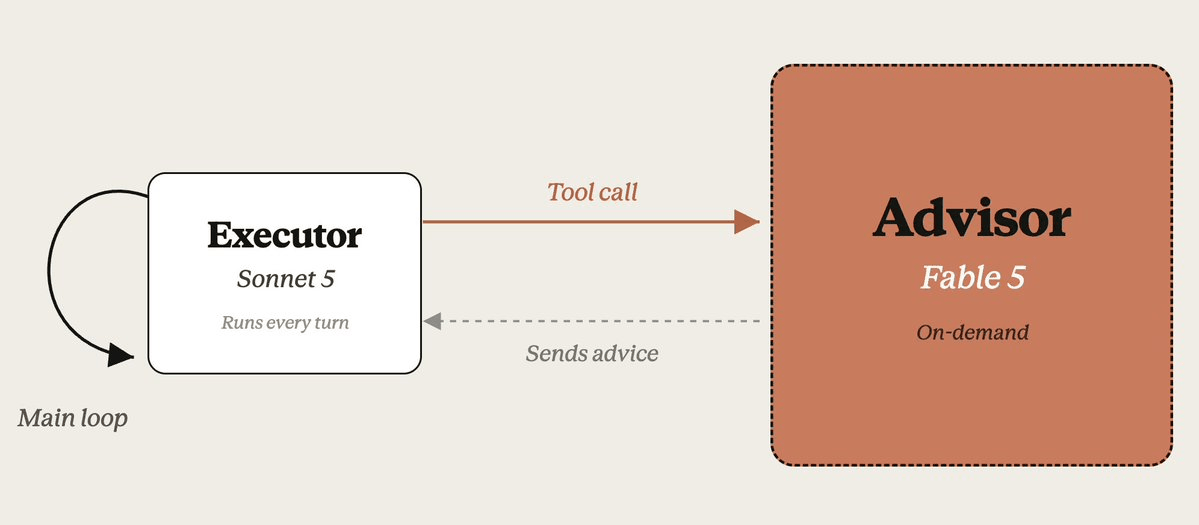
Dans l'« advisor strategy » (stratégie du conseiller), un modèle « executor » (exécuteur) moins coûteux exécute la boucle d'agent et effectue la plupart des tours. Il peut rencontrer une décision qui nécessite un jugement plus approfondi, comme le choix d'une approche ou la récupération après un échec. Il appelle alors un modèle « advisor » (conseiller) plus intelligent pour obtenir des conseils stratégiques, puis continue. La plupart des tokens sont facturés aux tarifs de l'exécuteur ; seules les consultations occasionnelles le sont aux tarifs du conseiller.
Pour l'utiliser, ajoutez l'outil advisor à votre requête. Cette fonctionnalité bêta exécute toute la stratégie côté serveur dans une seule requête /v1/messages. L'exécuteur émet un appel d'outil, Anthropic exécute l'inférence du conseiller, puis l'exécuteur continue avec le conseil. Vous n'écrivez aucun code d'orchestration. Sur Claude Managed Agents, donnez un conseiller à la session en ajoutant une entrée advisor à la liste multiagent de l'agent. Le fil principal de la session le consulte de la même manière. Claude Code le prend également en charge ; consultez faire remonter les décisions difficiles avec l'outil advisor.
Ce qui détermine le bénéfice. Le conseiller ne voit la tâche qu'à travers les appels de l'exécuteur. Deux éléments déterminent donc à quel point il aide.
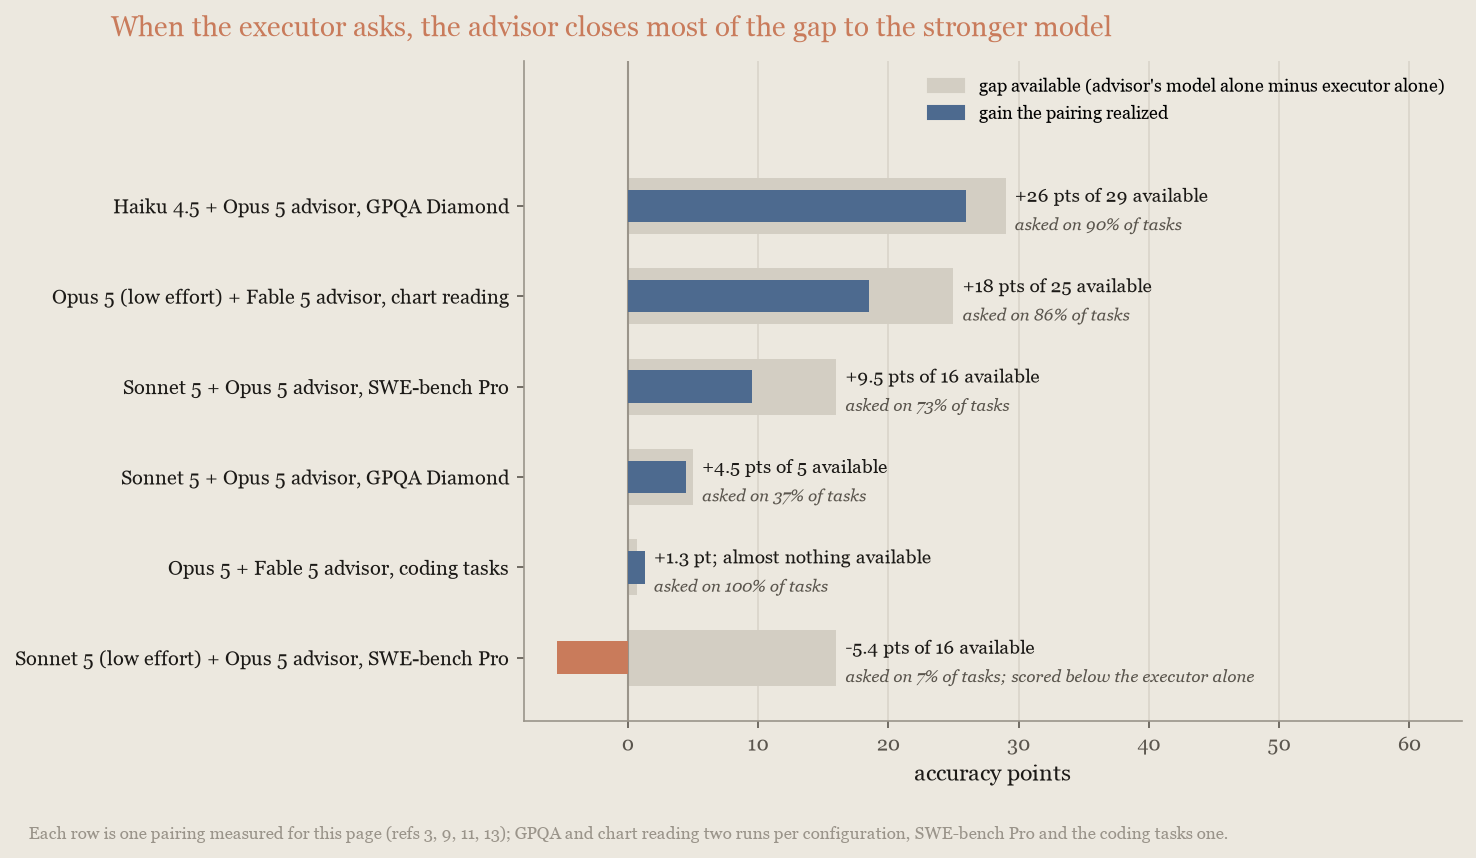
Le premier est l'écart entre les modèles. Le conseiller ne peut transmettre que les capacités qui manquent à l'exécuteur : sur GPQA Diamond9, avec un conseiller Claude Opus 5, un exécuteur Claude Haiku 4.5 a beaucoup gagné, un exécuteur Claude Sonnet 5 a gagné quelques points, et un exécuteur de pointe n'a presque rien gagné.
Le second élément, le plus fragile, est de savoir si l'exécuteur demande effectivement conseil : c'est le « consult rate » (taux de consultation). Un exécuteur à faible effort peut cesser de détecter qu'il est bloqué. Une paire peut consulter sur la plupart des tâches à l'effort par défaut, puis ne presque plus consulter lorsque l'effort est réduit. Elle obtient alors un score inférieur à celui de l'exécuteur seul. Le taux varie aussi selon la tâche. Sur DeepSWE10, un exécuteur Sonnet 5 à faible effort a continué à demander et a gagné 23 points. Sur SWE-bench Pro3, le même exécuteur a cessé de demander. Lorsque l'exécuteur demande, il comble une grande partie de l'écart. Le graphique suivant montre plusieurs paires. Dans celles dont l'exécuteur a continué à demander, le conseiller a comblé au moins la moitié de l'écart avec le modèle plus fort. La paire de codage a même battu le modèle plus fort. Vous ne payez le modèle plus fort que pour les consultations, ce qui rend possibles les cas d'économie :
Le taux de consultation réagit au prompting. Avec seulement la description intégrée de l'outil, les exécuteurs n'appellent pas assez le conseiller, en particulier sur le travail de codage. La documentation de l'outil advisor fournit donc une invite système qui demande un appel avant le travail substantiel et un autre avant de terminer, soit environ deux à trois appels par tâche. La paire de codage mesurée ensuite a fonctionné à ce rythme avec Claude Opus 5 comme exécuteur : environ deux consultations sur chaque tâche. Avec Claude Opus 5.5 comme exécuteur, elle a demandé conseil environ 1,4 fois par tentative, et 4 % de ses tentatives n'ont reçu aucun conseil. Cette documentation explique également comment inciter un exécuteur qui appelle trop peu et comment plafonner les appels côté client pour limiter le coût. Surveillez donc le taux de consultation : incitez-le par le prompt et mesurez-le. S'il s'effondre, rétablissez l'effort de l'exécuteur.
Quand il est rentable. Un conseiller fait économiser de l'argent lorsque quelques consultations courtes, facturées au tarif du conseiller, remplacent l'exécution du modèle du conseiller pour toute la tâche. Cela fonctionne mieux lorsque le modèle du conseiller est nettement plus cher que celui de l'exécuteur. La configuration la plus rentable est donc un conseiller de pointe au-dessus d'un exécuteur de milieu de gamme. Une paire en haut de la gamme peut récupérer une partie du coût des conseils, car les conseils font aussi économiser des tokens à l'exécuteur. Un exécuteur à qui l'on indique la bonne approche explore moins d'impasses. Dans la paire de codage ci-dessous, avec un exécuteur Claude Opus 5, cette économie a payé environ la moitié des conseils : l'exécuteur a dépensé 1,26 $ de moins par tentative qu'Opus 5 seul à son réglage par défaut, et les consultations ont coûté 2,47 $. Avec un exécuteur Claude Opus 5.5, les conseils n'ont presque rien fait économiser sur le coût de l'exécuteur. Celui-ci a dépensé 1,36 $ par tentative, contre 1,38 $ pour Opus 5.5 seul à high, tandis que les consultations ont coûté 1,55 $.
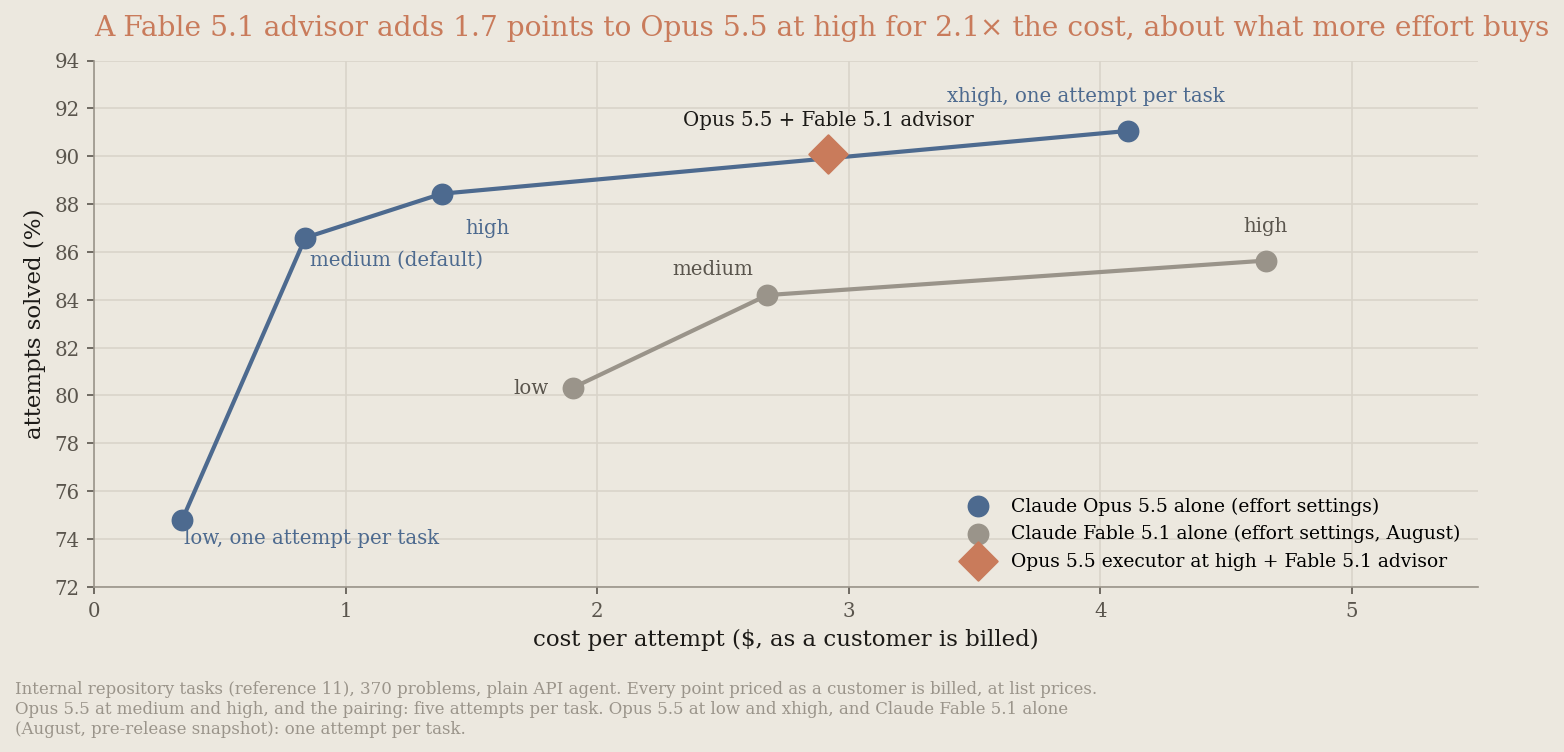
Sur un benchmark interne de codage agentique11, exécuté avec un agent API simple, un exécuteur Claude Opus 5.5 à high avec un conseiller Claude Fable 5.1 a obtenu 90,1 % pour 2,92 $ par tentative. C'est 1,7 point de plus qu'Opus 5.5 seul à high, le réglage propre de l'exécuteur, pour environ 2,1 fois le prix. Avec cinq tentatives par tâche, cet écart est à la limite du bruit d'une exécution à l'autre. Par rapport à Opus 5.5 à son réglage par défaut, medium, c'est 3,5 points de plus pour environ 3,5 fois le prix. Le résultat se situe à peu près sur la propre courbe d'effort d'Opus 5.5. Le conseiller apporte donc à peu près ce qu'apporte un effort supplémentaire : Opus 5.5 seul à xhigh a obtenu 91,1 % pour 4,11 $ par tentative (une tentative par tâche). En août, un conseiller Claude Fable 5.1 au-dessus d'un exécuteur Claude Opus 5 était la configuration la plus précise mesurée. Elle coûtait 6,21 $ par tentative, soit un peu plus du double de la paire Opus 5.5. Le graphique représente la paire Opus 5.5 par rapport à la propre courbe d'effort d'Opus 5.5 et à celle de Claude Fable 5.1 d'août :
Une mesure antérieure via le mode advisor de Claude Code a également classé sa paire avec conseiller au-dessus de chacun de ses deux modèles seuls. Considérez le résultat de Claude Opus 5.5 comme une tendance à tester sur votre charge de travail. Le conseiller apporte quelques points pour environ deux fois le coût de l'exécuteur seul. Un écart de capacités plus large ne garantit pas une meilleure affaire. Le coût en latence correspond aux consultations elles-mêmes. Sur ce benchmark, elles représentent environ un ou deux appels supplémentaires au modèle de pointe par tâche, chacun sur le chemin critique de la tâche.
Quand le modèle plus fort seul est la meilleure option. La précision de certaines charges de travail réagit à l'effort. Pour celles-ci, avant de construire la paire, comparez-la avec le modèle du conseiller seul à un réglage réduit. Le conseiller n'est payé que sur les tâches qui en ont besoin. Une consultation déclenchée sur la plupart des tâches coûte pourtant plus cher que d'exécuter directement le modèle plus fort. Sur Chartography13, un exécuteur Claude Opus 5.5 à low, doté d'un conseiller Claude Fable 5.1, a consulté ce conseiller sur 1 tâche sur 300 et a obtenu 61,7. C'est 7 points de moins qu'Opus 5.5 seul, au-delà du bruit d'une exécution à l'autre, pour à peu près le même coût. En août, un exécuteur Claude Opus 5 consultait sur presque chaque tâche, et cette paire égalait Fable 5.1 seul à medium dans la marge du bruit d'une exécution à l'autre (65,0 contre 67,5), pour environ 1,8 fois le coût par tâche. Mesurez d'abord votre propre taux de consultation. Si l'exécuteur demande conseil sur la plupart de ses tâches, vous payez les tarifs du conseiller sur l'ensemble de la charge de travail. Exécuter directement le modèle du conseiller est alors le moyen le moins coûteux d'obtenir le même score.
Quelle que soit la paire, évaluez d'abord le prix du modèle du conseiller seul à faible effort ; c'est la référence à battre. Revérifiez à chaque nouvelle version de modèle, car les versions modifient à la fois l'écart de capacités et le rapport de prix.
Quand elle convient. La stratégie du conseiller convient aux charges de travail où les tours sont majoritairement mécaniques, mais où un excellent plan compte. C'est le cas des agents de codage, du « computer use » (utilisation de l'ordinateur) et des pipelines de recherche en plusieurs étapes. Elle convient mal lorsque chaque tour nécessite réellement des capacités de pointe, lorsqu'il n'y a rien à planifier (comme pour des questions-réponses en un seul tour) ou lorsque votre exécuteur est déjà proche des capacités du conseiller.
Stratégie de l'orchestrateur : déléguer le travail de masse
Dans la stratégie « orchestrator » (orchestrateur), le « frontier model » (modèle de pointe) tient la boucle. Il décompose la tâche, distribue des sous-tâches à des « worker models » (modèles travailleurs) moins coûteux et fusionne leurs résultats. La transcription de l'orchestrateur reste courte, car les workers absorbent l'exploration gourmande en tokens. La plupart des tokens sont donc facturés aux tarifs des workers, tandis que le plan et la synthèse proviennent toujours du modèle de pointe.
Pour en construire un, utilisez l'orchestration multi-agents dans Claude Managed Agents : configurez un agent coordinateur (l'orchestrateur) et une liste d'agents workers, chacun avec son propre modèle. Pour un exemple complet et fonctionnel avec un coordinateur de pointe et des workers Claude Sonnet 5, consultez la recette du Claude Cookbook Coordinator pattern: big models for planning, small models for execution.
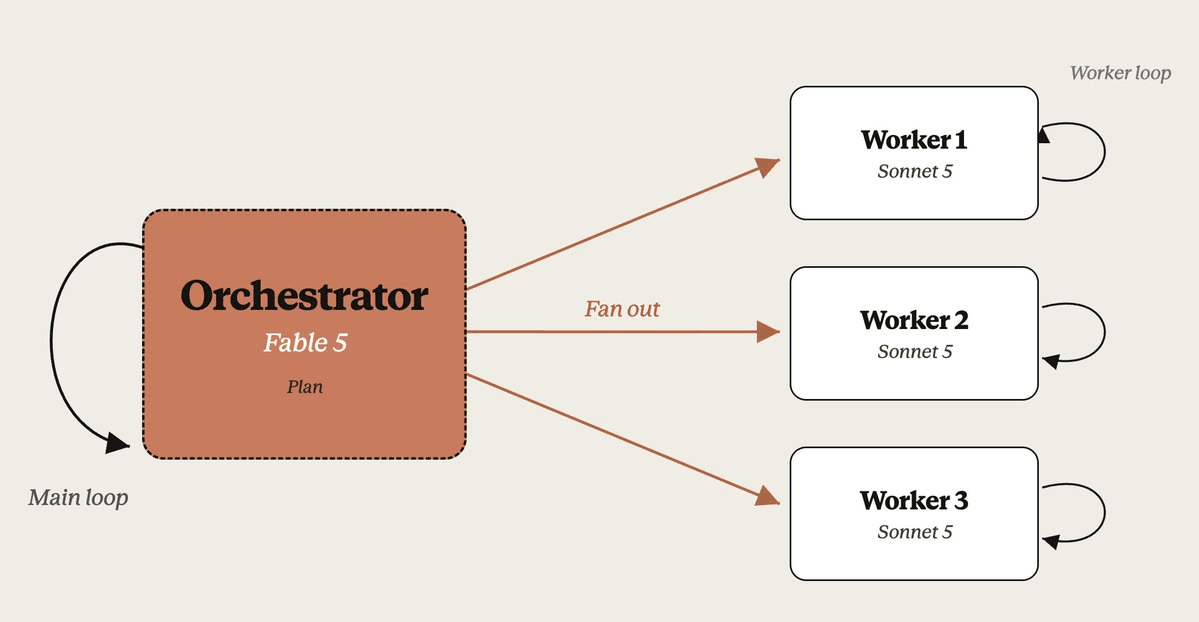
Ce schéma fait gagner du temps réel écoulé lorsque les workers peuvent s'exécuter en parallèle. Sur le benchmark de corpus8, un épisode a pris environ 2,3 heures lorsque le coordinateur exécutait 25 workers simultanés, soit la limite documentée de la plateforme, contre 15 à 20 heures en solo. Il n'a permis d'économiser de l'argent que dans deux situations mesurées. Sur un travail qu'un seul modèle pouvait gérer seul, le même modèle avec un effort moindre était moins cher à chaque fois.
Lorsque les workers s'exécutent en parallèle, une instruction de temps et une horloge du temps écoulé peuvent raccourcir l'exécution. Sur DRACO21, une équipe d'agents utilisant le même modèle, avec l'instruction et l'horloge, a terminé en 33 % de temps en moins pour un coût par tâche inférieur de 54 %, et a obtenu un score inférieur de 1,5 point. Chaque agent de cette équipe disposait de l'instruction et de l'horloge. Anthropic n'a pas mesuré l'effet de l'horloge avec des workers moins coûteux. Sur Claude Managed Agents, l'horloge n'atteint que le coordinateur, de sorte que les workers ne la voient jamais. Anthropic n'a pas mesuré d'équipe dans laquelle seul le coordinateur dispose de l'horloge. De plus, l'horloge du coordinateur n'est à jour que lors des tours qui suivent vos propres résultats d'outils ou messages. La section Montrer au modèle le temps écoulé fournit la recette pour une boucle d'agent que vous exécutez sur l'API Messages.
Cas 1 : une assurance contre la queue de coûts sur le travail de routine. Un modèle de pointe fonctionnant seul part parfois en spirale sur un problème de routine qu'il résoudrait normalement. Comme vous ne pouvez pas savoir à l'avance quels problèmes seront concernés, quelques exécutions de ce type dominent la facture. Un coordinateur qui confie le travail de routine à un worker moins coûteux plafonne cette queue, car toute spirale se produit désormais aux tarifs des workers.
Anthropic a mesuré cela sur une tranche délibérément facile de BrowseComp4 (10 problèmes que le modèle seul résout de manière fiable ; 50 exécutions déléguées et 70 en solo). Un coordinateur Claude Fable 5 avec un worker Claude Sonnet 5 a coûté environ moitié moins que Claude Fable 5 seul en moyenne, et environ trois fois moins au 90e centile (12 $ contre 33 $). De plus, l'exécution la plus coûteuse du modèle seul, à 84 $, a également produit une réponse erronée :
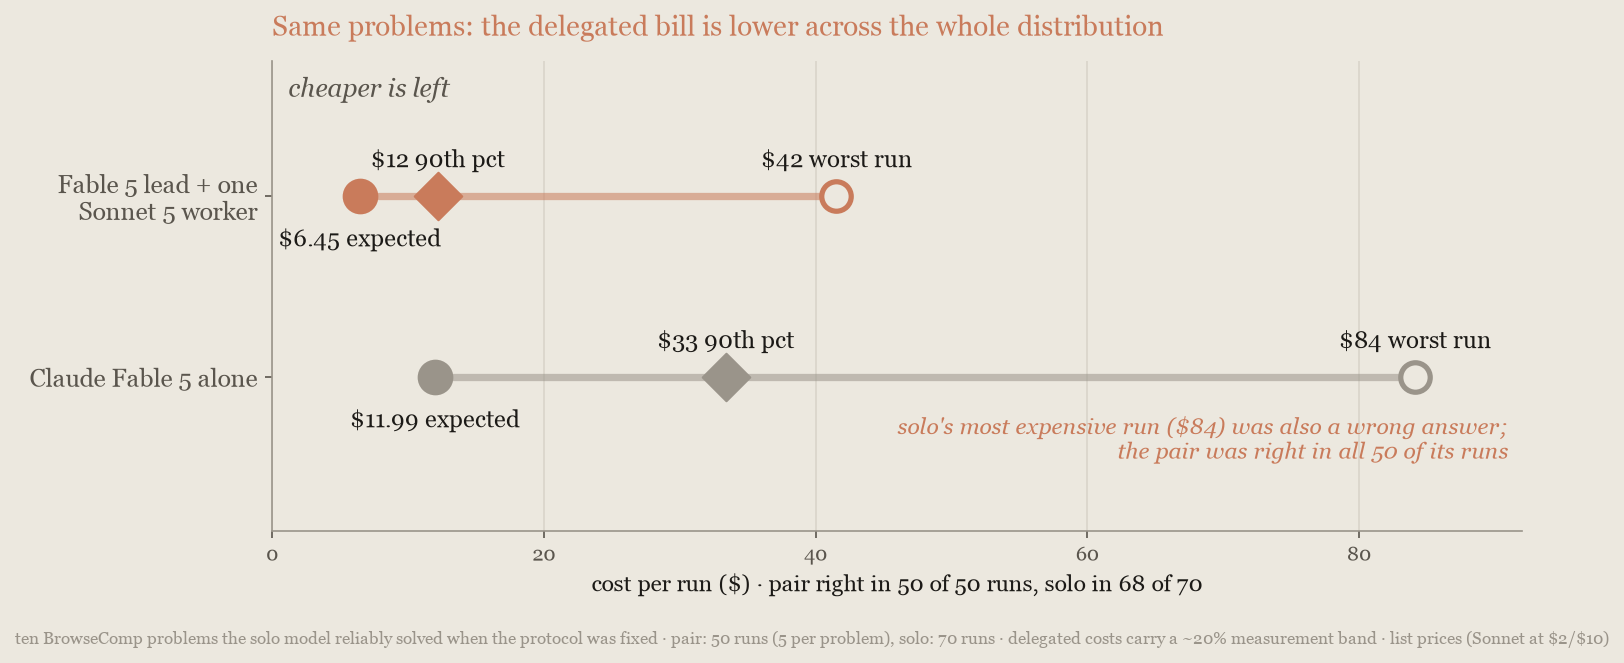
La délégation a été rentable sur la part routinière, normalement soluble, du travail, contrairement à l'intuition selon laquelle les workers sont destinés aux problèmes difficiles. Sur l'ensemble complet et plus difficile de BrowseComp, l'économie s'est inversée. Si votre trafic présente une longue queue de coûts sur les tâches de routine, c'est le cas d'orchestrateur à mesurer en premier.
Cas 2 : un travail plus grand qu'une fenêtre de contexte. Un modèle seul doit traiter une entrée aussi volumineuse en série, une fenêtre de contexte à la fois, en payant pour relire son propre état à chaque passage. Les workers lisent chacun leur propre partition, en parallèle et aux tarifs des workers. Un travail à forte lecture qui tient encore dans une seule fenêtre de contexte relève du choix de modèle, pas de la délégation : sur le seul coût de lecture, l'orchestrateur ne l'emporte que lorsqu'aucun contexte unique ne peut contenir le travail.
Anthropic a construit un benchmark pour ce cas8 : un corpus de 21,6 millions de tokens composé de 14 paquets Python publics contenant 130 défauts implantés, trop volumineux pour toute fenêtre de contexte. Réduire l'effort ne peut pas aider, car la facture correspond à la lecture du corpus elle-même : Claude Fable 5.1 en solo a coûté de 468 $ à 552 $ par épisode selon les trois réglages d'effort, et seule sa précision a varié. La configuration coordinateur, un Claude Fable 5.1 principal supervisant 25 workers Claude Sonnet 5, a coûté environ moitié moins que ces réglages (47 % à 55 % de moins). Elle a obtenu un score inférieur de 10 à 12 points, en environ 2,3 heures par épisode contre 15 à 20, tout en battant nettement une référence Claude Sonnet 5 en solo :
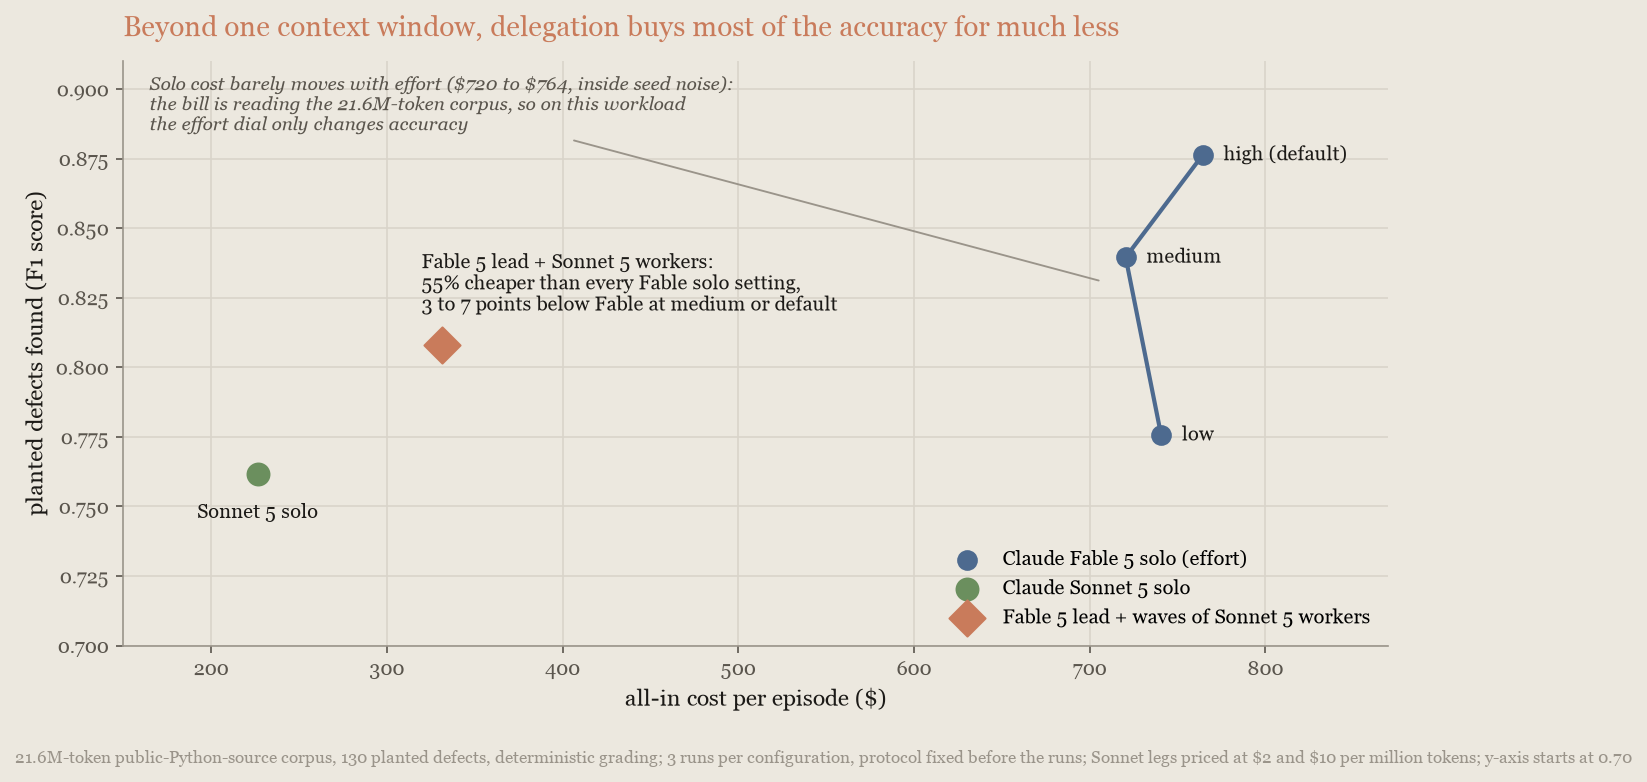
La comptabilité des tokens montre l'ampleur de la lecture. La configuration coordinateur a lu environ 560 millions de tokens en cache par épisode, soit environ une fois et demie les quelque 365 millions du modèle seul. Presque tous ces tokens ont été facturés au tarif de lecture du cache de Claude Sonnet 5, et la configuration a tout de même coûté environ moitié moins au total. Fable 5.1 avec l'effort high conserve toujours la précision maximale, pour environ 2,2 fois le coût de la configuration coordinateur. Ici, la délégation permet donc d'obtenir l'essentiel de la précision, mais pas la totalité.
Quand la délégation n'est pas rentable. Un orchestrateur n'apporte quelque chose que lorsqu'il y a du volume à confier : de nombreux éléments indépendants, idéalement trop nombreux pour une seule fenêtre de contexte. Lorsque le travail forme une seule chaîne d'étapes dépendantes, ou tient dans un seul contexte, l'orchestrateur paie pour un plan, une transmission et une fusion dont un modèle unique n'a pas besoin. Dans chacun des cas mesurés, le modèle du coordinateur utilisé seul avec un effort moindre l'a emporté.
Le facteur déterminant est la difficulté de la tâche, pas le benchmark : sur l'ensemble complet et plus difficile de BrowseComp4, Claude Fable 5 seul a atteint la précision de la configuration coordinateur pour un coût inférieur de 22 % à 30 %. Des travaux externes indépendants rapportent le même schéma5. Ne construisez pas d'orchestrateur si le travail forme une seule chaîne, s'il tient dans un seul contexte sans longue queue de coûts, ou si un modèle unique avec un effort moindre atteint déjà votre seuil.
Choisir entre les stratégies
La plupart des cas se résument à une question : le travail se divise-t-il en morceaux indépendants, ou s'agit-il d'une seule réponse atteinte par une chaîne d'étapes dépendantes ? Le tableau des stratégies associe les deux réponses aux deux stratégies.
Si vous n'êtes pas sûr, ne construisez rien pour l'instant :
- Balayez d'abord l'effort sur votre modèle actuel. C'est l'expérience la moins chère de cette page, et la plupart des charges de travail s'arrêtent là.
- Si le balayage montre un écart, chiffrez le modèle plus fort seul à faible effort. C'est le chiffre qu'une paire avec conseiller doit battre, et les paires de cette page qui l'ont battu étaient celles dont l'exécuteur a réellement consulté.
Les résultats multi-modèles de cette page ont été jugés par rapport au même modèle à un effort plus bas et par rapport au modèle immédiatement inférieur fonctionnant seul. C'est la comparaison à effectuer sur votre propre charge de travail, et la raison pour laquelle la première étape est un balayage d'effort.
Lorsque vous ajoutez effectivement un conseiller, il s'agit d'une définition d'outil plutôt que d'une refonte d'architecture.
Mesurer sur votre propre charge de travail
Les chiffres de cette page reflètent les prix catalogue au moment de la mesure et évolueront à mesure que les modèles et les prix changent. Votre taux d'escalade, la netteté avec laquelle les tâches se divisent et la longueur des transcriptions les font également varier. La méthode reste la même :
- Extrayez quelques tâches des journaux de production, pondérées comme le trafic réel, et rédigez des vérifications de résultats pour chacune : les tests réussissent, le ticket est fermé, le nombre de lignes est correct. Enregistrez le coût par tâche à côté du score. Pour cela, appliquez à chacun des cinq décomptes de tokens facturés dans le
usagede chaque réponse son propre tarif : entrée non mise en cache, écritures de cache de 5 minutes et d'1 heure (à 1,25x et 2x le prix d'entrée), lectures de cache et sortie. Additionnez ensuite ces coûts sur l'ensemble des requêtes de la tâche (l'API Usage and Cost fournit l'agrégat). - Établissez une référence pour chaque niveau de modèle sur l'ensemble des niveaux d'effort, pas seulement celui par défaut, et tracez le score en fonction de la dépense. Une configuration multi-modèles doit battre toute la courbe du modèle unique.
- Si la courbe révèle un écart que l'effort ne peut pas combler, ajoutez la stratégie multi-modèles adaptée et relancez la suite.
- Exécutez la configuration gagnante en mode fantôme sur une tranche de trafic avant la bascule, puis continuez à exécuter la suite.
L'exemple suivant calcule le coût de l'étape 1 pour une requête aux prix catalogue de Claude Opus 5.5 :
# Prix par million de tokens issus de la page de tarification ; modifiez ces trois valeurs pour un autre modèle.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0,05x le prix d'entrée sur Claude Opus 5.5 ; le multiplicateur varie selon le modèle.
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Les écritures en cache d'1 heure sont facturées 2x le prix d'entrée, celles de 5 minutes 1,25x ; les lectures au prix de lecture du cache.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
Dans les boucles d'agent, la plupart des tokens d'entrée devraient être des lectures de cache. Si cache_read_input_tokens est faible par rapport à input_tokens plus cache_creation_input_tokens, vérifiez que la mise en cache est activée et que le préfixe reste identique d'une requête à l'autre. Lorsque l'outil advisor ou la compaction est activé, certains tokens ne sont signalés que dans usage.iterations et non dans les totaux de premier niveau. Dans ce cas, additionnez plutôt les valeurs de usage.iterations, en appliquant aux entrées advisor_message les tarifs du modèle conseiller.
Le tableau suivant répertorie les leviers dans l'ordre où les essayer :
| Levier | Économie dans ces exécutions | Coût en qualité | Latence | Où |
|---|---|---|---|---|
| Mise en cache des prompts | Coût divisé par un facteur de 2,7 à 5,3 sur les boucles d'agent ; 83 % sur l'exécution de triage | Aucun | Plus rapide | Mettre en cache le contexte répété |
| Durée de cache d'1 heure | Moins cher que la valeur par défaut de 5 minutes dès qu'environ 1 tour sur 20 suit une pause comprise entre 5 minutes et une heure et que peu d'intervalles dépassent une heure. Exceptions : sur Claude Fable 5.1, maintenir le cache de 5 minutes actif est moins cher tant que les pauses durent quelques minutes, et la durée d'1 heure l'emporte lorsque les pauses approchent une heure ; sur Claude Opus 5.5, maintenir le cache de 5 minutes actif est moins cher lorsque seulement un ou deux tours sur 20 suivent une pause allant jusqu'à environ une demi-heure. Sans pauses, la valeur par défaut a coûté 15 % de moins sur Claude Sonnet 5 et environ 15 % à 18 % de moins sur Claude Opus 5.5 | Aucun | Reste actif après une pause | Choisir la durée du cache |
| Réduction des entrées | 5 points de pourcentage supplémentaires sur l'exécution de triage | Aucun | Neutre | Réduire les tokens d'entrée et de contexte |
| Élaguer les résultats d'outils obsolètes aux limites des tâches | 39 % sur la longue exécution de triage (compaction : 32 %) ; aucune sur les boucles courtes | Aucun mesuré | Neutre | Réduire les tokens d'entrée et de contexte |
| Recherche d'outils | 45 % avec 500 définitions d'outils attachées ; 20 % avec un serveur MCP GitHub | Aucun | Neutre | Réduire les tokens d'entrée et de contexte |
| Fichiers de données via l'exécution de code | 92 % sur une tâche de données de 25 questions | Un gain : 25 sur 25 au lieu de 6 sur 25 | Plus rapide | Réduire les tokens d'entrée et de contexte |
| API Batch | 50 % | Aucun | Résultats sous 24 heures | Mettre en lots le travail qui peut attendre |
| Audit des prompts par rapport au modèle actuel | 14 % sur les deux migrations mesurées | Aucun ; un gain sur l'une d'elles | Plus rapide (moins de tours d'outils) | Auditer les prompts par rapport au modèle actuel |
| Mettre à niveau le modèle | Opus 4.8 vers Opus 5 : 12 points de plus pour un coût par tâche résolue supérieur de 21 % (Opus 5 en low bat Opus 4.8 pour environ 30 % du coût) ; Sonnet 4.6 vers Sonnet 5 : 15 % de moins par tâche résolue, 5 points de plus ; Fable 5 vers Fable 5.1 : 43 % de moins par tâche résolue pour un score à peu près identique | Un gain | Neutre | Mettre à niveau le modèle |
| Réduire l'effort | Travail intellectuel : medium 13 % à 31 %, low un tiers à la moitié ; codage long : medium environ 30 % et low environ deux tiers, tous deux par rapport à high | 1 à 3 points sur le travail intellectuel, 2 à 8 sur le codage long | Plus rapide | Ajuster l'effort |
| Relancer les échecs | Environ 40 % par rapport à une exécution de toutes les tâches en high, avec un taux de réussite identique ou légèrement meilleur | Aucun | Deux exécutions pour les tâches qui échouent | Relancer les échecs avec un effort plus élevé |
| Budget de tâche | 44 % à 58 % | 3 à 6 points | Plus rapide | Définir des budgets et des plafonds de sortie |
| Demander des réponses plus courtes | 39 % des tokens de sortie, 14 % du coût sur l'exécution de triage | Aucun | Plus rapide | Définir des budgets et des plafonds de sortie |
Augmenter max_tokens | Aucune par tâche résolue, mais davantage de tâches résolues | Gains allant jusqu'à 22 points sur l'ensemble interne ; aucun sur la paire publique | Neutre | Définir des budgets et des plafonds de sortie |
| Conseiller | Dépend de l'écart de capacités et du taux de consultation. La paire de codage a obtenu 1,7 point de plus que Claude Opus 5.5 seul en high pour environ 2,1 fois le prix, soit à peu près ce qu'apporte un effort supplémentaire. Avec Claude Opus 5.5, la paire de lecture de graphiques n'a presque jamais consulté le conseiller et a obtenu 7 points de moins qu'Opus 5.5 seul | Un gain sur le codage, une perte sur la lecture de graphiques | Environ un ou deux appels supplémentaires par tâche | Stratégie du conseiller |
| Orchestrateur | Environ la moitié par rapport au modèle de pointe, aussi bien au-delà d'une fenêtre de contexte que sur les queues de coûts des tâches de routine (ces dernières mesurées sur Claude Fable 5) | 10 à 12 points en dessous du modèle de pointe | Beaucoup plus rapide sur les entrées volumineuses | Stratégie de l'orchestrateur |
Benchmarks référencés
Sauf indication contraire dans une référence, les mesures sont des exécutions internes à Anthropic de ces benchmarks. Sauf mention contraire, les coûts sont exprimés en USD aux prix catalogue en vigueur au moment de chaque exécution. Les chiffres de Claude Sonnet 5 utilisent 2 $ et 10 $ par million de tokens d'entrée et de sortie. Les graphiques intitulés « notional USD » (USD théoriques) valorisent le nombre de tokens de chaque requête à ces tarifs au lieu de reprendre des factures.
- WideSearch : Wong et al., « WideSearch: Benchmarking Agentic Broad Info-Seeking », arXiv:2508.07999, 2025. Tâches de recherche web étendue, notées sur l'exhaustivité et l'exactitude d'un tableau de nombreuses lignes ; 200 problèmes, 3 exécutions par configuration, réalisées du 1er au 2 août 2026. Le graphique de concentration des coûts provient d'une exécution distincte de 20 problèmes, avec 3 exécutions par problème, réalisée du 3 au 4 août 2026. Ses coûts sont calculés à partir des enregistrements de facturation par requête.
- GDPval : OpenAI, « GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks », 2025. Livrables de travail intellectuel notés selon les grilles d'évaluation de chaque tâche ; une exécution de 210 tâches de l'ensemble de référence publié, une tentative par tâche, réalisée le 2 août 2026. Un modèle Claude effectue la notation, de sorte que les scores absolus peuvent différer des résultats publiés.
- SWE-bench Pro : Scale AI, « SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks? », 2025. Un sous-ensemble de 482 problèmes, sélectionnés pour leur compatibilité avec le harnais d'évaluation d'Anthropic ; les scores ne sont pas comparables au classement public. Ils ne sont pas non plus comparables aux résultats SWE-bench Pro de la fiche système de Claude Opus 5.5, qui proviennent d'exécutions à l'effort
maxsur un ensemble de problèmes différent. Les chiffres de Claude Opus 5.5 font la moyenne de deux exécutions àlow,medium(sa valeur par défaut) ethigh, et utilisent une seule exécution àxhigh. Toutes ont été réalisées du 19 au 20 septembre 2026, avec le même plafond de 16 384 tokens par tour que les exécutions de Claude Opus 5 d'août. Ce plafond a interrompu 2 tentatives àxhighet aucune aux autres réglages. Les exécutions d'Opus 5.5 ont utilisé une version du benchmark dont les conteneurs de notation ne peuvent atteindre que des miroirs de paquets internes. Cette version écarte un problème dont le test nécessite un site web en ligne, et la solution de référence y échoue sur trois autres. Les comparaisons d'Opus 5.5, ainsi que les chiffres de Claude Fable 5.1 placés à côté, utilisent donc les 478 problèmes restants. Les chiffres SWE-bench Pro de Claude Opus 5 dans Mettre à niveau le modèle et dans le graphique des paires avec conseiller font la moyenne de deux exécutions à son effort par défaut et utilisent une seule exécution àlow, toutes réalisées le 4 août 2026. Les chiffres d'escalade proviennent, tâche par tâche, des exécutions d'Opus 5.5 :lowd'abord, puishighsur ses échecs, a résolu de 96,4 % à 97,5 % des problèmes selon les appariements d'exécutions, pour environ 0,17 $ ;mediumd'abord, de 96,0 % à 97,1 %, pour environ 0,24 $ ;highrelancé sur ses propres échecs, 96,9 %, pour 0,31 $ ; tout àhigh, de 94,8 % à 95,8 %, pour 0,29 $. Les coûts sur ce sous-ensemble sont calculés comme pour l'organisation d'un client. Le prompt antérieur de chaque requête est compté comme une « cache read » (lecture du cache) et ses nouveaux tokens comme une « cache write » (écriture dans le cache) de 5 minutes. Ces montants proviennent des enregistrements d'utilisation des exécutions et ont été vérifiés par rapport au registre d'un client. Jusqu'au 10 septembre 2026, la facturation de l'organisation d'évaluation comptait les lectures du cache par blocs de 8 192 tokens pour Claude Opus 5, Claude Fable 5, Claude Opus 4.7 et Claude Opus 4.8. Elle donnait ainsi des chiffres 1,4 à 1,8 fois plus élevés pour les exécutions de ces modèles. Pour Claude Fable 5.1, Claude Sonnet 5 et Claude Sonnet 4.6, les deux méthodes diffèrent d'environ 9 % au plus. Pour les chiffres de Claude Opus 5.5, elles concordent à 3 % près à chaque réglage d'effort. Les paires avec un exécuteur Claude Sonnet 5 sur le graphique des conseillers proviennent de la même série de mesures sur ce sous-ensemble : la paire Sonnet plus Opus 5 a été exécutée deux fois (les 7 et 8 août 2026, une exécution et une réplication exacte), la paire à faible effort une fois (le 8 août 2026), et Claude Sonnet 5 seul deux fois (77,4 %, la référence pour les deux lignes Pro). Le point Claude Fable 5 dans Mettre à niveau le modèle est la moyenne de trois exécutions à l'effort par défaut, réalisées le 26 août 2026, avec des coûts calculés de la même manière. Les chiffres de budget de tâche de Claude Fable 5.1 correspondent à une exécution par budget (deux à 35 000 tokens) sur le même sous-ensemble, à l'effort par défaut, le 26 août 2026. Une exécution sans budget réalisée le même jour (92,1 %, 1,10 $ par tâche) sert de référence. Une série antérieure à l'effortlow, réalisée le 21 août 2026, a obtenu 88,6 % sans budget pour 0,48 $ par tâche. La comparaison de Comparer les modèles associe cette exécution unique aux deux exécutions regroupées de Claude Sonnet 5 sur le même sous-ensemble. À l'effort par défaut de Fable 5.1, le résultat s'inverse : Fable 5.1 coûte 41 % de plus par tâche résolue que Sonnet 5. L'échelle de mise à niveau compte une exécution par modèle avec ses paramètres par défaut livrés, sauf Opus 5 et Sonnet 5 (deux exécutions chacun) et le point Fable 5 décrit ci-dessus. Les exécutions Opus et Sonnet ont eu lieu la même semaine, dans un même harnais et une même organisation. - BrowseComp : Wei et al., « BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents », OpenAI, 2025. Les chiffres d'effort utilisent une sélection de 500 problèmes, avec une à trois exécutions par réglage, réalisées le 3 août 2026. Le point par défaut regroupe deux exécutions des 26 et 27 juillet 2026. Le graphique d'assurance des coûts utilise 10 problèmes résolus de manière fiable, issus d'une tranche de 26 problèmes. Il repose sur 50 exécutions déléguées (du 1er au 2 août 2026) et 70 exécutions en solo (50 du 2 au 3 août 2026 ; 20 archivées des 12 et 13 juillet et du 1er août 2026). L'espérance est de 6,45 $ contre 11,99 $ par exécution. Les chiffres délégués comportent une marge de mesure d'environ 20 %.
- Mise à l'échelle des architectures d'agents : Kim et al., « Towards a Science of Scaling Agent Systems », arXiv:2512.08296, 2025. Étude externe indépendante, citée uniquement pour le sens de sa conclusion sur les cas où la délégation n'est pas rentable, et non pour ses chiffres.
- DeepWideSearch : « DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking », arXiv:2510.20168, 2025. Les 220 questions couvrent 15 domaines et combinent chacune une collecte sur de nombreuses lignes et une récupération multi-étapes. Mesuré sur l'ensemble de lignes permanent du benchmark, avec 3 exécutions par configuration, réalisées le 2 août 2026. Le point de l'équipe à un seul worker a été exécuté du 26 au 27 juillet 2026.
- DeepResearch Bench II : Li et al., « DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report », arXiv:2601.08536, 2026. Ses 132 tâches de recherche couvrent 22 domaines et sont notées selon des grilles binaires établies à partir de rapports d'experts. Mesuré sur un sous-ensemble de 50 tâches stratifié sur tous les thèmes, avec une tentative par tâche et 3 exécutions par réglage. Les exécutions ont eu lieu sur Claude Managed Agents, avec les outils de recherche et de récupération web de la plateforme (du 26 au 27 août 2026). La notation porte sur les 33 tâches qu'aucune configuration n'a refusées, sans les tentatives interrompues par les classificateurs de sécurité de production. Les coûts correspondent à ce qui est facturé à un client : les requêtes de la plateforme plus les frais de recherche web. Les scores sont la moyenne de chaque modèle sur la base des 33 tâches, sans ses propres tâches préemptées. Sur les 21 tâches propres dans chaque bras, Claude Fable 5.1 conserve une avance de 2 à 3 points sur Claude Fable 5 à chaque niveau d'effort. Les scores des deux modèles restent stables quel que soit l'effort. Le graphique de mise en cache recalcule le prix des mêmes requêtes en facturant chaque token d'entrée au tarif sans cache. Claude Opus 4.6 sert de juge selon le protocole de grille du benchmark. L'original utilise un juge différent, et un juge Anthropic peut favoriser le style maison. Claude Opus 5, à son effort par défaut, a été exécuté trois fois sur la même surface et le même sous-ensemble, le 28 août 2026. Il a obtenu 68,8 % sur les 50 tâches brutes, 70,8 % sur la base des 33 tâches et 71,1 % sur l'ensemble des 21 tâches, pour 6,71 $ par tâche (23,72 $ sans mise en cache). Aucune de ses tentatives n'a été interrompue par les classificateurs de sécurité. Il a toutefois été exécuté avec un déploiement de protections plus récent que celui des autres modèles.
- Balayage des défauts d'un corpus : Benchmark interne à Anthropic, pour un travail qui dépasse une fenêtre de contexte. Le corpus compte 21,6 millions de tokens, issus des sources de 14 paquets Python publics, avec 130 défauts implantés et une notation déterministe. Le protocole a été fixé avant les exécutions et revu en interne, avec trois exécutions par configuration. Toutes les configurations ont été exécutées sur Claude Managed Agents. Dans la configuration d'équipe représentée, le coordinateur Claude Fable 5.1 a mené l'ensemble du balayage au sein de la plateforme, le 30 août 2026. Il utilisait la limite documentée de la plateforme, soit 25 workers Claude Sonnet 5 simultanés. Après l'audit des éléments supplémentaires, ses trois épisodes ont obtenu un F1 de 0,764, 0,825 et 0,791 (valeurs brutes : 0,751, 0,821 et 0,781), pour 225 $, 234 $ et 283 $. La configuration Claude Sonnet 5 en solo a été exécutée du 3 au 4 août 2026. Les configurations Claude Fable 5.1 en solo ont été exécutées du 24 au 25 août 2026, avec les paramètres de service de lancement de la plateforme. Elles comptaient trois graines par réglage d'effort, sur la même version du corpus. L'image du bac à sable contenait des copies installées d'une partie du corpus. Dans 7 épisodes sur 9, l'étape d'assemblage final de Claude Fable 5.1 s'est comparée à ces copies. Une nouvelle notation sans ces ajouts a modifié les scores des graines concernées de 3 points au plus. Le F1 absolu est propre à cette version du corpus et n'est pas comparable d'un benchmark à l'autre. Les comparaisons de configurations se font à conditions égales.
- GPQA Diamond : Rein et al., « GPQA: A Graduate-Level Google-Proof Q&A Benchmark », 2023. Le sous-ensemble Diamond de 198 questions, avec deux exécutions par configuration, réalisées le 7 août 2026 (le 19 septembre 2026 pour Claude Opus 5.5). Un modèle note les réponses par rapport aux réponses de référence, et les tokens du conseiller sont comptabilisés par requête. Une vérification de sécurité de la plateforme a refusé deux questions de biologie sur les exécuteurs Claude Sonnet 5, dont l'une également sur Claude Opus 5. Les exclure ne modifie aucune comparaison de plus d'un point. Les 92 % de Claude Opus 5.5 proviennent de deux exécutions qui définissent
fallbacks: "default"pour activer le « server-side fallback » (repli côté serveur). Toute tentative qui se terminait malgré tout par un refus a été comptée comme fausse. Dans chaque exécution, la vérification de sécurité a signalé six questions de biologie. Claude Opus 5 a répondu à cinq d'entre elles via le repli, et la sixième s'est tout de même terminée par un refus. Le coût par question d'Opus 5.5 inclut ces réponses de repli. Si les refus ne sont pas comptés comme faux, ces exécutions obtiennent 93 %. En effet, le correcteur attribue tout de même une option de réponse à une tentative refusée, généralement la bonne. Avec les refus comptés comme faux, les exécutions de Claude Opus 5 obtiennent 91 % (un refus par exécution). Deux exécutions de Claude Opus 5.5 avec le repli désactivé obtiennent le même score ; Opus 5.5 y a refusé cinq ou six questions de biologie par exécution. - DeepSWE : Datacurve, « DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks », arXiv:2607.07946, 2026. L'ensemble comprend 113 tâches originales dans cinq langages, avec des vérificateurs basés sur des programmes. Chaque paire compte deux exécutions, réalisées le 7 août 2026, avec les tokens du conseiller comptabilisés par requête. Ces paires ont utilisé une boucle de conseiller côté client plutôt que l'outil advisor, avec une comptabilité identique. Les balayages d'effort à modèle unique sont des exécutions uniques, dont le prix est calculé à partir du nombre de tokens selon une approximation qui tient compte du cache. Les coûts par tâche correspondent aux totaux des exécutions divisés par 113.
- Benchmark interne de codage agentique : Benchmark interne à Anthropic : 370 tâches de dépôt, notées par les tests des dépôts eux-mêmes. Les chiffres de l'API ont été mesurés avec un plafond de sortie de 128 000 tokens et une exécution par configuration : Opus 5 seul, à l'effort par défaut du 9 au 10 août 2026, puis à
lowetmediumle 10 août 2026 ; Claude Fable 5.1 seul, à cinq valeurs d'effort définies explicitement, le 20 août 2026 (le graphique en montre trois) ; et la paire, du 24 au 25 août 2026. Claude Opus 5.5 seul a été exécuté sur les 370 tâches, du 19 au 20 septembre 2026. Il a effectué cinq tentatives par tâche à son effort par défaut (medium) et àhigh, et une seule àlowetxhigh. À chaque réglage, 369 tâches sur 370 ont été notées, en raison d'un échec de vérification de configuration. L'exécuteur Claude Opus 5.5 àhigha été associé à la version publiée de Claude Fable 5.1 comme conseiller (les exécutions d'août utilisaient un instantané de pré-publication). Il a effectué cinq tentatives par tâche aux mêmes dates. Une tâche a échoué à sa vérification de configuration, de sorte que 1 845 tentatives ont été notées. Les 279 tentatives où le conseiller a été refusé en raison de la charge ont été relancées. Les tentatives dont les consultations ont expiré ont été conservées, comme en août. En août, la paire et le contrôle Claude Opus 5 comptaient cinq tentatives par tâche, et les autres points une seule. La paire d'août a consulté le conseiller environ deux fois par tentative en moyenne. La paire Claude Opus 5.5 a demandé 1,39 consultation par tentative et en a obtenu 1,35. Les coûts sont indiqués par tentative et calculés comme pour l'organisation d'un client, aux prix catalogue. Pour chaque requête de la boucle d'agent, le prompt antérieur est compté comme une lecture du cache et les nouveaux tokens comme une écriture dans le cache de 5 minutes, d'après les enregistrements d'utilisation des exécutions. Chaque appel au conseiller, qui n'utilise pas de cache, est valorisé à partir de ses tokens enregistrés. Les chiffres de Claude Code proviennent d'exécutions des mêmes tâches du 8 au 23 juillet 2026, avec une exécution par configuration et des coûts approximatifs. - Benchmark interne de tâches de dépôt (mesure du plafond) : Un ensemble distinct, interne à Anthropic, d'environ 130 tâches de dépôt. Il a été exécuté le 20 août 2026 (Claude Fable 5.1) et le 19 septembre 2026 (Claude Opus 5.5, à son effort par défaut,
medium). Les exécutions utilisaient une simple boucle d'agent API, avec une tentative par tâche. Les exécutions de Claude Fable 5.1 comptent 135 tâches par plafond, à l'effort par défaut défini explicitement. Le chiffre à 16 384 tokens fait la moyenne de deux exécutions (36,3 % pour chacune). Les chiffres à 64 000 et 128 000 tokens proviennent d'exécutions uniques (58,5 % et 60,0 %). Six problèmes ont provoqué un refus de sécurité dans chaque exécution et comptent comme des échecs. Pour Claude Opus 5.5, le chiffre à 16 384 tokens fait la moyenne de deux exécutions (134 et 135 tâches notées). Ses chiffres à 64 000 et 128 000 tokens proviennent d'exécutions uniques (135 tâches chacune). Dans chaque exécution à 16 384 tokens, deux tentatives se sont terminées par un refus de sécurité et comptent comme des échecs. Les chiffres de plafond SWE-bench Pro correspondent à une exécution de Claude Fable 5.1 par plafond, à l'effort par défaut, le 26 août 2026. Ils portent sur un sous-ensemble de 100 problèmes, stratifié à partir de l'ensemble de 482 problèmes de la référence 3, et ne sont pas comparables à ses scores. À l'effort par défaut, les deux plafonds ont obtenu le même score. Les distributions par tour du graphique proviennent des exécutions de Claude Opus 5.5 et de Claude Fable 5.1 à 128 000 tokens. Aucun tour d'Opus 5.5 n'a atteint le plafond : le plus long comptait environ 61 000 tokens, et 0,56 % de ses tours ont dépassé 16 384 tokens. Un tour de Fable 5.1 a atteint 128 000 tokens, et 0,46 % de ses tours ont dépassé 16 384 tokens. - Chartography : Surge AI, « Chartography », 2026. L'ensemble complet publié de 100 questions, mesuré les 6 et 9 août 2026 (Claude Opus 5 seul) et le 20 septembre 2026 (Claude Opus 5.5). Les mesures utilisent l'implémentation d'Anthropic sur Claude Managed Agents, avec le bac à sable cloud standard ; les configurations avec conseiller utilisent le conseiller de Managed Agents. Claude Sonnet 4.6 effectue la notation à la place du juge de référence, et le benchmark s'exécute avec des outils. Les scores sont donc comparables entre les configurations de cette page, mais pas avec le classement publié. Ils ne sont pas non plus comparables aux résultats Chartography de la fiche système de Claude Opus 5.5, qui utilisent un autre correcteur et l'effort
max. Chaque configuration compte deux exécutions regroupées (trois pour Claude Opus 5.5). Les écarts d'une exécution à l'autre atteignaient 10 points. Les coûts correspondent à ce qui est facturé à un client qui exécute l'agent régulièrement. La première requête de chaque graphique lit depuis le cache l'invite système et les outils partagés de l'agent. C'est le cas lorsqu'une autre session du même agent a été exécutée dans les 5 minutes précédentes. Un graphique exécuté isolément coûte environ 0,03 $ de plus avec Claude Opus 5 ou Claude Opus 5.5, et environ 0,12 $ de plus avec Claude Fable 5.1. Les chiffres d'août ont été recalculés de cette manière à partir des enregistrements d'utilisation des exécutions. Jusqu'au 10 septembre 2026, la facturation de l'organisation d'évaluation comptait les lectures du cache de Claude Opus 5 par blocs de 8 192 tokens, ce qui surestimait ses coûts. Les coûts excluent le temps de bac à sable, qui a ajouté moins de 1 % aux exécutions d'août. Les exécutions en solo de Claude Fable 5.1 datent du 24 août 2026, avec les paramètres de service de lancement de la plateforme et deux exécutions par réglage. Six tentatives ont atteint le plafond de session de 15 minutes et obtiennent 0. Dans chaque exécution, Claude Opus 5 a répondu à deux graphiques après un refus de sécurité. L'exécuteur Claude Opus 5 à faible effort, associé à un conseiller Claude Fable 5.1, a été exécuté deux fois le 30 août 2026, avec les mêmes paramètres. Il a obtenu 63,0 et 67,0 (moyenne de 65,0), pour 0,47 $ par graphique. Le conseiller a été consulté sur 88 % des tâches dans chaque exécution. Sur ses 219 réponses, 4 provenaient de Claude Opus 5, chaque fois après qu'un filtre de sécurité de production a bloqué la réponse du conseiller. Claude Opus 5.5 a été exécuté àlow, avec le repli côté serveur désactivé et un classificateur de sécurité qui évaluait chaque appel d'outil. Il a obtenu 70, 68 et 68 lors de trois exécutions seul. Lors de trois exécutions avec un conseiller Claude Fable 5.1 configuré, il a obtenu 59, 63 et 63, et n'a consulté le conseiller que sur 1 tâche sur 300. La comparaison des taux de consultation pour les paires antérieures provient d'une réexécution des mêmes configurations sur l'API Messages, avec un ensemble d'outils de conteneur, du 10 au 11 août 2026. - Évaluation d'audit de prompts pour un service d'assistance : Un ensemble de 44 tickets d'assistance construit par Anthropic, avec une notation déterministe. Il a été exécuté début août 2026, et les résultats ont été rapportés le 8 août 2026. Les exécutions utilisaient six invites système. Chacune ajoutait au même prompt de base un motif courant dans les prompts rédigés pour Claude Opus 4.8 et Claude Sonnet 4.6. Chaque point du graphique correspond à l'un des trois cas suivants, moyenné sur les six prompts et les 44 tickets : ancien modèle, nouveau modèle sur le même prompt, nouveau modèle après l'audit. Le gain de précision d'Opus 5 a un intervalle de confiance à 95 % de 3 à 8 points. Les différences de précision de Sonnet restent dans le bruit.
- Ensemble de questions sur fichier de données : Un ensemble de 25 questions d'agrégation construit par Anthropic, portant sur une tranche de 1 862 lignes d'un CSV public de ventes d'alcool. La vérité terrain a été calculée avec pandas, et la notation repose sur une correspondance exacte. L'ensemble a été exécuté sur Claude Sonnet 5 et Claude Opus 5 le 19 août 2026, avec trois exécutions par configuration. La réflexion était désactivée, car le bras en contexte ne peut pas aboutir avec le réglage par défaut. Le plafond de sortie était de 4 000 tokens, sans mise en cache des prompts. Le bras fichier téléverse le CSV via l'API Files et utilise l'outil
code_execution_20260120. - Mesure de la durée du cache : La tâche de triage de 20 tickets de Réduire les tokens d'entrée et de contexte, exécutée sur l'API Messages avec le même harnais, sur Claude Sonnet 5 le 23 août 2026 et sur Claude Opus 5.5 les 19 et 20 septembre 2026, à son effort par défaut (
medium) et àhigh. Les exécutions de Claude Opus 5.5 utilisaient un portage du harnais qui envoie les mêmes corps de requête, avecmax_tokensporté à 4 096. Des pauses ont été insérées avant une part de tours choisie aléatoirement : aucune pause, 5 % des tours, 10 % des tours et une pause de 6 minutes avant chaque tour sur les 20 tickets pour les deux modèles, plus une pause de 2 minutes avant chaque tour sur Claude Sonnet 5 uniquement, ainsi que des pauses de 20 et 45 minutes sur un sous-ensemble de 5 tickets pour les deux modèles. Les chiffres de keep-alive de Claude Opus 5 ci-dessous proviennent de la même tâche, exécutée le 23 août 2026 avecmax_tokensporté à 4 096. Les calendriers étaient les mêmes, sauf les pauses de 2 et 45 minutes. Chaque cellule compte trois exécutions. Le coût est calculé aux prix catalogue à partir des champsusagede chaque réponse. Pour Claude Opus 5.5, ces prix sont, par million de tokens : 4 $ en entrée, 5 $ pour l'écriture de 5 minutes, 8 $ pour l'écriture d'1 heure, 0,20 $ pour la lecture du cache et 20 $ en sortie. Claude Sonnet 5 a été exécuté sur une organisation interne à Anthropic, dont l'utilisation est facturée comme celle d'une organisation cliente. La précision est mesurée par rapport aux mêmes étiquettes de référence. Les chiffres de Claude Opus 5.5 sur cette page couvrent les deux niveaux d'effort. Le point de bascule se situe à environ 3,3 % des tours sur Claude Sonnet 5, et entre 3,1 % et 3,2 % sur Claude Opus 5.5. Il s'agit de la médiane de la part d'équilibre de chaque session. Le modèle de coûts calcule cette part à partir des tailles de contexte tour par tour de la session. La médiane porte sur les 45 sessions de vingt tickets de Claude Sonnet 5 et sur les 36 sessions de vingt tickets de Claude Opus 5.5 à chaque niveau d'effort. Chaque calendrier de pauses a été exécuté sur la tâche complète, avec les trois réglages de cache et trois exécutions chacun ; les cellules de 5 tickets ne sont pas incluses. Dans la cellule à 5 %, les réglages de 5 minutes et d'1 heure sont arrivés à égalité sur Claude Sonnet 5, car les pauses de ce tirage sont tombées sur de petits préfixes. Sur Claude Opus 5.5, ils étaient presque à égalité. La règle de 1 sur 20 de la page se situe au-dessus du point de bascule mesuré. Le délai avant le premier token de Claude Opus 5.5 après une pause n'a pas été mesuré. Anthropic a mesuré des requêtes de keep-alive qui rafraîchissent le cache de 5 minutes, toujours envoyées avecmax_tokens: 1. Ces mesures ont porté sur Claude Sonnet 5 et Claude Opus 5 le 23 août 2026, et sur Claude Opus 5.5 dans les exécutions ci-dessus. Par rapport au réglage d'1 heure, sur Claude Sonnet 5, le keep-alive coûtait 7,7 % de moins avec 5 % des tours en pause, et à peu près autant avec 10 % ; sur Claude Opus 5, aucune différence n'était mesurable avec l'une ou l'autre part ; sur ces deux modèles, le keep-alive coûtait plus cher avec une pause de 6 minutes ou plus avant chaque tour. Sur Claude Opus 5.5, le keep-alive coûtait de 8 % à 18 % de moins que le réglage d'1 heure avec 5 % et 10 % des tours en pause. L'écart est d'environ 10 % à 15 % une fois le bruit entre sessions éliminé, en refacturant les tokens de chaque session de keep-alive aux prix du cache d'1 heure. Avec une pause avant chaque tour, il coûtait plus cher : de 4 % à 6 % de plus à 6 minutes, de 9 % à 10 % à 20 minutes, et de 56 % à 58 % à 45 minutes. Le keep-alive a permis d'économiser davantage sur Claude Opus 5.5, car chaque requête de keep-alive relit le préfixe au prix de lecture du cache. Ce prix vaut 0,05x le prix d'entrée sur Claude Opus 5.5, contre 0,1x sur Claude Sonnet 5 et Claude Opus 5. Refacturées aux prix de Claude Opus 5.5, les sessions de Claude Opus 5 montrent presque les mêmes économies que Claude Opus 5.5. Les tests d'API de pré-lancement d'Anthropic sur Claude Opus 5.5 montrent qu'une requêtemax_tokens: 0écrit dans le cache et que la requête suivante le lit. En revanche, Anthropic n'a pas mesuré sur Opus 5.5 si une telle requête rafraîchit une entrée existante. Sur Claude Fable 5.1, où ce prix vaut 0,025x, le keep-alive était moins cher même avec une pause avant chaque tour, sauf avec des pauses de 45 minutes (référence 19). - Part des lectures du cache en production : Utilisation agrégée de l'API Claude first-party sur les 14 jours se terminant le 23 août 2026. Les données portent uniquement sur le produit API direct, excluent les organisations internes à Anthropic et n'identifient aucune organisation. Un jour-organisation compte comme une boucle d'agent lorsque ses requêtes comportent des définitions d'outils et des résultats d'outils, que ses prompts contiennent en moyenne 9 appels d'outils antérieurs ou plus, que la mise en cache a été utilisée et qu'il compte au moins 10 requêtes de ce type. L'API n'a pas d'identifiant de conversation, et ce critère sert donc d'indicateur de la longueur des conversations. L'échantillon compte 303 003 jours-organisation, répartis sur 106 487 organisations. La part médiane des lectures du cache atteint 84,2 % de l'ensemble des tokens d'entrée, et le quartile supérieur 91,7 %. Les étiquettes de cas d'usage couvrent 74 % de ces jours-organisation et 99 % de leurs tokens. Il s'agit du cas d'usage déclaré par l'organisation ou, à défaut, de son cas d'usage classifié. Les organisations de codage fournissent 87 % des tokens d'entrée agentiques. Leur part médiane de lecture est de 88,5 % (90,9 % à partir de 25 appels d'outils antérieurs), et leur quartile supérieur de 93,4 %. Environ 72 % des jours-organisation de codage atteignent 80 % ou plus. Les agents de support, de recherche et de données lisent de 84 % à 85 %. Le décile supérieur des jours-organisation lit 95,9 % ou plus pour le codage. Pour les agents de support, de recherche, de données et autres, il lit de 94,2 % à 94,8 %. La répartition par requête à partir de 25 appels d'outils antérieurs provient d'un échantillon de six heures. Pour le codage, elle est de 92 % en lecture, 7 % en écriture et moins de 1 % sans cache. Les organisations sans étiquette, pour la plupart de petite taille, ont une part médiane de lecture de 11 %. Les jours-organisation sans définitions d'outils ont une part médiane de lecture de 34,6 %. Une requête indépendante sur la même période reconstitue les conversations de 10 requêtes ou plus au lieu d'évaluer les jours-organisation. Elle situe la médiane à 90,2 %. La différence tient au périmètre, pas aux données.
- Mesure du moment de la compaction : La variante longue de l'agent de triage de Réduire les tokens d'entrée et de contexte, exécutée le 24 août 2026 sur Claude Sonnet 5 avec le cache de 5 minutes. Le coût est calculé aux prix catalogue à partir des champs d'utilisation, avec cinq sessions par bras : un bras sans changement, à l'effort par défaut du début à la fin (0,81 $ par session), et deux bras qui commencent à faible effort et effectuent les deux mêmes changements qui invalident le cache, à savoir un passage à l'effort par défaut et l'ajout d'un outil. Le premier effectue ces changements en cours de session, aux requêtes 12 et 17 (0,95 $). Le second les effectue ensemble, à la première requête qui suit la première compaction (0,75 $). Un quatrième bras de six sessions, exécuté le 25 août 2026, a effectué les deux mêmes changements sur la requête ayant déclenché la première compaction (0,92 $ par session). Dans ce quatrième bras, la passe de résumé de la requête déclenchante a écrit le contexte de 81 000 tokens dans le cache au lieu de le lire. Cette passe a donc coûté 0,21 $, contre 0,04 $ pour la même passe dans le bras à la frontière. La première compaction a eu lieu entre les requêtes 21 et 25 (à la requête 22 pour 16 des 21 sessions), une fois que le prompt a dépassé le seuil de compaction de 80 000 tokens. Deux sessions sans changement ont été compactées une seconde fois vers la fin. Le bras à la frontière coûte moins au total que le bras sans changement, mais la mise en cache n'en est pas la cause. L'écart vient de ses requêtes à faible effort avant le changement et de ces secondes compactions : les coûts de réécriture des deux bras diffèrent de moins d'un cent. Le bras en cours de session a payé 0,23 $ par session en réécritures du cache. L'écart entre les bras en cours de session et à la frontière était de 0,20 $, avec un intervalle de confiance à 95 % de 0,11 $ à 0,29 $. Une session du bras en cours de session a coûté peu (0,82 $). Après la compaction, son modèle a mal appelé l'outil de recherche et a obtenu des résultats vides. Cette session est incluse ; sans elle, la moyenne du bras serait de 0,98 $. La précision moyenne était de 14,2 étiquettes sur 20 dans chaque bras du 24 août, et de 14,7 dans le bras du 25 août. Les lectures du cache représentaient 91 % des tokens de prompt sans changement, 85 % en cours de session, 91 % à la frontière et 86 % avec les changements sur la requête déclenchante.
- Mesure de la durée du cache sur Claude Fable 5.1 : La même tâche de triage de 20 tickets et le même harnais que la référence 16, exécutés les 23 et 26 août 2026 sur l'instantané de lancement de Claude Fable 5.1. Les prix de lancement sont, par million de tokens : 10 $ en entrée, 12,50 $ pour l'écriture de 5 minutes, 20 $ pour l'écriture d'1 heure, 0,25 $ pour la lecture du cache et 50 $ en sortie. Chaque calendrier a été testé avec trois réglages : le cache de 5 minutes, le cache d'1 heure et le cache de 5 minutes maintenu actif par une requête
max_tokens: 0sur le préfixe inchangé, toutes les 4 minutes à partir du début de la requête précédente. Les exécutions du 23 août envoyaient les requêtes de keep-alive avecmax_tokens: 1. Dans les cellules du 26 août rapportées ici, chaque requête de keep-alive a rafraîchi le cache sans facturer de sortie. Les calendriers étaient les suivants : aucune pause, 10 % des tours en pause et une pause de 6 minutes avant chaque tour sur les 20 tickets, ainsi que des pauses de 45 minutes sur le sous-ensemble de 5 tickets. Chaque cellule compte trois exécutions, sauf la cellule de keep-alive du 26 août avec des pauses de 45 minutes, qui en compte six. Le coût est calculé aux prix catalogue à partir des champsusagede chaque réponse. La précision est mesurée par rapport aux mêmes étiquettes de référence (de 12 à 17 étiquettes exactes sur 20). Moyennes par session le 26 août, pour les réglages 5 minutes, 1 heure et keep-alive : sans pause, 2,42 $, 3,09 $ et 2,29 $ ; 10 % des tours en pause, 4,50 $, 2,96 $ et 2,36 $ ; pause avant chaque tour, 22,89 $, 3,01 $ et 2,62 $. Les cellules du 23 août concordent à 6 % près. Le 26 août, un incident de facturation du cache a faussé les premières cellules de la journée. Les chiffres à 45 minutes (1,68 $, 0,59 $ et 0,71 $ par session de 5 tickets) proviennent donc d'une réexécution propre effectuée le même jour. Les exécutions du 23 août ont donné 1,67 $, 0,58 $ et 0,70 $. Le point de bascule entre les réglages de 5 minutes et d'1 heure se situe à 3,1 % des tours, selon la même mesure que la référence 16. - Terminal-Bench 3 : Les 74 tâches du benchmark public d'agents de terminal, exécutées sur Claude Managed Agents du 27 au 28 août 2026. Les exécutions utilisaient deux outils personnalisés à la place des outils intégrés de la plateforme : un shell et un éditeur de fichiers, que le harnais d'évaluation exécute dans le conteneur de chaque tâche. Les autres paramètres étaient ceux de la plateforme par défaut pour les comptes externes, avec deux exécutions par modèle à l'effort
high. Ces exécutions ont utilisé la version 3.0 de Terminal-Bench. Leurs scores ne sont donc comparables ni au classement public de Terminal-Bench, ni aux résultats Terminal-Bench 4.0 de la fiche système de Claude Opus 5.5. Ces derniers proviennent d'exécutions dans Claude Code à l'effortmax. Les limites de temps de chaque tâche valent 2,5 fois celles du benchmark. L'agent dispose ainsi de 75 minutes à 20 heures par tâche (5 heures pour la tâche médiane). Chaque tâche dispose de trois fois la mémoire qu'elle spécifie, soit de 6 Gio à 96 Gio. Les 12 tâches qui exécutent des services auxiliaires reçoivent de la mémoire supplémentaire. L'agent n'avait pas d'accès général à Internet. Ses conteneurs pouvaient atteindre un miroir de paquets interne, une courte liste de sites de téléchargement, dont GitHub et le Python Package Index, ainsi que quelques sites propres à certaines tâches. Huit des tâches n'avaient aucun accès réseau. Les scores sont des taux de réussite bruts sur les 148 tentatives par modèle. D'une exécution à l'autre, les scores varient de 5 à 11 points. Les coûts correspondent à ce qu'un client paierait aux prix catalogue. Ils ont été recalculés requête par requête à partir des enregistrements d'utilisation des exécutions, avec la durée de vie du cache de 5 minutes. Claude Opus 4.7 a atteint son plafond de sortie dans 11 de ses 148 tentatives. - DRACO : Perplexity, « DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity », arXiv:2602.11685, 2026. Ses 100 tâches de recherche couvrent 10 domaines et sont notées selon des grilles rédigées par des experts. Le score est le score normalisé du benchmark. Toutes les configurations ont été exécutées sur l'API Claude avec Claude Fable 5.1, avec les réglages suivants : la réflexion adaptative par défaut, les classificateurs de sécurité de production activés et
max_tokensà 128 000. Les configurations étaient les suivantes : un agent unique à l'efforthigh, un agent unique à l'effortmedium, l'agent unique àhighavec l'instruction et l'horloge, et une équipe àhigh, avec et sans l'instruction et l'horloge. L'équipe est un agent principal qui lance, via un outil, des agents auxiliaires du même modèle, sans limite de nombre. Sur DRACO, l'agent principal a lancé en médiane 4 auxiliaires par tentative. Chaque configuration a effectué trois tentatives par tâche, du 8 au 10 septembre 2026. Toute tentative qui atteignait la limite de quatre heures a été relancée, et seule la nouvelle tentative compte. Les seules tentatives écartées sont les 3 tentatives d'une même tâche pour l'agent unique à l'effortmedium. Cette configuration couvre donc 99 tâches. Cette tâche a expiré à chaque tentative, lors de l'exécution initiale comme lors de la réexécution. La notation du benchmark attribuerait 0 à ces 3 tentatives. Appliquer cette règle n'affecte que les deux comparaisons avec l'effortmedium: la baisse de score à l'effortmediumpar rapport àhighpasse de 0,7 à 1,7 point, et la baisse de score avec les deux modifications par rapport à l'effortmediumpasse de 1,2 à 0,2 point. Les agents ont utilisé un outil de recherche et un outil de récupération, hébergés par le harnais d'évaluation sur un index web figé. Ces outils déterminent une partie du temps d'exécution, et les vôtres fonctionneront à une vitesse différente. La page indique donc le temps sous forme de ratio entre configurations, et non en minutes. Le temps correspond au temps réel écoulé par tâche, de la première à la dernière requête, tous agents confondus. Il exclut le temps estimé d'attente avant de relancer des requêtes après des erreurs de limite de débit ou de surcharge. Ces erreurs provenaient des limites partagées du compte de test. Toutes les configurations d'une série ont démarré ensemble. Les plus lentes ont terminé des heures plus tard, et une partie de leur temps s'est donc déroulée sous une charge différente. Le coût de chaque tâche correspond à ses requêtes, valorisées aux prix catalogue publics, pour les tokens du modèle uniquement. La mise en cache des prompts est facturée comme pour un client qui place un point d'arrêt de cache à la fin de chaque requête et utilise la durée de vie du cache de 5 minutes. Les outils du harnais d'évaluation n'entraînent aucun frais supplémentaire. Les variations de score sont des différences appariées sur les tâches, avec des intervalles bootstrap à 95 %. Une variation est considérée comme comprise dans la marge lorsque son intervalle reste dans les 1,5 point sur DRACO et dans les 2,5 points sur HLE. Anthropic a fixé ces marges avant les exécutions. Claude Opus 5 note les réponses. Dans chaque configuration, ses notes diffèrent de celles du correcteur propre à chaque ensemble : elles sont supérieures de 1,9 à 2,4 points sur DRACO, inférieures de 2,2 à 2,9 points sur HLE (Opus 5 a noté 495 des 500 questions, et le correcteur du benchmark les a toutes notées) et inférieures de 1,3 à 2,0 points sur l'ensemble de physique, dont le correcteur utilise lui aussi les solutions de référence d'experts. Les deux correcteurs s'accordent sur le sens de chaque variation. - HLE : Phan et al., « Humanity's Last Exam », arXiv:2501.14249, 2025. Questions rédigées par des experts, avec des réponses exactes, notées par rapport aux réponses de référence. Mesuré sur les 500 premières questions, avec la même configuration que la référence 21. Les sources du benchmark lui-même étaient bloquées dans la recherche. Chaque configuration a effectué trois tentatives par question, du 8 au 10 septembre 2026. Claude Opus 5 compare chaque réponse à la réponse de référence, avec la réflexion adaptative activée, comme par défaut. Dans chaque configuration, le juge a noté 495 des 500 questions, et les scores portent sur ces 495 questions. Pour les 5 autres, la requête de notation dépassait la limite d'1M de tokens du juge. Toute tentative qui atteignait la limite de quatre heures a été relancée, et seule la nouvelle tentative compte. Chaque configuration dispose donc des 1 500 tentatives. La notation du benchmark attribuerait 0 aux 5 questions non notées. Appliquer cette règle ne modifie aucune conclusion.
- Ensemble de physique : Un ensemble interne de 70 problèmes de physique de niveau recherche, adapté du benchmark public CritPt : Zhu et al., « Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark », arXiv:2509.26574, 2025. Des relecteurs experts ont corrigé les énoncés des problèmes. Claude Opus 5 note chaque réponse par rapport à des solutions de référence d'experts, qui ne sont pas publiques. Les scores ne peuvent donc pas être comparés aux résultats publiés. Le score d'un problème est la note moyenne de ses tentatives, et le score global est la moyenne sur l'ensemble des problèmes. Mesuré sur les 70 problèmes, avec quatre tentatives par problème, du 8 au 9 septembre 2026. Chaque agent disposait d'un outil Python, d'un shell et d'un éditeur de fichiers, dans un conteneur de bac à sable sans accès réseau. Aucun outil de recherche ou de récupération n'était disponible. Pour le reste, la configuration est celle de la référence 21. Aucune marge de score n'a été fixée pour l'ensemble de physique avant les exécutions. La page indique donc ses variations de score avec leurs intervalles à 95 %, sans les décrire comme comprises dans une marge.
Prochaines étapes
Le plus grand gain gratuit de cette page : configuration, durées de vie et diagnostics.
Échangez de l'intelligence contre de la latence et du coût au sein d'un même modèle.
Évaluez les capacités, la vitesse et le coût dans toute la famille de modèles Claude.
Donnez aux boucles d'agent un décompte de tokens par rapport auquel elles s'autorégulent.
Fixez un plafond strict en dollars sur une session Managed Agents.
Consultez la tarification actuelle par token pour chaque modèle Claude.
Appliquez ces leviers un par un à un agent fonctionnel dans un notebook exécutable, avec le coût par tâche après chaque étape.
Regardez une présentation pas à pas des modèles de conseiller et d'orchestrateur.
Was this page helpful?