Otimizando para custo e inteligência
Equilibre custo e inteligência na Claude Platform, com resultados medidos para cache de prompt, esforço, escolha de modelo, orçamentos e estratégias multimodelo.
Quando uma carga de trabalho passa do protótipo para a produção, o custo se torna uma restrição de design de primeira ordem. O modelo mais capaz pode ser caro demais em escala, e o modelo mais barato pode deixar a desejar em qualidade. Gerenciar bem o custo significa entender como cada alavanca de custo afeta a qualidade da saída, porque algumas alavancas sacrificam qualidade e outras não. A Claude Platform oferece controle direto sobre esse "tradeoff" (compensação). Você escolhe o modelo, o nível de "effort" (esforço) e a arquitetura de cada requisição, o que permite posicionar uma carga de trabalho em praticamente qualquer ponto da fronteira entre custo e inteligência.
Custo e inteligência costumam ser representados como uma fronteira em que um se obtém à custa do outro. O primeiro grupo de alavancas desta página aproxima uma carga de trabalho dessa fronteira, cortando custo sem afetar a qualidade; apenas o segundo grupo se move ao longo dela:
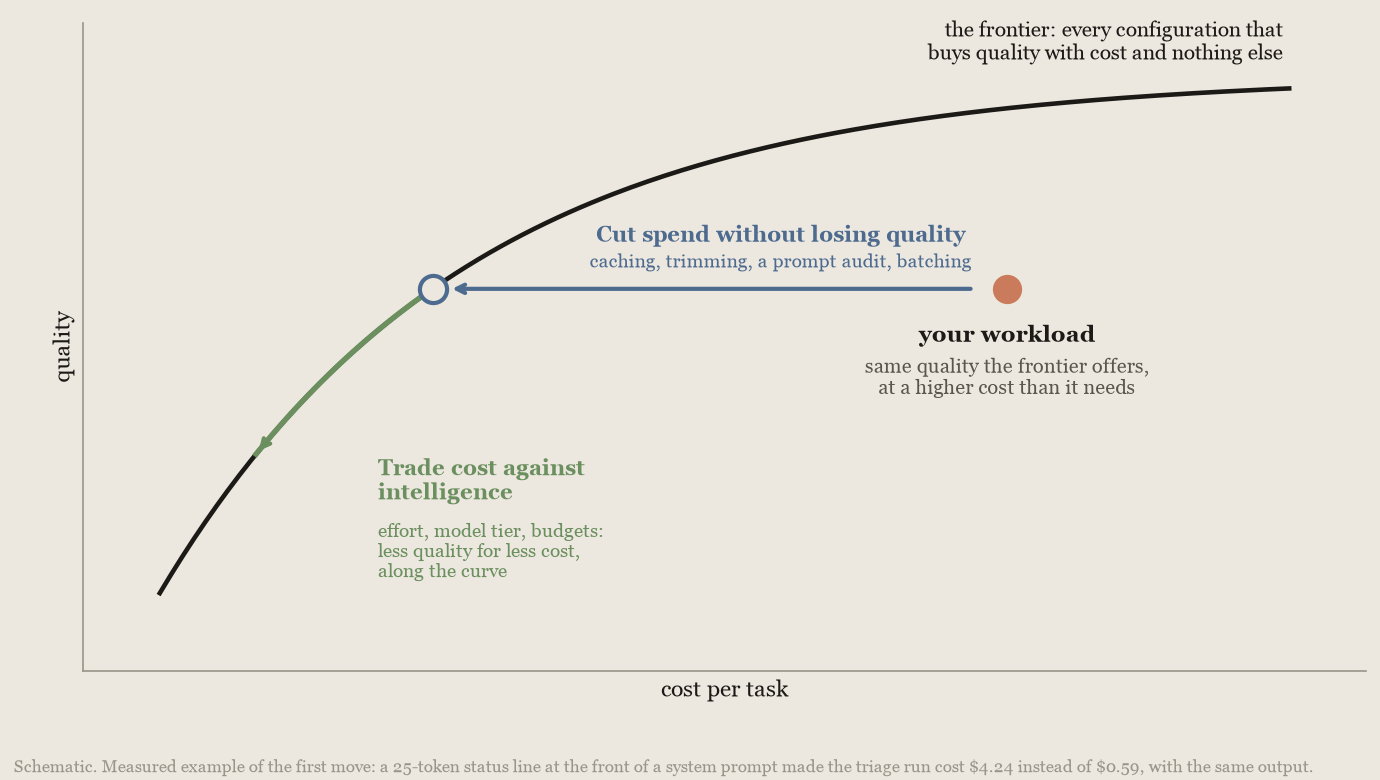
As alavancas são de dois tipos:
- Ganhos gratuitos reduzem o gasto sem afetar a qualidade: "prompt caching" (cache de prompt), higiene de tokens, uma auditoria de prompts em relação ao modelo que você está executando, "batch processing" (processamento em lote) com 50% de desconto para trabalhos que podem esperar até 24 horas, e limites de gastos do workspace como rede de segurança.
- Tradeoffs trocam custo por inteligência: escolha de modelo, esforço, limites de saída e orçamentos de tarefa, um relógio de tempo decorrido e arquiteturas multimodelo.
Cada alavanca vem com resultados medidos e a regra de quando ela compensa. Nas medições da Anthropic, o cache de prompt foi, de longe, a maior alavanca: reduziu o custo do loop de agente por um fator de 2,7 a 5,3 nos benchmarks deste guia e cortou a conta de um pequeno agente de triagem em 83%, ou 88% com o corte de entrada adicionado. As alavancas multimodelo têm alcance mais restrito; um segundo modelo compensou em dois formatos, um conselheiro (advisor) e um orquestrador (orchestrator).
Comece aqui
Encontre a linha que corresponde à sua situação.
| Sua situação | Faça isto | Onde |
|---|---|---|
| Qualquer carga de trabalho, qualquer modelo | Ative o cache de prompt e corte tokens desnecessários; ambos são gratuitos | Armazene contexto repetido em cache · Corte tokens |
| Uma pessoa espera entre os turnos | Use a duração de cache de 1 hora quando cerca de 1 turno em 20 vier após uma pausa entre 5 minutos e uma hora e poucos intervalos passarem de uma hora. No Claude Fable 5.1, mantenha o cache de 5 minutos aquecido enquanto as pausas durarem minutos, e pague pela duração de 1 hora quando as pausas se aproximarem de uma hora. No Claude Opus 5.5, mantenha o cache de 5 minutos aquecido em vez disso quando apenas um ou dois turnos em 20 vierem após uma pausa de até cerca de meia hora | Escolha a duração do cache |
| Os custos estão altos demais; a qualidade está boa | Reduza gradualmente o esforço no seu modelo atual | Ajuste o esforço |
| Você não está no modelo mais recente | Faça o upgrade; nas medições da Anthropic, cada modelo mais novo resolveu pelo menos tantas tarefas quanto o anterior, geralmente por um custo menor por tarefa resolvida | Faça upgrade do modelo |
| Você está escolhendo ou trocando de modelo | Compare pelo custo por tarefa concluída, não por token | Compare modelos |
| A qualidade não é boa o suficiente | Se você reduziu o esforço, restaure-o; caso contrário, experimente o próximo nível acima com esforço low | Ajuste o esforço · Compare modelos |
As tentativas terminam com stop_reason: max_tokens | Aumente max_tokens; 64.000 cobriu todos os 14.000 turnos medidos no esforço padrão, exceto 2, e 128.000 não custou nada a mais por tarefa resolvida | Defina orçamentos |
| Você consegue verificar as saídas (testes, um verificador) | Execute tudo com esforço baixo e execute novamente as falhas em high; no benchmark de codificação medido, a taxa de aprovação se manteve com cerca de metade do custo | Reexecute as falhas |
| Loops de agente com algumas execuções muito caras | Defina um orçamento de tarefa (beta; consulte a tabela de suporte para saber quais modelos), um orçamento de sessão do Claude Managed Agents e um limite de gastos do workspace | Defina orçamentos |
| Você quer que as execuções do agente terminem mais cedo | Diga ao modelo que o tempo importa e mostre a ele o tempo decorrido; no DRACO, no HLE e em um conjunto interno de física, as execuções levaram de 33% a 69% menos tempo, com um custo por tarefa de 28% a 54% menor e pontuações até 1,9 ponto mais baixas | Mostre ao modelo o tempo decorrido |
| Um modelo mais barato trava apenas em decisões difíceis | Adicione um advisor de fronteira. Ele compensa quando seu preço é bem superior ao do executor e quando é de fato consultado, então primeiro calcule o custo do modelo do advisor sozinho com esforço baixo e meça a taxa de consulta | Estratégia advisor |
| O trabalho excede uma janela de contexto | Delegue partições a workers mais baratos | Estratégia de orquestrador |
Esses resultados são internos da Anthropic (Benchmarks referenciados) e indicativos, não garantias, então meça na sua própria carga de trabalho com o método de quatro etapas.
Corte gastos sem perder qualidade
Cache de prompt, higiene de tokens, processamento em lote e uma auditoria de prompt em relação ao seu modelo atual reduzem o que você paga sem reduzir a qualidade da saída. Duas ressalvas se aplicam: o processamento em lote troca latência pelo seu desconto, e a edição de contexto, uma alavanca de higiene de tokens, custou mais do que economizou na execução medida nesta seção.
Armazene contexto repetido em cache
Por que o cache vem primeiro
Ative o cache de prompt antes de qualquer outra alavanca, porque cada turno de uma tarefa agêntica reenvia toda a conversa crescente: prompt do sistema, definições de ferramentas e cada turno anterior. Uma tarefa de 40 turnos envia seu primeiro turno 40 vezes, então o custo da tarefa cresce aproximadamente com o quadrado do número de turnos. O cache não impede o reenvio, mas cada reenvio custa cerca de um décimo e é processado mais rápido: o prefixo é cobrado na taxa de leitura de cache, um décimo do preço de entrada, e cada turno paga a taxa de gravação de cache de 1,25x apenas pelo que é novo.
Como é um bom resultado. Ao longo de um dia inteiro de tráfego real, os loops de agente leram uma mediana de 84% de sua entrada do cache, e os 10% melhores "harnesses" (estruturas de execução), de codificação ou não, leram 94% ou mais17. No meio de uma tarefa, um loop bem construído paga preço cheio em menos de 1% de sua entrada. Abaixo de cerca de 80%, procure algo que esteja quebrando o cache (consulte O que quebra o cache).
Nas execuções medidas pela Anthropic, as leituras de cache são rotineiramente o maior componente individual do custo da tarefa, tornando o cache mais valioso do que a maioria das decisões de escolha de modelo. A Anthropic precificou as execuções do DeepResearch Bench II7 com e sem cache:
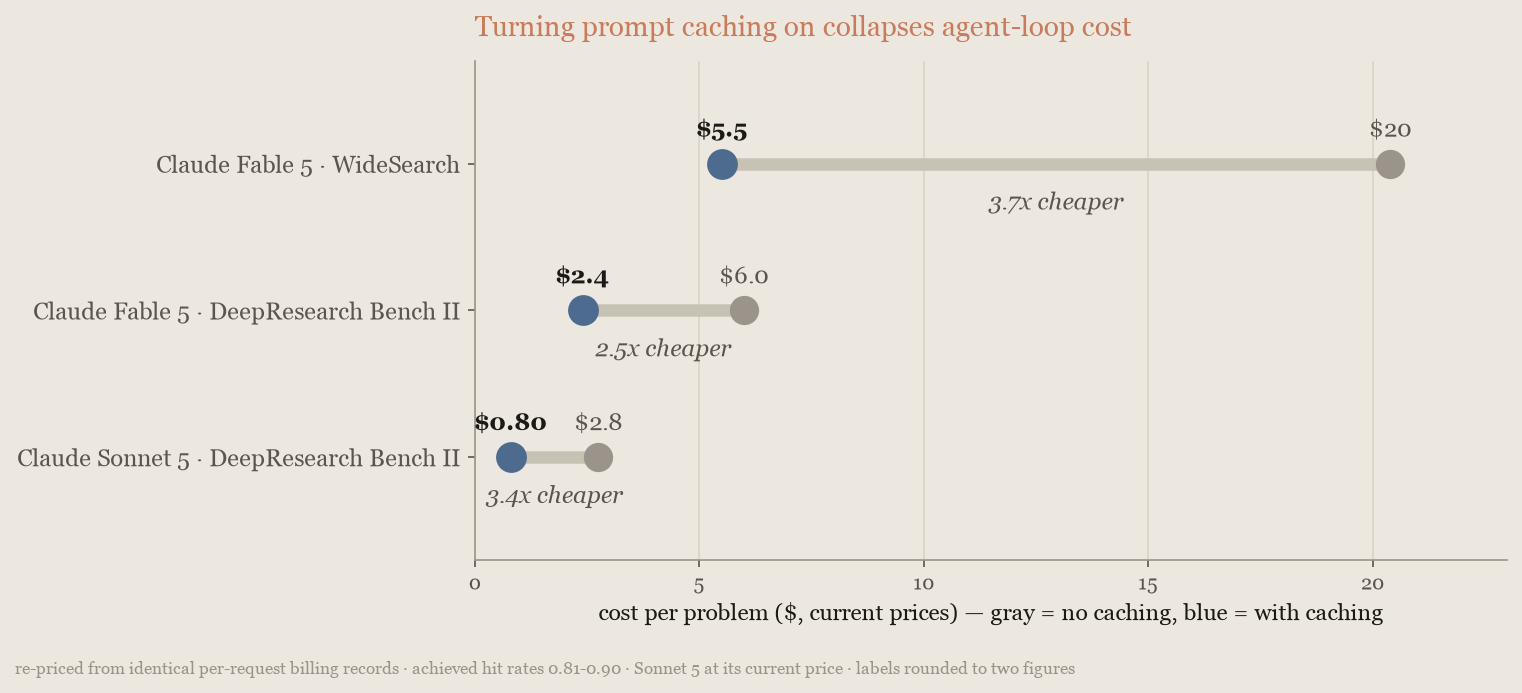
O tempo de vida padrão do cache é de 5 minutos e os turnos de um loop de agente têm segundos de intervalo, então o desconto se aplica à maioria dos tokens em cada turno. As execuções do gráfico de cache leram de 79% a 90% de seus tokens de entrada do cache. A economia varia com a profundidade do episódio, porque loops mais curtos releem menos, mas o cache permaneceu a maior alavanca individual em todos os modelos e benchmarks medidos.
Escolha a duração do cache
Se o seu loop espera por uma pessoa entre os turnos, use a duração de cache de 1 hora. Ela custa mais para gravar (2x o preço de entrada em vez de 1,25x). Uma falha de cache (miss) em qualquer uma das durações cobra o prefixo inteiro pelo preço de gravação em vez do preço de leitura, então a duração mais longa compensa quando alguns turnos por sessão vêm após uma pausa entre 5 minutos e uma hora.
Para decidir, conte os intervalos entre requisições consecutivas em uma conversa:
- Mais de cerca de 1 intervalo em 20 fica entre 5 minutos e uma hora, e intervalos acima de uma hora são raros: use a duração de 1 hora. No Claude Opus 5.5, quando apenas 1 ou 2 intervalos em 20 ficam nessa faixa e nenhum dura mais de cerca de meia hora, mantenha o cache de 5 minutos aquecido em vez disso, com as requisições de keep-alive descritas abaixo.
- Os turnos chegam com segundos de diferença: fique no padrão de 5 minutos. Quando não houve pausas, ele custou 15% menos do que a configuração de 1 hora no Claude Sonnet 5 e cerca de 15% a 18% menos no Claude Opus 5.5.
- Intervalos acima de uma hora são comuns: fique no padrão. Um intervalo acima de uma hora expira ambas as durações, e a configuração de 1 hora então regrava o prefixo pelo seu preço de gravação mais alto, de modo que ela sai perdendo em cada um desses intervalos. Das suas pausas com mais de 5 minutos, se cerca de 60% ou mais também passarem de uma hora, fique no padrão; a duração de 1 hora só compensa quando pelo menos cerca de 40% das pausas longas terminam dentro de uma hora.
A Anthropic mediu o trabalho de triagem de Corte tokens de entrada e de contexto com pausas inseridas antes de alguns turnos para simular a demora de uma pessoa16. No Claude Sonnet 5 e no Claude Opus 5.5, o cache de 1 hora se tornou a configuração mais barata quando cerca de 1 turno em 30 vinha após uma pausa, então a regra de 1 em 20 deixa uma margem, e a diferença aumenta rapidamente após o ponto de cruzamento porque cada turno pausado na configuração de 5 minutos regrava o prefixo inteiro. Todos os modelos atuais usam os mesmos multiplicadores de gravação de cache, e todos os modelos, exceto Claude Fable 5.1, Claude Mythos 5.1 e Claude Opus 5.5, usam o mesmo preço de leitura, então o ponto de cruzamento fica na mesma faixa nos outros modelos; o Fable 5.1 é o caso abordado a seguir. A precisão ficou dentro do ruído entre execuções em todas as células. O turno após uma pausa manteve a latência de cache aquecido na configuração de 1 hora (medido no Claude Sonnet 5 e no Claude Opus 5, não no Claude Opus 5.5). O gráfico a seguir mostra o custo por sessão em relação à proporção de turnos pausados no Claude Sonnet 5:
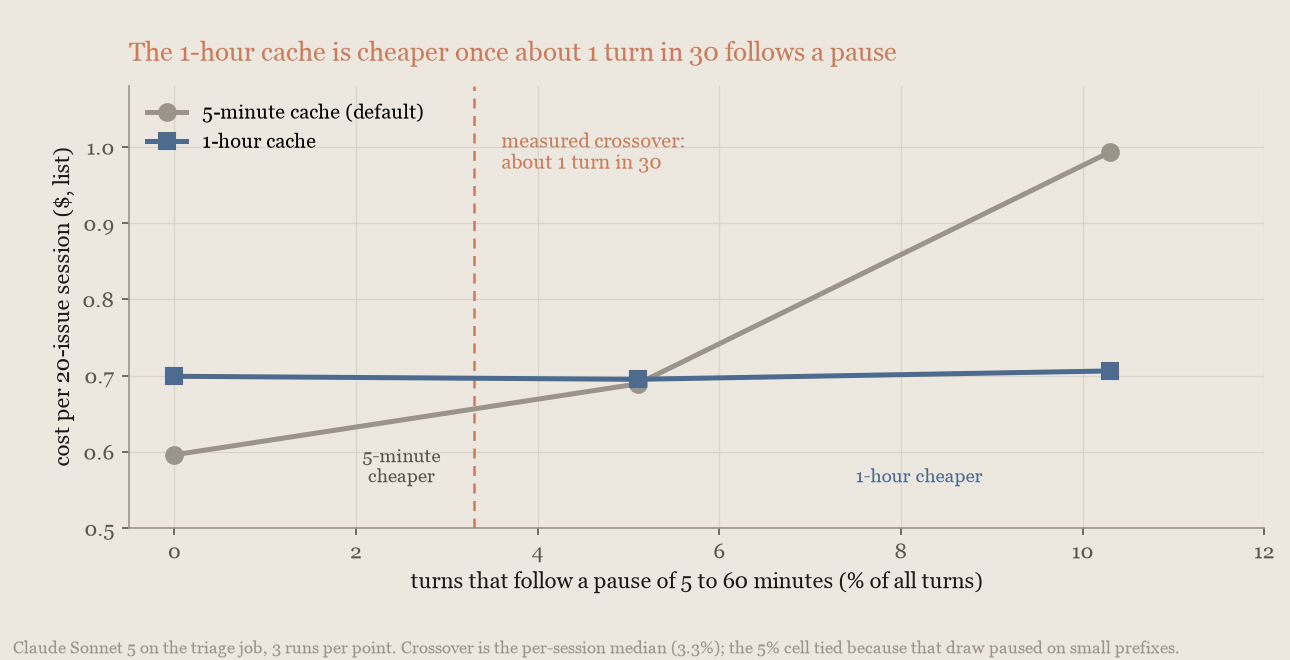
A Anthropic também mediu requisições extras que mantêm o cache de 5 minutos aquecido. No Claude Sonnet 5, elas custaram cerca de 8% menos do que a duração de 1 hora quando 1 turno em 20 vinha após uma pausa, mas aproximadamente o mesmo com 2 em 20; no Claude Opus 5, o modelo Opus anterior, elas não geraram nenhuma economia mensurável. Com uma pausa de 6 minutos ou mais antes de cada turno, elas custaram mais em ambos os modelos. Como a economia do Claude Sonnet 5 desapareceu com 2 turnos em 20, use a duração de 1 hora em vez disso no Claude Sonnet 5 e no Claude Opus 5.
No Claude Fable 5.1, a configuração mais barata é outra. Sua leitura de cache custa 0,025x o preço de entrada ($0,25 por milhão de tokens), enquanto suas gravações de cache mantêm os multiplicadores padrão, então uma requisição de keep-alive que relê o prefixo é barata e o adicional de gravação da duração de 1 hora é a conta maior. A Anthropic mediu o trabalho de triagem no Claude Fable 5.1 com as mesmas três configurações19. Manter o cache de 5 minutos aquecido custou de 13% a 20% menos por sessão do que o cache de 1 hora sempre que as pausas duravam minutos; apenas com pausas próximas de 45 minutos o cache de 1 hora venceu, por cerca de 12 centavos por sessão. No Claude Fable 5.1, mantenha o cache de 5 minutos aquecido enquanto uma pessoa estiver ausente por alguns minutos, e pague pela duração de 1 hora quando as pausas se aproximarem de uma hora:
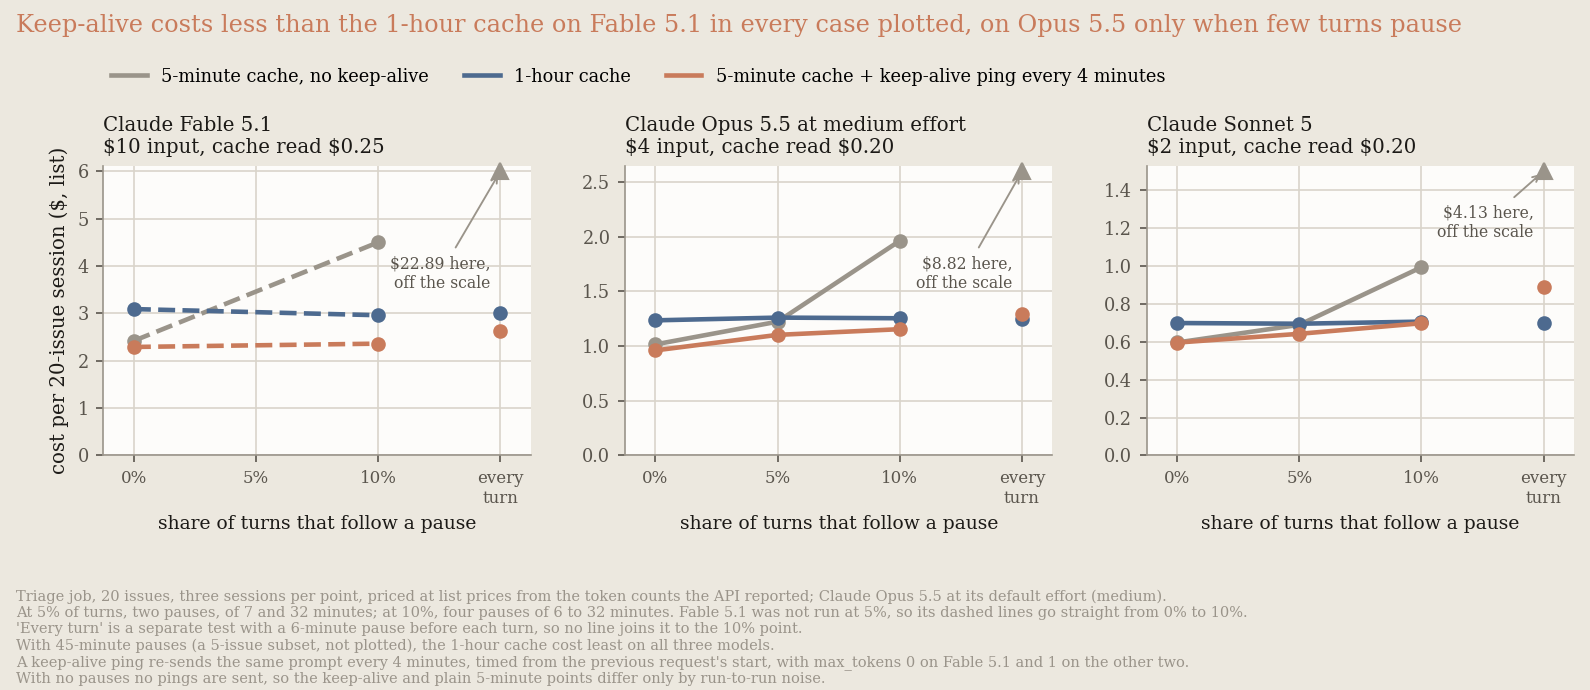
No Claude Opus 5.5, cuja leitura de cache custa 0,05x o preço de entrada, as requisições de keep-alive custaram de 8% a 13% menos do que a duração de 1 hora quando 5% ou 10% dos turnos vinham após uma pausa de 6 a 32 minutos (no esforço padrão, medium; de 10% a 18% menos em high), mas custaram mais com uma pausa antes de cada turno: cerca de 4% a 6% a mais com pausas de 6 minutos, chegando a mais de 50% a mais com pausas de 45 minutos. Portanto, no Claude Opus 5.5, mantenha o cache de 5 minutos aquecido quando apenas um ou dois turnos em 20 vierem após uma pausa de até cerca de meia hora e, caso contrário, siga a lista no início desta seção. Essas medições enviaram requisições de keep-alive com max_tokens: 1. Para a requisição com max_tokens: 0 descrita a seguir, os testes de API pré-lançamento da Anthropic no Claude Opus 5.5 mostram que ela grava o cache e que a próxima requisição o lê; não foi medido no Opus 5.5 se ela renova uma entrada existente.
Para manter o cache aquecido, envie a requisição anterior novamente com max_tokens definido como 0 em até 4 minutos após o início da requisição anterior, e a cada 4 minutos depois disso, removendo stream se estiver definido. Conte a partir do início da requisição, não do fim de sua resposta: o tempo de vida de 5 minutos do cache começa a contar a partir do início da requisição que gravou ou renovou a entrada, então o tempo que a resposta passou gerando é descontado dele. Essa é a requisição de pré-aquecimento: ela renova o tempo de vida do cache, não gera nada e cobra apenas a leitura de cache. Não altere nenhum byte do prefixo e não use max_tokens: 1, que amostra um token sem necessidade. Reenvie os cabeçalhos da requisição, além do corpo: se suas requisições carregam um cabeçalho anthropic-beta (para um orçamento de tarefa, por exemplo), a requisição de keep-alive precisa do mesmo cabeçalho, caso contrário os campos restritos ao beta no corpo reenviado são rejeitados. Uma requisição com max_tokens: 0 é rejeitada quando a requisição define thinking.type: "enabled" (o pensamento adaptativo padrão no Claude Fable 5.1 não causa problema), saídas estruturadas ou uma escolha de ferramenta forçada (suas limitações); nessas cargas de trabalho, pague pela duração de 1 hora em vez disso. Uma requisição com max_tokens: 0 também é rejeitada quando carrega o parâmetro compaction de nível superior, então não reenvie uma requisição de compactação de compactação sob demanda como requisição de keep-alive.
# Em até 4 minutos após o início da última requisição (o tempo gasto na geração conta
# para o tempo de vida do cache), reenvie essa requisição com max_tokens definido como
# 0, removendo stream (uma requisição com max_tokens: 0 não pode usar streaming). Envie os mesmos
# cabeçalhos da requisição original, incluindo qualquer cabeçalho anthropic-beta.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Ative o cache
A configuração dá pouco trabalho. O cache automático posiciona os pontos de interrupção para você; caso contrário, a skill Claude API que acompanha o Claude Code pode adicionar cache a uma integração existente a partir de um único prompt. O trecho a seguir mostra a skill adicionando-o ao harness que produziu essas medições:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Esses posicionamentos de pontos de interrupção seguem o padrão descrito em Pontos de interrupção de cache explícitos.
O que quebra o cache
Várias coisas podem quebrar seu cache durante uma tarefa. Qualquer coisa que mude a cada requisição, como um timestamp ou uma posição na fila, colocada antes do prefixo estável transforma cada requisição em uma gravação completa de cache: na execução de triagem em Corte tokens de entrada e de contexto, uma linha de status de 25 tokens no início do prompt do sistema custou $4,24 por execução em vez de $0,59, mais do que executar com o cache desativado. Mantenha o texto específico de cada requisição no turno de usuário mais recente.
O cache é uma correspondência exata de prefixo, byte a byte, sobre a requisição em ordem (ferramentas, depois prompt do sistema, depois mensagens), então uma alteração em qualquer ponto invalida tudo o que vem depois dela. Alterar o effort ou a configuração de pensamento entre requisições invalida o cache a partir desse ponto e, em alguns modelos, também as ferramentas e o prompt do sistema que vêm antes dele; qualquer edição no prompt do sistema invalida o cache a partir desse ponto; definir ou alterar um formato de saída invalida o cache da conversa inteira; adicionar, remover ou reordenar uma definição de ferramenta invalida todo o cache. A página de cache de prompt lista esses casos, exceto o formato de saída, que é abordado em saídas estruturadas. Nos modelos mais recentes, altere instruções com uma mensagem de sistema no meio da conversa, uma mensagem {"role": "system"} anexada a messages, em vez de editar o campo system de nível superior: o prefixo em cache permanece intacto. Consulte essa página para saber quais modelos oferecem suporte. Nos modelos que oferecem suporte, uma alteração de esforço por mensagem também mantém o prefixo em cache intacto. O risco é maior no Claude Fable 5.1 e no Claude Mythos 5.1, em que uma quebra regrava o prefixo a 1,25x o preço de entrada em vez de lê-lo a 0,025x. Em um prefixo de 100.000 tokens, um turno com cache quebrado nesses modelos custa $1,25 em vez de $0,03, 50 vezes o custo da leitura; no Claude Opus 5.5 custa $0,50 em vez de $0,02, 25 vezes, e nos outros modelos atuais, 12,5 vezes.
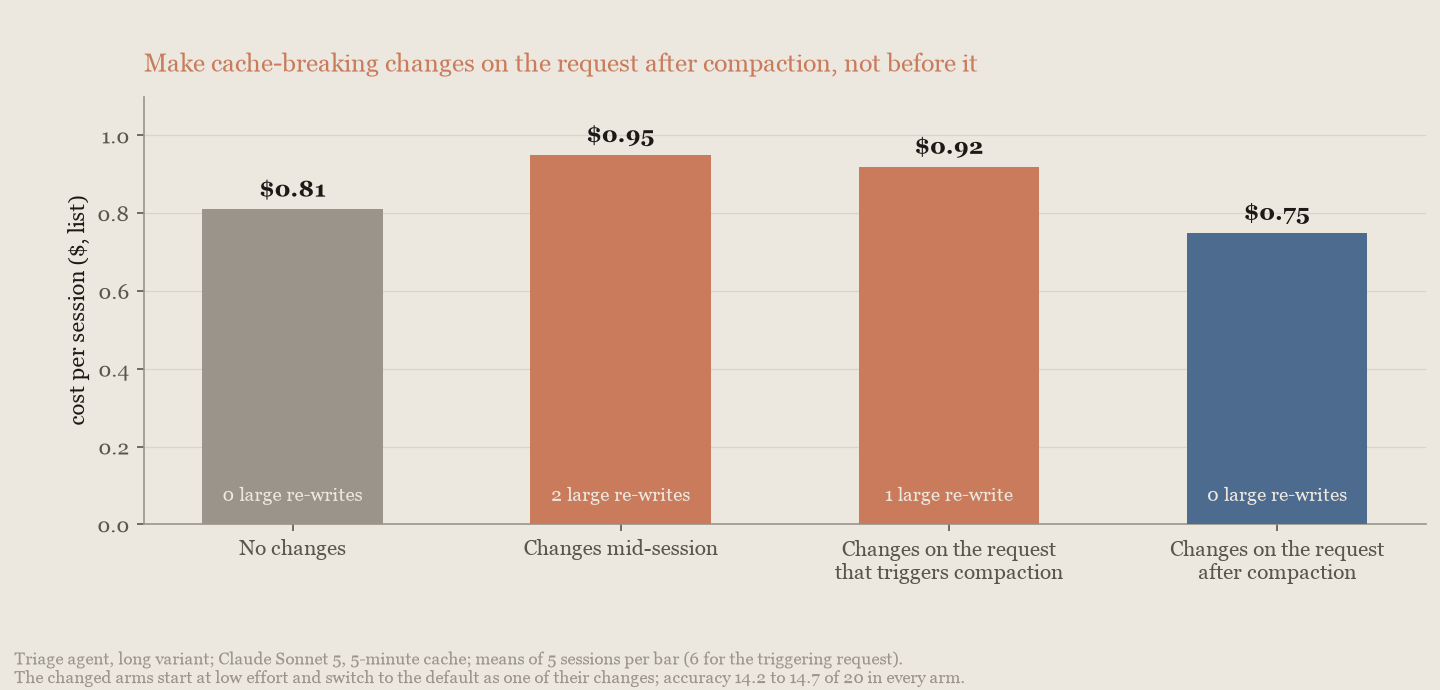
A Anthropic mediu isso nas sessões longas do agente de triagem18. Uma alteração de esforço e uma ferramenta adicionada no meio da sessão regravaram 39.000 e 60.000 tokens em cache, e essas sessões custaram $0,95 por sessão. As mesmas duas alterações na primeira requisição após a compactação custaram $0,75, e na requisição que acionou a compactação, $0,92, porque a etapa de sumarização da compactação então reprocessou o contexto de 81.000 tokens pelo preço de gravação de cache: essa etapa de sumarização custou $0,21, contra $0,04 quando as mesmas alterações vieram uma requisição depois, com a precisão dentro do ruído entre execuções em todos os braços do experimento:
Alterar um orçamento de tarefa no meio do caminho invalida qualquer prefixo em cache que contenha o valor do orçamento, então defina-o uma única vez, na primeira requisição. Cada passagem de edição de contexto invalida o prefixo a partir do ponto que ela limpa, e a próxima requisição paga para recolocar em cache tudo o que vem depois, então limpe em poucos lotes grandes em vez de muitos pequenos. No Claude Fable 5.1 e no Claude Mythos 5.1, cada uma dessas alterações custa 50 vezes o preço de leitura por token, então elas pesam mais nesses modelos. Faça toda alteração que invalida o cache em pausas naturais e depois confirme que as leituras de cache não caíram; se caíram, o diagnóstico de cache mostra onde o prefixo divergiu.
Corte tokens de entrada e de contexto
A maioria das requisições de agente carrega tokens que nunca influenciam a resposta. Cortá-los raramente custa qualidade de saída, embora nem toda alavanca aqui tenha economizado dinheiro quando medida. Há dois lugares para examinar:
- Corte de entrada. A filtragem dinâmica na ferramenta de web fetch mantém conteúdo repetitivo fora das páginas buscadas, o redimensionamento de imagens ajusta o tamanho das entradas de visão, e a "tool search" (busca de ferramentas) com carregamento adiado carrega definições de ferramentas apenas quando necessário (medido mais adiante nesta seção). A chamada programática de ferramentas permite que o Claude execute várias chamadas de ferramentas a partir de código, de modo que apenas o resultado filtrado entre no contexto; sua documentação relata 24% menos tokens de entrada em benchmarks de busca agêntica, com uma pontuação mais alta. Gerenciar o contexto de ferramentas compara busca de ferramentas, chamada programática de ferramentas, cache de prompt e edição de contexto.
- Ciclo de vida do contexto. A edição de contexto limpa resultados de ferramentas obsoletos, e a compactação automática, com seu limite, impede que loops longos carreguem todo o histórico adiante.
As alavancas interagem com o cache e entre si, então avalie-as pelo efeito líquido e use o diagnóstico de cache para confirmar que seu prefixo em cache sobrevive a cada alteração. A Anthropic as mediu em um agente de triagem de issues que processou 20 relatórios de bugs reais com capturas de tela de um repositório público, e em uma variante mais longa do mesmo trabalho com 2,6 vezes mais tokens. Com o cache ativado, o corte de entrada (redimensionamento de imagens e busca de ferramentas) reduziu mais 26% do custo da execução curta e 21% da longa.
Adie definições de ferramentas não utilizadas
Cada definição de ferramenta anexada a uma requisição é entrada em cada turno, e alguns servidores MCP somam centenas delas. A Anthropic executou o agente de triagem com suas próprias duas ferramentas mais um catálogo de definições de ferramentas reais de servidores MCP públicos, para um total de até 502 ferramentas, carregando todas elas ou marcando as extras com defer_loading atrás da busca de ferramentas:
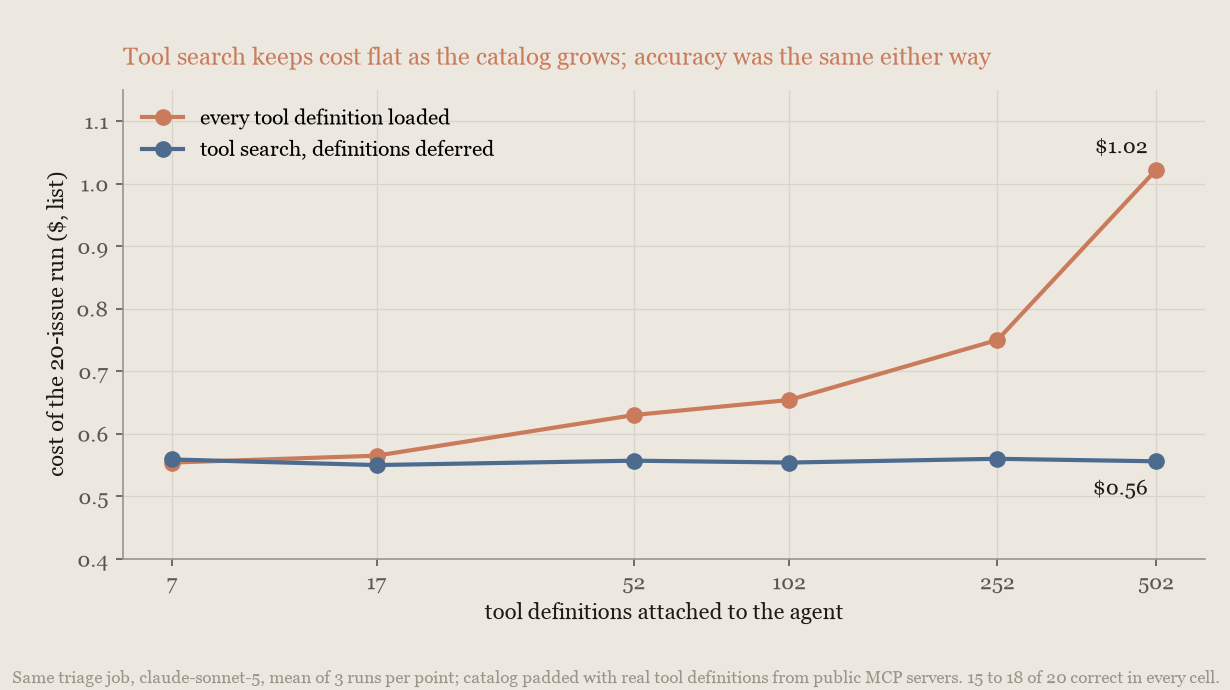
Com todas as definições carregadas, o custo da execução quase dobrou conforme o catálogo cresceu, acompanhando os tokens de esquema em cada requisição. Com a busca de ferramentas, ele ficou estável em todos os tamanhos de catálogo, 45% menos com 502 ferramentas. A precisão foi de 15 a 18 de 20 em todas as células de qualquer forma, e o modelo nunca chamou uma ferramenta errada, então nessa escala o catálogo custa dinheiro, não correção. O mesmo vale para ferramentas que vêm pelo conector MCP: com um servidor MCP público do GitHub anexado, adiar seu conjunto de ferramentas (default_config: {defer_loading: true}) cortou a execução em 20% com a mesma precisão.
Mantenha arquivos de dados fora do prompt
Quando o modelo precisa computar sobre uma tabela, faça o upload dela com a Files API e deixe o modelo consultá-la com execução de código em vez de colá-la. A Anthropic fez 25 perguntas agregadas15 (somas, contagens filtradas, agrupamentos e um filtro de data) sobre um CSV público de 1.862 linhas, com as respostas computadas pelo pandas:
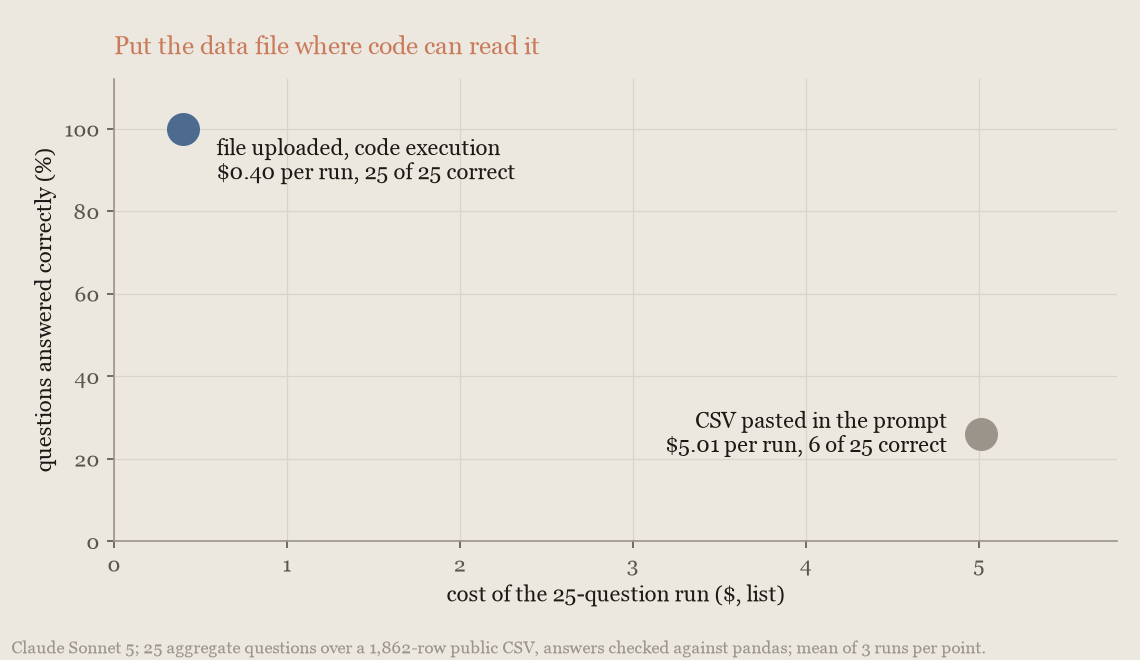
Colada no prompt, a tabela tem cerca de 91.000 tokens de entrada em cada requisição, e o Claude Sonnet 5 respondeu corretamente 6 de 25 perguntas. Enviada, com execução de código, ele respondeu todas as 25, e a execução custou cerca de um doze avos. O Claude Opus 5 mostrou o mesmo padrão.
Gerencie o ciclo de vida do contexto
As alavancas de contexto só compensam em uma sessão longa o suficiente para precisar delas:
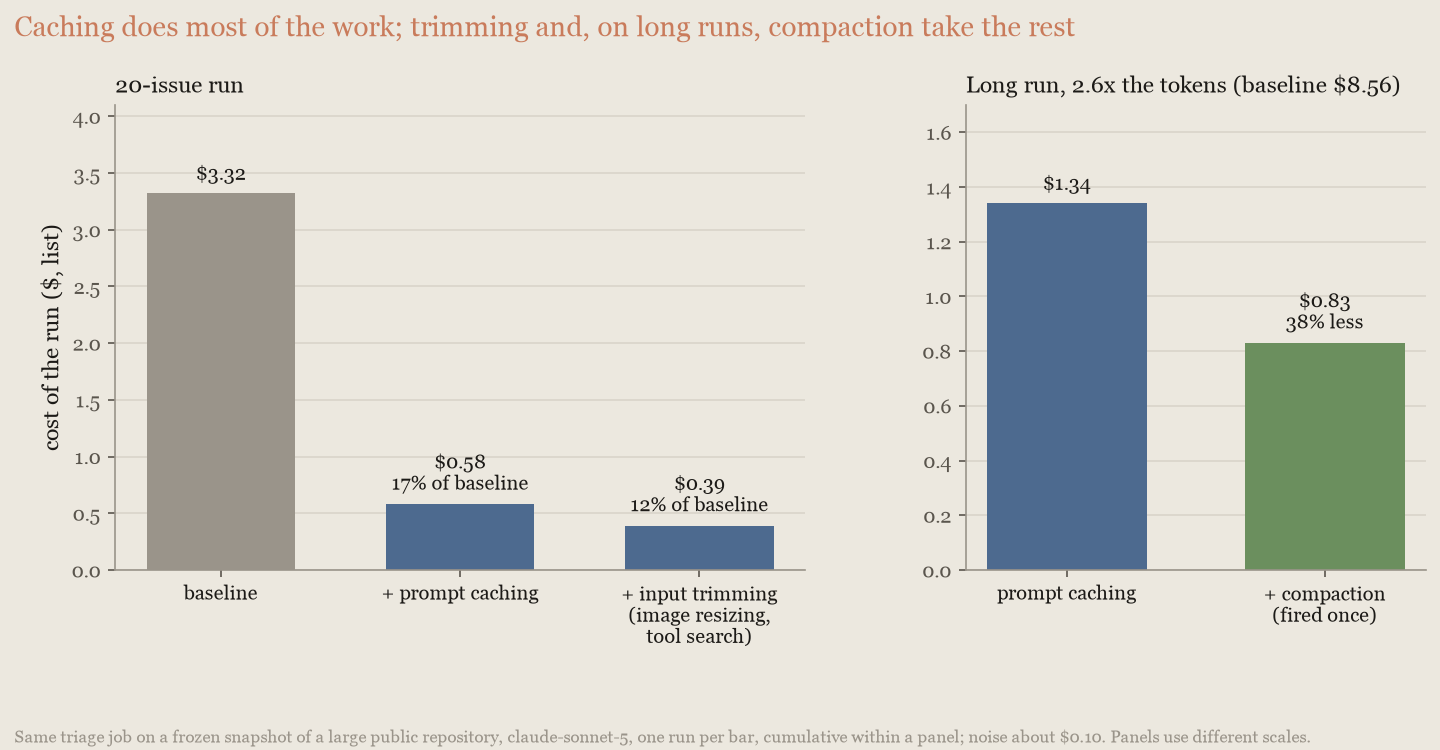
Na execução de 20 issues elas não economizaram nada, e a edição de contexto custou 74% mais. Na execução longa, a poda economizou 39% e a compactação 32%, enquanto a edição de contexto não mudou nada. A poda são algumas linhas que você mesmo escreve: em cada limite de tarefa, substitua resultados de ferramentas grandes e obsoletos por um extrato de uma linha. Ela funciona bem com o cache porque as edições ficam na cauda da conversa, onde a próxima tarefa adiciona conteúdo novo de qualquer forma: 89% de leituras de cache na primeira requisição após um limite e 81% nas requisições entre limites. Na execução inteira, a poda e a edição de contexto funcionam com o cache aproximadamente igualmente bem. A poda é mais barata porque a edição de contexto reescreve no meio da tarefa conteúdo que a poda exclui (cerca de dois terços da diferença) e porque ela mantém o contexto com cerca de metade do tamanho (o outro terço). Se você usar edição de contexto, limpe em alguns lotes grandes. A poda, adaptada do harness:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # limita resultados de linha única para manter o extrato curto
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractColoque em lote o trabalho que pode esperar
A Batch API tira 50% de cada token de uma requisição, incluindo os em cache, em troca de os resultados chegarem a qualquer momento dentro de 24 horas. Encaminhe por um lote toda requisição pela qual ninguém está esperando, e mantenha o caminho interativo para o restante. O processamento em lote é a segunda maior alavanca gratuita depois do cache para trabalho de agente não supervisionado: execuções de avaliação, preenchimentos retroativos e trabalhos agendados, como uma execução recorrente do agente de triagem de issues da medição de corte de tokens. Ele se combina com tudo nesta página exceto interatividade, mas não está disponível para sessões do Claude Managed Agents, que são interativas por design (consulte preços do Claude Managed Agents).
Audite prompts em relação ao modelo atual
Cada geração de modelo responde a prompts de forma diferente, então um prompt acumula texto escrito para um modelo que você não usa mais. O caso usual é instrução excessivamente específica adicionada para compensar um modelo mais antigo: "verifique duas vezes", "seja maximamente minucioso", um procedimento passo a passo obrigatório ou um rascunho de raciocínio feito à mão. Um modelo mais novo segue isso ao pé da letra, produzindo rodadas extras de ferramentas e escrita extra, então a conta sobe sem ganho em precisão. Auditar prompts em relação ao modelo que você executa agora, e novamente sempre que trocar de modelo, é um ganho gratuito.
A auditoria é um único comando. A skill Claude API que acompanha o Claude Code tem um comando prompt-audit que lê os prompts e o código de requisição de um projeto e relata o que foi escrito para um modelo diferente. Este trecho resumido mostra ele sendo executado em um prompt de central de suporte e código de requisição contendo esses padrões:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.O comando então propõe suas edições como um diff (um trecho mostrado) e lista o que deliberadamente deixou intacto: a janela de reembolso, o requisito de tom e o padrão de qualidade. Você revisa um patch, não uma reescrita.
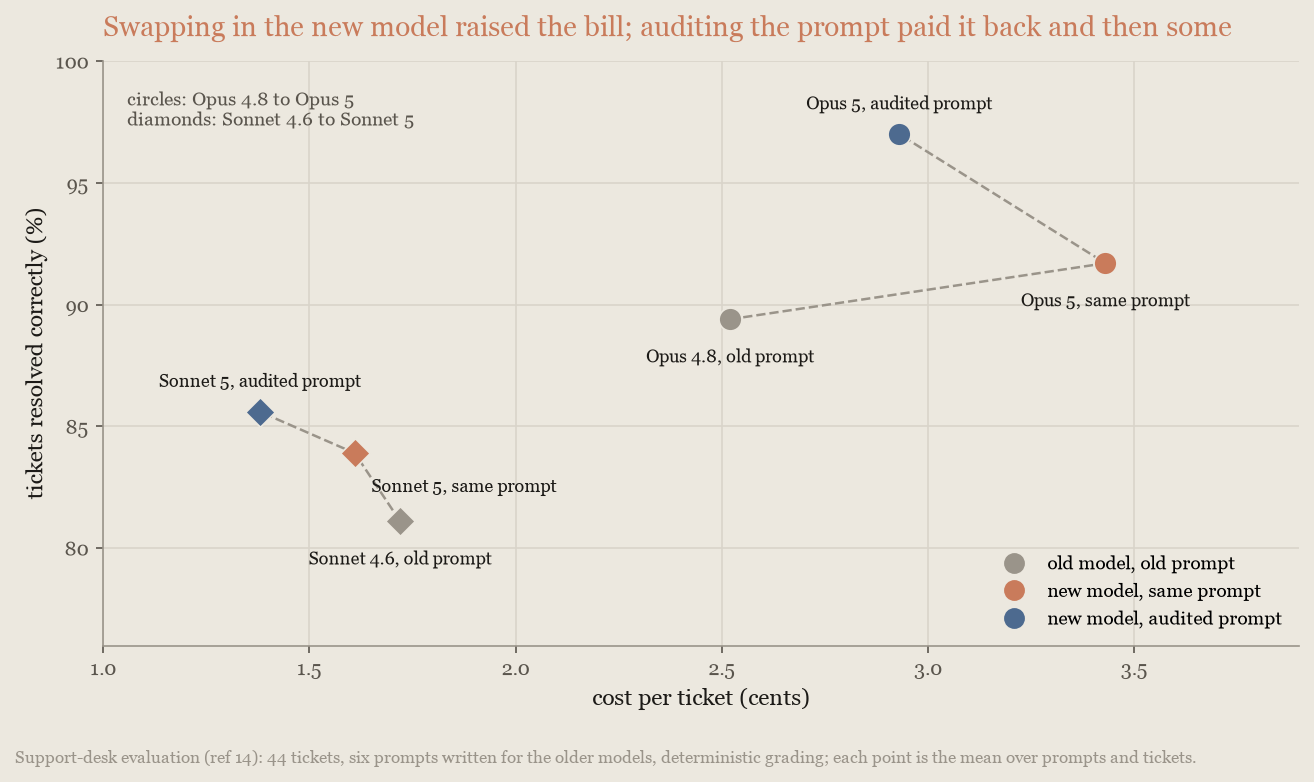
O efeito é mensurável. Em uma avaliação de central de suporte14, prompts escritos para o Claude Opus 4.8 custaram 36% mais por ticket no Claude Opus 5 sem mudança na precisão. Executar a auditoria sobre os mesmos prompts tornou o Opus 5 tanto mais barato que a versão não auditada (em 14%) quanto mais preciso (97% dos tickets, acima de 92%, um ganho fora do ruído). Na migração do Claude Sonnet 4.6 para o Claude Sonnet 5, a auditoria tirou 14% com a mesma precisão:
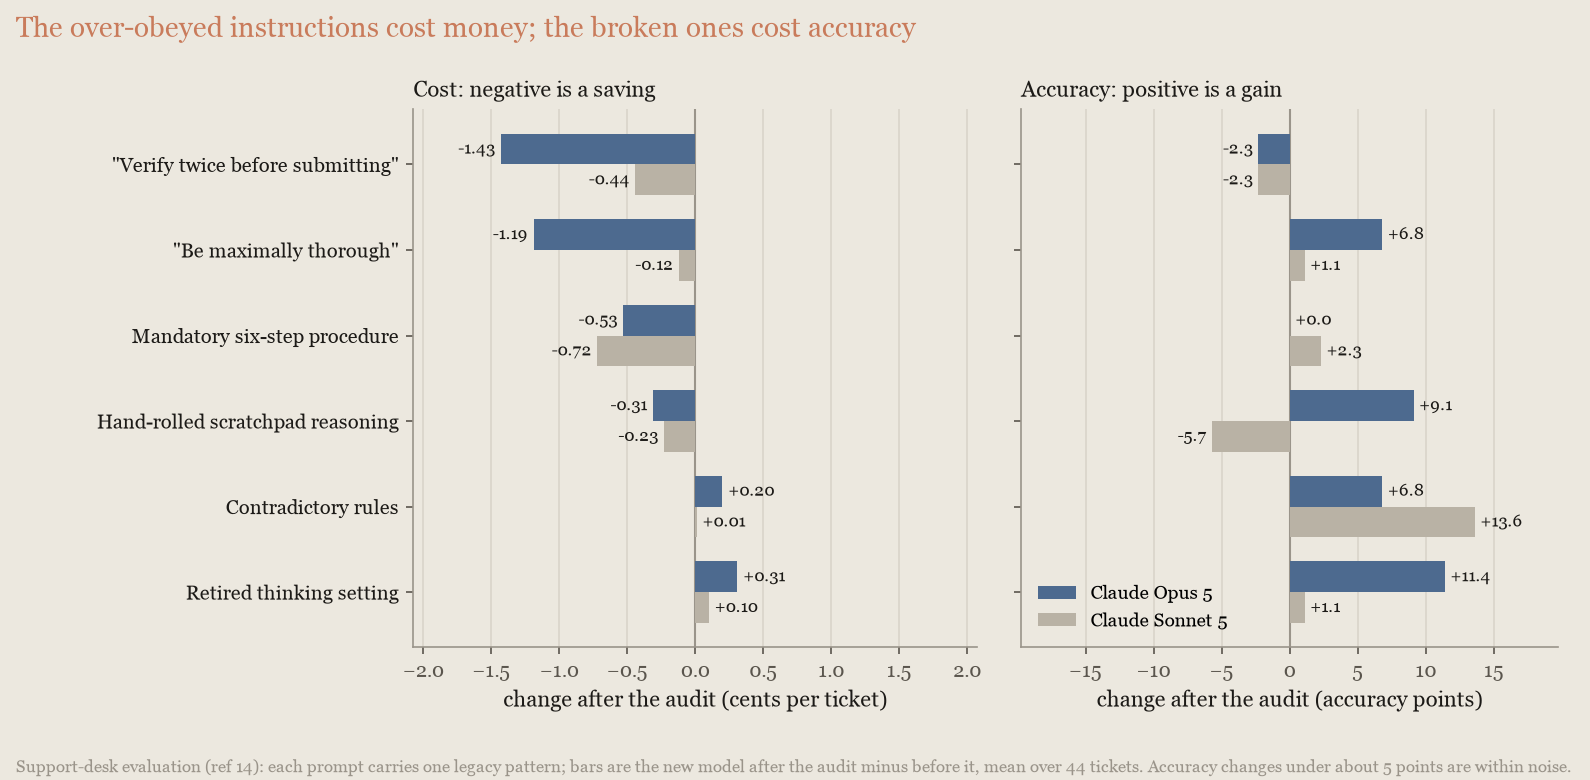
Os dois tipos de texto obsoleto têm custos diferentes. Instruções que o modelo novo segue literalmente demais custam dinheiro: remover "verifique duas vezes" cortou o custo por ticket do Opus 5 em um terço, e remover "seja maximamente minucioso" quase tanto. Texto que não se encaixa mais no modelo custa precisão em vez disso: uma configuração de pensamento desativada, regras contraditórias e um rascunho feito à mão que conflita com o próprio pensamento do modelo restauraram cada um de 7 a 11 pontos no Opus 5 quando removidos:
Os mesmos padrões tendem a aparecer em descrições de ferramentas e skills, que também vale a pena auditar.
Troque custo por inteligência
Essas alavancas definem onde um único modelo se posiciona entre custo e inteligência: escolha de modelo, esforço, reexecução de falhas em uma configuração mais alta, os orçamentos e limites dentro dos quais ele trabalha e se ele consegue ver quanto tempo passou. Comece com uma varredura de esforço no seu modelo atual (Ajuste o esforço). Do menor para o maior custo e capacidade, os modelos atuais são Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 e Claude Fable 5.1 (o modelo de fronteira); a Visão geral dos modelos traz a linha completa e os preços.
Compare modelos pelo custo por tarefa
As tabelas de preços são expressas por token, e por token o modelo de fronteira parece caro: o preço por token do Claude Fable 5.1 é várias vezes o do Claude Sonnet 5. Mas você paga por tarefas concluídas, então compare modelos pelo custo por tarefa concluída. Um modelo mais capaz conclui uma tarefa com menos trabalho: menos turnos, menos buscas, menos releitura do próprio contexto e menos retrocessos. O adicional por token muitas vezes é mais do que compensado por fazer menos de tudo.
A Anthropic mediu isso no subconjunto do SWE-bench Pro3, com preços calculados da mesma forma que um cliente é cobrado:
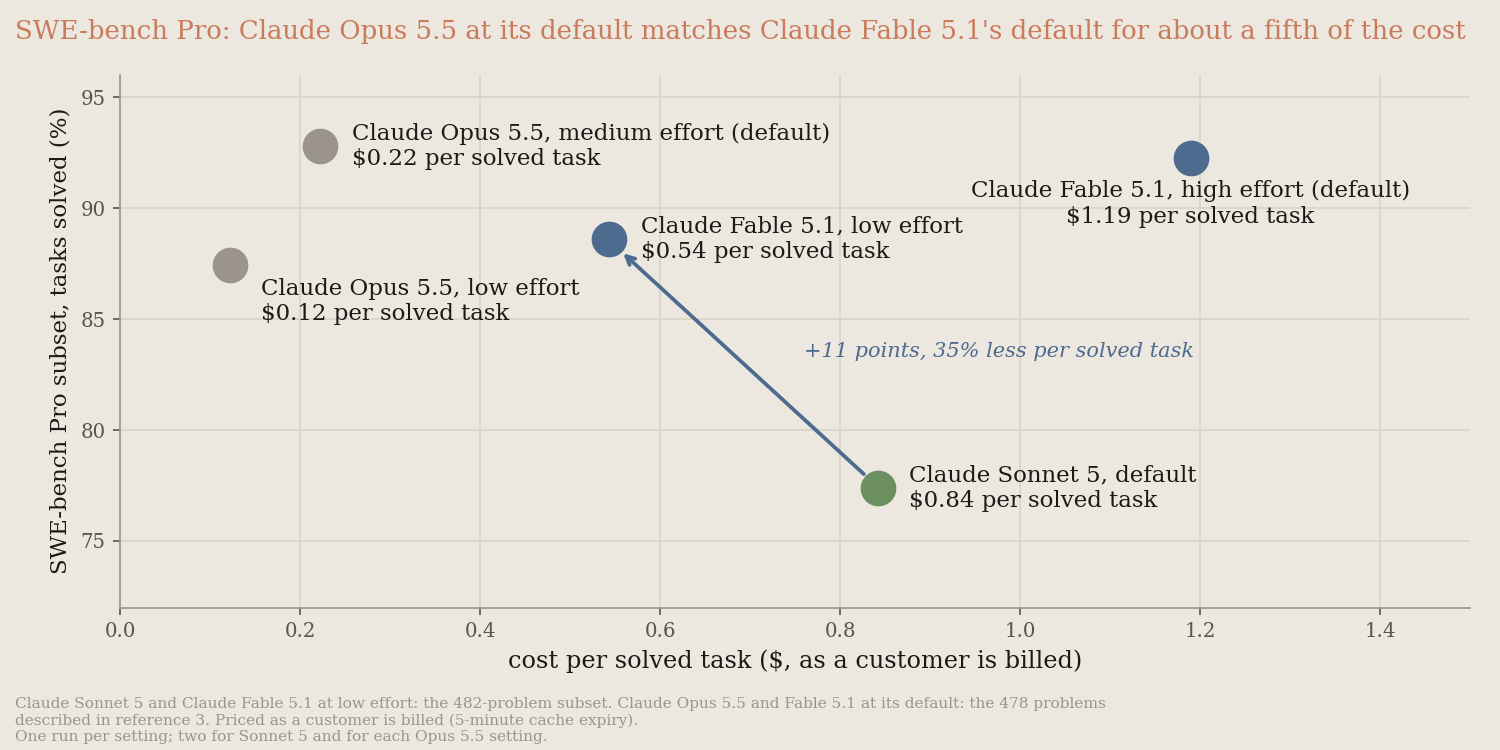
O Claude Fable 5.1 com esforço low resolveu 88,6% das tarefas por $0,54 por tarefa resolvida, contra 77,4% por $0,84 do Claude Sonnet 5 no seu padrão: 11 pontos a mais por 35% menos por tarefa resolvida, apesar de um preço por token cinco vezes maior. Mas ele nem sempre vence. No mesmo subconjunto, que o Claude Opus 5.5 e o Claude Fable 5.1 praticamente saturam e cujas pontuações não são comparáveis às do leaderboard público, o Opus 5.5 no seu padrão, medium, igualou o Fable 5.1 no seu padrão (92,8% contra 92,3%, dentro do ruído entre execuções) por cerca de um quinto do custo por tarefa resolvida ($0,22 contra $1,19). Em low, o Opus 5.5 resolveu 87,4% por $0,12. Esses números usam os 478 problemas descritos na referência 3. E em loops de pesquisa longos o modelo de fronteira faz mais trabalho, não menos: no DeepResearch Bench II7, o Fable 5.1 em low pontuou 10 pontos acima do Sonnet 5 (66% contra 56%) por cerca de quatro vezes o custo por tarefa ($4,66 contra $1,20), porque executa um loop de pesquisa mais longo sobre um contexto maior. O Claude Opus 5 no seu padrão pontuou 71% na mesma base por $6,71 por tarefa, acima do Fable 5.1 no seu padrão (65% por $7,12), então também em pesquisa o Fable 5.1 só justifica seu preço em low.
Para a maioria das cargas de trabalho de agente, comece com o Claude Opus 5.5 no seu esforço padrão (medium) e use o Claude Fable 5.1 para raciocínio exigente e trabalho agêntico de longo horizonte, ou quando suas avaliações no Claude Opus 5.5 com esforço mais alto ainda ficarem aquém do esperado. No subconjunto do SWE-bench Pro, o Opus 5.5 no seu padrão igualou o Fable 5.1 no seu padrão por cerca de um quinto do custo por tarefa resolvida, como observado anteriormente. No benchmark de codificação em Estratégia advisor, ele pontuou 86,6% contra 84,2% do Fable 5.1 em medium (uma única execução do Fable 5.1), por menos de um terço do custo por tentativa ($0,84 contra $2,68). No Chartography13, um benchmark de leitura de gráficos, o Opus 5.5 em low pontuou 68,7 por cerca de $0,03 por gráfico, contra 62,5 por $0,15 do Fable 5.1 em low e 49 por $0,16 do Claude Opus 5 em low. No outro extremo, o Claude Haiku 4.5 respondeu perguntas do GPQA Diamond9 por cerca de um quinto do custo por pergunta do Claude Opus 5.5, com 63% de precisão em comparação com 92% do Opus 5.5, e ficou muito mais para trás em tarefas longas de codificação. Ele é adequado para trabalho de alto volume com saídas verificáveis, não para loops agênticos longos.
A classificação se inverte conforme a carga de trabalho, e nenhuma tabela de preços diz para qual lado. Calcule o custo por tarefa concluída de cada candidato no seu próprio tráfego, incluindo o Claude Opus 5.5 no seu esforço padrão e o modelo de fronteira com esforço reduzido.
Calcule o custo da cauda da sua carga de trabalho, não da mediana: compare modelos no décimo mais difícil das suas tarefas, não na tarefa típica. Na tarefa típica, todos os modelos parecem semelhantes e o mais barato parece o melhor, mas a conta é decidida pelas tarefas em que o modelo mais barato falha, porque uma tarefa com falha ainda cobra seus tokens, depois a nova tentativa e, por fim, o que quer que a falha custe mais adiante. A cauda também é para onde vai o dinheiro mesmo quando nada falha. Em uma execução de 20 problemas do WideSearch1, dois problemas concentraram 43% do gasto:
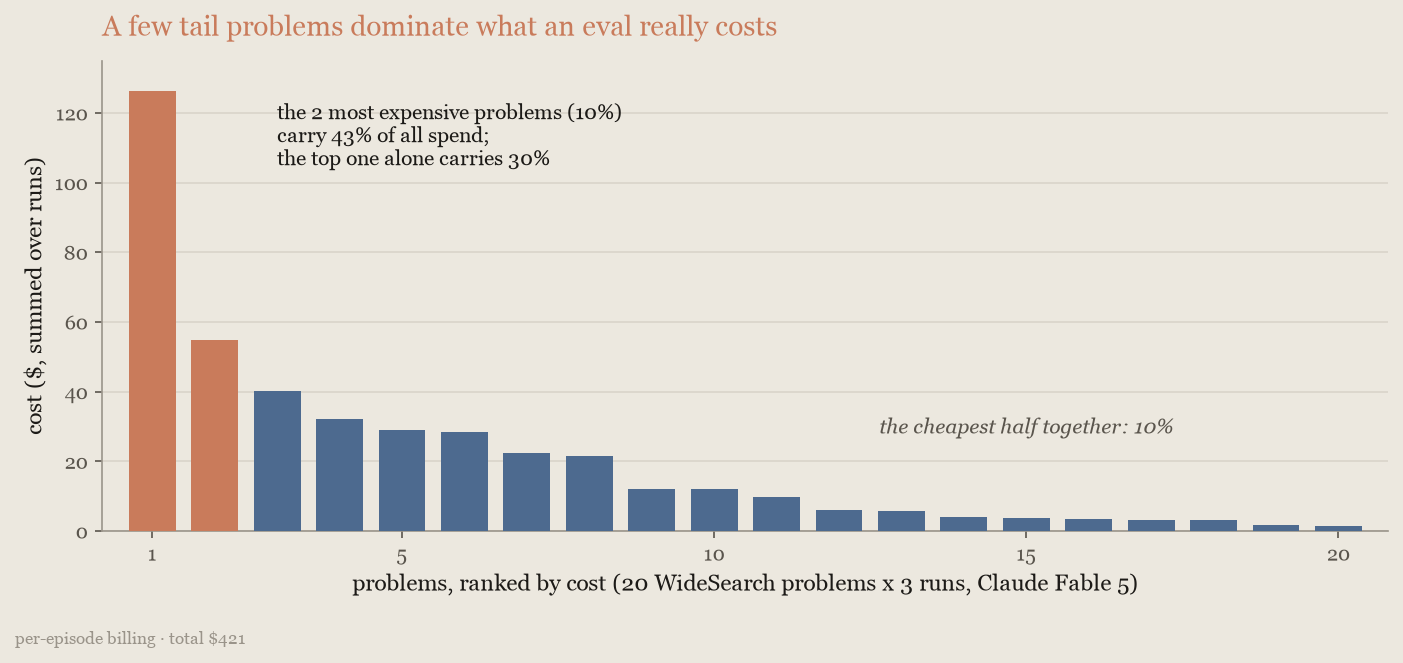
As estratégias multimodelo existem para gastar inteligência de fronteira nessa cauda sem pagar preços de fronteira pelo restante.
Faça upgrade do modelo
Se você está um ou dois modelos atrás, a alavanca mais barata é a string do modelo. A Anthropic executou modelos recentes Claude Opus, Claude Sonnet e Claude Fable no mesmo harness, no subconjunto do SWE-bench Pro3, cada um com suas configurações padrão de lançamento e com preços de tabela, e executou a linha Opus novamente no Terminal-Bench 320:
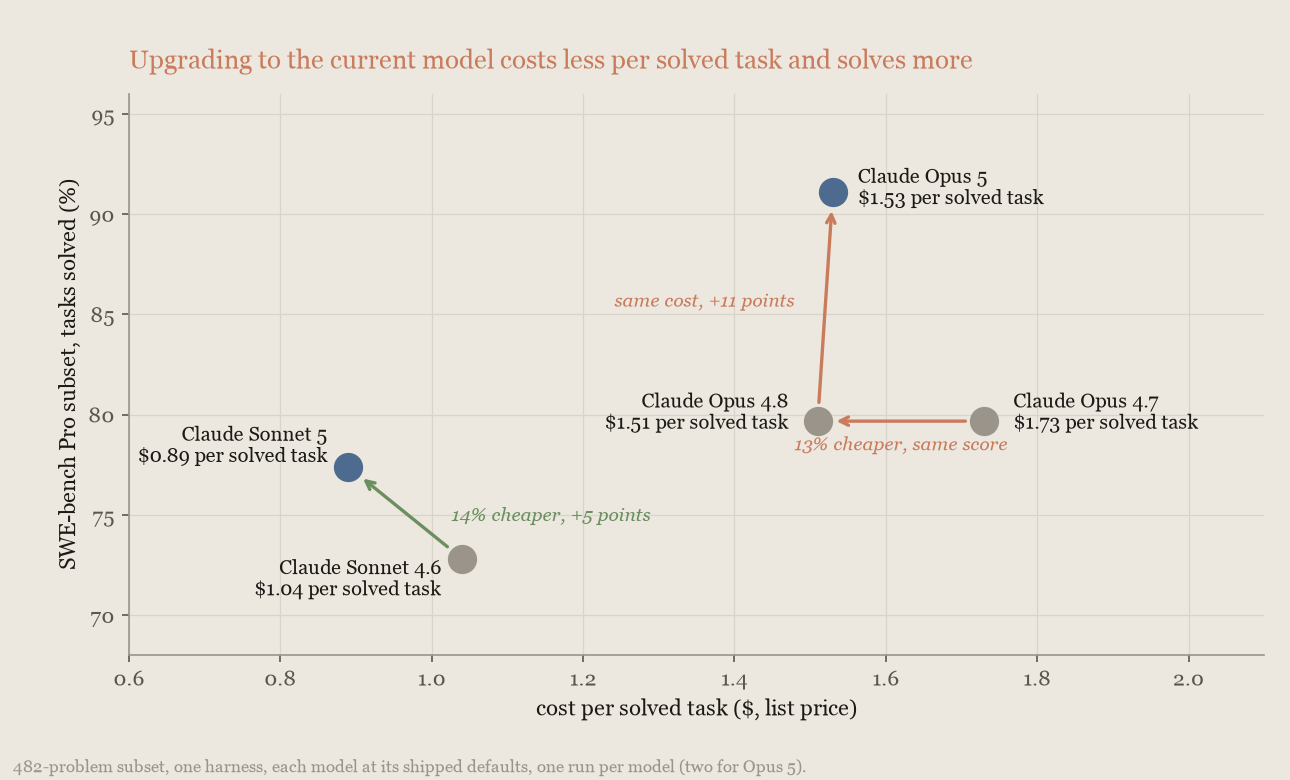
A Anthropic cobra o mesmo preço por token pelo Claude Opus 4.7, Opus 4.8 e Opus 5, então qualquer diferença entre eles vem de quanto trabalho cada modelo faz por tarefa: com preços calculados da mesma forma que um cliente é cobrado, o Claude Opus 4.8 resolve a mesma proporção de tarefas que o Claude Opus 4.7 por 14% menos por tarefa resolvida, e o Claude Opus 5, por sua vez, resolve 12 pontos a mais de tarefas por 21% a mais por tarefa resolvida. O Claude Opus 5 com esforço low supera o padrão do Opus 4.8 neste benchmark por cerca de 30% do custo por tarefa resolvida deste, então o upgrade mais barato é o novo modelo em uma configuração mais baixa. A economia do Sonnet 5 vem de seu preço por token mais baixo, que mais do que compensa os tokens extras que ele usa por tarefa em comparação com o Sonnet 4.6: 15% menos por tarefa resolvida, com 5 pontos a mais. O nível de fronteira ganhou da mesma forma: o Claude Fable 5.1 iguala a pontuação do Claude Fable 5 por 43% menos por tarefa resolvida, a maior parte disso graças ao preço de leitura de cache mais baixo. Essa direção não é garantida: no DeepResearch Bench II7, o mesmo upgrade custa 41% a mais por tarefa em high (79% a mais em low) em troca de 2 a 3 pontos extras nas tarefas limpas em todos os braços (referência 7), porque o novo modelo faz mais trabalho por tarefa nesse caso. Os preços de entrada e saída são os mesmos e a leitura de cache é 4x mais barata, então meça o upgrade na sua própria carga de trabalho antes de presumir que ele gera economia.
Em trabalhos mais difíceis, a diferença aumenta. No Terminal-Bench 320, onde as tarefas são difíceis o suficiente para que a taxa de aprovação, e não os tokens, determine a conta, o Claude Opus 4.7, o Opus 4.8 e o Opus 5 gastam, cada um, de $8 a $15 por tarefa, mas resolvem 7%, 15% e 41% das tarefas, respectivamente, então o custo por tarefa resolvida cai de $183 para $63 e depois para $28 à medida que se sobe na escada. O prêmio de 21% que o Claude Opus 5 tem sobre o Opus 4.8 no subconjunto de codificação saturado se torna uma economia de 56% no Terminal-Bench 3, onde o modelo mais antigo falha na maioria das vezes: quanto mais sua carga de trabalho supera a capacidade do modelo antigo, mais o upgrade economiza por resultado.
Compare pelo custo por tarefa resolvida, não por token: o mesmo texto consome cerca de 30% mais tokens no Claude Opus 4.7 e posteriores, então uma comparação por token faz os modelos mais novos parecerem mais caros por construção.
Ajuste o esforço
O "effort" (esforço) é a forma mais direta de ajustar um modelo à sua tarefa. O parâmetro effort controla quanto pensamento, chamadas de ferramentas e autoverificação o modelo faz, e high, o padrão na maioria dos modelos, é adequado para tarefas exigentes; o Claude Opus 5.5 usa medium como padrão. O custo escala com toda essa atividade; a precisão escala apenas com a parte de que sua tarefa precisa. Abaixo do teto do modelo, os níveis de esforço mais altos pagam por uma profundidade que a tarefa nunca usa.
Nos benchmarks de pesquisa e trabalho de conhecimento (WideSearch1, DeepWideSearch6, BrowseComp4 e GDPval2, todos com Claude Fable 5), a curva de precisão em relação ao custo é quase plana: low abriu mão de 1 a 3 pontos por uma redução de um terço à metade no custo por tarefa, medium igualou a precisão do padrão a cerca de 70% a 87% do seu custo, e o padrão não trouxe nenhum ganho mensurável em relação a medium em nenhum dos quatro. No DeepWideSearch, low também igualou um orquestrador com um worker Claude Sonnet 5 a um custo 29% menor: reduzir o esforço superou uma mudança de arquitetura.
Configurações de esforço mais baixas costumam ser mais rápidas, o que importa quando a "latency" (latência) é a restrição. Nessas execuções, low levou 4,5 minutos por problema no DeepWideSearch, em comparação com 7,9 minutos no padrão. No benchmark de corpus, cuja entrada não cabe em nenhuma "context window" (janela de contexto) única, o Fable 5.1 levou 15,2, 17,5 e 19,9 horas por episódio em low, medium e high.
A codificação de longo horizonte é onde o esforço realmente compra precisão. No SWE-bench Pro3, medido em relação a high, o Claude Opus 5.5 pontuou cerca de 2,5 pontos a menos em seu padrão, medium, por cerca de 70% do custo, e cerca de 8 pontos a menos em low por cerca de um terço do custo; xhigh pontuou cerca de 1,4 ponto a mais por 2,5 vezes o custo de high: um tradeoff real, que reexecutar falhas com esforço maior transforma de volta em economia. Este gráfico mostra a precisão em relação ao custo para os benchmarks de pesquisa e trabalho de conhecimento e para o SWE-bench Pro:
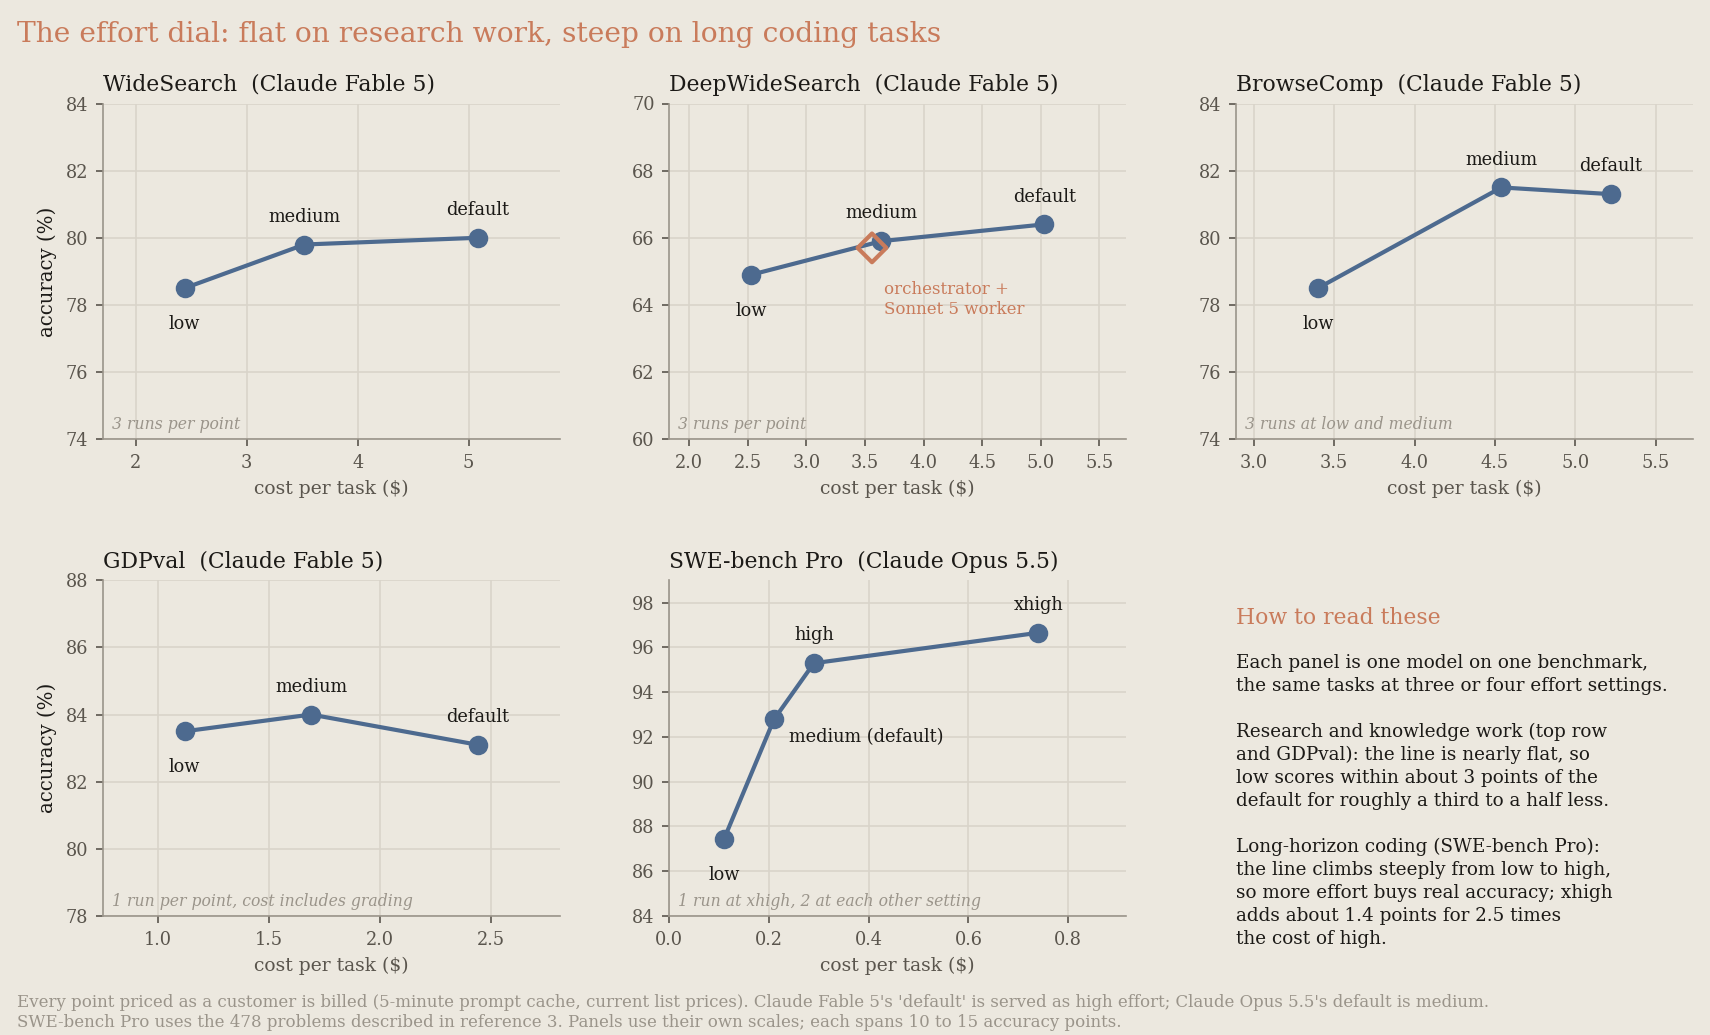
Duas consequências decorrem disso. Primeiro, trace essa curva para sua própria carga de trabalho antes de adicionar um segundo modelo: nessas medições internas, uma configuração multimodelo que parecia mais barata do que o modelo único padrão custou mais do que esse mesmo modelo com esforço menor. Segundo, essa curva é a linha de base de modelo único que qualquer estratégia multimodelo precisa superar, então a etapa 2 de medir na sua própria carga de trabalho estabelece linhas de base em vários níveis de esforço.
Trabalho difícil não precisa automaticamente de esforço alto. No DeepResearch Bench II7, o Claude Fable 5.1 pontuou quase o mesmo em low, medium e high, enquanto o custo por tarefa subiu de $4,66 para $7,12, então aumentar o esforço neste caso não melhora perceptivelmente a qualidade da saída; nas 21 tarefas limpas em todos os braços (referência 7), o Claude Fable 5 também ficou estável em todos os níveis de esforço, embora a base de 33 tarefas do gráfico, que descarta as tentativas interrompidas de cada modelo, mostre-o subindo. Meça a curva no modelo que você coloca em produção, não naquele que você mediu por último:
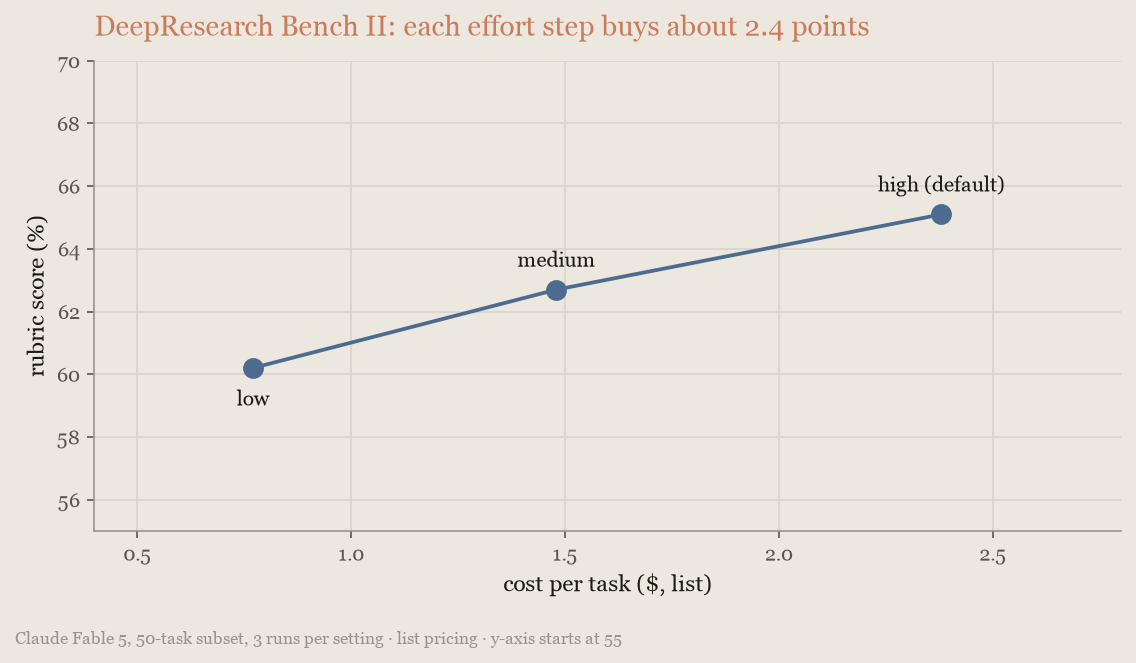
A descrição da tarefa por si só não revela que tipo de carga de trabalho você tem, então teste dois ou três níveis de esforço em uma amostra do seu próprio tráfego e leia a resposta na curva. Teste cada nível em uma sessão separada: alterar o esforço de nível superior no meio da sessão invalida o cache (consulte Armazene contexto repetido em cache) e distorce a comparação. Para detalhes do parâmetro, consulte Esforço.
Reexecute falhas com esforço maior
Quando o resultado de uma tarefa é verificável, a política mais barata na curva de esforço não é uma configuração fixa: execute todas as tarefas em uma configuração baixa e reexecute apenas as falhas em uma mais alta.
A Anthropic calculou essa política tarefa por tarefa a partir das execuções de esforço no subconjunto do SWE-bench Pro3 em Ajuste o esforço. Com o Claude Opus 5.5 em low, 13% das tarefas falharam; com essas reexecutadas em high, cerca de 97% passaram por cerca de $0,17 cada, contra 95,3% por $0,29 executando tudo em high: uma taxa de aprovação ligeiramente maior por pouco mais da metade do custo, contando as tentativas baratas que falharam. Começar em medium resolveu cerca de 97% por cerca de $0,24. A maior parte do pequeno ganho vem da segunda tentativa (reexecutar em high as falhas de uma execução em high pontua aproximadamente o mesmo, por mais dinheiro), então use essa política pela economia, não pelo ganho:
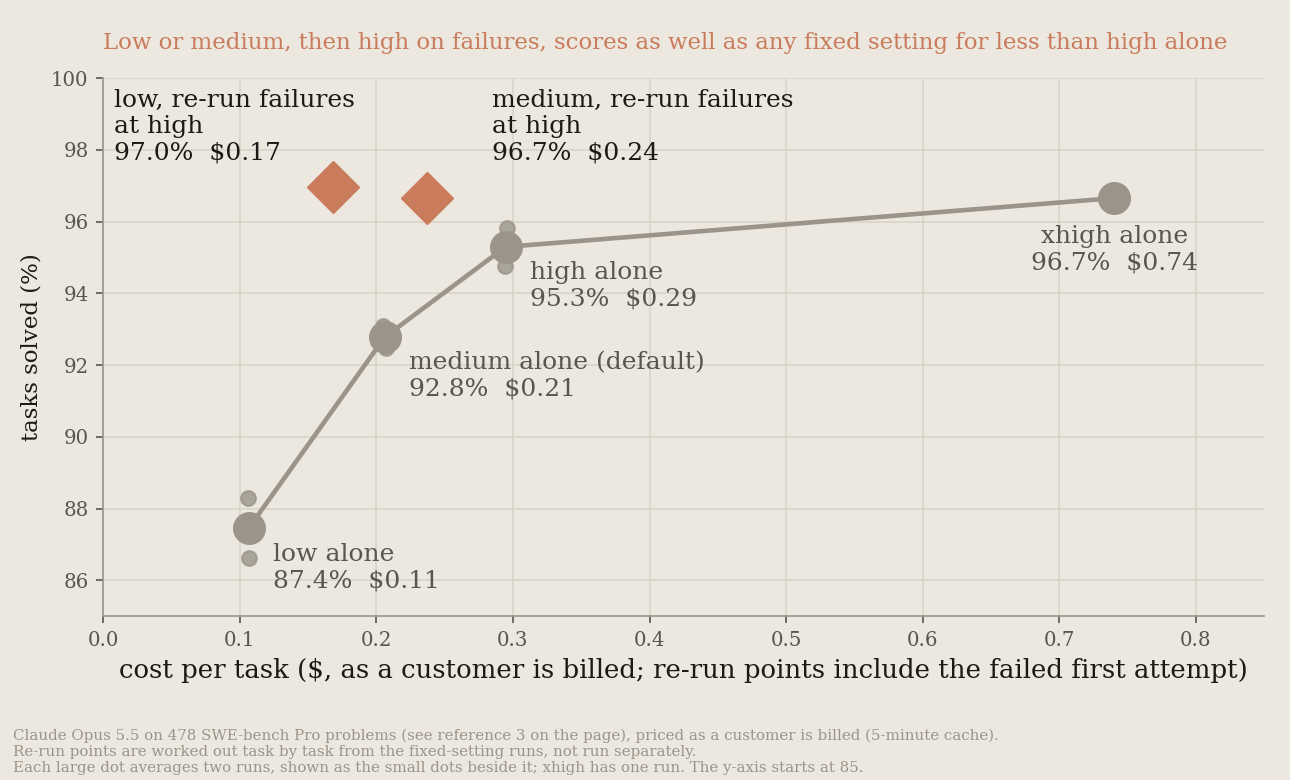
Duas condições se aplicam. Primeiro, você precisa de um sinal de falha (aqui, os próprios testes do benchmark); um verificador que aprova trabalho ruim deixa essas falhas passarem. Segundo, cada falha na primeira passagem leva o tempo de relógio de duas execuções, então a economia é paga em latência nas falhas.
Defina orçamentos e limites de saída
A maioria das execuções de tarefas agênticas é barata, mas uma minoria gasta muitas vezes o custo mediano em buscas, reverificações e testes excessivos. Um orçamento de tarefa ("task budget") mira essa cauda. O modelo vê uma contagem regressiva de tokens ao vivo para toda a tarefa e se autorregula, cortando buscas de baixo valor, pulando verificações redundantes e concluindo em vez de entrar em espiral.
A Anthropic mediu a taxa de aprovação e o custo por tarefa no SWE-bench Pro3 com o Claude Fable 5.1 à medida que o orçamento ficava mais apertado:
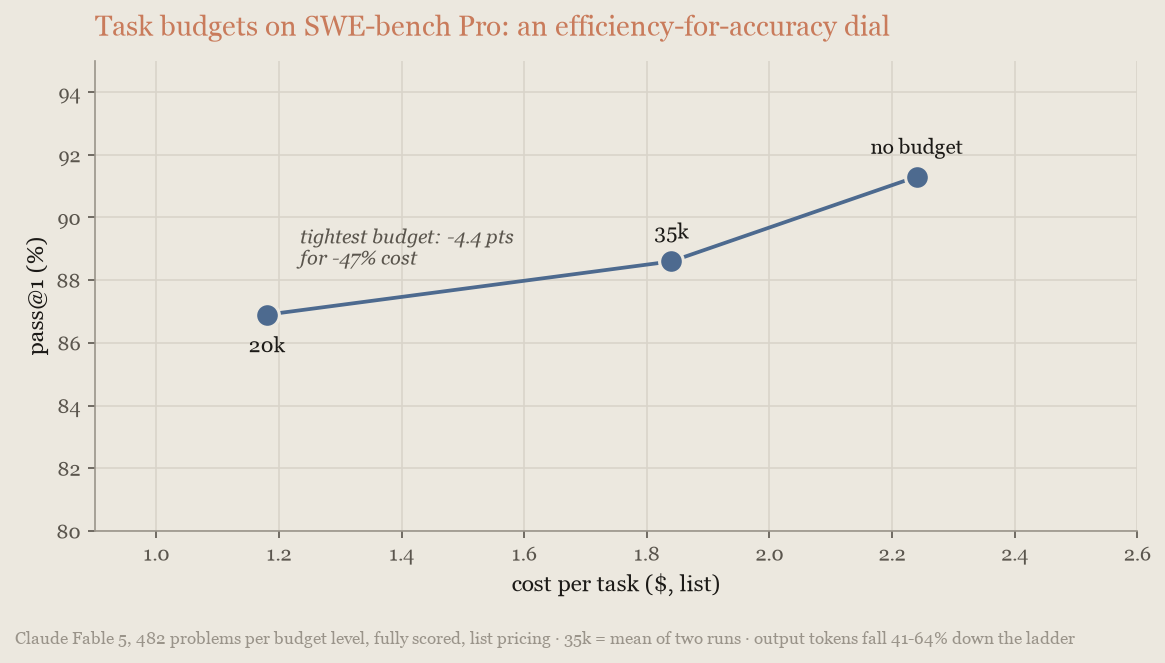
Um orçamento generoso reduziu o custo por tarefa em 44% por cerca de 3 pontos de taxa de aprovação, no limite do ruído entre execuções, e o orçamento mais apertado permitido o reduziu em 58% por 6 pontos. Os orçamentos compraram eficiência aqui, a um preço em taxa de aprovação que cresce à medida que o orçamento fica mais apertado.
Três controles fazem três trabalhos diferentes. Um orçamento de tarefa economiza dinheiro, porque o modelo o vê. max_tokens é um limite de segurança: reduzi-lo cortou o custo por tentativa sem reduzir o custo por tarefa resolvida. No Claude Managed Agents, um orçamento de sessão é a parada rígida em dólares por trás de ambos. Defina os três: um orçamento de tarefa, um max_tokens alto e um limite de sessão para a execução que você nunca quer ver em uma fatura, com um limite de gastos do workspace como última proteção.
- Orçamentos de tarefa estão em beta (cabeçalho beta
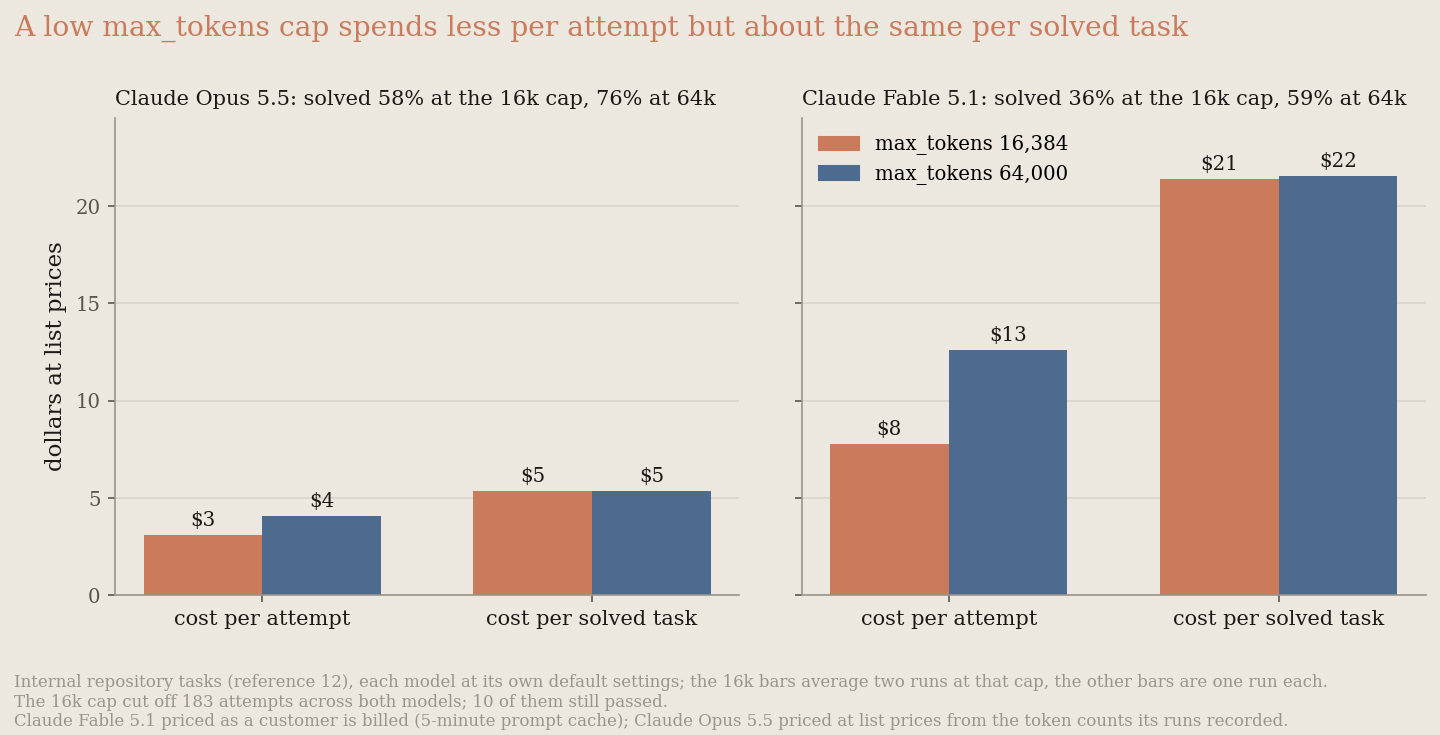
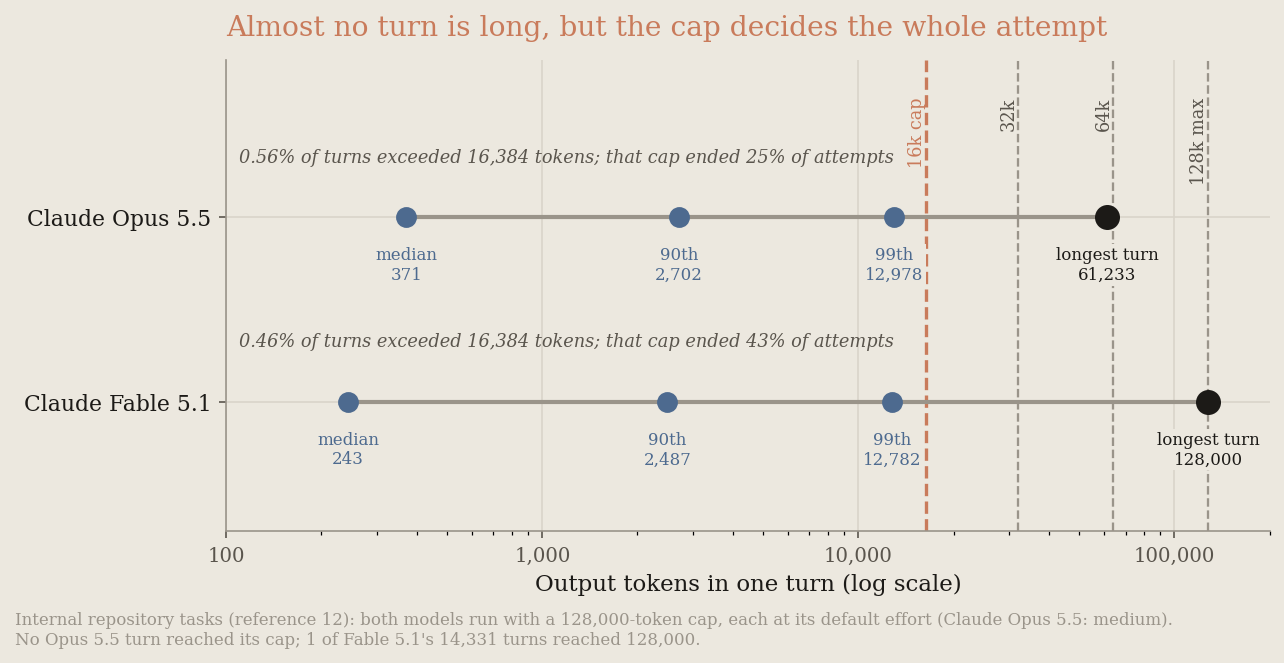
task-budgets-2026-03-13) nos modelos mais recentes; consulte a tabela de suporte para saber quais. Comece perto do uso de tokens do percentil 90 do seu loop e depois aperte (Escolhendo um orçamento mostra como coletar essa distribuição). Orçamentos abaixo do piso atual de 20.000 tokens são rejeitados, e orçamentos muito apertados podem produzir comportamento semelhante a recusa. Defina o orçamento uma vez, na primeira requisição, porque uma alteração no meio da tarefa invalida o cache. O orçamento é consultivo, orientando o modelo em vez de pará-lo, então verifique a adesão na sua carga de trabalho. max_tokenslimita uma única resposta, de forma invisível para o modelo, então reduzi-lo não faz o modelo economizar. Os turnos que precisavam do espaço são descartados e ainda assim cobrados. Em um benchmark interno de tarefas de repositório12, um limite de 16.384 tokens encerrou cerca de um quarto das tentativas do Claude Opus 5.5 e 43% das do Claude Fable 5.1, cada um em seu esforço padrão. Apenas 1 das 66 tentativas limitadas do Opus 5.5 e 9 das 117 tentativas limitadas do Fable ainda passaram. As execuções limitadas gastaram menos por tentativa, mas compraram proporcionalmente menos soluções, então o custo por tarefa resolvida foi aproximadamente o mesmo que com 64.000 (no Fable 5.1, $21 contra $22; no Opus 5.5, dentro de 1%). Com 64.000, 2 de cerca de 14.000 turnos do Claude Fable 5.1 em seu esforço padrão ainda foram cortados (nenhum turno do Claude Opus 5.5 foi), e o Fable 5.1 resolveu 58,5% das tarefas em vez de 36,3% (em um recorte separado do subconjunto do SWE-bench Pro3, descrito na referência 12, nenhuma diferença: 94 de 100 com qualquer um dos limites). Tentar novamente as tentativas limitadas raramente ajuda: com o mesmo limite, a maioria delas falha de novo, e com um limite maior você também paga pela tentativa desperdiçada. Definamax_tokenscomo 64.000 para trabalho agêntico, ou como 128.000, o máximo, quando uma única tentativa cortada for custosa; com 128.000, o Fable 5.1 resolveu 60,0% pelo mesmo custo por tarefa resolvida. Faça streaming das respostas desse tamanho, tratestop_reason: max_tokenscomo uma falha e economize dinheiro com esforço e orçamentos de tarefa, que o modelo consegue ver.- Orçamentos de sessão no Claude Managed Agents são a parada rígida. Um orçamento de sessão é um limite em dólares para uma sessão, a preços de tabela, para tokens, buscas e tempo de sessão. Ao atingir o limite, a sessão pausa com
stop_reason: budget_reached; aumentar o orçamento a retoma. Ele é aplicado pela plataforma, funciona em qualquer modelo com preço de tabela, incluindo modelos em que os orçamentos de tarefa ainda não estão disponíveis, e se combina com o orçamento de tarefa consultivo. As implantações aplicam o mesmo campo a todas as execuções.
Peça respostas mais curtas. Tokens de saída custam cinco vezes mais que tokens de entrada no Claude Sonnet 5, e em um loop de agente cada token que o modelo escreve volta como entrada em todos os turnos posteriores, então você paga por uma resposta longa repetidas vezes. A Anthropic executou o trabalho de triagem com três instruções de resposta final, três execuções cada, com o mesmo modelo e as mesmas ferramentas. A original pedia duas linhas:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>A variante mais curta pedia uma:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.A variante mais longa pedia um memorando com cinco seções com títulos: resumo do problema, evidências, verificação de duplicatas, rótulo recomendado e próximos passos. Para uma issue, um prompt enfileirado que nunca é enviado após uma pergunta pulada, as duas primeiras respostas foram:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.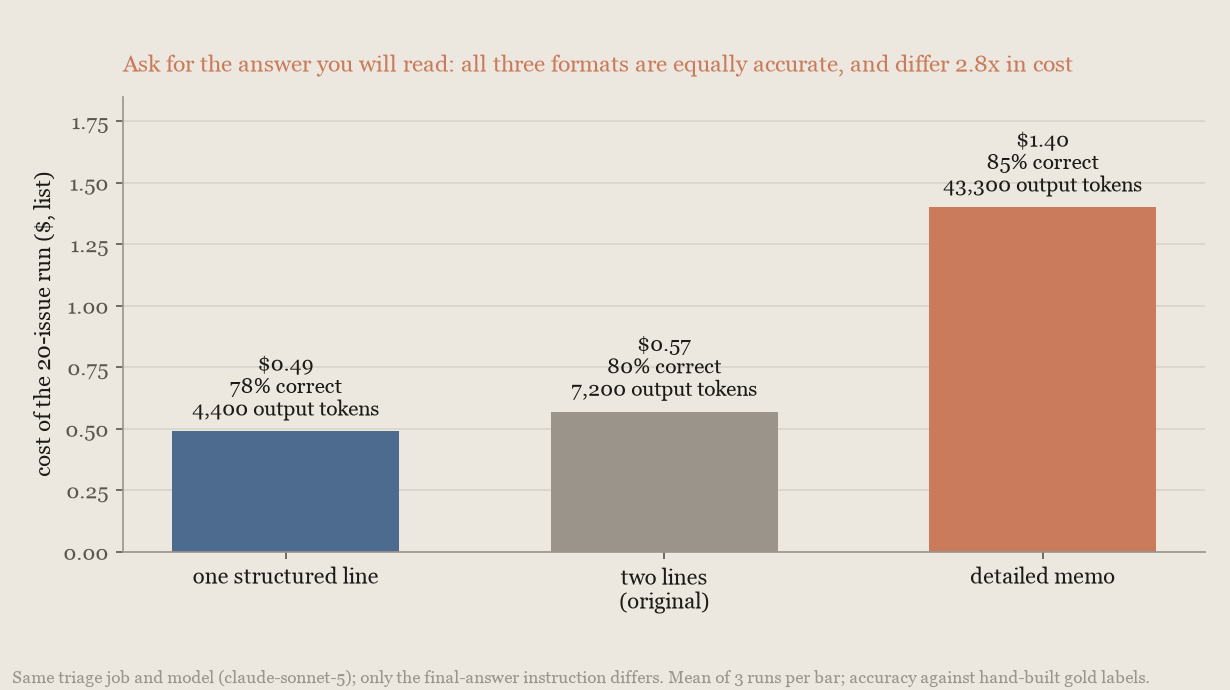
A resposta de uma linha usou 39% menos tokens de saída do que a original de duas linhas e custou 14% menos por execução. O memorando usou seis vezes mais tokens de saída e custou 2,8 vezes a resposta de uma linha. Os três pontuaram dentro do ruído entre execuções uns dos outros em relação aos rótulos de referência, então os formatos diferem muito mais no que você paga do que no que acertam. Peça a resposta que você vai ler, não a que parece minuciosa.
Com o limite de max_tokens mais baixo, ambos os modelos gastam menos por tentativa, mas resolvem proporcionalmente menos tarefas, então o custo por tarefa resolvida quase não se altera:
Quase todos os turnos terminam muito abaixo de qualquer um dos limites. O raro turno longo é o que o limite mais alto compra:
Mostre ao modelo o tempo decorrido
Um modelo em um loop de agente não consegue ver um relógio. Um orçamento de tarefa mostra a ele quantos tokens restam, mas por padrão nada na requisição mostra quanto tempo o trabalho levou. Duas pequenas mudanças dão a ele esse sinal. Adicione ao prompt do sistema uma instrução de duas frases dizendo que o tempo importa e, a partir da segunda requisição, envie o tempo decorrido antes de cada turno do modelo.
A Anthropic mediu as duas mudanças juntas com o Claude Fable 5.1 em esforço high, em dois benchmarks públicos, DRACO21 e HLE22, e em um conjunto interno de 70 problemas de física de nível de pesquisa, adaptado do benchmark público CritPt23. Esta página chama esse conjunto de conjunto de física. Cada um dos três foi executado em dois formatos: um único agente e uma equipe na qual um agente líder inicia agentes auxiliares do mesmo modelo que trabalham em paralelo. Uma mudança de pontuação conta como dentro da margem quando seu intervalo de 95% fica dentro de um limite que a Anthropic definiu antes das execuções: 1,5 ponto no DRACO e 2,5 pontos no HLE. O gráfico a seguir mostra a pontuação em relação ao custo por tarefa para cada configuração. Uma segunda linha de barras dá o tempo de cada configuração como uma razão em relação ao agente único em esforço high, sem esperas de nova tentativa. Uma terceira linha dá a mudança de pontuação que as duas mudanças produzem, com seu intervalo de 95%:
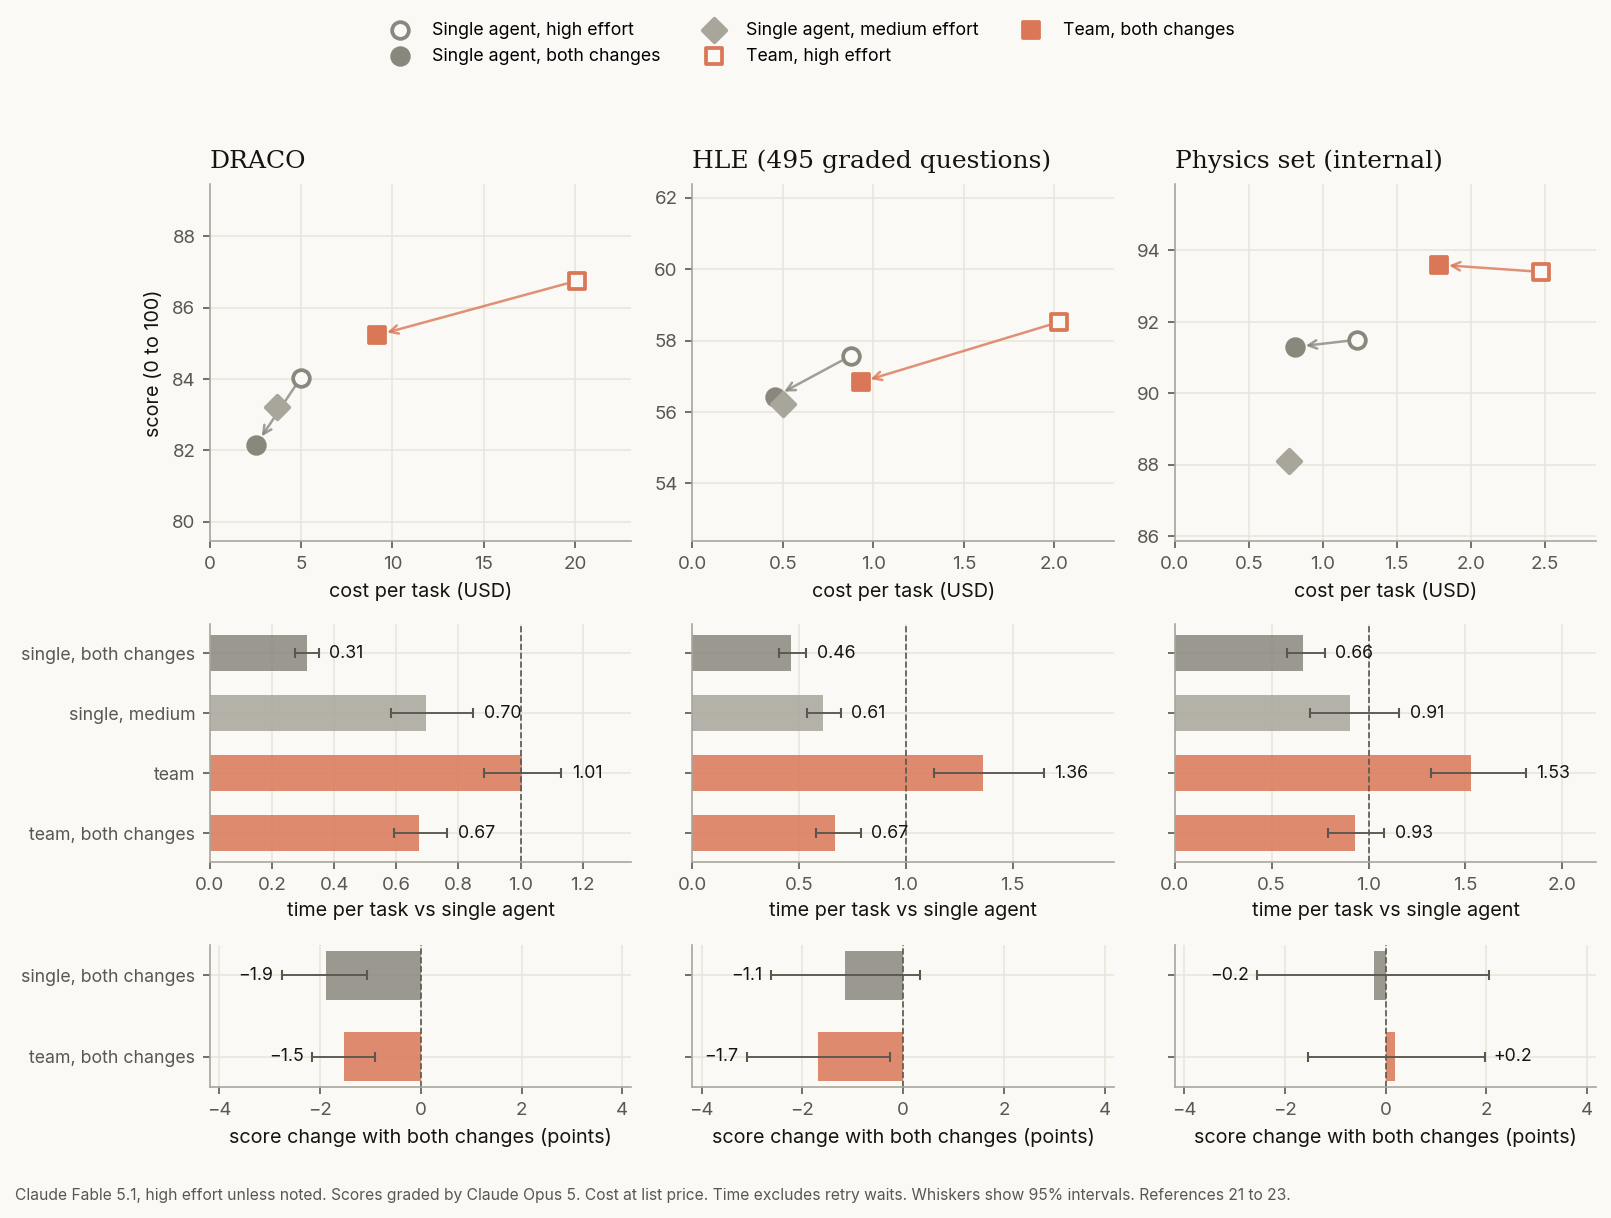
Com uma equipe de agentes. Uma equipe faz mais trabalho do que um único agente, então por padrão custa mais. No DRACO, a equipe custou 4,0 vezes mais que o agente único e levou aproximadamente o mesmo tempo (intervalo de 95% de 12% menos a 13% mais). Com a instrução e o relógio em todos os agentes, a equipe terminou em 33% menos tempo com um custo por tarefa 54% menor. Sua pontuação foi 1,5 ponto menor (intervalo de 95% de 0,9 a 2,1 menor), e a extremidade desse intervalo, 2,1 pontos menor, ultrapassa a margem de 1,5 ponto. No HLE, a equipe terminou em 51% menos tempo com um custo por tarefa 54% menor. Sua pontuação foi 1,7 ponto menor (intervalo de 95% de 0,3 a 3,1 menor), e a extremidade desse intervalo, 3,1 pontos menor, ultrapassa a margem de 2,5 pontos. No conjunto de física23, a equipe terminou em 39% menos tempo. Seu custo por tarefa foi 28% menor, e essa economia depende de com que frequência o cache de prompt expirou entre as requisições. Sem expiração, seria de 23%. Sua pontuação foi 0,2 ponto maior (intervalo de 95% de 1,5 menor a 2,0 maior).
No DRACO, o líder iniciou uma mediana de 4 auxiliares por tentativa, então o resultado do DRACO mostra uma equipe trabalhando em paralelo. No HLE e no conjunto de física, o líder iniciou uma mediana de 0 auxiliares, então pelo menos metade dessas execuções em equipe teve apenas o agente líder. Esses resultados de equipe mostram principalmente o comportamento do próprio agente líder, não o efeito de auxiliares em paralelo.
Com um único agente. No conjunto de física23, as mesmas mudanças reduziram o tempo de um único agente em 34% e seu custo por tarefa em 34%. Sua pontuação foi 0,2 ponto menor (intervalo de 95% de 2,5 menor a 2,1 maior). No conjunto de física, um nível de esforço mais baixo economizou custo, mas não claramente tempo. Em esforço medium, o agente único custou 37% menos por tarefa do que em high, e seu tempo foi 9% menor (intervalo de 95% de 30% menos a 16% mais). Ele pontuou 3,4 pontos a menos (intervalo de 95% de 0,4 a 6,8 menor), e o intervalo chega perto de zero. Com as duas mudanças em esforço high, o agente único levou 27% menos tempo do que em esforço medium (intervalo de 95% de 5% menos a 44% menos). Seu custo por tarefa foi 6% maior (intervalo de 95% de 12% menos a 27% mais), e sua pontuação foi 3,2 pontos maior (intervalo de 95% de 0,1 menor a 6,5 maior).
No HLE, as mesmas mudanças reduziram o tempo de um único agente em 54% e seu custo por tarefa em 48%. Sua pontuação foi 1,1 ponto menor (intervalo de 95% de 2,6 menor a 0,3 maior), e a extremidade desse intervalo, 2,6 pontos menor, fica logo além da margem de 2,5 pontos. Em esforço medium, o agente único custou 43% menos por tarefa do que em high, levou 39% menos tempo e pontuou 1,3 ponto a menos (intervalo de 95% de 2,8 menor a 0,1 maior). Com as duas mudanças em esforço high, o agente único levou 25% menos tempo do que em esforço medium (intervalo de 95% de 12% menos a 35% menos). Seu custo por tarefa foi 9% menor (intervalo de 95% de 21% menos a 6% mais), e sua pontuação foi 0,2 ponto maior (intervalo de 95% de 1,3 menor a 1,7 maior).
No DRACO, as mesmas mudanças reduziram o tempo de um único agente em 69% e seu custo por tarefa em 49%. Sua pontuação foi 1,9 ponto menor (intervalo de 95% de 1,1 a 2,8 menor), e a extremidade desse intervalo, 2,8 pontos menor, ultrapassa a margem de 1,5 ponto. Em esforço medium, o agente único custou 25% menos por tarefa do que em high, levou 30% menos tempo e pontuou 0,7 ponto a menos (intervalo de 95% de 0,1 a 1,3 menor). Com as duas mudanças em esforço high, o agente único levou 53% menos tempo do que em esforço medium (intervalo de 95% de 42% menos a 63% menos), e seu custo por tarefa foi 31% menor (intervalo de 95% de 28% menos a 35% menos). Sua pontuação foi 1,2 ponto menor (intervalo de 95% de 0,5 a 1,9 menor), e a extremidade desse intervalo, 1,9 ponto menor, ultrapassa a margem de 1,5 ponto.
Nos três conjuntos, as duas mudanças em esforço high economizaram mais tempo do que o esforço medium. No HLE e no conjunto de física, não houve diferença clara de custo, e no DRACO o custo foi menor. A pontuação foi aproximadamente a mesma no HLE. No conjunto de física, foi 3,2 pontos maior, mas esse intervalo inclui zero, então a diferença não é clara. Portanto, para um único agente, o relógio economiza mais tempo do que um nível de esforço mais baixo. No DRACO, porém, o agente único com as duas mudanças pontuou 1,2 ponto a menos do que em esforço medium (intervalo de 95% de 0,5 a 1,9 menor).
Quando usar.
- Use as duas mudanças quando o tempo de um agente importa e uma pequena mudança de pontuação é aceitável. Em todas as configurações medidas, elas reduziram o tempo e o custo por tarefa, para equipes e para agentes únicos.
- Verifique a pontuação nas suas próprias tarefas antes de adotá-las. No DRACO, a pontuação foi 1,5 ponto menor para uma equipe e 1,9 ponto menor para um agente único. No HLE, foi 1,7 ponto menor para uma equipe e 1,1 ponto menor para um agente único. No conjunto de física, nenhuma das mudanças de pontuação foi claramente diferente de zero.
- Se você já está pensando em um nível de esforço mais baixo para economizar tempo, compare-o com o relógio. Um agente único com as duas mudanças em esforço
highlevou menos tempo do que em esforçomedium: 53% menos no DRACO, 25% menos no HLE e 27% menos no conjunto de física. Seu custo por tarefa foi 31% menor no DRACO, sem diferença clara no HLE e no conjunto de física.
Como adicionar. Coloque esta instrução no início do prompt do sistema de cada agente:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.A segunda frase informa ao modelo que as mensagens de relógio existem. A primeira requisição não carrega relógio, e as execuções medidas usaram exatamente essa redação.
Em seguida, antes de cada requisição após a primeira de um agente, anexe uma mensagem de sistema no meio da conversa que informe o tempo decorrido em segundos inteiros, como Elapsed time: 412 seconds. Conte a partir do início da tarefa, não do início do agente. Em uma equipe, todos os agentes leem o mesmo relógio, então o primeiro relógio que um auxiliar vê já conta o tempo que a equipe gastou antes de o auxiliar começar. Em um loop de ferramentas, coloque a mensagem logo após a mensagem user que carrega os resultados das ferramentas, como mostra Posicionamento após resultados de ferramentas. Se, em vez disso, você enviar ao agente uma nova mensagem user, coloque o relógio após essa mensagem.
Deixe as mensagens de relógio anteriores onde estão. Cada uma se torna parte do histórico da conversa, então o prefixo em cache ainda corresponde na próxima requisição (consulte Combinando com cache de prompt). A Anthropic mediu essas mensagens de sistema simples, que permanecem visíveis para o modelo. Uma mensagem de sistema com escopo de turno mostraria ao modelo apenas o relógio mais recente, e a Anthropic não mediu essa forma.
O exemplo a seguir executa o loop de ferramentas de um agente com as duas mudanças. Ele adiciona o relógio após os resultados das ferramentas e lida apenas com ferramentas de cliente:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Segundos de relógio real (wall-clock), para que helpers em outros processos possam compartilhar o horário de início do líder.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Usa streaming porque um limite de 128.000 tokens é grande demais para uma requisição sem streaming.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Uma mensagem de sistema deve vir após um turno do usuário, então o relógio vai depois dos resultados das ferramentas.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)O Claude Fable 5.1 oferece suporte a mensagens de sistema no meio da conversa. A lista de modelos compatíveis cobre os demais. Em um modelo sem esse suporte, como o Claude Sonnet 5, você pode colocar a mesma linha em um bloco de texto após o último bloco tool_result no turno user. A Anthropic mediu apenas a forma de mensagem de sistema.
No Claude Managed Agents, você pode enviar um evento system.message com um resultado de ferramenta ou uma mensagem do usuário. A mensagem se aplica a esse turno e a todos os turnos posteriores. Assim, os turnos que seguem as ferramentas integradas da plataforma, como a busca na web, veem o último relógio que você enviou, não o horário atual. Um system.message também alcança apenas a thread principal da sessão. Em uma sessão multiagente, essa é a thread do coordenador, então os agentes workers nunca veem um relógio que você envia dessa forma. Para mostrar o horário atual antes de cada turno, e para todos os agentes de uma equipe, execute você mesmo o loop do agente na Messages API.
Combine modelos
Arquiteturas multimodelo se adequam a cargas de trabalho cuja complexidade de tarefa varia o suficiente para que diferentes etapas sejam melhor atendidas por diferentes modelos. Quando seu tráfego mistura trabalho rotineiro que um modelo menor lida de forma confiável com etapas mais difíceis que precisam de capacidade de fronteira, dividir o trabalho mantém a inteligência de fronteira onde ela importa enquanto a maioria dos tokens é cobrada a taxas de modelo menor. Quando uma carga de trabalho não tem essa mistura, porque sua dificuldade é uniforme ou é uma única cadeia dependente, um único modelo bem ajustado geralmente é a melhor escolha. Cada seção de estratégia dá a regra para distinguir os dois casos.
Duas estratégias cobrem a maioria das cargas de trabalho, e elas diferem em qual modelo mantém o loop principal:
| Estratégia | Fluxo de controle | Papel do modelo de fronteira | Adequada para | O custo de fronteira escala com |
|---|---|---|---|---|
| Advisor | O modelo menor executa o loop, escala sob demanda | Consultado para planos e correções | Trabalho serial que é difícil em alguns pontos, como os muitos turnos de um agente de codificação entre algumas decisões reais | Com que frequência o executor fica travado |
| Orquestrador | O modelo de fronteira executa o loop, delega o trabalho em massa | Planeja, despacha e sintetiza | Trabalho que se espalha por arquivos, documentos ou casos genuinamente independentes, especialmente mais de uma janela de contexto deles | Quão difícil é coordenar as partes |
Estratégia advisor: escale decisões difíceis
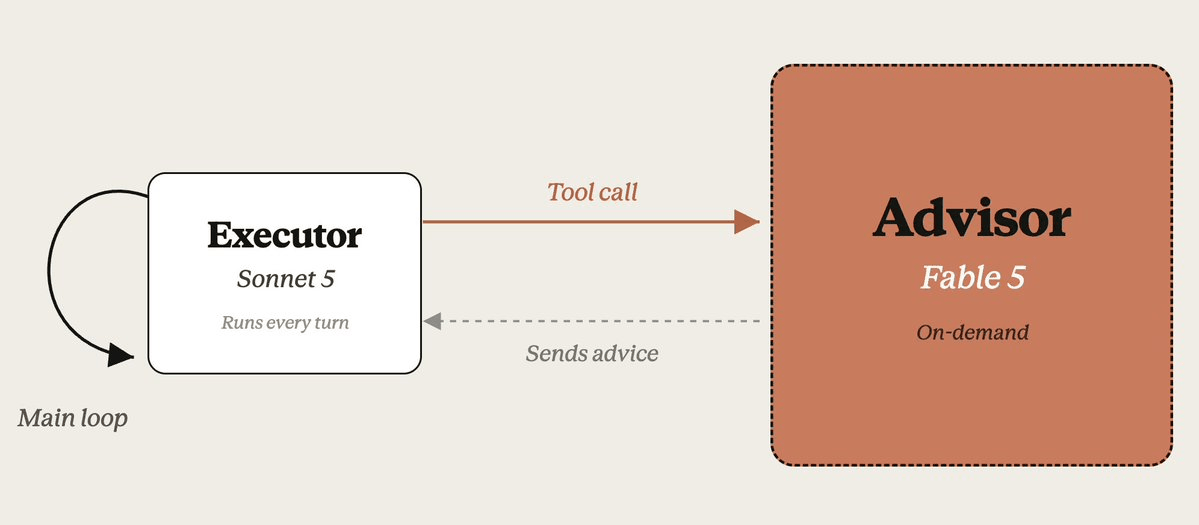
Na estratégia advisor, um modelo executor de menor custo executa o loop do agente e realiza a maioria dos turnos. Quando encontra uma decisão que precisa de julgamento mais profundo, como escolher uma abordagem ou se recuperar de uma falha, ele chama um modelo advisor de maior inteligência para obter orientação estratégica e depois continua. A maioria dos tokens é cobrada a preços do executor, e apenas as consultas ocasionais a preços do advisor.
Para usá-la, adicione a ferramenta advisor à sua requisição. Este recurso beta executa toda a estratégia no lado do servidor em uma única requisição /v1/messages: o executor emite uma chamada de ferramenta, a Anthropic executa a inferência do advisor e o executor continua com o conselho; você não escreve nenhum código de orquestração. No Claude Managed Agents, dê um advisor à sessão adicionando uma entrada advisor à lista multiagent do agente; a thread principal da sessão o consulta da mesma forma. O Claude Code também oferece suporte; consulte escalando decisões difíceis com a ferramenta advisor.
O que determina o retorno. O advisor vê a tarefa apenas por meio das chamadas do executor, então duas coisas decidem o quanto ele ajuda.
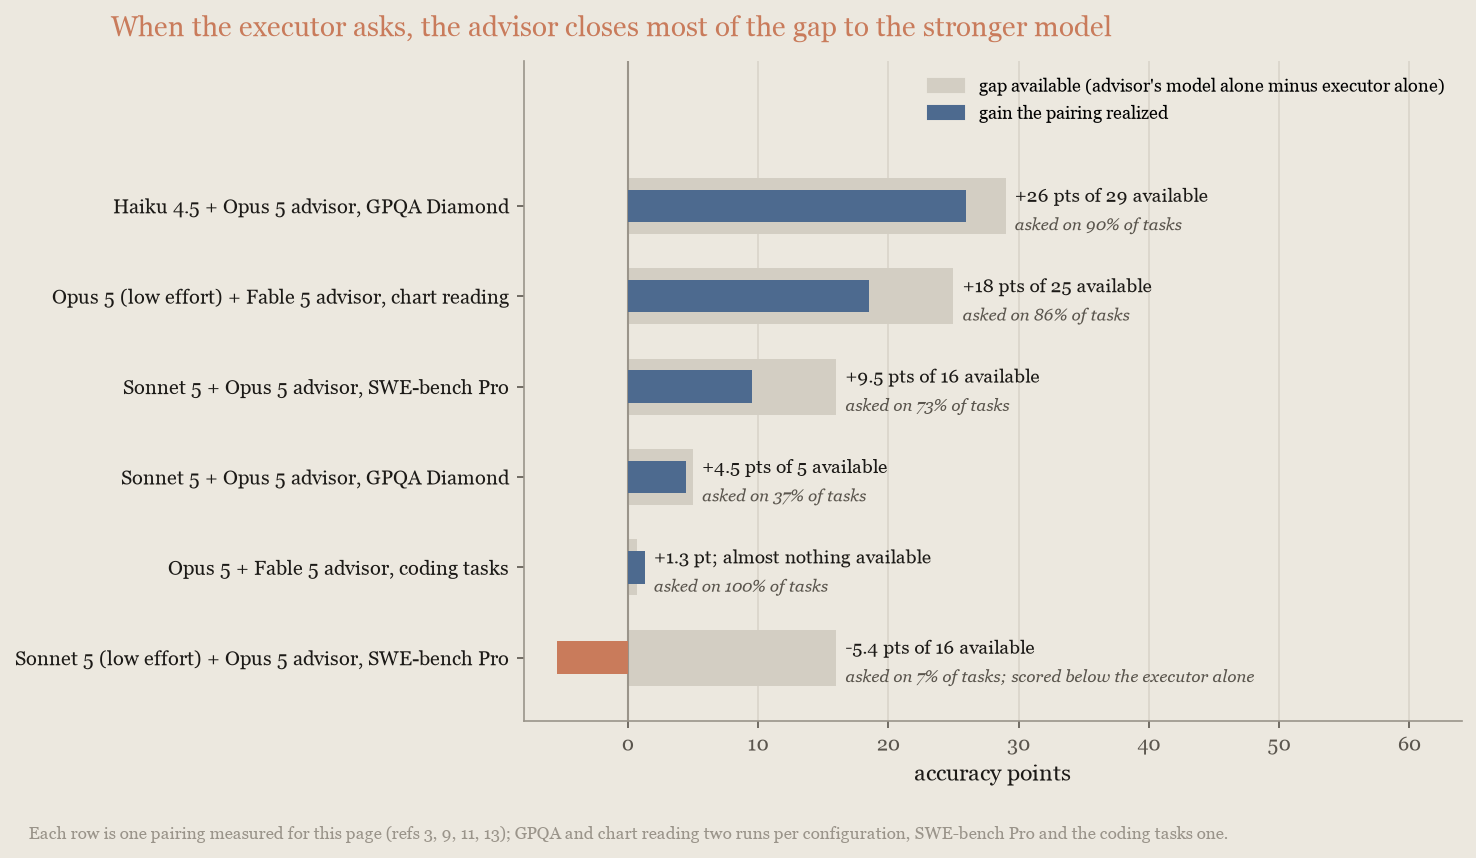
A primeira é a diferença entre os modelos. O advisor só pode transferir capacidade que falta ao executor: no GPQA Diamond9, um executor Claude Haiku 4.5 ganhou muito com um advisor Claude Opus 5, um executor Claude Sonnet 5 ganhou alguns pontos e um executor de fronteira quase nada.
A segunda, e a frágil, é se o executor realmente pede ajuda (a "consult rate", ou taxa de consulta). Um executor com esforço baixo pode deixar de detectar que está travado: um pareamento que consulta na maioria das tarefas com o esforço padrão pode passar a consultar em quase nenhuma quando o esforço é reduzido, e então pontua abaixo do executor sozinho. A taxa também varia por tarefa: no DeepSWE10, um executor Sonnet 5 com esforço baixo continuou pedindo e ganhou 23 pontos; no SWE-bench Pro3, o mesmo executor parou. Quando o executor pede, ele recupera grande parte da diferença. Entre os pareamentos do gráfico a seguir cujo executor continuou pedindo, o advisor fechou pelo menos metade da diferença para o modelo mais forte (o pareamento de codificação superou o modelo mais forte diretamente), e você paga pelo modelo mais forte apenas nas consultas, o que torna possíveis os casos de economia de custo:
A taxa de consulta responde ao prompt. Apenas com a descrição integrada da ferramenta, os executores fazem poucas chamadas, especialmente em trabalho de codificação, então a documentação da ferramenta advisor fornece um prompt do sistema que pede uma chamada antes do trabalho substantivo e uma antes de terminar, cerca de duas a três chamadas por tarefa. O pareamento de codificação medido a seguir funcionou nessa cadência com o Claude Opus 5 como executor, cerca de duas consultas em cada tarefa; com o Claude Opus 5.5 como executor, ele pediu conselho cerca de 1,4 vez por tentativa, e 4% de suas tentativas não receberam nenhum conselho. Essa página também aborda como incentivar um executor que faz poucas chamadas e como limitar chamadas no lado do cliente para restringir o custo. Portanto, observe a taxa de consulta: incentive-a via prompt, meça-a e restaure o esforço do executor se ela despencar.
Quando compensa em custo. Um advisor economiza dinheiro quando algumas consultas curtas, cobradas ao preço do advisor, substituem a execução do modelo do advisor durante toda a tarefa. Isso funciona melhor quando o modelo do advisor tem preço bem acima do executor, então a configuração mais econômica é um advisor de fronteira sobre um executor de nível intermediário. Um pareamento no topo da faixa pode recuperar parte do custo do conselho, porque o conselho também economiza tokens do executor: um executor informado sobre a abordagem certa explora menos becos sem saída. No pareamento de codificação abaixo com um executor Claude Opus 5, essa economia pagou cerca de metade do conselho: o executor gastou $1,26 a menos por tentativa do que o Opus 5 sozinho em seu padrão, e as consultas custaram $2,47. Com um executor Claude Opus 5.5, o conselho quase não economizou custo do executor: $1,36 por tentativa contra $1,38 do Opus 5.5 sozinho em high, enquanto as consultas custaram $1,55.
Em um benchmark interno de codificação agêntica11, executado com um agente simples via API, um executor Claude Opus 5.5 em high com um advisor Claude Fable 5.1 pontuou 90,1% a $2,92 por tentativa. Isso é 1,7 ponto acima do Opus 5.5 sozinho em high, a própria configuração do executor, uma diferença no limite do ruído entre execuções com cinco tentativas por tarefa, por cerca de 2,1 vezes o dinheiro; em relação ao Opus 5.5 em seu padrão, medium, são 3,5 pontos por cerca de 3,5 vezes o dinheiro. Ele fica aproximadamente sobre a própria curva de esforço do Opus 5.5, então o advisor compra aproximadamente o que mais esforço compra: o Opus 5.5 sozinho em xhigh pontuou 91,1% por $4,11 por tentativa (uma tentativa por tarefa). Em agosto, um advisor Claude Fable 5.1 sobre um executor Claude Opus 5 foi a configuração mais precisa medida, a $6,21 por tentativa, um pouco mais que o dobro do custo do pareamento com o Opus 5.5. O gráfico mostra o pareamento com o Opus 5.5 em relação à própria curva de esforço do Opus 5.5 e à do Claude Fable 5.1 de agosto:
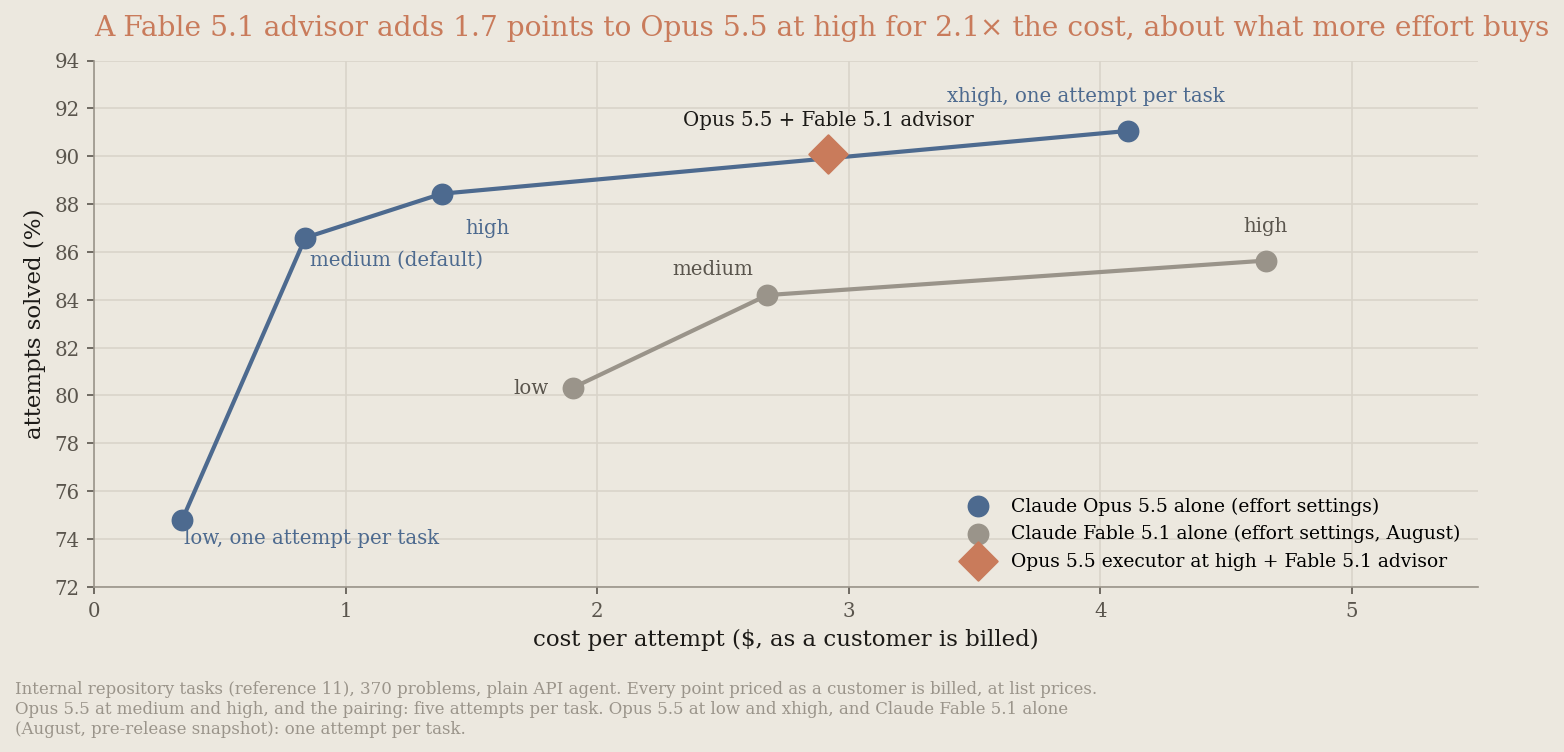
Uma medição anterior por meio do modo advisor do Claude Code também classificou seu pareamento de advisor acima de ambos os seus modelos sozinhos. Leia o resultado do Claude Opus 5.5 como um padrão a ser testado na sua carga de trabalho: o advisor compra alguns pontos por cerca do dobro do que o executor custa sozinho. Uma diferença de capacidade maior não garante um negócio melhor. O custo de latência são as próprias consultas: cerca de uma ou duas chamadas extras ao modelo de fronteira por tarefa neste benchmark, cada uma no caminho crítico da tarefa.
Quando o modelo mais forte sozinho é o melhor passo. Quando a precisão de uma carga de trabalho responde ao esforço, compare o pareamento com o modelo do advisor sozinho em uma configuração reduzida antes de construí-lo: o advisor é pago apenas nas tarefas que precisam dele, mas uma consulta que dispara na maioria das tarefas custa mais do que executar o próprio modelo mais forte. No Chartography13, um executor Claude Opus 5.5 em low, com um advisor Claude Fable 5.1, consultou-o em 1 de 300 tarefas e pontuou 61,7, 7 pontos abaixo do Opus 5.5 sozinho e além do ruído entre execuções, a aproximadamente o mesmo custo; em agosto, um executor Claude Opus 5 consultou em quase todas as tarefas, e esse pareamento igualou o Fable 5.1 sozinho em medium dentro do ruído entre execuções (65,0 contra 67,5) a cerca de 1,8 vez o custo por tarefa. Meça primeiro sua própria taxa de consulta: se o executor pede ajuda na maioria de suas tarefas, você está pagando preços de advisor em toda a carga de trabalho, e executar o próprio modelo do advisor é o caminho mais barato para a mesma pontuação.
Seja qual for o pareamento, primeiro precifique o modelo do advisor sozinho com esforço baixo; essa é a linha de base a ser superada. Verifique novamente a cada lançamento de modelo, porque os lançamentos alteram tanto a diferença de capacidade quanto a razão de preços.
Quando é adequada. A estratégia advisor é adequada para cargas de trabalho em que os turnos são majoritariamente mecânicos, mas um plano excelente importa: agentes de codificação, uso de computador e pipelines de pesquisa de várias etapas. Ela é pouco adequada quando cada turno realmente precisa de capacidade de fronteira, quando não há nada a planejar (perguntas e respostas de turno único) ou quando seu executor já está próximo da capacidade do advisor.
Estratégia de orquestrador: delegue o trabalho em massa
Na estratégia de "orchestrator" (orquestrador), o "frontier model" (modelo de fronteira) controla o loop. Ele decompõe a tarefa, despacha subtarefas para "worker models" (modelos trabalhadores) de menor custo e mescla os resultados deles. A transcrição do próprio orquestrador permanece curta porque os workers absorvem a exploração que consome muitos tokens. Assim, a maioria dos tokens é cobrada pelas tarifas dos workers, enquanto o plano e a síntese ainda vêm do modelo de fronteira.
Para construir um, use a orquestração multiagente no Claude Managed Agents: configure um agente coordenador (o orquestrador) e um conjunto de agentes workers, cada um com seu próprio modelo. Para um exemplo completo e funcional com um coordenador de fronteira e workers Claude Sonnet 5, consulte a receita do Claude Cookbook Coordinator pattern: big models for planning, small models for execution.
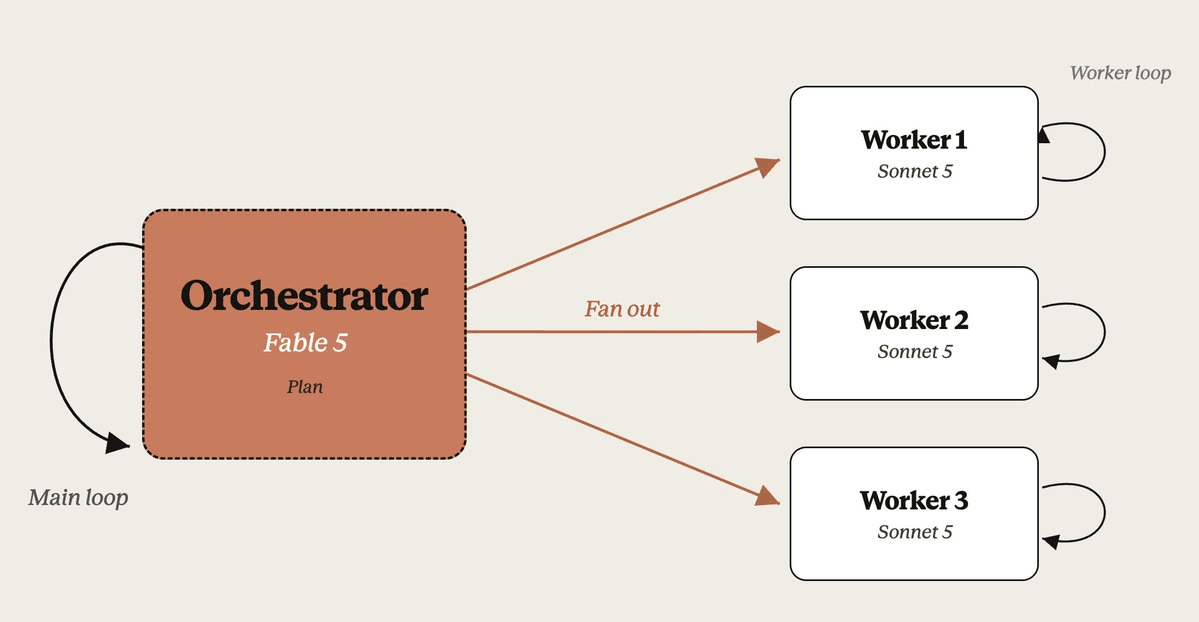
Esse padrão economiza "wall-clock time" (tempo de relógio) quando os workers podem ser executados em paralelo: no benchmark de corpus8, um episódio levou cerca de 2,3 horas com o coordenador executando o limite documentado da plataforma de 25 workers simultâneos, em comparação com 15 a 20 horas sozinho. Ele economizou dinheiro em apenas duas situações medidas. Em trabalhos que um único modelo conseguia realizar sozinho, o mesmo modelo com menor esforço foi mais barato em todas as vezes.
Quando os workers são executados em paralelo, uma instrução de tempo e um relógio de tempo decorrido podem encurtar a execução. No DRACO21, uma equipe de agentes do mesmo modelo com a instrução e o relógio terminou em 33% menos tempo, com um custo por tarefa 54% menor, e pontuou 1,5 ponto a menos. Todos os agentes dessa equipe tinham a instrução e o relógio. A Anthropic não mediu o relógio com workers de menor custo. No Claude Managed Agents, o relógio chega apenas ao coordenador, então os workers nunca o veem. A Anthropic não mediu uma equipe em que apenas o coordenador tem o relógio. O relógio do coordenador também só está atualizado nos turnos que seguem seus próprios resultados de ferramentas ou mensagens. Mostre ao modelo o tempo decorrido traz a receita para um loop de agente que você executa na Messages API.
Caso 1: seguro contra a cauda de custo em trabalho rotineiro. Um modelo de fronteira executando sozinho ocasionalmente entra em espiral em um problema rotineiro que normalmente resolveria. Como você não consegue saber com antecedência quais serão essas execuções, algumas delas dominam a fatura. Um coordenador que repassa o trabalho rotineiro a um worker de menor custo limita essa cauda, porque qualquer espiral agora acontece pelas tarifas do worker.
A Anthropic mediu isso em uma fatia deliberadamente fácil do BrowseComp4 (10 problemas que o modelo sozinho resolve de forma confiável; 50 execuções delegadas e 70 execuções solo). Um coordenador Claude Fable 5 com um worker Claude Sonnet 5 custou cerca de metade do Claude Fable 5 sozinho em média e cerca de um terço no percentil 90 ($12 em comparação com $33), e a execução individual mais cara do modelo sozinho, de $84, também estava errada:
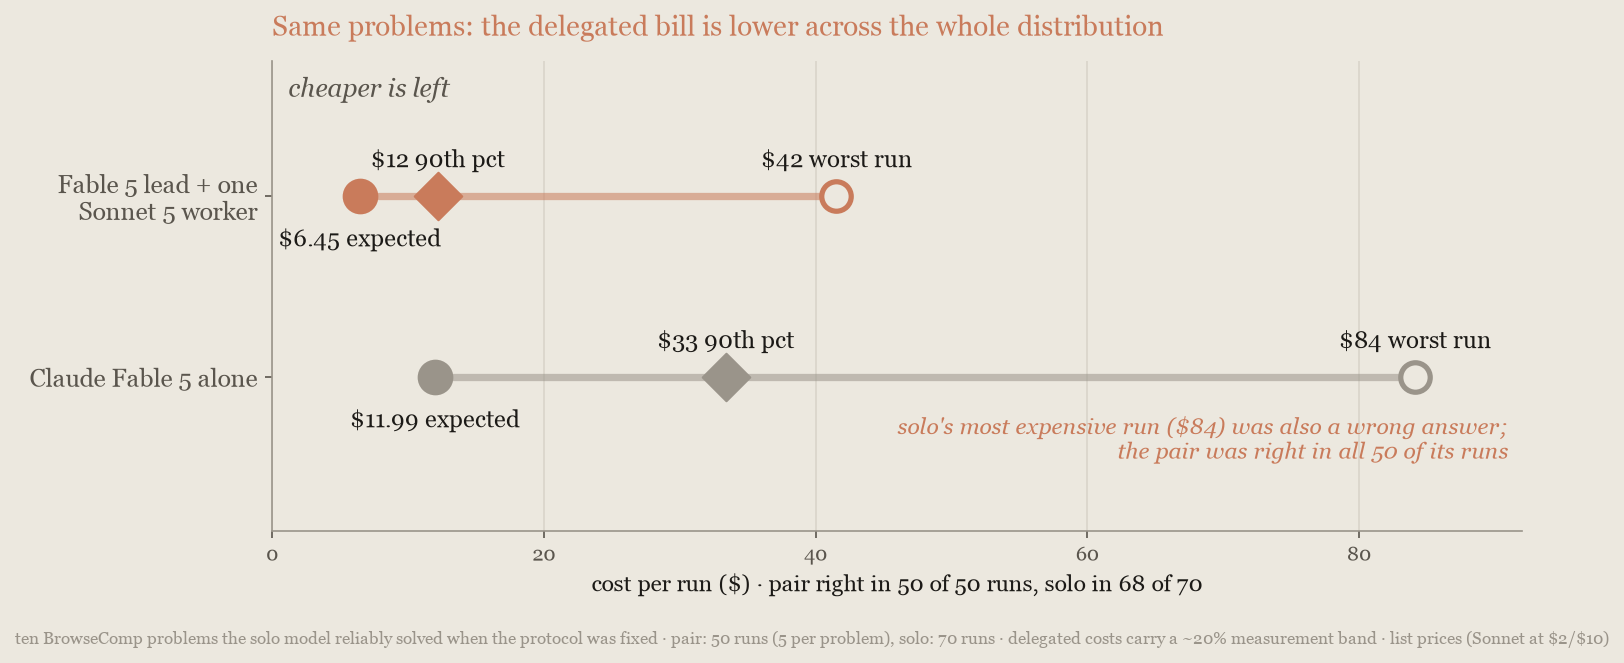
A delegação compensou na parcela rotineira e normalmente solucionável do trabalho, o oposto da intuição de que workers servem para problemas difíceis. No conjunto completo e mais difícil do BrowseComp, a economia se inverteu. Se o seu tráfego tem uma longa cauda de custo em tarefas rotineiras, este é o caso de orquestrador a ser medido primeiro.
Caso 2: trabalho maior do que uma "context window" (janela de contexto). Um modelo sozinho precisa processar uma entrada desse tamanho em série, uma janela de contexto por vez, pagando para reler seu próprio estado a cada passagem. Cada worker lê sua própria partição, em paralelo e pelas tarifas de worker. Trabalho com muita leitura que ainda cabe em uma janela de contexto é um problema de escolha de modelo, não de delegação: considerando apenas o custo de leitura, o orquestrador só sai na frente quando nenhum contexto único consegue comportar o trabalho.
A Anthropic construiu um benchmark para este caso8: um corpus de 21,6 milhões de tokens com 14 pacotes Python públicos e 130 defeitos plantados, grande demais para qualquer janela de contexto. Reduzir o esforço não ajuda, porque a fatura é a própria leitura do corpus: o Claude Fable 5.1 sozinho custou de $468 a $552 por episódio nas três configurações de esforço, e apenas sua precisão variou. A configuração com coordenador, um líder Claude Fable 5.1 sobre 25 workers Claude Sonnet 5, custou cerca de metade dessas configurações (47% a 55% menos) e pontuou de 10 a 12 pontos abaixo delas, em cerca de 2,3 horas por episódio contra 15 a 20, ao mesmo tempo em que superou com folga uma linha de base do Claude Sonnet 5 sozinho:
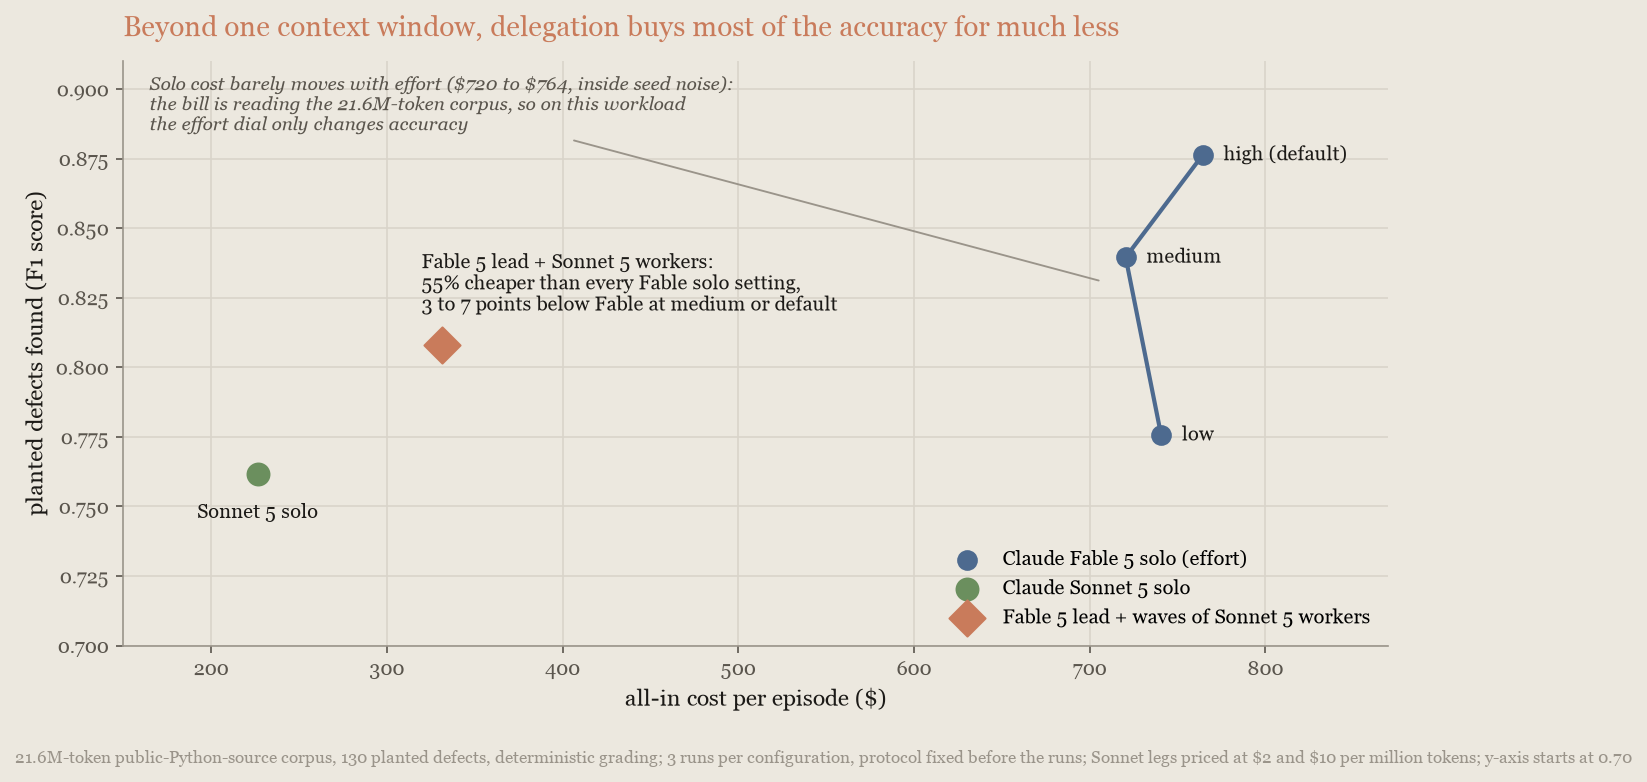
A contabilidade de tokens mostra a escala da leitura: a configuração com coordenador leu cerca de 560 milhões de tokens em cache por episódio, cerca de uma vez e meia os aproximadamente 365 milhões do modelo sozinho, quase todos pela tarifa de leitura de cache do Claude Sonnet 5, e ainda assim custou cerca de metade no total. O Fable 5.1 com esforço high ainda detém a precisão máxima, a cerca de 2,2 vezes o custo da configuração com coordenador, então a delegação aqui compra a maior parte da precisão, não toda ela.
Quando a delegação não compensa. Um orquestrador só traz algum benefício quando há trabalho em massa para repassar: muitas partes independentes, idealmente demais para uma janela de contexto. Quando o trabalho é uma única cadeia dependente, ou cabe em um único contexto, o orquestrador paga por um plano, um repasse e uma mesclagem que um único modelo obtém de graça. Em todos esses casos medidos, o modelo do coordenador sozinho com menor esforço saiu na frente.
O limite é a dificuldade da tarefa, não o benchmark: no conjunto completo e mais difícil do BrowseComp4, o Claude Fable 5 sozinho alcançou a precisão da configuração com coordenador com um custo de 22% a 30% menor. Trabalhos externos independentes relatam o mesmo padrão5. Se o trabalho é uma única cadeia, cabe em um contexto sem uma longa cauda de custo, ou se um único modelo com menor esforço já atende ao seu padrão, não construa um orquestrador.
Escolha entre as estratégias
A maioria dos casos se resume a uma pergunta: o trabalho se divide em partes independentes, ou é uma única resposta alcançada através de uma cadeia de etapas dependentes? A tabela de estratégias mapeia as duas respostas para as duas estratégias.
Se você não tem certeza, não construa nada ainda:
- Varra o esforço no seu modelo atual primeiro. É o experimento mais barato desta página, e a maioria das cargas de trabalho termina aí.
- Se a varredura mostrar uma lacuna, precifique o modelo mais forte sozinho com esforço baixo. Esse é o número que um pareamento de advisor precisa superar, e os pareamentos nesta página que o superaram foram aqueles cujo executor realmente consultou.
Os resultados multimodelo nesta página foram julgados em relação ao mesmo modelo com esforço mais baixo e em relação ao próximo modelo abaixo rodando sozinho. Essa é a comparação a executar na sua própria carga de trabalho, e o motivo pelo qual o primeiro passo é uma varredura de esforço.
Quando você adiciona um advisor, é uma definição de ferramenta em vez de uma rearquitetura.
Meça na sua própria carga de trabalho
Os números desta página refletem os preços de tabela no momento da medição e vão variar à medida que os modelos e os preços mudarem. Sua taxa de escalonamento, a clareza com que as tarefas se dividem e o comprimento da transcrição também os alteram. O método permanece o mesmo:
- Extraia algumas tarefas dos logs de produção, ponderadas como o tráfego real, e escreva verificações de resultado para cada uma: testes passam, ticket fechado, contagem de linhas correta. Registre o custo por tarefa ao lado da pontuação: precifique as cinco contagens de tokens precificadas no
usagede cada resposta pelas suas próprias tarifas (entrada sem cache, gravações de cache de 5 minutos e de 1 hora a 1,25x e 2x o preço de entrada, leituras de cache e saída), somadas em todas as requisições da tarefa (a API de Uso e Custo informa o agregado). - Estabeleça a linha de base dos níveis de modelo em todos os níveis de esforço, não apenas no padrão, e plote a pontuação em relação ao gasto. Uma configuração multimodelo precisa superar a curva inteira do modelo único.
- Se a curva mostrar uma lacuna que o esforço não consegue fechar, adicione a estratégia multimodelo adequada e execute o conjunto de testes novamente.
- Execute a vencedora em modo sombra em uma fatia do tráfego antes da migração e, depois, mantenha o conjunto de testes em execução.
O exemplo a seguir calcula o custo da etapa 1 de uma requisição com os preços de tabela do Claude Opus 5.5:
# Preços por milhão de tokens da página de preços; altere estes três para usar outro modelo.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0,05x o preço de entrada no Claude Opus 5.5; o multiplicador varia conforme o modelo
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Gravações de cache de 1 hora custam 2x o preço de entrada, as de 5 minutos 1,25x; leituras, o preço de leitura de cache.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
Em loops de agente, a maioria dos tokens de entrada deve ser de leituras de cache; se cache_read_input_tokens for pequeno em comparação com input_tokens mais cache_creation_input_tokens, verifique se o cache está ativo e se o prefixo permanece o mesmo entre as requisições. Quando a ferramenta advisor ou a compactação está habilitada, alguns tokens são informados apenas em usage.iterations e não nos totais de nível superior; portanto, some sobre usage.iterations, precificando as entradas advisor_message pelas tarifas do modelo advisor.
A tabela a seguir lista as alavancas na ordem em que devem ser testadas:
| Alavanca | Economia nestas execuções | Custo de qualidade | Latência | Onde |
|---|---|---|---|---|
| Cache de prompt | Custo reduzido por um fator de 2,7 a 5,3 em loops de agente; 83% na execução de triagem | Nenhum | Mais rápido | Armazene contexto repetido em cache |
| Duração de cache de 1 hora | Mais barata que o padrão de 5 minutos quando cerca de 1 turno em 20 segue uma pausa entre 5 minutos e uma hora e poucos intervalos passam de uma hora, exceto no Claude Fable 5.1, em que manter o cache de 5 minutos aquecido é mais barato enquanto as pausas duram minutos e a duração de 1 hora vence quando as pausas se aproximam de uma hora, e no Claude Opus 5.5, em que manter o cache de 5 minutos aquecido é mais barato quando apenas um ou dois turnos em 20 seguem uma pausa de até cerca de meia hora; sem pausas, o padrão custou 15% menos no Claude Sonnet 5 e cerca de 15% a 18% menos no Claude Opus 5.5 | Nenhum | Permanece aquecido após uma pausa | Escolha a duração do cache |
| Redução da entrada | Mais 5 pontos percentuais na execução de triagem | Nenhum | Neutra | Corte tokens de entrada e de contexto |
| Remoção de resultados de ferramentas obsoletos nos limites das tarefas | 39% na execução longa de triagem (compactação 32%); nada em loops curtos | Nenhum medido | Neutra | Corte tokens de entrada e de contexto |
| Busca de ferramentas | 45% com 500 definições de ferramentas anexadas; 20% com um servidor MCP do GitHub | Nenhum | Neutra | Corte tokens de entrada e de contexto |
| Arquivos de dados por meio de execução de código | 92% em uma tarefa de dados com 25 perguntas | Um ganho, 25 de 25 em vez de 6 de 25 | Mais rápido | Corte tokens de entrada e de contexto |
| Batch API | 50% | Nenhum | Resultados em até 24 horas | Coloque em lote o trabalho que pode esperar |
| Auditoria de prompts em relação ao modelo atual | 14% em ambas as migrações medidas | Nenhum; um ganho em uma delas | Mais rápido (menos rodadas de ferramentas) | Audite prompts em relação ao modelo atual |
| Atualizar o modelo | Opus 4.8 para Opus 5: 12 pontos a mais com 21% a mais por tarefa resolvida (Opus 5 em low supera o Opus 4.8 por cerca de 30% do custo); Sonnet 4.6 para Sonnet 5: 15% a menos por tarefa resolvida, 5 pontos a mais; Fable 5 para Fable 5.1: 43% a menos por tarefa resolvida com aproximadamente a mesma pontuação | Um ganho | Neutra | Faça upgrade do modelo |
| Reduzir o esforço | Trabalho de conhecimento: medium de 13% a 31%, low de um terço à metade; codificação longa: medium cerca de 30% e low cerca de dois terços, ambos em comparação com high | 1 a 3 pontos em trabalho de conhecimento, 2 a 8 em codificação longa | Mais rápido | Ajuste o esforço |
| Reexecutar falhas | Cerca de 40% em comparação com executar tudo em high, com a mesma taxa de aprovação ou um pouco melhor | Nenhum | Duas execuções nas tarefas que falham | Reexecute falhas com esforço maior |
| Orçamento de tarefa | 44% a 58% | 3 a 6 pontos | Mais rápido | Defina orçamentos e limites de saída |
| Pedir respostas mais curtas | 39% dos tokens de saída, 14% do custo na execução de triagem | Nenhum | Mais rápido | Defina orçamentos e limites de saída |
Aumentar max_tokens | Nenhuma por tarefa resolvida, mas mais tarefas resolvidas | Ganhos de até 22 pontos no conjunto interno; nenhum no par público | Neutra | Defina orçamentos e limites de saída |
| Advisor | Depende da diferença de capacidade e da taxa de consulta; o pareamento de codificação pontuou 1,7 ponto acima do Claude Opus 5.5 sozinho em high por cerca de 2,1 vezes o preço, aproximadamente o que mais esforço compra; com o Claude Opus 5.5, o pareamento de leitura de gráficos quase nunca consultou o advisor e pontuou 7 pontos abaixo do Opus 5.5 sozinho | Um ganho em codificação, uma perda em leitura de gráficos | Cerca de uma ou duas chamadas extras por tarefa | Estratégia advisor |
| Orquestrador | Cerca de metade em comparação com o modelo de fronteira, tanto além de uma janela de contexto quanto em caudas rotineiras (esta última medida no Claude Fable 5) | 10 a 12 pontos abaixo do modelo de fronteira | Muito mais rápido em entradas grandes | Estratégia de orquestrador |
Benchmarks referenciados
Exceto quando uma referência indicar o contrário, as medições são execuções internas da Anthropic desses benchmarks. Salvo indicação em contrário, os custos estão em USD aos preços de tabela vigentes quando cada benchmark foi executado; os números do Claude Sonnet 5 usam $2 e $10 por milhão de tokens de entrada e de saída. Gráficos rotulados como "notional USD" (USD nocional) precificam as contagens de tokens de cada requisição a essas taxas, em vez de reportar faturas.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Tarefas amplas de pesquisa na web avaliadas pela completude e precisão de uma tabela com muitas linhas; 200 problemas, 3 execuções por configuração, realizadas de 1 a 2 de agosto de 2026. O gráfico de concentração de custos é uma execução separada de 20 problemas, 3 execuções por problema, realizada de 3 a 4 de agosto de 2026, com custos calculados a partir de registros de faturamento por requisição.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Entregáveis de trabalho do conhecimento avaliados com base em rubricas de tarefas; uma execução de 210 tarefas do conjunto gold publicado, uma tentativa por tarefa, realizada em 2 de agosto de 2026. Um modelo Claude faz a avaliação, portanto as pontuações absolutas podem diferir dos resultados publicados.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Um subconjunto de 482 problemas selecionado por compatibilidade com o "harness" (ambiente de avaliação) da Anthropic; as pontuações não são comparáveis ao "leaderboard" (ranking) público. Elas também não são comparáveis aos resultados do SWE-bench Pro no "system card" (ficha técnica do sistema) do Claude Opus 5.5, que vêm de execuções com "effort" (esforço)
maxem um conjunto diferente de problemas. Os números do Claude Opus 5.5 são a média de duas execuções emlow,medium(seu padrão) ehigh, e usam uma execução emxhigh, todas realizadas de 19 a 20 de setembro de 2026, com o mesmo limite de 16.384 tokens por turno das execuções do Claude Opus 5 de agosto; o limite interrompeu 2 tentativas emxhighe nenhuma nas outras configurações. As execuções do Opus 5.5 usaram uma versão do benchmark cujos contêineres de avaliação só conseguem acessar espelhos internos de pacotes. Essa versão descarta um problema cujo teste precisa de um site ativo, e em outros três a solução de referência falha nesse ambiente, então as comparações do Opus 5.5, e os números do Claude Fable 5.1 colocados ao lado delas, usam os 478 problemas restantes. Os números do SWE-bench Pro do Claude Opus 5 em Faça upgrade do modelo e no gráfico de pareamentos com "advisor" (consultor) são a média de duas execuções em seu esforço padrão e usam uma execução emlow, todas realizadas em 4 de agosto de 2026. Os números de escalonamento vêm, tarefa por tarefa, das execuções do Opus 5.5:lowprimeiro, depoishighnas suas falhas, resolveu de 96,4% a 97,5% entre os pareamentos de execuções por cerca de $0,17;mediumprimeiro, de 96,0% a 97,1% por cerca de $0,24;highreexecutado nas próprias falhas, 96,9% por $0,31; tudo emhigh, de 94,8% a 95,8% por $0,29. Os custos neste subconjunto são precificados da forma como a organização de um cliente é medida: o prompt anterior de cada requisição como leitura de cache e seus novos tokens como gravação de cache de 5 minutos, a partir dos próprios registros de uso das execuções, conferidos com o extrato de um cliente; a medição da própria organização de avaliação, que até 10 de setembro de 2026 cobrava leituras de cache em blocos de 8.192 tokens para Claude Opus 5, Claude Fable 5, Claude Opus 4.7 e Claude Opus 4.8, gerou números de 1,4 a 1,8 vez maiores para as execuções desses modelos; para Claude Fable 5.1, Claude Sonnet 5 e Claude Sonnet 4.6, as duas diferem em no máximo cerca de 9%, e para os números do Claude Opus 5.5 elas concordam dentro de 3% em cada configuração de esforço. Os pareamentos com executor Claude Sonnet 5 no gráfico de advisor vêm da mesma série de medições neste subconjunto: o pareamento Sonnet com Opus 5 foi executado duas vezes (7 e 8 de agosto de 2026, uma execução e uma replicação exata), o pareamento de baixo esforço uma vez (8 de agosto de 2026), e o Claude Sonnet 5 sozinho duas vezes (77,4%, a linha de base para ambas as linhas do Pro). O ponto do Claude Fable 5 em Faça upgrade do modelo é a média de três execuções no esforço padrão, realizadas em 26 de agosto de 2026, precificadas da mesma forma. Os números de "task budget" (orçamento de tarefa) do Claude Fable 5.1 são uma execução por orçamento (duas em 35.000 tokens) no mesmo subconjunto no esforço padrão, realizadas em 26 de agosto de 2026, com uma execução sem orçamento no mesmo dia (92,1%, $1,10 por tarefa) como linha de base; um conjunto anterior com esforçolow, executado em 21 de agosto de 2026, obteve 88,6% sem orçamento a $0,48 por tarefa. A comparação em Compare modelos pareia essa execução única com as duas execuções agrupadas do Claude Sonnet 5 do mesmo subconjunto; no esforço padrão do Fable 5.1, o par se inverte: 41% a mais por tarefa resolvida do que o Sonnet 5. A escada de atualização é uma execução por modelo em seus padrões de lançamento (duas cada para Opus 5 e Sonnet 5, e o ponto do Fable 5 conforme descrito acima), com as execuções do Opus e do Sonnet na mesma semana, em um único harness e organização. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Os números de esforço usam um recorte de 500 problemas, de uma a três execuções por configuração, realizadas em 3 de agosto de 2026, com o ponto padrão agrupando duas execuções de 26 a 27 de julho de 2026. O gráfico de seguro de custo usa 10 problemas resolvidos de forma confiável de uma fatia de 26 problemas, 50 execuções delegadas (1 a 2 de agosto de 2026) e 70 execuções solo (50 de 2 a 3 de agosto de 2026; 20 arquivadas de 12 a 13 de julho e 1º de agosto de 2026), $6,45 em comparação com $11,99 por execução em valor esperado; os números delegados têm uma faixa de medição de cerca de 20%.
- Escalonamento de arquiteturas de agentes: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Estudo externo independente, citado apenas pela direção da conclusão sobre quando a delegação não compensa, e não por qualquer número.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. As 220 perguntas abrangem 15 domínios, cada uma combinando coleta de muitas linhas com recuperação multi-hop; medido no conjunto de linhas padrão do benchmark, 3 execuções por configuração, realizadas em 2 de agosto de 2026 (o ponto da equipe com um único worker foi executado de 26 a 27 de julho de 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Suas 132 tarefas de pesquisa em 22 domínios são avaliadas com base em rubricas binárias derivadas de especialistas; medido em um subconjunto de 50 tarefas estratificado entre todos os temas, uma tentativa por tarefa, 3 execuções por configuração, no Claude Managed Agents com as próprias ferramentas de busca e fetch na web da plataforma (26 a 27 de agosto de 2026); pontuado nas 33 tarefas que nenhuma configuração recusou, com a remoção das tentativas interrompidas pelos classificadores de segurança de produção; os custos são o que um cliente paga, as requisições da plataforma mais as taxas de busca na web. As pontuações são a média de cada modelo na base de 33 tarefas, com suas próprias tarefas interrompidas removidas; nas 21 tarefas limpas em todos os braços, o Claude Fable 5.1 mantém uma vantagem de 2 a 3 pontos sobre o Claude Fable 5 em todos os níveis de esforço, e ambos os modelos ficam estáveis entre os níveis de esforço. O gráfico de cache reprecifica as mesmas requisições com todos os tokens de entrada à taxa sem cache. O Claude Opus 4.6 avalia sob o protocolo de rubricas do benchmark; o original usa um avaliador diferente, e um avaliador da Anthropic pode favorecer o estilo da casa. O Claude Opus 5 em seu esforço padrão foi executado na mesma superfície e subconjunto, três execuções, em 28 de agosto de 2026: 68,8% nas 50 tarefas brutas, 70,8% na base de 33 tarefas e 71,1% no conjunto de 21 tarefas, a $6,71 por tarefa ($23,72 sem cache); nenhuma de suas tentativas foi interrompida pelos classificadores de segurança, sob uma implantação de salvaguardas mais recente do que aquela sob a qual os outros modelos foram executados.
- Varredura de defeitos em corpus: Interno da Anthropic, para trabalho maior que uma "context window" (janela de contexto): um corpus de 21,6 milhões de tokens de 14 fontes públicas de pacotes Python com 130 defeitos plantados e avaliação determinística; protocolo fixado antes das execuções e revisado internamente; três execuções por configuração. Todas as configurações foram executadas no Claude Managed Agents. A configuração de equipe mostrada no gráfico é uma execução em que o coordenador Claude Fable 5.1 executou toda a varredura dentro da plataforma em seu limite documentado de 25 workers Claude Sonnet 5 simultâneos, realizada em 30 de agosto de 2026; seus três episódios obtiveram F1 de 0,764, 0,825 e 0,791 após a auditoria de extras (brutos 0,751, 0,821 e 0,781) por $225, $234 e $283. A configuração solo do Claude Sonnet 5 foi executada de 3 a 4 de agosto de 2026; as configurações solo do Claude Fable 5.1 foram executadas de 24 a 25 de agosto de 2026, sob as configurações de serviço de lançamento da plataforma, três seeds por configuração de esforço, no mesmo build do corpus. A imagem do sandbox continha cópias instaladas de parte do corpus, e a etapa final de montagem do Claude Fable 5.1 fez comparações com elas em 7 de 9 episódios; reavaliar sem essas adições alterou as seeds afetadas em até 3 pontos. O F1 absoluto é específico deste build do corpus e não é comparável entre benchmarks; as comparações entre configurações comparam itens equivalentes.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. O subconjunto Diamond de 198 perguntas, duas execuções por configuração, realizadas em 7 de agosto de 2026 (Claude Opus 5.5: 19 de setembro de 2026), avaliadas por modelo com base em respostas de referência, com tokens do advisor medidos por requisição. Uma verificação de segurança da plataforma recusou duas perguntas de biologia nos executores Claude Sonnet 5, e uma delas também no Claude Opus 5; excluí-las não altera nenhuma comparação em mais de um ponto. Os 92% do Claude Opus 5.5 vêm de duas execuções que definem
fallbacks: "default"para optar pelo "server-side fallback" (fallback do lado do servidor), com qualquer tentativa que ainda terminou em recusa contada como errada. Em cada execução, a verificação de segurança sinalizou seis perguntas de biologia, o Claude Opus 5 respondeu cinco delas por meio do fallback, e a sexta ainda terminou em recusa. O custo por pergunta do Opus 5.5 inclui essas respostas de fallback. Sem contar recusas como erradas, essas execuções pontuam 93%, porque o avaliador ainda atribui uma opção de resposta a uma tentativa recusada, geralmente a correta. Com recusas contadas como erradas, as execuções do Claude Opus 5 pontuam 91% (uma recusa por execução), assim como duas execuções do Claude Opus 5.5 com fallback desativado, nas quais o Opus 5.5 recusou cinco ou seis perguntas de biologia por execução. - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. O conjunto tem 113 tarefas originais em cinco linguagens com verificadores baseados em programas. Os pareamentos são duas execuções cada, realizadas em 7 de agosto de 2026, com tokens do advisor medidos por requisição, e usaram um loop de advisor do lado do cliente em vez da ferramenta advisor, com contabilização idêntica. As varreduras de esforço de modelo único são execuções únicas precificadas a partir das contagens de tokens, uma aproximação que considera o cache. Os custos por tarefa são os totais das execuções divididos por 113.
- Benchmark interno de codificação agêntica: Interno da Anthropic: 370 tarefas de repositório avaliadas pelos próprios testes dos repositórios. Os números da API foram medidos com um limite de saída de 128.000 tokens, uma execução por configuração: Opus 5 sozinho no esforço padrão de 9 a 10 de agosto de 2026, e em
lowemediumem 10 de agosto de 2026; Claude Fable 5.1 sozinho em cinco valores de esforço definidos explicitamente em 20 de agosto de 2026 (o gráfico mostra três deles); e o pareamento de 24 a 25 de agosto de 2026. O Claude Opus 5.5 sozinho foi executado em todas as 370 tarefas, de 19 a 20 de setembro de 2026: em seu esforço padrão (medium) e emhighcom cinco tentativas por tarefa, e emlowexhighcom uma (369 de 370 pontuadas em cada, após uma falha na verificação de preparação). O executor Claude Opus 5.5 emhighcom o Claude Fable 5.1 lançado como advisor (as execuções de agosto usaram um snapshot de pré-lançamento) executou cinco tentativas por tarefa nas mesmas datas; uma tarefa falhou na verificação de preparação, então 1.845 tentativas foram pontuadas. As 279 tentativas em que o advisor foi recusado devido à carga foram reexecutadas, e as tentativas cujas consultas expiraram foram mantidas, como em agosto. As execuções de agosto tiveram cinco tentativas por tarefa para o pareamento e para o controle do Claude Opus 5, e uma para os outros pontos. O pareamento de agosto teve em média cerca de duas consultas ao advisor por tentativa; o pareamento do Claude Opus 5.5 solicitou 1,39 e recebeu 1,35. Os custos são por tentativa. Os custos são precificados da forma como a organização de um cliente é medida: o prompt anterior de cada requisição do loop do agente como leitura de cache e seus novos tokens como gravação de cache de 5 minutos, a partir dos próprios registros de uso das execuções, e cada chamada ao advisor, que não usa cache, a partir de seus tokens registrados, tudo a preços de tabela. Os números do Claude Code são execuções das mesmas tarefas de 8 a 23 de julho de 2026, uma execução por configuração, com custos aproximados. - Benchmark interno de tarefas de repositório (medição de limite): Um conjunto interno separado da Anthropic com cerca de 130 tarefas de repositório, executado em 20 de agosto de 2026 (Claude Fable 5.1) e 19 de setembro de 2026 (Claude Opus 5.5, em seu esforço padrão,
medium), com um loop de agente simples da API, uma tentativa por tarefa. As execuções do Claude Fable 5.1 são 135 tarefas por limite no esforço padrão definido explicitamente: o número de 16.384 tokens é a média de duas execuções (36,3% em ambas); os números de 64.000 e 128.000 são execuções únicas (58,5% e 60,0%). Seis problemas receberam uma recusa de segurança em todas as execuções e contam como falhas. O número de 16.384 tokens do Claude Opus 5.5 é a média de duas execuções (134 e 135 tarefas pontuadas), e seus números de 64.000 e 128.000 são execuções únicas (135 tarefas cada); duas tentativas em cada execução de 16.384 tokens terminaram em recusa de segurança e contam como falhas. Os números de limite do SWE-bench Pro são uma execução do Claude Fable 5.1 por limite no esforço padrão, realizada em 26 de agosto de 2026, em um subconjunto de 100 problemas estratificado a partir do conjunto de 482 problemas da referência 3, não comparável às suas pontuações; os dois limites pontuaram igual no padrão. As distribuições por turno do gráfico vêm das execuções do Claude Opus 5.5 e do Claude Fable 5.1 em 128.000: nenhum turno do Opus 5.5 atingiu o limite (o mais longo teve cerca de 61.000 tokens, e 0,56% de seus turnos excederam 16.384), e um turno do Fable 5.1 atingiu 128.000 (0,46% de seus turnos excederam 16.384). - Chartography: Surge AI, "Chartography," 2026. O conjunto completo publicado de 100 perguntas, medido em 6 e 9 de agosto de 2026 (Claude Opus 5 sozinho) e 20 de setembro de 2026 (Claude Opus 5.5), com a implementação da Anthropic no Claude Managed Agents (sandbox padrão na nuvem; as configurações com advisor usam o advisor do Managed Agents). O Claude Sonnet 4.6 avalia no lugar do avaliador de referência e o benchmark é executado com ferramentas, então as pontuações são comparáveis entre configurações aqui, mas não com o leaderboard publicado. Elas também não são comparáveis aos resultados do Chartography no system card do Claude Opus 5.5, que usam um avaliador diferente e são executados com esforço
max. Duas execuções por configuração (três para o Claude Opus 5.5), agrupadas; as variações entre execuções chegaram a 10 pontos. Os custos são o que um cliente que executa o agente rotineiramente paga: a primeira requisição de cada gráfico lê do cache o prompt do sistema compartilhado e as ferramentas do agente, como acontece quando outra sessão do mesmo agente foi executada nos 5 minutos anteriores. Um gráfico executado isoladamente custa cerca de $0,03 a mais com o Claude Opus 5 ou o Claude Opus 5.5 e cerca de $0,12 a mais com o Claude Fable 5.1. Os números de agosto são reprecificados dessa forma a partir dos registros de uso das execuções; a medição da própria organização de avaliação, que até 10 de setembro de 2026 cobrava as leituras de cache do Claude Opus 5 em blocos de 8.192 tokens, superestimou os custos do Claude Opus 5. Os custos excluem o tempo de sandbox, que acrescentou menos de 1% às execuções de agosto. As execuções solo do Claude Fable 5.1 são de 24 de agosto de 2026, sob as configurações de serviço de lançamento da plataforma, duas execuções por configuração; seis tentativas atingiram o limite de sessão de 15 minutos e pontuam 0, e dois gráficos por execução foram respondidos pelo Claude Opus 5 após uma recusa de segurança. O executor Claude Opus 5 de baixo esforço com um advisor Claude Fable 5.1 foi executado duas vezes em 30 de agosto de 2026, sob as mesmas configurações (63,0 e 67,0, média de 65,0, a $0,47 por gráfico; o advisor foi consultado em 88% das tarefas em cada execução, e 4 de suas 219 respostas vieram do Claude Opus 5, cada uma depois que um filtro de segurança de produção interrompeu a resposta do próprio advisor). O Claude Opus 5.5 foi executado emlow, com o fallback do lado do servidor desativado e um classificador de segurança avaliando cada chamada de ferramenta: três execuções sozinho (70, 68 e 68) e três com um advisor Claude Fable 5.1 configurado (59, 63 e 63), nas quais consultou o advisor em 1 de 300 tarefas. A comparação da taxa de consulta para os pareamentos anteriores vem da reexecução das mesmas configurações na Messages API com um conjunto de ferramentas de contêiner, de 10 a 11 de agosto de 2026. - Avaliação de auditoria de prompts de central de suporte: Um conjunto construído pela Anthropic de 44 tickets de suporte com avaliação determinística, executado no início de agosto de 2026 e relatado em 8 de agosto de 2026, sob seis prompts do sistema, cada um adicionando ao mesmo prompt limpo um padrão comum em prompts escritos para o Claude Opus 4.8 e o Claude Sonnet 4.6. Cada ponto do gráfico é um de três casos (modelo mais antigo, modelo mais novo no mesmo prompt, modelo mais novo após a auditoria), com média sobre os seis prompts e os 44 tickets. O ganho de precisão do Opus 5 tem um intervalo de confiança de 95% de 3 a 8 pontos; as diferenças de precisão do Sonnet estão dentro do ruído.
- Conjunto de perguntas sobre arquivo de dados: Um conjunto construído pela Anthropic de 25 perguntas agregadas sobre uma fatia de 1.862 linhas de um CSV público de vendas de bebidas alcoólicas, com gabarito calculado pelo pandas e avaliação por correspondência exata, executado no Claude Sonnet 5 e no Claude Opus 5 com o pensamento desativado (o braço em contexto não consegue concluir no padrão), um limite de saída de 4.000 tokens e sem "prompt caching" (cache de prompt), três execuções por configuração, realizadas em 19 de agosto de 2026. O braço de arquivo faz upload do CSV pela Files API e usa a ferramenta
code_execution_20260120. - Medição de duração do cache: O trabalho de triagem de 20 issues de Corte tokens de entrada e de contexto, executado no Claude Sonnet 5 em 23 de agosto de 2026, e no Claude Opus 5.5 em 19 e 20 de setembro de 2026, em seu esforço padrão (
medium) e emhigh, na Messages API com o mesmo harness (para o Claude Opus 5.5, uma adaptação dele que envia os mesmos corpos de requisição), as células do Claude Opus 5.5 commax_tokenselevado para 4.096, com pausas inseridas antes de uma parcela escolhida aleatoriamente dos turnos (nenhuma, 5%, 10% e todos os turnos com 6 minutos em todas as 20 issues em ambos os modelos, além de todos os turnos com 2 minutos no Claude Sonnet 5; pausas de 20 e 45 minutos em um subconjunto de 5 issues em ambos os modelos). Os números de "keep-alive" (manutenção ativa) do Claude Opus 5 abaixo vêm do mesmo job em 23 de agosto de 2026, commax_tokenselevado para 4.096, nos mesmos cronogramas, exceto as pausas de 2 e 45 minutos. Três execuções por célula, custo calculado a partir dos camposusagede cada resposta a preços de tabela (para o Claude Opus 5.5, $4 de entrada, $5 de gravação de 5 minutos, $8 de gravação de 1 hora, $0,20 de leitura de cache e $20 de saída por milhão de tokens; o Claude Sonnet 5 foi executado em uma organização interna da Anthropic cujo uso é medido da mesma forma que o de uma organização de cliente), precisão em relação aos mesmos rótulos gold. Os números do Claude Opus 5.5 nesta página cobrem ambos os níveis de esforço. O ponto de cruzamento é de cerca de 3,3% dos turnos no Claude Sonnet 5 e de 3,1% a 3,2% no Claude Opus 5.5: a mediana da parcela de equilíbrio de cada sessão, calculada pelo modelo de custo a partir dos tamanhos de contexto turno a turno dessa sessão, sobre todas as 45 sessões de vinte issues do Claude Sonnet 5 e as 36 sessões de vinte issues do Claude Opus 5.5 em cada nível de esforço (cada cronograma de pausas executado no job completo, sob as três configurações de cache, três execuções cada; as células de 5 issues não estão incluídas). Na célula de 5%, as configurações de 5 minutos e de 1 hora empataram no Claude Sonnet 5, porque as pausas desse sorteio caíram em prefixos pequenos; no Claude Opus 5.5, quase empataram. A regra de 1 em 20 da página fica acima do ponto de cruzamento medido. O tempo até o primeiro token após uma pausa não foi medido no Claude Opus 5.5. A Anthropic mediu requisições de keep-alive que renovam o cache de 5 minutos no Claude Sonnet 5 e no Claude Opus 5 em 23 de agosto de 2026, e no Claude Opus 5.5 nas execuções acima, sempre enviadas commax_tokens: 1. No Claude Sonnet 5, elas custaram 7,7% menos do que a configuração de 1 hora com 5% dos turnos pausados e aproximadamente o mesmo com 10%; no Claude Opus 5, nenhuma diferença foi mensurável em nenhuma das parcelas; em ambos, custaram mais com uma pausa de 6 minutos ou mais antes de cada turno. No Claude Opus 5.5, custaram de 8% a 18% menos do que a configuração de 1 hora com 5% e 10% dos turnos pausados (cerca de 10% a 15% depois que o ruído entre sessões é removido ao reprecificar os próprios tokens de cada sessão de keep-alive a preços de cache de 1 hora), e mais com uma pausa antes de cada turno: de 4% a 6% a mais com 6 minutos, de 9% a 10% com 20 minutos e de 56% a 58% com 45 minutos. O keep-alive economizou mais no Claude Opus 5.5 porque cada requisição de keep-alive relê o prefixo ao preço de leitura de cache: 0,05x o preço de entrada, contra 0,1x no Claude Sonnet 5 e no Claude Opus 5; as sessões do Claude Opus 5, reprecificadas aos preços do Claude Opus 5.5, mostram quase a mesma economia que o Claude Opus 5.5. Os testes de API pré-lançamento da Anthropic no Claude Opus 5.5 mostram que uma requisição commax_tokens: 0grava o cache e que a requisição seguinte o lê; se tal requisição renova uma entrada existente não foi medido no Opus 5.5. No Claude Fable 5.1, a 0,025x, o keep-alive foi mais barato mesmo com uma pausa antes de cada turno, exceto com pausas de 45 minutos (referência 19). - Participação de leitura de cache em produção: Uso agregado de primeira parte da Claude API nos 14 dias encerrados em 23 de agosto de 2026, apenas o produto de API direta, excluindo organizações internas da Anthropic, sem identificação de nenhuma organização. Uma organização-dia conta como um loop de agente quando suas requisições contêm definições de ferramentas e resultados de ferramentas, seus prompts contêm em média 9 ou mais chamadas de ferramentas anteriores, o cache foi usado e ela fez pelo menos 10 dessas requisições (a API não tem identificador de conversa, então isso substitui o comprimento da conversa): 303.003 organizações-dia em 106.487 organizações, participação mediana de leitura de cache de 84,2% de todos os tokens de entrada, quartil superior de 91,7%. Os rótulos de caso de uso (o caso de uso declarado pela organização ou, caso contrário, o classificado) cobrem 74% dessas organizações-dia e 99% de seus tokens; organizações de codificação fornecem 87% dos tokens de entrada agênticos e leem uma mediana de 88,5% (90,9% com 25 ou mais chamadas de ferramentas anteriores), quartil superior de 93,4%, com cerca de 72% das organizações-dia de codificação em 80% ou mais; agentes de suporte, pesquisa e dados leem de 84% a 85%. O decil superior de organizações-dia lê 95,9% ou mais para codificação e de 94,2% a 94,8% para agentes de suporte, pesquisa, dados e outros. A divisão por requisição com 25 ou mais chamadas de ferramentas anteriores vem de uma amostra de seis horas: codificação com 92% de leitura, 7% de gravação e menos de 1% sem cache. Organizações sem rótulo, em sua maioria pequenas, leem uma mediana de 11%. Organizações-dia sem definições de ferramentas leem uma mediana de 34,6%. Uma consulta independente na mesma janela, que reconstrói conversas de 10 ou mais requisições em vez de pontuar organizações-dia, coloca a mediana em 90,2%; a diferença é de escopo, não de dados.
- Medição do momento da compactação: A variante longa do agente de triagem de Corte tokens de entrada e de contexto, executada em 24 de agosto de 2026, no Claude Sonnet 5 com o cache de 5 minutos, custo a partir dos campos de uso a preços de tabela, cinco sessões por braço: um braço sem alterações no esforço padrão do início ao fim ($0,81 por sessão), e dois braços que começam com baixo esforço e fazem as mesmas duas alterações que quebram o cache, uma mudança para o esforço padrão e uma ferramenta adicionada, seja no meio da sessão nas requisições 12 e 17 ($0,95), seja juntas na primeira requisição após a primeira compactação ($0,75). Um quarto braço de seis sessões, executado em 25 de agosto de 2026, fez as mesmas duas alterações na requisição que disparou a primeira compactação ($0,92 por sessão): a etapa de sumarização dessa requisição gravou o contexto de 81.000 tokens no cache em vez de lê-lo, então essa etapa custou $0,21 contra $0,04 para a mesma etapa no braço de fronteira. As sessões compactaram pela primeira vez entre as requisições 21 e 25 (16 das 21 sessões na requisição 22), assim que o prompt ultrapassou o gatilho de compactação de 80.000 tokens, e duas sessões sem alterações compactaram uma segunda vez perto do fim. O total menor do braço de fronteira em relação ao braço sem alterações reflete suas requisições de baixo esforço antes da mudança e essas segundas compactações, e não o cache: os custos de regravação dos dois braços diferem em menos de um centavo. O braço de meio de sessão pagou $0,23 por sessão em regravações de cache; a diferença entre os braços de meio de sessão e de fronteira foi de $0,20, com um intervalo de confiança de 95% de $0,11 a $0,29. Uma sessão do braço de meio de sessão saiu barata ($0,82) depois que seu modelo chamou incorretamente a ferramenta de busca após a compactação e obteve resultados vazios; ela está incluída, e sem ela o braço tem média de $0,98. A precisão teve média de 14,2 de 20 rótulos em cada braço de 24 de agosto e 14,7 no braço de 25 de agosto; as leituras de cache foram 91% dos tokens de prompt sem alterações, 85% no meio da sessão, 91% na fronteira e 86% com as alterações na requisição de disparo.
- Medição de duração do cache no Claude Fable 5.1: O mesmo trabalho de triagem de 20 issues e o mesmo harness da referência 16, executados em 23 e 26 de agosto de 2026, no snapshot de lançamento do Claude Fable 5.1 a seus preços de lançamento ($10 de entrada, $12,50 de gravação de 5 minutos, $20 de gravação de 1 hora, $0,25 de leitura de cache, $50 de saída por milhão de tokens), três configurações por cronograma: o cache de 5 minutos, o cache de 1 hora e o cache de 5 minutos mantido aquecido por uma requisição com
max_tokens: 0no prefixo inalterado a cada 4 minutos, contados a partir do início da requisição anterior (as execuções de 23 de agosto enviaram requisições de keep-alive commax_tokens: 1; nas células de 26 de agosto relatadas aqui, cada requisição de keep-alive renovou o cache e não cobrou saída). Cronogramas: sem pausas, 10% dos turnos e todos os turnos com 6 minutos em todas as 20 issues, e pausas de 45 minutos no subconjunto de 5 issues; três execuções por célula (seis para a célula de keep-alive de 26 de agosto com pausas de 45 minutos), custo calculado a partir dos camposusagede cada resposta a preços de tabela, precisão em relação aos mesmos rótulos gold (de 12 a 17 rótulos exatos de 20). Médias por sessão em 26 de agosto para as configurações de 5 minutos, 1 hora e keep-alive: sem pausas $2,42, $3,09, $2,29; 10% pausados $4,50, $2,96, $2,36; todos os turnos $22,89, $3,01, $2,62; as células de 23 de agosto concordam dentro de 6%. Os números de 45 minutos ($1,68, $0,59 e $0,71 por sessão de 5 issues) são de uma reexecução limpa em 26 de agosto, depois que um incidente de cobrança de cache comprometeu as primeiras células daquele dia; as execuções de 23 de agosto deram $1,67, $0,58 e $0,70. O ponto de cruzamento entre as configurações de 5 minutos e de 1 hora é de 3,1% dos turnos, a mesma medida da referência 16. - Terminal-Bench 3: as 74 tarefas do benchmark público de agentes de terminal, executadas no Claude Managed Agents com duas ferramentas personalizadas, um shell e um editor de arquivos que o harness de avaliação executa no próprio contêiner de cada tarefa, no lugar das ferramentas integradas da plataforma, e de resto com as configurações padrão da plataforma para contas externas, duas execuções por modelo com esforço
high, de 27 a 28 de agosto de 2026. Essas execuções usaram a versão 3.0 do Terminal-Bench, e suas pontuações não são comparáveis com o leaderboard público do Terminal-Bench nem com os resultados do Terminal-Bench 4.0 no system card do Claude Opus 5.5, que vêm de execuções no Claude Code com esforçomax. Os limites de tempo de cada tarefa são 2,5 vezes os do próprio benchmark, o que dá ao agente entre 75 minutos e 20 horas por tarefa (5 horas para a tarefa mediana), e cada tarefa recebe três vezes a memória que especifica, de 6 GiB a 96 GiB, com memória extra para as 12 tarefas que executam serviços auxiliares. O agente não tinha acesso geral à internet: seus contêineres podiam acessar um espelho interno de pacotes, uma lista curta de sites de download, incluindo o GitHub e o Python Package Index, e alguns sites específicos de certas tarefas, e oito das tarefas não tinham nenhum acesso à rede. As pontuações são taxas brutas de aprovação sobre as 148 tentativas por modelo; execuções únicas variam de 5 a 11 pontos. Os custos são o que um cliente pagaria a preços de tabela, reprecificados requisição por requisição a partir dos registros de uso das execuções com o tempo de vida de cache de 5 minutos. O Claude Opus 4.7 encerrou 11 de suas 148 tentativas em seu limite de saída. - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. Suas 100 tarefas de pesquisa em 10 domínios são avaliadas com base em rubricas escritas por especialistas, e a pontuação é a pontuação normalizada do benchmark. Todas as configurações foram executadas na Claude API com o Claude Fable 5.1, o pensamento adaptativo padrão, os classificadores de segurança de produção ativados e
max_tokensem 128.000: um único agente com esforçohighe com esforçomedium, o agente único emhighcom a instrução e o relógio, e uma equipe emhighcom e sem eles. A equipe é um agente líder que inicia agentes auxiliares do mesmo modelo por meio de uma ferramenta, sem limite para o seu número. No DRACO, o líder iniciou uma mediana de 4 auxiliares por tentativa. Cada configuração fez três tentativas em cada tarefa, executadas de 8 a 10 de setembro de 2026. Uma tentativa que atingiu o limite de quatro horas foi executada novamente, e a nova tentativa é a que conta. As únicas tentativas deixadas de fora são todas as 3 tentativas em uma tarefa para o agente único com esforçomedium, então essa configuração cobre 99 tarefas. Essa tarefa expirou em todas as tentativas, na execução original e na reexecução. Pontuar essas 3 tentativas como 0, como faria a própria pontuação do benchmark, afeta apenas as duas comparações com esforçomedium. A mudança de pontuação com esforçomediumem relação ahighpassa de 0,7 para 1,7 ponto a menos, e a mudança de pontuação com ambas as alterações em relação ao esforçomediumpassa de 1,2 para 0,2 ponto a menos. Os agentes usaram uma ferramenta de busca e uma ferramenta de fetch que o harness de avaliação hospeda sobre um índice da web fixado. Essas ferramentas determinam parte do tempo, e as suas serão executadas em uma velocidade diferente, então a página apresenta o tempo como uma razão entre configurações, não em minutos. O tempo é o tempo de relógio por tarefa, da primeira à última requisição em qualquer agente, menos o tempo estimado gasto esperando para repetir requisições após erros de "rate limit" (limite de taxa) ou de sobrecarga. Esses erros vieram dos limites compartilhados da conta de teste. Todas as configurações de um conjunto começaram juntas. As mais lentas terminaram horas depois, então parte do seu tempo decorreu sob uma carga diferente. O custo de cada tarefa são suas requisições precificadas a preços de tabela públicos, com o cache de prompt cobrado como seria para um cliente que define um ponto de interrupção de cache no final de cada requisição e usa o tempo de vida de cache de 5 minutos, apenas para tokens do modelo. As ferramentas do harness não acrescentam cobranças. As mudanças de pontuação são diferenças pareadas entre tarefas, com intervalos bootstrap de 95%. Uma mudança conta como dentro da margem quando seu intervalo fica dentro de 1,5 ponto no DRACO e de 2,5 pontos no HLE. A Anthropic definiu essas margens antes das execuções. O Claude Opus 5 avalia as respostas. Em comparação com o avaliador próprio de cada conjunto, o Opus 5 pontuou de 1,9 a 2,4 pontos a mais no DRACO, de 2,2 a 2,9 pontos a menos no HLE (o Opus 5 avaliou 495 das 500 perguntas, e o avaliador do benchmark avaliou todas as 500) e de 1,3 a 2,0 pontos a menos no conjunto de física, cujo avaliador próprio também usa as soluções de referência de especialistas, em todas as configurações. Os dois avaliadores concordam quanto à direção de todas as mudanças. - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. Perguntas escritas por especialistas com respostas exatas, avaliadas com base nas respostas de referência. Medido nas primeiras 500 perguntas, com as próprias fontes do benchmark bloqueadas na busca, e com a mesma configuração da referência 21. Cada configuração fez três tentativas em cada pergunta, executadas de 8 a 10 de setembro de 2026. O Claude Opus 5 compara cada resposta com a resposta de referência, com o pensamento adaptativo ativado, como é por padrão. O avaliador avaliou 495 das 500 perguntas em todas as configurações, e as pontuações cobrem essas 495. Para as outras 5, a requisição de avaliação ultrapassou o limite de 1M de tokens do avaliador. Uma tentativa que atingiu o limite de quatro horas foi executada novamente, e a nova tentativa é a que conta, então todas as configurações têm todas as 1.500 tentativas. Pontuar as 5 perguntas não avaliadas como 0, como faria a própria pontuação do benchmark, não altera nenhuma conclusão.
- Conjunto de física: Um conjunto interno de 70 problemas de física em nível de pesquisa, adaptado do benchmark público CritPt: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. Revisores especialistas corrigiram os enunciados dos problemas. O Claude Opus 5 avalia cada resposta com base em soluções de referência de especialistas que não são públicas, então as pontuações não podem ser comparadas com resultados publicados. A pontuação é a nota média sobre as tentativas de um problema, com média entre os problemas. Medido em todos os 70 problemas, quatro tentativas por problema, executadas de 8 a 9 de setembro de 2026. Cada agente tinha uma ferramenta Python, um shell e um editor de arquivos em um contêiner sandbox sem acesso à rede, e nenhuma ferramenta de busca ou fetch. De resto, a configuração é a da referência 21. Nenhuma margem de pontuação foi definida para o conjunto de física antes das execuções, então a página apresenta suas mudanças de pontuação com seus intervalos de 95% e não as descreve como dentro de uma margem.
Próximos passos
O maior ganho gratuito desta página: configuração, tempos de vida e diagnósticos.
Troque inteligência por latência e custo dentro de um único modelo.
Avalie capacidade, velocidade e custo em toda a família de modelos Claude.
Dê aos loops de agente uma contagem regressiva de tokens contra a qual eles se autorregulam.
Coloque um limite rígido em dólares em uma sessão do Managed Agents.
Veja os preços atuais por token para cada modelo Claude.
Aplique essas alavancas uma de cada vez a um agente funcional em um notebook executável, com custo por tarefa após cada etapa.
Assista a um passo a passo dos padrões de advisor e orquestrador.
Was this page helpful?