优化成本与智能
在 Claude Platform 上平衡成本与智能,附有提示缓存、effort、模型选择、预算以及多模型策略的实测结果。
当工作负载从原型进入生产环境时,成本就成为首要的设计约束。能力最强的模型在大规模使用时可能过于昂贵,而成本最低的模型可能在质量上有所欠缺。要管理好成本,就需要了解每个成本杠杆如何影响输出质量,因为有些杠杆会牺牲质量,而有些则不会。Claude Platform 让您可以直接控制这种权衡。您可以为每个请求选择模型、"effort"(努力程度)级别和架构,从而将工作负载放置在"cost-to-intelligence frontier"(成本-智能前沿)上几乎任何位置。
成本与智能通常被描绘为一条前沿曲线,获得其中一方就要以另一方为代价。本页的第一组杠杆在不影响质量的情况下削减成本,从而将工作负载推向该前沿;只有第二组杠杆是沿着前沿移动:
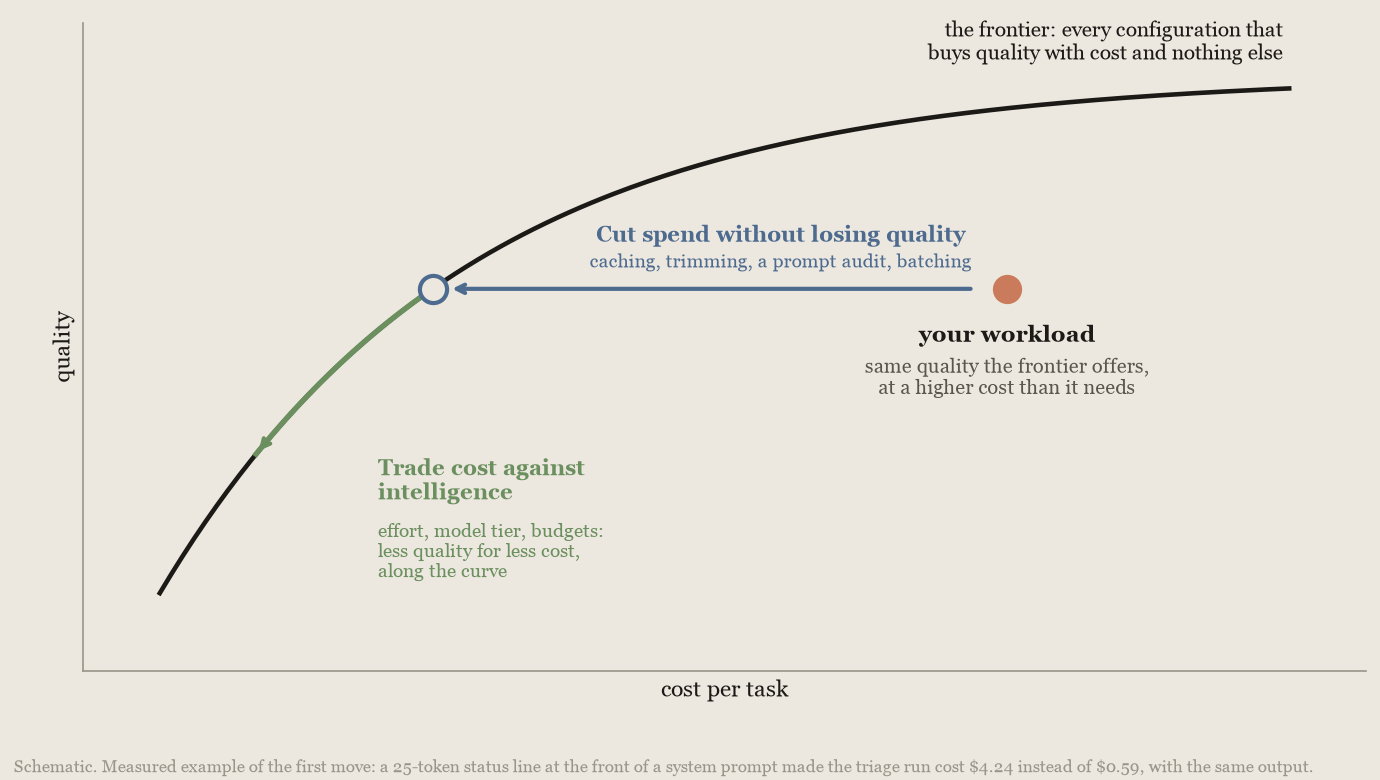
这些杠杆分为两类:
- 免费收益在不影响质量的情况下削减支出:"prompt caching"(提示缓存)、"token hygiene"(令牌精简)、针对您正在运行的模型进行提示审计、对可等待最多 24 小时的工作使用享受 50% 折扣的批处理,以及作为兜底的工作区支出限额。
- 权衡以成本换取智能:模型选择、努力程度、输出上限和任务预算、已用时间时钟,以及多模型架构。
每个杠杆都附有实测结果以及何时值得使用的规则。在 Anthropic 的测量中,提示缓存是遥遥领先的最大杠杆:在本指南的基准测试中,它将"agent loop"(智能体循环)的成本降低到原来的 1/2.7 至 1/5.3,并将一个小型分诊智能体的账单削减了 83%,加上输入精简后削减了 88%。多模型杠杆的适用范围较窄;第二个模型在两种形态下带来了回报:"advisor"(顾问)和"orchestrator"(编排器)。
从这里开始
将您的情况与表格中的某一行对应。
| 您的情况 | 应采取的措施 | 参见 |
|---|---|---|
| 任何工作负载、任何模型 | 开启提示缓存并精简不需要的令牌;两者都是免费的 | 缓存重复的上下文 · 精简令牌 |
| 有人在轮次之间等待 | 当大约每 20 个轮次中有 1 个发生在 5 分钟到 1 小时之间的暂停之后,且很少有间隔超过 1 小时时,使用 1 小时缓存时长。在 Claude Fable 5.1 上,当暂停持续数分钟时保持 5 分钟缓存预热,当暂停接近 1 小时时购买 1 小时时长。在 Claude Opus 5.5 上,当每 20 个轮次中只有一两个发生在最长约半小时的暂停之后时,改为保持 5 分钟缓存预热 | 选择缓存时长 |
| 成本过高;质量尚可 | 在当前模型上逐步调低努力程度 | 调整努力程度 |
| 您未使用最新模型 | 升级;在 Anthropic 的测量中,每个较新的模型解决的任务至少与前一个模型一样多,且每个已解决任务的成本通常更低 | 升级模型 |
| 您正在选择或切换模型 | 按每个已完成任务的成本进行比较,而不是按每个令牌 | 比较模型 |
| 质量不够好 | 如果您降低了努力程度,请恢复它;否则尝试以 low 努力程度使用更高一级的模型 | 调整努力程度 · 比较模型 |
尝试以 stop_reason: max_tokens 结束 | 提高 max_tokens;在默认努力程度下测量的 14,000 个轮次中,64,000 覆盖了除 2 个之外的所有轮次,而 128,000 不会增加每个已解决任务的成本 | 设置预算 |
| 您可以检查输出(测试、验证器) | 以低努力程度运行所有内容,并以 high 重新运行失败的任务;在所测量的编码基准测试中,通过率保持不变,成本约为一半 | 重新运行失败任务 |
| 智能体循环中有少数运行成本非常高 | 设置任务预算(beta;请查看支持表了解适用的模型)、Claude Managed Agents 会话预算和工作区支出限额 | 设置预算 |
| 您希望智能体运行更快完成 | 告诉模型时间很重要,并向其显示已用时间;在 DRACO、HLE 和一个内部物理数据集上,运行时间减少了 33% 到 69%,每个任务的成本降低了 28% 到 54%,分数最多降低 1.9 分 | 向模型显示已用时间 |
| 成本较低的模型仅在困难决策上停滞 | 添加一个前沿顾问。只有当顾问的定价远高于执行器且确实被咨询时,它才会带来回报,因此请先单独为顾问模型在低努力程度下定价,并测量咨询率 | 顾问策略 |
| 工作超出一个上下文窗口 | 将分区委派给成本更低的工作模型 | 编排器策略 |
这些结果来自 Anthropic 内部测量(引用的基准测试),仅具方向性参考意义,并非保证,因此请使用四步方法在您自己的工作负载上进行测量。
在不损失质量的情况下削减支出
提示缓存、令牌精简、批处理以及针对当前模型的提示审计都能降低您的支出而不降低输出质量。有两点需要注意:批处理以延迟换取折扣,而上下文编辑这一令牌精简杠杆在本节测量的运行中花费超过了它节省的。
缓存重复的上下文
为什么缓存排在第一位
在使用任何其他杠杆之前先开启提示缓存,因为智能体任务的每个轮次都会重新发送整个不断增长的对话:"system prompt"(系统提示)、工具定义以及之前的每个轮次。一个 40 轮的任务会将其第一轮发送 40 次,因此任务成本大致随轮次数的平方增长。缓存不会阻止重新发送,但每次重新发送的成本约为十分之一且处理更快:前缀按缓存读取费率计费,即输入价格的十分之一,每个轮次仅对新增内容支付 1.25 倍的缓存写入费率。
良好状态是什么样的。 在一整天的真实流量中,智能体循环从缓存中读取的输入中位数为 84%,而排名前 10% 的 harness(无论是否为编码类)读取 94% 或更多17。在任务深处,一个构建良好的循环对不到 1% 的输入支付全价。低于约 80% 时,请查找是什么破坏了缓存(参见什么会破坏缓存)。
在 Anthropic 的实测运行中,缓存读取通常是任务成本中最大的单一组成部分,这使得缓存比大多数模型选择决策更有价值。Anthropic 对 DeepResearch Bench II7 的运行分别在有缓存和无缓存的情况下进行了定价:
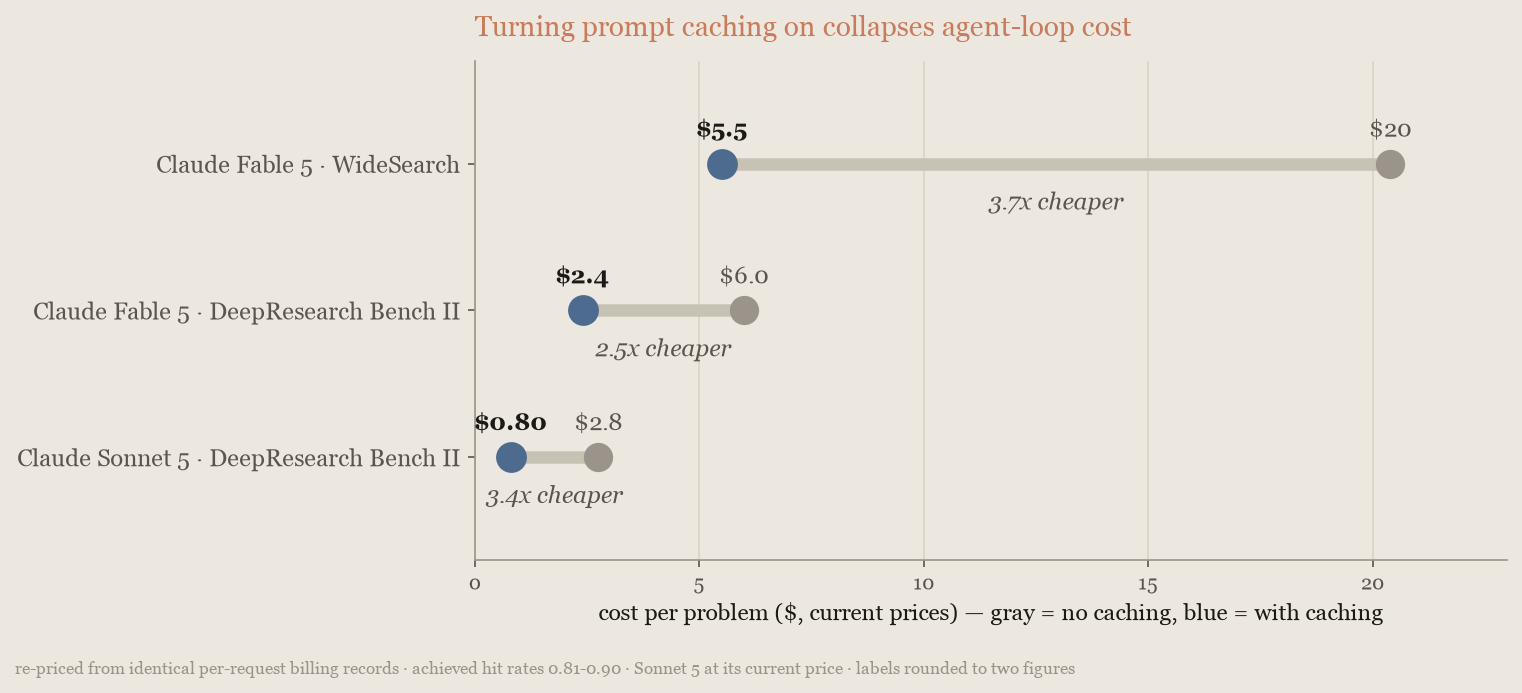
缓存的默认生命周期为 5 分钟,而智能体循环的轮次间隔只有几秒,因此折扣适用于每个轮次的大多数令牌。缓存图表中的运行从缓存中读取了 79% 到 90% 的输入令牌。节省量随回合深度而变化,因为较短的循环重新读取的内容较少,但在所测量的每个模型和基准上,缓存始终是最大的单一杠杆。
选择缓存时长
如果您的循环在轮次之间需要等待人员,请使用 1 小时缓存时长。它的写入成本更高(输入价格的 2 倍,而非 1.25 倍)。任一时长的缓存未命中都会按写入价格而非读取价格对整个前缀计费,因此一旦每个会话中有几个轮次发生在 5 分钟到 1 小时之间的暂停之后,较长的时长就会带来回报。
要做出决定,请统计对话中连续请求之间的间隔:
- 每 20 个间隔中有超过约 1 个落在 5 分钟到 1 小时之间,且超过 1 小时的间隔很少:使用 1 小时时长。在 Claude Opus 5.5 上,当每 20 个间隔中只有 1 或 2 个落在该范围内,且没有一个超过约半小时时,改为保持 5 分钟缓存预热,使用下文所述的保活请求。
- 轮次间隔仅几秒:保持 5 分钟默认值。在没有暂停的情况下,它在 Claude Sonnet 5 上比 1 小时设置便宜 15%,在 Claude Opus 5.5 上便宜约 15% 到 18%。
- 超过 1 小时的间隔很常见:保持默认值。超过 1 小时的间隔会使两种时长都过期,而 1 小时设置随后会以更高的写入价格重新写入前缀,因此在每个这样的间隔上都会亏损。在您超过 5 分钟的暂停中,如果约 60% 或更多也超过 1 小时,请保持默认值;只有当至少约 40% 的长暂停在 1 小时内结束时,1 小时时长才划算。
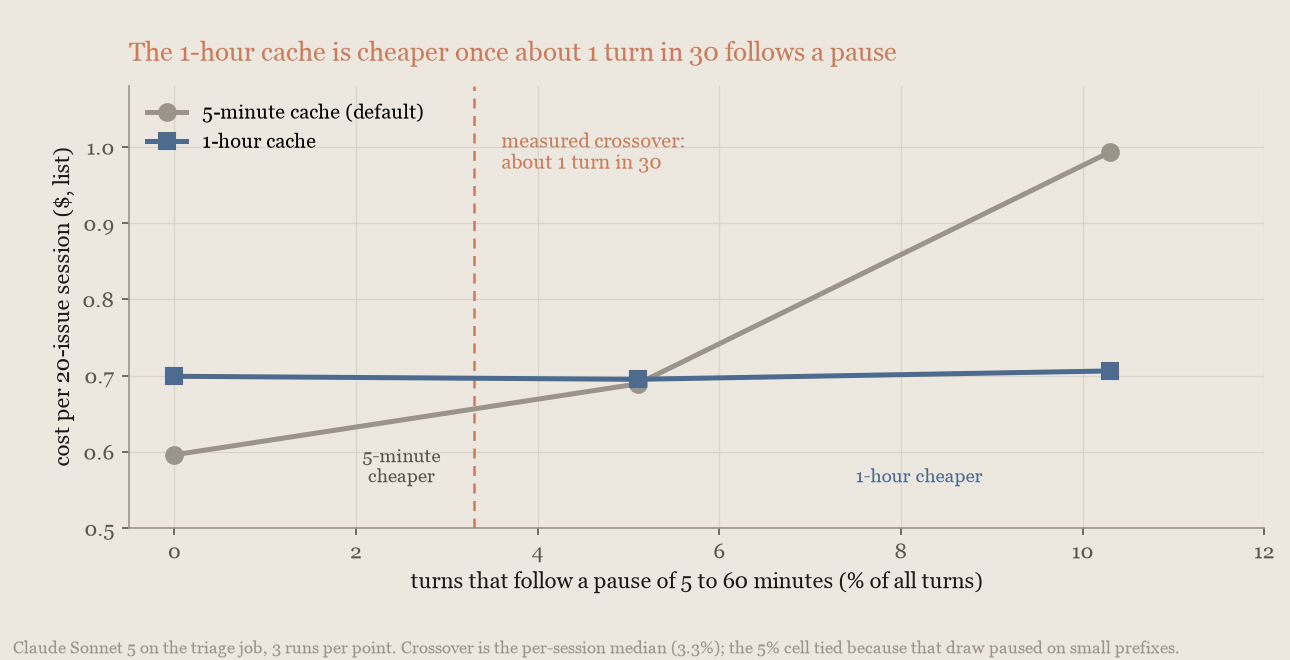
Anthropic 测量了精简输入和上下文令牌中的分诊任务,在某些轮次之前插入暂停以模拟人员的延迟16。在 Claude Sonnet 5 和 Claude Opus 5.5 上,一旦约每 30 个轮次中有 1 个发生在暂停之后,1 小时缓存就成为更便宜的设置,因此"每 20 个中有 1 个"的规则留有余量;而越过交叉点后差距会迅速扩大,因为在 5 分钟设置下,每个暂停后的轮次都会重新写入整个前缀。所有当前模型都使用相同的缓存写入倍数,除 Claude Fable 5.1、Claude Mythos 5.1 和 Claude Opus 5.5 之外的所有模型也使用相同的读取价格,因此其他模型上的交叉点处于相同范围内;Fable 5.1 的情况将在下文介绍。在每个单元中,准确率都保持在运行间噪声范围内。在 1 小时设置下,暂停后的轮次保持了其热缓存延迟(在 Claude Sonnet 5 和 Claude Opus 5 上测量,未在 Claude Opus 5.5 上测量)。下图绘制了 Claude Sonnet 5 上每个会话的成本与暂停轮次占比的关系:
Anthropic 还测量了保持 5 分钟缓存预热的额外请求。在 Claude Sonnet 5 上,当每 20 个轮次中有 1 个发生在暂停之后时,它们的成本比 1 小时时长低约 8%,但在每 20 个中有 2 个时成本大致相同;在上一代 Opus 模型 Claude Opus 5 上,它们没有带来可测量的节省。当每个轮次之前都有 6 分钟或更长的暂停时,它们在两个模型上的成本都更高。由于 Claude Sonnet 5 的节省在每 20 个轮次中有 2 个时就消失了,因此在 Claude Sonnet 5 和 Claude Opus 5 上请改用 1 小时时长。
在 Claude Fable 5.1 上,最便宜的设置有所不同。其缓存读取成本为输入价格的 0.025 倍(每百万令牌 $0.25),而其缓存写入保持标准倍数,因此重新读取前缀的保活请求很便宜,而 1 小时时长的写入溢价才是更大的开销。Anthropic 使用相同的三种设置在 Claude Fable 5.1 上测量了分诊任务19。只要暂停持续数分钟,保持 5 分钟缓存预热的每会话成本就比 1 小时缓存低 13% 到 20%;只有当暂停接近 45 分钟时,1 小时缓存才胜出,每个会话约便宜 12 美分。在 Claude Fable 5.1 上,当人员离开数分钟时保持 5 分钟缓存预热,当暂停接近 1 小时时购买 1 小时时长:
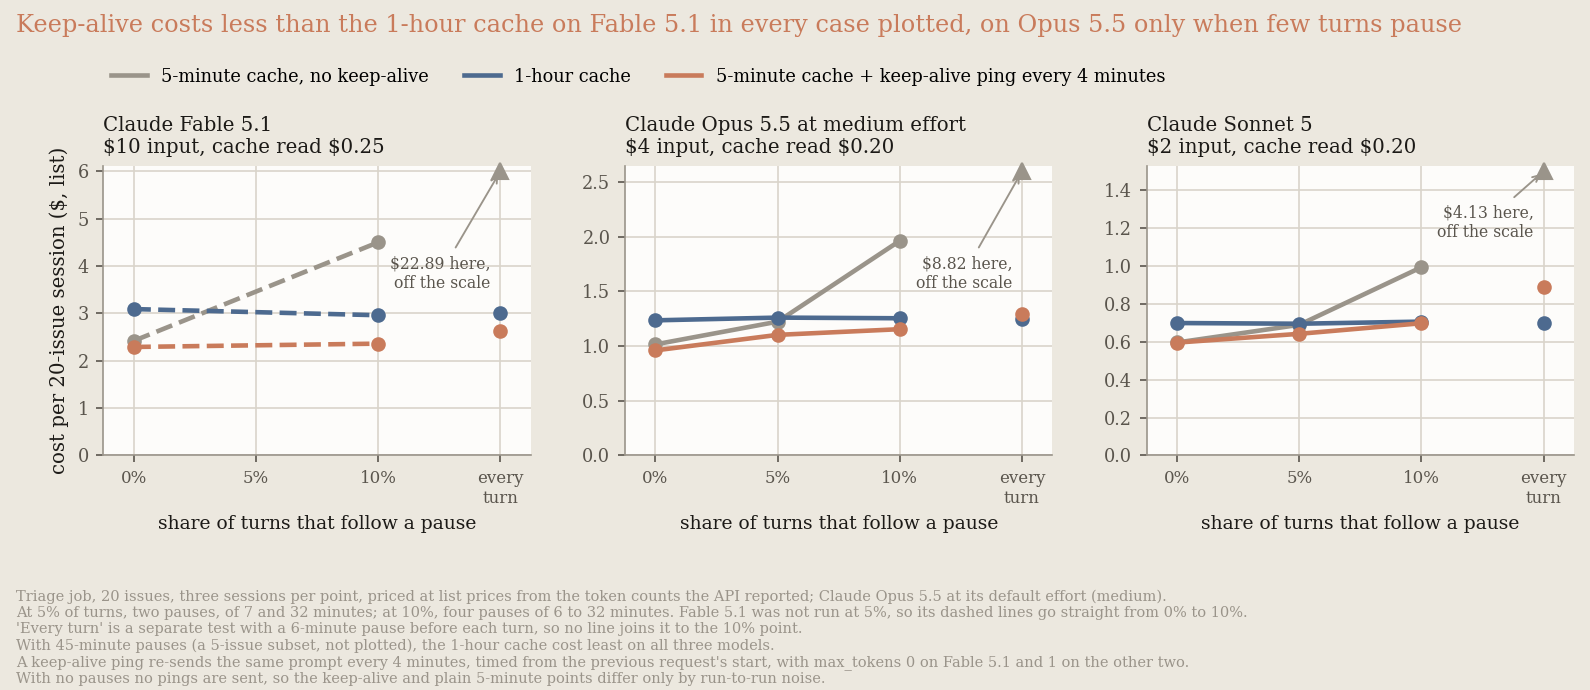
在缓存读取成本为输入价格 0.05 倍的 Claude Opus 5.5 上,当 5% 或 10% 的轮次发生在 6 到 32 分钟的暂停之后时,保活请求的成本比 1 小时时长低 8% 到 13%(在默认努力程度 medium 下;在 high 下低 10% 到 18%),但当每个轮次之前都有暂停时成本更高:6 分钟暂停时高约 4% 到 6%,45 分钟暂停时高出 50% 以上。因此在 Claude Opus 5.5 上,当每 20 个轮次中只有一两个发生在最长约半小时的暂停之后时,保持 5 分钟缓存预热,否则请遵循本节开头的列表。这些测量使用 max_tokens: 1 发送保活请求。对于下文所述的 max_tokens: 0 请求,Anthropic 在 Claude Opus 5.5 上的发布前 API 测试表明,它会写入缓存,且下一个请求会读取该缓存;它是否会刷新现有条目尚未在 Opus 5.5 上测量。
要保持缓存预热,请在上一个请求开始后的 4 分钟内再次发送上一个请求,并将 max_tokens 设置为 0,此后每 4 分钟发送一次;如果设置了 stream,则将其去掉。从请求开始时计时,而不是从响应结束时计时:缓存的 5 分钟生命周期从写入或刷新该条目的请求开始时计算,因此响应生成所花费的时间也计入其中。这就是预热请求:它刷新缓存的生命周期,不生成任何内容,并且只按缓存读取计费。不要更改前缀的任何一个字节,也不要使用 max_tokens: 1,因为它会无故采样一个令牌。除了请求体之外,还要重新发送请求头:如果您的请求带有 anthropic-beta 请求头(例如用于任务预算),保活请求也需要相同的请求头,否则重放请求体中受 beta 限制的字段会被拒绝。当请求设置了 thinking.type: "enabled"(Claude Fable 5.1 上默认的自适应思考没有问题)、结构化输出或强制工具选择时,max_tokens: 0 请求会被拒绝(其限制);对于这些工作负载,请改为购买 1 小时时长。当 max_tokens: 0 请求带有顶层 compaction 参数时也会被拒绝,因此不要将来自按需压缩的压缩请求作为保活请求重新发送。
# 在上一个请求开始后的 4 分钟内(生成所花费的时间
# 会计入缓存的生命周期),重新发送该请求,并将 max_tokens 设为
# 0,同时去掉 stream(max_tokens: 0 的请求无法进行流式传输)。发送与
# 原始请求相同的请求头,包括任何 anthropic-beta 请求头。
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
开启缓存
设置几乎不费功夫。自动缓存会为您放置断点;否则,Claude Code 附带的 Claude API skill 可以通过一个提示为现有集成添加缓存。以下摘录展示了该 skill 将其添加到产生这些测量结果的 harness 中:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...这些断点放置遵循显式缓存断点中的标准模式。
什么会破坏缓存
有几种情况可能会在任务期间破坏您的缓存。任何随请求变化的内容(例如时间戳或队列位置)如果放在稳定前缀之前,都会使每个请求变成完整的缓存写入:在精简输入和上下文令牌中的分诊运行中,系统提示开头一行 25 个令牌的状态行使每次运行的成本从 $0.59 变为 $4.24,比关闭缓存运行还要高。请将每个请求特有的文本放在最新的用户轮次中。
缓存是按顺序(工具、系统提示、消息)对请求进行的字节级精确前缀匹配,因此任何位置的更改都会使其之后的所有内容失效。在请求之间更改 effort 或思考配置会使从该点开始的缓存失效,在某些模型上还会使其之前的工具和系统提示失效;对系统提示的任何编辑都会使从该点开始的缓存失效;设置或更改输出格式会使整个对话的缓存失效;添加、删除或重新排序工具定义会使全部缓存失效。提示缓存页面列出了这些情况,但输出格式除外,该情况由结构化输出介绍。在最新的模型上,请使用对话中途系统消息(即追加到 messages 中的 {"role": "system"} 消息)来更改指令,而不是编辑顶层 system 字段:这样缓存的前缀会保持完整。请查看该页面了解哪些模型支持此功能。在支持的模型上,按消息更改努力程度同样会保持缓存前缀完整。在 Claude Fable 5.1 和 Claude Mythos 5.1 上风险最高,因为缓存被破坏时会以输入价格的 1.25 倍重新写入前缀,而不是以 0.025 倍读取。对于 100,000 令牌的前缀,在这些模型上一个被破坏的轮次成本为 $1.25 而非 $0.03,是读取成本的 50 倍;在 Claude Opus 5.5 上成本为 $0.50 而非 $0.02,是 25 倍;在其他当前模型上是 12.5 倍。
Anthropic 在分诊智能体的长会话上测量了这一点18。在会话中途进行的一次努力程度更改和一次工具添加分别重写了 39,000 和 60,000 个缓存令牌,这些会话的成本为每会话 $0.95。同样的两项更改如果在压缩后的第一个请求上进行,成本为 $0.75;如果在触发压缩的请求上进行,成本为 $0.92,因为压缩的摘要过程随后会以缓存写入价格重新处理 81,000 令牌的上下文:该摘要过程的成本为 $0.21,而当相同的更改在一个请求之后进行时仅为 $0.04,且每组的准确率都在运行间噪声范围内:
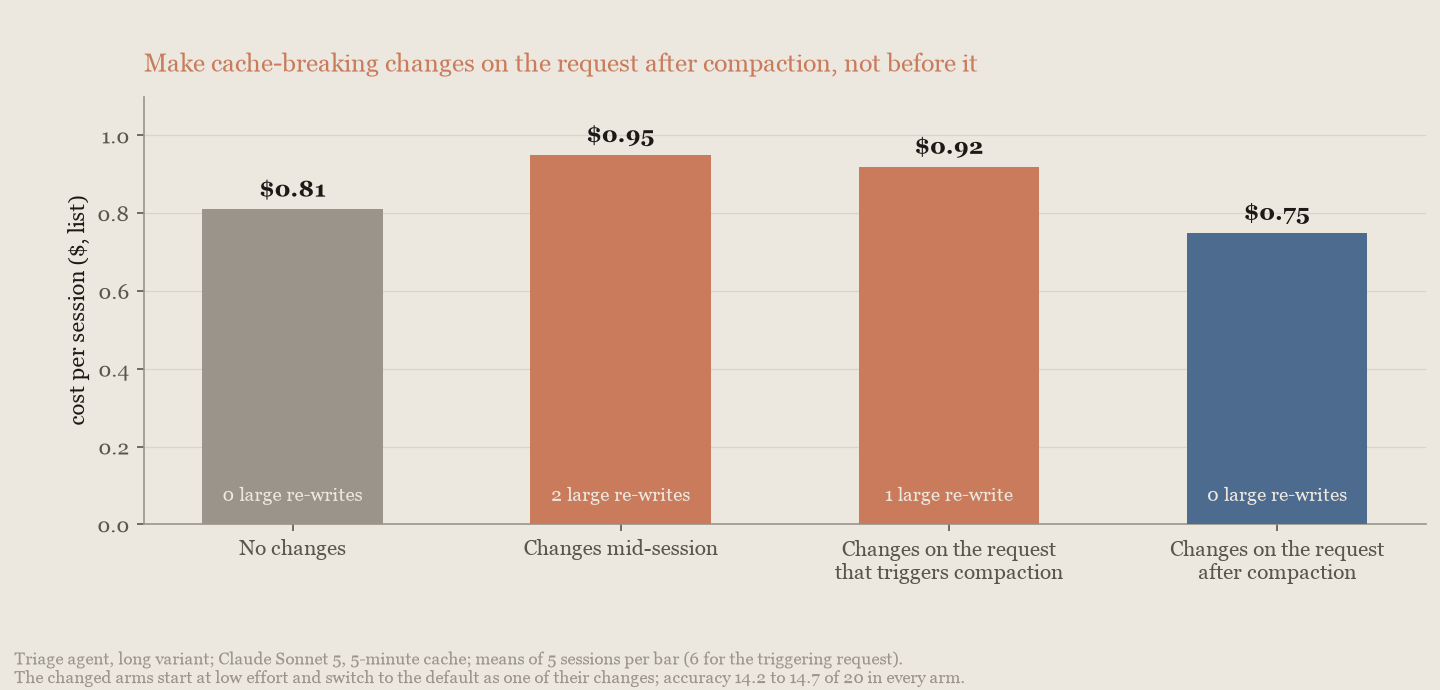
在中途更改任务预算会使包含预算值的任何缓存前缀失效,因此请在第一个请求上一次性设置。每次上下文编辑过程都会使从其清除点开始的前缀失效,下一个请求需要付费重新缓存其后的所有内容,因此请分几次大批量清除,而不是多次小批量清除。在 Claude Fable 5.1 和 Claude Mythos 5.1 上,这些操作每个令牌的成本都是读取价格的 50 倍,因此在这些模型上影响最大。请在自然的断点处进行所有会使缓存失效的更改,然后确认缓存读取没有下降;如果下降了,缓存诊断会显示前缀在何处出现分歧。
精简输入和上下文令牌
大多数智能体请求都携带着对答案毫无影响的令牌。精简这些令牌很少会损失输出质量,不过在测量中,并非这里的每个杠杆都节省了成本。有两个方面值得关注:
- 输入精简。 Web fetch 工具中的"dynamic filtering"(动态过滤)可将样板内容排除在获取的页面之外,图像缩放可将视觉输入调整到合适的尺寸,而"tool search"(工具搜索)与延迟加载仅在需要时加载工具定义(本节稍后会进行测量)。"Programmatic tool calling"(程序化工具调用)让 Claude 通过代码运行多个工具调用,从而只有过滤后的结果进入上下文;其文档报告称,在智能体搜索基准测试中,输入令牌减少了 24%,且得分更高。管理工具上下文对工具搜索、程序化工具调用、提示缓存和上下文编辑进行了比较。
- 上下文生命周期。 上下文编辑会清除过时的工具结果,而"automatic compaction"(自动压缩)及其阈值可防止长循环一直携带全部历史记录。
这些杠杆会与缓存相互作用,彼此之间也会相互影响,因此请根据净效果来评判,并使用缓存诊断确认每次更改后缓存前缀仍然有效。Anthropic 在一个问题分诊智能体上测量了这些杠杆,该智能体处理来自某个公共代码仓库的 20 个带截图的真实错误报告;此外还在同一作业的一个较长变体上进行了测量,其令牌数是前者的 2.6 倍。在开启缓存的情况下,输入精简(图像缩放和工具搜索)使短运行的成本进一步降低了 26%,长运行降低了 21%。
延迟加载未使用的工具定义
附加到请求的每个工具定义在每个轮次都是输入,而几个 MCP 服务器加起来就有数百个。Anthropic 运行分诊智能体时使用了它自己的两个工具加上来自公共 MCP 服务器的真实工具定义目录,总计最多 502 个工具,要么全部加载,要么将额外的工具标记为 defer_loading 并置于工具搜索之后:
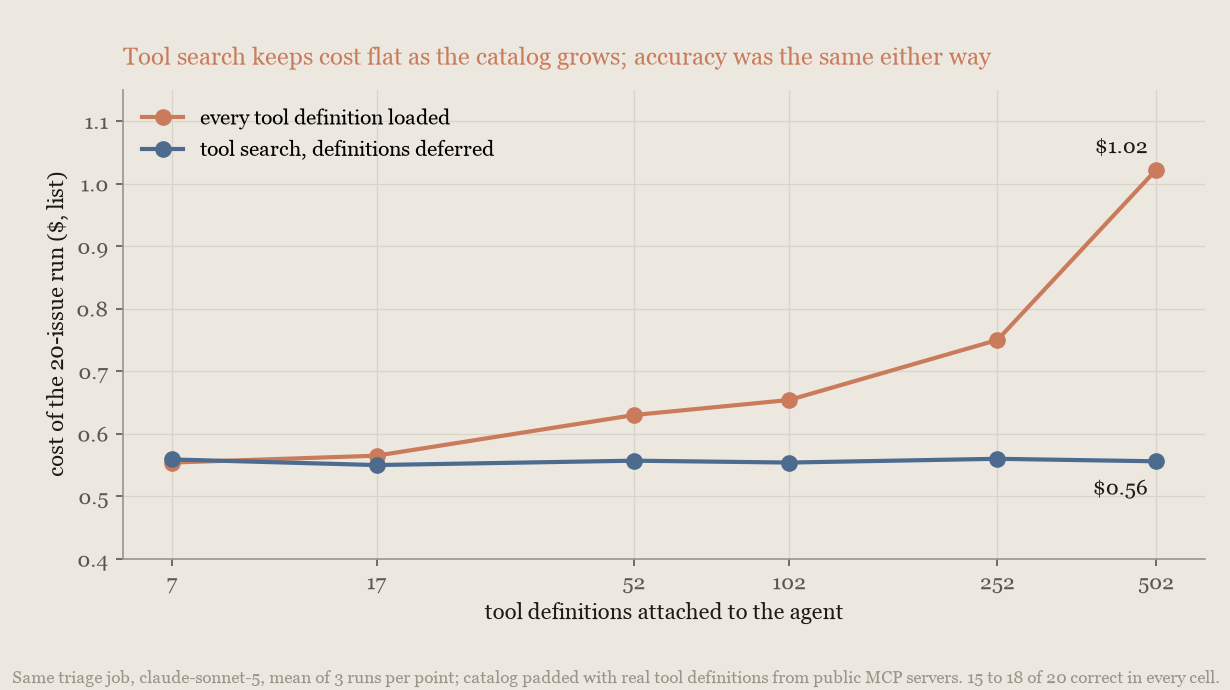
在加载每个定义的情况下,随着目录增长,运行成本几乎翻倍,与每个请求上的 schema 令牌同步。使用工具搜索时,在每个目录规模下都保持平稳,在 502 个工具时便宜 45%。无论哪种方式,每个单元格中的准确率都是 20 个中的 15 到 18 个,而且模型从未调用错误的工具,因此在这个规模下,目录消耗的是金钱,而不是正确性。对于通过 MCP 连接器接入的工具也是如此:在附加了一个公共 GitHub MCP 服务器的情况下,延迟加载其工具集(default_config: {defer_loading: true})在相同准确率下将运行成本削减了 20%。
将数据文件排除在提示之外
当模型需要对表格进行计算时,请使用 Files API 上传它,并让模型通过代码执行查询它,而不是将其粘贴进去。Anthropic 对一个 1,862 行的公共 CSV 提出了 25 个聚合问题15(求和、过滤计数、分组以及一个日期过滤),答案由 pandas 计算:
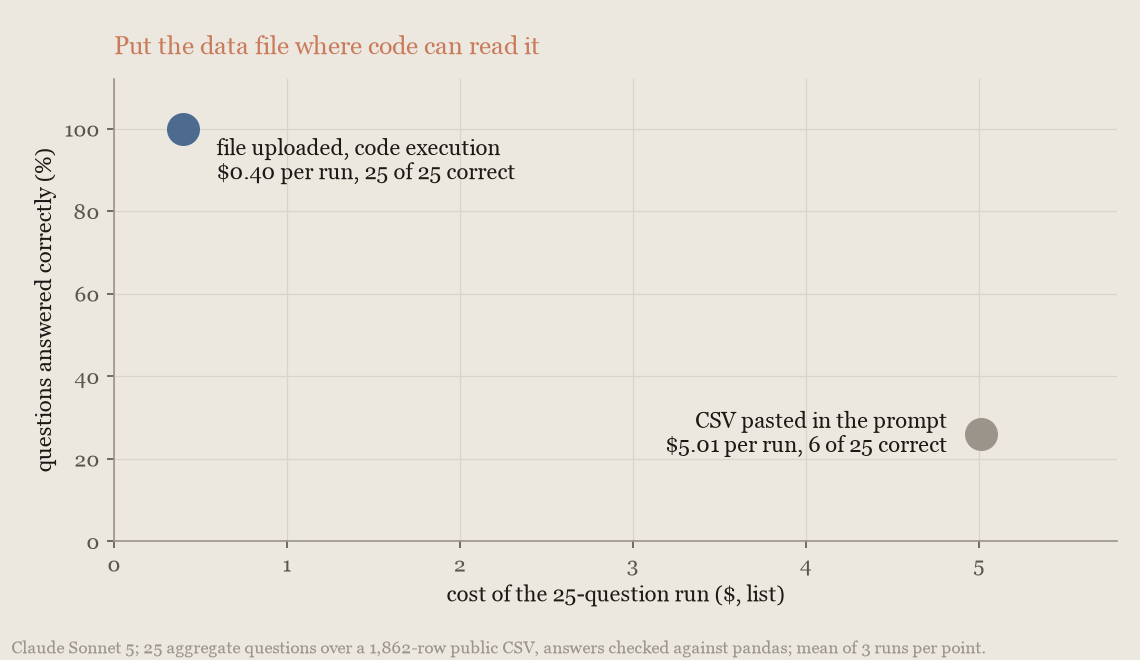
粘贴到提示中时,该表格在每个请求上约为 91,000 个输入令牌,Claude Sonnet 5 正确回答了 25 个问题中的 6 个。上传后使用代码执行,它回答了全部 25 个,而运行成本约为十二分之一。Claude Opus 5 表现出相同的模式。
管理上下文生命周期
上下文杠杆只有在会话足够长、需要它们时才划算:
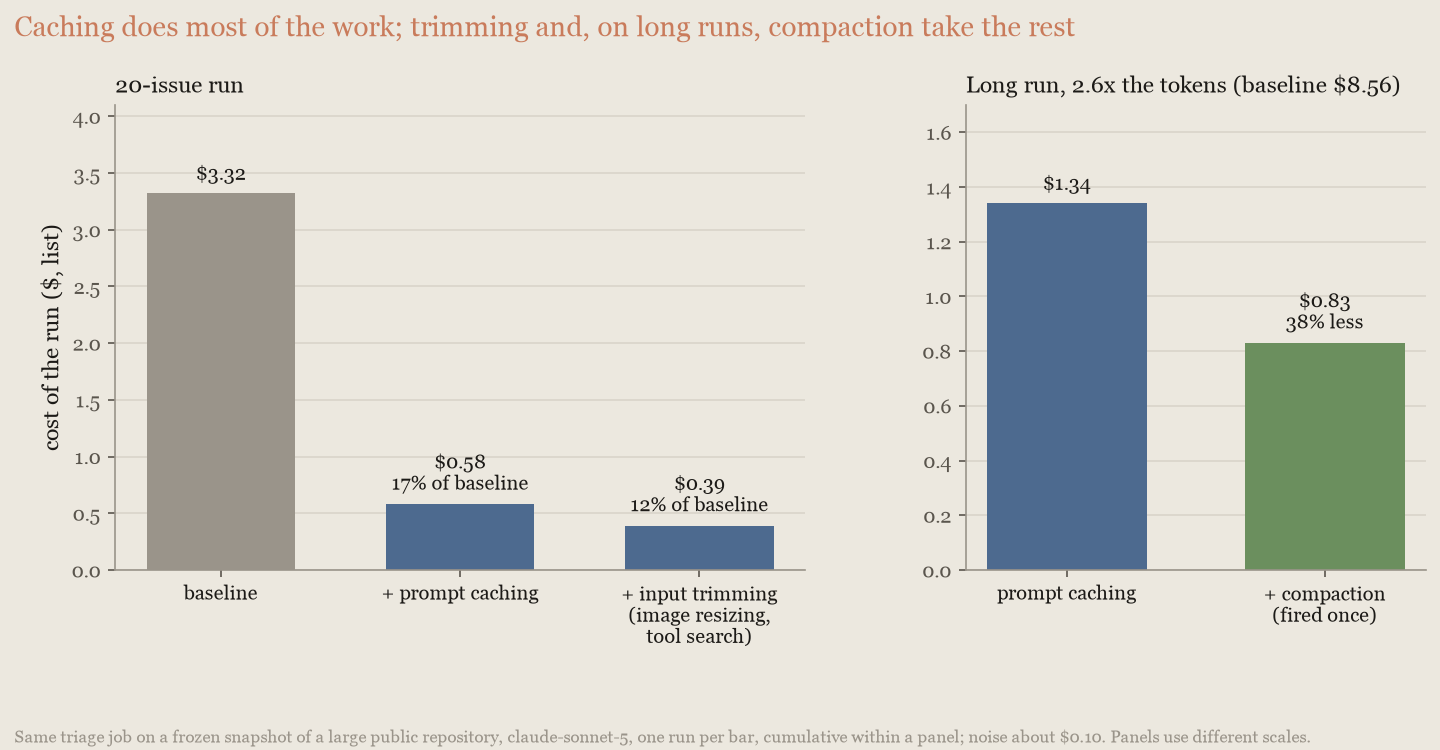
在 20 个问题的运行上,它们没有节省任何费用,而上下文编辑多花了 74%。在长运行上,修剪节省了 39%,压缩节省了 32%,而上下文编辑没有任何变化。修剪是您自己编写的几行代码:在每个任务边界处,用一行摘录替换大型过时的工具结果。它缓存效果好,因为编辑位于对话的尾部,下一个任务反正会在那里添加新内容:边界后的第一个请求有 89% 的缓存读取,边界之间的请求有 81%。在整个运行范围内,修剪和上下文编辑的缓存效果大致相同。修剪更便宜,是因为上下文编辑会在任务中途重写修剪所删除的内容(约占差距的三分之二),并且因为它使上下文保持约一半大小(另外三分之一)。如果您使用上下文编辑,请分几个大批次清除。改编自 harness 的修剪代码:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # 限制单行结果的长度,使提取内容保持简短
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extract批处理可以等待的工作
Batch API 对请求的每个令牌(包括缓存的令牌)提供 50% 折扣,代价是结果在 24 小时内的任何时间到达。将每个无人等待的请求通过批处理路由,其余的保留交互路径。对于无人值守的智能体工作,批处理是仅次于缓存的第二大免费杠杆:评估运行、回填以及计划作业,例如令牌精简测量中问题分诊智能体的定期运行。它可以与本页上除交互性之外的所有内容结合使用,但不适用于 Claude Managed Agents 会话,后者在设计上就是交互式的(参见 Claude Managed Agents 定价)。
针对当前模型审计提示
每一代模型对提示的响应都不同,因此提示会积累为您不再使用的模型编写的文本。常见的情况是为弥补旧模型而添加的过于具体的指令:"验证两次"、"尽最大可能彻底"、强制性的分步流程,或手工编写的推理草稿区。较新的模型会逐字遵循这些指令,产生额外的工具轮次和额外的书写,因此账单上升而准确率没有任何提升。针对您现在运行的模型审计提示,并在每次更换模型时再次审计,是一项免费收益。
审计只需一条命令。Claude Code 附带的 Claude API skill 有一个 prompt-audit 命令,它读取项目的提示和请求代码,并报告哪些内容是为不同模型编写的。以下简短摘录展示了它针对包含这些模式的客服台提示和请求代码运行的情况:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.该命令随后以 diff 形式提出其编辑(显示一个 hunk),并列出它有意保留不动的内容:退款窗口、语气要求和质量标准。您审查的是一个补丁,而不是重写。
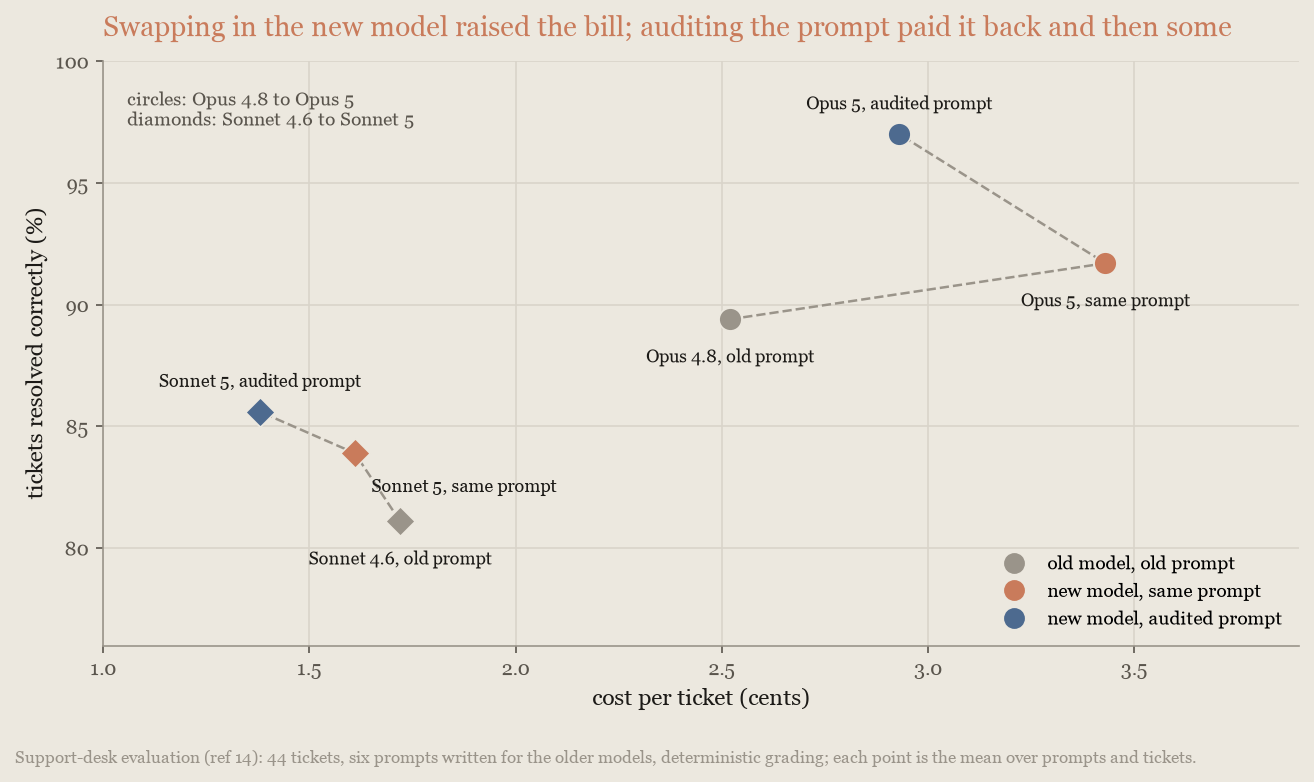
效果是可测量的。在一项客服台评估14中,为 Claude Opus 4.8 编写的提示在 Claude Opus 5 上每张工单多花 36%,而准确率没有变化。对相同的提示运行审计后,Opus 5 既比未审计版本更便宜(便宜 14%),又更准确(97% 的工单,从 92% 上升,增益超出噪声范围)。在 Claude Sonnet 4.6 到 Claude Sonnet 5 的迁移中,审计在相同准确率下削减了 14%:
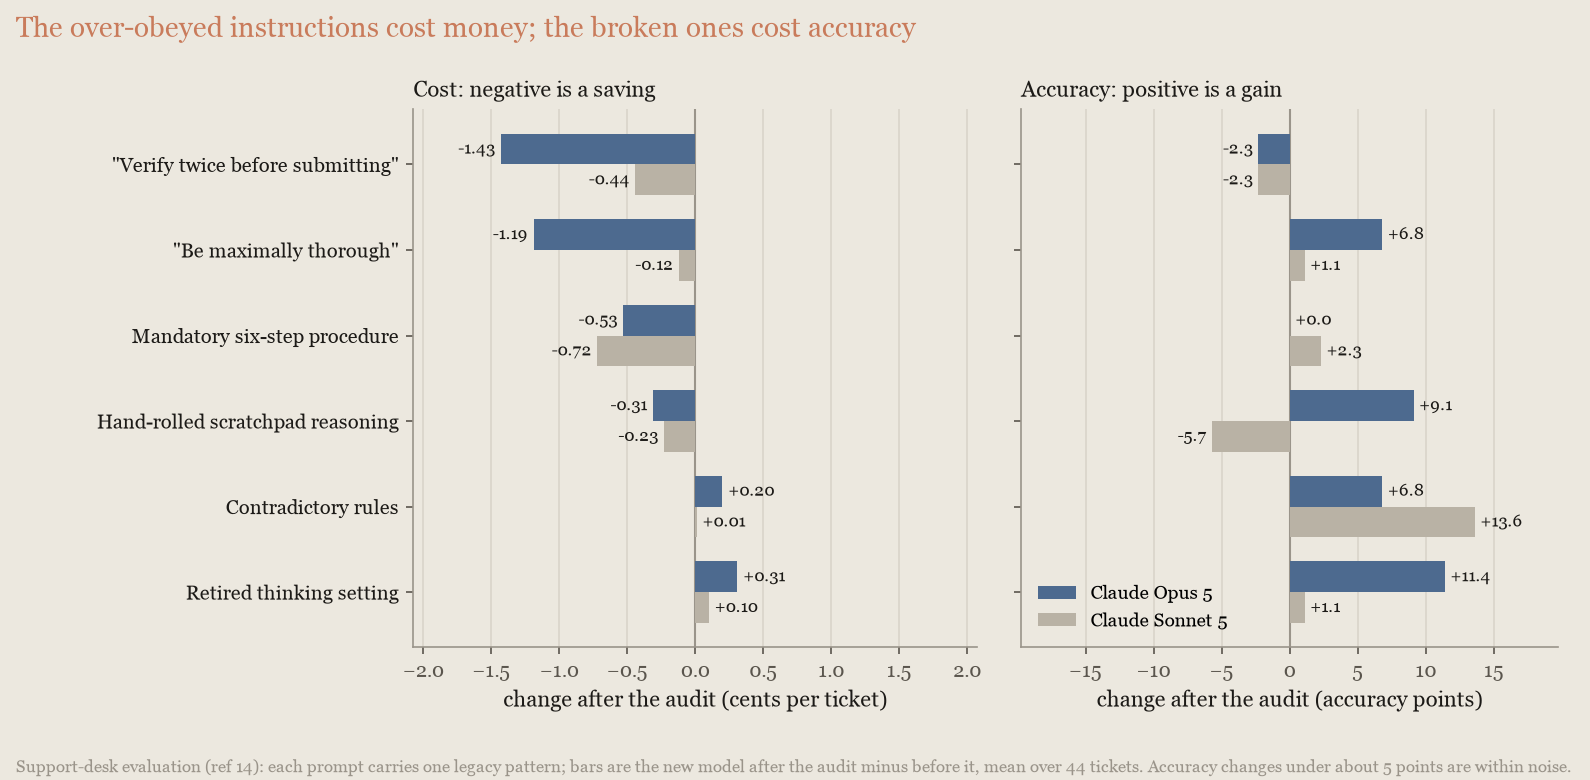
两种过时文本的代价不同。新模型过于字面遵循的指令消耗金钱:删除"验证两次"将 Opus 5 的每工单成本削减了三分之一,删除"尽最大可能彻底"几乎同样多。不再适合模型的文本则消耗准确率:一个已退役的思考设置、相互矛盾的规则,以及与模型自身思考冲突的手工草稿区,在 Opus 5 上删除后各自恢复了 7 到 11 个百分点:
相同的模式往往也出现在工具描述和 skill 中,它们同样值得审计。
在成本与智能之间权衡
这些杠杆决定了单个模型在成本与智能之间所处的位置:模型选择、努力程度、以更高设置重新运行失败任务、模型工作时所受的预算和上限,以及模型能否看到已经过去了多少时间。首先在当前模型上进行努力程度扫描(调整努力程度)。按成本和能力从低到高排列,当前模型依次为 Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5.5 和 Claude Fable 5.1(前沿模型);模型概览列出了完整的模型阵容和价格。
按每个任务的成本比较模型
价格表按每个令牌列出,而按每个令牌计算,前沿模型看起来很昂贵:Claude Fable 5.1 的每令牌价格是 Claude Sonnet 5 的数倍。但您是为已完成的任务付费,因此请按每个已完成任务的成本来比较模型。能力更强的模型完成任务所需的工作更少:更少的轮次、更少的搜索、更少地重新读取自身上下文,以及更少的回溯。每令牌的溢价往往会被各方面工作量的减少所抵消。
Anthropic 在 SWE-bench Pro3 子集上测量了这一点,并按客户的计费方式定价:
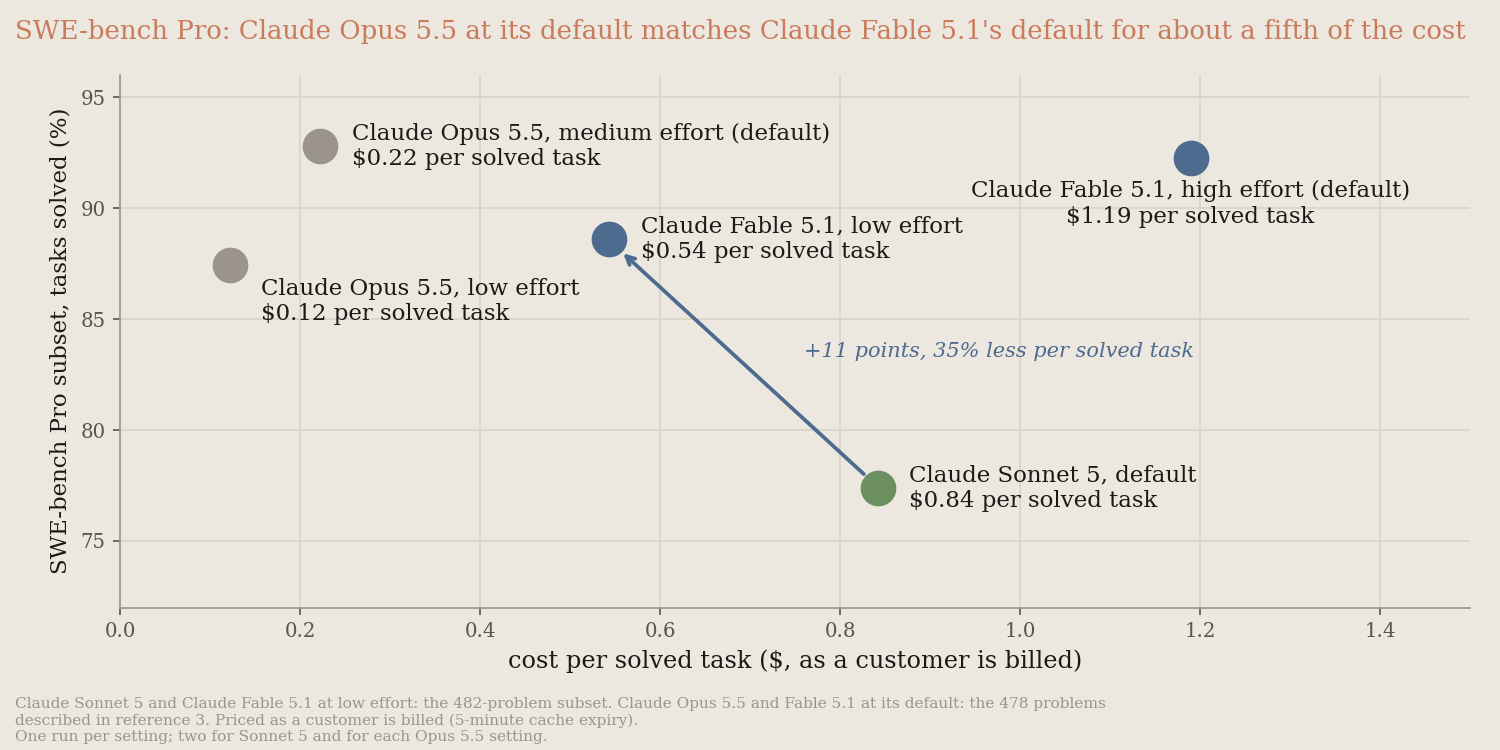
Claude Fable 5.1 在 low 努力程度下解决了 88.6% 的任务,每个已解决任务成本为 $0.54,而 Claude Sonnet 5 在默认设置下解决了 77.4%,成本为 $0.84:尽管每令牌价格高出五倍,却多出 11 个百分点,且每个已解决任务的成本低 35%。不过,它并不总是胜出。在同一子集上(Claude Opus 5.5 和 Claude Fable 5.1 在该子集上都已基本饱和,且其分数与公开排行榜不可比),Opus 5.5 在其默认设置 medium 下与 Fable 5.1 的默认设置表现相当(92.8% 对 92.3%,在运行间噪声范围内),而每个已解决任务的成本约为其五分之一($0.22 对 $1.19)。在 low 下,Opus 5.5 解决了 87.4%,成本为 $0.12。这些数据使用的是参考文献 3 中描述的 478 个问题。而在长时间的研究循环中,前沿模型做的工作更多而非更少:在 DeepResearch Bench II7 上,Fable 5.1 在 low 下的得分比 Sonnet 5 高 10 分(66% 对 56%),每个任务的成本约为其四倍($4.66 对 $1.20),因为它在更大的上下文上运行更长的研究循环。Claude Opus 5 在默认设置下以相同口径得分 71%,每个任务成本 $6.71,高于 Fable 5.1 在默认设置下的表现(65%,成本 $7.12),因此在研究任务上,Fable 5.1 同样只有在 low 下才物有所值。
对于大多数智能体工作负载,请从默认努力程度(medium)下的 Claude Opus 5.5 开始,并将 Claude Fable 5.1 用于要求较高的推理和长周期智能体工作,或者用于 Claude Opus 5.5 在更高努力程度下您的评估仍未达标的情况。如前所述,在 SWE-bench Pro 子集上,Opus 5.5 在默认设置下与 Fable 5.1 的默认设置表现相当,而每个已解决任务的成本约为其五分之一。在顾问策略中的编码基准测试上,它得分 86.6%,而 Fable 5.1 在 medium 下得分 84.2%(单次 Fable 5.1 运行),每次尝试的成本不到其三分之一($0.84 对 $2.68)。在图表阅读基准测试 Chartography13 上,Opus 5.5 在 low 下得分 68.7,每张图表约 $0.03,而 Fable 5.1 在 low 下得分 62.5,成本 $0.15,Claude Opus 5 在 low 下得分 49,成本 $0.16。在另一端,Claude Haiku 4.5 回答 GPQA Diamond9 问题的每题成本约为 Claude Opus 5.5 的五分之一,准确率为 63%,而 Opus 5.5 为 92%,并且在长编码任务上落后得更多。它适合输出可检查的大批量工作,而不适合长时间的智能体循环。
排名会因工作负载而反转,而任何价格表都无法告诉您会朝哪个方向反转。请在您自己的流量上以每个已完成任务的成本为每个候选模型定价,包括默认努力程度下的 Claude Opus 5.5 以及降低努力程度后的前沿模型。
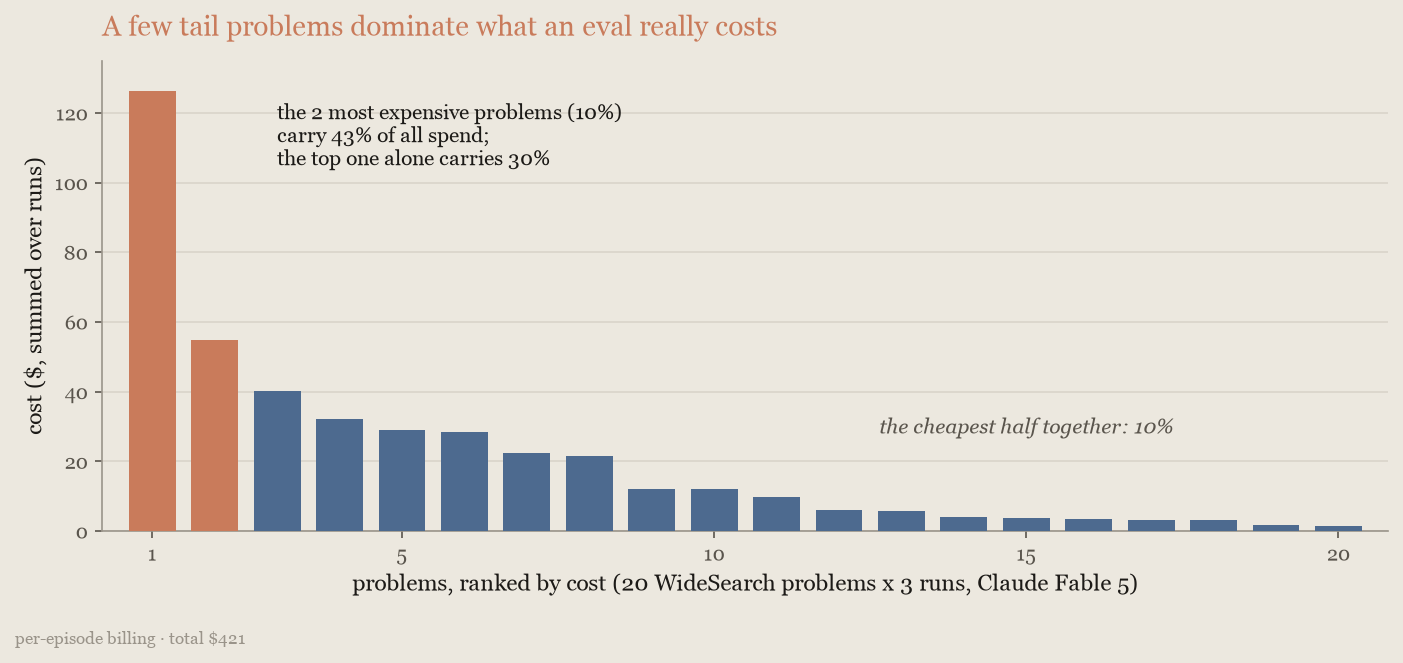
为工作负载的尾部定价,而不是中位数:在最难的十分之一任务上比较模型,而不是在典型任务上。在典型任务上,每个模型看起来都差不多,最便宜的看起来最好,但账单是由较便宜模型失败的任务决定的,因为失败的任务仍然会对其令牌计费,然后是重试,再然后是失败在下游造成的任何代价。即使没有任何失败,尾部也是资金的主要去向。在一次 20 个问题的 WideSearch1 运行中,两个问题占了 43% 的支出:
多模型策略的存在,就是为了将前沿智能用于这一尾部,而不必为其余部分支付前沿费率。
升级模型
如果您落后一两个模型版本,最便宜的杠杆就是更换模型字符串。Anthropic 在 SWE-bench Pro3 子集上使用相同的 harness 运行了近期的 Claude Opus、Claude Sonnet 和 Claude Fable 模型,每个模型都使用其发布时的默认设置并按标价定价,并在 Terminal-Bench 320 上再次运行了 Opus 系列:
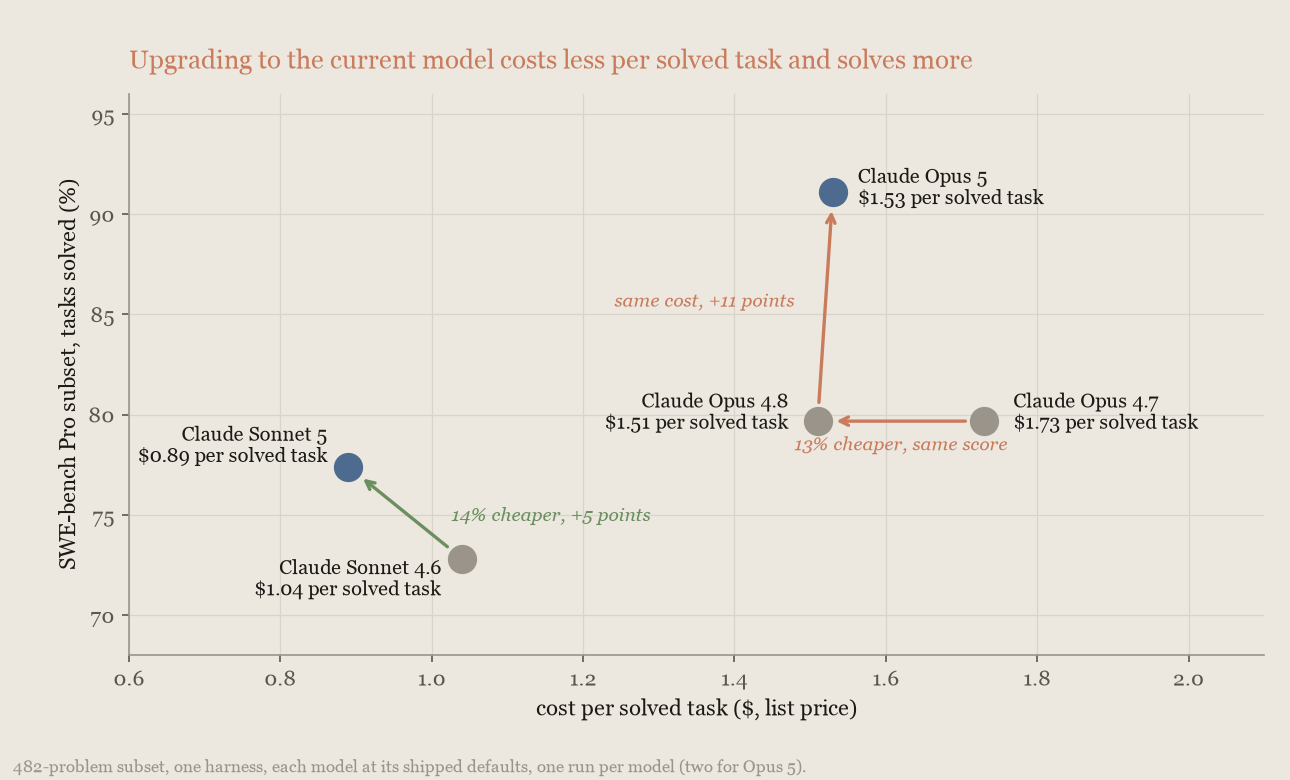
Anthropic 对 Claude Opus 4.7、Opus 4.8 和 Opus 5 的每令牌定价相同,因此它们之间的任何差异都来自每个模型完成每个任务所做的工作量。按客户的实际计费方式定价,Claude Opus 4.8 解决的任务比例与 Claude Opus 4.7 相同,每个已解决任务的成本低 14%;而 Claude Opus 5 则多解决 12 个百分点的任务,每个已解决任务的成本高 21%。在该基准测试上,low effort 下的 Claude Opus 5 胜过默认设置下的 Opus 4.8,每个已解决任务的成本约为后者的 30%,因此最便宜的升级方式是以较低设置使用新模型。Sonnet 5 的节省来自其较低的每令牌价格,这足以抵消它相比 Sonnet 4.6 在每个任务上多用的令牌:每个已解决任务的成本低 15%,同时多解决 5 个百分点。前沿层级也以同样的方式获益:Claude Fable 5.1 与 Claude Fable 5 得分持平,每个已解决任务的成本低 43%,其中大部分来自更低的缓存读取价格。但这一趋势并不能保证:在 DeepResearch Bench II7 上,同样的升级在 high 下使每个任务的成本高出 41%(在 low 下高出 79%),换来的只是在所有组别中均无异常的任务上多出 2 到 3 分(参见参考文献 7),因为新模型在该基准上每个任务做的工作更多。两者的输入和输出价格相同,缓存读取便宜 4 倍,因此在认定升级能节省成本之前,请先在您自己的工作负载上进行测量。
在更难的工作上,差距会进一步扩大。在 Terminal-Bench 320 上,任务难度高到决定账单的是通过率而不是令牌数:Claude Opus 4.7、Opus 4.8 和 Opus 5 每个任务各花费 $8 到 $15,但分别只解决了 7%、15% 和 41% 的任务,因此沿着阶梯向上,每个已解决任务的成本从 $183 降至 $63,再降至 $28。Claude Opus 5 在已饱和的编码子集上相对 Opus 4.8 的 21% 溢价,到了 Terminal-Bench 3 上变成了 56% 的节省,因为旧模型在那里大多失败:您的工作负载越是难倒旧模型,升级后每个结果节省的成本就越多。
请按每个已解决任务的成本进行比较,而不是按每个令牌比较:相同的文本在 Claude Opus 4.7 及更高版本上大约多消耗 30% 的令牌,因此按令牌比较必然会让较新的模型显得更昂贵。
调整努力程度
"Effort"(努力程度)是让模型适配您的任务的最直接方式。effort 参数控制模型进行多少思考、工具调用和自我验证。大多数模型的默认值是 high,适合要求较高的任务;Claude Opus 5.5 的默认值为 medium。成本随所有这些活动增长,而准确率只随任务实际需要的那部分增长。在模型能力上限以下,最高的努力程度级别是在为任务根本用不到的深度付费。
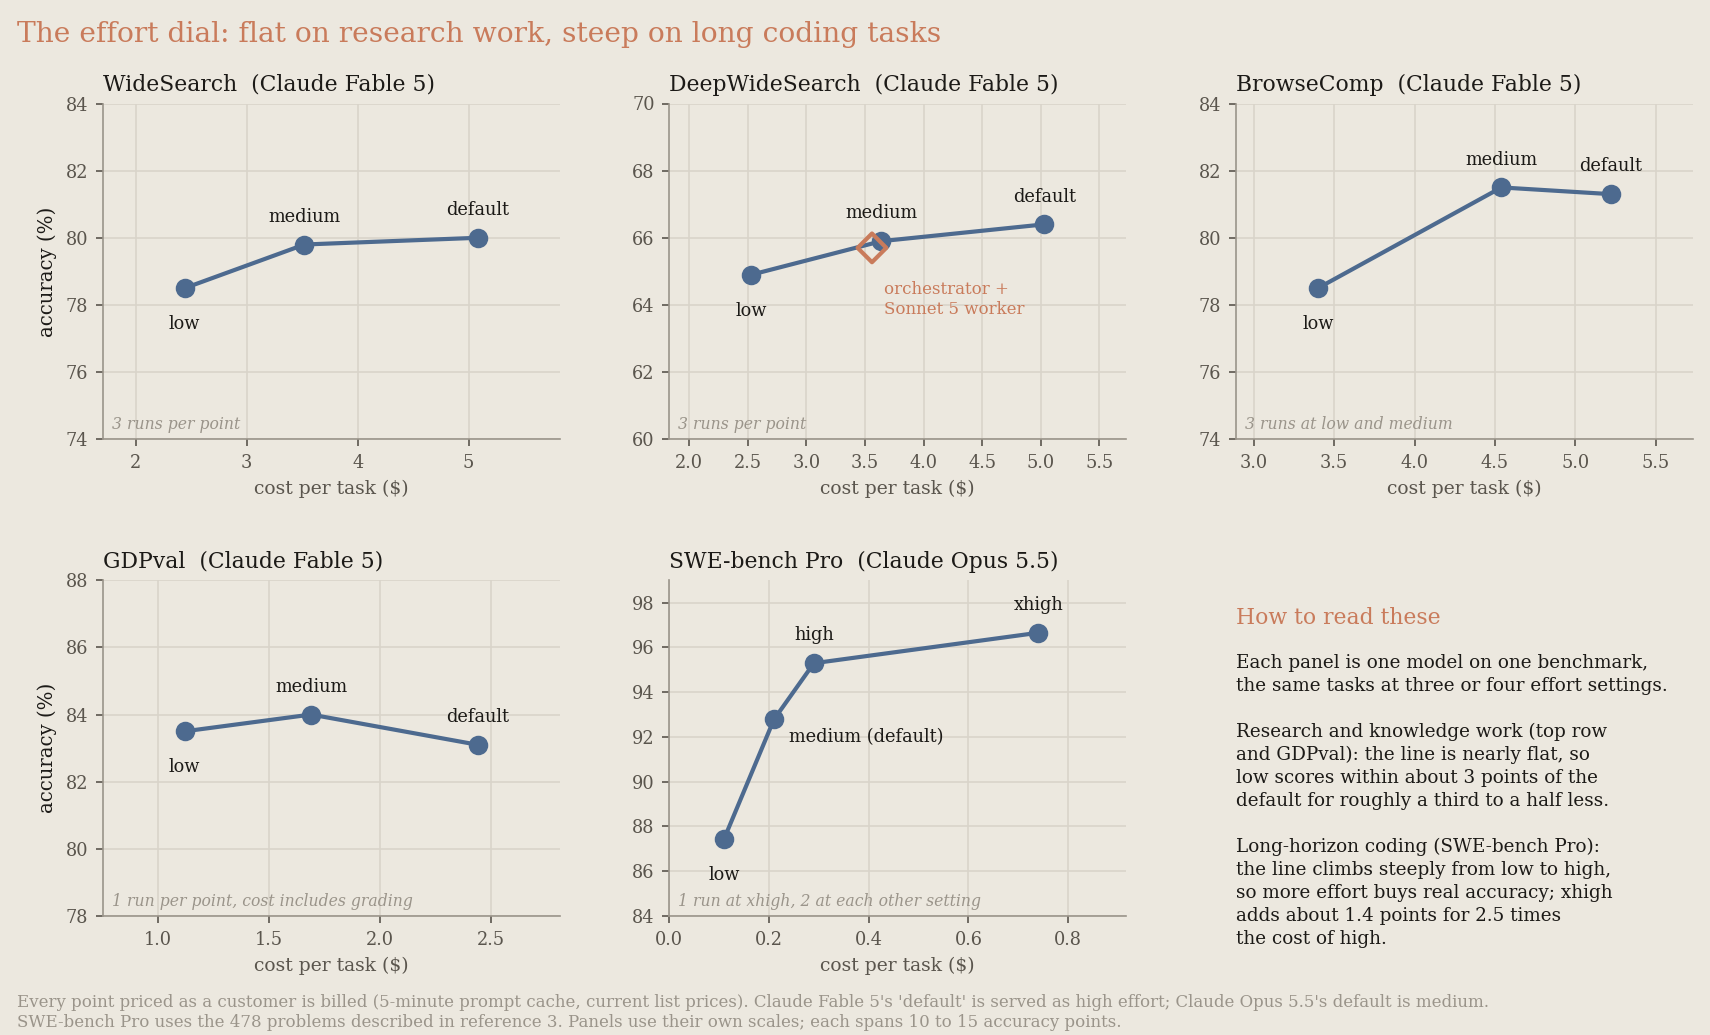
在研究和知识工作类基准测试上(WideSearch1、DeepWideSearch6、BrowseComp4 和 GDPval2,均使用 Claude Fable 5),准确率与成本的关系曲线几乎是平的:
low损失 1 到 3 个百分点,每个任务的成本降低三分之一到一半。medium的准确率与默认设置相当,成本约为默认设置的 70% 到 87%。- 在这四个基准中,默认设置相比
medium都没有带来可测量的提升。
在 DeepWideSearch 上,low 的表现还与"编排器 + Claude Sonnet 5 工作模型"的配置相当,成本却低 29%:降低努力程度的效果胜过了更改架构。
较低的努力程度设置通常也更快,这在 "latency"(延迟)受限时很重要。在这些运行中,low 在 DeepWideSearch 上每个问题耗时 4.5 分钟,默认设置则为 7.9 分钟。语料库基准测试的输入无法放入任何单个上下文窗口。在该基准上,Fable 5.1 在 low、medium 和 high 下每个回合分别耗时 15.2、17.5 和 19.9 小时。
长周期编码任务才是努力程度真正能换来准确率的场景。在 SWE-bench Pro3 上,以 high 为基准:
- Claude Opus 5.5 在默认设置
medium下得分低约 2.5 个百分点,成本约为 70%。 - 在
low下得分低约 8 个百分点,成本约为三分之一。 xhigh得分高约 1.4 个百分点,成本是high的 2.5 倍。
这是一个真实的权衡,而以更高的努力程度重新运行失败的任务可以把它重新变成节省。下图绘制了研究和知识工作类基准测试以及 SWE-bench Pro 上准确率与成本的关系:
由此可以得出两点结论:
- 在添加第二个模型之前,请先为您自己的工作负载绘制这条曲线。在这些内部测量中,有一种多模型配置看起来比默认的单模型更便宜,实际成本却高于同一模型在较低努力程度下的成本。
- 这条曲线是任何多模型策略都必须超越的单模型基线,因此在您自己的工作负载上进行测量的第 2 步会在多个努力程度级别上建立基线。
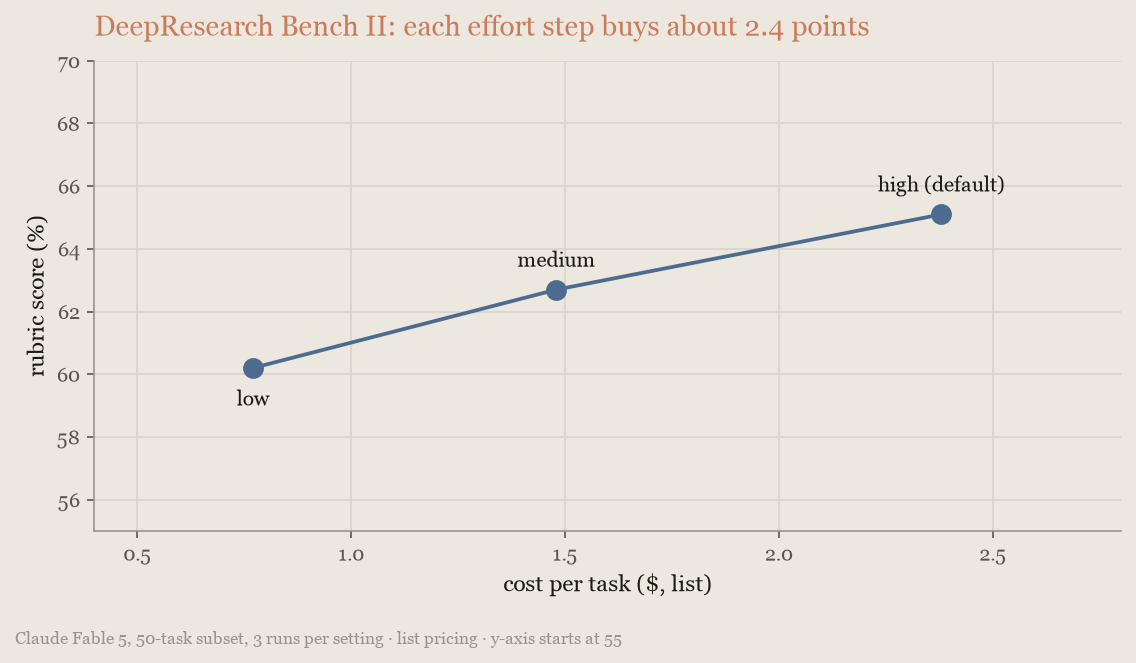
困难的工作并不一定需要高努力程度。在 DeepResearch Bench II7 上,Claude Fable 5.1 在 low、medium 和 high 下的得分几乎相同,而每个任务的成本从 $4.66 升至 $7.12。也就是说,在这种情况下提高努力程度并不会明显提升输出质量。在所有实验组中均无异常的 21 个任务(参考文献 7)上,Claude Fable 5 在各努力程度下的得分同样持平。不过,图表采用的是 33 个任务的口径,剔除了每个模型自身被截断的尝试,在该口径下 Claude Fable 5 的得分呈上升趋势。请在您实际部署的模型上测量这条曲线,而不是沿用上次测量的模型:
仅凭任务描述无法判断您的工作负载属于哪一类。因此,请在您自己的流量样本上测试两到三个努力程度级别,再从曲线中读出答案。请在单独的会话中测试每个级别:在会话中途更改顶层努力程度会使缓存失效(请参阅缓存重复的上下文),从而扭曲比较结果。有关参数详情,请参阅 Effort。
以更高的努力程度重新运行失败的任务
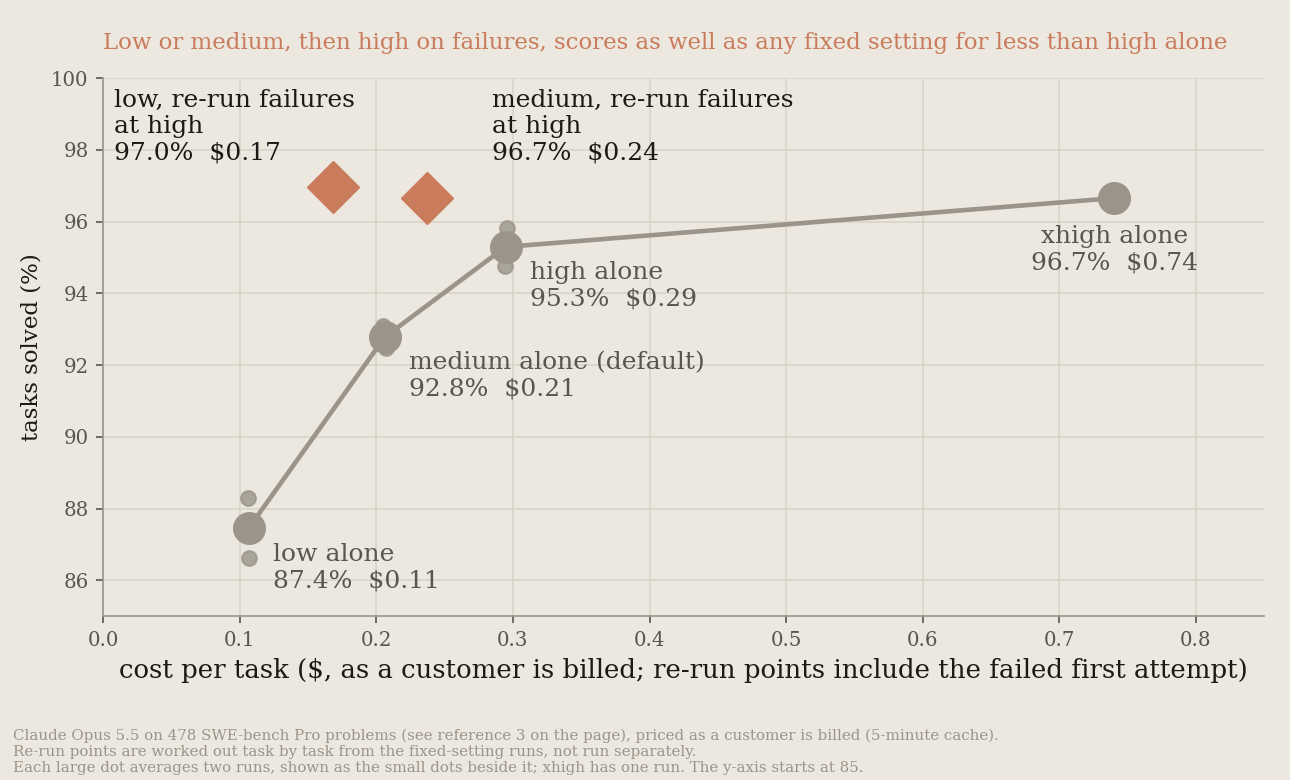
当任务结果可以检验时,努力程度曲线上成本最低的策略并不是某个固定设置,而是:以较低设置运行所有任务,只以较高设置重新运行失败的任务。
Anthropic 基于调整努力程度中 SWE-bench Pro3 子集上的努力程度运行结果,逐个任务计算了这一策略的效果:
- Claude Opus 5.5 在
low下有 13% 的任务失败。以high重新运行这些任务后,约 97% 的任务通过,每个任务约 $0.17。 - 全部以
high运行时,通过率为 95.3%,每个任务 $0.29。
即使把失败的低成本尝试也计算在内,该策略的通过率也略高,成本只有一半多一点。如果改为从 medium 开始,约 97% 的任务得到解决,每个任务约 $0.24。这一小幅提升主要来自第二次尝试:对一次 high 运行中失败的任务再以 high 重新运行,得分大致相同,但花费更多。因此,请把这一策略用于节省成本,而不是提升得分:
该策略有两个前提条件:
- 您需要一个失败信号(此处为基准测试自带的测试)。如果检查器会放过质量不合格的结果,这些失败就会被漏掉。
- 每个首轮失败的任务都要花费两次运行的实际耗时,因此节省的成本是以失败任务上的延迟为代价换来的。
设置预算和输出上限
大多数智能体任务运行的成本都很低,但少数运行会在搜索、反复验证和过度测试上花费数倍于中位数的成本。任务预算针对的正是这部分长尾。模型在整个任务期间都能看到实时的令牌倒计时,并据此自我调节:削减低价值的搜索,跳过冗余的验证,及时收尾,而不是陷入失控的循环。
Anthropic 使用 Claude Fable 5.1 在 SWE-bench Pro3 上测量了预算逐步收紧时的通过率和每个任务的成本:
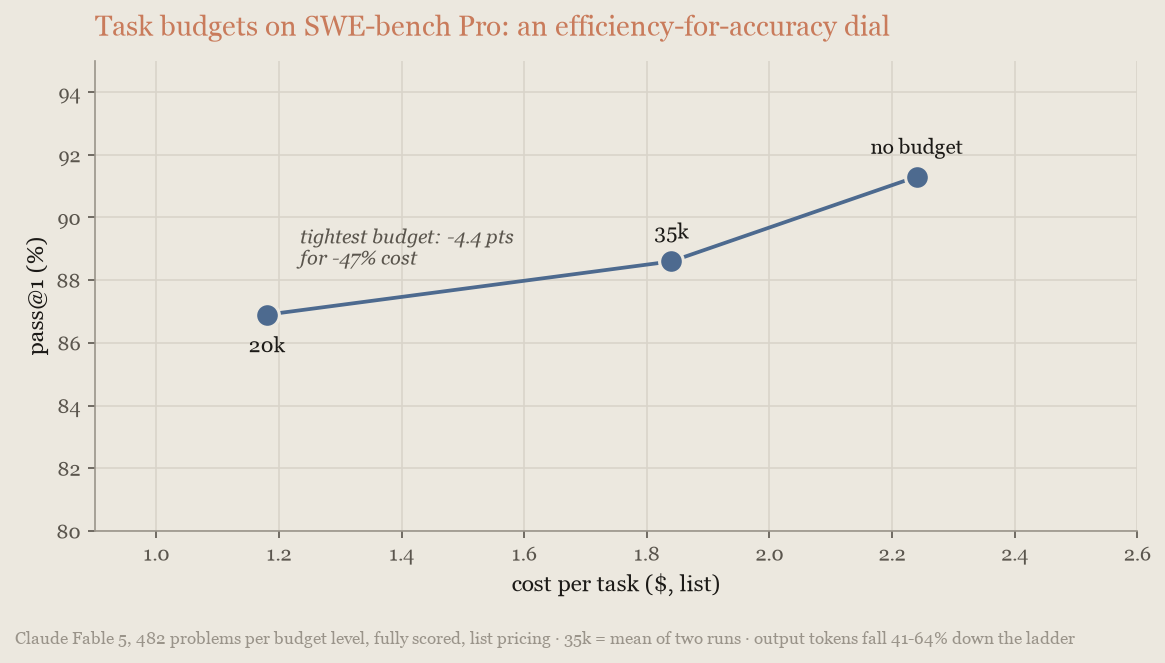
宽松的预算使每个任务的成本降低 44%,通过率下降约 3 个百分点,处于运行间噪声的边缘;允许的最紧预算使成本降低 58%,通过率下降 6 个百分点。在这里,预算换来了效率,代价是通过率的下降,而且预算越紧,下降越多。
三种控制手段各有不同的作用:
- 任务预算能节省成本,因为模型能看到它。
max_tokens是安全上限:降低它会减少每次尝试的成本,但不会降低每个已解决任务的成本。- 在 Claude Managed Agents 上,会话预算是兜底的硬性美元上限。
请三者都设置:一个任务预算、一个较高的 max_tokens,以及一个会话上限,防止出现您绝不希望在账单上看到的运行。最后再以工作区支出限额作为最终保障。
- 任务预算目前在最新模型上处于 beta 阶段(beta 标头为
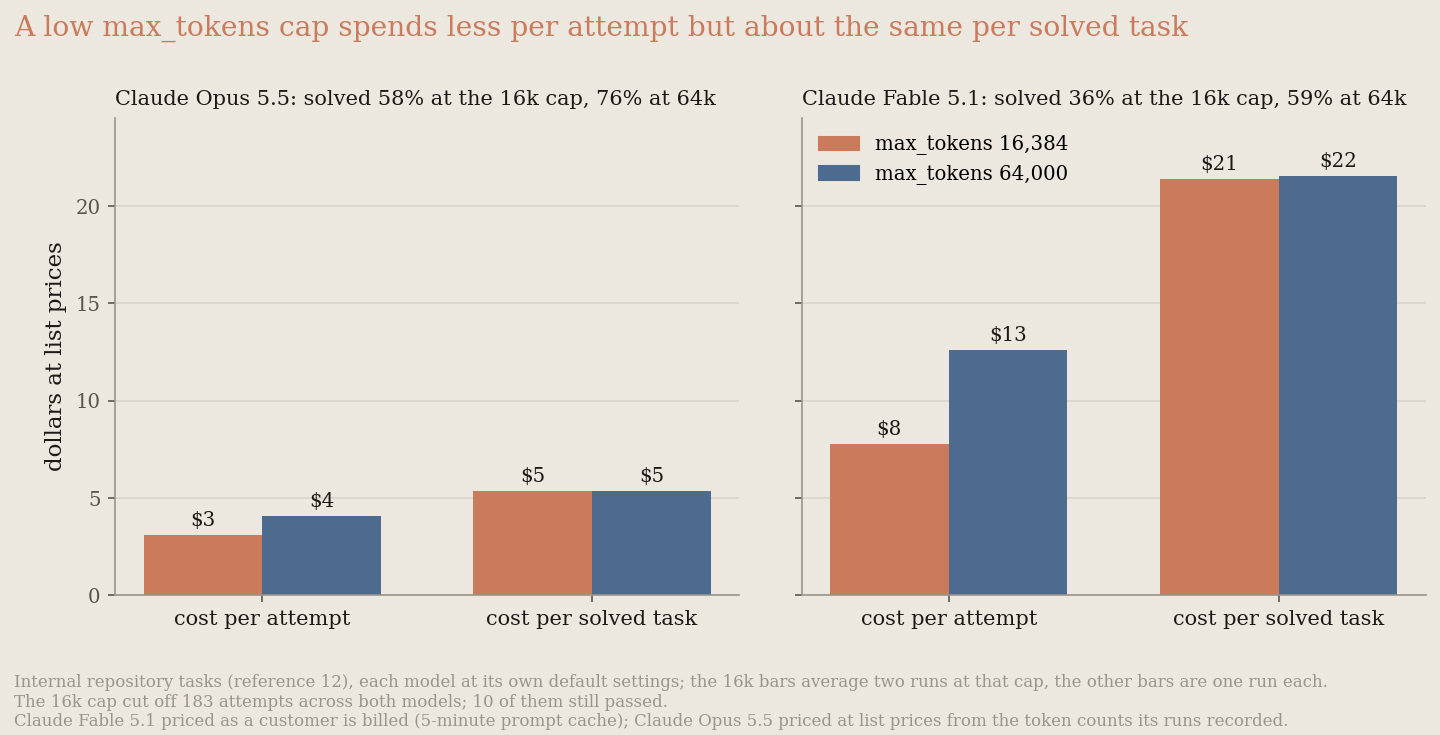
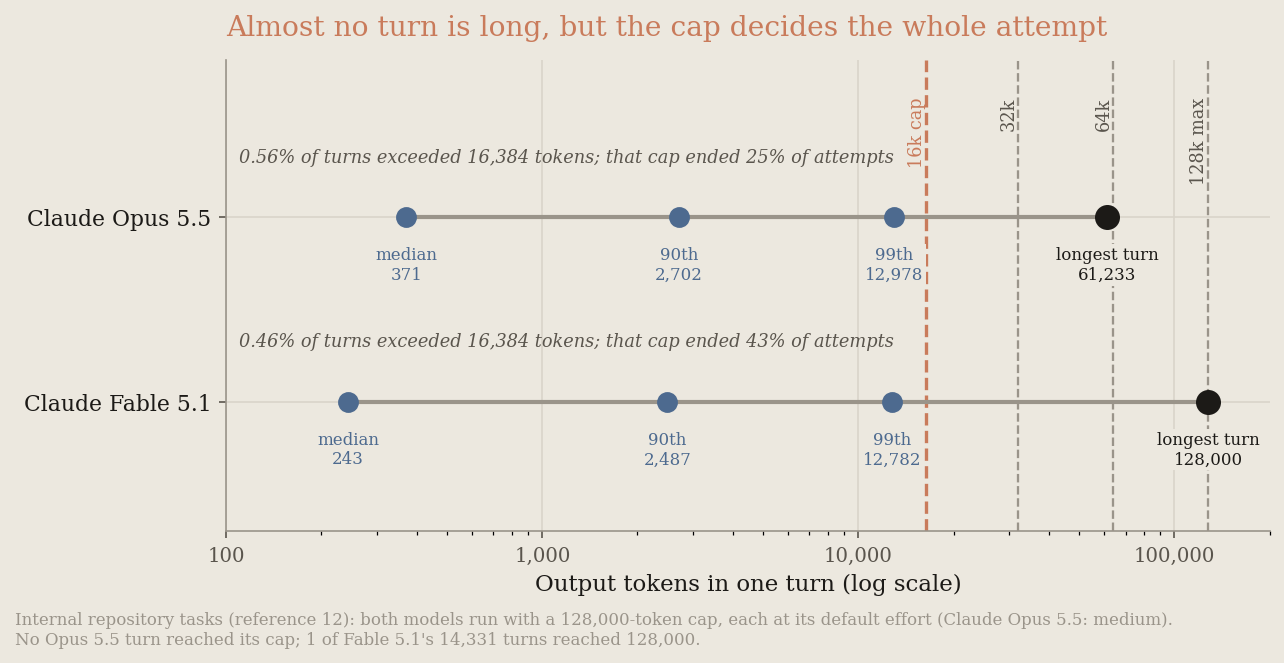
task-budgets-2026-03-13),具体支持哪些模型请查看支持表。 max_tokens限制单个响应的长度,而模型看不到这一限制,因此降低它并不会让模型节省用量。需要更多空间的轮次会被丢弃,但仍会计费。- 在一个内部代码仓库任务基准测试12上,各模型均使用默认努力程度时,16,384 令牌的上限截断了 Claude Opus 5.5 约四分之一的尝试,以及 Claude Fable 5.1 43% 的尝试。在被截断的尝试中,Opus 5.5 的 66 次里只有 1 次仍然通过,Fable 的 117 次里只有 9 次仍然通过。
- 受上限限制的运行每次尝试花费更少,但解决的任务也按比例减少,因此每个已解决任务的成本与 64,000 上限时大致相同:Fable 5.1 为 $21 对 $22,Opus 5.5 的差距在 1% 以内。
- 在 64,000 上限下,Claude Fable 5.1 在默认努力程度下约 14,000 个轮次中仍有 2 个被截断(Claude Opus 5.5 没有轮次被截断),Fable 5.1 解决了 58.5% 的任务,而 16,384 上限下为 36.3%。在 SWE-bench Pro3 子集的另一个切分上(见参考文献 12),两种上限没有差异,都是 100 个任务中解决 94 个。
- 重试被截断的尝试很少有帮助:在相同上限下,大多数尝试会再次失败;在更高上限下,您还要为浪费掉的那次尝试付费。
- 对于智能体工作,请将
max_tokens设置为 64,000;如果单次被截断的尝试代价很高,请设置为最大值 128,000。在 128,000 上限下,Fable 5.1 解决了 60.0% 的任务,每个已解决任务的成本不变。 - 对于这么大的响应,请使用流式传输,并将
stop_reason: max_tokens视为失败。要节省成本,请使用模型能看到的努力程度和任务预算。
- Claude Managed Agents 上的会话预算是硬性上限。
- 会话预算是对单个会话设置的美元上限,按令牌、搜索和会话时长的标价计算。
- 达到上限时,会话会暂停,并返回
stop_reason: budget_reached;提高预算即可恢复会话。 - 它由平台强制执行,适用于任何有标价的模型,包括尚不支持任务预算的模型,并且可以与建议性的任务预算配合使用。
- 部署会将同一字段应用于每次运行。
请要求模型给出更简短的回答。在 Claude Sonnet 5 上,输出令牌的价格是输入令牌的五倍。而在智能体循环中,模型写出的每个令牌都会在之后的每一轮中作为输入再次传回,因此一个冗长的回答会让您反复付费。Anthropic 在三种最终回答指令下运行了分诊任务,每种指令运行三次,使用相同的模型和工具。原始指令要求两行回答:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>较短的变体要求一行回答:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.较长的变体要求一份包含五个带标题部分的备忘录:问题摘要、证据、重复检查、建议标签和后续步骤。以其中一个问题为例(跳过某个问题后,排队中的提示始终没有发送),前两种指令得到的回答如下:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.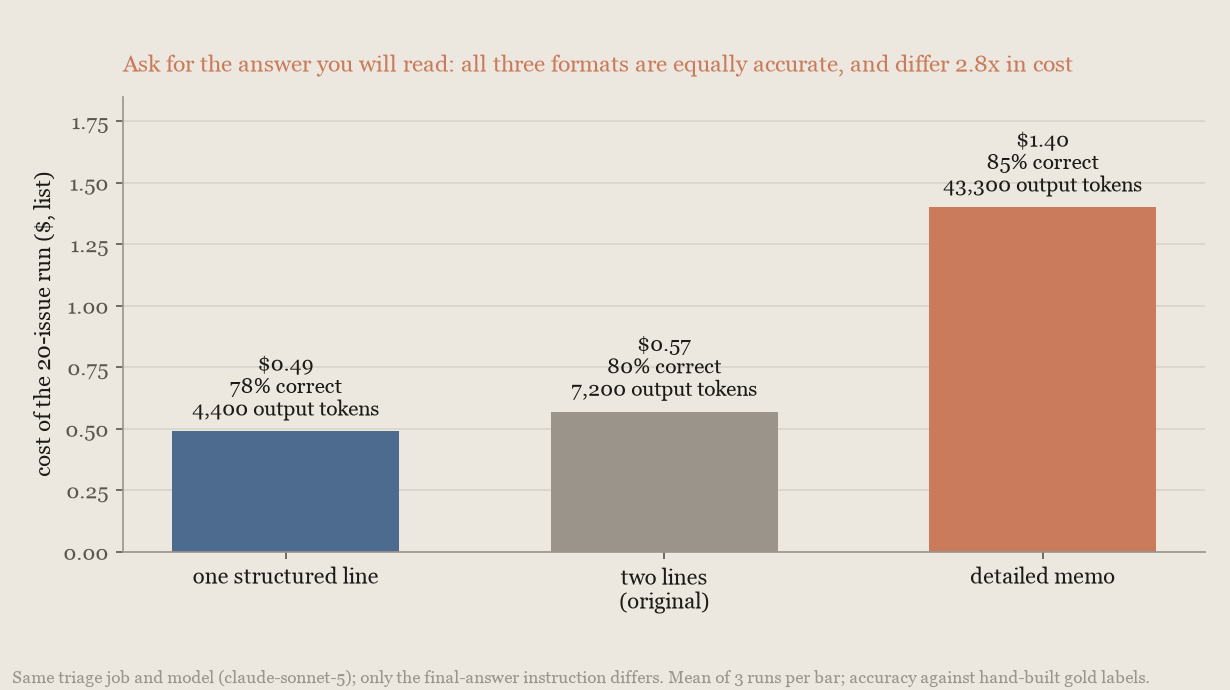
单行回答比原始的两行回答少用 39% 的输出令牌,每次运行的成本低 14%。备忘录使用的输出令牌是单行回答的六倍,成本是单行回答的 2.8 倍。对照标准标签,三种格式的得分差异都在运行间噪声范围内。也就是说,这些格式在费用上的差别远大于在正确率上的差别。请要求模型给出您真正会阅读的回答,而不是看起来详尽的回答。
在较低的 max_tokens 上限下,两个模型每次尝试的花费都更少,但解决的任务也按比例减少,因此每个已解决任务的成本几乎不变:
几乎每个轮次的输出都远低于这两个上限。更高的上限换来的,是能容纳偶尔出现的长轮次:
向模型显示已用时间
智能体循环中的模型看不到时钟。任务预算会告诉模型还剩多少令牌,但默认情况下,请求中没有任何信息告诉模型工作已经进行了多久。两处小改动就能为模型提供这一信号:
- 在系统提示中添加一条两句话的指令,说明时间很重要。
- 从第二个请求开始,在模型的每一轮之前发送已用时间。
Anthropic 使用 high 努力程度下的 Claude Fable 5.1,同时测量了这两处改动的效果。测量覆盖两个公开基准测试 DRACO21 和 HLE22,以及一个包含 70 道研究级物理题的内部题集,该题集改编自公开的 CritPt 基准测试23,本页称之为物理题集。三者都以两种形态运行:
- 单个智能体。
- 团队:由一个主智能体启动同一模型的多个辅助智能体并行工作。
Anthropic 在运行前为得分变化设定了容差:DRACO 为 1.5 个百分点,HLE 为 2.5 个百分点。如果得分变化的 95% 区间落在该容差之内,就视为在容差范围内。下图绘制了每种配置的得分与每个任务成本的关系。第二行条形图给出每种配置的耗时,以 high 努力程度下单个智能体的耗时为基准计算比值,不含重试等待时间。第三行给出两处改动带来的得分变化及其 95% 区间:
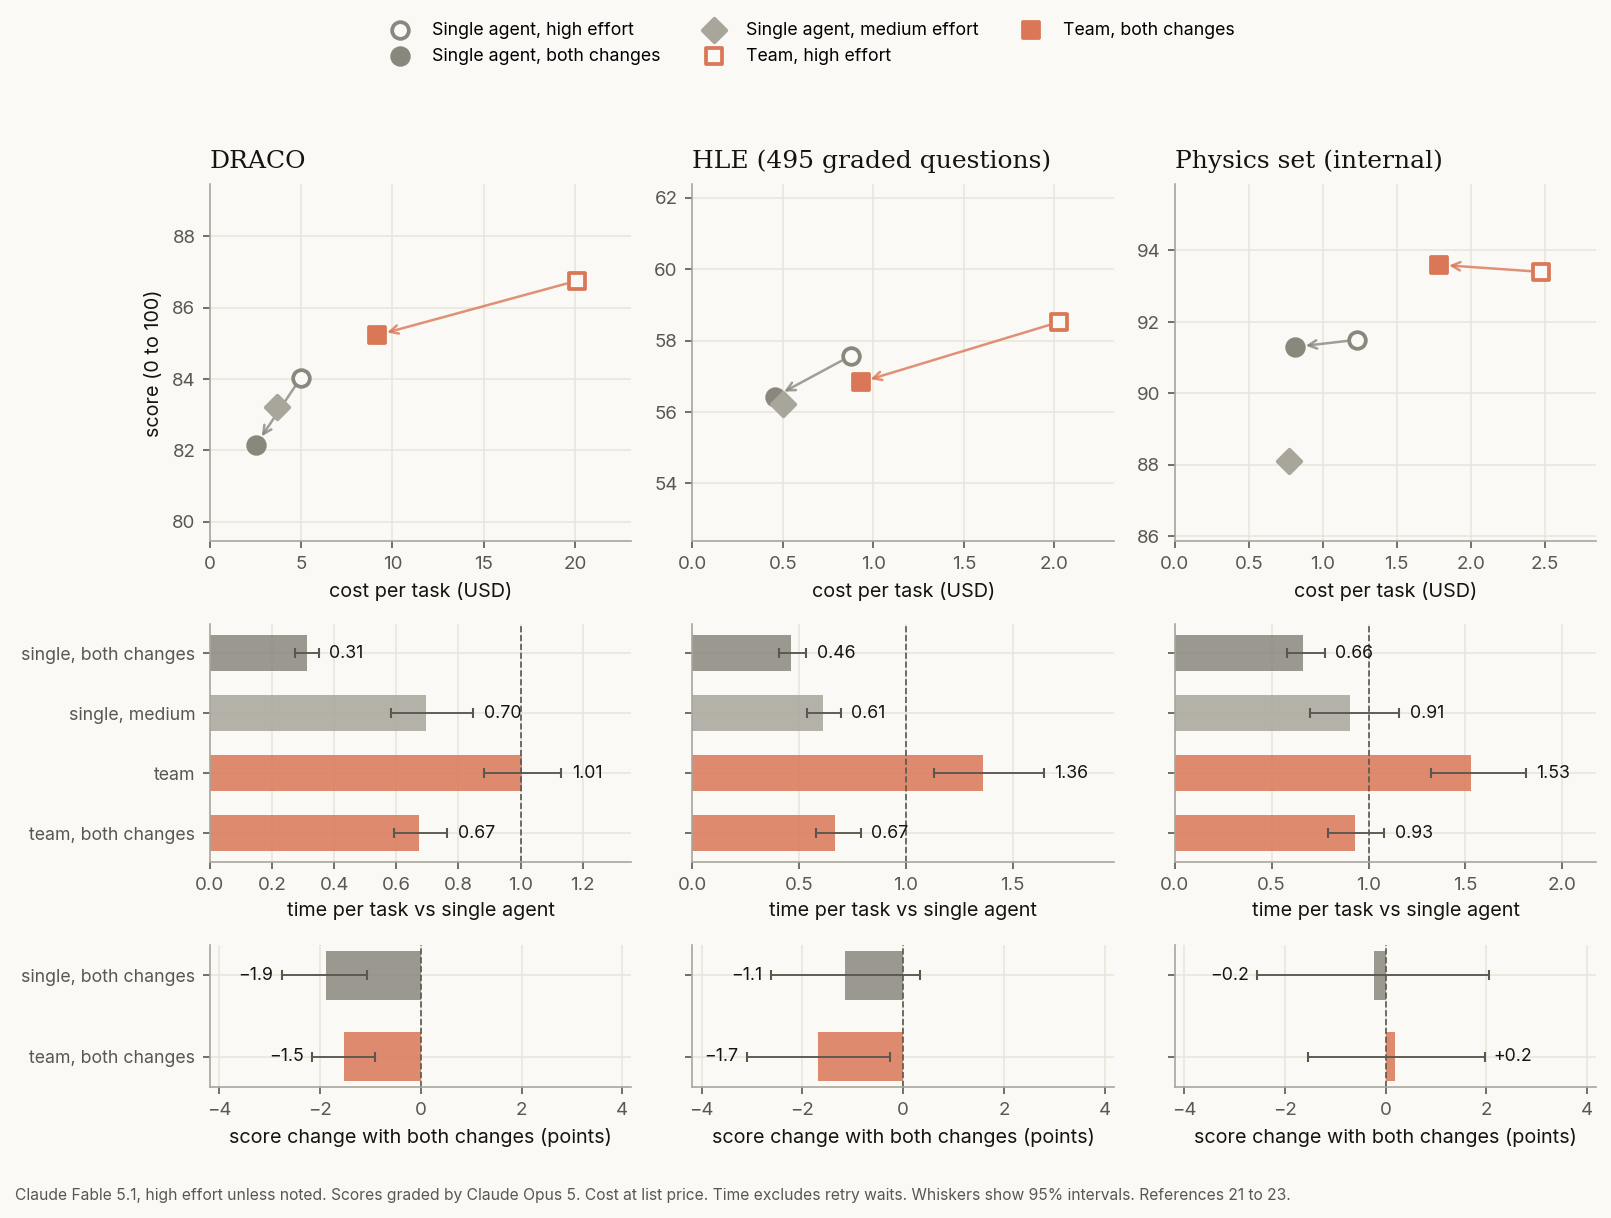
使用智能体团队时。 团队比单个智能体做的工作更多,因此默认情况下成本更高。在 DRACO 上,团队的成本是单个智能体的 4.0 倍,耗时大致相同(95% 区间为少 12% 到多 13%)。为每个智能体加上指令和时钟后:
- DRACO: 团队的耗时减少 33%,每个任务的成本降低 54%。得分低 1.5 个百分点(95% 区间为低 0.9 到 2.1 个百分点),区间的远端(低 2.1 个百分点)超出了 1.5 个百分点的容差。
- HLE: 团队的耗时减少 51%,每个任务的成本降低 54%。得分低 1.7 个百分点(95% 区间为低 0.3 到 3.1 个百分点),区间的远端(低 3.1 个百分点)超出了 2.5 个百分点的容差。
- 物理题集23: 团队的耗时减少 39%,每个任务的成本降低 28%。这一节省取决于提示缓存在请求之间过期的频率;如果缓存从不过期,节省将为 23%。得分高 0.2 个百分点(95% 区间为低 1.5 到高 2.0 个百分点)。
在 DRACO 上,主智能体每次尝试启动的辅助智能体数量中位数为 4,因此 DRACO 的结果反映的是团队并行工作的情况。在 HLE 和物理题集上,这一中位数为 0,也就是说至少一半的团队运行中只有主智能体在工作。因此,这两组团队结果主要反映的是主智能体自身的行为,而不是并行辅助智能体的效果。
使用单个智能体时。
- 物理题集23:
- 两处改动使单个智能体的耗时减少 34%,每个任务的成本降低 34%,得分低 0.2 个百分点(95% 区间为低 2.5 到高 2.1 个百分点)。
- 降低努力程度节省了成本,但没有明显节省时间。在
medium努力程度下,单个智能体每个任务的成本比high低 37%,耗时少 9%(95% 区间为少 30% 到多 16%),得分低 3.4 个百分点(95% 区间为低 0.4 到 6.8 个百分点),区间接近零。 - 与
medium努力程度相比,在high努力程度下应用两处改动后,单个智能体的耗时少 27%(95% 区间为少 5% 到少 44%),每个任务的成本高 6%(95% 区间为低 12% 到高 27%),得分高 3.2 个百分点(95% 区间为低 0.1 到高 6.5 个百分点)。
- HLE:
- 两处改动使单个智能体的耗时减少 54%,每个任务的成本降低 48%,得分低 1.1 个百分点(95% 区间为低 2.6 到高 0.3 个百分点)。区间的远端(低 2.6 个百分点)略微超出了 2.5 个百分点的容差。
- 在
medium努力程度下,单个智能体每个任务的成本比high低 43%,耗时少 39%,得分低 1.3 个百分点(95% 区间为低 2.8 到高 0.1 个百分点)。 - 与
medium努力程度相比,在high努力程度下应用两处改动后,单个智能体的耗时少 25%(95% 区间为少 12% 到少 35%),每个任务的成本低 9%(95% 区间为低 21% 到高 6%),得分高 0.2 个百分点(95% 区间为低 1.3 到高 1.7 个百分点)。
- DRACO:
- 两处改动使单个智能体的耗时减少 69%,每个任务的成本降低 49%,得分低 1.9 个百分点(95% 区间为低 1.1 到 2.8 个百分点)。区间的远端(低 2.8 个百分点)超出了 1.5 个百分点的容差。
- 在
medium努力程度下,单个智能体每个任务的成本比high低 25%,耗时少 30%,得分低 0.7 个百分点(95% 区间为低 0.1 到 1.3 个百分点)。 - 与
medium努力程度相比,在high努力程度下应用两处改动后,单个智能体的耗时少 53%(95% 区间为少 42% 到少 63%),每个任务的成本低 31%(95% 区间为低 28% 到低 35%),得分低 1.2 个百分点(95% 区间为低 0.5 到 1.9 个百分点)。区间的远端(低 1.9 个百分点)超出了 1.5 个百分点的容差。
在全部三个题集上,high 努力程度下应用两处改动节省的时间都多于改用 medium 努力程度:
- 成本: 在 HLE 和物理题集上没有明显差异,在 DRACO 上更低。
- 得分: 在 HLE 上大致相同。在物理题集上高 3.2 个百分点,但该区间包含零,因此差异并不明确。在 DRACO 上,应用两处改动的单个智能体比
medium努力程度低 1.2 个百分点(95% 区间为低 0.5 到 1.9 个百分点)。
因此,对于单个智能体,时钟节省的时间比降低努力程度更多。
何时使用。
- 当智能体的耗时很重要、且可以接受小幅得分变化时,请同时使用这两处改动。在所有测量过的配置中,无论是团队还是单个智能体,它们都降低了耗时和每个任务的成本。
- 在采用之前,请先在您自己的任务上检查得分。在 DRACO 上,团队的得分低 1.5 个百分点,单个智能体低 1.9 个百分点。在 HLE 上,团队低 1.7 个百分点,单个智能体低 1.1 个百分点。在物理题集上,两者的得分变化都与零没有明显差异。
- 如果您已经在考虑通过降低努力程度来节省时间,请先与时钟方案进行比较。在
high努力程度下应用两处改动的单个智能体,耗时比medium努力程度更少:DRACO 上少 53%,HLE 上少 25%,物理题集上少 27%。其每个任务的成本在 DRACO 上低 31%,在 HLE 和物理题集上没有明显差异。
如何添加。 将以下指令放在每个智能体系统提示的开头:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.第二句话告诉模型会有时钟消息。第一个请求不携带时钟,测量运行使用的正是这段措辞。
然后,从智能体的第二个请求开始,在每个请求之前追加一条对话中途系统消息,以整秒为单位给出已用时间,例如 Elapsed time: 412 seconds。请从任务开始时计时,而不是从智能体启动时计时。在团队中,每个智能体读取的是同一个时钟,因此辅助智能体看到的第一个时钟已经包含了它启动之前团队花费的时间。在工具循环中,请将该消息紧跟在携带工具结果的 user 消息之后,如放置在工具结果之后所示。如果您改为向智能体发送新的 user 消息,请将时钟放在该消息之后。
请保留之前的时钟消息,不要移动或删除。每条时钟消息都会成为对话历史的一部分,因此下一个请求仍能命中缓存的前缀(请参阅与提示缓存结合使用)。Anthropic 测量的是这种普通系统消息,它们对模型始终可见。轮次作用域系统消息只会向模型显示最新的时钟,Anthropic 没有测量这种形式。
以下示例运行一个应用了两处改动的智能体工具循环。它在工具结果之后添加时钟,并且只处理客户端工具:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # 使用挂钟时间(秒),以便其他进程中的辅助程序能共享主进程的开始时间。
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # 使用流式传输,因为 128,000 令牌的上限对非流式请求而言过大。
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # 系统消息必须跟在用户轮次之后,因此时钟信息放在工具结果之后。
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 支持对话中途系统消息,其他支持的模型请参阅支持的模型列表。对于不支持该功能的模型(例如 Claude Sonnet 5),您可以将同样的内容放在 user 轮次中最后一个 tool_result 块之后的文本块中。Anthropic 只测量了系统消息形式。
在 Claude Managed Agents 上,您可以随工具结果或用户消息一起发送 system.message 事件。该消息会作用于当前轮次及之后的每个轮次。因此,在平台内置工具(例如网络搜索)之后的轮次中,模型看到的是您最后发送的时钟,而不是当前时间。此外,system.message 只会到达会话的主线程。在多智能体会话中,主线程是协调者的线程,因此工作智能体永远看不到以这种方式发送的时钟。如果要在每个轮次之前、向团队中的每个智能体显示当前时间,请在 Messages API 上自行运行智能体循环。
组合模型
多模型架构适合任务复杂度变化足够大、以至于不同步骤最好由不同模型处理的工作负载。当您的流量混合了较小模型能可靠处理的常规工作与需要前沿能力的较难步骤时,拆分工作可以将前沿智能保留在重要之处,同时大多数令牌按较小模型的费率计费。当工作负载缺乏这种混合(因为其难度均匀,或者它是一条相互依赖的链)时,单个调优良好的模型通常是更好的选择。每个策略小节都给出了区分这两种情况的规则。
两种策略覆盖了大多数工作负载,它们的区别在于哪个模型持有主循环:
| 策略 | 控制流 | 前沿模型的角色 | 适合 | 前沿成本随之增长的因素 |
|---|---|---|---|---|
| 顾问(Advisor) | 较小模型运行循环,按需升级 | 被咨询以获取计划和纠正 | 局部困难的串行工作,例如编码智能体在少数真正决策之间的许多轮次 | 执行器卡住的频率 |
| 编排器(Orchestrator) | 前沿模型运行循环,委派大批量工作 | 规划、分派和综合 | 可扇出到真正独立的文件、文档或案例的工作,尤其是超过一个上下文窗口的工作 | 各部分协调的难度 |
顾问策略:升级处理困难决策
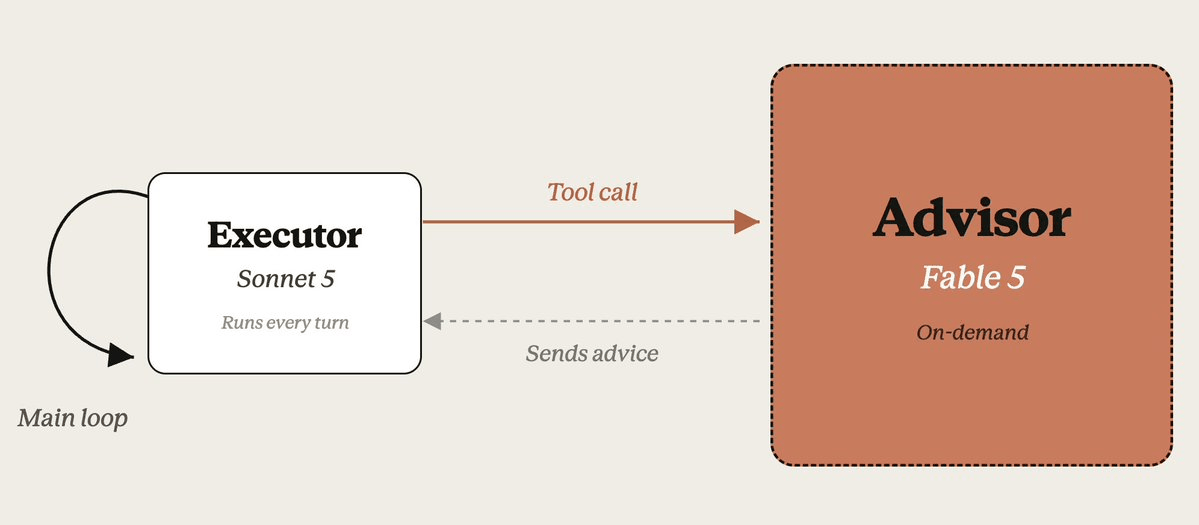
在顾问策略中,由成本较低的 "executor"(执行器)模型运行智能体循环,并执行大部分轮次。当执行器遇到需要更深入判断的决策时,例如选择方案或从失败中恢复,它会调用智能更高的 "advisor"(顾问)模型获取策略指导,然后继续工作。大部分令牌按执行器的价格计费,只有偶尔的咨询按顾问的价格计费。
要使用该策略,请在请求中添加顾问工具。这项 beta 功能在一个 /v1/messages 请求中于服务器端运行整个策略:执行器发出工具调用,Anthropic 运行顾问推理,执行器再根据建议继续工作。您无需编写任何编排代码。在 Claude Managed Agents 上,您可以在智能体的 multiagent 名册中添加一个 advisor 条目,从而为会话提供顾问,会话的主线程会以同样的方式咨询它。Claude Code 也支持该策略,请参阅使用顾问工具升级处理困难决策。
收益取决于什么。 顾问只能通过执行器的调用了解任务,因此有两个因素决定它能帮上多少忙。
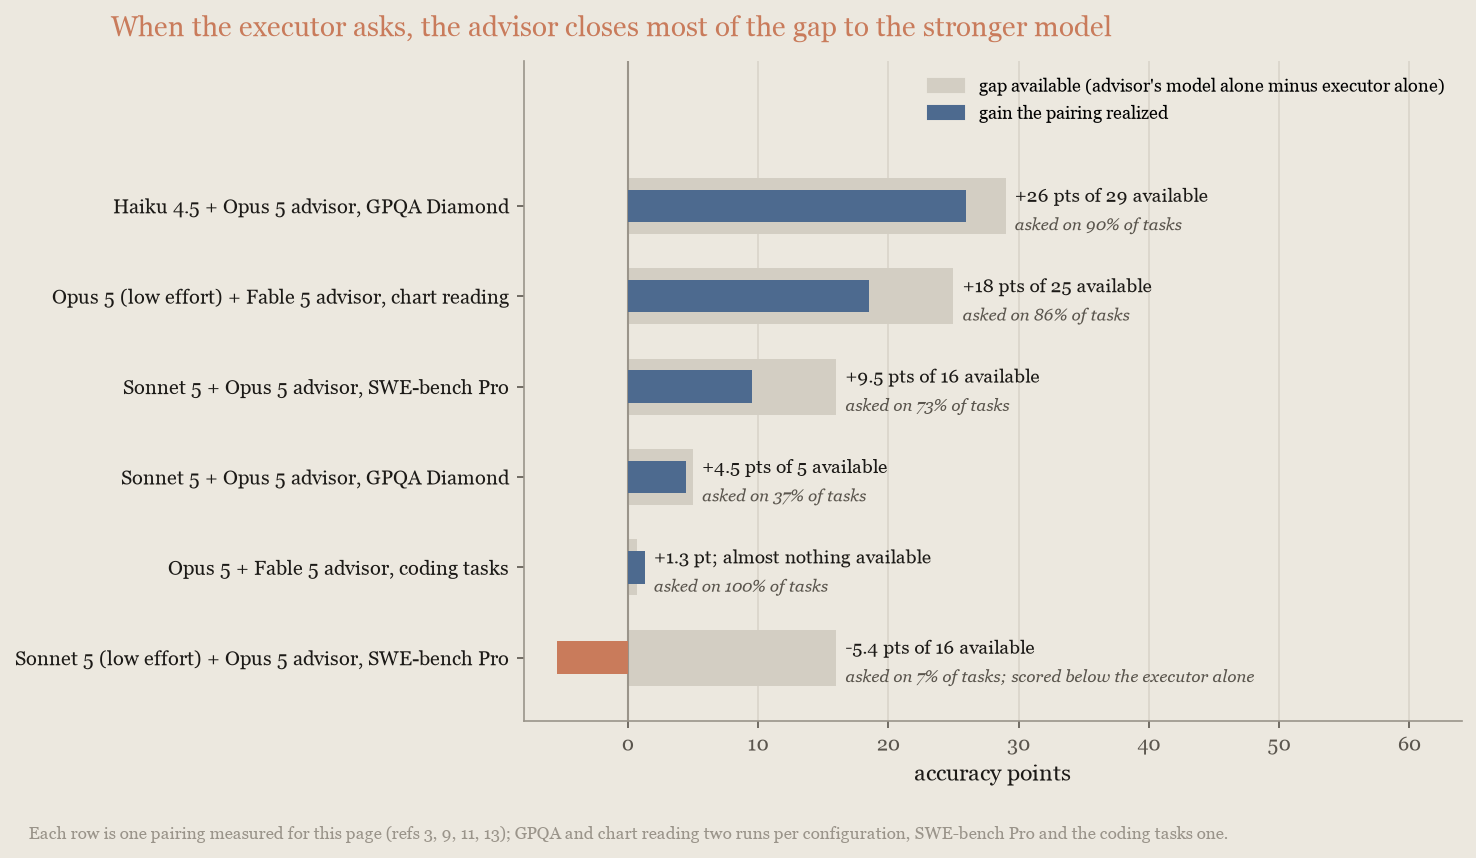
第一个因素是两个模型之间的能力差距。顾问只能补上执行器所欠缺的能力。在 GPQA Diamond9 上,Claude Opus 5 顾问让 Claude Haiku 4.5 执行器获益很大,让 Claude Sonnet 5 执行器提升了几个百分点,而对前沿执行器几乎没有帮助。
第二个因素是执行器是否真的会发起咨询,即 "consult rate"(咨询率),这也是更脆弱的一个因素。低努力程度下的执行器可能察觉不到自己卡住了:某个组合在默认努力程度下会在大多数任务上发起咨询,降低努力程度后可能几乎不再咨询,得分反而低于单独使用执行器。咨询率也因任务而异:在 DeepSWE10 上,低努力程度的 Sonnet 5 执行器持续发起咨询,得分提升了 23 个百分点;而在 SWE-bench Pro3 上,同一执行器停止了咨询。只要执行器发起咨询,就能弥补大部分差距。在下图中,凡是执行器持续发起咨询的组合,顾问都弥补了与更强模型之间至少一半的差距,其中编码组合甚至直接超过了更强的模型。而您只需在咨询时为更强的模型付费,这正是成本节省得以实现的原因:
咨询率会受提示影响。如果只依赖工具的内置描述,执行器的调用次数会偏少,在编码工作中尤其如此。因此,顾问工具文档提供了一段系统提示,要求执行器在开始实质性工作之前调用一次、在完成之前再调用一次,每个任务大约调用两到三次。下文测量的编码组合就采用了这一节奏:以 Claude Opus 5 作为执行器时,每个任务大约咨询两次;以 Claude Opus 5.5 作为执行器时,每次尝试平均咨询约 1.4 次,有 4% 的尝试没有获得任何建议。该页面还介绍了如何引导调用不足的执行器,以及如何在客户端限制调用次数以控制成本。因此,请关注咨询率:通过提示引导它,测量它,如果它骤降,请恢复执行器的努力程度。
何时能节省成本。 当几次简短的咨询(按顾问价格计费)可以替代在整个任务中运行顾问模型时,顾问策略就能节省成本。顾问模型的价格远高于执行器时,效果最好,因此最具成本效益的配置是前沿顾问搭配中端执行器。即使是顶端模型之间的组合,也能收回部分建议成本,因为建议同样能节省执行器的令牌:知道正确方案的执行器会少走弯路。
- 在下文以 Claude Opus 5 为执行器的编码组合中,这部分节省抵消了约一半的建议成本:执行器每次尝试比默认设置下单独使用 Opus 5 少花 $1.26,而咨询花费 $2.47。
- 以 Claude Opus 5.5 为执行器时,建议几乎没有节省执行器成本:每次尝试 $1.36,而在
high下单独使用 Opus 5.5 为 $1.38,咨询则花费 $1.55。
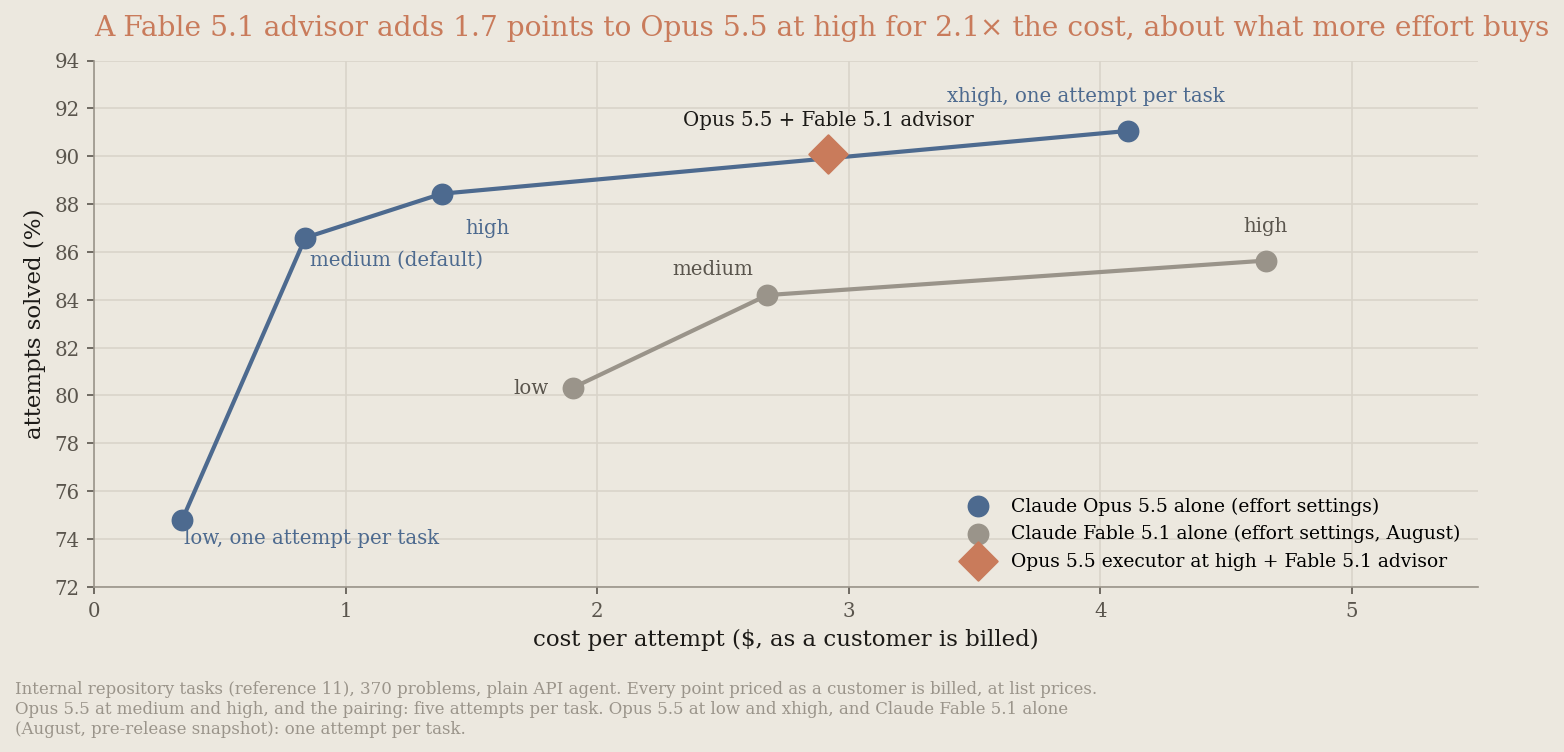
在一个内部智能体编码基准测试11上,使用普通 API 智能体运行时,high 下的 Claude Opus 5.5 执行器搭配 Claude Fable 5.1 顾问,得分为 90.1%,每次尝试 $2.92。
- 与执行器自身设置(
high)下单独使用 Opus 5.5 相比,得分高 1.7 个百分点,花费约为 2.1 倍。在每个任务尝试五次的情况下,这一差距处于运行间噪声的边缘。 - 与默认设置
medium下的 Opus 5.5 相比,得分高 3.5 个百分点,花费约为 3.5 倍。
该组合大致落在 Opus 5.5 自身的努力程度曲线上,也就是说,顾问带来的收益与提高努力程度大致相当:xhigh 下单独使用 Opus 5.5 的得分为 91.1%,每次尝试 $4.11(每个任务尝试一次)。在 8 月的测量中,Claude Fable 5.1 顾问搭配 Claude Opus 5 执行器是准确率最高的配置,每次尝试 $6.21,略高于 Opus 5.5 组合成本的两倍。下图将 Opus 5.5 组合与 Opus 5.5 自身的努力程度曲线,以及 8 月测得的 Claude Fable 5.1 曲线进行了对比:
早先通过 Claude Code 的顾问模式进行的测量中,顾问组合的排名同样高于其中任一模型单独使用。请把 Claude Opus 5.5 的结果当作一种需要在您的工作负载上验证的规律:顾问能带来几个百分点的提升,花费约为单独使用执行器的两倍。能力差距更大,并不保证性价比更高。延迟方面的代价就是咨询本身:在该基准测试上,每个任务大约多出一到两次前沿模型调用,而且每次调用都位于任务的关键路径上。
何时单独使用更强的模型更好。 如果工作负载的准确率会随努力程度变化,请在构建组合之前,先将其与以较低设置单独运行顾问模型进行比较。顾问只在需要它的任务上计费,但如果大多数任务都会触发咨询,成本就会高于直接运行更强的模型。
- 在 Chartography13 上,
low下的 Claude Opus 5.5 执行器搭配 Claude Fable 5.1 顾问,在 300 个任务中只咨询了 1 次,得分为 61.7,比单独使用 Opus 5.5 低 7 个百分点,超出了运行间噪声,而成本大致相同。 - 在 8 月的测量中,Claude Opus 5 执行器几乎在每个任务上都发起了咨询。该组合的得分与
medium下单独使用 Fable 5.1 在运行间噪声范围内相当(65.0 对 67.5),每个任务的成本约为后者的 1.8 倍。
请先测量您自己的咨询率:如果执行器在大多数任务上都会发起咨询,您实际上是在整个工作负载上支付顾问价格,而直接运行顾问模型是达到相同得分的更便宜方式。
无论采用哪种组合,都请先计算以低努力程度单独运行顾问模型的成本,这就是需要超越的基线。每次有新模型发布时都请重新检查,因为新版本会同时改变能力差距和价格比。
适用场景。 顾问策略适合大多数轮次都是机械性操作、但出色的计划至关重要的工作负载,例如编码智能体、计算机使用和多步骤研究流水线。以下情况不太适合使用顾问策略:
- 每个轮次都确实需要前沿能力。
- 没有需要规划的内容,例如单轮问答。
- 执行器的能力已经接近顾问。
编排器策略:委派批量工作
在 "orchestrator"(编排器)策略中,"frontier model"(前沿模型)掌控循环。它分解任务,将子任务分派给成本较低的 "worker"(工作)模型,并合并它们的结果。编排器自身的对话记录保持简短,因为工作模型承担了令牌密集的探索工作。因此,大部分令牌按工作模型的费率计费,而计划和综合仍由前沿模型完成。
要构建编排器,请使用 Claude Managed Agents 中的多智能体编排:配置一个协调者智能体(即编排器)和一组工作智能体,每个智能体使用各自的模型。有关使用前沿协调者和 Claude Sonnet 5 工作智能体的完整可运行示例,请参阅 Claude Cookbook 中的示例协调者模式:大模型负责规划,小模型负责执行。
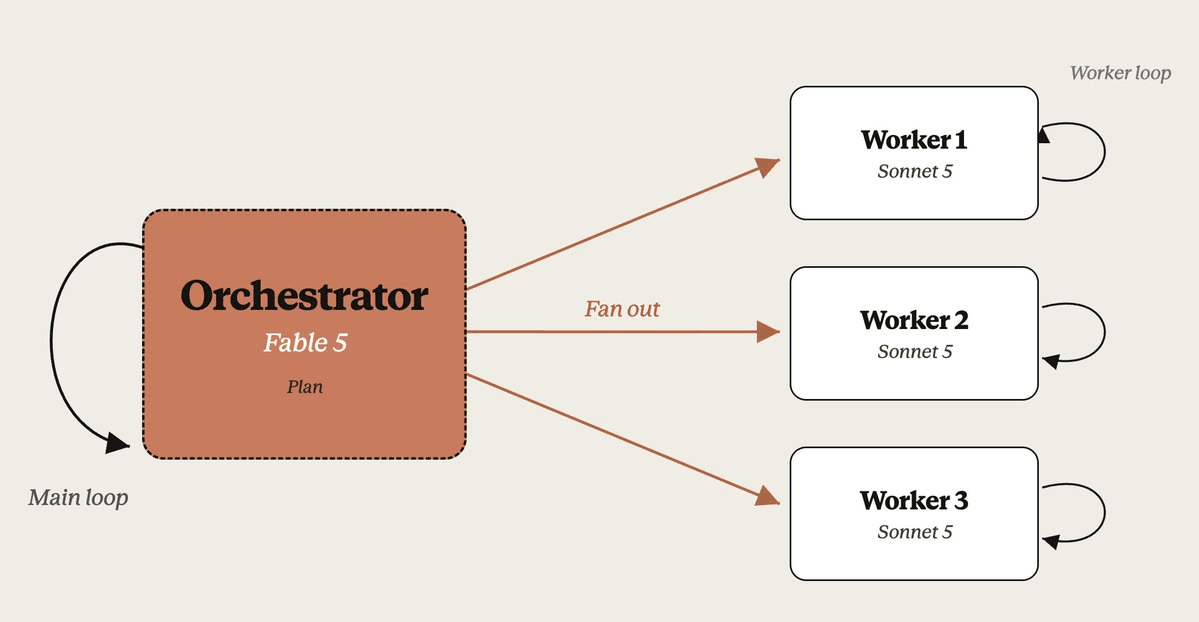
当工作模型可以并行运行时,此模式可以节省 "wall-clock time"(实际耗时)。在语料库基准测试8中,协调者以平台文档规定的上限(25 个并发工作模型)运行时,一个回合耗时约 2.3 小时,而单独运行则需要 15 到 20 小时。不过,它仅在两种测量情形下节省了费用。对于单个模型就能独立处理的工作,同一模型以较低的努力程度运行,每次都更便宜。
当工作模型并行运行时,时间指令和已用时间时钟可以缩短运行时间。在 DRACO21 上,一个由相同模型组成、带有该指令和时钟的智能体团队,完成时间缩短了 33%,每个任务的成本降低了 54%,得分则低 1.5 分。该团队中的每个智能体都有该指令和时钟。Anthropic 没有测量在低成本工作模型上使用时钟的效果。在 Claude Managed Agents 上,时钟只会传达给协调者,因此工作模型永远看不到它。Anthropic 也没有测量只有协调者拥有时钟的团队。此外,协调者的时钟仅在紧随您自己的工具结果或消息之后的轮次中才是最新的。向模型显示已用时间提供了在 Messages API 上运行智能体循环的实现方法。
情形 1:为常规工作的成本长尾提供保险。 单独运行的前沿模型偶尔会在它通常能解决的常规问题上陷入失控循环。由于您无法提前知道哪些问题会出现这种情况,少数此类运行会占据账单的大部分。协调者将常规工作交给低成本工作模型,可以限制这一长尾,因为任何失控现在都按工作模型的费率计费。
Anthropic 在 BrowseComp4 中一个刻意选取的简单子集上测量了这一点(10 个单独模型能可靠解决的问题;50 次委派运行和 70 次单独运行)。一个 Claude Fable 5 协调者搭配一个 Claude Sonnet 5 工作模型,平均成本约为 Claude Fable 5 单独运行的一半,在第 90 百分位约为三分之一($12 对比 $33)。而单独模型最昂贵的一次运行花费 $84,结果还是错误的:
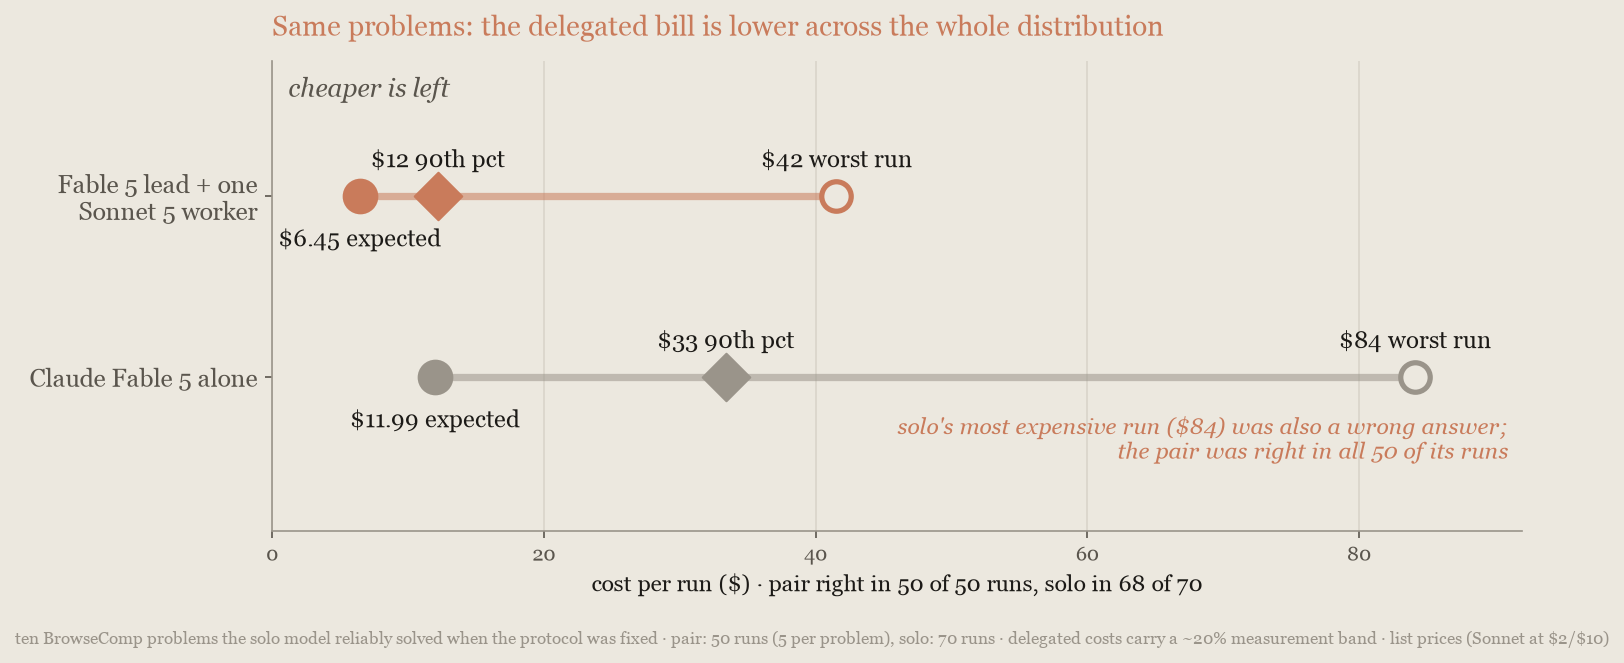
委派在常规的、通常可解决的那部分工作上带来了回报,这与"工作模型用于解决难题"的直觉恰恰相反。在完整的、更难的 BrowseComp 集上,经济效益发生了逆转。如果您的流量在常规任务上存在较长的成本长尾,应首先测量这种编排器情形。
情形 2:超出单个上下文窗口的工作。 面对如此大的输入,单独模型只能串行处理,一次处理一个上下文窗口,并在每一轮都要付费重新读取自己的状态。而工作模型各自并行读取自己的分区,并按工作模型的费率计费。如果阅读密集型工作仍能放入单个上下文窗口,那就是模型选择问题,而不是委派问题:仅就阅读成本而言,只有当任何单个上下文都无法容纳该工作时,编排器才更具优势。
Anthropic 为此情形构建了一个基准测试8:一个 2160 万令牌的语料库,包含 14 个公开 Python 包,其中植入了 130 个缺陷,对任何上下文窗口来说都太大。降低努力程度无济于事,因为账单主要来自语料库读取本身:Claude Fable 5.1 单独运行时,在三种努力程度设置下每个回合的成本为 $468 到 $552,变化的只有准确率。协调者配置(一个 Claude Fable 5.1 主导者管理 25 个 Claude Sonnet 5 工作模型)的成本约为这些设置的一半(低 47% 到 55%),得分比它们低 10 到 12 分,每个回合耗时约 2.3 小时(单独运行需要 15 到 20 小时),同时完全超越了 Claude Sonnet 5 单独运行的基线:
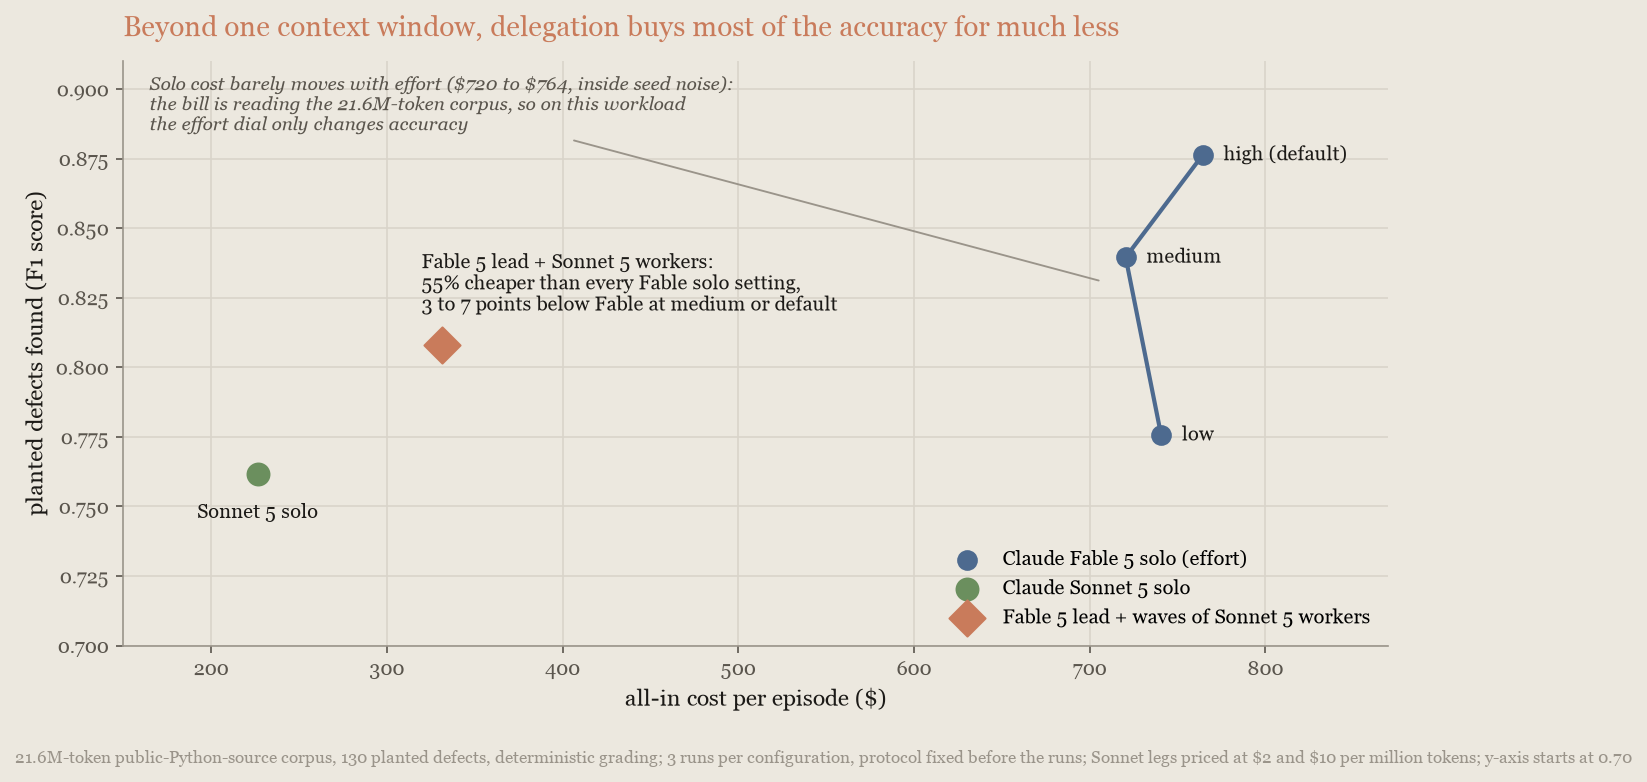
令牌统计显示了阅读的规模:协调者配置每个回合读取约 5.6 亿个缓存令牌,约为单独模型(约 3.65 亿个)的一倍半,其中几乎全部按 Claude Sonnet 5 的缓存读取费率计费,总体成本仍约为单独模型的一半。high 努力程度下的 Fable 5.1 仍保持最高准确率,但成本约为协调者配置的 2.2 倍。因此,这里的委派换来了大部分准确率,而非全部。
委派何时不划算。 只有当存在可以移交的批量工作时,编排器才有价值:工作应包含许多独立的部分,理想情况下多到单个上下文窗口无法容纳。如果工作是一条相互依赖的链,或者能放入单个上下文,编排器就要为计划、移交和合并付费,而单个模型无需这些开销。在所有测量过的此类情形中,协调者所用的模型以较低努力程度单独运行都更具优势。
分界线在于任务难度,而非基准测试:在完整的、更难的 BrowseComp4 集上,Claude Fable 5 单独运行就达到了协调者配置的准确率,成本还低 22% 到 30%。独立的外部研究也报告了相同的模式5。如果工作是一条链,或者能放入单个上下文且没有较长的成本长尾,又或者单个模型以较低努力程度已能达到您的标准,就不要构建编排器。
在两种策略之间选择
大多数情形归结为一个问题:工作是拆分为独立的部分,还是通过一连串相互依赖的步骤得出一个答案?策略表将这两种答案映射到两种策略。
如果您不确定,先什么都不要构建:
- 先在您当前的模型上扫描努力程度。这是本页最便宜的实验,大多数工作负载到此为止。
- 如果扫描显示存在差距,为更强模型在低努力程度下单独运行定价。那是顾问配对必须超越的数字,而本页上超越它的配对都是执行器确实进行了咨询的那些。
本页的多模型结果是对照同一模型在较低努力程度下以及对照下一级模型单独运行来评判的。那是要在您自己的工作负载上运行的比较,也是第一步是努力程度扫描的原因。
当您确实添加顾问时,它是一个工具定义,而非一次架构重构。
在您自己的工作负载上进行测量
本页的数字反映的是测量时的标价,会随着模型和价格的变化而变化。您的升级率、任务拆分的清晰程度以及对话记录长度也会影响这些数字。但方法保持不变:
- 从生产日志中抽取一些任务,按真实流量加权,并为每个任务编写结果检查,例如测试通过、工单关闭、行数正确。在得分旁记录每个任务的成本:每个响应的
usage中有五种计价令牌数,请按各自费率计价(未缓存输入、5 分钟缓存写入和 1 小时缓存写入(分别为输入价格的 1.25 倍和 2 倍)、缓存读取以及输出),并对该任务的所有请求求和(用量和成本 API 会报告汇总值)。 - 在各努力程度级别(而不仅是默认级别)上为各模型层级建立基线,并绘制得分与支出的关系图。多模型配置必须超越单个模型的整条曲线。
- 如果曲线显示存在努力程度无法弥补的差距,请添加合适的多模型策略,并重新运行测试套件。
- 在正式切换之前,先在一部分流量上以影子模式运行胜出方案,之后保持测试套件持续运行。
以下示例按 Claude Opus 5.5 的标价计算单个请求在第 1 步中的成本:
# 每百万令牌价格取自定价页面;如需用于其他模型,请修改这三个值。
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 在 Claude Opus 5.5 上为输入价格的 0.05 倍;该倍数因模型而异
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1 小时缓存写入按输入价格的 2 倍计费,5 分钟缓存写入按 1.25 倍计费;读取按缓存读取价格计费。
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
在智能体循环中,大多数输入令牌应为缓存读取。如果 cache_read_input_tokens 远小于 input_tokens 与 cache_creation_input_tokens 之和,请检查缓存是否已生效,以及前缀在请求之间是否保持不变。启用顾问工具或压缩时,某些令牌仅在 usage.iterations 中报告,不计入顶层总计。因此,请改为对 usage.iterations 求和,并按顾问模型的费率为 advisor_message 条目计价。
下表按建议的尝试顺序列出了各项优化手段:
| 手段 | 在这些运行中的节省 | 质量代价 | 延迟 | 位置 |
|---|---|---|---|---|
| 提示缓存 | 在智能体循环上,成本降至原来的 1/2.7 到 1/5.3;在分诊运行上降低 83% | 无 | 更快 | 缓存重复的上下文 |
| 1 小时缓存时长 | 如果约每 20 个轮次中有 1 个发生在 5 分钟到 1 小时的暂停之后,且很少有间隔超过 1 小时,则比默认的 5 分钟时长更便宜。但有两个例外:在 Claude Fable 5.1 上,暂停只有几分钟时,保持 5 分钟缓存预热更便宜,暂停接近 1 小时时,1 小时时长更优;在 Claude Opus 5.5 上,如果每 20 个轮次中只有一两个发生在最长约半小时的暂停之后,保持 5 分钟缓存预热更便宜。在没有暂停的情况下,默认时长在 Claude Sonnet 5 上成本低 15%,在 Claude Opus 5.5 上低约 15% 到 18% | 无 | 暂停后仍保持预热 | 选择缓存时长 |
| 精简输入 | 在分诊运行上再降低 5 个百分点 | 无 | 无影响 | 精简输入和上下文令牌 |
| 在任务边界修剪过时的工具结果 | 在长分诊运行上降低 39%(压缩为 32%);在短循环上无效果 | 未测得 | 无影响 | 精简输入和上下文令牌 |
| 工具搜索 | 附加 500 个工具定义时降低 45%;使用 GitHub MCP 服务器时降低 20% | 无 | 无影响 | 精简输入和上下文令牌 |
| 通过代码执行处理数据文件 | 在一个 25 题的数据任务上降低 92% | 有提升,答对 25 题中的 25 题,而非 6 题 | 更快 | 精简输入和上下文令牌 |
| Batch API | 50% | 无 | 24 小时内返回结果 | 批处理可以等待的工作 |
| 针对当前模型审计提示 | 在测量的两次迁移中均降低 14% | 无;其中一次有提升 | 更快(工具调用轮次更少) | 针对当前模型审计提示 |
| 升级模型 | Opus 4.8 升级到 Opus 5:得分高 12 分,每个已解决任务的成本高 21%(low 下的 Opus 5 以约 30% 的成本超越 Opus 4.8);Sonnet 4.6 升级到 Sonnet 5:每个已解决任务的成本低 15%,得分高 5 分;Fable 5 升级到 Fable 5.1:每个已解决任务的成本低 43%,得分大致相同 | 有提升 | 无影响 | 升级模型 |
| 降低努力程度 | 知识工作:medium 降低 13% 到 31%,low 降低三分之一到一半;长时间编码:medium 降低约 30%,low 降低约三分之二,均相对于 high | 知识工作上降低 1 到 3 分,长时间编码上降低 2 到 8 分 | 更快 | 调整努力程度 |
| 重新运行失败任务 | 相比全部以 high 运行降低约 40%,通过率相同或略高 | 无 | 失败的任务需运行两次 | 以更高的努力程度重新运行失败的任务 |
| 任务预算 | 44% 到 58% | 3 到 6 分 | 更快 | 设置预算和输出上限 |
| 要求更简短的回答 | 在分诊运行上减少 39% 的输出令牌,降低 14% 的成本 | 无 | 更快 | 设置预算和输出上限 |
提高 max_tokens | 每个已解决任务的成本无节省,但能解决更多任务 | 在内部数据集上最多提升 22 分;在两个公开数据集上无提升 | 无影响 | 设置预算和输出上限 |
| 顾问 | 取决于能力差距和咨询率。编码组合的得分比 high 下单独运行的 Claude Opus 5.5 高 1.7 分,价格约为其 2.1 倍,大致相当于提高努力程度所能换来的效果;使用 Claude Opus 5.5 时,图表阅读组合几乎从不咨询顾问,得分比单独运行的 Opus 5.5 低 7 分 | 编码上有提升,图表阅读上有损失 | 每个任务约多一到两次调用 | 顾问策略 |
| 编排器 | 相比前沿模型约降低一半,适用于超出单个上下文窗口的情形和常规任务的成本长尾情形(后者在 Claude Fable 5 上测得) | 比前沿模型低 10 到 12 分 | 在大型输入上快得多 | 编排器策略 |
引用的基准测试
除非参考文献另有说明,测量结果均来自 Anthropic 内部对这些基准测试的运行。除非另有注明,成本均以美元计,按各基准测试运行时有效的标价计算;Claude Sonnet 5 的数据按每百万输入令牌 2 美元、每百万输出令牌 10 美元计算。标注为"notional USD"(名义美元)的图表按这些费率对每个请求的令牌数计价,而非报告实际账单。
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025。广泛的网络研究任务,根据多行表格的完整性和准确性评分;200 个问题,每种配置运行 3 次,运行于 2026 年 8 月 1 日至 2 日。成本集中度图表来自另一次单独的 20 个问题的运行,每个问题运行 3 次,运行于 2026 年 8 月 3 日至 4 日,成本根据每个请求的计费记录计算。
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025。知识工作交付物根据任务的"rubric"(评分标准)评分;对已发布的黄金集进行 210 个任务的运行,每个任务尝试一次,运行于 2026 年 8 月 2 日。由 Claude 模型评分,因此绝对分数可能与已发布的结果不同。
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025。为与 Anthropic 的"evaluation harness"(评估框架)兼容而选取的 482 个问题子集;分数不可与公开排行榜比较。它们也不可与 Claude Opus 5.5 系统卡中的 SWE-bench Pro 结果比较,后者来自在不同问题集上以
max"effort"(努力程度)进行的运行。Claude Opus 5.5 的数据为low、medium(其默认值)和high下两次运行的平均值,xhigh下使用一次运行,均运行于 2026 年 9 月 19 日至 20 日,每轮上限与 8 月的 Claude Opus 5 运行相同,为 16,384 个令牌;该上限截断了 2 次xhigh尝试,其他设置下没有截断。Opus 5.5 的运行使用了该基准测试的一个版本,其评分容器只能访问内部软件包镜像。该版本删除了一个测试需要访问在线网站的问题,另有三个问题的参考解决方案在该环境中失败,因此 Opus 5.5 的比较以及与之并列的 Claude Fable 5.1 数据使用剩余的 478 个问题。升级模型和顾问配对图表中的 Claude Opus 5 SWE-bench Pro 数据为其默认努力程度下两次运行的平均值,low下使用一次运行,均运行于 2026 年 8 月 4 日。升级数据逐任务来自 Opus 5.5 的运行:先用low,再对其失败的任务用high,在各运行配对中解决了 96.4% 至 97.5%,成本约 0.17 美元;先用medium,为 96.0% 至 97.1%,约 0.24 美元;high对其自身失败的任务重新运行,为 96.9%,0.31 美元;全部使用high,为 94.8% 至 95.8%,0.29 美元。此子集上的成本按客户组织的计量方式计价:根据运行自身的使用记录,每个请求的先前提示按缓存读取计价,其新令牌按 5 分钟缓存写入计价,并与客户账本进行了核对;评估组织自身的计量方式(在 2026 年 9 月 10 日之前,对 Claude Opus 5、Claude Fable 5、Claude Opus 4.7 和 Claude Opus 4.8 以 8,192 个令牌为块计费缓存读取)得出的这些模型运行的数据高出 1.4 至 1.8 倍;对于 Claude Fable 5.1、Claude Sonnet 5 和 Claude Sonnet 4.6,两者最多相差约 9%,对于 Claude Opus 5.5 的数据,两者在每个努力程度设置下的差异均在 3% 以内。顾问图表上的 Claude Sonnet 5 执行器配对来自此子集上的同一测量系列:Sonnet 加 Opus 5 配对运行了两次(2026 年 8 月 7 日和 8 月 8 日,一次运行和一次完全复现),低努力程度配对运行了一次(2026 年 8 月 8 日),Claude Sonnet 5 单独运行了两次(77.4%,两个 Pro 行的基线)。升级模型中的 Claude Fable 5 数据点是默认努力程度下三次运行的平均值,运行于 2026 年 8 月 26 日,计价方式相同。Claude Fable 5.1 任务预算数据为在同一子集上以默认努力程度每个预算运行一次(35,000 个令牌时运行两次),运行于 2026 年 8 月 26 日,以同日的一次无预算运行(92.1%,每个任务 1.10 美元)作为基线;较早在low努力程度下的一组运行(2026 年 8 月 21 日)在无预算时得分 88.6%,每个任务 0.48 美元。比较模型中的比较将该单次运行与同一子集上合并的两次 Claude Sonnet 5 运行配对;在 Fable 5.1 的默认努力程度下,这一对比较的结果相反,每个已解决任务的成本比 Sonnet 5 高 41%。升级阶梯为每个模型在其发布默认设置下运行一次(Opus 5 和 Sonnet 5 各两次,Fable 5 数据点如上所述),Opus 和 Sonnet 的运行在同一周、同一框架和同一组织中进行。 - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025。努力程度数据使用 500 个问题的切分,每种设置运行一至三次,运行于 2026 年 8 月 3 日,默认数据点合并了 2026 年 7 月 26 日至 27 日的两次运行。成本保险图表使用从 26 个问题的切片中选出的 10 个可稳定解决的问题,包括 50 次委派运行(2026 年 8 月 1 日至 2 日)和 70 次单独运行(50 次来自 2026 年 8 月 2 日至 3 日;20 次存档自 2026 年 7 月 12 日至 13 日和 8 月 1 日),期望每次运行成本为 6.45 美元对比 11.99 美元;委派数据的测量误差带约为 20%。
- 智能体架构扩展: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025。独立的外部研究,仅引用其关于委派何时不划算这一发现的方向,不引用任何数据。
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025。220 个问题涵盖 15 个领域,每个问题都结合了多行收集与多跳检索;在该基准测试的常设行集上测量,每种配置运行 3 次,运行于 2026 年 8 月 2 日(单工作模型团队数据点运行于 2026 年 7 月 26 日至 27 日)。
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026。其涵盖 22 个领域的 132 个研究任务根据源自专家的二元评分标准评分;在跨所有主题分层抽取的 50 个任务子集上测量,每个任务尝试一次,每种设置运行 3 次,在 Claude Managed Agents 上使用平台自带的网络搜索和获取工具(2026 年 8 月 26 日至 27 日);在没有任何配置拒绝的 33 个任务上评分,并移除了被生产安全分类器提前中断的尝试;成本为客户被计费的金额,即平台请求费用加网络搜索费用。分数为每个模型在 33 个任务基础上的平均值,并移除了其自身被抢先中断的任务;在所有组中都未受影响的 21 个任务上,Claude Fable 5.1 在每个努力程度下都比 Claude Fable 5 领先 2 至 3 分,且两个模型在不同努力程度下表现持平。缓存图表以未缓存费率对每个输入令牌重新计价相同的请求。Claude Opus 4.6 按照该基准测试的评分标准协议进行评判;原始基准使用不同的评判模型,而 Anthropic 的评判模型可能偏好自家风格。Claude Opus 5 在其默认努力程度下于 2026 年 8 月 28 日在相同平台和子集上运行了三次:原始 50 个任务上为 68.8%,33 个任务基础上为 70.8%,21 个任务集上为 71.1%,每个任务 6.71 美元(不使用缓存时为 23.72 美元);其尝试均未被安全分类器提前中断,所用的安全防护部署比其他模型运行时所用的更新。
- 语料库缺陷扫描: Anthropic 内部,用于超出单个上下文窗口的工作:一个 2,160 万令牌的语料库,来自 14 个公开 Python 软件包源码,植入了 130 个缺陷,采用确定性评分;协议在运行前确定并经过内部审查;每种配置运行三次。所有配置均在 Claude Managed Agents 上运行。图表中的团队配置是一次运行,其中 Claude Fable 5.1 协调者在平台内以其文档规定的上限(25 个并发 Claude Sonnet 5 工作模型)运行整个扫描,运行于 2026 年 8 月 30 日;其三个回合在额外项审计后的 F1 分别为 0.764、0.825 和 0.791(原始值为 0.751、0.821 和 0.781),成本分别为 225 美元、234 美元和 283 美元。Claude Sonnet 5 单独配置运行于 2026 年 8 月 3 日至 4 日;Claude Fable 5.1 单独配置运行于 2026 年 8 月 24 日至 25 日,采用平台发布时的服务设置,每个努力程度设置使用三个种子,使用相同的语料库构建。沙箱镜像中包含部分语料库的已安装副本,Claude Fable 5.1 的最终汇总步骤在 9 个回合中的 7 个中与这些副本进行了比较;去除这些添加内容后重新评分,受影响种子的分数变化最多 3 分。绝对 F1 特定于此语料库构建,不可跨基准测试比较;配置之间的比较是同类比较。
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023。198 个问题的 Diamond 子集,每种配置运行两次,运行于 2026 年 8 月 7 日(Claude Opus 5.5:2026 年 9 月 19 日),由模型根据参考答案评分,顾问令牌按请求计量。平台安全检查在 Claude Sonnet 5 执行器上拒绝了两个生物学问题,其中一个在 Claude Opus 5 上也被拒绝;排除它们后,任何比较的变化都不超过一分。Claude Opus 5.5 的 92% 来自两次设置了
fallbacks: "default"以选择启用服务器端回退的运行,任何仍以拒绝结束的尝试都计为错误。在每次运行中,安全检查标记了六个生物学问题,Claude Opus 5 通过回退回答了其中五个,第六个仍以拒绝结束。Opus 5.5 的每题成本包括这些回退回答。如果不将拒绝计为错误,这些运行得分为 93%,因为评分器仍会为被拒绝的尝试分配一个答案选项,而且通常是正确的选项。将拒绝计为错误时,Claude Opus 5 的运行得分为 91%(每次运行一次拒绝),关闭回退的两次 Claude Opus 5.5 运行也是如此,其中 Opus 5.5 每次运行拒绝了五到六个生物学问题。 - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026。该集合包含五种语言的 113 个原创任务,配有基于程序的验证器。配对各运行两次,运行于 2026 年 8 月 7 日,顾问令牌按请求计量,并使用客户端顾问循环而非顾问工具,计费方式相同。单模型努力程度扫描为单次运行,根据令牌数计价,是一种考虑缓存的近似值。每个任务的成本为运行总成本除以 113。
- 内部智能体编码基准测试: Anthropic 内部:370 个代码仓库任务,由仓库自身的测试评分。API 数据在 128,000 令牌输出上限下测量,每种配置运行一次:Opus 5 单独在默认努力程度下运行于 2026 年 8 月 9 日至 10 日,在
low和medium下运行于 2026 年 8 月 10 日;Claude Fable 5.1 单独在五个显式设置的努力程度值下运行于 2026 年 8 月 20 日(图表显示其中三个);配对运行于 2026 年 8 月 24 日至 25 日。Claude Opus 5.5 单独在全部 370 个任务上运行,时间为 2026 年 9 月 19 日至 20 日:在其默认努力程度(medium)和high下每个任务尝试五次,在low和xhigh下尝试一次(由于一次设置检查失败,每种设置下 370 个任务中有 369 个被评分)。以high运行的 Claude Opus 5.5 执行器搭配已发布的 Claude Fable 5.1 作为顾问(8 月的运行使用的是预发布快照),在相同日期每个任务尝试五次;一个任务未通过设置检查,因此共评分 1,845 次尝试。顾问因负载而被拒绝的 279 次尝试被重新运行,咨询超时的尝试则被保留,与 8 月相同。8 月的运行中,配对和 Claude Opus 5 对照组每个任务尝试五次,其他数据点尝试一次。8 月的配对平均每次尝试约咨询顾问两次;Claude Opus 5.5 配对请求了 1.39 次,收到了 1.35 次。成本按每次尝试计算。成本按客户组织的计量方式计价:根据运行自身的使用记录,每个智能体循环请求的先前提示按缓存读取计价,其新令牌按 5 分钟缓存写入计价,每次顾问调用(不使用缓存)则根据其记录的令牌计价,均按标价计算。Claude Code 数据为 2026 年 7 月 8 日至 23 日对相同任务的运行,每种配置运行一次,成本为近似值。 - 内部代码仓库任务基准测试(上限测量): 另一个 Anthropic 内部集合,包含约 130 个代码仓库任务,运行于 2026 年 8 月 20 日(Claude Fable 5.1)和 2026 年 9 月 19 日(Claude Opus 5.5,在其默认努力程度
medium下),使用普通的 API 智能体循环,每个任务尝试一次。Claude Fable 5.1 的运行在显式设置的默认努力程度下每个上限 135 个任务:16,384 令牌的数据为两次运行的平均值(两次均为 36.3%);64,000 和 128,000 的数据为单次运行(58.5% 和 60.0%)。六个问题在每次运行中都遭到安全拒绝,计为失败。Claude Opus 5.5 的 16,384 令牌数据为两次运行的平均值(分别评分 134 和 135 个任务),其 64,000 和 128,000 数据为单次运行(各 135 个任务);每次 16,384 令牌运行中有两次尝试以安全拒绝结束,计为失败。SWE-bench Pro 上限数据为 Claude Fable 5.1 在默认努力程度下每个上限运行一次,运行于 2026 年 8 月 26 日,使用从参考文献 3 的 482 个问题集中分层抽取的 100 个问题子集,不可与其分数比较;两个上限在默认设置下得分相同。图表中的每轮分布来自 Claude Opus 5.5 和 Claude Fable 5.1 在 128,000 下的运行:没有任何 Opus 5.5 轮次达到上限(最长约 61,000 个令牌,其 0.56% 的轮次超过 16,384),有一个 Fable 5.1 轮次达到 128,000(其 0.46% 的轮次超过 16,384)。 - Chartography: Surge AI, "Chartography," 2026。完整发布的 100 个问题集,测量于 2026 年 8 月 6 日和 9 日(Claude Opus 5 单独)以及 2026 年 9 月 20 日(Claude Opus 5.5),使用 Anthropic 在 Claude Managed Agents 上的实现(标准云沙箱;顾问配置使用 Managed Agents 顾问)。由 Claude Sonnet 4.6 代替参考评判模型进行评分,且基准测试在使用工具的情况下运行,因此此处的分数可在配置之间比较,但不可与已发布的排行榜比较。它们也不可与 Claude Opus 5.5 系统卡中的 Chartography 结果比较,后者使用不同的评分器并以
max努力程度运行。每种配置运行两次(Claude Opus 5.5 为三次),结果合并;运行之间的差异最多达 10 分。成本为例行运行该智能体的客户被计费的金额:每个图表的第一个请求从缓存中读取智能体共享的系统提示和工具,就像同一智能体的另一个会话在前 5 分钟内运行过时那样。单独运行一个图表时,使用 Claude Opus 5 或 Claude Opus 5.5 约多花 0.03 美元,使用 Claude Fable 5.1 约多花 0.12 美元。8 月的数据根据运行的使用记录以这种方式重新计价;评估组织自身的计量方式(在 2026 年 9 月 10 日之前以 8,192 令牌为块计费 Claude Opus 5 的缓存读取)高估了 Claude Opus 5 的成本。成本不包括沙箱时间,沙箱时间使 8 月运行的成本增加不到 1%。Claude Fable 5.1 单独运行来自 2026 年 8 月 24 日,采用平台发布时的服务设置,每种设置运行两次;六次尝试达到 15 分钟会话上限,得分为 0,每次运行中有两个图表在安全拒绝后由 Claude Opus 5 回答。搭配 Claude Fable 5.1 顾问的 Claude Opus 5 低努力程度执行器于 2026 年 8 月 30 日在相同设置下运行了两次(63.0 和 67.0,平均 65.0,每个图表 0.47 美元;每次运行中 88% 的任务咨询了顾问,其 219 条回复中有 4 条改由 Claude Opus 5 给出,每次都是在生产安全过滤器阻止了顾问自身的回复之后)。Claude Opus 5.5 以low运行,关闭服务器端回退,并由安全分类器评判每次工具调用:单独运行三次(70、68 和 68),配置 Claude Fable 5.1 顾问运行三次(59、63 和 63),其中它在 300 个任务中仅有 1 个咨询了顾问。较早配对的咨询率比较来自 2026 年 8 月 10 日至 11 日在 Messages API 上使用容器工具集重新运行相同配置的结果。 - 客服台提示审计评估: 一个由 Anthropic 构建的包含 44 个支持工单的集合,采用确定性评分,于 2026 年 8 月初运行并于 2026 年 8 月 8 日报告,使用六个系统提示,每个提示都在同一个干净提示的基础上添加一种在为 Claude Opus 4.8 和 Claude Sonnet 4.6 编写的提示中常见的模式。每个图表数据点是三种情况之一(旧模型、使用相同提示的新模型、审计后的新模型),在六个提示和 44 个工单上取平均值。Opus 5 准确率提升的 95% 置信区间为 3 至 8 分;Sonnet 的准确率差异在噪声范围内。
- 数据文件问题集: 一个由 Anthropic 构建的集合,包含 25 个聚合问题,针对一个公开酒类销售 CSV 的 1,862 行切片,真实值由 pandas 计算,采用精确匹配评分,在 Claude Sonnet 5 和 Claude Opus 5 上运行,禁用思考(上下文内组在默认设置下无法完成)、输出上限为 4,000 个令牌、不使用提示缓存,每种配置运行三次,运行于 2026 年 8 月 19 日。文件组通过 Files API 上传 CSV 并使用
code_execution_20260120工具。 - 缓存时长测量: 来自精简输入和上下文令牌的 20 个问题分诊任务,于 2026 年 8 月 23 日在 Claude Sonnet 5 上运行,并于 2026 年 9 月 19 日和 20 日在 Claude Opus 5.5 上以其默认努力程度(
medium)和high运行,在 Messages API 上使用相同的框架(对于 Claude Opus 5.5,使用发送相同请求体的移植版本),Claude Opus 5.5 单元格的max_tokens提高到 4,096,并在随机选择的一部分轮次之前插入暂停(两个模型在全部 20 个问题上均测试了无暂停、5%、10% 以及每轮暂停 6 分钟,Claude Sonnet 5 另外测试了每轮暂停 2 分钟;两个模型均在 5 个问题的子集上测试了 20 分钟和 45 分钟的暂停)。下文 Claude Opus 5 的保活数据来自 2026 年 8 月 23 日的同一任务,max_tokens提高到 4,096,使用除 2 分钟和 45 分钟暂停外的相同计划。每个单元格运行三次,成本根据每个响应的usage字段按标价计算(对于 Claude Opus 5.5,每百万令牌输入 4 美元、5 分钟写入 5 美元、1 小时写入 8 美元、缓存读取 0.20 美元、输出 20 美元;Claude Sonnet 5 在 Anthropic 内部组织上运行,其使用量的计量方式与客户组织相同),准确率根据相同的黄金标签计算。本页上的 Claude Opus 5.5 数据涵盖两个努力程度。交叉点在 Claude Sonnet 5 上约为 3.3% 的轮次,在 Claude Opus 5.5 上为 3.1% 至 3.2%:即每个会话盈亏平衡比例的中位数,由成本模型根据该会话逐轮的上下文大小计算,涵盖全部 45 个 Claude Sonnet 5 二十问题会话以及每个努力程度下的 36 个 Claude Opus 5.5 二十问题会话(每种暂停计划都在完整任务上运行,涵盖全部三种缓存设置,各运行三次;5 个问题的单元格不包括在内)。在 5% 单元格中,5 分钟和 1 小时设置在 Claude Sonnet 5 上持平,因为该次抽样的暂停落在较小的前缀上;在 Claude Opus 5.5 上两者几乎持平。本页的"每 20 次中 1 次"规则高于测得的交叉点。未测量 Claude Opus 5.5 在暂停后的首个令牌时间。Anthropic 于 2026 年 8 月 23 日在 Claude Sonnet 5 和 Claude Opus 5 上,以及在上述运行中在 Claude Opus 5.5 上,测量了刷新 5 分钟缓存的保活请求,这些请求始终以max_tokens: 1发送。在 Claude Sonnet 5 上,当 5% 的轮次有暂停时,它们的成本比 1 小时设置低 7.7%,当 10% 的轮次有暂停时成本大致相同;在 Claude Opus 5 上,两种比例下均未测得差异;在这两个模型上,当每轮之前都有 6 分钟或更长的暂停时,它们的成本更高。在 Claude Opus 5.5 上,当 5% 和 10% 的轮次有暂停时,它们的成本比 1 小时设置低 8% 至 18%(通过按 1 小时缓存价格重新计费每个保活会话自身的令牌来消除会话间噪声后,约低 10% 至 15%),而当每轮之前都有暂停时成本更高:6 分钟时高 4% 至 6%,20 分钟时高 9% 至 10%,45 分钟时高 56% 至 58%。保活在 Claude Opus 5.5 上节省更多,因为每个保活请求都以缓存读取价格重新读取前缀:该价格为输入价格的 0.05 倍,而 Claude Sonnet 5 和 Claude Opus 5 上为 0.1 倍;Claude Opus 5 的会话按 Claude Opus 5.5 的价格重新计费后,显示出与 Claude Opus 5.5 几乎相同的节省。Anthropic 在 Claude Opus 5.5 上的发布前 API 测试表明,max_tokens: 0请求会写入缓存,且下一个请求会读取该缓存;此类请求是否会刷新现有条目未在 Opus 5.5 上测量。在 Claude Fable 5.1 上,缓存读取价格为 0.025 倍,即使每轮之前都有暂停,保活也更便宜,45 分钟暂停除外(参考文献 19)。 - 生产环境中的缓存读取占比: 截至 2026 年 8 月 23 日的 14 天内第一方 Claude API 使用量的汇总数据,仅限直接 API 产品,排除 Anthropic 内部组织,不识别任何组织。当某个组织日的请求携带工具定义和工具结果、其提示平均包含 9 次或更多先前工具调用、使用了缓存,且至少发出 10 个此类请求时,该组织日计为一个智能体循环(API 没有对话标识符,因此以此代替对话长度):106,487 个组织的 303,003 个组织日,缓存读取占全部输入令牌比例的中位数为 84.2%,上四分位数为 91.7%。用例标签(组织声明的用例,否则为其分类用例)覆盖了这些组织日的 74% 及其令牌的 99%;编码组织提供了 87% 的智能体输入令牌,读取比例中位数为 88.5%(在 25 次或更多先前工具调用时为 90.9%),上四分位数为 93.4%,约 72% 的编码组织日达到 80% 或更高;支持、研究和数据智能体的读取比例为 84% 至 85%。组织日的前十分位在编码方面读取比例为 95.9% 或更高,在支持、研究、数据和其他智能体方面为 94.2% 至 94.8%。25 次或更多先前工具调用时的请求级拆分来自一个六小时的样本:编码为 92% 读取、7% 写入、不到 1% 未缓存。未标记的组织(大多规模较小)读取比例中位数为 11%。没有工具定义的组织日读取比例中位数为 34.6%。在同一时间窗口内进行的一项独立查询重建了包含 10 个或更多请求的对话,而非对组织日进行统计,得出的中位数为 90.2%;差异在于范围,而非数据。
- 压缩时机测量: 来自精简输入和上下文令牌的分诊智能体的长版本,于 2026 年 8 月 24 日在 Claude Sonnet 5 上使用 5 分钟缓存运行,成本根据使用量字段按标价计算,每组五个会话:一个无变更组,全程使用默认努力程度(每个会话 0.81 美元),以及两个从低努力程度开始并进行相同两项破坏缓存的变更(切换到默认努力程度和添加一个工具)的组,变更要么在会话中途的第 12 和第 17 个请求进行(0.95 美元),要么在第一次压缩后的第一个请求上一起进行(0.75 美元)。第四组包含六个会话,运行于 2026 年 8 月 25 日,在触发第一次压缩的请求上进行相同的两项变更(每个会话 0.92 美元):该请求的摘要过程将 81,000 令牌的上下文写入缓存而非读取,因此该过程花费 0.21 美元,而边界组中相同过程花费 0.04 美元。会话在提示超过 80,000 令牌的压缩触发阈值后,于第 21 至 25 个请求首次压缩(21 个会话中有 16 个在第 22 个请求),两个无变更会话在接近结束时进行了第二次压缩。边界组的总成本低于无变更组,反映的是其变更前的低努力程度请求以及那些第二次压缩,而非缓存:两组的重写成本相差不到一美分。会话中途组每个会话在缓存重写上花费 0.23 美元;会话中途组与边界组之间的差异为 0.20 美元,95% 置信区间为 0.11 至 0.29 美元。会话中途组中有一个会话成本较低(0.82 美元),原因是其模型在压缩后错误调用了搜索工具并得到空结果;该会话被包括在内,若排除它,该组平均为 0.98 美元。8 月 24 日各组的准确率平均为 20 个标签中的 14.2 个,8 月 25 日组为 14.7 个;缓存读取占提示令牌的比例在无变更时为 91%,会话中途变更时为 85%,边界变更时为 91%,在触发请求上变更时为 86%。
- Claude Fable 5.1 上的缓存时长测量: 与参考文献 16 相同的 20 个问题分诊任务和框架,于 2026 年 8 月 23 日和 8 月 26 日在 Claude Fable 5.1 发布快照上按其发布价格运行(每百万令牌输入 10 美元、5 分钟写入 12.50 美元、1 小时写入 20 美元、缓存读取 0.25 美元、输出 50 美元),每种计划三种设置:5 分钟缓存、1 小时缓存,以及每 4 分钟(从上一个请求开始时计时)在未更改的前缀上发送
max_tokens: 0请求以保持预热的 5 分钟缓存(8 月 23 日的运行以max_tokens: 1发送保活请求;在此处报告的 8 月 26 日单元格中,每个保活请求都刷新了缓存且未计费任何输出)。计划:在全部 20 个问题上测试无暂停、10% 的轮次暂停以及每轮暂停 6 分钟,在 5 个问题的子集上测试 45 分钟暂停;每个单元格运行三次(8 月 26 日 45 分钟暂停的保活单元格运行六次),成本根据每个响应的usage字段按标价计算,准确率根据相同的黄金标签计算(20 个标签中精确匹配 12 至 17 个)。8 月 26 日 5 分钟、1 小时和保活设置的每会话平均值:无暂停为 2.42 美元、3.09 美元、2.29 美元;10% 暂停为 4.50 美元、2.96 美元、2.36 美元;每轮暂停为 22.89 美元、3.01 美元、2.62 美元;8 月 23 日的单元格与之相差在 6% 以内。45 分钟的数据(每个 5 问题会话 1.68 美元、0.59 美元和 0.71 美元)来自 8 月 26 日的一次干净重新运行,因为一次缓存计费事故破坏了当天的首批单元格;8 月 23 日的运行得出 1.67 美元、0.58 美元和 0.70 美元。5 分钟和 1 小时设置之间的交叉点为 3.1% 的轮次,与参考文献 16 的测量方式相同。 - Terminal-Bench 3: 该公开终端智能体基准测试的 74 个任务,在 Claude Managed Agents 上运行,使用两个自定义工具(一个 shell 和一个文件编辑器,由评估框架在每个任务自己的容器中运行)代替平台的内置工具,其他方面采用平台对外部账户的默认设置,每个模型在
high努力程度下运行两次,时间为 2026 年 8 月 27 日至 28 日。这些运行使用 Terminal-Bench 3.0 版本,其分数不可与公开的 Terminal-Bench 排行榜或 Claude Opus 5.5 系统卡中的 Terminal-Bench 4.0 结果比较,后者来自在 Claude Code 中以max努力程度进行的运行。每个任务的时间限制是基准测试自身限制的 2.5 倍,使智能体每个任务有 75 分钟到 20 小时的时间(中位任务为 5 小时),每个任务获得其指定内存的三倍,从 6 GiB 到 96 GiB 不等,运行辅助服务的 12 个任务还有额外内存。智能体没有一般的互联网访问权限:其容器可以访问内部软件包镜像、包括 GitHub 和 Python Package Index 在内的少量下载站点,以及某些任务特定的几个站点,其中八个任务完全没有网络访问。分数为每个模型 148 次尝试的原始通过率;单次运行的波动为 5 至 11 分。成本为客户按标价会被计费的金额,根据运行的使用记录以 5 分钟缓存生命周期逐请求重新计价。Claude Opus 4.7 的 148 次尝试中有 11 次因达到输出上限而结束。 - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026。其涵盖 10 个领域的 100 个研究任务根据专家编写的评分标准评分,分数为该基准测试的归一化分数。所有配置均在 Claude API 上使用 Claude Fable 5.1 运行,采用默认的自适应思考,开启生产安全分类器,
max_tokens为 128,000:单个智能体在high和medium努力程度下运行,单个智能体在high下附带指令和时钟运行,以及团队在high下附带和不附带这两者运行。团队是一个主智能体,它通过工具启动同一模型的辅助智能体,数量不设上限。在 DRACO 上,主智能体每次尝试启动的辅助智能体中位数为 4 个。每种配置对每个任务尝试三次,运行于 2026 年 9 月 8 日至 10 日。达到四小时限制的尝试会重新运行,以新的尝试为准。唯一被排除的尝试是单个智能体在medium努力程度下对某一个任务的全部 3 次尝试,因此该配置涵盖 99 个任务。该任务在原始运行和重新运行中的每次尝试都超时了。按照基准测试自身的评分方式将这 3 次尝试计为 0,只会影响与medium努力程度相关的两项比较。medium努力程度相对于high的分数变化从低 0.7 分变为低 1.7 分,同时进行两项更改相对于medium努力程度的分数变化从低 1.2 分变为低 0.2 分。智能体使用由评估框架基于固定网络索引托管的搜索工具和获取工具。这些工具决定了部分耗时,而您的工具运行速度会有所不同,因此本页以配置之间的比率而非分钟数给出时间。时间是每个任务的挂钟时间,从任何智能体的第一个请求到最后一个请求,减去在速率限制或过载错误后等待重试请求所花费的估计时间。这些错误来自测试账户的共享限制。一组中的所有配置同时开始。较慢的配置在数小时后才完成,因此其部分时间是在不同负载下运行的。每个任务的成本是其请求按公开标价计价的金额,提示缓存的计费方式与在每个请求末尾设置缓存断点并使用 5 分钟缓存生命周期的客户相同,仅计算模型令牌。框架的工具不产生额外费用。分数变化是任务间的配对差异,附带 95% bootstrap 区间。当变化的区间在 DRACO 上保持在 1.5 分以内、在 HLE 上保持在 2.5 分以内时,该变化被视为在误差范围内。Anthropic 在运行前设定了这些范围。Claude Opus 5 对答案进行评分。与每个集合自身的评分器相比,在每种配置中,Opus 5 在 DRACO 上的评分高 1.9 至 2.4 分,在 HLE 上低 2.2 至 2.9 分(Opus 5 评分了 500 个问题中的 495 个,而基准测试的评分器评分了全部 500 个),在物理题集上低 1.3 至 2.0 分(该集合自身的评分器也使用专家参考解答)。两个评分器在每项变化的方向上都一致。 - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025。专家编写的具有精确答案的问题,根据参考答案评分。在前 500 个问题上测量,在搜索中屏蔽了该基准测试自身的来源,其他设置与参考文献 21 相同。每种配置对每个问题尝试三次,运行于 2026 年 9 月 8 日至 10 日。Claude Opus 5 将每个答案与参考答案进行比较,并开启自适应思考(默认即开启)。评判模型在每种配置中评分了 500 个问题中的 495 个,分数涵盖这 495 个问题。对于其他 5 个问题,评分请求超出了评判模型 1M 令牌的限制。达到四小时限制的尝试会重新运行,以新的尝试为准,因此每种配置都有全部 1,500 次尝试。按照基准测试自身的评分方式将 5 个未评分的问题计为 0,不会改变任何结论。
- 物理题集: 一个包含 70 个研究级物理问题的内部集合,改编自公开的 CritPt 基准测试:Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025。专家审阅者修正了问题陈述。Claude Opus 5 根据未公开的专家参考解答对每个答案评分,因此分数不可与已发布的结果比较。分数是每个问题各次尝试的平均评分,再对所有问题取平均。在全部 70 个问题上测量,每个问题尝试四次,运行于 2026 年 9 月 8 日至 9 日。每个智能体在无网络访问的沙箱容器中拥有一个 Python 工具、一个 shell 和一个文件编辑器,没有搜索或获取工具。其他设置与参考文献 21 相同。物理题集在运行前未设定分数范围,因此本页给出其分数变化及 95% 区间,而不将其描述为在范围内。
后续步骤
本页最大的免费收益:设置、生命周期和诊断。
在单个模型内以智能换取延迟和成本。
评估整个 Claude 模型家族的能力、速度和成本。
为智能体循环提供一个可自我调节的令牌倒计时。
为 Managed Agents 会话设置硬性美元上限。
查看每个 Claude 模型当前的每令牌定价。
在可运行的 notebook 中将这些手段逐一应用于一个可工作的智能体,并在每一步后查看每任务成本。
观看顾问和编排器模式的演示讲解。
Was this page helpful?