Inference hooks
Envie cada prompt governado ao servidor de segurança de IA da sua organização para obter um veredito de permitir ou negar antes que a inferência prossiga.
Os "Inference hooks" (ganchos de inferência) permitem que uma organização Claude Enterprise encaminhe cada prompt governado por meio de um servidor de segurança de IA, um serviço HTTPS operado pela organização ou por seu fornecedor de segurança, antes que a inferência seja executada. Quando um usuário envia um prompt, a Anthropic envia a transcrição da conversa ao seu servidor de segurança de IA e aguarda um veredito de permitir ou negar; uma solicitação negada nunca chega ao modelo. Equipes de segurança e conformidade usam Inference hooks para aplicar políticas de dados inline, e desenvolvedores constroem o servidor de segurança de IA que avalia cada solicitação.
Como o hook é executado nos servidores da Anthropic, depois que a solicitação sai do cliente e antes que o modelo seja executado, ele se aplica a todas as solicitações governadas de forma uniforme, sem nada para instalar ou implantar nos dispositivos dos usuários.
Hoje, o único evento de hook é prompt, que dispara uma vez por solicitação de inferência governada, antes do início da inferência. A aplicação no lado da resposta está planejada como um evento posterior.
Como os Inference hooks funcionam
-
Um usuário envia um prompt em uma superfície governada.
-
A Anthropic envia um
POSTHTTPS ao endpoint do servidor de segurança de IA configurado pela sua organização. O corpo da solicitação contém a transcrição da conversa. Depois que sua organização gera o segredo de assinatura, cada solicitação é assinada de acordo com a especificação Standard Webhooks, para que seu servidor possa verificar que ela veio da Anthropic. -
Seu servidor de segurança de IA avalia o conteúdo e responde com um veredito dentro do tempo limite de veredito configurado pela sua organização (5 segundos por padrão).
-
Com
allow, a inferência prossegue normalmente. Comdeny, a solicitação é rejeitada e o usuário vê uma mensagem de bloqueio por política composta de duas partes:- o motivo específico da solicitação, fornecido pelo seu servidor de segurança de IA no campo
deny_reasondo veredito; - em seguida, uma mensagem fixa configurada pelos seus administradores (por exemplo, quem contatar ou onde solicitar uma exceção).
Se seus administradores não tiverem configurado essa mensagem, um padrão integrado orienta o usuário a entrar em contato com eles. Cada negação também é registrada no Activity Feed da sua organização.
- o motivo específico da solicitação, fornecido pelo seu servidor de segurança de IA no campo
O diagrama a seguir acompanha um exemplo (uma solicitação do Cowork em que Claude também chama uma ferramenta do O365) para ilustrar quais partes do fluxo passam pelo hook. Os pontos com hook são as etapas 1 e 6 do diagrama, em que o prompt chega e o resultado da ferramenta retorna. Cada um deles gera a troca de validação com seu servidor de segurança de IA mostrada nas etapas 2–3 e 7–8.
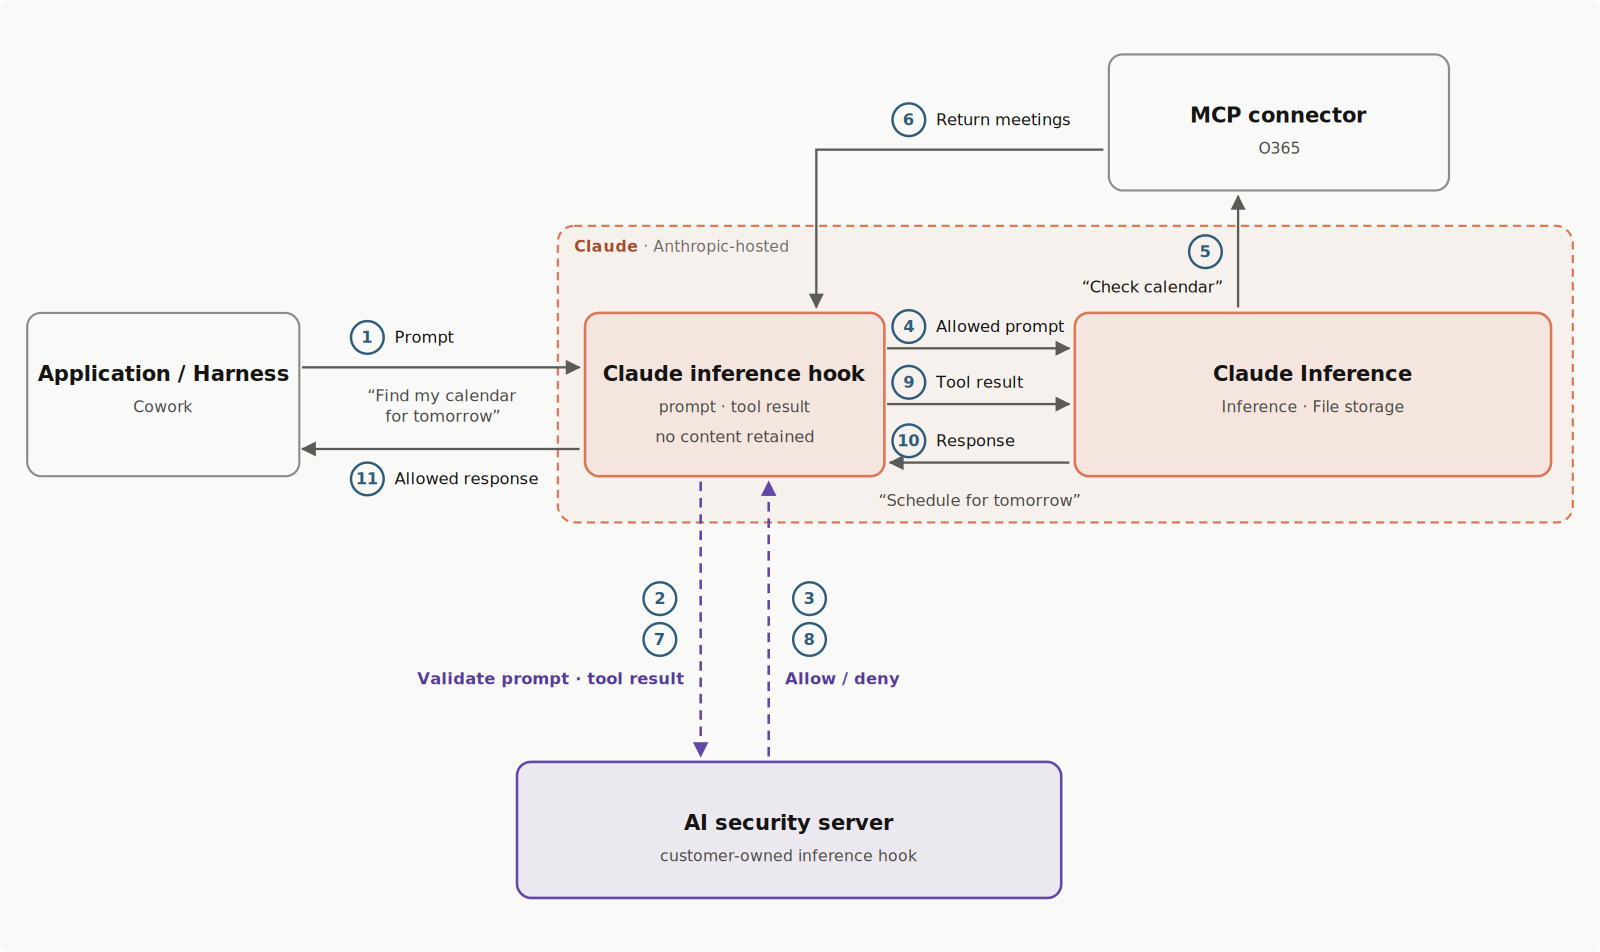
Um veredito é um pequeno objeto JSON: {"action": "allow"} permite que a solicitação prossiga, e uma negação inclui o motivo exibido ao usuário. Para o esquema completo do veredito, consulte Retornar um veredito.
Seu servidor de segurança de IA vê o mesmo que o usuário: o texto da transcrição, as chamadas de ferramentas e seus resultados, e o texto extraído de anexos. Ele nunca recebe bytes brutos de arquivos ou imagens, prompts do sistema nem contexto interno da Anthropic.
O sistema de Inference hooks não mantém sua própria cópia do conteúdo de prompts ou respostas. Ele armazena apenas a configuração do seu hook e metadados sobre a atividade do hook, como vereditos, carimbos de data/hora e identificadores de solicitação. O produto Claude que você usa armazena prompts e respostas de acordo com suas próprias regras de retenção de dados, com os hooks ativados ou não. Por exemplo, uma mensagem bloqueada por um hook no claude.ai permanece na conversa.
Seu servidor de segurança de IA pode ficar inacessível, retornar um erro ou não responder dentro do tempo limite. Nesses casos, a configuração de tratamento de falhas da sua organização decide o resultado: bloquear a solicitação ou permitir que ela prossiga sem inspeção.
Falhas persistentes atribuíveis ao seu servidor acionam um "circuit breaker" (disjuntor). Quando isso acontece, a Anthropic para de contatar o servidor e aplica sua configuração de tratamento de falhas a todas as solicitações. O circuit breaker é redefinido automaticamente assim que a Anthropic detecta que seu servidor voltou a retornar vereditos. Consulte Circuit breaker.
A aplicação de políticas pode ser implantada no seu ritmo, para que ninguém precise ser bloqueado logo no primeiro dia:
- O "shadow mode" (modo sombra) observa os vereditos no tráfego real sem bloquear nada.
- Uma "rollout percentage" (porcentagem de implantação) inspeciona uma fração escolhida das solicitações.
- As exclusões isentam totalmente os membros de funções escolhidas.
Consulte Configurar Inference hooks.
Para os esquemas completos de solicitação e resposta, a verificação de assinatura e os detalhes operacionais, consulte Desenvolver uma integração.
Continuar uma conversa após uma solicitação negada
Cada solicitação inclui a conversa inteira, então uma mensagem negada é enviada novamente junto com cada mensagem posterior. Se seu servidor de segurança de IA avaliar a transcrição inteira, ele também negará essas solicitações. Para continuar, o usuário remove o conteúdo negado daquilo que o aplicativo enviará em seguida, incluindo qualquer arquivo que Claude leria novamente.
As etapas dependem do aplicativo:
- claude.ai, incluindo o Claude Desktop e os aplicativos móveis. O usuário edita a mensagem negada, ou uma anterior, em vez de enviar uma cópia corrigida como nova mensagem. Na web e no Claude Desktop, a edição reenvia os anexos da mensagem, a menos que o usuário os remova. Um novo chat também funciona.
- Claude Code. O usuário executa
/rewinde seleciona o prompt que trouxe o conteúdo pela primeira vez. Se solicitado, ele seleciona Restore conversation e, em seguida, edita ou limpa o prompt que volta ao campo de entrada./clearrecomeça do zero. Consulte Checkpointing. - Cowork. O usuário edita a mensagem negada se ela for a mais recente dele. A edição reenvia os arquivos anexados, e Restart from here reenvia a mensagem inteira sem alterações. Se o conteúdo estiver em um arquivo ou em uma mensagem anterior, o usuário seleciona New task.
- Claude Tag. No Slack, o usuário primeiro edita a mensagem negada, ou a exclui se ela for uma resposta. Em seguida, ele envia
@Claude !restartsozinho no local onde Claude estava respondendo: nessa thread ou no nível superior do canal. A nova sessão relê as mensagens que ainda estão no Slack, por isso a edição ou exclusão deve vir primeiro. Consulte o comando!restart.
Casos de uso
- Prevenção contra perda de dados (DLP). Encaminhe a transcrição ao seu scanner de "data loss prevention" (prevenção contra perda de dados), ou DLP, e negue prompts que carreguem material regulamentado ou classificado. Esta é a implantação mais comum.
- Arquivamento de transcrições em tempo real. Arquive cada transcrição à medida que ela chega e sempre retorne
allow, como uma alternativa baseada em push à consulta periódica da Compliance API. - Telemetria de prompts. Meça como sua organização usa o Claude, no momento do uso.
- Mecanismos de políticas. Aplique suas próprias regras antes da inferência: listas de permissão de modelos, restrições com escopo de projeto ou controles de horário de trabalho.
Limitações atuais
- Anexos são representados por metadados e texto extraído. Bytes brutos de arquivos e imagens nunca são enviados, portanto conteúdo somente em imagem (por exemplo, uma captura de tela de um documento) não é inspecionado.
- Os vereditos são permitir ou negar. Reescrever ou redigir um prompt não é suportado.
- Organizações de plataforma (acesso à API por meio da Claude Platform) estão fora do escopo.
Disponibilidade
Os Inference hooks estão disponíveis para organizações Claude Enterprise. Configurá-los requer a permissão organization:manage, que apenas as funções Owner e Primary owner possuem.
Um único hook governa as conversas no claude.ai, no Cowork, no Claude Code e nas sessões do Claude Tag da sua organização Claude Enterprise. Isso vale para sessões na web, nos aplicativos para desktop ou dispositivos móveis, na CLI ou no Slack. Os Inference hooks não estão disponíveis no Amazon Bedrock nem no Google Cloud.
As solicitações governadas são as solicitações de inferência por trás da conversa do usuário. Solicitações auxiliares, como a geração de títulos de conversas, não são enviadas ao seu endpoint. Os prompts do sistema e as definições de ferramentas nunca são incluídos no que é enviado. O modo de voz não é coberto.
Inference hooks versus a Compliance API
Ambos os recursos atendem equipes de segurança, jurídicas e de conformidade em organizações Claude Enterprise.
| Inference hooks | Compliance API | |
|---|---|---|
| Quando atua | Inline, antes que a inferência seja executada | Após o fato |
| O que faz | Permite ou nega cada solicitação governada em tempo real | Recupera atividades, chats, arquivos, projetos, transcrições de sessões e usuários para auditoria e exportação |
| Direção | A Anthropic chama seu servidor de segurança de IA | Você chama a API da Anthropic |
Use os Inference hooks para interromper uma solicitação antes que ela chegue ao modelo, e a Compliance API para auditar o que aconteceu depois.
Nesta seção
Permita Inference hooks para sua organização, configure e teste seu servidor de segurança de IA, escolha o tratamento de falhas e aplique vereditos.
Os esquemas de solicitação e veredito, verificação de assinatura, semântica operacional e padrões de integração para construir o servidor de segurança de IA.
Was this page helpful?