Ottimizzare costo e intelligenza
Bilancia costo e intelligenza sulla Claude Platform, con risultati misurati per cache dei prompt, effort, scelta del modello, budget e strategie multi-modello.
Quando un carico di lavoro passa dal prototipo alla produzione, il costo diventa un vincolo di progettazione di primo piano. Su larga scala il modello più capace può risultare troppo costoso, mentre quello meno costoso può non garantire la qualità necessaria. Gestire bene i costi significa capire come ciascuna leva di costo influisce sulla qualità dell'output, perché alcune leve vanno a scapito della qualità e altre no. La Claude Platform ti offre il controllo diretto su questo compromesso. Per ogni richiesta scegli il modello, il livello di "effort" (impegno) e l'architettura, e puoi così collocare un carico di lavoro quasi ovunque sulla frontiera costo-intelligenza.
Costo e intelligenza vengono solitamente rappresentati come una frontiera in cui l'uno si ottiene a spese dell'altra. Il primo gruppo di leve in questa pagina avvicina un carico di lavoro a quella frontiera riducendo i costi senza toccare la qualità; solo il secondo gruppo lo sposta lungo di essa:
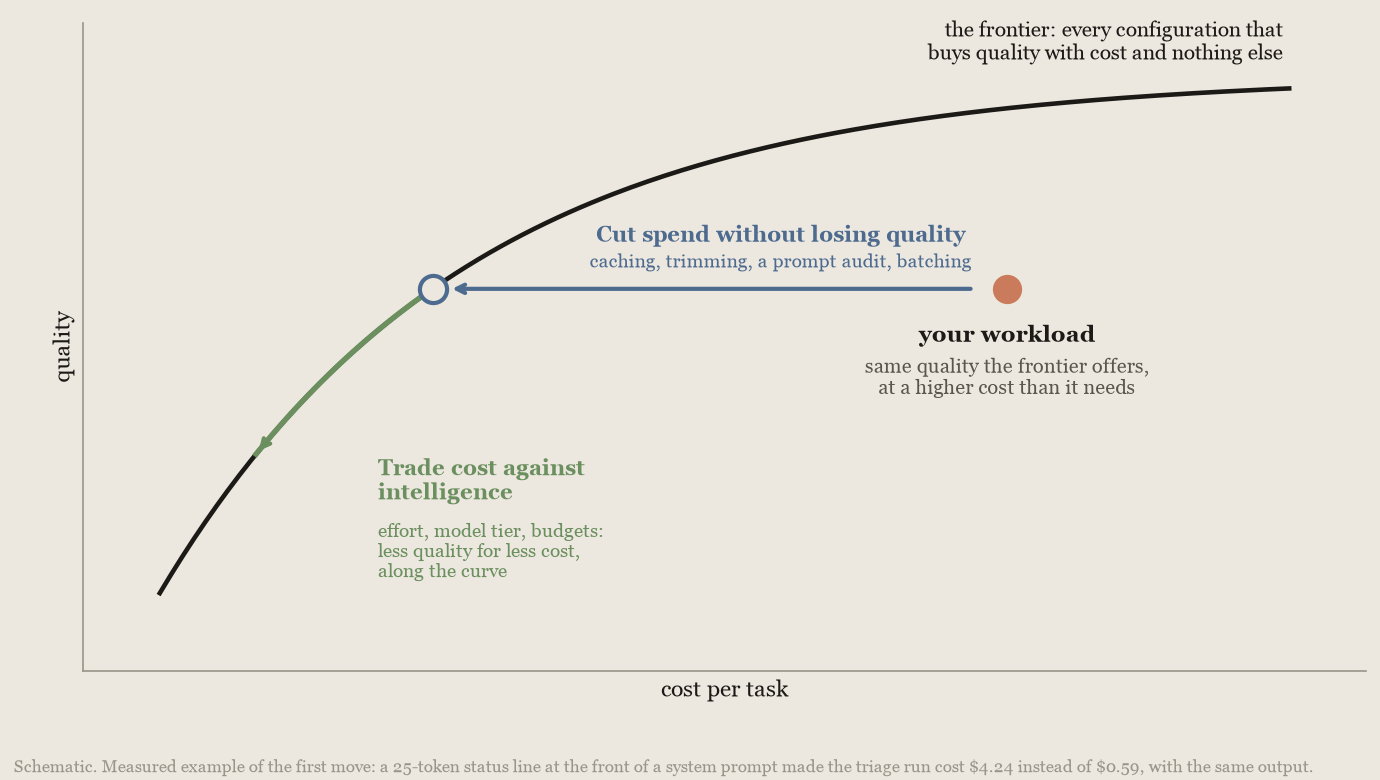
Le leve sono di due tipi:
- Vantaggi gratuiti: riducono la spesa senza toccare la qualità. Sono la "prompt caching" (cache dei prompt), l'igiene dei token, una revisione dei prompt rispetto al modello che stai usando, l'elaborazione batch con uno sconto del 50% per il lavoro che può attendere fino a 24 ore e, come rete di sicurezza, i limiti di spesa del workspace.
- Compromessi: scambiano costo con intelligenza. Sono la scelta del modello, l'effort, i limiti di output e i "task budget" (budget per attività), un orologio del tempo trascorso e le architetture multi-modello.
Ogni leva è accompagnata da risultati misurati e dalla regola che indica quando conviene. Nelle misurazioni di Anthropic, la cache dei prompt è stata di gran lunga la leva più importante. Sui benchmark di questa guida ha ridotto il costo dei loop agentici di un fattore compreso tra 2,7 e 5,3. Ha inoltre ridotto la spesa di un piccolo agente di triage dell'83%, o dell'88% aggiungendo il taglio dell'input. Le leve multi-modello hanno un ambito più ristretto: un secondo modello si è rivelato conveniente in due configurazioni, un advisor e un orchestratore.
Inizia da qui
Trova la riga che corrisponde alla tua situazione.
| La tua situazione | Cosa fare | Dove |
|---|---|---|
| Qualsiasi carico di lavoro, qualsiasi modello | Attiva la cache dei prompt e taglia i token non necessari; entrambe le cose sono gratuite | Metti in cache il contesto ripetuto · Taglia i token |
| Una persona attende tra un turno e l'altro | Usa la durata della cache di 1 ora quando circa 1 turno su 20 segue una pausa compresa tra 5 minuti e un'ora e poche pause superano l'ora. Su Claude Fable 5.1, mantieni calda la cache da 5 minuti finché le pause durano pochi minuti, e acquista la durata di 1 ora quando le pause si avvicinano all'ora. Su Claude Opus 5.5, mantieni invece calda la cache da 5 minuti quando solo un turno o due su 20 seguono una pausa fino a circa mezz'ora | Scegli la durata della cache |
| I costi sono troppo alti; la qualità va bene | Riduci progressivamente l'effort sul tuo modello attuale | Regola l'effort |
| Non usi il modello più recente | Aggiorna il modello; nelle misurazioni di Anthropic ogni modello più recente ha risolto almeno tante attività quante il precedente, di solito a un costo inferiore per attività risolta | Aggiorna il modello |
| Stai scegliendo o cambiando modello | Confronta il costo per attività completata, non per token | Confronta i modelli |
| La qualità non è sufficiente | Se hai abbassato l'effort, ripristinalo; altrimenti prova il livello superiore con effort low | Regola l'effort · Confronta i modelli |
I tentativi terminano con stop_reason: max_tokens | Aumenta max_tokens; con l'effort predefinito, 64.000 ha coperto tutti i 14.000 turni misurati tranne 2, e 128.000 non ha comportato alcun costo aggiuntivo per attività risolta | Imposta budget |
| Puoi verificare gli output (test, un verificatore) | Esegui tutto con effort basso e riesegui i fallimenti con high; sul benchmark di coding misurato, il tasso di successo è rimasto invariato a circa metà del costo | Riesegui i fallimenti |
| Loop agentici con alcune esecuzioni molto costose | Imposta un task budget (beta; controlla nella tabella di supporto quali modelli lo supportano), un budget di sessione di Claude Managed Agents e un limite di spesa del workspace | Imposta budget |
| Vuoi che le esecuzioni dell'agente terminino prima | Comunica al modello che il tempo conta e mostragli il tempo trascorso. Su DRACO, HLE e un set interno di fisica, le esecuzioni hanno richiesto dal 33% al 69% di tempo in meno, con un costo per attività inferiore dal 28% al 54% e punteggi fino a 1,9 punti più bassi | Mostra al modello il tempo trascorso |
| Un modello meno costoso si blocca solo sulle decisioni difficili | Aggiungi un advisor di frontiera. Conviene quando il suo prezzo è ben superiore a quello dell'esecutore e viene effettivamente consultato: prima calcola il costo del solo modello advisor con effort basso e misura il tasso di consultazione | Strategia advisor |
| Il lavoro supera una "context window" (finestra di contesto) | Delega le partizioni a worker meno costosi | Strategia orchestratore |
Questi risultati provengono da misurazioni interne di Anthropic (Benchmark citati) e sono indicativi, non garanzie. Misura quindi sul tuo carico di lavoro con il metodo in quattro passaggi.
Riduci la spesa senza perdere qualità
La cache dei prompt, l'igiene dei token, l'elaborazione batch e un audit dei prompt rispetto al tuo modello attuale riducono tutti ciò che paghi senza ridurre la qualità dell'output. Valgono due avvertenze: l'elaborazione batch scambia latenza con il suo sconto, e il "context editing" (modifica del contesto), una leva di igiene dei token, è costato più di quanto ha fatto risparmiare nell'esecuzione misurata in questa sezione.
Metti in cache il contesto ripetuto
Perché la cache viene prima
Attiva la cache dei prompt prima di qualsiasi altra leva, perché ogni turno di un'attività agentica reinvia l'intera conversazione in crescita: prompt di sistema, definizioni degli strumenti e ogni turno precedente. Un'attività di 40 turni invia il suo primo turno 40 volte, quindi il costo dell'attività cresce all'incirca con il quadrato del numero di turni. La cache non ferma il reinvio, ma ogni reinvio costa circa un decimo e viene elaborato più velocemente: il prefisso è fatturato alla tariffa di lettura della cache, un decimo del prezzo di input, e ogni turno paga la tariffa di scrittura della cache di 1,25x solo per ciò che è nuovo.
Come appare un buon risultato. Nell'arco di un'intera giornata di traffico reale, i cicli di agente hanno letto una mediana dell'84% del loro input dalla cache, e il 10% superiore degli harness, di coding o meno, ha letto il 94% o più17. In profondità in un'attività, un ciclo ben costruito paga il prezzo pieno su meno dell'1% del suo input. Sotto circa l'80%, cerca qualcosa che rompe la cache (vedi Cosa rompe la cache).
Nelle esecuzioni misurate da Anthropic, le letture della cache sono abitualmente la singola componente più grande del costo dell'attività, rendendo la cache più preziosa della maggior parte delle decisioni sulla scelta del modello. Anthropic ha calcolato il prezzo delle esecuzioni di DeepResearch Bench II7 con e senza cache:
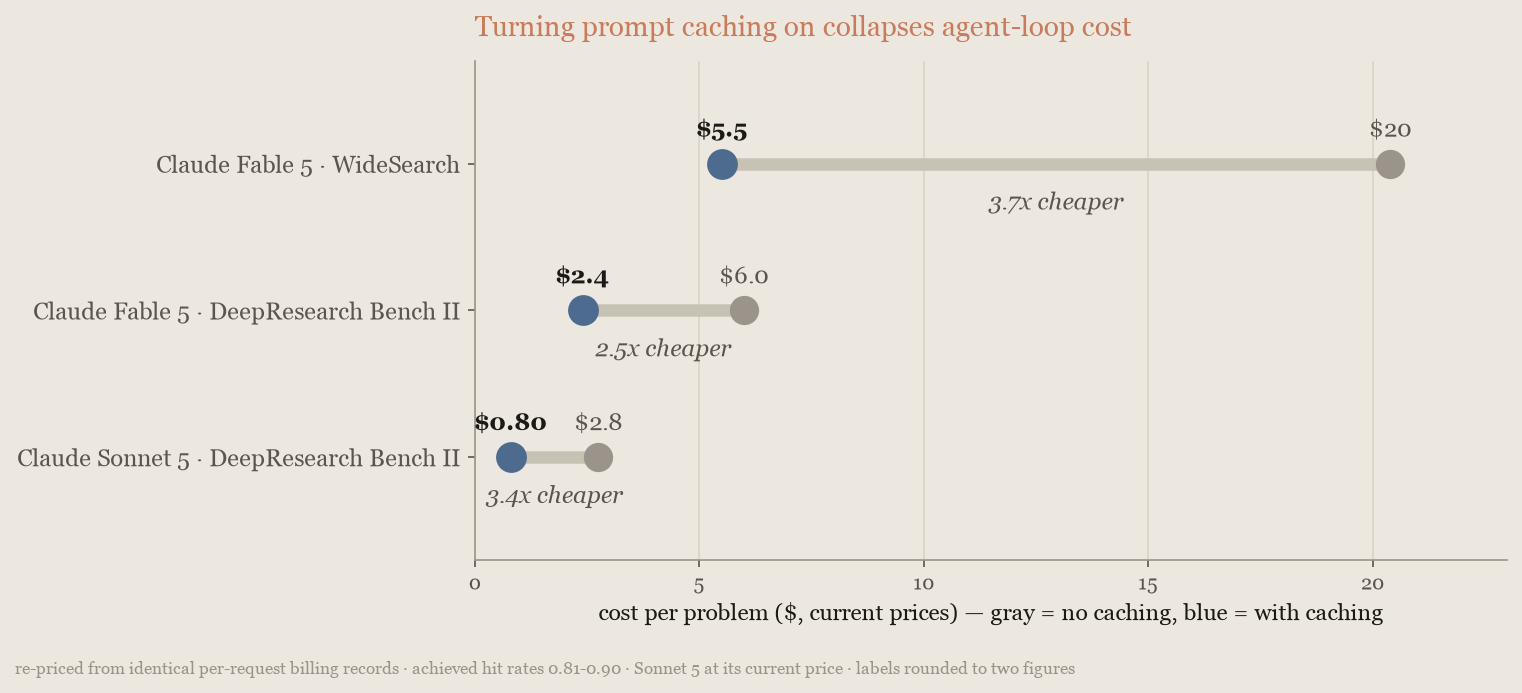
La durata predefinita della cache è di 5 minuti e i turni di un ciclo di agente sono a distanza di secondi, quindi lo sconto si applica alla maggior parte dei token a ogni turno. Le esecuzioni del grafico sulla cache hanno letto dal 79% al 90% dei loro token di input dalla cache. Il risparmio varia con la profondità dell'episodio, perché i cicli più brevi rileggono meno, ma la cache è rimasta la singola leva più grande su ogni modello e benchmark misurato.
Scegli la durata della cache
Se il tuo loop attende una persona tra un turno e l'altro, usa la durata della cache di 1 ora. La scrittura costa di più (2x il prezzo di input invece di 1,25x). Con entrambe le durate, un cache miss fattura l'intero prefisso al prezzo di scrittura invece che a quello di lettura. La durata più lunga conviene quindi quando alcuni turni per sessione seguono una pausa compresa tra 5 minuti e un'ora.
Per decidere, conta gli intervalli tra richieste consecutive in una conversazione:
- Più di circa 1 intervallo su 20 è compreso tra 5 minuti e un'ora, e gli intervalli superiori a un'ora sono rari: usa la durata di 1 ora. Su Claude Opus 5.5, se solo 1 o 2 intervalli su 20 rientrano in quella fascia e nessuno supera circa mezz'ora, mantieni invece calda la cache da 5 minuti con le richieste keep-alive descritte di seguito.
- I turni arrivano a pochi secondi di distanza: resta sul valore predefinito di 5 minuti. In assenza di pause, è costato il 15% in meno rispetto all'impostazione di 1 ora su Claude Sonnet 5 e circa dal 15% al 18% in meno su Claude Opus 5.5.
- Gli intervalli superiori a un'ora sono comuni: resta sul valore predefinito. Un intervallo superiore a un'ora fa scadere entrambe le durate, e l'impostazione di 1 ora riscrive allora il prefisso al suo prezzo di scrittura più alto, risultando svantaggiosa su ciascuno di quegli intervalli. Se circa il 60% o più delle tue pause superiori a 5 minuti supera anche l'ora, resta sul valore predefinito. La durata di 1 ora conviene solo quando almeno circa il 40% delle pause lunghe termina entro l'ora.
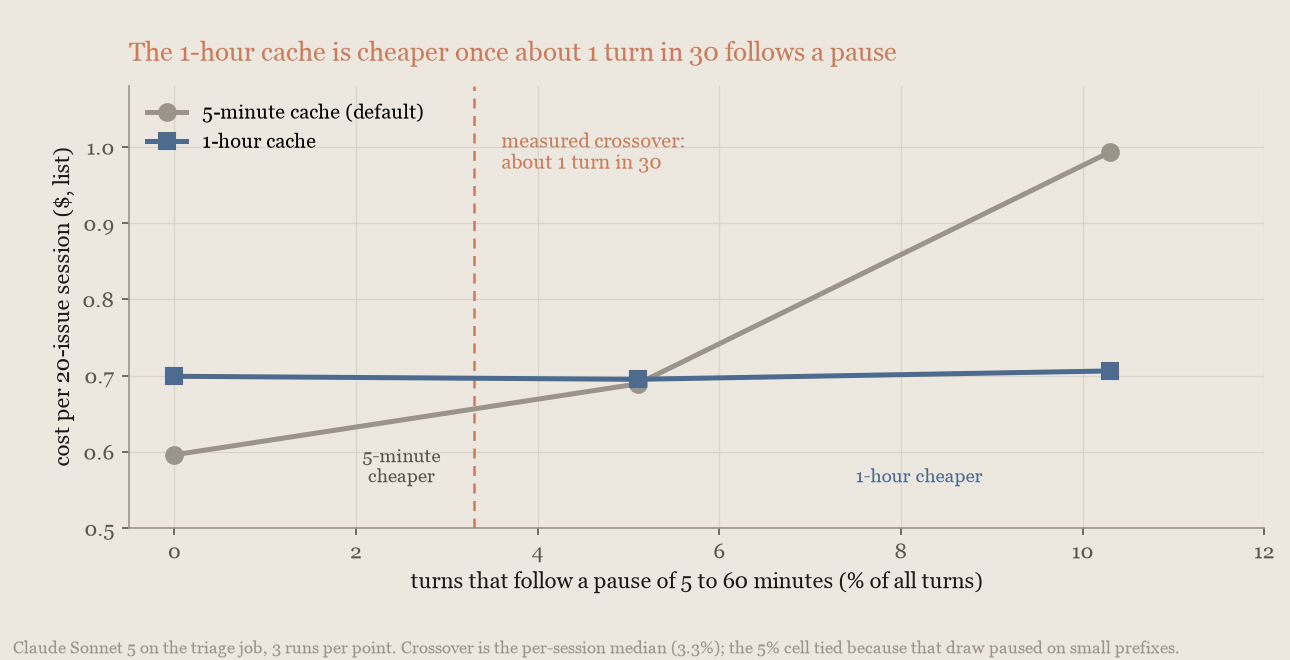
Anthropic ha misurato il lavoro di triage di Taglia i token di input e di contesto, inserendo pause prima di alcuni turni per simulare il ritardo di una persona16. Su Claude Sonnet 5 e Claude Opus 5.5, la cache di 1 ora è diventata l'impostazione più economica quando circa 1 turno su 30 seguiva una pausa, quindi la regola di 1 su 20 lascia un margine. Oltre il punto di incrocio il divario si allarga rapidamente, perché con l'impostazione di 5 minuti ogni turno dopo una pausa riscrive l'intero prefisso. Tutti i modelli attuali usano gli stessi moltiplicatori di scrittura in cache. Tutti tranne Claude Fable 5.1, Claude Mythos 5.1 e Claude Opus 5.5 hanno anche lo stesso prezzo di lettura, quindi sugli altri modelli il punto di incrocio si trova nello stesso intervallo; il caso di Fable 5.1 è trattato di seguito. In ogni cella l'accuratezza è rimasta entro il rumore tra un'esecuzione e l'altra. Con l'impostazione di 1 ora, il turno successivo a una pausa ha mantenuto la latenza da cache calda (misurato su Claude Sonnet 5 e Claude Opus 5, non su Claude Opus 5.5). Il grafico seguente mostra, su Claude Sonnet 5, il costo per sessione in funzione della quota di turni dopo una pausa:
Anthropic ha misurato anche le richieste aggiuntive che mantengono calda la cache da 5 minuti. Su Claude Sonnet 5 sono costate circa l'8% in meno rispetto alla durata di 1 ora quando 1 turno su 20 seguiva una pausa, ma circa lo stesso con 2 su 20. Su Claude Opus 5, il precedente modello Opus, non hanno prodotto alcun risparmio misurabile. Con una pausa di 6 minuti o più prima di ogni turno sono costate di più su entrambi i modelli. Poiché su Claude Sonnet 5 il risparmio scompariva già con 2 turni su 20, su Claude Sonnet 5 e Claude Opus 5 usa invece la durata di 1 ora.
Su Claude Fable 5.1 l'impostazione più economica è un'altra. La sua lettura dalla cache costa 0,025x il prezzo di input ($0,25 per milione di token), mentre le scritture in cache mantengono i moltiplicatori standard. Una richiesta keep-alive che rilegge il prefisso è quindi economica, e la voce più costosa diventa il sovrapprezzo di scrittura della durata di 1 ora. Anthropic ha misurato il lavoro di triage su Claude Fable 5.1 con le stesse tre impostazioni19. Con pause di alcuni minuti, mantenere calda la cache da 5 minuti è costato dal 13% al 20% in meno per sessione rispetto alla cache di 1 ora. Solo con pause vicine ai 45 minuti la cache di 1 ora è risultata più conveniente, di circa 12 centesimi a sessione. Su Claude Fable 5.1, quindi, mantieni calda la cache da 5 minuti quando una persona si assenta per pochi minuti, e acquista la durata di 1 ora quando le pause si avvicinano all'ora:
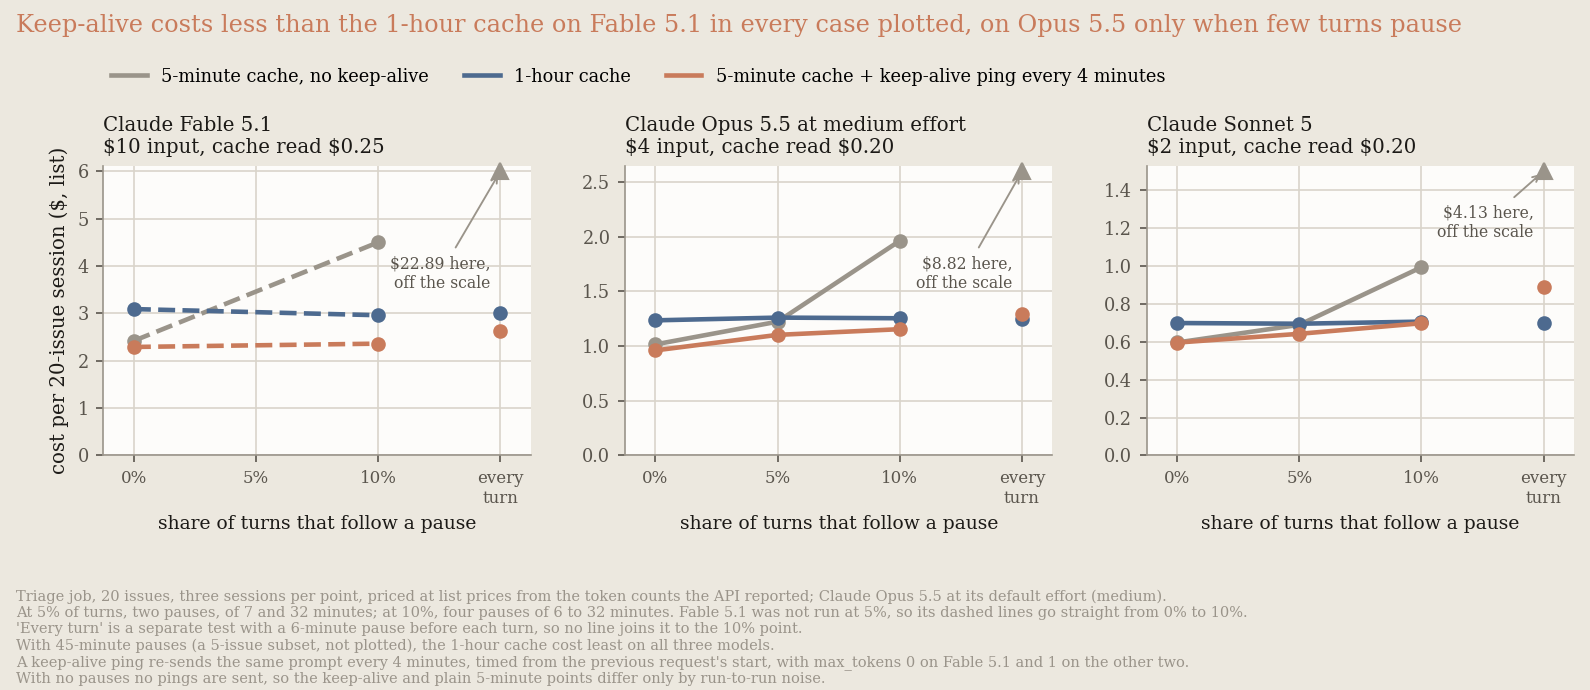
Su Claude Opus 5.5 la lettura dalla cache costa 0,05x il prezzo di input. Quando il 5% o il 10% dei turni seguiva una pausa da 6 a 32 minuti, le richieste keep-alive sono costate dall'8% al 13% in meno rispetto alla durata di 1 ora con l'effort predefinito, medium, e dal 10% al 18% in meno con high. Con una pausa prima di ogni turno sono invece costate di più: circa dal 4% al 6% in più con pause di 6 minuti, fino a oltre il 50% in più con pause di 45 minuti. Su Claude Opus 5.5, quindi, mantieni calda la cache da 5 minuti quando solo un turno o due su 20 seguono una pausa fino a circa mezz'ora; negli altri casi segui l'elenco all'inizio di questa sezione. Queste misurazioni hanno inviato richieste keep-alive con max_tokens: 1. Per la richiesta max_tokens: 0 descritta di seguito, i test API pre-lancio di Anthropic su Claude Opus 5.5 mostrano che la richiesta scrive la cache e che la richiesta successiva la legge. Non è stato invece misurato su Opus 5.5 se aggiorna una voce esistente.
Per mantenere calda la cache, invia di nuovo la richiesta precedente con max_tokens impostato a 0 entro 4 minuti dall'inizio della richiesta precedente, e poi ogni 4 minuti, rimuovendo stream se era impostato. Conta dall'inizio della richiesta, non dalla fine della risposta. La durata di 5 minuti della cache decorre infatti dall'inizio della richiesta che ha scritto o aggiornato la voce, quindi anche il tempo impiegato per generare la risposta viene conteggiato. Questa è la richiesta di pre-riscaldamento: aggiorna la durata della cache, non genera nulla e fattura solo la lettura dalla cache. Non modificare nemmeno un byte del prefisso e non usare max_tokens: 1, che campiona un token inutilmente. Reinvia sia gli header sia il corpo della richiesta. Se le tue richieste includono un header anthropic-beta (ad esempio per un task budget), la richiesta keep-alive deve includere lo stesso header, altrimenti i campi beta nel corpo reinviato vengono rifiutati. Una richiesta max_tokens: 0 viene rifiutata se imposta thinking.type: "enabled", gli output strutturati o una scelta forzata dello strumento (le sue limitazioni). L'"adaptive thinking" (ragionamento adattivo) predefinito su Claude Fable 5.1 invece va bene. Per questi carichi di lavoro, acquista la durata di 1 ora. Una richiesta max_tokens: 0 viene rifiutata anche se include il parametro di primo livello compaction: non reinviare quindi come richiesta keep-alive una richiesta di compattazione della compattazione su richiesta.
# Entro 4 minuti dall'inizio dell'ultima richiesta (il tempo di generazione conta
# ai fini della durata della cache), reinvia quella richiesta con max_tokens impostato a
# 0, rimuovendo stream (una richiesta con max_tokens: 0 non può usare lo streaming). Invia gli stessi
# header della richiesta originale, incluso l'eventuale header anthropic-beta.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Attiva la cache
La configurazione richiede poco lavoro. La cache automatica posiziona i breakpoint per te; altrimenti, la skill Claude API fornita con Claude Code può aggiungere la cache a un'integrazione esistente da un solo prompt. Il seguente estratto mostra la skill che la aggiunge all'harness che ha prodotto queste misurazioni:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Quei posizionamenti dei breakpoint seguono lo schema standard in Breakpoint di cache espliciti.
Cosa rompe la cache
Diversi fattori possono invalidare la cache durante un'attività. Qualsiasi elemento che cambia a ogni richiesta, come un timestamp o una posizione in coda, se posizionato prima del prefisso stabile trasforma ogni richiesta in una scrittura completa in cache. Nell'esecuzione di triage di Taglia i token di input e di contesto, una riga di stato di 25 token all'inizio del prompt di sistema ha fatto costare l'esecuzione $4,24 invece di $0,59, più che con la cache disattivata. Inserisci il testo che varia a ogni richiesta nel turno utente più recente.
La cache è una corrispondenza esatta, byte per byte, del prefisso della richiesta nel suo ordine (strumenti, poi prompt di sistema, poi messaggi): una modifica in qualsiasi punto invalida tutto ciò che segue. Cambiare effort o la configurazione del ragionamento tra una richiesta e l'altra invalida la cache da quel punto in poi e, su alcuni modelli, anche gli strumenti e il prompt di sistema che lo precedono; qualsiasi modifica al prompt di sistema invalida la cache da quel punto in poi; impostare o cambiare un formato di output invalida la cache per l'intera conversazione; aggiungere, rimuovere o riordinare una definizione di strumento invalida l'intera cache. La pagina sulla cache dei prompt elenca questi casi, tranne il formato di output, trattato in output strutturati. Sui modelli più recenti, per cambiare le istruzioni usa un messaggio di sistema a metà conversazione, cioè un messaggio {"role": "system"} aggiunto a messages, invece di modificare il campo di primo livello system: così il prefisso in cache rimane intatto. Consulta quella pagina per sapere quali modelli lo supportano. Sui modelli che la supportano, anche una modifica dell'effort per singolo messaggio lascia intatto il prefisso in cache. La posta in gioco è più alta su Claude Fable 5.1 e Claude Mythos 5.1, dove un'invalidazione riscrive il prefisso a 1,25x il prezzo di input invece di leggerlo a 0,025x. Su questi modelli, con un prefisso di 100.000 token, un turno con cache invalidata costa $1,25 invece di $0,03, cioè 50 volte la lettura. Su Claude Opus 5.5 costa $0,50 invece di $0,02 (25 volte), e sugli altri modelli attuali 12,5 volte.
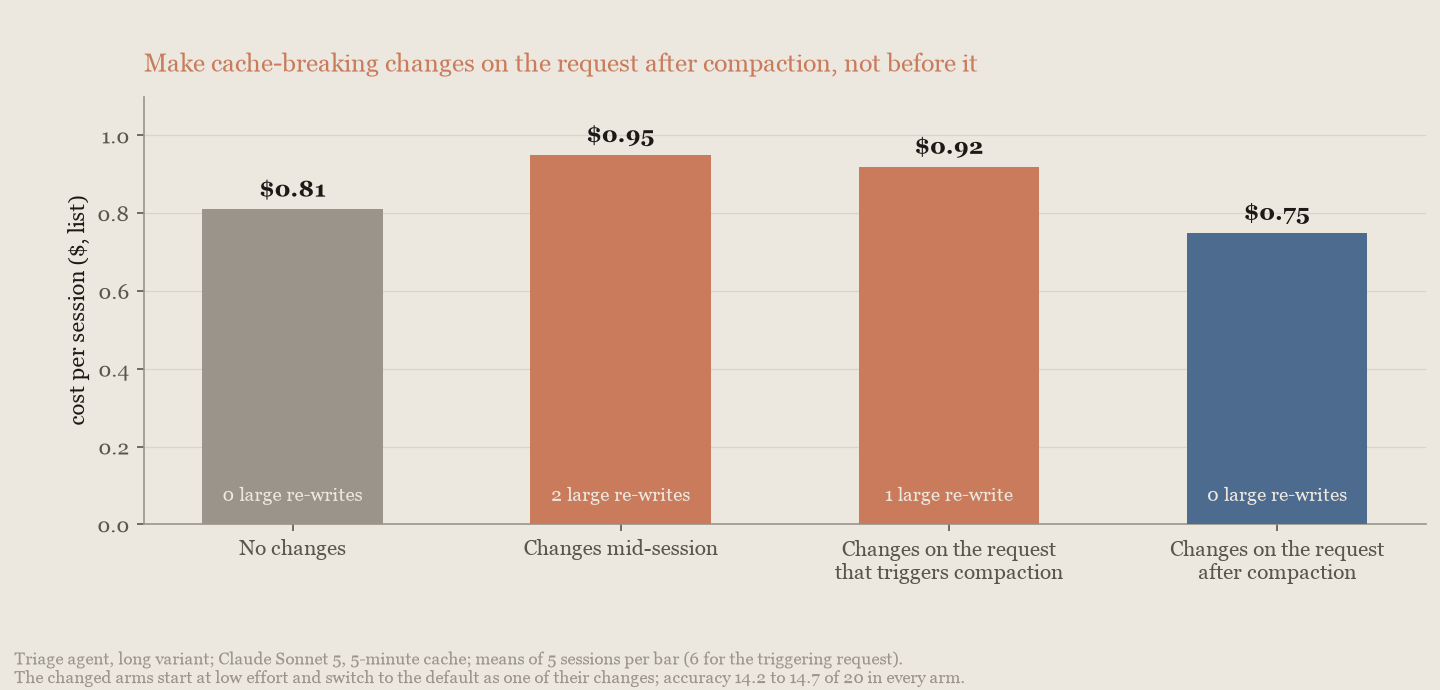
Anthropic ha misurato questo effetto sulle sessioni lunghe dell'agente di triage18. Una modifica dell'effort e l'aggiunta di uno strumento a metà sessione hanno riscritto rispettivamente 39.000 e 60.000 token in cache, e quelle sessioni sono costate $0,95 ciascuna. Le stesse due modifiche sono costate $0,75 se applicate alla prima richiesta dopo la compattazione, e $0,92 se applicate alla richiesta che ha attivato la compattazione. In quest'ultimo caso, il passaggio di riepilogo della compattazione ha rielaborato il contesto di 81.000 token al prezzo di scrittura in cache: quel passaggio è costato $0,21, contro $0,04 quando le stesse modifiche sono arrivate una richiesta dopo. In ogni braccio l'accuratezza è rimasta entro il rumore tra esecuzioni:
Cambiare un task budget a metà attività invalida qualsiasi prefisso in cache che contiene il valore del budget: impostalo quindi una sola volta, sulla prima richiesta. Ogni passaggio di context editing invalida il prefisso dal punto in cui cancella, e la richiesta successiva paga per rimettere in cache tutto ciò che segue. Conviene quindi cancellare in pochi lotti grandi anziché in molti piccoli. Su Claude Fable 5.1 e Claude Mythos 5.1 ciascuna di queste invalidazioni costa 50 volte il prezzo di lettura per token, quindi è lì che pesano di più. Applica ogni modifica che invalida la cache nelle pause naturali del lavoro, poi verifica che le letture dalla cache non siano diminuite. Se sono diminuite, la diagnostica della cache mostra dove il prefisso ha iniziato a divergere.
Taglia i token di input e di contesto
La maggior parte delle richieste degli agenti porta token che non influenzano mai la risposta. Tagliarli raramente costa qualità dell'output, anche se non ogni leva qui ha fatto risparmiare denaro quando misurata. Due posti dove guardare:
- Riduzione dell'input. Il filtraggio dinamico nello strumento web fetch tiene il contenuto superfluo fuori dalle pagine recuperate, il ridimensionamento delle immagini adatta le dimensioni degli input visivi, e la ricerca strumenti con caricamento differito carica le definizioni degli strumenti solo quando necessario (misurato più avanti in questa sezione). La chiamata programmatica degli strumenti consente a Claude di eseguire diverse chiamate agli strumenti dal codice, in modo che solo il risultato filtrato entri nel contesto; la sua documentazione riporta il 24% di token di input in meno sui benchmark di ricerca agentica, con un punteggio più alto. Gestire il contesto degli strumenti confronta la ricerca strumenti, la chiamata programmatica degli strumenti, la cache dei prompt e il context editing.
- Ciclo di vita del contesto. Il context editing rimuove i risultati obsoleti degli strumenti, e la compattazione automatica con la sua soglia impedisce ai loop lunghi di portarsi dietro l'intera cronologia.
Le leve interagiscono con la cache e tra loro, quindi giudicale per effetto netto, e usa la diagnostica della cache per confermare che il tuo prefisso in cache sopravviva a ogni modifica. Anthropic le ha misurate su un agente di triage delle issue che lavora su 20 segnalazioni di bug reali con screenshot da un repository pubblico, e su una variante più lunga dello stesso lavoro con 2,6 volte i token. Con la cache attiva, il taglio dell'input (ridimensionamento delle immagini e ricerca strumenti) ha tolto un ulteriore 26% dall'esecuzione breve e il 21% da quella lunga.
Differisci le definizioni degli strumenti non usate
Ogni definizione di strumento allegata a una richiesta è input a ogni turno, e pochi server MCP arrivano a centinaia di esse. Anthropic ha eseguito l'agente di triage con i suoi due strumenti più un catalogo di definizioni di strumenti reali da server MCP pubblici, per un totale fino a 502 strumenti, caricandoli tutti o contrassegnando gli extra con defer_loading dietro la ricerca strumenti:
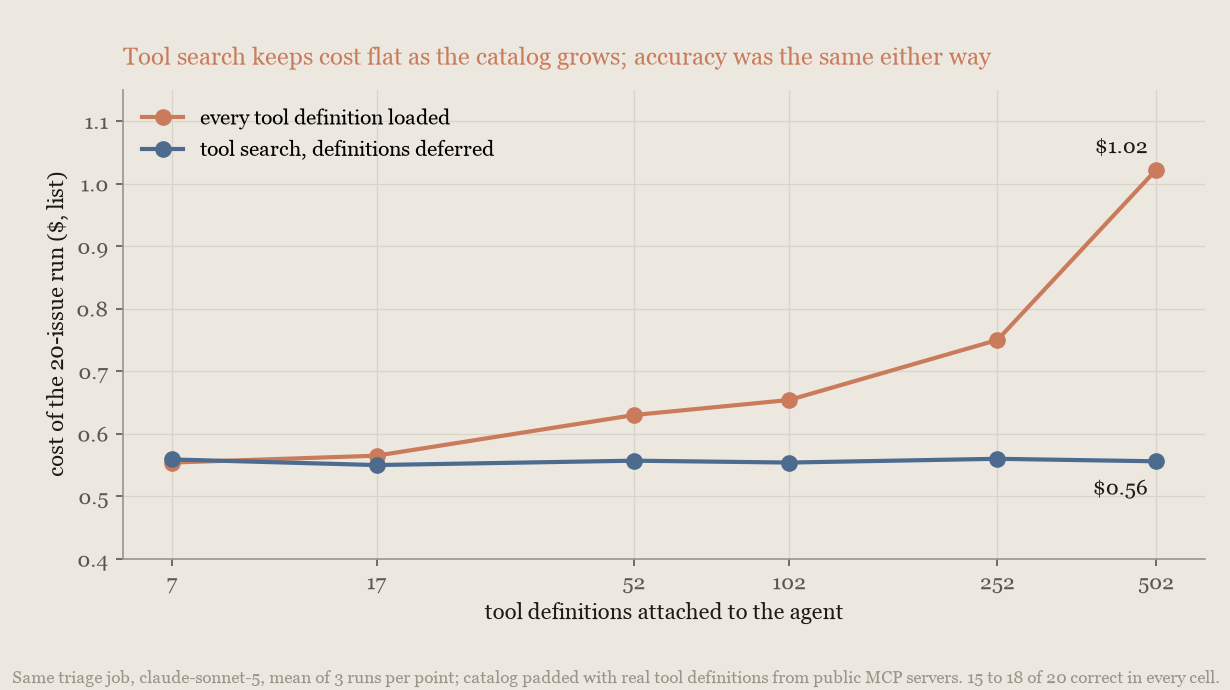
Con ogni definizione caricata, il costo dell'esecuzione è quasi raddoppiato al crescere del catalogo, seguendo i token dello schema su ogni richiesta. Con la ricerca strumenti è rimasto piatto a ogni dimensione del catalogo, il 45% in meno a 502 strumenti. L'accuratezza è stata da 15 a 18 su 20 in ogni cella in entrambi i casi, e il modello non ha mai chiamato uno strumento sbagliato, quindi a questa scala il catalogo costa denaro, non correttezza. Lo stesso vale per gli strumenti che arrivano tramite il connettore MCP: con un server MCP GitHub pubblico collegato, differire il suo set di strumenti (default_config: {defer_loading: true}) ha ridotto l'esecuzione del 20% alla stessa accuratezza.
Tieni i file di dati fuori dal prompt
Quando il modello deve calcolare su una tabella, caricala con la Files API e lascia che il modello la interroghi con l'esecuzione di codice invece di incollarla. Anthropic ha posto 25 domande aggregate15 (somme, conteggi filtrati, group-by e un filtro per data) su un CSV pubblico di 1.862 righe, con le risposte calcolate da pandas:
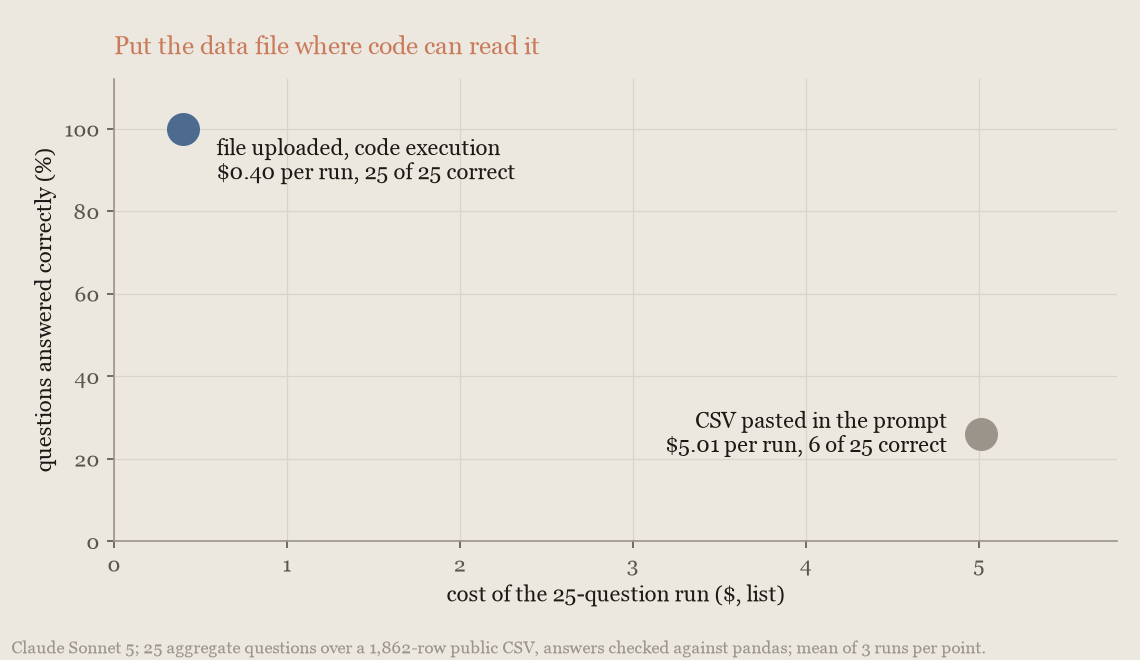
Incollata nel prompt, la tabella è circa 91.000 token di input su ogni richiesta, e Claude Sonnet 5 ha risposto correttamente a 6 domande su 25. Caricata, con l'esecuzione di codice, ha risposto a tutte e 25, e l'esecuzione è costata circa un dodicesimo. Claude Opus 5 ha mostrato lo stesso schema.
Gestisci il ciclo di vita del contesto
Le leve del contesto ripagano solo su una sessione abbastanza lunga da averne bisogno:
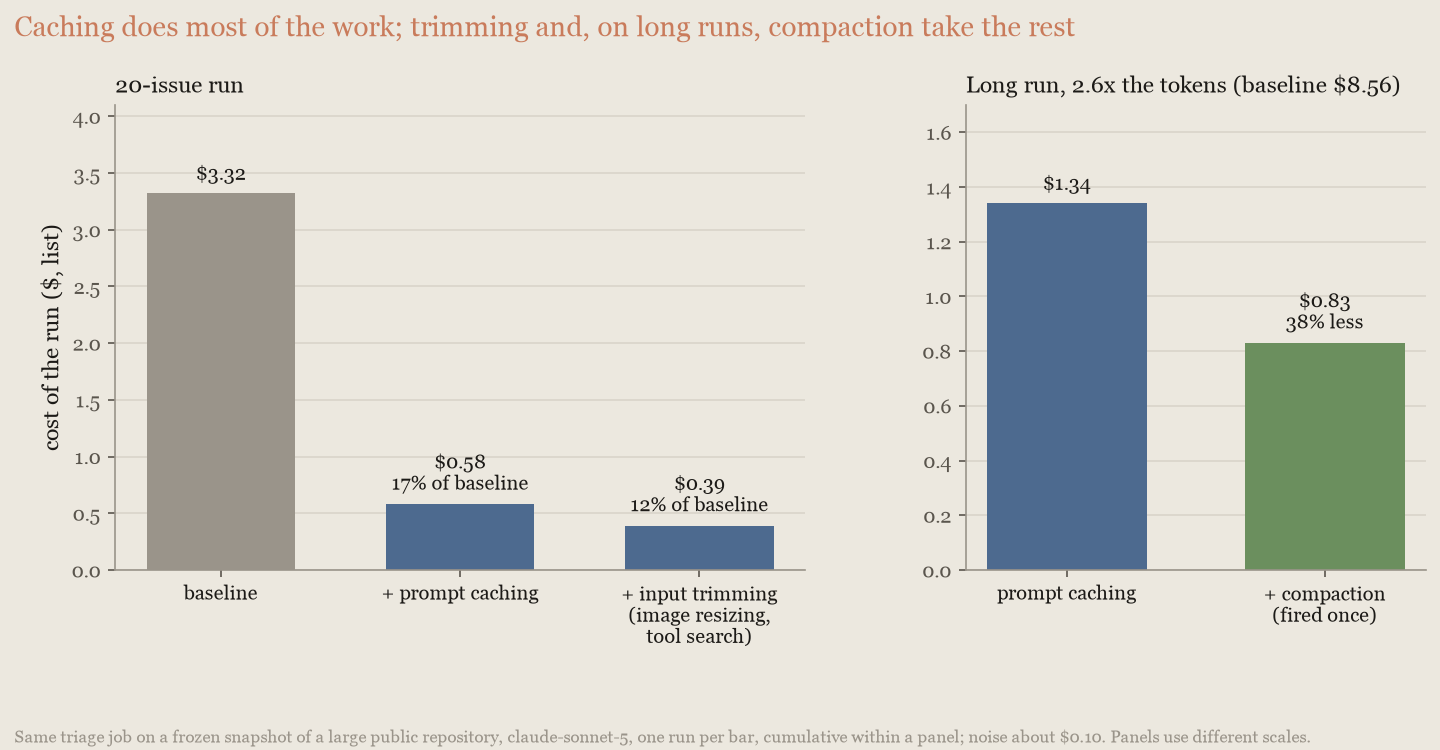
Sull'esecuzione di 20 issue non hanno fatto risparmiare nulla, e il context editing è costato il 74% in più. Sull'esecuzione lunga la potatura ha fatto risparmiare il 39% e la compattazione il 32%, mentre il context editing non ha cambiato nulla. La potatura è poche righe che scrivi tu stesso: a ogni confine di attività, sostituisci i risultati degli strumenti grandi e obsoleti con un estratto di una riga. Si mette bene in cache perché le modifiche stanno in coda alla conversazione, dove l'attività successiva aggiunge comunque nuovo contenuto: 89% di letture della cache sulla prima richiesta dopo un confine e 81% sulle richieste tra i confini. Sull'intera esecuzione, la potatura e il context editing si mettono in cache circa ugualmente bene. La potatura è più economica perché il context editing riscrive a metà attività contenuto che la potatura elimina (circa due terzi del divario) e perché mantiene il contesto a circa metà della dimensione (l'altro terzo). Se usi il context editing, cancella in pochi lotti grandi. La potatura, adattata dall'harness:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # limita i risultati a riga singola per mantenere breve l'estratto
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractMetti in batch il lavoro che può attendere
La Batch API toglie il 50% da ogni token di una richiesta, inclusi quelli in cache, in cambio di risultati che arrivano in qualsiasi momento entro 24 ore. Instrada ogni richiesta che nessuno sta aspettando attraverso un batch, e mantieni il percorso interattivo per il resto. Il batching è la seconda leva gratuita più grande dopo la cache per il lavoro degli agenti non presidiato: esecuzioni di valutazione, backfill e lavori pianificati come un'esecuzione ricorrente dell'agente di triage delle issue dalla misurazione del taglio dei token. Si combina con tutto in questa pagina tranne l'interattività, ma non è disponibile per le sessioni di Claude Managed Agents, che sono interattive per progettazione (vedi prezzi di Claude Managed Agents).
Verifica i prompt rispetto al modello attuale
Ogni generazione di modelli risponde ai prompt in modo diverso, quindi un prompt accumula testo scritto per un modello che non usi più. Il caso usuale è un'istruzione eccessivamente specifica aggiunta per compensare un modello più vecchio: "verifica due volte", "sii massimamente approfondito", una procedura passo-passo obbligatoria, o uno scratchpad di ragionamento fatto a mano. Un modello più nuovo le segue alla lettera, producendo round di strumenti extra e scrittura extra, quindi la fattura sale senza guadagno in accuratezza. Verificare i prompt rispetto al modello che esegui ora, e di nuovo ogni volta che cambi modello, è un vantaggio gratuito.
L'audit è un solo comando. La skill Claude API fornita con Claude Code ha un comando prompt-audit che legge i prompt e il codice delle richieste di un progetto e riporta cosa è stato scritto per un modello diverso. Questo estratto abbreviato lo mostra eseguito su un prompt di support desk e codice delle richieste contenente quegli schemi:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.Il comando propone poi le sue modifiche come diff (un hunk mostrato) ed elenca cosa ha deliberatamente lasciato invariato: la finestra di rimborso, il requisito di tono e la soglia di qualità. Rivedi una patch, non una riscrittura.
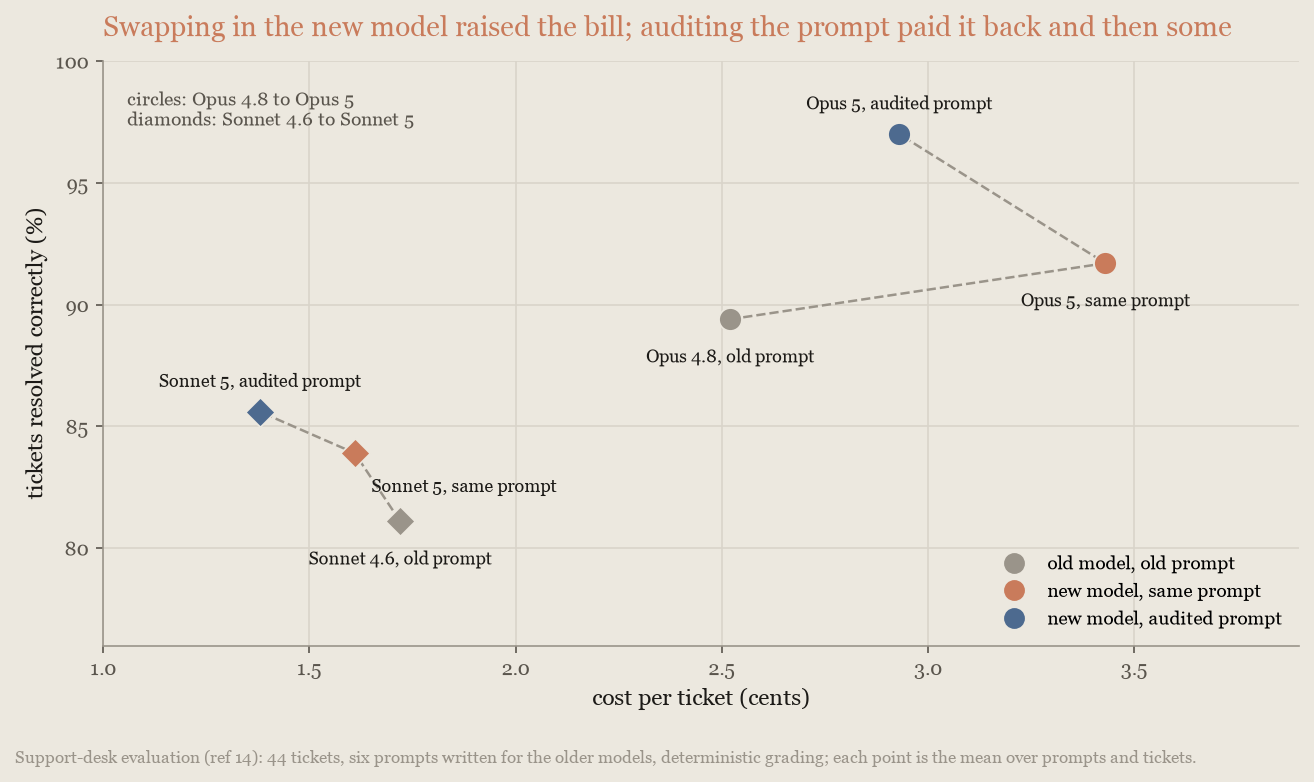
L'effetto è misurabile. Su una valutazione di support desk14, i prompt scritti per Claude Opus 4.8 sono costati il 36% in più per ticket su Claude Opus 5 senza alcun cambiamento in accuratezza. Eseguire l'audit sugli stessi prompt ha reso Opus 5 sia più economico della versione non verificata (del 14%) sia più accurato (97% dei ticket, dal 92%, un guadagno fuori dal rumore). Sulla migrazione da Claude Sonnet 4.6 a Claude Sonnet 5, l'audit ha tolto il 14% alla stessa accuratezza:
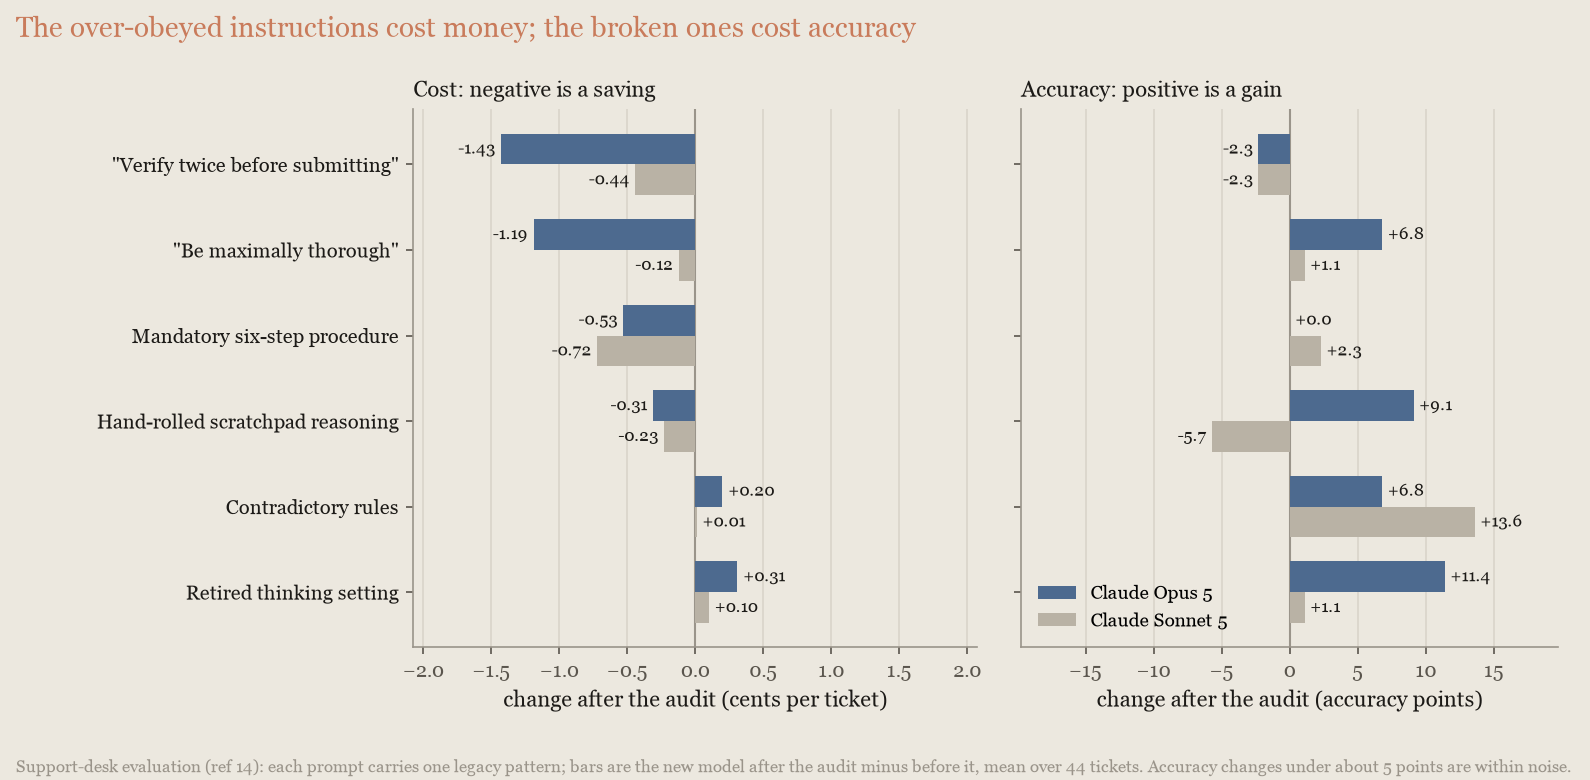
I due tipi di testo obsoleto hanno costi diversi. Le istruzioni che il nuovo modello segue troppo letteralmente costano denaro: rimuovere "verifica due volte" ha ridotto il costo per ticket di Opus 5 di un terzo, e rimuovere "sii massimamente approfondito" quasi altrettanto. Il testo che non si adatta più al modello costa invece accuratezza: un'impostazione di thinking ritirata, regole contraddittorie e uno scratchpad fatto a mano che confligge con il thinking proprio del modello hanno ciascuno ripristinato da 7 a 11 punti su Opus 5 quando rimossi:
Gli stessi schemi tendono ad apparire nelle descrizioni degli strumenti e nelle skill, che vale la pena verificare anch'esse.
Bilancia costo e intelligenza
Queste leve determinano dove si colloca un singolo modello tra costo e intelligenza: la scelta del modello, l'effort, la riesecuzione dei fallimenti con un'impostazione più alta, i budget e i limiti entro cui opera, e la possibilità di vedere quanto tempo è trascorso. Inizia provando diversi livelli di effort sul tuo modello attuale (Regola l'effort). In ordine crescente di costo e capacità, i modelli attuali sono Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 e Claude Fable 5.1 (il modello di frontiera). La panoramica dei modelli riporta la gamma completa e i prezzi.
Confronta i modelli sul costo per attività
I listini esprimono i prezzi per token, e per token il modello di frontiera sembra costoso: il prezzo per token di Claude Fable 5.1 è diverse volte quello di Claude Sonnet 5. Tuttavia paghi per le attività completate, quindi confronta i modelli sul costo per attività completata. Un modello più capace completa un'attività con meno lavoro: meno turni, meno ricerche, meno riletture del proprio contesto e meno passi indietro. Spesso questa riduzione complessiva del lavoro compensa ampiamente il sovrapprezzo per token.
Anthropic lo ha misurato sul sottoinsieme di SWE-bench Pro3, calcolando i costi come vengono fatturati a un cliente:
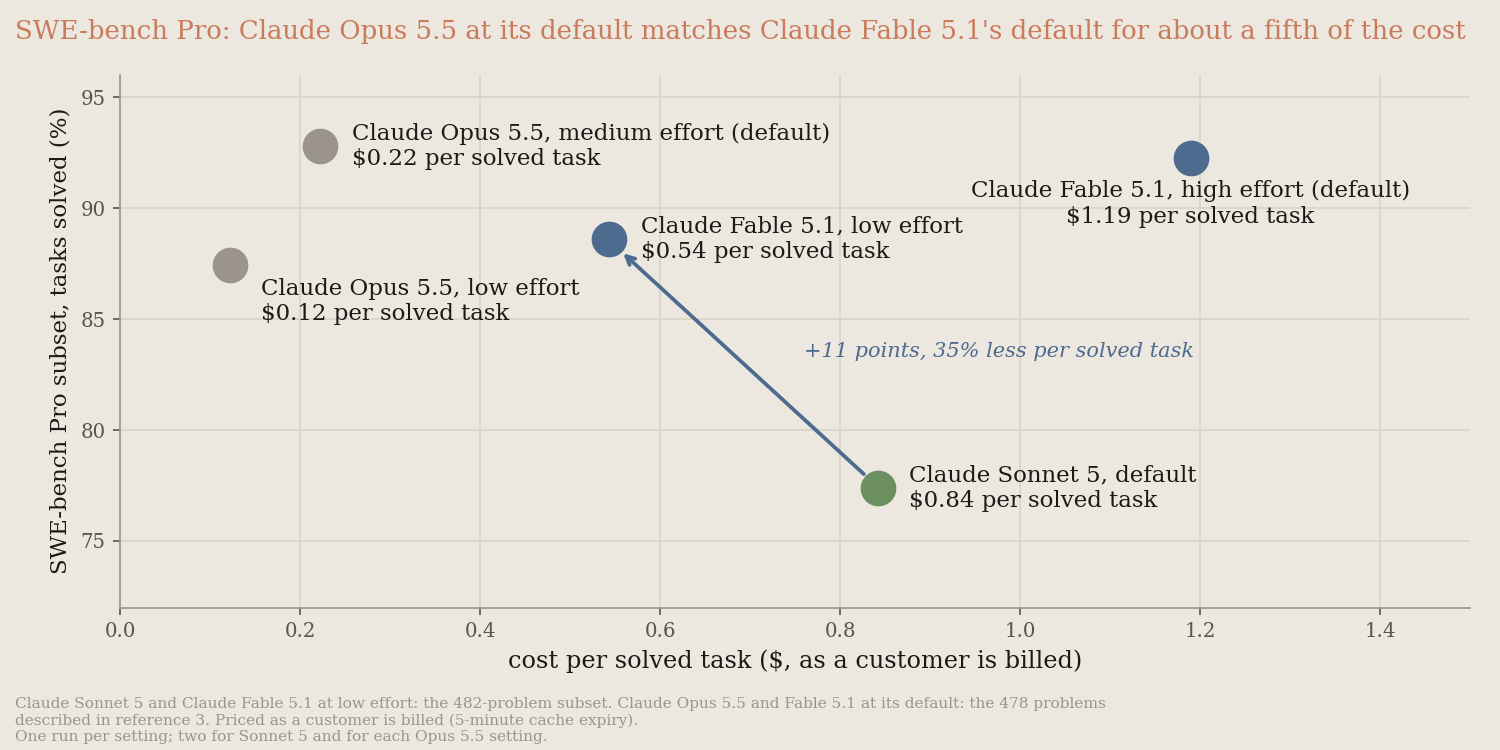
Claude Fable 5.1 con effort low ha risolto l'88,6% delle attività a $0,54 per attività risolta. Claude Sonnet 5 con l'impostazione predefinita ha risolto il 77,4% a $0,84. Fable 5.1 ha quindi ottenuto 11 punti in più con un costo per attività risolta inferiore del 35%, nonostante un prezzo per token cinque volte più alto. Il modello di frontiera però non vince sempre. Claude Opus 5.5 e Claude Fable 5.1 saturano entrambi in larga misura questo sottoinsieme, i cui punteggi non sono confrontabili con la classifica pubblica. Su di esso, Opus 5.5 con l'impostazione predefinita, medium, ha eguagliato Fable 5.1 con la sua impostazione predefinita (92,8% contro 92,3%, entro il rumore tra esecuzioni). Lo ha fatto a circa un quinto del costo per attività risolta ($0,22 contro $1,19). Con low, Opus 5.5 ha risolto l'87,4% a $0,12. Queste cifre si riferiscono ai 478 problemi descritti nel riferimento 3. Nei loop di ricerca lunghi, inoltre, il modello di frontiera fa più lavoro, non meno. Su DeepResearch Bench II7, Fable 5.1 con low ha ottenuto 10 punti in più di Sonnet 5 (66% contro 56%), ma a circa quattro volte il costo per attività ($4,66 contro $1,20), perché esegue un loop di ricerca più lungo su un contesto più ampio. Sulla stessa base, Claude Opus 5 con l'impostazione predefinita ha ottenuto il 71% a $6,71 per attività, superando Fable 5.1 con la sua impostazione predefinita (65% a $7,12). Anche nella ricerca, quindi, Fable 5.1 giustifica il suo prezzo solo con low.
Per la maggior parte dei carichi di lavoro agentici, inizia con Claude Opus 5.5 con il suo effort predefinito (medium). Usa Claude Fable 5.1 per il ragionamento impegnativo e il lavoro agentico a lungo orizzonte, oppure quando le tue valutazioni su Claude Opus 5.5 con effort più alto danno ancora risultati insufficienti. Come indicato in precedenza, sul sottoinsieme di SWE-bench Pro Opus 5.5 con l'impostazione predefinita ha eguagliato Fable 5.1 con la sua impostazione predefinita a circa un quinto del costo per attività risolta. Sul benchmark di coding di Strategia advisor, Opus 5.5 ha ottenuto l'86,6%, contro l'84,2% di Fable 5.1 con medium (una singola esecuzione di Fable 5.1), a meno di un terzo del costo per tentativo ($0,84 contro $2,68). Su Chartography13, un benchmark di lettura di grafici, Opus 5.5 con low ha ottenuto 68,7 a circa $0,03 per grafico. Fable 5.1 con low ha ottenuto 62,5 a $0,15, e Claude Opus 5 con low 49 a $0,16. All'estremo opposto, Claude Haiku 4.5 ha risposto alle domande di GPQA Diamond9 a circa un quinto del costo per domanda di Claude Opus 5.5, con un'accuratezza del 63% contro il 92% di Opus 5.5, ed è rimasto molto più indietro nelle attività di coding lunghe. È adatto al lavoro ad alto volume con output verificabili, non ai loop agentici lunghi.
La classifica cambia a seconda del carico di lavoro, e nessun listino può dirti in quale direzione. Calcola il costo per attività completata di ogni candidato sul tuo traffico reale, includendo Claude Opus 5.5 con il suo effort predefinito e il modello di frontiera con effort ridotto.
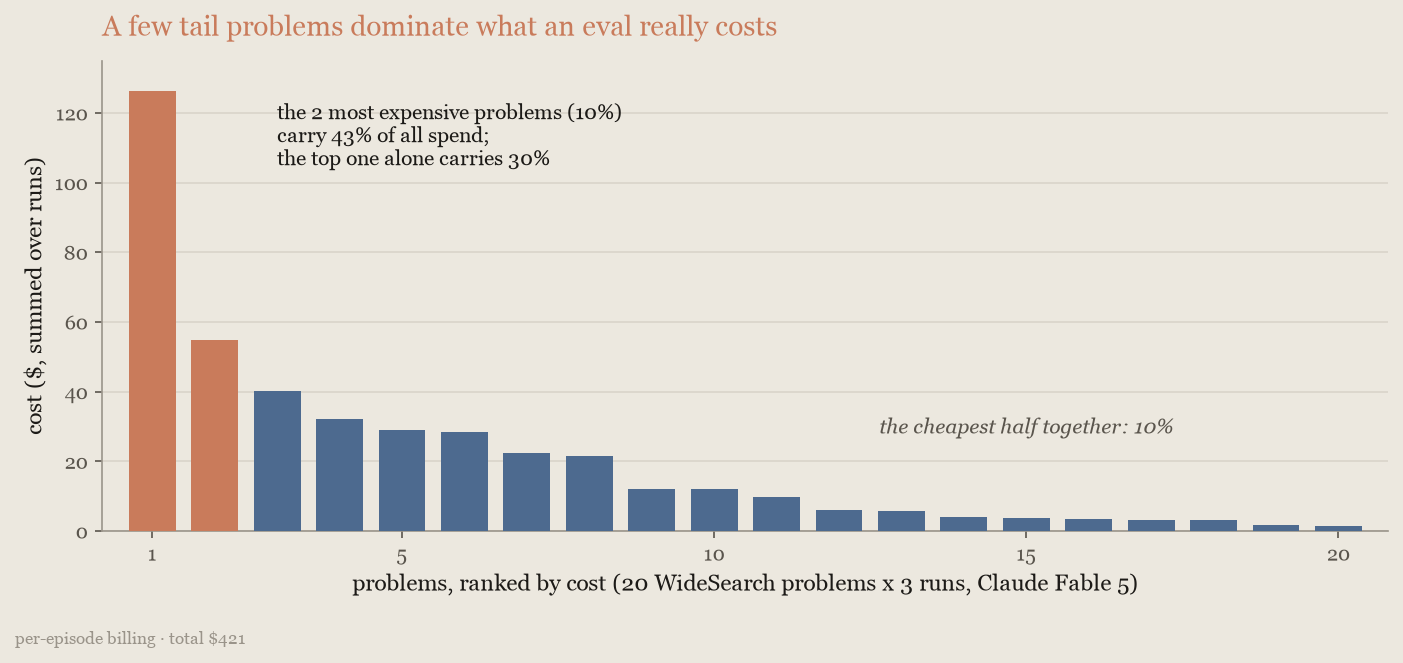
Valuta i costi sulla coda del tuo carico di lavoro, non sulla mediana: confronta i modelli sul 10% più difficile delle tue attività, non su quelle tipiche. Sulle attività tipiche tutti i modelli sembrano simili e il più economico sembra il migliore. La spesa, però, è determinata dalle attività in cui il modello più economico fallisce. Un'attività fallita fattura comunque i suoi token, poi quelli del nuovo tentativo, e infine qualunque costo il fallimento comporti a valle. Inoltre, anche quando nulla fallisce, è nella coda che si concentra la spesa. In un'esecuzione di WideSearch1 su 20 problemi, due soli problemi hanno rappresentato il 43% della spesa:
Le strategie multi-modello servono proprio a impiegare l'intelligenza di frontiera su quella coda senza pagare tariffe di frontiera per tutto il resto.
Aggiorna il modello
Se sei indietro di un modello o due, la leva più economica è la stringa del modello. Anthropic ha eseguito i recenti modelli Claude Opus, Claude Sonnet e Claude Fable attraverso lo stesso harness sul sottoinsieme di SWE-bench Pro3, ciascuno ai suoi predefiniti di rilascio e con prezzo a tariffe di listino, e ha eseguito di nuovo la linea Opus su Terminal-Bench 320:
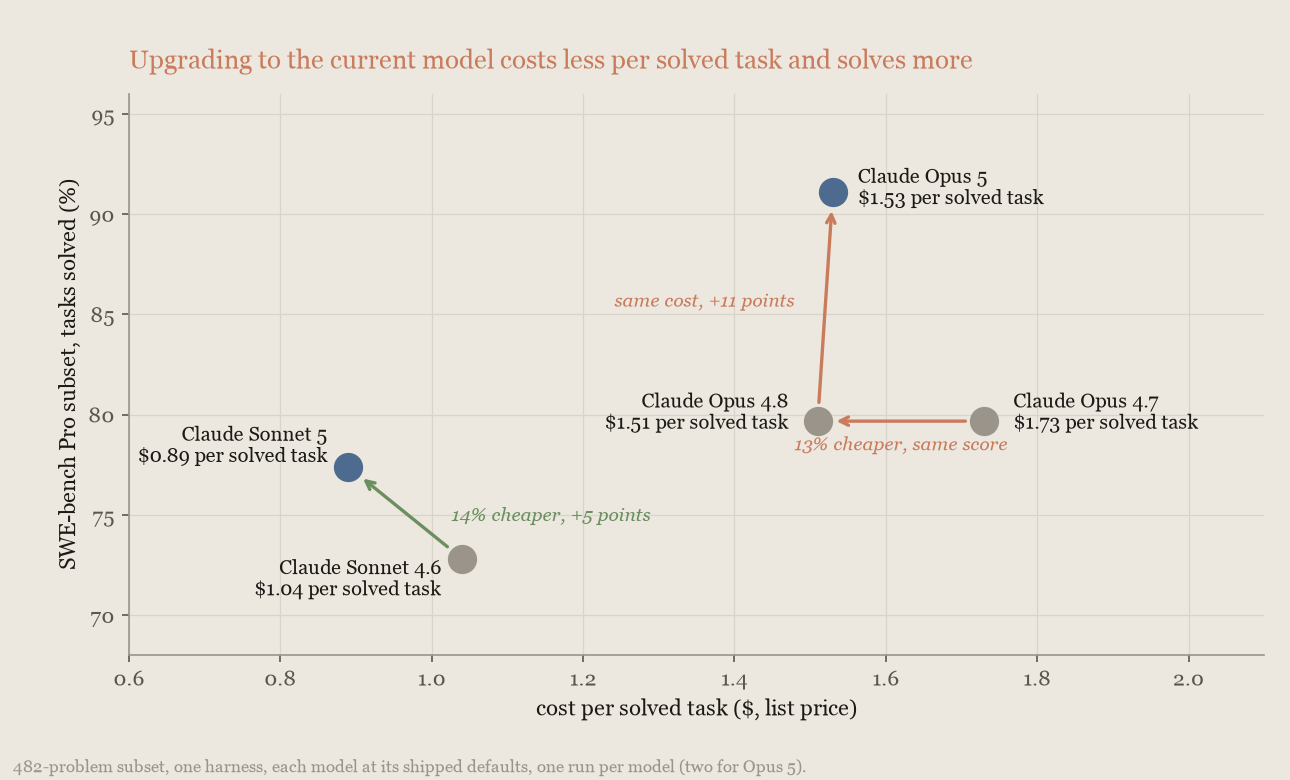
Anthropic applica lo stesso prezzo per token a Claude Opus 4.7, Opus 4.8 e Opus 5, quindi qualsiasi differenza tra loro deriva dalla quantità di lavoro che ciascun modello svolge per attività: con i prezzi calcolati come vengono fatturati a un cliente, Claude Opus 4.8 risolve la stessa quota di attività di Claude Opus 4.7 con un costo per attività risolta inferiore del 14%, e Claude Opus 5 risolve poi 12 punti in più di attività con un costo per attività risolta superiore del 21%. Claude Opus 5 con effort low supera l'impostazione predefinita di Opus 4.8 su questo benchmark a circa il 30% del suo costo per attività risolta, quindi l'aggiornamento più economico è il nuovo modello con un'impostazione più bassa. Il risparmio di Sonnet 5 deriva dal suo prezzo per token più basso, che compensa ampiamente i token aggiuntivi che usa per attività rispetto a Sonnet 4.6: il 15% in meno per attività risolta con 5 punti in più. Il livello di frontiera ha guadagnato allo stesso modo: Claude Fable 5.1 eguaglia il punteggio di Claude Fable 5 con un costo per attività risolta inferiore del 43%, in gran parte grazie al prezzo di lettura della cache più basso. Questa tendenza non è garantita: su DeepResearch Bench II7 lo stesso aggiornamento costa il 41% in più per attività con high (il 79% in più con low) per i suoi 2-3 punti aggiuntivi sulle attività pulite in ogni braccio (riferimento 7), perché lì il nuovo modello svolge più lavoro per attività. I prezzi di input e output sono gli stessi e la lettura dalla cache costa 4 volte meno, quindi misura l'aggiornamento sul tuo carico di lavoro prima di dare per scontato che faccia risparmiare.
Su lavoro più difficile il divario si allarga. Su Terminal-Bench 320, dove le attività sono abbastanza difficili che il tasso di successo piuttosto che i token determina la fattura, Claude Opus 4.7, Opus 4.8 e Opus 5 spendono ciascuno da $8 a $15 per attività ma risolvono il 7%, il 15% e il 41% delle attività, quindi il costo per attività risolta scende da $183 a $63 a $28 salendo la scala. Il sovrapprezzo del 21% che Claude Opus 5 porta rispetto a Opus 4.8 sul sottoinsieme di coding saturato diventa un risparmio del 56% su Terminal-Bench 3, dove il modello più vecchio per lo più fallisce: più il tuo carico di lavoro sconfigge il vecchio modello, più l'aggiornamento fa risparmiare per risultato.
Confronta sul costo per attività risolta, non per token: lo stesso testo costa circa il 30% in più di token su Claude Opus 4.7 e successivi, quindi un confronto per token fa sembrare i modelli più nuovi più costosi per costruzione.
Regola l'effort
L'effort è il modo più diretto per adattare un modello alla tua attività. Il parametro effort regola quanto ragionamento, quante chiamate agli strumenti e quanta autoverifica svolge il modello, e high, il valore predefinito sulla maggior parte dei modelli, è adatto ad attività impegnative; Claude Opus 5.5 usa medium come predefinito. Il costo cresce con tutta questa attività; l'accuratezza cresce solo con la parte di cui la tua attività ha bisogno. Per le attività al di sotto del limite delle capacità del modello, i livelli di effort più alti pagano per una profondità che l'attività non usa mai.
Sui benchmark di ricerca e di lavoro intellettuale (WideSearch1, DeepWideSearch6, BrowseComp4 e GDPval2, tutti con Claude Fable 5), la curva dell'accuratezza rispetto al costo è quasi piatta: low ha ceduto da 1 a 3 punti per un costo per attività ridotto da un terzo alla metà, medium ha eguagliato l'accuratezza del valore predefinito a circa il 70%-87% del suo costo, e il valore predefinito non ha ottenuto nulla di misurabile rispetto a medium su nessuno dei quattro. Su DeepWideSearch, low ha anche eguagliato un orchestratore con un worker Claude Sonnet 5 a un costo inferiore del 29%: abbassare l'effort ha battuto un cambio di architettura.
Le impostazioni di effort più basse sono spesso più veloci, il che conta quando la "latency" (latenza) è il vincolo. In queste esecuzioni, low ha impiegato 4,5 minuti per problema su DeepWideSearch, rispetto ai 7,9 minuti con il valore predefinito. Sul benchmark del corpus, il cui input non entra in nessuna singola finestra di contesto, Fable 5.1 ha impiegato 15,2, 17,5 e 19,9 ore per episodio con low, medium e high.
Il coding a lungo orizzonte è dove l'effort compra davvero accuratezza. Su SWE-bench Pro3, misurato rispetto a high, Claude Opus 5.5 ha ottenuto circa 2,5 punti in meno con il suo valore predefinito, medium, per circa il 70% del costo, e circa 8 punti in meno con low per circa un terzo del costo; xhigh ha ottenuto circa 1,4 punti in più per 2,5 volte il costo di high: un vero compromesso, che rieseguire i fallimenti con un effort più alto trasforma di nuovo in un risparmio. Questo grafico mostra l'accuratezza rispetto al costo per i benchmark di ricerca e di lavoro intellettuale e per SWE-bench Pro:
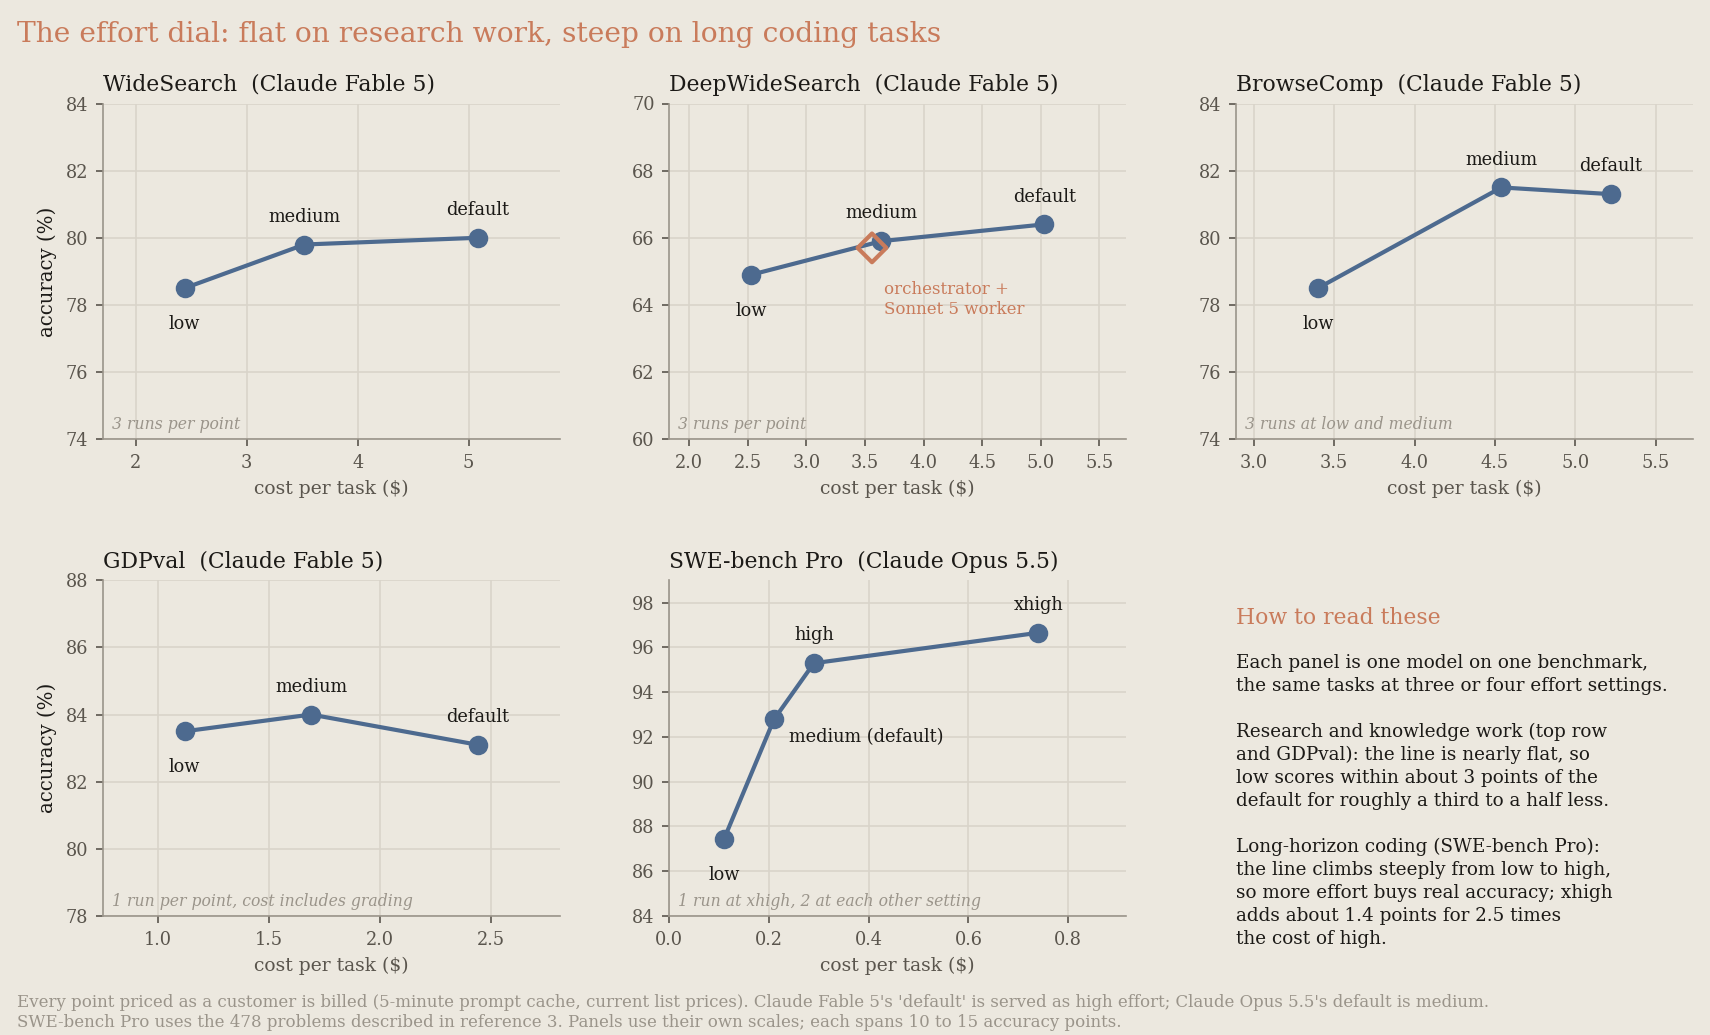
Ne derivano due conseguenze. Primo, traccia questa curva per il tuo carico di lavoro prima di aggiungere un secondo modello: in queste misurazioni interne, una configurazione multi-modello che sembrava più economica del singolo modello predefinito costava più dello stesso modello con un effort più basso. Secondo, questa curva è la baseline a modello singolo che qualsiasi strategia multi-modello deve battere, quindi il passaggio 2 della misurazione sul tuo carico di lavoro stabilisce la baseline su più livelli di effort.
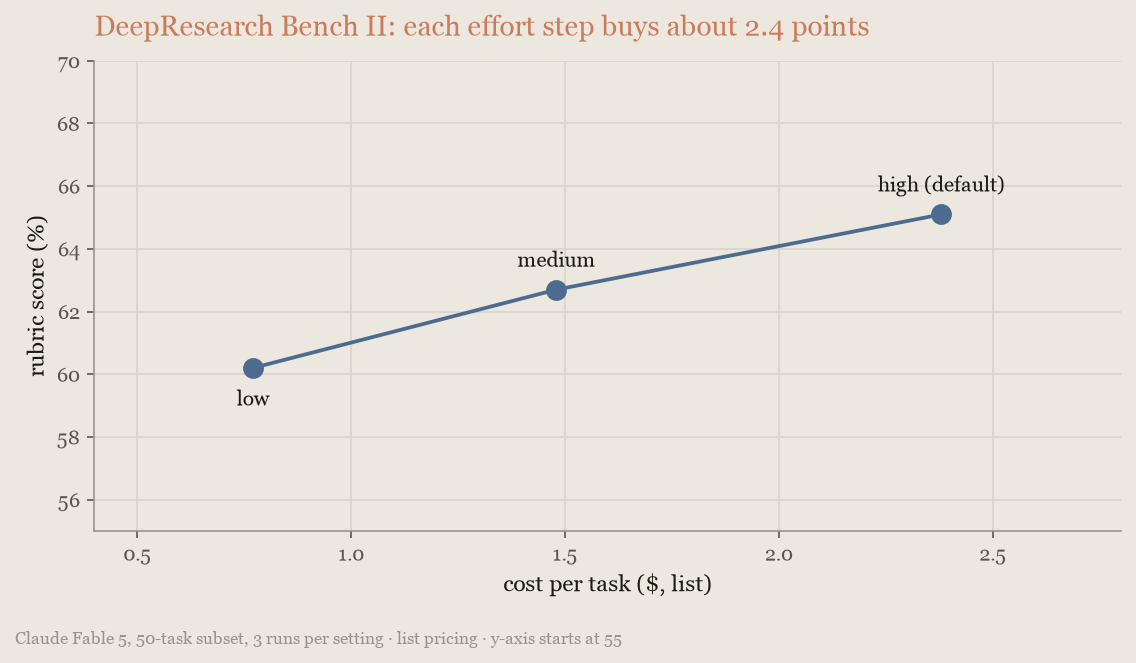
Il lavoro difficile non richiede automaticamente un effort elevato. Su DeepResearch Bench II7, Claude Fable 5.1 ha ottenuto quasi lo stesso punteggio con low, medium e high mentre il costo per attività saliva da $4,66 a $7,12, quindi in questo caso aumentare l'effort non migliora in modo evidente la qualità dell'output; sulle 21 attività valide in ogni braccio sperimentale (riferimento 7), anche Claude Fable 5 è rimasto piatto su tutti i livelli di effort, anche se la base di 33 attività del grafico, che esclude i tentativi interrotti di ciascun modello, lo mostra in crescita. Misura la curva sul modello che distribuisci, non su quello che hai misurato l'ultima volta:
La sola descrizione dell'attività non rivela che tipo di carico di lavoro hai, quindi prova due o tre livelli di effort su un campione del tuo traffico e leggi la risposta dalla curva. Testa ogni livello in una sessione separata: cambiare l'effort di primo livello a metà sessione invalida la cache (vedi Metti in cache il contesto ripetuto) e distorce il confronto. Per i dettagli sul parametro, vedi Effort.
Riesegui i fallimenti con un effort più alto
Quando l'esito di un'attività è verificabile, la politica più economica sulla curva dell'effort non è un'impostazione fissa: esegui ogni attività con un'impostazione bassa e riesegui solo i fallimenti con una più alta.
Anthropic ha calcolato questa politica attività per attività a partire dalle esecuzioni con diversi livelli di effort sul sottoinsieme di SWE-bench Pro3 in Regola l'effort. Con Claude Opus 5.5 a low, il 13% delle attività è fallito; rieseguendo queste con high, circa il 97% è stato superato per circa $0,17 ciascuna, contro il 95,3% per $0,29 eseguendo tutto con high: un tasso di successo leggermente più alto per poco più della metà del costo, contando i tentativi economici falliti. Partendo invece da medium si è risolto circa il 97% per circa $0,24. La maggior parte del piccolo miglioramento deriva dal secondo tentativo (rieseguire con high i fallimenti di un'esecuzione high ottiene circa lo stesso punteggio, spendendo di più), quindi usa questa politica per il risparmio, non per il miglioramento:
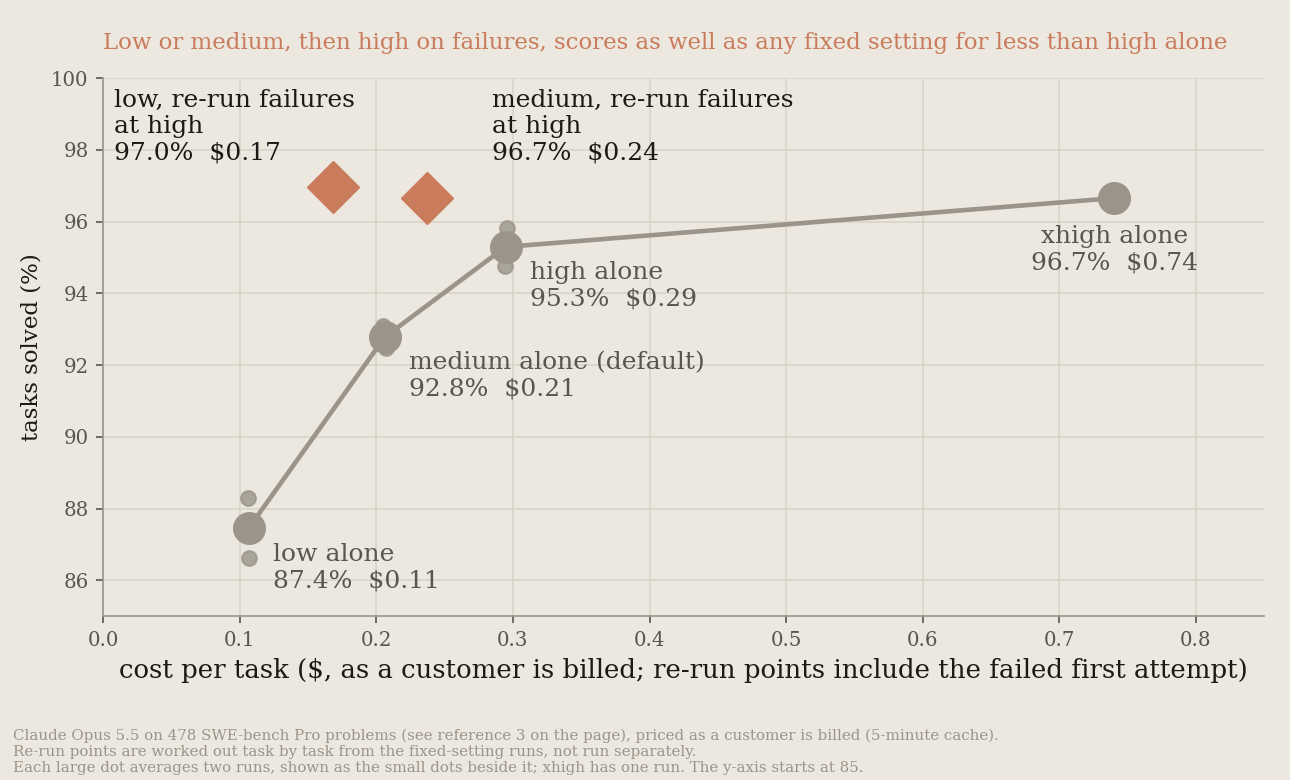
Si applicano due condizioni. Primo, ti serve un segnale di fallimento (qui, i test del benchmark stesso); un verificatore che approva lavoro scadente lascia passare quei fallimenti. Secondo, ogni fallimento al primo passaggio richiede il tempo reale di due esecuzioni, quindi il risparmio si paga in latenza sui fallimenti.
Imposta budget e limiti di output
La maggior parte delle esecuzioni di attività agentiche è economica, ma una minoranza spende molte volte il costo mediano in ricerche, riverifiche e test eccessivi. Un "task budget" (budget per attività) prende di mira questa coda. Il modello vede un conto alla rovescia dei token in tempo reale per l'intera attività e si autoregola, riducendo le ricerche di scarso valore, saltando le verifiche ridondanti e concludendo invece di andare in spirale.
Anthropic ha misurato il tasso di successo e il costo per attività su SWE-bench Pro3 con Claude Fable 5.1 man mano che il budget si restringeva:
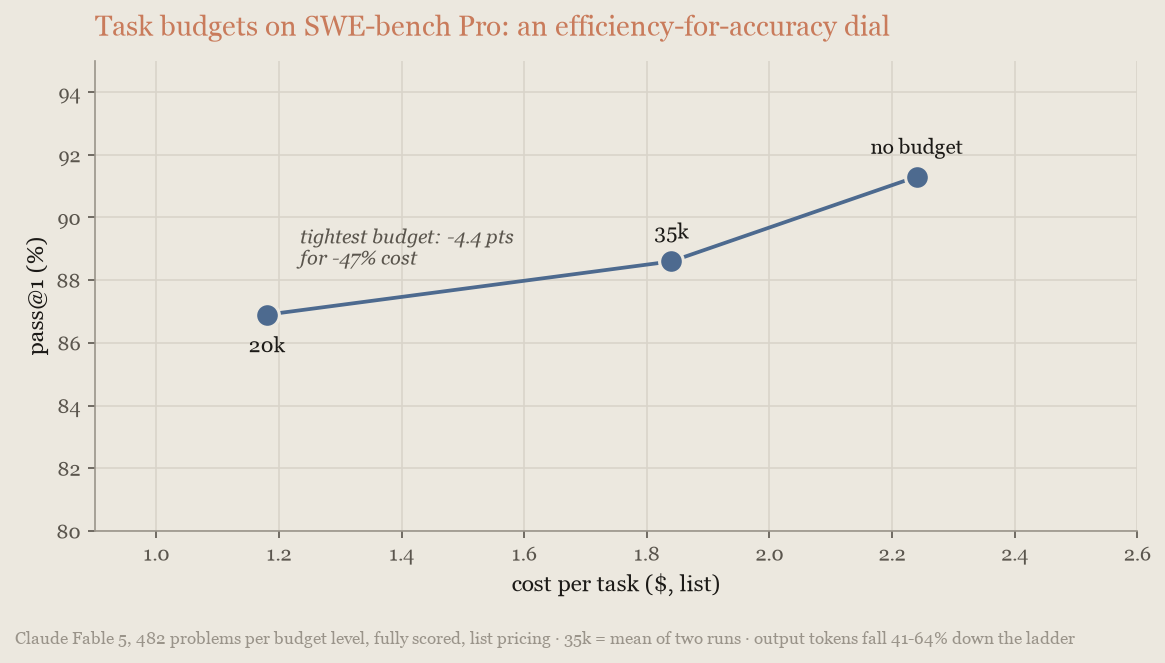
Un budget generoso ha ridotto il costo per attività del 44% per circa 3 punti di tasso di successo, al limite del rumore tra un'esecuzione e l'altra, e il budget più stretto consentito lo ha ridotto del 58% per 6 punti. Qui i budget hanno comprato efficienza, a un prezzo in tasso di successo che cresce man mano che il budget si restringe.
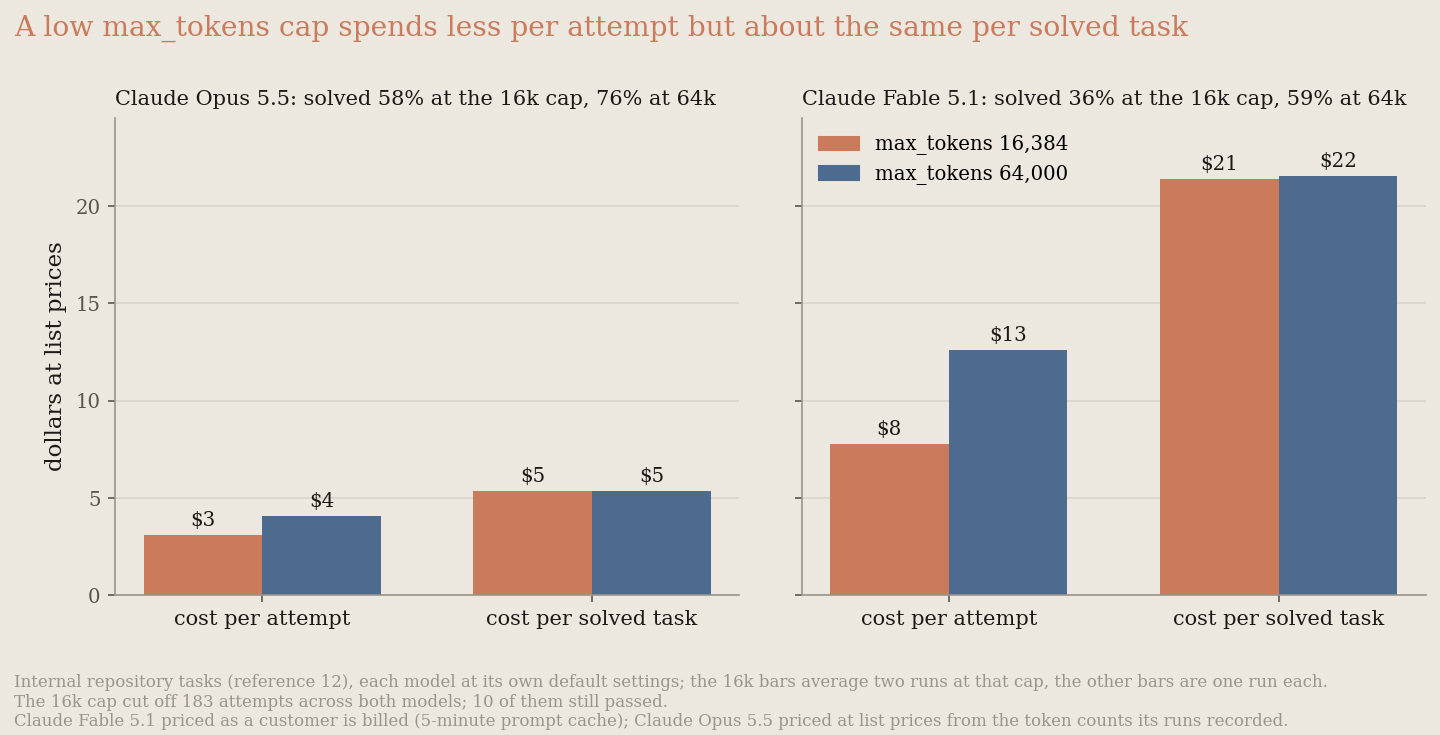
Tre controlli svolgono tre compiti diversi. Un task budget fa risparmiare denaro, perché il modello lo vede. max_tokens è un limite di sicurezza: abbassarlo ha ridotto il costo per tentativo senza ridurre il costo per attività risolta. Su Claude Managed Agents, un budget di sessione è il blocco rigido in dollari dietro entrambi. Imposta tutti e tre: un task budget, un max_tokens alto e un limite di sessione per l'esecuzione che non vorresti mai vedere in fattura, con un limite di spesa del workspace come ultima rete di sicurezza.
- I task budget sono in beta (header beta
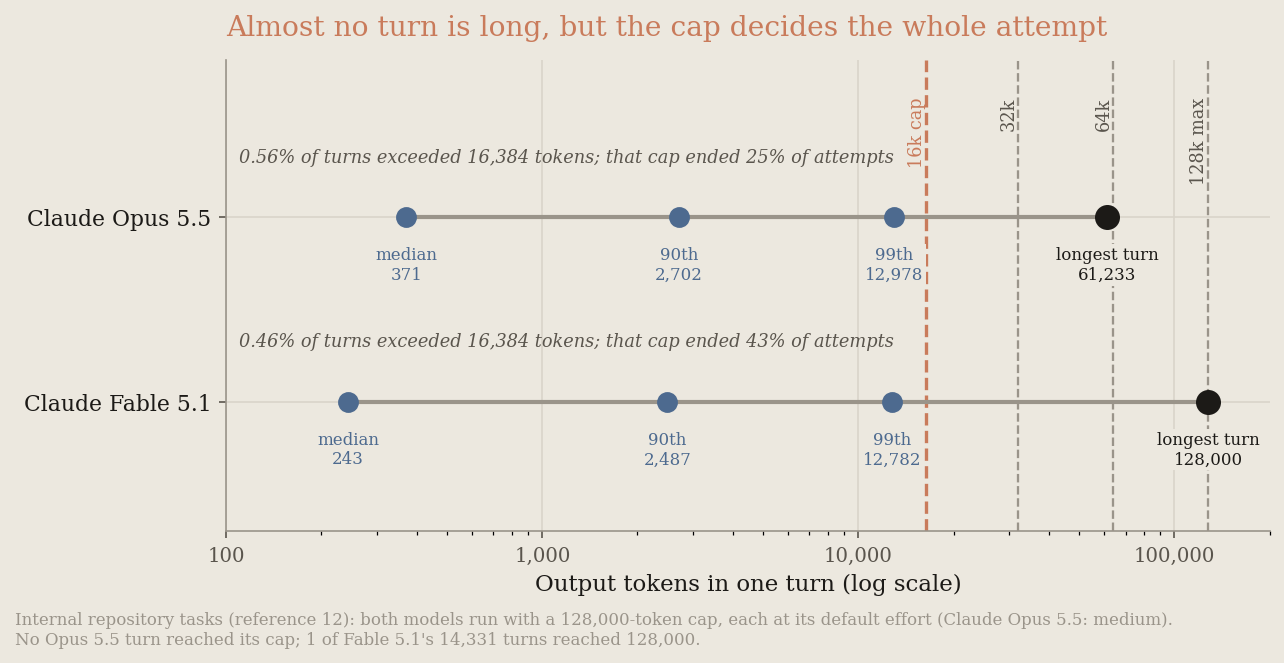
task-budgets-2026-03-13) sui modelli più recenti; controlla la tabella di supporto per sapere quali. Inizia vicino al 90° percentile di utilizzo dei token del tuo loop, poi restringi (Scegliere un budget mostra come raccogliere quella distribuzione). I budget al di sotto dell'attuale soglia minima di 20.000 token vengono rifiutati, e budget molto stretti possono produrre comportamenti simili a rifiuti. Imposta il budget una sola volta, nella prima richiesta, perché una modifica a metà attività invalida la cache. Il budget è indicativo, orienta il modello anziché fermarlo, quindi verifica che venga rispettato sul tuo carico di lavoro. max_tokenslimita una singola risposta, in modo invisibile al modello, quindi abbassarlo non fa economizzare il modello. I turni che avevano bisogno di spazio vengono scartati e comunque fatturati. Su un benchmark interno di attività su repository12, un limite di 16.384 token ha interrotto circa un quarto dei tentativi di Claude Opus 5.5 e il 43% di quelli di Claude Fable 5.1, ciascuno con il proprio effort predefinito. Solo 1 dei 66 tentativi limitati di Opus 5.5 e 9 dei 117 tentativi limitati di Fable sono comunque riusciti. Le esecuzioni limitate hanno speso meno per tentativo ma hanno ottenuto proporzionalmente meno soluzioni, quindi il costo per attività risolta è stato circa lo stesso che con 64.000 (su Fable 5.1, $21 contro $22; su Opus 5.5, entro l'1%). Con 64.000, 2 su circa 14.000 turni di Claude Fable 5.1 con il suo effort predefinito sono stati comunque interrotti (nessun turno di Claude Opus 5.5 lo è stato), e Fable 5.1 ha risolto il 58,5% delle attività invece del 36,3% (su una porzione separata del sottoinsieme di SWE-bench Pro3, descritta nel riferimento 12, nessuna differenza: 94 su 100 con entrambi i limiti). Ritentare i tentativi limitati raramente aiuta: con lo stesso limite la maggior parte fallisce di nuovo, e con uno più alto paghi anche il tentativo sprecato. Impostamax_tokensa 64.000 per il lavoro agentico, o a 128.000, il massimo, quando un singolo tentativo interrotto è costoso; con 128.000 Fable 5.1 ha risolto il 60,0% con lo stesso costo per attività risolta. Usa lo streaming per risposte così grandi, trattastop_reason: max_tokenscome un fallimento e risparmia con l'effort e i task budget, che il modello può vedere.- I budget di sessione su Claude Managed Agents sono il blocco rigido. Un budget di sessione è un limite in dollari su una sessione ai prezzi di listino per token, ricerche e tempo di sessione. Al raggiungimento del limite, la sessione si mette in pausa con
stop_reason: budget_reached; aumentare il budget la riprende. È applicato dalla piattaforma, funziona su qualsiasi modello con un prezzo di listino, inclusi i modelli su cui i task budget non sono ancora disponibili, e si combina con il task budget indicativo. I deployment applicano lo stesso campo a ogni esecuzione.
Chiedi risposte più brevi. I token di output costano cinque volte i token di input su Claude Sonnet 5, e in un loop agentico ogni token che il modello scrive ritorna come input in ogni turno successivo, quindi paghi una risposta lunga più e più volte. Anthropic ha eseguito il lavoro di triage con tre diverse istruzioni per la risposta finale, tre esecuzioni ciascuna, con lo stesso modello e gli stessi strumenti. L'originale chiedeva due righe:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>La variante più breve ne chiedeva una:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.La variante più lunga chiedeva un memo con cinque sezioni con intestazione: riepilogo del problema, prove, controllo dei duplicati, etichetta consigliata e passaggi successivi. Per una issue, un prompt in coda che non viene mai inviato dopo una domanda saltata, le prime due risposte sono state:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.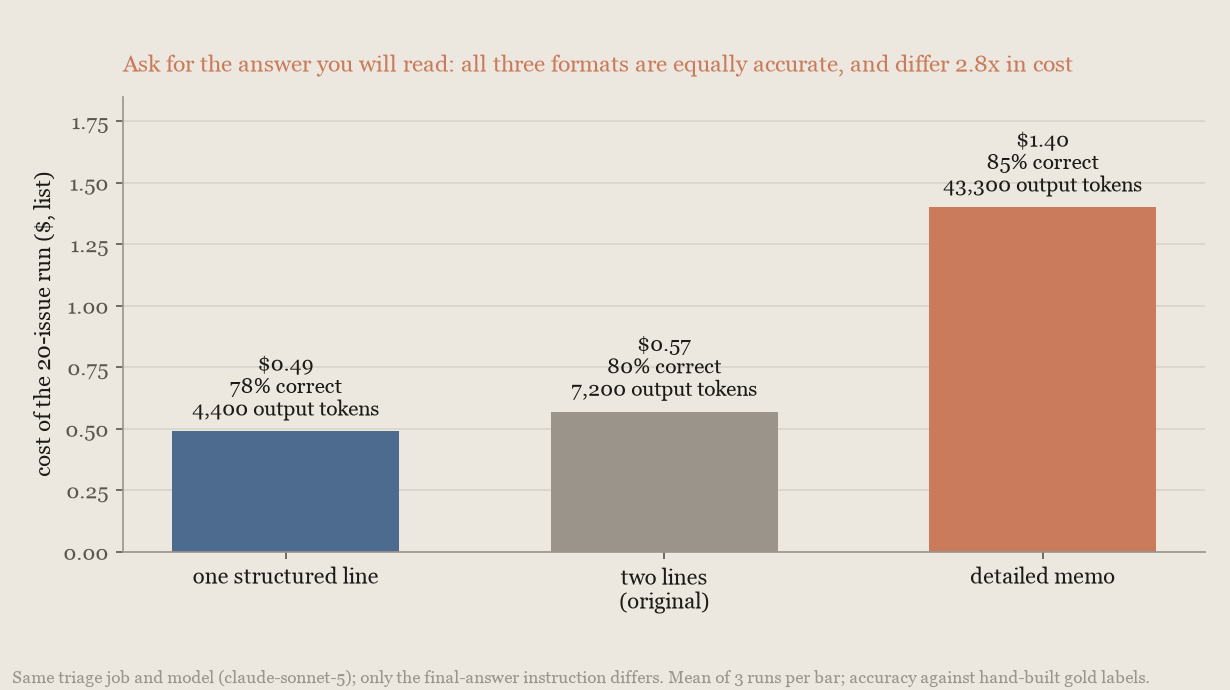
La risposta a una riga ha usato il 39% di token di output in meno rispetto all'originale a due righe e ha avuto un costo per esecuzione inferiore del 14%. Il memo ha usato sei volte i token di output e ha avuto un costo pari a 2,8 volte quello della risposta a una riga. Tutti e tre hanno ottenuto punteggi che differiscono tra loro entro il rumore tra esecuzioni rispetto alle etichette di riferimento, quindi i formati differiscono molto più in ciò che paghi che in ciò che azzeccano. Chiedi la risposta che leggerai, non quella che sembra esaustiva.
Con il limite max_tokens più basso entrambi i modelli spendono meno per tentativo ma risolvono proporzionalmente meno attività, quindi il costo per attività risolta si muove appena:
Quasi ogni turno termina molto al di sotto di entrambi i limiti. Il raro turno lungo è ciò che il limite più alto compra:
Mostra al modello il tempo trascorso
Un modello in un loop agentico non può vedere un orologio. Un task budget gli mostra quanti token restano, ma per impostazione predefinita nulla nella richiesta gli mostra quanto tempo ha richiesto il lavoro. Due piccole modifiche gli forniscono quel segnale. Aggiungi al prompt di sistema un'istruzione di due frasi che dica che il tempo conta e, dalla seconda richiesta in poi, invia il tempo trascorso prima di ciascun turno del modello.
Anthropic ha misurato entrambe le modifiche insieme su Claude Fable 5.1 a effort high, su due benchmark pubblici, DRACO21 e HLE22, e su un set interno di 70 problemi di fisica di livello di ricerca, adattati dal benchmark pubblico CritPt23. Questa pagina chiama quel set il set di fisica. Ciascuno dei tre è stato eseguito in due forme: un singolo agente e un team in cui un agente principale avvia agenti helper dello stesso modello che lavorano in parallelo. Una variazione di punteggio è considerata entro il margine quando il suo intervallo al 95% rimane entro un limite che Anthropic ha fissato prima delle esecuzioni: 1,5 punti su DRACO e 2,5 punti su HLE. Il grafico seguente mostra il punteggio rispetto al costo per attività per ciascuna configurazione. Una seconda riga di barre indica il tempo di ciascuna configurazione come rapporto rispetto al singolo agente con effort high, senza le attese dei nuovi tentativi. Una terza riga indica la variazione di punteggio prodotta da entrambe le modifiche, con il suo intervallo al 95%:
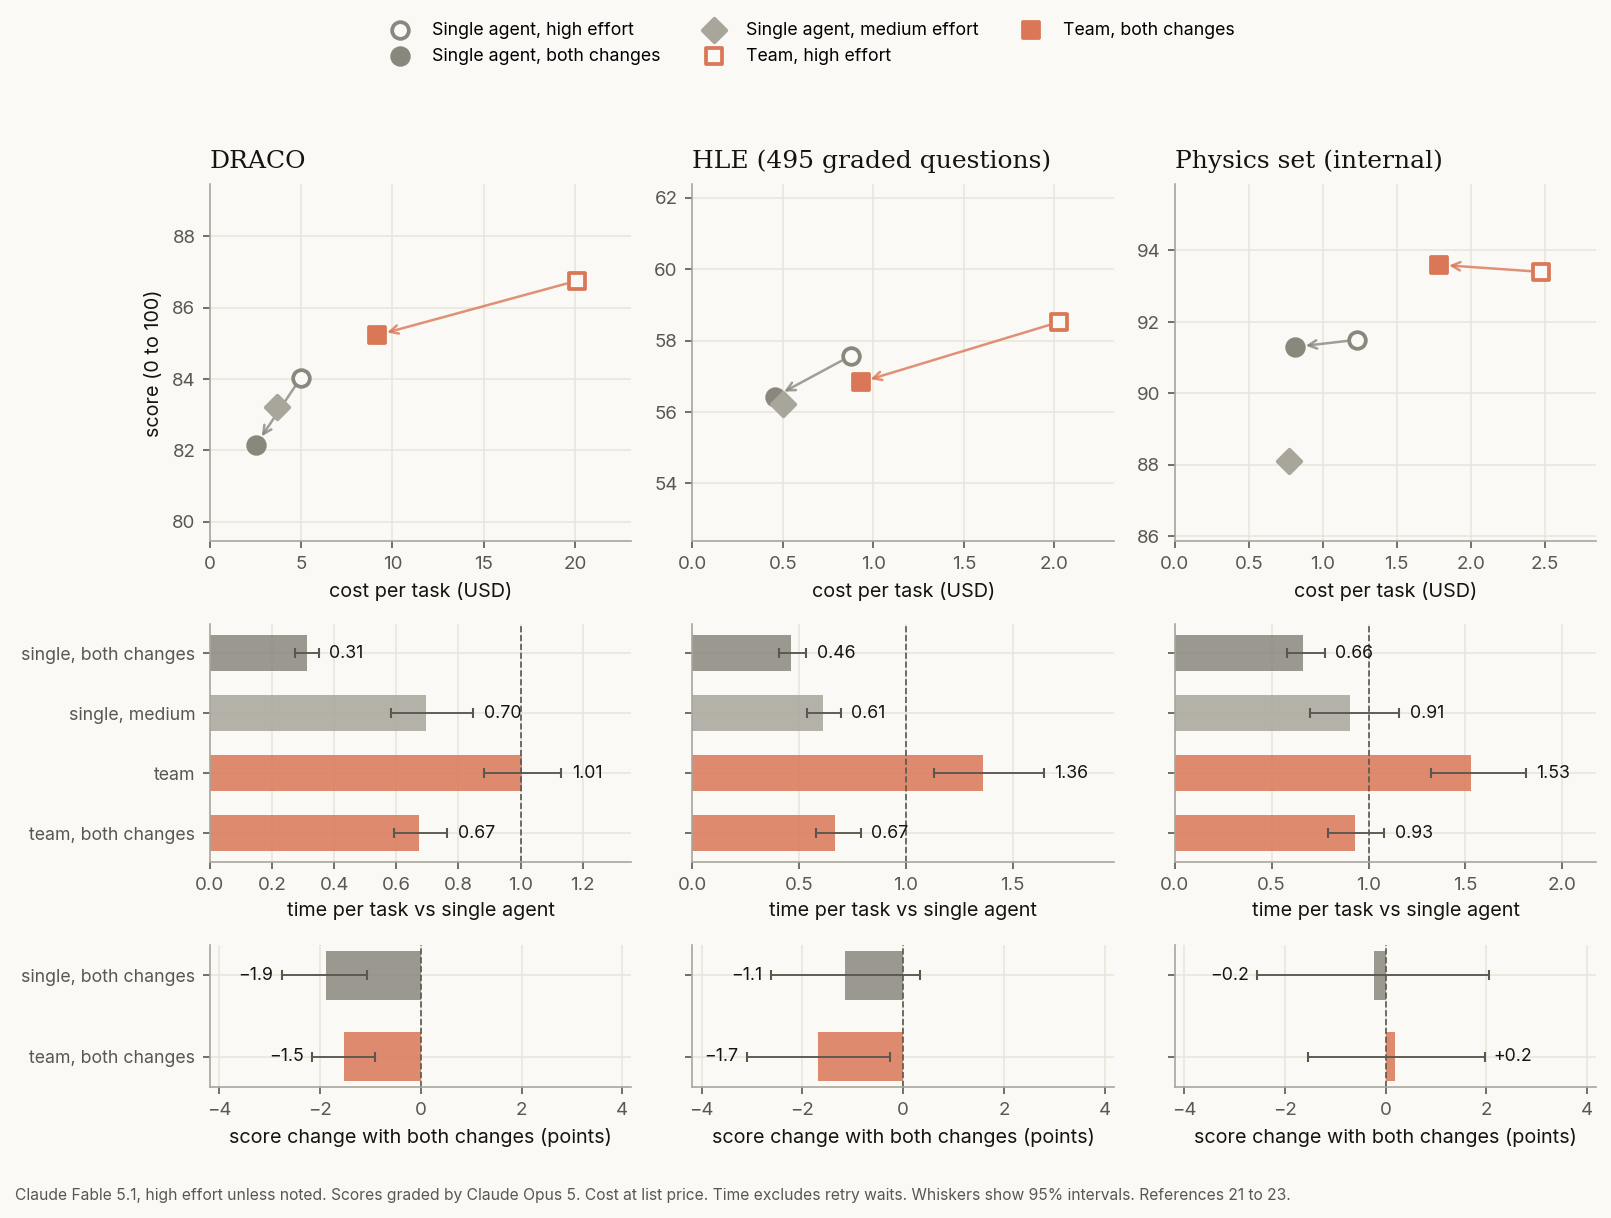
Con un team di agenti. Un team svolge più lavoro di un singolo agente, quindi per impostazione predefinita costa di più. Su DRACO, il team è costato 4,0 volte il singolo agente e ha impiegato circa lo stesso tempo (intervallo al 95% dal 12% in meno al 13% in più). Con l'istruzione e l'orologio su ogni agente, il team ha impiegato il 33% di tempo in meno, con un costo per attività inferiore del 54%. Il suo punteggio è stato inferiore di 1,5 punti (intervallo al 95% da 0,9 a 2,1 in meno), e l'estremo di quell'intervallo, 2,1 punti in meno, supera il margine di 1,5 punti. Su HLE, il team ha impiegato il 51% di tempo in meno, con un costo per attività inferiore del 54%. Il suo punteggio è stato inferiore di 1,7 punti (intervallo al 95% da 0,3 a 3,1 in meno), e l'estremo di quell'intervallo, 3,1 punti in meno, supera il margine di 2,5 punti. Sul set di fisica23, il team ha impiegato il 39% di tempo in meno. Il suo costo per attività è stato inferiore del 28%, e quel risparmio dipende da quanto spesso la cache dei prompt è scaduta tra una richiesta e l'altra. Senza scadenze, sarebbe del 23%. Il suo punteggio è stato superiore di 0,2 punti (intervallo al 95% da 1,5 in meno a 2,0 in più).
Su DRACO, l'agente principale ha avviato una mediana di 4 helper per tentativo, quindi il risultato di DRACO mostra un team che lavora in parallelo. Su HLE e sul set di fisica, l'agente principale ha avviato una mediana di 0 helper, quindi almeno metà di quelle esecuzioni del team aveva solo l'agente principale. Quei risultati del team mostrano per lo più il comportamento dell'agente principale stesso, non l'effetto degli helper in parallelo.
Con un singolo agente. Sul set di fisica23, le stesse modifiche hanno ridotto il tempo di un singolo agente del 34% e il suo costo per attività del 34%. Il suo punteggio è stato inferiore di 0,2 punti (intervallo al 95% da 2,5 in meno a 2,1 in più). Sul set di fisica, un livello di effort più basso ha fatto risparmiare sui costi ma non chiaramente sul tempo. Con effort medium, il singolo agente è costato il 37% in meno per attività rispetto a high, e il suo tempo è stato inferiore del 9% (intervallo al 95% dal 30% in meno al 16% in più). Ha ottenuto 3,4 punti in meno (intervallo al 95% da 0,4 a 6,8 in meno), e l'intervallo arriva vicino allo zero. Con entrambe le modifiche a effort high, il singolo agente ha impiegato il 27% di tempo in meno rispetto all'effort medium (intervallo al 95% dal 5% al 44% in meno). Il suo costo per attività è stato superiore del 6% (intervallo al 95% dal 12% in meno al 27% in più), e il suo punteggio è stato superiore di 3,2 punti (intervallo al 95% da 0,1 in meno a 6,5 in più).
Su HLE, le stesse modifiche hanno ridotto il tempo di un singolo agente del 54% e il suo costo per attività del 48%. Il suo punteggio è stato inferiore di 1,1 punti (intervallo al 95% da 2,6 in meno a 0,3 in più), e l'estremo di quell'intervallo, 2,6 punti in meno, supera di poco il margine di 2,5 punti. Con effort medium, il singolo agente è costato il 43% in meno per attività rispetto a high, ha impiegato il 39% di tempo in meno e ha ottenuto 1,3 punti in meno (intervallo al 95% da 2,8 in meno a 0,1 in più). Con entrambe le modifiche a effort high, il singolo agente ha impiegato il 25% di tempo in meno rispetto all'effort medium (intervallo al 95% dal 12% al 35% in meno). Il suo costo per attività è stato inferiore del 9% (intervallo al 95% dal 21% in meno al 6% in più), e il suo punteggio è stato superiore di 0,2 punti (intervallo al 95% da 1,3 in meno a 1,7 in più).
Su DRACO, le stesse modifiche hanno ridotto il tempo di un singolo agente del 69% e il suo costo per attività del 49%. Il suo punteggio è stato inferiore di 1,9 punti (intervallo al 95% da 1,1 a 2,8 in meno), e l'estremo di quell'intervallo, 2,8 punti in meno, supera il margine di 1,5 punti. Con effort medium, il singolo agente è costato il 25% in meno per attività rispetto a high, ha impiegato il 30% di tempo in meno e ha ottenuto 0,7 punti in meno (intervallo al 95% da 0,1 a 1,3 in meno). Con entrambe le modifiche a effort high, il singolo agente ha impiegato il 53% di tempo in meno rispetto all'effort medium (intervallo al 95% dal 42% al 63% in meno), e il suo costo per attività è stato inferiore del 31% (intervallo al 95% dal 28% al 35% in meno). Il suo punteggio è stato inferiore di 1,2 punti (intervallo al 95% da 0,5 a 1,9 in meno), e l'estremo di quell'intervallo, 1,9 punti in meno, supera il margine di 1,5 punti.
Su tutti e tre i set, entrambe le modifiche a effort high hanno fatto risparmiare più tempo rispetto all'effort medium. Su HLE e sul set di fisica non c'è stata una differenza chiara nei costi, e su DRACO il costo è stato inferiore. Il punteggio è stato circa lo stesso su HLE. Sul set di fisica è stato superiore di 3,2 punti, ma quell'intervallo include lo zero, quindi la differenza non è chiara. Quindi, per un singolo agente, l'orologio fa risparmiare più tempo di un livello di effort più basso. Su DRACO, però, il singolo agente con entrambe le modifiche ha ottenuto 1,2 punti in meno rispetto all'effort medium (intervallo al 95% da 0,5 a 1,9 in meno).
Quando usarlo.
- Usa entrambe le modifiche quando il tempo di un agente conta e una piccola variazione di punteggio è accettabile. In ogni configurazione misurata, hanno ridotto il tempo e il costo per attività, sia per i team sia per i singoli agenti.
- Verifica il punteggio sulle tue attività prima di adottarle. Su DRACO, il punteggio è stato inferiore di 1,5 punti per un team e di 1,9 punti per un singolo agente. Su HLE, è stato inferiore di 1,7 punti per un team e di 1,1 punti per un singolo agente. Sul set di fisica, nessuna delle due variazioni di punteggio è stata chiaramente diversa da zero.
- Se stai già pensando a un livello di effort più basso per risparmiare tempo, confrontalo con l'orologio. Un singolo agente con entrambe le modifiche a effort
highha impiegato meno tempo che con effortmedium: il 53% in meno su DRACO, il 25% in meno su HLE e il 27% in meno sul set di fisica. Il suo costo per attività è stato inferiore del 31% su DRACO, senza una differenza chiara su HLE e sul set di fisica.
Come aggiungerlo. Inserisci questa istruzione all'inizio del prompt di sistema di ogni agente:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.La seconda frase dice al modello che i messaggi dell'orologio esistono. La prima richiesta non contiene alcun orologio, e le esecuzioni misurate hanno usato esattamente questa formulazione.
Poi, prima di ogni richiesta successiva alla prima di un agente, aggiungi un messaggio di sistema a metà conversazione che indichi il tempo trascorso in secondi interi, come Elapsed time: 412 seconds. Conta dall'inizio dell'attività, non dall'avvio dell'agente. In un team, ogni agente legge lo stesso orologio, quindi il primo orologio che un helper vede conta già il tempo che il team ha impiegato prima che l'helper partisse. In un loop di strumenti, inserisci il messaggio subito dopo il messaggio user che contiene i risultati degli strumenti, come mostra Posizionamento dopo i risultati degli strumenti. Se invece invii all'agente un nuovo messaggio user, inserisci l'orologio dopo quel messaggio.
Lascia i messaggi dell'orologio precedenti dove sono. Ciascuno diventa parte della cronologia della conversazione, quindi il prefisso in cache corrisponde ancora alla richiesta successiva (vedi Combinazione con la cache dei prompt). Anthropic ha misurato questi semplici messaggi di sistema, che restano visibili al modello. Un messaggio di sistema limitato al turno mostrerebbe al modello solo l'orologio più recente, e Anthropic non ha misurato quella forma.
L'esempio seguente esegue il loop di strumenti di un agente con entrambe le modifiche. Aggiunge l'orologio dopo i risultati degli strumenti e gestisce solo gli strumenti client:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Secondi di tempo reale (wall-clock), così gli helper in altri processi possono condividere l'ora di inizio del lead.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Usa lo streaming perché un limite di 128.000 token è troppo grande per una richiesta non in streaming.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Un messaggio di sistema deve seguire un turno utente, quindi l'orologio va dopo i risultati degli strumenti.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 supporta i messaggi di sistema a metà conversazione. L'elenco dei modelli supportati copre gli altri. Su un modello che non li supporta, come Claude Sonnet 5, puoi inserire la stessa riga in un blocco di testo dopo l'ultimo blocco tool_result nel turno user. Anthropic ha misurato solo la forma con messaggio di sistema.
Su Claude Managed Agents, puoi inviare un evento system.message con un risultato di uno strumento o un messaggio dell'utente. Il messaggio si applica a quel turno e a ogni turno successivo. Quindi i turni che seguono gli strumenti integrati della piattaforma, come la ricerca web, vedono l'ultimo orologio che hai inviato, non l'ora corrente. Un system.message raggiunge inoltre solo il thread principale della sessione. In una sessione multiagente, quello è il thread del coordinatore, quindi gli agenti worker non vedono mai un orologio inviato in questo modo. Per mostrare l'ora corrente prima di ogni turno, e a ogni agente di un team, esegui tu stesso il loop dell'agente sulla Messages API.
Combina i modelli
Le architetture multi-modello si adattano a carichi di lavoro la cui complessità delle attività varia abbastanza da far sì che passi diversi siano serviti meglio da modelli diversi. Quando il tuo traffico mescola lavoro di routine che un modello più piccolo gestisce in modo affidabile con passi più difficili che richiedono capacità di frontiera, dividere il lavoro mantiene l'intelligenza di frontiera dove conta mentre la maggior parte dei token viene fatturata alle tariffe del modello più piccolo. Quando un carico di lavoro non ha quella mescolanza, perché la sua difficoltà è uniforme o è una singola catena dipendente, un singolo modello ben regolato è di solito la scelta migliore. Ogni sezione sulle strategie fornisce la regola per distinguere i due casi.
Due strategie coprono la maggior parte dei carichi di lavoro, e differiscono per quale modello tiene il loop principale:
| Strategia | Flusso di controllo | Ruolo del modello di frontiera | Adatta a | Il costo di frontiera cresce con |
|---|---|---|---|---|
| Advisor | Il modello più piccolo esegue il loop, scala su richiesta | Consultato per piani e correzioni | Lavoro seriale difficile in alcuni punti, come i molti turni di un agente di programmazione tra poche decisioni reali | Quanto spesso l'esecutore si blocca |
| Orchestratore | Il modello di frontiera esegue il loop, delega il lavoro di massa | Pianifica, distribuisce e sintetizza | Lavoro che si dirama su file, documenti o casi realmente indipendenti, specialmente più di una finestra di contesto di essi | Quanto sono difficili da coordinare i pezzi |
Strategia advisor: scala le decisioni difficili
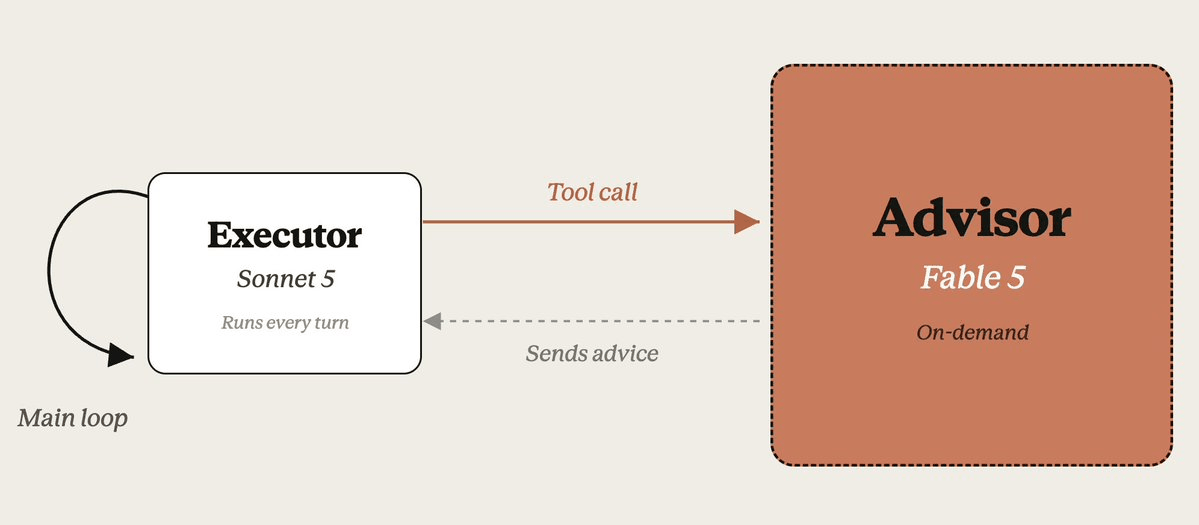
Nella strategia advisor, un modello esecutore a costo inferiore esegue il loop dell'agente e svolge la maggior parte dei turni. Quando incontra una decisione che richiede un giudizio più approfondito, come scegliere un approccio o riprendersi da un fallimento, chiama un modello advisor di intelligenza superiore per ottenere indicazioni strategiche, poi continua. La maggior parte dei token viene fatturata alle tariffe dell'esecutore, e solo le consultazioni occasionali alle tariffe dell'advisor.
Per usarla, aggiungi lo strumento advisor alla tua richiesta. Questa funzionalità beta esegue l'intera strategia lato server in un'unica richiesta /v1/messages: l'esecutore emette una chiamata allo strumento, Anthropic esegue l'inferenza dell'advisor e l'esecutore continua con il consiglio; non scrivi alcun codice di orchestrazione. Su Claude Managed Agents, fornisci un advisor alla sessione aggiungendo una voce advisor al roster multiagent dell'agente; il thread principale della sessione lo consulta allo stesso modo. Anche Claude Code lo supporta; vedi escalation delle decisioni difficili con lo strumento advisor.
Cosa determina il ritorno. L'advisor vede l'attività solo attraverso le chiamate dell'esecutore, quindi due fattori decidono quanto aiuta.
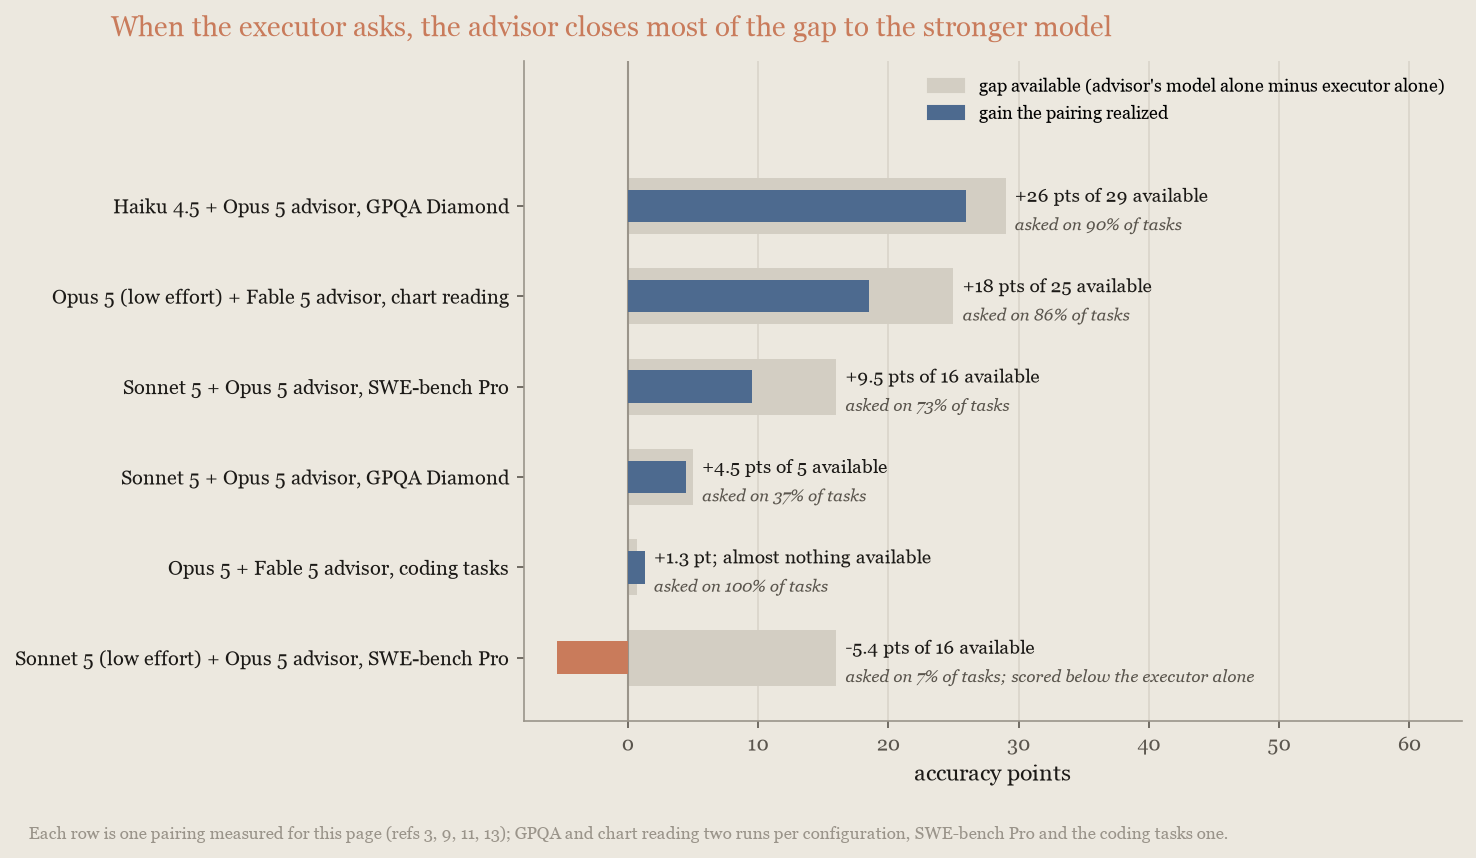
Il primo è il divario tra i modelli. L'advisor può trasferire solo le capacità che mancano all'esecutore: su GPQA Diamond9 un esecutore Claude Haiku 4.5 ha guadagnato molto da un advisor Claude Opus 5, un esecutore Claude Sonnet 5 ha guadagnato qualche punto e un esecutore di frontiera quasi nulla.
Il secondo, e quello fragile, è se l'esecutore chiede effettivamente aiuto: il "consult rate" (tasso di consultazione). Un esecutore con effort basso può smettere di rilevare di essere bloccato: un abbinamento che consulta l'advisor sulla maggior parte delle attività con l'effort predefinito può arrivare a non consultarlo quasi mai quando l'effort viene abbassato, e allora ottiene un punteggio inferiore a quello dell'esecutore da solo. Il tasso varia anche in base all'attività: su DeepSWE10 un esecutore Sonnet 5 con effort basso ha continuato a chiedere e ha guadagnato 23 punti; su SWE-bench Pro3 lo stesso esecutore ha smesso. Quando l'esecutore chiede, recupera gran parte del divario. Tra gli abbinamenti del grafico seguente il cui esecutore ha continuato a chiedere, l'advisor ha colmato almeno metà del divario rispetto al modello più forte (l'abbinamento di coding ha superato nettamente il modello più forte), e paghi il modello più forte solo per le consultazioni, il che rende possibili i casi di risparmio:
Il tasso di consultazione risponde al prompting. Con la sola descrizione integrata dello strumento, gli esecutori chiamano troppo poco, specialmente nel lavoro di coding, quindi la documentazione dello strumento advisor fornisce un prompt di sistema che chiede una chiamata prima del lavoro sostanziale e una prima di terminare, circa due o tre chiamate per attività. L'abbinamento di coding misurato di seguito ha funzionato con quella cadenza con Claude Opus 5 come esecutore, circa due consultazioni per ogni attività; con Claude Opus 5.5 come esecutore ha chiesto consiglio circa 1,4 volte per tentativo, e il 4% dei suoi tentativi non ha ricevuto alcun consiglio. Quella pagina spiega anche come sollecitare un esecutore che chiama troppo poco e come limitare le chiamate lato client per contenere i costi. Quindi tieni d'occhio il tasso di consultazione: sollecitalo con il prompt, misuralo e ripristina l'effort dell'esecutore se crolla.
Quando conviene in termini di costo. Un advisor fa risparmiare quando poche brevi consultazioni, fatturate alla tariffa dell'advisor, sostituiscono l'esecuzione del modello dell'advisor per l'intera attività. Funziona meglio quando il modello dell'advisor ha un prezzo molto superiore a quello dell'esecutore, quindi la configurazione più conveniente è un advisor di frontiera sopra un esecutore di fascia media. Un abbinamento al vertice della gamma può recuperare parte del costo del consiglio, perché il consiglio fa risparmiare anche token dell'esecutore: un esecutore a cui viene indicato l'approccio giusto esplora meno vicoli ciechi. Nell'abbinamento di coding qui sotto con un esecutore Claude Opus 5, quel risparmio ha pagato circa metà del consiglio: l'esecutore ha speso $1,26 in meno per tentativo rispetto a Opus 5 da solo con il suo valore predefinito, e le consultazioni sono costate $2,47. Con un esecutore Claude Opus 5.5, il consiglio non ha fatto risparmiare quasi nulla sul costo dell'esecutore: $1,36 per tentativo contro $1,38 per Opus 5.5 da solo con high, mentre le consultazioni sono costate $1,55.
Su un benchmark interno di coding agentico11, eseguito con un semplice agente API, un esecutore Claude Opus 5.5 con high e un advisor Claude Fable 5.1 ha ottenuto il 90,1% a $2,92 per tentativo. Sono 1,7 punti in più rispetto a Opus 5.5 da solo con high, l'impostazione dell'esecutore stesso, un divario al limite del rumore tra esecuzioni con cinque tentativi per attività, per circa 2,1 volte la spesa; rispetto a Opus 5.5 con il suo valore predefinito, medium, sono 3,5 punti per circa 3,5 volte la spesa. Si colloca più o meno sulla curva dell'effort di Opus 5.5 stesso, quindi l'advisor compra circa quanto compra un effort maggiore: Opus 5.5 da solo con xhigh ha ottenuto il 91,1% per $4,11 per tentativo (un tentativo per attività). Ad agosto, un advisor Claude Fable 5.1 sopra un esecutore Claude Opus 5 era la configurazione più accurata misurata, a $6,21 per tentativo, poco più del doppio di quanto costa l'abbinamento con Opus 5.5. Il grafico mostra l'abbinamento con Opus 5.5 rispetto alla curva dell'effort di Opus 5.5 stesso e a quella di Claude Fable 5.1 di agosto:
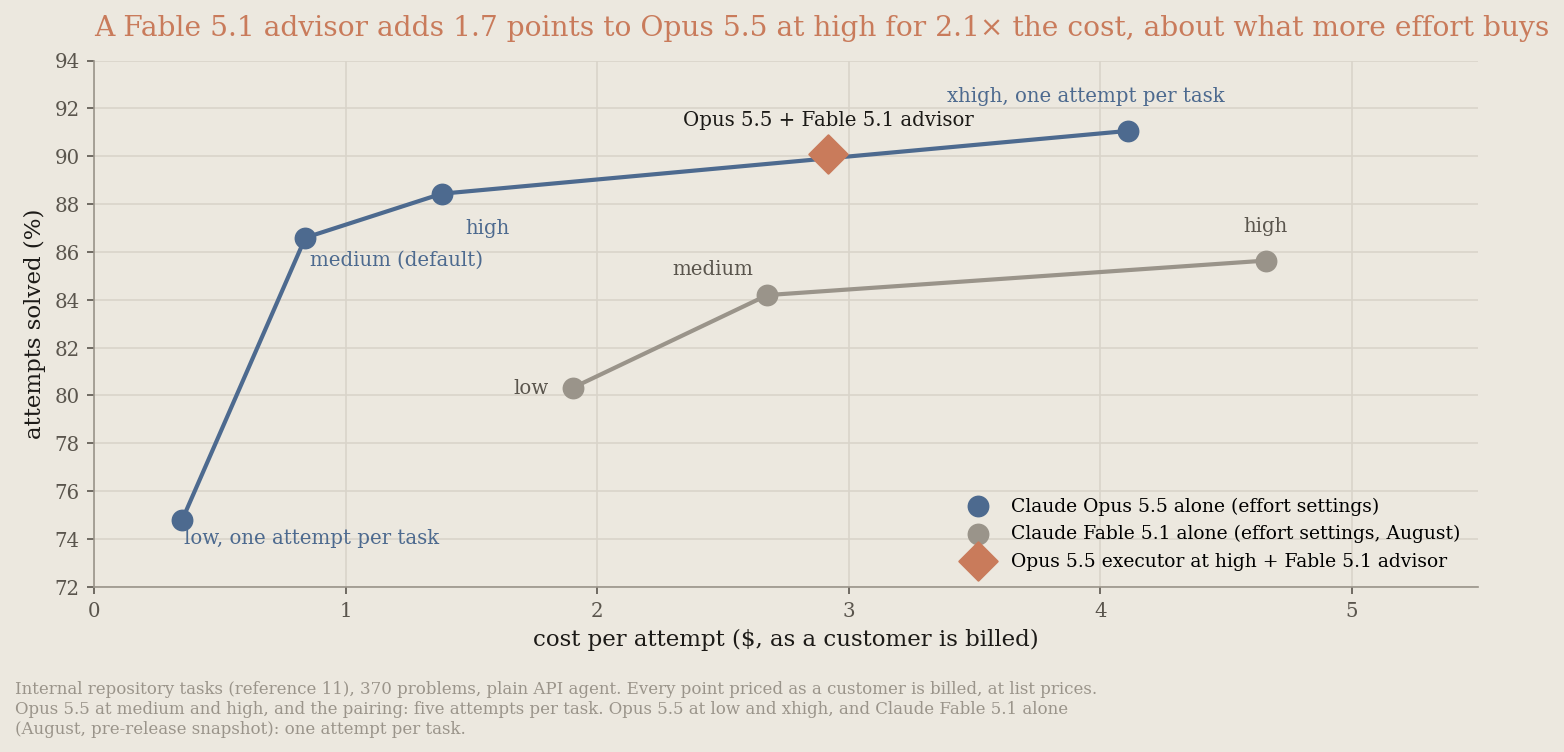
Anche una misurazione precedente tramite la modalità advisor di Claude Code ha classificato il suo abbinamento advisor sopra entrambi i suoi modelli da soli. Interpreta il risultato di Claude Opus 5.5 come un andamento da testare sul tuo carico di lavoro: l'advisor compra qualche punto per circa il doppio di quanto costa l'esecutore da solo. Un divario di capacità più ampio non garantisce un affare migliore. Il costo in latenza sono le consultazioni stesse: circa una o due chiamate aggiuntive al modello di frontiera per attività su questo benchmark, ciascuna sul percorso critico dell'attività.
Quando il modello più forte da solo è il passo migliore. Dove l'accuratezza di un carico di lavoro risponde all'effort, confronta l'abbinamento con il modello dell'advisor da solo con un'impostazione ridotta prima di costruirlo: l'advisor si paga solo sulle attività che ne hanno bisogno, ma una consultazione che scatta sulla maggior parte delle attività costa più che eseguire direttamente il modello più forte. Su Chartography13, un esecutore Claude Opus 5.5 con low, dotato di un advisor Claude Fable 5.1, lo ha consultato su 1 attività su 300 e ha ottenuto 61,7, 7 punti sotto Opus 5.5 da solo e oltre il rumore tra esecuzioni, a circa lo stesso costo; ad agosto, un esecutore Claude Opus 5 consultava l'advisor su quasi ogni attività, e quell'abbinamento eguagliava Fable 5.1 da solo con medium entro il rumore tra esecuzioni (65,0 contro 67,5) a circa 1,8 volte il costo per attività. Misura prima il tuo tasso di consultazione: se l'esecutore chiede sulla maggior parte delle sue attività, stai pagando le tariffe dell'advisor sull'intero carico di lavoro, ed eseguire direttamente il modello dell'advisor è il modo più economico per ottenere lo stesso punteggio.
Qualunque sia l'abbinamento, valuta prima il costo del modello dell'advisor da solo con effort basso; quella è la baseline da battere. Ricontrolla a ogni rilascio di modello, perché i rilasci spostano sia il divario di capacità sia il rapporto di prezzo.
Quando è adatta. La strategia advisor si adatta a carichi di lavoro in cui i turni sono per lo più meccanici ma un piano eccellente conta: agenti di coding, computer use e pipeline di ricerca in più passaggi. È poco adatta quando ogni turno richiede davvero capacità di frontiera, quando non c'è nulla da pianificare (domande e risposte a turno singolo) o quando il tuo esecutore è già vicino alle capacità dell'advisor.
Strategia orchestratore: delega il lavoro di massa
Nella strategia "orchestrator" (orchestratore), il "frontier model" (modello di frontiera) mantiene il controllo del ciclo. Scompone l'attività, invia le sottoattività a modelli "worker" (lavoratori) a costo inferiore e unisce i loro risultati. La trascrizione dell'orchestratore rimane breve perché i worker assorbono l'esplorazione ad alto consumo di token. Per questo la maggior parte dei token viene fatturata alle tariffe dei worker, mentre il piano e la sintesi provengono comunque dal modello di frontiera.
Per costruirne uno, usa l'orchestrazione multiagente in Claude Managed Agents: configura un agente coordinatore (l'orchestratore) e un insieme di agenti worker, ciascuno con il proprio modello. Per un esempio funzionante completo con un coordinatore di frontiera e worker Claude Sonnet 5, consulta la ricetta del Claude Cookbook Pattern coordinatore: modelli grandi per la pianificazione, modelli piccoli per l'esecuzione.
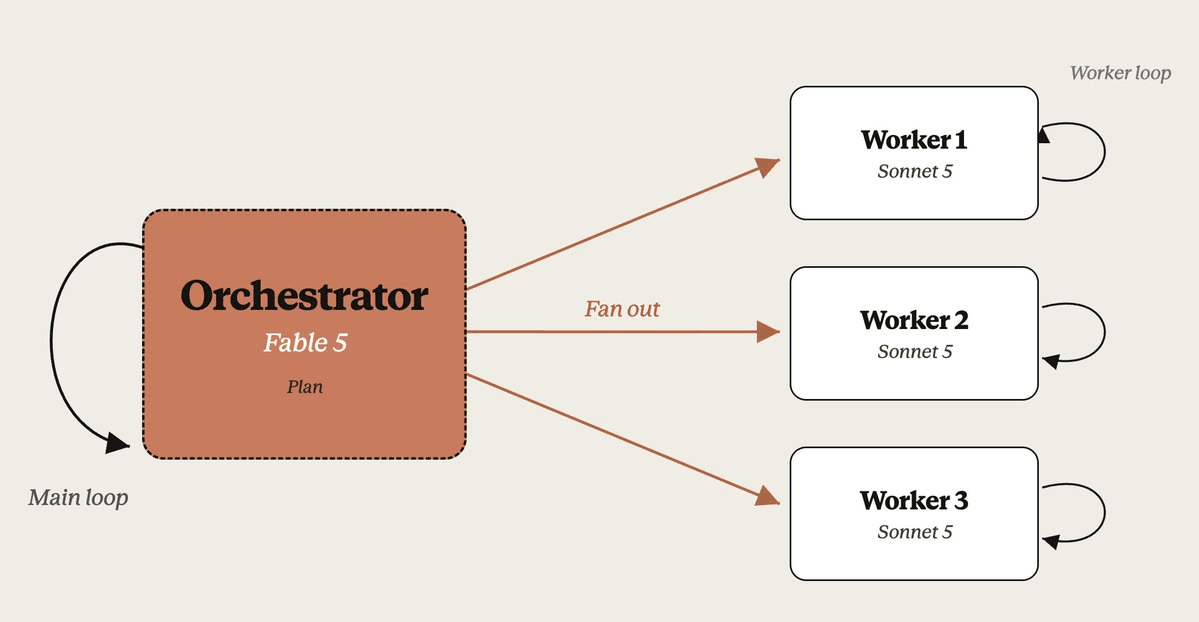
Questo pattern fa risparmiare tempo reale quando i worker possono essere eseguiti in parallelo. Sul benchmark del corpus8, un episodio ha richiesto circa 2,3 ore con il coordinatore che eseguiva 25 worker simultanei, il limite documentato della piattaforma, rispetto alle 15-20 ore del modello in solitaria. Ha fatto risparmiare denaro solo in due delle situazioni misurate. Sul lavoro che un singolo modello poteva gestire da solo, lo stesso modello con un effort inferiore è risultato ogni volta più economico.
Quando i worker vengono eseguiti in parallelo, un'istruzione sul tempo e un orologio del tempo trascorso possono accorciare l'esecuzione. Su DRACO21, un team di agenti con lo stesso modello, dotati dell'istruzione e dell'orologio, ha impiegato il 33% di tempo in meno, con un costo per attività inferiore del 54%, ottenendo un punteggio inferiore di 1,5 punti. Ogni agente di quel team aveva l'istruzione e l'orologio. Anthropic non ha misurato l'effetto dell'orologio con worker a costo inferiore. Su Claude Managed Agents, l'orologio raggiunge solo il coordinatore, quindi i worker non lo vedono mai. Anthropic non ha misurato un team in cui solo il coordinatore ha l'orologio. Inoltre, l'orologio del coordinatore è aggiornato solo nei turni che seguono i tuoi risultati degli strumenti o i tuoi messaggi. La sezione Mostra al modello il tempo trascorso contiene la ricetta per un ciclo agentico che esegui sulla Messages API.
Caso 1: un'assicurazione contro la coda dei costi sul lavoro di routine. Un modello di frontiera che lavora da solo a volte va in spirale su un problema di routine che normalmente risolverebbe. Poiché non puoi sapere in anticipo quali esecuzioni andranno in spirale, poche esecuzioni di questo tipo dominano la fattura. Un coordinatore che affida il lavoro di routine a un worker a costo inferiore limita quella coda, perché qualsiasi spirale ora avviene alle tariffe dei worker.
Anthropic ha misurato questo effetto su una porzione deliberatamente facile di BrowseComp4: 10 problemi che il modello in solitaria risolve in modo affidabile, con 50 esecuzioni delegate e 70 in solitaria. Un coordinatore Claude Fable 5 con un worker Claude Sonnet 5 è costato in media circa la metà di Claude Fable 5 da solo e circa un terzo al 90° percentile ($12 rispetto a $33). Inoltre, l'esecuzione singola più costosa del modello in solitaria, da $84, ha dato anche una risposta sbagliata:
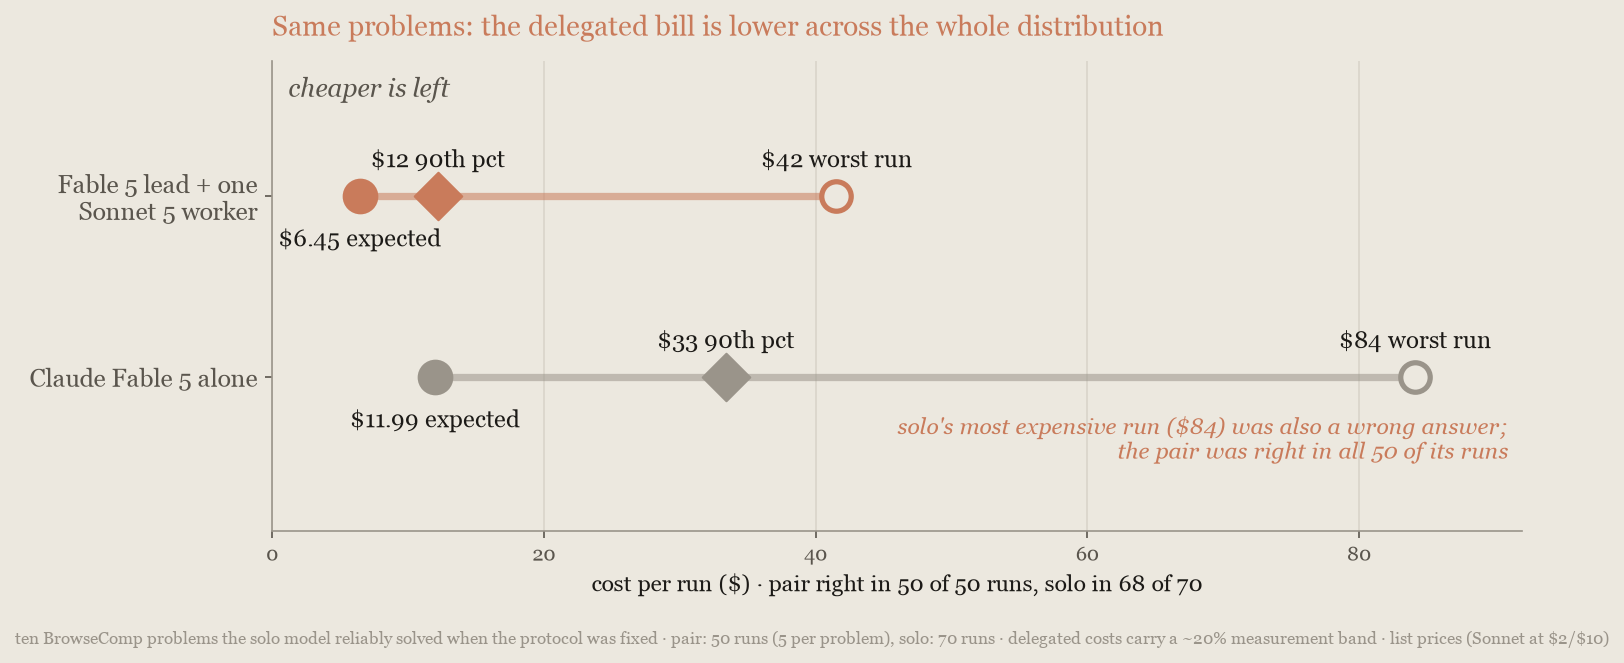
La delega ha ripagato sulla quota di lavoro di routine, normalmente risolvibile. È l'opposto dell'intuizione secondo cui i worker servono per i problemi difficili. Sull'insieme completo e più difficile di BrowseComp, il bilancio economico si è invertito. Se il tuo traffico ha una lunga coda dei costi sulle attività di routine, questo è il caso dell'orchestratore da misurare per primo.
Caso 2: lavoro più grande di una "context window" (finestra di contesto). Un modello in solitaria deve elaborare un input così grande in modo seriale, una finestra di contesto alla volta, pagando per rileggere il proprio stato a ogni passaggio. I worker invece leggono ciascuno la propria partizione, in parallelo e alle tariffe dei worker. Il lavoro ad alta intensità di lettura che rientra ancora in una finestra di contesto è un problema di scelta del modello, non di delega. Considerando solo il costo di lettura, l'orchestratore risulta vantaggioso solo quando nessun singolo contesto può contenere il lavoro.
Anthropic ha creato un benchmark per questo caso8: un corpus di 21,6 milioni di token composto da 14 pacchetti Python pubblici con 130 difetti inseriti, troppo grande per qualsiasi finestra di contesto. Ridurre l'effort non può aiutare, perché la fattura corrisponde alla lettura stessa del corpus. Claude Fable 5.1 in solitaria è costato da $468 a $552 per episodio nelle tre impostazioni di effort, e solo la sua accuratezza è cambiata. La configurazione con coordinatore, un lead Claude Fable 5.1 con 25 worker Claude Sonnet 5, è costata circa la metà di quelle impostazioni (dal 47% al 55% in meno). Ha ottenuto un punteggio inferiore di 10-12 punti, in circa 2,3 ore per episodio contro 15-20, e ha superato nettamente una baseline Claude Sonnet 5 in solitaria:
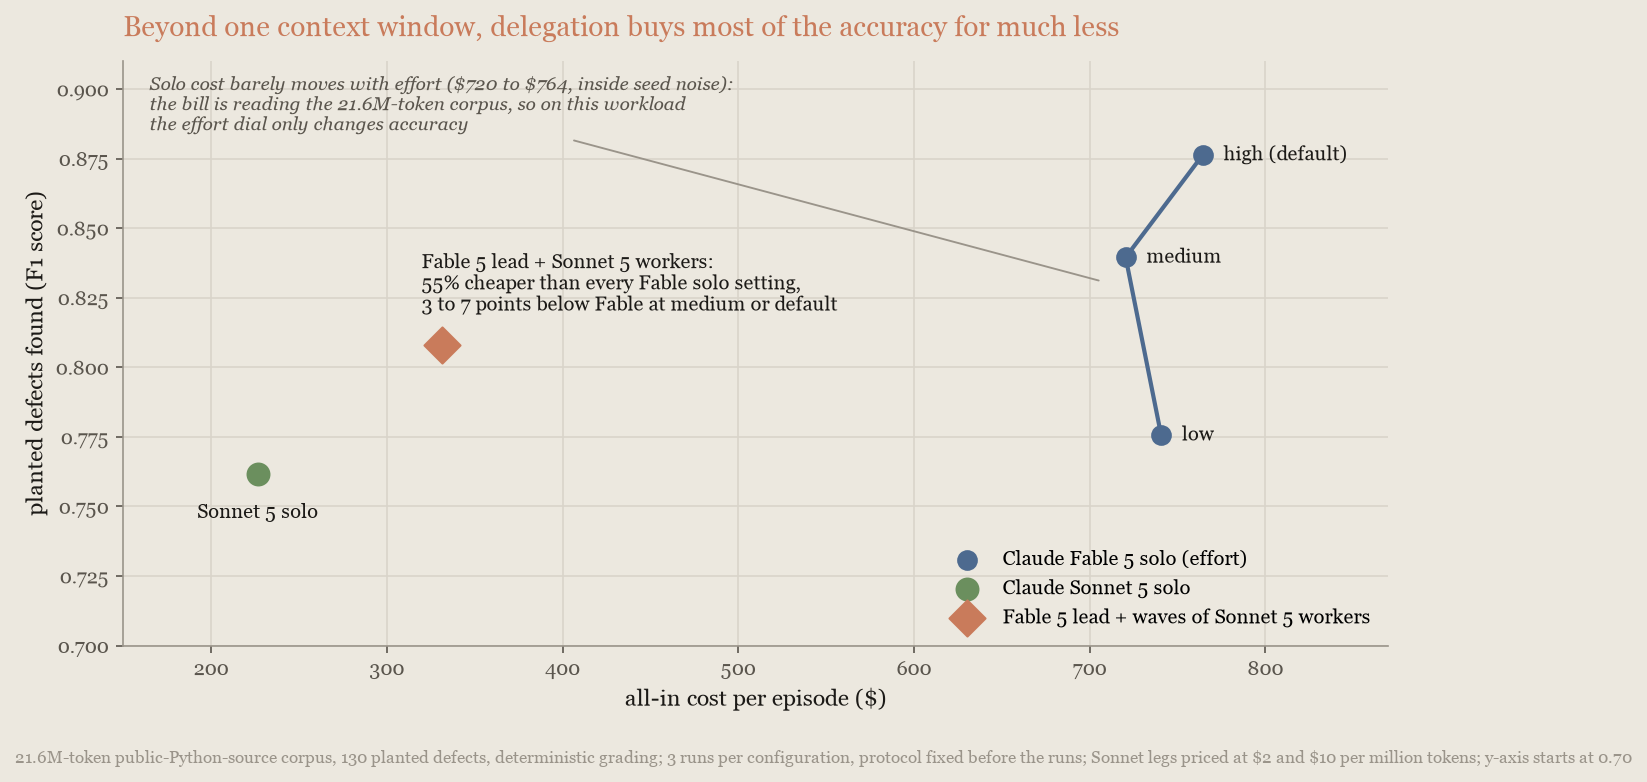
Il conteggio dei token mostra la portata della lettura. La configurazione con coordinatore ha letto circa 560 milioni di token dalla cache per episodio, circa una volta e mezza i circa 365 milioni del modello in solitaria. Quasi tutti sono stati fatturati alla tariffa di lettura dalla cache di Claude Sonnet 5, e nel complesso la configurazione è comunque costata circa la metà. Fable 5.1 con effort high mantiene comunque la massima accuratezza, a circa 2,2 volte il costo della configurazione con coordinatore. Qui la delega ottiene quindi la maggior parte dell'accuratezza, non tutta.
Quando la delega non ripaga. Un orchestratore offre un vantaggio solo quando c'è una mole di lavoro da affidare: molti pezzi indipendenti, idealmente troppi per una finestra di contesto. Quando il lavoro è un'unica catena di passaggi dipendenti, o rientra in un singolo contesto, l'orchestratore paga per un piano, un passaggio di consegne e un'unione che un singolo modello ottiene gratuitamente. In ogni caso di questo tipo misurato, il modello del coordinatore da solo con un effort inferiore è risultato più vantaggioso.
Il confine è la difficoltà dell'attività, non il benchmark. Sull'insieme completo e più difficile di BrowseComp4, Claude Fable 5 da solo ha raggiunto l'accuratezza della configurazione con coordinatore con un costo inferiore dal 22% al 30%. Lavori esterni indipendenti riportano lo stesso schema5. Non costruire un orchestratore se il lavoro è un'unica catena, se rientra in un contesto senza una lunga coda dei costi o se un singolo modello con un effort inferiore soddisfa già i tuoi requisiti.
Scegli tra le strategie
La maggior parte dei casi si riduce a una domanda: il lavoro si divide in pezzi indipendenti, o è una singola risposta raggiunta attraverso una catena di passi dipendenti? La tabella delle strategie associa le due risposte alle due strategie.
Se non sei sicuro, non costruire ancora nulla:
- Prova prima diversi livelli di effort sul tuo modello attuale. È l'esperimento più economico di questa pagina, e la maggior parte dei carichi di lavoro si ferma lì.
- Se la prova mostra un divario, calcola il prezzo del modello più forte da solo a effort basso. Quello è il numero che un abbinamento advisor deve battere, e gli abbinamenti di questa pagina che lo hanno battuto sono stati quelli il cui esecutore ha effettivamente consultato.
I risultati multi-modello di questa pagina sono stati giudicati rispetto allo stesso modello a effort più basso e rispetto al modello immediatamente inferiore eseguito da solo. Quello è il confronto da eseguire sul tuo carico di lavoro, ed è il motivo per cui il primo passo è una prova dei livelli di effort.
Quando aggiungi un advisor, si tratta di una definizione di strumento piuttosto che di una riprogettazione dell'architettura.
Misura sul tuo carico di lavoro
I numeri di questa pagina riflettono i prezzi di listino al momento della misurazione e cambieranno con l'evoluzione dei modelli e dei prezzi. Li influenzano anche il tuo tasso di escalation, la nettezza con cui le attività si suddividono e la lunghezza della trascrizione. Il metodo rimane lo stesso:
- Estrai alcune attività dai log di produzione, ponderate come il traffico reale, e scrivi controlli sui risultati per ciascuna: test superati, ticket chiuso, numero di righe corretto. Registra il costo per attività accanto al punteggio. Per calcolarlo, applica a ciascuno dei cinque conteggi di token tariffati nel campo
usagedi ogni risposta la rispettiva tariffa: input non in cache, scritture nella cache a 5 minuti e a 1 ora (a 1,25x e 2x il prezzo dell'input), letture dalla cache e output. Somma poi i costi di tutte le richieste dell'attività. L'API Usage and Cost riporta il totale aggregato. - Stabilisci una baseline per ogni livello di modello su tutti i livelli di effort, non solo su quello predefinito, e traccia il punteggio rispetto alla spesa. Una configurazione multi-modello deve battere l'intera curva del singolo modello.
- Se la curva mostra un divario che l'effort non riesce a colmare, aggiungi la strategia multi-modello adatta ed esegui di nuovo la suite.
- Esegui la configurazione vincente in modalità shadow su una porzione del traffico prima del passaggio definitivo, poi mantieni la suite in esecuzione.
L'esempio seguente calcola il costo del passaggio 1 per una singola richiesta ai prezzi di listino di Claude Opus 5.5:
# Prezzi per milione di token dalla pagina dei prezzi; modifica questi tre valori per un altro modello.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0,05x il prezzo di input su Claude Opus 5.5; il moltiplicatore varia in base al modello
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Le scritture in cache da 1 ora costano 2x il prezzo di input, quelle da 5 minuti 1,25x; le letture al prezzo di lettura cache.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
Nei cicli agentici la maggior parte dei token di input dovrebbe provenire da letture dalla cache. Se cache_read_input_tokens è piccolo rispetto a input_tokens più cache_creation_input_tokens, verifica che la cache sia attiva e che il prefisso rimanga lo stesso tra le richieste. Quando è abilitato lo strumento advisor o la compattazione, alcuni token vengono riportati solo in usage.iterations e non nei totali di primo livello. In questo caso somma i valori di usage.iterations e applica alle voci advisor_message le tariffe del modello advisor.
La tabella seguente elenca le leve nell'ordine in cui provarle:
| Leva | Risparmio in queste esecuzioni | Costo in qualità | Latenza | Dove |
|---|---|---|---|---|
| Cache dei prompt | Costo ridotto di un fattore da 2,7 a 5,3 nei cicli agentici; 83% nell'esecuzione di triage | Nessuno | Più veloce | Metti in cache il contesto ripetuto |
| Durata della cache di 1 ora | Più economica del valore predefinito di 5 minuti quando circa 1 turno su 20 segue una pausa tra 5 minuti e un'ora e poche pause superano l'ora. Fanno eccezione Claude Fable 5.1, dove mantenere calda la cache da 5 minuti è più economico finché le pause durano pochi minuti e la durata di 1 ora conviene quando le pause si avvicinano all'ora, e Claude Opus 5.5, dove mantenere calda la cache da 5 minuti è più economico quando solo uno o due turni su 20 seguono una pausa fino a circa mezz'ora. Senza pause, il valore predefinito è costato il 15% in meno su Claude Sonnet 5 e circa dal 15% al 18% in meno su Claude Opus 5.5 | Nessuno | Rimane calda dopo una pausa | Scegli la durata della cache |
| Riduzione dell'input | Ulteriori 5 punti percentuali nell'esecuzione di triage | Nessuno | Neutra | Taglia i token di input e di contesto |
| Eliminazione dei risultati degli strumenti obsoleti al termine di ogni attività | 39% nella lunga esecuzione di triage (compattazione 32%); nessuno nei cicli brevi | Nessuno misurato | Neutra | Taglia i token di input e di contesto |
| Ricerca degli strumenti | 45% con 500 definizioni di strumenti collegate; 20% con un server MCP di GitHub | Nessuno | Neutra | Taglia i token di input e di contesto |
| File di dati tramite esecuzione del codice | 92% su un'attività sui dati da 25 domande | Un guadagno: 25 su 25 invece di 6 su 25 | Più veloce | Taglia i token di input e di contesto |
| Batch API | 50% | Nessuno | Risultati entro 24 ore | Metti in batch il lavoro che può attendere |
| Revisione dei prompt rispetto al modello attuale | 14% in entrambe le migrazioni misurate | Nessuno; un guadagno in una delle due | Più veloce (meno round di chiamate agli strumenti) | Verifica i prompt rispetto al modello attuale |
| Aggiornamento del modello | Da Opus 4.8 a Opus 5: 12 punti in più con un costo per attività risolta superiore del 21% (Opus 5 a low batte Opus 4.8 a circa il 30% del costo); da Sonnet 4.6 a Sonnet 5: 15% in meno per attività risolta, 5 punti in più; da Fable 5 a Fable 5.1: 43% in meno per attività risolta con un punteggio pressoché invariato | Un guadagno | Neutra | Aggiorna il modello |
| Effort più basso | Lavoro intellettuale: medium dal 13% al 31%, low da un terzo alla metà; coding lungo: medium circa il 30% e low circa due terzi, entrambi rispetto a high | Da 1 a 3 punti nel lavoro intellettuale, da 2 a 8 nel coding lungo | Più veloce | Regola l'effort |
| Riesecuzione dei fallimenti | Circa il 40% rispetto all'esecuzione di tutto a high, con un tasso di successo uguale o leggermente migliore | Nessuno | Due esecuzioni sulle attività che falliscono | Riesegui i fallimenti con un effort più alto |
| Task budget | Dal 44% al 58% | Da 3 a 6 punti | Più veloce | Imposta budget e limiti di output |
| Richiesta di risposte più brevi | 39% dei token di output, 14% del costo nell'esecuzione di triage | Nessuno | Più veloce | Imposta budget e limiti di output |
Aumento di max_tokens | Nessuno per attività risolta, ma più attività risolte | Guadagni fino a 22 punti sul set interno; nessuno sulla coppia pubblica | Neutra | Imposta budget e limiti di output |
| Advisor | Dipende dal divario di capacità e dal tasso di consultazione. L'abbinamento per il coding ha ottenuto 1,7 punti in più rispetto a Claude Opus 5.5 da solo a high a circa 2,1 volte il prezzo, più o meno quanto si ottiene con un effort maggiore. Con Claude Opus 5.5, l'abbinamento per la lettura di grafici non ha quasi mai consultato l'advisor e ha ottenuto 7 punti in meno rispetto a Opus 5.5 da solo | Un guadagno nel coding, una perdita nella lettura di grafici | Circa una o due chiamate extra per attività | Strategia advisor |
| Orchestratore | Circa la metà rispetto al modello di frontiera, sia sul lavoro che supera una finestra di contesto sia sulle code dei costi del lavoro di routine (queste ultime misurate su Claude Fable 5) | Da 10 a 12 punti sotto il modello di frontiera | Molto più veloce su input di grandi dimensioni | Strategia orchestratore |
Benchmark citati
Salvo diversa indicazione in un riferimento, le misurazioni sono esecuzioni interne di Anthropic di questi benchmark. Salvo diversa indicazione, i costi sono in USD ai prezzi di listino in vigore al momento dell'esecuzione di ciascun benchmark; i dati di Claude Sonnet 5 usano $2 e $10 per milione di token di input e di output. I grafici etichettati "notional USD" (USD nozionali) calcolano il prezzo dei conteggi di token di ciascuna richiesta a quelle tariffe anziché riportare fatture.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Attività di ricerca web ampia valutate in base alla completezza e all'accuratezza di una tabella con molte righe; 200 problemi, 3 esecuzioni per configurazione, eseguite dal 1° al 2 agosto 2026. Il grafico sulla concentrazione dei costi deriva da un'esecuzione separata su 20 problemi, 3 esecuzioni per problema, eseguita dal 3 al 4 agosto 2026, con costi calcolati dai registri di fatturazione per richiesta.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Deliverable di lavoro intellettuale valutati rispetto a rubriche specifiche per attività; un'esecuzione su 210 attività del gold set rilasciato, un tentativo per attività, eseguita il 2 agosto 2026. La valutazione è affidata a un modello Claude, quindi i punteggi assoluti possono differire dai risultati pubblicati.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Un sottoinsieme di 482 problemi selezionato per la compatibilità con l'harness di valutazione di Anthropic; i punteggi non sono confrontabili con la classifica pubblica. Non sono nemmeno confrontabili con i risultati di SWE-bench Pro nella system card di Claude Opus 5.5, che provengono da esecuzioni a effort
maxsu un diverso insieme di problemi. I dati di Claude Opus 5.5 sono la media di due esecuzioni alow,medium(il suo valore predefinito) ehigh, e usano un'esecuzione axhigh, tutte eseguite dal 19 al 20 settembre 2026, con lo stesso limite di 16.384 token per turno delle esecuzioni di agosto di Claude Opus 5; il limite ha troncato 2 tentativi axhighe nessuno alle altre impostazioni. Le esecuzioni di Opus 5.5 hanno usato una versione del benchmark i cui container di valutazione possono raggiungere solo mirror interni dei pacchetti. Quella versione esclude un problema il cui test richiede un sito web attivo, e su altri tre la soluzione di riferimento fallisce in quell'ambiente, quindi i confronti con Opus 5.5, e i dati di Claude Fable 5.1 affiancati a essi, usano i restanti 478 problemi. I dati di SWE-bench Pro di Claude Opus 5 in Aggiorna il modello e nel grafico degli abbinamenti con advisor sono la media di due esecuzioni al suo effort predefinito e usano un'esecuzione alow, tutte eseguite il 4 agosto 2026. I dati sull'escalation provengono, attività per attività, dalle esecuzioni di Opus 5.5: primalow, poihighsui suoi fallimenti, ha risolto dal 96,4% al 97,5% tra gli abbinamenti di esecuzioni per circa $0,17; primamedium, dal 96,0% al 97,1% per circa $0,24;highrieseguito sui propri fallimenti, 96,9% per $0,31; tutto ahigh, dal 94,8% al 95,8% per $0,29. I costi su questo sottoinsieme sono calcolati nel modo in cui viene misurato il consumo dell'organizzazione di un cliente: il prompt precedente di ogni richiesta come lettura dalla cache e i suoi nuovi token come scrittura nella cache a 5 minuti, dai registri di utilizzo delle esecuzioni stesse, verificati rispetto al registro contabile di un cliente; la misurazione propria dell'organizzazione di valutazione, che fino al 10 settembre 2026 fatturava le letture dalla cache in blocchi da 8.192 token per Claude Opus 5, Claude Fable 5, Claude Opus 4.7 e Claude Opus 4.8, ha prodotto dati da 1,4 a 1,8 volte più alti per le esecuzioni di quei modelli; per Claude Fable 5.1, Claude Sonnet 5 e Claude Sonnet 4.6 le due differiscono al massimo di circa il 9%, e per i dati di Claude Opus 5.5 concordano entro il 3% a ogni impostazione di effort. Gli abbinamenti con esecutore Claude Sonnet 5 nel grafico degli advisor provengono dalla stessa serie di misurazioni su questo sottoinsieme: l'abbinamento Sonnet più Opus 5 è stato eseguito due volte (7 agosto e 8 agosto 2026, un'esecuzione e una replica esatta), l'abbinamento a basso effort una volta (8 agosto 2026), e Claude Sonnet 5 da solo due volte (77,4%, la baseline per entrambe le righe Pro). Il punto di Claude Fable 5 in Aggiorna il modello è la media di tre esecuzioni all'effort predefinito, eseguite il 26 agosto 2026, con costi calcolati allo stesso modo. I dati sui task budget di Claude Fable 5.1 sono un'esecuzione per budget (due a 35.000 token) sullo stesso sottoinsieme all'effort predefinito, eseguite il 26 agosto 2026, con un'esecuzione senza budget lo stesso giorno (92,1%, $1,10 per attività) come baseline; un insieme precedente con effortlow, eseguito il 21 agosto 2026, ha ottenuto l'88,6% senza budget a $0,48 per attività. Il confronto in Confronta i modelli abbina quella singola esecuzione alle due esecuzioni aggregate di Claude Sonnet 5 dello stesso sottoinsieme; all'effort predefinito di Fable 5.1 il confronto si inverte, con un costo per attività risolta superiore del 41% rispetto a Sonnet 5. La scala di aggiornamento è un'esecuzione per modello con le sue impostazioni predefinite di rilascio (due ciascuno per Opus 5 e Sonnet 5, e il punto di Fable 5 come descritto sopra), con le esecuzioni di Opus e Sonnet nella stessa settimana in un unico harness e in un'unica organizzazione. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. I dati sull'effort usano un taglio di 500 problemi, da una a tre esecuzioni per impostazione, eseguite il 3 agosto 2026, con il punto predefinito che aggrega due esecuzioni dal 26 al 27 luglio 2026. Il grafico sull'assicurazione dei costi usa 10 problemi risolti in modo affidabile da una porzione di 26 problemi, 50 esecuzioni delegate (dal 1° al 2 agosto 2026) e 70 esecuzioni in solitaria (50 dal 2 al 3 agosto 2026; 20 archiviate del 12-13 luglio e del 1° agosto 2026), $6,45 rispetto a $11,99 per esecuzione in valore atteso; i dati delegati hanno una banda di misurazione di circa il 20%.
- Scalabilità delle architetture di agenti: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Studio esterno indipendente, citato solo per la direzione del risultato su quando la delega non conviene, non per alcun dato.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. Le 220 domande coprono 15 domini, ciascuna combinando la raccolta di molte righe con il recupero multi-hop; misurato sull'insieme di righe standard del benchmark, 3 esecuzioni per configurazione, eseguite il 2 agosto 2026 (il punto del team con un singolo worker è stato eseguito dal 26 al 27 luglio 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Le sue 132 attività di ricerca in 22 domini sono valutate rispetto a rubriche binarie derivate da esperti; misurato su un sottoinsieme di 50 attività stratificato su tutti i temi, un tentativo per attività, 3 esecuzioni per impostazione, su Claude Managed Agents con gli strumenti di ricerca web e di fetch propri della piattaforma (dal 26 al 27 agosto 2026); valutato sulle 33 attività che nessuna configurazione ha rifiutato, escludendo i tentativi interrotti dai classificatori di sicurezza di produzione; i costi sono quelli fatturati a un cliente, ovvero le richieste della piattaforma più le tariffe di ricerca web. I punteggi sono la media di ciascun modello sulla base delle 33 attività, escludendo le proprie attività interrotte preventivamente; sulle 21 attività pulite in ogni braccio, Claude Fable 5.1 mantiene un vantaggio di 2-3 punti su Claude Fable 5 a ogni livello di effort ed entrambi i modelli restano stabili al variare dell'effort. Il grafico sulla cache ricalcola il prezzo delle stesse richieste con ogni token di input alla tariffa senza cache. Claude Opus 4.6 fa da giudice secondo il protocollo a rubriche del benchmark; l'originale usa un giudice diverso, e un giudice Anthropic potrebbe favorire lo stile della casa. Claude Opus 5 al suo effort predefinito è stato eseguito sulla stessa superficie e sullo stesso sottoinsieme, tre esecuzioni, il 28 agosto 2026: 68,8% sulle 50 attività grezze, 70,8% sulla base delle 33 attività e 71,1% sull'insieme di 21 attività, a $6,71 per attività ($23,72 senza cache); nessuno dei suoi tentativi è stato interrotto dai classificatori di sicurezza, con un deployment delle salvaguardie più recente di quello con cui sono stati eseguiti gli altri modelli.
- Scansione dei difetti nel corpus: Interno di Anthropic, per lavori più grandi di una "context window" (finestra di contesto): un corpus di 21,6 milioni di token da 14 sorgenti di pacchetti Python pubblici con 130 difetti inseriti e valutazione deterministica; protocollo fissato prima delle esecuzioni e revisionato internamente; tre esecuzioni per configurazione. Ogni configurazione è stata eseguita su Claude Managed Agents. La configurazione di team nel grafico è un'esecuzione in cui il coordinatore Claude Fable 5.1 ha eseguito l'intera scansione all'interno della piattaforma al suo limite documentato di 25 worker Claude Sonnet 5 simultanei, eseguita il 30 agosto 2026; i suoi tre episodi hanno ottenuto F1 0,764, 0,825 e 0,791 dopo la verifica degli extra (grezzi 0,751, 0,821 e 0,781) per $225, $234 e $283. La configurazione in solitaria di Claude Sonnet 5 è stata eseguita dal 3 al 4 agosto 2026; le configurazioni in solitaria di Claude Fable 5.1 sono state eseguite dal 24 al 25 agosto 2026, con le impostazioni di servizio del lancio della piattaforma, tre seed per impostazione di effort, sulla stessa build del corpus. L'immagine della sandbox conteneva copie installate di parte del corpus, e la fase di assemblaggio finale di Claude Fable 5.1 le ha usate per il confronto in 7 episodi su 9; una nuova valutazione senza quelle aggiunte ha spostato i seed interessati fino a 3 punti. L'F1 assoluto è specifico di questa build del corpus e non è confrontabile tra benchmark; i confronti tra configurazioni sono omogenei.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. Il sottoinsieme Diamond di 198 domande, due esecuzioni per configurazione, eseguite il 7 agosto 2026 (Claude Opus 5.5: 19 settembre 2026), valutate da un modello rispetto alle risposte di riferimento, con i token dell'advisor misurati per richiesta. Un controllo di sicurezza della piattaforma ha rifiutato due domande di biologia sugli esecutori Claude Sonnet 5, e una di esse anche su Claude Opus 5; escluderle non modifica alcun confronto di più di un punto. Il 92% di Claude Opus 5.5 proviene da due esecuzioni che impostano
fallbacks: "default"per attivare il fallback lato server, con ogni tentativo terminato comunque con un rifiuto conteggiato come errato. In ogni esecuzione il controllo di sicurezza ha segnalato sei domande di biologia, Claude Opus 5 ha risposto a cinque di esse tramite il fallback, e la sesta è comunque terminata con un rifiuto. Il costo per domanda di Opus 5.5 include quelle risposte di fallback. Senza conteggiare i rifiuti come errati, queste esecuzioni ottengono il 93%, perché il valutatore assegna comunque un'opzione di risposta a un tentativo rifiutato, di solito quella corretta. Con i rifiuti conteggiati come errati, le esecuzioni di Claude Opus 5 ottengono il 91% (un rifiuto per esecuzione), così come due esecuzioni di Claude Opus 5.5 con il fallback disattivato, in cui Opus 5.5 ha rifiutato cinque o sei domande di biologia per esecuzione. - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. L'insieme comprende 113 attività originali in cinque linguaggi con verificatori basati su programmi. Gli abbinamenti sono due esecuzioni ciascuno, eseguite il 7 agosto 2026, con i token dell'advisor misurati per richiesta, e hanno usato un ciclo advisor lato client anziché lo strumento advisor, con una contabilizzazione identica. Le variazioni di effort con un singolo modello sono esecuzioni singole con costi calcolati dai conteggi dei token, un'approssimazione che tiene conto della cache. I costi per attività sono i totali delle esecuzioni divisi per 113.
- Benchmark interno di coding agentico: Interno di Anthropic: 370 attività su repository valutate dai test dei repository stessi. I dati dell'API sono stati misurati con un limite di output di 128.000 token, un'esecuzione per configurazione: Opus 5 da solo all'effort predefinito dal 9 al 10 agosto 2026, e a
lowemediumil 10 agosto 2026; Claude Fable 5.1 da solo a cinque valori di effort impostati esplicitamente il 20 agosto 2026 (il grafico ne mostra tre); e l'abbinamento dal 24 al 25 agosto 2026. Claude Opus 5.5 da solo è stato eseguito su tutte le 370 attività, dal 19 al 20 settembre 2026: al suo effort predefinito (medium) e ahighcon cinque tentativi per attività, e alowexhighcon uno (369 su 370 valutate in ciascuno, dopo un fallimento del controllo di setup). L'esecutore Claude Opus 5.5 ahighcon il Claude Fable 5.1 rilasciato come advisor (le esecuzioni di agosto usavano uno snapshot pre-rilascio) ha eseguito cinque tentativi per attività nelle stesse date; un'attività non ha superato il controllo di setup, quindi sono stati valutati 1.845 tentativi. I 279 tentativi in cui l'advisor è stato respinto per carico sono stati rieseguiti, e i tentativi le cui consultazioni sono andate in timeout sono stati mantenuti, come ad agosto. Le esecuzioni di agosto avevano cinque tentativi per attività per l'abbinamento e per il controllo Claude Opus 5 e uno per gli altri punti. L'abbinamento di agosto ha registrato in media circa due consultazioni dell'advisor per tentativo; l'abbinamento Claude Opus 5.5 ne ha richieste 1,39 e ricevute 1,35. I costi sono per tentativo. I costi sono calcolati nel modo in cui viene misurato il consumo dell'organizzazione di un cliente: il prompt precedente di ogni richiesta del ciclo dell'agente come lettura dalla cache e i suoi nuovi token come scrittura nella cache a 5 minuti, dai registri di utilizzo delle esecuzioni stesse, e ogni chiamata all'advisor, che non usa cache, dai suoi token registrati, tutto ai prezzi di listino. I dati di Claude Code sono esecuzioni delle stesse attività dall'8 al 23 luglio 2026, un'esecuzione per configurazione, con costi approssimativi. - Benchmark interno di attività su repository (misurazione del limite): Un insieme separato interno di Anthropic di circa 130 attività su repository, eseguito il 20 agosto 2026 (Claude Fable 5.1) e il 19 settembre 2026 (Claude Opus 5.5, al suo effort predefinito,
medium), con un semplice ciclo di agente via API, un tentativo per attività. Le esecuzioni di Claude Fable 5.1 sono 135 attività per limite con l'effort predefinito impostato esplicitamente: il dato a 16.384 token è la media di due esecuzioni (36,3% in entrambe); i dati a 64.000 e 128.000 sono esecuzioni singole (58,5% e 60,0%). Sei problemi hanno ricevuto un rifiuto di sicurezza in ogni esecuzione e contano come fallimenti. Il dato di Claude Opus 5.5 a 16.384 token è la media di due esecuzioni (134 e 135 attività valutate), e i suoi dati a 64.000 e 128.000 sono esecuzioni singole (135 attività ciascuna); due tentativi in ciascuna esecuzione a 16.384 token sono terminati con un rifiuto di sicurezza e contano come fallimenti. I dati sul limite di SWE-bench Pro sono un'esecuzione di Claude Fable 5.1 per limite all'effort predefinito, eseguita il 26 agosto 2026, su un sottoinsieme di 100 problemi stratificato dall'insieme di 482 problemi del riferimento 3, non confrontabile con i suoi punteggi; i due limiti hanno ottenuto lo stesso punteggio all'effort predefinito. Le distribuzioni per turno del grafico provengono dalle esecuzioni di Claude Opus 5.5 e Claude Fable 5.1 a 128.000: nessun turno di Opus 5.5 ha raggiunto il limite (il più lungo era di circa 61.000 token, e lo 0,56% dei suoi turni ha superato 16.384), e un turno di Fable 5.1 ha raggiunto 128.000 (lo 0,46% dei suoi turni ha superato 16.384). - Chartography: Surge AI, "Chartography," 2026. L'insieme completo rilasciato di 100 domande, misurato il 6 e il 9 agosto 2026 (Claude Opus 5 da solo) e il 20 settembre 2026 (Claude Opus 5.5), con l'implementazione di Anthropic su Claude Managed Agents (sandbox cloud standard; le configurazioni con advisor usano l'advisor di Managed Agents). Claude Sonnet 4.6 valuta al posto del giudice di riferimento e il benchmark viene eseguito con strumenti, quindi qui i punteggi sono confrontabili tra le configurazioni ma non con la classifica pubblicata. Non sono nemmeno confrontabili con i risultati di Chartography nella system card di Claude Opus 5.5, che usano un valutatore diverso e vengono eseguiti con effort
max. Due esecuzioni per configurazione (tre per Claude Opus 5.5), aggregate; le variazioni tra esecuzioni sono arrivate fino a 10 punti. I costi sono quelli fatturati a un cliente che esegue l'agente abitualmente: la prima richiesta di ogni grafico legge dalla cache il "system prompt" (prompt di sistema) condiviso e gli strumenti dell'agente, come accade quando un'altra sessione dello stesso agente è stata eseguita nei 5 minuti precedenti. Un grafico eseguito da solo costa circa $0,03 in più con Claude Opus 5 o Claude Opus 5.5 e circa $0,12 in più con Claude Fable 5.1. I dati di agosto sono ricalcolati in questo modo dai registri di utilizzo delle esecuzioni; la misurazione propria dell'organizzazione di valutazione, che fino al 10 settembre 2026 fatturava le letture dalla cache di Claude Opus 5 in blocchi da 8.192 token, sovrastimava i costi di Claude Opus 5. I costi escludono il tempo della sandbox, che ha aggiunto meno dell'1% alle esecuzioni di agosto. Le esecuzioni in solitaria di Claude Fable 5.1 sono del 24 agosto 2026, con le impostazioni di servizio del lancio della piattaforma, due esecuzioni per impostazione; sei tentativi hanno raggiunto il limite di sessione di 15 minuti e ottengono 0, e due grafici per esecuzione hanno ricevuto risposta da Claude Opus 5 dopo un rifiuto di sicurezza. L'esecutore Claude Opus 5 a basso effort con un advisor Claude Fable 5.1 è stato eseguito due volte il 30 agosto 2026, con le stesse impostazioni (63,0 e 67,0, media 65,0, a $0,47 per grafico; l'advisor è stato consultato nell'88% delle attività in ogni esecuzione, e 4 delle sue 219 risposte sono arrivate invece da Claude Opus 5, ciascuna dopo che un filtro di sicurezza di produzione aveva bloccato la risposta dell'advisor stesso). Claude Opus 5.5 è stato eseguito alow, con il fallback lato server disattivato e un classificatore di sicurezza che valutava ogni chiamata agli strumenti: tre esecuzioni da solo (70, 68 e 68) e tre con un advisor Claude Fable 5.1 configurato (59, 63 e 63), in cui ha consultato l'advisor in 1 attività su 300. Il confronto del tasso di consultazione per gli abbinamenti precedenti proviene dalla riesecuzione delle stesse configurazioni sulla Messages API con un set di strumenti container, dal 10 all'11 agosto 2026. - Valutazione dell'audit dei prompt per l'help desk di supporto: Un insieme costruito da Anthropic di 44 ticket di supporto con valutazione deterministica, eseguito all'inizio di agosto 2026 e riportato l'8 agosto 2026, con sei prompt di sistema, ciascuno dei quali aggiunge allo stesso prompt pulito un pattern comune nei prompt scritti per Claude Opus 4.8 e Claude Sonnet 4.6. Ogni punto del grafico è uno di tre casi (modello precedente, modello più recente sullo stesso prompt, modello più recente dopo l'audit) mediato sui sei prompt e sui 44 ticket. Il guadagno di accuratezza di Opus 5 ha un intervallo di confidenza al 95% da 3 a 8 punti; le differenze di accuratezza di Sonnet rientrano nel rumore.
- Insieme di domande su file di dati: Un insieme costruito da Anthropic di 25 domande aggregate su una porzione di 1.862 righe di un CSV pubblico sulle vendite di liquori, con la verità di riferimento calcolata con pandas e valutazione a corrispondenza esatta, eseguito su Claude Sonnet 5 e Claude Opus 5 con il "thinking" (ragionamento) disabilitato (il braccio in contesto non riesce a completare con l'impostazione predefinita), un limite di output di 4.000 token e senza "prompt caching" (cache dei prompt), tre esecuzioni per configurazione, eseguite il 19 agosto 2026. Il braccio con file carica il CSV tramite la Files API e usa lo strumento
code_execution_20260120. - Misurazione della durata della cache: Il lavoro di triage di 20 issue da Taglia i token di input e di contesto, eseguito su Claude Sonnet 5 il 23 agosto 2026 e su Claude Opus 5.5 il 19 e 20 settembre 2026, al suo effort predefinito (
medium) e ahigh, sulla Messages API con lo stesso harness (per Claude Opus 5.5, un suo porting che invia gli stessi corpi di richiesta), le celle di Claude Opus 5.5 conmax_tokensaumentato a 4.096, con pause inserite prima di una quota di turni scelta casualmente (nessuna, 5%, 10% e ogni turno a 6 minuti su tutte le 20 issue su entrambi i modelli, più ogni turno a 2 minuti su Claude Sonnet 5; pause di 20 minuti e 45 minuti su un sottoinsieme di 5 issue su entrambi i modelli). I dati di keep-alive di Claude Opus 5 riportati di seguito provengono dallo stesso job del 23 agosto 2026, conmax_tokensaumentato a 4.096, con le stesse pianificazioni tranne le pause di 2 minuti e 45 minuti. Tre esecuzioni per cella, costo calcolato dai campiusagedi ogni risposta ai prezzi di listino (per Claude Opus 5.5, $4 di input, $5 di scrittura a 5 minuti, $8 di scrittura a 1 ora, $0,20 di lettura dalla cache e $20 di output per milione di token; Claude Sonnet 5 è stato eseguito su un'organizzazione interna di Anthropic il cui utilizzo è misurato allo stesso modo di quello di un'organizzazione cliente), accuratezza rispetto alle stesse etichette gold. I dati di Claude Opus 5.5 in questa pagina coprono entrambi i livelli di effort. Il punto di incrocio è circa il 3,3% dei turni su Claude Sonnet 5 e dal 3,1% al 3,2% su Claude Opus 5.5: la mediana della quota di pareggio di ciascuna sessione, calcolata dal modello di costo a partire dalle dimensioni del contesto turno per turno di quella sessione, su tutte le 45 sessioni da venti issue di Claude Sonnet 5 e sulle 36 sessioni da venti issue di Claude Opus 5.5 a ciascun livello di effort (ogni pianificazione di pause eseguita sul job completo, con tutte e tre le impostazioni di cache, tre esecuzioni ciascuna; le celle da 5 issue non sono incluse). Nella cella al 5% le impostazioni a 5 minuti e a 1 ora si sono equivalse su Claude Sonnet 5, perché le pause di quell'estrazione sono cadute su prefissi piccoli; su Claude Opus 5.5 si sono quasi equivalse. La regola di 1 su 20 della pagina si colloca sopra il punto di incrocio misurato. Il tempo al primo token dopo una pausa di Claude Opus 5.5 non è stato misurato. Anthropic ha misurato le richieste keep-alive che aggiornano la cache a 5 minuti su Claude Sonnet 5 e Claude Opus 5 il 23 agosto 2026, e su Claude Opus 5.5 nelle esecuzioni sopra indicate, sempre inviate conmax_tokens: 1. Su Claude Sonnet 5 sono costate il 7,7% in meno rispetto all'impostazione a 1 ora con il 5% dei turni in pausa e circa lo stesso con il 10%; su Claude Opus 5 non è stata misurabile alcuna differenza con nessuna delle due quote; su entrambi sono costate di più con una pausa di 6 minuti o più prima di ogni turno. Su Claude Opus 5.5 sono costate dall'8% al 18% in meno rispetto all'impostazione a 1 ora con il 5% e il 10% dei turni in pausa (circa dal 10% al 15% una volta rimosso il rumore tra sessioni rifatturando i token di ciascuna sessione keep-alive ai prezzi della cache a 1 ora), e di più con una pausa prima di ogni turno: dal 4% al 6% in più a 6 minuti, dal 9% al 10% a 20 minuti e dal 56% al 58% a 45 minuti. Il keep-alive ha fatto risparmiare di più su Claude Opus 5.5 perché ogni richiesta keep-alive rilegge il prefisso al prezzo di lettura dalla cache: 0,05x il prezzo di input, contro 0,1x su Claude Sonnet 5 e Claude Opus 5; le sessioni di Claude Opus 5, rifatturate ai prezzi di Claude Opus 5.5, mostrano quasi gli stessi risparmi di Claude Opus 5.5. I test API pre-lancio di Anthropic su Claude Opus 5.5 mostrano che una richiesta conmax_tokens: 0scrive nella cache e che la richiesta successiva la legge; se una tale richiesta aggiorni una voce esistente non è stato misurato su Opus 5.5. Su Claude Fable 5.1, a 0,025x, il keep-alive è risultato più economico anche con una pausa prima di ogni turno, tranne con pause di 45 minuti (riferimento 19). - Quota di letture dalla cache in produzione: Utilizzo aggregato della Claude API di prima parte per i 14 giorni terminati il 23 agosto 2026, solo prodotto API diretto, organizzazioni interne di Anthropic escluse, nessuna organizzazione identificata. Un giorno-organizzazione conta come ciclo di agente quando le sue richieste contengono definizioni di strumenti e risultati di strumenti, i suoi prompt contengono in media 9 o più chiamate a strumenti precedenti, è stata usata la cache, e ha effettuato almeno 10 richieste di questo tipo (l'API non ha un identificatore di conversazione, quindi questo criterio sostituisce la lunghezza della conversazione): 303.003 giorni-organizzazione su 106.487 organizzazioni, quota mediana di letture dalla cache dell'84,2% di tutti i token di input, quartile superiore 91,7%. Le etichette dei casi d'uso (il caso d'uso dichiarato dall'organizzazione, o altrimenti quello classificato) coprono il 74% di quei giorni-organizzazione e il 99% dei loro token; le organizzazioni di coding forniscono l'87% dei token di input agentici e leggono una mediana dell'88,5% (90,9% a 25 o più chiamate a strumenti precedenti), quartile superiore 93,4%, con circa il 72% dei giorni-organizzazione di coding all'80% o più; gli agenti di supporto, ricerca e dati leggono dall'84% all'85%. Il decile superiore dei giorni-organizzazione legge il 95,9% o più per il coding e dal 94,2% al 94,8% per gli agenti di supporto, ricerca, dati e altri. La suddivisione a livello di richiesta a 25 o più chiamate a strumenti precedenti proviene da un campione di sei ore: coding 92% letture, 7% scritture, meno dell'1% senza cache. Le organizzazioni senza etichetta, per lo più piccole, leggono una mediana dell'11%. I giorni-organizzazione senza definizioni di strumenti leggono una mediana del 34,6%. Una query indipendente sulla stessa finestra temporale che ricostruisce conversazioni di 10 o più richieste, anziché valutare i giorni-organizzazione, colloca la mediana al 90,2%; la differenza è di ambito, non di dati.
- Misurazione della tempistica della compattazione: La variante lunga dell'agente di triage da Taglia i token di input e di contesto, eseguita il 24 agosto 2026 su Claude Sonnet 5 con la cache a 5 minuti, costo dai campi di utilizzo ai prezzi di listino, cinque sessioni per braccio: un braccio senza modifiche all'effort predefinito per tutto il tempo ($0,81 per sessione), e due bracci che iniziano con effort basso e apportano le stesse due modifiche che invalidano la cache, un passaggio all'effort predefinito e uno strumento aggiunto, o a metà sessione alle richieste 12 e 17 ($0,95) o insieme alla prima richiesta dopo la prima compattazione ($0,75). Un quarto braccio di sei sessioni, eseguito il 25 agosto 2026, ha apportato le stesse due modifiche alla richiesta che ha attivato la prima compattazione ($0,92 per sessione): il passaggio di riepilogo di quella richiesta ha scritto nella cache il contesto di 81.000 token invece di leggerlo, quindi quel passaggio è costato $0,21 contro $0,04 per lo stesso passaggio nel braccio al confine. Le sessioni hanno compattato per la prima volta tra la richiesta 21 e la 25 (16 delle 21 sessioni alla richiesta 22), una volta che il prompt ha superato la soglia di compattazione di 80.000 token, e due sessioni senza modifiche hanno compattato una seconda volta verso la fine. Il totale inferiore del braccio al confine rispetto al braccio senza modifiche riflette le sue richieste a basso effort prima della modifica e quelle seconde compattazioni piuttosto che la cache: i costi di riscrittura dei due bracci differiscono di meno di un centesimo. Il braccio a metà sessione ha pagato $0,23 per sessione in riscritture della cache; la differenza tra i bracci a metà sessione e al confine è stata di $0,20 con un intervallo di confidenza al 95% da $0,11 a $0,29. Una sessione del braccio a metà sessione è risultata economica ($0,82) dopo che il suo modello ha chiamato in modo errato lo strumento di ricerca in seguito alla compattazione e ha ottenuto risultati vuoti; è inclusa, e senza di essa il braccio ha una media di $0,98. L'accuratezza è stata in media di 14,2 etichette su 20 in ciascun braccio del 24 agosto e di 14,7 nel braccio del 25 agosto; le letture dalla cache sono state il 91% dei token del prompt senza modifiche, l'85% a metà sessione, il 91% al confine e l'86% con le modifiche sulla richiesta di attivazione.
- Misurazione della durata della cache su Claude Fable 5.1: Lo stesso lavoro di triage di 20 issue e lo stesso harness del riferimento 16, eseguiti il 23 agosto e il 26 agosto 2026, sullo snapshot di lancio di Claude Fable 5.1 ai suoi prezzi di lancio ($10 di input, $12,50 di scrittura a 5 minuti, $20 di scrittura a 1 ora, $0,25 di lettura dalla cache, $50 di output per milione di token), tre impostazioni per pianificazione: la cache a 5 minuti, la cache a 1 ora e la cache a 5 minuti mantenuta attiva da una richiesta con
max_tokens: 0sul prefisso invariato ogni 4 minuti, a partire dall'inizio della richiesta precedente (le esecuzioni del 23 agosto inviavano richieste keep-alive conmax_tokens: 1; nelle celle del 26 agosto riportate qui, ogni richiesta keep-alive ha aggiornato la cache e non ha fatturato output). Pianificazioni: nessuna pausa, 10% dei turni e ogni turno a 6 minuti su tutte le 20 issue, e pause di 45 minuti sul sottoinsieme di 5 issue; tre esecuzioni per cella (sei per la cella keep-alive del 26 agosto con pause di 45 minuti), costo calcolato dai campiusagedi ogni risposta ai prezzi di listino, accuratezza rispetto alle stesse etichette gold (da 12 a 17 etichette esatte su 20). Medie per sessione del 26 agosto per le impostazioni a 5 minuti, a 1 ora e keep-alive: nessuna pausa $2,42, $3,09, $2,29; 10% in pausa $4,50, $2,96, $2,36; ogni turno $22,89, $3,01, $2,62; le celle del 23 agosto concordano entro il 6%. I dati a 45 minuti ($1,68, $0,59 e $0,71 per sessione da 5 issue) provengono da una riesecuzione pulita del 26 agosto dopo che un incidente di fatturazione della cache aveva compromesso le prime celle di quel giorno; le esecuzioni del 23 agosto hanno dato $1,67, $0,58 e $0,70. Il punto di incrocio tra le impostazioni a 5 minuti e a 1 ora è il 3,1% dei turni, con la stessa misura del riferimento 16. - Terminal-Bench 3: le 74 attività del benchmark pubblico per agenti da terminale, eseguite su Claude Managed Agents con due strumenti personalizzati, una shell e un editor di file che l'harness di valutazione esegue nel container di ciascuna attività, al posto degli strumenti integrati della piattaforma, e per il resto con le impostazioni predefinite della piattaforma per gli account esterni, due esecuzioni per modello con effort
high, dal 27 al 28 agosto 2026. Queste esecuzioni hanno usato la versione 3.0 di Terminal-Bench, e i loro punteggi non sono confrontabili con la classifica pubblica di Terminal-Bench né con i risultati di Terminal-Bench 4.0 nella system card di Claude Opus 5.5, che provengono da esecuzioni in Claude Code con effortmax. I limiti di tempo di ciascuna attività sono 2,5 volte quelli del benchmark, il che concede all'agente tra 75 minuti e 20 ore per attività (5 ore per l'attività mediana), e ogni attività riceve il triplo della memoria che specifica, da 6 GiB a 96 GiB, con memoria aggiuntiva per le 12 attività che eseguono servizi ausiliari. L'agente non aveva accesso generale a internet: i suoi container potevano raggiungere un mirror interno dei pacchetti, un breve elenco di siti di download tra cui GitHub e il Python Package Index, e alcuni siti specifici di determinate attività, e otto delle attività non avevano alcun accesso alla rete. I punteggi sono tassi di superamento grezzi sui 148 tentativi per modello; le singole esecuzioni oscillano da 5 a 11 punti. I costi sono quelli che verrebbero fatturati a un cliente ai prezzi di listino, ricalcolati richiesta per richiesta dai registri di utilizzo delle esecuzioni con la durata della cache di 5 minuti. Claude Opus 4.7 ha terminato 11 dei suoi 148 tentativi al suo limite di output. - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. Le sue 100 attività di ricerca in 10 domini sono valutate rispetto a rubriche scritte da esperti, e il punteggio è il punteggio normalizzato del benchmark. Ogni configurazione è stata eseguita sulla Claude API con Claude Fable 5.1, il ragionamento adattivo predefinito, i classificatori di sicurezza di produzione attivi e
max_tokensa 128.000: un singolo agente con efforthighe con effortmedium, il singolo agente ahighcon l'istruzione e l'orologio, e un team ahighcon e senza di essi. Il team è un agente principale che avvia agenti helper dello stesso modello tramite uno strumento, senza limite al loro numero. Su DRACO, l'agente principale ha avviato una mediana di 4 helper per tentativo. Ogni configurazione ha effettuato tre tentativi per ciascuna attività, eseguiti dall'8 al 10 settembre 2026. Un tentativo che ha raggiunto il limite di quattro ore è stato rieseguito, e conta il nuovo tentativo. Gli unici tentativi esclusi sono tutti e 3 i tentativi su un'attività per il singolo agente con effortmedium, quindi quella configurazione copre 99 attività. Quell'attività è andata in timeout a ogni tentativo, sia nell'esecuzione originale sia nella riesecuzione. Assegnare 0 a quei 3 tentativi, come farebbe il sistema di punteggio del benchmark, influisce solo sui due confronti con effortmedium. La variazione di punteggio con effortmediumrispetto ahighpassa da 0,7 a 1,7 punti in meno, e la variazione di punteggio con entrambe le modifiche rispetto all'effortmediumpassa da 1,2 a 0,2 punti in meno. Gli agenti hanno usato uno strumento di ricerca e uno strumento di fetch che l'harness di valutazione ospita su un indice web fissato. Quegli strumenti determinano parte del tempo, e i tuoi funzioneranno a una velocità diversa, quindi la pagina indica il tempo come rapporto tra configurazioni, non in minuti. Il tempo è il tempo reale per attività, dalla prima all'ultima richiesta su qualsiasi agente, meno il tempo stimato trascorso in attesa di ritentare le richieste dopo errori di "rate limit" (limite di velocità) o di sovraccarico. Quegli errori derivavano dai limiti condivisi dell'account di test. Tutte le configurazioni di un insieme sono partite insieme. Quelle più lente sono terminate ore dopo, quindi parte del loro tempo si è svolta con un carico diverso. Il costo di ciascuna attività è dato dalle sue richieste ai prezzi di listino pubblici, con la cache dei prompt fatturata come lo sarebbe per un cliente che imposta un breakpoint di cache alla fine di ogni richiesta e usa la durata della cache di 5 minuti, solo per i token del modello. Gli strumenti dell'harness non aggiungono costi. Le variazioni di punteggio sono differenze appaiate sulle attività, con intervalli bootstrap al 95%. Una variazione è considerata entro il margine quando il suo intervallo rimane entro 1,5 punti su DRACO e 2,5 punti su HLE. Anthropic ha fissato quei margini prima delle esecuzioni. Claude Opus 5 valuta le risposte. Rispetto al valutatore proprio di ciascun insieme, Opus 5 ha assegnato da 1,9 a 2,4 punti in più su DRACO, da 2,2 a 2,9 punti in meno su HLE (Opus 5 ha valutato 495 delle 500 domande, e il valutatore del benchmark le ha valutate tutte e 500), e da 1,3 a 2,0 punti in meno sul set di fisica, il cui valutatore usa anch'esso le soluzioni di riferimento degli esperti, in ogni configurazione. I due valutatori concordano sulla direzione di ogni variazione. - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. Domande scritte da esperti con risposte esatte, valutate rispetto alle risposte di riferimento. Misurato sulle prime 500 domande, con le fonti del benchmark stesso bloccate dalla ricerca, e con la stessa configurazione del riferimento 21. Ogni configurazione ha effettuato tre tentativi per ciascuna domanda, eseguiti dall'8 al 10 settembre 2026. Claude Opus 5 confronta ogni risposta con la risposta di riferimento, con il ragionamento adattivo attivo, come lo è per impostazione predefinita. Il giudice ha valutato 495 delle 500 domande in ogni configurazione, e i punteggi coprono quelle 495. Per le altre 5, la richiesta di valutazione superava il limite di 1M token del giudice. Un tentativo che ha raggiunto il limite di quattro ore è stato rieseguito, e conta il nuovo tentativo, quindi ogni configurazione ha tutti i 1.500 tentativi. Assegnare 0 alle 5 domande non valutate, come farebbe il sistema di punteggio del benchmark, non modifica alcun risultato.
- Set di fisica: Un insieme interno di 70 problemi di fisica di livello di ricerca, adattato dal benchmark pubblico CritPt: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. Revisori esperti hanno corretto gli enunciati dei problemi. Claude Opus 5 valuta ogni risposta rispetto a soluzioni di riferimento di esperti che non sono pubbliche, quindi i punteggi non possono essere confrontati con i risultati pubblicati. Il punteggio è la valutazione media sui tentativi di un problema, mediata sui problemi. Misurato su tutti i 70 problemi, quattro tentativi per problema, eseguiti dall'8 al 9 settembre 2026. Ogni agente aveva uno strumento Python, una shell e un editor di file in un container sandbox senza accesso alla rete, e nessuno strumento di ricerca o di fetch. Per il resto la configurazione è quella del riferimento 21. Nessun margine di punteggio è stato fissato per il set di fisica prima delle esecuzioni, quindi la pagina riporta le sue variazioni di punteggio con i relativi intervalli al 95% e non le descrive come entro un margine.
Prossimi passi
Il più grande vantaggio gratuito di questa pagina: configurazione, durate e diagnostica.
Scambia intelligenza con latenza e costo all'interno di un singolo modello.
Valuta capacità, velocità e costo nella famiglia di modelli Claude.
Dai ai cicli agente un conto alla rovescia di token rispetto al quale autoregolarsi.
Imposta un limite rigido in dollari su una sessione di Managed Agents.
Consulta i prezzi attuali per token di ogni modello Claude.
Applica queste leve una alla volta a un agente funzionante in un notebook eseguibile, con il costo per attività dopo ogni passaggio.
Guarda una presentazione guidata dei pattern advisor e orchestrator.
Was this page helpful?