비용과 지능 최적화
Claude Platform에서 비용과 지능의 균형을 맞추는 방법을 프롬프트 캐싱, effort, 모델 선택, 예산, 다중 모델 전략의 측정 결과와 함께 소개합니다.
워크로드가 프로토타입에서 프로덕션으로 넘어가면 비용은 최우선 설계 제약 조건이 됩니다. 가장 뛰어난 모델은 대규모로 사용하기에 너무 비쌀 수 있고, 가장 저렴한 모델은 품질이 부족할 수 있습니다. 비용을 잘 관리하려면 각 비용 레버가 출력 품질에 어떤 영향을 미치는지 이해해야 합니다. 일부 레버는 품질과 맞바꾸는 관계이고 일부는 그렇지 않기 때문입니다. Claude Platform에서는 이 트레이드오프를 직접 제어할 수 있습니다. 요청마다 모델, "effort"(노력 수준), 아키텍처를 선택할 수 있으므로 워크로드를 "cost-to-intelligence frontier"(비용 대비 지능 프런티어)의 거의 어느 지점에나 배치할 수 있습니다.
비용과 지능은 보통 한쪽을 얻으려면 다른 쪽을 내줘야 하는 프런티어로 그려집니다. 이 페이지의 첫 번째 레버 그룹은 품질에 손대지 않고 비용을 줄여 워크로드를 그 프런티어 쪽으로 이동시키며, 두 번째 그룹만이 프런티어를 따라 이동시킵니다:
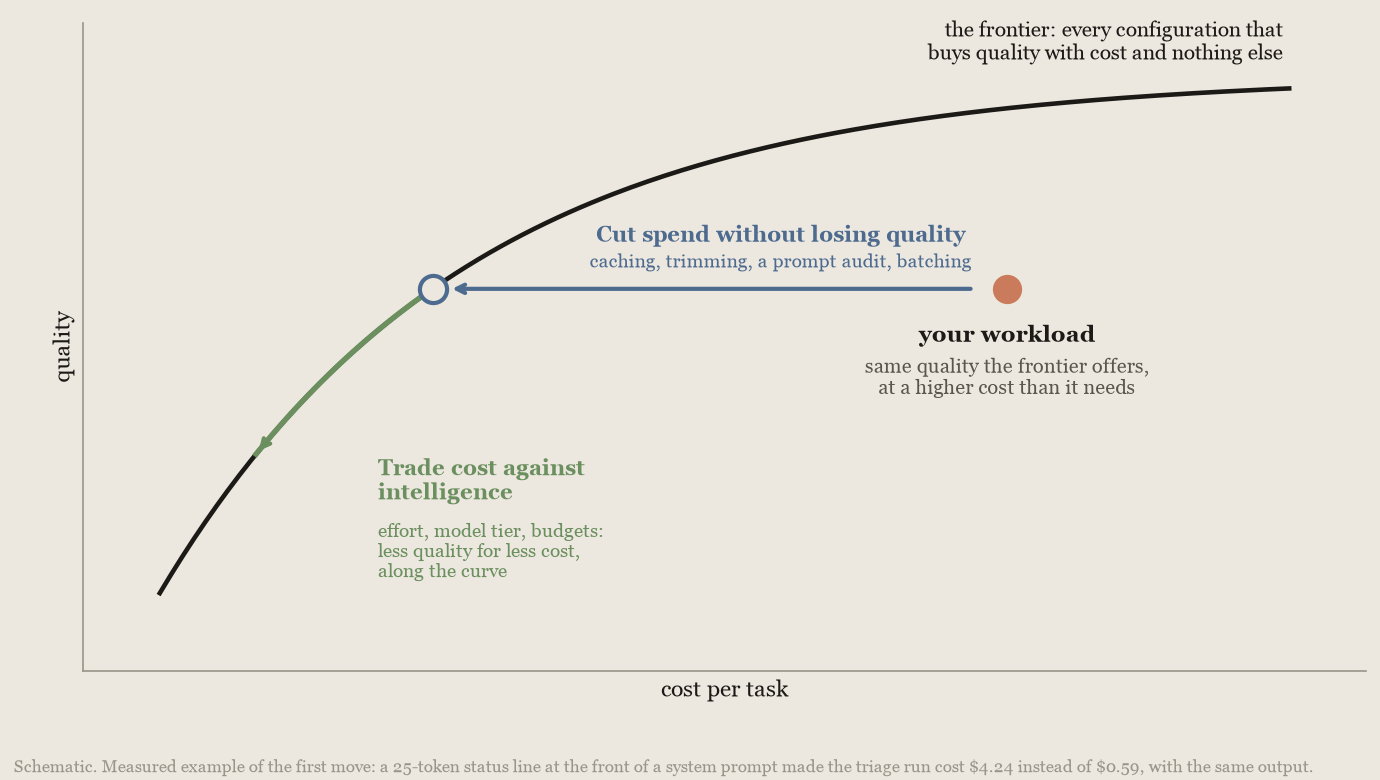
레버는 두 종류로 나뉩니다:
- 무료 이득(free wins)은 품질에 손대지 않고 지출을 줄입니다: "prompt caching"(프롬프트 캐싱), "token hygiene"(토큰 위생), 실행 중인 모델에 대한 프롬프트 감사, 최대 24시간 기다릴 수 있는 작업에 50% 할인이 적용되는 배치 처리, 그리고 최후의 안전장치인 워크스페이스 지출 한도입니다.
- 트레이드오프(tradeoffs)는 비용과 지능을 맞바꿉니다: 모델 선택, effort, 출력 상한과 "task budget"(작업 예산), 경과 시간 시계, 다중 모델 아키텍처입니다.
각 레버에는 측정 결과와 효과를 보는 조건에 대한 규칙이 함께 제시됩니다. Anthropic의 측정에서 프롬프트 캐싱은 압도적인 차이로 가장 큰 레버였습니다. 이 가이드의 벤치마크에서 에이전트 루프 비용을 2.7분의 1에서 5.3분의 1로 줄였고, 소규모 분류(triage) 에이전트의 비용을 83%, 입력 줄이기를 추가하면 88% 줄였습니다. 다중 모델 레버는 적용 범위가 더 좁습니다. 두 번째 모델은 어드바이저와 오케스트레이터라는 두 가지 형태에서 효과를 보였습니다.
여기서 시작하세요
자신의 상황에 맞는 행을 찾으세요.
| 상황 | 할 일 | 위치 |
|---|---|---|
| 모든 워크로드, 모든 모델 | 프롬프트 캐싱을 켜고 불필요한 토큰을 줄이세요. 둘 다 무료입니다 | 반복되는 컨텍스트 캐싱 · 토큰 줄이기 |
| 사람이 턴 사이에 기다리는 경우 | 20턴 중 약 1턴이 5분에서 1시간 사이의 일시 중지 후에 이어지고 1시간을 넘는 간격이 드물다면 1시간 캐시 지속 시간을 사용하세요. Claude Fable 5.1에서는 일시 중지가 몇 분 정도일 때는 5분 캐시를 웜 상태로 유지하고, 일시 중지가 1시간에 가까워지면 1시간 지속 시간을 구매하세요. Claude Opus 5.5에서는 20턴 중 한두 턴만 최대 약 30분의 일시 중지 후에 이어진다면 대신 5분 캐시를 웜 상태로 유지하세요 | 캐시 지속 시간 선택 |
| 비용이 너무 높지만 품질은 괜찮은 경우 | 현재 모델에서 effort를 낮춰 가며 테스트하세요 | Effort 조정 |
| 최신 모델을 사용하지 않는 경우 | 업그레이드하세요. Anthropic의 측정에서 새 모델은 각각 이전 모델 이상으로 많은 작업을 해결했으며, 대개 해결한 작업당 비용도 더 낮았습니다 | 모델 업그레이드 |
| 모델을 선택하거나 전환하는 경우 | 토큰당이 아니라 완료된 작업당 비용으로 비교하세요 | 모델 비교 |
| 품질이 충분하지 않은 경우 | effort를 낮췄다면 원래대로 되돌리세요. 그렇지 않다면 한 단계 위 티어를 low effort로 시도하세요 | Effort 조정 · 모델 비교 |
시도가 stop_reason: max_tokens로 끝나는 경우 | max_tokens를 높이세요. 기본 effort에서 측정한 14,000턴 중 2턴을 제외한 모든 턴이 64,000으로 충분했고, 128,000으로 설정해도 해결한 작업당 추가 비용이 없었습니다 | 예산 설정 |
| 출력을 검증할 수 있는 경우(테스트, 검증기) | 모든 작업을 낮은 effort로 실행하고 실패한 작업을 high로 다시 실행하세요. 측정한 코딩 벤치마크에서 통과율은 유지되면서 비용은 약 절반이었습니다 | 실패 재실행 |
| 일부 실행의 비용이 매우 큰 에이전트 루프 | 작업 예산(베타, 지원 모델은 지원 표를 확인하세요), Claude Managed Agents 세션 예산, 워크스페이스 지출 한도를 설정하세요 | 예산 설정 |
| 에이전트 실행을 더 빨리 끝내고 싶은 경우 | 시간이 중요하다고 모델에 알리고 경과 시간을 보여 주세요. DRACO, HLE, 내부 물리학 세트에서 실행 시간이 33%~69% 줄었고 작업당 비용은 28%~54% 낮아졌으며, 점수는 최대 1.9점 낮아졌습니다 | 모델에 경과 시간 표시하기 |
| 저렴한 모델이 어려운 결정에서만 막히는 경우 | 프런티어 어드바이저를 추가하세요. 어드바이저가 실행자(executor)보다 훨씬 높은 가격이고 실제로 자문을 받을 때 효과가 있으므로, 먼저 어드바이저 모델만 낮은 effort로 실행했을 때의 비용을 산정하고 자문 비율을 측정하세요 | 어드바이저 전략 |
| 작업이 하나의 컨텍스트 윈도우를 초과하는 경우 | 분할된 작업을 더 저렴한 워커에 위임하세요 | 오케스트레이터 전략 |
이 결과는 Anthropic 내부 결과(참조된 벤치마크)이며 방향성을 보여 줄 뿐 보장이 아니므로, 4단계 방법으로 자신의 워크로드에서 측정하세요.
품질 저하 없이 지출 줄이기
프롬프트 캐싱, 토큰 위생, 배치 처리, 현재 모델에 맞춘 프롬프트 감사는 모두 출력 품질을 낮추지 않고 비용을 줄입니다. 다만 두 가지 주의 사항이 있습니다. 배치 처리는 할인을 받는 대신 "latency"(지연 시간)를 감수해야 합니다. 또한 토큰 위생 레버 중 하나인 "context editing"(컨텍스트 편집)은 이 섹션에서 측정한 실행에서 절약한 금액보다 더 많은 비용이 들었습니다.
반복되는 컨텍스트 캐싱
캐싱이 가장 먼저인 이유
다른 어떤 레버보다 먼저 프롬프트 캐싱을 켜세요. 에이전트 작업은 매 턴마다 점점 커지는 대화 전체, 즉 시스템 프롬프트, 도구 정의, 이전의 모든 턴을 다시 전송하기 때문입니다. 40턴짜리 작업은 첫 번째 턴을 40번 전송하므로, 작업 비용은 대략 턴 수의 제곱에 비례해 증가합니다. 캐싱이 재전송 자체를 막지는 않지만, 재전송 비용이 약 10분의 1로 줄고 처리 속도도 빨라집니다. 접두사는 입력 가격의 10분의 1인 캐시 읽기 요금으로 청구되며, 각 턴은 새로 추가된 부분에 대해서만 1.25배의 캐시 쓰기 요금을 지불합니다.
바람직한 수준. 실제 트래픽을 하루 동안 측정한 결과, 에이전트 루프는 입력의 중앙값 84%를 캐시에서 읽었으며, 코딩 여부와 관계없이 상위 10%의 하네스는 94% 이상을 읽었습니다17. 작업이 충분히 진행된 시점에서 잘 구축된 루프는 입력의 1% 미만에 대해서만 정가를 지불합니다. 이 비율이 약 80% 미만이라면 캐시를 깨뜨리는 요인이 있는지 확인하세요(캐시를 깨뜨리는 요인 참조).
Anthropic이 측정한 실행 전반에서 캐시 읽기는 대개 작업 비용에서 가장 큰 단일 항목이었습니다. 그래서 캐싱은 대부분의 모델 선택 결정보다 더 큰 효과를 냅니다. Anthropic은 DeepResearch Bench II7 실행의 비용을 캐싱을 사용한 경우와 사용하지 않은 경우로 나누어 산정했습니다:
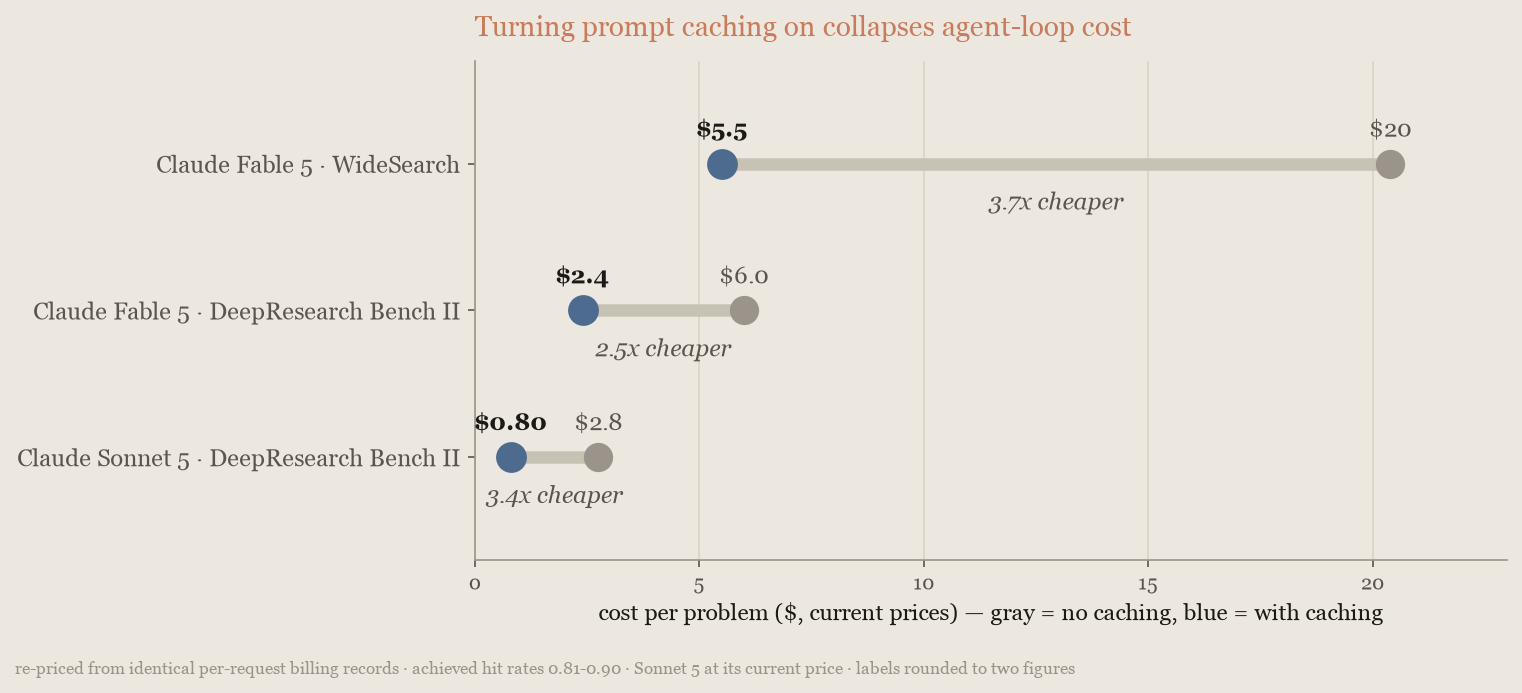
캐시의 기본 수명은 5분이고 에이전트 루프의 턴 간격은 몇 초에 불과하므로, 매 턴마다 대부분의 토큰에 할인이 적용됩니다. 캐싱 차트의 실행은 입력 토큰의 79%에서 90%를 캐시에서 읽었습니다. 절감액은 에피소드 깊이에 따라 달라지는데, 짧은 루프일수록 다시 읽는 양이 적기 때문입니다. 그래도 측정한 모든 모델과 벤치마크에서 캐싱은 가장 큰 단일 레버였습니다.
캐시 지속 시간 선택
루프가 턴 사이에 사람을 기다린다면 1시간 캐시 지속 시간을 사용하세요. 쓰기 비용은 더 높습니다(입력 가격의 1.25배 대신 2배). 어느 지속 시간이든 캐시 미스가 발생하면 접두사 전체가 읽기 가격이 아닌 쓰기 가격으로 청구되므로, 세션당 몇 개의 턴이 5분에서 1시간 사이의 일시 중지 후에 이어진다면 더 긴 지속 시간이 이득입니다.
결정하려면 대화에서 연속된 요청 사이의 간격을 세어 보세요:
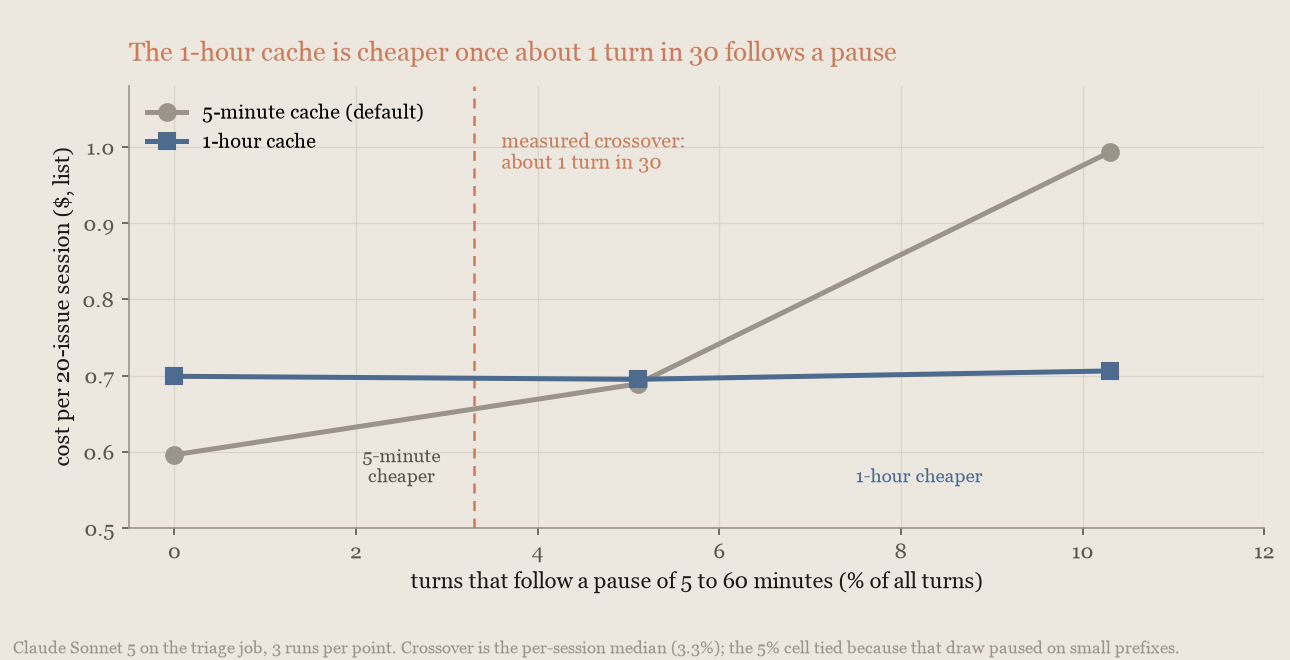
- 20개 간격 중 약 1개 이상이 5분에서 1시간 사이이고 1시간을 넘는 간격이 드문 경우: 1시간 지속 시간을 사용하세요. Claude Opus 5.5에서 20개 간격 중 1~2개만 그 범위에 속하고 약 30분을 넘는 간격이 없다면, 아래에 설명된 keep-alive 요청으로 대신 5분 캐시를 웜 상태로 유지하세요.
- 턴이 몇 초 간격으로 도착하는 경우: 기본값인 5분을 유지하세요. 일시 중지가 없을 때 Claude Sonnet 5에서는 1시간 설정보다 비용이 15%, Claude Opus 5.5에서는 약 15%~18% 적었습니다.
- 1시간을 넘는 간격이 흔한 경우: 기본값을 유지하세요. 1시간을 넘는 간격은 두 지속 시간 모두를 만료시키며, 이때 1시간 설정은 더 높은 쓰기 가격으로 접두사를 다시 쓰므로 그런 간격마다 손해를 봅니다. 5분보다 긴 일시 중지 중 약 60% 이상이 1시간도 넘긴다면 기본값을 유지하세요. 1시간 지속 시간은 긴 일시 중지 중 최소 약 40%가 1시간 이내에 끝날 때만 이득입니다.
Anthropic은 입력 및 컨텍스트 토큰 줄이기의 분류 작업을 일부 턴 앞에 일시 중지를 삽입해 사람의 지연을 시뮬레이션하며 측정했습니다16. Claude Sonnet 5와 Claude Opus 5.5에서는 약 30턴 중 1턴이 일시 중지 후에 이어지는 시점부터 1시간 캐시가 더 저렴한 설정이 되었으므로 20턴 중 1턴 규칙에는 여유가 있으며, 5분 설정에서는 일시 중지된 모든 턴이 접두사 전체를 다시 쓰기 때문에 교차점을 지나면 격차가 빠르게 벌어집니다. 현재의 모든 모델은 동일한 캐시 쓰기 배수를 사용하고, Claude Fable 5.1, Claude Mythos 5.1, Claude Opus 5.5를 제외한 모든 모델은 동일한 읽기 가격을 사용하므로, 다른 모델에서도 교차점은 비슷한 범위에 있습니다. Fable 5.1은 다음에 다루는 경우입니다. 모든 셀에서 정확도는 실행 간 노이즈 범위 내에 머물렀습니다. 1시간 설정에서는 일시 중지 후의 턴도 웜 캐시 수준의 지연 시간을 유지했습니다(Claude Opus 5.5가 아닌 Claude Sonnet 5와 Claude Opus 5에서 측정). 다음 차트는 Claude Sonnet 5에서 일시 중지된 턴의 비율에 따른 세션당 비용을 보여 줍니다:
Anthropic은 5분 캐시를 웜 상태로 유지하는 추가 요청도 측정했습니다. Claude Sonnet 5에서는 20턴 중 1턴이 일시 중지 후에 이어질 때 1시간 지속 시간보다 비용이 약 8% 적었지만, 20턴 중 2턴일 때는 거의 같았습니다. 이전 Opus 모델인 Claude Opus 5에서는 측정 가능한 절감이 없었습니다. 모든 턴 앞에 6분 이상의 일시 중지가 있으면 두 모델 모두에서 비용이 더 많이 들었습니다. Claude Sonnet 5의 절감 효과는 20턴 중 2턴에서 사라졌으므로, Claude Sonnet 5와 Claude Opus 5에서는 대신 1시간 지속 시간을 사용하세요.
Claude Fable 5.1에서는 가장 저렴한 설정이 다릅니다. 이 모델의 캐시 읽기는 입력 가격의 0.025배(백만 토큰당 $0.25)인 반면 캐시 쓰기는 표준 배수를 유지하므로, 접두사를 다시 읽는 keep-alive 요청은 저렴하고 1시간 지속 시간의 쓰기 프리미엄이 더 큰 비용이 됩니다. Anthropic은 동일한 세 가지 설정으로 Claude Fable 5.1에서 분류 작업을 측정했습니다19. 일시 중지가 몇 분 정도일 때는 항상 5분 캐시를 웜 상태로 유지하는 것이 1시간 캐시보다 세션당 13%~20% 저렴했으며, 일시 중지가 45분에 가까울 때만 1시간 캐시가 세션당 약 12센트 차이로 더 저렴했습니다. Claude Fable 5.1에서는 사람이 몇 분 동안 자리를 비우는 동안 5분 캐시를 웜 상태로 유지하고, 일시 중지가 1시간에 가까워지면 1시간 지속 시간을 구매하세요:
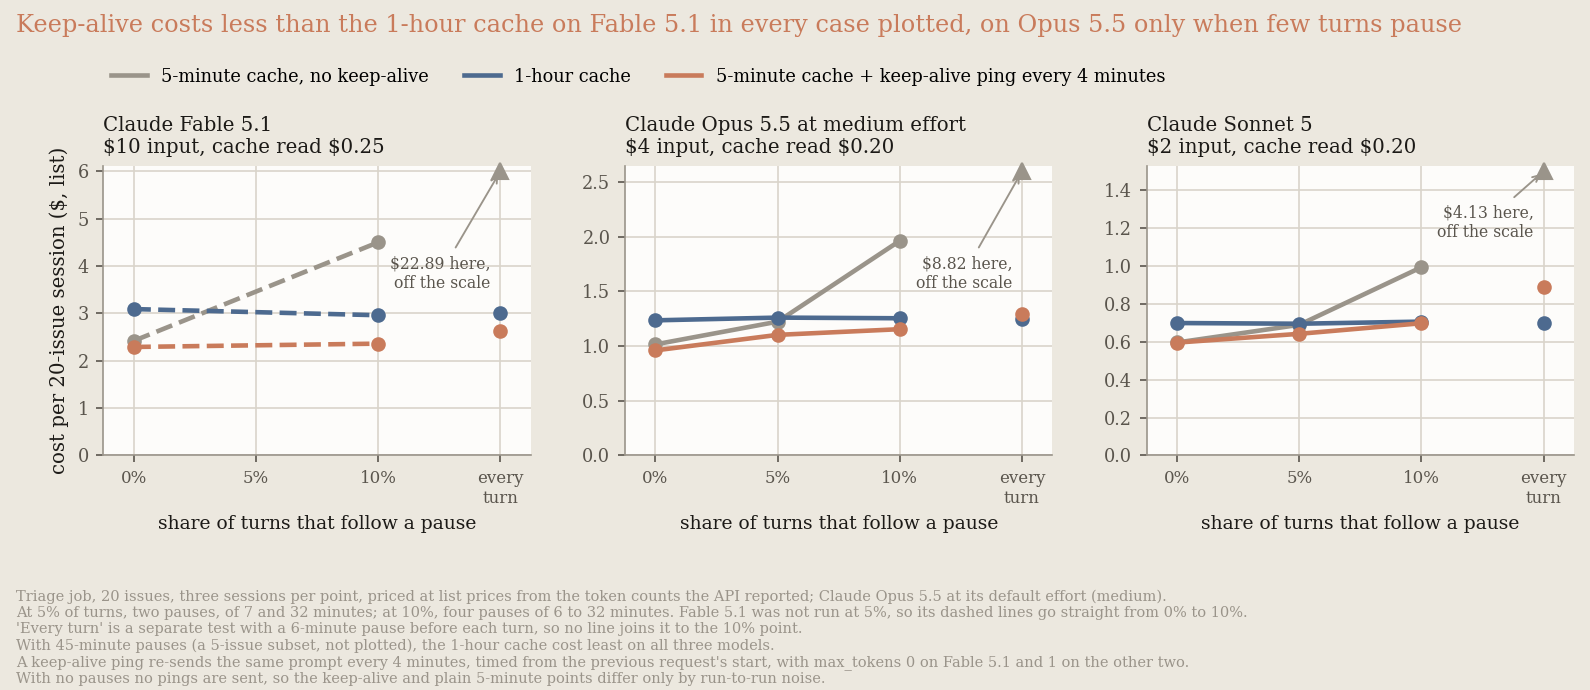
캐시 읽기가 입력 가격의 0.05배인 Claude Opus 5.5에서는 턴의 5% 또는 10%가 6~32분의 일시 중지 후에 이어질 때 keep-alive 요청이 1시간 지속 시간보다 8%~13% 저렴했지만(기본 effort인 medium 기준, high에서는 10%~18% 저렴), 모든 턴 앞에 일시 중지가 있을 때는 더 비쌌습니다. 6분 일시 중지에서는 약 4%~6% 더 비쌌고, 45분 일시 중지에서는 50% 이상 더 비쌌습니다. 따라서 Claude Opus 5.5에서는 20턴 중 한두 턴만 최대 약 30분의 일시 중지 후에 이어질 때 5분 캐시를 웜 상태로 유지하고, 그 외에는 이 섹션 시작 부분의 목록을 따르세요. 이 측정에서는 keep-alive 요청을 max_tokens: 1로 보냈습니다. 다음에 설명하는 max_tokens: 0 요청의 경우, Claude Opus 5.5에 대한 Anthropic의 출시 전 API 테스트에서 이 요청이 캐시를 쓰고 다음 요청이 그 캐시를 읽는 것으로 나타났습니다. 기존 항목을 갱신하는지는 Opus 5.5에서 측정하지 않았습니다.
캐시를 웜 상태로 유지하려면, 이전 요청이 시작된 후 4분 이내에 max_tokens를 0으로 설정하여 이전 요청을 다시 보내고, 그 후 4분마다 반복하세요. stream이 설정되어 있었다면 제거하세요. 응답이 끝난 시점이 아니라 요청이 시작된 시점부터 세세요. 캐시의 5분 수명은 항목을 쓰거나 갱신한 요청의 시작 시점부터 계산되므로, 응답 생성에 걸린 시간도 수명에 포함됩니다. 이것이 사전 워밍 요청입니다. 이 요청은 캐시의 수명을 갱신하고, 아무것도 생성하지 않으며, 캐시 읽기 비용만 청구됩니다. 접두사의 바이트 하나도 변경하지 말고, 이유 없이 토큰을 샘플링하는 max_tokens: 1은 사용하지 마세요. 요청 본문뿐 아니라 헤더도 다시 보내세요. 요청에 anthropic-beta 헤더가 포함되어 있다면(예: 작업 예산용), keep-alive 요청에도 같은 헤더가 필요하며, 그렇지 않으면 재전송된 본문의 베타 전용 필드가 거부됩니다. max_tokens: 0 요청은 요청에 thinking.type: "enabled"(Claude Fable 5.1의 기본 adaptive thinking은 괜찮습니다), 구조화된 출력, 또는 강제 도구 선택이 설정된 경우 거부됩니다(제한 사항). 이러한 워크로드에서는 대신 1시간 지속 시간을 구매하세요. max_tokens: 0 요청은 최상위 compaction 매개변수를 포함하는 경우에도 거부되므로, 온디맨드 압축의 압축 요청을 keep-alive 요청으로 다시 보내지 마세요.
# 마지막 요청이 시작된 후 4분 이내에(생성에 소요된 시간도
# 캐시 수명에 포함됩니다), max_tokens 값을 0으로 설정하고
# stream 매개변수를 제거하여 해당 요청을 다시 보내세요(max_tokens: 0 요청은 스트리밍할 수 없습니다). 원래 요청과
# 동일한 헤더(anthropic-beta 헤더 포함)를 함께 보내세요.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
캐싱 켜기
설정은 간단합니다. 자동 캐싱을 사용하면 중단점이 자동으로 배치됩니다. 그렇지 않은 경우에는 Claude Code와 함께 제공되는 Claude API 스킬로 프롬프트 하나만으로 기존 통합에 캐싱을 추가할 수 있습니다. 다음 발췌문은 이 스킬이 이 측정 결과를 만든 하네스에 캐싱을 추가하는 모습을 보여 줍니다:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...이 중단점 배치는 명시적 캐시 중단점의 표준 패턴을 따릅니다.
캐시를 깨뜨리는 요인
작업 중에 여러 요인이 캐시를 깨뜨릴 수 있습니다. 타임스탬프나 대기열 위치처럼 요청마다 바뀌는 내용을 안정적인 접두사 앞에 두면 모든 요청이 전체 캐시 쓰기가 됩니다. 입력 및 컨텍스트 토큰 줄이기의 분류 실행에서는 시스템 프롬프트 맨 앞에 있는 25토큰짜리 상태 줄 때문에 실행당 비용이 $0.59가 아닌 $4.24가 되었으며, 이는 캐싱을 끄고 실행한 것보다도 많은 비용입니다. 요청별 텍스트는 가장 최근의 사용자 턴에 두세요.
캐시는 요청을 순서대로(도구, 시스템 프롬프트, 메시지 순) 바이트 단위로 정확히 일치시키는 접두사 매칭이므로, 어느 곳에서든 변경이 생기면 그 이후의 모든 것이 무효화됩니다. 요청 사이에 effort나 사고 구성을 변경하면 그 지점부터 캐시가 무효화되며, 일부 모델에서는 그 앞의 도구와 시스템 프롬프트도 무효화됩니다. 시스템 프롬프트를 편집하면 그 지점부터 캐시가 무효화되고, 출력 형식을 설정하거나 변경하면 대화 전체의 캐시가 무효화되며, 도구 정의를 추가, 제거 또는 재정렬하면 캐시 전체가 무효화됩니다. 프롬프트 캐싱 페이지에 이러한 경우가 나열되어 있으며, 출력 형식은 예외로 구조화된 출력에서 다룹니다. 최신 모델에서는 최상위 system 필드를 편집하는 대신 messages에 추가하는 {"role": "system"} 메시지인 대화 중간 시스템 메시지로 지시 사항을 변경하세요. 그러면 캐시된 접두사가 그대로 유지됩니다. 지원 모델은 해당 페이지에서 확인하세요. 이를 지원하는 모델에서는 메시지별 effort 변경도 캐시된 접두사를 그대로 유지합니다. 위험이 가장 큰 모델은 Claude Fable 5.1과 Claude Mythos 5.1로, 캐시가 깨지면 접두사를 입력 가격의 0.025배로 읽는 대신 1.25배로 다시 씁니다. 100,000토큰 접두사에서 캐시가 깨진 턴 하나의 비용은 이 모델들에서 $0.03가 아닌 $1.25로 읽기 비용의 50배이며, Claude Opus 5.5에서는 $0.02가 아닌 $0.50로 25배, 다른 현재 모델에서는 12.5배입니다.
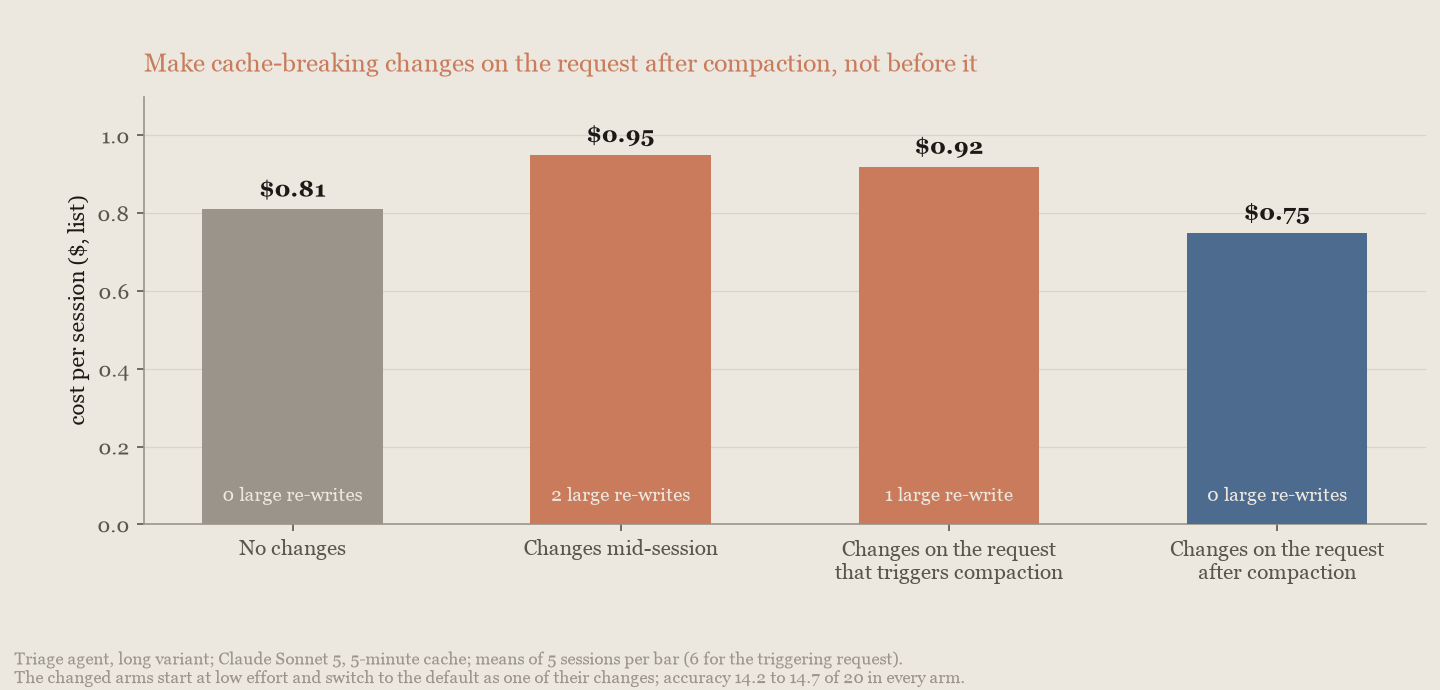
Anthropic은 분류 에이전트의 긴 세션에서 이를 측정했습니다18. 세션 중간에 effort를 변경하고 도구를 추가하자 캐시된 토큰 39,000개와 60,000개가 다시 쓰였고, 해당 세션의 비용은 세션당 $0.95였습니다. 같은 두 가지 변경을 "compaction"(압축) 후 첫 번째 요청에서 수행하면 $0.75, 압축을 트리거한 요청에서 수행하면 $0.92가 들었습니다. 후자의 경우 압축의 요약 단계가 81,000토큰 컨텍스트를 캐시 쓰기 가격으로 다시 처리했기 때문입니다. 그 요약 단계의 비용은 $0.21로, 같은 변경을 한 요청 뒤에 수행했을 때의 $0.04와 대비되며, 모든 조건에서 정확도는 실행 간 노이즈 범위 내였습니다:
작업 예산을 도중에 변경하면 예산 값이 포함된 캐시된 접두사가 무효화되므로, 첫 번째 요청에서 한 번만 설정하세요. 모든 컨텍스트 편집 단계는 지운 지점부터 접두사를 무효화하고 다음 요청은 그 이후의 모든 것을 다시 캐싱하는 비용을 지불하므로, 작은 단위로 여러 번 지우기보다 큰 단위로 몇 번에 나누어 지우세요. Claude Fable 5.1과 Claude Mythos 5.1에서는 이러한 각 변경에 토큰당 읽기 가격의 50배 비용이 들므로 이 모델들에서 가장 중요합니다. 캐시를 무효화하는 모든 변경은 자연스러운 구분 지점에서 수행한 다음, 캐시 읽기가 줄지 않았는지 확인하세요. 줄었다면 캐시 진단에서 접두사가 어디서 달라졌는지 확인할 수 있습니다.
입력 및 컨텍스트 토큰 줄이기
대부분의 에이전트 요청에는 답변에 전혀 영향을 주지 않는 토큰이 포함되어 있습니다. 이런 토큰을 줄여도 출력 품질이 떨어지는 경우는 드뭅니다. 다만 여기서 소개하는 레버가 측정에서 모두 비용을 절감한 것은 아닙니다. 살펴볼 곳은 두 가지입니다:
- 입력 줄이기. 웹 페치 도구의 동적 필터링은 가져온 페이지에서 상용구를 걸러 내고, 이미지 크기 조정은 비전 입력을 적절한 크기로 맞춥니다. 지연 로딩을 사용한 도구 검색은 필요할 때만 도구 정의를 로드합니다(이 섹션 뒷부분에서 측정). 프로그래밍 방식 도구 호출을 사용하면 Claude가 코드에서 여러 도구 호출을 실행하고 필터링된 결과만 컨텍스트에 넣을 수 있습니다. 해당 문서에 따르면 에이전트 검색 벤치마크에서 입력 토큰이 24% 줄었고 점수는 더 높았습니다. 도구 컨텍스트 관리에서 도구 검색, 프로그래밍 방식 도구 호출, 프롬프트 캐싱, 컨텍스트 편집을 비교합니다.
- 컨텍스트 수명 주기. 컨텍스트 편집은 오래된 도구 결과를 지웁니다. 임계값을 설정한 자동 압축은 긴 루프가 전체 기록을 계속 끌고 가지 않도록 합니다.
이 레버들은 캐시와도, 서로 간에도 영향을 주고받으므로 순효과로 판단하세요. 또한 캐시 진단으로 변경할 때마다 캐시된 접두사가 유지되는지 확인하세요. Anthropic은 공개 저장소에서 가져온 스크린샷 포함 실제 버그 보고서 20건을 처리하는 이슈 분류 에이전트로 이를 측정했습니다. 같은 작업을 토큰 수가 2.6배인 더 긴 버전으로도 측정했습니다. 캐싱을 켠 상태에서 입력 줄이기(이미지 크기 조정과 도구 검색)로 짧은 실행에서는 26%, 긴 실행에서는 21%를 추가로 절감했습니다.
사용하지 않는 도구 정의 지연 로딩
요청에 첨부된 모든 도구 정의는 매 턴마다 입력으로 전송됩니다. "Model Context Protocol", 즉 MCP 서버 몇 개만 연결해도 도구 정의가 수백 개에 이를 수 있습니다. Anthropic은 분류 에이전트 자체의 도구 2개에 공개 MCP 서버의 실제 도구 정의 카탈로그를 더해 최대 502개의 도구로 에이전트를 실행했습니다. 이때 모든 도구를 로드한 경우와, 추가 도구를 defer_loading으로 표시해 도구 검색으로 불러오게 한 경우를 비교했습니다:
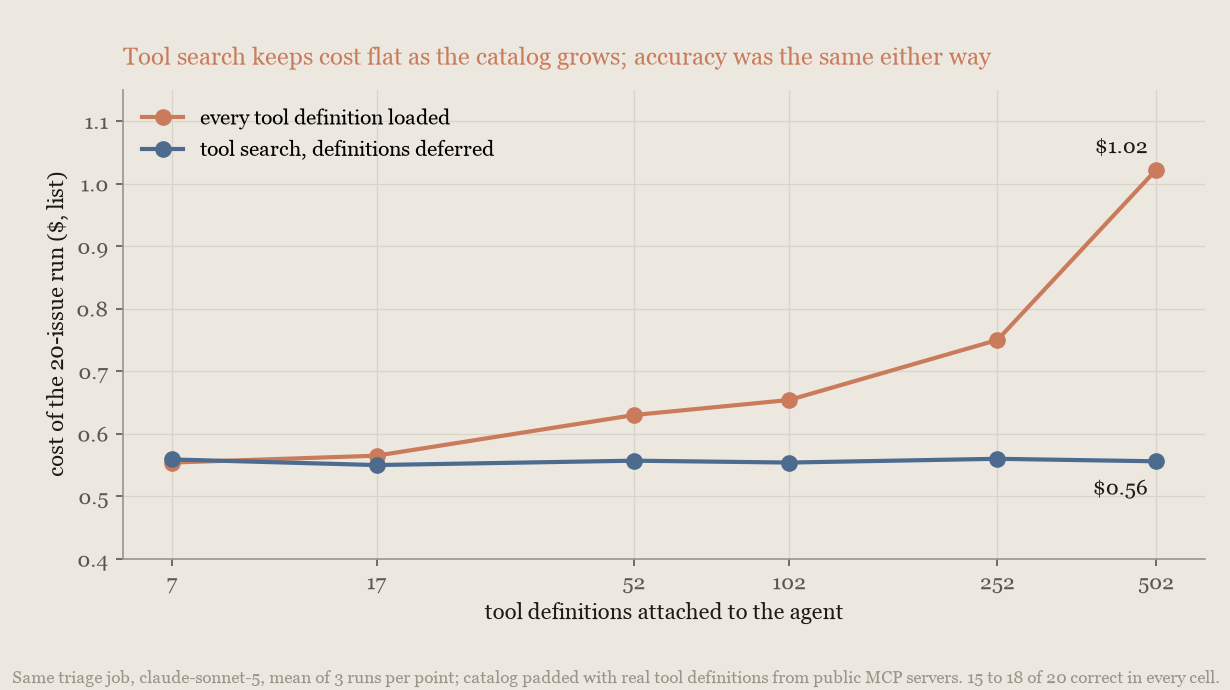
모든 정의를 로드하면 카탈로그가 커질수록 실행 비용이 거의 두 배로 늘었으며, 이는 요청마다 포함되는 스키마 토큰의 증가와 일치했습니다. 도구 검색을 사용하면 카탈로그 크기와 관계없이 비용이 일정했고, 502개 도구에서는 45% 적었습니다. 정확도는 두 방식 모두 모든 셀에서 20건 중 15~18건이었고, 모델이 잘못된 도구를 호출한 적은 한 번도 없었습니다. 즉, 이 규모에서 카탈로그 크기는 정확성이 아니라 비용에만 영향을 줍니다. MCP 커넥터를 통해 제공되는 도구도 마찬가지입니다. 공개 GitHub MCP 서버를 연결한 상태에서 해당 도구 세트를 지연 로딩(default_config: {defer_loading: true})하자 같은 정확도에서 실행 비용이 20% 줄었습니다.
데이터 파일을 프롬프트에서 제외하기
모델이 표 데이터로 계산해야 할 때는 표를 프롬프트에 붙여 넣지 마세요. 대신 Files API로 업로드하고 모델이 코드 실행으로 쿼리하게 하세요. Anthropic은 1,862행짜리 공개 CSV를 대상으로 25개의 집계 질문15(합계, 필터링된 개수, group-by, 날짜 필터)을 던졌으며, 정답은 pandas로 계산했습니다:
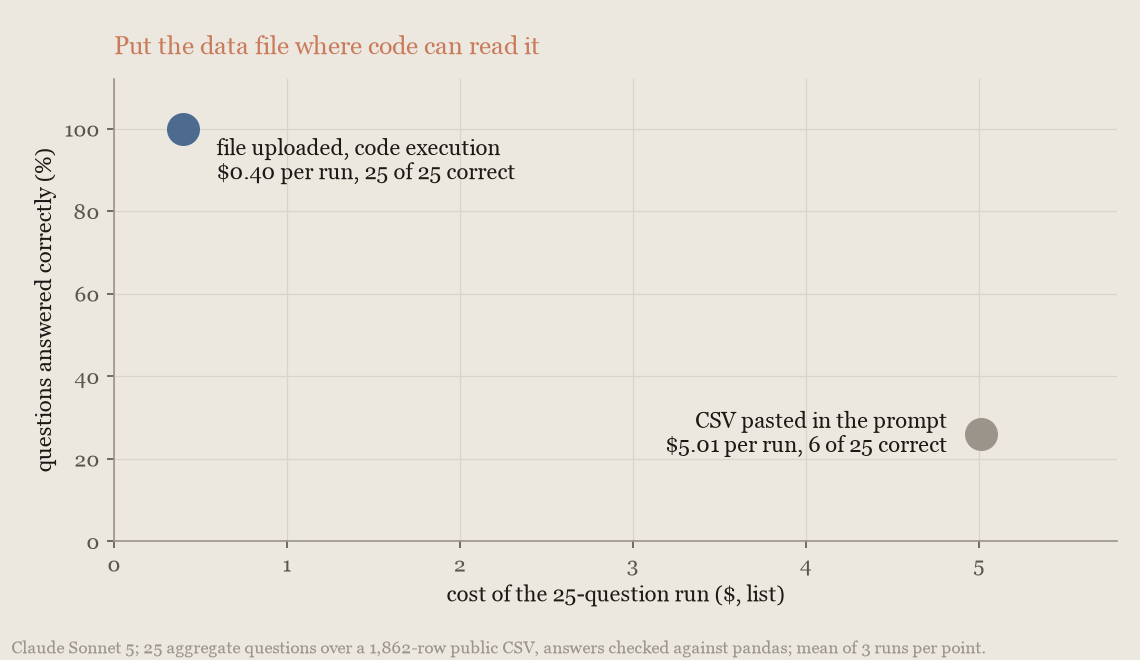
프롬프트에 붙여 넣으면 표가 매 요청마다 약 91,000개의 입력 토큰을 차지했고, Claude Sonnet 5는 25개 질문 중 6개만 맞혔습니다. 파일을 업로드하고 코드 실행을 사용하자 25개를 모두 맞혔고, 실행 비용은 약 12분의 1이었습니다. Claude Opus 5에서도 같은 패턴이 나타났습니다.
컨텍스트 수명 주기 관리
컨텍스트 레버는 세션이 이 레버가 필요할 만큼 길 때만 효과가 있습니다:
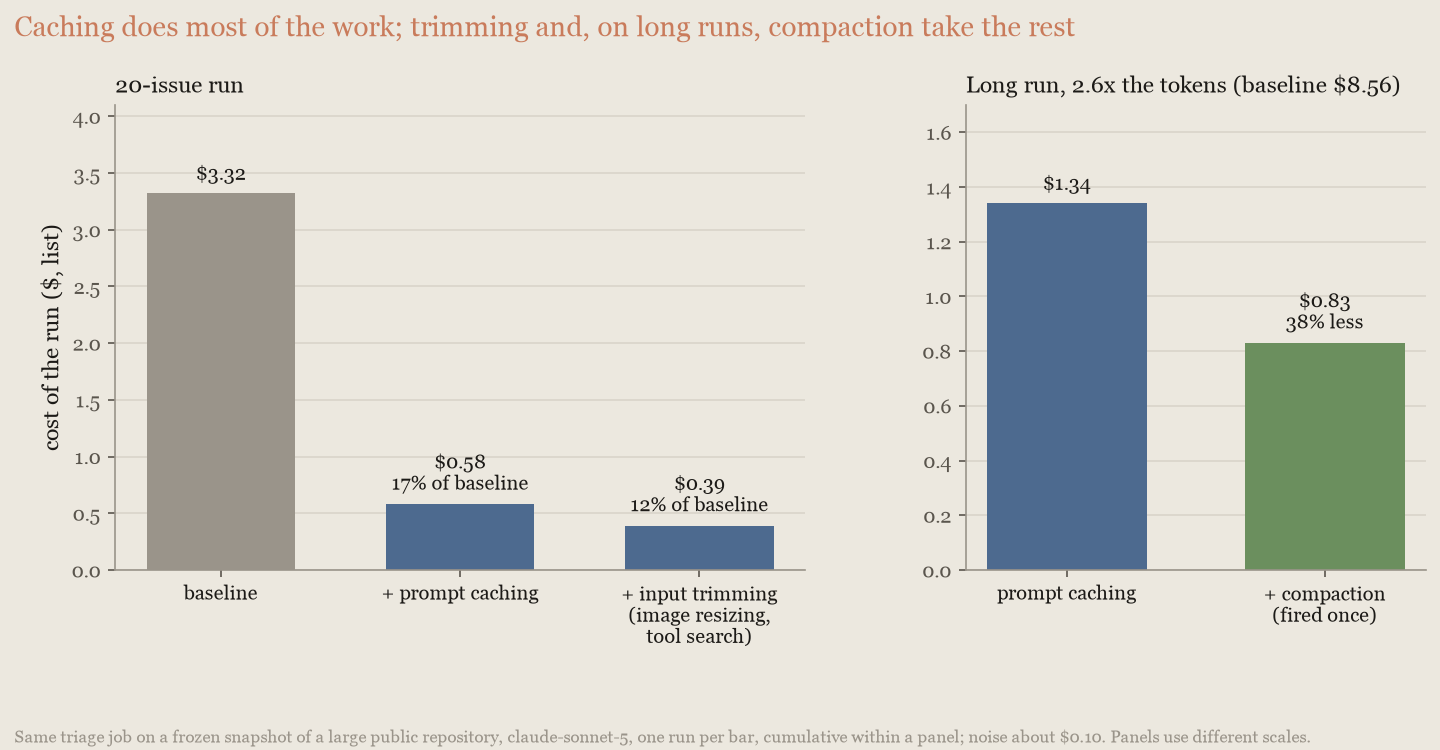
20건짜리 실행에서는 어떤 레버도 비용을 줄이지 못했고, 컨텍스트 편집은 오히려 비용이 74% 늘었습니다. 긴 실행에서는 가지치기가 39%, 압축이 32%를 절감했고, 컨텍스트 편집은 효과가 없었습니다. 가지치기는 직접 작성하는 몇 줄짜리 코드입니다. 각 작업 경계에서 크고 오래된 도구 결과를 한 줄짜리 요약으로 교체합니다. 편집이 대화의 끝부분, 즉 다음 작업이 어차피 새 콘텐츠를 추가하는 위치에서 일어나므로 캐시 효율이 좋습니다. 경계 직후 첫 번째 요청에서는 89%, 경계 사이의 요청에서는 81%가 캐시 읽기였습니다. 실행 전체로 보면 가지치기와 컨텍스트 편집의 캐시 효율은 비슷합니다. 그런데도 가지치기가 더 저렴한 이유는 두 가지입니다. 첫째, 컨텍스트 편집은 가지치기라면 삭제했을 콘텐츠를 작업 도중에 다시 씁니다(격차의 약 3분의 2). 둘째, 가지치기는 컨텍스트를 약 절반 크기로 유지합니다(나머지 3분의 1). 컨텍스트 편집을 사용한다면 몇 번에 걸쳐 한꺼번에 크게 지우세요. 다음은 하네스에서 가져와 수정한 가지치기 코드입니다:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # 추출 결과가 짧게 유지되도록 한 줄 결과의 길이를 제한합니다
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extract기다릴 수 있는 작업은 배치로 처리하기
Batch API는 결과가 24시간 이내 아무 때나 도착하는 대신, 캐시된 토큰을 포함해 요청의 모든 토큰에 50% 할인을 적용합니다. 아무도 결과를 기다리지 않는 요청은 모두 배치로 보내고, 나머지 요청만 대화형 경로로 처리하세요. 사람이 지켜보지 않는 에이전트 작업에서 배치 처리는 캐싱 다음으로 큰 무료 레버입니다. 평가 실행, 백필, 그리고 토큰 줄이기 측정의 이슈 분류 에이전트를 주기적으로 실행하는 것 같은 예약 작업이 여기에 해당합니다. 배치 처리는 대화형 처리를 제외한 이 페이지의 모든 레버와 함께 사용할 수 있습니다. 다만 설계상 대화형인 Claude Managed Agents 세션에서는 사용할 수 없습니다(Claude Managed Agents 가격 참조).
현재 모델에 맞춰 프롬프트 감사하기
모델 세대마다 프롬프트에 반응하는 방식이 다르므로, 프롬프트에는 더 이상 사용하지 않는 모델을 위해 작성된 텍스트가 쌓이게 됩니다. 흔한 예는 이전 모델의 부족한 점을 보완하려고 추가한 지나치게 구체적인 지침입니다. "verify twice"(두 번 검증하세요), "be maximally thorough"(최대한 철저하게 하세요), 필수 단계별 절차, 직접 만든 추론 스크래치패드 등이 여기에 해당합니다. 최신 모델은 이런 지침을 문자 그대로 따르기 때문에 도구 호출 라운드와 출력이 늘어나고, 정확도는 그대로인 채 청구액만 늘어납니다. 지금 실행 중인 모델에 맞춰 프롬프트를 감사하고, 모델을 바꿀 때마다 다시 감사하세요. 이는 비용이 들지 않는 개선입니다.
감사는 명령 하나로 실행할 수 있습니다. Claude Code와 함께 제공되는 Claude API 스킬에는 prompt-audit 명령이 있습니다. 이 명령은 프로젝트의 프롬프트와 요청 코드를 읽고 다른 모델을 위해 작성된 부분을 찾아 보고합니다. 다음은 이러한 패턴이 포함된 고객 지원 데스크 프롬프트와 요청 코드에 이 명령을 실행한 결과를 줄인 발췌문입니다:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.이어서 명령은 수정 사항을 diff로 제안하고(hunk 하나만 표시), 의도적으로 그대로 둔 항목인 환불 기간, 어조 요구 사항, 품질 기준을 나열합니다. 전체를 다시 작성한 결과가 아니라 패치만 검토하면 됩니다.
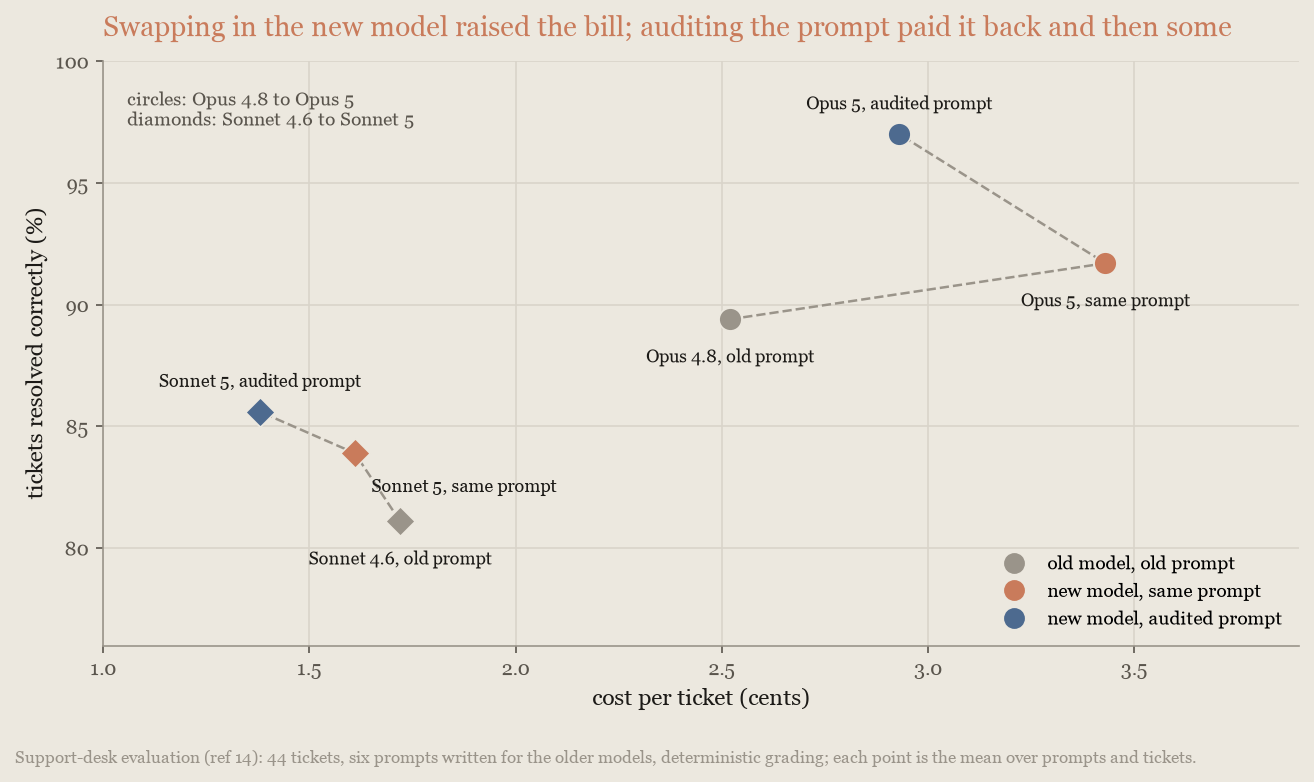
효과는 측정으로 확인할 수 있습니다. 고객 지원 데스크 평가14에서 Claude Opus 4.8용으로 작성된 프롬프트를 Claude Opus 5에서 실행하자, 정확도는 그대로인데 티켓당 비용이 36% 늘었습니다. 같은 프롬프트를 감사하자 Opus 5는 감사 전보다 14% 저렴해졌고 정확도도 높아졌습니다(티켓의 92%에서 97%로, 노이즈 범위를 벗어난 향상). Claude Sonnet 4.6에서 Claude Sonnet 5로 마이그레이션할 때는 감사로 같은 정확도를 유지하면서 비용을 14% 줄였습니다:
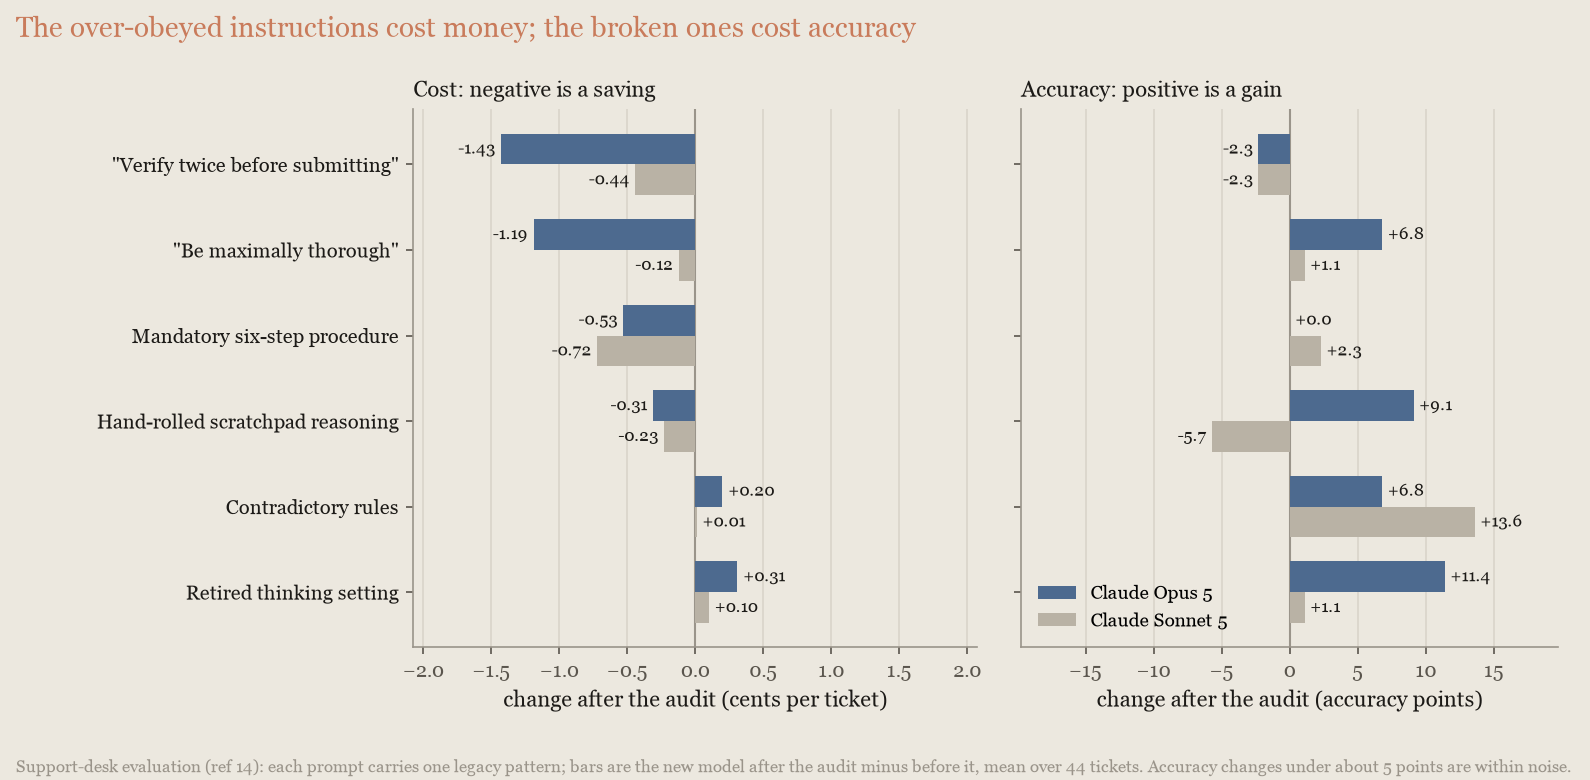
오래된 텍스트는 두 종류이며, 각각 다른 손실을 일으킵니다. 새 모델이 지나치게 문자 그대로 따르는 지침은 비용을 늘립니다. "verify twice"를 제거하자 Opus 5의 티켓당 비용이 3분의 1 줄었고, "be maximally thorough"를 제거했을 때도 거의 그만큼 줄었습니다. 반면 더 이상 모델에 맞지 않는 텍스트는 정확도를 떨어뜨립니다. 종료된 thinking 설정, 서로 모순되는 규칙, 모델 자체의 사고 과정과 충돌하는 직접 만든 스크래치패드는 각각 제거했을 때 Opus 5의 정확도를 7~11포인트 회복시켰습니다:
같은 패턴은 도구 설명과 스킬에도 나타나기 쉬우므로, 이들도 함께 감사하는 것이 좋습니다.
비용과 지능 맞바꾸기
이 레버들은 단일 모델이 비용과 지능 사이에서 어디에 위치할지를 결정합니다. 모델 선택, effort, 더 높은 설정으로 실패 재실행, 모델이 작업하는 범위인 예산과 상한, 그리고 모델이 경과 시간을 볼 수 있는지 여부입니다. 현재 모델에서 effort 스윕부터 시작하세요(effort 조정). 비용과 성능이 낮은 순서부터 높은 순서로 현재 모델은 Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5, Claude Fable 5.1(프런티어 모델)입니다. 전체 라인업과 가격은 모델 개요에서 확인하세요.
작업당 비용으로 모델 비교하기
가격표는 토큰당으로 작성되며, 토큰당으로 보면 프런티어 모델은 비싸 보입니다. Claude Fable 5.1의 토큰당 가격은 Claude Sonnet 5의 몇 배입니다. 하지만 실제로 비용을 지불하는 대상은 완료된 작업이므로, 완료된 작업당 비용으로 모델을 비교하세요. 더 뛰어난 모델은 더 적은 작업량으로 작업을 완료합니다. 턴 수가 적고, 검색이 적고, 자체 컨텍스트를 다시 읽는 일이 적고, 되돌아가는 일도 적습니다. 토큰당 프리미엄은 모든 것을 덜 하는 효과에 압도되는 경우가 많습니다.
Anthropic은 고객에게 청구되는 방식으로 가격을 산정하여 SWE-bench Pro3 하위 집합에서 이를 측정했습니다:
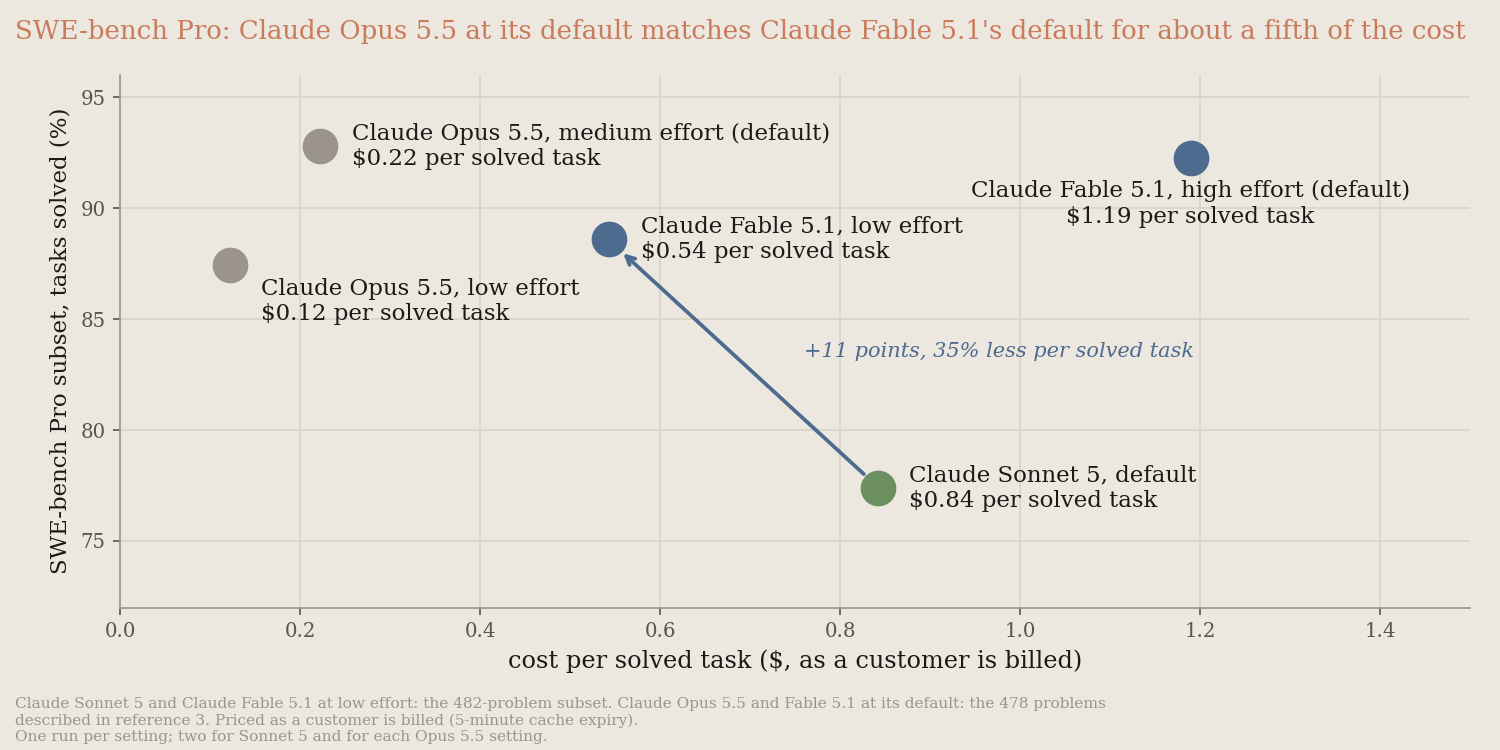
low effort의 Claude Fable 5.1은 해결한 작업당 $0.54로 작업의 88.6%를 해결했으며, 기본 설정의 Claude Sonnet 5는 $0.84로 77.4%를 해결했습니다. 토큰당 가격이 5배 높은데도 해결한 작업당 비용은 35% 적으면서 점수는 11점 더 높았습니다. 하지만 항상 이기는 것은 아닙니다. Claude Opus 5.5와 Claude Fable 5.1이 모두 대체로 포화 상태에 이르고 점수를 공개 리더보드와 비교할 수 없는 같은 하위 집합에서, 기본 설정인 medium의 Opus 5.5는 기본 설정의 Fable 5.1과 같은 성능(92.8% 대 92.3%, 실행 간 노이즈 범위 내)을 해결한 작업당 약 5분의 1 비용($0.22 대 $1.19)으로 냈습니다. low에서 Opus 5.5는 $0.12로 87.4%를 해결했습니다. 이 수치는 참조 3에 설명된 478개 문제를 사용합니다. 그리고 긴 리서치 루프에서는 프런티어 모델이 더 적게가 아니라 더 많이 작업합니다. DeepResearch Bench II7에서 low의 Fable 5.1은 Sonnet 5보다 10점 높은 점수(66% 대 56%)를 작업당 약 4배의 비용($4.66 대 $1.20)으로 기록했는데, 더 큰 컨텍스트에서 더 긴 리서치 루프를 실행하기 때문입니다. 기본 설정의 Claude Opus 5는 같은 기준에서 작업당 $6.71로 71%를 기록해 기본 설정의 Fable 5.1(65%, $7.12)보다 높았으므로, 리서치에서도 Fable 5.1은 low에서만 가격만큼의 가치를 합니다.
대부분의 에이전트 워크로드에서는 기본 effort(medium)의 Claude Opus 5.5로 시작하고, 까다로운 추론과 장기적인 에이전트 작업에는, 또는 더 높은 effort의 Claude Opus 5.5로도 평가 결과가 부족할 때는 Claude Fable 5.1을 사용하세요. 앞서 언급했듯이 SWE-bench Pro 하위 집합에서 기본 설정의 Opus 5.5는 해결한 작업당 약 5분의 1 비용으로 기본 설정의 Fable 5.1과 같은 성능을 냈습니다. 어드바이저 전략의 코딩 벤치마크에서는 medium의 Fable 5.1(단일 Fable 5.1 실행)의 84.2%에 비해 86.6%를 기록했으며, 시도당 비용은 3분의 1 미만($0.84 대 $2.68)이었습니다. 차트 읽기 벤치마크인 Chartography13에서 low의 Opus 5.5는 차트당 약 $0.03로 68.7점을 기록했으며, low의 Fable 5.1은 $0.15로 62.5점, low의 Claude Opus 5는 $0.16로 49점이었습니다. 반대쪽 끝에서 Claude Haiku 4.5는 GPQA Diamond9 질문에 Claude Opus 5.5의 질문당 비용의 약 5분의 1로 답했으며, 정확도는 Opus 5.5의 92%에 비해 63%였고, 긴 코딩 작업에서는 훨씬 더 뒤처졌습니다. Haiku 4.5는 긴 에이전트 루프가 아니라 출력을 검증할 수 있는 대량 작업에 적합합니다.
순위는 워크로드에 따라 뒤바뀌며, 어느 쪽으로 바뀔지는 어떤 가격표도 알려 주지 않습니다. 기본 effort의 Claude Opus 5.5와 낮춘 effort의 프런티어 모델을 포함해, 모든 후보를 자체 트래픽에서 완료된 작업당 비용으로 산정하세요.
중앙값이 아니라 워크로드의 꼬리(tail)를 기준으로 가격을 산정하세요. 일반적인 작업이 아니라 가장 어려운 상위 10%의 작업으로 모델을 비교하세요. 일반적인 작업에서는 모든 모델이 비슷해 보이고 가장 저렴한 모델이 가장 좋아 보이지만, 청구액은 더 저렴한 모델이 실패하는 작업에 의해 결정됩니다. 실패한 작업도 토큰 비용이 청구되고, 그다음 재시도 비용, 그리고 실패가 다운스트림에 초래하는 비용이 뒤따르기 때문입니다. 꼬리는 아무것도 실패하지 않을 때도 비용이 집중되는 곳입니다. 20개 문제로 구성된 WideSearch1 실행에서 두 문제가 지출의 43%를 차지했습니다:
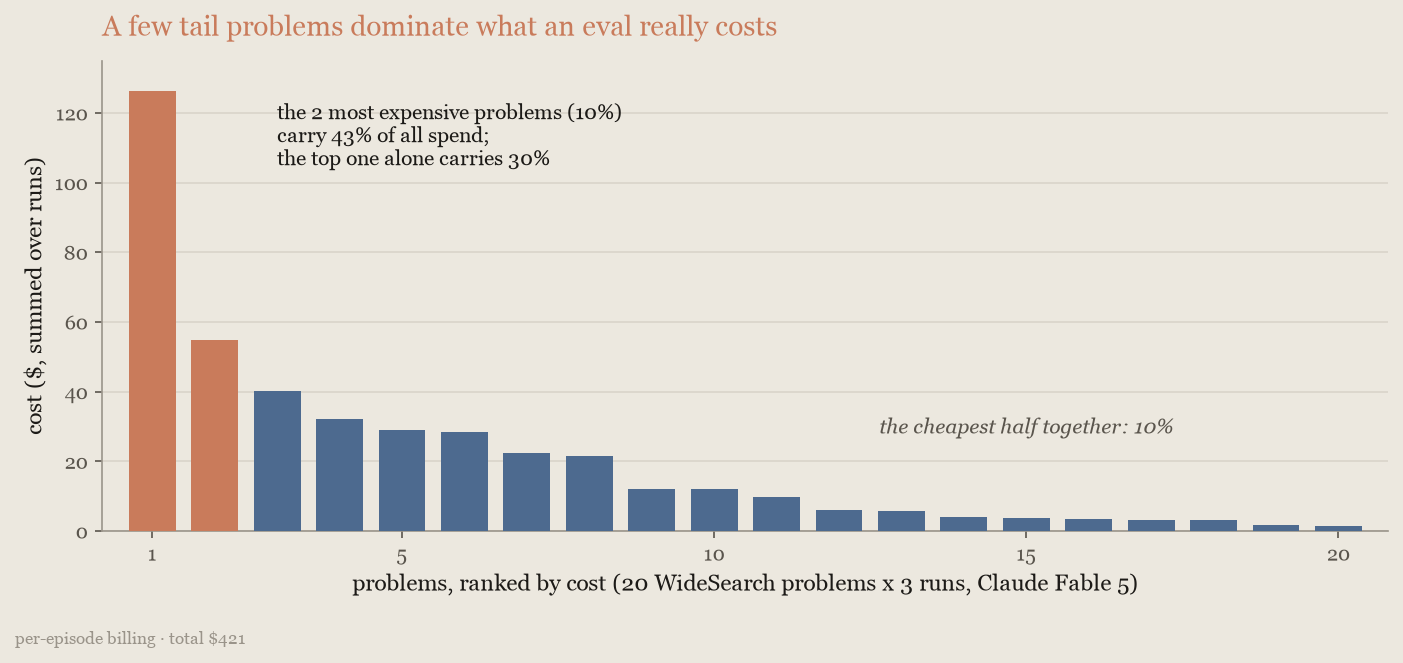
다중 모델 전략은 나머지 작업에 프런티어 요금을 지불하지 않으면서 그 꼬리에 프런티어 지능을 투입하기 위해 존재합니다.
모델 업그레이드
사용 중인 모델이 한두 세대 뒤처져 있다면 가장 저렴한 레버는 모델 문자열을 바꾸는 것입니다. Anthropic은 최근의 Claude Opus, Claude Sonnet, Claude Fable 모델을 SWE-bench Pro3 하위 집합에서 같은 하네스로 실행했습니다. 각 모델은 출시 시 기본 설정을 사용했고 비용은 정가로 산정했습니다. Opus 라인은 Terminal-Bench 320에서도 실행했습니다:
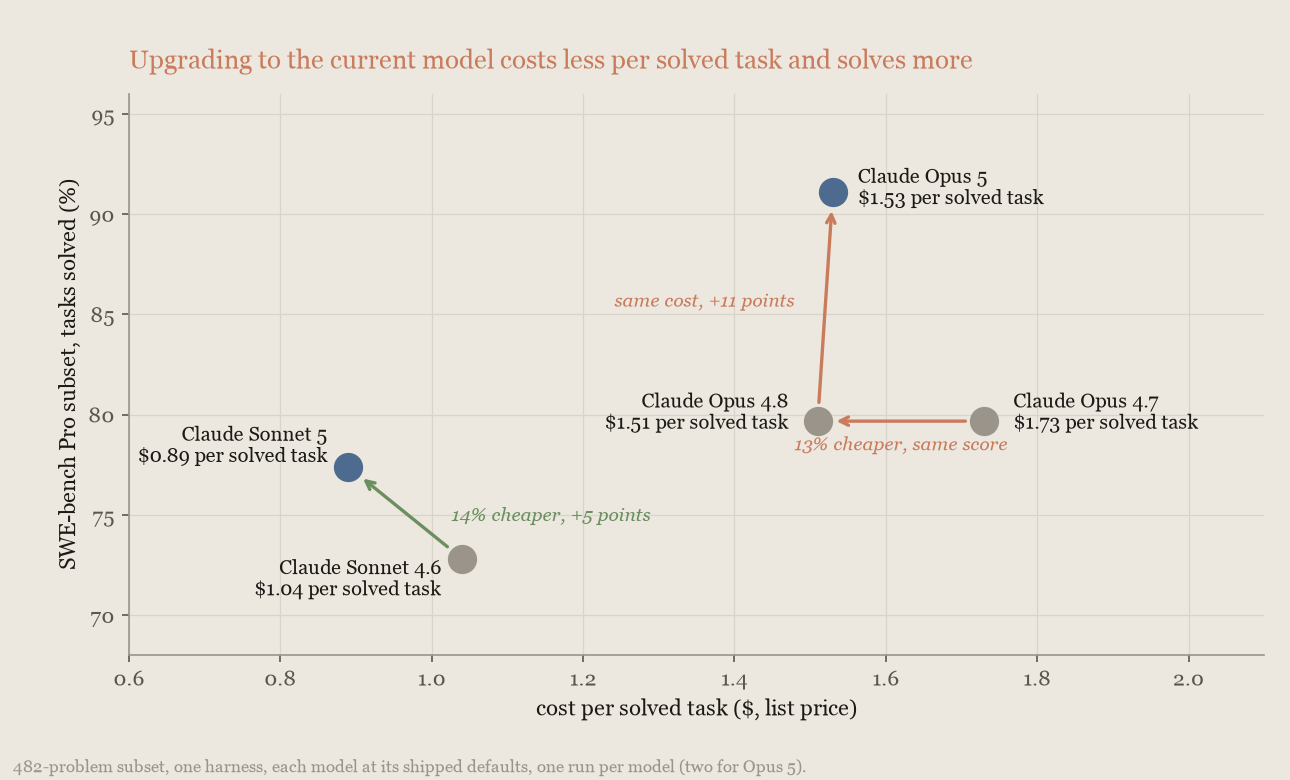
Anthropic은 Claude Opus 4.7, Opus 4.8, Opus 5의 토큰당 가격을 동일하게 책정하므로, 이 모델들 간의 비용 차이는 각 모델이 작업 하나에 얼마나 많은 작업량을 쓰는지에서 비롯됩니다. 실제 고객 청구 방식으로 산정하면 Claude Opus 4.8은 Claude Opus 4.7과 같은 비율의 작업을 해결된 작업당 14% 적은 비용으로 해결합니다. Claude Opus 5는 해결된 작업당 비용이 21% 더 들지만 12포인트 더 많은 작업을 해결합니다. 이 벤치마크에서 low effort의 Claude Opus 5는 기본값의 Opus 4.8보다 높은 성능을 해결된 작업당 약 30%의 비용으로 달성합니다. 따라서 가장 저렴한 업그레이드 방법은 새 모델을 더 낮은 설정으로 사용하는 것입니다. Sonnet 5의 절감은 더 낮은 토큰당 가격에서 나옵니다. Sonnet 4.6보다 작업당 토큰을 더 많이 사용하지만, 낮은 가격이 이를 상쇄하고도 남습니다. 그 결과 5포인트 더 높은 점수를 해결된 작업당 15% 적은 비용으로 달성합니다. 프런티어 티어도 같은 방식으로 개선되었습니다. Claude Fable 5.1은 Claude Fable 5와 같은 점수를 해결된 작업당 43% 적은 비용으로 달성하며, 절감분의 대부분은 더 낮은 캐시 읽기 가격에서 나옵니다. 하지만 업그레이드가 항상 비용을 줄이는 것은 아닙니다. DeepResearch Bench II7에서는 같은 업그레이드로 모든 조건에서 문제없이 실행된 작업(참조 7) 기준 2~3포인트를 더 얻었지만, 작업당 비용은 high에서 41%(low에서는 79%) 늘었습니다. 이 벤치마크에서는 새 모델이 작업당 더 많은 작업량을 쓰기 때문입니다. 입력 및 출력 가격은 같고 캐시 읽기는 4배 저렴하지만, 비용이 줄어든다고 가정하기 전에 자신의 워크로드에서 업그레이드 효과를 측정하세요.
더 어려운 작업에서는 격차가 더 벌어집니다. Terminal-Bench 320은 작업이 충분히 어려워서 토큰 수보다 통과율이 청구액을 좌우합니다. 여기서 Claude Opus 4.7, Opus 4.8, Opus 5는 각각 작업당 $8~$15를 쓰지만 작업의 7%, 15%, 41%를 해결합니다. 따라서 해결된 작업당 비용은 단계가 올라갈수록 $183에서 $63, $28로 떨어집니다. 포화된 코딩 하위 집합에서 Claude Opus 5가 Opus 4.8보다 21% 더 비쌌던 것이, 이전 모델이 대부분 실패하는 Terminal-Bench 3에서는 56%의 절감으로 바뀝니다. 워크로드가 이전 모델에게 어려울수록 업그레이드로 결과당 더 많이 절감할 수 있습니다.
토큰당 비용이 아니라 해결된 작업당 비용으로 비교하세요. Claude Opus 4.7 이상에서는 같은 텍스트가 약 30% 더 많은 토큰으로 계산되므로, 토큰당 비교에서는 최신 모델이 구조적으로 더 비싸 보일 수밖에 없습니다.
Effort 조정
"Effort"(노력 수준)는 모델을 작업에 맞게 조정하는 가장 직접적인 방법입니다. effort 매개변수는 모델이 수행하는 사고, 도구 호출, 자체 검증의 양을 제어합니다. 대부분의 모델에서 기본값인 high는 까다로운 작업에 적합하며, Claude Opus 5.5의 기본값은 medium입니다. 비용은 이 모든 활동에 비례해 증가하지만, 정확도는 그중 작업에 실제로 필요한 부분에 대해서만 높아집니다. 작업이 모델의 한계보다 낮은 수준이라면, 가장 높은 effort 수준에서는 작업에 필요하지 않은 깊이에 비용을 지불하게 됩니다.
연구 및 지식 작업 벤치마크(WideSearch1, DeepWideSearch6, BrowseComp4, GDPval2, 모두 Claude Fable 5 사용)에서는 비용 대비 정확도 곡선이 거의 평평합니다. low는 정확도가 1~3점 낮아지는 대신 작업당 비용이 3분의 1에서 절반까지 줄었습니다. medium은 기본값 비용의 약 70%~87%로 기본값과 같은 정확도를 달성했습니다. 네 가지 벤치마크 모두에서 기본값은 medium보다 측정 가능한 이점이 없었습니다. DeepWideSearch에서 low는 Claude Sonnet 5 워커를 사용하는 오케스트레이터와 같은 성능을 29% 낮은 비용으로 냈습니다. 즉, effort를 낮추는 것이 아키텍처를 변경하는 것보다 효과적이었습니다.
낮은 effort 설정은 대체로 더 빠르므로, "latency"(지연 시간)가 제약 조건일 때 유용합니다. 이 실행에서 DeepWideSearch의 문제당 소요 시간은 low에서 4.5분, 기본값에서 7.9분이었습니다. 입력이 어떤 단일 "context window"(컨텍스트 윈도우)에도 들어가지 않는 코퍼스 벤치마크에서 Fable 5.1의 에피소드당 소요 시간은 low, medium, high에서 각각 15.2시간, 17.5시간, 19.9시간이었습니다.
장기적인 코딩 작업에서는 effort를 높이면 실제로 정확도가 올라갑니다. SWE-bench Pro3에서 high와 비교하면, Claude Opus 5.5는 기본값인 medium에서 약 70%의 비용으로 점수가 약 2.5점 낮았고, low에서는 약 3분의 1의 비용으로 약 8점 낮았습니다. xhigh는 high의 2.5배 비용으로 점수가 약 1.4점 높았습니다. 이는 실제 트레이드오프이지만, 실패한 작업을 더 높은 effort로 재실행하면 다시 비용 절감으로 바꿀 수 있습니다. 다음 차트는 연구 및 지식 작업 벤치마크와 SWE-bench Pro의 비용 대비 정확도를 보여 줍니다:
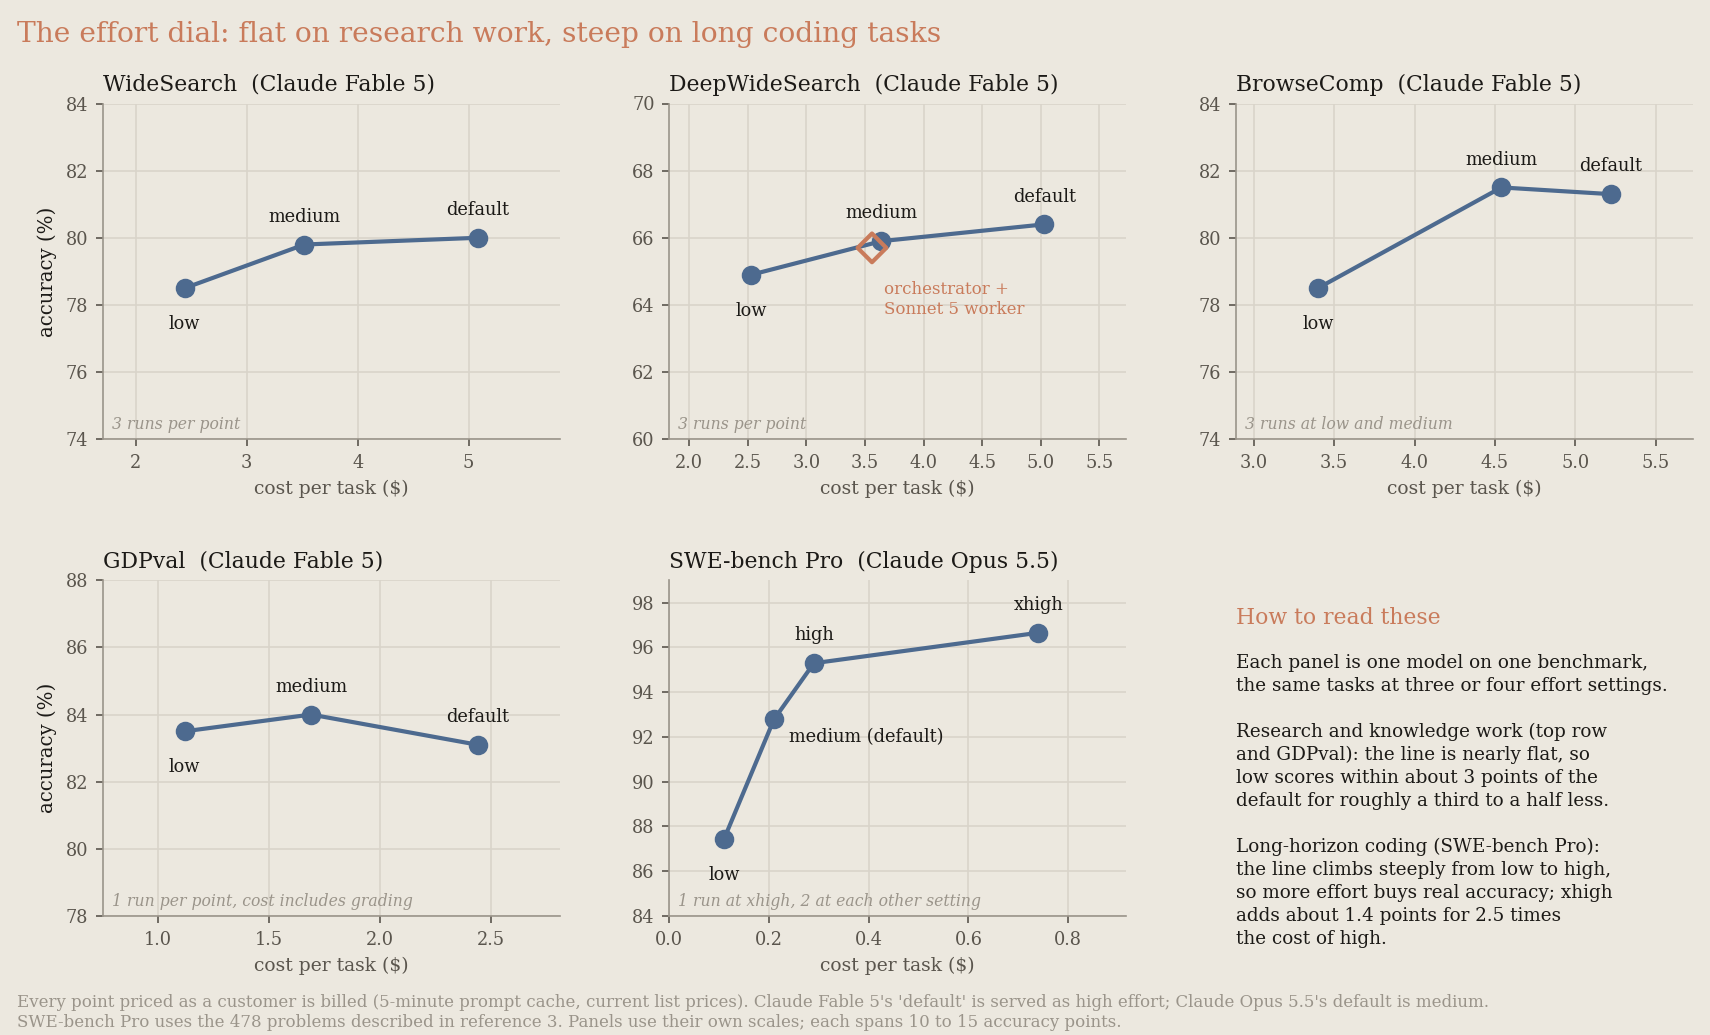
여기서 두 가지 시사점을 얻을 수 있습니다. 첫째, 두 번째 모델을 추가하기 전에 자체 워크로드에 대해 이 곡선을 그려 보세요. 이 내부 측정에서는 기본 설정의 단일 모델보다 저렴해 보였던 다중 모델 구성이, 같은 단일 모델을 더 낮은 effort로 실행한 것보다 비용이 더 많이 들었습니다. 둘째, 이 곡선은 모든 다중 모델 전략이 넘어서야 하는 단일 모델 기준선입니다. 그래서 자체 워크로드에서 측정하기의 2단계에서는 여러 effort 수준에 걸쳐 기준선을 설정합니다.
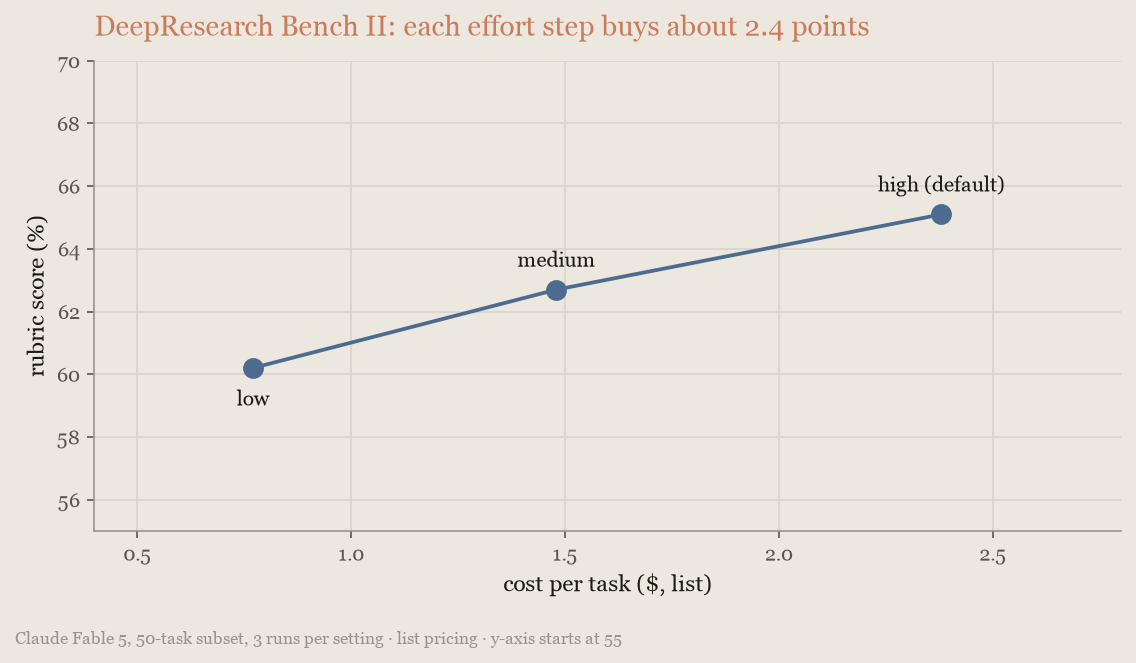
어려운 작업이라고 해서 반드시 높은 effort가 필요한 것은 아닙니다. DeepResearch Bench II7에서 Claude Fable 5.1은 low, medium, high에서 거의 같은 점수를 기록했지만, 작업당 비용은 $4.66에서 $7.12로 증가했습니다. 이 경우 effort를 높여도 출력 품질이 눈에 띄게 향상되지 않습니다. 모든 실험군에서 문제없이 완료된 21개 작업(참고 문헌 7)에서는 Claude Fable 5도 effort 수준과 관계없이 점수가 평평했습니다. 다만 각 모델에서 중간에 중단된 시도를 제외한 차트의 33개 작업 기준으로는 점수가 상승하는 것으로 나타납니다. 마지막으로 측정했던 모델이 아니라 실제로 배포하는 모델에서 곡선을 측정하세요:
작업 설명만으로는 워크로드가 어떤 유형인지 알 수 없습니다. 자체 트래픽 샘플에서 두세 가지 effort 수준을 테스트하고 곡선을 보고 판단하세요. 각 수준은 별도의 세션에서 테스트하세요. 세션 도중에 최상위 effort를 변경하면 캐시가 무효화되어(반복되는 컨텍스트 캐싱 참조) 비교 결과가 왜곡됩니다. 매개변수에 대한 자세한 내용은 Effort를 참조하세요.
실패한 작업을 더 높은 effort로 재실행
작업 결과를 검증할 수 있다면, effort 곡선에서 가장 저렴한 정책은 하나의 설정을 고정하는 것이 아닙니다. 모든 작업을 낮은 설정으로 실행한 다음, 실패한 작업만 더 높은 설정으로 재실행하세요.
Anthropic은 Effort 조정에서 사용한 SWE-bench Pro3 하위 집합의 effort 실행 결과를 바탕으로 이 정책의 효과를 작업별로 계산했습니다. Claude Opus 5.5를 low로 실행했을 때 작업의 13%가 실패했고, 실패한 작업을 high로 재실행하자 작업당 약 $0.17로 약 97%가 통과했습니다. 반면 모든 작업을 high로 실행하면 작업당 $0.29로 95.3%가 통과했습니다. 실패한 저렴한 시도의 비용까지 포함해도, 절반을 약간 넘는 비용으로 통과율이 약간 더 높았습니다. medium에서 시작하면 약 $0.24로 약 97%를 해결했습니다. 통과율이 소폭 오른 것은 대부분 두 번째 시도 덕분입니다. 한 번의 high 실행에서 실패한 작업을 다시 high로 재실행해도 점수는 거의 같고 비용만 더 듭니다. 따라서 이 정책은 통과율 향상이 아니라 비용 절감을 위해 사용하세요:
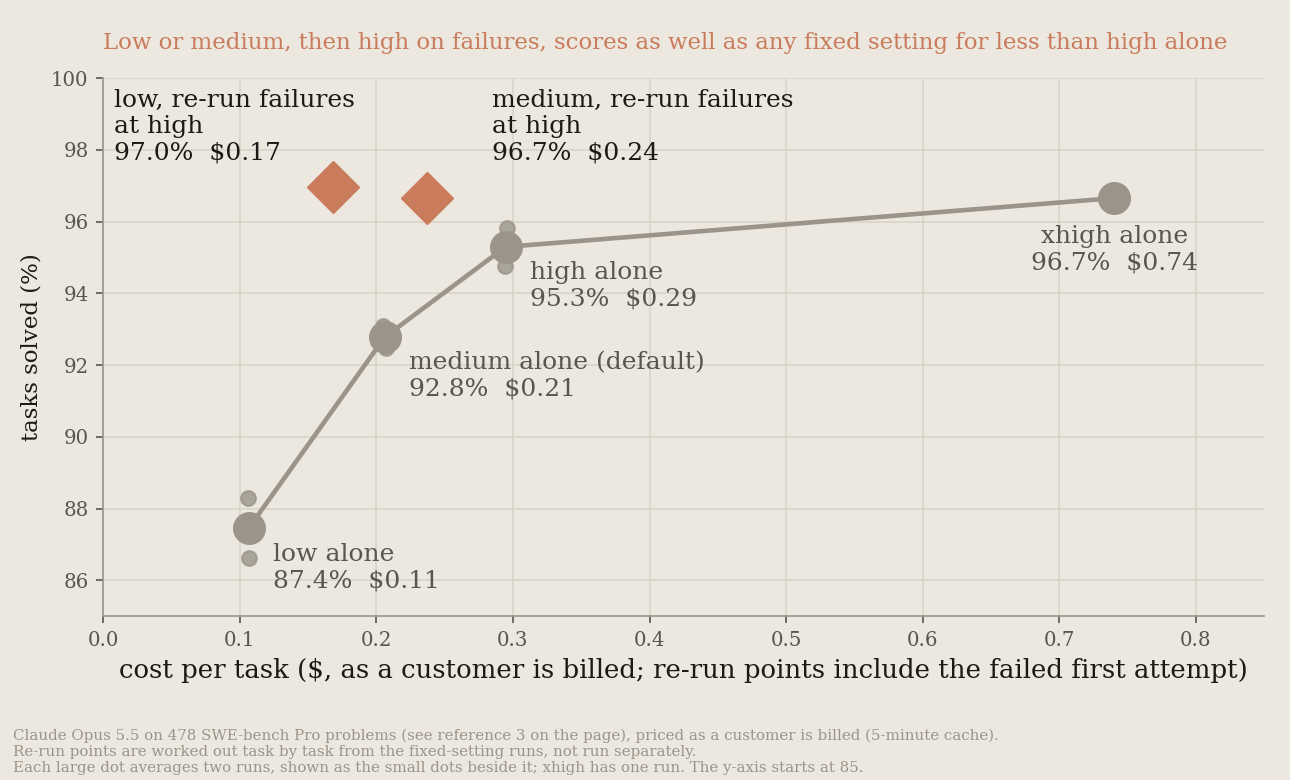
이 정책에는 두 가지 조건이 있습니다. 첫째, 실패를 판별할 신호가 필요합니다(여기서는 벤치마크 자체의 테스트). 검사기가 잘못된 결과를 통과시키면 그 실패는 재실행되지 않습니다. 둘째, 첫 번째 시도에서 실패한 작업은 실행 두 번 분량의 실제 소요 시간이 걸립니다. 즉, 비용 절감의 대가로 실패한 작업의 지연 시간이 늘어납니다.
예산 및 출력 상한 설정
대부분의 에이전트 작업 실행은 비용이 적게 들지만, 일부 실행은 검색, 재검증, 과도한 테스트에 중앙값 비용의 몇 배를 지출합니다. "Task budget"(작업 예산)은 이처럼 비용이 큰 소수의 실행을 겨냥합니다. 모델은 전체 작업에 대한 실시간 토큰 카운트다운을 보고 스스로 조절합니다. 가치가 낮은 검색을 줄이고, 중복 검증을 건너뛰며, 작업이 끝없이 늘어지기 전에 마무리합니다.
Anthropic은 Claude Fable 5.1로 SWE-bench Pro3를 실행하면서 예산을 점점 줄여 통과율과 작업당 비용을 측정했습니다:
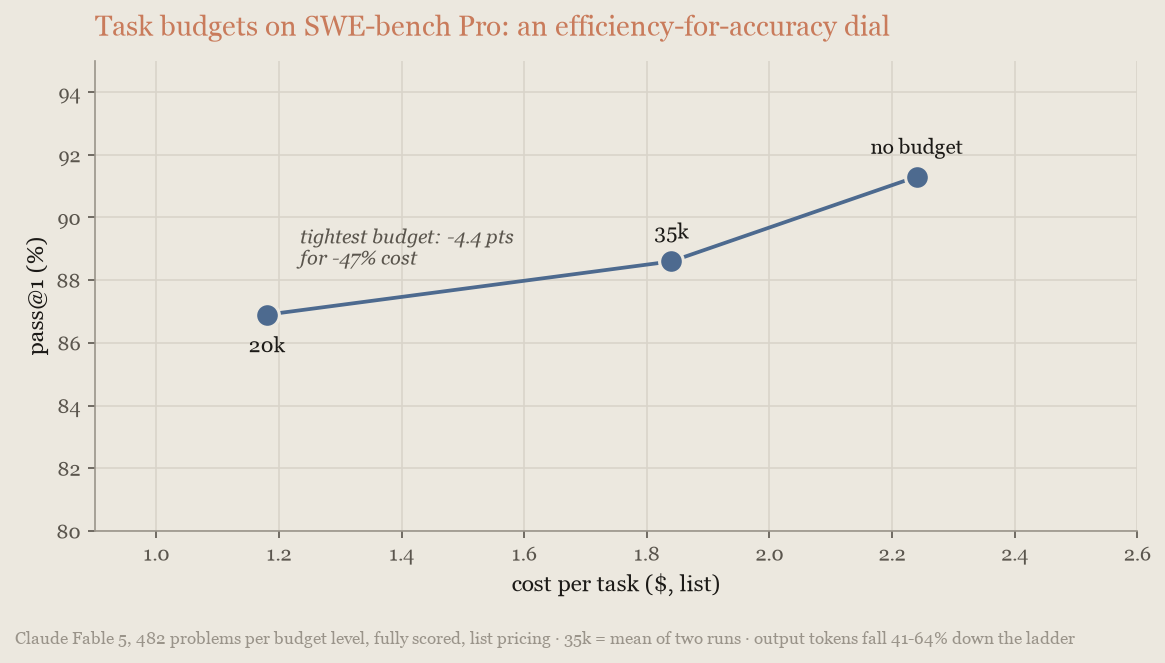
넉넉한 예산은 작업당 비용을 44% 줄였고, 통과율은 약 3점 낮아졌습니다. 이는 실행 간 노이즈와 구분하기 어려운 수준입니다. 허용되는 가장 엄격한 예산은 비용을 58% 줄였고, 통과율은 6점 낮아졌습니다. 이 측정에서 예산은 효율성을 높였지만, 예산이 엄격해질수록 통과율 손실도 커졌습니다.
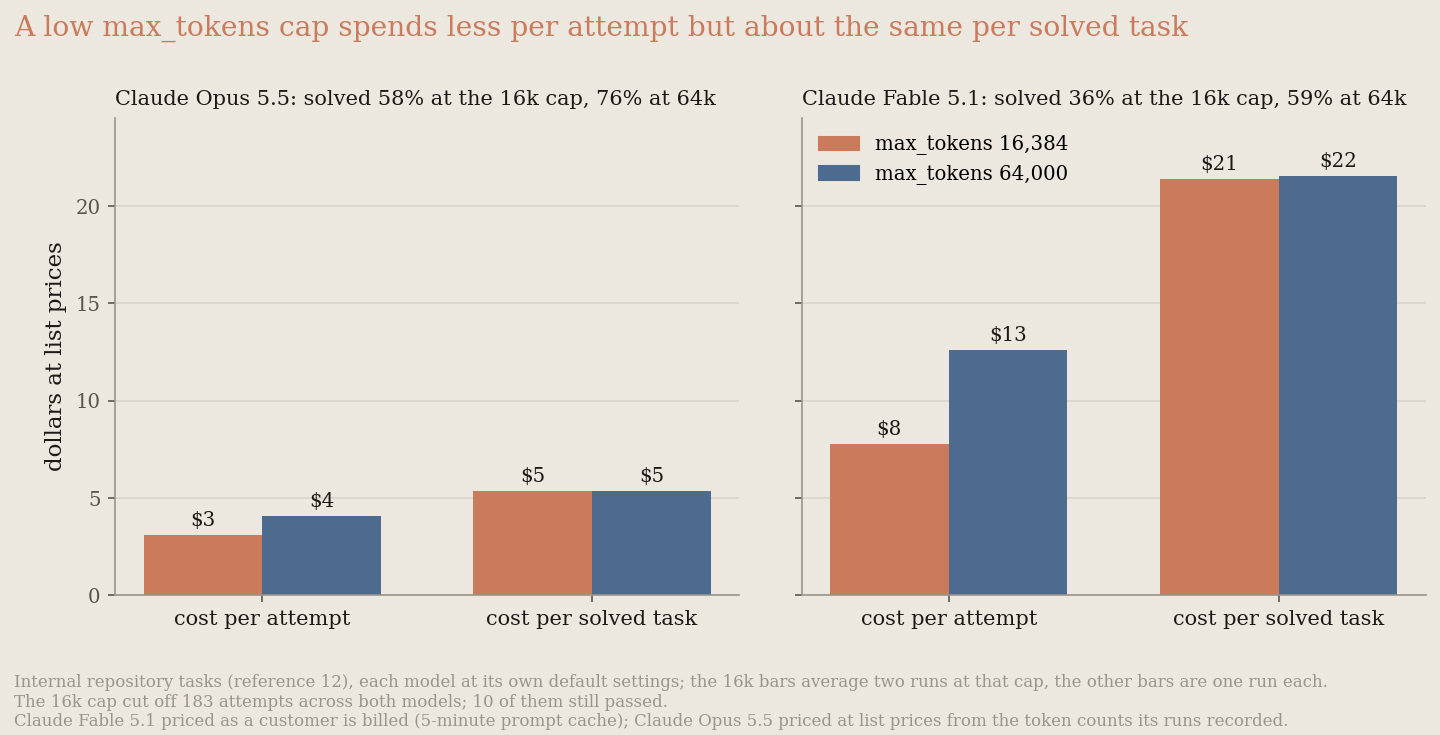
세 가지 제어 수단은 각기 다른 역할을 합니다. 작업 예산은 모델이 볼 수 있으므로 비용을 절감합니다. max_tokens는 안전 상한입니다. 이를 낮추면 시도당 비용은 줄었지만 해결된 작업당 비용은 줄지 않았습니다. Claude Managed Agents에서는 세션 예산이 이 두 가지를 뒷받침하는 엄격한 달러 기준 중단 장치입니다. 세 가지를 모두 설정하세요. 작업 예산을 설정하고, max_tokens는 높게 두고, 청구서에 나타나서는 안 되는 실행을 막기 위해 세션 상한을 설정하세요. 최종 안전장치로는 워크스페이스 지출 한도를 두세요.
- 작업 예산은 최신 모델에서 베타(베타 헤더
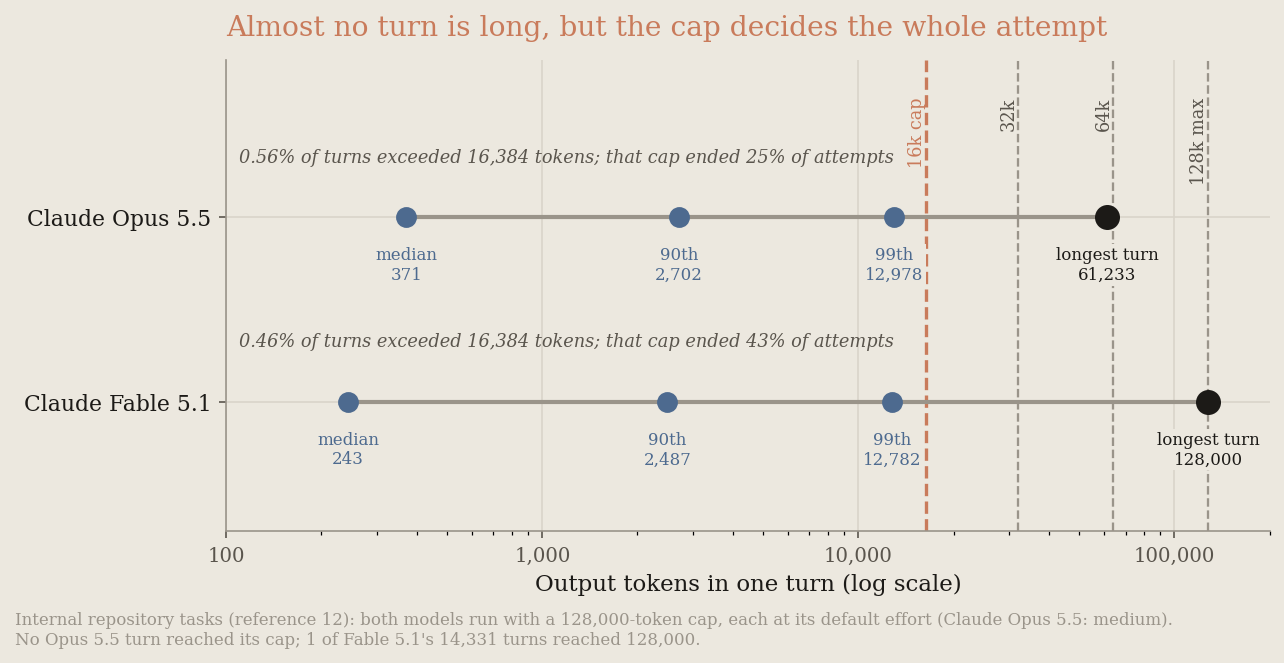
task-budgets-2026-03-13)로 제공됩니다. 지원되는 모델은 지원 표에서 확인하세요. 루프의 90번째 백분위수 토큰 사용량 근처에서 시작한 다음 점차 줄여 나가세요. 이 분포를 수집하는 방법은 예산 선택하기에서 설명합니다. 현재 하한인 20,000 토큰보다 낮은 예산은 거부되며, 예산이 매우 엄격하면 모델이 거부와 유사하게 동작할 수 있습니다. 작업 도중에 예산을 변경하면 캐시가 무효화되므로, 예산은 첫 번째 요청에서 한 번만 설정하세요. 예산은 권고 사항이어서 모델을 중단시키지 않고 방향만 안내합니다. 따라서 자체 워크로드에서 모델이 예산을 준수하는지 확인하세요. max_tokens는 단일 응답의 길이를 제한하며 모델에게는 보이지 않습니다. 따라서 이 값을 낮춰도 모델이 토큰을 아껴 쓰지 않습니다. 더 많은 공간이 필요했던 턴은 폐기되지만 비용은 그대로 청구됩니다. 내부 저장소 작업 벤치마크12에서 각 모델을 기본 effort로 실행했을 때, 16,384 토큰 상한으로 인해 Claude Opus 5.5 시도의 약 4분의 1과 Claude Fable 5.1 시도의 43%가 중단되었습니다. 상한에 걸린 시도 중 통과한 것은 Opus 5.5에서 66개 중 1개, Fable에서 117개 중 9개뿐이었습니다. 상한에 걸린 실행은 시도당 비용이 적었지만 해결한 작업도 그만큼 적었습니다. 그래서 해결된 작업당 비용은 상한이 64,000일 때와 거의 같았습니다(Fable 5.1에서는 $21 대 $22, Opus 5.5에서는 1% 이내). 상한이 64,000일 때는 기본 effort의 Claude Fable 5.1 턴 약 14,000개 중 2개만 중단되었고(Claude Opus 5.5 턴은 하나도 중단되지 않았습니다), Fable 5.1이 해결한 작업의 비율은 36.3%에서 58.5%로 높아졌습니다. 참고 문헌 12에 설명된 SWE-bench Pro3 하위 집합의 별도 분할에서는 차이가 없었습니다(두 상한 모두에서 100개 중 94개). 상한에 걸린 시도를 재시도해도 거의 도움이 되지 않습니다. 같은 상한에서는 대부분 다시 실패하고, 더 높은 상한으로 재시도하면 낭비된 첫 시도의 비용까지 지불하게 됩니다. 에이전트 작업에는max_tokens를 64,000으로 설정하세요. 시도 하나가 중단되는 것의 비용이 크다면 최댓값인 128,000으로 설정하세요. 상한이 128,000일 때 Fable 5.1은 해결된 작업당 비용은 같으면서 60.0%를 해결했습니다. 이처럼 큰 응답은 스트리밍으로 받고,stop_reason: max_tokens는 실패로 처리하세요. 비용 절감은 모델이 볼 수 있는 effort와 작업 예산으로 하세요.- Claude Managed Agents의 세션 예산은 엄격한 중단 장치입니다. 세션 예산은 한 세션에 적용되는 달러 상한으로, 토큰, 검색, 세션 시간을 정가 기준으로 계산합니다. 상한에 도달하면 세션은
stop_reason: budget_reached와 함께 일시 중지되며, 예산을 늘리면 재개됩니다. 세션 예산은 플랫폼에서 강제 적용됩니다. 작업 예산을 아직 사용할 수 없는 모델을 포함해 정가가 있는 모든 모델에서 작동하며, 권고 사항인 작업 예산과 함께 사용할 수 있습니다. 배포(Deployments)는 모든 실행에 같은 필드를 적용합니다.
더 짧은 답변을 요청하세요. Claude Sonnet 5에서 출력 토큰의 가격은 입력 토큰의 5배입니다. 또한 에이전트 루프에서는 모델이 작성한 모든 토큰이 이후의 모든 턴에서 입력으로 다시 들어가므로, 긴 답변의 비용을 반복해서 지불하게 됩니다. Anthropic은 같은 모델과 도구를 사용해 분류(triage) 작업을 세 가지 최종 답변 지침으로 각각 세 번씩 실행했습니다. 원래 지침은 두 줄짜리 답변을 요청했습니다:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>더 짧은 변형은 한 줄짜리 답변을 요청했습니다:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.더 긴 변형은 문제 요약, 증거, 중복 확인, 권장 레이블, 다음 단계라는 다섯 개의 제목 섹션으로 구성된 메모를 요청했습니다. 질문을 건너뛴 뒤 대기 중인 프롬프트가 전송되지 않는 이슈에 대해, 처음 두 지침의 답변은 다음과 같았습니다:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.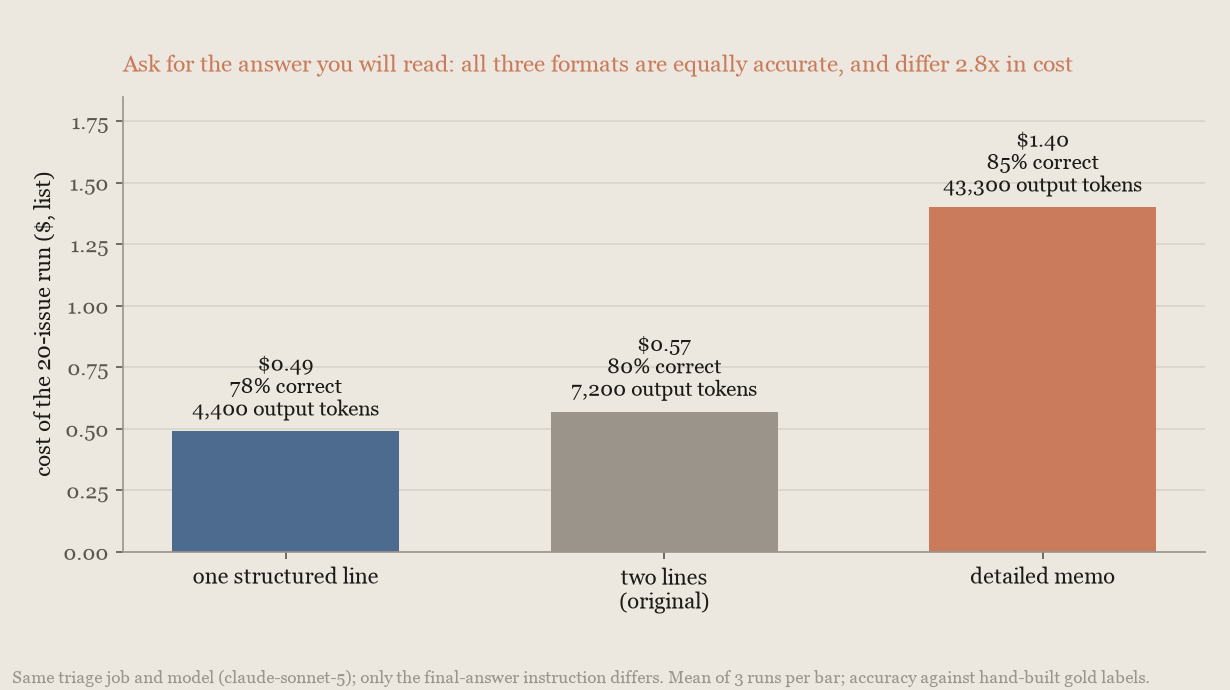
한 줄 답변은 원래의 두 줄 답변보다 출력 토큰을 39% 적게 사용했고, 실행당 비용은 14% 적었습니다. 메모는 출력 토큰을 6배 사용했고, 비용은 한 줄 답변의 2.8배였습니다. 정답 레이블과 비교한 세 형식의 점수 차이는 모두 실행 간 노이즈 범위 안에 있었습니다. 즉, 형식에 따라 정확도보다 비용이 훨씬 크게 달라집니다. 철저해 보이는 답변이 아니라 실제로 읽을 답변을 요청하세요.
max_tokens 상한을 낮추면 두 모델 모두 시도당 비용은 줄지만 해결하는 작업도 그만큼 줄어듭니다. 따라서 해결된 작업당 비용은 거의 변하지 않습니다:
거의 모든 턴은 두 상한보다 훨씬 짧게 끝납니다. 더 높은 상한은 드물게 발생하는 긴 턴을 위한 것입니다:
모델에 경과 시간 표시하기
에이전트 루프의 모델은 시계를 볼 수 없습니다. 작업 예산은 남은 토큰 수를 알려 주지만, 기본적으로 요청에는 작업에 시간이 얼마나 걸렸는지 알려 주는 정보가 없습니다. 두 가지 작은 변경으로 이 정보를 제공할 수 있습니다. 시스템 프롬프트에 시간이 중요하다는 두 문장짜리 지침을 추가하고, 두 번째 요청부터는 모델의 각 턴 전에 경과 시간을 보내세요.
Anthropic은 Claude Fable 5.1을 high effort로 사용해 두 변경 사항을 함께 측정했습니다. 측정에는 두 개의 공개 벤치마크인 DRACO21와 HLE22, 그리고 공개 CritPt 벤치마크23를 바탕으로 만든 연구 수준 물리학 문제 70개로 구성된 내부 세트를 사용했습니다. 이 페이지에서는 이 내부 세트를 물리학 세트라고 부릅니다. 세 세트는 각각 두 가지 형태로 실행되었습니다. 하나는 단일 에이전트이고, 다른 하나는 리드 에이전트가 같은 모델의 헬퍼 에이전트를 시작해 병렬로 작업하게 하는 팀입니다. Anthropic은 실행 전에 허용 범위를 DRACO에서 1.5점, HLE에서 2.5점으로 정했습니다. 점수 변화의 95% 구간이 이 범위 안에 있으면 허용 범위 내로 간주합니다. 다음 차트는 각 구성의 작업당 비용 대비 점수를 보여 줍니다. 두 번째 막대 행은 각 구성의 소요 시간을 high effort 단일 에이전트 대비 비율로 보여 주며, 재시도 대기 시간은 제외했습니다. 세 번째 행은 두 변경 사항으로 인한 점수 변화를 95% 구간과 함께 보여 줍니다:
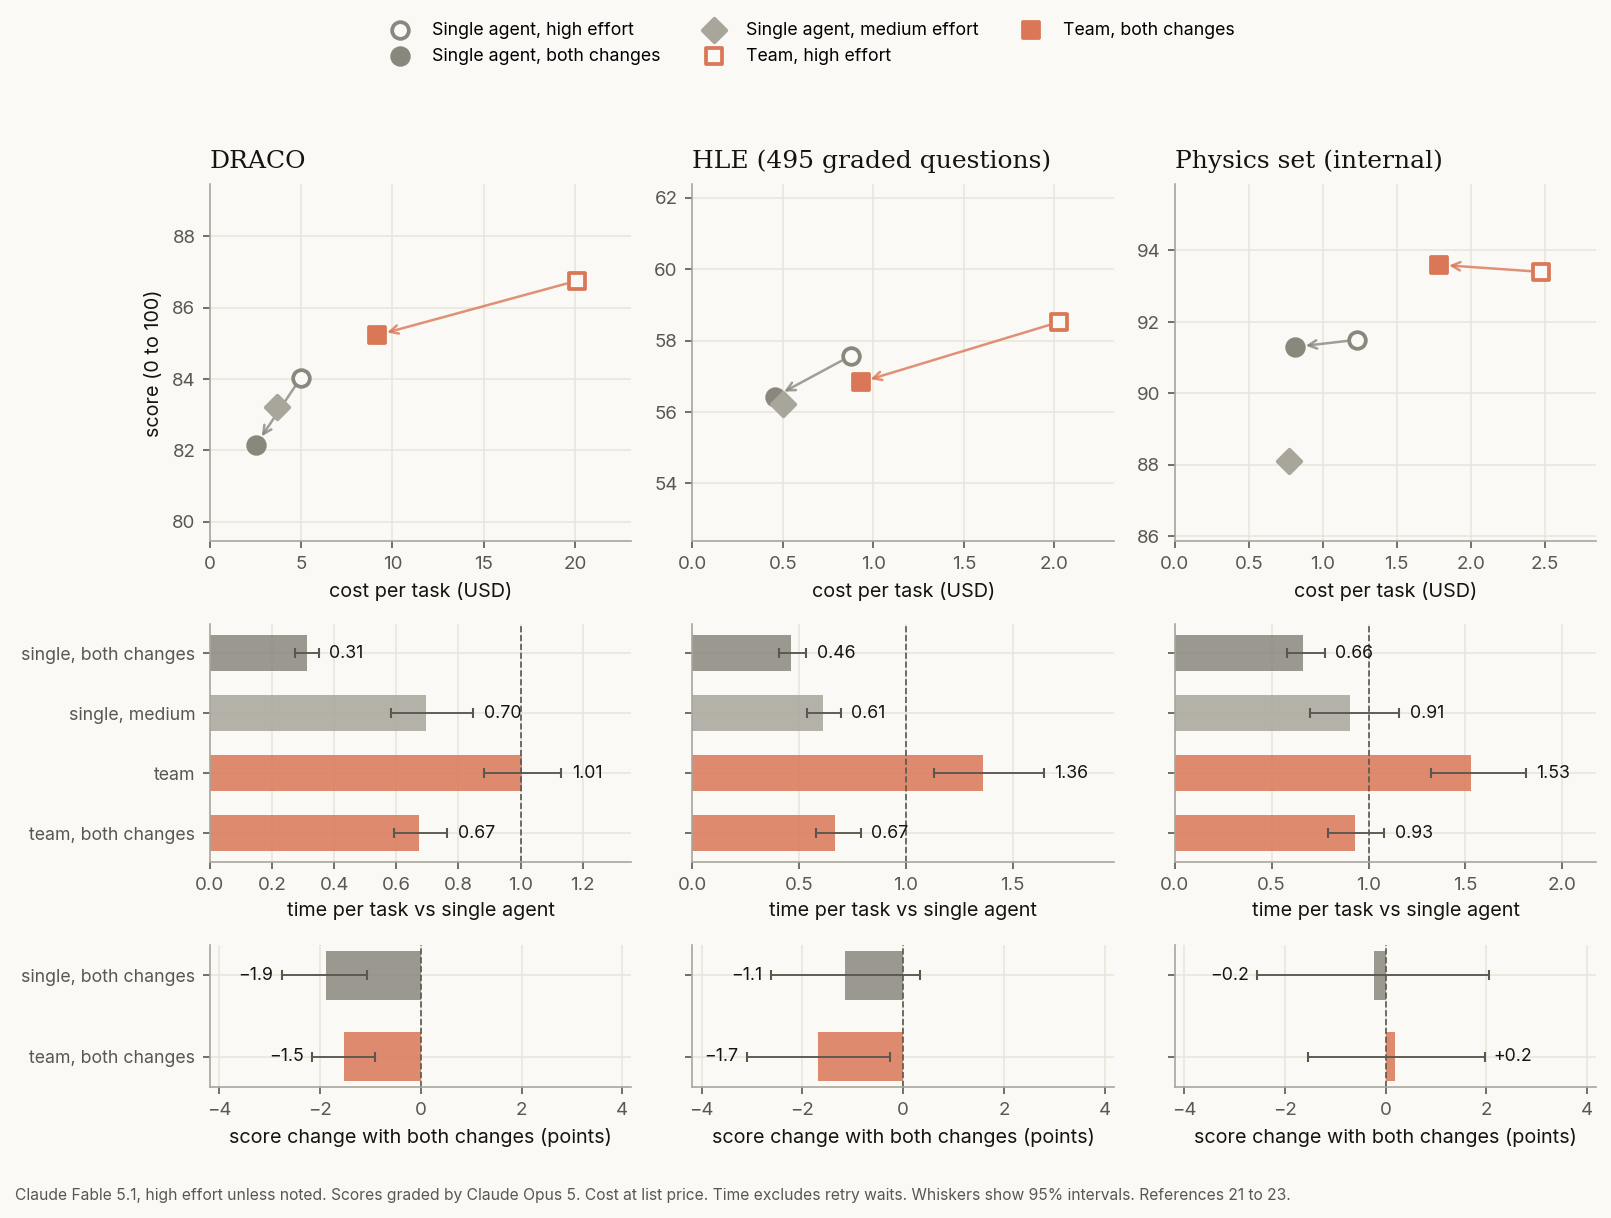
에이전트 팀의 경우. 팀은 단일 에이전트보다 더 많은 작업을 수행하므로 기본적으로 비용이 더 많이 듭니다. DRACO에서 팀의 비용은 단일 에이전트의 4.0배였고, 소요 시간은 거의 같았습니다(95% 구간 12% 감소~13% 증가). 모든 에이전트에 지침과 시계를 적용하자, 팀의 소요 시간은 33% 줄었고 작업당 비용은 54% 낮아졌습니다. 점수는 1.5점 낮았습니다(95% 구간 0.9~2.1점 낮음). 이 구간의 끝인 2.1점 하락은 1.5점 허용 범위를 넘어섭니다. HLE에서는 팀의 소요 시간이 51% 줄었고 작업당 비용은 54% 낮아졌습니다. 점수는 1.7점 낮았습니다(95% 구간 0.3~3.1점 낮음). 이 구간의 끝인 3.1점 하락은 2.5점 허용 범위를 넘어섭니다. 물리학 세트23에서는 팀의 소요 시간이 39% 줄었습니다. 작업당 비용은 28% 낮아졌는데, 이 절감 폭은 요청 사이에 프롬프트 캐싱의 캐시가 얼마나 자주 만료되었는지에 따라 달라집니다. 캐시가 만료되지 않았다면 절감 폭은 23%입니다. 점수는 0.2점 높았습니다(95% 구간 1.5점 낮음~2.0점 높음).
DRACO에서 리드는 시도당 중앙값 4개의 헬퍼를 시작했으므로, DRACO 결과는 병렬로 작업하는 팀의 효과를 보여 줍니다. HLE와 물리학 세트에서는 리드가 시작한 헬퍼 수의 중앙값이 0개였으므로, 팀 실행의 절반 이상은 리드 에이전트 혼자 작업했습니다. 따라서 이 두 세트의 팀 결과는 병렬 헬퍼의 효과보다는 주로 리드 에이전트 자체의 동작을 보여 줍니다.
단일 에이전트의 경우. 물리학 세트23에서 같은 변경 사항을 적용하자 단일 에이전트의 소요 시간과 작업당 비용이 각각 34% 줄었습니다. 점수는 0.2점 낮았습니다(95% 구간 2.5점 낮음~2.1점 높음). 물리학 세트에서 effort 수준을 낮추면 비용은 줄었지만 시간이 줄었다고 보기는 어려웠습니다. medium effort에서 단일 에이전트의 작업당 비용은 high보다 37% 적었고, 소요 시간은 9% 적었습니다(95% 구간 30% 감소~16% 증가). 점수는 3.4점 낮았으며(95% 구간 0.4~6.8점 낮음), 구간의 한쪽 끝이 0에 가깝습니다. high effort에서 두 변경 사항을 모두 적용하자, 단일 에이전트의 소요 시간은 medium effort보다 27% 적었습니다(95% 구간 5% 감소~44% 감소). 작업당 비용은 6% 많았고(95% 구간 12% 감소~27% 증가), 점수는 3.2점 높았습니다(95% 구간 0.1점 낮음~6.5점 높음).
HLE에서 같은 변경 사항을 적용하자 단일 에이전트의 소요 시간은 54%, 작업당 비용은 48% 줄었습니다. 점수는 1.1점 낮았습니다(95% 구간 2.6점 낮음~0.3점 높음). 이 구간의 끝인 2.6점 하락은 2.5점 허용 범위를 약간 넘어섭니다. medium effort에서 단일 에이전트는 high보다 작업당 비용이 43% 적고 소요 시간이 39% 적었으며, 점수는 1.3점 낮았습니다(95% 구간 2.8점 낮음~0.1점 높음). high effort에서 두 변경 사항을 모두 적용하자, 단일 에이전트의 소요 시간은 medium effort보다 25% 적었습니다(95% 구간 12% 감소~35% 감소). 작업당 비용은 9% 적었고(95% 구간 21% 감소~6% 증가), 점수는 0.2점 높았습니다(95% 구간 1.3점 낮음~1.7점 높음).
DRACO에서 같은 변경 사항을 적용하자 단일 에이전트의 소요 시간은 69%, 작업당 비용은 49% 줄었습니다. 점수는 1.9점 낮았습니다(95% 구간 1.1~2.8점 낮음). 이 구간의 끝인 2.8점 하락은 1.5점 허용 범위를 넘어섭니다. medium effort에서 단일 에이전트는 high보다 작업당 비용이 25% 적고 소요 시간이 30% 적었으며, 점수는 0.7점 낮았습니다(95% 구간 0.1~1.3점 낮음). high effort에서 두 변경 사항을 모두 적용하자, 단일 에이전트의 소요 시간은 medium effort보다 53% 적었고(95% 구간 42% 감소~63% 감소), 작업당 비용은 31% 적었습니다(95% 구간 28% 감소~35% 감소). 점수는 1.2점 낮았습니다(95% 구간 0.5~1.9점 낮음). 이 구간의 끝인 1.9점 하락은 1.5점 허용 범위를 넘어섭니다.
세 세트 모두에서 high effort에 두 변경 사항을 적용한 구성이 medium effort보다 시간을 더 많이 절약했습니다. 비용은 HLE와 물리학 세트에서 뚜렷한 차이가 없었고, DRACO에서는 더 낮았습니다. 점수는 HLE에서 거의 같았습니다. 물리학 세트에서는 3.2점 높았지만, 구간에 0이 포함되므로 차이가 있다고 단정할 수 없습니다. 따라서 단일 에이전트에서는 effort 수준을 낮추는 것보다 시계를 제공하는 것이 시간을 더 많이 절약합니다. 다만 DRACO에서는 두 변경 사항을 적용한 단일 에이전트의 점수가 medium effort보다 1.2점 낮았습니다(95% 구간 0.5~1.9점 낮음).
사용 시기.
- 에이전트의 소요 시간이 중요하고 점수가 약간 달라져도 괜찮다면 두 변경 사항을 모두 사용하세요. 측정한 모든 구성에서 팀과 단일 에이전트 모두 소요 시간과 작업당 비용이 줄었습니다.
- 도입하기 전에 자체 작업에서 점수를 확인하세요. DRACO에서는 점수가 팀에서 1.5점, 단일 에이전트에서 1.9점 낮았습니다. HLE에서는 팀에서 1.7점, 단일 에이전트에서 1.1점 낮았습니다. 물리학 세트에서는 두 형태 모두 점수 변화가 0과 뚜렷하게 다르지 않았습니다.
- 시간을 절약하려고 effort 수준을 낮추는 것을 고려하고 있다면, 먼저 시계를 제공하는 방법과 비교해 보세요.
higheffort에서 두 변경 사항을 적용한 단일 에이전트는mediumeffort보다 소요 시간이 DRACO에서 53%, HLE에서 25%, 물리학 세트에서 27% 적었습니다. 작업당 비용은 DRACO에서 31% 낮았고, HLE와 물리학 세트에서는 뚜렷한 차이가 없었습니다.
추가 방법. 모든 에이전트의 시스템 프롬프트 맨 앞에 다음 지침을 넣으세요:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.두 번째 문장은 시계 메시지가 전달된다는 사실을 모델에게 알려 줍니다. 첫 번째 요청에는 시계가 포함되지 않으며, 측정에서는 정확히 이 문구를 사용했습니다.
그런 다음, 에이전트의 첫 번째 요청 이후에는 각 요청 전에 대화 중간 시스템 메시지를 추가하세요. 이 메시지에는 Elapsed time: 412 seconds처럼 경과 시간을 정수 초 단위로 넣습니다. 경과 시간은 에이전트가 시작된 시점이 아니라 작업이 시작된 시점부터 계산하세요. 팀에서는 모든 에이전트가 같은 시계를 사용합니다. 따라서 헬퍼가 처음 받는 시계에는 헬퍼가 시작되기 전에 팀이 이미 사용한 시간이 포함됩니다. 도구 루프에서는 도구 결과 이후 배치에 나온 것처럼, 도구 결과를 담은 user 메시지 바로 뒤에 이 메시지를 넣으세요. 도구 결과 대신 에이전트에게 새 user 메시지를 보내는 경우에는 그 메시지 뒤에 시계를 넣으세요.
이전 시계 메시지는 삭제하지 말고 그대로 두세요. 각 메시지는 대화 기록의 일부가 되므로, 다음 요청에서도 캐시된 접두사가 계속 일치합니다(프롬프트 캐싱과 함께 사용하기 참조). Anthropic이 측정한 것은 모델에게 계속 표시되는 이러한 일반 시스템 메시지입니다. 턴 범위 시스템 메시지를 사용하면 모델에게 최신 시계만 표시되며, Anthropic은 이 형태를 측정하지 않았습니다.
다음 예제는 두 변경 사항을 적용해 에이전트 하나의 도구 루프를 실행합니다. 도구 결과 뒤에 시계를 추가하며, 클라이언트 도구만 처리합니다:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # 벽시계 기준 초 단위이므로 다른 프로세스의 헬퍼도 리드의 시작 시간을 공유할 수 있습니다.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # 128,000 토큰 상한은 비스트리밍 요청에 너무 크므로 스트리밍을 사용합니다.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # 시스템 메시지는 사용자 턴 뒤에 와야 하므로 시계는 도구 결과 뒤에 배치합니다.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1은 대화 중간 시스템 메시지를 지원합니다. 다른 모델의 지원 여부는 지원 모델 목록에서 확인하세요. Claude Sonnet 5처럼 이 기능을 지원하지 않는 모델에서는 user 턴의 마지막 tool_result 블록 뒤에 텍스트 블록을 추가하고 같은 내용을 넣을 수 있습니다. 다만 Anthropic은 시스템 메시지 형태만 측정했습니다.
Claude Managed Agents에서는 도구 결과나 사용자 메시지와 함께 system.message 이벤트를 보낼 수 있습니다. 이 메시지는 해당 턴과 이후의 모든 턴에 적용됩니다. 따라서 웹 검색처럼 플랫폼에 기본 제공되는 도구 뒤에 오는 턴에서는 모델이 현재 시간이 아니라 마지막으로 보낸 시계를 보게 됩니다. 또한 system.message는 세션의 기본 스레드에만 전달됩니다. 멀티에이전트 세션에서는 기본 스레드가 코디네이터의 스레드이므로, 이 방식으로 보낸 시계는 워커 에이전트에게 전달되지 않습니다. 모든 턴 전에, 그리고 팀의 모든 에이전트에게 현재 시간을 보여 주려면 Messages API에서 에이전트 루프를 직접 실행하세요.
모델 결합
다중 모델 아키텍처는 작업 복잡도의 편차가 커서 단계마다 서로 다른 모델이 가장 적합한 워크로드에 맞습니다. 트래픽에 더 작은 모델이 안정적으로 처리하는 일상적인 작업과 프런티어 수준의 능력이 필요한 더 어려운 단계가 섞여 있다면, 작업을 분할하여 프런티어 지능은 중요한 곳에 유지하면서 대부분의 토큰은 더 작은 모델의 요금으로 청구되게 할 수 있습니다. 워크로드에 그러한 혼합이 없다면(난이도가 균일하거나 하나의 종속적인 체인인 경우), 일반적으로 잘 조정된 단일 모델이 더 나은 선택입니다. 각 전략 섹션에서 두 경우를 구분하는 규칙을 제공합니다.
두 가지 전략이 대부분의 워크로드를 다루며, 어떤 모델이 메인 루프를 담당하는지에 따라 다릅니다:
| 전략 | 제어 흐름 | 프런티어 모델의 역할 | 적합한 경우 | 프런티어 비용을 좌우하는 요소 |
|---|---|---|---|---|
| Advisor(어드바이저) | 더 작은 모델이 루프를 실행하고, 필요 시 에스컬레이션 | 계획 및 수정에 대해 자문 | 곳곳에 어려운 부분이 있는 순차적 작업(예: 몇 가지 실제 결정 사이에 많은 턴이 있는 코딩 에이전트) | 실행자가 막히는 빈도 |
| Orchestrator(오케스트레이터) | 프런티어 모델이 루프를 실행하고, 대량 작업을 위임 | 계획, 분배, 종합 | 진정으로 독립적인 파일, 문서 또는 사례에 걸쳐 분산되는 작업, 특히 컨텍스트 윈도우 하나를 넘는 분량 | 조각들을 조율하기 어려운 정도 |
어드바이저 전략: 어려운 결정 에스컬레이션
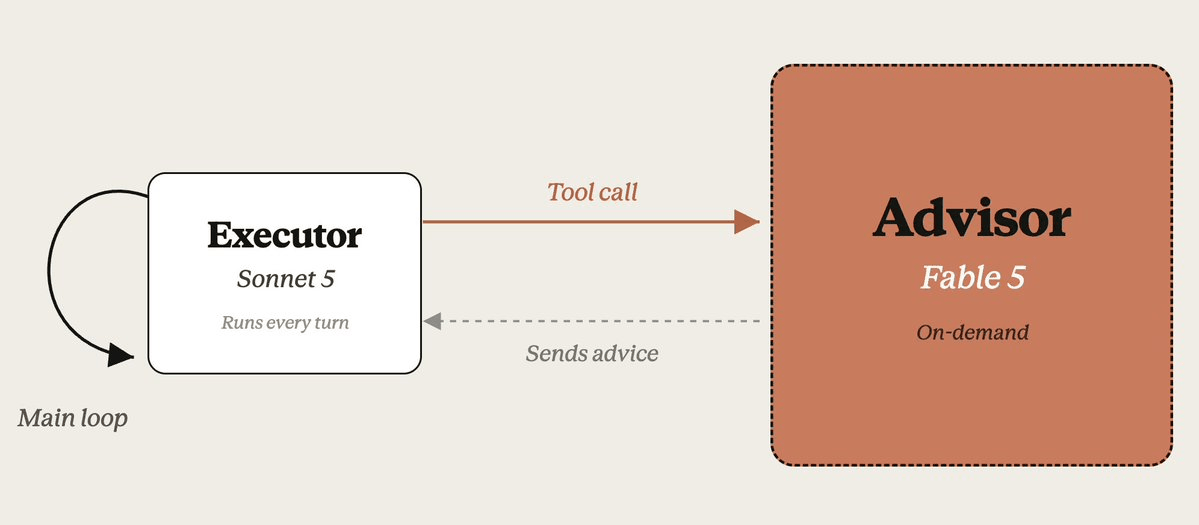
어드바이저 전략에서는 비용이 낮은 "executor"(실행자) 모델이 에이전트 루프를 실행하며 대부분의 턴을 처리합니다. 접근 방식을 선택하거나 실패에서 복구하는 것처럼 더 깊은 판단이 필요한 결정에 이르면, 실행자는 더 지능이 높은 "advisor"(어드바이저) 모델을 호출해 전략적 지침을 받은 뒤 작업을 계속합니다. 대부분의 토큰은 실행자 요금으로 청구되고, 가끔 있는 자문만 어드바이저 요금으로 청구됩니다.
이 전략을 사용하려면 요청에 어드바이저 도구를 추가하세요. 이 베타 기능은 하나의 /v1/messages 요청 안에서 전체 전략을 서버 측에서 실행합니다. 실행자가 도구 호출을 생성하면 Anthropic이 어드바이저 추론을 실행하고, 실행자는 받은 조언을 바탕으로 작업을 계속합니다. 오케스트레이션 코드를 직접 작성할 필요가 없습니다. Claude Managed Agents에서는 에이전트의 multiagent 명단에 advisor 항목을 추가해 세션에 어드바이저를 지정하세요. 그러면 세션의 기본 스레드가 같은 방식으로 어드바이저에게 자문을 구합니다. Claude Code에서도 이 기능을 사용할 수 있습니다. 자세한 내용은 어드바이저 도구로 어려운 결정 에스컬레이션하기를 참조하세요.
효과를 좌우하는 요소. 어드바이저는 실행자의 호출을 통해서만 작업 내용을 볼 수 있습니다. 따라서 어드바이저가 얼마나 도움이 되는지는 두 가지 요소에 달려 있습니다.
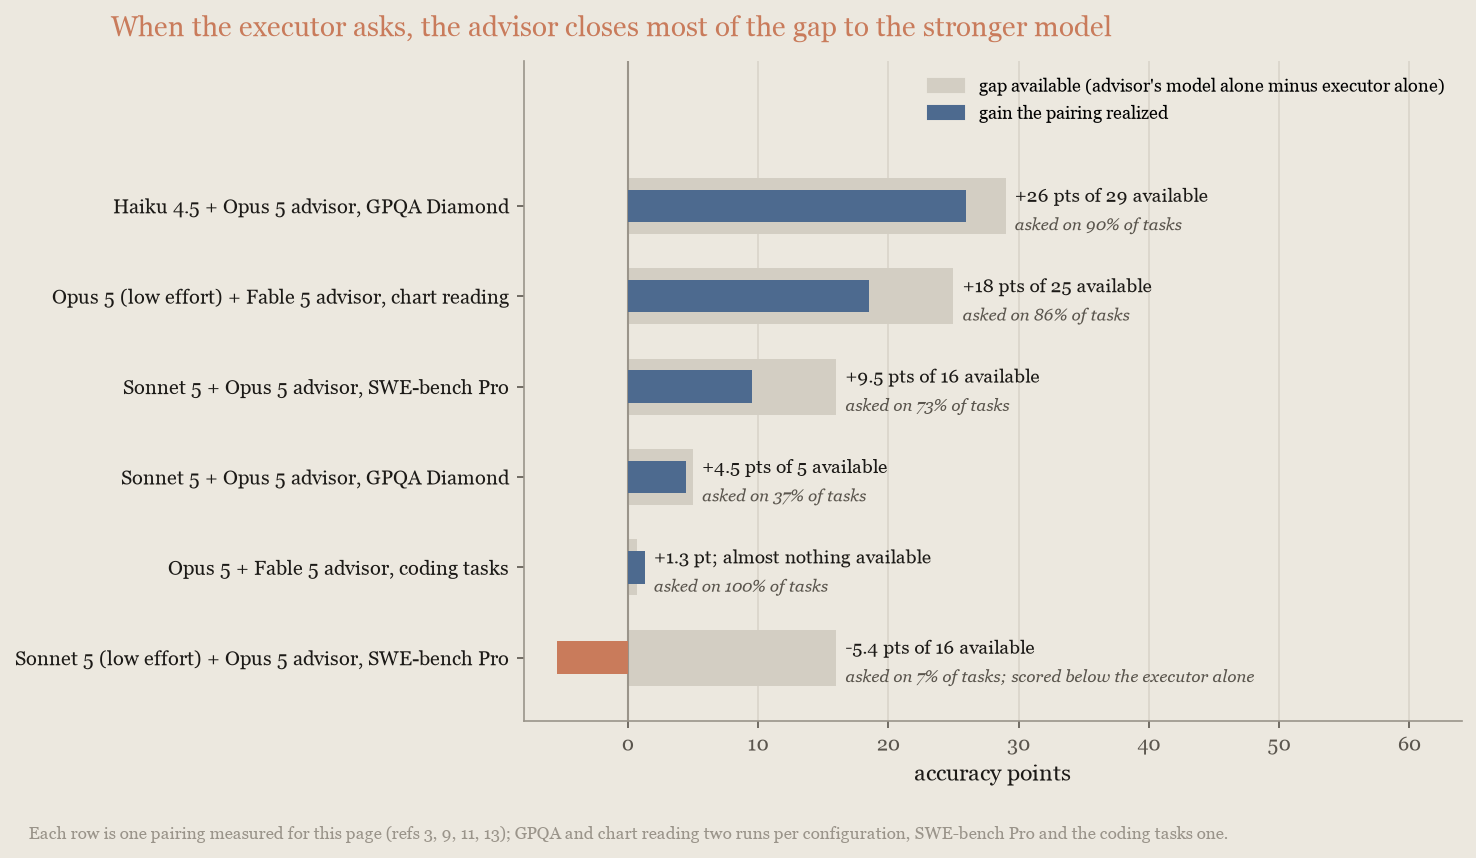
첫 번째는 두 모델 간의 역량 격차입니다. 어드바이저는 실행자에게 없는 역량만 보완할 수 있습니다. GPQA Diamond9에서 Claude Opus 5 어드바이저를 사용했을 때, Claude Haiku 4.5 실행자는 점수가 크게 올랐고, Claude Sonnet 5 실행자는 몇 점 올랐으며, 프런티어 실행자는 거의 오르지 않았습니다.
두 번째는 실행자가 실제로 자문을 요청하는지 여부, 즉 자문 비율이며, 이 요소는 쉽게 흔들립니다. effort가 낮은 실행자는 자신이 막혔다는 사실을 알아차리지 못할 수 있습니다. 기본 effort에서는 대부분의 작업에서 자문을 구하던 조합도 effort를 낮추면 거의 자문을 구하지 않게 되고, 그 결과 실행자 단독보다 점수가 낮아질 수 있습니다. 자문 비율은 작업에 따라서도 달라집니다. DeepSWE10에서는 낮은 effort의 Sonnet 5 실행자가 계속 자문을 요청해 점수가 23점 올랐지만, SWE-bench Pro3에서는 같은 실행자가 자문 요청을 멈췄습니다. 실행자가 실제로 자문을 요청하면 격차의 상당 부분을 메울 수 있습니다. 다음 차트에서 실행자가 계속 자문을 요청한 조합에서는 어드바이저가 더 강한 모델과의 격차를 절반 이상 좁혔습니다(코딩 조합은 더 강한 모델보다 점수가 높았습니다). 더 강한 모델의 비용은 자문할 때만 지불하므로, 이 덕분에 비용을 절감할 수 있습니다:
자문 비율은 프롬프트로 조절할 수 있습니다. 도구에 기본 제공되는 설명만 있으면 실행자는 특히 코딩 작업에서 어드바이저를 충분히 호출하지 않습니다. 그래서 어드바이저 도구 문서에서는 본격적인 작업 전에 한 번, 작업을 마치기 전에 한 번 호출하도록 요청하는 시스템 프롬프트를 제공합니다. 이렇게 하면 작업당 약 2~3회 호출하게 됩니다. 아래에서 측정한 코딩 조합은 Claude Opus 5를 실행자로 사용했을 때 이 주기대로 실행되어, 모든 작업에서 약 두 번씩 자문했습니다. Claude Opus 5.5를 실행자로 사용했을 때는 시도당 약 1.4회 조언을 요청했고, 시도의 4%에서는 조언을 받지 않았습니다. 해당 문서에서는 호출이 부족한 실행자가 더 자주 호출하도록 유도하는 방법과, 비용을 제한하기 위해 클라이언트 측에서 호출 횟수를 제한하는 방법도 설명합니다. 따라서 자문 비율을 계속 확인하세요. 프롬프트로 자문을 유도하고, 비율을 측정하고, 비율이 급격히 떨어지면 실행자의 effort를 원래대로 되돌리세요.
비용 측면에서 이득이 되는 경우. 어드바이저 요금으로 청구되는 몇 번의 짧은 자문이 작업 전체를 어드바이저 모델로 실행하는 것을 대신할 때 비용이 절감됩니다. 이 효과는 어드바이저 모델의 가격이 실행자보다 훨씬 높을 때 가장 큽니다. 따라서 가장 비용 효율적인 구성은 중간 등급 실행자에 프런티어 어드바이저를 붙이는 것입니다. 실행자가 최상위 등급에 가까운 조합에서도 조언 비용의 일부를 회수할 수 있습니다. 조언이 실행자의 토큰도 절약해 주기 때문입니다. 올바른 접근 방식을 안내받은 실행자는 막다른 길을 덜 탐색합니다. 아래의 Claude Opus 5 실행자 코딩 조합에서는 이렇게 절약한 금액이 조언 비용의 약 절반을 충당했습니다. 실행자는 기본 설정의 Opus 5 단독보다 시도당 $1.26를 적게 지출했고, 자문 비용은 $2.47이었습니다. Claude Opus 5.5 실행자에서는 조언으로 절약된 실행자 비용이 거의 없었습니다. 시도당 비용은 $1.36으로 high의 Opus 5.5 단독($1.38)과 비슷했고, 자문 비용은 $1.55였습니다.
일반 API 에이전트로 실행한 내부 에이전트 코딩 벤치마크11에서, Claude Fable 5.1 어드바이저를 붙인 high의 Claude Opus 5.5 실행자는 시도당 $2.92로 90.1%를 기록했습니다. 이는 실행자와 같은 설정인 high의 Opus 5.5 단독보다 1.7점 높은 점수이며, 비용은 약 2.1배입니다. 작업당 5회 시도 기준으로 이 격차는 실행 간 노이즈와 구분하기 어려운 수준입니다. 기본값인 medium의 Opus 5.5와 비교하면 약 3.5배의 비용으로 3.5점 높습니다. 이 결과는 Opus 5.5 자체의 effort 곡선과 거의 겹칩니다. 즉, 어드바이저를 붙이는 것은 effort를 높이는 것과 비슷한 효과를 냅니다. 실제로 xhigh의 Opus 5.5 단독은 시도당 $4.11로 91.1%를 기록했습니다(작업당 1회 시도). 8월 측정에서는 Claude Opus 5 실행자에 Claude Fable 5.1 어드바이저를 붙인 구성이 가장 정확했으며, 비용은 시도당 $6.21로 Opus 5.5 조합의 두 배를 약간 넘었습니다. 다음 차트는 Opus 5.5 조합을 Opus 5.5 자체의 effort 곡선 및 8월에 측정한 Claude Fable 5.1의 effort 곡선과 비교합니다:
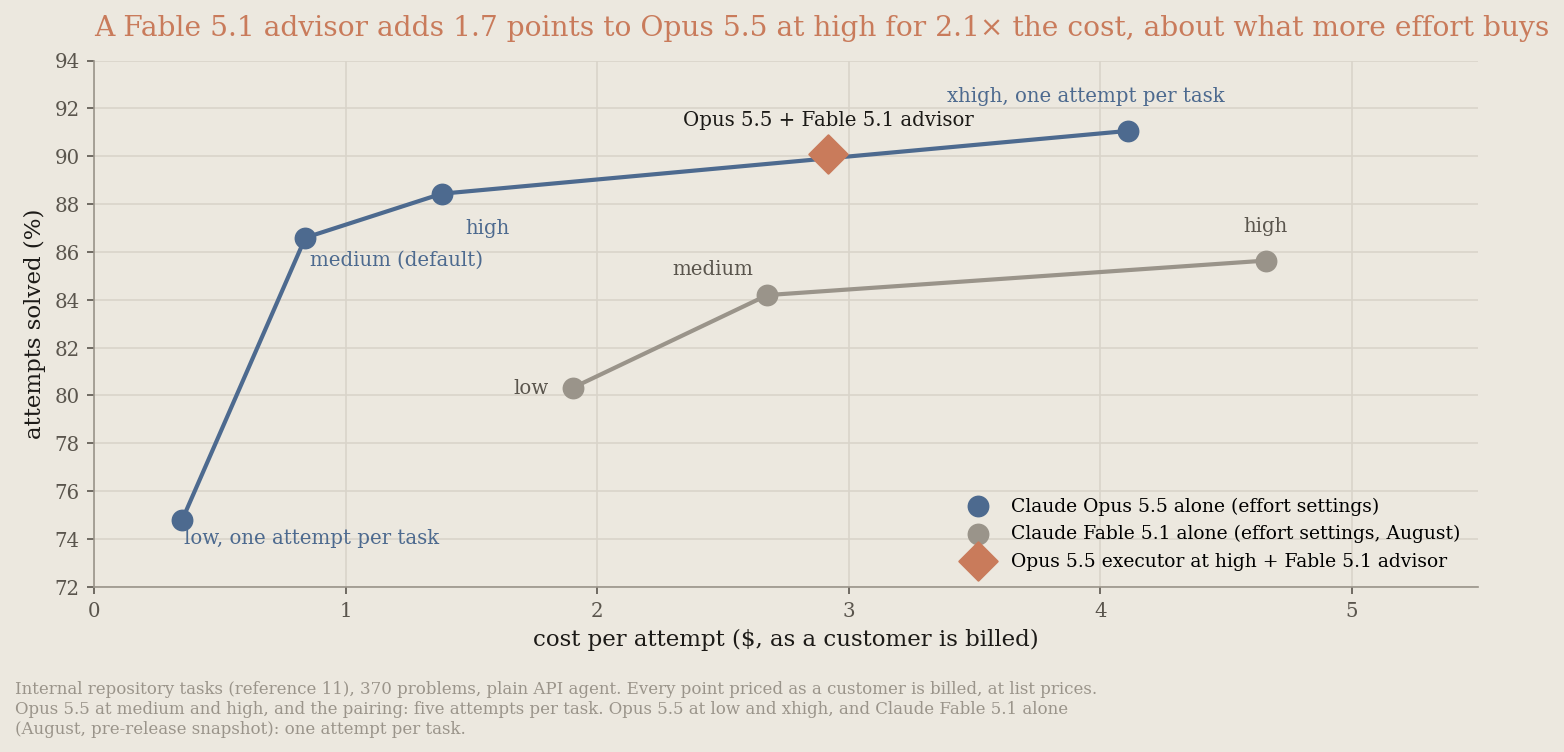
Claude Code의 어드바이저 모드로 진행한 이전 측정에서도 어드바이저 조합의 점수가 각 모델 단독보다 높았습니다. Claude Opus 5.5 결과는 자체 워크로드에서 검증해 볼 경향으로 받아들이세요. 즉, 어드바이저를 붙이면 실행자 단독 비용의 약 두 배로 점수를 몇 점 더 얻을 수 있습니다. 역량 격차가 크다고 해서 비용 대비 효과가 반드시 더 좋은 것은 아닙니다. 지연 시간 측면의 비용은 자문 자체에서 발생합니다. 이 벤치마크에서는 작업당 프런티어 모델 호출이 한두 번 추가되며, 각 호출은 작업의 임계 경로에 놓입니다.
더 강한 모델을 단독으로 사용하는 것이 나은 경우. 워크로드의 정확도가 effort에 따라 달라진다면, 조합을 구축하기 전에 어드바이저 모델을 낮은 설정으로 단독 실행한 결과와 비교하세요. 어드바이저 비용은 자문이 필요한 작업에서만 발생하지만, 대부분의 작업에서 자문이 이루어지면 더 강한 모델을 직접 실행하는 것보다 비용이 더 듭니다. Chartography13에서 Claude Fable 5.1 어드바이저를 붙인 low의 Claude Opus 5.5 실행자는 300개 작업 중 1개에서만 자문을 구했고, 점수는 61.7점이었습니다. 이는 Opus 5.5 단독보다 7점 낮아 실행 간 노이즈를 넘어서는 차이이며, 비용은 거의 같았습니다. 8월 측정에서는 Claude Opus 5 실행자가 거의 모든 작업에서 자문을 구했습니다. 이 조합은 medium의 Fable 5.1 단독과 실행 간 노이즈 범위 안에서 비슷한 점수를 냈지만(65.0 대 67.5), 작업당 비용은 약 1.8배였습니다. 먼저 자체 워크로드의 자문 비율을 측정하세요. 실행자가 대부분의 작업에서 자문을 요청한다면 사실상 워크로드 전체에 어드바이저 요금을 지불하는 셈이므로, 어드바이저 모델을 직접 실행하는 것이 같은 점수를 더 저렴하게 얻는 방법입니다.
어떤 조합을 사용하든, 먼저 어드바이저 모델을 낮은 effort로 단독 실행했을 때의 비용을 확인하세요. 이것이 조합이 넘어서야 할 기준선입니다. 새 모델이 출시될 때마다 다시 확인하세요. 모델 출시에 따라 역량 격차와 가격 비율이 모두 달라지기 때문입니다.
적합한 경우. 어드바이저 전략은 대부분의 턴이 기계적이지만 좋은 계획이 중요한 워크로드에 적합합니다. 코딩 에이전트, 컴퓨터 사용, 다단계 연구 파이프라인이 그 예입니다. 반면 모든 턴에 프런티어 역량이 필요한 경우, 계획할 것이 없는 경우(단일 턴 Q&A), 실행자의 역량이 이미 어드바이저에 가까운 경우에는 적합하지 않습니다.
오케스트레이터 전략: 대량 작업 위임
오케스트레이터 전략에서는 프런티어 모델이 루프를 담당합니다. 프런티어 모델은 작업을 분해하고, 하위 작업을 저비용 워커 모델에 배분하며, 그 결과를 병합합니다. 토큰 소모가 많은 탐색은 워커가 맡으므로 오케스트레이터 자체의 "transcript"(트랜스크립트)는 짧게 유지됩니다. 따라서 대부분의 토큰은 워커 요금으로 청구되고, 계획과 종합은 여전히 프런티어 모델이 담당합니다.
이를 구축하려면 Claude Managed Agents의 멀티에이전트 오케스트레이션을 사용하세요. 코디네이터 에이전트(오케스트레이터)와 워커 에이전트 목록을 구성하고, 각 에이전트에 고유한 모델을 지정합니다. 프런티어 코디네이터와 Claude Sonnet 5 워커를 사용하는 완전한 작동 예제는 Claude Cookbook 레시피 코디네이터 패턴: 계획에는 큰 모델, 실행에는 작은 모델을 참조하세요.
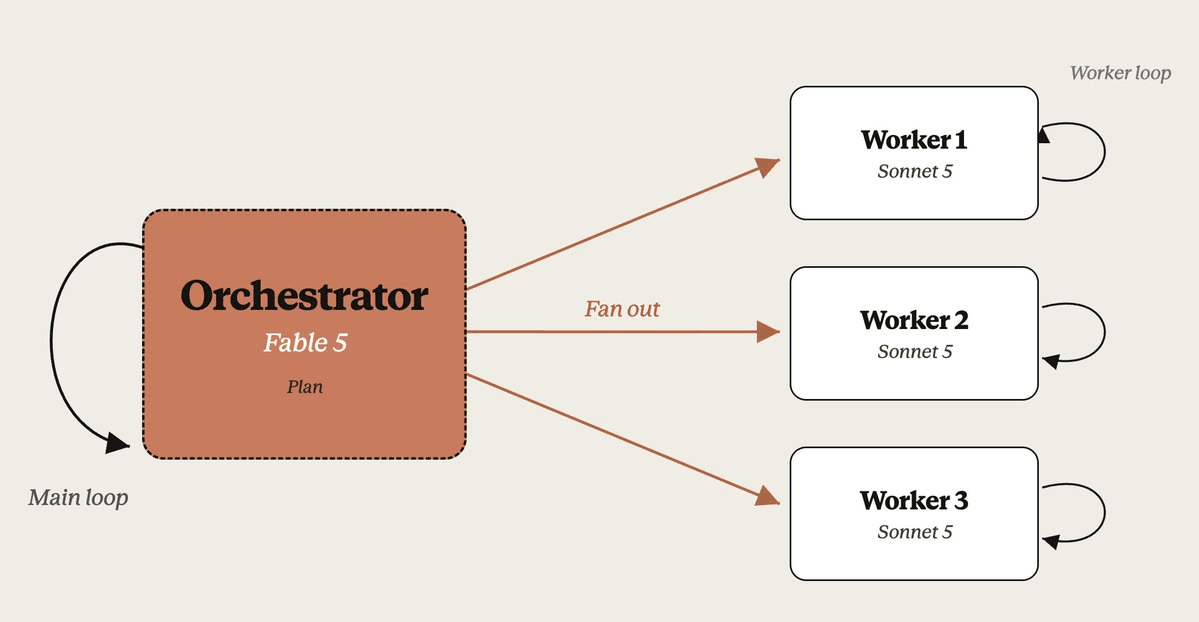
이 패턴은 워커를 병렬로 실행할 수 있을 때 "wall-clock time"(실제 소요 시간)을 절약합니다. 코퍼스 벤치마크8에서 코디네이터가 플랫폼에 문서화된 한도인 25개의 동시 워커를 실행했을 때 에피소드 하나에 약 2.3시간이 걸렸습니다. 단독 실행 시에는 15~20시간이 걸렸습니다. 반면 비용 절감 효과는 측정된 상황 중 두 가지에서만 나타났습니다. 단일 모델이 단독으로 처리할 수 있는 작업에서는 같은 모델을 더 낮은 effort로 실행하는 편이 매번 더 저렴했습니다.
워커가 병렬로 실행될 때는 시간 지침과 경과 시간 시계를 제공하면 실행 시간을 단축할 수 있습니다. DRACO21에서 지침과 시계를 갖춘 동일 모델 에이전트 팀은 작업을 33% 더 짧은 시간에 완료했고 작업당 비용은 54% 낮았으며, 점수는 1.5점 낮았습니다. 해당 팀의 모든 에이전트가 지침과 시계를 가지고 있었습니다. Anthropic은 저비용 워커를 사용할 때의 시계 효과는 측정하지 않았습니다. Claude Managed Agents에서는 시계가 코디네이터에게만 전달되므로 워커는 시계를 볼 수 없습니다. Anthropic은 코디네이터만 시계를 가진 팀도 측정하지 않았습니다. 또한 코디네이터의 시계는 사용자 자신의 도구 결과나 메시지 다음에 오는 턴에서만 최신 상태로 유지됩니다. Messages API에서 직접 실행하는 에이전트 루프에 적용하는 방법은 모델에 경과 시간 표시하기를 참조하세요.
사례 1: 일상적인 작업에서 비용 꼬리에 대비하는 보험. 단독으로 실행되는 프런티어 모델은 평소라면 해결했을 일상적인 문제에서 가끔 헤어나오지 못하고 맴돕니다. 어떤 실행이 그렇게 될지 미리 알 수 없으므로, 이런 소수의 실행이 청구 금액의 대부분을 차지하게 됩니다. 코디네이터가 일상적인 작업을 저비용 워커에게 넘기면 이 꼬리를 제한할 수 있습니다. 맴도는 현상이 발생하더라도 워커 요금으로 청구되기 때문입니다.
Anthropic은 BrowseComp4에서 의도적으로 쉬운 부분 집합을 골라 이를 측정했습니다(단독 모델이 안정적으로 해결하는 10개 문제, 위임 실행 50회, 단독 실행 70회). Claude Sonnet 5 워커 하나를 둔 Claude Fable 5 코디네이터의 비용은 Claude Fable 5 단독 대비 평균 약 절반, 90번째 백분위수에서는 약 3분의 1이었습니다($12 대 $33). 또한 단독 모델에서 가장 비쌌던 단일 실행($84)은 답도 틀렸습니다:
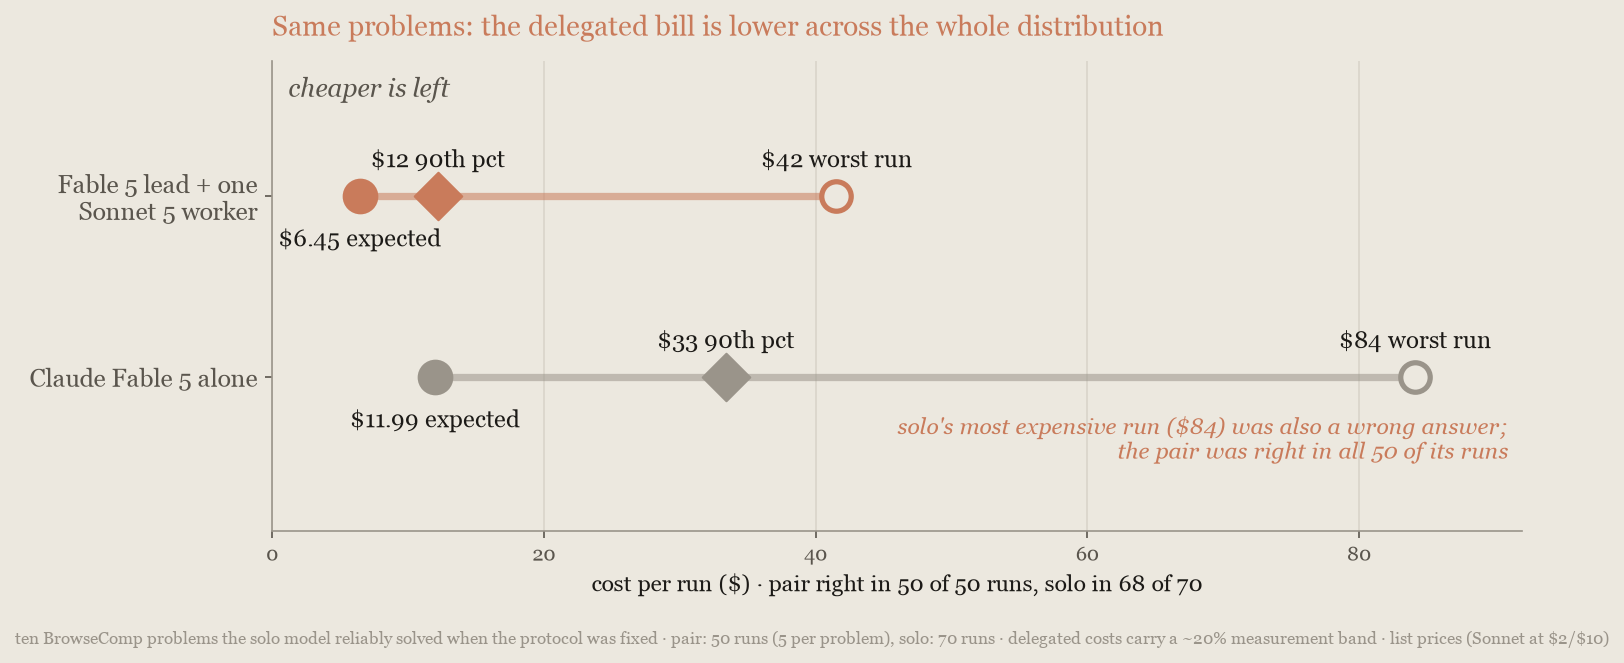
위임은 일상적이고 평소 해결 가능한 작업에서 효과를 보였습니다. 이는 워커가 어려운 문제에 적합하다는 직관과 반대되는 결과입니다. 더 어려운 전체 BrowseComp 세트에서는 경제성이 역전되었습니다. 트래픽에서 일상적인 작업에 긴 비용 꼬리가 나타난다면, 가장 먼저 측정해 볼 오케스트레이터 사례가 바로 이것입니다.
사례 2: 하나의 컨텍스트 윈도우보다 큰 작업. 단독 모델은 이렇게 큰 입력을 한 번에 하나의 컨텍스트 윈도우씩 순차적으로 처리해야 하며, 패스마다 자신의 상태를 다시 읽는 비용을 지불합니다. 반면 워커는 각자 맡은 파티션을 병렬로, 워커 요금으로 읽습니다. 하나의 컨텍스트 윈도우에 들어가는 읽기 중심 작업이라면 위임이 아니라 모델 선택의 문제입니다. 읽기 비용만 놓고 보면, 오케스트레이터는 어떤 단일 컨텍스트에도 작업이 들어가지 않을 때에만 유리합니다.
Anthropic은 이 사례를 위한 벤치마크8를 구축했습니다. 이 벤치마크는 14개의 공개 Python 패키지에 130개의 결함을 심어 만든 2,160만 토큰 규모의 코퍼스로, 어떤 컨텍스트 윈도우에도 들어가지 않습니다. 청구 금액의 대부분이 코퍼스 읽기 자체에서 발생하므로 effort를 낮춰도 도움이 되지 않습니다. Claude Fable 5.1 단독 실행은 세 가지 effort 설정 모두에서 에피소드당 $468~$552의 비용이 들었고, 달라진 것은 정확도뿐이었습니다. 25개의 Claude Sonnet 5 워커를 Claude Fable 5.1 리드가 이끄는 코디네이터 구성은 이 설정들보다 비용이 약 절반(47%~55% 절감)이었고 점수는 10~12점 낮았습니다. 소요 시간은 에피소드당 15~20시간 대비 약 2.3시간이었으며, Claude Sonnet 5 단독 기준선보다는 확실히 앞섰습니다:
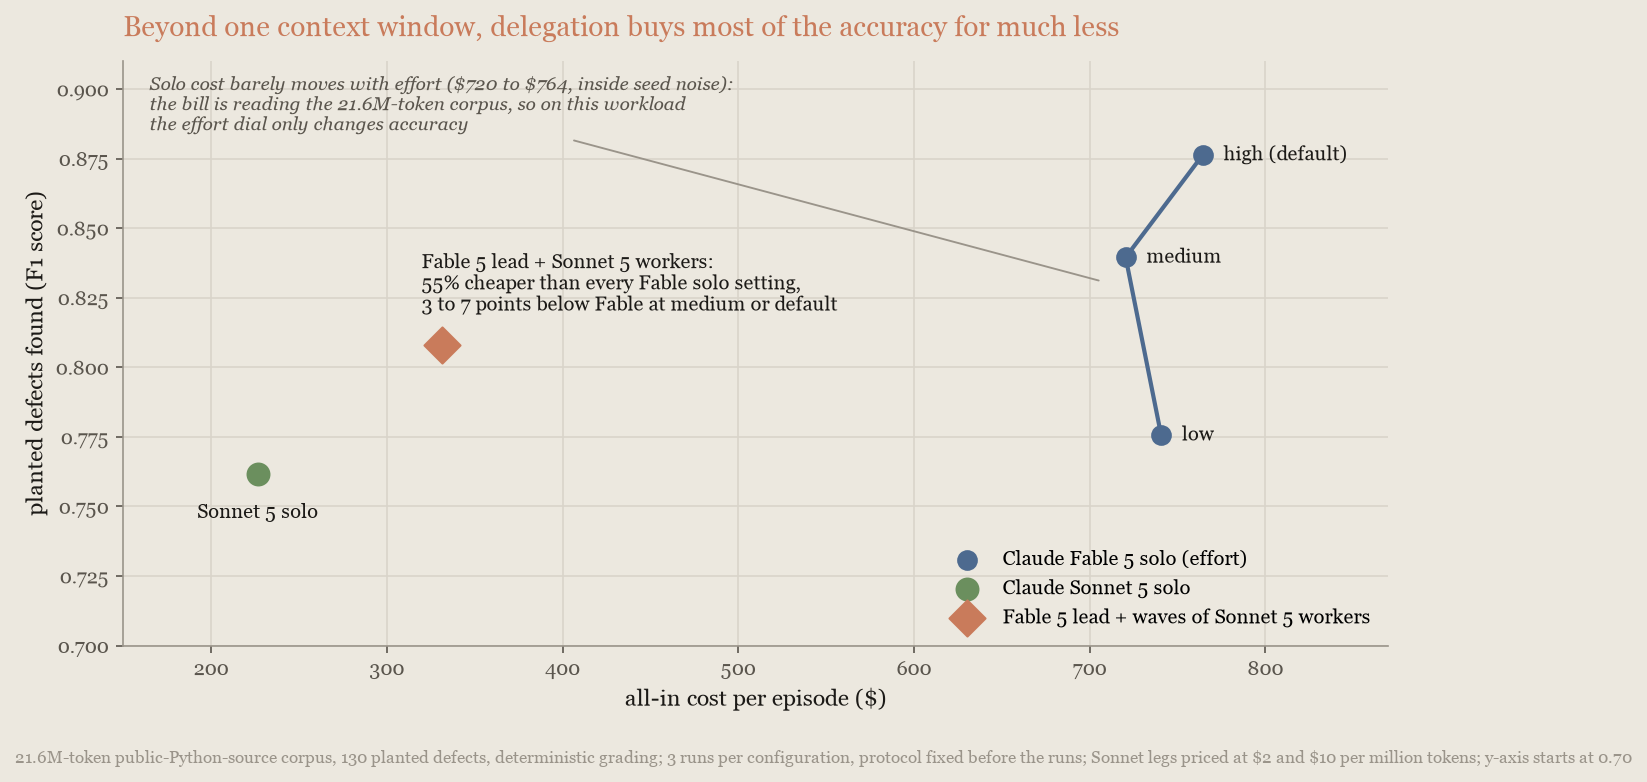
토큰 집계를 보면 읽기 작업의 규모를 알 수 있습니다. 코디네이터 구성은 에피소드당 약 5억 6천만 개의 캐시된 토큰을 읽었습니다. 이는 단독 모델이 읽은 약 3억 6,500만 개의 약 1.5배이지만, 거의 모두 Claude Sonnet 5의 캐시 읽기 요금으로 처리되어 전체 비용은 여전히 약 절반이었습니다. high effort의 Fable 5.1은 코디네이터 구성 비용의 약 2.2배로 여전히 최고 정확도를 유지합니다. 따라서 이 사례에서 위임으로 확보할 수 있는 정확도는 전부가 아니라 대부분입니다.
위임이 효과가 없는 경우. 오케스트레이터는 넘겨줄 대량 작업이 있을 때에만 이점이 있습니다. 즉, 독립적인 조각이 많아야 하며, 이상적으로는 하나의 컨텍스트 윈도우에 담기 어려울 만큼 많아야 합니다. 작업이 하나의 종속적인 체인이거나 단일 컨텍스트에 들어간다면, 단일 모델은 추가 비용 없이 처리하는 계획, 핸드오프, 병합에 오케스트레이터는 비용을 지불하게 됩니다. 측정된 이러한 사례에서는 모두 코디네이터의 모델을 더 낮은 effort로 단독 실행하는 편이 더 유리했습니다.
위임의 효과를 가르는 기준은 벤치마크가 아니라 작업 난이도입니다. 더 어려운 전체 BrowseComp4 세트에서 Claude Fable 5 단독 실행은 22%~30% 더 낮은 비용으로 코디네이터 구성과 같은 정확도에 도달했습니다. 독립적인 외부 연구에서도 같은 패턴이 보고되었습니다5. 작업이 하나의 체인이거나, 긴 비용 꼬리 없이 하나의 컨텍스트에 들어가거나, 더 낮은 effort의 단일 모델로 이미 기준을 충족한다면 오케스트레이터를 구축하지 마세요.
전략 선택
대부분의 경우는 하나의 질문으로 귀결됩니다. 작업이 독립적인 조각으로 나뉘는가, 아니면 종속적인 단계의 체인을 통해 도달하는 하나의 답인가? 전략 표는 두 답을 두 전략에 대응시킵니다.
확실하지 않다면 아직 아무것도 구축하지 마세요:
- 먼저 현재 모델에서 effort를 테스트하세요. 이 페이지에서 가장 저렴한 실험이며, 대부분의 워크로드는 여기서 끝납니다.
- 테스트 결과 격차가 보이면, 낮은 effort의 더 강한 모델 단독 비용을 산정하세요. 그것이 어드바이저 조합이 넘어서야 할 수치이며, 이 페이지에서 그 수치를 넘어선 조합은 실행자가 실제로 자문을 요청한 조합이었습니다.
이 페이지의 다중 모델 결과는 낮은 effort의 같은 모델, 그리고 단독으로 실행되는 한 단계 아래 모델과 비교하여 평가되었습니다. 그것이 자체 워크로드에서 실행해야 할 비교이며, 첫 번째 단계가 effort 테스트인 이유입니다.
어드바이저를 추가하더라도, 그것은 아키텍처 재설계가 아니라 도구 정의 하나입니다.
자체 워크로드에서 측정하기
이 페이지의 수치는 측정 당시의 정가를 반영하며, 모델과 가격이 바뀌면 달라집니다. 에스컬레이션 비율, 작업이 얼마나 깔끔하게 분할되는지, 트랜스크립트 길이도 수치에 영향을 줍니다. 측정 방법은 그대로입니다:
- 프로덕션 로그에서 실제 트래픽과 같은 비중으로 몇 가지 작업을 가져오고, 각 작업에 대해 결과 검사를 작성하세요. 예를 들어 테스트 통과, 티켓 종료, 정확한 행 수 등을 검사합니다. 점수와 함께 작업당 비용도 기록하세요. 각 응답의
usage에 있는 다섯 가지 과금 토큰 수에 각각의 요금을 적용하고(캐시되지 않은 입력, 입력 가격의 1.25배인 5분 캐시 쓰기와 2배인 1시간 캐시 쓰기, 캐시 읽기, 출력), 작업에 포함된 모든 요청에 걸쳐 합산합니다(Usage and Cost API에서 집계 값을 확인할 수 있습니다). - 기본값뿐 아니라 여러 effort 수준에 걸쳐 모델 티어별 기준선을 측정하고, 지출 대비 점수를 그래프로 그리세요. 다중 모델 구성은 단일 모델의 곡선 전체보다 나아야 합니다.
- 곡선에서 effort로 메울 수 없는 격차가 보이면, 적합한 다중 모델 전략을 추가하고 테스트 모음을 다시 실행하세요.
- 전환하기 전에 트래픽 일부에서 가장 좋은 구성을 섀도 모드로 실행하고, 전환 후에도 테스트 모음을 계속 실행하세요.
다음 예제는 Claude Opus 5.5의 정가를 기준으로 요청 하나에 대한 1단계 비용을 계산합니다:
# 가격 페이지의 백만 토큰당 가격입니다. 다른 모델을 사용하려면 이 세 값을 변경하세요.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# Claude Opus 5.5에서는 입력 가격의 0.05배이며, 배수는 모델마다 다릅니다
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1시간 캐시 쓰기는 입력 가격의 2배, 5분 캐시 쓰기는 1.25배로 청구되며, 읽기는 캐시 읽기 가격으로 청구됩니다.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
에이전트 루프에서는 입력 토큰 대부분이 캐시 읽기여야 합니다. cache_read_input_tokens가 input_tokens와 cache_creation_input_tokens의 합에 비해 작다면, 캐싱이 작동하는지, 그리고 요청 간에 접두사가 동일하게 유지되는지 확인하세요. 어드바이저 도구 또는 압축을 활성화하면 일부 토큰은 최상위 합계에 포함되지 않고 usage.iterations에만 보고됩니다. 이 경우 usage.iterations를 기준으로 합산하고, advisor_message 항목에는 어드바이저 모델의 요금을 적용하세요.
다음 표는 비용 절감 레버를 시도할 순서대로 나열합니다:
| 레버 | 이번 실행에서의 절감 | 품질 비용 | 지연 시간 | 위치 |
|---|---|---|---|---|
| 프롬프트 캐싱 | 에이전트 루프에서 비용이 2.7~5.3배 감소; 분류 실행에서 83% | 없음 | 더 빠름 | 반복되는 컨텍스트 캐싱 |
| 1시간 캐시 지속 시간 | 20턴 중 약 1턴이 5분에서 1시간 사이의 일시 중지 후에 이어지고 1시간을 넘는 간격이 거의 없으면 5분 기본값보다 저렴함. 예외: Claude Fable 5.1에서는 일시 중지가 몇 분 단위일 때 5분 캐시를 웜 상태로 유지하는 편이 더 저렴하고, 일시 중지가 1시간에 가까워지면 1시간 지속 시간이 유리함. Claude Opus 5.5에서는 20턴 중 한두 턴만 최대 약 30분의 일시 중지 후에 이어질 때 5분 캐시를 웜 상태로 유지하는 편이 더 저렴함. 일시 중지가 없으면 기본값이 Claude Sonnet 5에서 15%, Claude Opus 5.5에서 약 15%~18% 더 저렴했음 | 없음 | 일시 중지 후에도 캐시가 유지됨 | 캐시 지속 시간 선택 |
| 입력 줄이기 | 분류 실행에서 추가로 5%p | 없음 | 중립 | 입력 및 컨텍스트 토큰 줄이기 |
| 작업 경계에서 오래된 도구 결과 정리 | 긴 분류 실행에서 39%(압축은 32%); 짧은 루프에서는 효과 없음 | 측정된 바 없음 | 중립 | 입력 및 컨텍스트 토큰 줄이기 |
| 도구 검색 | 500개의 도구 정의를 첨부한 경우 45%; GitHub MCP 서버 사용 시 20% | 없음 | 중립 | 입력 및 컨텍스트 토큰 줄이기 |
| 코드 실행을 통한 데이터 파일 처리 | 25개 질문으로 구성된 데이터 작업에서 92% | 향상(25개 중 6개에서 25개 중 25개로) | 더 빠름 | 입력 및 컨텍스트 토큰 줄이기 |
| Batch API | 50% | 없음 | 24시간 이내에 결과 제공 | 기다릴 수 있는 작업은 배치로 처리하기 |
| 현재 모델 기준 프롬프트 감사 | 측정된 두 마이그레이션 모두에서 14% | 없음; 한 경우에서는 향상 | 더 빠름(도구 라운드 감소) | 현재 모델에 맞춰 프롬프트 감사하기 |
| 모델 업그레이드 | Opus 4.8에서 Opus 5로: 해결된 작업당 비용 21% 증가, 점수 12점 향상(low의 Opus 5가 약 30%의 비용으로 Opus 4.8보다 우수); Sonnet 4.6에서 Sonnet 5로: 해결된 작업당 비용 15% 절감, 점수 5점 향상; Fable 5에서 Fable 5.1로: 거의 같은 점수에서 해결된 작업당 비용 43% 절감 | 향상 | 중립 | 모델 업그레이드 |
| effort 낮추기 | 지식 작업: medium 13%~31%, low 3분의 1에서 절반; 긴 코딩: medium 약 30%, low 약 3분의 2(모두 high 대비) | 지식 작업에서 1~3점, 긴 코딩에서 2~8점 하락 | 더 빠름 | Effort 조정 |
| 실패한 작업 재실행 | 모든 작업을 high로 실행하는 경우 대비 약 40%, 통과율은 같거나 약간 더 높음 | 없음 | 실패한 작업은 두 번 실행 | 실패한 작업을 더 높은 effort로 재실행 |
| 작업 예산 | 44%~58% | 3~6점 하락 | 더 빠름 | 예산 및 출력 상한 설정 |
| 더 짧은 답변 요청 | 분류 실행에서 출력 토큰 39%, 비용 14% | 없음 | 더 빠름 | 예산 및 출력 상한 설정 |
max_tokens 늘리기 | 해결된 작업당 절감은 없지만 해결되는 작업이 늘어남 | 내부 세트에서 최대 22점 향상; 공개 세트 쌍에서는 변화 없음 | 중립 | 예산 및 출력 상한 설정 |
| 어드바이저 | 역량 격차와 자문 비율에 따라 다름; 코딩 조합은 약 2.1배의 비용으로 high의 Claude Opus 5.5 단독보다 1.7점 높았으며, 이는 effort를 높여 얻는 향상과 비슷한 수준; Claude Opus 5.5를 사용한 차트 읽기 조합은 어드바이저에게 거의 자문을 구하지 않았고 Opus 5.5 단독보다 7점 낮았음 | 코딩에서는 향상, 차트 읽기에서는 하락 | 작업당 약 1~2회의 추가 호출 | 어드바이저 전략 |
| 오케스트레이터 | 하나의 컨텍스트 윈도우를 넘는 작업과 일상 작업의 비용 꼬리 모두에서 프런티어 모델 대비 약 절반(후자는 Claude Fable 5에서 측정) | 프런티어 모델보다 10~12점 낮음 | 대용량 입력에서 훨씬 빠름 | 오케스트레이터 전략 |
참조된 벤치마크
참조 항목에 달리 명시된 경우를 제외하고, 측정값은 이러한 벤치마크를 Anthropic 내부에서 실행한 결과입니다. 별도 언급이 없는 한 비용은 각 벤치마크 실행 당시 적용된 정가 기준 USD이며, Claude Sonnet 5 수치는 입력 및 출력 토큰 100만 개당 각각 $2 및 $10를 적용합니다. "notional USD"(명목 USD)로 표시된 차트는 실제 청구 금액이 아니라 각 요청의 토큰 수에 해당 요율을 적용해 산정한 금액입니다.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. 여러 행으로 구성된 표의 완전성과 정확성으로 채점하는 광범위한 웹 리서치 작업입니다. 200개 문제를 구성당 3회 실행했으며, 2026년 8월 1일~2일에 실행했습니다. 비용 집중도 차트는 별도로 실행한 20개 문제 세트(문제당 3회 실행, 2026년 8월 3일~4일 실행)의 결과이며, 요청별 청구 기록을 기반으로 비용을 산정했습니다.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. 작업 "rubric"(루브릭)에 따라 채점하는 지식 업무 결과물입니다. 공개된 골드 세트의 210개 작업을 작업당 1회 시도로 실행했으며, 2026년 8월 2일에 실행했습니다. Claude 모델이 채점하므로 절대 점수는 공개된 결과와 다를 수 있습니다.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Anthropic의 평가 하네스와 호환되도록 선택한 482개 문제 하위 집합이므로, 점수를 공개 리더보드와 비교할 수 없습니다. Claude Opus 5.5 시스템 카드의 SWE-bench Pro 결과와도 비교할 수 없습니다. 해당 결과는 다른 문제 세트에서
maxeffort로 실행한 결과이기 때문입니다. Claude Opus 5.5 수치는low,medium(기본값),high에서는 각각 2회 실행의 평균이고xhigh에서는 1회 실행 결과입니다. 모두 2026년 9월 19일~20일에 실행했으며, 8월의 Claude Opus 5 실행과 동일하게 턴당 16,384 토큰 상한을 적용했습니다. 이 상한 때문에xhigh시도 2건이 중단되었고, 다른 설정에서는 중단된 시도가 없었습니다. Opus 5.5 실행에는 채점 컨테이너가 내부 패키지 미러에만 접근할 수 있는 버전의 벤치마크를 사용했습니다. 이 버전에서는 테스트에 실제 웹사이트가 필요한 문제 1개가 빠지고, 다른 3개 문제에서는 참조 솔루션이 이 환경에서 실패합니다. 따라서 Opus 5.5 비교와, 그 옆에 제시된 Claude Fable 5.1 수치는 모두 나머지 478개 문제를 기준으로 합니다. 모델 업그레이드 및 "advisor"(어드바이저) 조합 차트의 Claude Opus 5 SWE-bench Pro 수치는 기본 effort에서는 2회 실행의 평균이고low에서는 1회 실행 결과이며, 모두 2026년 8월 4일에 실행했습니다. 에스컬레이션 수치는 Opus 5.5 실행 결과를 작업별로 조합해 산출했습니다. 먼저low로 실행하고 실패한 작업을high로 다시 실행하면 실행 조합에 따라 약 $0.17에 96.4%~97.5%를 해결했습니다. 먼저medium으로 실행하면 약 $0.24에 96.0%~97.1%,high로 실행한 뒤 실패한 작업을high로 재실행하면 $0.31에 96.9%, 모든 작업을high로 실행하면 $0.29에 94.8%~95.8%였습니다. 이 하위 집합의 비용은 고객 조직에 적용되는 계량 방식으로 산정했습니다. 즉, 실행 자체의 사용량 기록을 바탕으로 각 요청의 이전 프롬프트는 "cache read"(캐시 읽기)로, 새 토큰은 5분 "cache write"(캐시 쓰기)로 계산했으며, 고객 원장과 대조해 확인했습니다. 평가 조직 자체의 계량 방식은 2026년 9월 10일까지 Claude Opus 5, Claude Fable 5, Claude Opus 4.7, Claude Opus 4.8의 캐시 읽기를 8,192 토큰 블록 단위로 청구했기 때문에, 해당 모델 실행에서는 1.4~1.8배 높은 수치가 나왔습니다. Claude Fable 5.1, Claude Sonnet 5, Claude Sonnet 4.6에서는 두 방식의 차이가 최대 약 9%이며, Claude Opus 5.5 수치는 각 effort 설정에서 3% 이내로 일치합니다. 어드바이저 차트의 Claude Sonnet 5 "executor"(실행자) 조합은 이 하위 집합에 대한 동일한 측정 시리즈에서 나온 결과입니다. Sonnet과 Opus 5 조합은 2회 실행했고(2026년 8월 7일과 8월 8일, 1회 실행과 그 정확한 재현), 낮은 effort 조합은 1회(2026년 8월 8일), Claude Sonnet 5 단독은 2회 실행했습니다(77.4%, 두 Pro 행의 기준선). 모델 업그레이드의 Claude Fable 5 지점은 기본 effort에서 3회 실행한 결과의 평균으로, 2026년 8월 26일에 실행했으며 같은 방식으로 비용을 산정했습니다. Claude Fable 5.1 작업 예산 수치는 같은 하위 집합에서 기본 effort로 예산별 1회(35,000 토큰에서는 2회) 실행한 결과로, 2026년 8월 26일에 실행했습니다. 기준선은 같은 날 예산 없이 실행한 결과(92.1%, 작업당 $1.10)입니다. 앞서 2026년 8월 21일에loweffort로 실행한 세트는 예산 없이 작업당 $0.48에 88.6%를 기록했습니다. 모델 비교에서는 이 단일 실행을 같은 하위 집합에서 실행한 Claude Sonnet 5의 2회 실행 통합 결과와 비교합니다. Fable 5.1의 기본 effort에서는 결과가 반대로 나타나, 해결된 작업당 비용이 Sonnet 5보다 41% 더 높습니다. 업그레이드 단계는 각 모델을 출시 기본값으로 1회씩 실행한 결과이며(Opus 5와 Sonnet 5는 각각 2회, Fable 5 지점은 위에서 설명한 방식), Opus와 Sonnet 실행은 같은 주에 하나의 하네스와 조직에서 수행했습니다. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. effort 수치는 500개 문제 세트를 설정당 1~3회 실행한 결과로, 2026년 8월 3일에 실행했습니다. 기본값 지점은 2026년 7월 26일~27일에 실행한 2회 결과를 통합한 것입니다. 비용 보험 차트는 26개 문제 세트 중 안정적으로 해결된 10개 문제를 사용하며, 위임 실행 50회(2026년 8월 1일~2일)와 단독 실행 70회(2026년 8월 2일~3일 50회, 2026년 7월 12일~13일 및 8월 1일에 보관된 20회)로 구성됩니다. 기댓값 기준 실행당 비용은 $6.45 대 $11.99입니다. 위임 수치에는 약 20%의 측정 오차 범위가 있습니다.
- 에이전트 아키텍처 확장: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. 독립적인 외부 연구로, 위임이 효과가 없는 경우에 대한 결과의 방향성을 근거로만 인용하며 수치는 인용하지 않습니다.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. 220개 질문이 15개 도메인에 걸쳐 있으며, 각 질문은 여러 행의 정보 수집과 "multi-hop retrieval"(다단계 검색)을 함께 요구합니다. 벤치마크의 표준 행 세트에서 구성당 3회 실행해 측정했으며, 2026년 8월 2일에 실행했습니다(단일 워커 팀 지점은 2026년 7월 26일~27일에 실행).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. 22개 도메인에 걸친 132개 리서치 작업을 전문가가 도출한 이진 루브릭으로 채점합니다. 모든 주제에 걸쳐 층화 추출한 50개 작업 하위 집합에서 측정했으며, 작업당 1회 시도, 설정당 3회 실행으로 플랫폼 자체의 웹 검색 및 가져오기 도구를 사용해 Claude Managed Agents에서 실행했습니다(2026년 8월 26일~27일). 채점은 어떤 구성에서도 거부되지 않은 33개 작업을 대상으로 했으며, 프로덕션 안전 분류기에 의해 중단된 시도는 제외했습니다. 비용은 고객에게 청구되는 금액으로, 플랫폼 요청 비용과 웹 검색 수수료를 합한 것입니다. 점수는 33개 작업 기준에서 각 모델별로 중단된 작업을 제외하고 계산한 평균입니다. 모든 실험군에서 중단 없이 완료된 21개 작업에서는 Claude Fable 5.1이 모든 effort 수준에서 Claude Fable 5보다 2~3점 앞서며, 두 모델 모두 effort에 따른 점수 변화가 없습니다. 캐싱 차트는 같은 요청의 모든 입력 토큰에 캐시되지 않은 요율을 적용해 비용을 다시 산정한 것입니다. 채점은 벤치마크의 루브릭 프로토콜에 따라 Claude Opus 4.6이 수행합니다. 원본 벤치마크는 다른 평가 모델을 사용하며, Anthropic 모델이 평가하면 Anthropic 모델의 스타일을 선호할 수 있습니다. 기본 effort의 Claude Opus 5는 2026년 8월 28일에 같은 환경과 하위 집합에서 3회 실행했습니다. 결과는 원래의 50개 작업 기준 68.8%, 33개 작업 기준 70.8%, 21개 작업 세트 기준 71.1%이며, 비용은 작업당 $6.71(캐싱 없이 $23.72)입니다. 이 실행은 다른 모델들보다 최신 세이프가드 배포 환경에서 진행되었으며, 안전 분류기에 의해 중단된 시도는 없었습니다.
- 코퍼스 결함 탐색: 하나의 컨텍스트 윈도우보다 큰 작업을 위한 Anthropic 내부 벤치마크입니다. 14개 공개 Python 패키지 소스로 구성된 2,160만 토큰 코퍼스에 130개의 결함을 심어 두고 결정론적으로 채점합니다. 프로토콜은 실행 전에 확정하고 내부 검토를 거쳤으며, 구성당 3회 실행했습니다. 모든 구성은 Claude Managed Agents에서 실행했습니다. 차트의 팀 구성은 Claude Fable 5.1 코디네이터가 플랫폼에 문서화된 한도인 25개의 동시 Claude Sonnet 5 워커를 사용해 플랫폼 안에서 전체 탐색을 수행한 실행으로, 2026년 8월 30일에 실행했습니다. 세 에피소드의 F1은 추가 항목 감사 후 0.764, 0.825, 0.791(감사 전 0.751, 0.821, 0.781)이었고, 비용은 각각 $225, $234, $283였습니다. Claude Sonnet 5 단독 구성은 2026년 8월 3일~4일에 실행했습니다. Claude Fable 5.1 단독 구성은 2026년 8월 24일~25일에 플랫폼의 출시 시점 서빙 설정으로, effort 설정당 3개 시드를 사용해 같은 코퍼스 빌드에서 실행했습니다. 샌드박스 이미지에는 코퍼스 일부가 설치된 사본으로 포함되어 있었고, Claude Fable 5.1의 최종 취합 단계는 9개 에피소드 중 7개에서 이 사본과 대조했습니다. 이렇게 추가된 결과를 빼고 다시 채점하면 영향을 받은 시드의 점수가 최대 3점 달라졌습니다. 절대 F1 값은 이 코퍼스 빌드에만 해당하므로 다른 벤치마크와 비교할 수 없으며, 구성 간 비교는 동일한 조건에서 이루어졌습니다.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. 198개 질문으로 구성된 Diamond 하위 집합을 구성당 2회 실행했으며, 2026년 8월 7일(Claude Opus 5.5: 2026년 9월 19일)에 실행했습니다. 모델이 참조 답변을 기준으로 채점했고, 어드바이저 토큰은 요청별로 계량했습니다. 플랫폼 안전 검사가 Claude Sonnet 5 실행자에서 생물학 질문 2개를 거부했으며, 그중 1개는 Claude Opus 5에서도 거부되었습니다. 이 질문들을 제외해도 어떤 비교 결과도 1점 넘게 달라지지 않습니다. Claude Opus 5.5의 92%는
fallbacks: "default"를 설정해 서버 측 폴백을 사용한 2회 실행의 결과이며, 폴백 후에도 거부로 끝난 시도는 오답으로 처리했습니다. 각 실행에서 안전 검사가 생물학 질문 6개를 플래그했고, 그중 5개는 폴백을 통해 Claude Opus 5가 답변했으며, 나머지 1개는 여전히 거부로 끝났습니다. Opus 5.5의 질문당 비용에는 이 폴백 답변 비용이 포함됩니다. 거부를 오답으로 처리하지 않으면 이 실행들의 점수는 93%입니다. 채점기가 거부된 시도에도 답변 선택지를 할당하며, 대개 정답을 할당하기 때문입니다. 거부를 오답으로 처리하면 Claude Opus 5의 실행은 91%(실행당 거부 1건)이며, 폴백을 끈 Claude Opus 5.5의 2회 실행도 91%입니다. 폴백을 끈 실행에서 Opus 5.5는 실행당 생물학 질문 5~6개를 거부했습니다. - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. 5개 언어에 걸친 113개의 자체 제작 작업과 프로그램 기반 검증기로 구성된 세트입니다. 조합은 각각 2회 실행했으며, 2026년 8월 7일에 실행했고 어드바이저 토큰은 요청별로 계량했습니다. 어드바이저 도구 대신 클라이언트 측 어드바이저 루프를 사용했으며, 비용 집계 방식은 동일합니다. 단일 모델 effort 비교는 토큰 수로 비용을 산정한 단일 실행 결과로, 캐시를 반영한 근사치입니다. 작업당 비용은 실행 총비용을 113으로 나눈 값입니다.
- 내부 에이전트 코딩 벤치마크: 저장소 자체 테스트로 채점하는 370개 저장소 작업으로 구성된 Anthropic 내부 벤치마크입니다. API 수치는 128,000 토큰 출력 상한으로 구성당 1회 실행해 측정했습니다. Opus 5 단독은 기본 effort에서 2026년 8월 9일~10일,
low와medium에서 2026년 8월 10일에 실행했습니다. Claude Fable 5.1 단독은 명시적으로 설정한 5개 effort 값으로 2026년 8월 20일에 실행했으며(차트에는 그중 3개만 표시), 조합은 2026년 8월 24일~25일에 실행했습니다. Claude Opus 5.5 단독은 2026년 9월 19일~20일에 370개 작업 전체에서 실행했습니다. 기본 effort(medium)와high에서는 작업당 5회,low와xhigh에서는 1회 시도했습니다(설정 검사 실패로 각각 370개 중 369개 작업만 채점). 출시된 Claude Fable 5.1을 어드바이저로 사용한high의 Claude Opus 5.5 실행자(8월 실행에서는 출시 전 스냅샷 사용)는 같은 날짜에 작업당 5회 시도했습니다. 작업 1개가 설정 검사에 실패해 1,845회 시도가 채점되었습니다. 부하로 인해 어드바이저 요청이 거절된 279회 시도는 다시 실행했고, 어드바이저 상담이 시간 초과된 시도는 8월과 마찬가지로 결과에 포함했습니다. 8월 실행에서는 조합과 Claude Opus 5 대조군은 작업당 5회, 나머지 지점은 1회 시도했습니다. 8월 조합은 시도당 평균 약 2회 어드바이저와 상담했으며, Claude Opus 5.5 조합은 평균 1.39회 상담을 요청해 1.35회 응답을 받았습니다. 비용은 시도당 기준입니다. 비용은 고객 조직에 적용되는 계량 방식으로 산정했습니다. 즉, 실행 자체의 사용량 기록을 바탕으로 각 에이전트 루프 요청의 이전 프롬프트는 캐시 읽기로, 새 토큰은 5분 캐시 쓰기로 계산했습니다. 캐시를 사용하지 않는 어드바이저 호출은 기록된 토큰 수로 계산했으며, 모두 정가를 적용했습니다. Claude Code 수치는 2026년 7월 8일~23일에 같은 작업을 구성당 1회 실행한 결과이며, 비용은 근사치입니다. - 내부 저장소 작업 벤치마크(상한 측정): 약 130개 저장소 작업으로 구성된 별도의 Anthropic 내부 세트입니다. 2026년 8월 20일(Claude Fable 5.1)과 2026년 9월 19일(Claude Opus 5.5, 기본 effort인
medium)에 기본 API 에이전트 루프로 작업당 1회 시도해 실행했습니다. Claude Fable 5.1 실행은 기본 effort를 명시적으로 설정하고 상한별로 135개 작업을 실행했습니다. 16,384 토큰 수치는 2회 실행의 평균(두 번 모두 36.3%)이고, 64,000 및 128,000 수치는 단일 실행 결과(각각 58.5% 및 60.0%)입니다. 6개 문제는 모든 실행에서 안전 거부가 발생해 실패로 처리했습니다. Claude Opus 5.5의 16,384 토큰 수치는 2회 실행의 평균(각각 134개 및 135개 작업 채점)이고, 64,000 및 128,000 수치는 단일 실행 결과(각 135개 작업)입니다. 16,384 토큰 실행마다 2회 시도가 안전 거부로 끝나 실패로 처리했습니다. SWE-bench Pro 상한 수치는 2026년 8월 26일에 기본 effort로 상한별 Claude Fable 5.1을 1회 실행한 결과입니다. 참조 3의 482개 문제 세트에서 층화 추출한 100개 문제 하위 집합에서 실행했으므로 참조 3의 점수와 비교할 수 없습니다. 기본 effort에서는 두 상한의 점수가 같았습니다. 차트의 턴별 분포는 128,000 상한에서 실행한 Claude Opus 5.5 및 Claude Fable 5.1 결과에서 나온 것입니다. Opus 5.5에서는 상한에 도달한 턴이 없었고(가장 긴 턴은 약 61,000 토큰, 16,384를 초과한 턴은 0.56%), Fable 5.1에서는 1개 턴이 128,000에 도달했습니다(16,384를 초과한 턴은 0.46%). - Chartography: Surge AI, "Chartography," 2026. 공개된 100개 질문 세트 전체를 사용했으며, 2026년 8월 6일과 9일(Claude Opus 5 단독) 및 2026년 9월 20일(Claude Opus 5.5)에 Claude Managed Agents에서 Anthropic의 구현으로 측정했습니다(표준 클라우드 샌드박스 사용, 어드바이저 구성은 Managed Agents 어드바이저 사용). 참조 평가 모델 대신 Claude Sonnet 4.6이 채점하고 벤치마크를 도구와 함께 실행하므로, 이 점수는 여기서의 구성 간에는 비교할 수 있지만 공개 리더보드와는 비교할 수 없습니다. 다른 채점기를 사용하고
maxeffort로 실행한 Claude Opus 5.5 시스템 카드의 Chartography 결과와도 비교할 수 없습니다. 구성당 2회(Claude Opus 5.5는 3회) 실행한 결과를 통합했으며, 실행 간 편차는 최대 10점이었습니다. 비용은 에이전트를 상시 운영하는 고객에게 청구되는 금액입니다. 즉, 같은 에이전트의 다른 세션이 직전 5분 이내에 실행된 경우처럼, 각 차트의 첫 요청이 에이전트의 공유 시스템 프롬프트와 도구를 캐시에서 읽는다고 가정합니다. 차트를 단독으로 실행하면 Claude Opus 5 또는 Claude Opus 5.5에서는 약 $0.03, Claude Fable 5.1에서는 약 $0.12가 더 듭니다. 8월 수치는 실행의 사용량 기록을 바탕으로 이 방식에 따라 비용을 다시 산정한 것입니다. 평가 조직 자체의 계량 방식은 2026년 9월 10일까지 Claude Opus 5의 캐시 읽기를 8,192 토큰 블록 단위로 청구했기 때문에 Claude Opus 5의 비용을 실제보다 높게 산정했습니다. 비용에는 샌드박스 사용 시간이 포함되지 않으며, 8월 실행에서 샌드박스 시간이 추가한 비용은 1% 미만이었습니다. Claude Fable 5.1 단독 실행은 2026년 8월 24일에 플랫폼의 출시 시점 서빙 설정으로 설정당 2회 실행한 결과입니다. 6회 시도가 15분 세션 상한에 도달해 0점을 받았으며, 실행마다 차트 2개는 안전 거부 후 Claude Opus 5가 답변했습니다. Claude Fable 5.1 어드바이저를 사용한 낮은 effort의 Claude Opus 5 실행자는 2026년 8월 30일에 같은 설정으로 2회 실행했습니다(63.0 및 67.0, 평균 65.0, 차트당 $0.47). 각 실행에서 작업의 88%에 대해 어드바이저와 상담했으며, 219개 응답 중 4개는 프로덕션 안전 필터가 어드바이저의 응답을 차단한 뒤 Claude Opus 5가 대신 제공했습니다. Claude Opus 5.5는 서버 측 폴백을 끄고 안전 분류기가 모든 도구 호출을 검사하는 상태에서low로 실행했습니다. 단독으로 3회(70, 68, 68), Claude Fable 5.1 어드바이저를 구성해 3회(59, 63, 63) 실행했으며, 어드바이저를 구성한 실행에서는 300개 작업 중 1개에서만 어드바이저와 상담했습니다. 이전 조합의 자문 비율 비교는 2026년 8월 10일~11일에 컨테이너 도구 세트를 사용해 Messages API에서 같은 구성을 다시 실행한 결과입니다. - 지원 데스크 프롬프트 감사 평가: 결정론적으로 채점하는 44개 지원 티켓으로 구성된 Anthropic 자체 제작 세트입니다. 2026년 8월 초에 실행해 2026년 8월 8일에 보고했으며, 6개의 시스템 프롬프트로 실행했습니다. 각 시스템 프롬프트는 동일한 기본 프롬프트에 Claude Opus 4.8 및 Claude Sonnet 4.6용 프롬프트에서 흔히 볼 수 있는 패턴을 하나씩 추가한 것입니다. 각 차트 지점은 세 가지 경우(이전 모델, 같은 프롬프트를 사용한 최신 모델, 감사 후 프롬프트를 사용한 최신 모델) 중 하나를 6개 프롬프트와 44개 티켓에 대해 평균한 값입니다. Opus 5의 정확도 향상 폭은 95% 신뢰 구간 기준 3~8점이며, Sonnet의 정확도 차이는 노이즈 범위 안에 있습니다.
- 데이터 파일 질문 세트: 공개 주류 판매 CSV에서 추출한 1,862행에 대한 25개 집계 질문으로 구성된 Anthropic 자체 제작 세트입니다. 정답은 pandas로 계산했고 정확 일치 방식으로 채점했습니다. Claude Sonnet 5와 Claude Opus 5에서 사고를 비활성화하고(컨텍스트 내 실험군은 기본 설정으로는 완료할 수 없음), 4,000 토큰 출력 상한을 적용하고, 프롬프트 캐싱 없이 구성당 3회 실행했으며, 2026년 8월 19일에 실행했습니다. 파일 실험군은 Files API로 CSV를 업로드하고
code_execution_20260120도구를 사용합니다. - 캐시 지속 시간 측정: 입력 및 컨텍스트 토큰 줄이기의 20개 이슈 분류 작업을 Messages API에서 같은 하네스로 실행했습니다(Claude Opus 5.5에서는 같은 요청 본문을 보내도록 이식한 버전 사용). Claude Sonnet 5는 2026년 8월 23일에, Claude Opus 5.5는 2026년 9월 19일과 20일에 기본 effort(
medium)와high로 실행했으며, Claude Opus 5.5 셀에서는max_tokens를 4,096으로 높였습니다. 무작위로 선택한 일부 턴 앞에는 일시 중지를 넣었습니다. 두 모델 모두 20개 이슈 전체에서 일시 중지 없음, 턴의 5%, 턴의 10%, 모든 턴에 6분 일시 중지를 적용했고, Claude Sonnet 5에서는 모든 턴에 2분 일시 중지를 추가로 적용했습니다. 또한 두 모델 모두 5개 이슈 하위 집합에서 20분 및 45분 일시 중지를 적용했습니다. 아래의 Claude Opus 5 "keep-alive"(연결 유지) 수치는 2026년 8월 23일에max_tokens를 4,096으로 높여 같은 작업을 실행한 결과이며, 2분 및 45분 일시 중지를 제외하고 같은 일정을 적용했습니다. 셀당 3회 실행했고, 비용은 각 응답의usage필드에 정가를 적용해 계산했습니다(Claude Opus 5.5의 경우 100만 토큰당 입력 $4, 5분 쓰기 $5, 1시간 쓰기 $8, 캐시 읽기 $0.20, 출력 $20). Claude Sonnet 5는 고객 조직과 같은 방식으로 사용량을 계량하는 Anthropic 내부 조직에서 실행했습니다. 정확도는 같은 골드 레이블을 기준으로 측정했습니다. 이 페이지의 Claude Opus 5.5 수치는 두 effort 수준을 모두 포함합니다. "crossover"(교차점)는 Claude Sonnet 5에서 턴의 약 3.3%, Claude Opus 5.5에서 3.1%~3.2%입니다. 이 값은 비용 모델이 각 세션의 턴별 컨텍스트 크기로 계산한 세션별 "break-even"(손익분기) 비율의 중앙값입니다. 대상은 Claude Sonnet 5의 20개 이슈 세션 45개 전체와, effort 수준별 Claude Opus 5.5의 20개 이슈 세션 36개입니다(모든 일시 중지 일정을 전체 작업에서 세 가지 캐시 설정으로 각각 3회 실행했으며, 5개 이슈 셀은 포함하지 않음). 5% 셀에서는 무작위로 선택된 일시 중지가 짧은 접두사 구간에 걸렸기 때문에 Claude Sonnet 5에서 5분 설정과 1시간 설정의 비용이 같았고, Claude Opus 5.5에서는 거의 같았습니다. 이 페이지의 20분의 1 규칙은 측정된 교차점보다 높게 설정되어 있습니다. 일시 중지 후 Claude Opus 5.5의 첫 토큰까지의 시간은 측정하지 않았습니다. Anthropic은 5분 캐시를 갱신하는 keep-alive 요청을 2026년 8월 23일에 Claude Sonnet 5와 Claude Opus 5에서, 위의 실행에서 Claude Opus 5.5에서 측정했으며, 요청은 항상max_tokens: 1로 보냈습니다. Claude Sonnet 5에서는 턴의 5%에 일시 중지가 있을 때 1시간 설정보다 7.7% 저렴했고, 10%일 때는 비용이 거의 같았습니다. Claude Opus 5에서는 두 비율 모두에서 측정 가능한 차이가 없었습니다. 두 모델 모두 모든 턴 앞에 6분 이상 일시 중지가 있으면 비용이 더 들었습니다. Claude Opus 5.5에서는 턴의 5% 및 10%에 일시 중지가 있을 때 1시간 설정보다 8%~18% 저렴했습니다(각 keep-alive 세션의 토큰을 1시간 캐시 가격으로 다시 계산해 세션 간 노이즈를 제거하면 약 10%~15%). 모든 턴 앞에 일시 중지가 있으면 비용이 더 들었으며, 6분에서 4%~6%, 20분에서 9%~10%, 45분에서 56%~58% 더 들었습니다. Claude Opus 5.5에서 keep-alive의 절감 효과가 더 큰 이유는 각 keep-alive 요청이 접두사를 캐시 읽기 가격으로 다시 읽기 때문입니다. 이 가격은 입력 가격의 0.05배로, Claude Sonnet 5와 Claude Opus 5의 0.1배보다 낮습니다. Claude Opus 5의 세션을 Claude Opus 5.5의 가격으로 다시 계산하면 Claude Opus 5.5와 거의 같은 절감 효과가 나타납니다. Claude Opus 5.5에 대한 Anthropic의 출시 전 API 테스트에서는max_tokens: 0요청이 캐시를 쓰고 다음 요청이 그 캐시를 읽는 것으로 확인되었습니다. 다만 이러한 요청이 기존 캐시 항목을 갱신하는지는 Opus 5.5에서 측정하지 않았습니다. Claude Fable 5.1에서는 캐시 읽기 가격이 0.025배이므로, 45분 일시 중지를 제외하면 모든 턴 앞에 일시 중지가 있어도 keep-alive가 더 저렴했습니다(참조 19). - 프로덕션의 캐시 읽기 비율: 2026년 8월 23일까지 14일간의 퍼스트 파티 Claude API 사용량을 집계한 결과입니다. 직접 API 제품만 포함하고 Anthropic 내부 조직은 제외했으며, 개별 조직은 식별하지 않았습니다. 조직-일(organization-day)은 다음 조건을 모두 충족하면 에이전트 루프로 분류했습니다. 요청에 도구 정의와 도구 결과가 포함되고, 프롬프트에 평균 9개 이상의 이전 도구 호출이 있으며, 캐싱을 사용했고, 이러한 요청이 10건 이상인 경우입니다(API에는 대화 식별자가 없으므로 이 기준으로 대화 길이를 대신 판단함). 그 결과 106,487개 조직의 303,003개 조직-일이 해당되었으며, 캐시 읽기 비율의 중앙값은 전체 입력 토큰의 84.2%, 상위 사분위수는 91.7%였습니다. 사용 사례 레이블(조직이 신고한 사용 사례, 신고하지 않은 경우 분류된 사용 사례)은 해당 조직-일의 74%, 토큰의 99%에 적용됩니다. 코딩 조직은 에이전트 입력 토큰의 87%를 차지하며, 캐시 읽기 비율의 중앙값은 88.5%(이전 도구 호출 25개 이상에서는 90.9%), 상위 사분위수는 93.4%이고, 코딩 조직-일의 약 72%가 80% 이상입니다. 지원, 리서치, 데이터 에이전트의 캐시 읽기 비율은 84%~85%입니다. 조직-일 상위 10%의 캐시 읽기 비율은 코딩에서 95.9% 이상, 지원, 리서치, 데이터 및 기타 에이전트에서 94.2%~94.8%입니다. 이전 도구 호출 25개 이상에서의 요청 단위 분포는 6시간 샘플에서 산출했으며, 코딩의 경우 캐시 읽기 92%, 캐시 쓰기 7%, 캐시되지 않은 토큰 1% 미만입니다. 레이블이 없는 조직(대부분 소규모)의 캐시 읽기 비율 중앙값은 11%입니다. 도구 정의가 없는 조직-일의 캐시 읽기 비율 중앙값은 34.6%입니다. 같은 기간을 대상으로 조직-일 대신 요청 10건 이상의 대화를 재구성해 집계한 별도의 쿼리에서는 중앙값이 90.2%로 나타났습니다. 이 차이는 데이터가 아니라 집계 범위의 차이에서 비롯됩니다.
- 압축 타이밍 측정: 입력 및 컨텍스트 토큰 줄이기의 분류 에이전트 장기 실행 버전을 2026년 8월 24일에 5분 캐시를 사용해 Claude Sonnet 5에서 실행했습니다. 비용은 사용량 필드에 정가를 적용해 계산했으며, 실험군당 5개 세션을 실행했습니다. 실험군은 다음과 같습니다. 처음부터 끝까지 기본 effort를 사용하는 변경 없음 실험군(세션당 $0.81)이 있고, 낮은 effort로 시작해 캐시를 무효화하는 동일한 두 가지 변경(기본 effort로 전환, 도구 1개 추가)을 적용하는 두 실험군이 있습니다. 이 두 실험군은 변경을 세션 중간인 요청 12와 17에서 적용하거나($0.95), 첫 번째 압축 직후의 첫 요청에서 함께 적용합니다($0.75). 2026년 8월 25일에 6개 세션으로 실행한 네 번째 실험군은 첫 번째 압축을 트리거한 요청에서 같은 두 가지 변경을 적용했습니다(세션당 $0.92). 이 경우 해당 요청의 요약 단계가 81,000 토큰 컨텍스트를 캐시에서 읽지 않고 캐시에 새로 썼기 때문에, 경계 실험군에서 같은 단계가 $0.04였던 것과 달리 $0.21가 들었습니다. 세션은 프롬프트가 80,000 토큰 압축 트리거를 넘은 뒤 요청 21~25에서 처음 압축되었으며(21개 세션 중 16개는 요청 22에서), 변경 없음 세션 2개는 종료 무렵에 한 번 더 압축되었습니다. 경계 실험군의 총비용이 변경 없음 실험군보다 낮은 것은 캐싱 때문이 아니라, 변경 전의 낮은 effort 요청과 변경 없음 세션의 두 번째 압축 때문입니다. 두 실험군의 캐시 재작성 비용 차이는 1센트 미만입니다. 세션 중간 실험군은 캐시 재작성에 세션당 $0.23를 지불했습니다. 세션 중간 실험군과 경계 실험군의 비용 차이는 $0.20였으며, 95% 신뢰 구간은 $0.11~$0.29였습니다. 세션 중간 실험군의 세션 하나는 압축 후 모델이 검색 도구를 잘못 호출해 빈 결과를 받으면서 비용이 낮게 나왔습니다($0.82). 이 세션은 결과에 포함했으며, 제외하면 실험군 평균은 $0.98입니다. 정확도는 8월 24일의 각 실험군에서 20개 레이블 중 평균 14.2개, 8월 25일 실험군에서 14.7개였습니다. 프롬프트 토큰 중 캐시 읽기 비율은 변경 없음 91%, 세션 중간 변경 85%, 경계 변경 91%, 트리거 요청에서 변경 86%였습니다.
- Claude Fable 5.1의 캐시 지속 시간 측정: 참조 16과 같은 20개 이슈 분류 작업과 하네스를 사용해 2026년 8월 23일과 8월 26일에 Claude Fable 5.1 출시 스냅샷에서 출시 가격(100만 토큰당 입력 $10, 5분 쓰기 $12.50, 1시간 쓰기 $20, 캐시 읽기 $0.25, 출력 $50)으로 실행했습니다. 일정마다 세 가지 설정을 비교했습니다. 5분 캐시, 1시간 캐시, 그리고 직전 요청의 시작 시점부터 4분마다 변경되지 않은 접두사에
max_tokens: 0요청을 보내 유지한 5분 캐시입니다(8월 23일 실행에서는 keep-alive 요청을max_tokens: 1로 보냈으며, 여기에 보고한 8월 26일 셀에서는 모든 keep-alive 요청이 캐시를 갱신했고 출력 비용이 청구되지 않았습니다). 일정은 20개 이슈 전체에서 일시 중지 없음, 턴의 10%, 모든 턴에 6분 일시 중지, 그리고 5개 이슈 하위 집합에서 45분 일시 중지입니다. 셀당 3회 실행했으며(45분 일시 중지를 적용한 8월 26일 keep-alive 셀은 6회), 비용은 각 응답의usage필드에 정가를 적용해 계산했고, 정확도는 같은 골드 레이블을 기준으로 측정했습니다(20개 중 정확히 일치한 레이블 12~17개). 8월 26일의 5분, 1시간, keep-alive 설정별 세션당 평균 비용은 일시 중지 없음 $2.42, $3.09, $2.29, 10% 일시 중지 $4.50, $2.96, $2.36, 모든 턴 일시 중지 $22.89, $3.01, $2.62입니다. 8월 23일 셀의 결과는 이와 6% 이내로 일치합니다. 45분 수치(5개 이슈 세션당 $1.68, $0.59, $0.71)는 캐시 청구 오류로 그날 처음 실행한 셀의 결과를 사용할 수 없게 되어 8월 26일에 다시 실행한 결과이며, 8월 23일 실행에서는 $1.67, $0.58, $0.70였습니다. 5분 설정과 1시간 설정 간의 교차점은 참조 16과 같은 방식으로 측정했을 때 턴의 3.1%입니다. - Terminal-Bench 3: 공개 터미널 에이전트 벤치마크의 74개 작업을 Claude Managed Agents에서 실행했습니다. 플랫폼의 기본 제공 도구 대신 평가 하네스가 각 작업의 컨테이너에서 실행하는 두 가지 사용자 정의 도구(셸과 파일 편집기)를 사용했고, 그 밖에는 외부 계정용 플랫폼 기본 설정을 적용했습니다.
higheffort로 모델당 2회 실행했으며, 2026년 8월 27일~28일에 실행했습니다. 이 실행에는 Terminal-Bench 버전 3.0을 사용했으므로, 점수를 공개 Terminal-Bench 리더보드와 비교할 수 없습니다. Claude Code에서maxeffort로 실행한 Claude Opus 5.5 시스템 카드의 Terminal-Bench 4.0 결과와도 비교할 수 없습니다. 각 작업의 시간 제한은 벤치마크 기본 제한의 2.5배로, 에이전트에게 작업당 75분에서 20시간(중앙값 작업 기준 5시간)이 주어집니다. 각 작업에는 작업에 지정된 메모리의 3배인 6 GiB~96 GiB가 할당되며, 헬퍼 서비스를 실행하는 12개 작업에는 메모리가 추가로 할당됩니다. 에이전트에게는 일반 인터넷 접근 권한이 없었습니다. 컨테이너는 내부 패키지 미러, GitHub 및 Python Package Index를 포함한 소수의 다운로드 사이트, 일부 작업에 필요한 몇몇 사이트에만 접근할 수 있었으며, 8개 작업은 네트워크에 전혀 접근할 수 없었습니다. 점수는 모델당 148회 시도의 원시 통과율이며, 단일 실행 간에는 5~11점의 편차가 있습니다. 비용은 고객에게 정가로 청구될 금액으로, 실행의 사용량 기록을 바탕으로 5분 캐시 수명을 적용해 요청별로 다시 산정했습니다. Claude Opus 4.7은 148회 시도 중 11회가 출력 상한에 도달해 종료되었습니다. - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. 10개 도메인에 걸친 100개 리서치 작업을 전문가가 작성한 루브릭으로 채점하며, 점수는 벤치마크의 정규화 점수입니다. 모든 구성은 Claude API에서 Claude Fable 5.1로 실행했으며, 기본 적응형 사고를 사용하고, 프로덕션 안전 분류기를 켜고,
max_tokens를 128,000으로 설정했습니다. 구성은high및mediumeffort의 단일 에이전트, 지침과 시계를 추가한high의 단일 에이전트, 그리고 지침과 시계를 추가한 경우와 추가하지 않은 경우의high팀입니다. 팀은 도구를 통해 같은 모델의 헬퍼 에이전트를 시작하는 리드 에이전트로 구성되며, 헬퍼 수에는 제한이 없습니다. DRACO에서 리드는 시도당 중앙값 4개의 헬퍼를 시작했습니다. 각 구성은 작업마다 3회 시도했으며, 2026년 9월 8일~10일에 실행했습니다. 4시간 제한에 도달한 시도는 다시 실행했고, 새 시도의 결과를 집계했습니다. 제외한 시도는mediumeffort 단일 에이전트의 한 작업에 대한 3회 시도뿐이므로, 이 구성은 99개 작업을 대상으로 합니다. 이 작업은 원래 실행과 재실행 모두에서 모든 시도가 시간 초과되었습니다. 벤치마크 자체 채점 방식대로 이 3회 시도를 0점으로 처리하면mediumeffort가 포함된 두 비교에만 영향이 있습니다.high대비mediumeffort의 점수 하락 폭은 0.7점에서 1.7점으로 커지고,mediumeffort 대비 두 가지 변경을 모두 적용한 경우의 점수 하락 폭은 1.2점에서 0.2점으로 줄어듭니다. 에이전트는 평가 하네스가 고정된 웹 인덱스를 기반으로 호스팅하는 검색 도구와 가져오기 도구를 사용했습니다. 소요 시간의 일부는 이 도구들에 따라 달라지며 여러분의 도구는 속도가 다를 것이므로, 이 페이지에서는 시간을 분 단위가 아니라 구성 간 비율로 제시합니다. 시간은 작업당 실제 경과 시간으로, 모든 에이전트를 통틀어 첫 요청부터 마지막 요청까지의 시간에서 속도 제한 또는 과부하 오류 후 재시도를 기다린 추정 시간을 뺀 값입니다. 이러한 오류는 테스트 계정의 공유 한도 때문에 발생했습니다. 한 세트의 모든 구성은 동시에 시작했습니다. 느린 구성은 몇 시간 늦게 완료되었으므로, 실행 시간의 일부는 다른 부하 조건에서 측정되었습니다. 각 작업의 비용은 요청에 공개 정가를 적용해 산정했으며, 프롬프트 캐싱은 각 요청 끝에 캐시 중단점을 설정하고 5분 캐시 수명을 사용하는 고객에게 청구되는 방식으로 계산했고, 모델 토큰 비용만 포함합니다. 하네스의 도구에는 추가 요금이 없습니다. 점수 변화는 작업별 쌍체 차이이며, 95% "bootstrap interval"(부트스트랩 구간)을 함께 제시합니다. 구간이 DRACO에서 1.5점, HLE에서 2.5점 이내에 있으면 변화가 허용 범위 안에 있는 것으로 봅니다. Anthropic은 실행 전에 이 허용 범위를 정했습니다. 답변은 Claude Opus 5가 채점합니다. 각 세트의 자체 채점기와 비교하면, 모든 구성에서 Opus 5는 DRACO에서 1.9~2.4점 높게, HLE에서 2.2~2.9점 낮게(Opus 5는 500개 질문 중 495개를 채점했고 벤치마크 채점기는 500개 전부를 채점), 물리학 세트에서 1.3~2.0점 낮게 채점했습니다. 물리학 세트의 자체 채점기도 전문가 참조 솔루션을 사용합니다. 두 채점기는 모든 변화의 방향에서 일치합니다. - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. 정답이 명확한 전문가 작성 질문으로, 참조 답변을 기준으로 채점합니다. 처음 500개 질문에서 측정했으며, 벤치마크 자체의 출처는 검색에서 차단했고, 나머지 설정은 참조 21과 같습니다. 각 구성은 질문마다 3회 시도했으며, 2026년 9월 8일~10일에 실행했습니다. Claude Opus 5가 기본값대로 적응형 사고를 켠 상태에서 각 답변을 참조 답변과 비교합니다. 평가 모델은 모든 구성에서 500개 질문 중 495개를 채점했으며, 점수는 이 495개를 기준으로 합니다. 나머지 5개는 채점 요청이 평가 모델의 1M 토큰 한도를 초과했습니다. 4시간 제한에 도달한 시도는 다시 실행하고 새 시도의 결과를 집계했으므로, 모든 구성에 1,500회 시도가 모두 포함됩니다. 벤치마크 자체 채점 방식대로 채점되지 않은 5개 질문을 0점으로 처리해도 결론은 달라지지 않습니다.
- 물리학 세트: 공개 CritPt 벤치마크를 바탕으로 만든 70개의 연구 수준 물리학 문제로 구성된 내부 세트입니다. 원본 벤치마크: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. 전문가 검토자가 문제 설명을 수정했습니다. Claude Opus 5가 비공개 전문가 참조 솔루션을 기준으로 각 답변을 채점하므로, 점수를 공개된 결과와 비교할 수 없습니다. 점수는 문제별 시도 점수의 평균을 전체 문제에 대해 다시 평균한 값입니다. 70개 문제 전체에서 문제당 4회 시도해 측정했으며, 2026년 9월 8일~9일에 실행했습니다. 모든 에이전트는 네트워크에 접근할 수 없는 샌드박스 컨테이너에서 Python 도구, 셸, 파일 편집기를 사용했으며, 검색 도구와 가져오기 도구는 제공되지 않았습니다. 그 밖의 설정은 참조 21과 같습니다. 물리학 세트에는 실행 전에 점수 허용 범위를 정하지 않았으므로, 이 페이지에서는 점수 변화를 95% 구간과 함께 제시하며 허용 범위 안에 있는지는 판단하지 않습니다.
다음 단계
이 페이지에서 추가 비용 없이 가장 크게 절감할 수 있는 방법입니다. 설정, 수명, 진단 방법을 알아보세요.
단일 모델 안에서 지능과 지연 시간 및 비용 사이의 균형을 조정하세요.
Claude 모델 제품군의 성능, 속도, 비용을 비교해 평가하세요.
에이전트 루프에 토큰 카운트다운을 제공해 스스로 사용량을 조절하게 하세요.
Managed Agents 세션에 엄격한 달러 상한을 설정하세요.
모든 Claude 모델의 현재 토큰당 가격을 확인하세요.
실행 가능한 노트북에서 작동하는 에이전트에 이러한 방법을 하나씩 적용하고, 단계마다 작업당 비용을 확인하세요.
advisor 및 오케스트레이터 패턴에 대한 설명 영상을 시청하세요.
Was this page helpful?