推論フック
推論が進行する前に、ガバナンス対象の各プロンプトを組織のAIセキュリティサーバーに送信し、許可または拒否の判定を受け取ります。
「Inference hooks」(推論フック)を使用すると、Claude Enterprise組織は、推論が実行される前に、ガバナンス対象のすべてのプロンプトをAIセキュリティサーバー(組織またはそのセキュリティベンダーが運用するHTTPSサービス)経由でルーティングできます。ユーザーがプロンプトを送信すると、Anthropicは会話のトランスクリプトをAIセキュリティサーバーに送信し、許可または拒否の判定を待ちます。拒否されたリクエストはモデルに到達することはありません。セキュリティチームとコンプライアンスチームは推論フックを使用してデータポリシーをインラインで適用し、開発者は各リクエストを評価するAIセキュリティサーバーを構築します。
フックはAnthropicのサーバー上で、リクエストがクライアントを離れた後かつモデルが実行される前に動作するため、ガバナンス対象のすべてのリクエストに一律に適用され、ユーザーのデバイスにインストールやデプロイするものは何もありません。
現在、唯一のフックイベントは prompt であり、ガバナンス対象の推論リクエストごとに1回、推論が開始される前に発火します。レスポンス側の適用は、今後のイベントとして計画されています。
推論フックの仕組み
- ユーザーがガバナンス対象のサーフェスでプロンプトを送信します。
- Anthropicは、組織で設定されたAIセキュリティサーバーのエンドポイントにHTTPS
POSTを送信します。リクエストボディには会話のトランスクリプトが含まれます。組織が署名シークレットを生成すると、各リクエストはStandard Webhooks仕様に従って署名されるため、サーバーはリクエストがAnthropicから送信されたものであることを検証できます。 - AIセキュリティサーバーはコンテンツを評価し、組織が設定した判定タイムアウト(デフォルトでは5秒)以内に判定を返します。
allowの場合、推論は通常どおり進行します。denyの場合、リクエストは拒否され、ユーザーには2つの部分から構成される「ポリシーによりブロックされました」というメッセージが表示されます。1つ目はAIセキュリティサーバーが判定のdeny_reasonフィールドで提供したリクエストごとの理由、続いて管理者が設定する固定メッセージ(たとえば、連絡先や例外申請の窓口)です。管理者が固定メッセージを設定していない場合は、組み込みのデフォルトメッセージがユーザーに管理者へ連絡するよう案内します。各拒否は、組織のアクティビティフィードにも記録されます。
次の図は、1つの例(ClaudeがO365ツールも呼び出すCoworkリクエスト)をたどり、フローのどの部分がフックされるかを示しています。フックされるポイントは図のステップ1と6で、それぞれプロンプトが到着する時点とツール結果が返される時点です。いずれの場合も、ステップ2~3および7~8に示すAIセキュリティサーバーとの検証のやり取りが発生します。
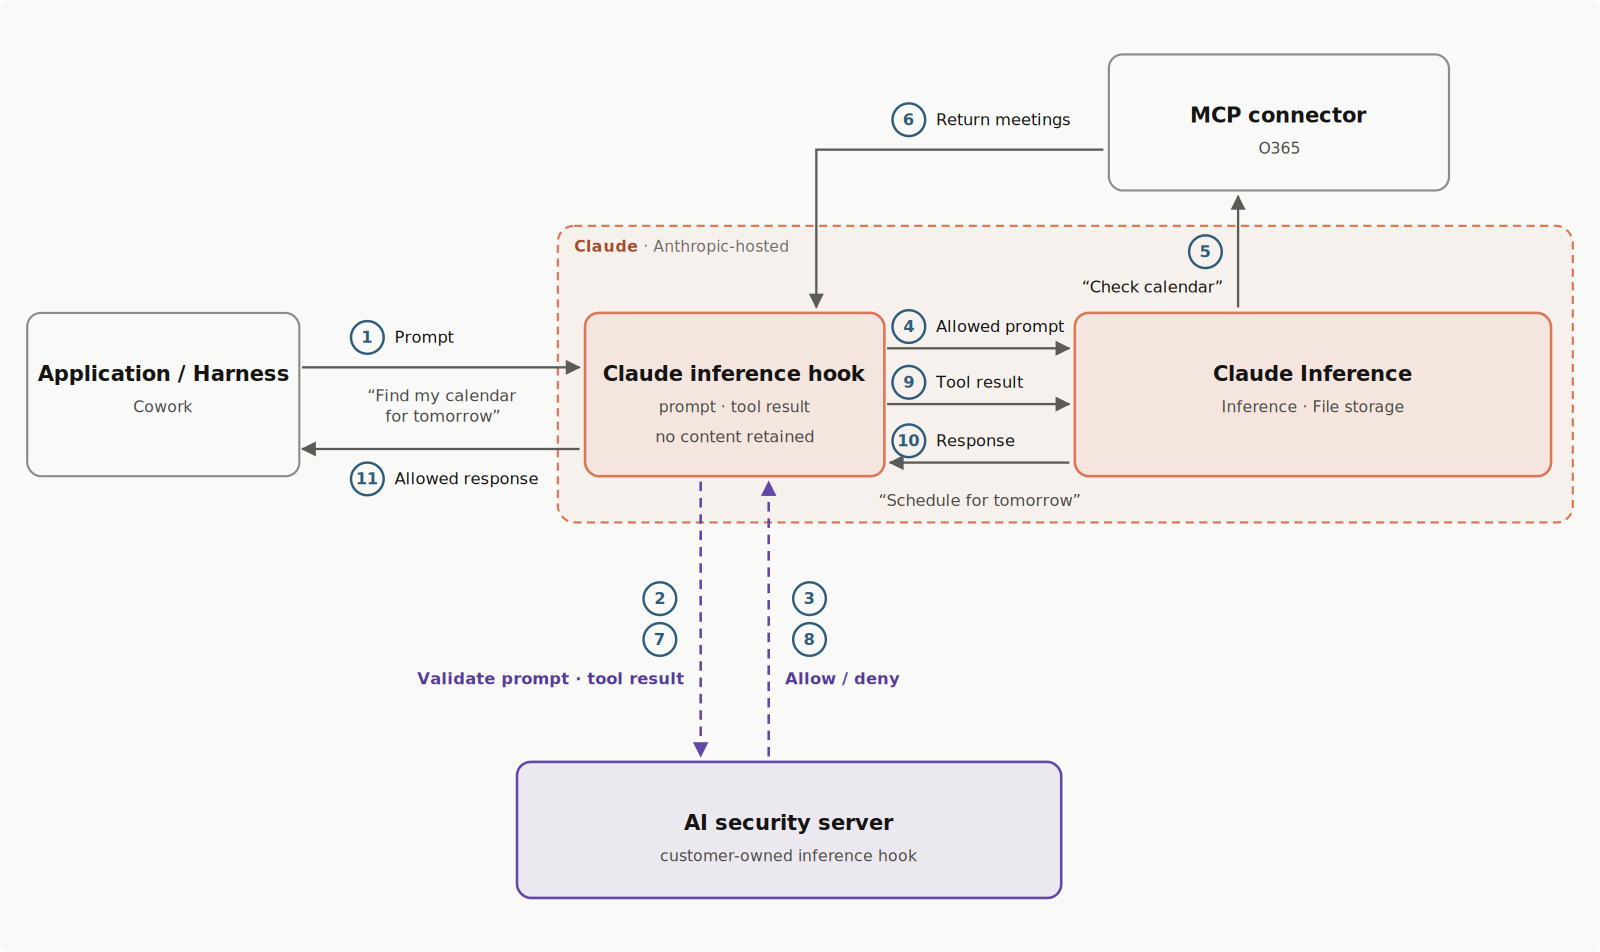
判定は小さなJSONオブジェクトです。{"action": "allow"} はリクエストの進行を許可し、拒否の場合はユーザー向けの理由が含まれます。判定の完全なスキーマについては、判定を返すを参照してください。
AIセキュリティサーバーが参照できるのは、ユーザーが目にするものと同じです。トランスクリプトのテキスト、ツール呼び出しとその結果、添付ファイルから抽出されたテキストです。生のファイルや画像のバイト、システムプロンプト、Anthropic内部のコンテキストを受け取ることはありません。Anthropicは推論フックの一部としてプロンプトやレスポンスの内容を保存しません。判定、タイムスタンプ、リクエスト識別子など、フックのアクティビティに関するメタデータのみを記録します。
AIセキュリティサーバーに到達できない場合、エラーが返された場合、またはタイムアウト内に応答がない場合は、組織の障害処理設定によって結果が決まります。リクエストをブロックするか、検査なしで続行を許可するかのいずれかです。サーバーに起因する障害が継続すると、「circuit breaker」(サーキットブレーカー)が作動します。Anthropicはサーバーへの接続を停止してすべてのリクエストに障害処理設定を適用し、サーバーが再び判定を返していることを検出すると、サーキットブレーカーを自動的にリセットします。詳しくはサーキットブレーカーを参照してください。
適用は組織のペースで段階的に展開できるため、初日から誰かがブロックされる必要はありません。シャドウモードでは何もブロックせずに本番トラフィックに対する判定を観察でき、ロールアウト率では選択した割合のリクエストを検査し、除外設定では選択したロールのメンバーを完全に対象外にできます。推論フックの設定を参照してください。
リクエストとレスポンスの完全なスキーマ、署名検証、運用上の詳細については、インテグレーションの開発を参照してください。
ユースケース
- データ損失防止(DLP)。 トランスクリプトをDLPスキャナーに転送し、規制対象または機密扱いの情報を含むプロンプトを拒否します。これが最も一般的な導入形態です。
- リアルタイムのトランスクリプトアーカイブ。 各トランスクリプトを到着時にアーカイブし、常に
allowを返します。Compliance APIをポーリングする代わりとなるプッシュベースの方法です。 - プロンプトのテレメトリ。 組織がClaudeをどのように使用しているかを、使用の瞬間に計測します。
- ポリシーエンジン。 推論の前に独自のルールを適用します。モデルの許可リスト、プロジェクト単位の制限、業務時間による制御などです。
現在の制限事項
- 添付ファイルはメタデータと抽出されたテキストで表現されます。生のファイルや画像のバイトは送信されないため、画像のみのコンテンツ(たとえば、ドキュメントのスクリーンショット)は検査されません。
- 判定は許可または拒否のいずれかです。プロンプトの書き換えやマスキングはサポートされていません。
- プラットフォーム組織(Claude Platform経由のAPIアクセス)は対象外です。
利用可能範囲
Inference hooksはClaude Enterprise組織で利用できます。設定にはorganization:manage権限が必要で、この権限を持つのはOwnerロールとPrimary ownerロールのみです。
1つのフックで、Claude Enterprise組織内のclaude.ai、Cowork、Claude Codeのセッションにおける会話を、Web、デスクトップアプリやモバイルアプリ、CLIのいずれで実行されているかにかかわらず管理できます。Inference hooksはAmazon BedrockやGoogle Cloudでは利用できません。
ガバナンス対象のリクエストとは、ユーザーの会話の背後にある推論リクエストです。会話タイトルの生成などの付随的なリクエストはエンドポイントに送信されず、システムプロンプトとツール定義は送信内容に含まれることはありません。音声モードは対象外です。
推論フックとCompliance APIの比較
どちらの機能も、Claude Enterprise組織のセキュリティ、法務、コンプライアンスチームを対象としています。
| 推論フック | Compliance API | |
|---|---|---|
| 動作するタイミング | インライン、推論の実行前 | 事後 |
| 実行内容 | ガバナンス対象の各リクエストをリアルタイムで許可または拒否 | 監査およびエクスポートのために、アクティビティ、チャット、ファイル、プロジェクト、セッショントランスクリプト、ユーザーを取得 |
| 方向 | AnthropicがAIセキュリティサーバーを呼び出す | お客様がAnthropicのAPIを呼び出す |
リクエストがモデルに到達する前に停止するには推論フックを使用し、その後に何が起きたかを監査するにはCompliance APIを使用してください。
このセクションの内容
組織で推論フックを許可し、AIセキュリティサーバーをセットアップしてテストし、障害処理を選択し、判定を適用します。
AIセキュリティサーバーを構築するためのリクエストと判定のスキーマ、署名検証、運用上のセマンティクス、インテグレーションパターン。
Was this page helpful?