コストとインテリジェンスの最適化
Claude Platformでコストとインテリジェンスのバランスを取る方法を、プロンプトキャッシング、エフォート、モデル選択、予算、マルチモデル戦略についての測定結果とともに解説します。
ワークロードがプロトタイプから本番環境へ移行すると、コストは第一級の設計上の制約になります。最も高性能なモデルは大規模運用では高価すぎる場合があり、最も安価なモデルは品質面で不足する場合があります。コストをうまく管理するということは、各コストレバーが出力品質にどう影響するかを理解することを意味します。品質とトレードオフになるレバーもあれば、そうでないレバーもあるからです。Claude Platformでは、そのトレードオフを直接制御できます。リクエストごとにモデル、エフォートレベル、アーキテクチャを選択できるため、ワークロードをコスト対インテリジェンスのフロンティア上のほぼどこにでも配置できます。
コストとインテリジェンスは通常、一方で他方を買うフロンティアとして描かれます。このページの最初のグループのレバーは、品質に触れずにコストを削減することでワークロードをそのフロンティアに近づけます。フロンティアに沿って移動するのは2番目のグループだけです。
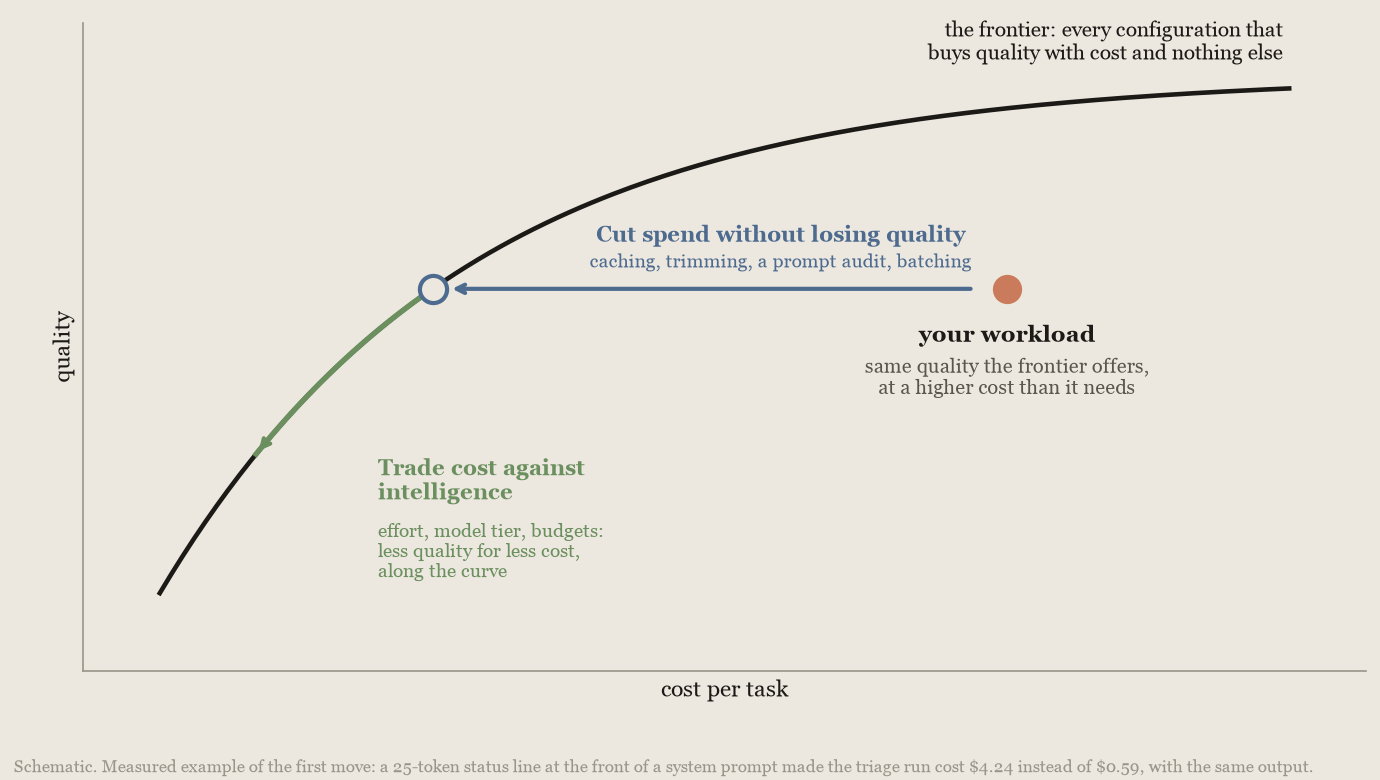
レバーには2種類あります。
- 無償の改善(Free wins) は品質に触れずに支出を削減します。「prompt caching」(プロンプトキャッシング)、トークンの衛生管理、実行中のモデルに対するプロンプト監査、最大24時間待てる作業向けの50%割引のバッチ処理、そして最後の防衛線としてのワークスペースの支出制限です。
- トレードオフ(Tradeoffs) は、コストとインテリジェンスを交換します。モデル選択、エフォート、出力上限とタスク予算、経過時間の表示、マルチモデルアーキテクチャです。
各レバーには測定結果と、それが効果を発揮する条件のルールが付いています。Anthropicの測定では、プロンプトキャッシングが群を抜いて最大のレバーでした。このガイドのベンチマークではエージェントループのコストを2.7分の1から5.3分の1に削減し、小規模なトリアージエージェントの請求額を83%、入力のトリミングを加えると88%削減しました。マルチモデルのレバーはより限定的で、2つ目のモデルが効果を発揮したのはアドバイザーとオーケストレーターという2つの形でした。
ここから始める
自分の状況に合う行を見つけてください。
| 状況 | やること | 参照先 |
|---|---|---|
| あらゆるワークロード、あらゆるモデル | プロンプトキャッシングを有効にし、不要なトークンを削る。どちらも無償 | 繰り返されるコンテキストをキャッシュする · トークンを削る |
| ターン間で人が待機する | 約20ターンに1ターンが5分から1時間の休止の後に続き、1時間を超える間隔がほとんどない場合は、1時間のキャッシュ期間を使う。Claude Fable 5.1では、休止が数分程度の間は5分のキャッシュをウォームに保ち、休止が1時間に近づく場合は1時間の期間を購入する。Claude Opus 5.5では、約30分までの休止の後に続くのが20ターン中1〜2ターンだけの場合は、代わりに5分のキャッシュをウォームに保つ | キャッシュ期間を選ぶ |
| コストが高すぎるが品質は問題ない | 現在のモデルでエフォートを下げてスイープする | エフォートを調整する |
| 最新モデルを使用していない | アップグレードする。Anthropicの測定では、新しいモデルはそれぞれ前のモデルと同等以上のタスクを解決し、通常は解決したタスクあたりのコストも低かった | モデルをアップグレードする |
| モデルを選択または切り替えている | トークンあたりではなく、完了タスクあたりのコストで比較する | モデルを比較する |
| 品質が十分でない | エフォートを下げた場合は元に戻す。そうでなければ次の上位ティアをlowエフォートで試す | エフォートを調整する · モデルを比較する |
試行がstop_reason: max_tokensで終わる | max_tokensを上げる。デフォルトのエフォートで測定した14,000ターンのうち64,000でカバーできなかったのは2ターンだけで、128,000にしても解決済みタスクあたりの追加コストはゼロだった | 予算を設定する |
| 出力をチェックできる(テスト、検証器) | すべてを低エフォートで実行し、失敗をhighで再実行する。測定されたコーディングベンチマークでは、合格率は約半分のコストで維持された | 失敗を再実行する |
| 少数の非常に高コストな実行があるエージェントループ | タスク予算(ベータ。対応モデルはサポート表を確認)、Claude Managed Agentsのセッション予算、ワークスペースの支出制限を設定する | 予算を設定する |
| エージェントの実行をより早く終わらせたい | 時間が重要であることをモデルに伝え、経過時間を表示する。DRACO、HLE、社内の物理セットでは、実行時間が33%〜69%短縮され、タスクあたりのコストが28%〜54%低下し、スコアの低下は最大1.9ポイントだった | モデルに経過時間を表示する |
| 低コストモデルが難しい判断でのみ行き詰まる | フロンティアのアドバイザーを追加する。エグゼキューターより十分高価で、実際に相談される場合に効果があるため、まずアドバイザーのモデル単体を低エフォートで価格評価し、相談率を測定する | アドバイザー戦略 |
| 作業が1つのコンテキストウィンドウを超える | パーティションをより安価なワーカーに委任する | オーケストレーター戦略 |
これらの結果はAnthropic社内のもの(参照ベンチマーク)であり、方向性を示すもので保証ではありません。4ステップの方法で自分のワークロードで測定してください。
品質を落とさずに支出を削減する
プロンプトキャッシング、トークンの衛生管理、バッチ処理、現在のモデルに対するプロンプト監査は、いずれも出力品質を下げずに支払額を下げます。注意点が2つあります。バッチ処理は割引と引き換えにレイテンシを犠牲にします。また、トークン衛生のレバーであるコンテキスト編集は、このセクションで測定した実行では節約額よりもコストのほうが大きくなりました。
繰り返されるコンテキストをキャッシュする
キャッシングが最優先である理由
他のどのレバーよりも先にプロンプトキャッシングを有効にしてください。エージェントタスクの各ターンは、増え続ける会話全体、つまりシステムプロンプト、ツール定義、過去のすべてのターンを再送信するからです。40ターンのタスクは最初のターンを40回送信するため、タスクのコストはターン数のほぼ2乗で増加します。キャッシングは再送信を止めるわけではありませんが、各再送信のコストは約10分の1になり、処理も速くなります。プレフィックスは入力価格の10分の1であるキャッシュ読み取り料金で課金され、各ターンは新しい部分についてのみ1.25倍のキャッシュ書き込み料金を支払います。
良い状態の目安。 実際のトラフィックの丸1日分で、エージェントループは入力の中央値84%をキャッシュから読み取り、コーディングかどうかを問わず上位10%のハーネスは94%以上を読み取っていました17。タスクの深い段階では、よく構築されたループが正規料金を支払うのは入力の1%未満です。約80%を下回る場合は、キャッシュを壊している何かを探してください(キャッシュを壊すものを参照)。
Anthropicが測定した実行全体で、キャッシュ読み取りは常にタスクコストの単一最大の構成要素であり、キャッシングはほとんどのモデル選択の判断よりも価値があります。AnthropicはDeepResearch Bench II7の実行をキャッシングありとなしで価格評価しました。
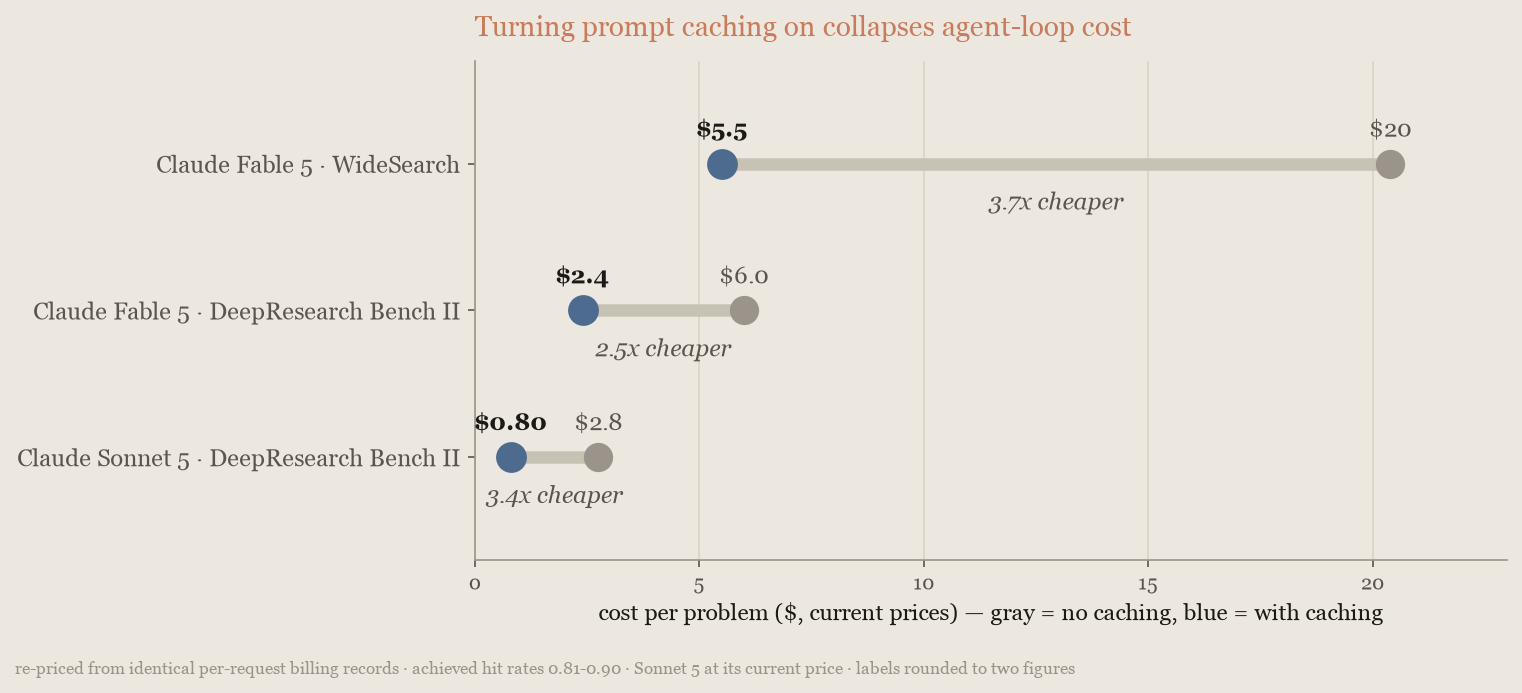
キャッシュのデフォルトの有効期間は5分で、エージェントループのターンは数秒間隔なので、割引は毎ターンほとんどのトークンに適用されます。キャッシングのチャートの実行では、入力トークンの79%から90%をキャッシュから読み取っていました。短いループは再読み取りが少ないため、節約額はエピソードの深さによって変わりますが、測定したすべてのモデルとベンチマークでキャッシングは単一最大のレバーであり続けました。
キャッシュ期間を選ぶ
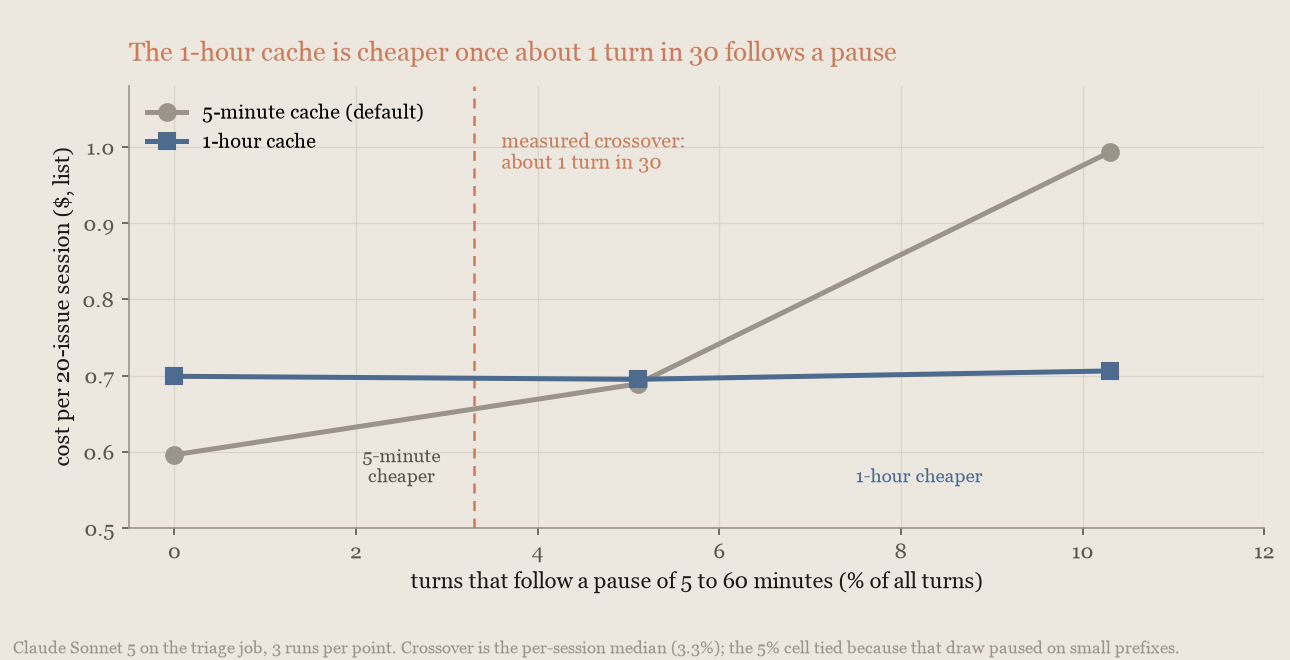
ループがターンの間に人を待つ場合は、1時間のキャッシュ期間を使用してください。書き込みコストは高くなります(入力価格の1.25倍ではなく2倍)。どちらの期間でもミスするとプレフィックス全体が読み取り価格ではなく書き込み価格で課金されるため、セッションあたり数ターンが5分から1時間の休止の後に続くようになれば、長い期間のほうが得になります。
判断するには、会話内の連続するリクエスト間の間隔を数えます。
- 20回に約1回を超える間隔が5分から1時間の範囲にあり、1時間を超える間隔がまれな場合:1時間の期間を使用します。Claude Opus 5.5では、その範囲に入る間隔が20回中1〜2回だけで、約30分を超えるものがない場合は、代わりに後述のキープアライブリクエストで5分のキャッシュをウォームに保ちます。
- ターンが数秒間隔で届く場合:5分のデフォルトのままにします。休止がない場合、Claude Sonnet 5では1時間の設定より15%、Claude Opus 5.5では約15%〜18%コストが低くなりました。
- 1時間を超える間隔が多い場合:デフォルトのままにします。1時間を超える間隔はどちらの期間も期限切れにし、1時間設定はその後プレフィックスをより高い書き込み価格で再書き込みするため、そうした間隔のたびに損をします。5分を超える休止のうち、約60%以上が1時間も超える場合はデフォルトのままにしてください。1時間の期間が得になるのは、長い休止の少なくとも約40%が1時間以内に終わる場合だけです。
Anthropicは、入力とコンテキストのトークンを削るのトリアージジョブを、人の遅延をシミュレートするために一部のターンの前に休止を挿入して測定しました16。Claude Sonnet 5とClaude Opus 5.5では、約30ターンに1ターンが休止の後に続くようになると1時間のキャッシュのほうが安くなったため、20回に1回というルールには余裕があります。また、5分の設定では休止後のすべてのターンでプレフィックス全体が再書き込みされるため、損益分岐点を過ぎると差は急速に広がります。現在のすべてのモデルは同じキャッシュ書き込み倍率を使用し、Claude Fable 5.1、Claude Mythos 5.1、Claude Opus 5.5以外のすべてのモデルは同じ読み取り価格を使用するため、他のモデルでも損益分岐点は同じ範囲にあります。Fable 5.1のケースについては次に説明します。精度はすべてのセルで実行間のノイズの範囲内にとどまりました。休止後のターンは、1時間の設定ではウォームキャッシュ時のレイテンシを維持しました(Claude Sonnet 5とClaude Opus 5で測定。Claude Opus 5.5では未測定)。次のチャートは、Claude Sonnet 5でのセッションあたりのコストを、休止後のターンの割合に対してプロットしたものです。
Anthropicは、5分のキャッシュをウォームに保つための追加リクエストも測定しました。Claude Sonnet 5では、20ターンに1ターンが休止の後に続く場合は1時間の期間より約8%安くなりましたが、20ターンに2ターンではほぼ同じでした。前世代のOpusモデルであるClaude Opus 5では、測定可能な節約はありませんでした。すべてのターンの前に6分以上の休止がある場合は、どちらのモデルでもコストが高くなりました。Claude Sonnet 5での節約は20ターンに2ターンの時点で消えていたため、Claude Sonnet 5とClaude Opus 5では代わりに1時間の期間を使用してください。
Claude Fable 5.1では最も安い設定が異なります。そのキャッシュ読み取りは入力価格の0.025倍(100万トークンあたり$0.25)である一方、キャッシュ書き込みは標準の倍率のままなので、プレフィックスを再読み取りするキープアライブリクエストは安く、1時間の期間の書き込みプレミアムのほうが大きな請求になります。AnthropicはClaude Fable 5.1で同じ3つの設定を使ってトリアージジョブを測定しました19。休止が数分である限り、5分キャッシュをウォームに保つほうが1時間キャッシュよりセッションあたり13%から20%安くなりました。休止が45分近くになった場合にのみ1時間キャッシュが勝ち、その差はセッションあたり約12セントでした。Claude Fable 5.1では、人が数分間離れている間は5分キャッシュをウォームに保ち、休止が1時間に近づく場合は1時間の期間を購入してください。
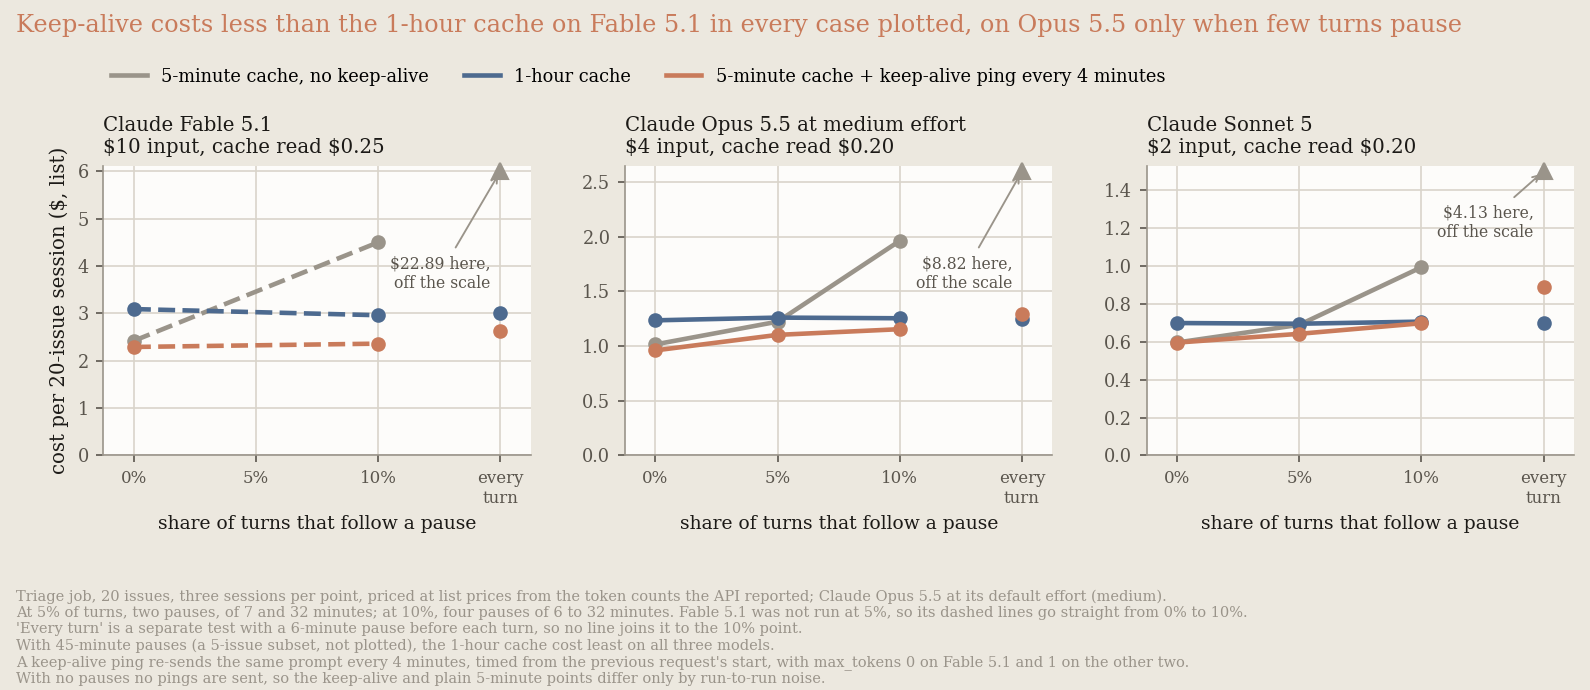
キャッシュ読み取りが入力価格の0.05倍であるClaude Opus 5.5では、ターンの5%または10%が6〜32分の休止の後に続く場合、キープアライブリクエストは1時間の期間より8%〜13%安くなりました(デフォルトのエフォートであるmediumの場合。highでは10%〜18%安い)。しかし、すべてのターンの前に休止がある場合はコストが高くなり、6分の休止で約4%〜6%高く、45分の休止では50%以上高くなりました。したがってClaude Opus 5.5では、約30分までの休止の後に続くのが20ターン中1〜2ターンだけの場合は5分のキャッシュをウォームに保ち、それ以外の場合はこのセクションの冒頭のリストに従ってください。これらの測定では、キープアライブリクエストをmax_tokens: 1で送信しました。次に説明するmax_tokens: 0のリクエストについては、Claude Opus 5.5でのAnthropicのリリース前のAPIテストで、キャッシュを書き込み、次のリクエストがそれを読み取ることが示されています。既存のエントリを更新するかどうかは、Opus 5.5では測定されていません。
キャッシュをウォームに保つには、前のリクエストの開始から4分以内に、max_tokensを0に設定して前のリクエストを再送信し、その後も4分ごとに送信します。streamが設定されていた場合は削除します。時間はレスポンスの終了からではなく、リクエストの開始から数えてください。キャッシュの5分の有効期間は、エントリを書き込んだか更新したリクエストの開始から始まるため、レスポンスの生成に費やされた時間もその期間に含まれます。これが事前ウォーミングリクエストです。キャッシュの有効期間を更新し、何も生成せず、キャッシュ読み取りのみが課金されます。プレフィックスは1バイトも変更しないでください。また、理由なくトークンをサンプリングしてしまうmax_tokens: 1は使用しないでください。リクエストのボディだけでなくヘッダーも再送信してください。リクエストにanthropic-betaヘッダーが含まれている場合(たとえばタスク予算のため)、キープアライブリクエストにも同じヘッダーが必要です。そうしないと、再送信したボディ内のベータ限定フィールドが拒否されます。max_tokens: 0のリクエストは、リクエストでthinking.type: "enabled"(Claude Fable 5.1のデフォルトの適応型思考は問題ありません)、構造化出力、または強制的なツール選択を設定している場合は拒否されます(その制限事項)。そのようなワークロードでは、代わりに1時間の期間を購入してください。max_tokens: 0のリクエストは、トップレベルのcompactionパラメータを含む場合も拒否されるため、オンデマンドのコンパクションのコンパクションリクエストをキープアライブリクエストとして再送信しないでください。
# 最後のリクエスト開始から4分以内に(生成に費やした時間もキャッシュの
# 有効期間に含まれます)、max_tokensを0に設定してそのリクエストを再送信し、
# streamは削除します(max_tokens: 0のリクエストはストリーミングできません)。
# anthropic-betaヘッダーを含め、元のリクエストと同じヘッダーを送信します。
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
キャッシングを有効にする
セットアップにはほとんど手間がかかりません。自動キャッシングがブレークポイントを配置してくれます。そうでなければ、Claude Codeに同梱されているClaude APIスキルが、1つのプロンプトから既存の統合にキャッシングを追加できます。次の抜粋は、これらの測定を行ったハーネスにスキルがキャッシングを追加している様子です。
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...これらのブレークポイントの配置は、明示的なキャッシュブレークポイントの標準パターンに従っています。
キャッシュを壊すもの
タスク中にキャッシュを壊しうるものはいくつかあります。タイムスタンプやキューの位置など、リクエストごとに変わるものを安定したプレフィックスの前に置くと、すべてのリクエストが完全なキャッシュ書き込みになります。入力とコンテキストのトークンを削るのトリアージ実行では、システムプロンプトの先頭にある25トークンのステータス行のせいで、実行あたり$0.59ではなく$4.24かかり、キャッシングをオフにした場合よりも高くなりました。リクエストごとのテキストは最新のユーザーターンに置いてください。
キャッシュはリクエストを順番に(ツール、システムプロンプト、メッセージの順)バイト単位で完全一致させるプレフィックスマッチなので、どこかが変更されるとそれ以降のすべてが無効になります。リクエスト間でeffortや思考の設定を変更すると、その時点以降のキャッシュが無効になり、一部のモデルではその前にあるツールとシステムプロンプトも無効になります。システムプロンプトを編集すると、その時点以降のキャッシュが無効になります。出力形式を設定または変更すると、会話全体のキャッシュが無効になります。ツール定義を追加、削除、または並べ替えると、すべてが無効になります。プロンプトキャッシングのページにはこれらのケースが記載されていますが、出力形式については構造化出力で説明しています。最新のモデルでは、トップレベルのsystemフィールドを編集する代わりに、messagesに追加する{"role": "system"}メッセージである会話途中のシステムメッセージで指示を変更してください。キャッシュされたプレフィックスはそのまま維持されます。対応モデルについてはそのページを確認してください。対応モデルでは、メッセージごとのエフォート変更でもキャッシュされたプレフィックスはそのまま維持されます。影響が最も大きいのはClaude Fable 5.1とClaude Mythos 5.1で、キャッシュが壊れると、プレフィックスを入力価格の0.025倍で読み取る代わりに1.25倍で再書き込みすることになります。100,000トークンのプレフィックスでは、そこでキャッシュが壊れたターン1回のコストは$0.03ではなく$1.25で、読み取りの50倍になります。Claude Opus 5.5では$0.02ではなく$0.50で25倍、その他の現在のモデルでは12.5倍です。
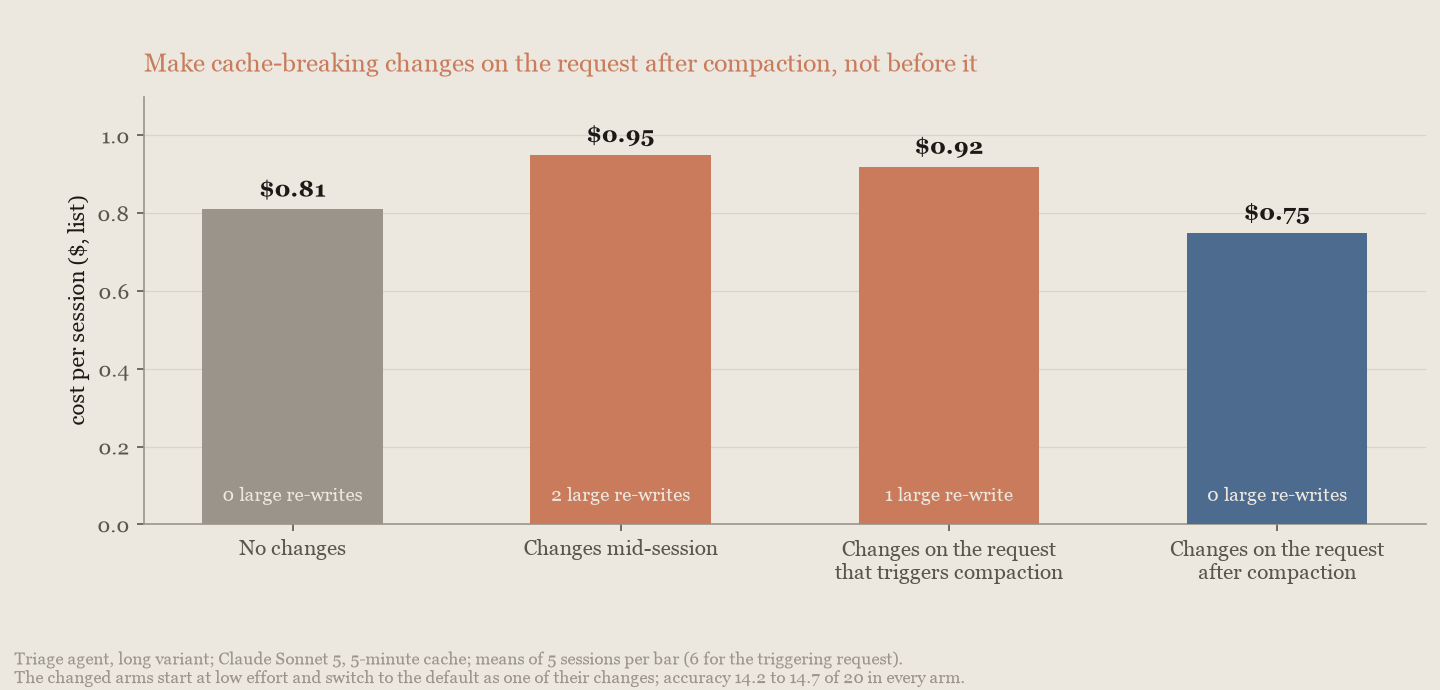
Anthropicはこれをトリアージエージェントの長いセッションで測定しました18。セッション途中で行ったエフォート変更とツール追加は、39,000トークンと60,000トークンのキャッシュを再書き込みし、それらのセッションはセッションあたり$0.95かかりました。同じ2つの変更をコンパクション後の最初のリクエストで行うと$0.75、コンパクションをトリガーしたリクエストで行うと$0.92でした。後者では、コンパクションの要約パスが81,000トークンのコンテキストをキャッシュ書き込み価格で再処理したためです。その要約パスは$0.21かかりましたが、同じ変更を1リクエスト後に行った場合は$0.04でした。精度はすべてのアームで実行間のノイズの範囲内でした。
タスク予算を途中で変更すると、予算値を含むキャッシュ済みプレフィックスがすべて無効になるため、最初のリクエストで一度だけ設定してください。コンテキスト編集のパスは毎回、クリアした時点からプレフィックスを無効にし、次のリクエストがそれ以降のすべてを再キャッシュする費用を支払うため、小さなバッチを何度も行うのではなく、少数の大きなバッチでクリアしてください。Claude Fable 5.1とClaude Mythos 5.1では、これらはいずれもトークンあたり読み取り価格の50倍かかるため、そこで最も重要になります。キャッシュを無効にする変更はすべて自然な区切りで行い、その後キャッシュ読み取りが減っていないことを確認してください。減っている場合は、キャッシュ診断でプレフィックスがどこで分岐したかがわかります。
入力とコンテキストのトークンを削る
ほとんどのエージェントリクエストには、回答にまったく影響しないトークンが含まれています。それらを削っても出力品質が損なわれることはめったにありませんが、ここで挙げるすべてのレバーが測定時に費用を節約したわけではありません。見るべき場所は2つあります。
- 入力のトリミング。 Webフェッチツールの動的フィルタリングは取得したページからボイラープレートを排除し、画像のリサイズはビジョン入力を適切なサイズにし、遅延読み込みを伴うツール検索は必要なときにのみツール定義を読み込みます(このセクションの後半で測定)。プログラマティックツール呼び出しにより、Claudeはコードから複数のツール呼び出しを実行できるため、フィルタリングされた結果のみがコンテキストに入ります。そのドキュメントは、エージェント検索ベンチマークで入力トークンが24%少なく、スコアが高いと報告しています。ツールコンテキストの管理は、ツール検索、プログラマティックツール呼び出し、プロンプトキャッシング、コンテキスト編集を比較しています。
- コンテキストのライフサイクル。 コンテキスト編集は古くなったツール結果をクリアし、しきい値付きの自動コンパクションは長いループが履歴全体を持ち越すのを防ぎます。
これらのレバーはキャッシュとも互いとも相互作用するため、正味の効果で判断し、キャッシュ診断を使って各変更後もキャッシュ済みプレフィックスが維持されていることを確認してください。Anthropicは、公開リポジトリのスクリーンショット付きの実際のバグ報告20件を処理するイシュートリアージエージェントと、トークン数が2.6倍の同じジョブの長いバリアントでこれらを測定しました。キャッシングをオンにした状態で、入力のトリミング(画像のリサイズとツール検索)により、短い実行ではさらに26%、長い実行では21%削減されました。
使わないツール定義を遅延させる
リクエストに添付されたすべてのツール定義は毎ターンの入力になり、いくつかのMCPサーバーを合わせると数百に達します。Anthropicは、トリアージエージェント自身の2つのツールに加えて、公開MCPサーバーからの実際のツール定義のカタログを付け、合計最大502ツールで実行しました。すべてを読み込む場合と、追加分をツール検索の背後でdefer_loadingとマークする場合です。
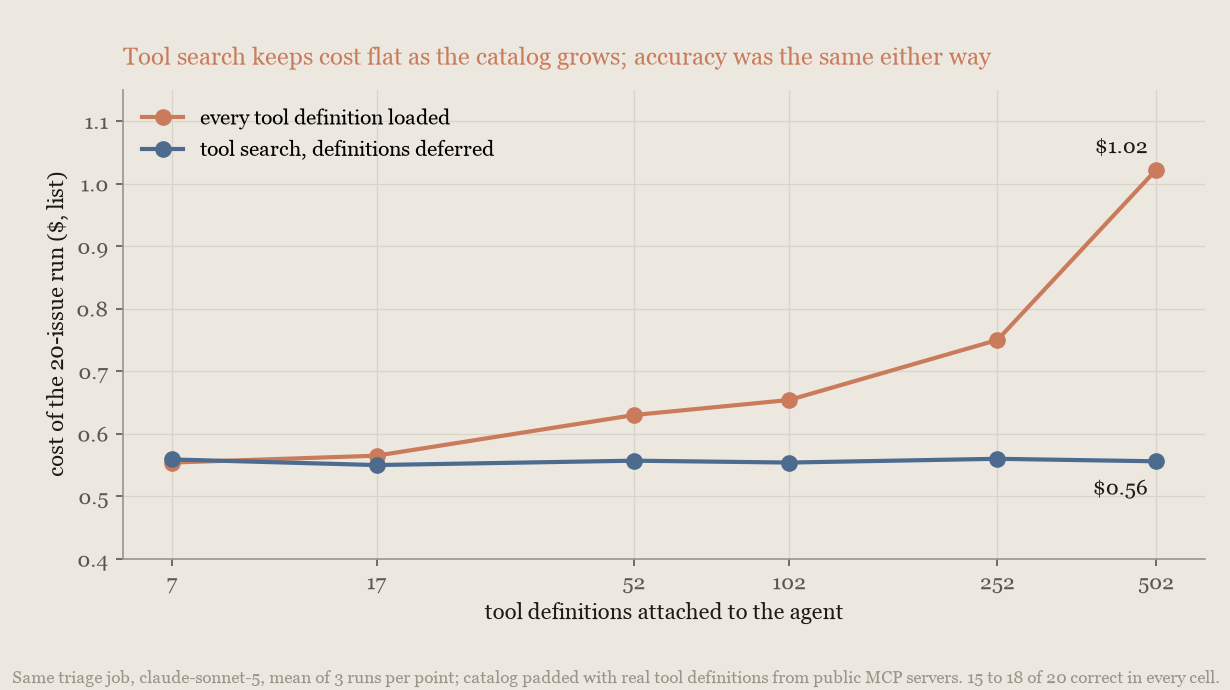
すべての定義を読み込むと、カタログが大きくなるにつれて実行コストはほぼ2倍になり、各リクエストのスキーマトークンに追従しました。ツール検索ではどのカタログサイズでも横ばいで、502ツールでは45%安くなりました。精度はどちらの場合もすべてのセルで20件中15から18件で、モデルが間違ったツールを呼び出すことは一度もなかったため、この規模ではカタログが損なうのは正確性ではなくお金です。MCPコネクタ経由のツールでも同じことが言えます。公開GitHub MCPサーバーを接続した状態で、そのツールセットを遅延させる(default_config: {defer_loading: true})と、同じ精度で実行コストが20%削減されました。
データファイルをプロンプトに入れない
モデルが表に対して計算を行う必要がある場合は、貼り付けるのではなく、Files APIでアップロードし、コード実行でモデルにクエリさせてください。Anthropicは、1,862行の公開CSVに対して25の集計質問15(合計、フィルタ付きカウント、グループ化、日付フィルタ)を行い、正解はpandasで計算しました。
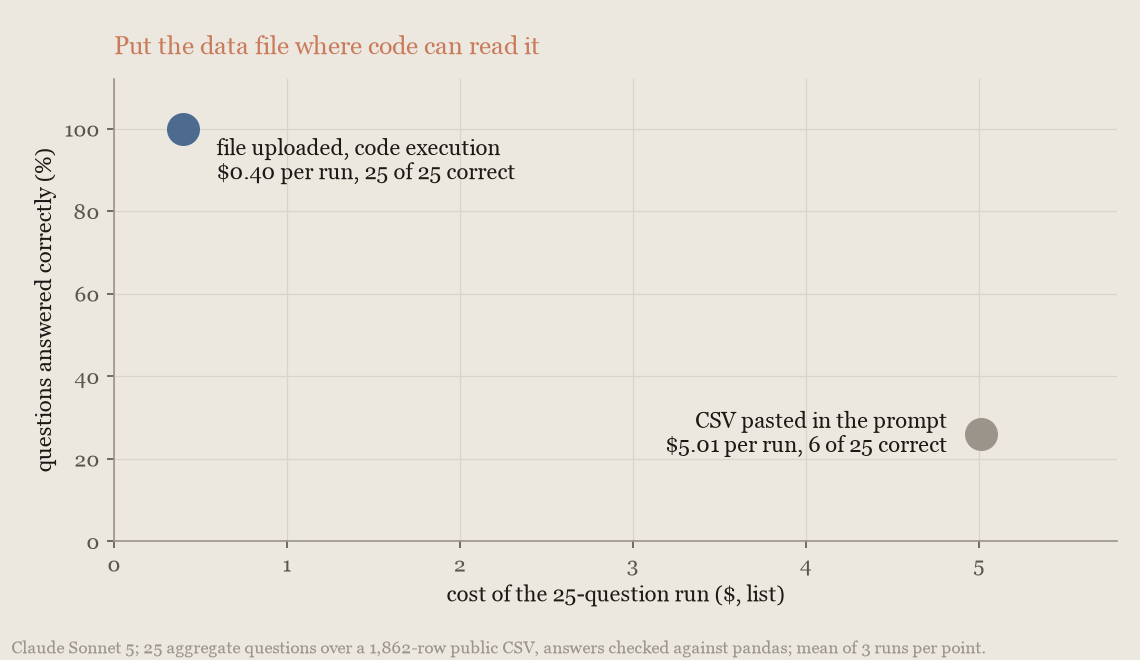
プロンプトに貼り付けると、表は毎リクエスト約91,000入力トークンになり、Claude Sonnet 5は25問中6問に正解しました。アップロードしてコード実行を使うと25問すべてに正解し、実行コストは約12分の1でした。Claude Opus 5も同じパターンを示しました。
コンテキストのライフサイクルを管理する
コンテキストのレバーは、それを必要とするほど長いセッションでのみ効果があります。
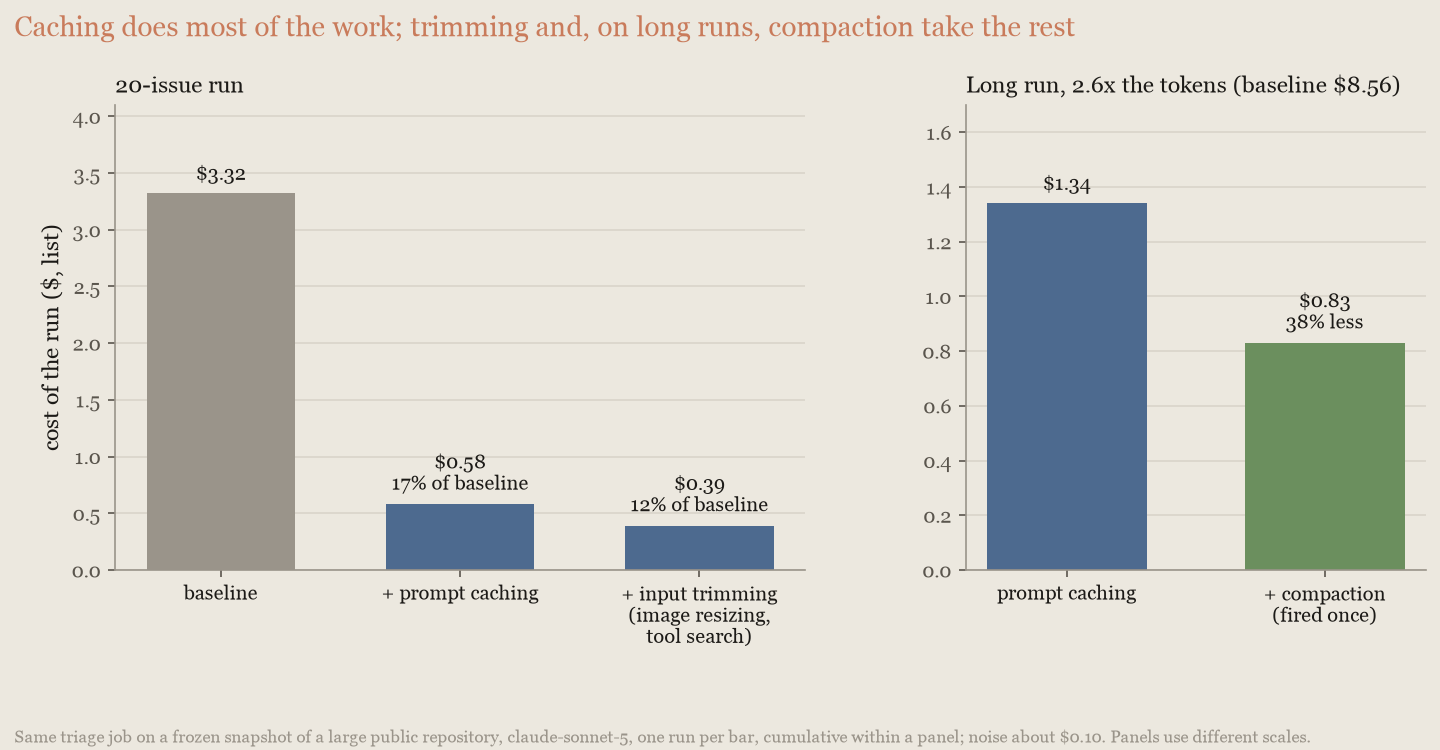
20イシューの実行では何も節約されず、コンテキスト編集は74%高くなりました。長い実行ではプルーニングが39%、コンパクションが32%節約し、コンテキスト編集は何も変えませんでした。プルーニングは自分で書く数行のコードです。各タスクの境界で、大きな古いツール結果を1行の抜粋に置き換えます。編集が会話の末尾、つまり次のタスクがどうせ新しいコンテンツを追加する場所にあるため、キャッシュとの相性が良く、境界後の最初のリクエストで89%、境界間のリクエストで81%のキャッシュ読み取りでした。実行全体では、プルーニングとコンテキスト編集のキャッシュ効率はほぼ同等です。プルーニングのほうが安いのは、プルーニングが削除するコンテンツをコンテキスト編集はタスク途中で再書き込みするため(差の約3分の2)、そしてコンテキストを約半分のサイズに保つため(残りの3分の1)です。コンテキスト編集を使う場合は、少数の大きなバッチでクリアしてください。ハーネスから抜粋したプルーニングは次のとおりです。
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # 抽出結果を短く保つため、単一行の結果に上限を設ける
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extract待てる作業をバッチ処理する
Batch APIは、結果が24時間以内のいつかに届くことと引き換えに、キャッシュ済みのものを含むリクエストのすべてのトークンを50%割引します。誰も待っていないリクエストはすべてバッチ経由にし、残りはインタラクティブな経路に残してください。バッチ処理は、無人のエージェント作業、つまり評価実行、バックフィル、トークントリミングの測定のイシュートリアージエージェントの定期実行のようなスケジュールジョブにとって、キャッシングに次いで2番目に大きな無償のレバーです。このページのインタラクティブ性以外のすべてと組み合わせられますが、設計上インタラクティブであるClaude Managed Agentsのセッションでは利用できません(Claude Managed Agentsの料金を参照)。
現在のモデルに対してプロンプトを監査する
モデルの世代ごとにプロンプトへの反応は異なるため、プロンプトにはもう使っていないモデル向けに書かれたテキストが蓄積していきます。よくあるのは、古いモデルを補うために追加された過度に具体的な指示です。「2回検証せよ」「最大限徹底的に」、必須のステップバイステップ手順、手作りの推論用スクラッチパッドなどです。新しいモデルはこれらを文字どおりに従い、余分なツールラウンドと余分な記述を生み出すため、精度の向上なしに請求額が上がります。今実行しているモデルに対してプロンプトを監査し、モデルを変更するたびに再度監査することは、無償の改善です。
監査はコマンド1つです。Claude Codeに同梱されているClaude APIスキルにはprompt-auditコマンドがあり、プロジェクトのプロンプトとリクエストコードを読み、別のモデル向けに書かれたものを報告します。この短縮した抜粋は、それらのパターンを含むサポートデスクのプロンプトとリクエストコードに対して実行した様子です。
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.コマンドはその後、編集案をdiffとして提示し(1つのハンクを表示)、意図的に手を付けなかったもの、つまり返金期間、トーンの要件、品質基準を一覧します。レビューするのは書き直しではなくパッチです。
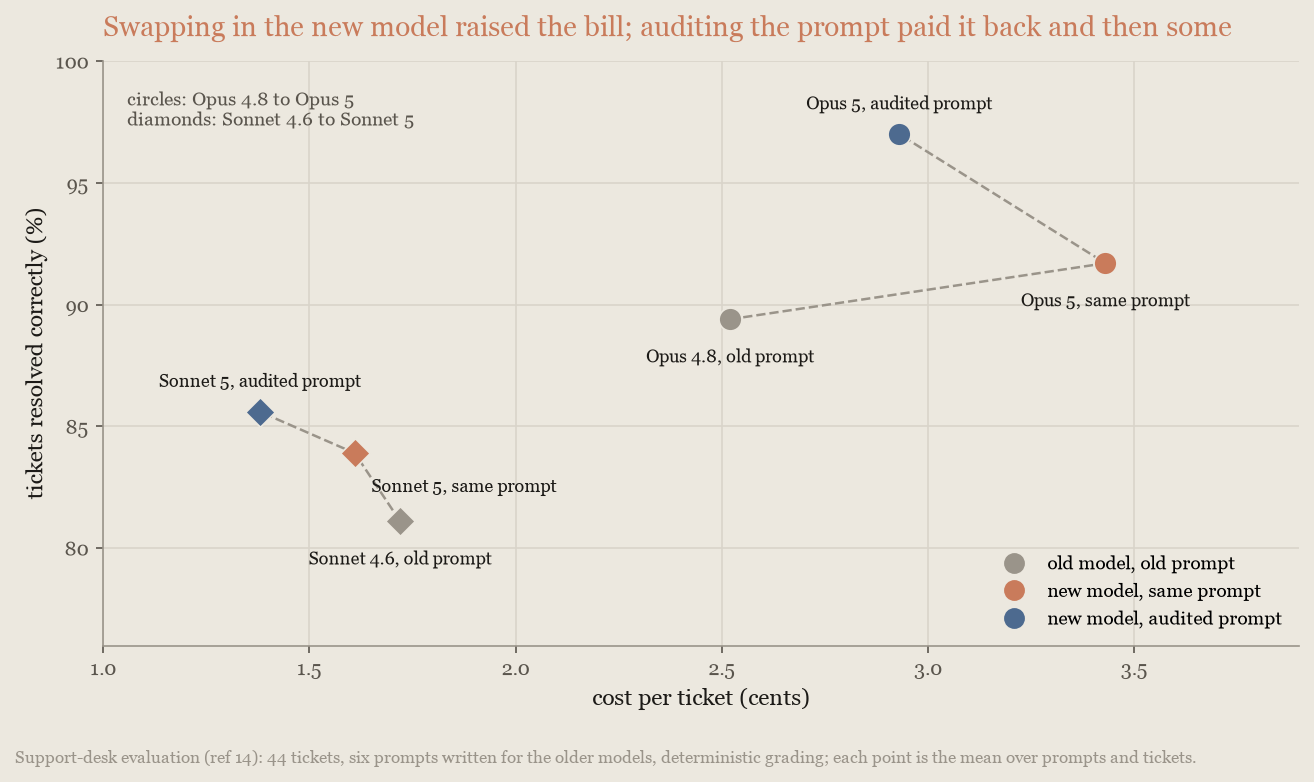
効果は測定可能です。サポートデスクの評価14では、Claude Opus 4.8向けに書かれたプロンプトはClaude Opus 5でチケットあたり36%高くなり、精度は変わりませんでした。同じプロンプトに監査を実行すると、Opus 5は監査前のバージョンより安く(14%)、かつ精度も高く(チケットの97%、92%から上昇、ノイズの範囲外の向上)なりました。Claude Sonnet 4.6からClaude Sonnet 5への移行では、監査により同じ精度で14%削減されました。
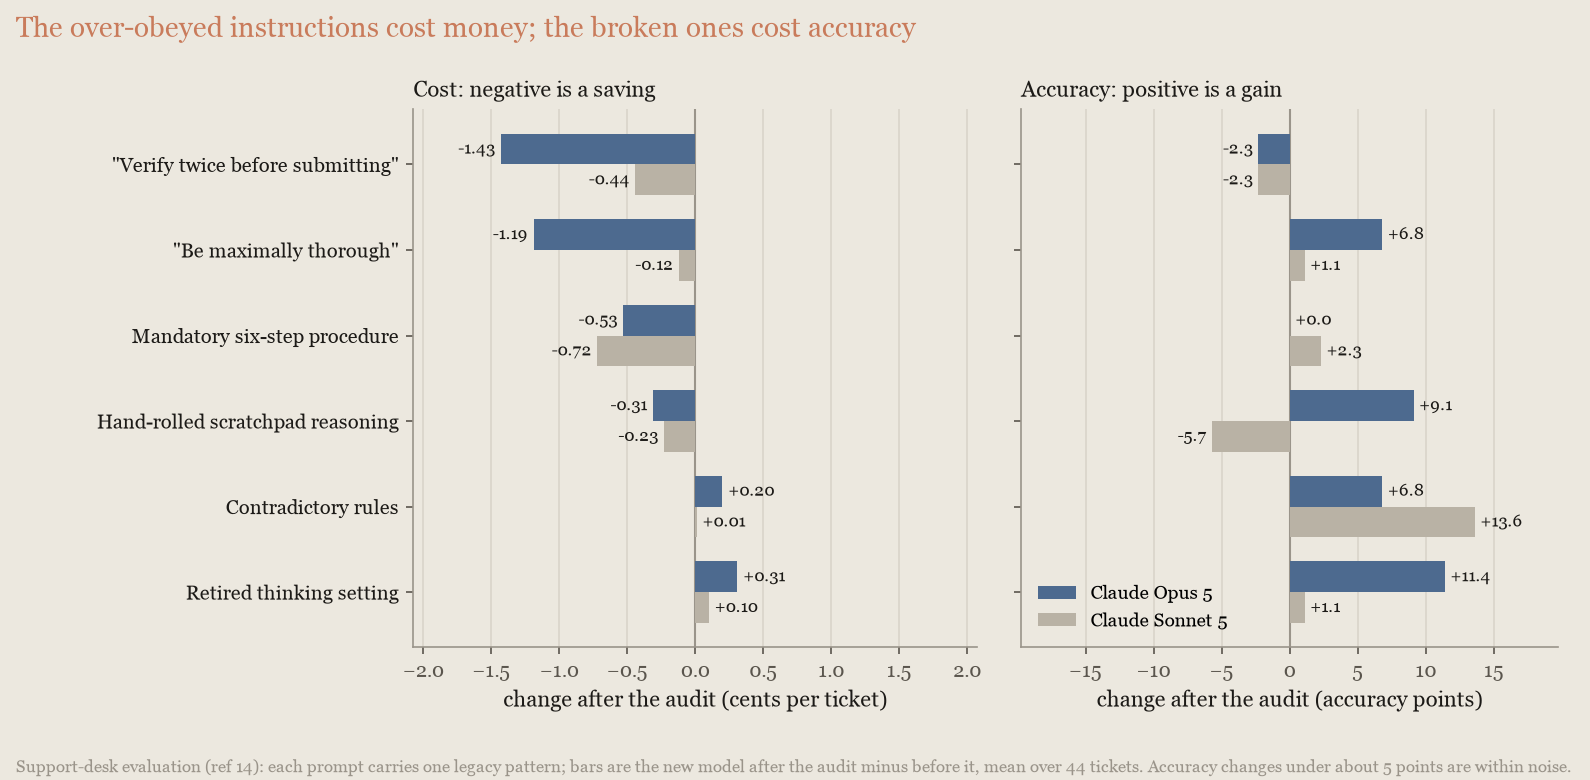
2種類の古いテキストはコストの種類が異なります。新しいモデルが文字どおりに従いすぎる指示はお金がかかります。「2回検証せよ」を削除するとOpus 5のチケットあたりコストが3分の1減り、「最大限徹底的に」を削除してもほぼ同程度でした。モデルに合わなくなったテキストは代わりに精度を損ないます。廃止済みの思考設定、矛盾するルール、モデル自身の思考と衝突する手作りのスクラッチパッドは、削除するとそれぞれOpus 5で7から11ポイントを回復しました。
同じパターンはツールの説明やスキルにも現れがちで、それらも監査する価値があります。
コストとインテリジェンスをトレードオフする
これらのレバーは、単一のモデルがコストとインテリジェンスの間のどこに位置するかを決めます。モデル選択、エフォート、失敗をより高い設定で再実行すること、モデルが作業する範囲となる予算と上限、そして経過時間をモデルが把握できるかどうかです。まず現在のモデルでエフォートのスイープから始めてください(エフォートを調整する)。コストと能力が低い順に、現在のモデルはClaude Haiku 4.5、Claude Sonnet 5、Claude Opus 5.5、Claude Fable 5.1(フロンティアモデル)です。全ラインナップと価格はモデルの概要を参照してください。
タスクあたりのコストでモデルを比較する
価格表はトークンあたりで書かれており、トークンあたりではフロンティアモデルは高価に見えます。Claude Fable 5.1のトークンあたり価格はClaude Sonnet 5の数倍です。しかし支払うのは完了したタスクに対してなので、完了タスクあたりのコストでモデルを比較してください。より高性能なモデルはより少ない作業でタスクを終えます。ターンが少なく、検索が少なく、自身のコンテキストの再読み取りが少なく、後戻りが少なくなります。トークンあたりのプレミアムは、あらゆることを少なく済ませることでしばしば打ち消されます。
AnthropicはこれをSWE-bench Pro3のサブセットで、顧客への課金どおりに価格評価して測定しました。
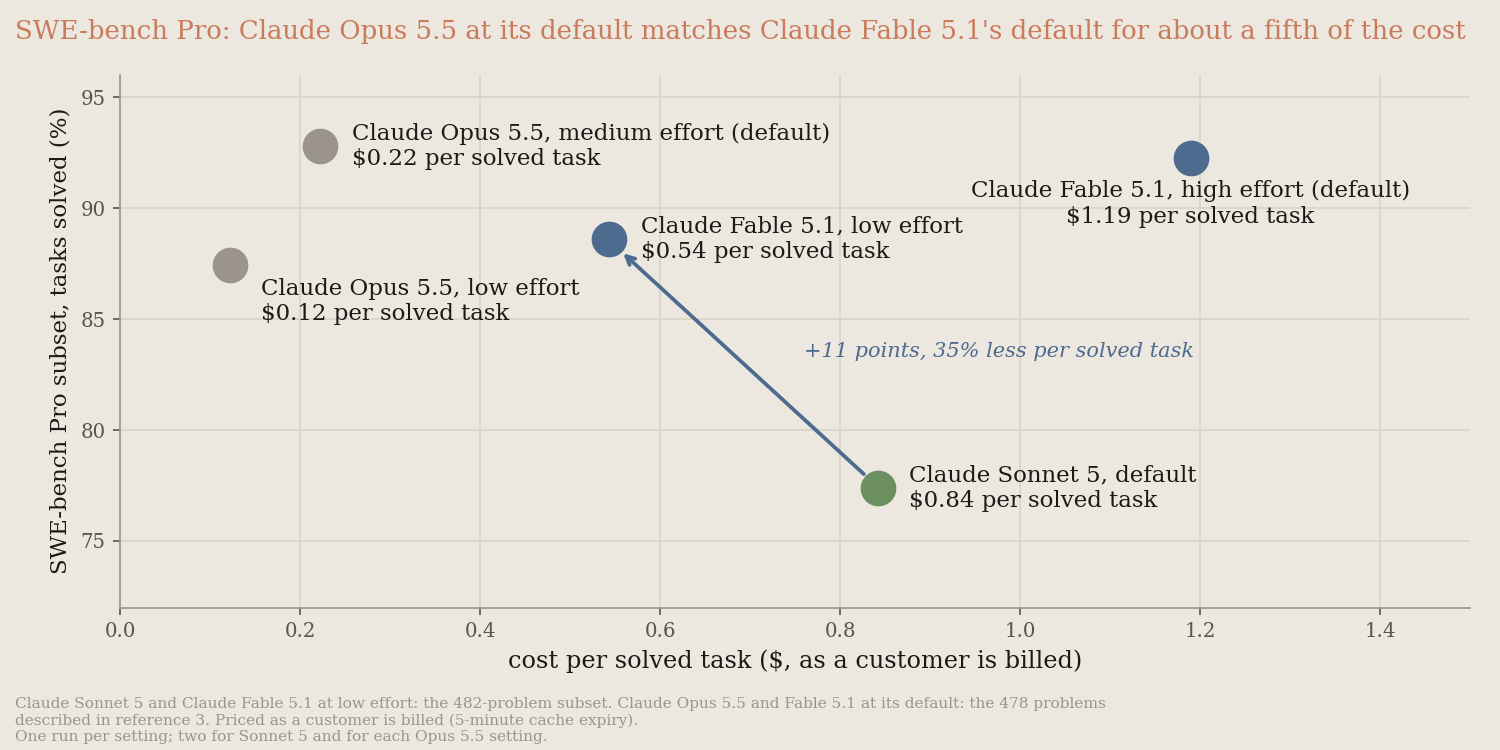
lowエフォートのClaude Fable 5.1は、解決したタスクあたり$0.54でタスクの88.6%を解決しました。一方、デフォルト設定のClaude Sonnet 5は$0.84で77.4%でした。トークンあたりの価格が5倍高いにもかかわらず、11ポイント高く、解決したタスクあたりのコストは35%低くなっています。ただし、常に勝つわけではありません。Claude Opus 5.5とClaude Fable 5.1の両方がほぼ飽和しており、スコアが公開リーダーボードと比較できない同じサブセットでは、デフォルト(medium)のOpus 5.5が、デフォルトのFable 5.1と同等の結果(92.8%対92.3%、実行間のノイズの範囲内)を、解決したタスクあたり約5分の1のコスト($0.22対$1.19)で達成しました。lowでは、Opus 5.5は$0.12で87.4%を解決しました。これらの数値は、参考文献3に記載されている478問を使用しています。また、長いリサーチループでは、フロンティアモデルは作業が少なくなるのではなく多くなります。DeepResearch Bench II7では、lowのFable 5.1はSonnet 5より10ポイント高いスコア(66%対56%)を、タスクあたり約4倍のコスト($4.66対$1.20)で記録しました。より大きなコンテキストに対してより長いリサーチループを実行するためです。同じ基準で、デフォルトのClaude Opus 5はタスクあたり$6.71で71%を記録し、デフォルトのFable 5.1($7.12で65%)を上回りました。したがって、リサーチでもFable 5.1が価格に見合うのはlowの場合だけです。
ほとんどのエージェントワークロードでは、デフォルトのエフォート(medium)のClaude Opus 5.5から始め、高度な推論や長期的なエージェント作業、またはより高いエフォートのClaude Opus 5.5でも評価結果が要件に届かない場合にClaude Fable 5.1を使用してください。前述のとおり、SWE-bench Proのサブセットでは、デフォルトのOpus 5.5は、解決したタスクあたり約5分の1のコストでデフォルトのFable 5.1と同等の結果を出しました。アドバイザー戦略のコーディングベンチマークでは、mediumのFable 5.1の84.2%(Fable 5.1は1回の実行)に対して86.6%を記録し、試行あたりのコストは3分の1未満($0.84対$2.68)でした。グラフ読み取りベンチマークであるChartography13では、lowのOpus 5.5はグラフあたり約$0.03で68.7を記録し、lowのFable 5.1は$0.15で62.5、lowのClaude Opus 5は$0.16で49でした。反対側では、Claude Haiku 4.5はGPQA Diamond9の質問に、Claude Opus 5.5の質問あたりのコストの約5分の1で回答し、精度はOpus 5.5の92%に対して63%で、長いコーディングタスクではさらに大きく後れを取りました。Haiku 4.5は、出力を検証できる大量の作業に適しており、長いエージェントループには適していません。
ランキングはワークロードによって逆転し、どちらに転ぶかは価格表からはわかりません。デフォルトのエフォートのClaude Opus 5.5や、エフォートを下げたフロンティアモデルを含め、すべての候補を自分のトラフィックで完了したタスクあたりのコストで価格評価してください。
中央値ではなくワークロードのテールを価格評価してください。典型的なタスクではなく、最も難しい10分の1のタスクでモデルを比較します。典型的なタスクではどのモデルも似たように見え、最も安いものが最良に見えますが、請求額は安いモデルが失敗するタスクで決まります。失敗したタスクもトークンが課金され、次に再試行が、そして失敗が下流で引き起こすコストが課金されるからです。何も失敗しない場合でも、お金が流れるのはテールです。20問のWideSearch1の実行では、2問が支出の43%を占めました。
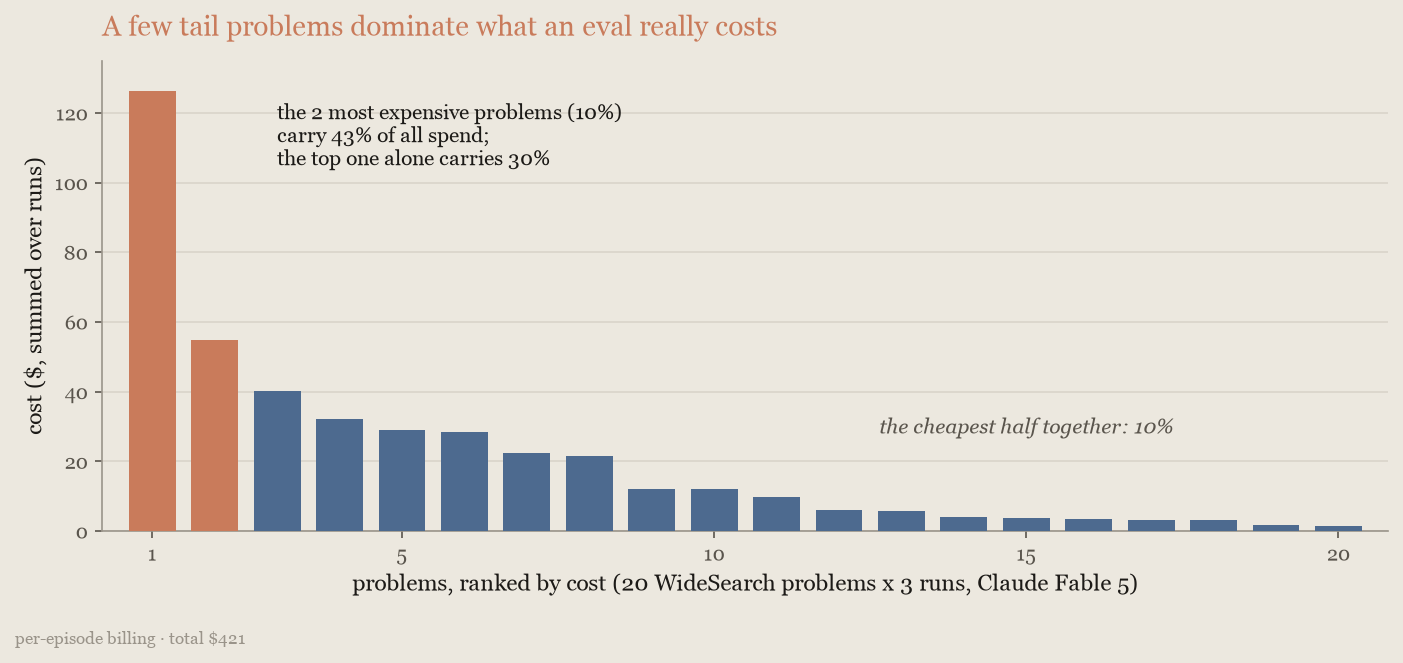
マルチモデル戦略は、残りにフロンティア料金を払うことなく、そのテールにフロンティアのインテリジェンスを費やすために存在します。
モデルをアップグレードする
1つか2つ前のモデルを使っている場合、最も安いレバーはモデル文字列です。Anthropicは最近のClaude Opus、Claude Sonnet、Claude Fableの各モデルを、それぞれ出荷時のデフォルトで定価で価格評価し、SWE-bench Pro3のサブセットで同じハーネスにかけ、OpusのラインをTerminal-Bench 320でも再度実行しました。
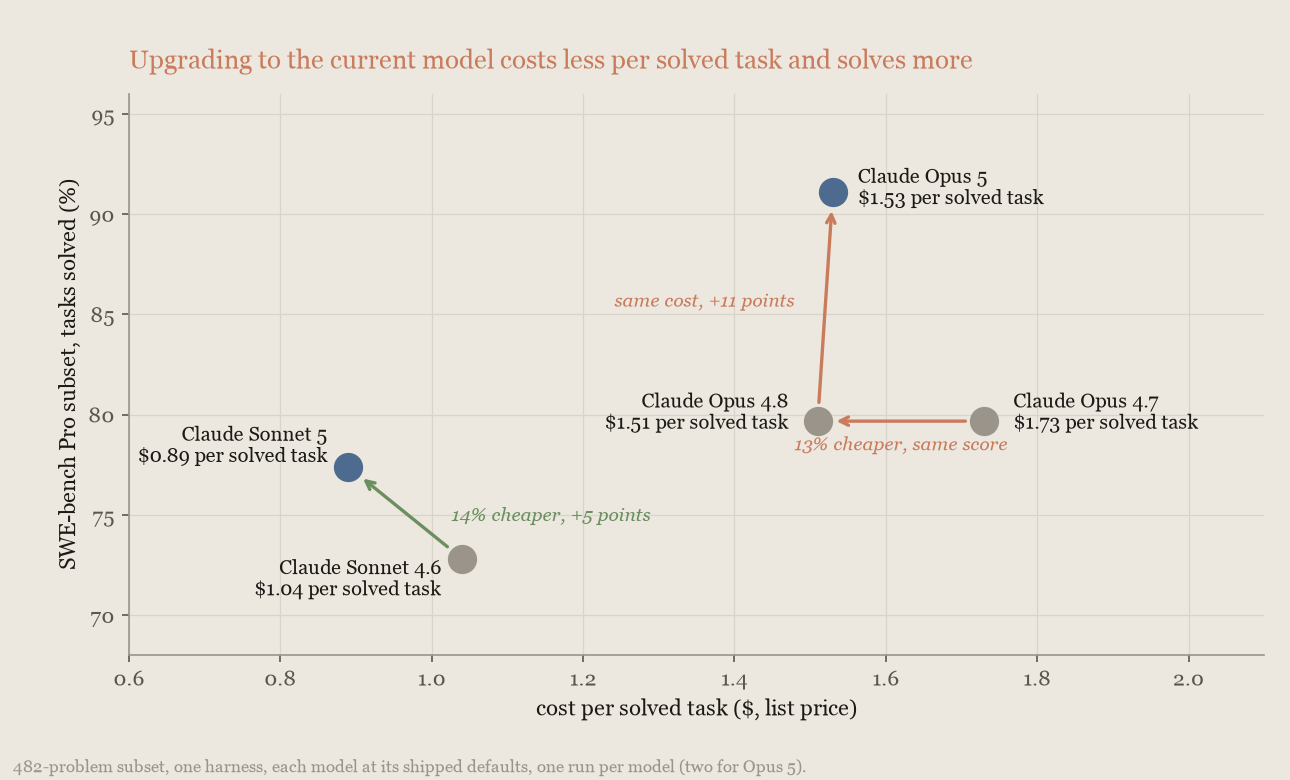
AnthropicはClaude Opus 4.7、Opus 4.8、Opus 5をトークンあたり同一価格にしているため、これらの間の差はすべて各モデルがタスクあたりどれだけ作業するかから生じます。顧客への課金どおりに価格評価すると、Claude Opus 4.8はClaude Opus 4.7と同じ割合のタスクを解決済みタスクあたり14%安く解決し、Claude Opus 5はさらに12ポイント多くのタスクを解決済みタスクあたり21%高く解決します。lowエフォートのClaude Opus 5は、このベンチマークでOpus 4.8のデフォルトを解決済みタスクあたりコストの約30%で上回るため、最も安いアップグレードは新しいモデルを低い設定で使うことです。Sonnet 5の節約はトークンあたり価格の低さから来ており、Sonnet 4.6と比べてタスクあたりに使う追加トークンを十分に相殺します。5ポイント多く、解決済みタスクあたり15%安くなります。フロンティアティアも同じように向上しました。Claude Fable 5.1はClaude Fable 5のスコアに解決済みタスクあたり43%安く並び、その大部分はキャッシュ読み取り価格の低さによるものです。この方向は保証されていません。DeepResearch Bench II7では、同じアップグレードは、すべてのアームでクリーンなタスク(参照7)での2から3ポイントの上乗せに対して、highでタスクあたり41%高く(lowでは79%高く)なります。新しいモデルがそこではタスクあたりより多くの作業をするためです。入力と出力の価格は同じでキャッシュ読み取りは4倍安いので、節約になると決めつける前に自分のワークロードでアップグレードを測定してください。
より難しい作業では差が広がります。タスクが十分に難しく、トークンではなく合格率が請求額を決めるTerminal-Bench 320では、Claude Opus 4.7、Opus 4.8、Opus 5はそれぞれタスクあたり$8から$15を費やしますが、タスクの7%、15%、41%を解決するため、解決済みタスクあたりのコストはラダーを上がるにつれて$183から$63、$28へと下がります。飽和したコーディングサブセットでClaude Opus 5がOpus 4.8に対して持つ21%のプレミアムは、古いモデルがほとんど失敗するTerminal-Bench 3では56%の節約になります。ワークロードが古いモデルを打ち負かすほど、アップグレードは結果あたりでより多く節約します。
トークンあたりではなく解決済みタスクあたりのコストで比較してください。同じテキストはClaude Opus 4.7以降では約30%多くのトークンになるため、トークンあたりの比較では構造的に新しいモデルのほうが高価に見えます。
エフォートを調整する
「effort」(エフォート)は、モデルをタスクに合わせて調整する最も直接的な手段です。effortパラメータは、モデルが行う思考、ツール呼び出し、自己検証の量を制御し、ほとんどのモデルでデフォルトとなっているhighは要求の厳しいタスクに適しています。Claude Opus 5.5のデフォルトはmediumです。コストはそうした活動すべてに応じて増加しますが、精度が向上するのはタスクが必要とする部分に対してのみです。モデルの能力上限を下回る領域では、最も高いエフォートレベルは、タスクが決して使わない深さに対して料金を支払うことになります。
リサーチおよびナレッジワークのベンチマーク(WideSearch1、DeepWideSearch6、BrowseComp4、GDPval2、いずれもClaude Fable 5を使用)では、コストに対する精度の曲線はほぼ平坦です。lowはタスクあたりのコストを3分の1から半分削減する代わりに1〜3ポイントを失い、mediumはデフォルトの約70%〜87%のコストでデフォルトと同等の精度を達成し、デフォルトは4つのいずれにおいてもmediumに対して測定可能な上積みを何ももたらしませんでした。DeepWideSearchでは、lowはClaude Sonnet 5ワーカーを使ったオーケストレーターにも29%低いコストで並びました。つまり、エフォートを下げることがアーキテクチャの変更に勝ったのです。
低いエフォート設定は多くの場合より高速でもあり、これは「latency」(レイテンシ)が制約となる場合に重要です。これらの実行では、DeepWideSearchにおいてlowは1問あたり4.5分かかったのに対し、デフォルトでは7.9分でした。入力がどの単一の「context window」(コンテキストウィンドウ)にも収まらないコーパスベンチマークでは、Fable 5.1はlow、medium、highでそれぞれ1エピソードあたり15.2時間、17.5時間、19.9時間かかりました。
エフォートが実際に精度の向上につながるのは、長期にわたるコーディングです。SWE-bench Pro3でhighと比較すると、Claude Opus 5.5のスコアは、デフォルトのmediumでは約70%のコストで約2.5ポイント低く、lowでは約3分の1のコストで約8ポイント低くなりました。xhighは、highの2.5倍のコストで約1.4ポイント高いスコアでした。これは実際のトレードオフですが、失敗したタスクをより高いエフォートで再実行することで、コスト削減に変えることができます。次のグラフは、リサーチおよびナレッジワークのベンチマークとSWE-bench Proについて、コストに対する精度をプロットしたものです:
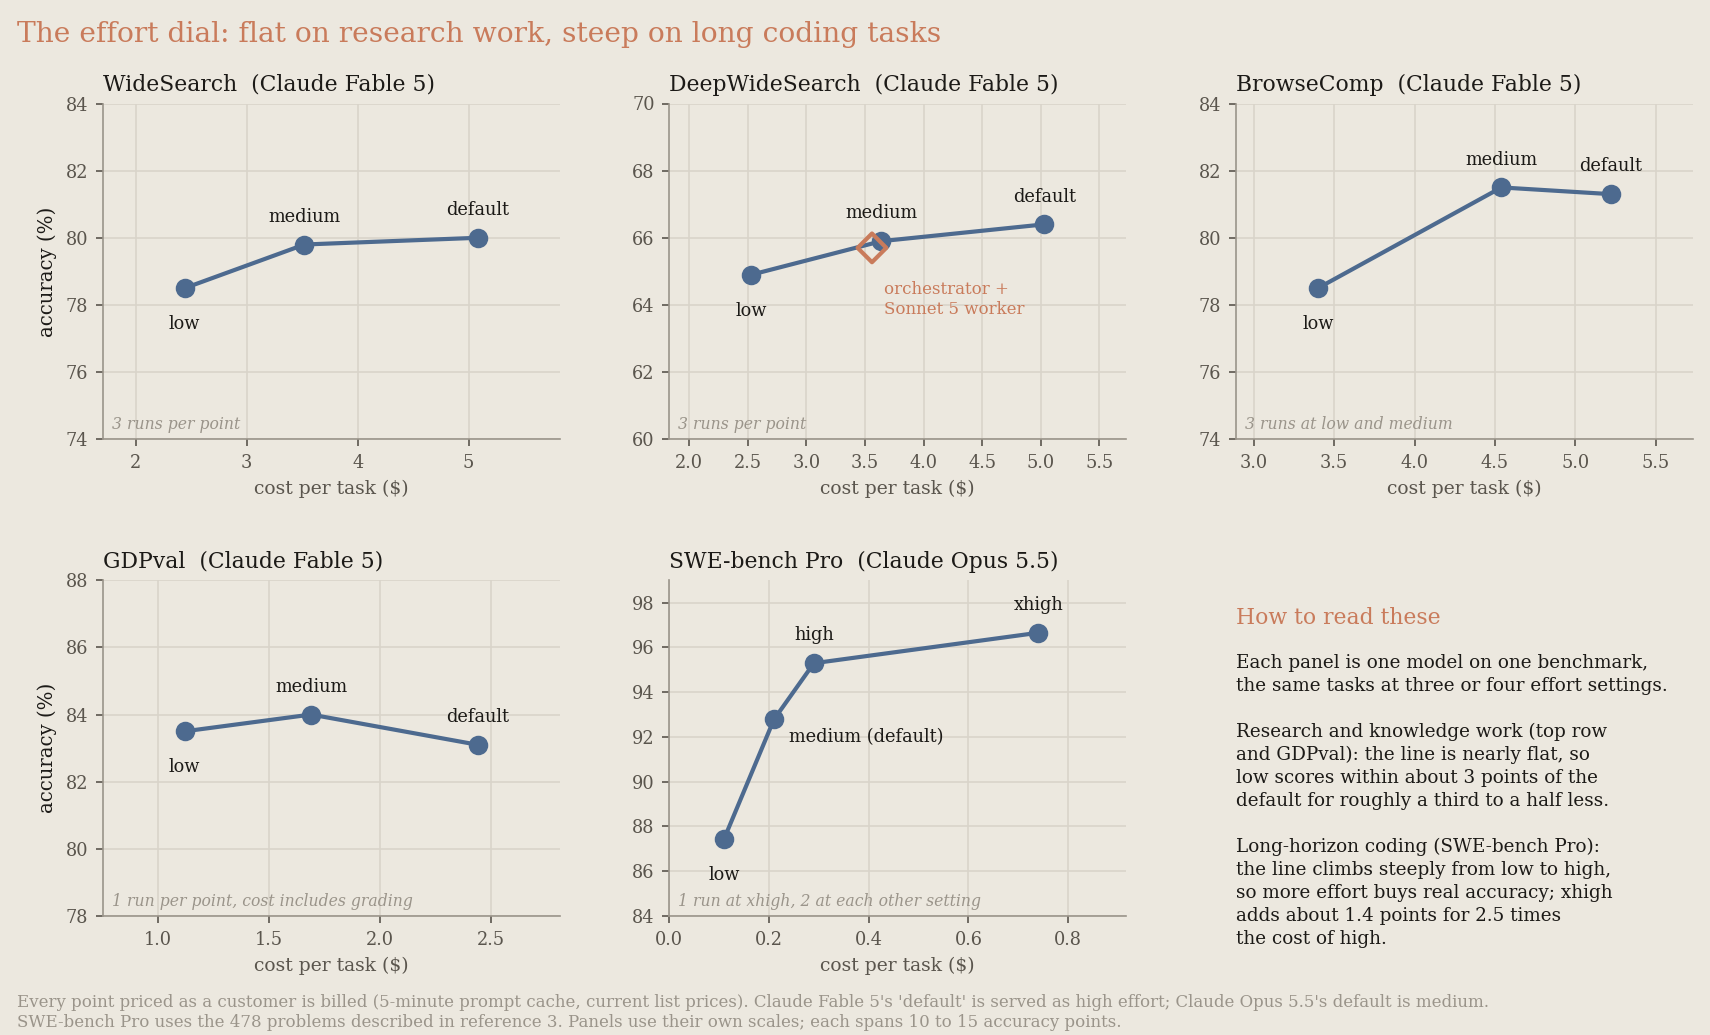
ここから2つの帰結が導かれます。第一に、2つ目のモデルを追加する前に、自分のワークロードでこの曲線を描いてください。これらの社内測定では、デフォルトの単一モデルより安く見えたマルチモデル構成は、同じモデルを低いエフォートで使う場合よりも高くつきました。第二に、この曲線はあらゆるマルチモデル戦略が上回らなければならない単一モデルのベースラインであり、そのため自分のワークロードで測定する手順のステップ2ではエフォートレベル全体にわたってベースラインを取ります。
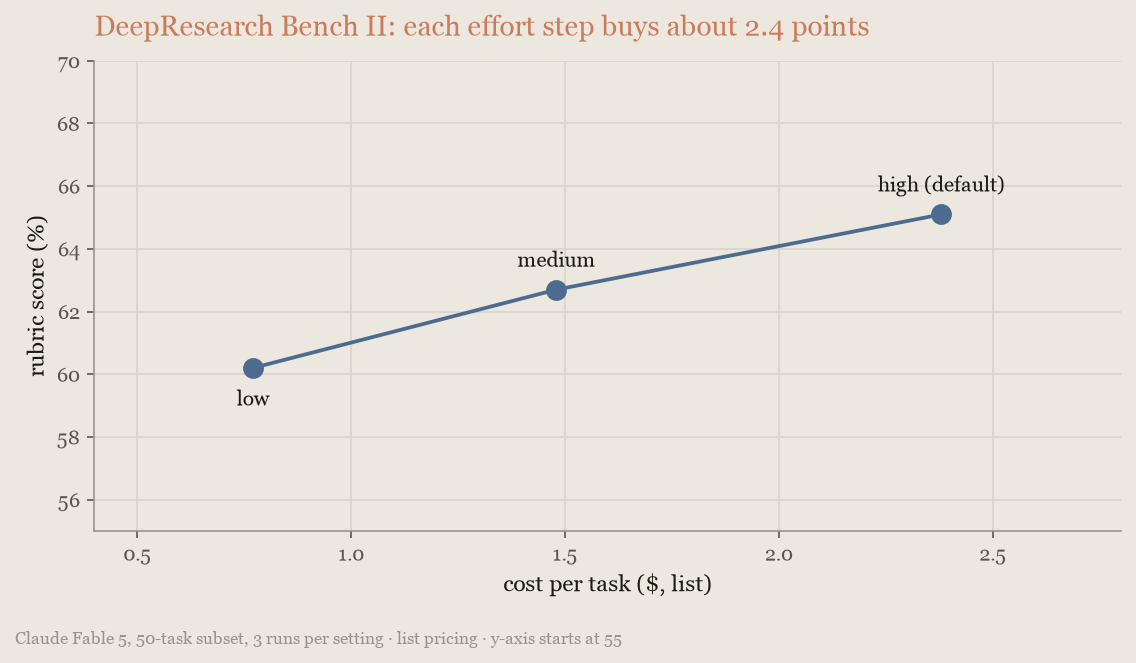
難しい作業が自動的に高いエフォートを必要とするわけではありません。DeepResearch Bench II7では、Claude Fable 5.1はlow、medium、highでほぼ同じスコアを記録した一方、タスクあたりのコストは$4.66から$7.12に上昇しました。つまりこのケースでは、エフォートを上げても出力の品質は目に見えて向上しません。すべての条件で問題なく完了した21タスク(参考文献7)では、Claude Fable 5もエフォート全体で平坦でしたが、各モデル自身の途中で打ち切られた試行を除外したチャートの33タスク基準では上昇しているように見えます。曲線は、前回測定したモデルではなく、実際に出荷するモデルで測定してください。
タスクの説明だけでは、自分のワークロードがどちらの種類かはわかりません。そのため、自分のトラフィックのサンプルで2〜3のエフォートレベルをスイープし、曲線から答えを読み取ってください。各レベルは別々のセッションでテストしてください。セッションの途中でトップレベルのエフォートを変更するとキャッシュが無効になり(繰り返されるコンテキストをキャッシュするを参照)、比較が歪みます。パラメータの詳細については、エフォートを参照してください。
失敗したタスクをより高いエフォートで再実行する
タスクの結果が検証可能な場合、エフォート曲線上で最も安価な方針は固定の設定ではありません。すべてのタスクを低い設定で実行し、失敗したものだけをより高い設定で再実行するのです。
Anthropicは、エフォートを調整するで紹介したSWE-bench Pro3サブセットでのエフォート別の実行結果から、このポリシーの効果をタスクごとに算出しました。lowのClaude Opus 5.5では、13%のタスクが失敗しました。それらをhighで再実行すると、タスクあたり約$0.17で約97%が合格しました。一方、すべてをhighで実行した場合は、$0.29で95.3%でした。失敗した安価な試行のコストを含めても、半分強のコストでわずかに高い合格率を達成しています。mediumから始めた場合は、約$0.24で約97%を解決しました。このわずかな向上の大部分は、2回目の試行によるものです(highで1回実行して失敗したものをhighで再実行しても、スコアはほぼ同じで、コストはより高くなります)。したがって、このポリシーはスコアの向上ではなく、コスト削減のために使用してください:
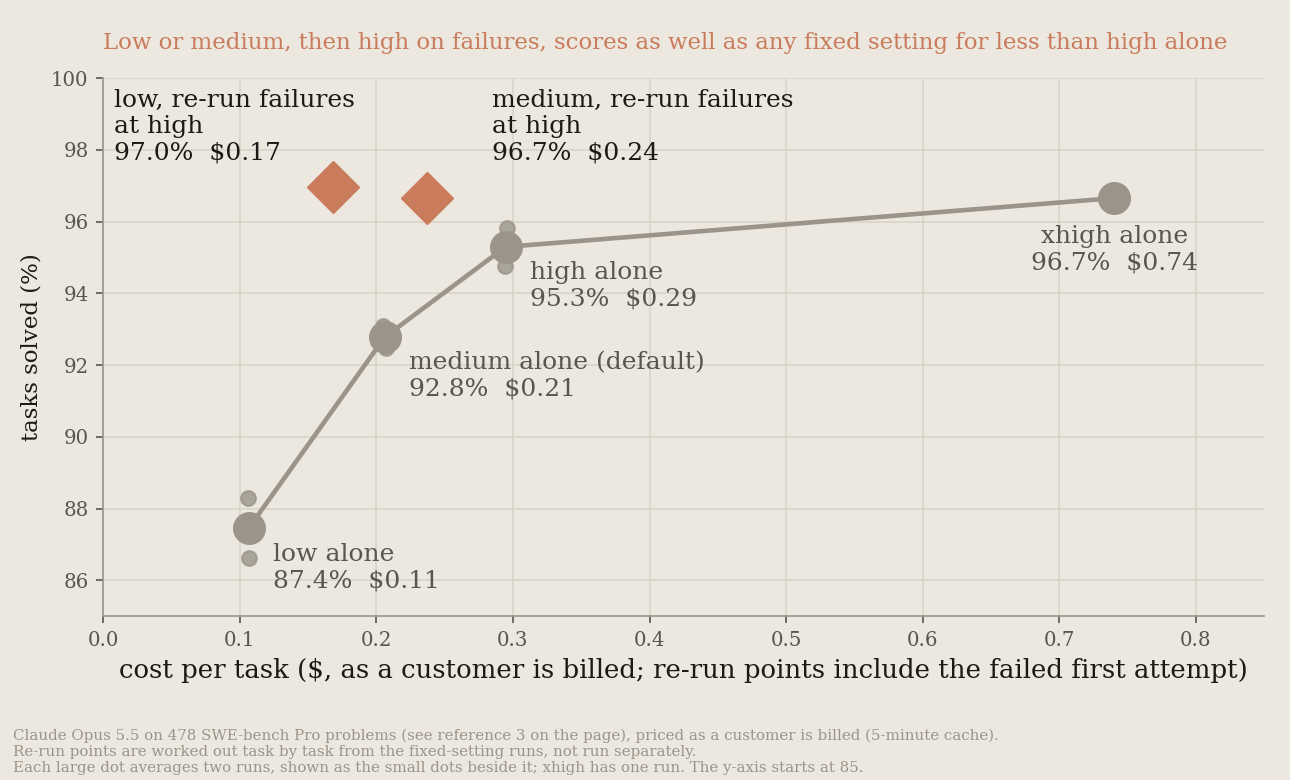
2つの条件があります。第一に、失敗シグナルが必要です(ここではベンチマーク自身のテスト)。不良な成果物を合格させてしまうチェッカーは、それらの失敗を素通りさせます。第二に、初回で失敗したタスクはすべて2回分の実時間を要するため、節約の代償は失敗したタスクにおけるレイテンシとして支払われます。
予算と出力上限を設定する
エージェント型タスクの実行の大半は安価ですが、少数の実行は検索、再検証、過剰なテストに中央値の何倍ものコストを費やします。タスク予算はそのテール(裾)を狙います。モデルはタスク全体に対するリアルタイムのトークンカウントダウンを見て自己調整し、価値の低い検索を削り、冗長な検証を省き、際限なく迷走する代わりに作業をまとめ上げます。
Anthropicは、予算を厳しくしていった際のSWE-bench Pro3における合格率とタスクあたりのコストを、Claude Fable 5.1で測定しました。
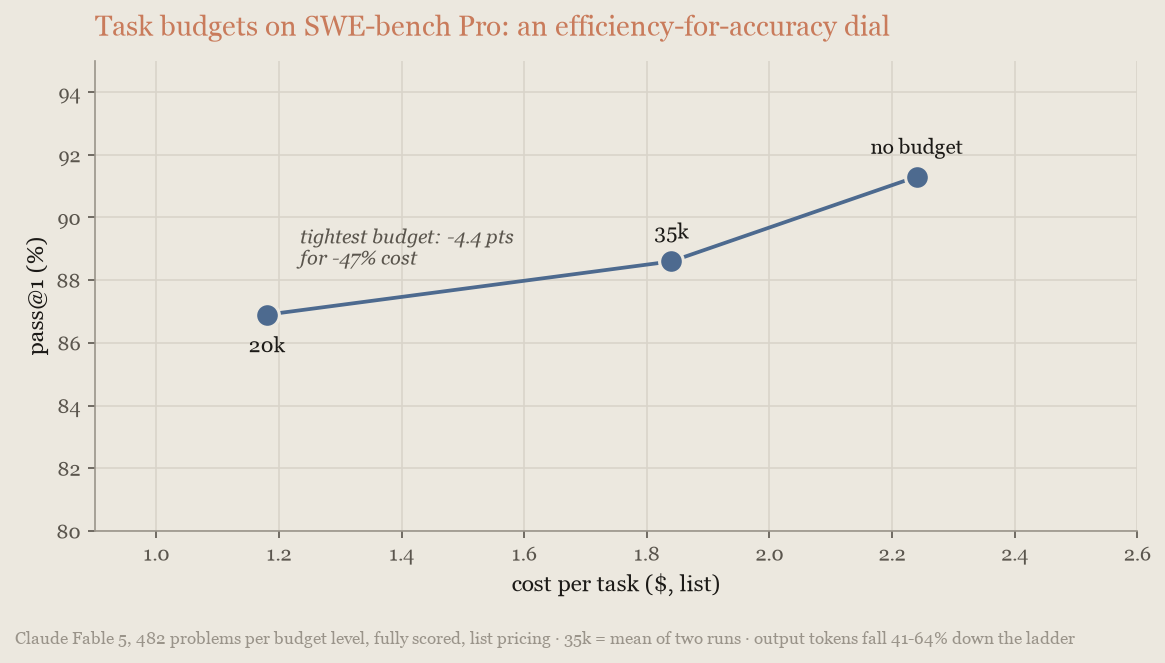
余裕のある予算は、実行間ノイズの境界程度である約3ポイントの合格率と引き換えにタスクあたりのコストを44%削減し、許容される最も厳しい予算は6ポイントと引き換えに58%削減しました。ここでは予算が効率を買いましたが、その代償となる合格率の低下は予算を厳しくするほど大きくなります。
3つの制御手段は3つの異なる役割を果たします。タスク予算は、モデルがそれを見るため、費用を節約します。max_tokensは安全上限です。これを下げると試行あたりのコストは下がりましたが、解決済みタスクあたりのコストは下がりませんでした。Claude Managed Agentsでは、セッション予算がその両方の背後にあるドル建てのハードストップです。3つすべてを設定してください。タスク予算、高めのmax_tokens、そして請求書に決して載せたくない実行のためのセッション上限を設定し、最後の防波堤としてワークスペースの支出制限を置きます。
- タスク予算は最新のモデルでベータ版(ベータヘッダー
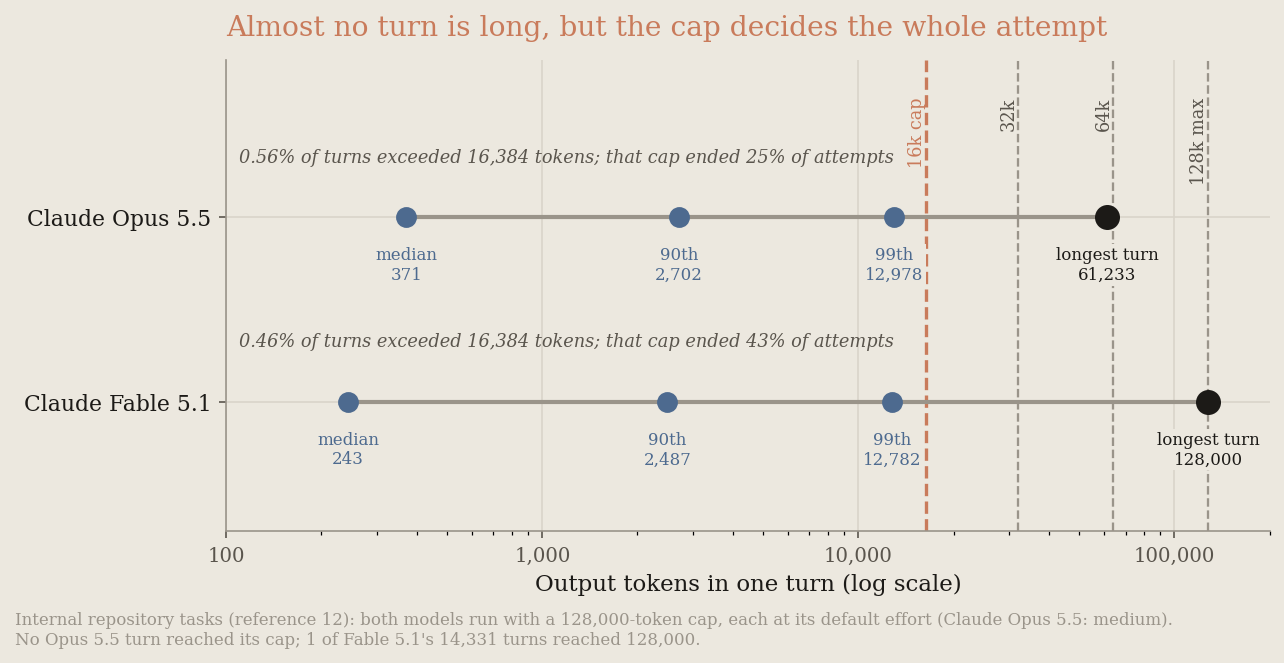
task-budgets-2026-03-13)として提供されています。どのモデルが対応しているかはサポート表を確認してください。ループの90パーセンタイルのトークン使用量付近から始め、そこから厳しくしていきます(その分布の収集方法は予算の選び方に示されています)。現在の下限である20,000トークンを下回る予算は拒否され、非常に厳しい予算は拒否に似た挙動を生むことがあります。タスク途中の変更はキャッシュを無効にするため、予算は最初のリクエストで一度だけ設定してください。予算は助言的なものであり、モデルを停止させるのではなく誘導するものなので、自分のワークロードで遵守状況を検証してください。 max_tokensは単一のレスポンスの上限です。モデルからは見えないため、これを下げてもモデルがトークンを節約するようにはなりません。上限を超える長さが必要だったターンは破棄されますが、料金は請求されます。社内のリポジトリタスクベンチマーク12では、それぞれデフォルトのエフォートで、16,384トークンの上限によりClaude Opus 5.5の試行の約4分の1、Claude Fable 5.1の試行の43%が打ち切られました。上限に達した試行のうち、合格したのはOpus 5.5では66件中1件、Fableでは117件中9件のみでした。上限に達した実行は試行あたりのコストが少なかったものの、解決数もそれに比例して少なくなりました。そのため、解決タスクあたりのコストは64,000の場合とほぼ同じでした(Fable 5.1では$21対$22、Opus 5.5では差が1%以内)。64,000でも、デフォルトのエフォートのClaude Fable 5.1では約14,000ターンのうち2ターンが打ち切られました(Claude Opus 5.5では打ち切られたターンはありませんでした)。また、Fable 5.1が解決したタスクの割合は、36.3%から58.5%に上がりました(参考文献12で説明しているSWE-bench Pro3サブセットの別の抽出では差はなく、どちらの上限でも100件中94件でした)。上限に達した試行を再試行しても、ほとんど効果はありません。同じ上限ではほとんどが再び失敗し、より高い上限では無駄になった試行の分も支払うことになります。エージェント型の作業ではmax_tokensを64,000に設定してください。1回の打ち切りによる損失が大きい場合は、最大値の128,000に設定してください。128,000では、Fable 5.1は解決タスクあたりのコストを変えずに60.0%を解決しました。これほど大きなレスポンスはストリーミングで受信し、stop_reason: max_tokensを失敗として扱ってください。コスト削減には、モデルから見えるエフォートとタスク予算を使用してください。- Claude Managed Agentsのセッション予算はハードストップです。セッション予算は、トークン、検索、セッション時間の定価に基づく、1セッションに対するドル建ての上限です。上限に達するとセッションは
stop_reason: budget_reachedで一時停止し、予算を引き上げると再開します。これはプラットフォームによって強制され、タスク予算がまだ利用できないモデルを含め、定価のあるあらゆるモデルで機能し、助言的なタスク予算と組み合わせられます。デプロイメントは同じフィールドをすべての実行に適用します。
より短い回答を求めてください。Claude Sonnet 5では出力トークンは入力トークンの5倍のコストがかかり、エージェントループではモデルが書いたすべてのトークンが以降のすべてのターンで入力として戻ってくるため、長い回答に対して何度も繰り返し支払うことになります。Anthropicは、同じモデルとツールを使い、3種類の最終回答指示のもとでトリアージジョブをそれぞれ3回実行しました。元の指示は2行を求めていました。
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>短い方のバリアントは1行を求めました。
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.長い方のバリアントは、問題の要約、証拠、重複チェック、推奨ラベル、次のステップという5つの見出し付きセクションからなるメモを求めました。ある1件のissue(スキップされた質問の後にキューに入ったプロンプトが送信されないというもの)について、最初の2つの回答は次のとおりでした。
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.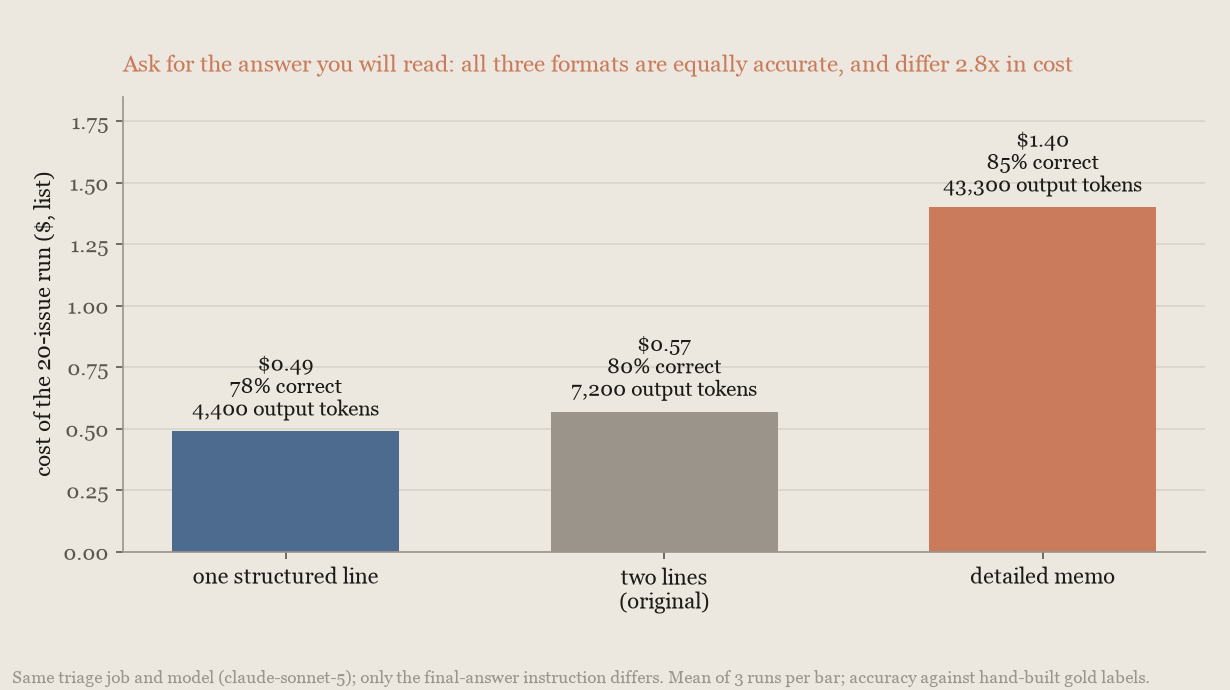
1行の回答は2行の元の形式より出力トークンが39%少なく、1回あたりのコストは14%低くなりました。メモは6倍の出力トークンを使い、1行の回答の2.8倍のコストがかかりました。3つともゴールドラベルに対するスコアは互いに実行間ノイズの範囲内だったため、形式の違いは正答率よりも支払う金額にはるかに大きく表れます。徹底して見える回答ではなく、実際に読む回答を求めてください。
低い方のmax_tokens上限では、どちらのモデルも試行あたりの支出は少なくなりますが、それに比例して解決するタスクも少なくなるため、解決済みタスクあたりのコストはほとんど動きません。
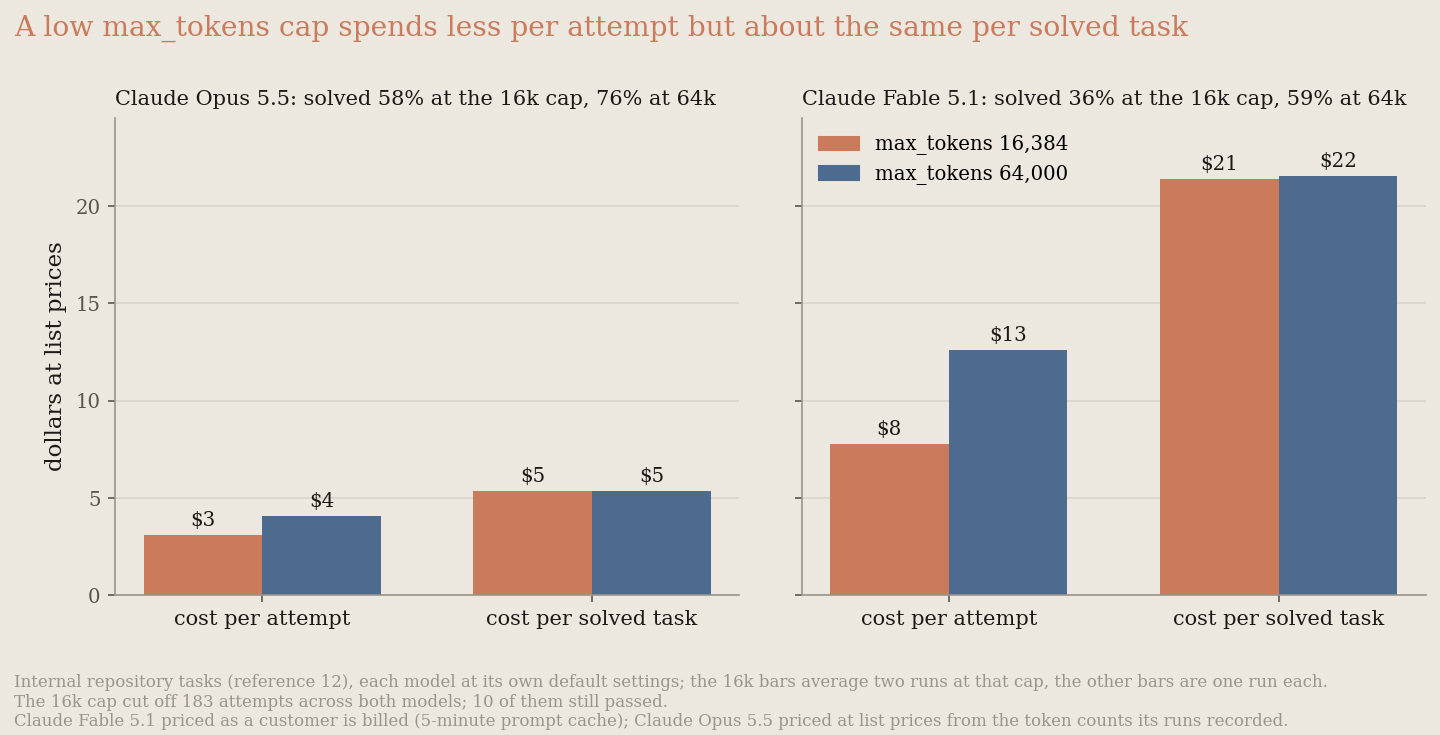
ほぼすべてのターンはどちらの上限よりもはるかに下で終了します。高い方の上限が買うのは、まれに発生する長いターンです。
モデルに経過時間を表示する
エージェントループ内のモデルは、時計を見ることができません。タスク予算は残りのトークン数をモデルに示しますが、デフォルトでは、作業にどれだけ時間がかかったかを示す情報はリクエストに含まれていません。2つの小さな変更で、この情報をモデルに与えることができます。時間が重要であることを伝える2文の指示をシステムプロンプトに追加し、2回目以降のリクエストでは、モデルの各ターンの前に経過時間を送信します。
Anthropicは、highエフォートのClaude Fable 5.1を使用し、両方の変更を組み合わせた効果を測定しました。対象は、2つの公開ベンチマークであるDRACO21とHLE22、および公開ベンチマークCritPt23を基にした研究レベルの物理問題70問からなる社内セットです。このページでは、この社内セットを物理セットと呼びます。3つのセットはそれぞれ2つの形態で実行しました。単一エージェントと、リードエージェントが同じモデルのヘルパーエージェントを起動して並列に作業させるチームです。スコアの変化は、その95%区間が、Anthropicが実行前に設定した限界(DRACOでは1.5ポイント、HLEでは2.5ポイント)内に収まる場合に、許容範囲内とみなします。次のグラフは、各構成について、タスクあたりのコストに対するスコアをプロットしたものです。2行目の棒グラフは、各構成の所要時間を、highエフォートの単一エージェントに対する比率で示しています(リトライの待ち時間は除きます)。3行目は、両方の変更によるスコアの変化を95%区間とともに示しています:
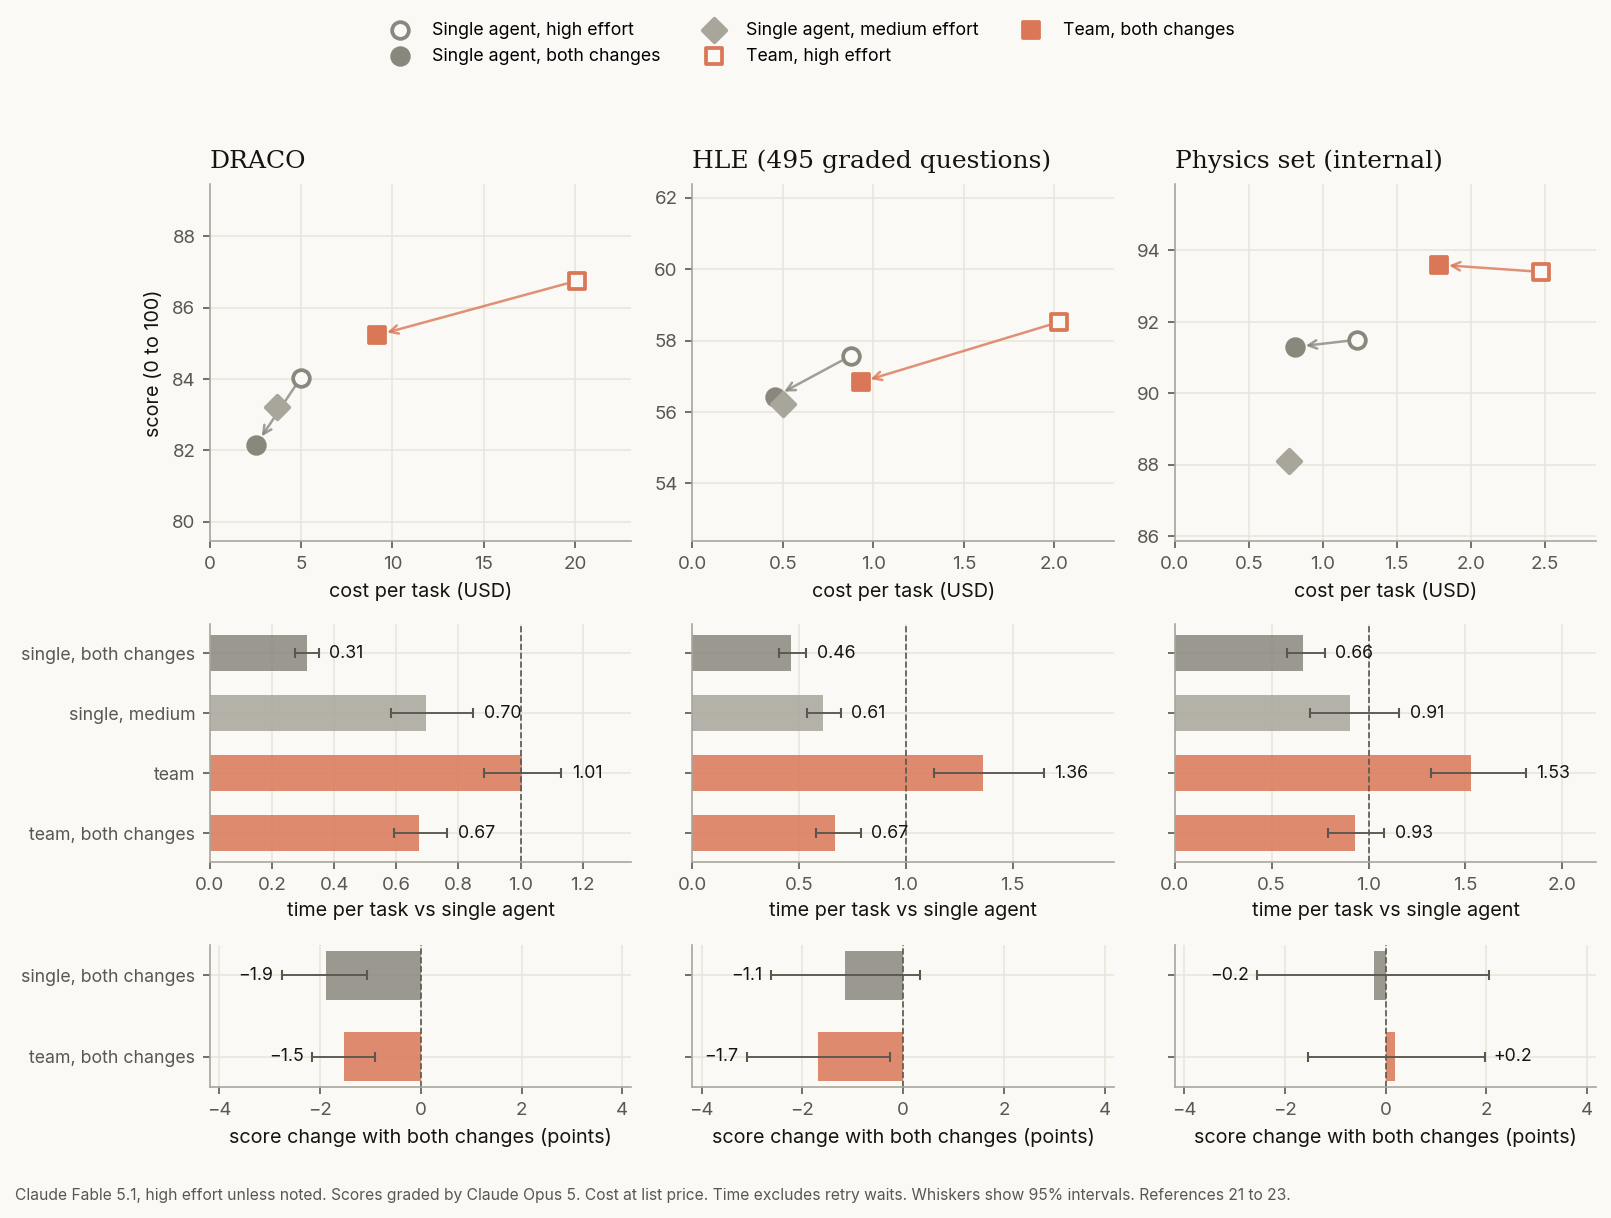
エージェントのチームの場合。 チームは単一エージェントより多くの作業を行うため、デフォルトではコストが高くなります。DRACOでは、チームのコストは単一エージェントの4.0倍で、所要時間はほぼ同じでした(95%区間は12%短い〜13%長い)。すべてのエージェントに指示と時計を与えると、チームの所要時間は33%短くなり、タスクあたりのコストは54%低くなりました。スコアは1.5ポイント低くなりました(95%区間は0.9〜2.1ポイント低い)。この区間の下限である2.1ポイントの低下は、1.5ポイントの許容範囲を超えています。HLEでは、チームの所要時間は51%短くなり、タスクあたりのコストは54%低くなりました。スコアは1.7ポイント低くなりました(95%区間は0.3〜3.1ポイント低い)。この区間の下限である3.1ポイントの低下は、2.5ポイントの許容範囲を超えています。物理セット23では、チームの所要時間は39%短くなりました。タスクあたりのコストは28%低くなりましたが、この削減幅は、リクエスト間でプロンプトキャッシングのキャッシュが期限切れになる頻度に左右されます。期限切れがなければ、削減幅は23%になります。スコアは0.2ポイント高くなりました(95%区間は1.5ポイント低い〜2.0ポイント高い)。
DRACOでは、リードエージェントが起動したヘルパーの数は試行あたり中央値で4つでした。そのため、DRACOの結果は並列に作業するチームの効果を示しています。HLEと物理セットでは、リードエージェントが起動したヘルパーの数の中央値は0でした。つまり、これらのチーム実行の少なくとも半数では、リードエージェントだけが作業していました。これらのチームの結果は、並列ヘルパーの効果ではなく、主にリードエージェント自身の動作を示しています。
単一エージェントの場合。 物理セット23では、同じ変更により、単一エージェントの所要時間が34%、タスクあたりのコストが34%削減されました。スコアは0.2ポイント低くなりました(95%区間は2.5ポイント低い〜2.1ポイント高い)。物理セットでは、エフォートレベルを下げるとコストは削減されましたが、時間が削減されたかどうかは明確ではありませんでした。mediumエフォートでは、単一エージェントのタスクあたりのコストはhighより37%低く、所要時間は9%短くなりました(95%区間は30%短い〜16%長い)。スコアは3.4ポイント低くなりました(95%区間は0.4〜6.8ポイント低い)。この区間の一端はゼロに近い値です。highエフォートで両方の変更を適用すると、単一エージェントの所要時間はmediumエフォートより27%短くなりました(95%区間は5%〜44%短い)。タスクあたりのコストは6%高く(95%区間は12%低い〜27%高い)、スコアは3.2ポイント高くなりました(95%区間は0.1ポイント低い〜6.5ポイント高い)。
HLEでは、同じ変更により、単一エージェントの所要時間が54%、タスクあたりのコストが48%削減されました。スコアは1.1ポイント低くなりました(95%区間は2.6ポイント低い〜0.3ポイント高い)。この区間の下限である2.6ポイントの低下は、2.5ポイントの許容範囲をわずかに超えています。mediumエフォートでは、単一エージェントのタスクあたりのコストはhighより43%低く、所要時間は39%短く、スコアは1.3ポイント低くなりました(95%区間は2.8ポイント低い〜0.1ポイント高い)。highエフォートで両方の変更を適用すると、単一エージェントの所要時間はmediumエフォートより25%短くなりました(95%区間は12%〜35%短い)。タスクあたりのコストは9%低く(95%区間は21%低い〜6%高い)、スコアは0.2ポイント高くなりました(95%区間は1.3ポイント低い〜1.7ポイント高い)。
DRACOでは、同じ変更により、単一エージェントの所要時間が69%、タスクあたりのコストが49%削減されました。スコアは1.9ポイント低くなりました(95%区間は1.1〜2.8ポイント低い)。この区間の下限である2.8ポイントの低下は、1.5ポイントの許容範囲を超えています。mediumエフォートでは、単一エージェントのタスクあたりのコストはhighより25%低く、所要時間は30%短く、スコアは0.7ポイント低くなりました(95%区間は0.1〜1.3ポイント低い)。highエフォートで両方の変更を適用すると、単一エージェントの所要時間はmediumエフォートより53%短く(95%区間は42%〜63%短い)、タスクあたりのコストは31%低くなりました(95%区間は28%〜35%低い)。スコアは1.2ポイント低くなりました(95%区間は0.5〜1.9ポイント低い)。この区間の下限である1.9ポイントの低下は、1.5ポイントの許容範囲を超えています。
3つのセットすべてで、highエフォートで両方の変更を適用した場合のほうが、mediumエフォートよりも多くの時間を削減しました。コストについては、HLEと物理セットでは明確な差がなく、DRACOでは低くなりました。スコアは、HLEではほぼ同じでした。物理セットでは3.2ポイント高くなりましたが、その区間にはゼロが含まれるため、差は明確ではありません。したがって単一エージェントでは、エフォートレベルを下げるよりも、時計を示すほうが多くの時間を削減できます。ただしDRACOでは、両方の変更を適用した単一エージェントのスコアは、mediumエフォートより1.2ポイント低くなりました(95%区間は0.5〜1.9ポイント低い)。
使用すべき場合。
- エージェントの所要時間が重要で、わずかなスコアの変化を許容できる場合は、両方の変更を使用してください。測定したすべての構成で、チームと単一エージェントのどちらでも、所要時間とタスクあたりのコストが削減されました。
- 導入する前に、自分のタスクでスコアを確認してください。DRACOでは、スコアはチームで1.5ポイント、単一エージェントで1.9ポイント低くなりました。HLEでは、チームで1.7ポイント、単一エージェントで1.1ポイント低くなりました。物理セットでは、どちらのスコアの変化もゼロとの明確な差はありませんでした。
- 時間を節約するためにエフォートレベルを下げることをすでに検討している場合は、時計を示す方法と比較してください。
highエフォートで両方の変更を適用した単一エージェントは、mediumエフォートより所要時間が短くなりました。DRACOでは53%、HLEでは25%、物理セットでは27%短くなっています。タスクあたりのコストは、DRACOでは31%低く、HLEと物理セットでは明確な差はありませんでした。
追加方法。 すべてのエージェントのシステムプロンプトの先頭に、次の指示を配置します:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.2文目は、時計のメッセージが送られてくることをモデルに伝えます。最初のリクエストには時計は含まれません。測定した実行では、この文言をそのまま使用しました。
次に、エージェントの2回目以降の各リクエストの前に、会話途中のシステムメッセージを追加し、Elapsed time: 412 secondsのように経過時間を整数の秒数で示します。経過時間は、エージェントの開始時点からではなく、タスクの開始時点から数えてください。チームでは、すべてのエージェントが同じ時計を参照します。そのため、ヘルパーが最初に見る時計には、そのヘルパーが起動する前にチームが費やした時間がすでに含まれています。ツールループでは、ツール結果の後の配置に示すように、ツール結果を含むuserメッセージの直後にこのメッセージを配置します。代わりにエージェントに新しいuserメッセージを送信する場合は、そのメッセージの後に時計を配置します。
以前の時計メッセージは削除せずに残してください。各メッセージは会話履歴の一部になるため、次のリクエストでもキャッシュされたプレフィックスが一致します(プロンプトキャッシングとの組み合わせを参照)。Anthropicが測定したのは、モデルから見え続けるこれらの通常のシステムメッセージです。ターンスコープのシステムメッセージを使うと、モデルには最新の時計だけが表示されますが、Anthropicはこの形式を測定していません。
次の例では、両方の変更を適用して、1つのエージェントのツールループを実行します。ツール結果の後に時計を追加し、クライアントツールのみを処理します:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # 実時間(wall-clock)の秒数です。他プロセスのヘルパーもリードの開始時刻を共有できます。
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # 128,000トークンの上限は非ストリーミングリクエストには大きすぎるため、ストリーミングを使用します。
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # システムメッセージはユーザーターンの後に置く必要があるため、時刻はツール結果の後に配置します。
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1は、会話途中のシステムメッセージをサポートしています。その他のモデルについては、サポートされているモデルの一覧を参照してください。Claude Sonnet 5のようにこの機能をサポートしていないモデルでは、userターン内の最後のtool_resultブロックの後にテキストブロックを追加し、そこに同じ行を配置できます。Anthropicが測定したのは、システムメッセージ形式のみです。
Claude Managed Agentsでは、ツール結果またはユーザーメッセージとともにsystem.messageイベントを送信できます。このメッセージは、そのターンと以降のすべてのターンに適用されます。そのため、ウェブ検索などのプラットフォームの組み込みツールに続くターンでは、現在の時刻ではなく、最後に送信した時計が表示されます。また、system.messageはセッションのプライマリスレッドにのみ届きます。マルチエージェントセッションでは、プライマリスレッドはコーディネーターのスレッドです。そのため、この方法で送信した時計がワーカーエージェントに表示されることはありません。すべてのターンの前に、チーム内のすべてのエージェントに現在の時刻を示すには、Messages APIでエージェントループを自分で実行してください。
モデルを組み合わせる
マルチモデルアーキテクチャは、タスクの複雑さが十分にばらついており、異なるステップに異なるモデルが最適となるワークロードに適しています。トラフィックに、小さなモデルが確実に処理できる定型作業と、フロンティア級の能力を必要とする難しいステップが混在している場合、作業を分割することで、フロンティアの知能を重要な箇所に残しつつ、大半のトークンを小さなモデルの料金で課金できます。難易度が均一である、あるいは1本の依存関係の連鎖であるといった理由でワークロードにその混在がない場合は、通常、よく調整された単一モデルの方が良い選択です。各戦略のセクションでは、この2つのケースを見分けるためのルールを示します。
2つの戦略でほとんどのワークロードをカバーでき、両者はどのモデルがメインループを保持するかで異なります。
| 戦略 | 制御フロー | フロンティアモデルの役割 | 適するケース | フロンティアのコストが比例するもの |
|---|---|---|---|---|
| アドバイザー | 小さなモデルがループを実行し、必要に応じてエスカレーションする | 計画と修正について相談を受ける | 部分的に難しい直列の作業。たとえば、少数の本当の判断の間に多数のターンがあるコーディングエージェント | エグゼキューターが行き詰まる頻度 |
| オーケストレーター | フロンティアモデルがループを実行し、大量の作業を委任する | 計画、ディスパッチ、統合を行う | 本当に独立したファイル、ドキュメント、ケースにわたってファンアウトする作業。特にコンテキストウィンドウ1つ分を超える場合 | 各部分の調整の難しさ |
アドバイザー戦略:難しい判断をエスカレーションする
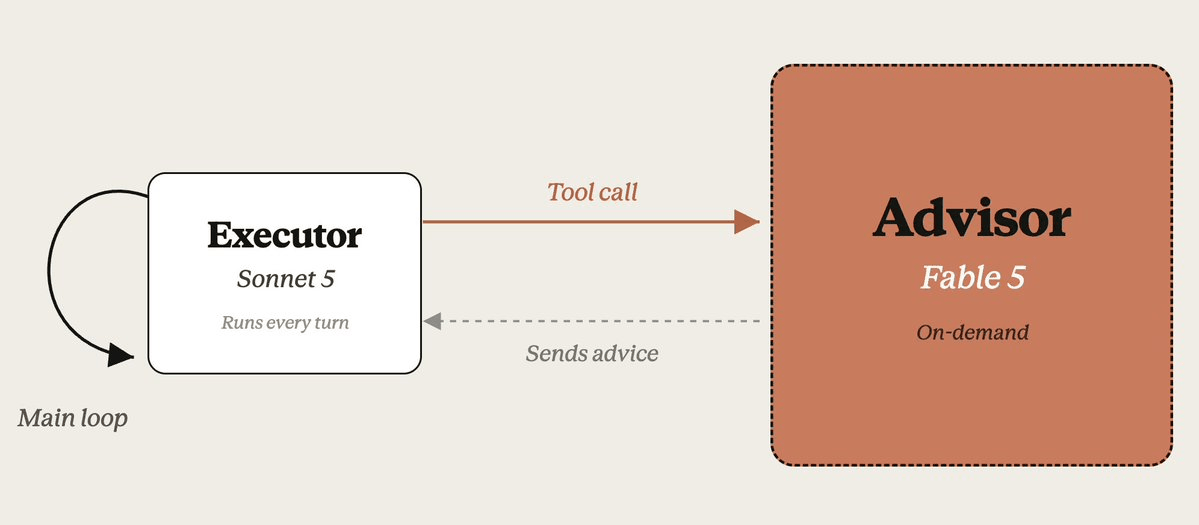
アドバイザー戦略では、低コストのエグゼキューターモデルがエージェントループを実行し、大半のターンを処理します。アプローチの選択や失敗からの回復など、より深い判断を要する決定に突き当たると、より高い知能を持つアドバイザーモデルを呼び出して戦略的な指針を得てから続行します。大半のトークンはエグゼキューターの料金で課金され、時折の相談だけがアドバイザーの料金で課金されます。
これを使うには、リクエストにアドバイザーツールを追加します。このベータ機能は戦略全体を1回の/v1/messagesリクエスト内でサーバー側で実行します。エグゼキューターがツール呼び出しを発行し、Anthropicがアドバイザーの推論を実行し、エグゼキューターがその助言を受けて続行します。オーケストレーションコードを書く必要はありません。Claude Managed Agentsでは、エージェントのmultiagentロスターにadvisorエントリを追加することでセッションにアドバイザーを与えます。セッションのプライマリスレッドは同じ方法でそれに相談します。Claude Codeもこれをサポートしています。アドバイザーツールで難しい判断をエスカレーションするを参照してください。
見返りを決めるもの。 アドバイザーはエグゼキューターの呼び出しを通してしかタスクを見ないため、どれだけ役立つかは2つの要素で決まります。
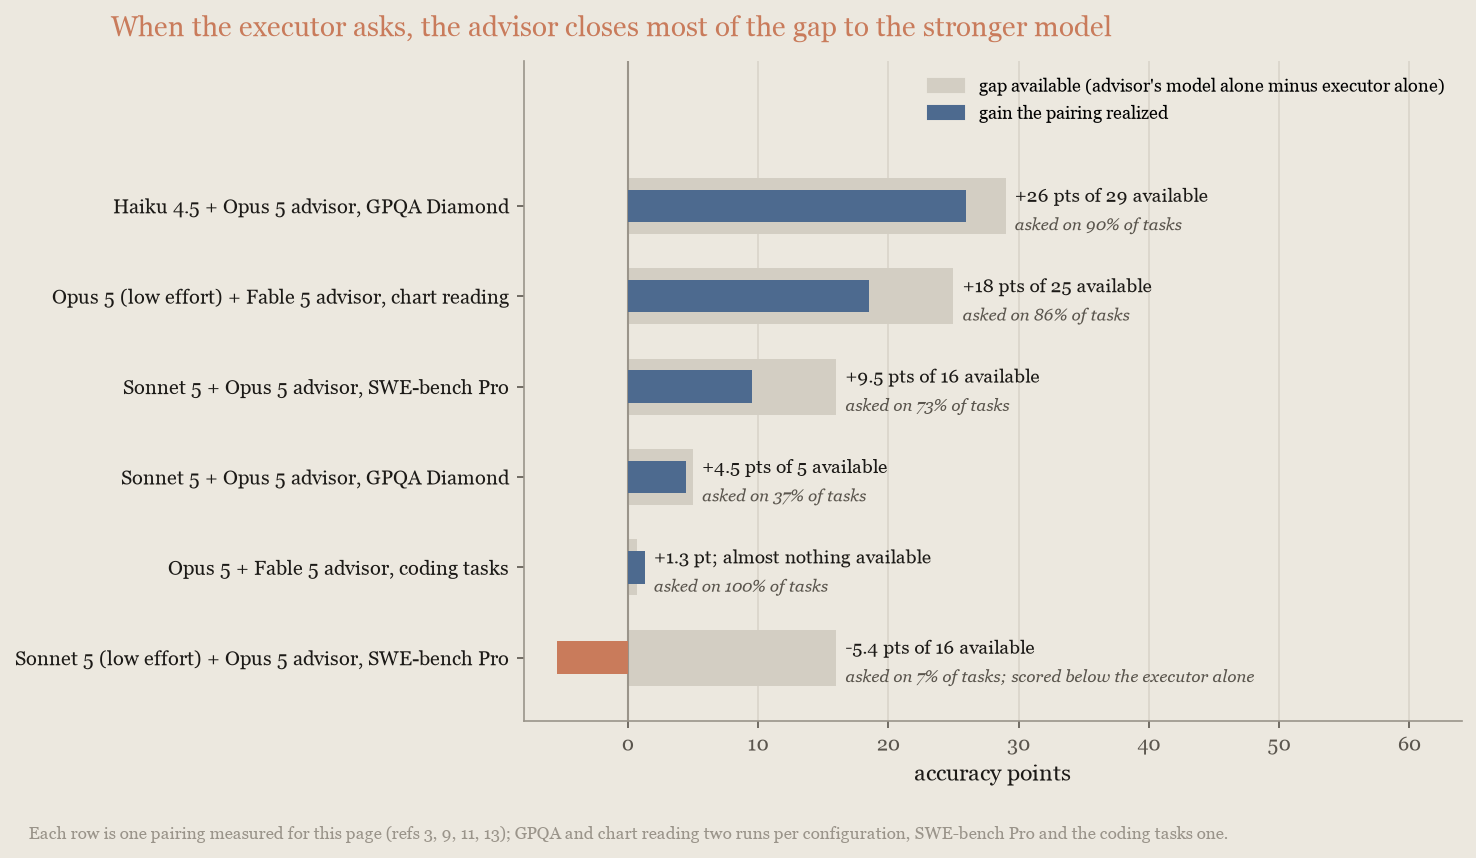
1つ目はモデル間のギャップです。アドバイザーが渡せるのはエグゼキューターに欠けている能力だけです。GPQA Diamond9では、Claude Haiku 4.5エグゼキューターはClaude Opus 5アドバイザーから大きな恩恵を受け、Claude Sonnet 5エグゼキューターは数ポイントを得、フロンティアエグゼキューターはほとんど何も得ませんでした。
2つ目は、そして脆いのはこちらですが、エグゼキューターが実際に尋ねるかどうか(相談率)です。低いエフォートのエグゼキューターは、自分が行き詰まっていることを検知しなくなることがあります。デフォルトのエフォートでは大半のタスクで相談するペアリングが、エフォートを下げるとほとんど相談しなくなり、その結果エグゼキューター単独よりも低いスコアになることがあります。この率はタスクによっても変わります。DeepSWE10では低エフォートのSonnet 5エグゼキューターは尋ね続けて23ポイントを得ましたが、SWE-bench Pro3では同じエグゼキューターが尋ねるのをやめました。エグゼキューターが実際に尋ねる場合、ギャップの多くを取り戻します。次のチャートのペアリングのうちエグゼキューターが尋ね続けたものでは、アドバイザーはより強いモデルとのギャップの少なくとも半分を埋め(コーディングのペアリングはより強いモデルを完全に上回りました)、しかもより強いモデルに支払うのは相談の分だけです。これがコスト面での成立を可能にしています。
相談率はプロンプトによって変わります。ツールの組み込みの説明だけでは、特にコーディング作業において、エグゼキューターの呼び出し回数が不足します。そのためアドバイザーツールのドキュメントでは、実質的な作業の前に1回、完了前に1回の呼び出しを求めるシステムプロンプトを紹介しています。これにより、呼び出しはタスクあたり約2〜3回になります。次に紹介するコーディングのペアリングでは、Claude Opus 5をエグゼキューターとした場合、この頻度で相談が行われ、すべてのタスクで約2回相談しました。Claude Opus 5.5をエグゼキューターとした場合は、試行あたり約1.4回アドバイスを求め、試行の4%ではアドバイスを受けませんでした。同じページでは、呼び出しが不足しているエグゼキューターに相談を促す方法や、コストを抑えるためにクライアント側で呼び出し回数に上限を設ける方法も説明しています。相談率には注意を払ってください。プロンプトで相談を促し、相談率を測定し、相談率が急落した場合はエグゼキューターのエフォートを元に戻してください。
コスト面で有利になる場合。 アドバイザーの料金で請求される数回の短い相談が、タスク全体をアドバイザーのモデルで実行する代わりになる場合、アドバイザーはコストを削減します。この効果は、アドバイザーのモデルの価格がエグゼキューターよりも大幅に高い場合に最も大きくなります。そのため、最もコスト効率の高い構成は、中位層のエグゼキューターにフロンティアモデルのアドバイザーを組み合わせることです。最上位層のモデル同士のペアリングでも、アドバイスのコストの一部を回収できます。アドバイスによってエグゼキューターのトークンも節約されるためです。正しいアプローチを教えられたエグゼキューターは、行き止まりを探索することが少なくなります。以下で紹介する、Claude Opus 5をエグゼキューターとするコーディングのペアリングでは、この節約によってアドバイスのコストの約半分がまかなわれました。エグゼキューターの試行あたりのコストは、デフォルト設定のOpus 5単体より$1.26少なく、相談のコストは$2.47でした。Claude Opus 5.5をエグゼキューターとした場合、アドバイスによるエグゼキューターのコスト削減はほとんどありませんでした。試行あたりのコストは$1.36で、highのOpus 5.5単体の$1.38とほぼ同じであり、相談のコストは$1.55でした。
シンプルなAPIエージェントで実行した社内のエージェント型コーディングベンチマーク11では、Claude Fable 5.1をアドバイザーとするhighのClaude Opus 5.5エグゼキューターが、試行あたり$2.92で90.1%のスコアを記録しました。これは、エグゼキューター自身の設定であるhighのOpus 5.5単体より1.7ポイント高く、コストは約2.1倍です。この差は、タスクあたり5回の試行における実行間のノイズの範囲ぎりぎりです。デフォルトのmediumのOpus 5.5と比べると、約3.5倍のコストで3.5ポイント高くなります。この結果はOpus 5.5自身のエフォート曲線のほぼ上に位置します。つまり、アドバイザーで得られる効果は、エフォートを上げた場合とほぼ同じです。xhighのOpus 5.5単体は、試行あたり$4.11で91.1%のスコアでした(タスクあたり1回の試行)。8月の測定では、Claude Opus 5エグゼキューターにClaude Fable 5.1アドバイザーを組み合わせた構成が、測定した中で最も精度の高い構成でした。そのコストは試行あたり$6.21で、Opus 5.5のペアリングの2倍強です。次のグラフは、Opus 5.5のペアリングを、Opus 5.5自身のエフォート曲線および8月に測定したClaude Fable 5.1のエフォート曲線と比較したものです:
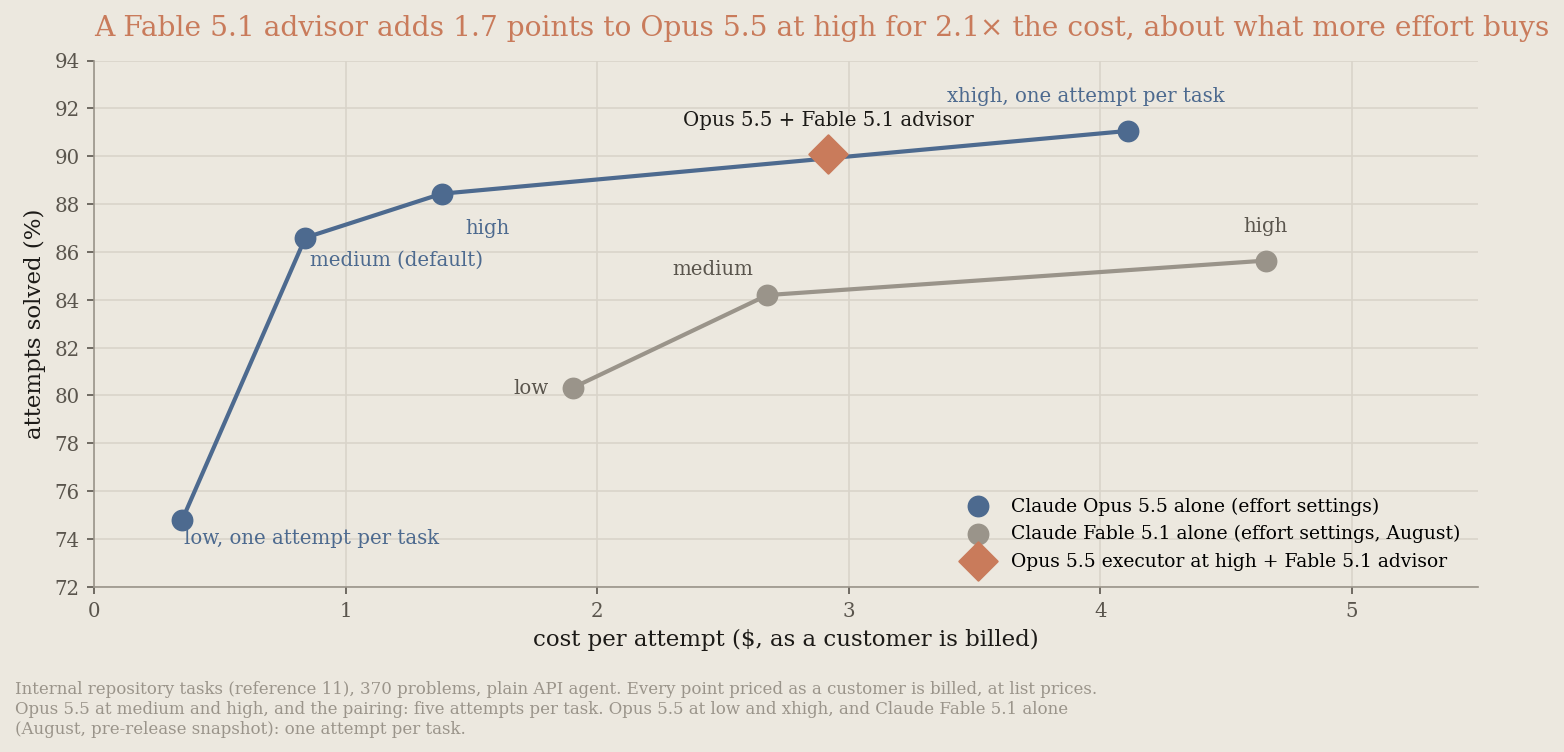
Claude Codeのアドバイザーモードを使った以前の測定でも、アドバイザーのペアリングは、それを構成する2つのモデルのどちらの単体よりも高いスコアでした。Claude Opus 5.5の結果は、自分のワークロードで検証すべき傾向として捉えてください。アドバイザーは、エグゼキューター単体の約2倍のコストで、スコアを数ポイント向上させます。能力の差が大きいほど費用対効果が高くなるとは限りません。レイテンシのコストは、相談そのものです。このベンチマークでは、タスクあたり約1〜2回のフロンティアモデルの追加呼び出しが発生し、そのそれぞれがタスクのクリティカルパス上にあります。
より強力なモデル単体のほうが良い選択となる場合。 ワークロードの精度がエフォートによって変わる場合は、ペアリングを構築する前に、設定を下げたアドバイザーのモデル単体と比較してください。アドバイザーの料金は必要なタスクでのみ発生しますが、ほとんどのタスクで相談が発生すると、より強力なモデル自体を実行するよりもコストが高くなります。Chartography13では、Claude Fable 5.1アドバイザーを組み合わせたlowのClaude Opus 5.5エグゼキューターは、300タスク中1タスクでしか相談しませんでした。スコアは61.7で、Opus 5.5単体より7ポイント低く(実行間のノイズを超える差)、コストはほぼ同じでした。8月の測定では、Claude Opus 5エグゼキューターはほぼすべてのタスクで相談しました。このペアリングのスコアは、mediumのFable 5.1単体と実行間のノイズの範囲内で同等(65.0対67.5)でしたが、タスクあたりのコストは約1.8倍でした。まず自分のワークロードの相談率を測定してください。エグゼキューターがほとんどのタスクで相談する場合、ワークロード全体でアドバイザーの料金を支払っていることになります。その場合は、アドバイザーのモデル自体を実行するほうが、同じスコアをより安価に得られます。
どのペアリングであれ、まず低いエフォートでのアドバイザーのモデル単独の価格を出してください。それが上回るべきベースラインです。モデルのリリースごとに再確認してください。リリースは能力のギャップと価格比の両方を動かすからです。
適する場合。 アドバイザー戦略は、ターンの大半は機械的だが優れた計画が重要なワークロードに適しています。コーディングエージェント、コンピュータ操作、多段階のリサーチパイプラインなどです。すべてのターンが本当にフロンティア級の能力を必要とする場合、計画すべきものがない場合(単一ターンのQ&A)、あるいはエグゼキューターがすでにアドバイザーの能力に近い場合には適しません。
オーケストレーター戦略:大量の作業を委任する
オーケストレーター戦略では、フロンティアモデルがループを保持します。タスクを分解し、サブタスクを低コストのワーカーモデルにディスパッチし、その結果を統合します。トークンを大量に消費する探索はワーカーが吸収するため、オーケストレーター自身のトランスクリプトは短く保たれ、大半のトークンはワーカーの料金で課金されつつ、計画と統合は依然としてフロンティアモデルから得られます。
これを構築するには、Claude Managed Agentsのマルチエージェントオーケストレーションを使用します。コーディネーターエージェント(オーケストレーター)と、それぞれ独自のモデルを持つワーカーエージェントのロスターを設定します。フロンティアのコーディネーターとClaude Sonnet 5ワーカーを使った完全な動作例については、Claude Cookbookのレシピコーディネーターパターン:計画には大きなモデル、実行には小さなモデルを参照してください。
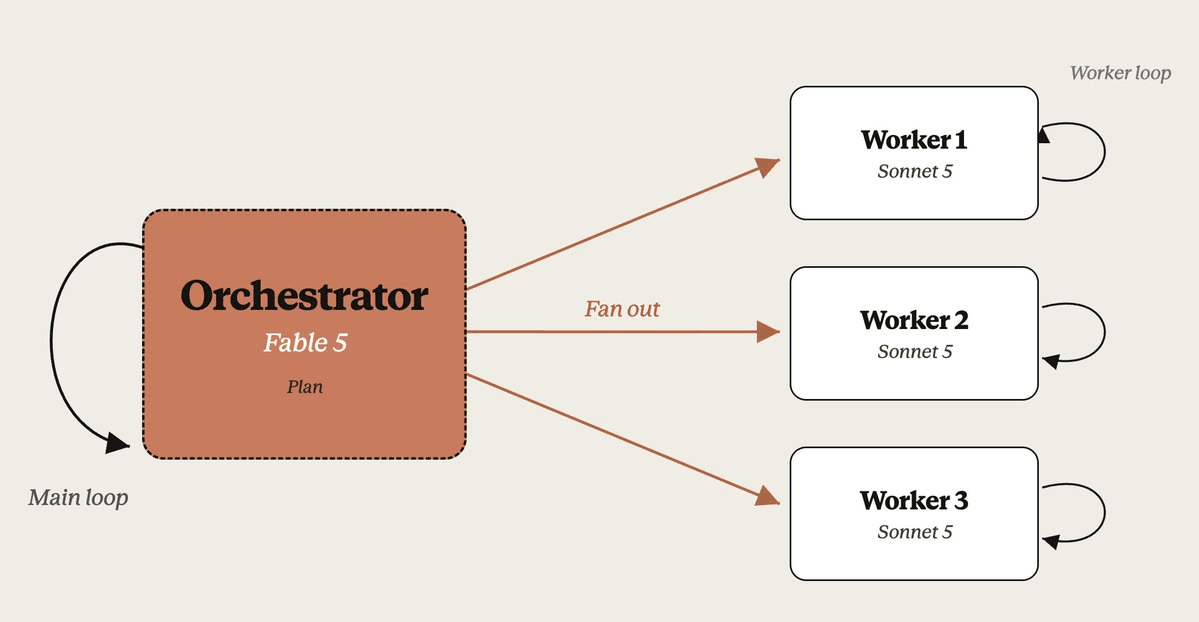
このパターンは、ワーカーが並列に実行できる場合に実時間を節約します。コーパスベンチマーク8では、コーディネーターがプラットフォームの文書化された上限である25の同時ワーカーを実行した場合、1エピソードは約2.3時間で済んだのに対し、単独では15〜20時間かかりました。費用を節約したのは、測定した中で2つの状況だけでした。単一モデルが単独で処理できる作業では、同じモデルを低いエフォートで使う方が毎回安価でした。
ワーカーを並列実行する場合、時間に関する指示と経過時間の時計によって実行時間を短縮できます。DRACO21では、指示と時計を与えた同一モデルのエージェントチームが、タスクあたりのコストを54%削減しつつ33%短い時間で完了し、スコアは1.5ポイント低下しました。このチームのすべてのエージェントが指示と時計を持っていました。Anthropicは、低コストのワーカーでの時計の効果は測定していません。Claude Managed Agentsでは、時計はコーディネーターにのみ届き、ワーカーには表示されません。Anthropicは、コーディネーターのみが時計を持つチームについては測定していません。また、コーディネーターの時計が最新になるのは、あなた自身のツール結果またはメッセージに続くターンのみです。Messages APIで実行するエージェントループのレシピについては、モデルに経過時間を表示するを参照してください。
ケース1:定型作業におけるコストのテールに対する保険。 単独で実行されるフロンティアモデルは、通常なら解決する定型的な問題で時折迷走します。どれがそうなるかを事前に知ることはできないため、そうした少数の実行が請求額を支配します。定型作業を低コストのワーカーに渡すコーディネーターはそのテールに上限を設けます。迷走が起きてもワーカーの料金で起きるからです。
Anthropicはこれを、意図的に簡単にしたBrowseComp4のスライス(単独モデルが確実に解く10問。委任実行50回、単独実行70回)で測定しました。Claude Sonnet 5ワーカー1つを持つClaude Fable 5コーディネーターは、平均でClaude Fable 5単独の約半分、90パーセンタイルでは約3分の1のコスト($12対$33)で済み、単独モデルの最も高額だった1回の実行($84)は答えも間違っていました。
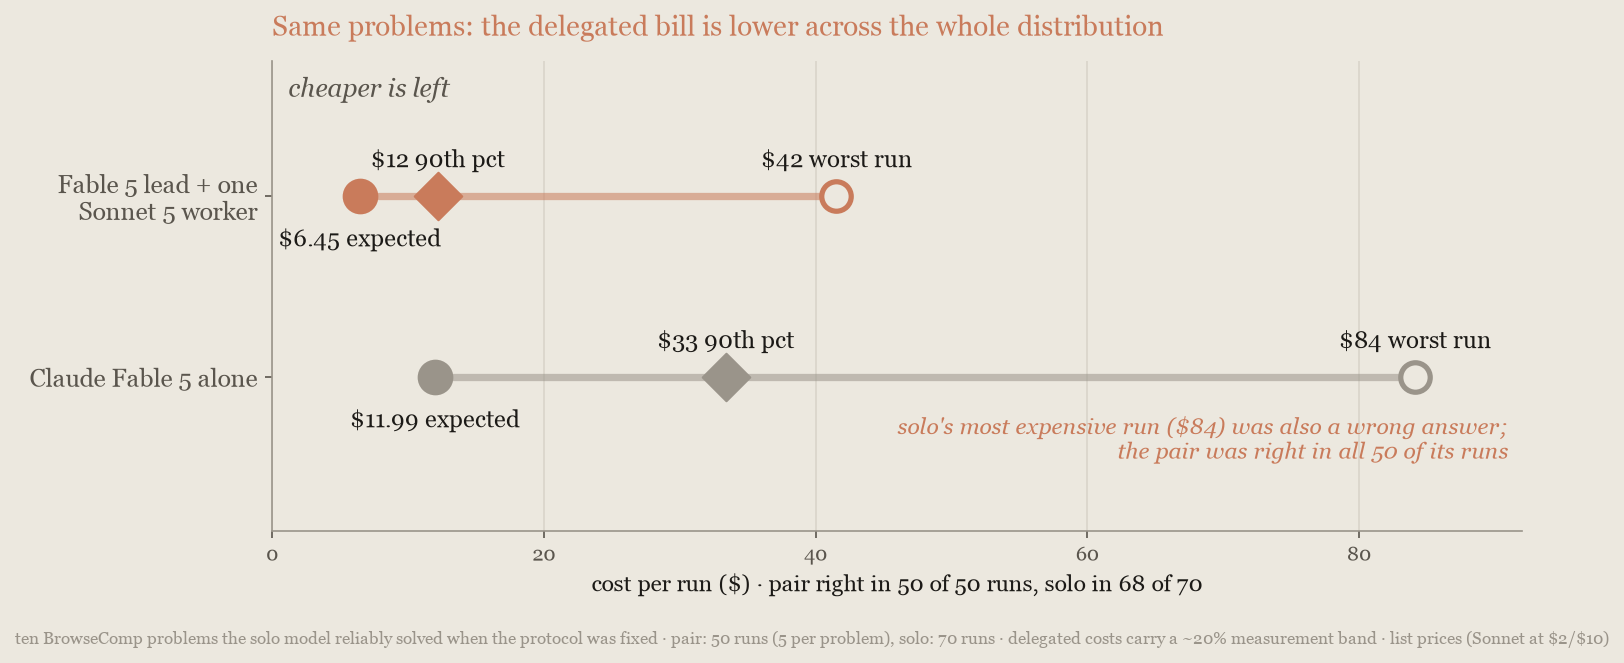
委任が見合ったのは、作業のうち定型的で通常は解決可能な部分であり、ワーカーは難しい問題のためのものだという直感とは逆でした。より難しいBrowseCompの全セットでは、経済性は逆転しました。トラフィックに定型タスクでの長いコストのテールがあるなら、これが最初に測定すべきオーケストレーターのケースです。
ケース2:コンテキストウィンドウ1つ分より大きな作業。 単独モデルはそれほど大きな入力を、コンテキストウィンドウ1つ分ずつ直列に処理しなければならず、パスごとに自身の状態を読み直すための費用を支払います。ワーカーはそれぞれ自分のパーティションを、並列に、ワーカーの料金で読みます。読み取りの多い作業でも1つのコンテキストウィンドウに収まるなら、それは委任の問題ではなくモデル選択の問題です。読み取りコストだけで見れば、オーケストレーターが優位に立つのは、単一のコンテキストでは作業を保持できない場合だけです。
Anthropicはこのケースのためのベンチマーク8を構築しました。14の公開Pythonパッケージからなる2,160万トークンのコーパスに130の欠陥を仕込んだもので、どのコンテキストウィンドウにも大きすぎます。請求額はコーパスの読み取りそのものなので、エフォートを下げても役に立ちません。Claude Fable 5.1単独は3つのエフォート設定にわたって1エピソードあたり$468〜$552かかり、動いたのは精度だけでした。コーディネーター構成(25のClaude Sonnet 5ワーカーを率いるClaude Fable 5.1リード)は、それらの設定の約半分のコスト(47%〜55%減)で、スコアはそれらより10〜12ポイント低く、1エピソードあたり15〜20時間に対して約2.3時間で済み、Claude Sonnet 5単独のベースラインは完全に上回りました。
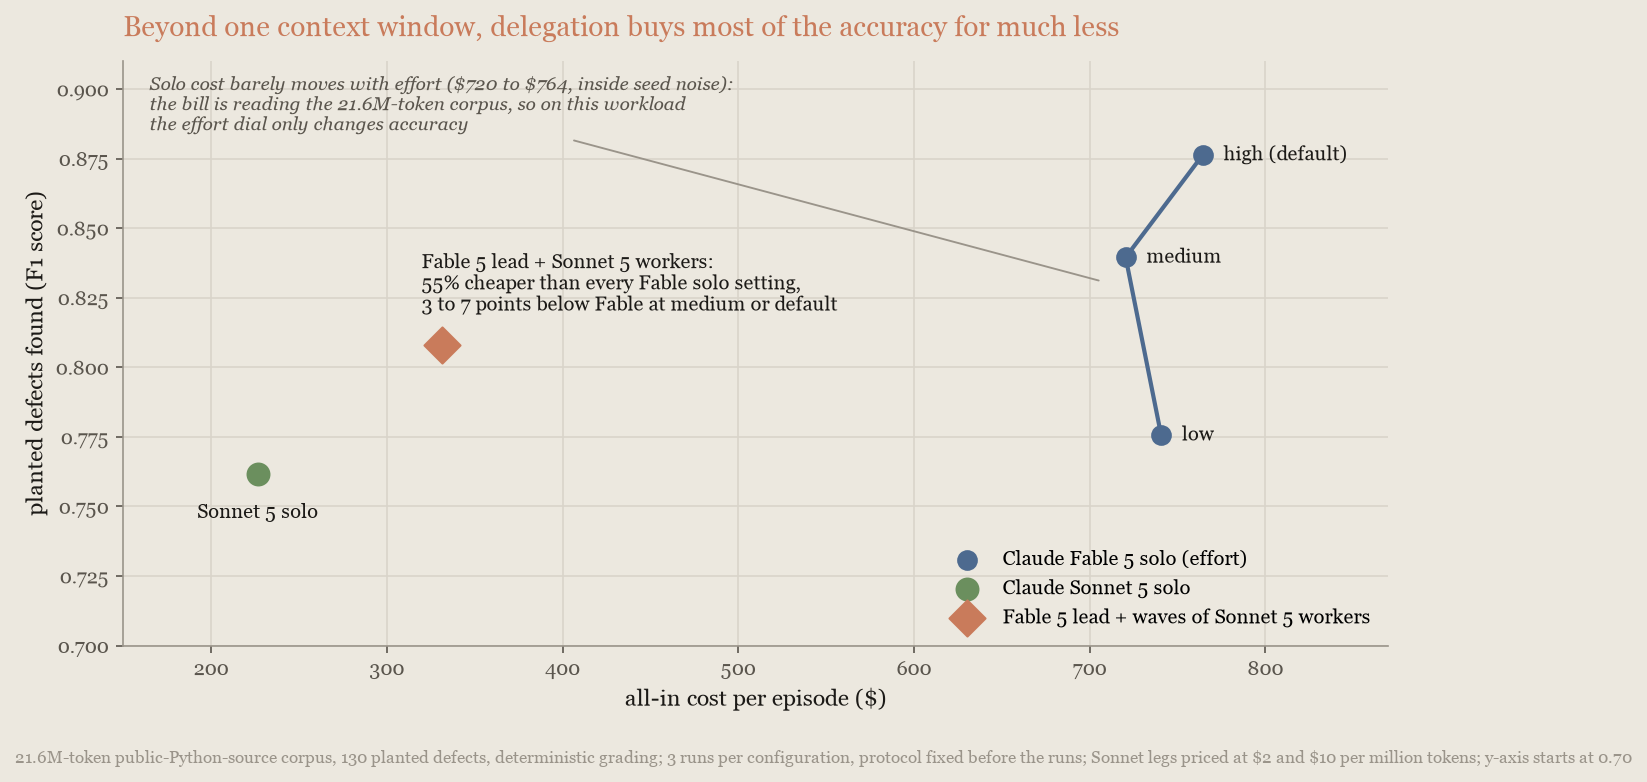
トークンの内訳は読み取りの規模を示しています。コーディネーター構成は1エピソードあたり約5億6,000万のキャッシュ済みトークンを読み取り、これは単独モデルの約3億6,500万の約1.5倍で、そのほぼすべてがClaude Sonnet 5のキャッシュ読み取り料金でしたが、それでも全体のコストは約半分でした。highエフォートのFable 5.1は依然として最高精度を保持しており、そのコストはコーディネーター構成の約2.2倍です。したがって、ここでの委任は精度の大半を買いますが、すべてではありません。
委任が見合わない場合。 オーケストレーターが何かを買えるのは、渡すべき大量の作業がある場合だけです。多数の独立した部分、理想的には1つのコンテキストウィンドウには多すぎるほどの部分です。作業が1本の依存関係の連鎖である場合、あるいは単一のコンテキストに収まる場合、オーケストレーターは、単一モデルなら無料で得られる計画、引き渡し、統合に対して支払うことになります。測定したそのようなケースのすべてで、コーディネーターのモデル単独を低いエフォートで使う方が優位でした。
境界はベンチマークではなくタスクの難易度です。より難しいBrowseComp4の全セットでは、Claude Fable 5単独がコーディネーター構成の精度に22%〜30%低いコストで到達しました。独立した外部の研究も同じパターンを報告しています5。作業が1本の連鎖である、長いコストのテールなしに1つのコンテキストに収まる、あるいは低いエフォートの単一モデルがすでに基準を満たしているなら、オーケストレーターを構築しないでください。
戦略を選ぶ
ほとんどのケースは1つの問いに帰着します。作業は独立した部分に分割できるのか、それとも依存するステップの連鎖を経て到達する1つの答えなのか。戦略の表は、この2つの答えを2つの戦略に対応付けています。
確信が持てないなら、まだ何も構築しないでください。
- まず現在のモデルでエフォートをスイープします。これはこのページで最も安価な実験であり、ほとんどのワークロードはそこで終わります。
- スイープでギャップが見つかったら、低いエフォートでのより強いモデル単独の価格を出します。それがアドバイザーのペアリングが上回らなければならない数字であり、このページでそれを上回ったペアリングは、エグゼキューターが実際に相談したものでした。
このページのマルチモデルの結果は、同じモデルを低いエフォートで使った場合、および1つ下のモデルを単独で実行した場合と比較して評価されました。それが自分のワークロードで実行すべき比較であり、最初のステップがエフォートのスイープである理由です。
実際にアドバイザーを追加する場合、それは再アーキテクチャではなくツール定義の追加です。
自分のワークロードで測定する
このページの数値は測定時点の定価を反映しており、モデルと価格が変わるにつれてずれていきます。エスカレーション率、タスクがどれだけきれいに分割できるか、トランスクリプトの長さもそれらを動かします。方法は変わりません。
- 本番ログから実際のトラフィックと同じ重み付けでいくつかのタスクを抽出し、それぞれに結果チェックを書きます。テストが通る、チケットがクローズされる、行数が正しい、などです。スコアの横にタスクあたりのコストを記録します。各レスポンスの
usageにある5つの課金対象トークン数をそれぞれの料金で価格付けし(キャッシュなし入力、入力価格の1.25倍と2倍の5分および1時間キャッシュ書き込み、キャッシュ読み取り、出力)、タスクのリクエスト全体で合計します(Usage and Cost APIは集計値を報告します)。 - デフォルトだけでなくエフォートレベル全体にわたってモデルの各ティアのベースラインを取り、支出に対するスコアをプロットします。マルチモデル構成は単一モデルの曲線全体を上回らなければなりません。
- 曲線にエフォートでは埋められないギャップが見られる場合は、適合するマルチモデル戦略を追加してスイートを再実行します。
- 切り替え前にトラフィックの一部で勝者をシャドー実行し、その後もスイートを実行し続けます。
次の例は、Claude Opus 5.5の定価で、1つのリクエストについてステップ1のコストを計算します。
# 料金ページに記載の100万トークンあたりの価格です。別のモデルを使う場合はこの3つを変更してください。
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# Claude Opus 5.5 では入力価格の0.05倍です。倍率はモデルによって異なります
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1時間キャッシュの書き込みは入力価格の2倍、5分キャッシュは1.25倍で課金され、読み取りはキャッシュ読み取り価格で課金されます。
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")エージェントループでは、入力トークンの大部分がキャッシュ読み取りであるべきです。cache_read_input_tokensがinput_tokensとcache_creation_input_tokensの合計に比べて小さい場合は、キャッシングが有効になっていること、およびリクエスト間でプレフィックスが同じに保たれていることを確認してください。アドバイザーツールまたはコンパクションが有効な場合、一部のトークンはトップレベルの合計には含まれずusage.iterationsにのみ報告されるため、代わりにusage.iterations全体を合計し、advisor_messageエントリはアドバイザーモデルの料金で計算してください。
次の表は、試すべき順序でレバーを一覧にしたものです。
| レバー | これらの実行での節約 | 品質コスト | レイテンシ | 参照先 |
|---|---|---|---|---|
| プロンプトキャッシング | エージェントループでコストが2.7〜5.3分の1に削減。トリアージ実行で83% | なし | 高速化 | 繰り返されるコンテキストをキャッシュする |
| 1時間のキャッシュ期間 | 約20ターンに1ターンが5分から1時間の休止の後に続き、1時間を超える間隔がほとんどない場合、5分間のデフォルトより安価。ただし、Claude Fable 5.1では休止が数分程度の間は5分間のキャッシュをウォームに保つ方が安価で、休止が1時間近くになると1時間の期間が有利。Claude Opus 5.5では、20ターン中1〜2ターンのみが最大約30分の休止の後に続く場合、5分間のキャッシュをウォームに保つ方が安価。休止がない場合、デフォルトはClaude Sonnet 5で15%、Claude Opus 5.5で約15%〜18%安価 | なし | 休止後もウォームな状態を維持 | キャッシュ期間を選ぶ |
| 入力のトリミング | トリアージ実行でさらに5パーセントポイント | なし | 中立 | 入力とコンテキストのトークンを削減する |
| タスク境界で古いツール結果を削除 | 長いトリアージ実行で39%(コンパクションは32%)。短いループでは効果なし | 測定上なし | 中立 | 入力とコンテキストのトークンを削減する |
| ツール検索 | 500のツール定義を添付した場合45%。GitHub MCPサーバーで20% | なし | 中立 | 入力とコンテキストのトークンを削減する |
| コード実行を通じたデータファイル | 25問のデータタスクで92% | 向上、25問中6問ではなく25問中25問 | 高速化 | 入力とコンテキストのトークンを削減する |
| Batch API | 50% | なし | 24時間以内に結果 | 待てる作業をバッチ処理する |
| 現在のモデルに対するプロンプト監査 | 測定した両方の移行で14% | なし。1つでは向上 | 高速化(ツールラウンドの減少) | 現在のモデルに対してプロンプトを監査する |
| モデルのアップグレード | Opus 4.8からOpus 5:解決済みタスクあたり21%増で12ポイント増(lowのOpus 5は約30%のコストでOpus 4.8を上回る)。Sonnet 4.6からSonnet 5:解決済みタスクあたり15%減、5ポイント増。Fable 5からFable 5.1:ほぼ同じスコアで解決済みタスクあたり43%減 | 向上 | 中立 | モデルをアップグレードする |
| エフォートを下げる | ナレッジワーク:mediumで13%〜31%、lowで3分の1〜半分。長いコーディング:mediumで約30%、lowで約3分の2(いずれもhighとの比較) | ナレッジワークで1〜3ポイント、長いコーディングで2〜8ポイント | 高速化 | エフォートを調整する |
| 失敗の再実行 | すべてをhighで実行する場合と比べて約40%、合格率は同等かわずかに向上 | なし | 失敗したタスクで2回実行 | 失敗したタスクをより高いエフォートで再実行する |
| タスク予算 | 44%〜58% | 3〜6ポイント | 高速化 | 予算と出力上限を設定する |
| より短い回答を求める | トリアージ実行で出力トークンの39%、コストの14% | なし | 高速化 | 予算と出力上限を設定する |
max_tokensを上げる | 解決済みタスクあたりではなし、ただし解決タスク数は増加 | 社内セットで最大22ポイントの向上。公開ペアではなし | 中立 | 予算と出力上限を設定する |
| アドバイザー | 能力差と相談率に依存。コーディングのペアリングは、highのClaude Opus 5.5単独より1.7ポイント高いスコアを約2.1倍の価格で達成(エフォートを上げた場合とほぼ同等)。Claude Opus 5.5では、チャート読み取りのペアリングはほとんどアドバイザーに相談せず、Opus 5.5単独より7ポイント低いスコア | コーディングでは向上、チャート読み取りでは低下 | タスクあたり約1〜2回の追加呼び出し | アドバイザー戦略 |
| オーケストレーター | フロンティアモデルに対して約半分。コンテキストウィンドウ1つ分を超える場合と定型のテールの両方で(後者はClaude Fable 5で測定) | フロンティアモデルより10〜12ポイント低い | 大きな入力で大幅に高速化 | オーケストレーター戦略 |
参照したベンチマーク
参照先に別途記載がある場合を除き、測定値はこれらのベンチマークをAnthropic社内で実行した結果です。特に注記がない限り、コストは各ベンチマーク実行時点で有効だった定価に基づく米ドル建てです。Claude Sonnet 5の数値は、入力トークン100万あたり$2、出力トークン100万あたり$10を使用しています。「notional USD」(名目米ドル)と表示されたチャートは、請求書の金額を報告するのではなく、各リクエストのトークン数をこれらのレートで価格付けしたものです。
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025。多数の行を持つ表の完全性と正確性で採点される広範なウェブリサーチタスク。200問、構成ごとに3回実行、2026年8月1日から2日に実行。コスト集中チャートは別途の20問の実行で、1問あたり3回実行、2026年8月3日から4日に実行し、リクエストごとの請求記録からコストを算出しています。
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025。タスクのルーブリックに照らして採点されるナレッジワークの成果物。公開されたゴールドセットの210タスクの実行で、タスクごとに1回の試行、2026年8月2日に実行。Claudeモデルが採点するため、絶対スコアは公開結果と異なる場合があります。
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025。Anthropicの評価ハーネスとの互換性を考慮して選んだ482問のサブセットです。スコアは公開リーダーボードとは比較できません。また、Claude Opus 5.5のシステムカードに掲載されたSWE-bench Proの結果とも比較できません。そちらは異なる問題セットを
maxeffortで実行したものです。Claude Opus 5.5の数値は、low、medium(デフォルト)、highでは2回の実行の平均、xhighでは1回の実行の値です。いずれも2026年9月19日〜20日に、8月のClaude Opus 5の実行と同じターンあたり16,384トークンの上限で実行しました。この上限で打ち切られたのはxhighの2件の試行のみで、他の設定では打ち切りはありませんでした。Opus 5.5の実行では、採点コンテナが社内のパッケージミラーにしかアクセスできないバージョンのベンチマークを使用しました。このバージョンでは、テストに稼働中のウェブサイトを必要とする1問が除外されます。さらに3問ではこの環境で参照解が失敗するため、Opus 5.5の比較と、それと並べて示すClaude Fable 5.1の数値には、残りの478問を使用しています。モデルをアップグレードするおよびアドバイザーの組み合わせのグラフに示すClaude Opus 5のSWE-bench Proの数値は、デフォルトのeffortでは2回の実行の平均、lowでは1回の実行の値で、いずれも2026年8月4日に実行しました。エスカレーションの数値は、Opus 5.5の実行結果からタスクごとに算出しました。まずlowで実行し、失敗したタスクをhighで実行した場合、実行の組み合わせ全体で96.4%〜97.5%を約$0.17で解決しました。まずmediumで実行した場合は96.0%〜97.1%を約$0.24、highで失敗したタスクをhighで再実行した場合は96.9%を$0.31、すべてをhighで実行した場合は94.8%〜95.8%を$0.29で解決しました。このサブセットのコストは、顧客の組織に対する計量と同じ方法で算出しています。実行自体の使用量記録をもとに、各リクエストの以前のプロンプトをキャッシュ読み取り、新しいトークンを5分間のキャッシュ書き込みとして扱い、顧客の台帳と照合しました。評価用組織自体の計量では、2026年9月10日まで、Claude Opus 5、Claude Fable 5、Claude Opus 4.7、Claude Opus 4.8のキャッシュ読み取りが8,192トークン単位のブロックで請求されていました。そのため、これらのモデルの実行では数値が1.4〜1.8倍高くなりました。Claude Fable 5.1、Claude Sonnet 5、Claude Sonnet 4.6では両者の差は最大で約9%で、Claude Opus 5.5の数値は各effort設定で3%以内で一致しています。アドバイザーのグラフのうち、Claude Sonnet 5をエグゼキューターとする組み合わせは、このサブセットでの同じ測定シリーズによるものです。Sonnet+Opus 5の組み合わせは2回(2026年8月7日と8月8日。1回の実行とその厳密な再現)、low effortの組み合わせは1回(2026年8月8日)、Claude Sonnet 5単体は2回(77.4%。両方のPro行のベースライン)実行しました。「モデルをアップグレードする」のClaude Fable 5のポイントは、デフォルトのeffortで2026年8月26日に実行した3回の平均で、同じ方法でコストを算出しています。Claude Fable 5.1のタスク予算の数値は、同じサブセットをデフォルトのeffortで予算ごとに1回(35,000トークンでは2回)、2026年8月26日に実行したものです。ベースラインは同日の予算なしの実行(92.1%、タスクあたり$1.10)です。2026年8月21日にloweffortで実行した以前のセットでは、予算なしで88.6%、タスクあたり$0.48でした。モデルを比較するの比較では、この1回の実行を、同じサブセットでのClaude Sonnet 5の2回の実行をプールした結果と比べています。Fable 5.1のデフォルトのeffortでは結果が逆になり、解決したタスクあたりのコストはSonnet 5より41%高くなります。アップグレードの段階比較は、各モデルを出荷時のデフォルト設定で1回ずつ実行したものです(Opus 5とSonnet 5はそれぞれ2回、Fable 5のポイントは上記のとおり)。OpusとSonnetの実行は、同じ週に同一のハーネスと組織で行いました。 - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025。effortの数値は500問のカットを使用し、設定ごとに1回から3回実行、2026年8月3日に実行、デフォルトのポイントは2026年7月26日から27日の2回の実行をプールしています。コスト保険チャートは、26問のスライスから確実に解決される10問を使用し、委任実行50回(2026年8月1日から2日)と単独実行70回(2026年8月2日から3日の50回、2026年7月12日から13日および8月1日からアーカイブした20回)で、期待値で1実行あたり$6.45対$11.99です。委任の数値には約20%の測定幅があります。
- エージェントアーキテクチャのスケーリング: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025。独立した外部研究で、委任が割に合わない場合に関する知見の方向性についてのみ引用しており、いかなる数値についても引用していません。
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025。220問は15のドメインにまたがり、それぞれが多数行の収集とマルチホップ検索を組み合わせています。ベンチマークの常設の行セットで測定し、構成ごとに3回実行、2026年8月2日に実行しました(単一ワーカーのチームポイントは2026年7月26日から27日に実行)。
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026。22のドメインにわたる132のリサーチタスクが、専門家由来の二値ルーブリックに照らして採点されます。全テーマにわたって層化した50タスクのサブセットで測定し、タスクごとに1回の試行、設定ごとに3回実行、Claude Managed Agents上でプラットフォーム自体のウェブ検索およびフェッチツールを使用しました(2026年8月26日から27日)。どの構成も拒否しなかった33タスクで採点し、本番の安全性分類器が途中で打ち切った試行は除外しています。コストは顧客に請求される金額、すなわちプラットフォームのリクエストにウェブ検索料金を加えたものです。スコアは、各モデル自身の打ち切られたタスクを除いた33タスクベースでの各モデルの平均です。すべてのアームでクリーンだった21タスクでは、Claude Fable 5.1はすべてのeffortレベルでClaude Fable 5に対して2から3ポイントのリードを保ち、両モデルともeffort全体で横ばいです。キャッシングチャートは、同じリクエストをすべての入力トークンを非キャッシュレートで再価格付けしたものです。Claude Opus 4.6がベンチマークのルーブリックプロトコルに従って判定します。オリジナルは別の判定者を使用しており、Anthropicの判定者は自社のスタイルを好む可能性があります。デフォルトのeffortでのClaude Opus 5は、同じサーフェスとサブセットで3回、2026年8月28日に実行しました。生の50タスクで68.8%、33タスクベースで70.8%、21タスクセットで71.1%、タスクあたり$6.71(キャッシングなしでは$23.72)でした。その試行はいずれも安全性分類器によって打ち切られませんでしたが、これは他のモデルが実行された際のものより新しいセーフガードのデプロイメント下でのことです。
- コーパス欠陥スイープ: Anthropic社内、1つのコンテキストウィンドウより大きな作業向け。14の公開Pythonパッケージソースからなる2,160万トークンのコーパスに130の欠陥を埋め込み、決定論的に採点します。プロトコルは実行前に固定し社内でレビュー済み、構成ごとに3回実行。すべての構成はClaude Managed Agents上で実行しました。チャートに示したチーム構成は、Claude Fable 5.1コーディネーターがプラットフォーム内で、文書化された上限である25の同時Claude Sonnet 5ワーカーでスイープ全体を実行したもので、2026年8月30日に実行しました。その3つのエピソードは、追加分の監査後にF1 0.764、0.825、0.791(生の値は0.751、0.821、0.781)を記録し、コストは$225、$234、$283でした。Claude Sonnet 5単独構成は2026年8月3日から4日に実行しました。Claude Fable 5.1単独構成は2026年8月24日から25日に、プラットフォームのローンチ時のサービング設定下で、effort設定ごとに3シード、同じコーパスビルドで実行しました。サンドボックスイメージにはコーパスの一部のインストール済みコピーが含まれており、Claude Fable 5.1の最終組み立てステップは9エピソード中7エピソードでそれらと比較しました。それらの追加分を除いて再採点すると、影響を受けたシードは最大3ポイント動きました。絶対F1はこのコーパスビルドに固有のもので、ベンチマーク間で比較できません。構成の比較は同一条件です。
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023。198問のDiamondサブセットを、構成ごとに2回、2026年8月7日に実行しました(Claude Opus 5.5は2026年9月19日)。採点は参照解答に照らしてモデルが行い、アドバイザーのトークンはリクエストごとに計量しました。プラットフォームの安全性チェックにより、Claude Sonnet 5をエグゼキューターとする構成で生物学の2問が拒否され、そのうち1問はClaude Opus 5でも拒否されました。これらを除外しても、どの比較も1ポイントを超えて変わることはありません。Claude Opus 5.5の92%は、
fallbacks: "default"を設定してサーバー側フォールバックを有効にした2回の実行によるもので、それでも拒否で終わった試行は不正解として数えています。各実行で安全性チェックは生物学の6問にフラグを立てました。そのうち5問にはフォールバックによってClaude Opus 5が回答し、残りの1問は拒否で終わりました。Opus 5.5の問題あたりのコストには、これらのフォールバックによる回答が含まれます。拒否を不正解として数えない場合、これらの実行のスコアは93%になります。採点者は拒否された試行にも回答の選択肢を割り当て、それが多くの場合正解になるためです。拒否を不正解として数えると、Claude Opus 5の実行は91%(実行ごとに1件の拒否)になります。フォールバックを無効にしたClaude Opus 5.5の2回の実行も同じく91%で、これらの実行ではOpus 5.5が実行ごとに生物学の5問または6問を拒否しました。 - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026。このセットには5つの言語にわたる113のオリジナルタスクがあり、プログラムベースの検証器が付いています。組み合わせはそれぞれ2回実行、2026年8月7日に実行、アドバイザートークンはリクエストごとに計量し、アドバイザーツールではなくクライアント側のアドバイザーループを使用しましたが、会計処理は同一です。単一モデルのeffortスイープは単一実行で、トークン数から価格付けしたキャッシュを考慮した近似値です。タスクあたりのコストは実行合計を113で割ったものです。
- 社内のエージェント型コーディングベンチマーク: Anthropic社内のベンチマークで、370のリポジトリタスクを各リポジトリ自体のテストで採点します。APIの数値は128,000トークンの出力上限で、構成ごとに1回実行して測定しました。Opus 5単体は、デフォルトのeffortで2026年8月9日〜10日、
lowとmediumで2026年8月10日に実行しました。Claude Fable 5.1単体は、明示的に設定した5つのeffort値で2026年8月20日に実行しました(グラフにはそのうち3つを表示)。組み合わせは2026年8月24日〜25日に実行しました。Claude Opus 5.5単体は、2026年9月19日〜20日に370タスクすべてで実行しました。デフォルトのeffort(medium)とhighではタスクごとに5回、lowとxhighでは1回試行しました(セットアップチェックの失敗により、いずれも370タスク中369タスクを採点)。リリース版のClaude Fable 5.1(8月の実行ではリリース前のスナップショットを使用)をアドバイザーとするhighのClaude Opus 5.5エグゼキューターは、同じ日程でタスクごとに5回試行しました。1つのタスクがセットアップチェックに失敗したため、採点した試行は1,845回です。負荷のためにアドバイザーが応答しなかった279回の試行は再実行し、相談がタイムアウトした試行は8月と同様にそのまま残しました。8月の実行では、組み合わせとClaude Opus 5の対照群はタスクごとに5回、その他のポイントは1回試行しました。8月の組み合わせでは、試行あたり平均約2回アドバイザーに相談しました。Claude Opus 5.5の組み合わせでは、相談の要求が1.39回、応答の受信が1.35回でした。コストは試行あたりの値です。コストは、顧客の組織に対する計量と同じ方法で算出しています。実行自体の使用量記録をもとに、エージェントループの各リクエストの以前のプロンプトをキャッシュ読み取り、新しいトークンを5分間のキャッシュ書き込みとして扱いました。キャッシュを使用しないアドバイザー呼び出しは、記録されたトークン数から算出しました。いずれも定価で計算しています。Claude Codeの数値は、2026年7月8日〜23日に同じタスクを構成ごとに1回実行したもので、コストは概算です。 - 社内のリポジトリタスクベンチマーク(上限の測定): 約130のリポジトリタスクからなる、Anthropic社内の別のセットです。2026年8月20日(Claude Fable 5.1)と2026年9月19日(Claude Opus 5.5、デフォルトのeffortである
medium)に、シンプルなAPIエージェントループで、タスクごとに1回試行して実行しました。Claude Fable 5.1の実行では、デフォルトのeffortを明示的に設定し、上限ごとに135タスクを実行しました。16,384トークンの数値は2回の実行の平均(どちらも36.3%)、64,000と128,000の数値は1回の実行の値(58.5%と60.0%)です。6問はすべての実行で安全性による拒否となり、失敗として数えています。Claude Opus 5.5の16,384トークンの数値は2回の実行の平均(採点したタスクは134と135)、64,000と128,000の数値は1回の実行の値(それぞれ135タスク)です。16,384トークンの各実行では2回の試行が安全性による拒否で終わり、失敗として数えています。SWE-bench Proの上限の数値は、Claude Fable 5.1をデフォルトのeffortで上限ごとに1回、2026年8月26日に実行したものです。使用したのは参照3の482問のセットから層化抽出した100問のサブセットで、参照3のスコアとは比較できません。デフォルトのeffortでは、2つの上限のスコアは同じでした。グラフのターンごとの分布は、上限128,000でのClaude Opus 5.5とClaude Fable 5.1の実行によるものです。Opus 5.5では上限に達したターンはありませんでした(最長は約61,000トークンで、16,384を超えたターンは0.56%)。Fable 5.1では1つのターンが128,000に達しました(16,384を超えたターンは0.46%)。 - Chartography: Surge AI, "Chartography," 2026。公開された100問のセット全体を、2026年8月6日と9日(Claude Opus 5単体)および2026年9月20日(Claude Opus 5.5)に測定しました。実行環境はClaude Managed Agents上のAnthropicの実装です(標準のクラウドサンドボックス。アドバイザー構成ではManaged Agentsのアドバイザーを使用)。参照の判定モデルの代わりにClaude Sonnet 4.6が採点し、ベンチマークはツールありで実行しています。そのため、スコアはここでの構成間では比較できますが、公開リーダーボードとは比較できません。また、Claude Opus 5.5のシステムカードに掲載されたChartographyの結果とも比較できません。そちらは別の採点者を使用し、
maxeffortで実行したものです。構成ごとに2回(Claude Opus 5.5は3回)実行し、結果をプールしました。実行間のばらつきは最大10ポイントでした。コストは、エージェントを日常的に実行している顧客に請求される金額です。各グラフの最初のリクエストは、エージェントの共有システムプロンプトとツールをキャッシュから読み取ります。これは、同じエージェントの別のセッションが直前の5分以内に実行された場合と同じ状態です。グラフを単独で実行すると、Claude Opus 5またはClaude Opus 5.5では約$0.03、Claude Fable 5.1では約$0.12高くなります。8月の数値は、実行の使用量記録からこの方法で再計算しています。評価用組織自体の計量では、2026年9月10日までClaude Opus 5のキャッシュ読み取りが8,192トークン単位のブロックで請求されていたため、Claude Opus 5のコストが実際より高く示されていました。コストにはサンドボックスの時間は含まれていません。8月の実行では、その分の追加コストは1%未満でした。Claude Fable 5.1の単独実行は、2026年8月24日に、プラットフォームのローンチ時のサービング設定で、設定ごとに2回実行したものです。6回の試行が15分のセッション上限に達してスコア0となりました。また、各実行で2つのグラフは、安全性による拒否の後にClaude Opus 5が回答しました。Claude Fable 5.1をアドバイザーとするClaude Opus 5のlow effortエグゼキューターは、2026年8月30日に同じ設定で2回実行しました(スコアは63.0と67.0、平均65.0、グラフあたり$0.47)。各実行でタスクの88%でアドバイザーに相談しました。アドバイザーの219件の応答のうち4件は、本番環境の安全性フィルターがアドバイザー自身の応答を停止したため、代わりにClaude Opus 5が返したものです。Claude Opus 5.5はlowで、サーバー側フォールバックを無効にし、安全性分類器がすべてのツール呼び出しを判定する状態で実行しました。単体で3回(70、68、68)、Claude Fable 5.1アドバイザーを構成して3回(59、63、63)実行し、後者でアドバイザーに相談したのは300タスク中1タスクのみでした。以前の組み合わせの相談率の比較は、2026年8月10日〜11日に、コンテナツールセットを使用してMessages APIで同じ構成を再実行した結果によるものです。 - サポートデスクのプロンプト監査評価: Anthropicが構築した44件のサポートチケットのセットで、決定論的に採点し、2026年8月初旬に実行して2026年8月8日に報告しました。6つのシステムプロンプトの下で実行し、それぞれが同じクリーンなプロンプトに、Claude Opus 4.8およびClaude Sonnet 4.6向けに書かれたプロンプトでよく見られるパターンを1つ追加しています。各チャートポイントは、3つのケース(旧モデル、同じプロンプトでの新モデル、監査後の新モデル)のいずれかを、6つのプロンプトと44件のチケットで平均したものです。Opus 5の精度向上の95%信頼区間は3から8ポイントです。Sonnetの精度差はノイズの範囲内です。
- データファイル質問セット: 公開されている酒類販売CSVの1,862行のスライスに対する25の集計質問からなるAnthropicが構築したセットで、正解はpandasで計算し完全一致で採点、Claude Sonnet 5とClaude Opus 5で思考を無効にして実行しました(コンテキスト内アームはデフォルトでは完了できません)。4,000トークンの出力上限、プロンプトキャッシングなし、構成ごとに3回実行、2026年8月19日に実行。ファイルアームはFiles APIを通じてCSVをアップロードし、
code_execution_20260120ツールを使用します。 - キャッシュ期間の測定: 入力トークンとコンテキストトークンを削減するの20件のissueのトリアージジョブを使用しました。Claude Sonnet 5では2026年8月23日に、Claude Opus 5.5では2026年9月19日と20日にデフォルトのeffort(
medium)とhighで実行しました。いずれもMessages API上で同じハーネス(Claude Opus 5.5では、同じリクエストボディを送信する移植版)を使用しています。Claude Opus 5.5のセルではmax_tokensを4,096に引き上げました。ランダムに選んだ一定割合のターンの前には一時停止を挿入しました。両モデルとも、20件すべてのissueで一時停止なし、5%、10%、すべてのターンで6分の各スケジュールを実行し、Claude Sonnet 5ではさらにすべてのターンで2分のスケジュールも実行しました。また、両モデルとも5件のissueのサブセットで20分と45分の一時停止を実行しました。以下のClaude Opus 5の「keep-alive」(キープアライブ)の数値は、2026年8月23日に同じジョブをmax_tokensを4,096に引き上げて実行したもので、2分と45分の一時停止を除いて同じスケジュールを使用しています。セルごとに3回実行し、コストは各レスポンスのusageフィールドから定価で計算しました(Claude Opus 5.5の料金は、100万トークンあたり入力$4、5分間の書き込み$5、1時間の書き込み$8、キャッシュ読み取り$0.20、出力$20です。Claude Sonnet 5は、顧客の組織と同じ方法で使用量が計量されるAnthropic社内の組織で実行しました)。精度は同じゴールドラベルに照らして評価しました。このページのClaude Opus 5.5の数値は、両方のeffortレベルを対象としています。「crossover」(損益分岐点)は、Claude Sonnet 5ではターンの約3.3%、Claude Opus 5.5では3.1%〜3.2%です。この値は、各セッションのターンごとのコンテキストサイズからコストモデルで算出した損益分岐割合の中央値です。対象は、Claude Sonnet 5の20件のissueのセッション45件すべてと、各effortレベルでのClaude Opus 5.5の20件のissueのセッション36件です(ジョブ全体で実行したすべての一時停止スケジュールを、3つのキャッシュ設定それぞれで3回ずつ実行したもの。5件のissueのセルは含みません)。5%のセルでは、抽選された一時停止が小さなプレフィックスの位置に当たったため、Claude Sonnet 5では5分と1時間の設定のコストが同じになり、Claude Opus 5.5でもほぼ同じになりました。このページの「20回に1回」のルールは、測定された損益分岐点より高い値に設定されています。一時停止後のClaude Opus 5.5の最初のトークンまでの時間は測定していません。Anthropicは、5分間のキャッシュを更新するキープアライブリクエストを、2026年8月23日にClaude Sonnet 5とClaude Opus 5で、上記の実行でClaude Opus 5.5で測定しました。キープアライブリクエストは常にmax_tokens: 1で送信しています。Claude Sonnet 5では、ターンの5%で一時停止した場合は1時間の設定より7.7%安く、10%ではほぼ同じでした。Claude Opus 5では、どちらの割合でも測定可能な差はありませんでした。両モデルとも、すべてのターンの前に6分以上の一時停止がある場合はコストが高くなりました。Claude Opus 5.5では、ターンの5%と10%で一時停止した場合は1時間の設定より8%〜18%安くなりました(各キープアライブセッション自体のトークンを1時間のキャッシュ料金で再計算し、セッション間のノイズを除去すると約10%〜15%)。すべてのターンの前に一時停止がある場合はコストが高くなり、6分では4%〜6%、20分では9%〜10%、45分では56%〜58%高くなりました。Claude Opus 5.5でキープアライブによる節約が大きかったのは、各キープアライブリクエストがプレフィックスをキャッシュ読み取り料金で再読み取りするためです。この料金は、Claude Opus 5.5では入力料金の0.05倍、Claude Sonnet 5とClaude Opus 5では0.1倍です。Claude Opus 5のセッションをClaude Opus 5.5の料金で再計算すると、Claude Opus 5.5とほぼ同じ節約効果が得られます。Claude Opus 5.5に対するAnthropicのローンチ前のAPIテストでは、max_tokens: 0のリクエストがキャッシュを書き込み、次のリクエストがそれを読み取ることが確認されています。このようなリクエストが既存のエントリを更新するかどうかは、Opus 5.5では測定していません。Claude Fable 5.1ではこの倍率が0.025倍のため、45分の一時停止を除き、すべてのターンの前に一時停止がある場合でもキープアライブの方が安価でした(参照19)。 - 本番環境でのキャッシュ読み取りの割合: 2026年8月23日までの14日間のファーストパーティClaude API使用量の集計で、直接API製品のみ、Anthropic社内組織を除外、組織は特定していません。組織日は、そのリクエストがツール定義とツール結果を含み、プロンプトが平均9回以上の以前のツール呼び出しを保持し、キャッシングが使用され、そのようなリクエストを少なくとも10回行った場合にエージェントループとして数えます(APIには会話識別子がないため、これが会話の長さの代わりとなります)。106,487組織にわたる303,003組織日で、キャッシュ読み取りの割合の中央値は全入力トークンの84.2%、上位四分位は91.7%です。ユースケースラベル(組織が申告したユースケース、またはそれ以外の場合は分類されたもの)は、これらの組織日の74%とそのトークンの99%をカバーしています。コーディング組織はエージェント型入力トークンの87%を供給し、中央値88.5%を読み取り(以前のツール呼び出しが25回以上では90.9%)、上位四分位は93.4%で、コーディング組織日の約72%が80%以上です。サポート、リサーチ、データのエージェントは84%から85%を読み取ります。組織日の上位十分位は、コーディングで95.9%以上、サポート、リサーチ、データ、その他のエージェントで94.2%から94.8%を読み取ります。以前のツール呼び出しが25回以上でのリクエストレベルの内訳は6時間のサンプルから得ています。コーディングは92%が読み取り、7%が書き込み、1%未満が非キャッシュです。ラベルのない組織は大半が小規模で、中央値11%を読み取ります。ツール定義のない組織日は中央値34.6%を読み取ります。組織日を採点するのではなく、10リクエスト以上の会話を再構築する同じ期間に対する独立したクエリでは、中央値は90.2%となります。この差はスコープによるもので、データによるものではありません。
- コンパクションのタイミング測定: 入力トークンとコンテキストトークンを削減するのトリアージエージェントの長いバリアントを、2026年8月24日に、Claude Sonnet 5で5分間のキャッシュを使って実行し、コストはusageフィールドから定価で算出、アームごとに5セッションです。全体を通してデフォルトのeffortの変更なしアーム(セッションあたり$0.81)と、低effortで開始して同じ2つのキャッシュを破壊する変更(デフォルトのeffortへの切り替えと1つのツール追加)を、セッション途中のリクエスト12と17で行うアーム($0.95)、または最初のコンパクション後の最初のリクエストでまとめて行うアーム($0.75)の2つです。2026年8月25日に実行した6セッションの4番目のアームは、最初のコンパクションをトリガーしたリクエストで同じ2つの変更を行いました(セッションあたり$0.92)。そのリクエストの要約パスは81,000トークンのコンテキストを読み取る代わりにキャッシュに書き込んだため、そのパスのコストは$0.21で、境界アームでの同じパスの$0.04と対照的でした。セッションは、プロンプトが80,000トークンのコンパクショントリガーを超えた時点で、リクエスト21から25で最初にコンパクションされ(21セッション中16セッションがリクエスト22)、変更なしの2セッションは終わり近くで2回目のコンパクションを行いました。境界アームの合計が変更なしアームより低いのは、キャッシングではなく、変更前の低effortリクエストとそれらの2回目のコンパクションを反映しています。2つのアームの再書き込みコストの差は1セント未満です。セッション途中アームはキャッシュ再書き込みにセッションあたり$0.23を支払いました。セッション途中アームと境界アームの差は$0.20で、95%信頼区間は$0.11から$0.29でした。セッション途中の1セッションは、コンパクション後にモデルが検索ツールを誤って呼び出して空の結果を得たため、安価($0.82)に実行されました。これは含まれており、これを除くとアームの平均は$0.98です。精度は8月24日の各アームで20ラベル中平均14.2、8月25日のアームで14.7でした。キャッシュ読み取りは、変更なしでプロンプトトークンの91%、セッション途中で85%、境界で91%、トリガーリクエストでの変更で86%でした。
- Claude Fable 5.1でのキャッシュ期間の測定: 参照16と同じ20件のissueのトリアージジョブとハーネスを使用し、2026年8月23日と8月26日に、Claude Fable 5.1のローンチ時のスナップショットで実行しました。料金はローンチ時のもの(100万トークンあたり入力$10、5分間の書き込み$12.50、1時間の書き込み$20、キャッシュ読み取り$0.25、出力$50)です。スケジュールごとに3つの設定を使用しました。5分間のキャッシュ、1時間のキャッシュ、そしてウォーム状態を保った5分間のキャッシュです。最後の設定では、前のリクエストの開始から4分ごとに、変更のないプレフィックスに対して
max_tokens: 0のリクエストを送信しました(8月23日の実行では、キープアライブリクエストをmax_tokens: 1で送信しました。ここで報告する8月26日のセルでは、すべてのキープアライブリクエストがキャッシュを更新し、出力は請求されませんでした)。スケジュールは、20件すべてのissueでの一時停止なし、ターンの10%、すべてのターンで6分と、5件のissueのサブセットでの45分の一時停止です。セルごとに3回実行しました(45分の一時停止での8月26日のキープアライブのセルは6回)。コストは各レスポンスのusageフィールドから定価で計算し、精度は同じゴールドラベルに照らして評価しました(20件中12〜17件が完全一致)。8月26日のセッションあたりの平均コストは、5分、1時間、キープアライブの順に、一時停止なしで$2.42、$3.09、$2.29、10%一時停止で$4.50、$2.96、$2.36、すべてのターンで一時停止した場合は$22.89、$3.01、$2.62でした。8月23日のセルとの差は6%以内です。45分の数値(5件のissueのセッションあたり$1.68、$0.59、$0.71)は、キャッシュ請求のインシデントでその日の最初のセルが使えなくなったため、8月26日にクリーンな状態で再実行した結果です。8月23日の実行では$1.67、$0.58、$0.70でした。5分と1時間の設定の損益分岐点は、参照16と同じ尺度でターンの3.1%です。 - Terminal-Bench 3: 公開されているターミナルエージェントベンチマークの74タスクを、Claude Managed Agents上で実行しました。プラットフォームの組み込みツールの代わりに、評価ハーネスが各タスク専用のコンテナ内で実行する2つのカスタムツール(シェルとファイルエディター)を使用し、それ以外は外部アカウント向けのプラットフォームのデフォルト設定としました。モデルごとに
higheffortで2回、2026年8月27日〜28日に実行しました。これらの実行ではTerminal-Benchバージョン3.0を使用しています。そのため、スコアは公開されているTerminal-Benchのリーダーボードとも、Claude Opus 5.5のシステムカードに掲載されたTerminal-Bench 4.0の結果(Claude Codeでmaxeffortで実行したもの)とも比較できません。各タスクの制限時間はベンチマーク本来の2.5倍で、エージェントにはタスクあたり75分から20時間(中央値のタスクでは5時間)が与えられます。また、各タスクには指定されたメモリの3倍(6 GiBから96 GiB)を割り当て、ヘルパーサービスを実行する12のタスクにはさらにメモリを追加しました。エージェントは一般的なインターネットにはアクセスできませんでした。コンテナからアクセスできたのは、社内のパッケージミラー、GitHubやPython Package Indexを含む少数のダウンロードサイト、一部のタスクに固有のいくつかのサイトのみです。8つのタスクでは、ネットワークにまったくアクセスできませんでした。スコアは、モデルごとの148回の試行における生の合格率です。1回の実行ごとのスコアは5〜11ポイント変動します。コストは顧客に定価で請求される金額で、実行の使用量記録から、5分間のキャッシュ有効期間を前提にリクエストごとに再計算しました。Claude Opus 4.7は、148回の試行のうち11回が出力上限に達して終了しました。 - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026。10のドメインにわたる100のリサーチタスクを、専門家が作成したルーブリックで採点します。スコアはベンチマークの正規化スコアです。すべての構成は、Claude API上でClaude Fable 5.1を使用し、デフォルトの適応型思考、本番環境の安全性分類器を有効にし、
max_tokensを128,000として実行しました。構成は、higheffortとmediumeffortの単一エージェント、指示と時計を加えたhighの単一エージェント、指示と時計の有無それぞれでのhighのチームです。チームは、ツールを通じて同じモデルのヘルパーエージェントを起動するリードエージェントで構成され、ヘルパーの数に上限はありません。DRACOでは、リードが起動したヘルパーの数は試行あたり中央値で4つでした。各構成で各タスクを3回試行し、2026年9月8日〜10日に実行しました。4時間の制限に達した試行は再実行し、再実行の結果を採用しています。除外した試行は、mediumeffortの単一エージェントにおける1つのタスクの3回の試行のみで、この構成の対象は99タスクです。このタスクは、元の実行でも再実行でも、すべての試行でタイムアウトしました。ベンチマーク本来の採点方法に従ってこれら3回の試行を0点とした場合、影響を受けるのはmediumeffortに関する2つの比較のみです。highに対するmediumeffortのスコア変化は、0.7ポイント低下から1.7ポイント低下に変わります。mediumeffortに対する両方の変更を加えた場合のスコア変化は、1.2ポイント低下から0.2ポイント低下に変わります。エージェントは、評価ハーネスが固定されたウェブインデックス上でホストする検索ツールとフェッチツールを使用しました。所要時間の一部はこれらのツールに左右され、お使いのツールでは速度が異なるため、このページでは時間を分単位ではなく構成間の比率で示しています。時間はタスクあたりの実時間で、いずれかのエージェントの最初のリクエストから最後のリクエストまでの時間から、レート制限エラーや過負荷エラーの後にリクエストを再試行するまでの推定待機時間を差し引いたものです。これらのエラーは、テストアカウントの共有制限によって発生しました。各セットのすべての構成は同時に開始しました。遅い構成は数時間後に終了したため、その時間の一部は異なる負荷の下で計測されています。各タスクのコストは、そのリクエストを公開定価で換算したもので、対象はモデルのトークンのみです。プロンプトキャッシングは、各リクエストの末尾にキャッシュブレークポイントを設定し、5分間のキャッシュ有効期間を使用する顧客と同じ方法で請求されるものとして計算しました。ハーネスのツールによる追加料金はありません。スコアの変化はタスク単位の対応のある差で、95%ブートストラップ区間を付しています。区間がDRACOでは1.5ポイント以内、HLEでは2.5ポイント以内に収まる場合、その変化は許容範囲内とみなします。これらの許容範囲は、Anthropicが実行前に設定しました。回答の採点はClaude Opus 5が行います。各セット本来の採点者と比べると、Opus 5のスコアはすべての構成で、DRACOでは1.9〜2.4ポイント高く、HLEでは2.2〜2.9ポイント低く(Opus 5は500問中495問を採点し、ベンチマークの採点者は500問すべてを採点)、物理セットでは1.3〜2.0ポイント低くなりました(物理セット本来の採点者も専門家の参照解を使用します)。2つの採点者の判定は、すべての変化の方向について一致しています。 - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025。専門家が作成した、答えが一意に定まる質問で構成され、参照解答に照らして採点します。最初の500問を使用し、ベンチマーク自体の情報源を検索対象から除外したうえで、参照21と同じセットアップで測定しました。各構成で各質問を3回試行し、2026年9月8日〜10日に実行しました。Claude Opus 5が、デフォルトどおり適応型思考を有効にした状態で、各回答を参照解答と比較します。判定モデルはすべての構成で500問中495問を採点し、スコアはこの495問を対象としています。残りの5問は、採点リクエストが判定モデルの100万トークンの上限を超えたため採点できませんでした。4時間の制限に達した試行は再実行し、再実行の結果を採用しているため、すべての構成で1,500回の試行がすべて揃っています。ベンチマーク本来の採点方法に従って採点できなかった5問を0点としても、どの知見も変わりません。
- 物理セット: 研究レベルの物理問題70問からなる社内セットで、公開されているCritPtベンチマークを改変したものです(Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025)。問題文は専門家のレビュアーが修正しました。Claude Opus 5が、非公開の専門家による参照解に照らして各回答を採点するため、スコアは公表結果と比較できません。スコアは、問題ごとに試行の評点を平均し、それを全問題で平均した値です。70問すべてを問題ごとに4回試行し、2026年9月8日〜9日に実行して測定しました。すべてのエージェントは、ネットワークにアクセスできないサンドボックスコンテナ内でPythonツール、シェル、ファイルエディターを使用でき、検索ツールとフェッチツールは使用できませんでした。それ以外のセットアップは参照21と同じです。物理セットについては実行前にスコアの許容範囲を設定していなかったため、このページではスコアの変化を95%区間とともに示し、許容範囲内かどうかは記述していません。
次のステップ
このページで最大の無料の成果:セットアップ、有効期間、診断。
単一モデル内で知能をレイテンシとコストと引き換えにします。
Claudeモデルファミリー全体で能力、速度、コストを評価します。
エージェントループに、自己調整の基準となるトークンのカウントダウンを与えます。
Managed Agentsセッションにドル建てのハード上限を設定します。
すべてのClaudeモデルの現在のトークンあたり価格を確認します。
実行可能なノートブックで、動作するエージェントにこれらのレバーを1つずつ適用し、各ステップ後のタスクあたりコストを確認します。
アドバイザーパターンとオーケストレーターパターンのウォークスルーをご覧ください。
Was this page helpful?