チケットルーティング
このガイドでは、Claudeの高度な自然言語理解能力を活用して、顧客の意図、緊急度、優先順位、顧客プロファイルなどに基づいてカスタマーサポートチケットを大規模に分類する方法を説明します。
前提条件
- ClaudeのAPIキーとインストール済みのPython SDK
- 既存のサポートチケットシステムへのアクセスと、そのシステムに関する知識
- テスト用の過去のサポートチケットのサンプルセット
チケットルーティングにClaudeを使用するかどうかを判断する
分類タスクに従来のMLアプローチではなく、Claudeのような「large language model」(大規模言語モデル)、すなわちLLMを使用すべきであることを示す主な指標を以下に示します。
従来のMLプロセスでは、大規模なラベル付きデータセットが必要です。Claudeの事前訓練済みモデルは、わずか数十件のラベル付きサンプルでチケットを効果的に分類できるため、データ準備の時間とコストを大幅に削減できます。
従来のMLアプローチが一度確立されると、それを変更するのは手間がかかり、大量のデータを必要とする作業になります。一方、製品や顧客のニーズが進化しても、Claudeはトレーニングデータの大規模な再ラベル付けを行うことなく、クラス定義の変更や新しいクラスに容易に適応できます。
従来のMLモデルは非構造化データの扱いに苦労することが多く、大規模な特徴量エンジニアリングを必要とします。Claudeの高度な言語理解により、厳密なオントロジー構造に依存するのではなく、内容とコンテキストに基づいた正確な分類が可能になります。
従来のMLアプローチは、bag-of-wordsモデルや単純なパターンマッチングに依存することがよくあります。Claudeは、クラスが例ではなく条件によって定義されている場合に、その根底にあるルールを理解して適用することに優れています。
多くの従来のMLモデルは、意思決定プロセスについてほとんど洞察を提供しません。Claudeは分類の判断について人間が読める説明を提供できるため、自動化システムへの信頼を構築し、必要に応じて容易に適応させることができます。
従来のMLシステムは外れ値や曖昧な入力の扱いに苦労することが多く、誤分類したり、包括的なカテゴリにデフォルトで振り分けたりすることが頻繁にあります。Claudeの自然言語処理能力により、サポートチケットのコンテキストやニュアンスをより適切に解釈できるため、手動での介入が必要となる誤ルーティングや未分類のチケットの数を減らせる可能性があります。
従来のMLアプローチでは通常、サポートする言語ごとに個別のモデルや大規模な翻訳プロセスが必要です。Claudeの多言語能力により、個別のモデルや大規模な翻訳プロセスを必要とせずにさまざまな言語のチケットを分類できるため、グローバルな顧客基盤へのサポートを効率化できます。
LLMサポートワークフローを構築してデプロイする
現在のサポートアプローチを理解する
自動化する前に、既存のチケットシステムを理解することが重要です。まず、サポートチームが現在どのようにチケットルーティングを処理しているかを調査することから始めましょう。
次のような質問を検討してください。
- どのSLA/サービス提供が適用されるかを決定するために、どのような基準が使用されていますか?
- チケットルーティングは、チケットがどのサポート階層または製品スペシャリストに送られるかを決定するために使用されていますか?
- すでに導入されている自動化ルールやワークフローはありますか?それらはどのような場合に失敗しますか?
- エッジケースや曖昧なチケットはどのように処理されていますか?
- チームはどのようにチケットの優先順位を付けていますか?
人間が特定のケースをどのように処理しているかを知れば知るほど、Claudeと協力してタスクをより適切に実行できるようになります。
ユーザー意図のカテゴリを定義する
明確に定義されたユーザー意図カテゴリのリストは、Claudeによる正確なサポートチケット分類に不可欠です。Claudeがシステム内でチケットを効果的にルーティングする能力は、システムのカテゴリがどれだけ明確に定義されているかに正比例します。
ユーザー意図のカテゴリとサブカテゴリの例を以下に示します。
- ハードウェアの問題
- ソフトウェアのバグ
- 互換性の問題
- パフォーマンスの問題
- パスワードのリセット
- アカウントアクセスの問題
- 請求に関する問い合わせ
- サブスクリプションの変更
- 機能に関する問い合わせ
- 製品の互換性に関する質問
- 価格情報
- 在庫状況に関する問い合わせ
- 操作方法に関する質問
- 機能の使用に関する支援
- ベストプラクティスに関するアドバイス
- トラブルシューティングのガイダンス
- バグ報告
- 機能リクエスト
- 一般的なフィードバックや提案
- 苦情
- 注文状況に関する問い合わせ
- 配送情報
- 返品と交換
- 注文の変更
- インストールの支援
- アップグレードのリクエスト
- メンテナンスのスケジュール設定
- サービスの解約
- データプライバシーに関する問い合わせ
- 不審なアクティビティの報告
- セキュリティ機能に関する支援
- 規制コンプライアンスに関する質問
- 利用規約に関する問い合わせ
- 法的文書のリクエスト
- 重大なシステム障害
- 緊急のセキュリティ問題
- 時間的制約のある問題
- 製品トレーニングのリクエスト
- ドキュメントに関する問い合わせ
- ウェビナーやワークショップの情報
- インテグレーションの支援
- APIの使用に関する質問
- サードパーティとの互換性に関する問い合わせ
意図に加えて、チケットのルーティングと優先順位付けは、緊急度、顧客タイプ、SLA、言語などの他の要因にも影響される場合があります。自動ルーティングシステムを構築する際には、他のルーティング基準も必ず考慮してください。
成功基準を確立する
サポートチームと協力して、測定可能なベンチマーク、しきい値、目標を含む明確な成功基準を定義してください。
サポートチケットルーティングにLLMを使用する際の標準的な基準とベンチマークを以下に示します。
この指標は、Claudeが類似のチケットを時間の経過とともにどれだけ一貫して分類するかを評価します。これはルーティングの信頼性を維持するために重要です。標準化された入力セットでモデルを定期的にテストすることで測定し、95%以上の一貫性率を目指してください。
これは、Claudeが新しいカテゴリや変化するチケットパターンにどれだけ速く適応できるかを測定します。新しいチケットタイプを導入し、モデルがこれらの新しいカテゴリで満足のいく精度(例:90%超)を達成するまでにかかる時間を測定することでテストします。50〜100件のサンプルチケット以内での適応を目指してください。
これは、複数の言語のチケットを正確にルーティングするClaudeの能力を評価します。さまざまな言語でのルーティング精度を測定し、主要言語以外での精度低下が5〜10%以内に収まることを目指してください。
これは、珍しいチケットや複雑なチケットに対するClaudeのパフォーマンスを評価します。エッジケースのテストセットを作成してルーティング精度を測定し、これらの難しい入力に対して少なくとも80%の精度を目指してください。
これは、さまざまな顧客層にわたるルーティングにおけるClaudeの公平性を測定します。潜在的なバイアスについてルーティングの判断を定期的に監査し、すべての顧客グループにわたって一貫したルーティング精度(2〜3%以内)を目指してください。
トークン数の最小化が重要な状況において、この基準は最小限のコンテキストでClaudeがどれだけうまく機能するかを評価します。提供するコンテキストの量を変えてルーティング精度を測定し、チケットのタイトルと簡単な説明だけで90%以上の精度を目指してください。
これは、ルーティングの判断に対するClaudeの説明の質と関連性を評価します。人間の評価者が説明をスケール(例:1〜5)で採点し、平均スコア4以上の達成を目標とします。
LLMを使用するかどうかに関係なく役立つ可能性のある一般的な成功基準を以下に示します。
ルーティング精度は、チケットが最初の試行で適切なチームまたは個人に正しく割り当てられる頻度を測定します。これは通常、全チケットのうち正しくルーティングされたチケットの割合として測定されます。業界のベンチマークでは90〜95%の精度を目指すことが多いですが、これはサポート体制の複雑さによって異なる場合があります。
この指標は、チケットが送信されてからどれだけ速く割り当てられるかを追跡します。割り当て時間が短いほど、一般的に解決が早くなり、顧客満足度が向上します。クラス最高のシステムでは平均割り当て時間が5分未満であることが多く、多くのシステムがほぼ瞬時のルーティング(LLMの実装で可能)を目指しています。
再ルーティング率は、最初のルーティング後にチケットを再割り当てする必要がある頻度を示します。率が低いほど、最初のルーティングがより正確であることを示唆します。再ルーティング率10%未満を目指してください。トップクラスのシステムでは5%以下の率を達成しています。
これは、顧客との最初のやり取りで解決されたチケットの割合を測定します。率が高いほど、効率的なルーティングと準備の整ったサポートチームであることを示します。業界のベンチマークは通常70〜75%の範囲で、トップパフォーマーは80%以上の率を達成しています。
平均処理時間は、チケットを最初から最後まで解決するのにかかる時間を測定します。効率的なルーティングにより、この時間を大幅に短縮できます。ベンチマークは業界や複雑さによって大きく異なりますが、多くの組織は重大でない問題について平均処理時間を24時間未満に保つことを目指しています。
多くの場合、やり取り後のアンケートを通じて測定されるこれらのスコアは、サポートプロセスに対する顧客の全体的な満足度を反映します。効果的なルーティングは満足度の向上に貢献します。CSATスコア90%以上を目指してください。トップパフォーマーは95%以上の満足度を達成することがよくあります。
これは、チケットをより上位のサポート階層にエスカレーションする必要がある頻度を測定します。エスカレーション率が低いほど、最初のルーティングがより正確であることを示すことが多いです。エスカレーション率20%未満を目指してください。クラス最高のシステムでは10%以下の率を達成しています。
この指標は、ルーティングソリューションの導入後にエージェントが効果的に処理できるチケットの数を調べます。ルーティングが改善されれば生産性が向上するはずです。エージェント1人あたりの1日または1時間ごとの解決チケット数を追跡することで測定し、新しいルーティングシステムの導入後に10〜20%の改善を目指してください。
これは、ルーティングシステムに入る前にセルフサービスオプションを通じて解決された潜在的なチケットの割合を測定します。率が高いほど、ルーティング前のトリアージが効果的であることを示します。回避率20〜30%を目指してください。トップパフォーマーは40%以上の率を達成しています。
この指標は、各サポートチケットを解決するための平均コストを計算します。効率的なルーティングは、時間の経過とともにこのコストの削減に役立つはずです。ベンチマークは大きく異なりますが、多くの組織は改善されたルーティングシステムの導入後にチケットあたりのコストを10〜15%削減することを目指しています。
適切なClaudeモデルを選択する
モデルの選択は、コスト、精度、応答時間の間のトレードオフによって決まります。
多くのお客様は、claude-haiku-4-5-20251001がチケットルーティングに理想的なモデルであると感じています。これはClaude 4ファミリーの中で最も高速かつコスト効率の高いモデルでありながら、優れた結果を提供するためです。分類の問題に深い専門知識や大量の意図カテゴリ、または複雑な推論が必要な場合は、より大きなSonnetモデルを選択することもできます。
強力なプロンプトを構築する
チケットルーティングは分類タスクの一種です。Claudeはサポートチケットの内容を分析し、問題の種類、緊急度、必要な専門知識、またはその他の関連要因に基づいて、事前に定義されたカテゴリに分類します。
チケット分類プロンプトを作成しましょう。最初のプロンプトには、ユーザーリクエストの内容を含め、推論と意図の両方を返すようにする必要があります。
チケットルーティング分類プロンプトの例を以下に示します。
def classify_support_request(ticket_contents):
    # 分類タスク用のプロンプトを定義
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""このプロンプトの主要な構成要素は以下のとおりです。
- プロンプトテンプレートはPythonのf-stringであり、
ticket_contentsを<request>タグ内に挿入できます。 - プロンプトは、チケットの内容を注意深く分析して顧客の中核的な意図とニーズを判断する分類システムとして、明確に定義された役割をClaudeに与えています。
- プロンプトは適切な出力フォーマットについてClaudeに指示しています。この場合、
<reasoning>タグ内に推論と分析を提供し、続いて<intent>タグ内に適切な分類ラベルを提供するよう指示しています。 - プロンプトは有効な意図カテゴリとして「Support, Feedback, Complaint」、「Order Tracking」、「Refund/Exchange」を指定しています。
- プロンプトには、出力のフォーマット方法を示すためのいくつかの例(いわゆるfew-shotプロンプティング)が含まれており、これにより精度と一貫性が向上します。
Claudeに応答を個別のXMLタグセクションに分割させることで、正規表現を使用して出力から推論と意図を独立して抽出できます。これにより、意図のみを使用してチケットをどの担当者にルーティングするかを決定するなど、チケットルーティングワークフローにおいて的を絞った次のステップを作成できます。
プロンプトをデプロイする
テスト用の本番環境にデプロイして評価を実行しなければ、プロンプトがどれだけうまく機能するかを知ることは困難です。
デプロイ構造を構築しましょう。まず、Claudeへの呼び出しをラップするメソッドシグネチャを定義します。先ほど書き始めたticket_contentsを入力として受け取るメソッドを拡張し、reasoningとintentのタプルを出力として返すようにします。従来のMLを使用した既存の自動化がある場合は、代わりにそのメソッドシグネチャに従うとよいでしょう。
import re

# Claude APIクライアントのインスタンスを作成します
client = anthropic.Anthropic()

# デフォルトのモデルを設定します
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # 分類タスク用のプロンプトを定義します
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # プロンプトをAPIに送信し、サポートリクエストを分類します。
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Pythonの正規表現ライブラリを使用して`reasoning`を抽出します。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同様に、`intent`も抽出します。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
このコードは以下を行います。
- APIキーを使用してクライアントインスタンスを作成します。
ticket_contents文字列を受け取るclassify_support_request関数を定義します。classification_promptを使用して、分類のためにticket_contentsをClaudeに送信します。- 応答から抽出したモデルの
reasoningとintentを返します。
解析の前に推論と意図のテキスト全体が生成されている必要があるため、この例ではstream=False(デフォルト)を設定しています。
プロンプトを評価する
プロンプティングを本番環境で使用できる状態にするには、多くの場合テストと最適化が必要です。ソリューションの準備状況を判断するには、先に確立した成功基準としきい値に基づいてパフォーマンスを評価します。
評価を実行するには、実行対象となるテストケースが必要です。このガイドの残りの部分では、すでにテストケースを開発済みであることを前提としています。
評価関数を構築する
このガイドの評価例では、次の主要な指標に沿ってClaudeのパフォーマンスを測定します。
- 精度
- 分類あたりのコスト
重要視する要因に応じて、他の軸でClaudeを評価する必要がある場合もあります。
これを評価するには、まずスクリプトを修正して、予測された意図と実際の意図を比較し、正しい予測の割合を計算する関数を追加します。次に、コスト計算と時間測定の機能を追加します。
import re

# Claude APIクライアントのインスタンスを作成します
client = anthropic.Anthropic()

# デフォルトのモデルを設定します
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # 分類タスク用のプロンプトを定義します
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Pythonの正規表現ライブラリを使用して`reasoning`を抽出します。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同様に、`intent`も抽出します。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # モデルの予測が正しいかどうかを確認します。
    correct = actual_intent.strip() == intent.strip()

    # reasoning、intent、correct、usageを返します。
    return reasoning, intent, correct, usage
編集内容の内訳は以下のとおりです。
classify_support_requestメソッドは、テストケースからactual_intentを受け取り、Claudeの意図分類と比較して一致するかどうかを評価するようになりました。- このメソッドは、API呼び出しの使用統計を抽出し、使用された入力トークンと出力トークンに基づいてコストを計算します。
評価を実行する
適切な評価には、何が良い結果であるかを判断するための明確なしきい値とベンチマークが必要です。前述のスクリプトは精度、応答時間、分類あたりのコストの実行時の値を返しますが、明確に確立されたしきい値が依然として必要です。例:
- 精度: 95%(100件のテスト中)
- 分類あたりのコスト: 現在のルーティング方法から平均50%削減(100件のテスト全体で)
これらのしきい値を設けることで、どの方法が最適か、また要件により適合させるためにどのような変更が必要かを、大規模かつ公平な実証に基づいて迅速かつ容易に判断できます。
パフォーマンスを向上させる
複雑なシナリオでは、標準的なプロンプトエンジニアリング手法やガードレール実装戦略を超えて、パフォーマンスを向上させるための追加の戦略を検討することが役立つ場合があります。一般的なシナリオを以下に示します。
意図カテゴリが20以上ある場合は分類階層を使用する
クラスの数が増えると、必要な例の数も増え、プロンプトが扱いにくくなる可能性があります。代替案として、複数の分類器を組み合わせた階層的な分類システムの実装を検討できます。
- 意図を分類ツリー構造に整理します。
- ツリーの各レベルに一連の分類器を作成し、カスケード型のルーティングアプローチを可能にします。
たとえば、チケットを「Technical Issues」、「Billing Questions」、「General Inquiries」に大まかに分類するトップレベルの分類器を用意できます。これらの各カテゴリには、分類をさらに絞り込むための独自のサブ分類器を持たせることができます。
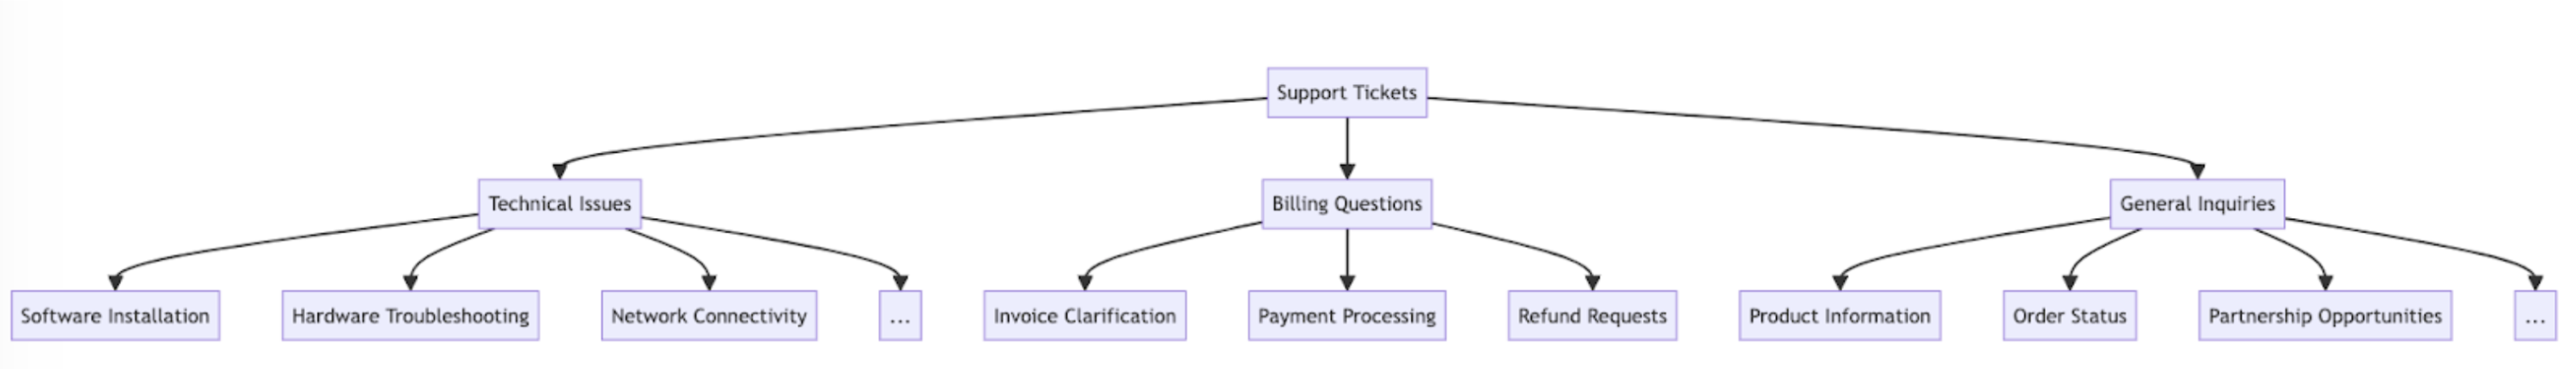
-
長所 - より細かなニュアンスと精度: 親パスごとに異なるプロンプトを作成できるため、より的を絞ったコンテキスト固有の分類が可能になります。これにより、精度が向上し、顧客リクエストをよりきめ細かく処理できるようになります。
-
短所 - レイテンシの増加: 複数の分類器を使用すると「latency」(レイテンシ)が増加する可能性があることに注意してください。Anthropicは、このアプローチを最速のモデルであるHaikuで実装することを推奨しています。
ベクトルデータベースと類似検索による取得を使用して、ばらつきの大きいチケットを処理する
例を提供することがパフォーマンスを向上させる最も効果的な方法であるにもかかわらず、サポートリクエストのばらつきが大きい場合、1つのプロンプトに十分な例を含めることが難しい場合があります。
このシナリオでは、ベクトルデータベースを使用して例のデータセットから類似検索を行い、特定のクエリに最も関連性の高い例を取得できます。
分類レシピで詳しく説明されているこのアプローチは、精度を71%から93%に向上させることが示されています。
予想されるエッジケースを具体的に考慮する
Claudeがチケットを誤分類する可能性のあるシナリオを以下に示します(状況に固有の他のシナリオもあるかもしれません)。これらのシナリオでは、Claudeがエッジケースをどのように処理すべきかについて、プロンプト内で明示的な指示や例を提供することを検討してください。
顧客はニーズを間接的に表現することがよくあります。たとえば、「荷物を2週間以上待っています」は、注文状況に関する間接的なリクエストである可能性があります。
- 解決策: この種のリクエストの実際の顧客例を、その根底にある意図とともにClaudeに提供してください。特にニュアンスの微妙なチケットの意図について分類の根拠を含めると、Claudeがそのロジックを他のチケットにより適切に一般化できるため、さらに良い結果が得られます。
顧客が不満を表明すると、Claudeは根本的な問題の解決よりも感情への対処を優先する場合があります。
- 解決策: 顧客の感情をいつ優先すべきか、またはすべきでないかについてClaudeに指示を与えてください。「顧客の感情はすべて無視してください。顧客のリクエストの意図と、顧客が求めている可能性のある情報の分析のみに集中してください。」のような簡単なものでも構いません。
顧客が1回のやり取りで複数の問題を提示すると、Claudeは主要な懸念事項を特定するのが難しい場合があります。
- 解決策: 意図の優先順位を明確にして、Claudeが抽出した意図をより適切にランク付けし、主要な懸念事項を特定できるようにしてください。
Claudeをより大きなサポートワークフローに統合する
適切な統合には、Claudeベースのチケットルーティングスクリプトが、より大きなチケットルーティングシステムのアーキテクチャにどのように適合するかについて、いくつかの決定を行う必要があります。これには2つの方法があります。
- プッシュベース: 使用しているサポートチケットシステム(例:Zendesk)がルーティングサービスにWebhookイベントを送信することでコードをトリガーし、ルーティングサービスが意図を分類してルーティングします。
- このアプローチはWebスケーラビリティに優れていますが、パブリックエンドポイントを公開する必要があります。
- プルベース: コードが所定のスケジュールに基づいて最新のチケットをプルし、プル時にルーティングします。
- このアプローチは実装が容易ですが、プル頻度が高すぎるとサポートチケットシステムへの不要な呼び出しが発生する可能性があり、プル頻度が低すぎると過度に遅くなる可能性があります。
どちらのアプローチでも、スクリプトをサービスでラップする必要があります。アプローチの選択は、サポートチケットシステムが提供するAPIによって決まります。
その他のサンプルコードと詳細な評価ガイダンスについては、分類クックブックをご覧ください。
Claude Consoleでワークフローの構築と評価を始めましょう。
Was this page helpful?