Оптимизация стоимости и интеллекта
Балансируйте стоимость и интеллект на Claude Platform, опираясь на измеренные результаты для кэширования подсказок, усилия, выбора модели, бюджетов и многомодельных стратегий.
Когда рабочая нагрузка переходит от прототипа к продакшену, стоимость становится одним из главных ограничений при проектировании. Самая мощная модель может оказаться слишком дорогой в масштабе, а самая недорогая — не дотягивать по качеству. Чтобы грамотно управлять стоимостью, нужно понимать, как каждый рычаг стоимости влияет на качество вывода: одни рычаги снижают качество, а другие — нет. Claude Platform даёт вам прямой контроль над этим компромиссом. Для каждого запроса вы выбираете модель, «effort level» (уровень усилий) и архитектуру. Это позволяет разместить рабочую нагрузку практически в любой точке на «cost-to-intelligence frontier» (границе соотношения стоимости и интеллекта).
Стоимость и интеллект обычно представляют как границу, на которой одно приобретается за счёт другого. Первая группа рычагов на этой странице приближает рабочую нагрузку к этой границе: она снижает стоимость, не затрагивая качество. Лишь вторая группа перемещает нагрузку вдоль границы:
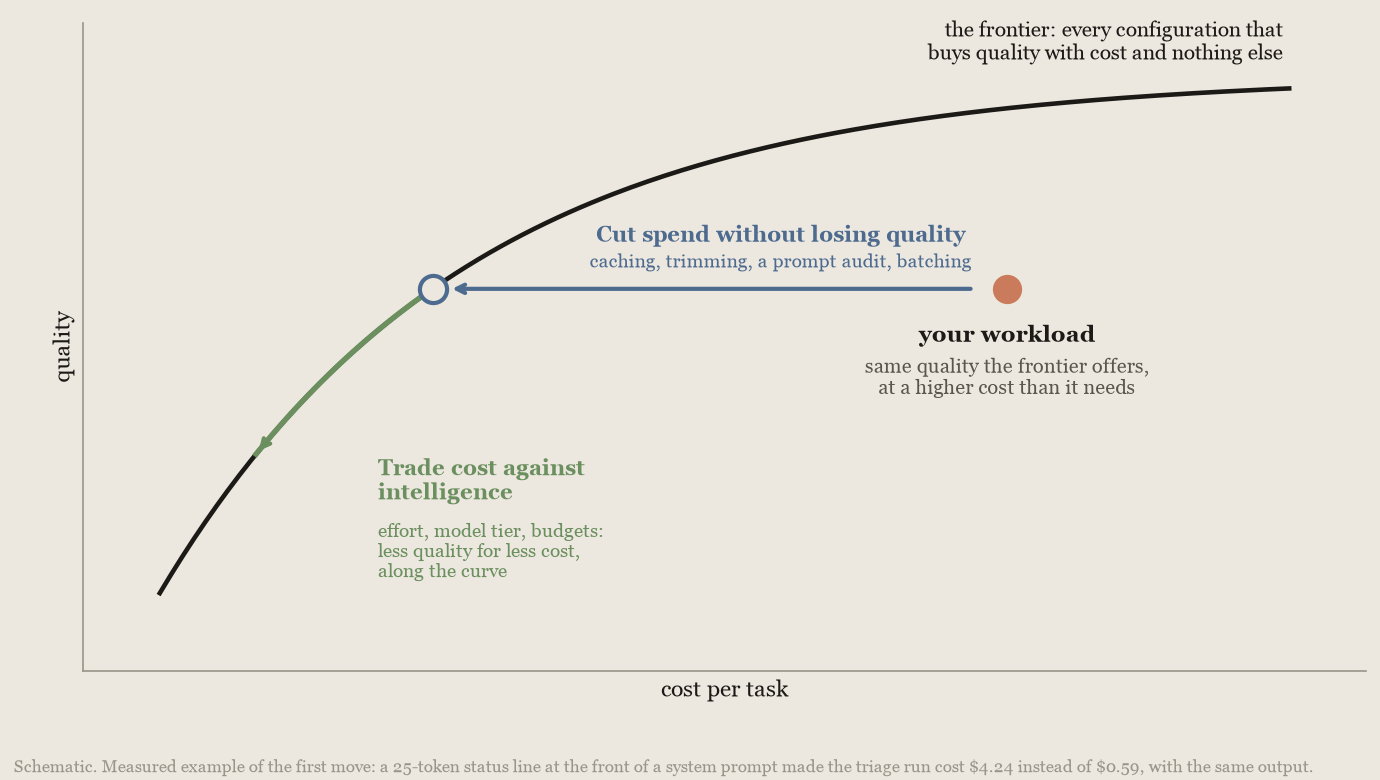
Рычаги бывают двух видов:
- Бесплатные выигрыши снижают расходы без ущерба для качества. Это «prompt caching» (кэширование подсказок), «token hygiene» (гигиена токенов), аудит подсказок под используемую модель, «batch processing» (пакетная обработка) со скидкой 50% для работы, которая может подождать до 24 часов, и лимиты расходов рабочего пространства в качестве страховки.
- Компромиссы обменивают стоимость на интеллект. Это выбор модели, уровень усилий, ограничения вывода и бюджеты задач, часы прошедшего времени и многомодельные архитектуры.
Для каждого рычага приведены измеренные результаты и правило, когда он окупается. По измерениям Anthropic, кэширование подсказок оказалось самым крупным рычагом с большим отрывом. На бенчмарках этого руководства оно снизило стоимость «agent loop» (агентного цикла) в 2,7–5,3 раза. Счёт небольшого агента сортировки оно сократило на 83%, а вместе с сокращением входных данных — на 88%. Многомодельные рычаги применимы в более узком круге случаев: вторая модель окупилась в двух вариантах — как советник и как оркестратор.
С чего начать
Найдите строку, соответствующую вашей ситуации.
| Ваша ситуация | Что делать | Где |
|---|---|---|
| Любая рабочая нагрузка, любая модель | Включите кэширование подсказок и удалите ненужные токены; оба способа бесплатны | Кэшируйте повторяющийся контекст · Сократите токены |
| Человек делает паузы между ходами | Используйте 1-часовую длительность кэша, если примерно 1 ход из 20 следует за паузой от 5 минут до часа, а паузы длиннее часа редки. На Claude Fable 5.1 поддерживайте 5-минутный кэш тёплым, пока паузы длятся минуты, и выбирайте 1-часовую длительность, когда паузы приближаются к часу. На Claude Opus 5.5 вместо этого поддерживайте 5-минутный кэш тёплым, если лишь один-два хода из 20 следуют за паузой длительностью примерно до получаса | Выберите длительность кэша |
| Затраты слишком высоки, качество устраивает | Постепенно понижайте уровень усилий на текущей модели | Настройте уровень усилий |
| Вы используете не последнюю модель | Обновитесь: по измерениям Anthropic, каждая более новая модель решала не меньше задач, чем предыдущая, и обычно обходилась дешевле в расчёте на решённую задачу | Обновите модель |
| Вы выбираете или меняете модель | Сравнивайте по стоимости выполненной задачи, а не токена | Сравните модели |
| Качество недостаточно | Если вы понижали уровень усилий, верните его; иначе попробуйте модель следующего уровня с усилием low | Настройте уровень усилий · Сравните модели |
Попытки завершаются с stop_reason: max_tokens | Увеличьте max_tokens. При уровне усилий по умолчанию значение 64 000 покрыло все измеренные ходы, кроме 2 из 14 000, а 128 000 не увеличило стоимость решённой задачи | Задайте бюджеты |
| Вы можете проверять результаты (тесты, верификатор) | Запускайте всё с низким уровнем усилий, а неудачные попытки перезапускайте с high. На измеренном бенчмарке по программированию доля успешных решений сохранилась примерно при половине стоимости | Перезапускайте неудачи |
| Агентные циклы с несколькими очень дорогими запусками | Задайте бюджет задачи (бета; поддерживаемые модели см. в таблице поддержки), бюджет сессии Claude Managed Agents и лимит расходов рабочего пространства | Задайте бюджеты |
| Вы хотите, чтобы агентные запуски завершались быстрее | Сообщите модели, что время важно, и показывайте ей прошедшее время. На DRACO, HLE и внутреннем наборе задач по физике запуски заняли на 33–69% меньше времени, стоимость задачи снизилась на 28–54%, а оценки упали не более чем на 1,9 пункта | Показывайте модели прошедшее время |
| Более дешёвая модель буксует только на сложных решениях | Добавьте советника на передовой модели. Он окупается, если его цена значительно выше цены исполнителя и к нему действительно обращаются. Поэтому сначала оцените стоимость одной модели советника при низком уровне усилий и измерьте частоту обращений | Стратегия советника |
| Работа не помещается в одно «context window» (контекстное окно) | Делегируйте части работы более дешёвым исполнителям | Стратегия оркестратора |
Эти результаты получены внутри Anthropic (Использованные бенчмарки). Они носят ориентировочный характер и не являются гарантиями, поэтому проводите измерения на собственной рабочей нагрузке с помощью метода из четырёх шагов.
Сократите расходы без потери качества
Кэширование подсказок, гигиена токенов, пакетная обработка и аудит подсказок относительно вашей текущей модели — всё это снижает то, что вы платите, не снижая качества вывода. Действуют две оговорки: пакетная обработка обменивает задержку на свою скидку, а редактирование контекста, рычаг гигиены токенов, стоило больше, чем сэкономило, в запуске, измеренном в этом разделе.
Кэшируйте повторяющийся контекст
Почему кэширование идёт первым
Включите кэширование подсказок раньше любого другого рычага, потому что каждый ход агентной задачи повторно отправляет весь растущий разговор: «system prompt» (системную подсказку), определения инструментов и каждый предыдущий ход. Задача из 40 ходов отправляет свой первый ход 40 раз, поэтому стоимость задачи растёт примерно как квадрат числа ходов. Кэширование не прекращает повторную отправку, но каждая повторная отправка стоит примерно в десять раз меньше и обрабатывается быстрее: префикс тарифицируется по ставке чтения из кэша, десятой части цены ввода, и каждый ход платит ставку записи в кэш 1,25x только за то, что ново.
Как выглядит хороший результат. За полный день реального трафика агентные циклы читали медианно 84% своего ввода из кэша, а верхние 10% обвязок, для кодирования или нет, читали 94% или больше17. Глубоко в задаче хорошо построенный цикл платит полную цену менее чем за 1% своего ввода. Ниже примерно 80% ищите что-то, что ломает кэш (см. Что ломает кэш).
Во всех измеренных запусках Anthropic чтения из кэша регулярно являются крупнейшей отдельной составляющей стоимости задачи, что делает кэширование более ценным, чем большинство решений о выборе модели. Anthropic оценила запуски DeepResearch Bench II7 с кэшированием и без него:
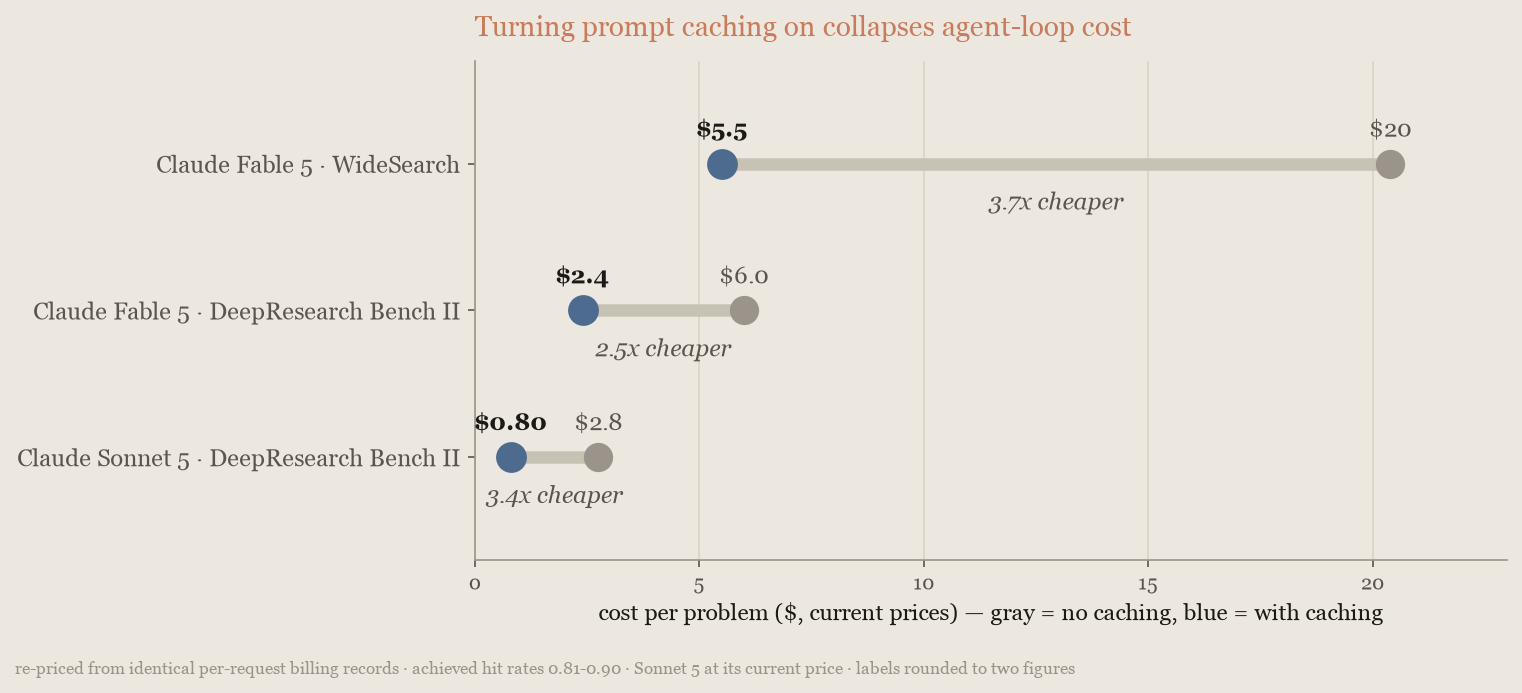
Время жизни кэша по умолчанию — 5 минут, а ходы агентного цикла разделены секундами, поэтому скидка применяется к большинству токенов на каждом ходу. Запуски на диаграмме кэширования читали от 79% до 90% своих входных токенов из кэша. Экономия варьируется в зависимости от глубины эпизода, потому что более короткие циклы перечитывают меньше, но кэширование оставалось крупнейшим отдельным рычагом на каждой измеренной модели и бенчмарке.
Выберите длительность кэша
Если ваш цикл ждёт человека между ходами, используйте 1-часовую длительность кэша. Запись в такой кэш стоит дороже: 2x цены входных данных вместо 1,25x. При промахе кэша любой длительности весь префикс оплачивается по цене записи, а не чтения. Поэтому более длительный вариант окупается, как только несколько ходов за сессию следуют за паузой от 5 минут до часа.
Чтобы принять решение, подсчитайте интервалы между последовательными запросами в диалоге:
- Больше примерно 1 интервала из 20 длятся от 5 минут до часа, а интервалы длиннее часа редки: используйте 1-часовую длительность. Исключение — Claude Opus 5.5: если в этот диапазон попадают лишь 1 или 2 интервала из 20 и ни один не длится дольше примерно получаса, поддерживайте 5-минутный кэш тёплым с помощью «keep-alive requests» (запросов поддержания активности), описанных ниже.
- Ходы следуют друг за другом с интервалом в секунды: оставьте 5-минутную длительность по умолчанию. Без пауз она обходилась на 15% дешевле 1-часовой на Claude Sonnet 5 и примерно на 15–18% дешевле на Claude Opus 5.5.
- Интервалы длиннее часа встречаются часто: оставьте длительность по умолчанию. За интервал длиннее часа истекает кэш любой длительности, и при 1-часовой настройке префикс затем перезаписывается по более высокой цене записи. Поэтому на каждом таком интервале эта настройка проигрывает. Если из ваших пауз длиннее 5 минут примерно 60% или более длятся и дольше часа, оставьте длительность по умолчанию. 1-часовая длительность окупается, только если не менее примерно 40% длинных пауз заканчиваются в пределах часа.
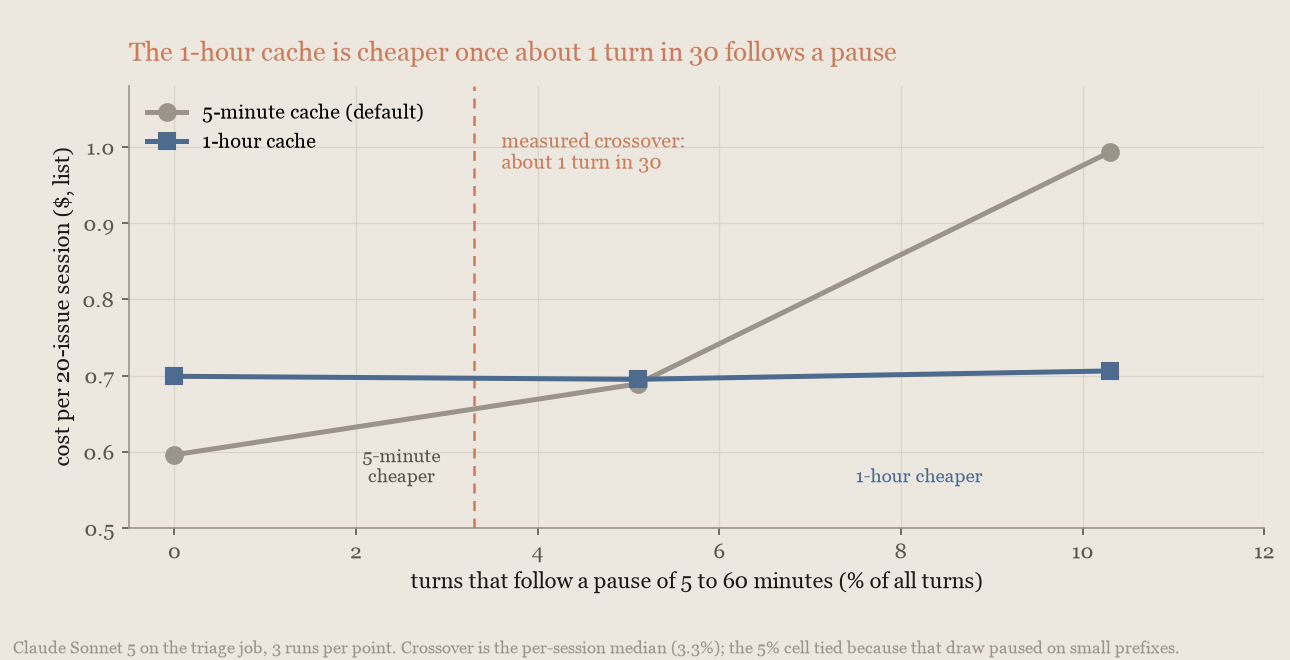
Anthropic измерила задачу сортировки из раздела Сократите входные и контекстные токены, вставив паузы перед некоторыми ходами, чтобы имитировать задержку человека16. На Claude Sonnet 5 и Claude Opus 5.5 1-часовой кэш становился дешевле, как только примерно 1 ход из 30 следовал за паузой. Значит, правило «1 из 20» оставляет запас. После точки пересечения разрыв быстро растёт, потому что при 5-минутной настройке каждый ход после паузы перезаписывает весь префикс. Все текущие модели используют одинаковые множители записи в кэш. Цена чтения тоже одинакова у всех моделей, кроме Claude Fable 5.1, Claude Mythos 5.1 и Claude Opus 5.5. Поэтому на других моделях точка пересечения находится в том же диапазоне; случай Fable 5.1 рассмотрен далее. Точность во всех ячейках оставалась в пределах разброса между запусками. При 1-часовой настройке ход после паузы сохранял задержку тёплого кэша (измерено на Claude Sonnet 5 и Claude Opus 5, но не на Claude Opus 5.5). На следующей диаграмме показана стоимость сессии в зависимости от доли ходов после паузы на Claude Sonnet 5:
Anthropic также измерила дополнительные запросы, которые поддерживают 5-минутный кэш тёплым. На Claude Sonnet 5 они обходились примерно на 8% дешевле 1-часовой длительности, когда за паузой следовал 1 ход из 20, но при 2 ходах из 20 стоили примерно столько же. На Claude Opus 5, предыдущей модели Opus, измеримой экономии они не дали. При паузе в 6 минут или более перед каждым ходом они обходились дороже на обеих моделях. Экономия на Claude Sonnet 5 исчезала уже при 2 ходах из 20, поэтому на Claude Sonnet 5 и Claude Opus 5 используйте 1-часовую длительность.
На Claude Fable 5.1 самой дешёвой оказывается другая настройка. Чтение из кэша у этой модели стоит 0,025x цены входных данных ($0,25 за миллион токенов), а множители записи в кэш остаются стандартными. Поэтому запрос поддержания активности, перечитывающий префикс, обходится дёшево, а надбавка за запись при 1-часовой длительности становится более крупной статьёй расходов. Anthropic измерила задачу сортировки на Claude Fable 5.1 с теми же тремя настройками19. Когда паузы длились минуты, поддержание 5-минутного кэша тёплым обходилось на 13–20% дешевле за сессию, чем 1-часовой кэш. 1-часовой кэш выигрывал лишь при паузах около 45 минут — примерно на 12 центов за сессию. Поэтому на Claude Fable 5.1 поддерживайте 5-минутный кэш тёплым, пока человек отсутствует несколько минут, и выбирайте 1-часовую длительность, когда паузы приближаются к часу:
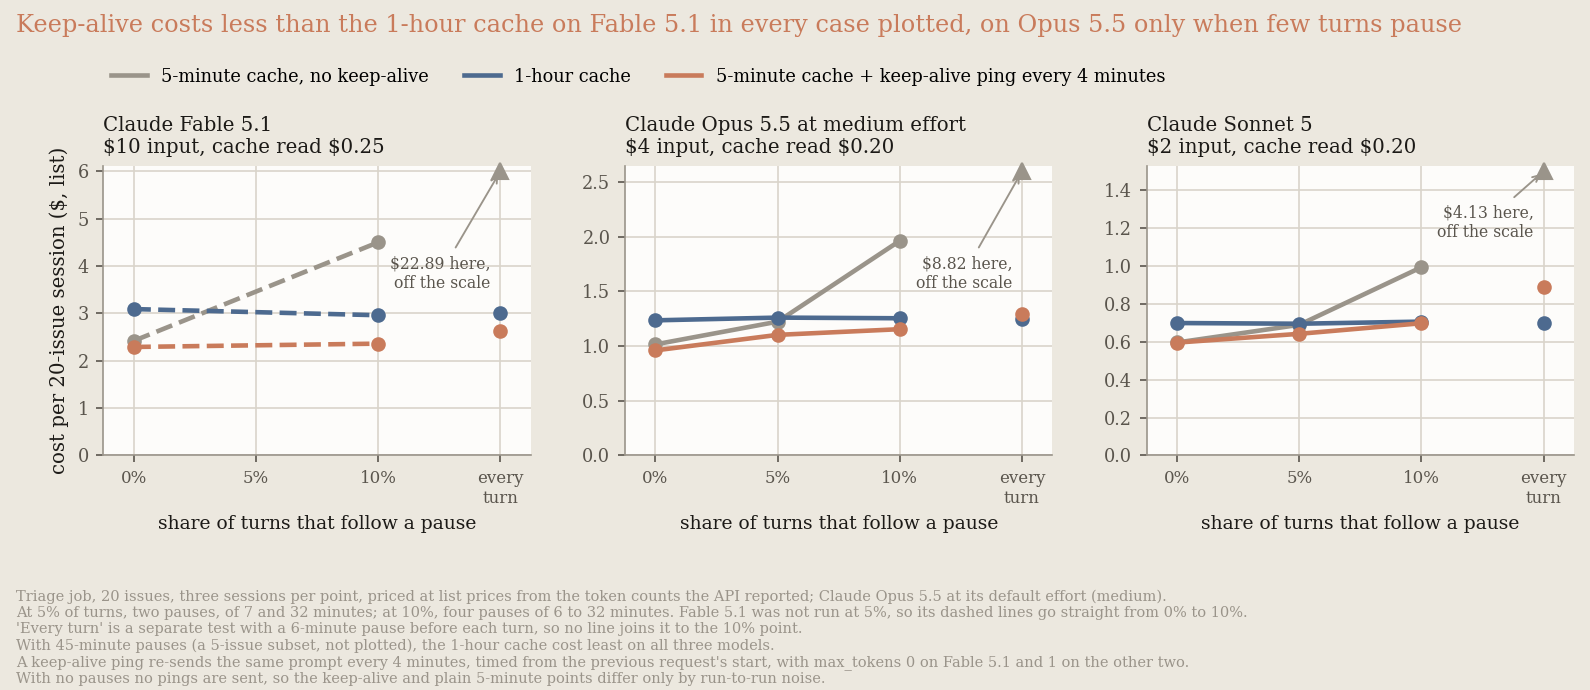
На Claude Opus 5.5 чтение из кэша стоит 0,05x цены входных данных. Когда 5% или 10% ходов следовали за паузой от 6 до 32 минут, запросы поддержания активности обходились на 8–13% дешевле 1-часовой длительности при уровне усилий по умолчанию (medium) и на 10–18% дешевле при high. Но при паузе перед каждым ходом они стоили дороже: примерно на 4–6% при 6-минутных паузах и более чем на 50% при 45-минутных. Поэтому на Claude Opus 5.5 поддерживайте 5-минутный кэш тёплым, если лишь один-два хода из 20 следуют за паузой длительностью примерно до получаса. В остальных случаях следуйте списку в начале этого раздела. В этих измерениях запросы поддержания активности отправлялись с max_tokens: 1. Для описанного далее запроса с max_tokens: 0 предрелизные тесты API Anthropic на Claude Opus 5.5 показывают, что он записывает кэш, а следующий запрос его считывает. Обновляет ли он существующую запись, на Opus 5.5 не измерялось.
Чтобы поддерживать кэш тёплым, повторно отправьте предыдущий запрос с max_tokens, равным 0. Сделайте это в течение 4 минут после начала предыдущего запроса, а затем повторяйте каждые 4 минуты; если был задан stream, уберите его. Отсчитывайте время от начала запроса, а не от окончания ответа. 5-минутное время жизни кэша отсчитывается от начала запроса, который записал или обновил запись, поэтому время генерации ответа тоже входит в эти 5 минут. Такой запрос называется «pre-warming request» (запрос предварительного прогрева): он обновляет время жизни кэша, ничего не генерирует и оплачивается только как чтение из кэша. Не меняйте ни одного байта префикса и не используйте max_tokens: 1: в этом случае модель без всякой необходимости генерирует токен. Отправляйте повторно не только тело запроса, но и его заголовки. Если ваши запросы содержат заголовок anthropic-beta (например, для бюджета задачи), запросу поддержания активности нужен тот же заголовок. Иначе бета-поля в повторно отправленном теле будут отклонены. Запрос с max_tokens: 0 отклоняется, если в нём задано thinking.type: "enabled", «structured outputs» (структурированные выводы) или принудительный выбор инструмента (ограничения). «Adaptive thinking» (адаптивные размышления), которые на Claude Fable 5.1 включены по умолчанию, допустимы. Если рабочая нагрузка использует одну из этих отклоняемых настроек, выбирайте 1-часовую длительность. Запрос с max_tokens: 0 также отклоняется, если содержит параметр верхнего уровня compaction. Поэтому не используйте запрос на «compaction» (сжатие) из сжатия по запросу в качестве запроса поддержания активности.
# В течение 4 минут после начала последнего запроса (время генерации входит
# в срок жизни кэша) повторно отправьте этот запрос с max_tokens, равным
# 0, убрав stream (запрос с max_tokens: 0 не может использовать потоковую передачу). Отправьте те же
# заголовки, что и в исходном запросе, включая заголовок anthropic-beta, если он есть.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Включите кэширование
Настройка требует мало работы. Автоматическое кэширование расставляет точки разрыва за вас; в противном случае навык Claude API, поставляемый с Claude Code, может добавить кэширование в существующую интеграцию по одной подсказке. Следующий фрагмент показывает, как навык добавляет его в обвязку, которая произвела эти измерения:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Эти размещения точек разрыва следуют стандартному шаблону из раздела Явные точки разрыва кэша.
Что ломает кэш
Кэш может сломаться во время задачи по нескольким причинам. Если перед стабильным префиксом стоит что-то, что меняется от запроса к запросу (например, метка времени или позиция в очереди), каждый запрос превращается в полную запись в кэш. В запуске сортировки из раздела Сократите входные и контекстные токены строка состояния из 25 токенов в начале системной подсказки подняла стоимость запуска с $0,59 до $4,24. Это дороже, чем запуск вообще без кэширования. Размещайте текст, зависящий от запроса, в последнем ходе пользователя.
Кэш работает как побайтовое совпадение префикса запроса в порядке следования: инструменты, затем системная подсказка, затем сообщения. Поэтому изменение в любом месте делает недействительным всё, что идёт после него:
- Изменение
effortили конфигурации размышлений между запросами делает кэш недействительным начиная с этой точки, а на некоторых моделях — также инструменты и системную подсказку перед ней. - Любое изменение системной подсказки делает кэш недействительным начиная с этой точки.
- Задание или изменение формата вывода делает недействительным кэш всего диалога.
- Добавление, удаление или перестановка определений инструментов делает недействительным весь кэш.
Эти случаи перечислены на странице кэширования подсказок, кроме формата вывода: он описан на странице структурированных выводов.
На самых новых моделях меняйте инструкции не через поле верхнего уровня system, а с помощью системного сообщения в середине разговора — сообщения {"role": "system"}, добавленного в messages. Так кэшированный префикс остаётся нетронутым. Список поддерживающих моделей приведён на той же странице. На поддерживающих моделях изменение уровня усилий для отдельного сообщения тоже не затрагивает кэшированный префикс.
Выше всего ставки на Claude Fable 5.1 и Claude Mythos 5.1: при поломке кэша префикс перезаписывается по 1,25x цены входных данных вместо чтения по 0,025x. Для префикса в 100 000 токенов один сломанный ход на этих моделях стоит $1,25 вместо $0,03 — в 50 раз дороже чтения. На Claude Opus 5.5 он стоит $0,50 вместо $0,02 (в 25 раз дороже), а на других текущих моделях — в 12,5 раза дороже.
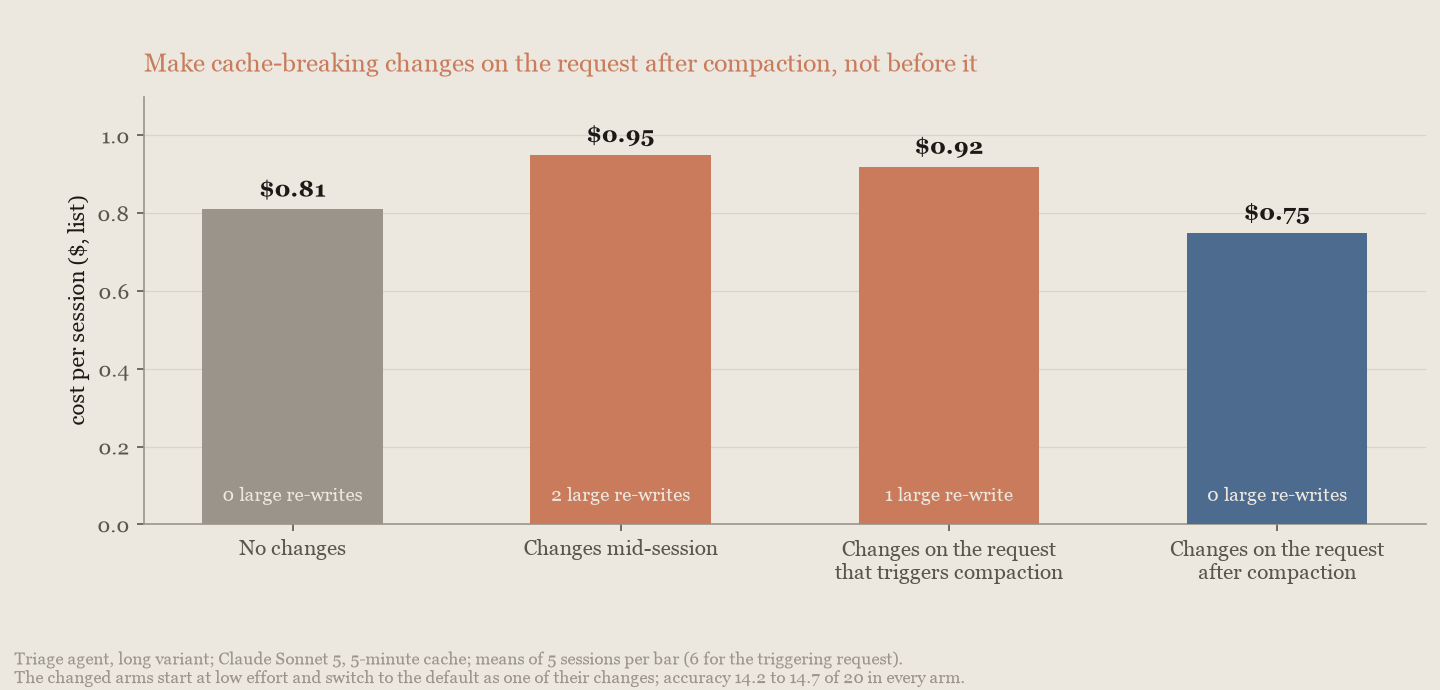
Anthropic измерила это на длинных сессиях агента сортировки18. Изменение уровня усилий и добавление инструмента в середине сессии перезаписали 39 000 и 60 000 кэшированных токенов, и такие сессии стоили $0,95. Те же два изменения в первом запросе после сжатия обошлись в $0,75. В запросе, который запустил сжатие, они обошлись в $0,92: проход суммаризации при сжатии повторно обработал контекст из 81 000 токенов по цене записи в кэш. Этот проход стоил $0,21, а если те же изменения вносились на один запрос позже — $0,04. Точность во всех вариантах оставалась в пределах разброса между запусками:
Изменение бюджета задачи по ходу работы делает недействительным любой кэшированный префикс, содержащий значение бюджета. Поэтому задавайте бюджет один раз, в первом запросе. Каждый проход редактирования контекста делает префикс недействительным начиная с точки очистки, и следующий запрос платит за повторное кэширование всего, что идёт после неё. Поэтому очищайте контекст несколькими крупными пакетами, а не множеством мелких. На Claude Fable 5.1 и Claude Mythos 5.1 каждое из этих действий стоит в 50 раз больше цены чтения за токен, так что там они важнее всего. Вносите все изменения, ломающие кэш, в естественных точках перерыва, а затем проверяйте, не упал ли объём чтения из кэша. Если упал, диагностика кэша покажет, где разошёлся префикс.
Сократите входные и контекстные токены
Большинство запросов агентов содержат токены, которые никак не влияют на ответ. Их удаление редко снижает качество вывода, хотя при измерениях не каждый из этих рычагов сэкономил деньги. Обратите внимание на две области:
- Сокращение входных данных. Динамическая фильтрация в инструменте «web fetch» (веб-загрузки) отсекает шаблонный текст загруженных страниц. Изменение размера изображений подгоняет размер изображений на входе. Поиск инструментов с отложенной загрузкой загружает определения инструментов только при необходимости (измерения приведены далее в этом разделе). Программный вызов инструментов позволяет Claude выполнять несколько вызовов инструментов из кода, так что в контекст попадает только отфильтрованный результат. Согласно его документации, на бенчмарках агентного поиска он сокращает входные токены на 24% и при этом повышает результат. На странице Управление контекстом инструментов сравниваются поиск инструментов, программный вызов инструментов, кэширование подсказок и редактирование контекста.
- Жизненный цикл контекста. Редактирование контекста очищает устаревшие результаты инструментов. Автоматическая компактизация с настраиваемым порогом не даёт длинным циклам переносить всю историю дальше.
Рычаги взаимодействуют с кэшем и друг с другом, поэтому оценивайте их по итоговому эффекту. С помощью диагностики кэша проверяйте, что кэшированный префикс сохраняется после каждого изменения. Anthropic измерила эти рычаги на агенте «issue triage» (сортировки задач), который обрабатывал 20 реальных отчётов об ошибках со скриншотами из публичного репозитория. Также измерялся более длинный вариант той же работы, в котором токенов было в 2,6 раза больше. При включённом кэшировании сокращение входных данных (изменение размера изображений и поиск инструментов) дополнительно снизило стоимость короткого запуска на 26%, а длинного — на 21%.
Отложите неиспользуемые определения инструментов
Каждое определение инструмента, прикреплённое к запросу, является вводом на каждом ходу, а несколько серверов MCP в сумме дают сотни таких определений. Anthropic запустила агента сортировки с его собственными двумя инструментами плюс каталогом реальных определений инструментов с публичных серверов MCP, всего до 502 инструментов, загружая их все или помечая дополнительные как defer_loading за поиском инструментов:
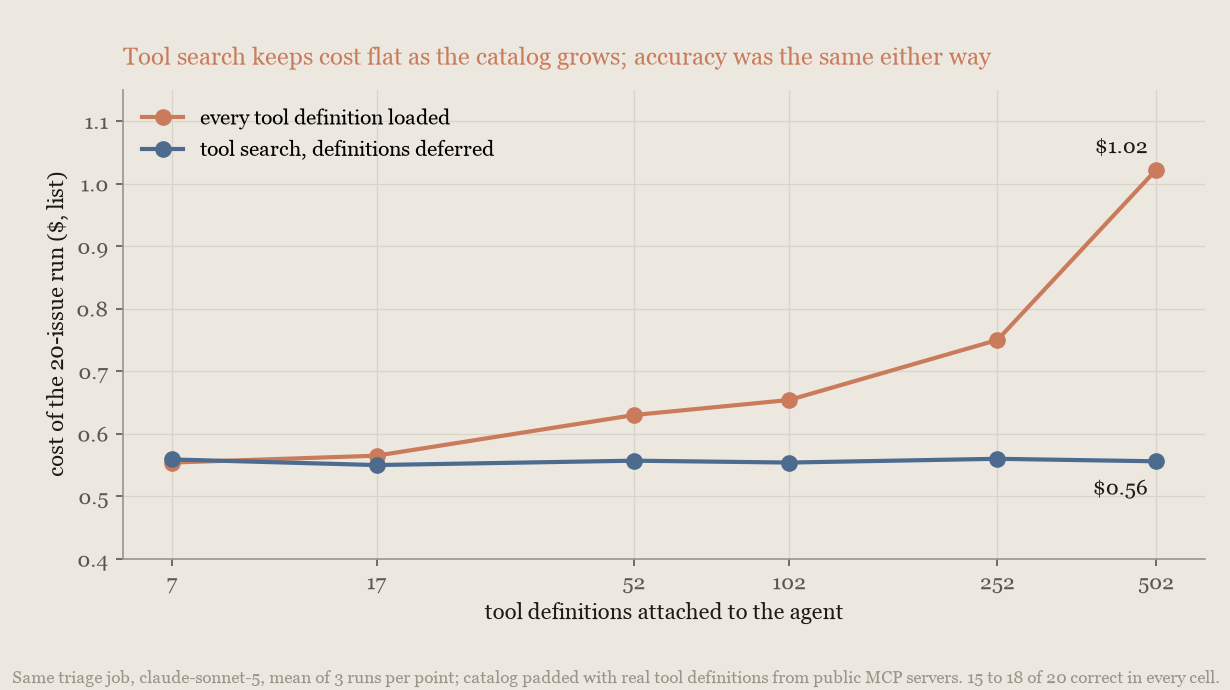
При каждом загруженном определении стоимость запуска почти удвоилась по мере роста каталога, следуя за токенами схем в каждом запросе. С поиском инструментов она оставалась ровной при любом размере каталога, на 45% меньше при 502 инструментах. Точность составляла от 15 до 18 из 20 в каждой ячейке в обоих случаях, и модель ни разу не вызвала неправильный инструмент, так что в этом масштабе каталог стоит денег, а не корректности. То же верно для инструментов, приходящих через коннектор MCP: при подключённом публичном сервере GitHub MCP откладывание его набора инструментов (default_config: {defer_loading: true}) сократило запуск на 20% при той же точности.
Держите файлы данных вне подсказки
Когда модели нужно вычислять по таблице, загрузите её с помощью Files API и позвольте модели запрашивать её с помощью выполнения кода вместо вставки в подсказку. Anthropic задала 25 агрегатных вопросов15 (суммы, отфильтрованные подсчёты, группировки и фильтр по дате) по публичному CSV из 1862 строк, с ответами, вычисленными pandas:
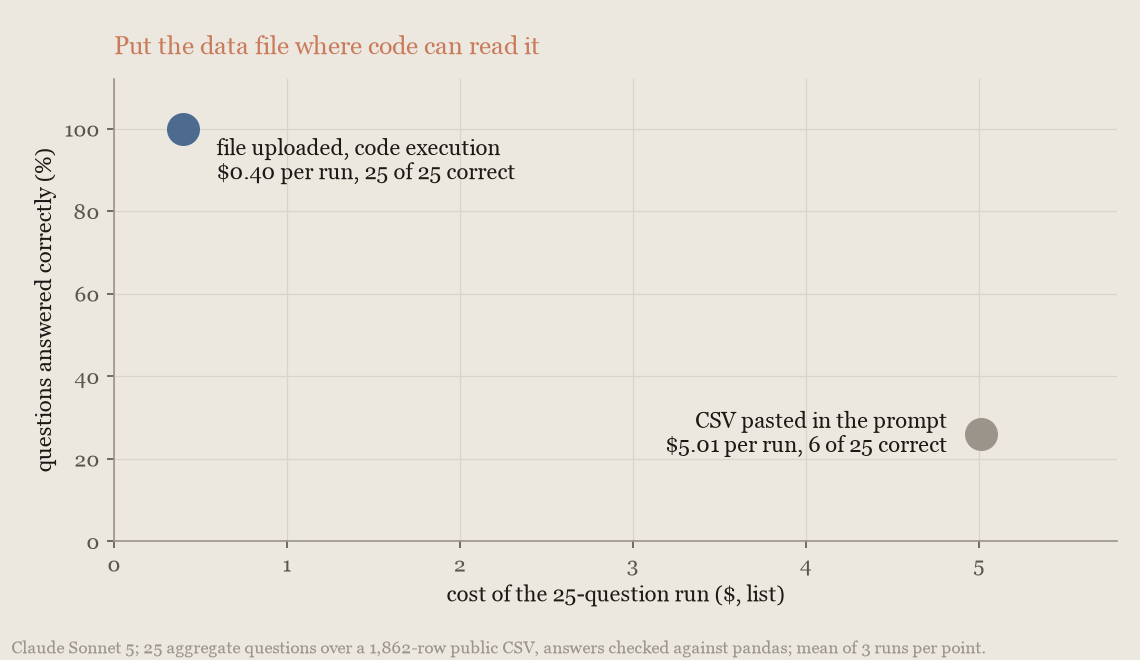
Вставленная в подсказку, таблица составляет около 91 000 входных токенов на каждом запросе, и Claude Sonnet 5 правильно ответил на 6 из 25 вопросов. Загруженная, с выполнением кода, — он ответил на все 25, и запуск стоил примерно в двенадцать раз меньше. Claude Opus 5 показал ту же картину.
Управляйте жизненным циклом контекста
Рычаги контекста окупаются только на сессии, достаточно длинной, чтобы в них нуждаться:
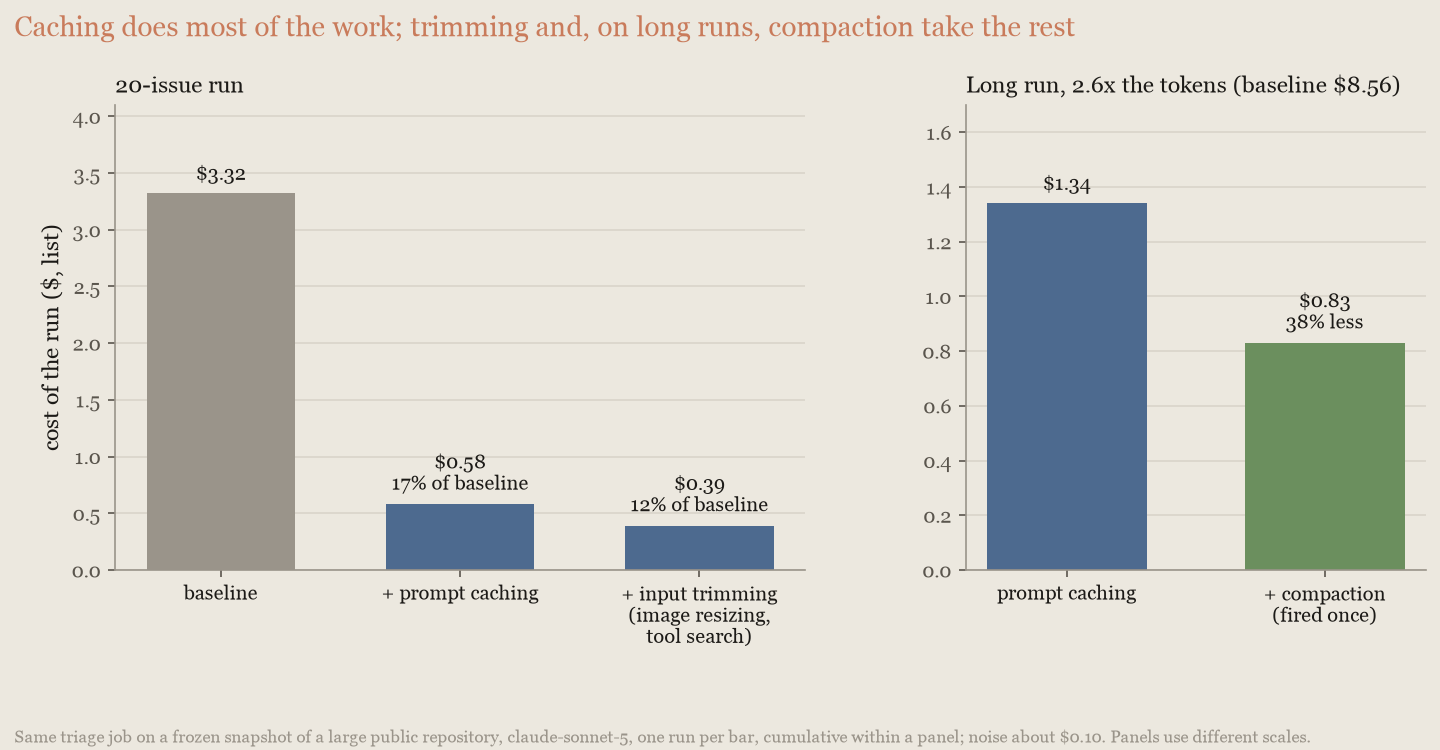
На запуске из 20 issue они ничего не сэкономили, а редактирование контекста стоило на 74% больше. На длинном запуске обрезка сэкономила 39%, а компактизация 32%, тогда как редактирование контекста ничего не изменило. Обрезка — это несколько строк, которые вы пишете сами: на каждой границе задачи заменяйте большие устаревшие результаты инструментов однострочной выдержкой. Она хорошо кэшируется, потому что правки находятся в хвосте разговора, куда следующая задача всё равно добавляет новое содержимое: 89% чтений из кэша на первом запросе после границы и 81% на запросах между границами. В масштабе всего запуска обрезка и редактирование контекста кэшируются примерно одинаково хорошо. Обрезка дешевле, потому что редактирование контекста перезаписывает в середине задачи содержимое, которое обрезка удаляет (около двух третей разрыва), и потому что она держит контекст примерно вдвое меньшим (оставшаяся треть). Если вы используете редактирование контекста, очищайте несколькими большими партиями. Обрезка, адаптированная из обвязки:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # ограничиваем однострочные результаты, чтобы выдержка оставалась короткой
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractПакетируйте работу, которая может подождать
Batch API снимает 50% с каждого токена запроса, включая кэшированные, в обмен на то, что результаты приходят в любое время в течение 24 часов. Направляйте каждый запрос, которого никто не ждёт, через пакет, а интерактивный путь оставьте для остального. Пакетирование — второй по величине бесплатный рычаг после кэширования для агентной работы без присмотра: оценочные запуски, дозаполнения и запланированные задания, такие как регулярный запуск агента сортировки issue из измерения обрезки токенов. Оно сочетается со всем на этой странице, кроме интерактивности, но недоступно для сессий Claude Managed Agents, которые интерактивны по замыслу (см. цены Claude Managed Agents).
Проведите аудит подсказок относительно текущей модели
Каждое поколение моделей реагирует на подсказки по-разному, поэтому подсказка накапливает текст, написанный для модели, которую вы больше не используете. Обычный случай — чрезмерно конкретная инструкция, добавленная для компенсации более старой модели: «проверь дважды», «будь максимально тщательным», обязательная пошаговая процедура или самодельный черновик для рассуждений. Более новая модель следует им буквально, производя дополнительные раунды инструментов и дополнительный текст, так что счёт растёт без выигрыша в точности. Аудит подсказок относительно модели, которую вы используете сейчас, и снова при каждой смене модели — это бесплатный выигрыш.
Аудит — это одна команда. Навык Claude API, поставляемый с Claude Code, имеет команду prompt-audit, которая читает подсказки и код запросов проекта и сообщает, что было написано для другой модели. Этот сокращённый фрагмент показывает её запуск на подсказке службы поддержки и коде запросов, содержащих эти шаблоны:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.Затем команда предлагает свои правки в виде diff (показан один фрагмент) и перечисляет, что она намеренно оставила нетронутым: окно возврата средств, требование к тону и планку качества. Вы проверяете патч, а не переписанный текст.
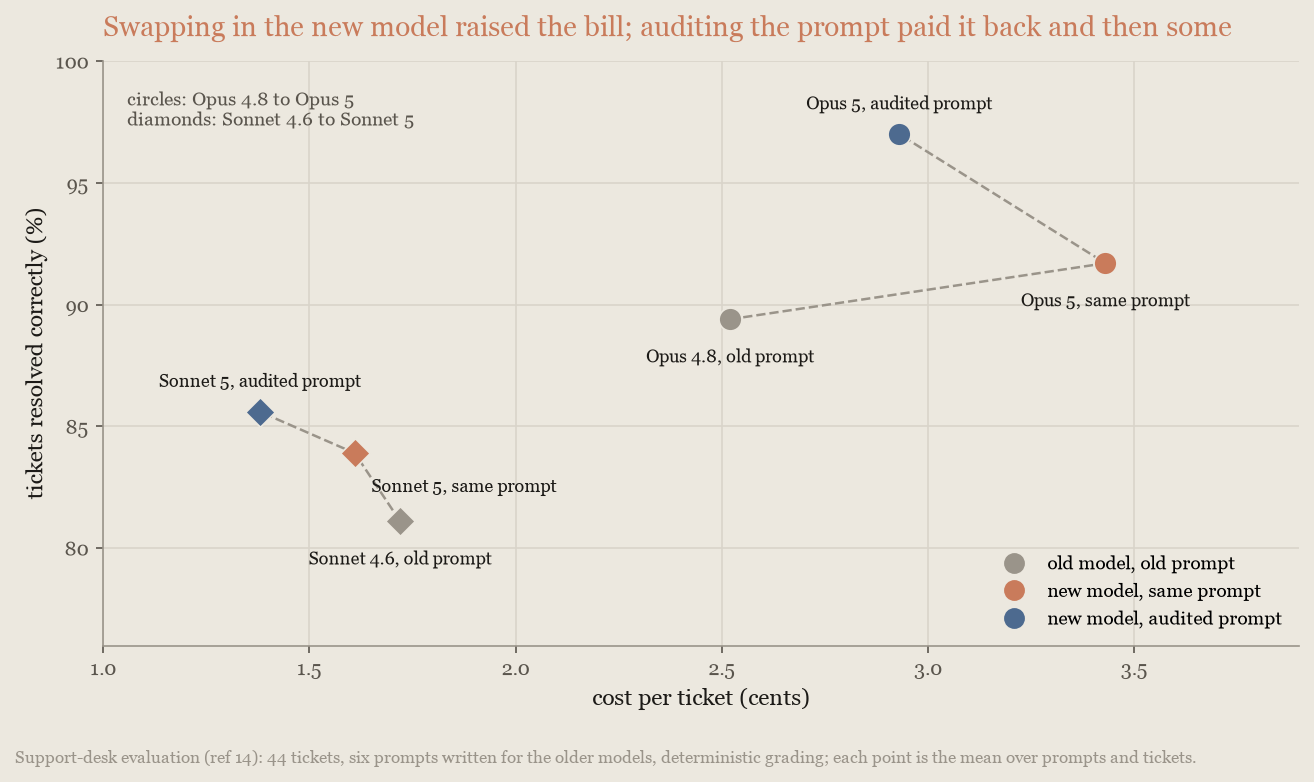
Эффект измерим. На оценке службы поддержки14 подсказки, написанные для Claude Opus 4.8, стоили на 36% больше за тикет на Claude Opus 5 без изменения точности. Запуск аудита по тем же подсказкам сделал Opus 5 и дешевле неаудированной версии (на 14%), и точнее (97% тикетов против 92%, выигрыш за пределами шума). При миграции с Claude Sonnet 4.6 на Claude Sonnet 5 аудит снял 14% при той же точности:
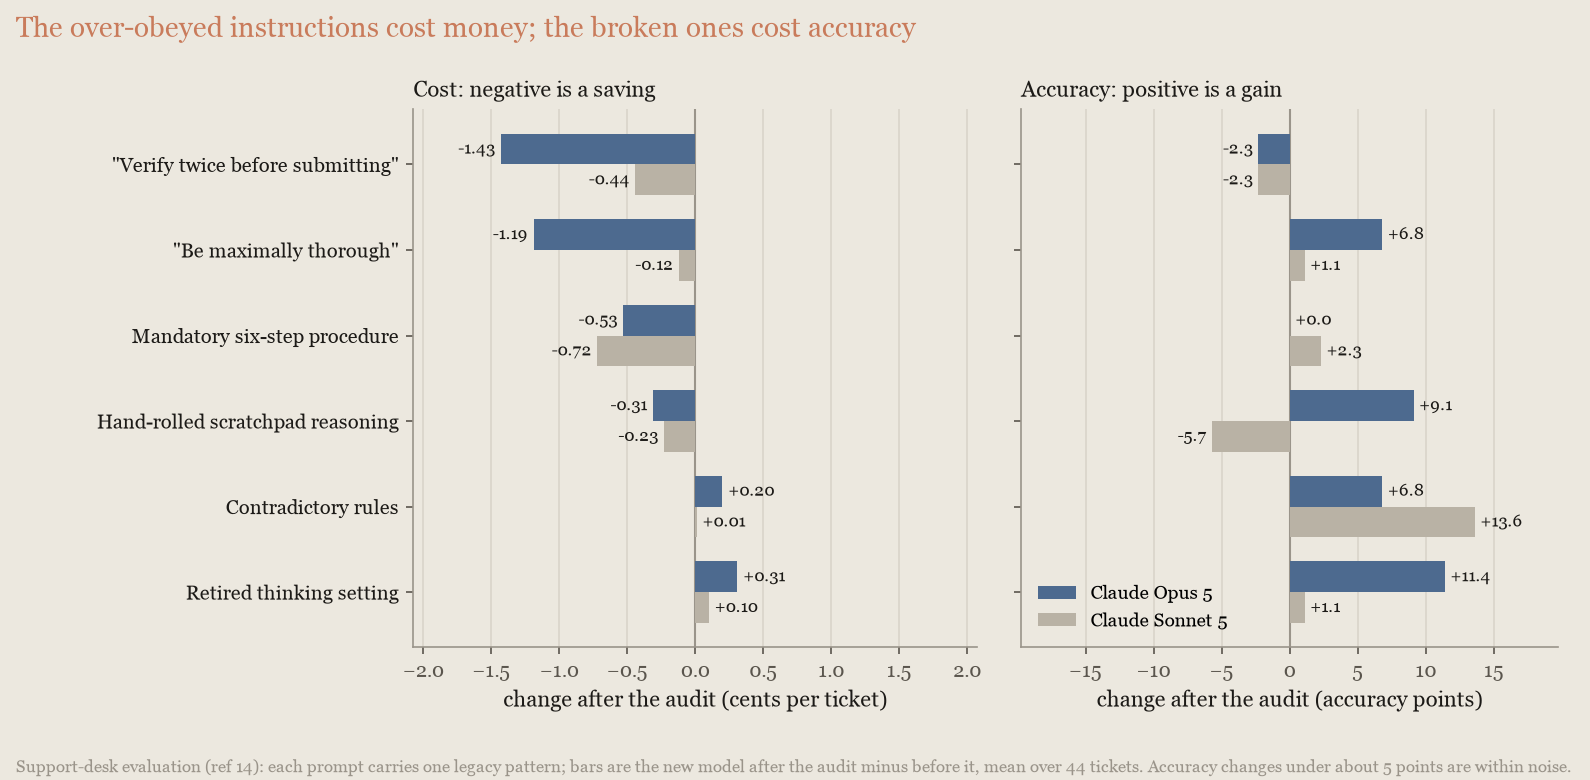
Два вида устаревшего текста имеют разную цену. Инструкции, которым новая модель следует слишком буквально, стоят денег: удаление «проверь дважды» сократило стоимость Opus 5 за тикет на треть, а удаление «будь максимально тщательным» — почти на столько же. Текст, который больше не подходит модели, вместо этого стоит точности: устаревшая настройка размышлений, противоречивые правила и самодельный черновик, конфликтующий с собственными размышлениями модели, каждый восстановил от 7 до 11 пунктов на Opus 5 при удалении:
Те же шаблоны, как правило, появляются в описаниях инструментов и навыках, которые тоже стоит проверить.
Компромисс между стоимостью и интеллектом
Эти рычаги определяют положение отдельной модели между стоимостью и интеллектом. К ним относятся выбор модели, уровень усилий, перезапуск неудачных попыток с более высокой настройкой, бюджеты и ограничения, в рамках которых работает модель, а также то, видит ли она, сколько прошло времени. Начните с «effort sweep» (перебора уровней усилий) на текущей модели (Настройте уровень усилий). По возрастанию стоимости и возможностей текущие модели располагаются так: Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 и Claude Fable 5.1 («frontier model», передовая модель). Полный список моделей и цены приведены в обзоре моделей.
Сравнивайте модели по стоимости задачи
Прайс-листы указывают цену за токен, и по этому показателю передовая модель выглядит дорогой: цена за токен у Claude Fable 5.1 в несколько раз выше, чем у Claude Sonnet 5. Однако платите вы за выполненные задачи, поэтому и сравнивать модели стоит по стоимости выполненной задачи. Более способная модель выполняет задачу с меньшим объёмом работы: делает меньше ходов, меньше ищет, реже перечитывает собственный контекст и реже возвращается назад. Поскольку всего делается меньше, это часто с лихвой перекрывает более высокую цену за токен.
Anthropic измерила это на подмножестве SWE-bench Pro3 по тем же ценам, по которым выставляется счёт клиенту:
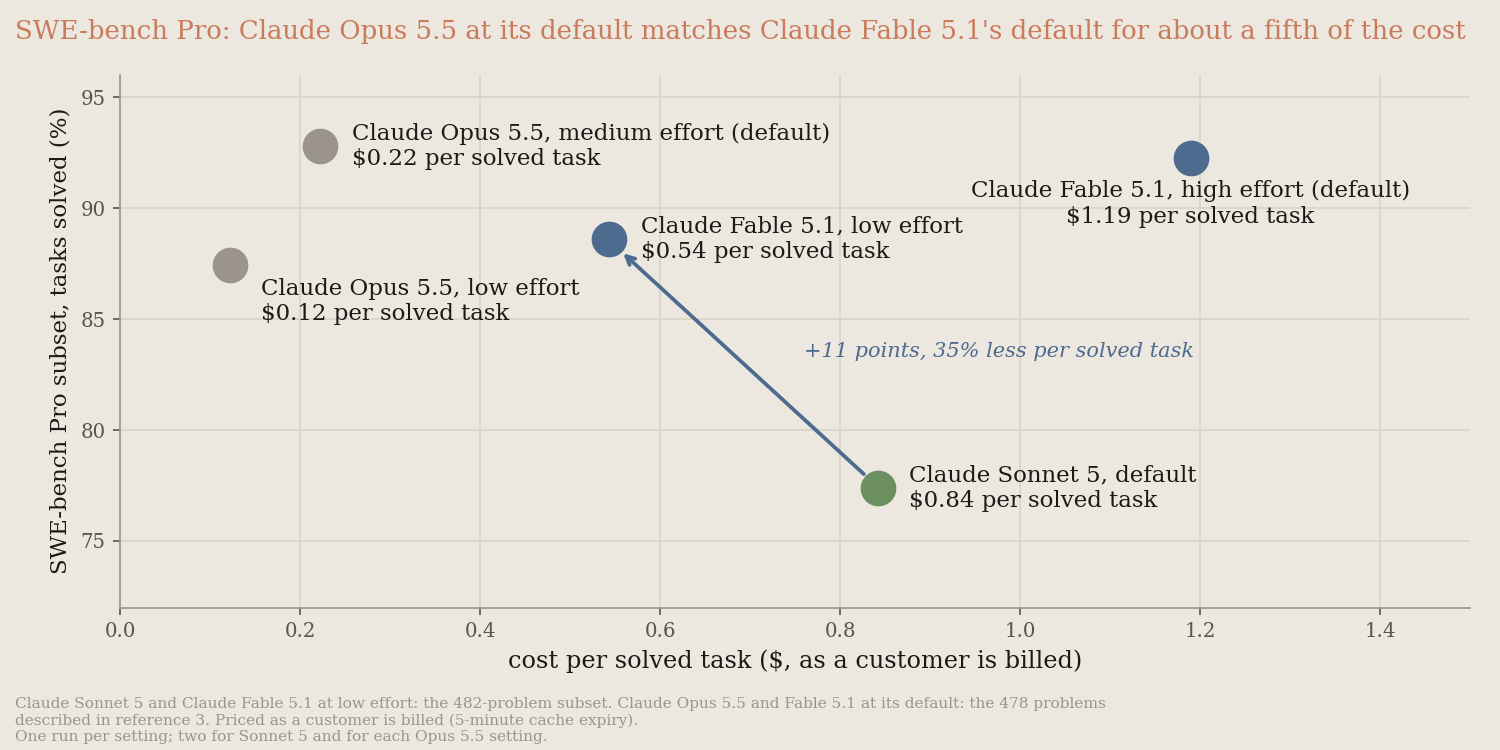
Claude Fable 5.1 с уровнем усилий low решил 88,6% задач по $0,54 за решённую задачу. Claude Sonnet 5 с настройкой по умолчанию решил 77,4% по $0,84. Итого у Fable 5.1 на 11 пунктов больше при стоимости решённой задачи на 35% ниже, хотя его цена за токен в пять раз выше. Однако передовая модель выигрывает не всегда. Claude Opus 5.5 и Claude Fable 5.1 почти полностью решают это подмножество, и его оценки несопоставимы с публичным рейтингом. На нём Opus 5.5 с настройкой по умолчанию (medium) сравнялся с Fable 5.1 с его настройкой по умолчанию: 92,8% против 92,3%, в пределах разброса между запусками. При этом решённая задача обошлась примерно в пять раз дешевле: $0,22 против $1,19. С low Opus 5.5 решил 87,4% по $0,12. Эти цифры получены на 478 задачах, описанных в ссылке 3.
На длинных исследовательских циклах передовая модель, наоборот, выполняет больше работы, а не меньше. На DeepResearch Bench II7 Fable 5.1 с low набрал на 10 пунктов больше, чем Sonnet 5 (66% против 56%), но задача обошлась примерно вчетверо дороже ($4,66 против $1,20). Причина в том, что Fable 5.1 выполняет более длинный исследовательский цикл над более крупным контекстом. Claude Opus 5 с настройкой по умолчанию набрал 71% при том же способе подсчёта, по $6,71 за задачу. Это больше, чем у Fable 5.1 с настройкой по умолчанию (65% по $7,12). Так что и в исследованиях Fable 5.1 оправдывает свою цену только при low.
Для большинства агентных рабочих нагрузок начинайте с Claude Opus 5.5 с уровнем усилий по умолчанию (medium). Claude Fable 5.1 используйте для сложных рассуждений и длительной агентной работы, а также в случаях, когда ваши оценки на Claude Opus 5.5 с более высоким уровнем усилий всё ещё не дотягивают. Как отмечалось выше, на подмножестве SWE-bench Pro Opus 5.5 с настройкой по умолчанию сравнялся с Fable 5.1 с настройкой по умолчанию примерно за пятую часть стоимости решённой задачи. На бенчмарке по программированию из раздела Стратегия советника Opus 5.5 набрал 86,6% против 84,2% у Fable 5.1 с medium (один запуск Fable 5.1), причём попытка обошлась менее чем в треть стоимости ($0,84 против $2,68). На Chartography13, бенчмарке по чтению диаграмм, Opus 5.5 с low набрал 68,7 примерно по $0,03 за диаграмму. Для сравнения: Fable 5.1 с low набрал 62,5 по $0,15, а Claude Opus 5 с low — 49 по $0,16. На другом конце спектра Claude Haiku 4.5 отвечал на вопросы GPQA Diamond9 примерно в пять раз дешевле Claude Opus 5.5 в расчёте на вопрос, но с точностью 63% против 92% у Opus 5.5. На длинных задачах по программированию он отставал гораздо сильнее. Эта модель подходит для больших объёмов работы с проверяемыми результатами, а не для длинных агентных циклов.
Рейтинг моделей меняется в зависимости от рабочей нагрузки, и ни один прайс-лист не подскажет, в какую сторону. Оценивайте каждого кандидата по стоимости выполненной задачи на собственном трафике. Включите в сравнение Claude Opus 5.5 с уровнем усилий по умолчанию и передовую модель с пониженным уровнем усилий.
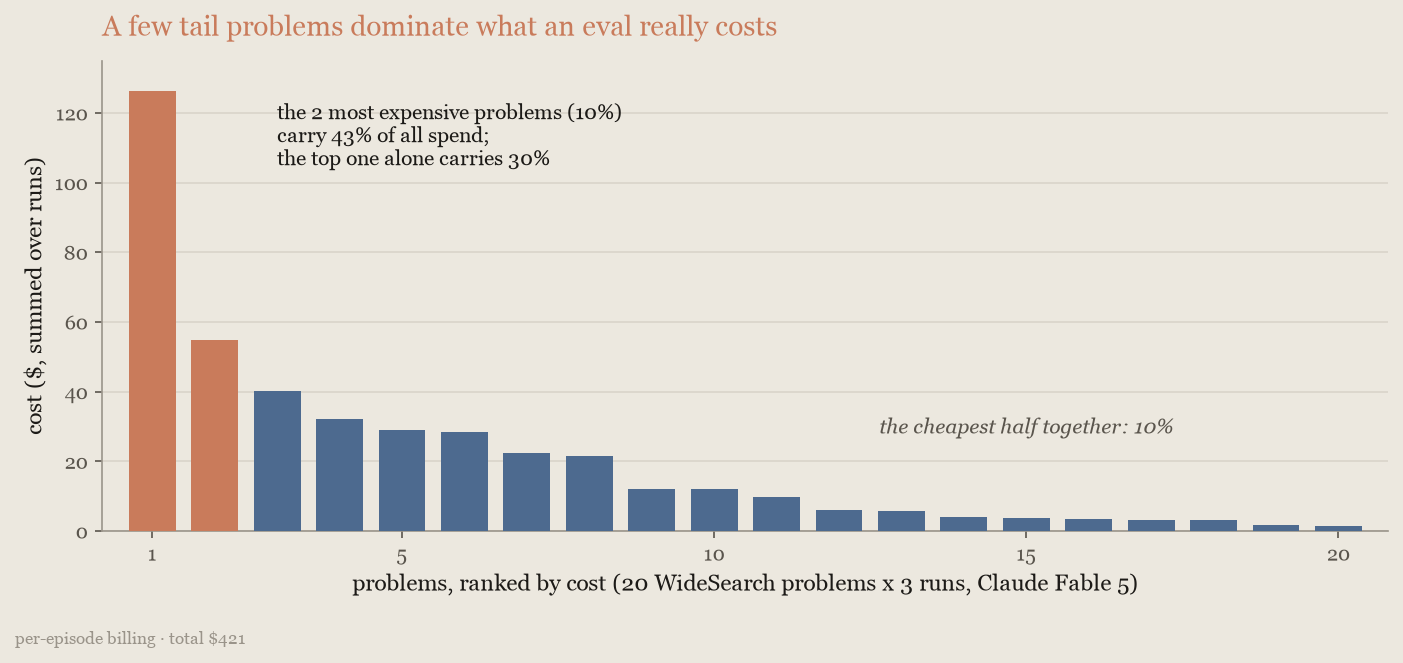
Оценивайте стоимость «хвоста» рабочей нагрузки, а не медианы: сравнивайте модели на самой сложной десятой части задач, а не на типичных. На типичной задаче все модели выглядят похоже, и самая дешёвая кажется лучшей. Но итоговый счёт определяют задачи, которые более дешёвая модель проваливает. За проваленную задачу всё равно приходится платить: сначала за её токены, затем за повторную попытку, а затем за последствия провала дальше по цепочке. Кроме того, именно на «хвост» уходят деньги, даже когда провалов нет. В запуске WideSearch1 из 20 задач на две задачи пришлось 43% расходов:
Многомодельные стратегии нужны для того, чтобы тратить передовой интеллект на этот «хвост», не платя передовые тарифы за всё остальное.
Обновите модель
Если вы отстаёте на одну-две модели, самый дешёвый рычаг — сменить строку модели. Anthropic прогнала последние модели Claude Opus, Claude Sonnet и Claude Fable через одну и ту же обвязку на подмножестве SWE-bench Pro3. Каждая модель работала со своими настройками по умолчанию, а стоимость рассчитывалась по прейскурантным ценам. Линейку Opus дополнительно прогнали на Terminal-Bench 320:
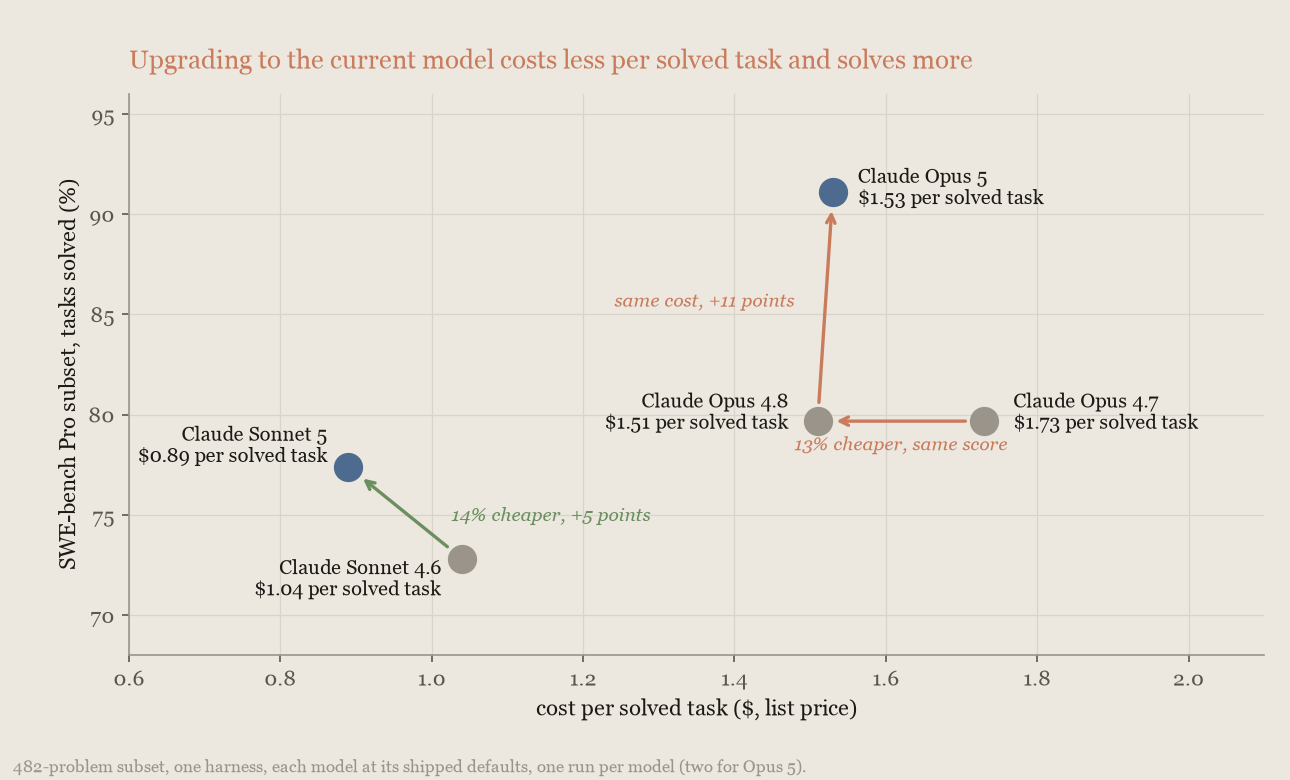
Цена за токен у Claude Opus 4.7, Opus 4.8 и Opus 5 одинакова. Поэтому разница в стоимости между ними определяется только объёмом работы, которую каждая модель выполняет на задачу. При расчёте по ценам для клиента Claude Opus 4.8 решает ту же долю задач, что и Claude Opus 4.7, при стоимости за решённую задачу на 14% ниже. Claude Opus 5 решает на 12 пунктов больше задач, но стоимость за решённую задачу у неё на 21% выше. При этом Claude Opus 5 с уровнем усилий low превосходит Opus 4.8 с настройкой по умолчанию на этом бенчмарке примерно за 30% её стоимости за решённую задачу. Поэтому самое дешёвое обновление — новая модель с более низкой настройкой.
Sonnet 5 экономит за счёт более низкой цены за токен. Эта цена с лихвой компенсирует дополнительные токены, которые Sonnet 5 расходует на задачу по сравнению с Sonnet 4.6. В итоге стоимость за решённую задачу на 15% ниже, а результат на 5 пунктов выше. Передовой уровень выиграл так же: Claude Fable 5.1 показывает тот же результат, что и Claude Fable 5, при стоимости за решённую задачу на 43% ниже, в основном за счёт более низкой цены чтения из кэша.
Однако обновление не всегда снижает стоимость. На DeepResearch Bench II7 то же обновление стоит на 41% больше за задачу с high и на 79% больше с low. Взамен оно даёт 2–3 дополнительных пункта на задачах, чистых во всех вариантах (см. ссылку 7). Причина в том, что на этом бенчмарке новая модель выполняет больше работы на задачу. Цены входных и выходных токенов у этих моделей одинаковы, а чтение из кэша у новой модели в 4 раза дешевле. Поэтому, прежде чем рассчитывать на экономию, измерьте эффект обновления на собственной рабочей нагрузке.
На более сложной работе разрыв увеличивается. Задачи Terminal-Bench 320 настолько сложны, что итоговый счёт определяется долей успешных решений, а не числом токенов. Claude Opus 4.7, Opus 4.8 и Opus 5 тратят от $8 до $15 на задачу, но решают 7%, 15% и 41% задач соответственно. Поэтому при переходе к более новой модели стоимость за решённую задачу снижается с $183 до $63 и затем до $28. На подмножестве задач программирования, которое модели решают почти полностью, Claude Opus 5 дороже Opus 4.8 на 21%. На Terminal-Bench 3, где старая модель в основном терпит неудачу, эта надбавка превращается в экономию 56%. Чем чаще ваши задачи оказываются не по силам старой модели, тем больше обновление экономит на каждом результате.
Сравнивайте модели по стоимости за решённую задачу, а не за токен. На Claude Opus 4.7 и более поздних моделях один и тот же текст занимает примерно на 30% больше токенов. Поэтому при сравнении по токенам новые модели всегда выглядят дороже.
Настройте уровень усилий
Усилие — самый прямой способ настроить модель под вашу задачу. Параметр effort определяет, сколько размышлений, вызовов инструментов и самопроверки выполняет модель. Значение high используется по умолчанию в большинстве моделей и подходит для требовательных задач; у Claude Opus 5.5 значение по умолчанию — medium. Стоимость растёт вместе со всей этой активностью, а точность — только с той её частью, которая нужна вашей задаче. Если задача не требует предельных возможностей модели, самые высокие уровни усилий оплачивают глубину, которая ей не нужна.
Anthropic проверила это на бенчмарках исследовательской работы и интеллектуального труда: WideSearch1, DeepWideSearch6, BrowseComp4 и GDPval2, все с Claude Fable 5. Кривая зависимости точности от стоимости на них почти плоская. low уступал 1–3 пункта, но снижал стоимость задачи на треть–половину. medium давал ту же точность, что и значение по умолчанию, примерно за 70–87% его стоимости. Значение по умолчанию не дало измеримого преимущества над medium ни на одном из четырёх бенчмарков. На DeepWideSearch low также сравнялся с оркестратором с рабочей моделью Claude Sonnet 5 при стоимости на 29% ниже: снижение усилия оказалось эффективнее изменения архитектуры.
Более низкие настройки усилия часто работают быстрее, что важно, когда ограничением является «latency» (задержка). В этих прогонах low тратил 4,5 минуты на задачу в DeepWideSearch против 7,9 минуты при значении по умолчанию. Входные данные бенчмарка корпуса не помещаются ни в одно «context window» (контекстное окно). На нём Fable 5.1 тратил 15,2, 17,5 и 19,9 часа на эпизод при low, medium и high соответственно.
Долгосрочное программирование — область, где усилие действительно повышает точность. На SWE-bench Pro3 результаты Claude Opus 5.5 в сравнении с high выглядят так:
- при значении по умолчанию,
medium, — примерно на 2,5 пункта меньше примерно за 70% стоимости; - при
low— примерно на 8 пунктов меньше примерно за треть стоимости; - при
xhigh— примерно на 1,4 пункта больше при стоимости в 2,5 раза выше, чем уhigh.
Это реальный компромисс, но повторный запуск неудачных задач с более высоким усилием снова превращает его в экономию. Этот график показывает зависимость точности от стоимости для бенчмарков исследовательской работы и интеллектуального труда, а также для SWE-bench Pro:
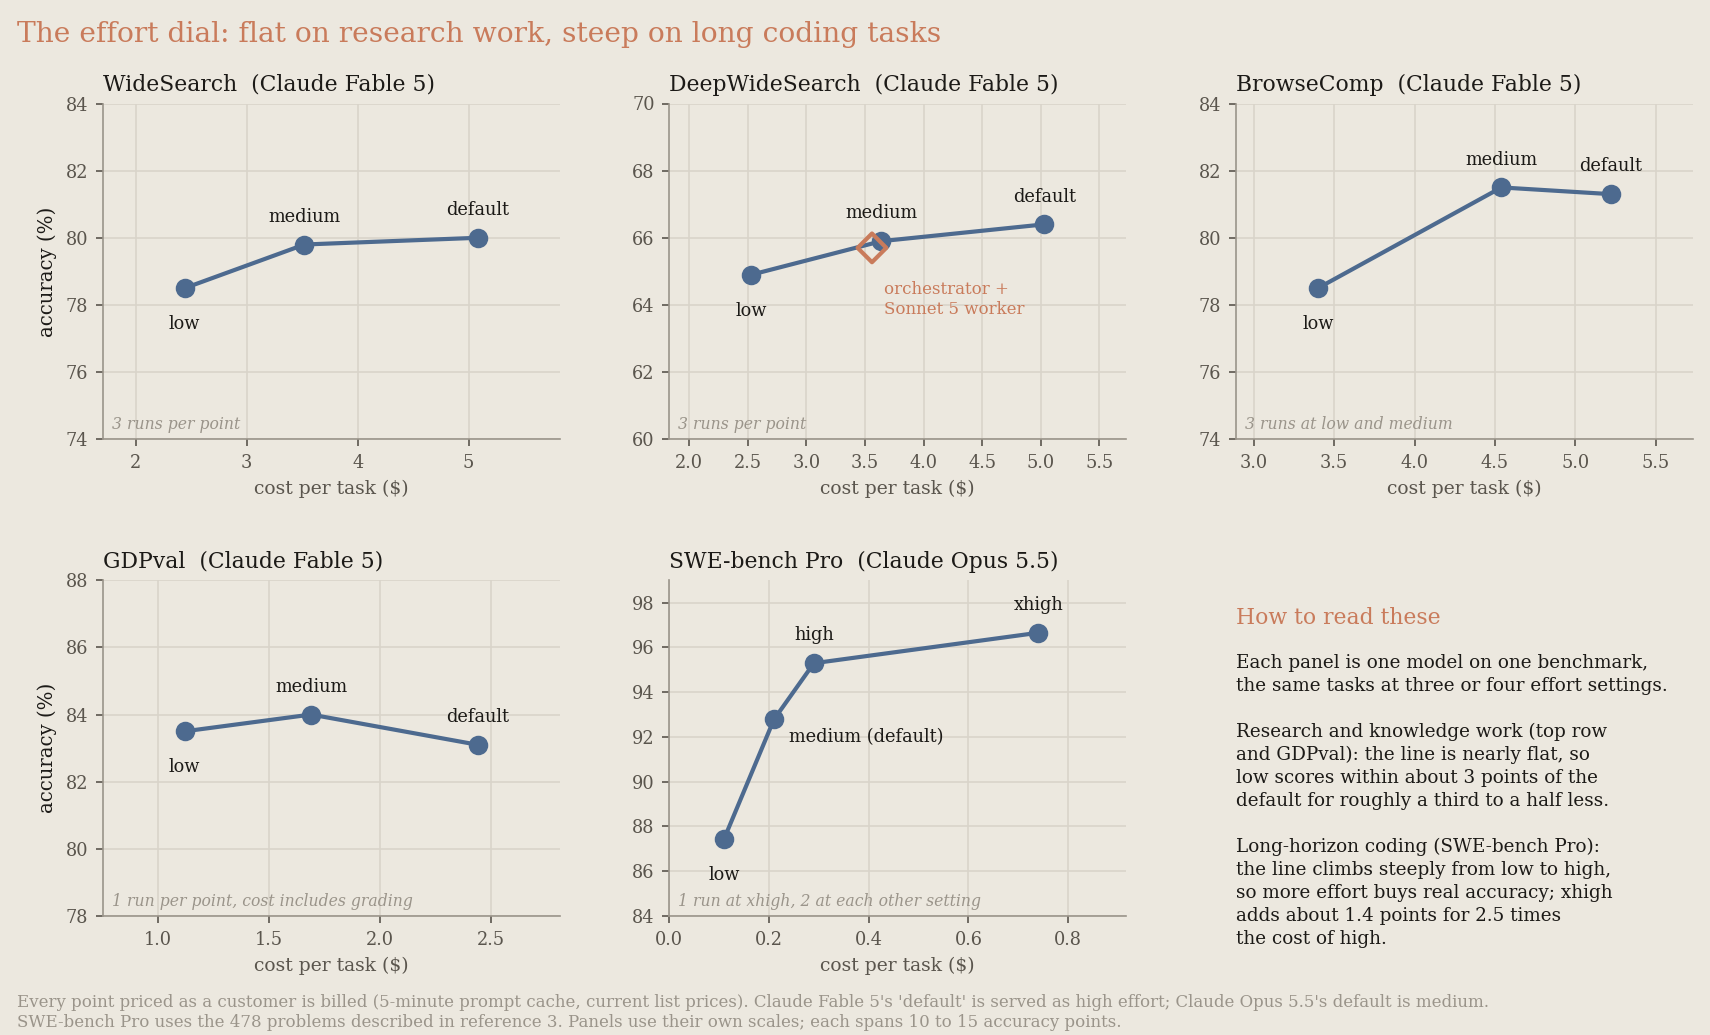
Из этого следуют два вывода. Во-первых, постройте эту кривую для своей рабочей нагрузки, прежде чем добавлять вторую модель. Во внутренних измерениях Anthropic многомодельная конфигурация выглядела дешевле одиночной модели с настройками по умолчанию, но стоила больше, чем та же модель с более низким усилием. Во-вторых, эта кривая — базовый уровень одиночной модели, который должна превзойти любая многомодельная стратегия. Поэтому на шаге 2 измерения на собственной рабочей нагрузке базовые уровни устанавливаются для разных уровней усилий.
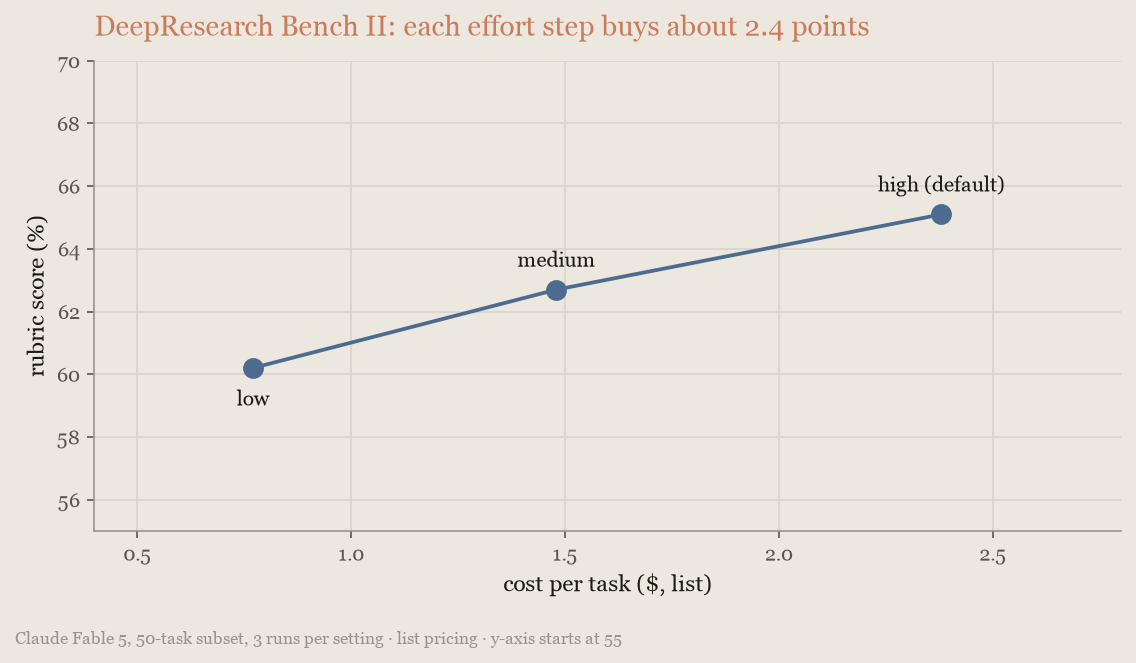
Сложная работа не обязательно требует высокого усилия. На DeepResearch Bench II7 Claude Fable 5.1 набрал почти одинаковый результат при low, medium и high, тогда как стоимость задачи выросла с $4,66 до $7,12. Значит, в этом случае повышение усилия заметно не улучшает качество результата. На 21 задаче, прошедшей без сбоев во всех вариантах (ссылка 7), результат Claude Fable 5 тоже не менялся с уровнем усилий. На графике он всё же растёт, потому что график построен по 33 задачам, из которых исключены прерванные попытки каждой модели. Измеряйте кривую на той модели, которую используете в продакшене, а не на той, которую измеряли в последний раз:
По одному лишь описанию задачи нельзя понять, какой тип рабочей нагрузки у вас. Поэтому проверьте два-три уровня усилий на выборке собственного трафика и определите ответ по кривой. Тестируйте каждый уровень в отдельной сессии. Изменение усилия верхнего уровня посреди сессии делает кэш недействительным (см. Кэшируйте повторяющийся контекст) и искажает сравнение. Подробнее о параметре см. в разделе Усилие.
Повторно запускайте неудачные задачи с более высоким уровнем усилий
Если результат задачи можно проверить, самая дешёвая политика — не фиксированный уровень усилия. Запускайте каждую задачу с низкой настройкой, а неудачные повторно запускайте с более высокой.
Anthropic рассчитала эту политику для каждой задачи по прогонам с разными уровнями усилий на подмножестве SWE-bench Pro3 из раздела Настройте уровень усилий. С Claude Opus 5.5 при low 13% задач завершились неудачей. После их повторного запуска с high успешными оказались около 97% задач примерно по $0,17 за каждую. Для сравнения: при запуске всех задач с high успешными были 95,3% по $0,29. Таким образом, доля успешных решений чуть выше, а стоимость — чуть больше половины, даже с учётом неудачных дешёвых попыток. Если начинать с medium, успешными оказываются около 97% задач примерно по $0,24. Небольшой прирост в основном даёт сама вторая попытка: если повторно запустить с high неудачные задачи прогона high, результат будет примерно тем же, но дороже. Поэтому используйте эту политику ради экономии, а не ради прироста:
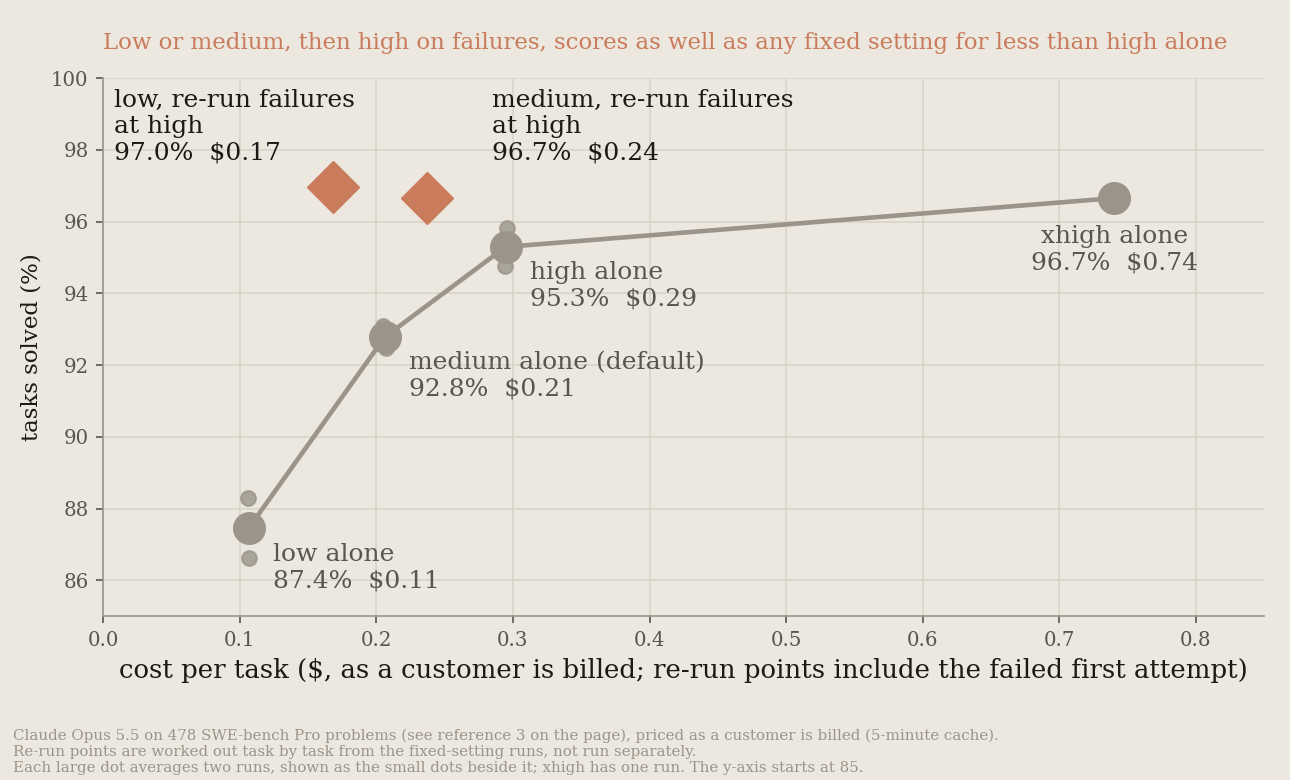
Действуют два условия. Во-первых, вам нужен сигнал о неудаче (здесь — собственные тесты бенчмарка). Если проверка пропускает плохую работу, эти неудачи останутся незамеченными. Во-вторых, каждая неудача первого прохода занимает время двух прогонов, поэтому за экономию приходится платить задержкой на неудачных задачах.
Задайте бюджеты и ограничения вывода
Большинство прогонов агентных задач обходятся дёшево. Но небольшая их часть тратит во много раз больше медианной стоимости на поиск, повторную проверку и избыточное тестирование. «Task budget» (бюджет задачи) нацелен именно на этот хвост распределения. Модель видит обратный отсчёт оставшихся токенов для всей задачи и сама регулирует расход. Она сокращает малоценные поиски, пропускает избыточную проверку и завершает работу, а не уходит в бесконечные циклы.
Anthropic измерила долю успешных решений и стоимость задачи на SWE-bench Pro3 с Claude Fable 5.1 по мере ужесточения бюджета:
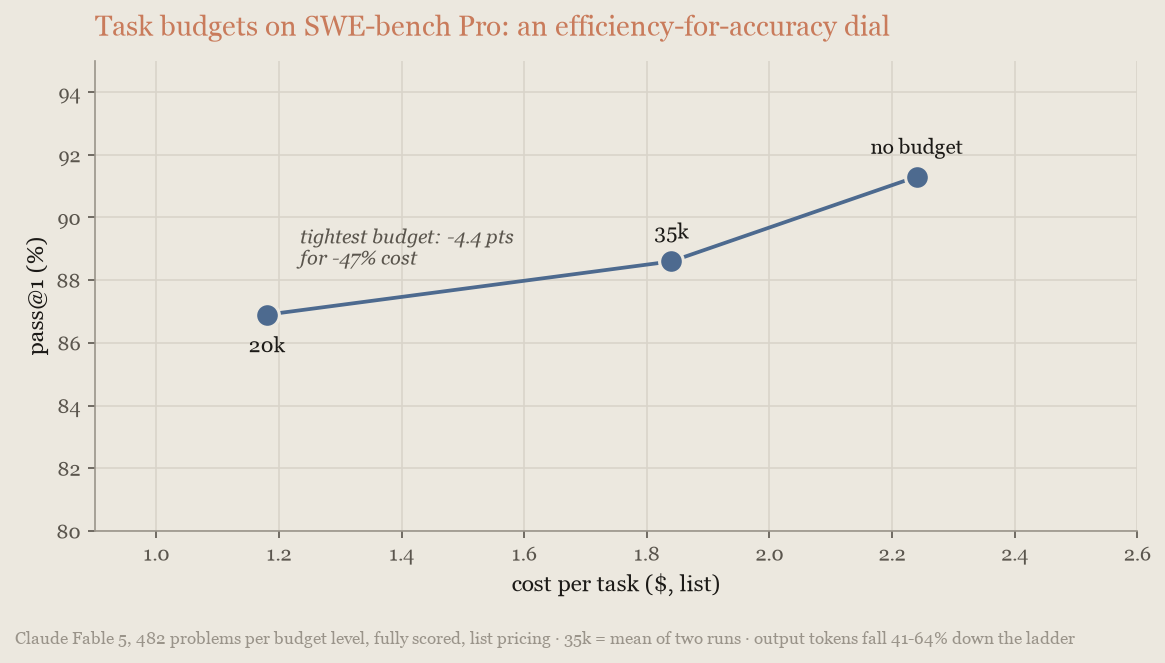
Щедрый бюджет снизил стоимость задачи на 44% ценой примерно 3 пунктов доли успешных решений, что находится на границе разброса между прогонами. Самый жёсткий допустимый бюджет снизил её на 58% ценой 6 пунктов. Здесь бюджеты повысили эффективность, но за счёт доли успешных решений, и эта цена растёт по мере ужесточения бюджета.
Три механизма управления решают три разные задачи:
- Бюджет задачи экономит деньги, потому что модель его видит.
max_tokens— это предохранительное ограничение. Его снижение уменьшило стоимость попытки, но не стоимость решённой задачи.- В Claude Managed Agents бюджет сессии — жёсткий лимит в долларах, который страхует оба предыдущих механизма.
Задайте все три: бюджет задачи, высокое значение max_tokens и ограничение сессии на случай прогона, который не должен попасть в счёт. В качестве последней страховки используйте лимит расходов рабочего пространства.
-
Бюджеты задач доступны в бета-версии (бета-заголовок
task-budgets-2026-03-13) на самых последних моделях; список моделей см. в таблице поддержки. Начните примерно с 90-го процентиля расхода токенов вашим циклом, затем ужесточайте бюджет. Как собрать это распределение, описано в разделе Выбор бюджета. Бюджеты ниже текущего минимума в 20 000 токенов отклоняются, а при очень жёстких бюджетах модель может вести себя так, будто отказывается от задачи. Задавайте бюджет один раз, в первом запросе, потому что изменение посреди задачи делает кэш недействительным. Бюджет носит рекомендательный характер: он направляет модель, но не останавливает её. Поэтому проверьте, насколько модель его соблюдает на вашей рабочей нагрузке. -
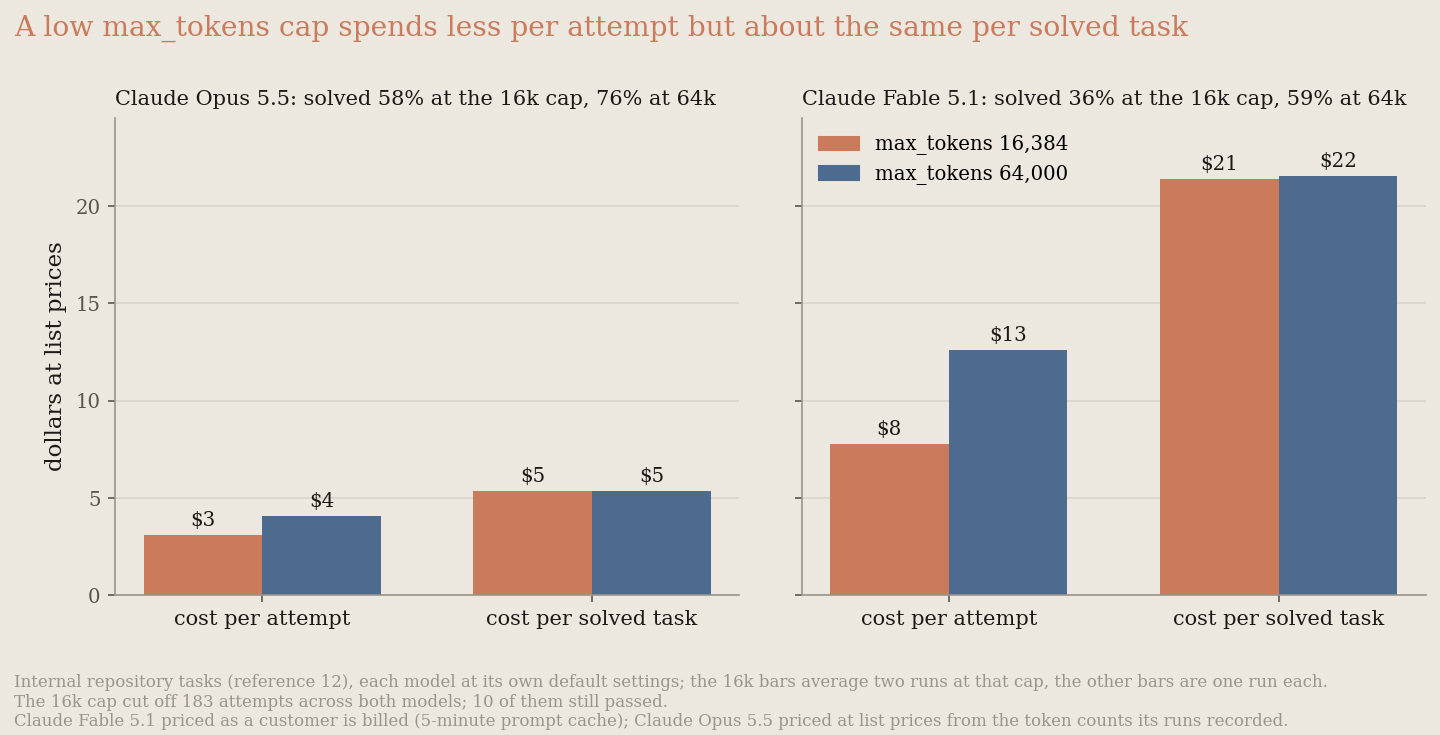
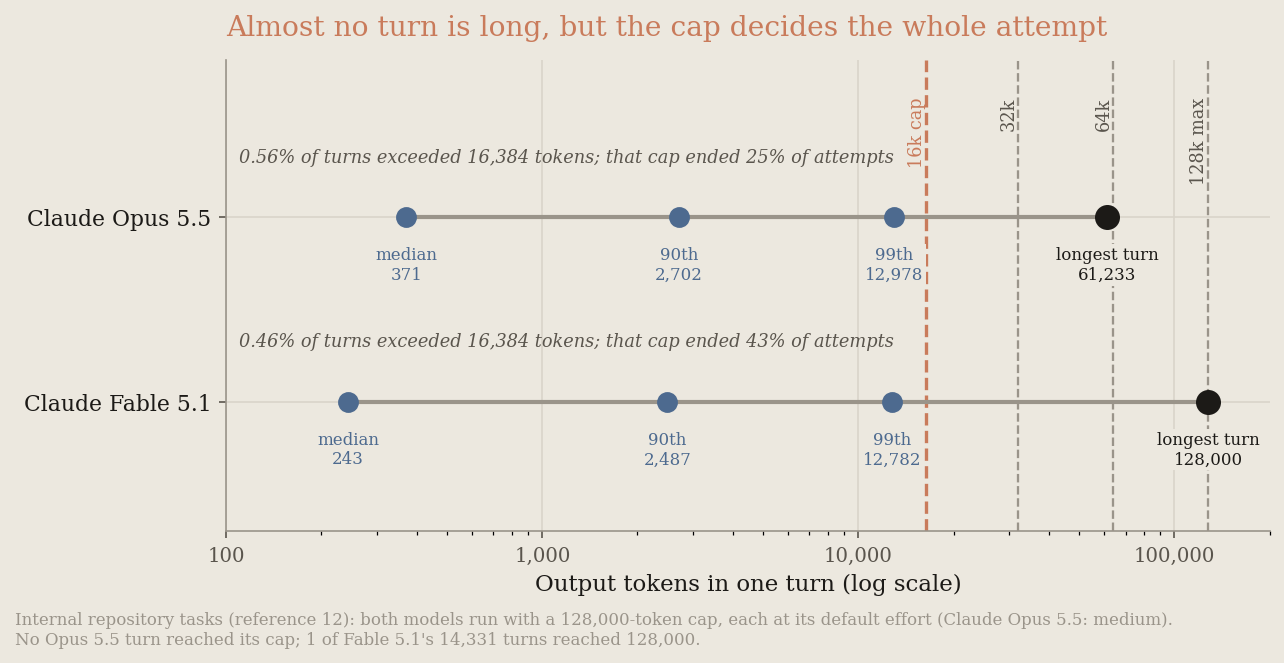
max_tokensограничивает один ответ, и модель этого ограничения не видит, поэтому его снижение не заставляет её экономить. Ходы, которым не хватило места, отбрасываются, но всё равно оплачиваются.- На внутреннем бенчмарке задач в репозиториях12 ограничение в 16 384 токена прервало около четверти попыток Claude Opus 5.5 и 43% попыток Claude Fable 5.1, каждой при её усилии по умолчанию. Лишь 1 из 66 прерванных попыток Opus 5.5 и 9 из 117 прерванных попыток Fable всё же прошли.
- Прерванные прогоны тратили меньше на попытку, но давали пропорционально меньше решений. Поэтому стоимость решённой задачи была примерно такой же, как при 64 000: на Fable 5.1 — $21 против $22, на Opus 5.5 — в пределах 1%.
- При 64 000 прервались лишь 2 из примерно 14 000 ходов Claude Fable 5.1 при усилии по умолчанию, а у Claude Opus 5.5 — ни одного. Fable 5.1 решил 58,5% задач вместо 36,3%. На отдельной выборке из подмножества SWE-bench Pro3, описанной в ссылке 12, разницы нет: 94 из 100 при любом ограничении.
- Повторные попытки после прерывания редко помогают. При том же ограничении большинство из них снова терпят неудачу, а при более высоком вы дополнительно платите за потраченную впустую попытку.
Установите
max_tokensв 64 000 для агентной работы. Если одна прерванная попытка обходится дорого, используйте максимум — 128 000: при этом значении Fable 5.1 решил 60,0% задач при той же стоимости решённой задачи. Для таких больших ответов используйте «streaming» (потоковую передачу) и рассматривайтеstop_reason: max_tokensкак неудачу. Экономьте с помощью усилия и бюджетов задач, которые модель видит. -
Бюджеты сессий в Claude Managed Agents — это жёсткий лимит. Бюджет сессии ограничивает в долларах расходы одной сессии на токены, поиски и время сессии по прейскурантным ценам. При достижении лимита сессия приостанавливается с
stop_reason: budget_reached, а повышение бюджета возобновляет её. Лимит применяется на уровне платформы и работает с любой моделью, у которой есть прейскурантная цена, включая модели, для которых бюджеты задач ещё недоступны. Его можно сочетать с рекомендательным бюджетом задачи. Развёртывания применяют одно и то же поле к каждому прогону.
Просите более короткие ответы. В Claude Sonnet 5 выходные токены стоят в пять раз дороже входных. Кроме того, в агентном цикле каждый токен, написанный моделью, возвращается как входные данные на каждом последующем ходе, поэтому за длинный ответ вы платите снова и снова. Anthropic запустила задачу сортировки (triage) с тремя вариантами инструкции для финального ответа, по три прогона на каждый, с той же моделью и инструментами. Исходная инструкция просила две строки:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>Более короткий вариант просил одну:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.Более длинный вариант просил служебную записку из пяти разделов с заголовками: краткое описание проблемы, доказательства, проверка на дубликаты, рекомендуемая метка и следующие шаги. Возьмём одно issue: подсказка, поставленная в очередь, так и не отправляется после пропущенного вопроса. Первые два ответа на него были такими:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.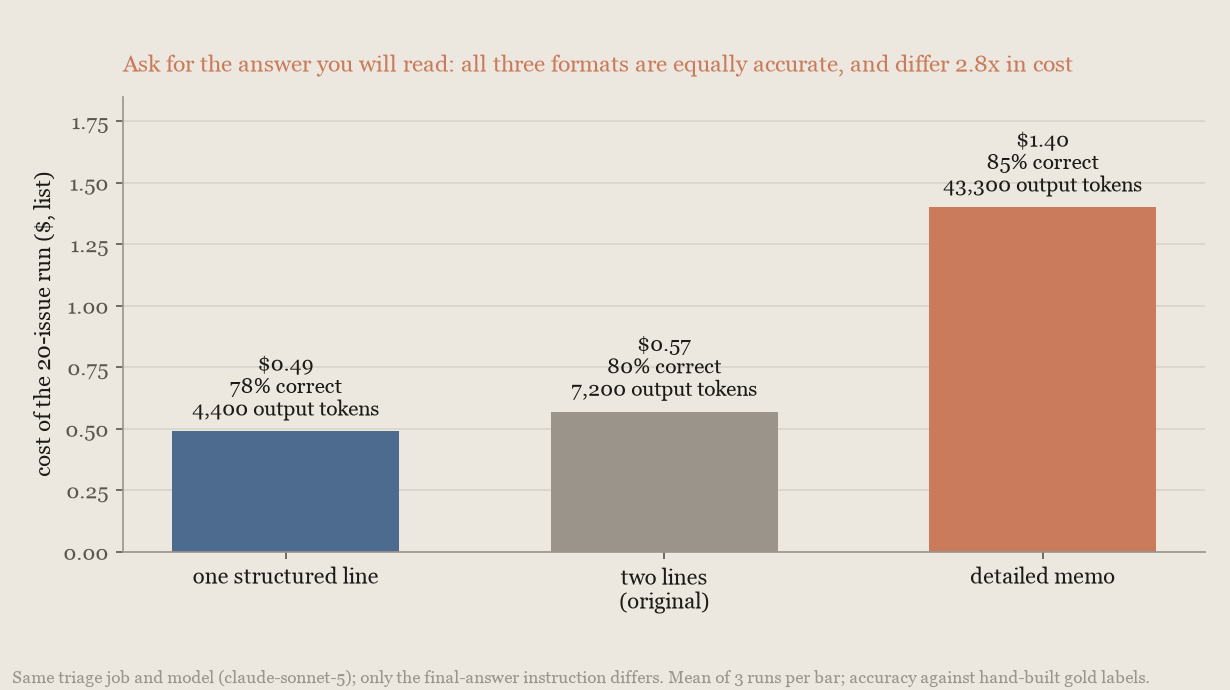
Однострочный ответ использовал на 39% меньше выходных токенов, чем исходный двухстрочный, и стоил на 14% меньше за прогон. Служебная записка использовала в шесть раз больше выходных токенов и стоила в 2,8 раза больше однострочного ответа. По сравнению с эталонными метками все три варианта показали результаты в пределах разброса между прогонами. Значит, форматы различаются прежде всего стоимостью, а не точностью. Просите тот ответ, который вы действительно будете читать, а не тот, который выглядит основательным.
При более низком ограничении max_tokens обе модели тратят меньше на попытку, но решают пропорционально меньше задач, поэтому стоимость решённой задачи почти не меняется:
Почти каждый ход завершается намного раньше любого из ограничений. Более высокое ограничение нужно именно для редких длинных ходов:
Показывайте модели прошедшее время
Модель в агентном цикле не видит часов. Бюджет задачи показывает ей, сколько токенов осталось, но по умолчанию ничто в запросе не сообщает, сколько времени уже заняла работа. Два небольших изменения дают модели этот сигнал:
- Добавьте в «system prompt» (системную подсказку) инструкцию из двух предложений о том, что время имеет значение.
- Начиная со второго запроса, отправляйте прошедшее время перед каждым ходом модели.
Anthropic измерила эффект обоих изменений вместе на Claude Fable 5.1 при усилии high. Измерения проводились на трёх наборах:
- публичный бенчмарк DRACO21;
- публичный бенчмарк HLE22;
- внутренний набор из 70 физических задач исследовательского уровня, адаптированных из публичного бенчмарка CritPt23. Далее на этой странице он называется физическим набором.
Каждый набор запускался в двух конфигурациях: одиночный агент и команда. В команде ведущий агент запускает вспомогательных агентов той же модели, которые работают параллельно. До прогонов Anthropic установила допуск: 1,5 пункта на DRACO и 2,5 пункта на HLE. Изменение оценки считается находящимся в пределах допуска, если его 95%-й интервал не выходит за эту границу.
Следующий график показывает оценку в зависимости от стоимости задачи для каждой конфигурации. Второй ряд столбцов показывает время каждой конфигурации относительно времени одиночного агента при усилии high, без учёта ожидания повторных попыток. Третий ряд показывает, как оба изменения меняют оценку, с 95%-м интервалом:
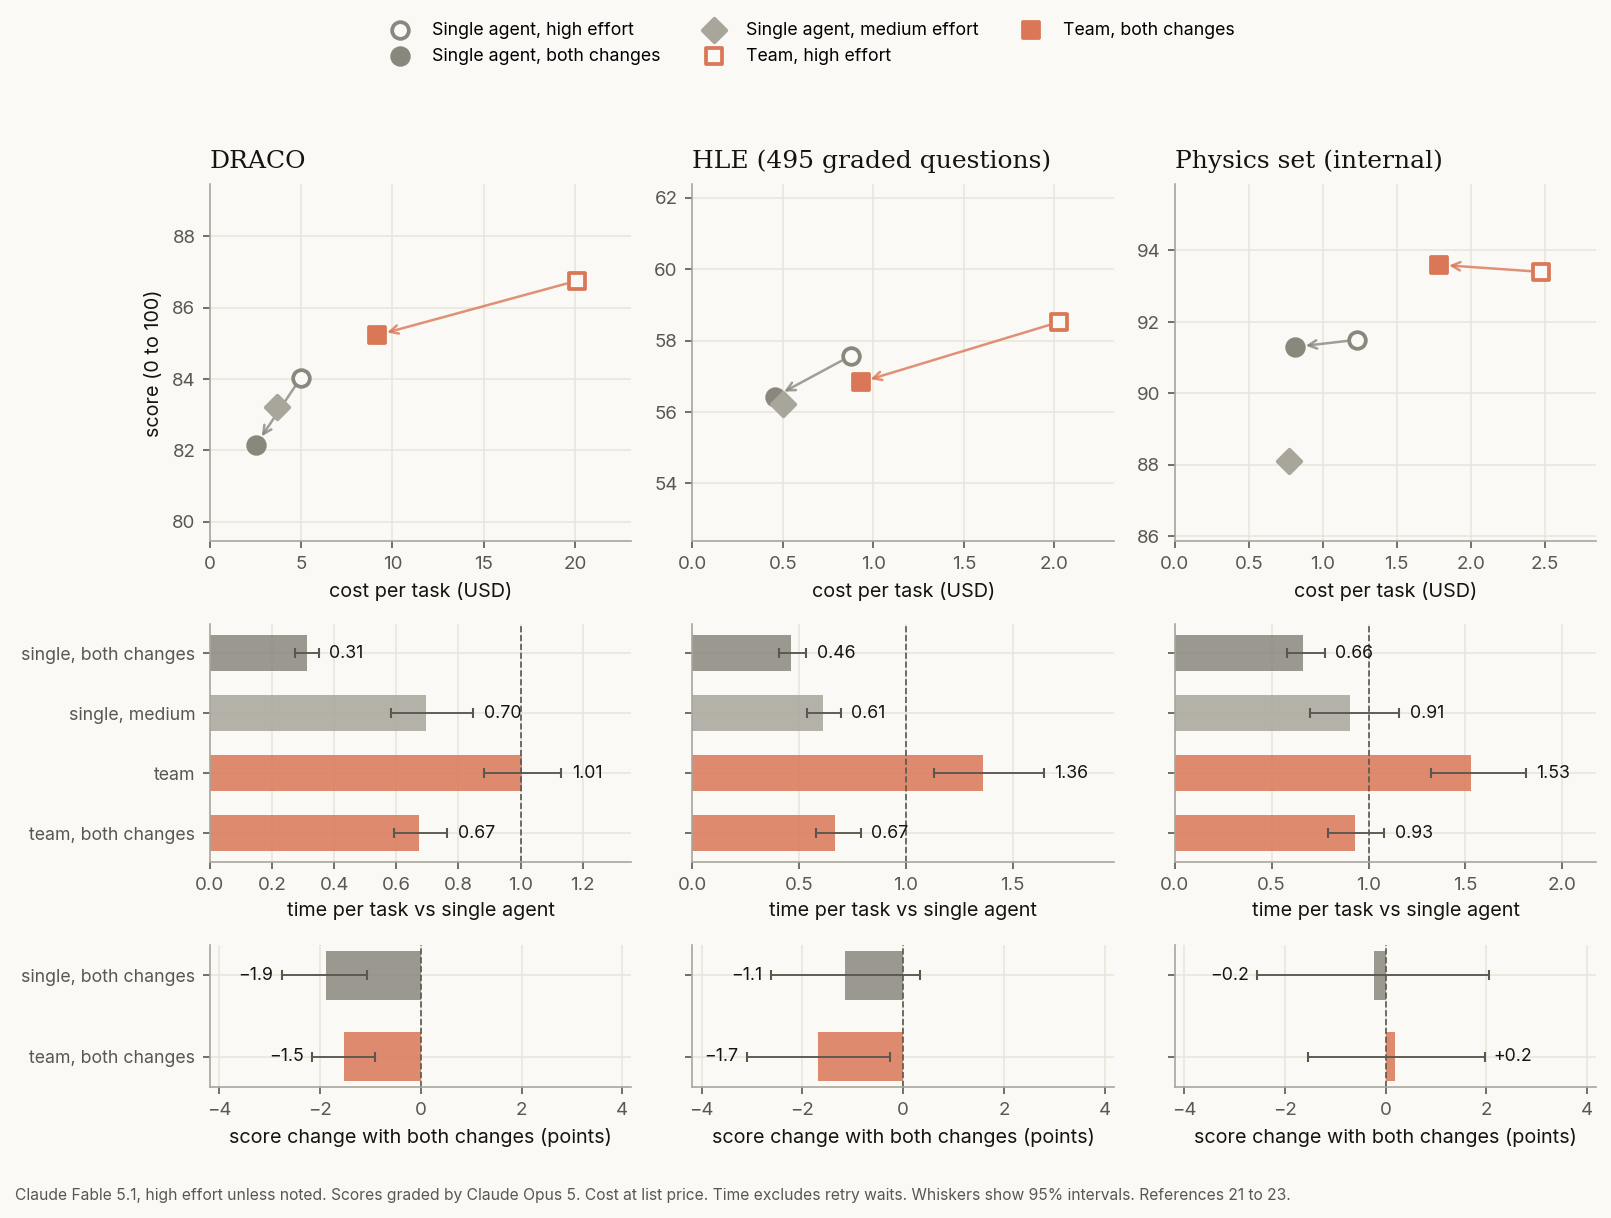
С командой агентов. Команда выполняет больше работы, чем одиночный агент, поэтому по умолчанию стоит дороже. На DRACO команда стоила в 4,0 раза больше одиночного агента и работала примерно столько же (95%-й интервал: от 12% меньше до 13% больше). Ниже — результаты команды, в которой у каждого агента есть инструкция и часы:
- DRACO. Команда затратила на 33% меньше времени, а стоимость задачи снизилась на 54%. Оценка снизилась на 1,5 пункта (95%-й интервал: на 0,9–2,1 ниже). Дальний конец интервала, 2,1 пункта, выходит за допуск в 1,5 пункта.
- HLE. Команда затратила на 51% меньше времени, а стоимость задачи снизилась на 54%. Оценка снизилась на 1,7 пункта (95%-й интервал: на 0,3–3,1 ниже). Дальний конец интервала, 3,1 пункта, выходит за допуск в 2,5 пункта.
- Физический набор23. Команда затратила на 39% меньше времени, а стоимость задачи снизилась на 28%. Эта экономия зависит от того, как часто кэш подсказок истекал между запросами; без истечения кэша она составила бы 23%. Оценка выросла на 0,2 пункта (95%-й интервал: от 1,5 ниже до 2,0 выше).
На DRACO ведущий агент запускал в среднем (по медиане) 4 помощника на попытку, поэтому результат DRACO отражает работу команды в параллельном режиме. На HLE и физическом наборе медиана составила 0 помощников, то есть как минимум в половине командных прогонов работал только ведущий агент. Поэтому эти результаты в основном отражают поведение самого ведущего агента, а не эффект параллельных помощников.
С одиночным агентом. Для каждого набора ниже приведены три сравнения: эффект обоих изменений, эффект перехода на medium и сравнение обоих изменений при high с medium без изменений.
На физическом наборе23:
- Оба изменения сократили время одиночного агента на 34% и стоимость задачи на 34%. Оценка снизилась на 0,2 пункта (95%-й интервал: от 2,5 ниже до 2,1 выше).
- Более низкий уровень усилий сэкономил деньги, но явного выигрыша во времени не дал. При
mediumодиночный агент стоил на 37% меньше за задачу, чем приhigh, а время сократилось на 9% (95%-й интервал: от 30% меньше до 16% больше). Оценка снизилась на 3,4 пункта (95%-й интервал: на 0,4–6,8 ниже), причём интервал подходит близко к нулю. - С обоими изменениями при
highодиночный агент затратил на 27% меньше времени, чем приmedium(95%-й интервал: от 5% до 44% меньше). Стоимость задачи была на 6% выше (95%-й интервал: от 12% меньше до 27% больше), а оценка — на 3,2 пункта выше (95%-й интервал: от 0,1 ниже до 6,5 выше).
На HLE:
- Оба изменения сократили время одиночного агента на 54% и стоимость задачи на 48%. Оценка снизилась на 1,1 пункта (95%-й интервал: от 2,6 ниже до 0,3 выше). Дальний конец интервала, 2,6 пункта, чуть выходит за допуск в 2,5 пункта.
- При
mediumодиночный агент стоил на 43% меньше за задачу, чем приhigh, и затратил на 39% меньше времени. Оценка снизилась на 1,3 пункта (95%-й интервал: от 2,8 ниже до 0,1 выше). - С обоими изменениями при
highодиночный агент затратил на 25% меньше времени, чем приmedium(95%-й интервал: от 12% до 35% меньше). Стоимость задачи была на 9% ниже (95%-й интервал: от 21% меньше до 6% больше), а оценка — на 0,2 пункта выше (95%-й интервал: от 1,3 ниже до 1,7 выше).
На DRACO:
- Оба изменения сократили время одиночного агента на 69% и стоимость задачи на 49%. Оценка снизилась на 1,9 пункта (95%-й интервал: на 1,1–2,8 ниже). Дальний конец интервала, 2,8 пункта, выходит за допуск в 1,5 пункта.
- При
mediumодиночный агент стоил на 25% меньше за задачу, чем приhigh, и затратил на 30% меньше времени. Оценка снизилась на 0,7 пункта (95%-й интервал: на 0,1–1,3 ниже). - С обоими изменениями при
highодиночный агент затратил на 53% меньше времени, чем приmedium(95%-й интервал: от 42% до 63% меньше), а стоимость задачи была на 31% ниже (95%-й интервал: от 28% до 35% ниже). Оценка была на 1,2 пункта ниже (95%-й интервал: на 0,5–1,9 ниже). Дальний конец интервала, 1,9 пункта, выходит за допуск в 1,5 пункта.
На всех трёх наборах оба изменения при high сэкономили больше времени, чем переход на medium. По стоимости на HLE и физическом наборе явной разницы не было, а на DRACO стоимость оказалась ниже. Оценка на HLE была примерно такой же. На физическом наборе она была на 3,2 пункта выше, но интервал включает ноль, поэтому разница неочевидна. Таким образом, для одиночного агента часы экономят больше времени, чем снижение уровня усилий. Однако на DRACO одиночный агент с обоими изменениями набрал на 1,2 пункта меньше, чем при medium (95%-й интервал: на 0,5–1,9 ниже).
Когда это использовать.
- Используйте оба изменения, когда время работы агента важно, а небольшое изменение оценки допустимо. Во всех измеренных конфигурациях они сократили время и стоимость задачи — как для команд, так и для одиночных агентов.
- Прежде чем внедрять изменения, проверьте оценку на собственных задачах. На DRACO оценка снизилась на 1,5 пункта для команды и на 1,9 пункта для одиночного агента. На HLE — на 1,7 пункта для команды и на 1,1 пункта для одиночного агента. На физическом наборе ни одно из изменений оценки явно не отличалось от нуля.
- Если вы рассматриваете снижение уровня усилий ради экономии времени, сначала сравните его с часами. Одиночный агент с обоими изменениями при
highзатратил меньше времени, чем приmedium: на 53% на DRACO, на 25% на HLE и на 27% на физическом наборе. Стоимость задачи на DRACO была на 31% ниже, а на HLE и физическом наборе явной разницы не было.
Как это добавить. Поместите эту инструкцию в начало системной подсказки каждого агента:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.Второе предложение сообщает модели, что она будет получать сообщения с часами. Первый запрос часов не содержит. В измеренных прогонах использовалась именно эта формулировка.
Затем перед каждым запросом агента, кроме первого, добавляйте системное сообщение в середине разговора с прошедшим временем в целых секундах, например Elapsed time: 412 seconds. Отсчитывайте время от начала задачи, а не от запуска агента. В команде все агенты читают одни и те же часы. Поэтому первые показания, которые видит помощник, уже включают время, потраченное командой до его запуска. В цикле инструментов размещайте сообщение сразу после сообщения user с результатами инструментов, как показано в разделе Размещение после результатов инструментов. Если вместо этого вы отправляете агенту новое сообщение user, размещайте часы после него.
Не удаляйте и не перемещайте предыдущие сообщения с часами. Каждое из них становится частью истории разговора, поэтому кэшированный префикс по-прежнему совпадает при следующем запросе (см. Сочетание с кэшированием подсказок). Anthropic измеряла именно такие обычные системные сообщения, которые остаются видимыми для модели. Системное сообщение, ограниченное ходом показывало бы модели только последние показания часов, но эту форму Anthropic не измеряла.
Следующий пример запускает цикл инструментов одного агента с обоими изменениями. Он добавляет часы после результатов инструментов и обрабатывает только клиентские инструменты:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Секунды реального времени (wall-clock), чтобы помощники в других процессах могли использовать время запуска ведущего.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Используем потоковую передачу: лимит в 128 000 токенов слишком велик для запроса без потоковой передачи.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Системное сообщение должно следовать за ходом пользователя, поэтому отметка времени идёт после результатов инструментов.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 поддерживает системные сообщения в середине разговора; остальные модели с такой поддержкой перечислены в списке поддерживаемых моделей. Если модель их не поддерживает (например, Claude Sonnet 5), поместите ту же строку в текстовый блок после последнего блока tool_result в ходе user. Anthropic измеряла только вариант с системным сообщением.
В Claude Managed Agents можно отправить событие system.message вместе с результатом инструмента или сообщением пользователя. У этого способа есть ограничения:
- Сообщение применяется к текущему ходу и ко всем последующим. Поэтому ходы после встроенных инструментов платформы, например веб-поиска, видят последние отправленные вами показания часов, а не текущее время.
system.messageдоходит только до основного потока сессии. В мультиагентной сессии это поток координатора, поэтому рабочие агенты не видят часы, отправленные таким способом.
Чтобы показывать текущее время перед каждым ходом и каждому агенту в команде, запускайте агентный цикл самостоятельно через Messages API.
Комбинирование моделей
Многомодельные архитектуры подходят для рабочих нагрузок, сложность задач в которых варьируется достаточно, чтобы разные шаги лучше всего обслуживались разными моделями. Когда ваш трафик смешивает рутинную работу, с которой надёжно справляется меньшая модель, с более сложными шагами, требующими передовых возможностей, разделение работы сохраняет передовой интеллект там, где он важен, тогда как большинство токенов оплачивается по ставкам меньшей модели. Когда рабочей нагрузке не хватает такой смеси, потому что её сложность однородна или она представляет собой одну зависимую цепочку, одна хорошо настроенная модель обычно является лучшим выбором. Каждый раздел о стратегии даёт правило, позволяющее различить эти два случая.
Две стратегии покрывают большинство рабочих нагрузок, и они различаются тем, какая модель держит основной цикл:
| Стратегия | Поток управления | Роль передовой модели | Подходит для | Стоимость передовой модели масштабируется с |
|---|---|---|---|---|
| Советник | Меньшая модель ведёт цикл, эскалирует по требованию | Консультирует по планам и исправлениям | Последовательная работа, сложная местами, например множество ходов агента программирования между несколькими реальными решениями | Тем, как часто исполнитель застревает |
| Оркестратор | Передовая модель ведёт цикл, делегирует основной объём работы | Планирует, распределяет и синтезирует | Работа, которая разветвляется по действительно независимым файлам, документам или случаям, особенно объёмом более одного контекстного окна | Тем, насколько сложно координировать части |
Стратегия советника: передавайте сложные решения более сильной модели
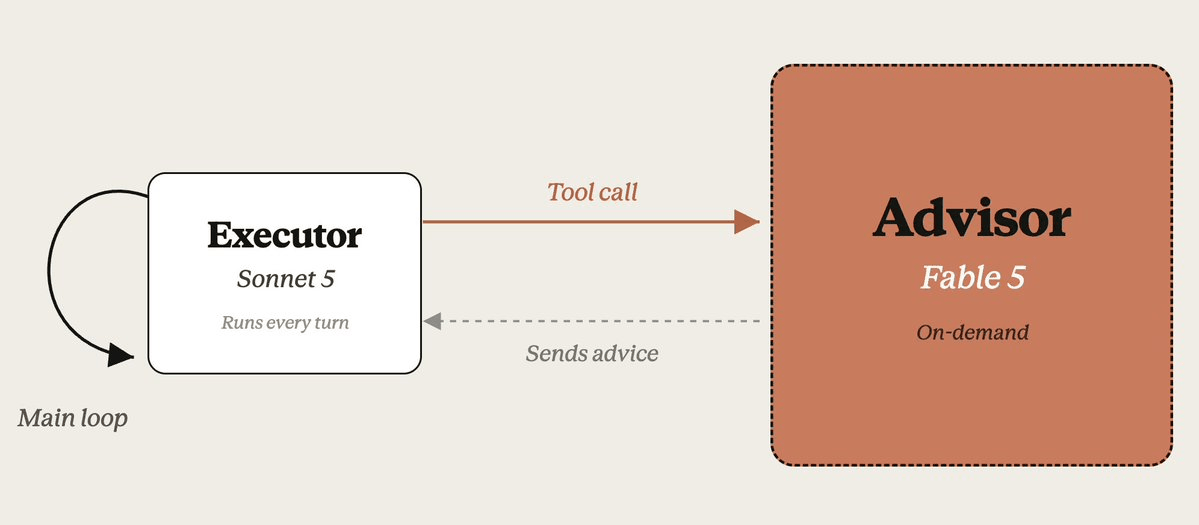
В стратегии советника более дешёвая модель — «executor» (исполнитель) — выполняет агентный цикл и большинство ходов. Иногда ей нужно принять решение, требующее более глубокого анализа, например выбрать подход или восстановиться после сбоя. Тогда она обращается за стратегическим советом к более интеллектуальной модели — «advisor» (советнику), а затем продолжает работу. Большая часть токенов оплачивается по тарифам исполнителя, и лишь редкие консультации — по тарифам советника.
Чтобы использовать эту стратегию, добавьте в запрос инструмент-советник. Эта бета-функция выполняет всю стратегию на стороне сервера в одном запросе /v1/messages:
- Исполнитель генерирует вызов инструмента.
- Anthropic выполняет инференс советника.
- Исполнитель продолжает работу с полученным советом.
Писать код оркестрации не нужно. В Claude Managed Agents добавьте советника в сессию: для этого добавьте запись advisor в список multiagent агента. Основной поток сессии будет консультироваться с ним так же. Claude Code тоже поддерживает эту стратегию; см. передачу сложных решений с помощью инструмента-советника.
Что определяет отдачу. Советник видит задачу только через вызовы исполнителя, поэтому его польза зависит от двух факторов.
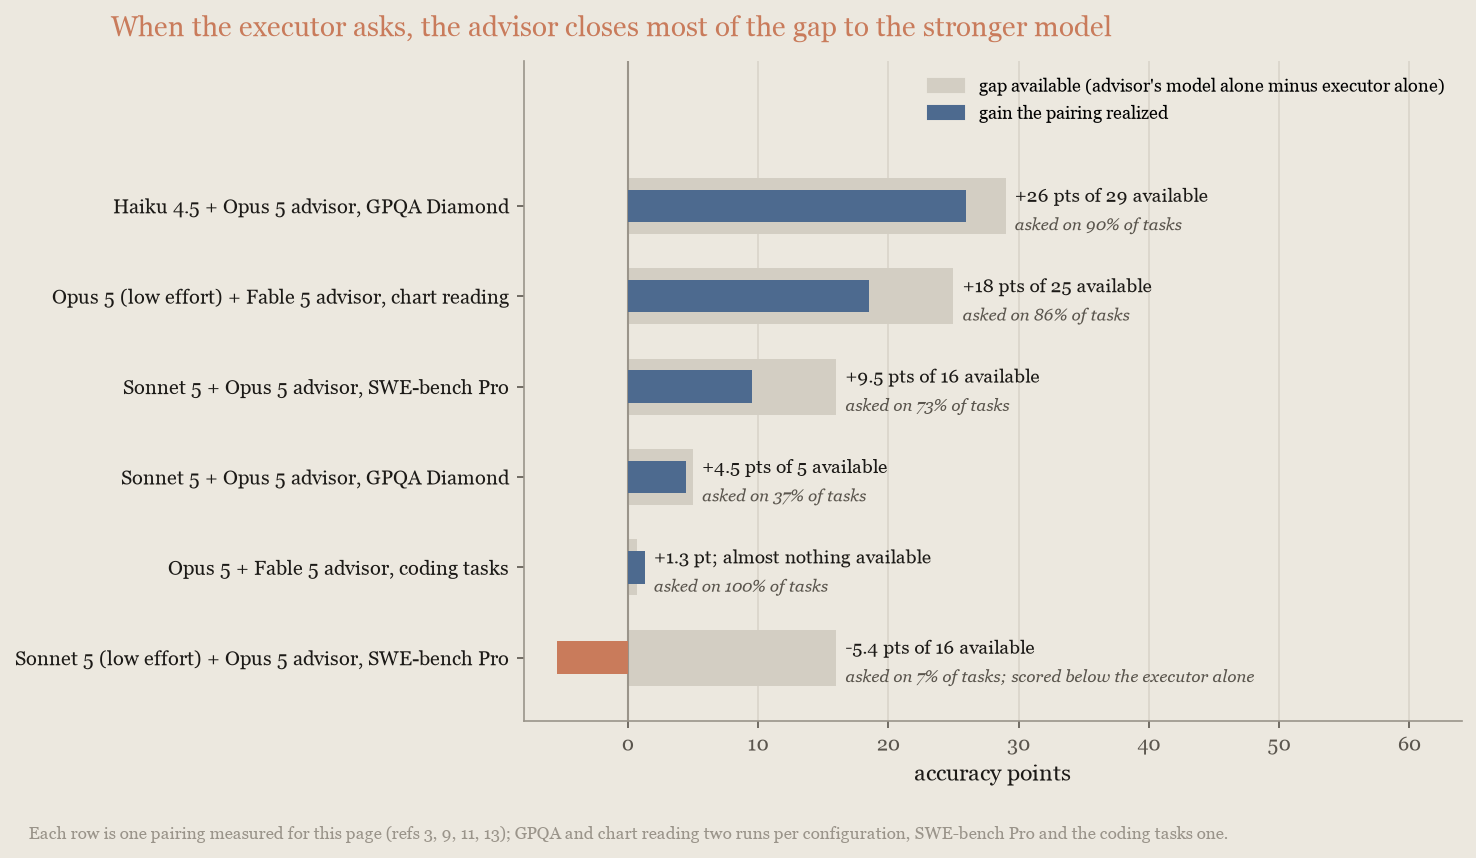
Первый фактор — разрыв между моделями. Советник может передать только те возможности, которых не хватает исполнителю. На GPQA Diamond9 советник Claude Opus 5 дал исполнителю Claude Haiku 4.5 значительный прирост, исполнителю Claude Sonnet 5 — несколько пунктов, а передовому исполнителю — почти ничего.
Второй фактор, более хрупкий, — обращается ли исполнитель за советом на самом деле («consult rate» — частота консультаций). При низком усилии исполнитель может перестать замечать, что зашёл в тупик. Пара, которая при усилии по умолчанию консультируется на большинстве задач, при сниженном усилии может почти перестать это делать. В таком случае она набирает меньше, чем исполнитель в одиночку. Частота консультаций зависит и от задачи. На DeepSWE10 исполнитель Sonnet 5 с низким усилием продолжал обращаться к советнику и получил прирост в 23 пункта, а на SWE-bench Pro3 тот же исполнитель перестал это делать.
Если исполнитель всё же обращается за советом, он восстанавливает значительную часть разрыва. На следующем графике во всех парах, где исполнитель продолжал консультироваться, советник закрыл как минимум половину разрыва до более сильной модели. Пара для программирования даже превзошла более сильную модель. При этом за более сильную модель вы платите только во время консультаций — именно это и делает экономию возможной:
На частоту консультаций можно влиять подсказкой. Если у исполнителя есть только встроенное описание инструмента, он обращается к советнику слишком редко, особенно в задачах программирования. Поэтому в документации по инструменту-советнику приведена системная подсказка, которая просит делать один вызов перед содержательной работой и один перед завершением — примерно два-три вызова на задачу. Пара для программирования, описанная ниже, консультировалась так:
- с Claude Opus 5 в роли исполнителя — примерно две консультации на каждой задаче;
- с Claude Opus 5.5 в роли исполнителя — примерно 1,4 запроса совета на попытку, причём 4% попыток обошлись без советов.
На той же странице описано, как побудить исполнителя чаще обращаться к советнику и как ограничить число вызовов на стороне клиента, чтобы контролировать стоимость. Следите за частотой консультаций: задавайте её подсказкой, измеряйте и возвращайте прежний уровень усилий исполнителя, если частота резко падает.
Когда это окупается. Советник экономит деньги, если несколько коротких консультаций по тарифу советника заменяют выполнение всей задачи моделью советника. Лучше всего это работает, когда модель советника стоит значительно дороже модели исполнителя. Поэтому наиболее экономичная конфигурация — передовой советник в паре с исполнителем среднего уровня. Даже пара из двух моделей верхнего ценового уровня может частично окупить стоимость советов, потому что советы экономят и токены исполнителя: получив правильный подход, исполнитель реже заходит в тупик.
- В паре для программирования с исполнителем Claude Opus 5 (см. ниже) эта экономия окупила примерно половину стоимости советов. Исполнитель потратил на $1,26 меньше за попытку, чем Opus 5 в одиночку при настройке по умолчанию, а консультации стоили $2,47.
- С исполнителем Claude Opus 5.5 советы почти не снизили затраты исполнителя: $1,36 за попытку против $1,38 у Opus 5.5 в одиночку при
high. При этом консультации стоили $1,55.
Anthropic проверила пару на внутреннем бенчмарке агентного программирования11 с простым агентом на API. Исполнитель Claude Opus 5.5 при high с советником Claude Fable 5.1 набрал 90,1% при $2,92 за попытку. Сравнение с Opus 5.5 в одиночку:
- при
high(той же настройке, что у исполнителя) — на 1,7 пункта больше при стоимости примерно в 2,1 раза выше. При пяти попытках на задачу этот разрыв находится на границе разброса между прогонами; - при значении по умолчанию,
medium, — на 3,5 пункта больше при стоимости примерно в 3,5 раза выше.
Результат пары ложится примерно на собственную кривую усилий Opus 5.5, то есть советник даёт примерно то же, что и повышение усилия. Для сравнения: Opus 5.5 в одиночку при xhigh набрал 91,1% при $4,11 за попытку (одна попытка на задачу). В августе самой точной из измеренных конфигураций была пара из советника Claude Fable 5.1 и исполнителя Claude Opus 5. Она стоила $6,21 за попытку — чуть более чем вдвое дороже пары с Opus 5.5. График сравнивает пару с Opus 5.5 с собственной кривой усилий Opus 5.5 и с августовской кривой Claude Fable 5.1:
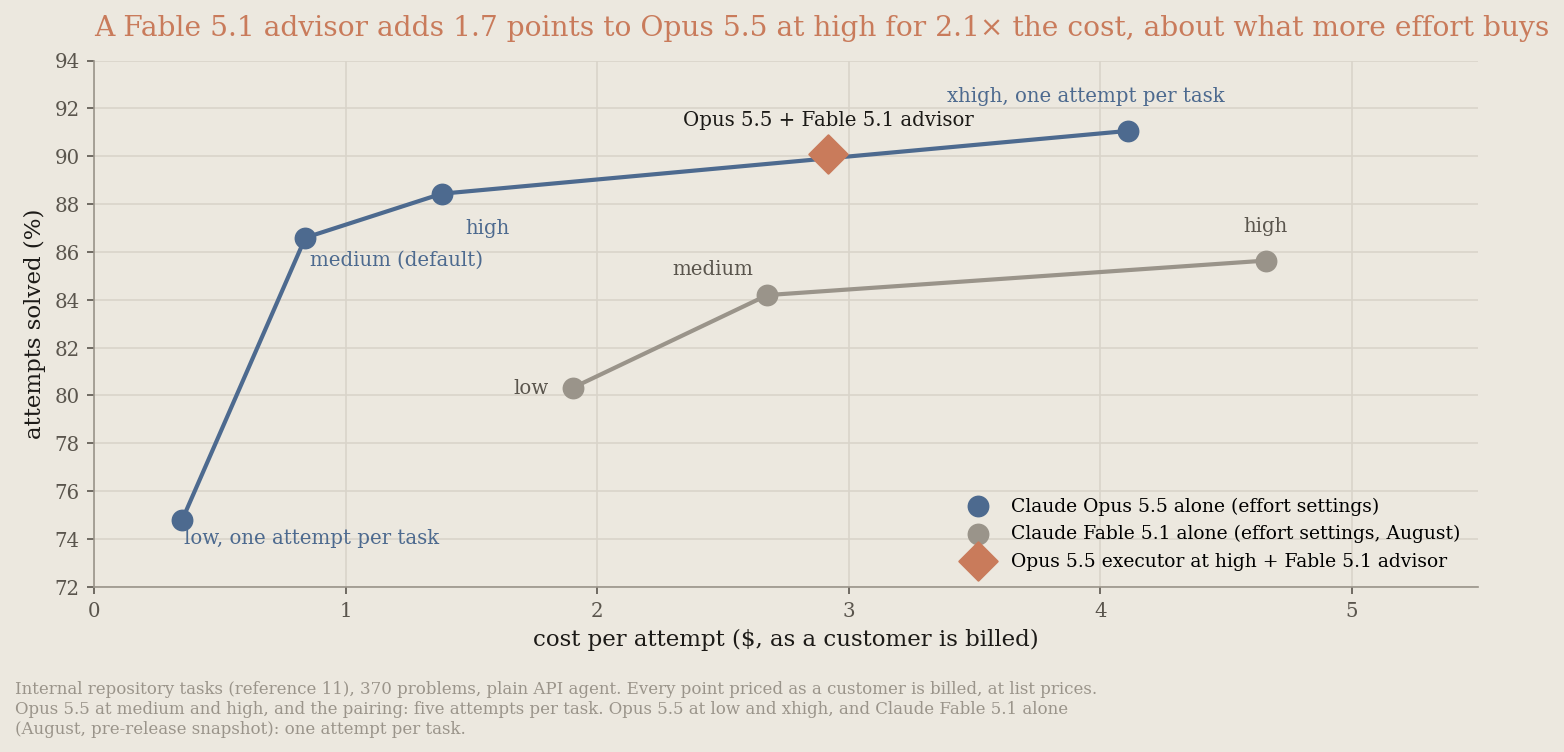
Более раннее измерение через режим советника в Claude Code также показало, что пара с советником превосходит каждую из своих моделей по отдельности. Воспринимайте результат Claude Opus 5.5 как ориентир, который стоит проверить на своей рабочей нагрузке: советник даёт несколько пунктов примерно за удвоенную стоимость исполнителя. Более широкий разрыв в возможностях не гарантирует более выгодного соотношения цены и результата. Задержку добавляют сами консультации: на этом бенчмарке это примерно один-два дополнительных вызова передовой модели на задачу, и каждый из них лежит на критическом пути задачи.
Когда лучше использовать только более сильную модель. Если точность вашей рабочей нагрузки зависит от усилия, то прежде чем строить пару, сравните её с моделью советника в одиночку при пониженной настройке. За советника вы платите только на тех задачах, где он нужен. Но если консультации происходят на большинстве задач, пара обходится дороже, чем сама более сильная модель. Пример — Chartography13:
- Исполнитель Claude Opus 5.5 при
lowс советником Claude Fable 5.1 обратился к нему лишь на 1 из 300 задач. Пара набрала 61,7 — на 7 пунктов меньше, чем Opus 5.5 в одиночку, что выходит за пределы разброса между прогонами, — примерно при той же стоимости. - В августе исполнитель Claude Opus 5 консультировался почти на каждой задаче. Эта пара сравнялась с Fable 5.1 в одиночку при
mediumв пределах разброса между прогонами (65,0 против 67,5), но стоила примерно в 1,8 раза больше за задачу.
Поэтому сначала измерьте собственную частоту консультаций. Если исполнитель обращается к советнику на большинстве задач, вы фактически платите по тарифам советника за всю рабочую нагрузку. В этом случае запуск самой модели советника — более дешёвый путь к той же оценке.
Какую бы пару вы ни выбрали, сначала оцените стоимость модели советника в одиночку при низком усилии: это базовый уровень, который пара должна превзойти. Повторяйте проверку при каждом выпуске новой модели, потому что выпуски меняют и разрыв в возможностях, и соотношение цен.
Когда это подходит. Стратегия советника подходит для рабочих нагрузок, где ходы в основном механические, но качество плана имеет большое значение. Примеры — агенты программирования, «computer use» (использование компьютера) и многошаговые исследовательские конвейеры. Стратегия плохо подходит в трёх случаях:
- каждый ход действительно требует передовых возможностей;
- планировать нечего, например в однократных вопросах и ответах (Q&A);
- исполнитель уже близок по возможностям к советнику.
Стратегия оркестратора: делегирование основного объёма работы
В стратегии «orchestrator» (оркестратор) цикл удерживает «frontier model» (передовая модель). Она декомпозирует задачу, распределяет подзадачи между более дешёвыми «worker models» (рабочими моделями) и объединяет их результаты. Собственная стенограмма оркестратора остаётся короткой, потому что рабочие модели берут на себя исследование, расходующее много токенов. Поэтому большая часть токенов оплачивается по тарифам рабочих моделей, а план и синтез по-прежнему выполняет передовая модель.
Чтобы построить такую систему, используйте мультиагентную оркестрацию в Claude Managed Agents: настройте агента-координатора (оркестратор) и набор рабочих агентов, каждый со своей моделью. Полный рабочий пример с передовым координатором и рабочими агентами Claude Sonnet 5 см. в рецепте Claude Cookbook Паттерн координатора: большие модели для планирования, маленькие — для выполнения.
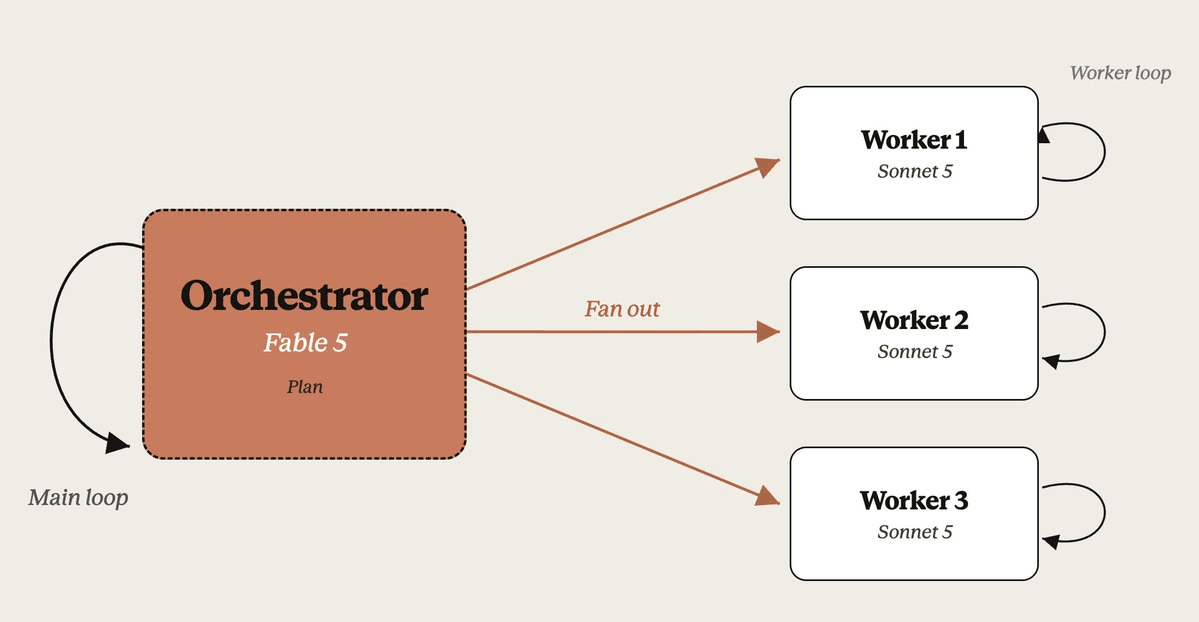
Этот паттерн экономит «wall-clock time» (реальное время выполнения), когда рабочие модели могут работать параллельно. На бенчмарке корпуса8 эпизод занимал около 2,3 часа, когда координатор запускал 25 параллельных рабочих агентов (задокументированный лимит платформы), против 15–20 часов при работе в одиночку. Деньги этот паттерн сэкономил лишь в двух измеренных ситуациях. На работе, с которой одна модель могла справиться самостоятельно, та же модель с более низким уровнем усилий каждый раз оказывалась дешевле.
Когда рабочие модели работают параллельно, инструкция о времени и часы прошедшего времени могут сократить время выполнения. На DRACO21 команда агентов на одной и той же модели с инструкцией и часами затрачивала на 33% меньше времени при стоимости задачи на 54% ниже и набирала на 1,5 пункта меньше. У каждого агента в этой команде были инструкция и часы. Anthropic не измеряла эффект часов с более дешёвыми рабочими моделями. В Claude Managed Agents часы доступны только координатору, поэтому рабочие агенты их никогда не видят. Anthropic не измеряла команду, в которой часы есть только у координатора. Кроме того, часы координатора актуальны только на ходах, следующих за вашими собственными результатами инструментов или сообщениями. В разделе Показывайте модели прошедшее время приведён рецепт для цикла агента, который вы запускаете через Messages API.
Случай 1: страховка от хвоста затрат на рутинной работе. Передовая модель, работающая в одиночку, иногда зацикливается на рутинной задаче, которую обычно решила бы. Заранее нельзя сказать, на каких задачах это произойдёт, поэтому несколько таких запусков составляют основную часть счёта. Координатор, передающий рутинную работу более дешёвой рабочей модели, ограничивает этот «cost tail» (хвост затрат): любое зацикливание теперь оплачивается по тарифам рабочей модели.
Anthropic измерила это на намеренно простом срезе BrowseComp4 (10 задач, которые одиночная модель надёжно решает; 50 делегированных и 70 одиночных запусков). Координатор Claude Fable 5 с одной рабочей моделью Claude Sonnet 5 в среднем стоил примерно вдвое меньше, чем Claude Fable 5 в одиночку, и примерно втрое меньше на 90-м процентиле ($12 против $33). Самый дорогой запуск одиночной модели, за $84, к тому же дал неверный ответ:
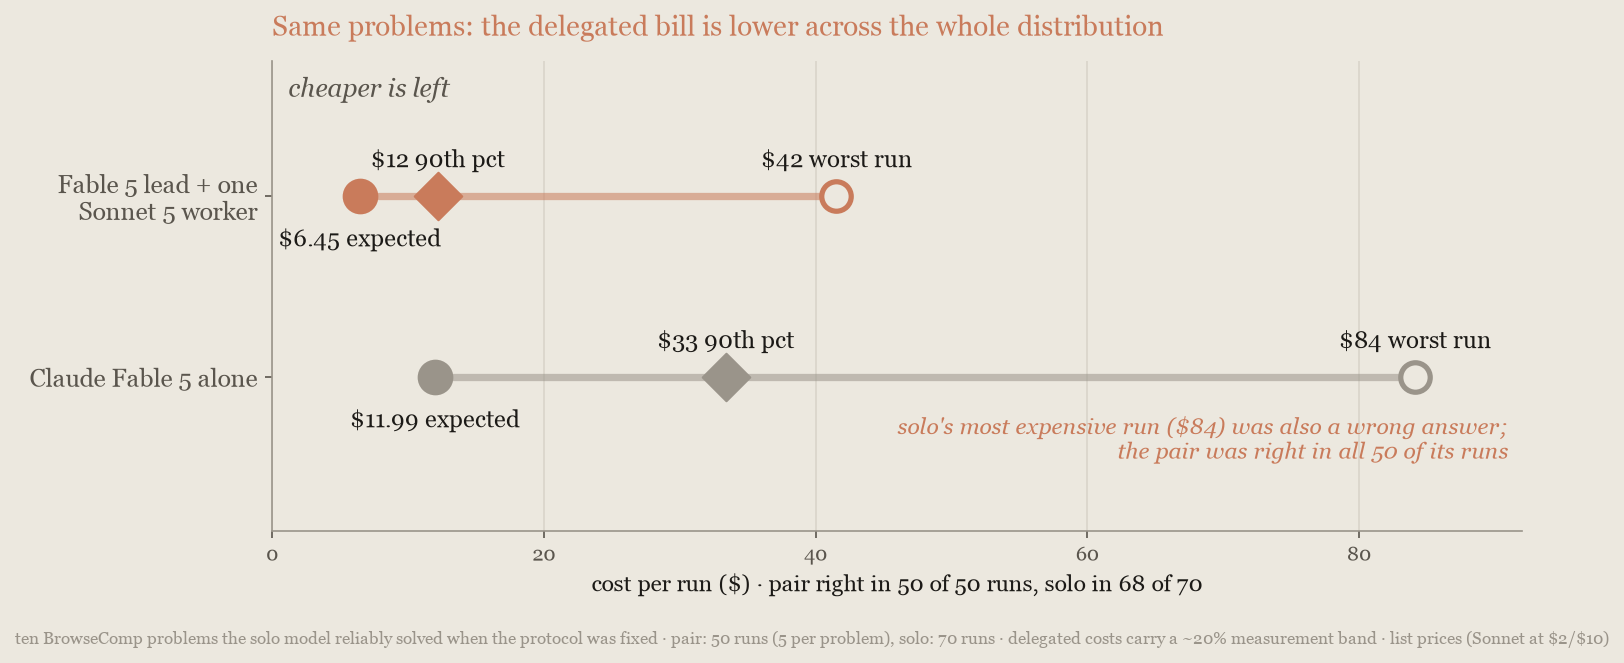
Делегирование окупилось на рутинной, обычно решаемой доле работы — вопреки интуиции, что рабочие модели нужны для сложных задач. На полном, более сложном наборе BrowseComp экономика оказалась обратной. Если у вашего трафика длинный хвост затрат на рутинных задачах, этот случай оркестратора стоит измерить первым.
Случай 2: работа, превышающая одно «context window» (контекстное окно). Одиночная модель должна обрабатывать такой большой объём входных данных последовательно, по одному контекстному окну за раз, и на каждом проходе платить за повторное чтение собственного состояния. Рабочие модели читают каждая свой раздел — параллельно и по тарифам рабочих моделей. Работа с большим объёмом чтения, которая всё же помещается в одно контекстное окно, — это задача выбора модели, а не делегирования: если учитывать только стоимость чтения, оркестратор выигрывает лишь тогда, когда работа не помещается ни в один контекст.
Anthropic создала бенчмарк для этого случая8: корпус из 21,6 миллиона токенов, состоящий из 14 публичных пакетов Python со 130 внедрёнными дефектами, — слишком большой для любого контекстного окна. Снижение уровня усилий здесь не помогает, потому что основную часть счёта составляет само чтение корпуса: Claude Fable 5.1 в одиночку стоил от $468 до $552 за эпизод при трёх настройках усилий, и менялась только его точность. Конфигурация с координатором — ведущая Claude Fable 5.1 над 25 рабочими моделями Claude Sonnet 5 — стоила примерно вдвое меньше этих настроек (на 47–55% меньше) и набирала на 10–12 пунктов меньше. При этом она тратила около 2,3 часа на эпизод против 15–20 и безоговорочно превзошла одиночный базовый уровень Claude Sonnet 5:
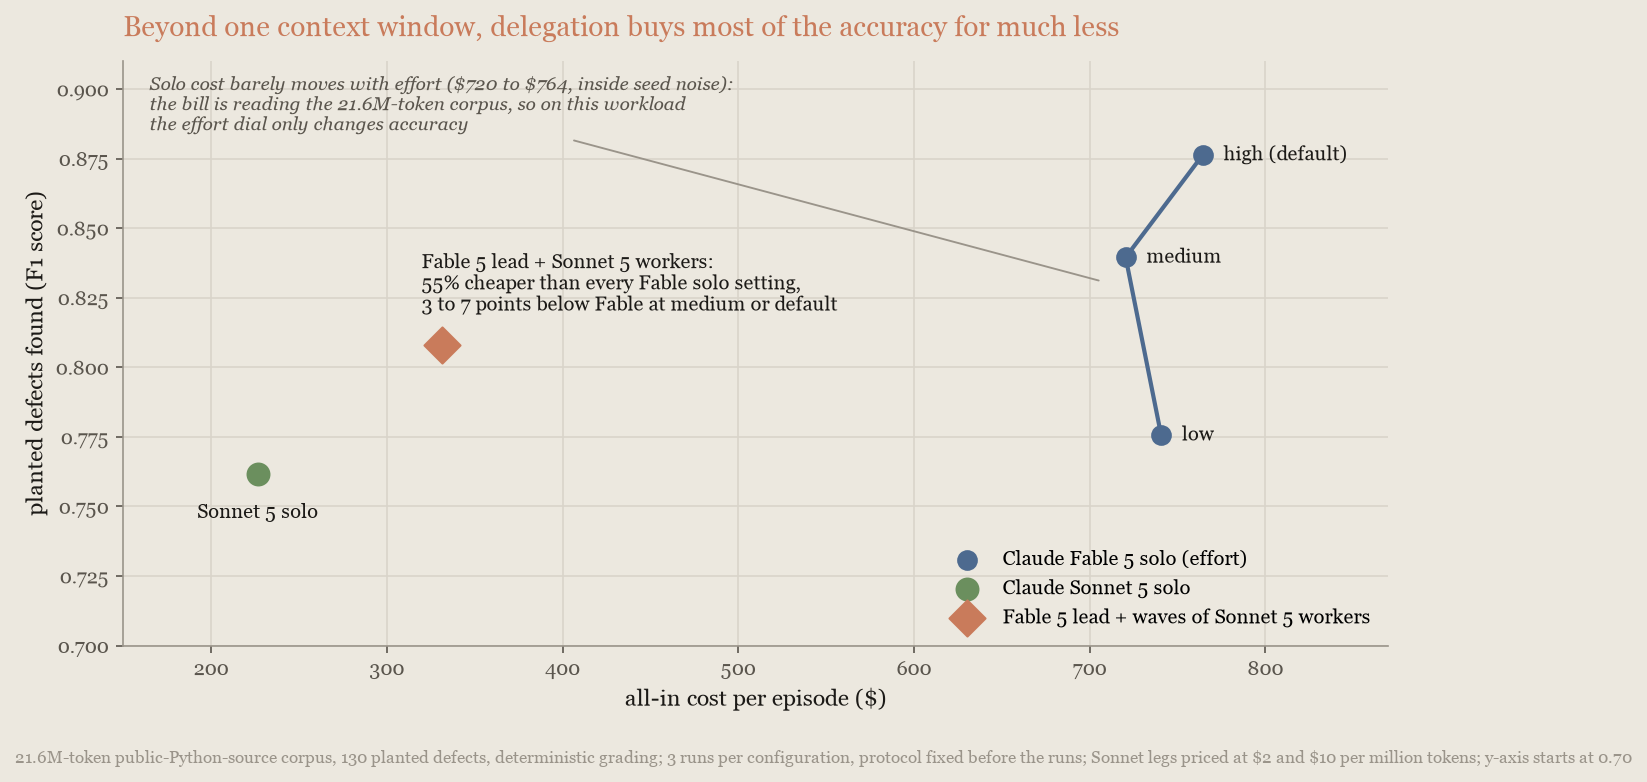
Учёт токенов показывает масштаб чтения. Конфигурация с координатором читала около 560 миллионов кэшированных токенов за эпизод — примерно в полтора раза больше, чем одиночная модель (около 365 миллионов). Почти все эти токены оплачивались по тарифу чтения кэша Claude Sonnet 5, и в целом конфигурация всё равно стоила примерно вдвое меньше. Fable 5.1 с уровнем усилий high по-прежнему даёт пиковую точность, но стоит примерно в 2,2 раза дороже конфигурации с координатором. Поэтому делегирование здесь даёт большую часть точности, но не всю.
Когда делегирование не окупается. Оркестратор приносит пользу только тогда, когда есть объёмная работа для передачи: много независимых частей, в идеале слишком много для одного контекстного окна. Если работа представляет собой одну цепочку зависимых шагов или помещается в один контекст, оркестратор платит за план, передачу и слияние, которые одиночная модель получает бесплатно. Во всех измеренных случаях такого рода модель координатора в одиночку с меньшим уровнем усилий оказывалась выгоднее.
Граница определяется сложностью задачи, а не бенчмарком: на полном, более сложном наборе BrowseComp4 Claude Fable 5 в одиночку достиг точности конфигурации с координатором при стоимости на 22–30% ниже. Независимые внешние исследования сообщают о той же закономерности5. Не стройте оркестратор, если работа представляет собой одну цепочку, помещается в один контекст без длинного хвоста затрат или если одиночная модель с меньшим уровнем усилий уже соответствует вашим требованиям.
Выбор между стратегиями
Большинство случаев сводится к одному вопросу: разделяется ли работа на независимые части или это один ответ, достигаемый через цепочку зависимых шагов? Таблица стратегий сопоставляет два ответа с двумя стратегиями.
Если вы не уверены, пока ничего не стройте:
- Сначала прогоните усилие на вашей текущей модели. Это самый дешёвый эксперимент на этой странице, и большинство рабочих нагрузок на нём заканчиваются.
- Если прогон показывает разрыв, оцените стоимость более сильной модели в одиночку при низком усилии. Это число, которое должна превзойти пара с советником, и пары на этой странице, которые его превзошли, были теми, чей исполнитель действительно консультировался.
Многомодельные результаты на этой странице оценивались относительно той же модели при более низком усилии и относительно следующей модели ниже, работающей в одиночку. Это сравнение, которое нужно провести на собственной рабочей нагрузке, и причина, по которой первый шаг — прогон усилия.
Когда вы всё же добавляете советника, это определение инструмента, а не перестройка архитектуры.
Измерение на вашей собственной рабочей нагрузке
Числа на этой странице отражают прейскурантные цены на момент измерения и будут меняться вместе с моделями и ценами. На них также влияют частота эскалации, то, насколько чётко разделяются задачи, и длина стенограммы. Метод остаётся прежним:
- Возьмите несколько задач из производственных логов так, чтобы их распределение соответствовало реальному трафику, и напишите проверки результатов для каждой: тесты проходят, тикет закрыт, количество строк верное. Записывайте стоимость задачи рядом с оценкой. Для этого оцените пять тарифицируемых счётчиков токенов в
usageкаждого ответа по их собственным тарифам: некэшированный ввод, запись в кэш на 5 минут и на 1 час (в 1,25 и 2 раза дороже цены ввода), чтение кэша и вывод. Затем просуммируйте результаты по всем запросам задачи (Usage and Cost API сообщает агрегированное значение). - Установите базовый уровень для классов моделей при разных уровнях усилий, а не только при уровне по умолчанию, и постройте график зависимости оценки от затрат. Многомодельная конфигурация должна превзойти всю кривую одиночной модели.
- Если кривая показывает разрыв, который не удаётся закрыть уровнем усилий, добавьте подходящую многомодельную стратегию и повторно запустите набор тестов.
- Перед переключением запустите победившую конфигурацию в теневом режиме на части трафика, а затем продолжайте регулярно запускать набор тестов.
В следующем примере вычисляется стоимость одного запроса для шага 1 по прейскурантным ценам Claude Opus 5.5:
# Цены за миллион токенов со страницы тарифов; для другой модели измените эти три значения.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0,05x от цены входных токенов для Claude Opus 5.5; множитель зависит от модели
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Запись в кэш на 1 час тарифицируется по 2x цены входных токенов, на 5 минут — по 1,25x; чтение — по цене чтения из кэша.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
В циклах агентов большинство входных токенов должны приходиться на чтение из кэша. Если значение cache_read_input_tokens мало по сравнению с суммой input_tokens и cache_creation_input_tokens, проверьте, что кэширование задействовано и что префикс не меняется между запросами. Когда включён инструмент-советник или «compaction» (сжатие), часть токенов отображается только в usage.iterations и не входит в итоговые значения верхнего уровня. В этом случае суммируйте по usage.iterations, а записи advisor_message оценивайте по тарифам модели-советника.
В следующей таблице перечислены рычаги в том порядке, в котором их стоит пробовать:
| Рычаг | Экономия в этих запусках | Влияние на качество | Задержка | Где |
|---|---|---|---|---|
| «Prompt caching» (кэширование подсказок) | Снижение стоимости в 2,7–5,3 раза в циклах агентов; 83% в запуске сортировки | Нет | Быстрее | Кэшируйте повторяющийся контекст |
| Длительность кэша 1 час | Дешевле 5-минутного значения по умолчанию, если примерно 1 ход из 20 следует за паузой от 5 минут до часа и лишь немногие перерывы длятся дольше часа. Исключения: на Claude Fable 5.1 поддерживать 5-минутный кэш тёплым дешевле, пока паузы длятся минуты, а длительность 1 час выигрывает, когда паузы приближаются к часу; на Claude Opus 5.5 поддерживать 5-минутный кэш тёплым дешевле, когда лишь один-два хода из 20 следуют за паузой продолжительностью примерно до получаса. Без пауз значение по умолчанию стоило на 15% меньше на Claude Sonnet 5 и примерно на 15–18% меньше на Claude Opus 5.5 | Нет | Остаётся тёплым после паузы | Выберите длительность кэша |
| Сокращение входных данных | Ещё 5 процентных пунктов в запуске сортировки | Нет | Без изменений | Сократите входные и контекстные токены |
| Удаление устаревших результатов инструментов на границах задач | 39% в длинном запуске сортировки (сжатие — 32%); нет экономии в коротких циклах | Не выявлено | Без изменений | Сократите входные и контекстные токены |
| Поиск инструментов | 45% при 500 подключённых определениях инструментов; 20% с сервером GitHub MCP | Нет | Без изменений | Сократите входные и контекстные токены |
| Файлы данных через выполнение кода | 92% на задаче с данными из 25 вопросов | Улучшение: 25 из 25 вместо 6 из 25 | Быстрее | Сократите входные и контекстные токены |
| Batch API | 50% | Нет | Результаты в течение 24 часов | Пакетируйте работу, которая может подождать |
| Аудит подсказок относительно текущей модели | 14% в обеих измеренных миграциях | Нет; улучшение в одной из них | Быстрее (меньше раундов вызова инструментов) | Проведите аудит подсказок относительно текущей модели |
| Обновление модели | С Opus 4.8 на Opus 5: на 12 пунктов больше при стоимости решённой задачи на 21% выше (Opus 5 с low превосходит Opus 4.8 примерно за 30% стоимости); с Sonnet 4.6 на Sonnet 5: на 15% дешевле за решённую задачу и на 5 пунктов больше; с Fable 5 на Fable 5.1: на 43% дешевле за решённую задачу примерно при той же оценке | Улучшение | Без изменений | Обновите модель |
| Снижение уровня усилий | Работа со знаниями: medium — 13–31%, low — от трети до половины; длительное программирование: medium — около 30%, low — около двух третей; в обоих случаях по сравнению с high | 1–3 пункта в работе со знаниями, 2–8 в длительном программировании | Быстрее | Настройте уровень усилий |
| Повторный запуск неудачных задач | Около 40% по сравнению с запуском всех задач на high при том же или немного более высоком проценте прохождения | Нет | Два запуска для неудачных задач | Повторно запускайте неудачные задачи с более высоким уровнем усилий |
| Бюджет задачи | 44–58% | 3–6 пунктов | Быстрее | Задайте бюджеты и ограничения вывода |
| Запрос более коротких ответов | 39% выходных токенов, 14% стоимости в запуске сортировки | Нет | Быстрее | Задайте бюджеты и ограничения вывода |
Увеличение max_tokens | Нет в расчёте на решённую задачу, но решается больше задач | Прирост до 22 пунктов на внутреннем наборе; нет прироста на публичной паре | Без изменений | Задайте бюджеты и ограничения вывода |
| Советник | Зависит от разрыва в возможностях и частоты обращений. Пара для программирования набрала на 1,7 пункта больше, чем Claude Opus 5.5 в одиночку с high, примерно за 2,1-кратную цену — примерно столько же даёт повышение уровня усилий. С Claude Opus 5.5 пара для чтения диаграмм почти никогда не обращалась к советнику и набрала на 7 пунктов меньше, чем Opus 5.5 в одиночку | Улучшение в программировании, ухудшение в чтении диаграмм | Примерно один-два дополнительных вызова на задачу | Стратегия советника |
| Оркестратор | Около половины по сравнению с передовой моделью — как при работе, превышающей одно контекстное окно, так и на хвостах затрат рутинных задач (последнее измерено на Claude Fable 5) | На 10–12 пунктов ниже передовой модели | Намного быстрее на больших входных данных | Стратегия оркестратора |
Использованные бенчмарки
Если в описании источника не указано иное, измерения — это внутренние прогоны этих бенчмарков в Anthropic. Если не оговорено иное, стоимость указана в долларах США по прейскурантным ценам, действовавшим на момент прогона каждого бенчмарка; для Claude Sonnet 5 используются цены $2 и $10 за миллион входных и выходных токенов. Графики с подписью «notional USD» (условные доллары США) оценивают количество токенов каждого запроса по этим ставкам и не отражают выставленные счета.
- WideSearch: Wong et al., «WideSearch: Benchmarking Agentic Broad Info-Seeking», arXiv:2508.07999, 2025. Задачи широкого веб-исследования, которые оцениваются по полноте и точности таблицы из множества строк; 200 задач, 3 прогона на конфигурацию, прогоны 1–2 августа 2026 г. График концентрации затрат построен по отдельному прогону на 20 задачах: 3 прогона на задачу, 3–4 августа 2026 г., стоимость рассчитана по записям о тарификации каждого запроса.
- GDPval: OpenAI, «GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks», 2025. Результаты интеллектуальной работы, которые оцениваются по рубрикам задач; прогон 210 задач из опубликованного эталонного набора (gold set), одна попытка на задачу, 2 августа 2026 г. Оценку выставляет модель Claude, поэтому абсолютные баллы могут отличаться от опубликованных результатов.
- SWE-bench Pro: Scale AI, «SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?», 2025. Подмножество из 482 задач, отобранных по совместимости с evaluation harness (оценочной средой) Anthropic; баллы несопоставимы с публичной таблицей лидеров. Они также несопоставимы с результатами SWE-bench Pro в системной карточке Claude Opus 5.5: те получены в прогонах с параметром effort (уровень усилий)
maxна другом наборе задач. Показатели Claude Opus 5.5 — это среднее двух прогонов на уровняхlow,medium(уровень по умолчанию для этой модели) иhighи один прогон наxhigh. Все прогоны выполнены 19–20 сентября 2026 г. с тем же ограничением в 16 384 токена на ход, что и в августовских прогонах Claude Opus 5; это ограничение оборвало 2 попытки наxhighи ни одной на других настройках. В прогонах Opus 5.5 использовалась версия бенчмарка, в которой контейнеры оценки имеют доступ только к внутренним зеркалам пакетов. В этой версии исключена одна задача, тест которой требует работающего веб-сайта, а ещё в трёх задачах эталонное решение в этой среде не проходит. Поэтому сравнения с Opus 5.5 и приведённые рядом с ними показатели Claude Fable 5.1 используют оставшиеся 478 задач. Показатели Claude Opus 5 на SWE-bench Pro в разделе Обновите модель и на графике пар с советником — это среднее двух прогонов на уровне усилий по умолчанию и один прогон наlow; все выполнены 4 августа 2026 г. Показатели эскалации получены по каждой задаче из прогонов Opus 5.5. Сначалаlow, затемhighна неудачных задачах: решено от 96,4% до 97,5% в разных сочетаниях прогонов примерно за $0,17. Сначалаmedium: от 96,0% до 97,1% примерно за $0,24. Повторный прогонhighна собственных неудачах: 96,9% за $0,31. Всё наhigh: от 94,8% до 95,8% за $0,29. Стоимость на этом подмножестве рассчитана так, как тарифицируется организация клиента: предыдущая подсказка каждого запроса учитывается как чтение из кэша, а его новые токены — как 5-минутная запись в кэш. Расчёт выполнен по собственным записям об использовании из прогонов и сверен с журналом расходов клиента. Собственная тарификация оценочной организации до 10 сентября 2026 г. учитывала чтения из кэша блоками по 8 192 токена для Claude Opus 5, Claude Fable 5, Claude Opus 4.7 и Claude Opus 4.8. Для прогонов этих моделей она давала показатели в 1,4–1,8 раза выше. Для Claude Fable 5.1, Claude Sonnet 5 и Claude Sonnet 4.6 два способа расчёта расходятся не более чем примерно на 9%, а для показателей Claude Opus 5.5 совпадают в пределах 3% на каждом уровне усилий. Пары с исполнителем Claude Sonnet 5 на графике советника взяты из той же серии измерений на этом подмножестве. Пара Sonnet с Opus 5 прогонялась дважды (7 и 8 августа 2026 г., прогон и его точное повторение), пара с низким уровнем усилий — один раз (8 августа 2026 г.), а Claude Sonnet 5 без советника — дважды (77,4%, базовый уровень для обеих строк Pro). Точка Claude Fable 5 в разделе «Обновите модель» — это среднее трёх прогонов на уровне усилий по умолчанию, выполненных 26 августа 2026 г.; стоимость рассчитана тем же способом. Показатели бюджета задачи для Claude Fable 5.1 — это один прогон на бюджет (два при 35 000 токенов) на том же подмножестве с уровнем усилий по умолчанию, 26 августа 2026 г. Базовым уровнем служит прогон без бюджета в тот же день (92,1%, $1,10 за задачу). Более ранний набор на уровнеlow, выполненный 21 августа 2026 г., набрал 88,6% без бюджета при $0,48 за задачу. Сравнение в разделе Сравните модели сопоставляет этот единственный прогон с двумя объединёнными прогонами Claude Sonnet 5 на том же подмножестве. На уровне усилий Fable 5.1 по умолчанию соотношение обратное: решённая задача обходится на 41% дороже, чем у Sonnet 5. Лестница обновления — это один прогон на модель с её стандартными настройками (по два для Opus 5 и Sonnet 5; точка Fable 5 описана выше). Прогоны Opus и Sonnet выполнены на одной неделе в одной оценочной среде и в одной организации. - BrowseComp: Wei et al., «BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents», OpenAI, 2025. Показатели уровня усилий получены на выборке из 500 задач, от одного до трёх прогонов на настройку, 3 августа 2026 г.; точка по умолчанию объединяет два прогона 26–27 июля 2026 г. График «страховки затрат» построен на 10 надёжно решаемых задачах из среза в 26 задач. В него вошли 50 делегированных прогонов (1–2 августа 2026 г.) и 70 одиночных прогонов (50 — 2–3 августа 2026 г.; 20 архивных — 12–13 июля и 1 августа 2026 г.). Ожидаемая стоимость прогона — $6,45 против $11,99; погрешность измерения делегированных показателей — около 20%.
- Масштабирование архитектур агентов: Kim et al., «Towards a Science of Scaling Agent Systems», arXiv:2512.08296, 2025. Независимое внешнее исследование. Оно цитируется только ради общего направления вывода о том, когда делегирование не окупается, а не ради каких-либо цифр.
- DeepWideSearch: «DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking», arXiv:2510.20168, 2025. 220 вопросов охватывают 15 предметных областей; каждый сочетает сбор множества строк с многошаговым поиском. Измерено на постоянном наборе строк бенчмарка, 3 прогона на конфигурацию, 2 августа 2026 г. (точка команды с одним рабочим агентом — 26–27 июля 2026 г.).
- DeepResearch Bench II: Li et al., «DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report», arXiv:2601.08536, 2026. Его 132 исследовательские задачи в 22 областях оцениваются по бинарным рубрикам, составленным на основе экспертных отчётов. Измерено на подмножестве из 50 задач, стратифицированном по всем темам: одна попытка на задачу, 3 прогона на настройку, на Claude Managed Agents с собственными инструментами платформы для веб-поиска и загрузки страниц (26–27 августа 2026 г.). Оценка проводилась на 33 задачах, от которых не отказалась ни одна конфигурация; попытки, прерванные производственными классификаторами безопасности, исключены. Стоимость — это сумма, которую платит клиент: запросы платформы плюс плата за веб-поиск. Баллы — это среднее каждой модели на базе из 33 задач без её собственных прерванных задач. На 21 задаче, не затронутой прерываниями ни в одном варианте, Claude Fable 5.1 опережает Claude Fable 5 на 2–3 пункта на каждом уровне усилий, а результаты обеих моделей не зависят от уровня усилий. График кэширования пересчитывает стоимость тех же запросов так, будто каждый входной токен тарифицируется по ставке без кэша. Судьёй выступает Claude Opus 4.6 по протоколу рубрик бенчмарка. В оригинале используется другой судья, а судья от Anthropic может отдавать предпочтение стилю собственных моделей. Claude Opus 5 на уровне усилий по умолчанию прогонялся на той же платформе и том же подмножестве, три прогона, 28 августа 2026 г. Результаты: 68,8% на исходных 50 задачах, 70,8% на базе из 33 задач и 71,1% на наборе из 21 задачи, при $6,71 за задачу ($23,72 без кэширования). Классификаторы безопасности не прервали ни одной его попытки, но он работал с более новой версией защитных механизмов, чем другие модели.
- Поиск дефектов в корпусе: внутренний бенчмарк Anthropic для работы, которая не помещается в одно context window (контекстное окно). Корпус объёмом 21,6 миллиона токенов собран из исходного кода 14 публичных пакетов Python и содержит 130 внедрённых дефектов; оценка детерминированная. Протокол зафиксирован до прогонов и прошёл внутреннюю проверку; три прогона на конфигурацию. Все конфигурации выполнялись на Claude Managed Agents. Командная конфигурация на графике — это прогон 30 августа 2026 г., в котором координатор Claude Fable 5.1 выполнил всю проверку внутри платформы на её документированном пределе в 25 параллельных рабочих агентов Claude Sonnet 5. Три его эпизода набрали F1 0,764, 0,825 и 0,791 после аудита лишних находок (до аудита — 0,751, 0,821 и 0,781) при стоимости $225, $234 и $283. Одиночная конфигурация Claude Sonnet 5 выполнялась 3–4 августа 2026 г. Одиночные конфигурации Claude Fable 5.1 выполнялись 24–25 августа 2026 г. со стартовыми настройками обслуживания платформы, по три сида на уровень усилий, на той же сборке корпуса. Образ песочницы содержал установленные копии части корпуса, и на финальном этапе сборки Claude Fable 5.1 сверялся с ними в 7 из 9 эпизодов. Повторная оценка без этих дополнений изменила результаты затронутых сидов не более чем на 3 пункта. Абсолютное значение F1 относится только к этой сборке корпуса и несопоставимо между бенчмарками; конфигурации сравниваются в равных условиях.
- GPQA Diamond: Rein et al., «GPQA: A Graduate-Level Google-Proof Q&A Benchmark», 2023. Подмножество Diamond из 198 вопросов, два прогона на конфигурацию, 7 августа 2026 г. (Claude Opus 5.5: 19 сентября 2026 г.). Ответы оценивает модель по эталонным ответам; токены советника учитываются по каждому запросу. Проверка безопасности платформы отклонила два вопроса по биологии у исполнителей Claude Sonnet 5, а один из них — также у Claude Opus 5; если их исключить, ни одно сравнение не изменится более чем на один пункт. 92% у Claude Opus 5.5 получены в двух прогонах с параметром
fallbacks: "default", который включает серверную резервную обработку. Любая попытка, которая всё равно завершилась отказом, засчитывалась как неверная. В каждом прогоне проверка безопасности пометила шесть вопросов по биологии: на пять из них ответил Claude Opus 5 через резервное переключение, а шестой всё равно завершился отказом. Стоимость вопроса для Opus 5.5 включает эти резервные ответы. Если не засчитывать отказы как неверные, эти прогоны набирают 93%: оценщик всё равно присваивает отклонённой попытке вариант ответа, обычно правильный. Если засчитывать отказы как неверные, прогоны Claude Opus 5 набирают 91% (один отказ на прогон). Столько же набирают два прогона Claude Opus 5.5 с отключённым резервным переключением, в которых Opus 5.5 отказывался отвечать на пять или шесть вопросов по биологии за прогон. - DeepSWE: Datacurve, «DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks», arXiv:2607.07946, 2026. Набор содержит 113 оригинальных задач на пяти языках с программными верификаторами. Для каждой пары выполнено по два прогона 7 августа 2026 г.; токены советника учитывались по каждому запросу. В этих прогонах использовался клиентский цикл советника вместо инструмента-советника, с идентичным учётом. Прогоны одной модели на разных уровнях усилий — одиночные; их стоимость рассчитана по количеству токенов с приближённым учётом кэша. Стоимость задачи — это итоговая стоимость прогона, делённая на 113.
- Внутренний бенчмарк агентного программирования: внутренний бенчмарк Anthropic из 370 задач в репозиториях, которые оцениваются собственными тестами репозиториев. Показатели API измерены с ограничением вывода в 128 000 токенов, один прогон на конфигурацию. Opus 5 без советника прогонялся на уровне усилий по умолчанию 9–10 августа 2026 г., а на
lowиmedium— 10 августа 2026 г. Claude Fable 5.1 без советника прогонялся на пяти явно заданных уровнях усилий 20 августа 2026 г. (на графике показаны три из них). Пара прогонялась 24–25 августа 2026 г. Claude Opus 5.5 без советника прогонялся на всех 370 задачах 19–20 сентября 2026 г.: на уровне усилий по умолчанию (medium) и наhigh— с пятью попытками на задачу, а наlowиxhigh— с одной. На каждом уровне оценено 369 из 370 задач из-за сбоя проверки настройки. Исполнитель Claude Opus 5.5 наhighс выпущенной Claude Fable 5.1 в роли советника выполнил по пять попыток на задачу в те же даты (в августовских прогонах использовался предрелизный снимок). Одна задача не прошла проверку настройки, поэтому оценено 1 845 попыток. 279 попыток, в которых советник был недоступен из-за нагрузки, были перезапущены, а попытки, в которых консультации завершились по тайм-ауту, сохранены, как и в августе. В августовских прогонах было по пять попыток на задачу для пары и контрольного прогона Claude Opus 5 и по одной для остальных точек. Августовская пара в среднем обращалась к советнику около двух раз за попытку; пара с Claude Opus 5.5 запросила 1,39 консультации и получила 1,35. Стоимость указана за попытку. Стоимость рассчитана так, как тарифицируется организация клиента, по прейскурантным ценам. Для каждого запроса цикла агента предыдущая подсказка учитывается как чтение из кэша, а новые токены — как 5-минутная запись в кэш, по собственным записям об использовании из прогонов. Каждый вызов советника не использует кэш и учитывается по записанным токенам. Показатели Claude Code — это прогоны тех же задач с 8 по 23 июля 2026 г., один прогон на конфигурацию; стоимость приблизительная. - Внутренний бенчмарк задач в репозиториях (измерение ограничения вывода): отдельный внутренний набор Anthropic примерно из 130 задач в репозиториях. Прогоны выполнены 20 августа 2026 г. (Claude Fable 5.1) и 19 сентября 2026 г. (Claude Opus 5.5 на уровне усилий по умолчанию,
medium) с простым циклом агента через API, одна попытка на задачу. Прогоны Claude Fable 5.1 охватывают 135 задач на каждое ограничение при явно заданном уровне усилий по умолчанию. Показатель для 16 384 токенов — среднее двух прогонов (36,3% в обоих); показатели для 64 000 и 128 000 — одиночные прогоны (58,5% и 60,0%). Шесть задач вызывали отказ по соображениям безопасности в каждом прогоне и засчитываются как неудачи. Показатель Claude Opus 5.5 для 16 384 токенов — среднее двух прогонов (оценено 134 и 135 задач), а показатели для 64 000 и 128 000 — одиночные прогоны (по 135 задач). В каждом прогоне с ограничением 16 384 токена две попытки завершились отказом по соображениям безопасности и засчитываются как неудачи. Показатели ограничения на SWE-bench Pro — это один прогон Claude Fable 5.1 на каждое ограничение на уровне усилий по умолчанию, 26 августа 2026 г. Прогоны выполнены на подмножестве из 100 задач, стратифицированном из набора в 482 задачи из ссылки 3, и несопоставимы с его баллами. На уровне по умолчанию оба ограничения дали одинаковый результат. Распределения по ходам на графике взяты из прогонов Claude Opus 5.5 и Claude Fable 5.1 с ограничением 128 000. Ни один ход Opus 5.5 не достиг ограничения: самый длинный составил около 61 000 токенов, а 16 384 токена превысили 0,56% его ходов. Один ход Fable 5.1 достиг 128 000 токенов, а 16 384 токена превысили 0,46% его ходов. - Chartography: Surge AI, «Chartography», 2026. Полный опубликованный набор из 100 вопросов. Измерения выполнены 6 и 9 августа 2026 г. (Claude Opus 5 без советника) и 20 сентября 2026 г. (Claude Opus 5.5) с реализацией Anthropic на Claude Managed Agents (стандартная облачная песочница; конфигурации с советником используют советника Managed Agents). Оценку выставляет Claude Sonnet 4.6 вместо эталонного судьи, а бенчмарк выполняется с инструментами. Поэтому баллы сопоставимы между конфигурациями на этой странице, но не с опубликованной таблицей лидеров. Они также несопоставимы с результатами Chartography в системной карточке Claude Opus 5.5, где используются другой оценщик и уровень усилий
max. Для каждой конфигурации объединены два прогона (для Claude Opus 5.5 — три); разброс между прогонами достигал 10 пунктов. Стоимость — это сумма, которую платит клиент, регулярно запускающий агента. Первый запрос для каждой диаграммы читает из кэша общие для агента системную подсказку и инструменты — так происходит, если другая сессия того же агента выполнялась в предыдущие 5 минут. Если диаграмма обрабатывается без такой сессии, она стоит примерно на $0,03 больше с Claude Opus 5 или Claude Opus 5.5 и примерно на $0,12 больше с Claude Fable 5.1. Августовские показатели пересчитаны этим способом по записям об использовании из прогонов. Собственная тарификация оценочной организации до 10 сентября 2026 г. учитывала чтения из кэша Claude Opus 5 блоками по 8 192 токена и поэтому завышала стоимость Claude Opus 5. Стоимость не включает время работы песочницы, которое добавило к августовским прогонам менее 1%. Одиночные прогоны Claude Fable 5.1 выполнены 24 августа 2026 г. со стартовыми настройками обслуживания платформы, по два прогона на настройку. Шесть попыток упёрлись в 15-минутное ограничение сессии и получили 0 баллов, а на две диаграммы в каждом прогоне после отказа по соображениям безопасности ответил Claude Opus 5. Исполнитель Claude Opus 5 с низким уровнем усилий и советником Claude Fable 5.1 прогонялся дважды 30 августа 2026 г. с теми же настройками: 63,0 и 67,0, в среднем 65,0, при $0,47 за диаграмму. В каждом прогоне к советнику обращались в 88% задач. 4 из 219 его ответов вместо него дал Claude Opus 5 — каждый раз после того, как производственный фильтр безопасности остановил собственный ответ советника. Claude Opus 5.5 работал на уровнеlowс отключённым серверным резервным переключением; классификатор безопасности проверял каждый вызов инструмента. Opus 5.5 выполнил три прогона без советника (70, 68 и 68) и три с настроенным советником Claude Fable 5.1 (59, 63 и 63); в последних он обратился к советнику в 1 из 300 задач. Частота консультаций для более ранних пар получена повторным запуском тех же конфигураций через Messages API с набором инструментов контейнера, 10–11 августа 2026 г. - Оценка аудита подсказок для службы поддержки: составленный Anthropic набор из 44 обращений в службу поддержки с детерминированной оценкой. Прогоны выполнены в начале августа 2026 г., результаты опубликованы 8 августа 2026 г. Использовались шесть системных подсказок: каждая добавляет к одной и той же чистой подсказке один шаблон, распространённый в подсказках, написанных для Claude Opus 4.8 и Claude Sonnet 4.6. Каждая точка графика соответствует одному из трёх случаев (старая модель, новая модель с той же подсказкой, новая модель после аудита) и усреднена по шести подсказкам и 44 обращениям. 95% доверительный интервал прироста точности Opus 5 — от 3 до 8 пунктов; различия в точности Sonnet находятся в пределах шума.
- Набор вопросов по файлу данных: составленный Anthropic набор из 25 агрегирующих вопросов по срезу из 1 862 строк публичного CSV-файла о продажах алкоголя. Эталонные ответы вычислены с помощью pandas, оценка — по точному совпадению. Прогоны выполнены 19 августа 2026 г. на Claude Sonnet 5 и Claude Opus 5, по три прогона на конфигурацию. Размышления были отключены, потому что вариант с данными в контексте не может завершиться с настройками по умолчанию. Ограничение вывода — 4 000 токенов, кэширование подсказок не использовалось. Вариант с файлом загружает CSV через Files API и использует инструмент
code_execution_20260120. - Измерение времени жизни кэша: задание по сортировке 20 issue из раздела Сократите входные и контекстные токены. Прогоны выполнены через Messages API на Claude Sonnet 5 23 августа 2026 г. и на Claude Opus 5.5 19 и 20 сентября 2026 г. на уровне усилий по умолчанию (
medium) и наhigh. Использовалась та же оценочная среда; для Claude Opus 5.5 — её порт, который отправляет те же тела запросов. В ячейках Claude Opus 5.5 значениеmax_tokensувеличено до 4 096. Перед случайно выбранной долей ходов вставлялись паузы. На обеих моделях на всех 20 issue проверялись варианты без пауз, с паузами по 6 минут перед 5% и 10% ходов и перед каждым ходом; на Claude Sonnet 5 дополнительно — паузы по 2 минуты перед каждым ходом. На подмножестве из 5 issue на обеих моделях проверялись паузы по 20 и 45 минут. Приведённые ниже показатели запросов поддержания активности для Claude Opus 5 получены на том же задании 23 августа 2026 г. сmax_tokens, увеличенным до 4 096, по тем же расписаниям, кроме пауз в 2 и 45 минут. На каждую ячейку выполнено три прогона. Стоимость рассчитана по полямusageкаждого ответа по прейскурантным ценам. Для Claude Opus 5.5 это $4 за ввод, $5 за 5-минутную запись, $8 за 1-часовую запись, $0,20 за чтение из кэша и $20 за вывод за миллион токенов. Claude Sonnet 5 прогонялся во внутренней организации Anthropic, использование которой тарифицируется так же, как у организации клиента. Точность измерялась по тем же эталонным меткам. Показатели Claude Opus 5.5 на этой странице охватывают оба уровня усилий. Точка пересечения — около 3,3% ходов на Claude Sonnet 5 и от 3,1% до 3,2% на Claude Opus 5.5. Это медиана доли безубыточности по сессиям; для каждой сессии модель стоимости вычисляет её по размерам контекста на каждом ходу. Медиана взята по всем 45 сессиям Claude Sonnet 5 с двадцатью issue и по 36 сессиям Claude Opus 5.5 с двадцатью issue на каждом уровне усилий. В расчёт вошли все расписания пауз на полном задании при всех трёх настройках кэша, по три прогона; ячейки с 5 issue не включены. В ячейке 5% на Claude Sonnet 5 настройки 5 минут и 1 час дали одинаковый результат, потому что паузы в этой выборке пришлись на небольшие префиксы; на Claude Opus 5.5 результаты почти совпали. Правило «1 из 20» на этой странице задаёт порог выше измеренной точки пересечения. Время до первого токена после паузы для Claude Opus 5.5 не измерялось. Anthropic измерила запросы поддержания активности, которые обновляют 5-минутный кэш: на Claude Sonnet 5 и Claude Opus 5 — 23 августа 2026 г., на Claude Opus 5.5 — в описанных выше прогонах. Эти запросы всегда отправлялись сmax_tokens: 1. На Claude Sonnet 5 они обошлись на 7,7% дешевле настройки 1 час при паузах перед 5% ходов и примерно так же при 10%. На Claude Opus 5 разница не была измеримой ни при одной из этих долей. На обеих моделях они обходились дороже при паузе в 6 минут или более перед каждым ходом. На Claude Opus 5.5 они обошлись на 8–18% дешевле настройки 1 час при паузах перед 5% и 10% ходов. Если устранить шум между сессиями, пересчитав собственные токены каждой сессии с запросами поддержания активности по ценам 1-часового кэша, экономия составляет примерно 10–15%. При паузе перед каждым ходом они обходились дороже: на 4–6% при 6 минутах, на 9–10% при 20 минутах и на 56–58% при 45 минутах. На Claude Opus 5.5 запросы поддержания активности сэкономили больше, потому что каждый такой запрос повторно читает префикс по цене чтения из кэша. На Claude Opus 5.5 эта цена составляет 0,05x от цены ввода, а на Claude Sonnet 5 и Claude Opus 5 — 0,1x. Сессии Claude Opus 5, пересчитанные по ценам Claude Opus 5.5, показывают почти такую же экономию, как Claude Opus 5.5. Предрелизные тесты API Anthropic на Claude Opus 5.5 показывают, что запрос сmax_tokens: 0записывает кэш, а следующий запрос его читает. Обновляет ли такой запрос существующую запись, на Opus 5.5 не измерялось. На Claude Fable 5.1 цена чтения из кэша составляет 0,025x, и поддержание активности было дешевле даже при паузе перед каждым ходом, кроме пауз в 45 минут (ссылка 19). - Доля чтения из кэша в продакшене: агрегированные данные об использовании собственного (first-party) Claude API за 14 дней, закончившихся 23 августа 2026 г. Учитывался только прямой API; внутренние организации Anthropic исключены, организации не идентифицировались. Организация-день считается циклом агента при выполнении всех условий: запросы содержат определения инструментов и результаты инструментов, подсказки содержат в среднем 9 или более предыдущих вызовов инструментов, использовалось кэширование и сделано не менее 10 таких запросов. В API нет идентификатора диалога, поэтому эти условия заменяют длину диалога. Под них подпадают 303 003 организации-дня в 106 487 организациях; медианная доля чтения из кэша — 84,2% всех входных токенов, верхний квартиль — 91,7%. Метки сценариев использования (заявленный организацией сценарий, а при его отсутствии — определённый классификатором) охватывают 74% этих организаций-дней и 99% их токенов. На организации, занимающиеся программированием, приходится 87% входных токенов агентов. Их медианная доля чтения из кэша — 88,5% (90,9% при 25 или более предыдущих вызовах инструментов), верхний квартиль — 93,4%; около 72% их организаций-дней достигают 80% или более. У агентов поддержки, исследований и работы с данными доля чтения составляет 84–85%. В верхнем дециле организаций-дней доля чтения составляет 95,9% или более для программирования и 94,2–94,8% для агентов поддержки, исследований, данных и прочих. Разбивка на уровне запросов при 25 или более предыдущих вызовах инструментов получена из шестичасовой выборки: для программирования 92% токенов приходится на чтение из кэша, 7% — на запись, менее 1% — на токены без кэша. У организаций без меток, в основном небольших, медианная доля чтения — 11%. У организаций-дней без определений инструментов медианная доля чтения — 34,6%. Независимый запрос за тот же период восстанавливает диалоги из 10 или более запросов вместо оценки организаций-дней и даёт медиану 90,2%; разница объясняется охватом, а не данными.
- Измерение момента compaction (сжатия контекста): длинный вариант агента сортировки из раздела Сократите входные и контекстные токены. Прогоны выполнены 24 августа 2026 г. на Claude Sonnet 5 с 5-минутным кэшем; стоимость рассчитана по полям использования по прейскурантным ценам, по пять сессий на вариант. Вариант без изменений всю сессию работал на уровне усилий по умолчанию ($0,81 за сессию). Два других варианта начинали с низкого уровня усилий и вносили одни и те же два изменения, сбрасывающих кэш: переключение на уровень усилий по умолчанию и добавление одного инструмента. Один вариант вносил их в середине сессии, на запросах 12 и 17 ($0,95), другой — вместе, на первом запросе после первого сжатия ($0,75). Четвёртый вариант из шести сессий, прогон 25 августа 2026 г., вносил те же два изменения в запросе, который запустил первое сжатие ($0,92 за сессию). Проход суммаризации в этом запросе записал контекст в 81 000 токенов в кэш вместо того, чтобы прочитать его. Поэтому этот проход стоил $0,21 против $0,04 за тот же проход в варианте с изменениями на границе. Первое сжатие в сессиях происходило на запросах 21–25 (в 16 из 21 сессии — на запросе 22), как только подсказка превышала порог сжатия в 80 000 токенов. Две сессии без изменений сжимались второй раз ближе к концу. Вариант с изменениями на границе обошёлся дешевле варианта без изменений благодаря запросам с низким уровнем усилий до изменения и этим вторым сжатиям, а не кэшированию: затраты на повторную запись у двух вариантов различаются менее чем на цент. Вариант с изменениями в середине сессии тратил $0,23 за сессию на повторные записи в кэш. Разница между вариантами с изменениями в середине сессии и на границе составила $0,20 с 95% доверительным интервалом от $0,11 до $0,29. Одна сессия варианта с изменениями в середине оказалась дешёвой ($0,82): после сжатия модель неправильно вызвала инструмент поиска и получила пустые результаты. Эта сессия включена в расчёт; без неё среднее варианта составляет $0,98. Средняя точность составила 14,2 из 20 меток в каждом варианте 24 августа и 14,7 в варианте 25 августа. Доля чтения из кэша среди токенов подсказки составила 91% без изменений, 85% при изменениях в середине сессии, 91% при изменениях на границе и 86% при изменениях в запросе, запустившем сжатие.
- Измерение времени жизни кэша на Claude Fable 5.1: то же задание по сортировке 20 issue и та же оценочная среда, что и в ссылке 16. Прогоны выполнены 23 и 26 августа 2026 г. на стартовом снимке Claude Fable 5.1 по стартовым ценам: $10 за ввод, $12,50 за 5-минутную запись, $20 за 1-часовую запись, $0,25 за чтение из кэша и $50 за вывод за миллион токенов. Для каждого расписания проверялись три настройки: 5-минутный кэш, 1-часовой кэш и 5-минутный кэш, который поддерживается запросом с
max_tokens: 0на неизменённом префиксе каждые 4 минуты, считая от начала предыдущего запроса. Прогоны 23 августа отправляли запросы поддержания активности сmax_tokens: 1; в приведённых здесь ячейках 26 августа каждый такой запрос обновлял кэш, а вывод не тарифицировался. Расписания: без пауз, паузы по 6 минут перед 10% ходов и перед каждым ходом на всех 20 issue, а также паузы по 45 минут на подмножестве из 5 issue. На каждую ячейку выполнено три прогона (шесть для ячейки с поддержанием активности 26 августа с паузами по 45 минут). Стоимость рассчитана по полямusageкаждого ответа по прейскурантным ценам, точность — по тем же эталонным меткам (от 12 до 17 точных меток из 20). Средняя стоимость сессии 26 августа для настроек 5 минут, 1 час и поддержание активности: без пауз — $2,42, $3,09 и $2,29; с паузами перед 10% ходов — $4,50, $2,96 и $2,36; с паузами перед каждым ходом — $22,89, $3,01 и $2,62. Ячейки 23 августа совпадают с этими значениями в пределах 6%. Показатели для пауз по 45 минут ($1,68, $0,59 и $0,71 за сессию с 5 issue) получены в чистом повторном прогоне 26 августа: первые ячейки того дня испортил инцидент с тарификацией кэша. Прогоны 23 августа дали $1,67, $0,58 и $0,70. Точка пересечения между настройками 5 минут и 1 час — 3,1% ходов; она рассчитана тем же способом, что и в ссылке 16. - Terminal-Bench 3: 74 задачи публичного бенчмарка терминальных агентов. Прогоны выполнены на Claude Managed Agents 27–28 августа 2026 г., по два прогона на модель на уровне усилий
high. Вместо встроенных инструментов платформы использовались два пользовательских инструмента — оболочка и редактор файлов, которые оценочная среда запускает в собственном контейнере каждой задачи. Остальные настройки платформы соответствовали настройкам по умолчанию для внешних аккаунтов. В этих прогонах использовалась версия Terminal-Bench 3.0. Их баллы несопоставимы с публичной таблицей лидеров Terminal-Bench и с результатами Terminal-Bench 4.0 в системной карточке Claude Opus 5.5, полученными в прогонах в Claude Code на уровне усилийmax. Ограничения по времени для каждой задачи в 2,5 раза больше собственных ограничений бенчмарка: агент получает от 75 минут до 20 часов на задачу (5 часов для медианной задачи). Каждая задача получает в три раза больше памяти, чем в ней указано, — от 6 ГиБ до 96 ГиБ; 12 задачам, которые запускают вспомогательные сервисы, выделена дополнительная память. У агента не было общего доступа в интернет. Его контейнеры могли обращаться к внутреннему зеркалу пакетов, к короткому списку сайтов для загрузки, включая GitHub и Python Package Index, и к нескольким сайтам, нужным для отдельных задач. У восьми задач доступа к сети не было вовсе. Баллы — это доля успешных попыток без поправок из 148 попыток на модель; результаты отдельных прогонов колеблются на 5–11 пунктов. Стоимость — это сумма, которую заплатил бы клиент по прейскурантным ценам; она пересчитана по каждому запросу из записей об использовании с 5-минутным временем жизни кэша. Claude Opus 4.7 упёрся в ограничение вывода в 11 из своих 148 попыток. - DRACO: Perplexity, «DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity», arXiv:2602.11685, 2026. Его 100 исследовательских задач в 10 областях оцениваются по рубрикам, написанным экспертами; балл — это нормализованный балл бенчмарка. Все конфигурации выполнялись через Claude API с Claude Fable 5.1, адаптивными размышлениями по умолчанию, включёнными производственными классификаторами безопасности и
max_tokens, равным 128 000. Проверялись одиночный агент на уровнях усилийhighиmedium, одиночный агент наhighс инструкцией и часами, а также команда наhighс ними и без них. Команда — это ведущий агент, который через инструмент запускает вспомогательных агентов той же модели без ограничения их количества. На DRACO ведущий агент запускал в медиане 4 помощника за попытку. Каждая конфигурация сделала по три попытки на каждую задачу, прогоны 8–10 сентября 2026 г. Попытка, достигшая четырёхчасового лимита, запускалась повторно, и засчитывалась новая попытка. Исключены только все 3 попытки одиночного агента на уровнеmediumна одной задаче, поэтому эта конфигурация охватывает 99 задач. Эта задача завершалась по тайм-ауту при каждой попытке — и в исходном прогоне, и в повторном. Если засчитать эти 3 попытки как 0, как это сделала бы собственная система оценки бенчмарка, изменятся только два сравнения с уровнемmedium. Снижение балла наmediumотносительноhighвырастет с 0,7 до 1,7 пункта, а снижение балла при обоих изменениях относительноmediumуменьшится с 1,2 до 0,2 пункта. Агенты использовали инструменты поиска и загрузки страниц, которые оценочная среда предоставляет поверх зафиксированного веб-индекса. Эти инструменты частично определяют время выполнения, а ваши инструменты будут работать с другой скоростью. Поэтому на странице время указано как соотношение между конфигурациями, а не в минутах. Время — это фактическое время на задачу от первого до последнего запроса любого агента за вычетом оценочного времени ожидания перед повторными запросами после ошибок rate limit (ограничения скорости) или перегрузки. Эти ошибки возникали из-за общих лимитов тестового аккаунта. Все конфигурации одного набора запускались одновременно. Более медленные завершались на несколько часов позже, поэтому часть их времени пришлась на другую нагрузку. Стоимость каждой задачи — это стоимость её запросов по публичным прейскурантным ценам, только за токены модели. Кэширование подсказок тарифицируется так же, как для клиента, который ставит точку останова кэша в конце каждого запроса и использует 5-минутное время жизни кэша. Инструменты оценочной среды не добавляют расходов. Изменения баллов — это парные разности по задачам с 95% бутстреп-интервалами. Изменение считается находящимся в пределах допуска, если его интервал не выходит за 1,5 пункта на DRACO и 2,5 пункта на HLE. Anthropic установила эти допуски до прогонов. Ответы оценивает Claude Opus 5. По сравнению с собственным оценщиком каждого набора Opus 5 во всех конфигурациях ставил на 1,9–2,4 пункта выше на DRACO и на 2,2–2,9 пункта ниже на HLE (Opus 5 оценил 495 из 500 вопросов, а оценщик бенчмарка — все 500). На физическом наборе, собственный оценщик которого также использует экспертные эталонные решения, Opus 5 ставил на 1,3–2,0 пункта ниже. Оба оценщика согласны в направлении каждого изменения. - HLE: Phan et al., «Humanity's Last Exam», arXiv:2501.14249, 2025. Написанные экспертами вопросы с точными ответами, которые оцениваются по эталонным ответам. Измерено на первых 500 вопросах; собственные источники бенчмарка заблокированы для поиска, остальная настройка такая же, как в ссылке 21. Каждая конфигурация сделала по три попытки на каждый вопрос, прогоны 8–10 сентября 2026 г. Claude Opus 5 сравнивает каждый ответ с эталонным при включённых адаптивных размышлениях, как задано по умолчанию. В каждой конфигурации судья оценил 495 из 500 вопросов, и баллы рассчитаны по этим 495. Для остальных 5 вопросов запрос на оценку превысил лимит судьи в 1M токенов. Попытка, достигшая четырёхчасового лимита, запускалась повторно, и засчитывалась новая попытка, поэтому у каждой конфигурации есть все 1 500 попыток. Если засчитать 5 неоценённых вопросов как 0, как это сделала бы собственная система оценки бенчмарка, ни один вывод не изменится.
- Физический набор: внутренний набор из 70 задач по физике исследовательского уровня, адаптированный из публичного бенчмарка CritPt: Zhu et al., «Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark», arXiv:2509.26574, 2025. Эксперты-рецензенты исправили формулировки задач. Claude Opus 5 оценивает каждый ответ по непубличным экспертным эталонным решениям, поэтому баллы нельзя сравнивать с опубликованными результатами. Балл — это средняя оценка по попыткам для каждой задачи, усреднённая по всем задачам. Измерено на всех 70 задачах, по четыре попытки на задачу, прогоны 8–9 сентября 2026 г. У каждого агента были инструмент Python, оболочка и редактор файлов в контейнере-песочнице без доступа к сети; инструментов поиска и загрузки страниц не было. В остальном настройка такая же, как в ссылке 21. Допуск для физического набора до прогонов не устанавливался. Поэтому на странице изменения его баллов приводятся с 95% интервалами и не описываются как находящиеся в пределах допуска.
Следующие шаги
Самый крупный бесплатный выигрыш на этой странице: настройка, время жизни и диагностика.
Обменивайте интеллект на задержку и стоимость в рамках одной модели.
Оцените возможности, скорость и стоимость по всему семейству моделей Claude.
Дайте агентным циклам обратный отсчёт токенов, по которому они саморегулируются.
Установите жёсткий долларовый лимит на сессию Managed Agents.
Посмотрите текущие цены за токен для каждой модели Claude.
Применяйте эти рычаги по одному к работающему агенту в исполняемом ноутбуке, со стоимостью за задачу после каждого шага.
Посмотрите пошаговый разбор паттернов советника и оркестратора.
Was this page helpful?