Optimización de costo e inteligencia
Equilibra costo e inteligencia en la Claude Platform, con resultados medidos para el almacenamiento en caché de prompts, el esfuerzo, la elección de modelo, los presupuestos y las estrategias multimodelo.
Cuando una carga de trabajo pasa del prototipo a producción, el costo se convierte en una restricción de diseño de primer orden. El modelo más capaz puede resultar demasiado caro a escala, y el modelo menos costoso puede quedarse corto en calidad. Gestionar bien el costo significa entender cómo cada palanca de costo afecta la calidad de la salida, porque algunas palancas se intercambian por calidad y otras no. La Claude Platform te da control directo sobre ese equilibrio. Eliges el modelo, el nivel de esfuerzo y la arquitectura de cada solicitud, lo que te permite ubicar una carga de trabajo casi en cualquier punto de la frontera entre costo e inteligencia.
El costo y la inteligencia suelen representarse como una frontera en la que uno se obtiene a cambio del otro. El primer grupo de palancas de esta página acerca una carga de trabajo a esa frontera al reducir el costo sin afectar la calidad; solo el segundo grupo la desplaza a lo largo de ella:
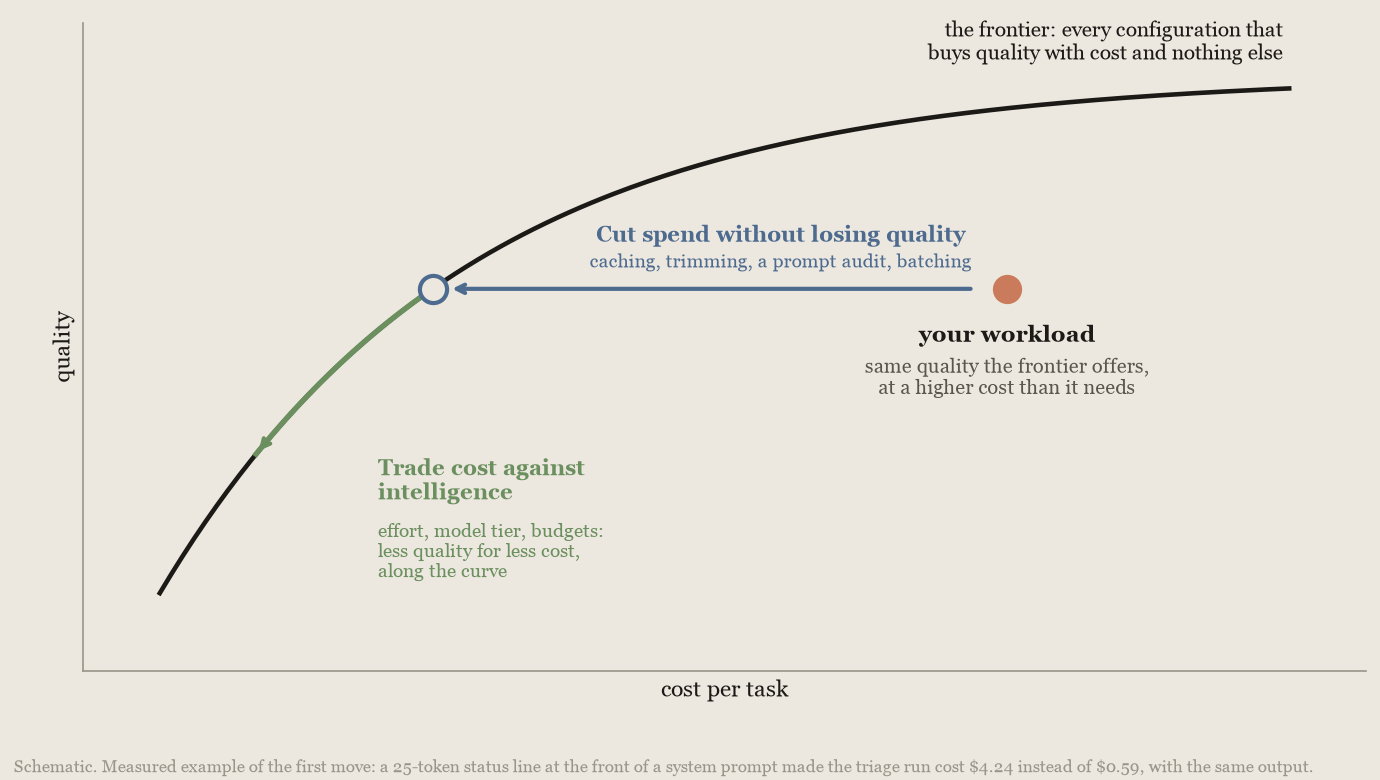
Las palancas son de dos tipos:
- Ganancias gratuitas que reducen el gasto sin afectar la calidad: el "prompt caching" (almacenamiento en caché de prompts), la "token hygiene" (higiene de tokens), una auditoría de prompts frente al modelo que ejecutas, el "batch processing" (procesamiento por lotes) con un 50% de descuento para el trabajo que puede esperar hasta 24 horas, y los límites de gasto del espacio de trabajo como respaldo.
- Compensaciones que intercambian costo por inteligencia: la elección de modelo, el "effort" (esfuerzo), los límites de salida y los presupuestos de tarea, un reloj de tiempo transcurrido y las arquitecturas multimodelo.
Cada palanca viene con resultados medidos y la regla de cuándo compensa. En las mediciones de Anthropic, el almacenamiento en caché de prompts fue, por amplio margen, la palanca más grande: redujo el costo del bucle de agente entre 2.7 y 5.3 veces en los benchmarks de esta guía y recortó la factura de un pequeño agente de triaje en un 83%, o en un 88% al añadir el recorte de entrada. Las palancas multimodelo son más limitadas; un segundo modelo resultó rentable en dos formas: un asesor y un orquestador.
Comienza aquí
Busca la fila que corresponda a tu situación.
| Tu situación | Haz esto | Dónde |
|---|---|---|
| Cualquier carga de trabajo, cualquier modelo | Activa el almacenamiento en caché de prompts y recorta los tokens innecesarios; ambos son gratuitos | Almacena en caché el contexto repetido · Recorta tokens |
| Una persona espera entre turnos | Usa la duración de caché de 1 hora cuando aproximadamente 1 de cada 20 turnos siga a una pausa de entre 5 minutos y una hora y pocas pausas superen una hora. En Claude Fable 5.1, mantén caliente la caché de 5 minutos mientras las pausas duren minutos, y paga la duración de 1 hora cuando las pausas se acerquen a una hora. En Claude Opus 5.5, mantén caliente la caché de 5 minutos en su lugar cuando solo uno o dos de cada 20 turnos sigan a una pausa de hasta aproximadamente media hora | Elige la duración de la caché |
| Los costos son demasiado altos; la calidad está bien | Prueba niveles de esfuerzo progresivamente más bajos en tu modelo actual | Ajusta el esfuerzo |
| No usas el modelo más reciente | Actualiza; en las mediciones de Anthropic, cada modelo más nuevo resolvió al menos tantas tareas como el anterior, normalmente con un costo menor por tarea resuelta | Actualiza el modelo |
| Estás eligiendo o cambiando de modelo | Compara por costo por tarea completada, no por token | Compara modelos |
| La calidad no es suficiente | Si bajaste el esfuerzo, restáuralo; de lo contrario, prueba el siguiente nivel superior con esfuerzo low | Ajusta el esfuerzo · Compara modelos |
Los intentos terminan con stop_reason: max_tokens | Aumenta max_tokens; 64,000 cubrió todos menos 2 de 14,000 turnos medidos con el esfuerzo predeterminado, y 128,000 no costó nada adicional por tarea resuelta | Establece presupuestos |
| Puedes verificar las salidas (pruebas, un verificador) | Ejecuta todo con esfuerzo bajo y vuelve a ejecutar los fallos con high; en el benchmark de programación medido, la tasa de aprobación se mantuvo a aproximadamente la mitad del costo | Vuelve a ejecutar los fallos |
| Bucles de agente con algunas ejecuciones muy costosas | Establece un presupuesto de tarea (beta; consulta la tabla de compatibilidad para ver qué modelos), un presupuesto de sesión de Claude Managed Agents y un límite de gasto del espacio de trabajo | Establece presupuestos |
| Quieres que las ejecuciones del agente terminen antes | Dile al modelo que el tiempo importa y muéstrale el tiempo transcurrido; en DRACO, HLE y un conjunto interno de física, las ejecuciones tardaron entre un 33% y un 69% menos con un costo por tarea entre un 28% y un 54% menor, con puntuaciones hasta 1.9 puntos más bajas | Muestra al modelo el tiempo transcurrido |
| Un modelo de menor costo se atasca solo en decisiones difíciles | Añade un asesor de frontera. Compensa cuando su precio está muy por encima del ejecutor y realmente se le consulta, así que primero calcula el precio del modelo del asesor por sí solo con esfuerzo bajo y mide la tasa de consultas | Estrategia de asesor |
| El trabajo excede una "context window" (ventana de contexto) | Delega particiones a trabajadores más económicos | Estrategia de orquestador |
Estos resultados son internos de Anthropic (Benchmarks referenciados) y orientativos, no garantías, así que mide en tu propia carga de trabajo con el método de cuatro pasos.
Reduce el gasto sin perder calidad
El almacenamiento en caché de prompts, la higiene de tokens, el procesamiento por lotes y una auditoría de prompts contra tu modelo actual reducen lo que pagas sin reducir la calidad del resultado. Aplican dos advertencias: el procesamiento por lotes intercambia latencia por su descuento, y la edición de contexto, una palanca de higiene de tokens, costó más de lo que ahorró en la ejecución medida en esta sección.
Almacena en caché el contexto repetido
Por qué el almacenamiento en caché va primero
Activa el almacenamiento en caché de prompts antes que cualquier otra palanca, porque cada turno de una tarea agéntica reenvía toda la conversación creciente: la "system prompt" (indicación del sistema), las definiciones de herramientas y cada turno anterior. Una tarea de 40 turnos envía su primer turno 40 veces, así que el costo de la tarea crece aproximadamente con el cuadrado del número de turnos. El almacenamiento en caché no detiene el reenvío, pero cada reenvío cuesta aproximadamente una décima parte y se procesa más rápido: el prefijo se factura a la tarifa de lectura de caché, una décima parte del precio de entrada, y cada turno paga la tarifa de escritura de caché de 1.25x solo por lo que es nuevo.
Cómo se ve un buen resultado. Durante un día completo de tráfico real, los bucles de agente leyeron una mediana del 84% de su entrada desde la caché, y el 10% superior de los arneses, de programación o no, leyó el 94% o más17. En lo profundo de una tarea, un bucle bien construido paga el precio completo por menos del 1% de su entrada. Por debajo de aproximadamente el 80%, busca algo que esté rompiendo la caché (consulta Qué rompe la caché).
En las ejecuciones medidas por Anthropic, las lecturas de caché son rutinariamente el componente individual más grande del costo de la tarea, lo que hace que el almacenamiento en caché valga más que la mayoría de las decisiones de elección de modelo. Anthropic calculó el precio de las ejecuciones de DeepResearch Bench II7 con y sin almacenamiento en caché:
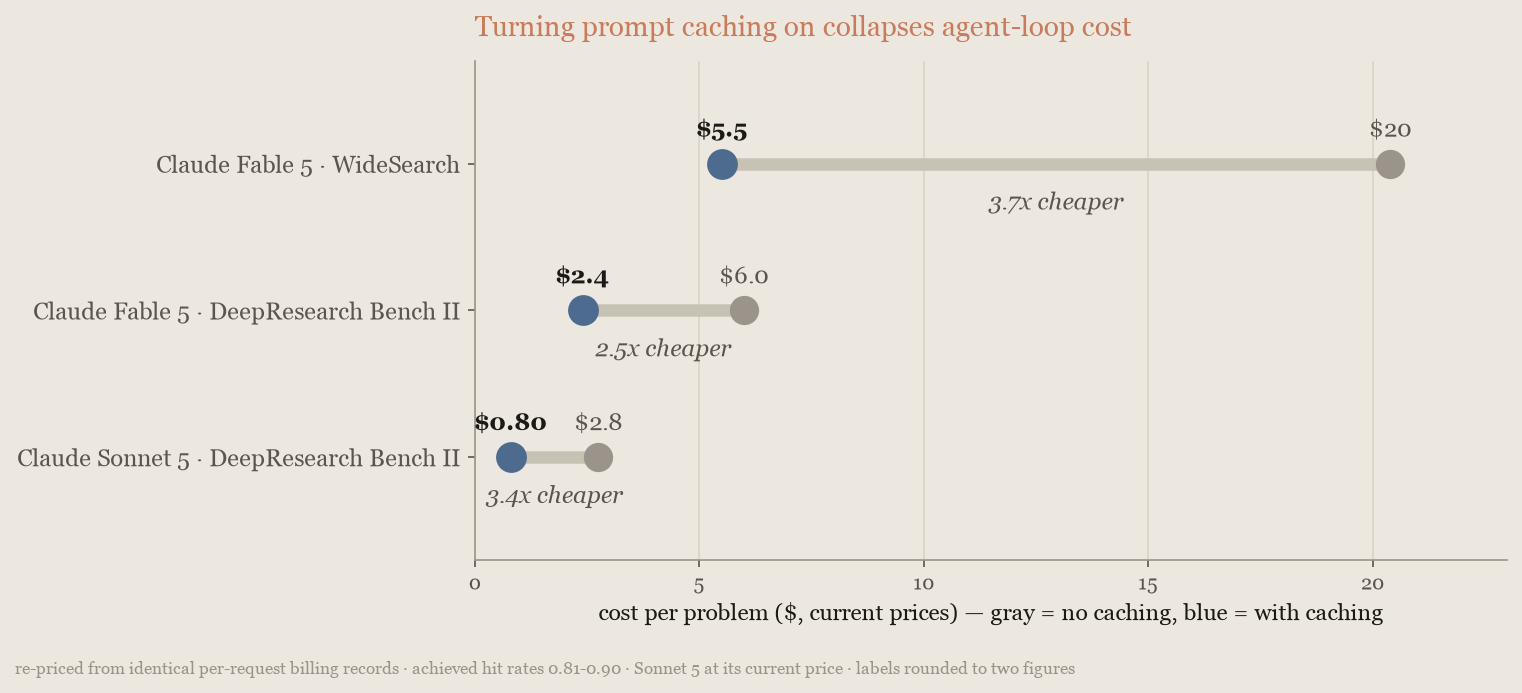
La vida útil predeterminada de la caché es de 5 minutos y los turnos de un bucle de agente están separados por segundos, así que el descuento aplica a la mayoría de los tokens en cada turno. Las ejecuciones del gráfico de almacenamiento en caché leyeron del 79% al 90% de sus tokens de entrada desde la caché. El ahorro varía con la profundidad del episodio, porque los bucles más cortos releen menos, pero el almacenamiento en caché se mantuvo como la palanca individual más grande en cada modelo y benchmark medido.
Elige la duración de la caché
Si tu bucle espera a una persona entre turnos, usa la duración de caché de 1 hora. Cuesta más escribirla (2x el precio de entrada en lugar de 1.25x). Un fallo de caché en cualquiera de las dos duraciones factura todo el prefijo al precio de escritura en lugar del precio de lectura, por lo que la duración más larga compensa cuando algunos turnos por sesión siguen a una pausa de entre 5 minutos y una hora.
Para decidir, cuenta los intervalos entre solicitudes consecutivas de una conversación:
- Más de aproximadamente 1 de cada 20 intervalos está entre 5 minutos y una hora, y los intervalos de más de una hora son raros: usa la duración de 1 hora. En Claude Opus 5.5, cuando solo 1 o 2 de cada 20 intervalos caen en ese rango y ninguno dura más de aproximadamente media hora, mantén caliente la caché de 5 minutos en su lugar, con las solicitudes "keep-alive" (de mantenimiento) que se describen a continuación.
- Los turnos llegan con segundos de diferencia: quédate con el valor predeterminado de 5 minutos. Cuando no hubo pausas, costó un 15% menos que la configuración de 1 hora en Claude Sonnet 5 y aproximadamente entre un 15% y un 18% menos en Claude Opus 5.5.
- Los intervalos de más de una hora son comunes: quédate con el valor predeterminado. Un intervalo de más de una hora hace expirar ambas duraciones, y la configuración de 1 hora vuelve a escribir entonces el prefijo a su precio de escritura más alto, así que pierde en cada uno de esos intervalos. De tus pausas de más de 5 minutos, si aproximadamente el 60% o más también superan una hora, quédate con el valor predeterminado; la duración de 1 hora solo compensa cuando al menos aproximadamente el 40% de las pausas largas terminan dentro de la hora.
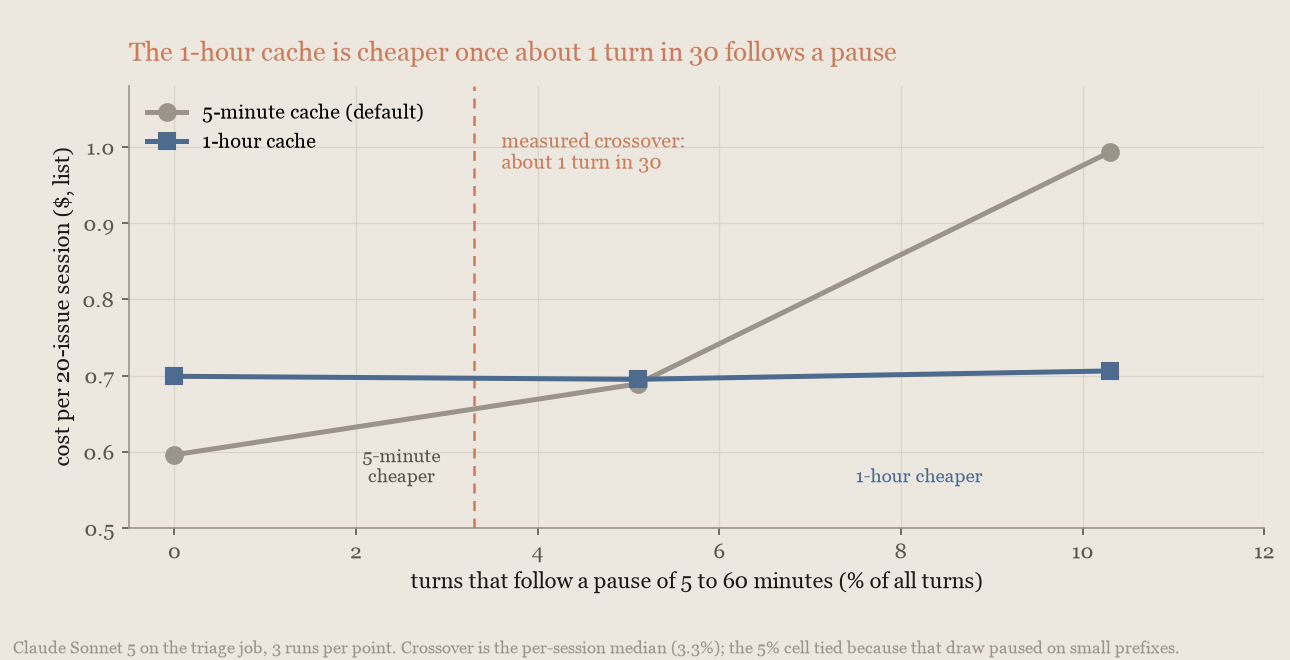
Anthropic midió el trabajo de triaje de Recorta los tokens de entrada y de contexto con pausas insertadas antes de algunos turnos para simular la demora de una persona16. En Claude Sonnet 5 y Claude Opus 5.5, la caché de 1 hora pasó a ser la configuración más económica una vez que aproximadamente 1 de cada 30 turnos siguió a una pausa, así que la regla de 1 de cada 20 deja un margen, y la diferencia se amplía rápidamente pasado el punto de cruce porque cada turno con pausa en la configuración de 5 minutos vuelve a escribir todo el prefijo. Todos los modelos actuales usan los mismos multiplicadores de escritura de caché, y todos los modelos excepto Claude Fable 5.1, Claude Mythos 5.1 y Claude Opus 5.5 el mismo precio de lectura, así que el punto de cruce está en el mismo rango en los demás modelos; Fable 5.1 es el caso que se trata a continuación. La precisión se mantuvo dentro del ruido entre ejecuciones en todas las celdas. El turno posterior a una pausa conservó su latencia de caché caliente con la configuración de 1 hora (medido en Claude Sonnet 5 y Claude Opus 5, no en Claude Opus 5.5). El siguiente gráfico representa el costo por sesión frente a la proporción de turnos con pausa en Claude Sonnet 5:
Anthropic también midió solicitudes adicionales que mantienen caliente la caché de 5 minutos. En Claude Sonnet 5 costaron aproximadamente un 8% menos que la duración de 1 hora cuando 1 de cada 20 turnos siguió a una pausa, pero aproximadamente lo mismo con 2 de cada 20; en Claude Opus 5, el modelo Opus anterior, no ahorraron nada medible. Con una pausa de 6 minutos o más antes de cada turno costaron más en ambos modelos. Como el ahorro de Claude Sonnet 5 había desaparecido con 2 de cada 20 turnos, usa en su lugar la duración de 1 hora en Claude Sonnet 5 y Claude Opus 5.
En Claude Fable 5.1 la configuración más económica es otra. Su lectura de caché cuesta 0.025x el precio de entrada ($0.25 por millón de tokens), mientras que sus escrituras de caché mantienen los multiplicadores estándar, así que una solicitud de mantenimiento que relee el prefijo es barata y el recargo de escritura de la duración de 1 hora es la factura más grande. Anthropic midió el trabajo de triaje en Claude Fable 5.1 con las mismas tres configuraciones19. Mantener caliente la caché de 5 minutos costó entre un 13% y un 20% menos por sesión que la caché de 1 hora siempre que las pausas duraron minutos; solo con pausas cercanas a 45 minutos ganó la caché de 1 hora, por unos 12 centavos por sesión. En Claude Fable 5.1, mantén caliente la caché de 5 minutos mientras una persona esté ausente durante minutos, y paga la duración de 1 hora cuando las pausas se acerquen a una hora:
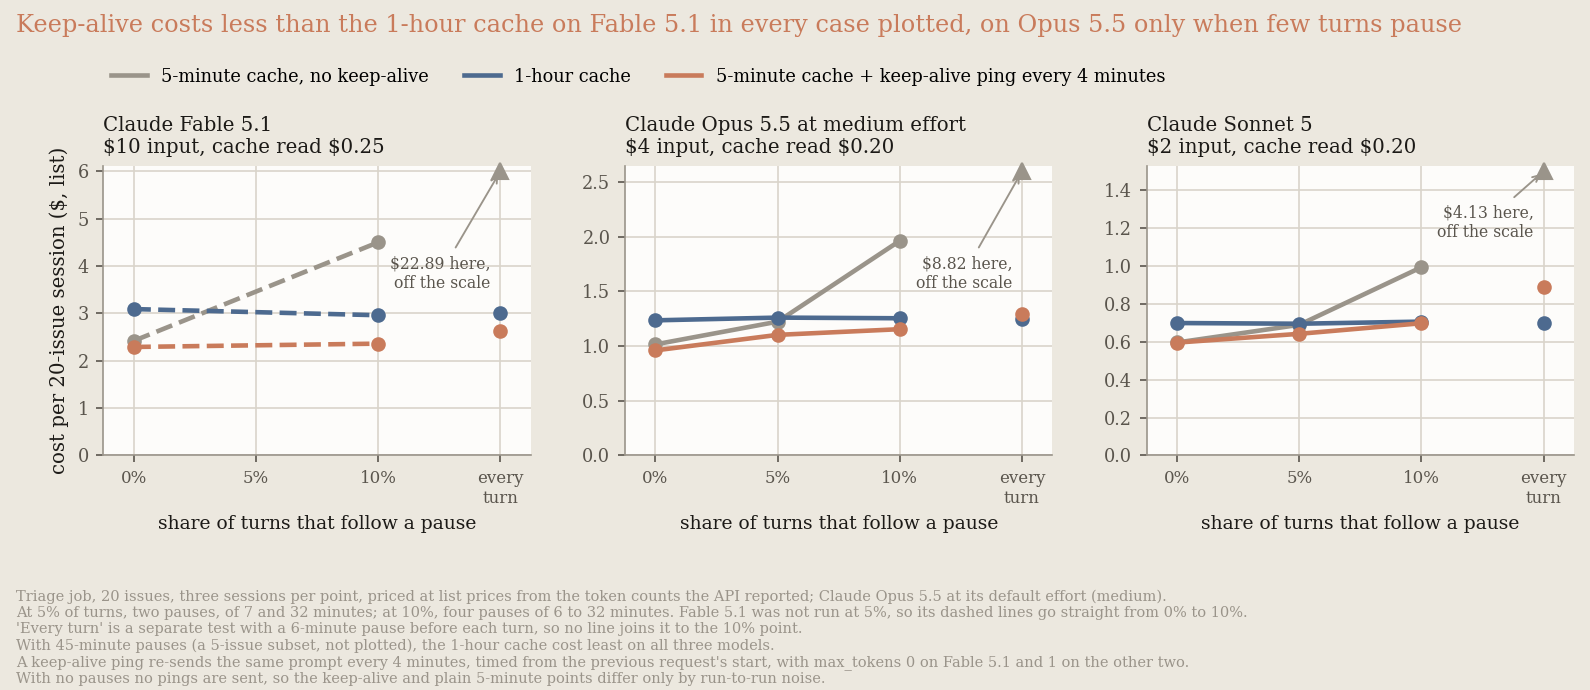
En Claude Opus 5.5, cuya lectura de caché cuesta 0.05x el precio de entrada, las solicitudes de mantenimiento costaron entre un 8% y un 13% menos que la duración de 1 hora cuando el 5% o el 10% de los turnos siguieron a una pausa de 6 a 32 minutos (con el esfuerzo predeterminado, medium; entre un 10% y un 18% menos con high), pero más con una pausa antes de cada turno: aproximadamente entre un 4% y un 6% más con pausas de 6 minutos, y más de un 50% más con pausas de 45 minutos. Así que en Claude Opus 5.5, mantén caliente la caché de 5 minutos cuando solo uno o dos de cada 20 turnos sigan a una pausa de hasta aproximadamente media hora y, en caso contrario, sigue la lista del inicio de esta sección. Estas mediciones enviaron solicitudes de mantenimiento con max_tokens: 1. Para la solicitud con max_tokens: 0 que se describe a continuación, las pruebas de API previas al lanzamiento de Anthropic en Claude Opus 5.5 muestran que escribe la caché y que la siguiente solicitud la lee; no se midió en Opus 5.5 si actualiza una entrada existente.
Para mantener caliente la caché, vuelve a enviar la solicitud anterior con max_tokens establecido en 0 dentro de los 4 minutos posteriores al inicio de la solicitud anterior, y luego cada 4 minutos, quitando stream si estaba establecido. Cuenta desde el inicio de la solicitud, no desde el final de su respuesta: la vida útil de 5 minutos de la caché corre desde el inicio de la solicitud que escribió o actualizó la entrada, así que el tiempo que la respuesta pasó generando cuenta en su contra. Esa es la solicitud de precalentamiento: actualiza la vida útil de la caché, no genera nada y solo factura la lectura de caché. No cambies ni un byte del prefijo, y no uses max_tokens: 1, que muestrea un token sin motivo. Vuelve a enviar los encabezados de la solicitud además de su cuerpo: si tus solicitudes llevan un encabezado anthropic-beta (para un presupuesto de tarea, por ejemplo), la solicitud de mantenimiento necesita el mismo encabezado, o los campos restringidos por beta en el cuerpo reenviado se rechazan. Una solicitud con max_tokens: 0 se rechaza cuando la solicitud establece thinking.type: "enabled" (el pensamiento adaptativo predeterminado en Claude Fable 5.1 no tiene problema), salidas estructuradas o una elección de herramienta forzada (sus limitaciones); en esas cargas de trabajo, paga la duración de 1 hora en su lugar. Una solicitud con max_tokens: 0 también se rechaza cuando lleva el parámetro compaction de nivel superior, así que no reenvíes una solicitud de compactación de compactación bajo demanda como solicitud de mantenimiento.
# Dentro de los 4 minutos desde el inicio de la última solicitud (el tiempo de generación cuenta
# para la vida útil de la caché), reenvía esa solicitud con max_tokens establecido en
# 0, quitando stream (una solicitud con max_tokens: 0 no admite streaming). Envía los mismos
# encabezados que la solicitud original, incluido cualquier encabezado anthropic-beta.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Activa el almacenamiento en caché
La configuración requiere poco trabajo. El almacenamiento en caché automático coloca los puntos de interrupción por ti; de lo contrario, la skill de Claude API que viene con Claude Code puede agregar almacenamiento en caché a una integración existente desde un solo prompt. El siguiente extracto muestra la skill agregándolo al arnés que produjo estas mediciones:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Esas ubicaciones de puntos de interrupción siguen el patrón estándar de Puntos de interrupción de caché explícitos.
Qué rompe la caché
Varias cosas pueden romper tu caché durante una tarea. Cualquier cosa que cambie en cada solicitud, como una marca de tiempo o una posición en la cola, colocada antes del prefijo estable convierte cada solicitud en una escritura completa de caché: en la ejecución de triaje de Recorta los tokens de entrada y de contexto, una línea de estado de 25 tokens al principio de la indicación del sistema costó $4.24 por ejecución en lugar de $0.59, más que ejecutar con el almacenamiento en caché desactivado. Mantén el texto específico de cada solicitud en el turno de usuario más reciente.
La caché es una coincidencia de prefijo exacta byte a byte sobre la solicitud en orden (herramientas, luego indicación del sistema, luego mensajes), así que un cambio en cualquier punto invalida todo lo que viene después. Cambiar effort o la configuración de pensamiento entre solicitudes invalida la caché desde ese punto en adelante y, en algunos modelos, también las herramientas y la indicación del sistema que la preceden; cualquier edición de la indicación del sistema invalida la caché desde ese punto en adelante; establecer o cambiar un formato de salida invalida la caché de toda la conversación; añadir, quitar o reordenar una definición de herramienta la invalida por completo. La página de almacenamiento en caché de prompts enumera estos casos, salvo el formato de salida, que se trata en salidas estructuradas. En los modelos más recientes, cambia las instrucciones con un mensaje de sistema a mitad de conversación, un mensaje {"role": "system"} añadido a messages, en lugar de editar el campo system de nivel superior: el prefijo en caché permanece intacto. Consulta esa página para ver qué modelos lo admiten. En los modelos que lo admiten, un cambio de esfuerzo por mensaje también deja intacto el prefijo en caché. Lo que está en juego es mayor en Claude Fable 5.1 y Claude Mythos 5.1, donde una ruptura vuelve a escribir el prefijo a 1.25x el precio de entrada en lugar de leerlo a 0.025x. En un prefijo de 100,000 tokens, un turno roto allí cuesta $1.25 en lugar de $0.03, 50 veces la lectura; en Claude Opus 5.5 cuesta $0.50 en lugar de $0.02, 25 veces, y en los demás modelos actuales 12.5 veces.
Anthropic midió esto en las sesiones largas del agente de triaje18. Un cambio de esfuerzo y una herramienta añadida a mitad de sesión reescribieron 39,000 y 60,000 tokens en caché, y esas sesiones costaron $0.95 por sesión. Los mismos dos cambios en la primera solicitud después de la compactación costaron $0.75, y en la solicitud que desencadenó la compactación $0.92, porque el paso de resumen de la compactación volvió a procesar entonces el contexto de 81,000 tokens al precio de escritura de caché: ese paso de resumen costó $0.21, frente a $0.04 cuando los mismos cambios llegaron una solicitud después, con una precisión dentro del ruido entre ejecuciones en cada brazo:
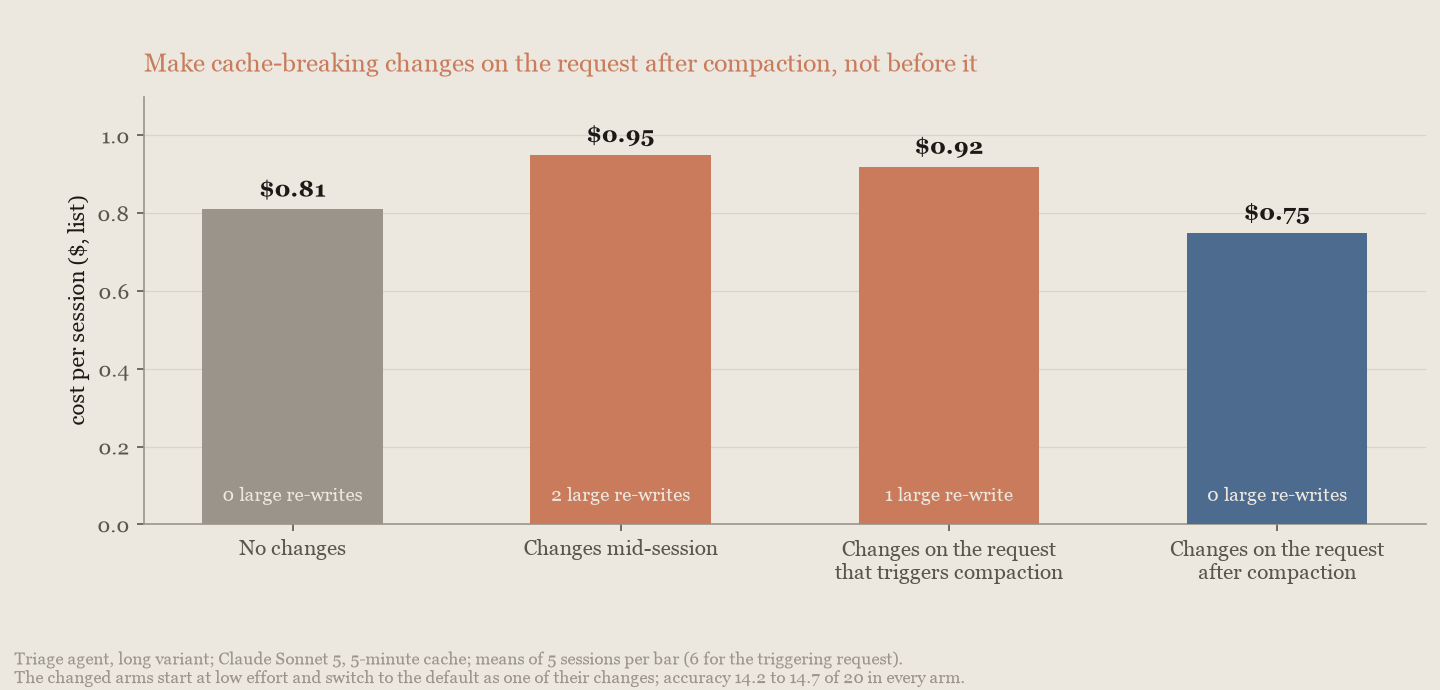
Cambiar un presupuesto de tarea a mitad de camino invalida cualquier prefijo en caché que contenga el valor del presupuesto, así que establécelo una sola vez, en la primera solicitud. Cada pasada de edición de contexto invalida el prefijo desde el punto que limpia y la siguiente solicitud paga por volver a almacenar en caché todo lo que viene después, así que limpia en pocos lotes grandes en lugar de muchos pequeños. En Claude Fable 5.1 y Claude Mythos 5.1 cada uno de estos cuesta 50 veces el precio de lectura por token, así que ahí es donde más importan. Haz cada cambio que invalide la caché en pausas naturales y luego confirma que las lecturas de caché no hayan bajado; si bajaron, el diagnóstico de caché muestra dónde divergió el prefijo.
Recorta los tokens de entrada y de contexto
La mayoría de las solicitudes de agente llevan tokens que nunca influyen en la respuesta. Recortarlos rara vez cuesta calidad de salida, aunque no todas las palancas de esta sección ahorraron dinero al medirlas. Dos lugares donde buscar:
- Recorte de entrada. El filtrado dinámico de la herramienta de obtención web mantiene el contenido repetitivo fuera de las páginas obtenidas, el redimensionamiento de imágenes ajusta el tamaño de las entradas de visión, y la búsqueda de herramientas con carga diferida carga las definiciones de herramientas solo cuando se necesitan (medido más adelante en esta sección). La llamada programática de herramientas permite a Claude ejecutar varias llamadas a herramientas desde código para que solo el resultado filtrado entre en el contexto; su documentación informa un 24% menos de tokens de entrada en benchmarks de búsqueda agéntica, con una puntuación más alta. Gestiona el contexto de las herramientas compara la búsqueda de herramientas, la llamada programática de herramientas, el almacenamiento en caché de prompts y la edición de contexto.
- Ciclo de vida del contexto. La edición de contexto limpia los resultados de herramientas obsoletos, y la compactación automática con su umbral evita que los bucles largos arrastren todo su historial.
Las palancas interactúan con la caché y entre sí, así que júzgalas por su efecto neto, y usa el diagnóstico de caché para confirmar que tu prefijo almacenado en caché sobrevive a cada cambio. Anthropic las midió en un agente de triaje de issues que procesaba 20 informes de errores reales con capturas de pantalla de un repositorio público, y en una variante más larga del mismo trabajo con 2.6 veces los tokens. Con el almacenamiento en caché activado, el recorte de entrada (redimensionamiento de imágenes y búsqueda de herramientas) redujo un 26% adicional en la ejecución corta y un 21% en la larga.
Difiere las definiciones de herramientas no usadas
Cada definición de herramienta adjunta a una solicitud es entrada en cada turno, y unos pocos servidores MCP suman cientos de ellas. Anthropic ejecutó el agente de triaje con sus propias dos herramientas más un catálogo de definiciones de herramientas reales de servidores MCP públicos, para un total de hasta 502 herramientas, cargándolas todas o marcando las extras con defer_loading detrás de la búsqueda de herramientas:
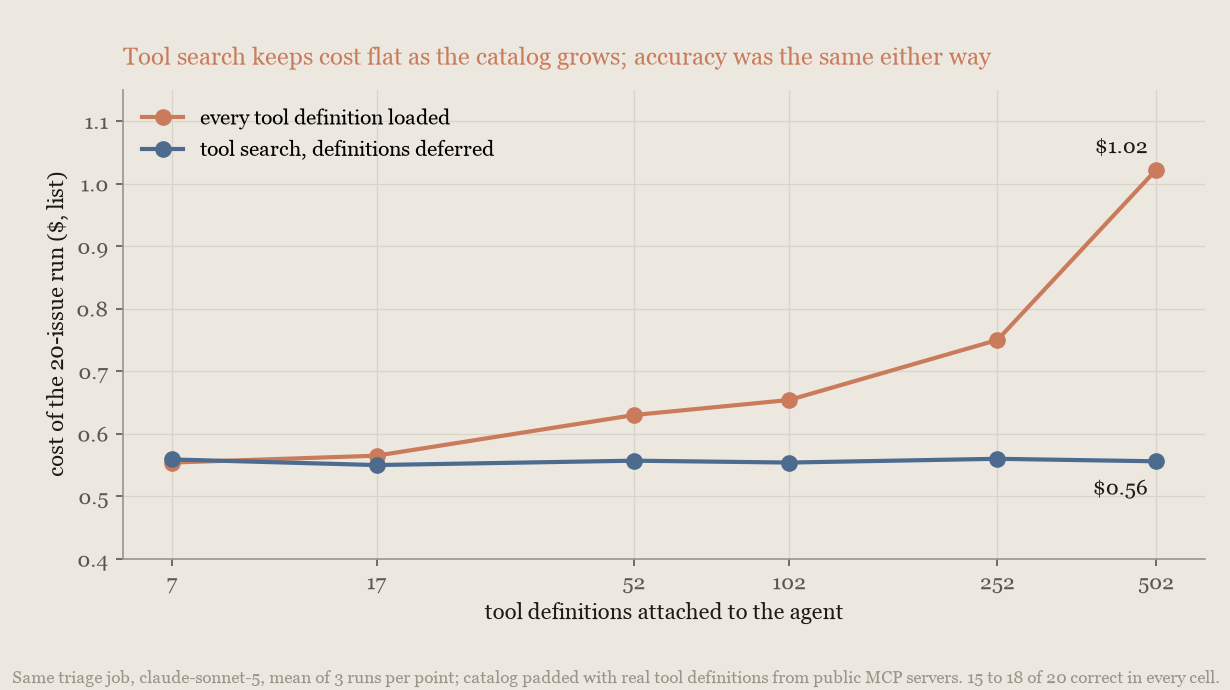
Con cada definición cargada, el costo de la ejecución casi se duplicó a medida que crecía el catálogo, siguiendo los tokens de esquema en cada solicitud. Con la búsqueda de herramientas se mantuvo plano en cada tamaño de catálogo, 45% menos con 502 herramientas. La precisión fue de 15 a 18 de 20 en cada celda de cualquier manera, y el modelo nunca llamó a una herramienta equivocada, así que a esta escala el catálogo cuesta dinero, no corrección. Lo mismo aplica para las herramientas que llegan a través del conector MCP: con un servidor MCP público de GitHub adjunto, diferir su conjunto de herramientas (default_config: {defer_loading: true}) redujo la ejecución un 20% con la misma precisión.
Mantén los archivos de datos fuera del prompt
Cuando el modelo tiene que calcular sobre una tabla, súbela con la Files API y deja que el modelo la consulte con ejecución de código en lugar de pegarla. Anthropic hizo 25 preguntas de agregación15 (sumas, conteos filtrados, agrupaciones y un filtro de fecha) sobre un CSV público de 1,862 filas, con las respuestas calculadas por pandas:
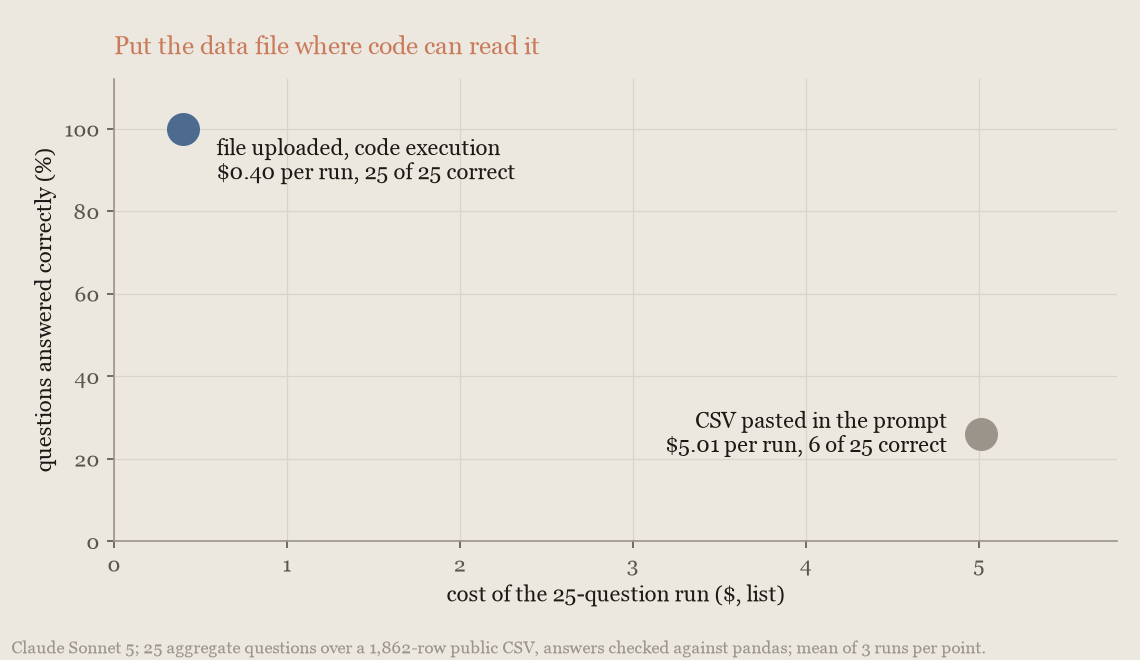
Pegada en el prompt, la tabla son aproximadamente 91,000 tokens de entrada en cada solicitud, y Claude Sonnet 5 respondió correctamente 6 de 25 preguntas. Subida, con ejecución de código, respondió las 25, y la ejecución costó aproximadamente una doceava parte. Claude Opus 5 mostró el mismo patrón.
Gestiona el ciclo de vida del contexto
Las palancas de contexto solo convienen en una sesión lo suficientemente larga para necesitarlas:
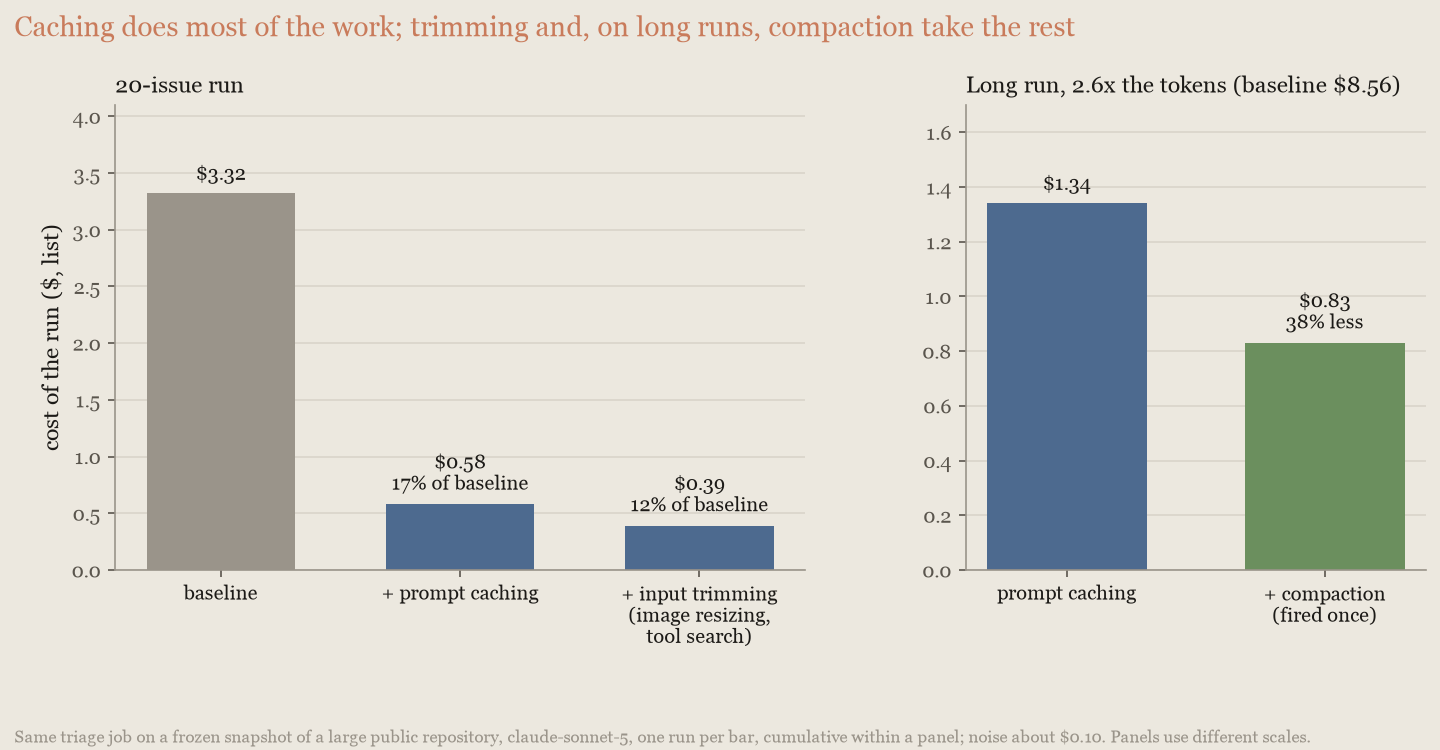
En la ejecución de 20 issues no ahorraron nada, y la edición de contexto costó 74% más. En la ejecución larga la poda ahorró 39% y la compactación 32%, mientras que la edición de contexto no cambió nada. La poda son unas pocas líneas que escribes tú mismo: en cada límite de tarea, reemplaza los resultados de herramientas grandes y obsoletos con un extracto de una línea. Se almacena bien en caché porque las ediciones quedan en la cola de la conversación, donde la siguiente tarea agrega contenido nuevo de todos modos: 89% de lecturas de caché en la primera solicitud después de un límite y 81% en las solicitudes entre límites. A lo largo de toda la ejecución, la poda y la edición de contexto se almacenan en caché aproximadamente igual de bien. La poda es más barata porque la edición de contexto reescribe a mitad de tarea contenido que la poda elimina (aproximadamente dos tercios de la brecha) y porque mantiene el contexto aproximadamente a la mitad del tamaño (el otro tercio). Si usas edición de contexto, limpia en unos pocos lotes grandes. La poda, adaptada del arnés:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # limita los resultados de una sola línea para que el extracto sea breve
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractProcesa por lotes el trabajo que puede esperar
La Batch API quita 50% a cada token de una solicitud, incluidos los que están en caché, a cambio de que los resultados lleguen en cualquier momento dentro de 24 horas. Enruta a través de un lote cada solicitud que nadie esté esperando, y mantén la ruta interactiva para el resto. El procesamiento por lotes es la segunda palanca gratuita más grande después del almacenamiento en caché para trabajo de agente no supervisado: ejecuciones de evaluación, rellenos retroactivos y trabajos programados como una ejecución recurrente del agente de triaje de issues de la medición de recorte de tokens. Se combina con todo lo de esta página excepto la interactividad, pero no está disponible para sesiones de Claude Managed Agents, que son interactivas por diseño (consulta precios de Claude Managed Agents).
Audita los prompts contra el modelo actual
Cada generación de modelos responde a los prompts de manera diferente, así que un prompt acumula texto escrito para un modelo que ya no usas. El caso habitual es una instrucción demasiado específica agregada para compensar un modelo más antiguo: "verifica dos veces", "sé lo más exhaustivo posible", un procedimiento paso a paso obligatorio o un bloc de razonamiento hecho a mano. Un modelo más nuevo las sigue al pie de la letra, produciendo rondas de herramientas extra y escritura extra, así que la factura sube sin ganancia en precisión. Auditar los prompts contra el modelo que ejecutas ahora, y de nuevo cada vez que cambies de modelo, es una ganancia gratuita.
La auditoría es un solo comando. La skill de Claude API que viene con Claude Code tiene un comando prompt-audit que lee los prompts y el código de solicitud de un proyecto y reporta lo que fue escrito para un modelo diferente. Este extracto abreviado lo muestra ejecutado contra un prompt de mesa de soporte y código de solicitud que contienen esos patrones:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.El comando luego propone sus ediciones como un diff (se muestra un fragmento) y enumera lo que deliberadamente dejó intacto: la ventana de reembolso, el requisito de tono y el estándar de calidad. Revisas un parche, no una reescritura.
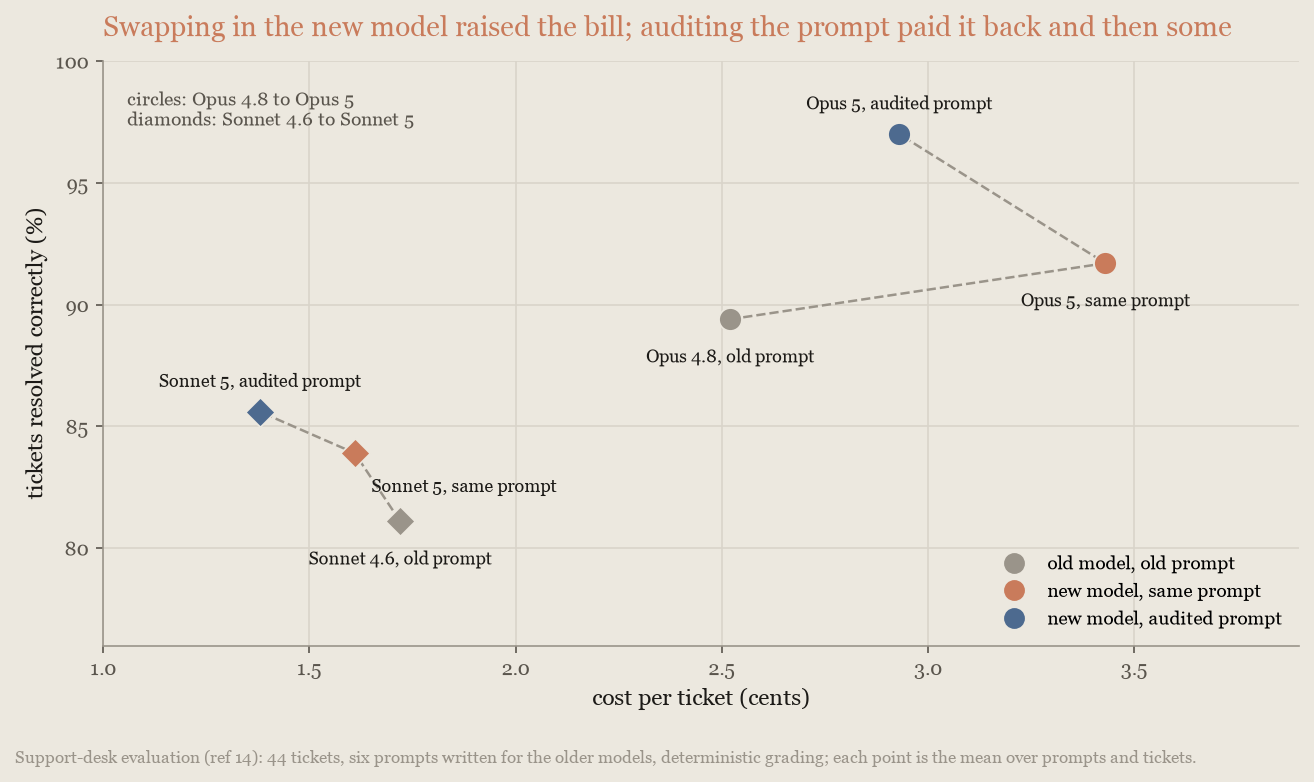
El efecto es medible. En una evaluación de mesa de soporte14, los prompts escritos para Claude Opus 4.8 costaron 36% más por ticket en Claude Opus 5 sin cambio en la precisión. Ejecutar la auditoría sobre los mismos prompts hizo que Opus 5 fuera tanto más barato que la versión sin auditar (en un 14%) como más preciso (97% de los tickets, frente a 92%, una ganancia fuera del ruido). En la migración de Claude Sonnet 4.6 a Claude Sonnet 5, la auditoría quitó un 14% con la misma precisión:
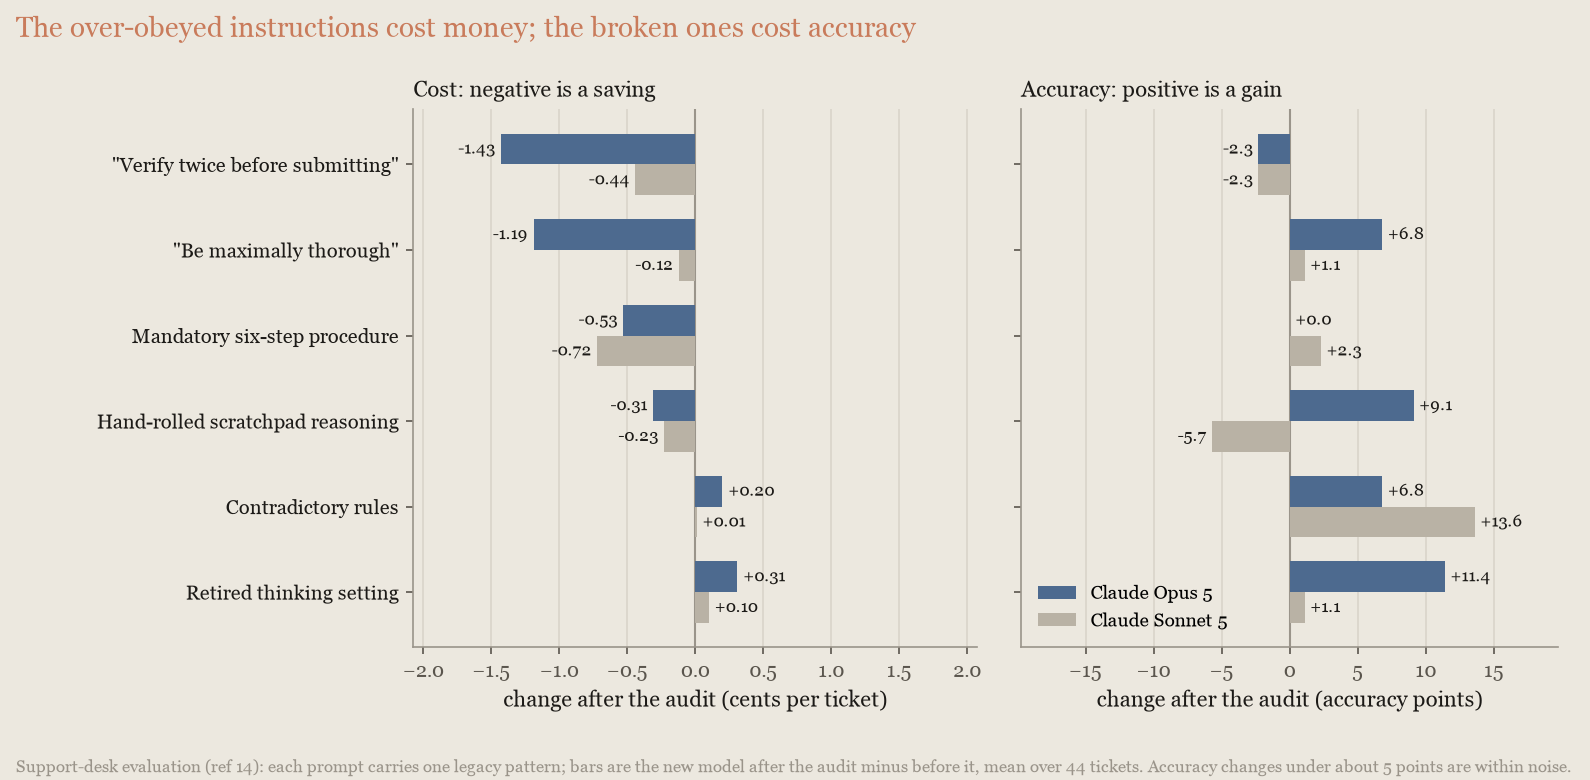
Los dos tipos de texto obsoleto tienen costos diferentes. Las instrucciones que el modelo nuevo sigue demasiado literalmente cuestan dinero: quitar "verifica dos veces" redujo el costo por ticket de Opus 5 en un tercio, y quitar "sé lo más exhaustivo posible" casi lo mismo. El texto que ya no se ajusta al modelo cuesta precisión en cambio: una configuración de pensamiento retirada, reglas contradictorias y un bloc hecho a mano que entra en conflicto con el propio pensamiento del modelo restauraron cada uno de 7 a 11 puntos en Opus 5 al quitarse:
Los mismos patrones tienden a aparecer en descripciones de herramientas y skills, que también vale la pena auditar.
Intercambia costo por inteligencia
Estas palancas determinan dónde se sitúa un solo modelo entre el costo y la inteligencia: la elección de modelo, el esfuerzo, volver a ejecutar los fallos con una configuración más alta, los presupuestos y límites dentro de los que trabaja, y si puede ver cuánto tiempo ha pasado. Empieza con un barrido de esfuerzo en tu modelo actual (Ajusta el esfuerzo). De menor a mayor costo y capacidad, los modelos actuales son Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5 y Claude Fable 5.1 (el modelo de frontera); Descripción general de los modelos tiene la gama completa y los precios.
Compara modelos por costo por tarea
Las listas de precios se expresan por token, y por token el modelo de frontera parece caro: el precio por token de Claude Fable 5.1 es varias veces el de Claude Sonnet 5. Sin embargo, pagas por tareas completadas, así que compara los modelos por costo por tarea completada. Un modelo más capaz termina una tarea con menos trabajo: menos turnos, menos búsquedas, menos relectura de su propio contexto y menos retrocesos. El sobreprecio por token a menudo queda superado por hacer menos de todo.
Anthropic midió esto en el subconjunto de SWE-bench Pro3, con precios calculados como se le factura a un cliente:
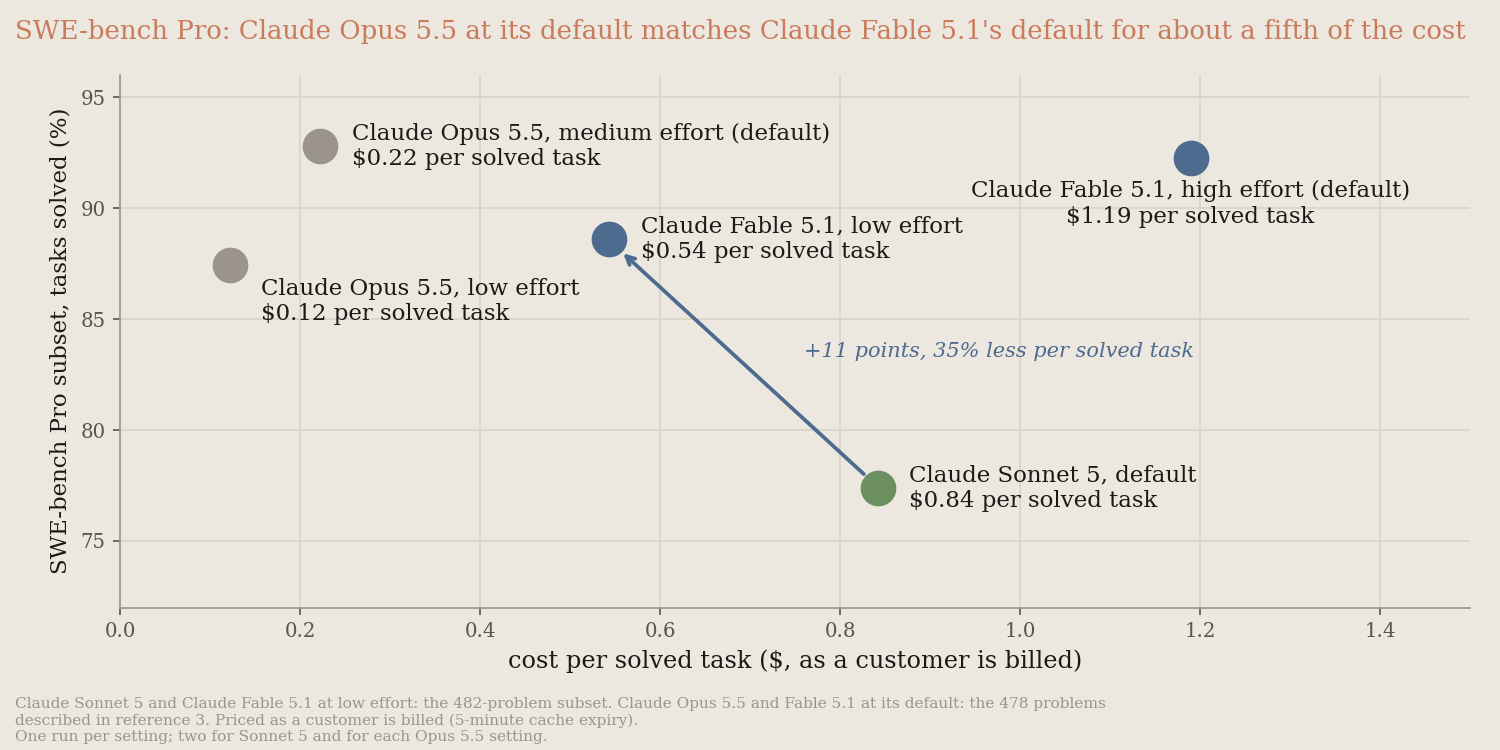
Claude Fable 5.1 con esfuerzo low resolvió el 88.6% de las tareas por $0.54 por tarea resuelta, frente al 77.4% por $0.84 de Claude Sonnet 5 con su valor predeterminado: 11 puntos más por un 35% menos por tarea resuelta, a pesar de un precio por token cinco veces mayor. Sin embargo, no siempre gana. En el mismo subconjunto, que Claude Opus 5.5 y Claude Fable 5.1 saturan en gran medida y cuyas puntuaciones no son comparables con la clasificación pública, Opus 5.5 con su valor predeterminado, medium, igualó a Fable 5.1 con su valor predeterminado (92.8% frente a 92.3%, dentro del ruido entre ejecuciones) por aproximadamente una quinta parte del costo por tarea resuelta ($0.22 frente a $1.19). Con low, Opus 5.5 resolvió el 87.4% por $0.12. Estas cifras usan los 478 problemas descritos en la referencia 3. Y en bucles de investigación largos, el modelo de frontera hace más trabajo, no menos: en DeepResearch Bench II7, Fable 5.1 con low obtuvo 10 puntos más que Sonnet 5 (66% frente a 56%) a aproximadamente cuatro veces el costo por tarea ($4.66 frente a $1.20), porque ejecuta un bucle de investigación más largo sobre un contexto más grande. Claude Opus 5 con su valor predeterminado obtuvo un 71% sobre la misma base por $6.71 por tarea, por encima de Fable 5.1 con su valor predeterminado (65% por $7.12), así que también en investigación Fable 5.1 justifica su precio solo con low.
Para la mayoría de las cargas de trabajo de agentes, empieza con Claude Opus 5.5 con su esfuerzo predeterminado (medium), y usa Claude Fable 5.1 para razonamiento exigente y trabajo agéntico de largo horizonte, o cuando tus evaluaciones en Claude Opus 5.5 con un esfuerzo más alto sigan quedándose cortas. En el subconjunto de SWE-bench Pro, Opus 5.5 con su valor predeterminado igualó a Fable 5.1 con su valor predeterminado por aproximadamente una quinta parte del costo por tarea resuelta, como se indicó antes. En el benchmark de programación de Estrategia de asesor, obtuvo un 86.6% frente al 84.2% de Fable 5.1 con medium (una sola ejecución de Fable 5.1), por menos de un tercio del costo por intento ($0.84 frente a $2.68). En Chartography13, un benchmark de lectura de gráficos, Opus 5.5 con low obtuvo 68.7 por unos $0.03 por gráfico, frente a 62.5 por $0.15 de Fable 5.1 con low y 49 por $0.16 de Claude Opus 5 con low. En el otro extremo, Claude Haiku 4.5 respondió preguntas de GPQA Diamond9 por aproximadamente una quinta parte del costo por pregunta de Claude Opus 5.5, con un 63% de precisión frente al 92% de Opus 5.5, y se quedó mucho más atrás en tareas de programación largas. Encaja en trabajo de alto volumen con salidas verificables, no en bucles agénticos largos.
La clasificación se invierte según la carga de trabajo, y ninguna lista de precios te dice en qué sentido. Calcula el precio de cada candidato en costo por tarea completada sobre tu propio tráfico, incluidos Claude Opus 5.5 con su esfuerzo predeterminado y el modelo de frontera con esfuerzo reducido.
Calcula el precio de la cola de tu carga de trabajo, no de la mediana: compara los modelos en la décima parte más difícil de tus tareas, no en la típica. En la tarea típica todos los modelos parecen similares y el más barato parece el mejor, pero la factura la deciden las tareas en las que falla el modelo más barato, porque una tarea fallida sigue facturando sus tokens, luego el reintento y luego lo que cueste el fallo más adelante. La cola es también donde va el dinero incluso cuando nada falla. En una ejecución de WideSearch1 de 20 problemas, dos problemas concentraron el 43% del gasto:
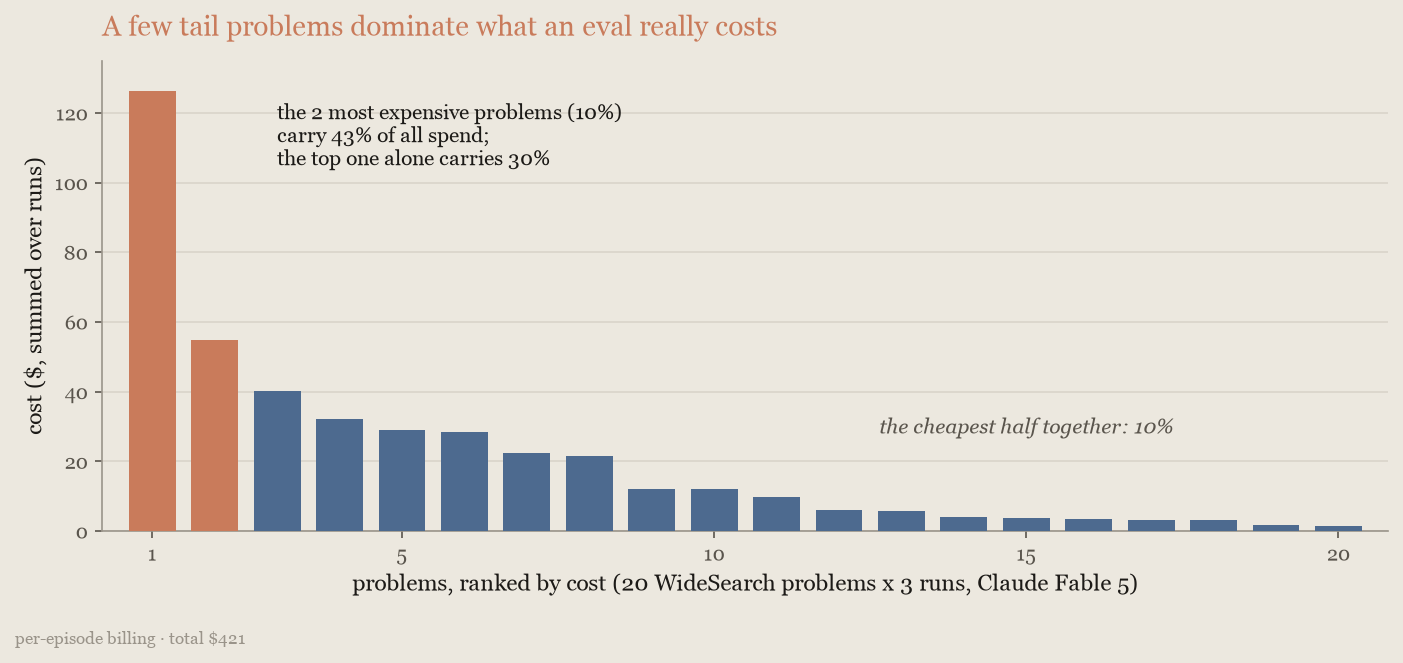
Las estrategias multimodelo existen para dedicar la inteligencia de frontera a esa cola sin pagar tarifas de frontera por el resto.
Actualiza el modelo
Si estás uno o dos modelos atrás, la palanca más económica es la cadena del modelo. Anthropic ejecutó modelos recientes de Claude Opus, Claude Sonnet y Claude Fable con el mismo arnés en el subconjunto de SWE-bench Pro3, cada uno con sus valores predeterminados de fábrica y con precios de lista, y volvió a ejecutar la línea Opus en Terminal-Bench 320:
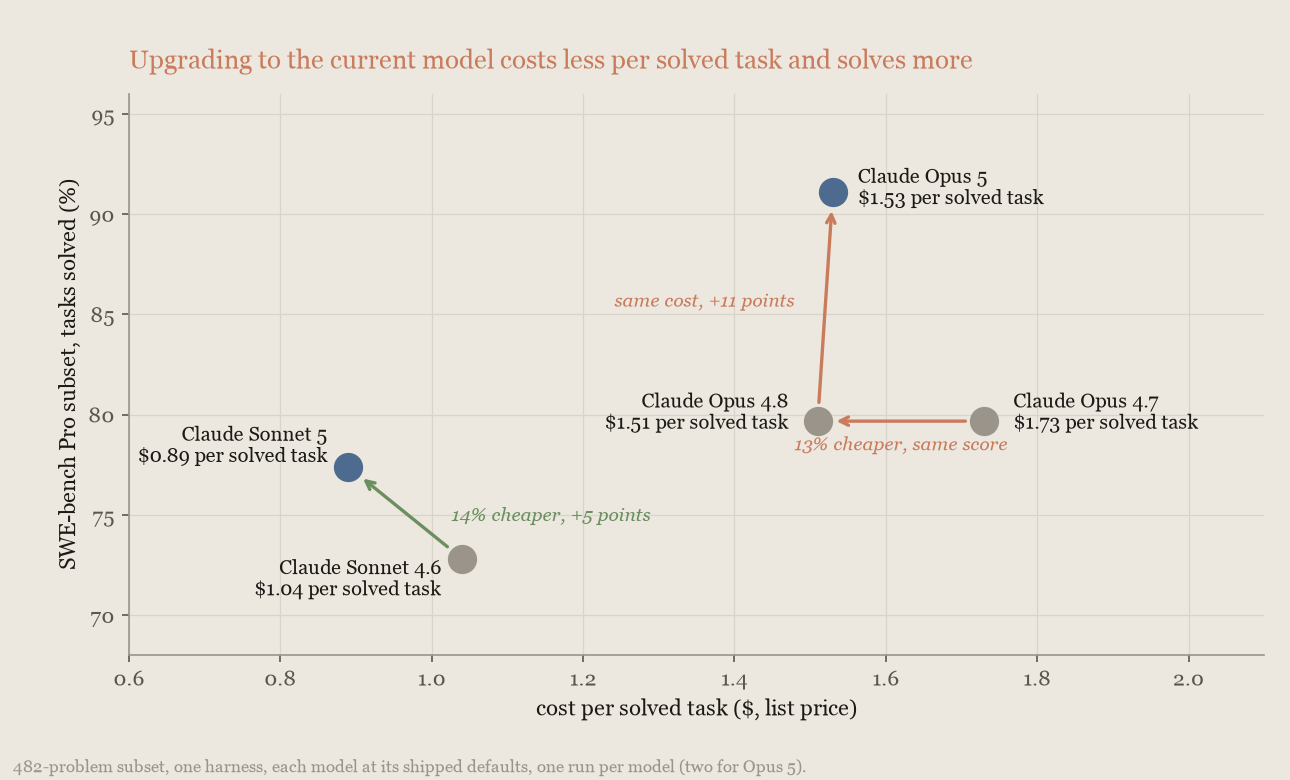
Anthropic fija el mismo precio por token para Claude Opus 4.7, Opus 4.8 y Opus 5, por lo que cualquier diferencia entre ellos proviene de cuánto trabajo hace cada modelo por tarea: con precios calculados tal como se factura a un cliente, Claude Opus 4.8 resuelve la misma proporción de tareas que Claude Opus 4.7 por un 14% menos por tarea resuelta, y Claude Opus 5 resuelve luego 12 puntos más de tareas por un 21% más por tarea resuelta. Claude Opus 5 con esfuerzo low supera al valor predeterminado de Opus 4.8 en este benchmark por aproximadamente el 30% de su costo por tarea resuelta, así que la actualización más económica es el nuevo modelo con una configuración más baja. El ahorro de Sonnet 5 proviene de su menor precio por token, que compensa con creces los tokens adicionales que usa por tarea en comparación con Sonnet 4.6: un 15% menos por tarea resuelta por 5 puntos más. El nivel de frontera mejoró de la misma manera: Claude Fable 5.1 iguala la puntuación de Claude Fable 5 por un 43% menos por tarea resuelta, en su mayor parte gracias al menor precio de lectura de caché. Esa dirección no está garantizada: en DeepResearch Bench II7 la misma actualización cuesta un 41% más por tarea con high (un 79% más con low) por sus 2 a 3 puntos adicionales en las tareas limpias en cada brazo (referencia 7), porque el nuevo modelo hace más trabajo por tarea allí. Los precios de entrada y salida son los mismos y la lectura de caché es 4 veces más económica, así que mide la actualización en tu propia carga de trabajo antes de suponer que ahorra.
En trabajos más difíciles la diferencia se amplía. En Terminal-Bench 320, donde las tareas son lo bastante difíciles como para que la tasa de aprobación, y no los tokens, determine la factura, Claude Opus 4.7, Opus 4.8 y Opus 5 gastan cada uno entre $8 y $15 por tarea, pero resuelven el 7%, el 15% y el 41% de las tareas, por lo que el costo por tarea resuelta baja de $183 a $63 y a $28 al subir por la escalera. El recargo del 21% que Claude Opus 5 tiene sobre Opus 4.8 en el subconjunto de programación saturado se convierte en un ahorro del 56% en Terminal-Bench 3, donde el modelo anterior falla en su mayoría: cuanto más supere tu carga de trabajo al modelo anterior, más ahorra la actualización por resultado.
Compara por costo por tarea resuelta, no por token: el mismo texto cuesta aproximadamente un 30% más de tokens en Claude Opus 4.7 y posteriores, por lo que una comparación por token hace que los modelos más nuevos parezcan más caros por construcción.
Ajusta el esfuerzo
El "effort" (esfuerzo) es la forma más directa de ajustar un modelo a tu tarea. El parámetro effort controla cuánto pensamiento, cuántas llamadas a herramientas y cuánta autoverificación realiza el modelo. high, el valor predeterminado en la mayoría de los modelos, es adecuado para tareas exigentes; Claude Opus 5.5 usa medium de forma predeterminada. El costo escala con toda esa actividad; la precisión escala solo con la parte que tu tarea necesita. Por debajo del techo del modelo, los niveles de esfuerzo más altos pagan por una profundidad que la tarea nunca usa.
En los benchmarks de investigación y trabajo de conocimiento (WideSearch1, DeepWideSearch6, BrowseComp4 y GDPval2, todos con Claude Fable 5), la curva de precisión frente a costo es casi plana. low cedió de 1 a 3 puntos a cambio de reducir entre un tercio y la mitad el costo por tarea. medium igualó la precisión del valor predeterminado por aproximadamente entre el 70% y el 87% de su costo. El valor predeterminado no aportó nada medible sobre medium en ninguno de los cuatro. En DeepWideSearch, low también igualó a un orquestador con un trabajador Claude Sonnet 5 con un costo un 29% menor: reducir el esfuerzo superó a un cambio de arquitectura.
Las configuraciones de esfuerzo más bajas suelen ser más rápidas, lo cual importa cuando la "latency" (latencia) es la restricción. En estas ejecuciones, low tardó 4.5 minutos por problema en DeepWideSearch, frente a 7.9 minutos con el valor predeterminado. En el benchmark de corpus, cuya entrada no cabe en ninguna "context window" (ventana de contexto) individual, Fable 5.1 tardó 15.2, 17.5 y 19.9 horas por episodio con low, medium y high.
La programación de largo horizonte es donde el esfuerzo realmente compra precisión. En SWE-bench Pro3, en comparación con high, Claude Opus 5.5 obtuvo unos 2.5 puntos menos con su valor predeterminado, medium, por aproximadamente el 70% del costo. Con low obtuvo unos 8 puntos menos por aproximadamente un tercio del costo. xhigh obtuvo unos 1.4 puntos más por 2.5 veces el costo de high. Es una compensación real, que volver a ejecutar los fallos con mayor esfuerzo convierte de nuevo en un ahorro. Este gráfico representa la precisión frente al costo para los benchmarks de investigación y trabajo de conocimiento y para SWE-bench Pro:
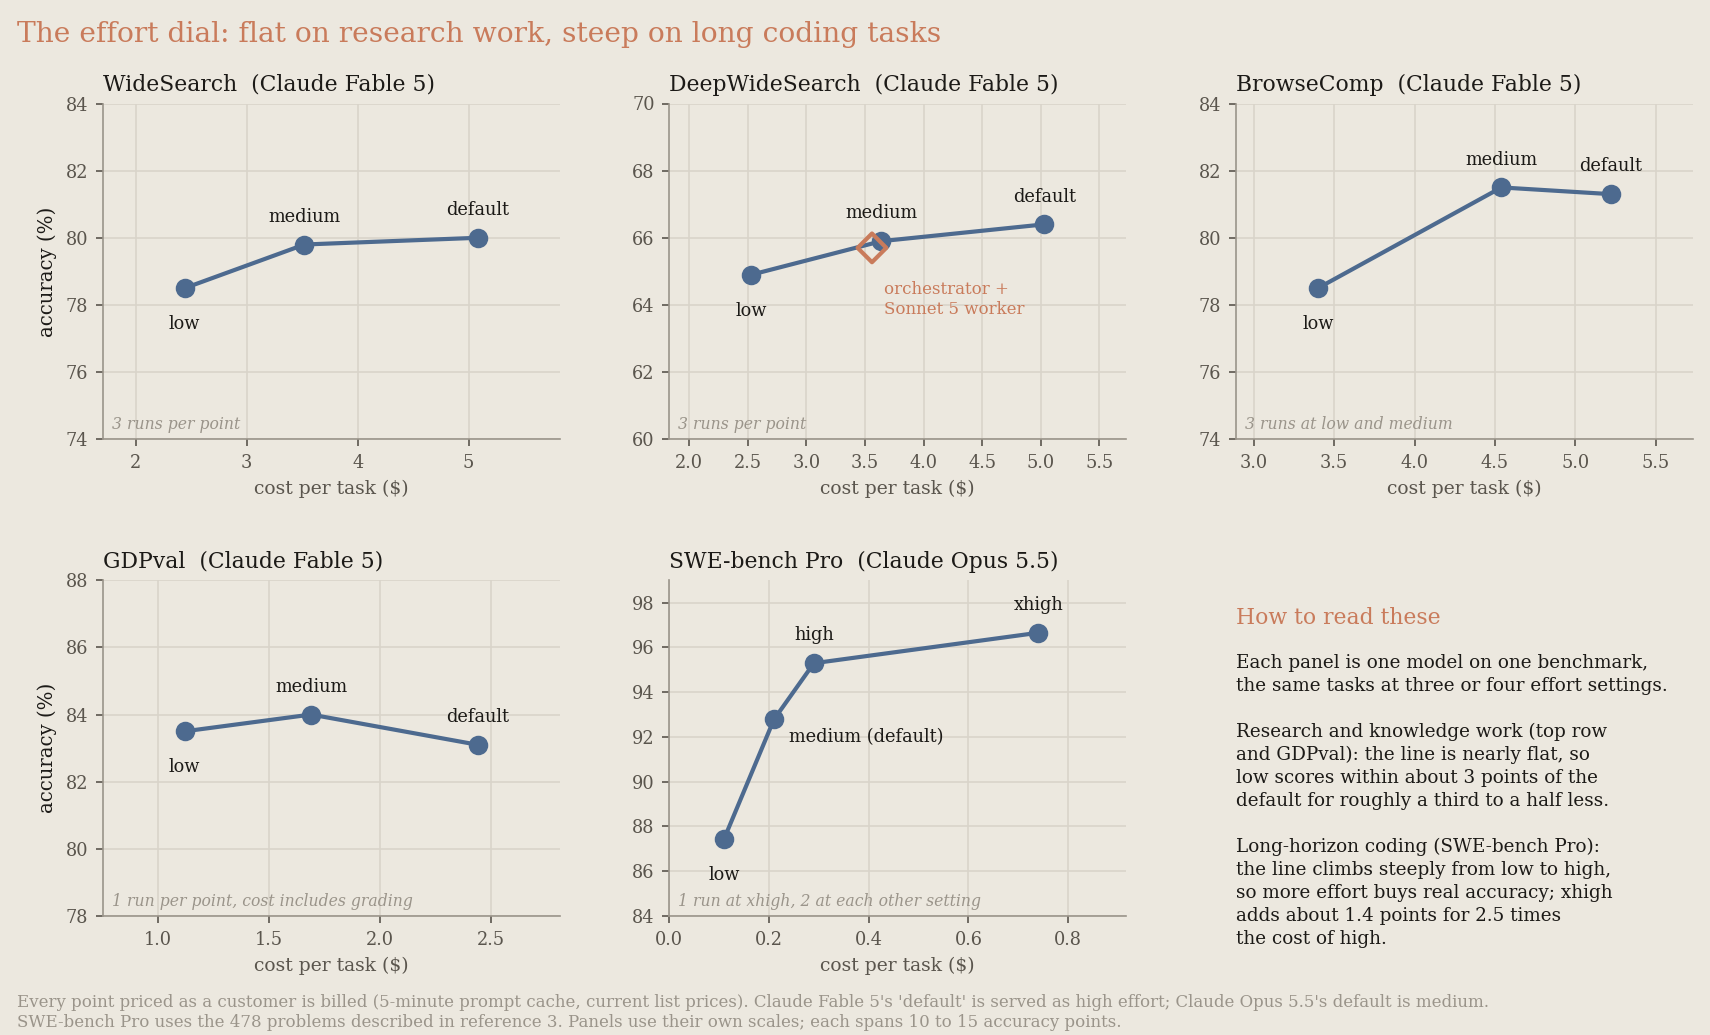
De esto se derivan dos consecuencias. Primero, traza esta curva para tu propia carga de trabajo antes de agregar un segundo modelo: en estas mediciones internas, una configuración multimodelo que parecía más barata que el modelo único predeterminado costó más que ese mismo modelo con menor esfuerzo. Segundo, esta curva es la línea base de modelo único que cualquier estrategia multimodelo debe superar, por lo que el paso 2 de la medición en tu propia carga de trabajo establece líneas base en varios niveles de esfuerzo.
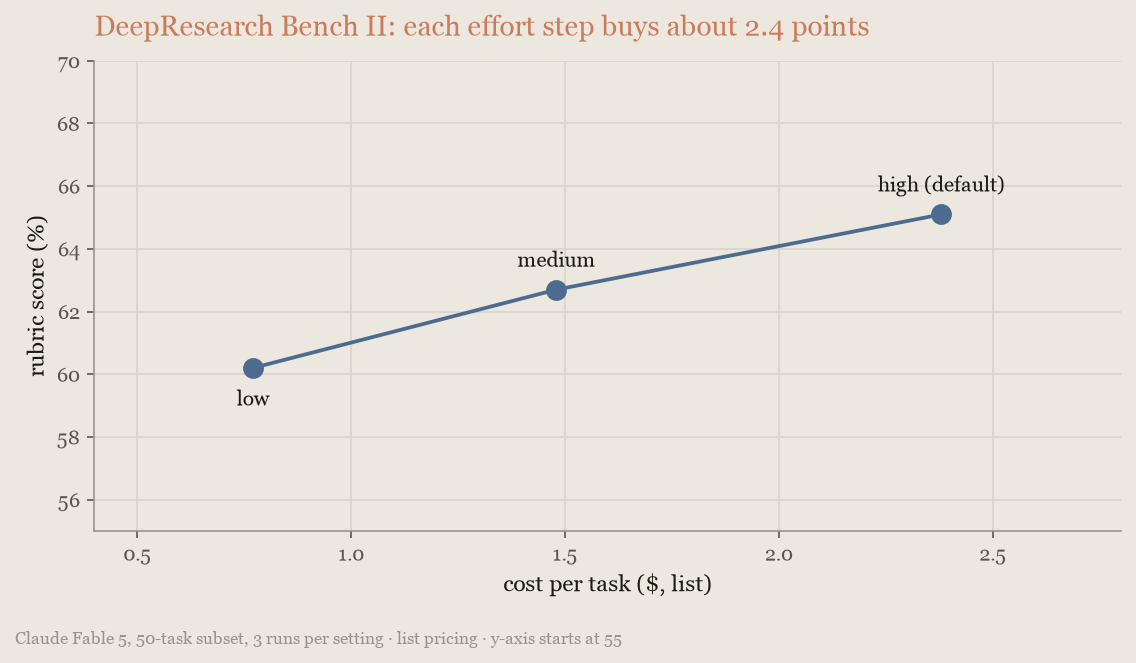
El trabajo difícil no necesita automáticamente un esfuerzo alto. En DeepResearch Bench II7, Claude Fable 5.1 obtuvo casi la misma puntuación con low, medium y high, mientras que el costo por tarea subió de $4.66 a $7.12. En este caso, aumentar el esfuerzo no mejora de forma notable la calidad del resultado. En las 21 tareas limpias en cada brazo (referencia 7), Claude Fable 5 también se mantuvo plano en todos los niveles de esfuerzo. Sin embargo, la base de 33 tareas del gráfico, que descarta los intentos interrumpidos de cada modelo, lo muestra en ascenso. Mide la curva en el modelo que despliegas, no en el que mediste la última vez:
La descripción de la tarea por sí sola no revela qué tipo de carga de trabajo tienes, así que prueba dos o tres niveles de esfuerzo en una muestra de tu propio tráfico y lee la respuesta en la curva. Prueba cada nivel en una sesión separada: cambiar el esfuerzo de nivel superior a mitad de sesión invalida la caché (consulta Almacena en caché el contexto repetido) y distorsiona la comparación. Para obtener detalles sobre el parámetro, consulta Esfuerzo.
Vuelve a ejecutar los fallos con mayor esfuerzo
Cuando el resultado de una tarea es verificable, la política más barata en la curva de esfuerzo no es una configuración fija. Ejecuta cada tarea con una configuración baja y vuelve a ejecutar solo los fallos con una más alta.
Anthropic calculó esta política tarea por tarea a partir de las ejecuciones de esfuerzo en el subconjunto de SWE-bench Pro3 de Ajusta el esfuerzo. Con Claude Opus 5.5 en low, el 13% de las tareas fallaron. Al volver a ejecutar esas tareas con high, aprobó aproximadamente el 97% por unos $0.17 cada una, frente al 95.3% por $0.29 al ejecutar todo con high. Es una tasa de aprobación ligeramente mayor por poco más de la mitad del costo, contando los intentos baratos fallidos. Empezar con medium resolvió aproximadamente el 97% por unos $0.24. La mayor parte de la pequeña mejora proviene del segundo intento: volver a ejecutar con high los fallos de una ejecución con high obtiene aproximadamente la misma puntuación, por más dinero. Así que usa esta política por el ahorro, no por la mejora:
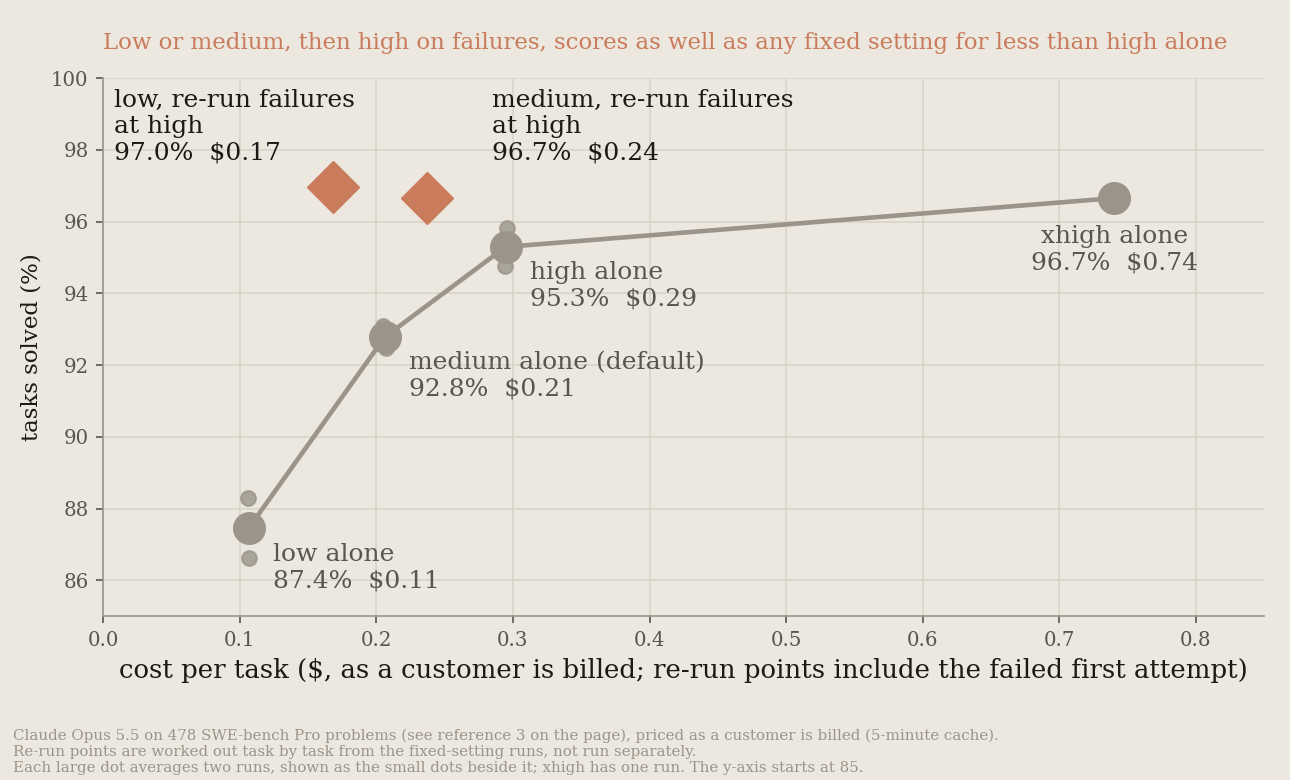
Se aplican dos condiciones. Primero, necesitas una señal de fallo (aquí, las propias pruebas del benchmark); un verificador que aprueba trabajo deficiente deja pasar esos fallos. Segundo, cada fallo de la primera pasada consume el tiempo real de dos ejecuciones, así que el ahorro se paga en latencia en los fallos.
Establece presupuestos y límites de salida
La mayoría de las ejecuciones de tareas agénticas son baratas, pero una minoría gasta muchas veces el costo mediano en búsquedas, reverificaciones y pruebas excesivas. Un "task budget" (presupuesto de tarea) apunta a esa cola. El modelo ve una cuenta regresiva de tokens en vivo para toda la tarea y se autorregula: recorta búsquedas de poco valor, omite verificaciones redundantes y concluye en lugar de entrar en espiral.
Anthropic midió la tasa de aprobación y el costo por tarea en SWE-bench Pro3 con Claude Fable 5.1 a medida que el presupuesto se ajustaba:
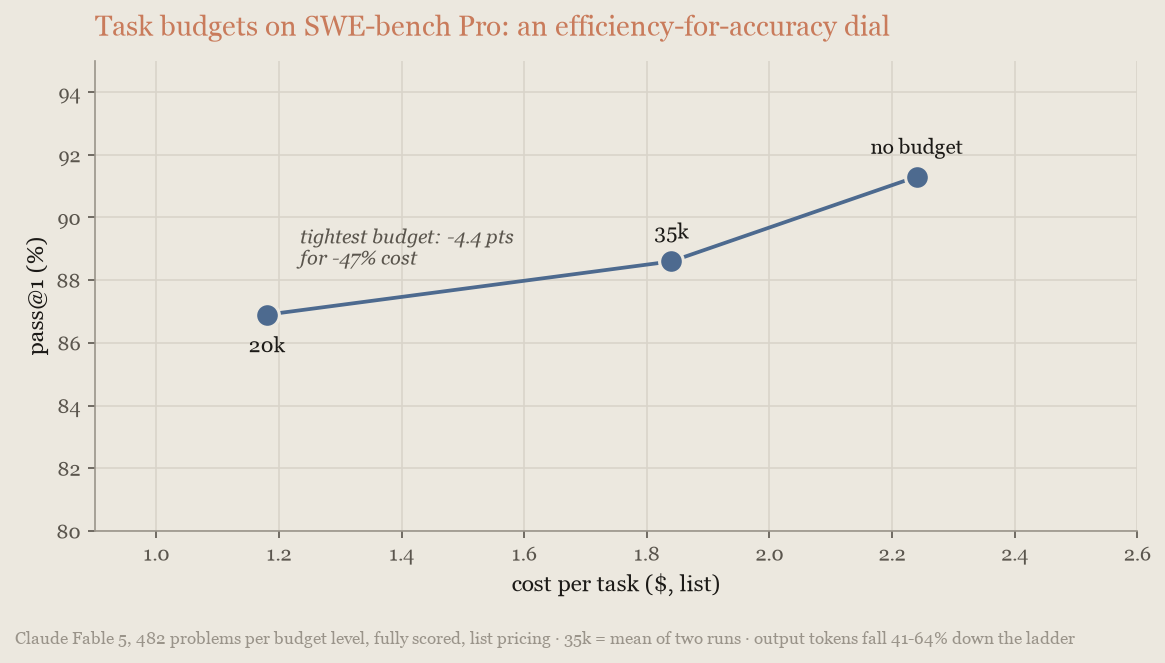
Un presupuesto generoso redujo el costo por tarea un 44% a cambio de unos 3 puntos de tasa de aprobación, en el límite del ruido entre ejecuciones. El presupuesto más ajustado permitido lo redujo un 58% a cambio de 6 puntos. Aquí los presupuestos compraron eficiencia, a un precio en tasa de aprobación que crece a medida que el presupuesto se ajusta.
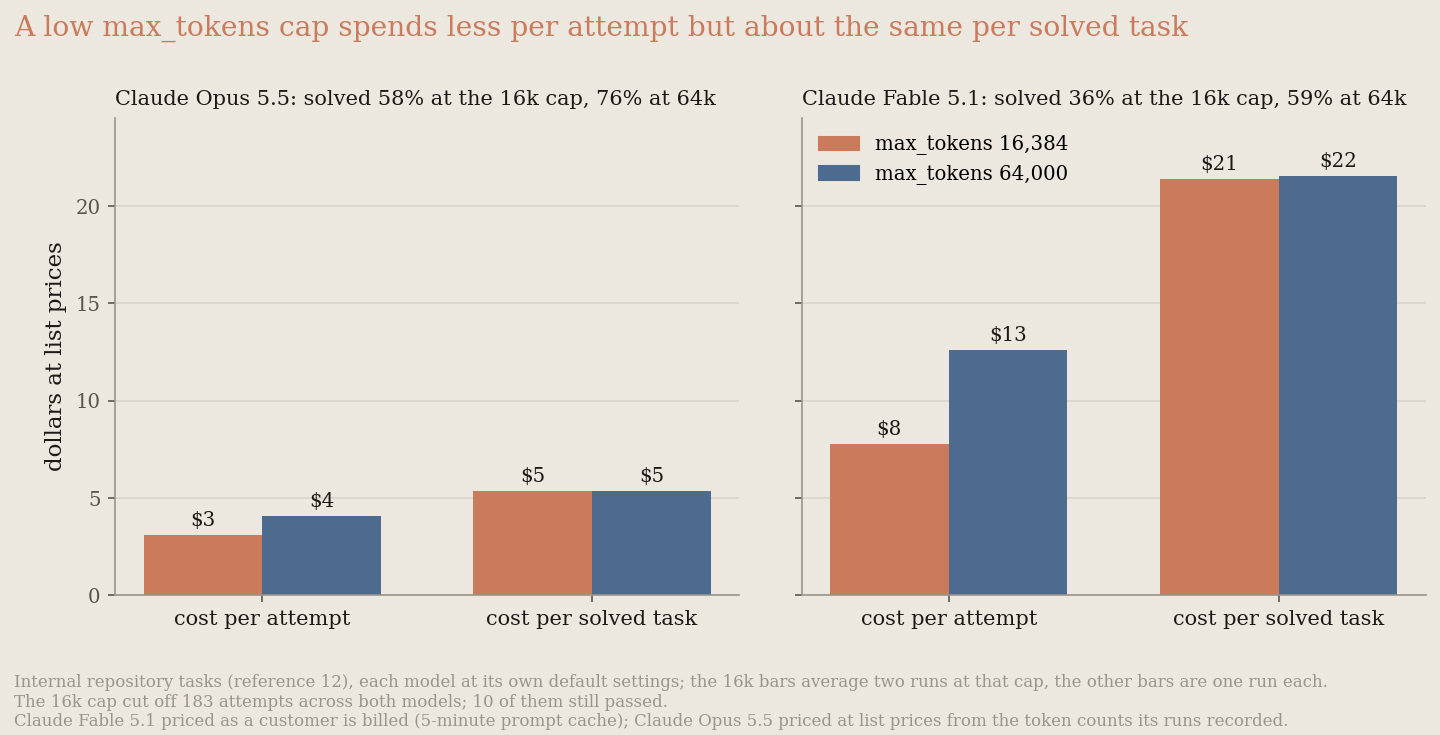
Tres controles cumplen tres funciones distintas. Un presupuesto de tarea ahorra dinero, porque el modelo lo ve. max_tokens es un límite de seguridad: reducirlo bajó el costo por intento sin bajar el costo por tarea resuelta. En Claude Managed Agents, un presupuesto de sesión es el tope estricto en dólares que respalda a ambos. Establece los tres: un presupuesto de tarea, un max_tokens alto y un límite de sesión para la ejecución que nunca quieres ver en una factura. Como último respaldo, agrega un límite de gasto del espacio de trabajo.
- Los presupuestos de tarea están en beta (encabezado beta
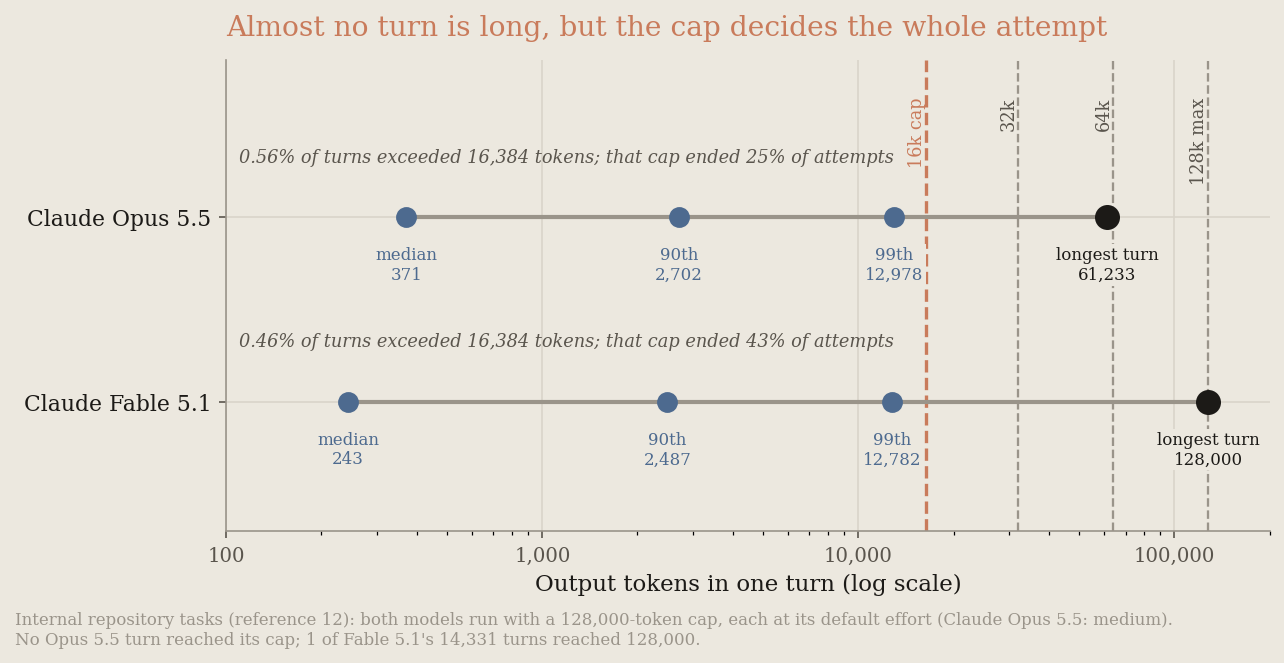
task-budgets-2026-03-13) en los modelos más recientes; consulta la tabla de compatibilidad para saber cuáles. Empieza cerca del percentil 90 del uso de tokens de tu bucle y luego ajústalo (Elegir un presupuesto muestra cómo recopilar esa distribución). Los presupuestos por debajo del mínimo actual de 20,000 tokens se rechazan, y los presupuestos muy ajustados pueden producir un comportamiento similar a un rechazo. Establece el presupuesto una sola vez, en la primera solicitud, porque un cambio a mitad de la tarea invalida la caché. El presupuesto es orientativo: guía al modelo en lugar de detenerlo, así que verifica su cumplimiento en tu carga de trabajo. max_tokenslimita una sola respuesta, de forma invisible para el modelo, así que reducirlo no hace que el modelo economice. Los turnos que necesitaban el espacio se descartan y aun así se facturan. En un benchmark interno de tareas de repositorio12, un límite de 16,384 tokens interrumpió aproximadamente una cuarta parte de los intentos de Claude Opus 5.5 y el 43% de los de Claude Fable 5.1, cada uno con su esfuerzo predeterminado. Solo 1 de los 66 intentos limitados de Opus 5.5 y 9 de los 117 intentos limitados de Fable aprobaron de todos modos. Las ejecuciones limitadas gastaron menos por intento, pero lograron proporcionalmente menos resoluciones. Por eso, el costo por tarea resuelta fue aproximadamente el mismo que con 64,000 (en Fable 5.1, $21 frente a $22; en Opus 5.5, dentro del 1%). Con 64,000, 2 de aproximadamente 14,000 turnos de Claude Fable 5.1 con su esfuerzo predeterminado aún se interrumpieron (ningún turno de Claude Opus 5.5 se interrumpió). Además, Fable 5.1 resolvió el 58.5% de las tareas en lugar del 36.3%. En un corte separado del subconjunto de SWE-bench Pro3, descrito en la referencia 12, no hubo diferencia: 94 de 100 con cualquiera de los dos límites. Reintentar los intentos limitados rara vez ayuda: con el mismo límite, la mayoría vuelve a fallar, y con uno más alto también pagas el intento desperdiciado. Establecemax_tokensen 64,000 para el trabajo agéntico, o en 128,000, el máximo, cuando un solo intento interrumpido sea costoso; con 128,000, Fable 5.1 resolvió el 60.0% por el mismo costo por tarea resuelta. Usa streaming para las respuestas de ese tamaño y tratastop_reason: max_tokenscomo un fallo. Para ahorrar dinero, usa el esfuerzo y los presupuestos de tarea, que el modelo sí puede ver.- Los presupuestos de sesión en Claude Managed Agents son el tope estricto. Un presupuesto de sesión es un límite en dólares para una sesión, a tarifas de lista, que cubre tokens, búsquedas y tiempo de sesión. Al alcanzar el límite, la sesión se pausa con
stop_reason: budget_reached; aumentar el presupuesto la reanuda. Lo aplica la plataforma y funciona en cualquier modelo con precio de lista, incluidos los modelos en los que los presupuestos de tarea aún no están disponibles. Además, se combina con el presupuesto de tarea orientativo. Los despliegues aplican el mismo campo a cada ejecución.
Pide respuestas más cortas. En Claude Sonnet 5, los tokens de salida cuestan cinco veces más que los de entrada. Además, en un bucle de agente, cada token que escribe el modelo vuelve como entrada en cada turno posterior, así que pagas una respuesta larga una y otra vez. Anthropic ejecutó el trabajo de triaje con tres instrucciones distintas para la respuesta final, tres ejecuciones cada una, con el mismo modelo y las mismas herramientas. La original pedía dos líneas:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>La variante más corta pedía una:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.La variante más larga pedía un memorando con cinco secciones con encabezado: resumen del problema, evidencia, verificación de duplicados, etiqueta recomendada y próximos pasos. Para un issue, un prompt en cola que nunca se envía después de una pregunta omitida, las dos primeras respuestas fueron:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.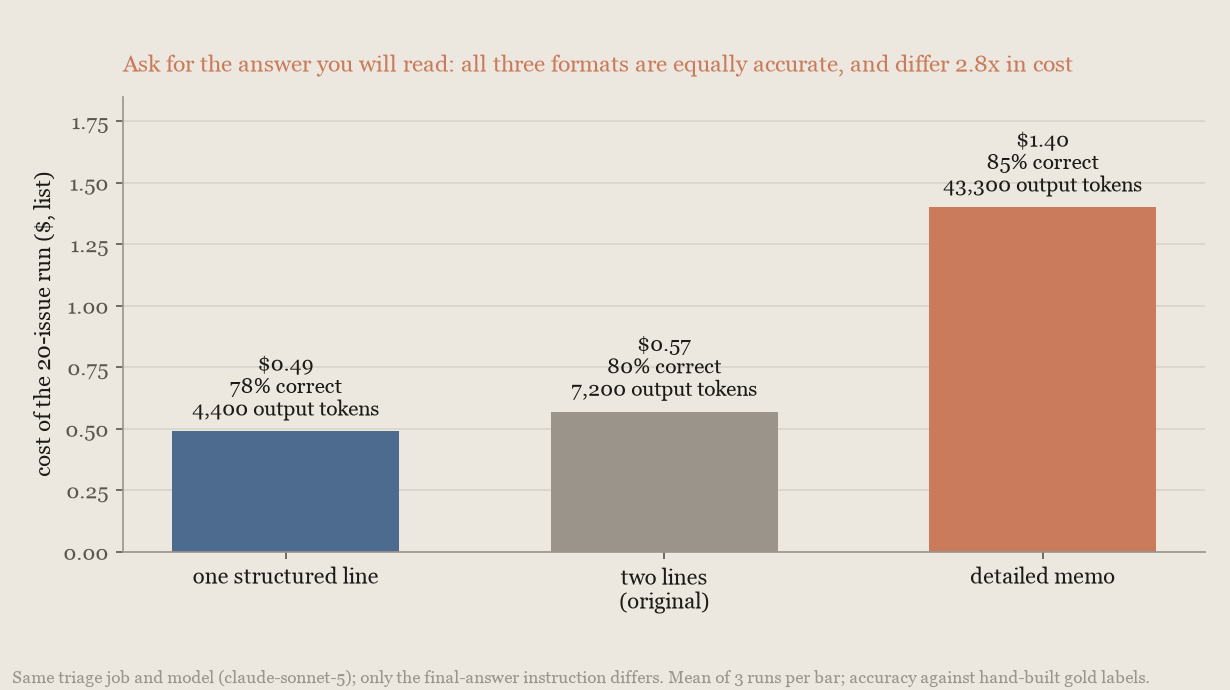
La respuesta de una línea usó un 39% menos de tokens de salida que la original de dos líneas y costó un 14% menos por ejecución. El memorando usó seis veces más tokens de salida y costó 2.8 veces lo que la respuesta de una línea. Frente a las etiquetas de referencia, las tres puntuaciones quedaron dentro del ruido entre ejecuciones. Los formatos difieren mucho más en lo que pagas que en lo que aciertan. Pide la respuesta que vas a leer, no la que parece exhaustiva.
Con el límite de max_tokens más bajo, ambos modelos gastan menos por intento, pero resuelven proporcionalmente menos tareas, así que el costo por tarea resuelta apenas cambia:
Casi todos los turnos terminan muy por debajo de cualquiera de los dos límites. El turno largo poco frecuente es lo que compra el límite más alto:
Muestra al modelo el tiempo transcurrido
Un modelo en un bucle de agente no puede ver un reloj. Un presupuesto de tarea le muestra cuántos tokens quedan, pero, de forma predeterminada, nada en la solicitud le muestra cuánto tiempo ha tomado el trabajo. Dos pequeños cambios le dan esa señal. Agrega a la indicación del sistema una instrucción de dos oraciones que diga que el tiempo importa. Luego, a partir de la segunda solicitud, envía el tiempo transcurrido antes de cada turno del modelo.
Anthropic midió ambos cambios juntos con Claude Fable 5.1 con esfuerzo high en dos benchmarks públicos, DRACO21 y HLE22. También los midió en un conjunto interno de 70 problemas de física de nivel de investigación, adaptado del benchmark público CritPt23. Esta página llama a ese conjunto el conjunto de física. Cada uno de los tres se ejecutó en dos formas: un solo agente y un equipo en el que un agente principal inicia agentes auxiliares del mismo modelo que trabajan en paralelo. Un cambio de puntuación cuenta como dentro del margen cuando su intervalo del 95% se mantiene dentro de un límite que Anthropic fijó antes de las ejecuciones: 1.5 puntos en DRACO y 2.5 puntos en HLE. El siguiente gráfico representa la puntuación frente al costo por tarea para cada configuración. Una segunda fila de barras muestra el tiempo de cada configuración como proporción respecto al agente único con esfuerzo high, sin esperas por reintentos. Una tercera fila muestra el cambio de puntuación que producen ambos cambios, con su intervalo del 95%:
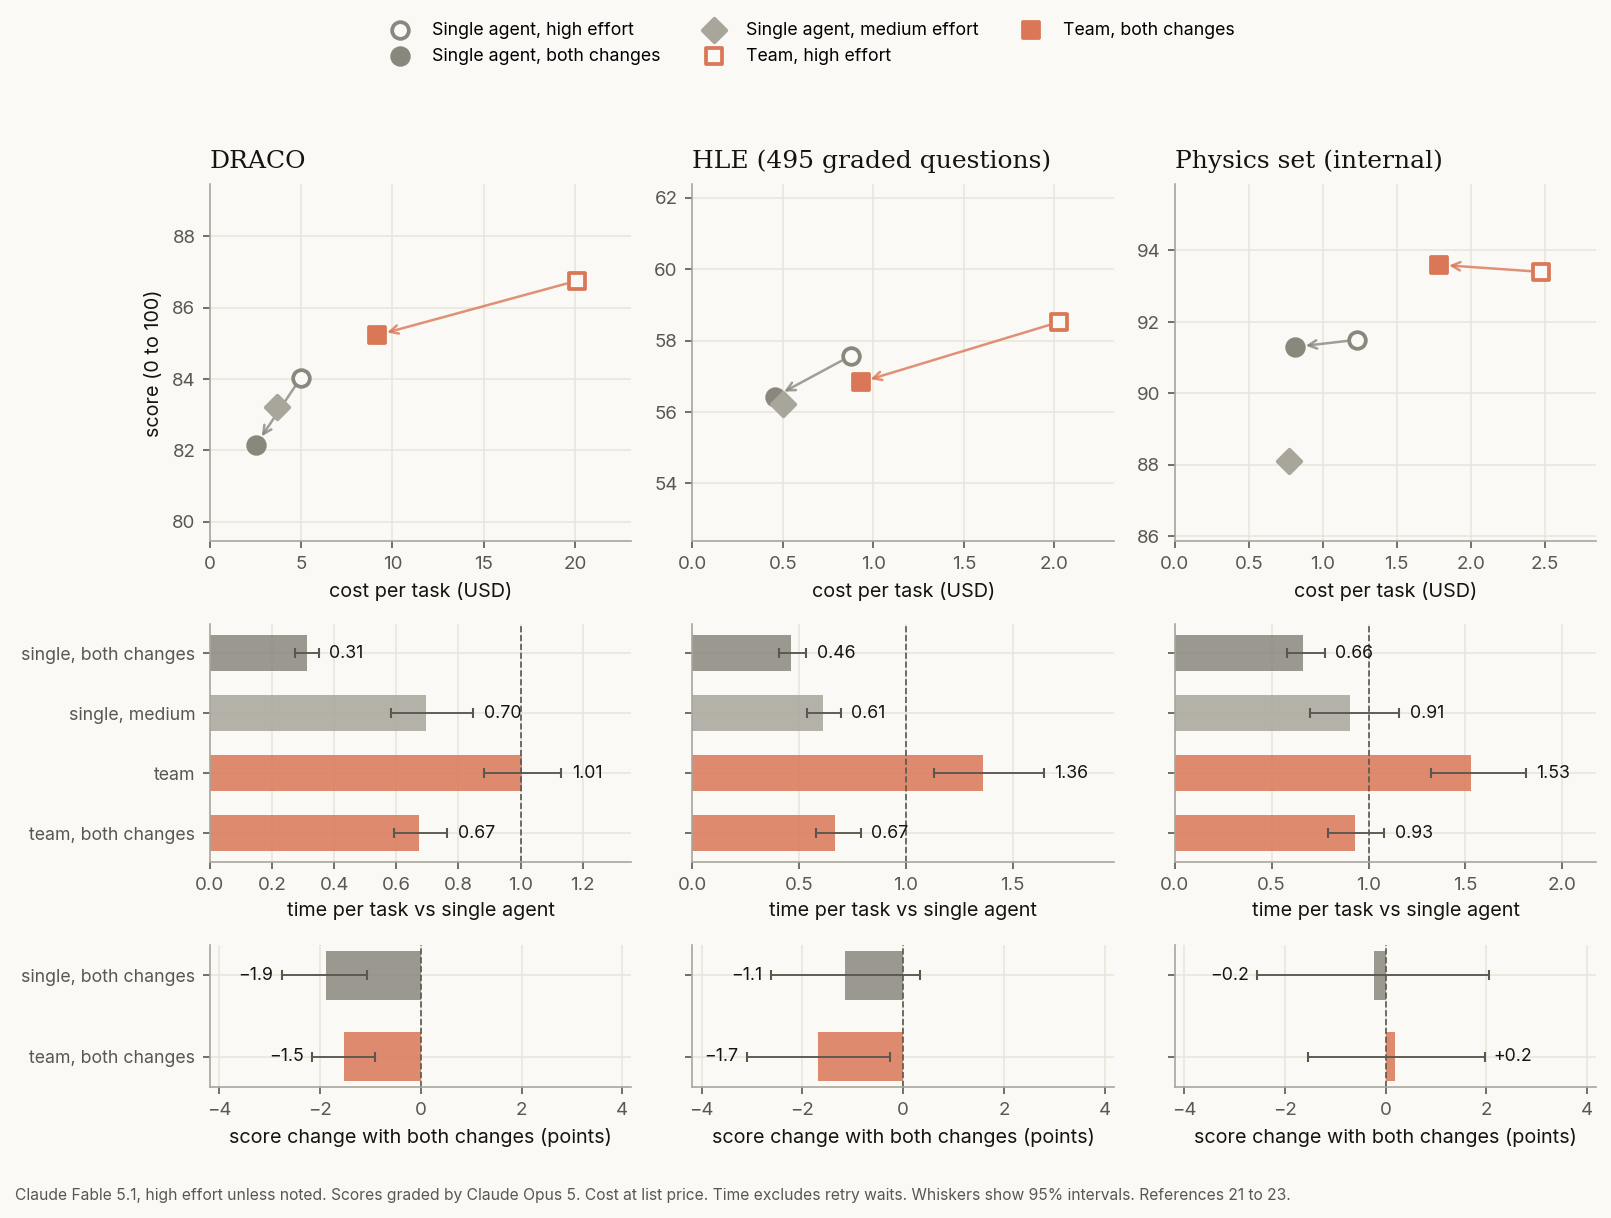
Con un equipo de agentes. Un equipo hace más trabajo que un solo agente, así que, de forma predeterminada, cuesta más. En DRACO, el equipo costó 4.0 veces lo que el agente único y tardó aproximadamente lo mismo (intervalo del 95%: de un 12% menos a un 13% más). Con la instrucción y el reloj en cada agente, el equipo terminó en un 33% menos de tiempo con un costo por tarea un 54% menor. Su puntuación fue 1.5 puntos más baja (intervalo del 95%: de 0.9 a 2.1 más baja), y el extremo lejano de ese intervalo, 2.1 puntos más baja, supera el margen de 1.5 puntos. En HLE, el equipo terminó en un 51% menos de tiempo con un costo por tarea un 54% menor. Su puntuación fue 1.7 puntos más baja (intervalo del 95%: de 0.3 a 3.1 más baja), y el extremo lejano de ese intervalo, 3.1 puntos más baja, supera el margen de 2.5 puntos. En el conjunto de física23, el equipo terminó en un 39% menos de tiempo. Su costo por tarea fue un 28% menor, y ese ahorro depende de la frecuencia con la que la caché de prompts expiró entre solicitudes. Sin expiración, sería del 23%. Su puntuación fue 0.2 puntos más alta (intervalo del 95%: de 1.5 más baja a 2.0 más alta).
En DRACO, el agente principal inició una mediana de 4 auxiliares por intento, así que el resultado de DRACO muestra a un equipo trabajando en paralelo. En HLE y en el conjunto de física, el agente principal inició una mediana de 0 auxiliares, así que al menos la mitad de esas ejecuciones de equipo tuvieron solo al agente principal. Esos resultados de equipo muestran principalmente el comportamiento propio del agente principal, no el efecto de los auxiliares en paralelo.
Con un solo agente. En el conjunto de física23, los mismos cambios redujeron el tiempo de un agente único en un 34% y su costo por tarea en un 34%. Su puntuación fue 0.2 puntos más baja (intervalo del 95%: de 2.5 más baja a 2.1 más alta). En el conjunto de física, un nivel de esfuerzo más bajo ahorró costo, pero no claramente tiempo. Con esfuerzo medium, el agente único costó un 37% menos por tarea que con high, y su tiempo fue un 9% menor (intervalo del 95%: de un 30% menos a un 16% más). Obtuvo 3.4 puntos menos (intervalo del 95%: de 0.4 a 6.8 menos), y el intervalo llega cerca de cero. Con ambos cambios y esfuerzo high, el agente único tardó un 27% menos que con esfuerzo medium (intervalo del 95%: de un 5% menos a un 44% menos). Su costo por tarea fue un 6% mayor (intervalo del 95%: de un 12% menos a un 27% más), y su puntuación fue 3.2 puntos más alta (intervalo del 95%: de 0.1 más baja a 6.5 más alta).
En HLE, los mismos cambios redujeron el tiempo de un agente único en un 54% y su costo por tarea en un 48%. Su puntuación fue 1.1 puntos más baja (intervalo del 95%: de 2.6 más baja a 0.3 más alta), y el extremo lejano de ese intervalo, 2.6 puntos más baja, supera apenas el margen de 2.5 puntos. Con esfuerzo medium, el agente único costó un 43% menos por tarea que con high, tardó un 39% menos y obtuvo 1.3 puntos menos (intervalo del 95%: de 2.8 más baja a 0.1 más alta). Con ambos cambios y esfuerzo high, el agente único tardó un 25% menos que con esfuerzo medium (intervalo del 95%: de un 12% menos a un 35% menos). Su costo por tarea fue un 9% menor (intervalo del 95%: de un 21% menos a un 6% más), y su puntuación fue 0.2 puntos más alta (intervalo del 95%: de 1.3 más baja a 1.7 más alta).
En DRACO, los mismos cambios redujeron el tiempo de un agente único en un 69% y su costo por tarea en un 49%. Su puntuación fue 1.9 puntos más baja (intervalo del 95%: de 1.1 a 2.8 más baja), y el extremo lejano de ese intervalo, 2.8 puntos más baja, supera el margen de 1.5 puntos. Con esfuerzo medium, el agente único costó un 25% menos por tarea que con high, tardó un 30% menos y obtuvo 0.7 puntos menos (intervalo del 95%: de 0.1 a 1.3 menos). Con ambos cambios y esfuerzo high, el agente único tardó un 53% menos que con esfuerzo medium (intervalo del 95%: de un 42% menos a un 63% menos), y su costo por tarea fue un 31% menor (intervalo del 95%: de un 28% menos a un 35% menos). Su puntuación fue 1.2 puntos más baja (intervalo del 95%: de 0.5 a 1.9 más baja), y el extremo lejano de ese intervalo, 1.9 puntos más baja, supera el margen de 1.5 puntos.
En los tres conjuntos, ambos cambios con esfuerzo high ahorraron más tiempo que el esfuerzo medium. En HLE y en el conjunto de física no hubo una diferencia clara en el costo, y en DRACO el costo fue menor. La puntuación fue aproximadamente la misma en HLE. En el conjunto de física fue 3.2 puntos más alta, pero ese intervalo incluye el cero, así que la diferencia no es clara. Por lo tanto, para un agente único, el reloj ahorra más tiempo que un nivel de esfuerzo más bajo. Sin embargo, en DRACO, el agente único con ambos cambios obtuvo 1.2 puntos menos que con esfuerzo medium (intervalo del 95%: de 0.5 a 1.9 menos).
Cuándo usarlo.
- Usa ambos cambios cuando el tiempo de un agente importe y un pequeño cambio en la puntuación sea aceptable. En todas las configuraciones medidas, redujeron el tiempo y el costo por tarea, tanto para equipos como para agentes únicos.
- Verifica la puntuación en tus propias tareas antes de adoptarlos. En DRACO, la puntuación fue 1.5 puntos más baja para un equipo y 1.9 puntos más baja para un agente único. En HLE, fue 1.7 puntos más baja para un equipo y 1.1 puntos más baja para un agente único. En el conjunto de física, ningún cambio de puntuación fue claramente distinto de cero.
- Si ya estás pensando en un nivel de esfuerzo más bajo para ahorrar tiempo, compáralo con el reloj. Un agente único con ambos cambios y esfuerzo
hightardó menos que con esfuerzomedium: un 53% menos en DRACO, un 25% menos en HLE y un 27% menos en el conjunto de física. Su costo por tarea fue un 31% menor en DRACO, sin una diferencia clara en HLE ni en el conjunto de física.
Cómo agregarlo. Coloca esta instrucción al inicio de la indicación del sistema de cada agente:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.La segunda oración le indica al modelo que existen los mensajes de reloj. La primera solicitud no lleva reloj, y las ejecuciones medidas usaron exactamente esta redacción.
Luego, antes de cada solicitud posterior a la primera de un agente, agrega un mensaje del sistema a mitad de la conversación que indique el tiempo transcurrido en segundos enteros, como Elapsed time: 412 seconds. Cuenta desde el inicio de la tarea, no desde el inicio del agente. En un equipo, todos los agentes leen el mismo reloj, así que el primer reloj que ve un auxiliar ya cuenta el tiempo que el equipo dedicó antes de que el auxiliar empezara. En un bucle de herramientas, coloca el mensaje justo después del mensaje user que lleva los resultados de las herramientas, como muestra Ubicación después de los resultados de herramientas. Si en cambio le envías al agente un nuevo mensaje user, coloca el reloj después de ese mensaje.
Deja los mensajes de reloj anteriores donde están. Cada uno pasa a formar parte del historial de la conversación, así que el prefijo en caché sigue coincidiendo en la siguiente solicitud (consulta Combinación con el almacenamiento en caché de prompts). Anthropic midió estos mensajes del sistema simples, que permanecen visibles para el modelo. Un mensaje del sistema con alcance de turno le mostraría al modelo solo el reloj más reciente, y Anthropic no midió esa forma.
El siguiente ejemplo ejecuta el bucle de herramientas de un agente con ambos cambios. Agrega el reloj después de los resultados de las herramientas y solo maneja herramientas de cliente:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # Segundos de reloj real, para que los auxiliares en otros procesos puedan compartir la hora de inicio del líder.
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # Usa streaming porque un límite de 128,000 tokens es demasiado grande para una solicitud sin streaming.
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # Un mensaje del sistema debe ir después de un turno del usuario, así que el reloj va después de los resultados de las herramientas.
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 admite mensajes del sistema a mitad de la conversación. La lista de modelos compatibles cubre los demás. En un modelo que no los admite, como Claude Sonnet 5, puedes colocar la misma línea en un bloque de texto después del último bloque tool_result en el turno user. Anthropic midió solo la forma de mensaje del sistema.
En Claude Managed Agents, puedes enviar un evento system.message con un resultado de herramienta o un mensaje de usuario. El mensaje se aplica a ese turno y a todos los turnos posteriores. Por eso, los turnos que siguen a las herramientas integradas de la plataforma, como la búsqueda web, ven el último reloj que enviaste, no la hora actual. Un system.message también llega solo al hilo principal de la sesión. En una sesión multiagente, ese es el hilo del coordinador, así que los agentes trabajadores nunca ven un reloj que envíes de esta manera. Para mostrar la hora actual antes de cada turno, y a cada agente de un equipo, ejecuta tú mismo el bucle del agente en la Messages API.
Combina modelos
Las arquitecturas multimodelo se adaptan a cargas de trabajo cuya complejidad de tareas varía lo suficiente como para que distintos pasos se atiendan mejor con distintos modelos. Cuando tu tráfico mezcla trabajo rutinario que un modelo más pequeño maneja de forma confiable con pasos más difíciles que necesitan capacidad de frontera, dividir el trabajo mantiene la inteligencia de frontera donde importa mientras la mayoría de los tokens se facturan a tarifas de modelo más pequeño. Cuando una carga de trabajo carece de esa mezcla, porque su dificultad es uniforme o es una sola cadena dependiente, un único modelo bien ajustado suele ser la mejor opción. Cada sección de estrategia da la regla para distinguir los dos casos.
Dos estrategias cubren la mayoría de las cargas de trabajo, y difieren en qué modelo sostiene el bucle principal:
| Estrategia | Flujo de control | Rol del modelo de frontera | Se adapta a | El costo de frontera escala con |
|---|---|---|---|---|
| Asesor | El modelo más pequeño ejecuta el bucle, escala bajo demanda | Consultado para planes y correcciones | Trabajo en serie que es difícil en algunos puntos, como los muchos turnos de un agente de programación entre unas pocas decisiones reales | Con qué frecuencia se atasca el ejecutor |
| Orquestador | El modelo de frontera ejecuta el bucle, delega el trabajo masivo | Planifica, despacha y sintetiza | Trabajo que se ramifica en archivos, documentos o casos genuinamente independientes, especialmente más de una ventana de contexto de ello | Qué tan difíciles son de coordinar las piezas |
Estrategia de asesor: escala las decisiones difíciles
En la estrategia de asesor, un modelo ejecutor de menor costo ejecuta el bucle del agente y realiza la mayoría de los turnos. Cuando llega a una decisión que requiere un juicio más profundo, como elegir un enfoque o recuperarse de un fallo, llama a un modelo asesor de mayor inteligencia para obtener orientación estratégica y luego continúa. La mayoría de los tokens se facturan a tarifas del ejecutor, y solo las consultas ocasionales a tarifas del asesor.
Para usarla, agrega la "advisor tool" (herramienta de asesor) a tu solicitud. Esta función beta ejecuta toda la estrategia del lado del servidor en una sola solicitud /v1/messages. El ejecutor emite una llamada a herramienta, Anthropic ejecuta la inferencia del asesor y el ejecutor continúa con el consejo; no escribes código de orquestación. En Claude Managed Agents, dale un asesor a la sesión agregando una entrada advisor a la lista multiagent del agente; el hilo principal de la sesión lo consulta de la misma manera. Claude Code también lo admite; consulta escalar decisiones difíciles con la herramienta de asesor.
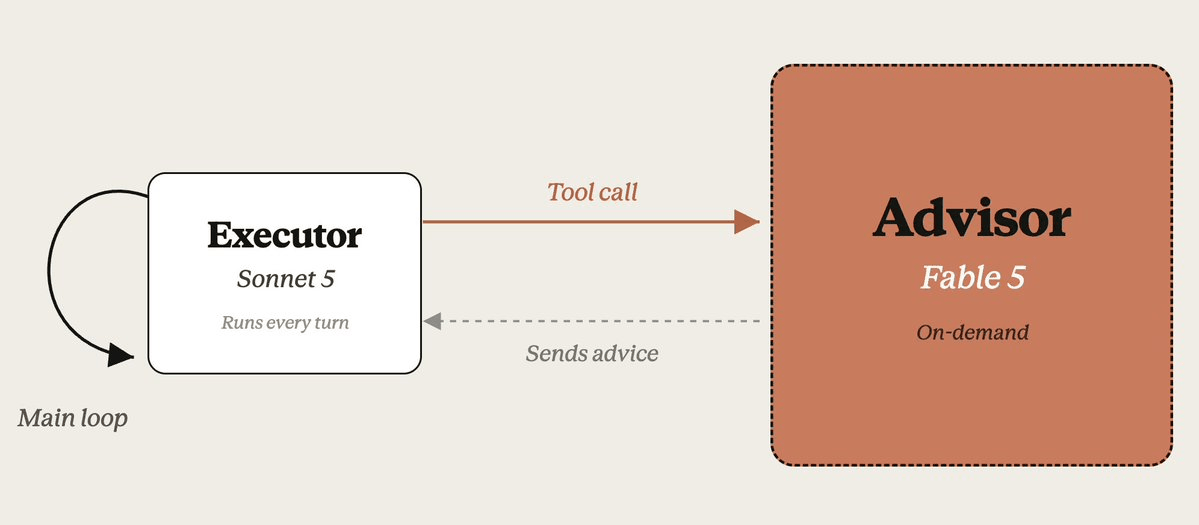
Qué determina el beneficio. El asesor ve la tarea solo a través de las llamadas del ejecutor, así que dos factores deciden cuánto ayuda.
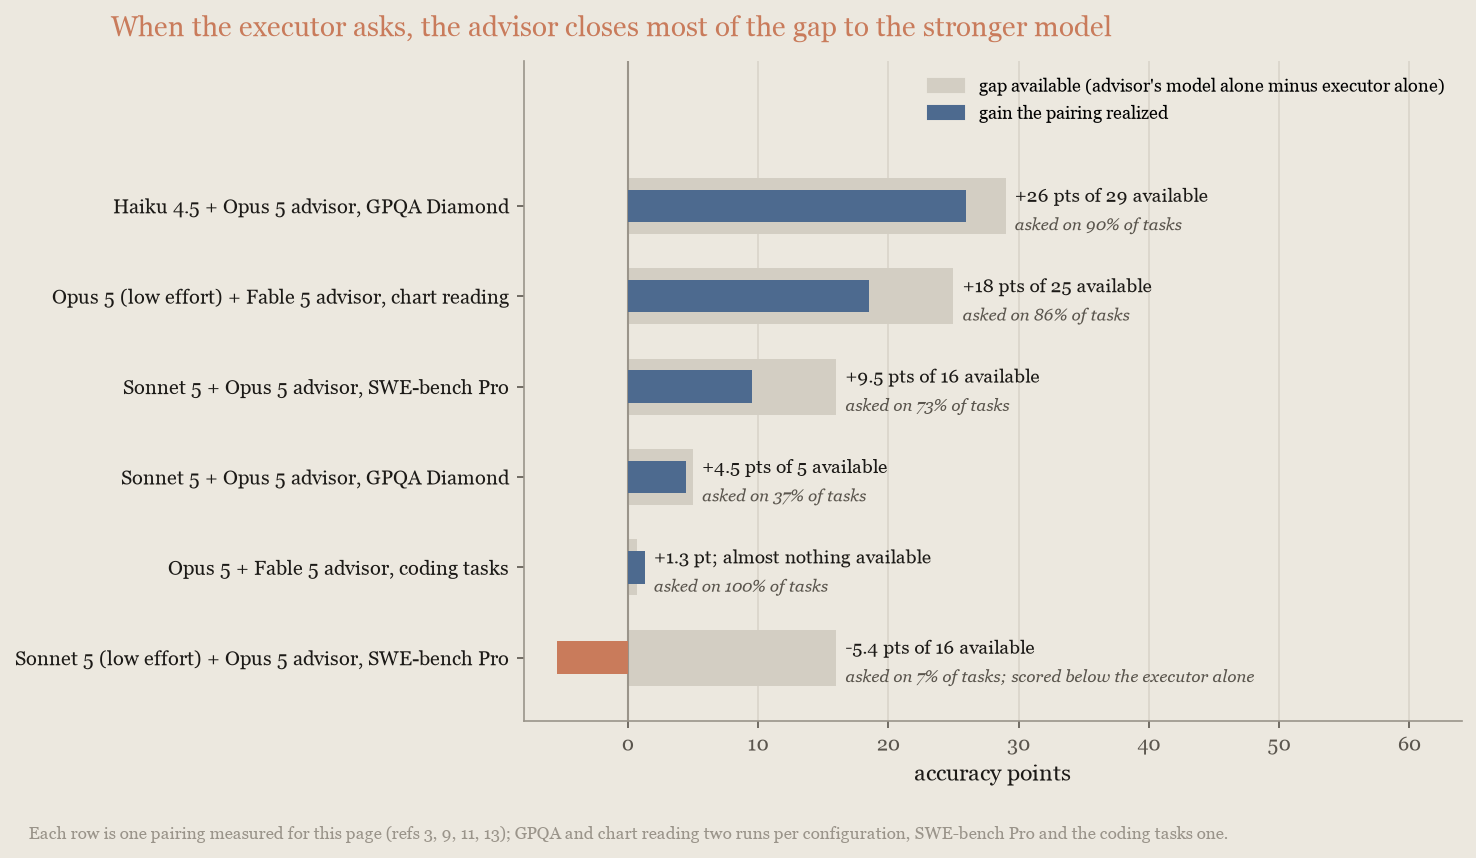
El primero es la brecha entre los modelos. El asesor solo puede aportar la capacidad que le falta al ejecutor. En GPQA Diamond9, un ejecutor Claude Haiku 4.5 ganó mucho con un asesor Claude Opus 5, un ejecutor Claude Sonnet 5 ganó unos pocos puntos y un ejecutor de frontera casi nada.
El segundo, y el más frágil, es si el ejecutor realmente pregunta: la "consult rate" (tasa de consulta). Un ejecutor con esfuerzo bajo puede dejar de detectar que está atascado. Un emparejamiento que consulta en la mayoría de las tareas con el esfuerzo predeterminado puede pasar a no consultar en casi ninguna cuando se reduce el esfuerzo, y entonces obtiene una puntuación inferior a la del ejecutor solo. La tasa también varía según la tarea. En DeepSWE10, un ejecutor Sonnet 5 con esfuerzo bajo siguió preguntando y ganó 23 puntos; en SWE-bench Pro3, el mismo ejecutor dejó de hacerlo. Cuando el ejecutor sí pregunta, recupera gran parte de la brecha. En los emparejamientos del siguiente gráfico cuyo ejecutor siguió preguntando, el asesor cerró al menos la mitad de la brecha con el modelo más fuerte (el emparejamiento de programación superó directamente al modelo más fuerte). Además, pagas el modelo más fuerte solo en las consultas, y eso es lo que hace posibles los casos de ahorro:
La tasa de consulta responde a las instrucciones del prompt. Con solo la descripción integrada de la herramienta, los ejecutores la llaman poco, especialmente en trabajo de programación. Por eso, la documentación de la herramienta de asesor ofrece una indicación del sistema que pide una llamada antes del trabajo sustancial y otra antes de terminar, unas dos o tres llamadas por tarea. El emparejamiento de programación que se mide a continuación funcionó con esa cadencia con Claude Opus 5 como ejecutor, con unas dos consultas en cada tarea. Con Claude Opus 5.5 como ejecutor, pidió consejo unas 1.4 veces por intento, y el 4% de sus intentos no recibió ningún consejo. Esa página también explica cómo incentivar a un ejecutor que llama poco y cómo limitar las llamadas del lado del cliente para acotar el costo. Así que vigila la tasa de consulta: pídela en el prompt, mídela y restablece el esfuerzo del ejecutor si se desploma.
Cuándo compensa en costo. Un asesor ahorra dinero cuando unas pocas consultas breves, facturadas a la tarifa del asesor, reemplazan la ejecución del modelo del asesor durante toda la tarea. Esto funciona mejor cuando el modelo del asesor tiene un precio muy superior al del ejecutor, así que la configuración más rentable es un asesor de frontera sobre un ejecutor de nivel medio. Un emparejamiento en la parte alta del rango puede recuperar parte del costo del consejo, porque el consejo también ahorra tokens del ejecutor: un ejecutor al que se le indica el enfoque correcto explora menos callejones sin salida. En el emparejamiento de programación que se describe a continuación, con un ejecutor Claude Opus 5, ese ahorro pagó aproximadamente la mitad del consejo. El ejecutor gastó $1.26 menos por intento que Opus 5 solo con su valor predeterminado, y las consultas costaron $2.47. Con un ejecutor Claude Opus 5.5, el consejo casi no ahorró costo del ejecutor: $1.36 por intento frente a $1.38 de Opus 5.5 solo con high, mientras que las consultas costaron $1.55.
En un benchmark interno de programación agéntica11, ejecutado con un agente simple de la API, un ejecutor Claude Opus 5.5 con high y un asesor Claude Fable 5.1 obtuvo un 90.1% a $2.92 por intento. Eso son 1.7 puntos más que Opus 5.5 solo con high, la propia configuración del ejecutor, por aproximadamente 2.1 veces el dinero. Esa brecha está en el límite del ruido entre ejecuciones, con cinco intentos por tarea. Frente a Opus 5.5 con su valor predeterminado, medium, son 3.5 puntos por aproximadamente 3.5 veces el dinero. El resultado cae aproximadamente sobre la propia curva de esfuerzo de Opus 5.5, así que el asesor compra más o menos lo mismo que un mayor esfuerzo: Opus 5.5 solo con xhigh obtuvo un 91.1% por $4.11 por intento (un intento por tarea). En agosto, un asesor Claude Fable 5.1 sobre un ejecutor Claude Opus 5 fue la configuración más precisa medida, a $6.21 por intento, un poco más del doble de lo que cuesta el emparejamiento con Opus 5.5. El gráfico representa el emparejamiento con Opus 5.5 frente a la propia curva de esfuerzo de Opus 5.5 y la de Claude Fable 5.1 de agosto:
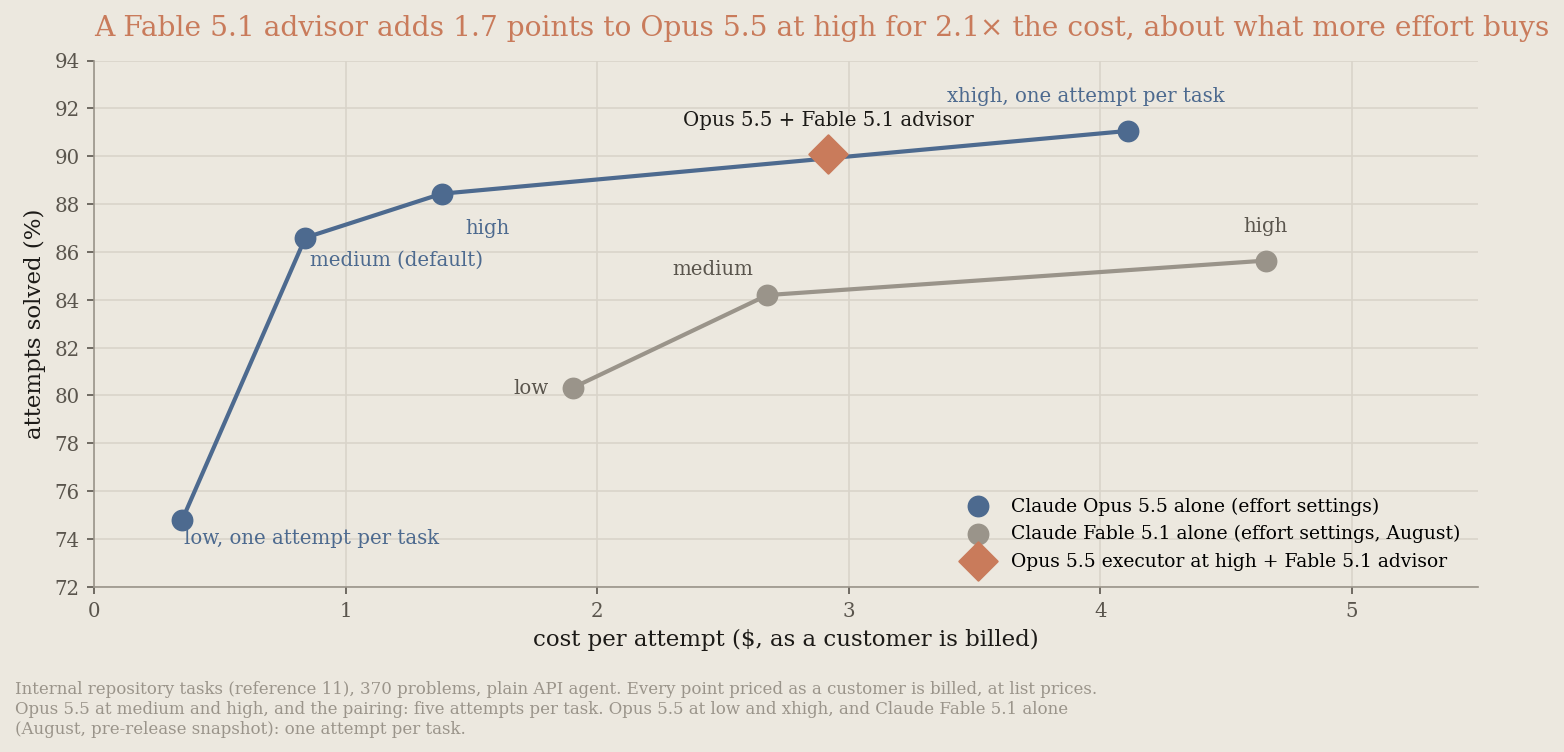
Una medición anterior a través del modo asesor de Claude Code también situó su emparejamiento de asesor por encima de cada uno de sus modelos por separado. Interpreta el resultado de Claude Opus 5.5 como un patrón que debes probar en tu carga de trabajo: el asesor compra unos pocos puntos por aproximadamente el doble de lo que cuesta el ejecutor solo. Una brecha de capacidad más amplia no garantiza un mejor trato. El costo en latencia son las propias consultas: aproximadamente una o dos llamadas adicionales al modelo de frontera por tarea en este benchmark, cada una en la ruta crítica de la tarea.
Cuándo el modelo más fuerte por sí solo es el mejor paso. Cuando la precisión de una carga de trabajo responde al esfuerzo, compara el emparejamiento con el modelo del asesor solo, con una configuración reducida, antes de construirlo. El asesor se paga solo en las tareas que lo necesitan, pero una consulta que se activa en la mayoría de las tareas cuesta más que ejecutar el propio modelo más fuerte. En Chartography13, un ejecutor Claude Opus 5.5 con low y un asesor Claude Fable 5.1 lo consultó en 1 de 300 tareas. Obtuvo 61.7, 7 puntos por debajo de Opus 5.5 solo y más allá del ruido entre ejecuciones, con aproximadamente el mismo costo. En agosto, un ejecutor Claude Opus 5 consultó en casi todas las tareas. Ese emparejamiento igualó a Fable 5.1 solo con medium dentro del ruido entre ejecuciones (65.0 frente a 67.5), a aproximadamente 1.8 veces el costo por tarea. Mide primero tu propia tasa de consulta. Si el ejecutor pregunta en la mayoría de sus tareas, estás pagando tarifas de asesor en toda la carga de trabajo, y ejecutar el propio modelo del asesor es la forma más barata de obtener la misma puntuación.
Sea cual sea el emparejamiento, primero calcula el precio del modelo del asesor solo con esfuerzo bajo; esa es la línea base que debes superar. Vuelve a verificarlo con cada lanzamiento de modelo, porque los lanzamientos cambian tanto la brecha de capacidad como la relación de precios.
Cuándo es adecuada. La estrategia de asesor es adecuada para cargas de trabajo en las que los turnos son mayormente mecánicos, pero un plan excelente importa: agentes de programación, uso de computadora y pipelines de investigación de varios pasos. Es poco adecuada cuando cada turno realmente necesita capacidad de frontera, cuando no hay nada que planificar (preguntas y respuestas de un solo turno) o cuando tu ejecutor ya está cerca de la capacidad del asesor.
Estrategia de orquestador: delega el trabajo masivo
En la estrategia de "orchestrator" (orquestador), el modelo de frontera controla el bucle. Descompone la tarea, envía subtareas a "worker models" (modelos trabajadores) de menor costo y combina sus resultados. La transcripción del propio orquestador se mantiene corta porque los trabajadores absorben la exploración que consume muchos tokens, así que la mayoría de los tokens se facturan a las tarifas de los trabajadores, mientras que el plan y la síntesis siguen viniendo del modelo de frontera.
Para construir uno, usa la orquestación multiagente en Claude Managed Agents: configura un agente coordinador (el orquestador) y un conjunto de agentes trabajadores, cada uno con su propio modelo. Para ver un ejemplo completo y funcional con un coordinador de frontera y trabajadores Claude Sonnet 5, consulta la receta del Claude Cookbook Coordinator pattern: big models for planning, small models for execution.
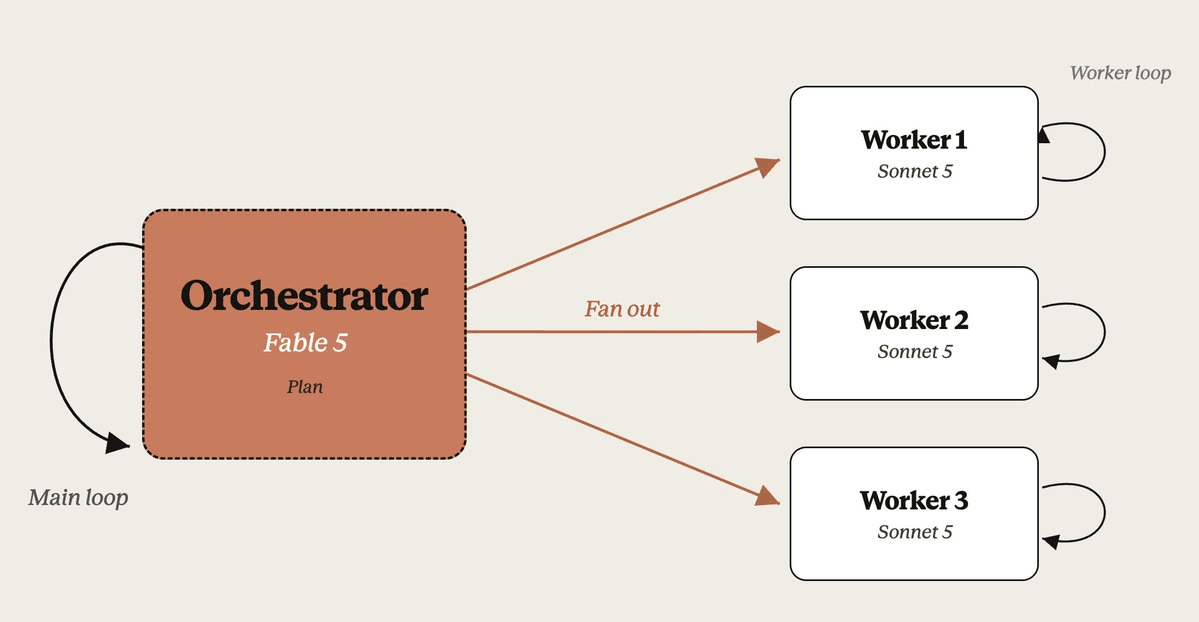
Este patrón ahorra tiempo real transcurrido cuando los trabajadores pueden ejecutarse en paralelo: en el benchmark del corpus8, un episodio tardó unas 2.3 horas con el coordinador ejecutando el límite documentado de la plataforma de 25 trabajadores concurrentes, frente a 15 a 20 horas en solitario. Ahorró dinero solo en dos situaciones medidas. En trabajo que un solo modelo podía manejar por sí mismo, el mismo modelo con menor esfuerzo fue más barato en todos los casos.
Cuando los trabajadores se ejecutan en paralelo, una instrucción de tiempo y un reloj de tiempo transcurrido pueden acortar la ejecución. En DRACO21, un equipo de agentes del mismo modelo con la instrucción y el reloj terminó en un 33% menos de tiempo con un costo por tarea un 54% menor, y obtuvo 1.5 puntos menos. Todos los agentes de ese equipo tenían la instrucción y el reloj. Anthropic no midió el reloj con trabajadores de menor costo. En Claude Managed Agents, el reloj llega solo al coordinador, por lo que los trabajadores nunca lo ven. Anthropic no midió un equipo en el que solo el coordinador tenga el reloj. Además, el reloj del coordinador solo está actualizado en los turnos que siguen a tus propios resultados de herramientas o mensajes. Muestra al modelo el tiempo transcurrido tiene la receta para un bucle de agente que ejecutas en la Messages API.
Caso 1: un seguro contra la cola de costos en el trabajo rutinario. Un modelo de frontera que trabaja solo ocasionalmente entra en espiral en un problema rutinario que normalmente resolvería. Como no puedes saber de antemano cuáles serán, unas pocas ejecuciones de ese tipo dominan la factura. Un coordinador que entrega el trabajo rutinario a un trabajador de menor costo limita esa cola, porque cualquier espiral ahora ocurre a las tarifas del trabajador.
Anthropic midió esto en una porción deliberadamente fácil de BrowseComp4 (10 problemas que el modelo en solitario resuelve de forma confiable; 50 ejecuciones delegadas y 70 en solitario). Un coordinador Claude Fable 5 con un trabajador Claude Sonnet 5 costó aproximadamente la mitad que Claude Fable 5 solo en promedio y aproximadamente un tercio en el percentil 90 ($12 frente a $33), y la ejecución individual más cara del modelo en solitario, de $84, además fue incorrecta:
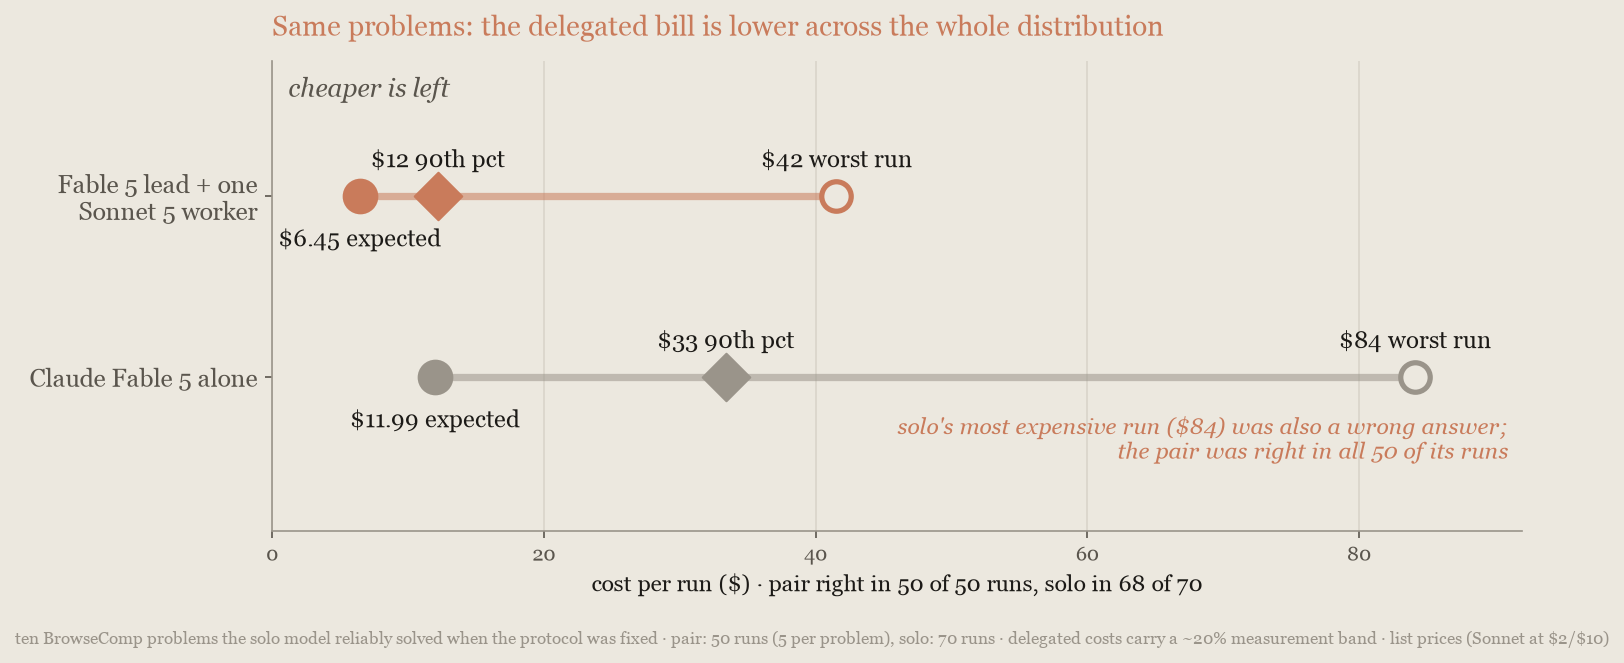
La delegación resultó rentable en la parte rutinaria y normalmente resoluble del trabajo, lo contrario de la intuición de que los trabajadores son para los problemas difíciles. En el conjunto completo y más difícil de BrowseComp, la economía se invirtió. Si tu tráfico tiene una cola de costos larga en tareas rutinarias, este es el caso de orquestador que debes medir primero.
Caso 2: trabajo más grande que una ventana de contexto. Un modelo en solitario debe procesar una entrada así de grande en serie, una ventana de contexto a la vez, pagando por volver a leer su propio estado en cada pasada. Cada trabajador lee su propia partición, en paralelo y a tarifas de trabajador. El trabajo con mucha lectura que aún cabe en una ventana de contexto es un problema de elección de modelo, no de delegación: solo en costo de lectura, el orquestador sale ganando únicamente cuando ningún contexto individual puede contener el trabajo.
Anthropic construyó un benchmark para este caso8: un corpus de 21.6 millones de tokens de 14 paquetes públicos de Python con 130 defectos plantados, demasiado grande para cualquier ventana de contexto. Reducir el esfuerzo no puede ayudar, porque la factura es la propia lectura del corpus: Claude Fable 5.1 en solitario costó de $468 a $552 por episodio en los tres ajustes de esfuerzo, y solo su precisión cambió. La configuración de coordinador, un líder Claude Fable 5.1 sobre 25 trabajadores Claude Sonnet 5, costó aproximadamente la mitad que esos ajustes (entre un 47% y un 55% menos) y obtuvo entre 10 y 12 puntos menos que ellos, en unas 2.3 horas por episodio frente a 15 a 20, mientras superaba claramente una línea base de Claude Sonnet 5 en solitario:
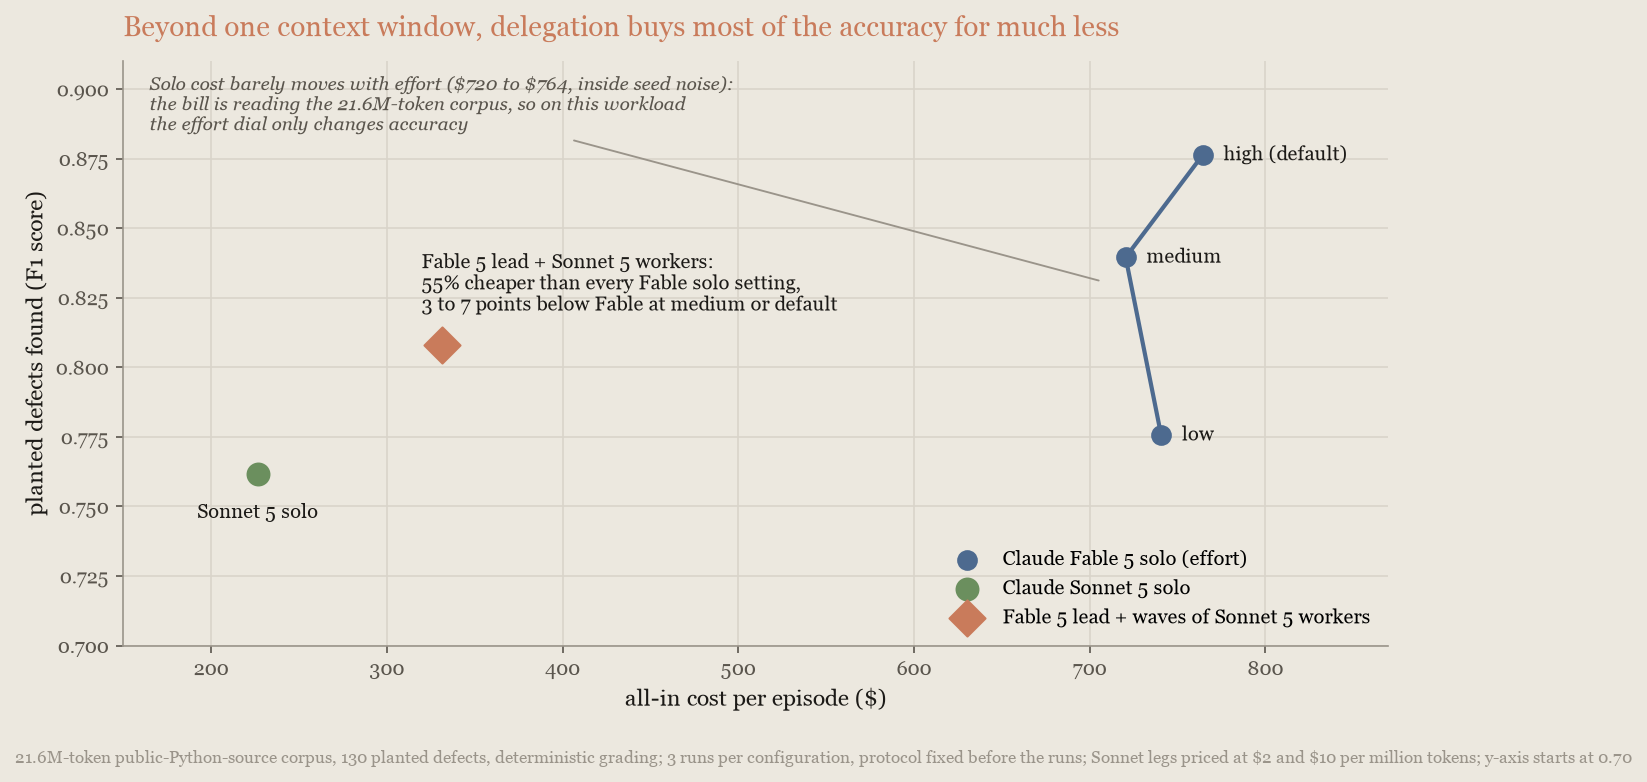
La contabilidad de tokens muestra la escala de la lectura: la configuración de coordinador leyó unos 560 millones de tokens en caché por episodio, aproximadamente una vez y media los cerca de 365 millones del modelo en solitario, casi todos a la tarifa de lectura de caché de Claude Sonnet 5, y aun así costó aproximadamente la mitad en total. Fable 5.1 con esfuerzo high sigue teniendo la máxima precisión, a unas 2.2 veces el costo de la configuración de coordinador, así que aquí la delegación compra la mayor parte de la precisión, no toda.
Cuándo la delegación no compensa. Un orquestador aporta algo solo cuando hay trabajo masivo que entregar: muchas piezas independientes, idealmente demasiadas para una ventana de contexto. Cuando el trabajo es una única cadena dependiente, o cabe en un solo contexto, el orquestador paga por un plan, una entrega y una combinación que un solo modelo obtiene gratis. En todos los casos de este tipo que se midieron, el modelo del coordinador solo con menor esfuerzo salió ganando.
El límite es la dificultad de la tarea, no el benchmark: en el conjunto completo y más difícil de BrowseComp4, Claude Fable 5 solo alcanzó la precisión de la configuración de coordinador con un costo entre un 22% y un 30% menor. Trabajos externos independientes reportan el mismo patrón5. Si el trabajo es una sola cadena, cabe en un contexto sin una cola de costos larga, o un solo modelo con menor esfuerzo ya cumple tu estándar, no construyas un orquestador.
Elige entre las estrategias
La mayoría de los casos se reducen a una pregunta: ¿el trabajo se divide en piezas independientes, o es una sola respuesta alcanzada a través de una cadena de pasos dependientes? La tabla de estrategias asigna las dos respuestas a las dos estrategias.
Si no estás seguro, no construyas nada todavía:
- Barre primero el esfuerzo en tu modelo actual. Es el experimento más barato de esta página, y la mayoría de las cargas de trabajo terminan ahí.
- Si el barrido muestra una brecha, calcula el precio del modelo más fuerte solo con esfuerzo bajo. Ese es el número que un emparejamiento de asesor tiene que superar, y los emparejamientos de esta página que lo superaron fueron aquellos cuyo ejecutor realmente consultó.
Los resultados multimodelo de esta página se juzgaron frente al mismo modelo con menor esfuerzo y frente al siguiente modelo inferior ejecutándose solo. Esa es la comparación que debes ejecutar en tu propia carga de trabajo, y la razón por la que el primer paso es un barrido de esfuerzo.
Cuando sí añades un asesor, es una definición de herramienta en lugar de una rearquitectura.
Mide en tu propia carga de trabajo
Las cifras de esta página reflejan los precios de lista en el momento de la medición y variarán a medida que cambien los modelos y los precios. Tu tasa de escalamiento, la limpieza con la que se dividen las tareas y la longitud de la transcripción también las modifican. El método sigue siendo el mismo:
- Toma algunas tareas de los registros de producción, ponderadas como el tráfico real, y escribe comprobaciones de resultados para cada una: las pruebas pasan, el ticket se cierra, el recuento de filas es correcto. Registra el costo por tarea junto a la puntuación: calcula el precio de los cinco recuentos de tokens con precio en el
usagede cada respuesta a sus propias tarifas (entrada sin caché, escrituras de caché de 5 minutos y de 1 hora a 1.25x y 2x el precio de entrada, lecturas de caché y salida), sumados en todas las solicitudes de la tarea (la API de uso y costos informa el agregado). - Establece una línea base de los niveles de modelo en todos los niveles de esfuerzo, no solo el predeterminado, y grafica la puntuación frente al gasto. Una configuración multimodelo debe superar toda la curva del modelo individual.
- Si la curva muestra una brecha que el esfuerzo no puede cerrar, añade la estrategia multimodelo que encaje y vuelve a ejecutar el conjunto de pruebas.
- Ejecuta la opción ganadora en modo sombra sobre una porción del tráfico antes del cambio definitivo, y luego mantén el conjunto de pruebas en ejecución.
El siguiente ejemplo calcula el costo del paso 1 de una solicitud con los precios de lista de Claude Opus 5.5:
# Precios por millón de tokens de la página de precios; cambia estos tres para otro modelo.
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 0.05x el precio de entrada en Claude Opus 5.5; el multiplicador varía según el modelo
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Escrituras en caché de 1 hora se cobran a 2x el precio de entrada, de 5 min a 1.25x; lecturas al precio de lectura de caché.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
En los bucles de agente, la mayoría de los tokens de entrada deberían ser lecturas de caché; si cache_read_input_tokens es pequeño en comparación con input_tokens más cache_creation_input_tokens, comprueba que el almacenamiento en caché esté activo y que el prefijo se mantenga igual entre solicitudes. Cuando la herramienta advisor o la compactación están habilitadas, algunos tokens se informan solo en usage.iterations y no en los totales de nivel superior, así que suma sobre usage.iterations en su lugar, calculando el precio de las entradas advisor_message a las tarifas del modelo asesor.
La siguiente tabla enumera las palancas en el orden en que conviene probarlas:
| Palanca | Ahorro en estas ejecuciones | Costo en calidad | Latencia | Dónde |
|---|---|---|---|---|
| Almacenamiento en caché de prompts | Costo reducido por un factor de 2.7 a 5.3 en bucles de agente; 83% en la ejecución de triaje | Ninguno | Más rápida | Almacena en caché el contexto repetido |
| Duración de caché de 1 hora | Más barata que la predeterminada de 5 minutos una vez que aproximadamente 1 de cada 20 turnos sigue a una pausa de entre 5 minutos y una hora y pocas pausas superan la hora, excepto en Claude Fable 5.1, donde mantener activa la caché de 5 minutos es más barato mientras las pausas duran minutos y la duración de 1 hora gana cuando las pausas se acercan a una hora, y en Claude Opus 5.5, donde mantener activa la caché de 5 minutos es más barato cuando solo uno o dos turnos de cada 20 siguen a una pausa de hasta aproximadamente media hora; sin pausas, la predeterminada costó un 15% menos en Claude Sonnet 5 y aproximadamente entre un 15% y un 18% menos en Claude Opus 5.5 | Ninguno | Se mantiene activa tras una pausa | Elige la duración de la caché |
| Recorte de la entrada | 5 puntos porcentuales adicionales en la ejecución de triaje | Ninguno | Neutral | Recorta los tokens de entrada y de contexto |
| Eliminar resultados de herramientas obsoletos en los límites de tarea | 39% en la ejecución larga de triaje (compactación 32%); nada en bucles cortos | Ninguno medido | Neutral | Recorta los tokens de entrada y de contexto |
| Búsqueda de herramientas | 45% con 500 definiciones de herramientas adjuntas; 20% con un servidor MCP de GitHub | Ninguno | Neutral | Recorta los tokens de entrada y de contexto |
| Archivos de datos mediante ejecución de código | 92% en una tarea de datos de 25 preguntas | Una mejora, 25 de 25 en lugar de 6 de 25 | Más rápida | Recorta los tokens de entrada y de contexto |
| Batch API | 50% | Ninguno | Resultados en un plazo de 24 horas | Procesa por lotes el trabajo que puede esperar |
| Auditoría de prompts frente al modelo actual | 14% en ambas migraciones medidas | Ninguno; una mejora en una | Más rápida (menos rondas de herramientas) | Audita los prompts contra el modelo actual |
| Actualizar el modelo | De Opus 4.8 a Opus 5: 12 puntos más con un 21% más por tarea resuelta (Opus 5 en low supera a Opus 4.8 por aproximadamente el 30% del costo); de Sonnet 4.6 a Sonnet 5: un 15% menos por tarea resuelta, 5 puntos más; de Fable 5 a Fable 5.1: un 43% menos por tarea resuelta con aproximadamente la misma puntuación | Una mejora | Neutral | Actualiza el modelo |
| Reducir el esfuerzo | Trabajo de conocimiento: medium del 13% al 31%, low de un tercio a la mitad; programación larga: medium alrededor del 30% y low alrededor de dos tercios, ambos frente a high | De 1 a 3 puntos en trabajo de conocimiento, de 2 a 8 en programación larga | Más rápida | Ajusta el esfuerzo |
| Volver a ejecutar los fallos | Alrededor del 40% frente a ejecutar todo en high, con la misma tasa de aprobación o ligeramente mejor | Ninguno | Dos ejecuciones en las tareas que fallan | Vuelve a ejecutar los fallos con mayor esfuerzo |
| Presupuesto de tarea | Del 44% al 58% | De 3 a 6 puntos | Más rápida | Establece presupuestos y límites de salida |
| Pedir respuestas más cortas | 39% de los tokens de salida, 14% del costo en la ejecución de triaje | Ninguno | Más rápida | Establece presupuestos y límites de salida |
Aumentar max_tokens | Ninguno por tarea resuelta, pero se resuelven más tareas | Mejoras de hasta 22 puntos en el conjunto interno; ninguna en el par público | Neutral | Establece presupuestos y límites de salida |
| Asesor | Depende de la brecha de capacidad y de la tasa de consulta; el emparejamiento de programación obtuvo 1.7 puntos más que Claude Opus 5.5 solo en high por aproximadamente 2.1 veces el precio, más o menos lo que compra un mayor esfuerzo; con Claude Opus 5.5, el emparejamiento de lectura de gráficos casi nunca consultó al asesor y obtuvo 7 puntos menos que Opus 5.5 solo | Una mejora en programación, una pérdida en lectura de gráficos | Alrededor de una o dos llamadas adicionales por tarea | Estrategia de asesor |
| Orquestador | Alrededor de la mitad frente al modelo de frontera, tanto más allá de una ventana de contexto como en colas rutinarias (esto último medido en Claude Fable 5) | De 10 a 12 puntos por debajo del modelo de frontera | Mucho más rápida en entradas grandes | Estrategia de orquestador |
Benchmarks referenciados
Salvo que una referencia indique lo contrario, las mediciones son ejecuciones internas de Anthropic de estos benchmarks. Salvo que se indique otra cosa, los costos están en USD a los precios de lista vigentes cuando se ejecutó cada benchmark; las cifras de Claude Sonnet 5 usan $2 y $10 por millón de tokens de entrada y de salida. Los gráficos etiquetados como "notional USD" (USD nocionales) calculan el precio de los recuentos de tokens de cada solicitud a esas tarifas en lugar de reportar facturas.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Tareas amplias de investigación web calificadas según la completitud y la precisión de una tabla de muchas filas; 200 problemas, 3 ejecuciones por configuración, ejecutadas del 1 al 2 de agosto de 2026. El gráfico de concentración de costos corresponde a una ejecución separada de 20 problemas, con 3 ejecuciones por problema, realizada del 3 al 4 de agosto de 2026, y sus costos se calcularon a partir de los registros de facturación por solicitud.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Entregables de trabajo del conocimiento calificados según rúbricas de tareas; una ejecución de 210 tareas del conjunto gold publicado, un intento por tarea, ejecutada el 2 de agosto de 2026. Un modelo Claude actúa como calificador, por lo que las puntuaciones absolutas pueden diferir de los resultados publicados.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Un subconjunto de 482 problemas seleccionado por su compatibilidad con el arnés de evaluación de Anthropic; las puntuaciones no son comparables con la tabla de clasificación pública. Tampoco son comparables con los resultados de SWE-bench Pro de la tarjeta del sistema de Claude Opus 5.5, que provienen de ejecuciones con esfuerzo
maxen un conjunto de problemas diferente. Las cifras de Claude Opus 5.5 promedian dos ejecuciones enlow,medium(su valor predeterminado) yhigh, y usan una ejecución enxhigh. Todas se realizaron del 19 al 20 de septiembre de 2026, con el mismo límite de 16,384 tokens por turno que las ejecuciones de Claude Opus 5 de agosto; el límite cortó 2 intentos enxhighy ninguno en las demás configuraciones. Las ejecuciones de Opus 5.5 usaron una versión del benchmark cuyos contenedores de calificación solo pueden acceder a réplicas internas de paquetes. Esa versión descarta un problema cuya prueba necesita un sitio web activo, y en otros tres la solución de referencia falla en ese entorno. Por eso, las comparaciones de Opus 5.5, y las cifras de Claude Fable 5.1 que se presentan junto a ellas, usan los 478 problemas restantes. Las cifras de SWE-bench Pro de Claude Opus 5 en Actualiza el modelo y en el gráfico de emparejamientos con asesor promedian dos ejecuciones con su esfuerzo predeterminado y usan una ejecución enlow, todas realizadas el 4 de agosto de 2026. Las cifras de escalamiento provienen, tarea por tarea, de las ejecuciones de Opus 5.5: conlowprimero y luegohighen sus fallos, se resolvió entre el 96.4% y el 97.5% según los emparejamientos de ejecuciones, por unos $0.17; conmediumprimero, entre el 96.0% y el 97.1%, por unos $0.24; conhighreejecutado en sus propios fallos, el 96.9%, por $0.31; y con todo enhigh, entre el 94.8% y el 95.8%, por $0.29. Los costos en este subconjunto se calculan tal como se mide el consumo de la organización de un cliente: el prompt previo de cada solicitud cuenta como lectura de caché y sus tokens nuevos como escritura de caché de 5 minutos. Los datos provienen de los propios registros de uso de las ejecuciones y se verificaron contra un libro contable de cliente. La medición propia de la organización de evaluación facturaba, hasta el 10 de septiembre de 2026, las lecturas de caché en bloques de 8,192 tokens para Claude Opus 5, Claude Fable 5, Claude Opus 4.7 y Claude Opus 4.8, y dio cifras entre 1.4 y 1.8 veces más altas para las ejecuciones de esos modelos. Para Claude Fable 5.1, Claude Sonnet 5 y Claude Sonnet 4.6, ambas mediciones difieren como máximo en aproximadamente un 9%, y para las cifras de Claude Opus 5.5 coinciden dentro de un 3% en cada configuración de esfuerzo. Los emparejamientos con Claude Sonnet 5 como ejecutor en el gráfico de asesor provienen de la misma serie de mediciones en este subconjunto: el emparejamiento de Sonnet con Opus 5 se ejecutó dos veces (el 7 y el 8 de agosto de 2026: una ejecución y una réplica exacta), el emparejamiento de esfuerzo bajo se ejecutó una vez (8 de agosto de 2026) y Claude Sonnet 5 en solitario se ejecutó dos veces (77.4%, la línea base para ambas filas de Pro). El punto de Claude Fable 5 en Actualiza el modelo es la media de tres ejecuciones con el esfuerzo predeterminado, realizadas el 26 de agosto de 2026, con costos calculados de la misma manera. Las cifras de presupuesto de tareas de Claude Fable 5.1 corresponden a una ejecución por presupuesto (dos con 35,000 tokens) en el mismo subconjunto y con el esfuerzo predeterminado, realizadas el 26 de agosto de 2026. Como línea base se usó una ejecución sin presupuesto del mismo día (92.1%, $1.10 por tarea). Un conjunto anterior con esfuerzolow, ejecutado el 21 de agosto de 2026, obtuvo un 88.6% sin presupuesto a $0.48 por tarea. La comparación de Compara modelos empareja esa única ejecución con las dos ejecuciones agrupadas de Claude Sonnet 5 del mismo subconjunto. Con el esfuerzo predeterminado de Fable 5.1, la comparación se invierte: Fable 5.1 cuesta un 41% más por tarea resuelta que Sonnet 5. La escalera de actualización consiste en una ejecución por modelo con sus valores predeterminados de lanzamiento (dos para Opus 5 y dos para Sonnet 5, y el punto de Fable 5 descrito arriba). Las ejecuciones de Opus y de Sonnet se realizaron la misma semana, con un mismo arnés y en una misma organización. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Las cifras de esfuerzo usan un corte de 500 problemas, con entre una y tres ejecuciones por configuración, realizadas el 3 de agosto de 2026; el punto predeterminado agrupa dos ejecuciones del 26 al 27 de julio de 2026. El gráfico de seguro de costos usa 10 problemas resueltos de forma confiable, tomados de una porción de 26 problemas. Incluye 50 ejecuciones delegadas (del 1 al 2 de agosto de 2026) y 70 ejecuciones en solitario (50 del 2 al 3 de agosto de 2026 y 20 archivadas del 12 al 13 de julio y del 1 de agosto de 2026). El costo esperado es de $6.45 frente a $11.99 por ejecución; las cifras delegadas tienen una banda de medición de aproximadamente un 20%.
- Escalado de arquitecturas de agentes: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Estudio externo independiente, citado solo por la dirección de su hallazgo sobre cuándo no compensa delegar, no por ninguna cifra.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. Las 220 preguntas abarcan 15 dominios, y cada una combina la recopilación de muchas filas con la recuperación de múltiples saltos. Se midió en el conjunto de filas vigente del benchmark, con 3 ejecuciones por configuración, realizadas el 2 de agosto de 2026 (el punto del equipo de un solo trabajador se ejecutó del 26 al 27 de julio de 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Sus 132 tareas de investigación en 22 dominios se califican según rúbricas binarias derivadas de expertos. Se midió en un subconjunto de 50 tareas estratificado en todos los temas, con un intento por tarea y 3 ejecuciones por configuración, en Claude Managed Agents con las herramientas propias de búsqueda web y de obtención de la plataforma (del 26 al 27 de agosto de 2026). La puntuación se calculó sobre las 33 tareas que ninguna configuración rechazó, y se eliminaron los intentos que los clasificadores de seguridad de producción interrumpieron. Los costos son lo que se le factura a un cliente: las solicitudes de la plataforma más las tarifas de búsqueda web. Las puntuaciones son la media de cada modelo sobre la base de 33 tareas, sin las tareas que se le interrumpieron a ese modelo. En las 21 tareas sin interrupciones en ningún brazo, Claude Fable 5.1 mantiene una ventaja de 2 a 3 puntos sobre Claude Fable 5 en cada nivel de esfuerzo, y ninguno de los dos modelos varía entre niveles de esfuerzo. El gráfico de caché recalcula el precio de las mismas solicitudes con cada token de entrada a la tarifa sin caché. Claude Opus 4.6 actúa como juez según el protocolo de rúbricas del benchmark; el original usa un juez diferente, y un juez de Anthropic puede favorecer el estilo de la casa. Claude Opus 5, con su esfuerzo predeterminado, se ejecutó tres veces en la misma superficie y el mismo subconjunto el 28 de agosto de 2026. Obtuvo un 68.8% en las 50 tareas sin filtrar, un 70.8% sobre la base de 33 tareas y un 71.1% en el conjunto de 21 tareas, a $6.71 por tarea ($23.72 sin caché). Los clasificadores de seguridad no interrumpieron ninguno de sus intentos, aunque se ejecutó con un despliegue de salvaguardas más reciente que el de los otros modelos.
- Barrido de defectos en corpus: Interno de Anthropic, para trabajo que excede una ventana de contexto. Usa un corpus de 21.6 millones de tokens procedente de 14 fuentes de paquetes públicos de Python, con 130 defectos plantados y calificación determinista. El protocolo se fijó antes de las ejecuciones y se revisó internamente; hubo tres ejecuciones por configuración. Todas las configuraciones se ejecutaron en Claude Managed Agents. La configuración de equipo del gráfico es una ejecución del 30 de agosto de 2026 en la que el coordinador Claude Fable 5.1 realizó todo el barrido dentro de la plataforma, con el límite documentado de 25 trabajadores Claude Sonnet 5 concurrentes. Sus tres episodios obtuvieron un F1 de 0.764, 0.825 y 0.791 tras la auditoría de extras (0.751, 0.821 y 0.781 sin ajustar), con costos de $225, $234 y $283. La configuración de Claude Sonnet 5 en solitario se ejecutó del 3 al 4 de agosto de 2026. Las configuraciones de Claude Fable 5.1 en solitario se ejecutaron del 24 al 25 de agosto de 2026, con la configuración de servicio de lanzamiento de la plataforma, tres semillas por configuración de esfuerzo y la misma compilación del corpus. La imagen del sandbox contenía copias instaladas de parte del corpus, y el paso final de ensamblaje de Claude Fable 5.1 se comparó con ellas en 7 de 9 episodios; al recalificar sin esas adiciones, las semillas afectadas variaron hasta 3 puntos. El F1 absoluto es específico de esta compilación del corpus y no es comparable entre benchmarks; las comparaciones entre configuraciones se hacen en igualdad de condiciones.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. El subconjunto Diamond de 198 preguntas, con dos ejecuciones por configuración, realizadas el 7 de agosto de 2026 (Claude Opus 5.5: 19 de septiembre de 2026). Un modelo calificó las respuestas contra las respuestas de referencia, y los tokens del asesor se midieron por solicitud. Una verificación de seguridad de la plataforma rechazó dos preguntas de biología en los ejecutores Claude Sonnet 5, y una de ellas también en Claude Opus 5; excluirlas no cambia ninguna comparación en más de un punto. El 92% de Claude Opus 5.5 proviene de dos ejecuciones que establecieron
fallbacks: "default"para activar el "server-side fallback" (respaldo del lado del servidor); cualquier intento que aun así terminara en un rechazo se contó como incorrecto. En cada ejecución, la verificación de seguridad marcó seis preguntas de biología: Claude Opus 5 respondió cinco de ellas mediante el respaldo, y la sexta terminó igualmente en un rechazo. El costo por pregunta de Opus 5.5 incluye esas respuestas de respaldo. Si los rechazos no se cuentan como incorrectos, estas ejecuciones obtienen un 93%, porque el calificador asigna de todos modos una opción de respuesta a un intento rechazado, normalmente la correcta. Con los rechazos contados como incorrectos, las ejecuciones de Claude Opus 5 obtienen un 91% (un rechazo por ejecución). Lo mismo obtienen dos ejecuciones de Claude Opus 5.5 con el respaldo desactivado, en las que Opus 5.5 rechazó cinco o seis preguntas de biología por ejecución. - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. El conjunto tiene 113 tareas originales en cinco lenguajes, con verificadores basados en programas. Cada emparejamiento tiene dos ejecuciones, realizadas el 7 de agosto de 2026, con los tokens del asesor medidos por solicitud. Los emparejamientos usaron un bucle de asesor del lado del cliente en lugar de la herramienta de asesor, con una contabilidad idéntica. Los barridos de esfuerzo de un solo modelo son ejecuciones únicas cuyo costo se calculó a partir de los recuentos de tokens, una aproximación que tiene en cuenta la caché. Los costos por tarea son los totales de cada ejecución divididos entre 113.
- Benchmark interno de programación agéntica: Interno de Anthropic: 370 tareas de repositorio calificadas con las propias pruebas de los repositorios. Las cifras de la API se midieron con un límite de salida de 128,000 tokens y una ejecución por configuración: Opus 5 solo, con el esfuerzo predeterminado, del 9 al 10 de agosto de 2026, y en
lowymediumel 10 de agosto de 2026; Claude Fable 5.1 solo, con cinco valores de esfuerzo establecidos explícitamente, el 20 de agosto de 2026 (el gráfico muestra tres de ellos); y el emparejamiento, del 24 al 25 de agosto de 2026. Claude Opus 5.5 en solitario se ejecutó en las 370 tareas del 19 al 20 de septiembre de 2026: con su esfuerzo predeterminado (medium) y enhigh, con cinco intentos por tarea, y enlowyxhigh, con uno. En cada caso se puntuaron 369 de las 370 tareas, tras un fallo en la verificación de configuración. El ejecutor Claude Opus 5.5 enhigh, con la versión publicada de Claude Fable 5.1 como asesor (las ejecuciones de agosto usaron una instantánea previa al lanzamiento), realizó cinco intentos por tarea en las mismas fechas. Una tarea falló su verificación de configuración, por lo que se puntuaron 1,845 intentos. Los 279 intentos en los que el asesor no respondió por exceso de carga se volvieron a ejecutar, y los intentos cuyas consultas agotaron el tiempo de espera se conservaron, igual que en agosto. En las ejecuciones de agosto hubo cinco intentos por tarea para el emparejamiento y para el control de Claude Opus 5, y uno para los demás puntos. El emparejamiento de agosto promedió unas dos consultas al asesor por intento; el emparejamiento de Claude Opus 5.5 solicitó 1.39 y recibió 1.35. Los costos son por intento y se calculan tal como se mide el consumo de la organización de un cliente, a precios de lista y a partir de los propios registros de uso de las ejecuciones. En cada solicitud del bucle del agente, el prompt previo cuenta como lectura de caché y los tokens nuevos como escritura de caché de 5 minutos. Cada llamada al asesor, que no usa caché, se calcula a partir de sus tokens registrados. Las cifras de Claude Code corresponden a ejecuciones de las mismas tareas del 8 al 23 de julio de 2026, con una ejecución por configuración y costos aproximados. - Benchmark interno de tareas de repositorio (medición del límite): Un conjunto interno de Anthropic, distinto del anterior, de unas 130 tareas de repositorio. Se ejecutó el 20 de agosto de 2026 (Claude Fable 5.1) y el 19 de septiembre de 2026 (Claude Opus 5.5, con su esfuerzo predeterminado,
medium), con un bucle de agente simple de la API y un intento por tarea. Las ejecuciones de Claude Fable 5.1 cubren 135 tareas por límite, con el esfuerzo predeterminado establecido explícitamente. La cifra de 16,384 tokens promedia dos ejecuciones (36.3% en ambas); las cifras de 64,000 y 128,000 son ejecuciones únicas (58.5% y 60.0%). Seis problemas provocaron un rechazo de seguridad en todas las ejecuciones y cuentan como fallos. La cifra de 16,384 tokens de Claude Opus 5.5 promedia dos ejecuciones (134 y 135 tareas puntuadas), y sus cifras de 64,000 y 128,000 son ejecuciones únicas (135 tareas cada una). En cada ejecución de 16,384 tokens, dos intentos terminaron en un rechazo de seguridad y cuentan como fallos. Las cifras de límite de SWE-bench Pro corresponden a una ejecución de Claude Fable 5.1 por límite, con el esfuerzo predeterminado, realizada el 26 de agosto de 2026. Se usó un subconjunto de 100 problemas estratificado a partir del conjunto de 482 problemas de la referencia 3, por lo que no es comparable con sus puntuaciones; con el esfuerzo predeterminado, los dos límites obtuvieron la misma puntuación. Las distribuciones por turno del gráfico provienen de las ejecuciones de Claude Opus 5.5 y Claude Fable 5.1 con 128,000 tokens. Ningún turno de Opus 5.5 alcanzó el límite: el más largo fue de unos 61,000 tokens, y el 0.56% de sus turnos superó los 16,384. Un turno de Fable 5.1 alcanzó los 128,000, y el 0.46% de sus turnos superó los 16,384. - Chartography: Surge AI, "Chartography," 2026. El conjunto completo publicado de 100 preguntas, medido el 6 y el 9 de agosto de 2026 (Claude Opus 5 solo) y el 20 de septiembre de 2026 (Claude Opus 5.5). Se usó la implementación de Anthropic en Claude Managed Agents (sandbox en la nube estándar; las configuraciones con asesor usan el asesor de Managed Agents). Claude Sonnet 4.6 califica en lugar del juez de referencia y el benchmark se ejecuta con herramientas, por lo que las puntuaciones son comparables entre las configuraciones de esta página, pero no con la tabla de clasificación publicada. Tampoco son comparables con los resultados de Chartography de la tarjeta del sistema de Claude Opus 5.5, que usan un calificador diferente y se ejecutan con esfuerzo
max. Hubo dos ejecuciones por configuración (tres para Claude Opus 5.5), agrupadas; la variación entre ejecuciones llegó a 10 puntos. Los costos son lo que se le factura a un cliente que ejecuta el agente de forma habitual. La primera solicitud de cada gráfico lee de la caché la indicación del sistema compartida y las herramientas del agente, como ocurre cuando otra sesión del mismo agente se ejecutó en los 5 minutos anteriores. Un gráfico ejecutado de forma aislada cuesta unos $0.03 más con Claude Opus 5 o Claude Opus 5.5, y unos $0.12 más con Claude Fable 5.1. Las cifras de agosto se recalcularon de esta manera a partir de los registros de uso de las ejecuciones. La medición propia de la organización de evaluación, que hasta el 10 de septiembre de 2026 facturaba las lecturas de caché de Claude Opus 5 en bloques de 8,192 tokens, sobrestimaba los costos de Claude Opus 5. Los costos excluyen el tiempo de sandbox, que añadió menos del 1% a las ejecuciones de agosto. Las ejecuciones de Claude Fable 5.1 en solitario son del 24 de agosto de 2026, con la configuración de servicio de lanzamiento de la plataforma y dos ejecuciones por configuración. Seis intentos alcanzaron el límite de sesión de 15 minutos y obtienen 0, y en cada ejecución Claude Opus 5 respondió dos gráficos tras un rechazo de seguridad. El ejecutor Claude Opus 5 de esfuerzo bajo con un asesor Claude Fable 5.1 se ejecutó dos veces el 30 de agosto de 2026, con la misma configuración. Obtuvo 63.0 y 67.0 (media de 65.0), a $0.47 por gráfico. En cada ejecución se consultó al asesor en el 88% de las tareas, y 4 de sus 219 respuestas las dio Claude Opus 5, cada una después de que un filtro de seguridad de producción bloqueara la respuesta del propio asesor. Claude Opus 5.5 se ejecutó enlow, con el respaldo del lado del servidor desactivado y un clasificador de seguridad evaluando cada llamada a herramienta. Hubo tres ejecuciones en solitario (70, 68 y 68) y tres con un asesor Claude Fable 5.1 configurado (59, 63 y 63), en las que consultó al asesor en 1 de 300 tareas. La comparación de la tasa de consulta de los emparejamientos anteriores proviene de volver a ejecutar las mismas configuraciones en la Messages API con un conjunto de herramientas de contenedor, del 10 al 11 de agosto de 2026. - Evaluación de auditoría de prompts de mesa de soporte: Un conjunto creado por Anthropic de 44 tickets de soporte con calificación determinista, ejecutado a principios de agosto de 2026 y reportado el 8 de agosto de 2026. Se usaron seis indicaciones del sistema; cada una añade a la misma indicación limpia un patrón común en los prompts escritos para Claude Opus 4.8 y Claude Sonnet 4.6. Cada punto del gráfico corresponde a uno de tres casos (modelo anterior, modelo más nuevo con el mismo prompt y modelo más nuevo después de la auditoría), promediado sobre las seis indicaciones y los 44 tickets. La mejora de precisión de Opus 5 tiene un intervalo de confianza del 95% de 3 a 8 puntos; las diferencias de precisión de Sonnet están dentro del margen de ruido.
- Conjunto de preguntas sobre archivos de datos: Un conjunto creado por Anthropic de 25 preguntas de agregación sobre una porción de 1,862 filas de un CSV público de ventas de licores. Los valores de referencia se calcularon con pandas y la calificación es por coincidencia exacta. Se ejecutó en Claude Sonnet 5 y Claude Opus 5 el 19 de agosto de 2026, con tres ejecuciones por configuración, con el pensamiento desactivado (el brazo en contexto no puede completarse con el valor predeterminado), un límite de salida de 4,000 tokens y sin almacenamiento en caché de prompts. El brazo de archivo sube el CSV mediante la Files API y usa la herramienta
code_execution_20260120. - Medición de la duración de la caché: El trabajo de triaje de 20 issues de Recorta los tokens de entrada y de contexto, ejecutado en la Messages API con el mismo arnés: en Claude Sonnet 5, el 23 de agosto de 2026, y en Claude Opus 5.5, el 19 y el 20 de septiembre de 2026, con su esfuerzo predeterminado (
medium) y enhigh. Para Claude Opus 5.5 se usó una adaptación del arnés que envía los mismos cuerpos de solicitud, y las celdas de Claude Opus 5.5 tienenmax_tokenselevado a 4,096. Se insertaron pausas antes de una proporción de turnos elegida al azar. Los calendarios fueron: sin pausas, el 5% de los turnos, el 10% de los turnos y todos los turnos con pausas de 6 minutos, con los 20 issues y en ambos modelos; todos los turnos con pausas de 2 minutos, solo en Claude Sonnet 5; y pausas de 20 y de 45 minutos en un subconjunto de 5 issues, en ambos modelos. Las cifras de keep-alive de Claude Opus 5 que aparecen más abajo provienen del mismo trabajo, ejecutado el 23 de agosto de 2026 conmax_tokenselevado a 4,096 y con los mismos calendarios, salvo las pausas de 2 y de 45 minutos. Hubo tres ejecuciones por celda. El costo se calculó a partir de los camposusagede cada respuesta a precios de lista. Para Claude Opus 5.5, los precios por millón de tokens son $4 de entrada, $5 de escritura de 5 minutos, $8 de escritura de 1 hora, $0.20 de lectura de caché y $20 de salida. Claude Sonnet 5 se ejecutó en una organización interna de Anthropic cuyo uso se mide igual que el de una organización de cliente. La precisión se midió contra las mismas etiquetas de referencia. Las cifras de Claude Opus 5.5 de esta página cubren ambos niveles de esfuerzo. El punto de cruce es de aproximadamente el 3.3% de los turnos en Claude Sonnet 5 y de entre el 3.1% y el 3.2% en Claude Opus 5.5. Es la mediana de la proporción de equilibrio de cada sesión, que el modelo de costos calcula a partir de los tamaños de contexto turno por turno de esa sesión. La mediana abarca las 45 sesiones de veinte issues de Claude Sonnet 5 y las 36 sesiones de veinte issues de Claude Opus 5.5 en cada nivel de esfuerzo: cada calendario de pausas ejecutado en el trabajo completo, con las tres configuraciones de caché y tres ejecuciones cada una. Las celdas de 5 issues no están incluidas. En la celda del 5%, las configuraciones de 5 minutos y de 1 hora empataron en Claude Sonnet 5, porque en ese sorteo las pausas cayeron en prefijos pequeños; en Claude Opus 5.5 casi empataron. La regla de 1 de cada 20 de la página queda por encima del punto de cruce medido. No se midió el tiempo hasta el primer token de Claude Opus 5.5 después de una pausa. Anthropic midió solicitudes keep-alive que renuevan la caché de 5 minutos, siempre enviadas conmax_tokens: 1: en Claude Sonnet 5 y Claude Opus 5 el 23 de agosto de 2026, y en Claude Opus 5.5 en las ejecuciones descritas arriba. En Claude Sonnet 5, costaron un 7.7% menos que la configuración de 1 hora con el 5% de los turnos en pausa, y aproximadamente lo mismo con el 10%; en Claude Opus 5, no se pudo medir ninguna diferencia con ninguna de las dos proporciones; y en ambos modelos, costaron más con una pausa de 6 minutos o más antes de cada turno. En Claude Opus 5.5, costaron entre un 8% y un 18% menos que la configuración de 1 hora con el 5% y el 10% de los turnos en pausa. Una vez eliminado el ruido entre sesiones, la diferencia es de aproximadamente un 10% a un 15%; para eliminarlo, se volvieron a facturar los tokens de cada sesión keep-alive a precios de caché de 1 hora. Con una pausa antes de cada turno, en Claude Opus 5.5 costaron más: entre un 4% y un 6% más con 6 minutos, entre un 9% y un 10% más con 20 minutos, y entre un 56% y un 58% más con 45 minutos. El keep-alive ahorró más en Claude Opus 5.5 porque cada solicitud keep-alive vuelve a leer el prefijo al precio de lectura de caché, que es 0.05x el precio de entrada, frente a 0.1x en Claude Sonnet 5 y Claude Opus 5. Las sesiones de Claude Opus 5, refacturadas a los precios de Claude Opus 5.5, muestran casi el mismo ahorro que Claude Opus 5.5. Las pruebas de API previas al lanzamiento que Anthropic realizó en Claude Opus 5.5 muestran que una solicitud conmax_tokens: 0escribe la caché y que la siguiente solicitud la lee. No se midió en Opus 5.5 si una solicitud así renueva una entrada existente. En Claude Fable 5.1, con un precio de lectura de 0.025x, el keep-alive fue más barato incluso con una pausa antes de cada turno, salvo con pausas de 45 minutos (referencia 19). - Proporción de lecturas de caché en producción: Uso agregado de primera parte de la Claude API durante los 14 días que terminaron el 23 de agosto de 2026. Solo incluye el producto de API directa, excluye las organizaciones internas de Anthropic y no identifica a ninguna organización. Un día-organización cuenta como bucle de agente cuando sus solicitudes incluyen definiciones de herramientas y resultados de herramientas, sus prompts contienen en promedio 9 o más llamadas a herramientas previas, se usó caché y realizó al menos 10 solicitudes de ese tipo. Como la API no tiene un identificador de conversación, este criterio sustituye a la longitud de la conversación. El resultado abarca 303,003 días-organización de 106,487 organizaciones, con una mediana de lecturas de caché del 84.2% de todos los tokens de entrada y un cuartil superior del 91.7%. Las etiquetas de caso de uso (el caso de uso que declaró la organización o, en su defecto, el que se le asignó por clasificación) cubren el 74% de esos días-organización y el 99% de sus tokens. Las organizaciones de programación aportan el 87% de los tokens de entrada agénticos. Su mediana de lecturas es del 88.5% (90.9% con 25 o más llamadas a herramientas previas), su cuartil superior es del 93.4%, y aproximadamente el 72% de sus días-organización alcanza el 80% o más. Los agentes de soporte, investigación y datos leen entre el 84% y el 85%. El decil superior de días-organización lee el 95.9% o más en programación, y entre el 94.2% y el 94.8% en agentes de soporte, investigación, datos y otros. El desglose por solicitud con 25 o más llamadas a herramientas previas proviene de una muestra de seis horas: en programación, el 92% es lectura, el 7% escritura y menos del 1% sin caché. Las organizaciones sin etiqueta, en su mayoría pequeñas, tienen una mediana de lecturas del 11%. Los días-organización sin definiciones de herramientas tienen una mediana de lecturas del 34.6%. Una consulta independiente sobre el mismo periodo, que reconstruye conversaciones de 10 o más solicitudes en lugar de puntuar días-organización, sitúa la mediana en el 90.2%; la diferencia se debe al alcance, no a los datos.
- Medición del momento de la compactación: La variante larga del agente de triaje de Recorta los tokens de entrada y de contexto, ejecutada el 24 de agosto de 2026 en Claude Sonnet 5 con la caché de 5 minutos. El costo se calculó a partir de los campos de uso a precios de lista, con cinco sesiones por brazo: un brazo sin cambios, con el esfuerzo predeterminado en todo momento ($0.81 por sesión), y dos brazos que comienzan con esfuerzo bajo y hacen los mismos dos cambios que invalidan la caché (pasar al esfuerzo predeterminado y añadir una herramienta). Uno hace los cambios a mitad de sesión, en las solicitudes 12 y 17 ($0.95). El otro, el brazo de frontera, los hace juntos en la primera solicitud después de la primera compactación ($0.75). Un cuarto brazo de seis sesiones, ejecutado el 25 de agosto de 2026, hizo los mismos dos cambios en la solicitud que desencadenó la primera compactación ($0.92 por sesión). La pasada de resumen de esa solicitud escribió en la caché el contexto de 81,000 tokens en lugar de leerlo, por lo que costó $0.21, frente a $0.04 de la misma pasada en el brazo de frontera. Las sesiones se compactaron por primera vez entre las solicitudes 21 y 25 (16 de las 21 sesiones, en la solicitud 22), cuando el prompt superó el umbral de compactación de 80,000 tokens. Dos sesiones sin cambios se compactaron una segunda vez cerca del final. El total del brazo de frontera es más bajo que el del brazo sin cambios por sus solicitudes de esfuerzo bajo antes del cambio y por esas segundas compactaciones, no por la caché: los costos de reescritura de ambos brazos difieren en menos de un centavo. El brazo de mitad de sesión pagó $0.23 por sesión en reescrituras de caché. La diferencia entre el brazo de mitad de sesión y el de frontera fue de $0.20, con un intervalo de confianza del 95% de $0.11 a $0.29. Una sesión del brazo de mitad de sesión salió barata ($0.82) porque, tras la compactación, su modelo llamó incorrectamente a la herramienta de búsqueda y obtuvo resultados vacíos. Esa sesión está incluida; sin ella, el brazo promedia $0.98. La precisión promedió 14.2 de 20 etiquetas en cada brazo del 24 de agosto y 14.7 en el brazo del 25 de agosto. Las lecturas de caché representaron el 91% de los tokens del prompt sin cambios, el 85% con los cambios a mitad de sesión, el 91% con los cambios en la frontera y el 86% con los cambios en la solicitud desencadenante.
- Medición de la duración de la caché en Claude Fable 5.1: El mismo trabajo de triaje de 20 issues y el mismo arnés que en la referencia 16, ejecutado el 23 y el 26 de agosto de 2026 en la instantánea de lanzamiento de Claude Fable 5.1. Se usaron sus precios de lanzamiento por millón de tokens: $10 de entrada, $12.50 de escritura de 5 minutos, $20 de escritura de 1 hora, $0.25 de lectura de caché y $50 de salida. Se probaron tres configuraciones por calendario: la caché de 5 minutos, la caché de 1 hora y la caché de 5 minutos mantenida activa con una solicitud
max_tokens: 0sobre el prefijo sin cambios cada 4 minutos, contados desde el inicio de la solicitud anterior. Las ejecuciones del 23 de agosto enviaron las solicitudes keep-alive conmax_tokens: 1. En las celdas del 26 de agosto que se reportan aquí, cada solicitud keep-alive renovó la caché y no facturó salida. Los calendarios fueron: sin pausas, el 10% de los turnos y todos los turnos con pausas de 6 minutos, con los 20 issues, y pausas de 45 minutos en el subconjunto de 5 issues. Hubo tres ejecuciones por celda (seis en la celda keep-alive del 26 de agosto con pausas de 45 minutos). El costo se calculó a partir de los camposusagede cada respuesta a precios de lista, y la precisión se midió contra las mismas etiquetas de referencia (entre 12 y 17 etiquetas exactas de 20). Las medias por sesión del 26 de agosto para las configuraciones de 5 minutos, 1 hora y keep-alive fueron: sin pausas, $2.42, $3.09 y $2.29; con el 10% de los turnos en pausa, $4.50, $2.96 y $2.36; y con todos los turnos en pausa, $22.89, $3.01 y $2.62. Las celdas del 23 de agosto coinciden con estas dentro de un 6%. Las cifras de 45 minutos ($1.68, $0.59 y $0.71 por sesión de 5 issues) provienen de una reejecución limpia del 26 de agosto, realizada después de que un incidente de facturación de caché invalidara las primeras celdas de ese día; las ejecuciones del 23 de agosto dieron $1.67, $0.58 y $0.70. El punto de cruce entre las configuraciones de 5 minutos y de 1 hora es el 3.1% de los turnos, con la misma medida que en la referencia 16. - Terminal-Bench 3: Las 74 tareas del benchmark público de agentes de terminal, ejecutadas en Claude Managed Agents con dos ejecuciones por modelo y esfuerzo
high, del 27 al 28 de agosto de 2026. En lugar de las herramientas integradas de la plataforma, se usaron dos herramientas personalizadas: un shell y un editor de archivos que el arnés de evaluación ejecuta en el contenedor de cada tarea. Por lo demás, se usó la configuración predeterminada de la plataforma para cuentas externas. Estas ejecuciones usaron la versión 3.0 de Terminal-Bench. Sus puntuaciones no son comparables con la tabla de clasificación pública de Terminal-Bench ni con los resultados de Terminal-Bench 4.0 de la tarjeta del sistema de Claude Opus 5.5, que provienen de ejecuciones en Claude Code con esfuerzomax. Los límites de tiempo de cada tarea son 2.5 veces los del propio benchmark, lo que da al agente entre 75 minutos y 20 horas por tarea (5 horas para la tarea mediana). Cada tarea recibe el triple de la memoria que especifica, de 6 GiB a 96 GiB, y las 12 tareas que ejecutan servicios auxiliares reciben memoria adicional. El agente no tenía acceso general a internet. Sus contenedores podían acceder a una réplica interna de paquetes, a una lista corta de sitios de descarga que incluía GitHub y el Python Package Index, y a algunos sitios específicos de ciertas tareas; ocho de las tareas no tenían ningún acceso a la red. Las puntuaciones son tasas de aprobación sin ajustar sobre los 148 intentos por modelo; las ejecuciones individuales varían entre 5 y 11 puntos. Los costos son lo que se le facturaría a un cliente a precios de lista, recalculados solicitud por solicitud a partir de los registros de uso de las ejecuciones, con la duración de caché de 5 minutos. Claude Opus 4.7 terminó 11 de sus 148 intentos al alcanzar su límite de salida. - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026. Sus 100 tareas de investigación en 10 dominios se califican según rúbricas escritas por expertos, y la puntuación es la puntuación normalizada del benchmark. Todas las configuraciones se ejecutaron en la Claude API con Claude Fable 5.1, el pensamiento adaptativo predeterminado, los clasificadores de seguridad de producción activados y
max_tokensen 128,000. Las configuraciones fueron un solo agente con esfuerzohigh, un solo agente con esfuerzomedium, un solo agente enhighcon la instrucción y el reloj, un equipo enhighcon la instrucción y el reloj, y un equipo enhighsin ellos. El equipo es un agente principal que inicia, mediante una herramienta, agentes auxiliares del mismo modelo, sin límite en su número. En DRACO, el agente principal inició una mediana de 4 auxiliares por intento. Cada configuración hizo tres intentos en cada tarea, del 8 al 10 de septiembre de 2026. Los intentos que alcanzaron el límite de cuatro horas se volvieron a ejecutar, y cuenta el nuevo intento. Los únicos intentos excluidos son los 3 de una tarea en la configuración de un solo agente con esfuerzomedium, por lo que esa configuración cubre 99 tareas. Esa tarea agotó el tiempo de espera en todos los intentos, tanto en la ejecución original como en la reejecución. Si esos 3 intentos se puntúan como 0, como haría el propio benchmark, solo cambian las dos comparaciones con esfuerzomedium. El cambio de puntuación con esfuerzomediumfrente ahighpasa de 0.7 a 1.7 puntos menos, y el cambio de puntuación con ambos cambios frente al esfuerzomediumpasa de 1.2 a 0.2 puntos menos. Los agentes usaron una herramienta de búsqueda y una herramienta de obtención que el arnés de evaluación aloja sobre un índice web fijo. Esas herramientas determinan parte del tiempo, y las tuyas funcionarán a otra velocidad, por lo que la página expresa el tiempo como una proporción entre configuraciones, no en minutos. El tiempo es el tiempo real transcurrido por tarea, desde la primera hasta la última solicitud de cualquier agente. A ese tiempo se le resta el tiempo estimado de espera para reintentar solicitudes tras errores de "rate limit" (límite de velocidad) o de sobrecarga. Esos errores se debieron a los límites compartidos de la cuenta de prueba. Todas las configuraciones de un conjunto comenzaron a la vez. Las más lentas terminaron horas después, por lo que parte de su tiempo transcurrió con una carga diferente. El costo de cada tarea es el de sus solicitudes a precios de lista públicos, solo para tokens del modelo. El almacenamiento en caché de prompts se factura como se le facturaría a un cliente que establece un punto de interrupción de caché al final de cada solicitud y usa la duración de caché de 5 minutos. Las herramientas del arnés no añaden cargos. Los cambios de puntuación son diferencias pareadas por tarea, con intervalos bootstrap del 95%. Un cambio se considera dentro del margen cuando su intervalo no supera 1.5 puntos en DRACO ni 2.5 puntos en HLE. Anthropic fijó esos márgenes antes de las ejecuciones. Claude Opus 5 califica las respuestas. En comparación con el calificador propio de cada conjunto, Opus 5 dio, en todas las configuraciones, entre 1.9 y 2.4 puntos más en DRACO, entre 2.2 y 2.9 puntos menos en HLE (Opus 5 calificó 495 de las 500 preguntas, y el calificador del benchmark calificó las 500) y entre 1.3 y 2.0 puntos menos en el conjunto de física, cuyo calificador propio también usa las soluciones de referencia de expertos. Los dos calificadores coinciden en la dirección de todos los cambios. - HLE: Phan et al., "Humanity's Last Exam," arXiv:2501.14249, 2025. Preguntas escritas por expertos con respuestas exactas, calificadas contra las respuestas de referencia. Se midió en las primeras 500 preguntas, con las fuentes del propio benchmark bloqueadas en la búsqueda y con la misma configuración que en la referencia 21. Cada configuración hizo tres intentos en cada pregunta, del 8 al 10 de septiembre de 2026. Claude Opus 5 compara cada respuesta con la respuesta de referencia, con el pensamiento adaptativo activado, como lo está de forma predeterminada. El juez calificó 495 de las 500 preguntas en todas las configuraciones, y las puntuaciones cubren esas 495. En las otras 5, la solicitud de calificación superaba el límite de 1M de tokens del juez. Los intentos que alcanzaron el límite de cuatro horas se volvieron a ejecutar, y cuenta el nuevo intento, por lo que todas las configuraciones tienen los 1,500 intentos. Puntuar las 5 preguntas sin calificar como 0, como haría el propio benchmark, no cambia ningún hallazgo.
- Conjunto de física: Un conjunto interno de 70 problemas de física de nivel de investigación, adaptado del benchmark público CritPt: Zhu et al., "Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025. Revisores expertos corrigieron los enunciados de los problemas. Claude Opus 5 califica cada respuesta contra soluciones de referencia de expertos que no son públicas, por lo que las puntuaciones no se pueden comparar con los resultados publicados. La puntuación es la calificación media de los intentos de cada problema, promediada entre todos los problemas. Se midió en los 70 problemas, con cuatro intentos por problema, del 8 al 9 de septiembre de 2026. Cada agente tenía una herramienta de Python, un shell y un editor de archivos en un contenedor sandbox sin acceso a la red, y no tenía herramientas de búsqueda ni de obtención. Por lo demás, la configuración es la de la referencia 21. No se fijó ningún margen de puntuación para el conjunto de física antes de las ejecuciones, por lo que la página presenta sus cambios de puntuación con sus intervalos del 95% y no los describe como dentro de un margen.
Próximos pasos
La mayor ganancia gratuita de esta página: configuración, duraciones y diagnósticos.
Intercambia inteligencia por latencia y costo dentro de un solo modelo.
Evalúa capacidad, velocidad y costo en toda la familia de modelos Claude.
Da a los bucles de agente una cuenta regresiva de tokens contra la cual se autorregulan.
Pon un límite estricto en dólares a una sesión de Managed Agents.
Consulta los precios actuales por token para cada modelo Claude.
Aplica estas palancas una a la vez a un agente funcional en un notebook ejecutable, con el costo por tarea después de cada paso.
Mira un recorrido por los patrones de asesor y orquestador.
Was this page helpful?