工單路由
本指南將逐步說明如何運用 Claude 先進的自然語言理解能力,根據客戶意圖、緊急程度、優先順序、客戶資料等因素,大規模地對客戶支援工單進行分類。
先決條件
- 一組 Claude API 金鑰,並已安裝 Python SDK
- 能夠存取並熟悉您現有的支援工單系統
- 一組用於測試的歷史支援工單樣本
決定是否使用 Claude 進行工單路由
以下是一些關鍵指標,表明您應該在分類任務中使用像 Claude 這樣的「large language model」(大型語言模型),即 LLM,而非傳統的機器學習(ML)方法:
傳統的 ML 流程需要大量已標註的資料集。Claude 的預訓練模型只需幾十個已標註的範例即可有效地對工單進行分類,大幅減少資料準備的時間與成本。
一旦建立了傳統的 ML 方法,要更改它是一項費力且需要大量資料的工作。另一方面,隨著您的產品或客戶需求演進,Claude 可以輕鬆適應類別定義的變更或新增的類別,而無需大量重新標註訓練資料。
傳統的 ML 模型通常難以處理非結構化資料,並且需要大量的特徵工程。Claude 先進的語言理解能力使其能夠根據內容與上下文進行準確分類,而非依賴嚴格的本體結構。
傳統的 ML 方法通常依賴詞袋模型或簡單的模式比對。當類別是由條件而非範例定義時,Claude 擅長理解並應用其背後的規則。
許多傳統的 ML 模型幾乎無法提供其決策過程的洞察。Claude 可以為其分類決策提供人類可讀的解釋,建立對自動化系統的信任,並在需要時便於調整。
傳統的 ML 系統通常難以處理離群值與模糊的輸入,經常將其錯誤分類或預設歸入一個籠統的類別。Claude 的自然語言處理能力使其能夠更好地解讀支援工單中的上下文與細微差異,有可能減少需要人工介入的錯誤路由或未分類工單的數量。
傳統的 ML 方法通常需要為每種支援的語言建立獨立的模型或進行大量的翻譯流程。Claude 的多語言能力使其能夠對各種語言的工單進行分類,而無需獨立的模型或大量的翻譯流程,從而簡化對全球客戶群的支援。
建構並部署您的 LLM 支援工作流程
了解您目前的支援方式
在進行自動化之前,了解您現有的工單系統至關重要。首先調查您的支援團隊目前如何處理工單路由。
請思考以下問題:
- 使用什麼標準來決定套用哪種 SLA/服務方案?
- 工單路由是否用於決定工單應轉交給哪一層級的支援人員或產品專家?
- 是否已有任何自動化規則或工作流程?它們在哪些情況下會失效?
- 邊緣案例或模糊的工單如何處理?
- 團隊如何決定工單的優先順序?
您越了解人類如何處理特定案例,就越能與 Claude 協作完成這項任務。
定義使用者意圖類別
一份定義明確的使用者意圖類別清單,對於使用 Claude 準確分類支援工單至關重要。Claude 在您的系統中有效路由工單的能力,與您系統類別定義的明確程度直接成正比。
以下是一些使用者意圖類別與子類別的範例。
- 硬體問題
- 軟體錯誤
- 相容性問題
- 效能問題
- 密碼重設
- 帳戶存取問題
- 帳單查詢
- 訂閱變更
- 功能查詢
- 產品相容性問題
- 價格資訊
- 供貨情況查詢
- 操作方法問題
- 功能使用協助
- 最佳實務建議
- 疑難排解指引
- 錯誤回報
- 功能請求
- 一般意見回饋或建議
- 投訴
- 訂單狀態查詢
- 運送資訊
- 退貨與換貨
- 訂單修改
- 安裝協助
- 升級請求
- 維護排程
- 服務取消
- 資料隱私查詢
- 可疑活動回報
- 安全功能協助
- 法規合規問題
- 服務條款查詢
- 法律文件請求
- 重大系統故障
- 緊急安全問題
- 具時效性的問題
- 產品培訓請求
- 文件查詢
- 網路研討會或工作坊資訊
- 整合協助
- API 使用問題
- 第三方相容性查詢
除了意圖之外,工單路由與優先順序也可能受到其他因素影響,例如緊急程度、客戶類型、SLA 或語言。在建構自動化路由系統時,請務必考量其他路由標準。
建立成功標準
與您的支援團隊合作,定義明確的成功標準,包含可衡量的基準、門檻與目標。
以下是使用 LLM 進行支援工單路由時的一些標準準則與基準:
此指標評估 Claude 隨時間對相似工單進行分類的一致程度。這對於維持路由可靠性至關重要。可透過定期以一組標準化輸入測試模型來衡量,目標是達到 95% 或更高的一致率。
此指標衡量 Claude 適應新類別或變化中的工單模式的速度。可透過引入新的工單類型,並測量模型在這些新類別上達到令人滿意的準確率(例如 >90%)所需的時間來進行測試。目標是在 50–100 個樣本工單內完成適應。
此指標評估 Claude 準確路由多種語言工單的能力。衡量不同語言的路由準確率,目標是非主要語言的準確率下降不超過 5–10%。
此指標評估 Claude 在不尋常或複雜工單上的表現。建立一組邊緣案例測試集並衡量路由準確率,目標是在這些具挑戰性的輸入上達到至少 80% 的準確率。
此指標衡量 Claude 在不同客戶族群之間路由的公平性。定期稽核路由決策是否存在潛在偏見,目標是在所有客戶群體之間維持一致的路由準確率(差異在 2–3% 以內)。
在必須盡量減少 token 數量的情況下,此準則評估 Claude 在最少上下文下的表現。衡量在提供不同數量上下文時的路由準確率,目標是僅憑工單標題與簡短描述即可達到 90% 以上的準確率。
此指標評估 Claude 對其路由決策所提供解釋的品質與相關性。人工評分者可以依量表(例如 1–5 分)為解釋評分,目標是達到平均 4 分或更高。
以下是一些無論是否使用 LLM 都可能有用的常見成功標準:
路由準確率衡量工單在第一次嘗試時被正確分配給適當團隊或個人的頻率。這通常以正確路由的工單佔總工單的百分比來衡量。業界基準通常以 90–95% 的準確率為目標,但這可能因支援結構的複雜程度而有所不同。
此指標追蹤工單提交後被分配的速度。更快的分配時間通常會帶來更快的解決速度與更高的客戶滿意度。一流的系統通常能達到平均 5 分鐘以內的分配時間,許多系統更以近乎即時的路由為目標(這在 LLM 實作中是可行的)。
重新路由率表示工單在初次路由後需要重新分配的頻率。較低的比率表示初次路由更為準確。目標是將重新路由率控制在 10% 以下,表現最佳的系統可達到 5% 或更低。
此指標衡量在與客戶首次互動中即獲得解決的工單百分比。較高的比率表示路由有效率且支援團隊準備充分。業界基準通常在 70–75% 之間,表現最佳者可達到 80% 或更高。
平均處理時間衡量從開始到結束解決一張工單所需的時間。有效率的路由可以大幅縮短此時間。基準因產業與複雜程度而差異甚大,但許多組織的目標是將非重大問題的平均處理時間控制在 24 小時以內。
這些分數通常透過互動後的問卷調查來衡量,反映客戶對支援流程的整體滿意程度。有效的路由有助於提升滿意度。目標是達到 90% 或更高的 CSAT 分數,表現最佳者通常能達到 95% 以上的滿意率。
此指標衡量工單需要升級至更高層級支援的頻率。較低的升級率通常表示初次路由更為準確。努力將升級率控制在 20% 以下,一流的系統可達到 10% 或更低。
此指標觀察在實施路由解決方案後,客服人員能有效處理多少工單。改善後的路由應能提升生產力。可透過追蹤每位客服人員每天或每小時解決的工單數來衡量,目標是在實施新路由系統後提升 10–20%。
此指標衡量在進入路由系統之前,透過自助服務選項解決的潛在工單百分比。較高的比率表示路由前的分流有效。目標是達到 20–30% 的分流率,表現最佳者可達到 40% 或更高。
此指標計算解決每張支援工單的平均成本。有效率的路由應有助於隨時間降低此成本。雖然基準差異甚大,但許多組織的目標是在實施改善後的路由系統後,將每張工單成本降低 10–15%。
選擇合適的 Claude 模型
模型的選擇取決於成本、準確率與回應時間之間的權衡。
許多客戶發現 claude-haiku-4-5-20251001 是工單路由的理想模型,因為它是 Claude 4 系列中速度最快、最具成本效益的模型,同時仍能提供出色的結果。如果您的分類問題需要深厚的領域專業知識、大量的意圖類別或複雜的推理,您可以選擇更大的 Sonnet 模型。
建構強大的提示
工單路由是一種分類任務。Claude 會分析支援工單的內容,並根據問題類型、緊急程度、所需專業知識或其他相關因素,將其分類到預先定義的類別中。
撰寫一個工單分類提示。初始提示應包含使用者請求的內容,並同時回傳推理與意圖。
以下是一個工單路由分類提示的範例:
def classify_support_request(ticket_contents):
    # 定義分類任務的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""以下是此提示的關鍵組成部分:
- 提示範本是一個 Python f-string,可將
ticket_contents插入<request>標籤中。 - 提示為 Claude 賦予了一個明確定義的角色:一個仔細分析工單內容以判斷客戶核心意圖與需求的分類系統。
- 提示指示 Claude 正確的輸出格式,在此例中是在
<reasoning>標籤內提供其推理與分析,接著在<intent>標籤內提供適當的分類標籤。 - 提示指定了有效的意圖類別:「Support, Feedback, Complaint」、「Order Tracking」與「Refund/Exchange」。
- 提示包含了幾個範例(亦即 few-shot prompting,少樣本提示)來說明輸出應如何格式化,這能提升準確率與一致性。
讓 Claude 將其回應拆分為獨立的 XML 標籤區段,可讓您使用正規表示式從輸出中分別擷取推理與意圖。這使您能夠在工單路由工作流程中建立有針對性的後續步驟,例如僅使用意圖來決定將工單路由給哪個人。
部署您的提示
如果不將提示部署到測試生產環境中並執行評估,就很難知道您的提示效果如何。
建構部署結構。首先定義用於包裝 Claude 呼叫的方法簽章。擴充您先前開始撰寫的方法(該方法以 ticket_contents 作為輸入),使其現在回傳一個由 reasoning 與 intent 組成的元組作為輸出。如果您已有使用傳統 ML 的現有自動化流程,則應改為遵循該方法簽章。
import re

# 建立 Claude API 用戶端的實例
client = anthropic.Anthropic()

# 設定預設模型
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # 定義分類任務的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # 將提示傳送至 API 以分類支援請求。
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # 使用 Python 的正規表示式函式庫擷取 `reasoning`。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同樣地,也擷取 `intent`。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
此程式碼:
- 使用您的 API 金鑰建立一個用戶端實例。
- 定義一個接受
ticket_contents字串的classify_support_request函式。 - 使用
classification_prompt將ticket_contents傳送給 Claude 進行分類。 - 回傳從回應中擷取的模型
reasoning與intent。
由於必須在解析之前產生完整的推理與意圖文字,因此範例設定 stream=False(預設值)。
評估您的提示
提示通常需要經過測試與最佳化才能達到生產就緒的狀態。若要判斷您的解決方案是否就緒,請根據您先前建立的成功標準與門檻來評估效能。
若要執行評估,您需要有可供執行的測試案例。本指南的其餘部分假設您已經開發好測試案例。
建構評估函式
本指南的範例評估從三個關鍵指標衡量 Claude 的表現:
- 準確率
- 每次分類成本
根據對您而言重要的因素,您可能需要從其他面向評估 Claude。
為了進行評估,首先修改腳本,新增一個函式來比較預測意圖與實際意圖,並計算正確預測的百分比。接著新增成本計算與時間測量功能。
import re

# 建立 Claude API 用戶端的實例
client = anthropic.Anthropic()

# 設定預設模型
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # 定義分類任務的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # 使用 Python 的正規表示式函式庫擷取 `reasoning`。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同樣地,也擷取 `intent`。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # 檢查模型的預測是否正確。
    correct = actual_intent.strip() == intent.strip()

    # 回傳 reasoning、intent、correct 與 usage。
    return reasoning, intent, correct, usage
以下是修改內容的說明:
classify_support_request方法現在會接收測試案例中的actual_intent,並將其與 Claude 的意圖分類進行比較,以評估兩者是否相符。- 該方法會擷取 API 呼叫的使用量統計資料,以根據所使用的輸入與輸出 token 計算成本。
執行您的評估
一個適當的評估需要明確的門檻與基準來判斷什麼是好的結果。前述腳本會回傳準確率、回應時間與每次分類成本的執行期數值,但您仍需要明確建立的門檻。例如:
- 準確率: 95%(在 100 次測試中)
- 每次分類成本: 相較於目前的路由方法,平均降低 50%(在 100 次測試中)
有了這些門檻,您就能以公正的實證方式,快速且輕鬆地大規模判斷哪種方法最適合您,以及可能需要進行哪些變更以更符合您的需求。
提升效能
在複雜的情境中,除了標準的提示工程技巧與防護機制實作策略之外,考慮其他策略來提升效能可能會有所幫助。以下是一些常見情境:
對於有 20 個以上意圖類別的情況,使用分類階層
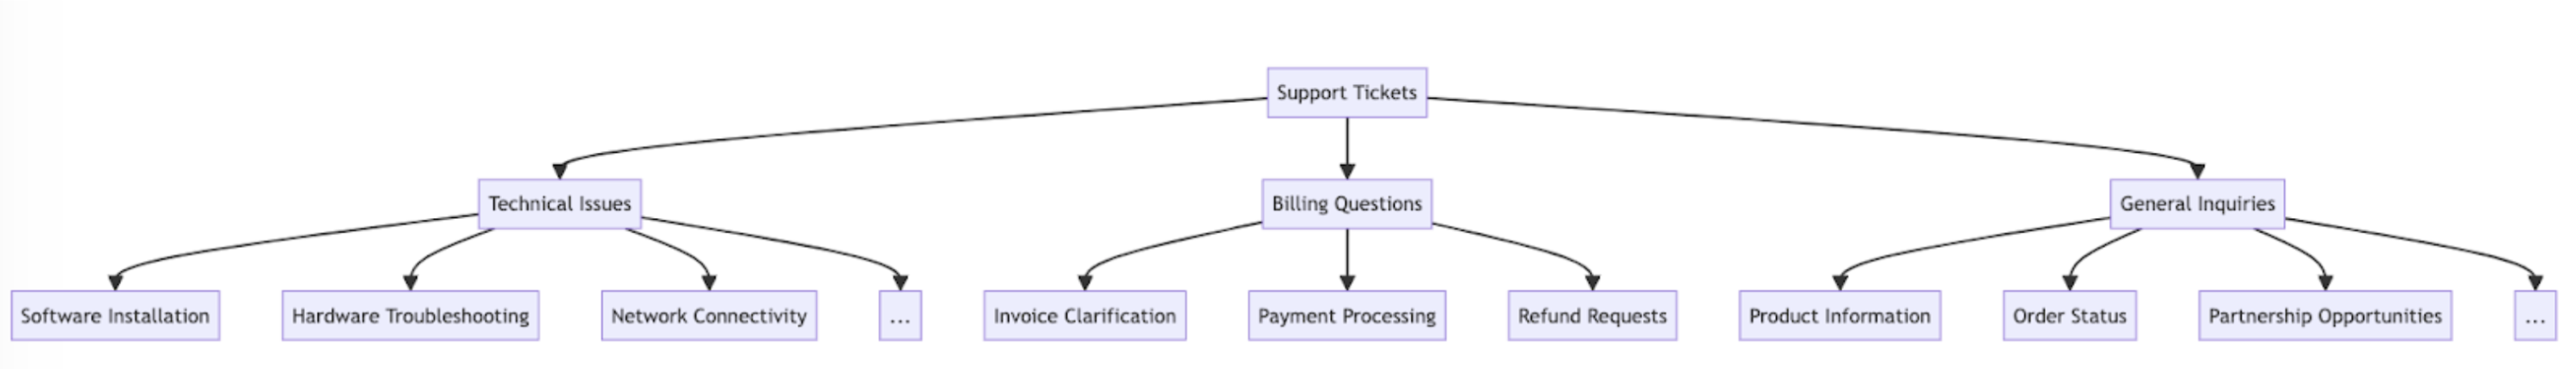
隨著類別數量增加,所需的範例數量也會隨之擴大,可能使提示變得難以管理。作為替代方案,您可以考慮使用混合分類器來實作階層式分類系統。
- 將您的意圖組織成分類樹狀結構。
- 在樹的每一層建立一系列分類器,實現級聯式路由方法。
例如,您可能有一個頂層分類器,將工單大致分為「Technical Issues」(技術問題)、「Billing Questions」(帳單問題)與「General Inquiries」(一般查詢)。這些類別各自可以再有自己的子分類器,以進一步細化分類。
-
優點 - 更細緻且更準確: 您可以為每個父路徑建立不同的提示,實現更有針對性且更符合上下文的分類。這可以提升準確率,並更細緻地處理客戶請求。
-
缺點 - 延遲增加: 請注意,多個分類器可能導致「latency」(延遲)增加,Anthropic 建議使用速度最快的模型 Haiku 來實作此方法。
使用向量資料庫與相似度搜尋檢索來處理高度多變的工單
儘管提供範例是提升效能最有效的方式,但如果支援請求高度多變,可能很難在單一提示中包含足夠的範例。
在這種情境下,您可以使用向量資料庫從範例資料集中進行相似度搜尋,並為給定的查詢檢索最相關的範例。
此方法在分類範例中有詳細說明,已被證明可將效能從 71% 的準確率提升至 93% 的準確率。
特別考量預期的邊緣案例
以下是一些 Claude 可能錯誤分類工單的情境(可能還有其他您特有的情況)。在這些情境中,請考慮在提示中提供明確的指示或範例,說明 Claude 應如何處理該邊緣案例:
客戶經常間接表達需求。例如,「我已經等我的包裹超過兩週了」可能是對訂單狀態的間接詢問。
- 解決方案: 向 Claude 提供一些這類請求的真實客戶範例,以及其背後的意圖。如果您針對特別細微的工單意圖附上分類理由,可以獲得更好的結果,讓 Claude 能更好地將該邏輯推廣到其他工單。
當客戶表達不滿時,Claude 可能會優先處理情緒,而非解決根本問題。
- 解決方案: 向 Claude 提供何時應優先考量客戶情緒、何時不應的指示。可以簡單到像是「忽略所有客戶情緒。僅專注於分析客戶請求的意圖,以及客戶可能在詢問什麼資訊。」
當客戶在單次互動中提出多個問題時,Claude 可能難以辨識主要關切事項。
- 解決方案: 釐清意圖的優先順序,讓 Claude 能更好地對擷取出的意圖進行排序並辨識主要關切事項。
將 Claude 整合到您更大的支援工作流程中
適當的整合需要您針對基於 Claude 的工單路由腳本如何融入更大的工單路由系統架構做出一些決策。有兩種方式可以做到這一點:
- 推送式(Push-based): 您使用的支援工單系統(例如 Zendesk)透過向您的路由服務傳送 webhook 事件來觸發您的程式碼,接著由路由服務對意圖進行分類並路由。
- 此方法更具網路可擴展性,但需要您公開一個公用端點。
- 拉取式(Pull-based): 您的程式碼依照給定的排程拉取最新的工單,並在拉取時進行路由。
- 此方法較容易實作,但當拉取頻率過高時可能會對支援工單系統發出不必要的呼叫,而當拉取頻率過低時則可能過於緩慢。
無論採用哪種方法,您都需要將腳本包裝成一個服務。方法的選擇取決於您的支援工單系統提供哪些 API。
造訪分類 cookbook 以取得更多範例程式碼與詳細的評估指引。
在 Claude Console 上開始建構並評估您的工作流程。
Was this page helpful?