Хуки инференса
Отправляйте каждую контролируемую подсказку на сервер безопасности ИИ вашей организации для получения вердикта «разрешить» или «отклонить» до того, как начнётся инференс.
Inference hooks (хуки инференса) позволяют организации Claude Enterprise направлять каждую контролируемую подсказку через «AI security server» (сервер безопасности ИИ) — HTTPS-сервис, которым управляет организация или её поставщик средств безопасности, — до запуска инференса. Когда пользователь отправляет подсказку, Anthropic отправляет транскрипт разговора на ваш сервер безопасности ИИ и ожидает вердикта «разрешить» или «отклонить»; отклонённый запрос никогда не достигает модели. Команды безопасности и комплаенса используют Inference hooks для применения политик в отношении данных непосредственно в потоке обработки, а разработчики создают сервер безопасности ИИ, который оценивает каждый запрос.
Поскольку хук выполняется на серверах Anthropic — после того как запрос покидает клиент и до того как запускается модель, — он единообразно применяется к каждому контролируемому запросу, и на устройствах пользователей ничего не нужно устанавливать или развёртывать.
На сегодняшний день единственное событие хука — prompt, которое срабатывает один раз для каждого контролируемого запроса на инференс, до начала инференса. Контроль на стороне ответа запланирован как более позднее событие.
Как работают Inference hooks
- Пользователь отправляет подсказку на контролируемой поверхности.
- Anthropic отправляет HTTPS-запрос
POSTна настроенную конечную точку сервера безопасности ИИ вашей организации. Тело запроса содержит транскрипт разговора, и каждый запрос подписывается в соответствии со спецификацией Standard Webhooks, как только ваша организация сгенерирует свой секрет подписи, чтобы ваш сервер мог убедиться, что запрос поступил от Anthropic. - Ваш сервер безопасности ИИ оценивает содержимое и отвечает вердиктом в пределах тайм-аута вердикта, настроенного вашей организацией (по умолчанию 5 секунд).
- При
allowинференс продолжается в обычном режиме. Приdenyзапрос отклоняется, и пользователь видит сообщение о блокировке политикой, составленное из двух частей: причины для конкретного запроса, которую ваш сервер безопасности ИИ указал в полеdeny_reasonвердикта, за которой следует постоянное сообщение, настроенное вашими администраторами (например, к кому обратиться или где запросить исключение). Если ваши администраторы его не настроили, встроенное сообщение по умолчанию направляет пользователя обратиться к ним. Каждый отказ также записывается в Activity Feed (ленту активности) вашей организации.
На следующей схеме прослеживается один пример (запрос в Cowork, при котором Claude также вызывает инструмент O365), чтобы показать, какие части процесса перехватываются хуками. Точки перехвата — это шаги 1 и 6 на схеме, где поступает подсказка и возвращается результат инструмента; каждая из них приводит к обмену данными для проверки с вашим сервером безопасности ИИ, показанному на шагах 2–3 и 7–8.
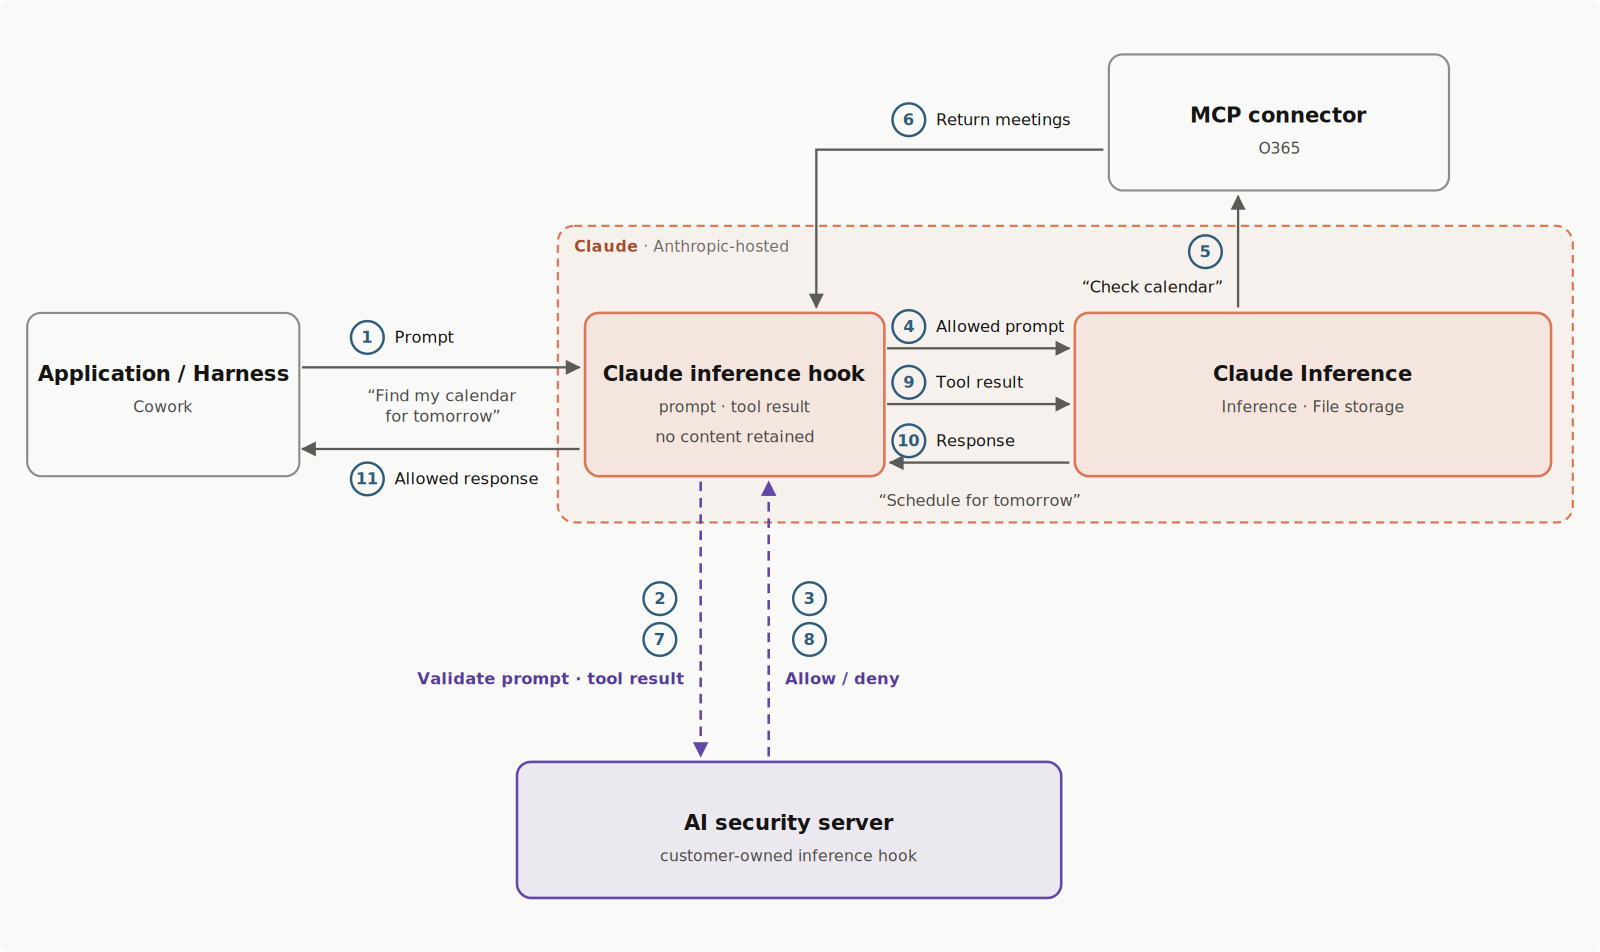
Вердикт — это небольшой объект JSON: {"action": "allow"} позволяет запросу продолжиться, а отказ содержит причину, отображаемую пользователю. Полную схему вердикта см. в разделе Возврат вердикта.
Ваш сервер безопасности ИИ видит то же, что видит пользователь: текст транскрипта, вызовы инструментов и их результаты, а также текст, извлечённый из вложений. Он никогда не получает необработанные байты файлов или изображений, системные подсказки или внутренний контекст Anthropic.
Система Inference hooks не хранит собственную копию содержимого подсказок или ответов. Она хранит только конфигурацию ваших хуков и метаданные об активности хуков, такие как вердикты, временные метки и идентификаторы запросов. Используемый вами продукт Claude хранит подсказки и ответы в соответствии со своими собственными правилами хранения данных, независимо от того, включены хуки или нет. Например, сообщение, заблокированное хуком в claude.ai, остаётся в разговоре.
Если ваш сервер безопасности ИИ недоступен, возвращает ошибку или не отвечает в пределах тайм-аута, результат определяется настройкой обработки сбоев вашей организации: заблокировать запрос или разрешить его выполнение без проверки. Продолжительные сбои, вызванные вашим сервером, срабатывают «circuit breaker» (автоматический выключатель): Anthropic прекращает обращаться к серверу и применяет вашу настройку обработки сбоев ко всем запросам, а затем автоматически сбрасывает выключатель, как только обнаруживает, что ваш сервер снова возвращает вердикты; см. Circuit breaker.
Контроль можно внедрять в удобном для вас темпе, так что никого не придётся блокировать в первый же день: теневой режим наблюдает за вердиктами на реальном трафике, ничего не блокируя, процент развёртывания проверяет выбранную долю запросов, а исключения полностью освобождают участников выбранных ролей. См. Настройка Inference hooks.
Полные схемы запросов и ответов, проверку подписи и эксплуатационные подробности см. в разделе Разработка интеграции.
Продолжение разговора после отклонённого запроса
Каждый запрос включает весь разговор, поэтому отклонённое сообщение отправляется повторно с каждым последующим сообщением. Если ваш сервер безопасности ИИ оценивает весь транскрипт, он отклонит и эти запросы. Чтобы продолжить, пользователь удаляет отклонённое содержимое из того, что приложение отправит далее, включая любой файл, который Claude прочитал бы снова.
Порядок действий зависит от приложения:
- claude.ai, включая Claude Desktop и мобильные приложения. Пользователь редактирует отклонённое сообщение или одно из предыдущих, а не отправляет исправленную копию как новое сообщение. В веб-версии и в Claude Desktop при редактировании вложения сообщения отправляются повторно, если пользователь их не удалит. Также можно начать новый чат.
- Claude Code. Пользователь выполняет
/rewindи выбирает подсказку, которая первой внесла это содержимое. При появлении запроса он выбирает Restore conversation, а затем редактирует или очищает подсказку, которая возвращается в поле ввода./clearначинает всё заново. См. Checkpointing. - Cowork. Пользователь редактирует отклонённое сообщение, если оно является его последним сообщением. При редактировании прикреплённые файлы отправляются повторно, а Restart from here повторно отправляет всё сообщение без изменений. Если содержимое находится в файле или в более раннем сообщении, пользователь выбирает New task.
- Claude Tag. В Slack пользователь сначала редактирует отклонённое сообщение или удаляет его, если это ответ. Затем он отправляет отдельное сообщение
@Claude !restartтам, где отвечал Claude: в этой ветке или на верхнем уровне канала. Новый сеанс заново считывает сообщения, которые остаются в Slack, поэтому редактирование или удаление должно быть выполнено первым. См. команду!restart.
Сценарии использования
- «Data loss prevention» (предотвращение утечки данных), или DLP. Пересылайте транскрипт вашему DLP-сканеру и отклоняйте подсказки, содержащие регулируемые или секретные материалы. Это наиболее распространённый вариант развёртывания.
- Архивирование транскриптов в реальном времени. Архивируйте каждый транскрипт по мере поступления и всегда возвращайте
allow— как push-альтернативу опросу Compliance API. - Телеметрия подсказок. Измеряйте, как ваша организация использует Claude, в момент использования.
- Движки политик. Применяйте собственные правила до инференса: списки разрешённых моделей, ограничения на уровне проектов или контроль рабочего времени.
Текущие ограничения
- Вложения представлены метаданными и извлечённым текстом. Необработанные байты файлов и изображений никогда не отправляются, поэтому содержимое, состоящее только из изображений (например, снимок экрана документа), не проверяется.
- Вердикты — это «разрешить» или «отклонить». Переписывание или редактирование подсказки не поддерживается.
- Платформенные организации (доступ к API через Claude Platform) не входят в область действия.
Доступность
Inference hooks доступны организациям Claude Enterprise. Для их настройки требуется разрешение organization:manage, которым обладают только роли Owner и Primary owner.
Один хук контролирует разговоры в сеансах claude.ai, Cowork, Claude Code и Claude Tag в вашей организации Claude Enterprise, независимо от того, выполняются ли они в веб-версии, в настольных или мобильных приложениях, в CLI или в Slack. Inference hooks недоступны в Amazon Bedrock и Google Cloud.
Контролируемые запросы — это запросы на инференс, лежащие в основе разговора пользователя. Вспомогательные запросы, такие как генерация заголовка разговора, не отправляются на вашу конечную точку, а системные подсказки и определения инструментов никогда не включаются в отправляемые данные. Голосовой режим не охватывается.
Inference hooks в сравнении с Compliance API
Обе функции служат командам безопасности, юридическим командам и командам комплаенса в организациях Claude Enterprise.
| Inference hooks | Compliance API | |
|---|---|---|
| Когда действует | Непосредственно в потоке, до запуска инференса | Постфактум |
| Что делает | Разрешает или отклоняет каждый контролируемый запрос в реальном времени | Извлекает активность, чаты, файлы, проекты, транскрипты сеансов и пользователей для аудита и экспорта |
| Направление | Anthropic вызывает ваш сервер безопасности ИИ | Вы вызываете API Anthropic |
Используйте Inference hooks, чтобы остановить запрос до того, как он достигнет модели, а Compliance API — чтобы провести аудит произошедшего впоследствии.
В этом разделе
Разрешите Inference hooks для вашей организации, настройте и протестируйте ваш сервер безопасности ИИ, выберите обработку сбоев и применяйте вердикты.
Схемы запросов и вердиктов, проверка подписи, эксплуатационная семантика и шаблоны интеграции для создания сервера безопасности ИИ.
Was this page helpful?