Routage des tickets
Ce guide explique comment exploiter les capacités avancées de compréhension du langage naturel de Claude pour classifier les tickets de support client à grande échelle en fonction de l'intention du client, de l'urgence, de la priorisation, du profil client, et plus encore.
Prérequis
- Une clé API Claude et le SDK Python installé
- Un accès à votre système de gestion de tickets de support existant, ainsi qu'une bonne connaissance de celui-ci
- Un échantillon de tickets de support historiques pour les tests
Déterminer s'il convient d'utiliser Claude pour le routage des tickets
Voici quelques indicateurs clés montrant que vous devriez utiliser un « large language model » (grand modèle de langage), ou LLM, comme Claude plutôt que des approches de ML traditionnelles pour votre tâche de classification :
Les processus de ML traditionnels nécessitent d'énormes jeux de données étiquetés. Le modèle préentraîné de Claude peut classifier efficacement les tickets avec seulement quelques dizaines d'exemples étiquetés, ce qui réduit considérablement le temps et les coûts de préparation des données.
Une fois qu'une approche de ML traditionnelle a été mise en place, la modifier est une entreprise laborieuse et gourmande en données. En revanche, à mesure que votre produit ou les besoins de vos clients évoluent, Claude peut facilement s'adapter aux changements de définitions de classes ou à de nouvelles classes sans réétiquetage massif des données d'entraînement.
Les modèles de ML traditionnels ont souvent du mal avec les données non structurées et nécessitent une ingénierie des caractéristiques poussée. La compréhension avancée du langage de Claude permet une classification précise basée sur le contenu et le contexte, plutôt que de s'appuyer sur des structures ontologiques strictes.
Les approches de ML traditionnelles s'appuient souvent sur des modèles de type sac de mots ou sur une simple correspondance de motifs. Claude excelle dans la compréhension et l'application de règles sous-jacentes lorsque les classes sont définies par des conditions plutôt que par des exemples.
De nombreux modèles de ML traditionnels offrent peu de visibilité sur leur processus de décision. Claude peut fournir des explications lisibles par un humain pour ses décisions de classification, ce qui renforce la confiance dans le système d'automatisation et facilite son adaptation si nécessaire.
Les systèmes de ML traditionnels ont souvent du mal avec les valeurs aberrantes et les entrées ambiguës, les classant fréquemment de manière erronée ou les reléguant par défaut dans une catégorie fourre-tout. Les capacités de traitement du langage naturel de Claude lui permettent de mieux interpréter le contexte et les nuances des tickets de support, réduisant potentiellement le nombre de tickets mal routés ou non classifiés qui nécessitent une intervention manuelle.
Les approches de ML traditionnelles nécessitent généralement des modèles distincts ou des processus de traduction lourds pour chaque langue prise en charge. Les capacités multilingues de Claude lui permettent de classifier des tickets dans diverses langues sans avoir besoin de modèles distincts ni de processus de traduction lourds, ce qui simplifie le support pour une clientèle internationale.
Construire et déployer votre workflow de support basé sur un LLM
Comprendre votre approche de support actuelle
Avant d'automatiser, il est essentiel de comprendre votre système de gestion de tickets existant. Commencez par examiner comment votre équipe de support gère actuellement le routage des tickets.
Posez-vous des questions telles que :
- Quels critères sont utilisés pour déterminer quel SLA/quelle offre de service est appliqué(e) ?
- Le routage des tickets sert-il à déterminer vers quel niveau de support ou quel spécialiste produit un ticket est dirigé ?
- Existe-t-il déjà des règles ou des workflows automatisés ? Dans quels cas échouent-ils ?
- Comment les cas limites ou les tickets ambigus sont-ils traités ?
- Comment l'équipe priorise-t-elle les tickets ?
Plus vous en savez sur la manière dont les humains traitent certains cas, mieux vous pourrez travailler avec Claude pour accomplir la tâche.
Définir les catégories d'intention utilisateur
Une liste bien définie de catégories d'intention utilisateur est essentielle pour une classification précise des tickets de support avec Claude. La capacité de Claude à router efficacement les tickets au sein de votre système est directement proportionnelle à la qualité de définition des catégories de votre système.
Voici quelques exemples de catégories et sous-catégories d'intention utilisateur.
- Problème matériel
- Bug logiciel
- Problème de compatibilité
- Problème de performance
- Réinitialisation de mot de passe
- Problèmes d'accès au compte
- Questions de facturation
- Modifications d'abonnement
- Questions sur les fonctionnalités
- Questions de compatibilité produit
- Informations tarifaires
- Questions de disponibilité
- Questions pratiques
- Aide à l'utilisation des fonctionnalités
- Conseils sur les bonnes pratiques
- Aide au dépannage
- Signalements de bugs
- Demandes de fonctionnalités
- Retours ou suggestions d'ordre général
- Réclamations
- Questions sur le statut de commande
- Informations de livraison
- Retours et échanges
- Modifications de commande
- Aide à l'installation
- Demandes de mise à niveau
- Planification de maintenance
- Résiliation de service
- Questions sur la confidentialité des données
- Signalements d'activité suspecte
- Aide sur les fonctionnalités de sécurité
- Questions de conformité réglementaire
- Questions sur les conditions d'utilisation
- Demandes de documentation juridique
- Pannes système critiques
- Problèmes de sécurité urgents
- Problèmes sensibles au temps
- Demandes de formation produit
- Questions sur la documentation
- Informations sur les webinaires ou ateliers
- Aide à l'intégration
- Questions sur l'utilisation de l'API
- Questions de compatibilité avec des tiers
Outre l'intention, le routage et la priorisation des tickets peuvent également être influencés par d'autres facteurs tels que l'urgence, le type de client, les SLA ou la langue. Veillez à prendre en compte d'autres critères de routage lors de la construction de votre système de routage automatisé.
Établir des critères de réussite
Travaillez avec votre équipe de support pour définir des critères de réussite clairs avec des références, des seuils et des objectifs mesurables.
Voici quelques critères et références standard lors de l'utilisation de LLM pour le routage des tickets de support :
Cette métrique évalue la cohérence avec laquelle Claude classifie des tickets similaires au fil du temps. Elle est essentielle pour maintenir la fiabilité du routage. Mesurez-la en testant périodiquement le modèle avec un ensemble d'entrées standardisées et en visant un taux de cohérence de 95 % ou plus.
Cette métrique mesure la rapidité avec laquelle Claude peut s'adapter à de nouvelles catégories ou à l'évolution des types de tickets. Testez-la en introduisant de nouveaux types de tickets et en mesurant le temps nécessaire au modèle pour atteindre une précision satisfaisante (par exemple, >90 %) sur ces nouvelles catégories. Visez une adaptation en 50 à 100 tickets d'exemple.
Cette métrique évalue la capacité de Claude à router avec précision des tickets dans plusieurs langues. Mesurez la précision du routage dans différentes langues, en visant une baisse de précision ne dépassant pas 5 à 10 % pour les langues non principales.
Cette métrique évalue les performances de Claude sur des tickets inhabituels ou complexes. Créez un jeu de test de cas limites et mesurez la précision du routage, en visant au moins 80 % de précision sur ces entrées difficiles.
Cette métrique mesure l'équité de Claude dans le routage entre différents profils démographiques de clients. Auditez régulièrement les décisions de routage pour détecter d'éventuels biais, en visant une précision de routage cohérente (à 2–3 % près) pour tous les groupes de clients.
Dans les situations où il est essentiel de minimiser le nombre de tokens, ce critère évalue les performances de Claude avec un contexte minimal. Mesurez la précision du routage avec différentes quantités de contexte fournies, en visant une précision de 90 % ou plus avec seulement le titre du ticket et une brève description.
Cette métrique évalue la qualité et la pertinence des explications de Claude pour ses décisions de routage. Des évaluateurs humains peuvent noter les explications sur une échelle (par exemple, de 1 à 5), l'objectif étant d'atteindre une note moyenne de 4 ou plus.
Voici quelques critères de réussite courants qui peuvent être utiles, qu'un LLM soit utilisé ou non :
La précision du routage mesure la fréquence à laquelle les tickets sont correctement attribués à l'équipe ou à la personne appropriée dès la première tentative. Elle est généralement mesurée en pourcentage de tickets correctement routés par rapport au nombre total de tickets. Les références du secteur visent souvent une précision de 90 à 95 %, bien que cela puisse varier selon la complexité de la structure de support.
Cette métrique suit la rapidité avec laquelle les tickets sont attribués après leur soumission. Des délais d'attribution plus courts conduisent généralement à des résolutions plus rapides et à une meilleure satisfaction client. Les meilleurs systèmes atteignent souvent des délais d'attribution moyens inférieurs à 5 minutes, beaucoup visant un routage quasi instantané (ce qui est possible avec des implémentations basées sur des LLM).
Le taux de reroutage indique la fréquence à laquelle les tickets doivent être réattribués après le routage initial. Un taux plus faible suggère un routage initial plus précis. Visez un taux de reroutage inférieur à 10 %, les systèmes les plus performants atteignant des taux aussi bas que 5 % ou moins.
Cette métrique mesure le pourcentage de tickets résolus lors de la première interaction avec le client. Des taux plus élevés indiquent un routage efficace et des équipes de support bien préparées. Les références du secteur se situent généralement entre 70 et 75 %, les plus performants atteignant des taux de 80 % ou plus.
Le temps de traitement moyen mesure le temps nécessaire pour résoudre un ticket du début à la fin. Un routage efficace peut réduire considérablement ce temps. Les références varient largement selon le secteur et la complexité, mais de nombreuses organisations visent à maintenir le temps de traitement moyen sous 24 heures pour les problèmes non critiques.
Souvent mesurés par des enquêtes post-interaction, ces scores reflètent la satisfaction globale des clients vis-à-vis du processus de support. Un routage efficace contribue à une satisfaction plus élevée. Visez des scores CSAT de 90 % ou plus, les plus performants atteignant souvent des taux de satisfaction de 95 % ou plus.
Cette métrique mesure la fréquence à laquelle les tickets doivent être escaladés vers des niveaux de support supérieurs. Des taux d'escalade plus faibles indiquent souvent un routage initial plus précis. Efforcez-vous d'atteindre un taux d'escalade inférieur à 20 %, les meilleurs systèmes atteignant des taux de 10 % ou moins.
Cette métrique examine le nombre de tickets que les agents peuvent traiter efficacement après la mise en place de la solution de routage. Un routage amélioré devrait augmenter la productivité. Mesurez-la en suivant le nombre de tickets résolus par agent par jour ou par heure, en visant une amélioration de 10 à 20 % après la mise en place d'un nouveau système de routage.
Cette métrique mesure le pourcentage de tickets potentiels résolus via des options en libre-service avant d'entrer dans le système de routage. Des taux plus élevés indiquent un tri pré-routage efficace. Visez un taux de déflexion de 20 à 30 %, les plus performants atteignant des taux de 40 % ou plus.
Cette métrique calcule le coût moyen de résolution de chaque ticket de support. Un routage efficace devrait contribuer à réduire ce coût au fil du temps. Bien que les références varient largement, de nombreuses organisations visent à réduire le coût par ticket de 10 à 15 % après la mise en place d'un système de routage amélioré.
Choisir le bon modèle Claude
Le choix du modèle dépend des compromis entre coût, précision et temps de réponse.
De nombreux clients ont trouvé que claude-haiku-4-5-20251001 était un modèle idéal pour le routage des tickets, car il s'agit du modèle le plus rapide et le plus économique de la famille Claude 4, tout en offrant d'excellents résultats. Si votre problème de classification nécessite une expertise métier approfondie, un grand nombre de catégories d'intention ou un raisonnement complexe, vous pouvez opter pour le modèle Sonnet, plus grand.
Construire un prompt solide
Le routage des tickets est un type de tâche de classification. Claude analyse le contenu d'un ticket de support et le classe dans des catégories prédéfinies en fonction du type de problème, de l'urgence, de l'expertise requise ou d'autres facteurs pertinents.
Rédigez un prompt de classification de tickets. Le prompt initial doit contenir le contenu de la demande de l'utilisateur et renvoyer à la fois le raisonnement et l'intention.
Voici un exemple de prompt de classification pour le routage des tickets :
def classify_support_request(ticket_contents):
    # Définir le prompt pour la tâche de classification
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Voici les composants clés de ce prompt :
- Le modèle de prompt est une f-string Python, ce qui permet d'insérer
ticket_contentsdans les balises<request>. - Le prompt donne à Claude un rôle clairement défini en tant que système de classification qui analyse soigneusement le contenu du ticket pour déterminer l'intention et les besoins fondamentaux du client.
- Le prompt indique à Claude le format de sortie approprié, en l'occurrence fournir son raisonnement et son analyse dans des balises
<reasoning>, suivis de l'étiquette de classification appropriée dans des balises<intent>. - Le prompt spécifie les catégories d'intention valides : « Support, Feedback, Complaint », « Order Tracking » et « Refund/Exchange ».
- Le prompt inclut quelques exemples (c'est-à-dire du few-shot prompting) pour illustrer le format attendu de la sortie, ce qui améliore la précision et la cohérence.
Le fait que Claude divise sa réponse en sections de balises XML distinctes vous permet d'utiliser des expressions régulières pour extraire indépendamment le raisonnement et l'intention de la sortie. Cela vous permet de créer des étapes suivantes ciblées dans le workflow de routage des tickets, par exemple en utilisant uniquement l'intention pour décider vers quelle personne router le ticket.
Déployer votre prompt
Il est difficile de savoir si votre prompt fonctionne bien sans le déployer dans un environnement de test de production et sans exécuter des évaluations.
Construisez la structure de déploiement. Commencez par définir la signature de la méthode qui encapsule l'appel à Claude. Étendez la méthode que vous avez commencé à écrire précédemment, qui prend ticket_contents en entrée, afin qu'elle renvoie désormais un tuple reasoning et intent en sortie. Si vous disposez d'une automatisation existante utilisant du ML traditionnel, vous devrez plutôt suivre cette signature de méthode.
import re

# Créer une instance du client de l'API Claude
client = anthropic.Anthropic()

# Définir le modèle par défaut
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Définir le prompt pour la tâche de classification
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Envoyer le prompt à l'API pour classer la demande d'assistance.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Utiliser la bibliothèque d'expressions régulières de Python pour extraire `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # De même, extraire également l'`intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Ce code :
- Crée une instance de client à l'aide de votre clé API.
- Définit une fonction
classify_support_requestqui prend une chaîneticket_contents. - Envoie
ticket_contentsà Claude pour classification à l'aide declassification_prompt. - Renvoie le
reasoninget l'intentdu modèle extraits de la réponse.
Comme l'intégralité du texte de raisonnement et d'intention doit être générée avant l'analyse, l'exemple définit stream=False (la valeur par défaut).
Évaluer votre prompt
Le prompting nécessite souvent des tests et une optimisation pour être prêt pour la production. Pour déterminer si votre solution est prête, évaluez ses performances en fonction des critères de réussite et des seuils que vous avez établis précédemment.
Pour exécuter votre évaluation, vous avez besoin de cas de test sur lesquels l'exécuter. Le reste de ce guide suppose que vous avez déjà développé vos cas de test.
Construire une fonction d'évaluation
L'exemple d'évaluation de ce guide mesure les performances de Claude selon trois métriques clés :
- Précision
- Coût par classification
Vous devrez peut-être évaluer Claude sur d'autres axes en fonction des facteurs qui sont importants pour vous.
Pour évaluer cela, modifiez d'abord le script pour ajouter une fonction qui compare l'intention prédite à l'intention réelle et calcule le pourcentage de prédictions correctes. Ajoutez ensuite les fonctionnalités de calcul des coûts et de mesure du temps.
import re

# Créer une instance du client de l'API Claude
client = anthropic.Anthropic()

# Définir le modèle par défaut
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Définir le prompt pour la tâche de classification
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Utiliser la bibliothèque d'expressions régulières de Python pour extraire `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # De même, extraire également `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Vérifier si la prédiction du modèle est correcte.
    correct = actual_intent.strip() == intent.strip()

    # Renvoyer reasoning, intent, correct et usage.
    return reasoning, intent, correct, usage
Voici le détail des modifications :
- La méthode
classify_support_requestprend désormais l'actual_intentissu des cas de test et le compare à la classification d'intention de Claude pour évaluer s'ils correspondent. - La méthode extrait les statistiques d'utilisation de l'appel API pour calculer le coût en fonction des tokens d'entrée et de sortie utilisés.
Exécuter votre évaluation
Une évaluation correcte nécessite des seuils et des références clairs pour déterminer ce qui constitue un bon résultat. Le script précédent renvoie les valeurs d'exécution pour la précision, le temps de réponse et le coût par classification, mais vous avez toujours besoin de seuils clairement établis. Par exemple :
- Précision : 95 % (sur 100 tests)
- Coût par classification : réduction de 50 % en moyenne (sur 100 tests) par rapport à la méthode de routage actuelle
Disposer de ces seuils vous permet de déterminer rapidement et facilement, à grande échelle et avec un empirisme impartial, quelle méthode vous convient le mieux et quels changements pourraient être nécessaires pour mieux répondre à vos exigences.
Améliorer les performances
Dans des scénarios complexes, il peut être utile d'envisager des stratégies supplémentaires pour améliorer les performances au-delà des techniques de prompt engineering standard et des stratégies de mise en place de garde-fous. Voici quelques scénarios courants :
Utiliser une hiérarchie taxonomique pour les cas comportant plus de 20 catégories d'intention
À mesure que le nombre de classes augmente, le nombre d'exemples requis augmente également, ce qui peut rendre le prompt difficile à gérer. Comme alternative, vous pouvez envisager de mettre en place un système de classification hiérarchique utilisant une combinaison de classificateurs.
- Organisez vos intentions dans une structure arborescente taxonomique.
- Créez une série de classificateurs à chaque niveau de l'arbre, permettant une approche de routage en cascade.
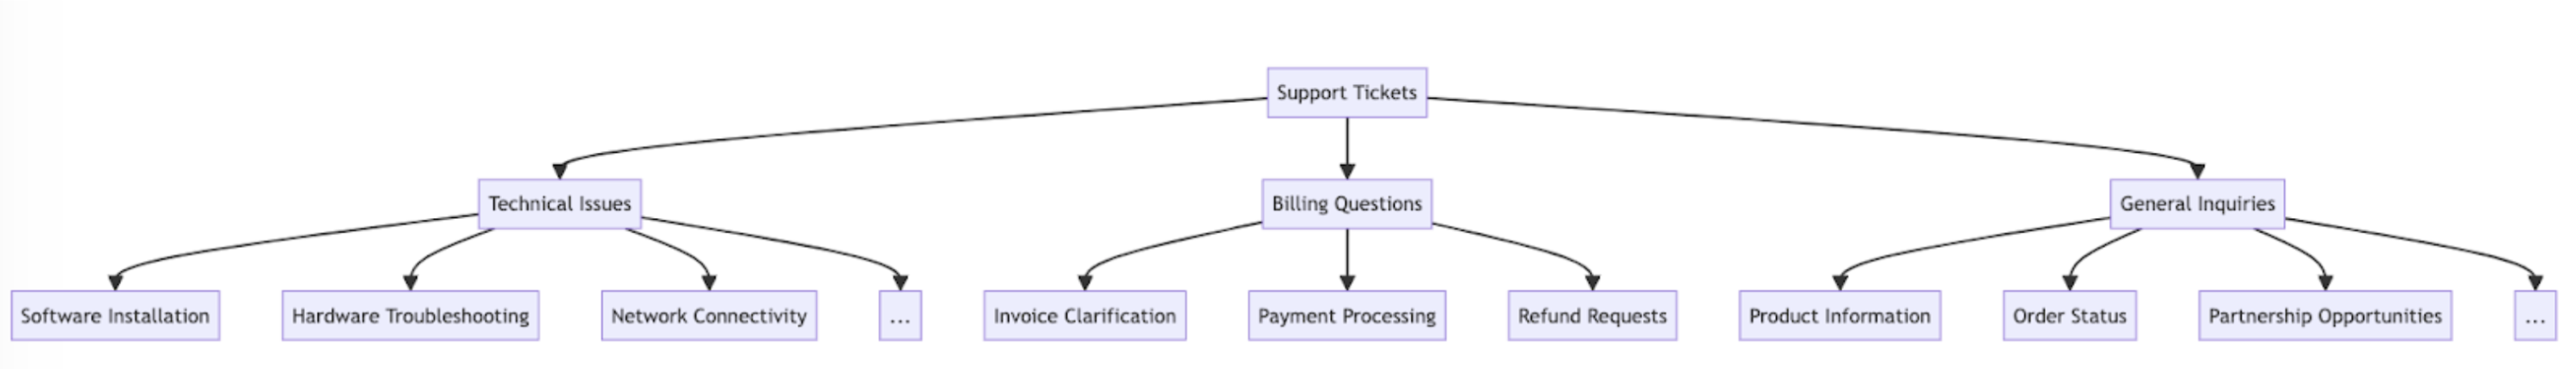
Par exemple, vous pourriez avoir un classificateur de premier niveau qui catégorise globalement les tickets en « Technical Issues » (problèmes techniques), « Billing Questions » (questions de facturation) et « General Inquiries » (demandes générales). Chacune de ces catégories peut ensuite avoir son propre sous-classificateur pour affiner davantage la classification.
-
Avantages - plus de nuance et de précision : vous pouvez créer des prompts différents pour chaque chemin parent, ce qui permet une classification plus ciblée et spécifique au contexte. Cela peut conduire à une meilleure précision et à un traitement plus nuancé des demandes des clients.
-
Inconvénients - latence accrue : sachez que plusieurs classificateurs peuvent entraîner une « latency » (latence) accrue, et Anthropic recommande de mettre en œuvre cette approche avec le modèle le plus rapide, Haiku.
Utiliser des bases de données vectorielles et la recherche par similarité pour gérer des tickets très variables
Bien que fournir des exemples soit le moyen le plus efficace d'améliorer les performances, si les demandes de support sont très variables, il peut être difficile d'inclure suffisamment d'exemples dans un seul prompt.
Dans ce scénario, vous pourriez utiliser une base de données vectorielle pour effectuer des recherches par similarité à partir d'un jeu de données d'exemples et récupérer les exemples les plus pertinents pour une requête donnée.
Cette approche, décrite en détail dans la recette de classification, a permis d'améliorer les performances de 71 % à 93 % de précision.
Tenir compte spécifiquement des cas limites attendus
Voici quelques scénarios dans lesquels Claude peut mal classifier des tickets (il peut en exister d'autres propres à votre situation). Dans ces scénarios, envisagez de fournir dans le prompt des instructions explicites ou des exemples sur la manière dont Claude doit gérer le cas limite :
Les clients expriment souvent leurs besoins de manière indirecte. Par exemple, « J'attends mon colis depuis plus de deux semaines maintenant » peut être une demande indirecte de statut de commande.
- Solution : fournissez à Claude quelques exemples réels de clients pour ce type de demandes, accompagnés de l'intention sous-jacente. Vous pouvez obtenir des résultats encore meilleurs si vous incluez une justification de classification pour les intentions de tickets particulièrement nuancées, afin que Claude puisse mieux généraliser la logique à d'autres tickets.
Lorsque les clients expriment leur mécontentement, Claude peut privilégier la prise en compte de l'émotion plutôt que la résolution du problème sous-jacent.
- Solution : donnez à Claude des indications sur les moments où il doit ou non privilégier le sentiment du client. Cela peut être aussi simple que « Ignore toutes les émotions du client. Concentre-toi uniquement sur l'analyse de l'intention de la demande du client et sur les informations que le client pourrait rechercher. »
Lorsque les clients présentent plusieurs problèmes au cours d'une même interaction, Claude peut avoir du mal à identifier la préoccupation principale.
- Solution : clarifiez la priorisation des intentions afin que Claude puisse mieux hiérarchiser les intentions extraites et identifier la préoccupation principale.
Intégrer Claude dans votre workflow de support global
Une intégration correcte nécessite que vous preniez certaines décisions concernant la manière dont votre script de routage de tickets basé sur Claude s'intègre dans l'architecture de votre système de routage de tickets global. Il existe deux façons de procéder :
- Mode push : le système de tickets de support que vous utilisez (par exemple, Zendesk) déclenche votre code en envoyant un événement webhook à votre service de routage, qui classifie ensuite l'intention et route le ticket.
- Cette approche est plus évolutive à l'échelle du web, mais nécessite que vous exposiez un point de terminaison public.
- Mode pull : votre code récupère les derniers tickets selon un calendrier donné et les route au moment de la récupération.
- Cette approche est plus facile à mettre en œuvre, mais peut effectuer des appels inutiles au système de tickets de support lorsque la fréquence de récupération est trop élevée, ou être excessivement lente lorsque la fréquence de récupération est trop faible.
Pour chacune de ces approches, vous devez encapsuler votre script dans un service. Le choix de l'approche dépend des API fournies par votre système de gestion de tickets de support.
Consultez le cookbook de classification pour plus d'exemples de code et des conseils détaillés sur les évaluations.
Commencez à construire et à évaluer votre workflow sur la Claude Console.
Was this page helpful?