Hooks de inferencia
Envía cada prompt gobernado al servidor de seguridad de IA de tu organización para obtener un veredicto de permitir o denegar antes de que continúe la inferencia.
Los "Inference hooks" (hooks de inferencia) permiten que una organización de Claude Enterprise dirija cada prompt gobernado a través de un "AI security server" (servidor de seguridad de IA) antes de que se ejecute la inferencia. Se trata de un servicio HTTPS que opera la organización o su proveedor de seguridad. Cuando un usuario envía un prompt, Anthropic envía la transcripción de la conversación a tu servidor de seguridad de IA y espera un veredicto de permitir o denegar. Una solicitud denegada nunca llega al modelo. Los equipos de seguridad y cumplimiento usan los Inference hooks para aplicar políticas de datos en línea, y los desarrolladores construyen el servidor de seguridad de IA que evalúa cada solicitud.
El hook se ejecuta en los servidores de Anthropic, después de que la solicitud sale del cliente y antes de que se ejecute el modelo. Por eso se aplica de manera uniforme a cada solicitud gobernada, sin nada que instalar ni desplegar en los dispositivos de los usuarios.
Actualmente, el único evento de hook es prompt, que se activa una vez por cada solicitud de inferencia gobernada, antes de que comience la inferencia. La aplicación de políticas del lado de la respuesta está planificada como un evento posterior.
Cómo funcionan los Inference hooks
- Un usuario envía un prompt en una superficie gobernada.
- Anthropic envía un
POSTHTTPS al endpoint del servidor de seguridad de IA configurado por tu organización. El cuerpo de la solicitud contiene la transcripción de la conversación. Una vez que tu organización genera su secreto de firma, cada solicitud se firma según la especificación Standard Webhooks, para que tu servidor pueda verificar que proviene de Anthropic. - Tu servidor de seguridad de IA evalúa el contenido y responde con un veredicto dentro del tiempo de espera de veredicto que configura tu organización (5 segundos de forma predeterminada).
- Con
allow, la inferencia continúa con normalidad. Condeny, la solicitud se rechaza y el usuario ve un mensaje de bloqueo por política compuesto de dos partes. La primera es el motivo específico de la solicitud que tu servidor de seguridad de IA proporcionó en el campodeny_reasondel veredicto. La segunda es un mensaje permanente que configuran tus administradores (por ejemplo, a quién contactar o dónde solicitar una excepción). Si tus administradores no han configurado uno, un mensaje predeterminado integrado indica al usuario que se comunique con ellos. Cada denegación también se registra en el Activity Feed de tu organización.
El siguiente diagrama sigue un ejemplo (una solicitud de Cowork en la que Claude también llama a una herramienta de O365) para ilustrar qué partes del flujo tienen hooks. Los puntos con hooks son los pasos 1 y 6 del diagrama, donde llega el prompt y donde regresa el resultado de la herramienta. Cada uno da lugar al intercambio de validación con tu servidor de seguridad de IA que se muestra en los pasos 2–3 y 7–8.
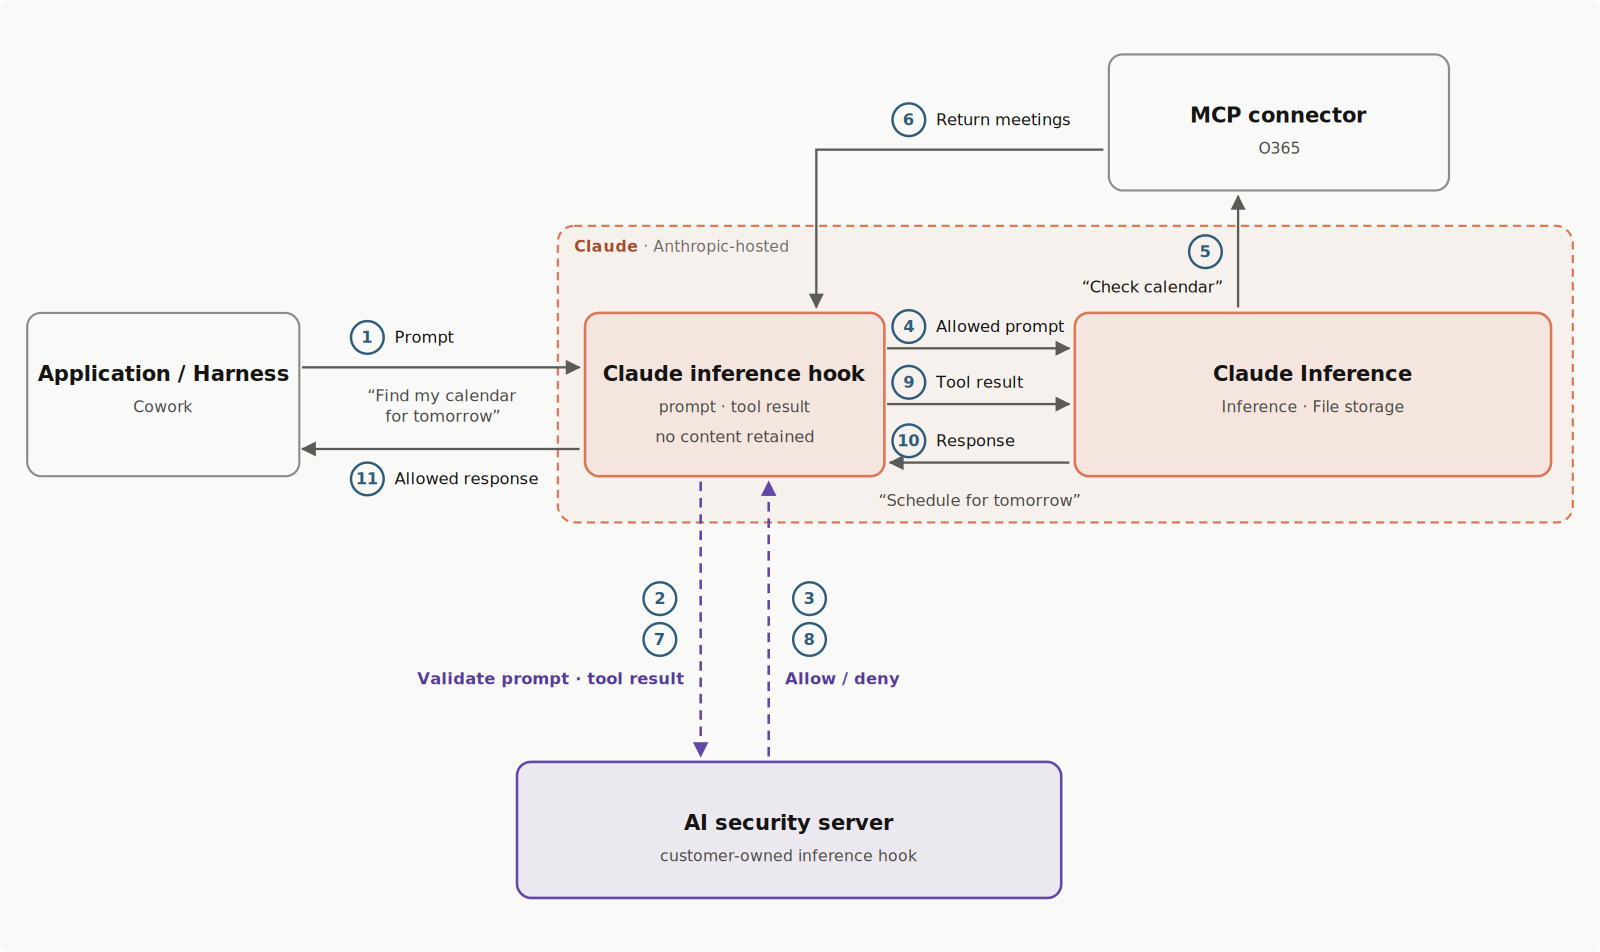
Un veredicto es un pequeño objeto JSON: {"action": "allow"} permite que la solicitud continúe, y una denegación incluye el motivo que se muestra al usuario. Para ver el esquema completo del veredicto, consulta Devolver un veredicto.
Tu servidor de seguridad de IA ve lo mismo que ve el usuario: el texto de la transcripción, las llamadas a herramientas y sus resultados, y el texto extraído de los archivos adjuntos. Nunca recibe los bytes sin procesar de archivos o imágenes, las indicaciones del sistema ni el contexto interno de Anthropic. Anthropic no almacena el contenido de los prompts ni de las respuestas como parte de los Inference hooks. Solo registra metadatos sobre la actividad de los hooks, como veredictos, marcas de tiempo e identificadores de solicitud.
Si tu servidor de seguridad de IA no está disponible, devuelve un error o no responde dentro del tiempo de espera, la configuración de manejo de fallos de tu organización decide el resultado: bloquear la solicitud o permitir que continúe sin inspección. Los fallos sostenidos atribuibles a tu servidor activan un "circuit breaker" (disyuntor). En ese caso, Anthropic deja de contactar a tu servidor y aplica tu configuración de manejo de fallos a cada solicitud. El circuit breaker se restablece automáticamente cuando Anthropic detecta que tu servidor vuelve a devolver veredictos; consulta Circuit breaker.
Puedes implementar la aplicación de políticas a tu propio ritmo, para que nadie quede bloqueado desde el primer día. Tienes tres opciones:
- El "shadow mode" (modo sombra) observa los veredictos sobre el tráfico real sin bloquear nada.
- Un porcentaje de implementación inspecciona la fracción de solicitudes que elijas.
- Las exclusiones eximen por completo a los miembros de los roles que elijas.
Consulta Configurar Inference hooks.
Para ver los esquemas completos de solicitud y respuesta, la verificación de firmas y los detalles operativos, consulta Desarrollar una integración.
Casos de uso
- "Data loss prevention" (prevención de pérdida de datos), o DLP. Reenvía la transcripción a tu escáner de DLP y deniega los prompts que contengan material regulado o clasificado. Esta es la implementación más común.
- Archivado de transcripciones en tiempo real. Archiva cada transcripción a medida que llega y devuelve siempre
allow, como alternativa basada en envío (push) a consultar periódicamente la Compliance API. - Telemetría de prompts. Mide cómo usa Claude tu organización, en el momento de uso.
- Motores de políticas. Aplica tus propias reglas antes de la inferencia: listas de modelos permitidos, restricciones por proyecto o controles de horario laboral.
Limitaciones actuales
- Los archivos adjuntos se representan mediante metadatos y texto extraído. Los bytes sin procesar de archivos e imágenes nunca se envían, por lo que el contenido que solo consiste en imágenes (por ejemplo, una captura de pantalla de un documento) no se inspecciona.
- Los veredictos son permitir o denegar. No se admite reescribir ni censurar partes de un prompt.
- Las organizaciones de Platform (acceso a la API a través de Claude Platform) quedan fuera del alcance.
Disponibilidad
Los Inference hooks están disponibles para las organizaciones de Claude Enterprise. Para configurarlos se necesita el permiso organization:manage, que solo tienen los roles Owner y Primary owner.
Un solo hook gobierna las conversaciones en claude.ai, Cowork y las sesiones de Claude Code de tu organización de Claude Enterprise. Esto aplica tanto en la web como en las aplicaciones de escritorio o móviles y en la CLI. Los Inference hooks no están disponibles en Amazon Bedrock ni en Google Cloud.
Las solicitudes gobernadas son las solicitudes de inferencia que sustentan la conversación del usuario. Las solicitudes auxiliares, como la generación de títulos de conversación, no se envían a tu endpoint. Las indicaciones del sistema y las definiciones de herramientas nunca se incluyen en lo que se envía. El modo de voz no está cubierto.
Inference hooks frente a la Compliance API
Ambas funciones están dirigidas a los equipos de seguridad, legales y de cumplimiento de las organizaciones de Claude Enterprise.
| Inference hooks | Compliance API | |
|---|---|---|
| Cuándo actúa | En línea, antes de que se ejecute la inferencia | A posteriori |
| Qué hace | Permite o deniega cada solicitud gobernada en tiempo real | Recupera actividad, chats, archivos, proyectos, transcripciones de sesiones y usuarios para auditoría y exportación |
| Dirección | Anthropic llama a tu servidor de seguridad de IA | Tú llamas a la API de Anthropic |
Usa los Inference hooks para detener una solicitud antes de que llegue al modelo, y la Compliance API para auditar lo que ocurrió después.
En esta sección
Habilita los Inference hooks para tu organización, configura y prueba tu servidor de seguridad de IA, elige el manejo de fallos y aplica los veredictos.
Los esquemas de solicitud y de veredicto, la verificación de firmas, la semántica operativa y los patrones de integración para construir el servidor de seguridad de IA.
Was this page helpful?