Enrutamiento de tickets
Esta guía explica cómo aprovechar las capacidades avanzadas de comprensión del lenguaje natural de Claude para clasificar tickets de soporte al cliente a escala según la intención del cliente, la urgencia, la priorización, el perfil del cliente y más.
Requisitos previos
- Una clave de API de Claude y el SDK de Python instalado
- Acceso a tu sistema de tickets de soporte existente y familiaridad con él
- Un conjunto de muestra de tickets de soporte históricos para pruebas
Define si usar Claude para el enrutamiento de tickets
Estos son algunos indicadores clave de que deberías usar un "large language model" (modelo de lenguaje grande), o LLM, como Claude en lugar de enfoques tradicionales de ML para tu tarea de clasificación:
Los procesos tradicionales de ML requieren conjuntos de datos etiquetados masivos. El modelo preentrenado de Claude puede clasificar tickets de manera efectiva con solo unas pocas docenas de ejemplos etiquetados, lo que reduce significativamente el tiempo y los costos de preparación de datos.
Una vez que se ha establecido un enfoque tradicional de ML, cambiarlo es una tarea laboriosa que requiere muchos datos. Por otro lado, a medida que tu producto o las necesidades de tus clientes evolucionan, Claude puede adaptarse fácilmente a cambios en las definiciones de clases o a nuevas clases sin un reetiquetado extenso de los datos de entrenamiento.
Los modelos tradicionales de ML a menudo tienen dificultades con datos no estructurados y requieren una extensa ingeniería de características. La comprensión avanzada del lenguaje de Claude permite una clasificación precisa basada en el contenido y el contexto, en lugar de depender de estructuras ontológicas estrictas.
Los enfoques tradicionales de ML a menudo dependen de modelos de bolsa de palabras o de coincidencia simple de patrones. Claude sobresale en comprender y aplicar reglas subyacentes cuando las clases se definen por condiciones en lugar de ejemplos.
Muchos modelos tradicionales de ML ofrecen poca visibilidad sobre su proceso de toma de decisiones. Claude puede proporcionar explicaciones legibles por humanos para sus decisiones de clasificación, lo que genera confianza en el sistema de automatización y facilita la adaptación si es necesario.
Los sistemas tradicionales de ML a menudo tienen dificultades con valores atípicos y entradas ambiguas, clasificándolos incorrectamente con frecuencia o asignándolos por defecto a una categoría general. Las capacidades de procesamiento de lenguaje natural de Claude le permiten interpretar mejor el contexto y los matices en los tickets de soporte, lo que potencialmente reduce la cantidad de tickets mal enrutados o sin clasificar que requieren intervención manual.
Los enfoques tradicionales de ML normalmente requieren modelos separados o procesos de traducción extensos para cada idioma admitido. Las capacidades multilingües de Claude le permiten clasificar tickets en varios idiomas sin necesidad de modelos separados ni procesos de traducción extensos, lo que simplifica el soporte para bases de clientes globales.
Construye y despliega tu flujo de trabajo de soporte con LLM
Comprende tu enfoque de soporte actual
Antes de automatizar, es crucial comprender tu sistema de tickets existente. Comienza investigando cómo tu equipo de soporte maneja actualmente el enrutamiento de tickets.
Considera preguntas como:
- ¿Qué criterios se utilizan para determinar qué SLA/oferta de servicio se aplica?
- ¿Se utiliza el enrutamiento de tickets para determinar a qué nivel de soporte o especialista de producto va un ticket?
- ¿Existen ya reglas o flujos de trabajo automatizados? ¿En qué casos fallan?
- ¿Cómo se manejan los casos límite o los tickets ambiguos?
- ¿Cómo prioriza el equipo los tickets?
Cuanto más sepas sobre cómo los humanos manejan ciertos casos, mejor podrás trabajar con Claude para realizar la tarea.
Define las categorías de intención del usuario
Una lista bien definida de categorías de intención del usuario es crucial para una clasificación precisa de tickets de soporte con Claude. La capacidad de Claude para enrutar tickets de manera efectiva dentro de tu sistema es directamente proporcional a lo bien definidas que estén las categorías de tu sistema.
Estos son algunos ejemplos de categorías y subcategorías de intención del usuario.
- Problema de hardware
- Error de software
- Problema de compatibilidad
- Problema de rendimiento
- Restablecimiento de contraseña
- Problemas de acceso a la cuenta
- Consultas de facturación
- Cambios de suscripción
- Consultas sobre funciones
- Preguntas sobre compatibilidad del producto
- Información de precios
- Consultas de disponibilidad
- Preguntas de tipo "cómo hacer"
- Asistencia en el uso de funciones
- Consejos sobre mejores prácticas
- Orientación para la resolución de problemas
- Reportes de errores
- Solicitudes de funciones
- Retroalimentación general o sugerencias
- Quejas
- Consultas sobre el estado del pedido
- Información de envío
- Devoluciones y cambios
- Modificaciones de pedidos
- Asistencia de instalación
- Solicitudes de actualización
- Programación de mantenimiento
- Cancelación de servicio
- Consultas sobre privacidad de datos
- Reportes de actividad sospechosa
- Asistencia con funciones de seguridad
- Preguntas sobre cumplimiento normativo
- Consultas sobre términos de servicio
- Solicitudes de documentación legal
- Fallas críticas del sistema
- Problemas de seguridad urgentes
- Problemas sensibles al tiempo
- Solicitudes de capacitación sobre el producto
- Consultas sobre documentación
- Información sobre webinars o talleres
- Asistencia de integración
- Preguntas sobre el uso de la API
- Consultas sobre compatibilidad con terceros
Además de la intención, el enrutamiento y la priorización de tickets también pueden verse influidos por otros factores como la urgencia, el tipo de cliente, los SLA o el idioma. Asegúrate de considerar otros criterios de enrutamiento al construir tu sistema de enrutamiento automatizado.
Establece criterios de éxito
Trabaja con tu equipo de soporte para definir criterios de éxito claros con puntos de referencia, umbrales y objetivos medibles.
Estos son algunos criterios y puntos de referencia estándar al usar LLMs para el enrutamiento de tickets de soporte:
Esta métrica evalúa qué tan consistentemente Claude clasifica tickets similares a lo largo del tiempo. Es crucial para mantener la confiabilidad del enrutamiento. Mídela probando periódicamente el modelo con un conjunto de entradas estandarizadas y apuntando a una tasa de consistencia del 95% o superior.
Esto mide qué tan rápido Claude puede adaptarse a nuevas categorías o a patrones de tickets cambiantes. Pruébalo introduciendo nuevos tipos de tickets y midiendo el tiempo que tarda el modelo en alcanzar una precisión satisfactoria (por ejemplo, >90%) en estas nuevas categorías. Apunta a una adaptación dentro de 50–100 tickets de muestra.
Esto evalúa la capacidad de Claude para enrutar con precisión tickets en múltiples idiomas. Mide la precisión del enrutamiento en diferentes idiomas, apuntando a una caída de precisión no mayor al 5–10% para los idiomas no principales.
Esto evalúa el rendimiento de Claude en tickets inusuales o complejos. Crea un conjunto de prueba de casos límite y mide la precisión del enrutamiento, apuntando a al menos un 80% de precisión en estas entradas desafiantes.
Esto mide la equidad de Claude en el enrutamiento entre diferentes grupos demográficos de clientes. Audita regularmente las decisiones de enrutamiento en busca de posibles sesgos, apuntando a una precisión de enrutamiento consistente (dentro del 2–3%) en todos los grupos de clientes.
En situaciones donde minimizar el conteo de tokens es crucial, este criterio evalúa qué tan bien se desempeña Claude con un contexto mínimo. Mide la precisión del enrutamiento con distintas cantidades de contexto proporcionado, apuntando a una precisión del 90% o más con solo el título del ticket y una breve descripción.
Esto evalúa la calidad y relevancia de las explicaciones de Claude para sus decisiones de enrutamiento. Evaluadores humanos pueden puntuar las explicaciones en una escala (por ejemplo, 1–5), con el objetivo de lograr una puntuación promedio de 4 o superior.
Estos son algunos criterios de éxito comunes que pueden ser útiles independientemente de si se usa un LLM:
La precisión del enrutamiento mide con qué frecuencia los tickets se asignan correctamente al equipo o persona apropiada en el primer intento. Normalmente se mide como un porcentaje de tickets enrutados correctamente sobre el total de tickets. Los puntos de referencia de la industria suelen apuntar a una precisión del 90–95%, aunque esto puede variar según la complejidad de la estructura de soporte.
Esta métrica rastrea qué tan rápido se asignan los tickets después de ser enviados. Tiempos de asignación más rápidos generalmente conducen a resoluciones más rápidas y a una mayor satisfacción del cliente. Los mejores sistemas de su clase suelen lograr tiempos de asignación promedio de menos de 5 minutos, y muchos apuntan a un enrutamiento casi instantáneo (lo cual es posible con implementaciones de LLM).
La tasa de reenrutamiento indica con qué frecuencia los tickets deben reasignarse después del enrutamiento inicial. Una tasa más baja sugiere un enrutamiento inicial más preciso. Apunta a una tasa de reenrutamiento inferior al 10%, con los sistemas de mejor rendimiento logrando tasas tan bajas como el 5% o menos.
Esto mide el porcentaje de tickets resueltos durante la primera interacción con el cliente. Tasas más altas indican un enrutamiento eficiente y equipos de soporte bien preparados. Los puntos de referencia de la industria suelen oscilar entre el 70–75%, con los mejores logrando tasas del 80% o superiores.
El tiempo promedio de gestión mide cuánto tiempo se tarda en resolver un ticket de principio a fin. Un enrutamiento eficiente puede reducir significativamente este tiempo. Los puntos de referencia varían ampliamente según la industria y la complejidad, pero muchas organizaciones apuntan a mantener el tiempo promedio de gestión por debajo de 24 horas para problemas no críticos.
A menudo medidas mediante encuestas posteriores a la interacción, estas puntuaciones reflejan la satisfacción general del cliente con el proceso de soporte. Un enrutamiento efectivo contribuye a una mayor satisfacción. Apunta a puntuaciones CSAT del 90% o superiores, con los mejores logrando a menudo tasas de satisfacción del 95% o más.
Esto mide con qué frecuencia los tickets deben escalarse a niveles superiores de soporte. Tasas de escalamiento más bajas suelen indicar un enrutamiento inicial más preciso. Esfuérzate por lograr una tasa de escalamiento inferior al 20%, con los mejores sistemas de su clase logrando tasas del 10% o menos.
Esta métrica analiza cuántos tickets pueden manejar los agentes de manera efectiva después de implementar la solución de enrutamiento. Un enrutamiento mejorado debería aumentar la productividad. Mídela rastreando los tickets resueltos por agente por día u hora, apuntando a una mejora del 10–20% después de implementar un nuevo sistema de enrutamiento.
Esto mide el porcentaje de tickets potenciales resueltos mediante opciones de autoservicio antes de ingresar al sistema de enrutamiento. Tasas más altas indican un triaje previo al enrutamiento efectivo. Apunta a una tasa de desvío del 20–30%, con los mejores logrando tasas del 40% o superiores.
Esta métrica calcula el costo promedio de resolver cada ticket de soporte. Un enrutamiento eficiente debería ayudar a reducir este costo con el tiempo. Aunque los puntos de referencia varían ampliamente, muchas organizaciones apuntan a reducir el costo por ticket en un 10–15% después de implementar un sistema de enrutamiento mejorado.
Elige el modelo de Claude adecuado
La elección del modelo depende de las compensaciones entre costo, precisión y tiempo de respuesta.
Muchos clientes han encontrado que claude-haiku-4-5-20251001 es un modelo ideal para el enrutamiento de tickets, ya que es el modelo más rápido y rentable de la familia Claude 4 y aun así ofrece excelentes resultados. Si tu problema de clasificación requiere una profunda experiencia en la materia, un gran volumen de categorías de intención o un razonamiento complejo, puedes optar por el modelo Sonnet más grande.
Construye un prompt sólido
El enrutamiento de tickets es un tipo de tarea de clasificación. Claude analiza el contenido de un ticket de soporte y lo clasifica en categorías predefinidas según el tipo de problema, la urgencia, la experiencia requerida u otros factores relevantes.
Escribe un prompt de clasificación de tickets. El prompt inicial debe contener el contenido de la solicitud del usuario y devolver tanto el razonamiento como la intención.
Este es un ejemplo de prompt de clasificación para enrutamiento de tickets:
def classify_support_request(ticket_contents):
    # Define el prompt para la tarea de clasificación
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Estos son los componentes clave de este prompt:
- La plantilla del prompt es un f-string de Python, lo que permite insertar
ticket_contentsdentro de las etiquetas<request>. - El prompt le da a Claude un rol claramente definido como un sistema de clasificación que analiza cuidadosamente el contenido del ticket para determinar la intención y las necesidades principales del cliente.
- El prompt instruye a Claude sobre el formato de salida adecuado, en este caso proporcionar su razonamiento y análisis dentro de etiquetas
<reasoning>, seguido de la etiqueta de clasificación apropiada dentro de etiquetas<intent>. - El prompt especifica las categorías de intención válidas: "Support, Feedback, Complaint", "Order Tracking" y "Refund/Exchange".
- El prompt incluye algunos ejemplos (también conocido como few-shot prompting) para ilustrar cómo debe formatearse la salida, lo que mejora la precisión y la consistencia.
Hacer que Claude divida su respuesta en secciones separadas con etiquetas XML te permite usar expresiones regulares para extraer el razonamiento y la intención de la salida de forma independiente. Esto te permite crear pasos siguientes específicos en el flujo de trabajo de enrutamiento de tickets, como usar solo la intención para decidir a qué persona enrutar el ticket.
Despliega tu prompt
Es difícil saber qué tan bien funciona tu prompt sin desplegarlo en un entorno de producción de prueba y ejecutar evaluaciones.
Construye la estructura de despliegue. Comienza definiendo la firma del método que envuelve la llamada a Claude. Extiende el método que comenzaste a escribir antes, que toma ticket_contents como entrada, para que ahora devuelva una tupla de reasoning e intent como salida. Si tienes una automatización existente que usa ML tradicional, querrás seguir esa firma de método en su lugar.
import re

# Crea una instancia del cliente de la API de Claude
client = anthropic.Anthropic()

# Establece el modelo predeterminado
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Define el prompt para la tarea de clasificación
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Envía el prompt a la API para clasificar la solicitud de soporte.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Usa la biblioteca de expresiones regulares de Python para extraer `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # De manera similar, extrae también el `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Este código:
- Crea una instancia del cliente usando tu clave de API.
- Define una función
classify_support_requestque toma una cadenaticket_contents. - Envía
ticket_contentsa Claude para su clasificación usando elclassification_prompt. - Devuelve el
reasoningy elintentdel modelo extraídos de la respuesta.
Dado que todo el texto de razonamiento e intención debe generarse antes del análisis, el ejemplo establece stream=False (el valor predeterminado).
Evalúa tu prompt
El prompting a menudo requiere pruebas y optimización para estar listo para producción. Para determinar la preparación de tu solución, evalúa el rendimiento según los criterios de éxito y umbrales que estableciste anteriormente.
Para ejecutar tu evaluación, necesitas casos de prueba sobre los cuales ejecutarla. El resto de esta guía asume que ya has desarrollado tus casos de prueba.
Construye una función de evaluación
La evaluación de ejemplo de esta guía mide el rendimiento de Claude en tres métricas clave:
- Precisión
- Costo por clasificación
Es posible que necesites evaluar a Claude en otros ejes dependiendo de qué factores sean importantes para ti.
Para evaluar esto, primero modifica el script para agregar una función que compare la intención predicha con la intención real y calcule el porcentaje de predicciones correctas. Luego agrega funcionalidad de cálculo de costos y medición de tiempo.
import re

# Crea una instancia del cliente de la API de Claude
client = anthropic.Anthropic()

# Establece el modelo predeterminado
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Define el prompt para la tarea de clasificación
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Usa la biblioteca de expresiones regulares de Python para extraer `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # De manera similar, extrae también el `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Verifica si la predicción del modelo es correcta.
    correct = actual_intent.strip() == intent.strip()

    # Devuelve el razonamiento, la intención, si es correcta y el uso.
    return reasoning, intent, correct, usage
Este es un desglose de las modificaciones:
- El método
classify_support_requestahora toma elactual_intentde los casos de prueba y lo compara con la clasificación de intención de Claude para evaluar si coinciden. - El método extrae estadísticas de uso de la llamada a la API para calcular el costo según los tokens de entrada y salida utilizados.
Ejecuta tu evaluación
Una evaluación adecuada requiere umbrales y puntos de referencia claros para determinar qué es un buen resultado. El script anterior devuelve los valores en tiempo de ejecución de precisión, tiempo de respuesta y costo por clasificación, pero aún necesitas umbrales claramente establecidos. Por ejemplo:
- Precisión: 95% (de 100 pruebas)
- Costo por clasificación: reducción del 50% en promedio (en 100 pruebas) respecto al método de enrutamiento actual
Tener estos umbrales te permite determinar rápida y fácilmente a escala, y con empirismo imparcial, qué método es mejor para ti y qué cambios podrían ser necesarios para ajustarse mejor a tus requisitos.
Mejora el rendimiento
En escenarios complejos, puede ser útil considerar estrategias adicionales para mejorar el rendimiento más allá de las técnicas de ingeniería de prompts estándar y las estrategias de implementación de barreras de protección. Estos son algunos escenarios comunes:
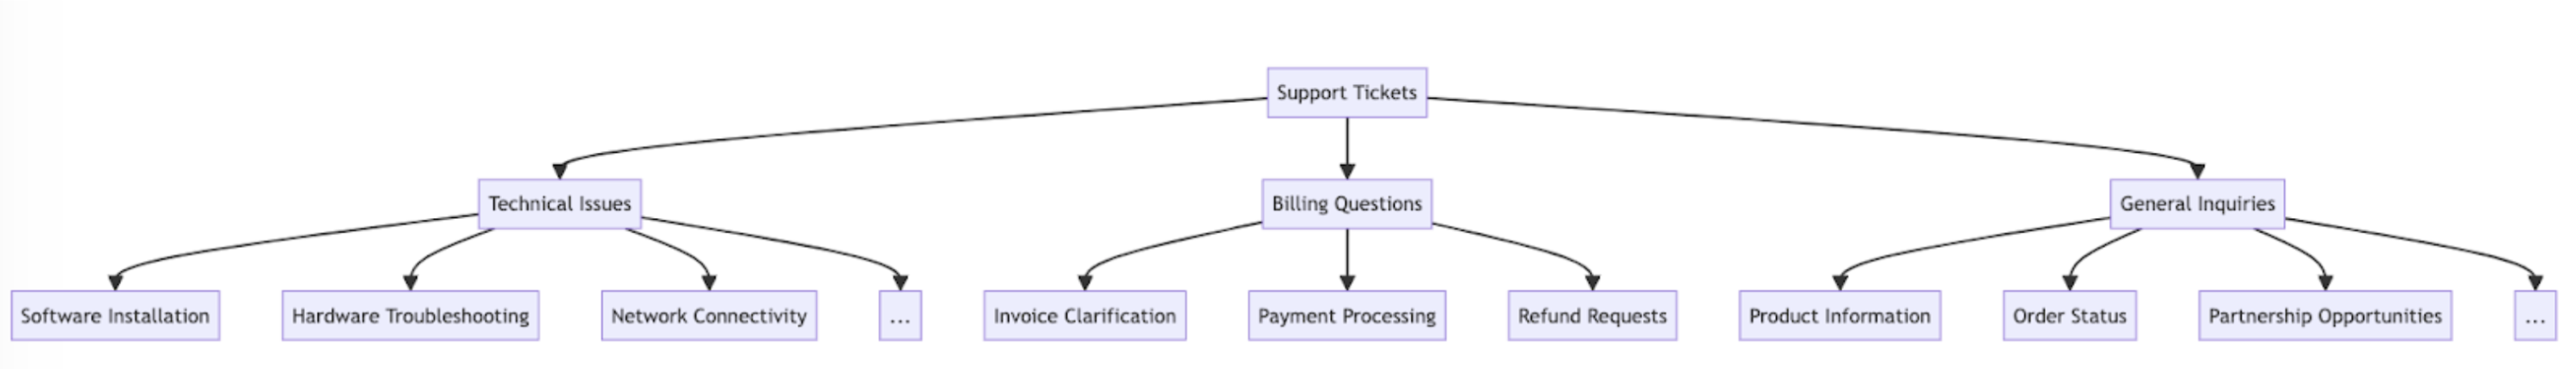
Usa una jerarquía taxonómica para casos con más de 20 categorías de intención
A medida que crece el número de clases, también aumenta el número de ejemplos requeridos, lo que potencialmente hace que el prompt sea difícil de manejar. Como alternativa, puedes considerar implementar un sistema de clasificación jerárquico usando una combinación de clasificadores.
- Organiza tus intenciones en una estructura de árbol taxonómico.
- Crea una serie de clasificadores en cada nivel del árbol, lo que permite un enfoque de enrutamiento en cascada.
Por ejemplo, podrías tener un clasificador de nivel superior que categorice ampliamente los tickets en "Technical Issues" (problemas técnicos), "Billing Questions" (preguntas de facturación) y "General Inquiries" (consultas generales). Cada una de estas categorías puede tener su propio subclasificador para refinar aún más la clasificación.
-
Ventajas - mayor matiz y precisión: Puedes crear diferentes prompts para cada ruta principal, lo que permite una clasificación más específica y adaptada al contexto. Esto puede conducir a una mayor precisión y a un manejo más matizado de las solicitudes de los clientes.
-
Desventajas - mayor latencia: Ten en cuenta que múltiples clasificadores pueden generar una mayor "latency" (latencia), y Anthropic recomienda implementar este enfoque con el modelo más rápido, Haiku.
Usa bases de datos vectoriales y recuperación por búsqueda de similitud para manejar tickets altamente variables
Aunque proporcionar ejemplos es la forma más efectiva de mejorar el rendimiento, si las solicitudes de soporte son altamente variables, puede ser difícil incluir suficientes ejemplos en un solo prompt.
En este escenario, podrías emplear una base de datos vectorial para realizar búsquedas de similitud a partir de un conjunto de datos de ejemplos y recuperar los ejemplos más relevantes para una consulta dada.
Este enfoque, descrito en detalle en la receta de clasificación, ha demostrado mejorar el rendimiento de un 71% de precisión a un 93% de precisión.
Ten en cuenta específicamente los casos límite esperados
Estos son algunos escenarios en los que Claude puede clasificar incorrectamente los tickets (puede haber otros que sean únicos para tu situación). En estos escenarios, considera proporcionar instrucciones explícitas o ejemplos en el prompt sobre cómo Claude debe manejar el caso límite:
Los clientes a menudo expresan sus necesidades de forma indirecta. Por ejemplo, "Llevo esperando mi paquete más de dos semanas" puede ser una solicitud indirecta del estado del pedido.
- Solución: Proporciona a Claude algunos ejemplos reales de clientes con este tipo de solicitudes, junto con cuál es la intención subyacente. Puedes obtener resultados aún mejores si incluyes una justificación de clasificación para intenciones de tickets particularmente matizadas, de modo que Claude pueda generalizar mejor la lógica a otros tickets.
Cuando los clientes expresan insatisfacción, Claude puede priorizar abordar la emoción por encima de resolver el problema subyacente.
- Solución: Proporciona a Claude indicaciones sobre cuándo priorizar o no el sentimiento del cliente. Puede ser algo tan simple como "Ignora todas las emociones del cliente. Concéntrate solo en analizar la intención de la solicitud del cliente y qué información podría estar pidiendo el cliente."
Cuando los clientes presentan múltiples problemas en una sola interacción, Claude puede tener dificultades para identificar la preocupación principal.
- Solución: Aclara la priorización de intenciones para que Claude pueda ordenar mejor las intenciones extraídas e identificar la preocupación principal.
Integra Claude en tu flujo de trabajo de soporte general
Una integración adecuada requiere que tomes algunas decisiones sobre cómo tu script de enrutamiento de tickets basado en Claude encaja en la arquitectura de tu sistema de enrutamiento de tickets general. Hay dos formas de hacerlo:
- Basado en push: El sistema de tickets de soporte que estás usando (por ejemplo, Zendesk) activa tu código enviando un evento de webhook a tu servicio de enrutamiento, que luego clasifica la intención y lo enruta.
- Este enfoque es más escalable en la web, pero requiere que expongas un endpoint público.
- Basado en pull: Tu código consulta los tickets más recientes según un cronograma determinado y los enruta en el momento de la consulta.
- Este enfoque es más fácil de implementar, pero podría realizar llamadas innecesarias al sistema de tickets de soporte cuando la frecuencia de consulta es demasiado alta, o podría ser demasiado lento cuando la frecuencia de consulta es demasiado baja.
Para cualquiera de estos enfoques, necesitas envolver tu script en un servicio. La elección del enfoque depende de qué APIs proporcione tu sistema de tickets de soporte.
Visita el cookbook de clasificación para ver más código de ejemplo y orientación detallada sobre evaluaciones.
Comienza a construir y evaluar tu flujo de trabajo en la Claude Console.
Was this page helpful?