Ticket-Routing
Dieser Leitfaden zeigt, wie du Claudes fortschrittliche Fähigkeiten zum Verstehen natürlicher Sprache nutzen kannst, um Kundensupport-Tickets in großem Umfang nach Kundenabsicht, Dringlichkeit, Priorisierung, Kundenprofil und mehr zu klassifizieren.
Voraussetzungen
- Ein Claude API-Key und das installierte Python SDK
- Zugriff auf dein bestehendes Support-Ticketsystem und Vertrautheit damit
- Ein Beispielsatz historischer Support-Tickets zum Testen
Festlegen, ob Claude für das Ticket-Routing verwendet werden soll
Hier sind einige wichtige Indikatoren dafür, dass du ein „large language model“ (großes Sprachmodell), oder LLM, wie Claude anstelle traditioneller ML-Ansätze für deine Klassifizierungsaufgabe verwenden solltest:
Traditionelle ML-Prozesse erfordern riesige gelabelte Datensätze. Claudes vortrainiertes Modell kann Tickets mit nur wenigen Dutzend gelabelten Beispielen effektiv klassifizieren, was den Zeit- und Kostenaufwand für die Datenvorbereitung erheblich reduziert.
Sobald ein traditioneller ML-Ansatz etabliert ist, ist seine Änderung ein mühsames und datenintensives Unterfangen. Claude hingegen kann sich, wenn sich dein Produkt oder die Bedürfnisse deiner Kunden weiterentwickeln, leicht an Änderungen der Klassendefinitionen oder an neue Klassen anpassen, ohne dass Trainingsdaten umfangreich neu gelabelt werden müssen.
Traditionelle ML-Modelle haben oft Schwierigkeiten mit unstrukturierten Daten und erfordern umfangreiches Feature Engineering. Claudes fortschrittliches Sprachverständnis ermöglicht eine genaue Klassifizierung auf Grundlage von Inhalt und Kontext, anstatt sich auf strenge ontologische Strukturen zu verlassen.
Traditionelle ML-Ansätze stützen sich oft auf Bag-of-Words-Modelle oder einfaches Pattern Matching. Claude ist hervorragend darin, zugrunde liegende Regeln zu verstehen und anzuwenden, wenn Klassen durch Bedingungen statt durch Beispiele definiert sind.
Viele traditionelle ML-Modelle geben wenig Einblick in ihren Entscheidungsprozess. Claude kann menschenlesbare Erklärungen für seine Klassifizierungsentscheidungen liefern, was Vertrauen in das Automatisierungssystem schafft und bei Bedarf eine einfache Anpassung ermöglicht.
Traditionelle ML-Systeme haben oft Schwierigkeiten mit Ausreißern und mehrdeutigen Eingaben, klassifizieren sie häufig falsch oder ordnen sie standardmäßig einer Sammelkategorie zu. Claudes Fähigkeiten zur Verarbeitung natürlicher Sprache ermöglichen es, Kontext und Nuancen in Support-Tickets besser zu interpretieren, wodurch sich die Anzahl falsch weitergeleiteter oder nicht klassifizierter Tickets, die manuelles Eingreifen erfordern, potenziell verringert.
Traditionelle ML-Ansätze erfordern in der Regel separate Modelle oder umfangreiche Übersetzungsprozesse für jede unterstützte Sprache. Claudes mehrsprachige Fähigkeiten ermöglichen es, Tickets in verschiedenen Sprachen zu klassifizieren, ohne dass separate Modelle oder umfangreiche Übersetzungsprozesse erforderlich sind, was den Support für globale Kundenstämme vereinfacht.
Deinen LLM-Support-Workflow erstellen und bereitstellen
Deinen aktuellen Support-Ansatz verstehen
Bevor du automatisierst, ist es entscheidend, dein bestehendes Ticketsystem zu verstehen. Beginne damit, zu untersuchen, wie dein Support-Team derzeit das Ticket-Routing handhabt.
Berücksichtige Fragen wie:
- Welche Kriterien werden verwendet, um zu bestimmen, welches SLA/Serviceangebot angewendet wird?
- Wird das Ticket-Routing verwendet, um zu bestimmen, an welche Support-Stufe oder welchen Produktspezialisten ein Ticket geht?
- Gibt es bereits automatisierte Regeln oder Workflows? In welchen Fällen versagen sie?
- Wie werden Grenzfälle oder mehrdeutige Tickets behandelt?
- Wie priorisiert das Team Tickets?
Je mehr du darüber weißt, wie Menschen bestimmte Fälle handhaben, desto besser kannst du mit Claude zusammenarbeiten, um die Aufgabe zu erledigen.
Kategorien für Nutzerabsichten definieren
Eine gut definierte Liste von Kategorien für Nutzerabsichten ist entscheidend für eine genaue Klassifizierung von Support-Tickets mit Claude. Claudes Fähigkeit, Tickets innerhalb deines Systems effektiv weiterzuleiten, ist direkt proportional dazu, wie gut die Kategorien deines Systems definiert sind.
Hier sind einige Beispiele für Kategorien und Unterkategorien von Nutzerabsichten.
- Hardwareproblem
- Softwarefehler
- Kompatibilitätsproblem
- Leistungsproblem
- Passwort zurücksetzen
- Probleme beim Kontozugriff
- Abrechnungsanfragen
- Abonnementänderungen
- Anfragen zu Funktionen
- Fragen zur Produktkompatibilität
- Preisinformationen
- Verfügbarkeitsanfragen
- How-to-Fragen
- Unterstützung bei der Funktionsnutzung
- Beratung zu Best Practices
- Anleitung zur Fehlerbehebung
- Fehlerberichte
- Funktionswünsche
- Allgemeines Feedback oder Vorschläge
- Beschwerden
- Anfragen zum Bestellstatus
- Versandinformationen
- Rückgaben und Umtausch
- Bestelländerungen
- Installationsunterstützung
- Upgrade-Anfragen
- Wartungsterminplanung
- Servicekündigung
- Datenschutzanfragen
- Meldungen verdächtiger Aktivitäten
- Unterstützung bei Sicherheitsfunktionen
- Fragen zur Einhaltung von Vorschriften
- Anfragen zu den Nutzungsbedingungen
- Anfragen nach rechtlichen Dokumenten
- Kritische Systemausfälle
- Dringende Sicherheitsprobleme
- Zeitkritische Probleme
- Anfragen zu Produktschulungen
- Dokumentationsanfragen
- Informationen zu Webinaren oder Workshops
- Integrationsunterstützung
- Fragen zur API-Nutzung
- Anfragen zur Kompatibilität mit Drittanbietern
Neben der Absicht können Ticket-Routing und Priorisierung auch von anderen Faktoren wie Dringlichkeit, Kundentyp, SLAs oder Sprache beeinflusst werden. Achte darauf, beim Aufbau deines automatisierten Routing-Systems auch andere Routing-Kriterien zu berücksichtigen.
Erfolgskriterien festlegen
Arbeite mit deinem Support-Team zusammen, um klare Erfolgskriterien zu definieren – mit messbaren Benchmarks, Schwellenwerten und Zielen.
Hier sind einige Standardkriterien und Benchmarks für den Einsatz von LLMs beim Routing von Support-Tickets:
Diese Metrik bewertet, wie konsistent Claude ähnliche Tickets im Laufe der Zeit klassifiziert. Sie ist entscheidend für die Aufrechterhaltung der Routing-Zuverlässigkeit. Miss dies, indem du das Modell regelmäßig mit einem Satz standardisierter Eingaben testest, und strebe eine Konsistenzrate von 95 % oder höher an.
Dies misst, wie schnell sich Claude an neue Kategorien oder sich ändernde Ticketmuster anpassen kann. Teste dies, indem du neue Tickettypen einführst und die Zeit misst, die das Modell benötigt, um bei diesen neuen Kategorien eine zufriedenstellende Genauigkeit (zum Beispiel >90 %) zu erreichen. Strebe eine Anpassung innerhalb von 50–100 Beispieltickets an.
Dies bewertet Claudes Fähigkeit, Tickets in mehreren Sprachen genau weiterzuleiten. Miss die Routing-Genauigkeit über verschiedene Sprachen hinweg und strebe einen Genauigkeitsverlust von nicht mehr als 5–10 % für Nicht-Primärsprachen an.
Dies bewertet Claudes Leistung bei ungewöhnlichen oder komplexen Tickets. Erstelle einen Testsatz mit Grenzfällen und miss die Routing-Genauigkeit, wobei du bei diesen anspruchsvollen Eingaben eine Genauigkeit von mindestens 80 % anstreben solltest.
Dies misst Claudes Fairness beim Routing über verschiedene Kundendemografien hinweg. Überprüfe Routing-Entscheidungen regelmäßig auf mögliche Verzerrungen und strebe eine konsistente Routing-Genauigkeit (innerhalb von 2–3 %) über alle Kundengruppen hinweg an.
In Situationen, in denen die Minimierung der Token-Anzahl entscheidend ist, bewertet dieses Kriterium, wie gut Claude mit minimalem Kontext abschneidet. Miss die Routing-Genauigkeit bei unterschiedlichen Mengen an bereitgestelltem Kontext und strebe eine Genauigkeit von über 90 % mit nur dem Tickettitel und einer kurzen Beschreibung an.
Dies bewertet die Qualität und Relevanz von Claudes Erklärungen für seine Routing-Entscheidungen. Menschliche Bewerter können Erklärungen auf einer Skala (zum Beispiel 1–5) bewerten, mit dem Ziel, einen Durchschnittswert von 4 oder höher zu erreichen.
Hier sind einige gängige Erfolgskriterien, die unabhängig davon nützlich sein können, ob ein LLM verwendet wird:
Die Routing-Genauigkeit misst, wie oft Tickets beim ersten Versuch korrekt dem richtigen Team oder der richtigen Person zugewiesen werden. Dies wird in der Regel als Prozentsatz der korrekt weitergeleiteten Tickets an der Gesamtzahl der Tickets gemessen. Branchen-Benchmarks zielen oft auf eine Genauigkeit von 90–95 % ab, wobei dies je nach Komplexität der Support-Struktur variieren kann.
Diese Metrik erfasst, wie schnell Tickets nach dem Einreichen zugewiesen werden. Schnellere Zuweisungszeiten führen im Allgemeinen zu schnelleren Lösungen und höherer Kundenzufriedenheit. Erstklassige Systeme erreichen oft durchschnittliche Zuweisungszeiten von unter 5 Minuten, wobei viele ein nahezu sofortiges Routing anstreben (was mit LLM-Implementierungen möglich ist).
Die Umleitungsrate gibt an, wie oft Tickets nach dem ersten Routing neu zugewiesen werden müssen. Eine niedrigere Rate deutet auf ein genaueres anfängliches Routing hin. Strebe eine Umleitungsrate unter 10 % an, wobei leistungsstärkste Systeme Raten von nur 5 % oder weniger erreichen.
Dies misst den Prozentsatz der Tickets, die bei der ersten Interaktion mit dem Kunden gelöst werden. Höhere Raten deuten auf effizientes Routing und gut vorbereitete Support-Teams hin. Branchen-Benchmarks liegen in der Regel bei 70–75 %, wobei Spitzenreiter Raten von 80 % oder höher erreichen.
Die durchschnittliche Bearbeitungszeit misst, wie lange es dauert, ein Ticket von Anfang bis Ende zu lösen. Effizientes Routing kann diese Zeit erheblich verkürzen. Benchmarks variieren stark je nach Branche und Komplexität, aber viele Organisationen streben an, die durchschnittliche Bearbeitungszeit für nicht kritische Probleme unter 24 Stunden zu halten.
Diese Werte, die oft durch Umfragen nach der Interaktion gemessen werden, spiegeln die allgemeine Zufriedenheit der Kunden mit dem Support-Prozess wider. Effektives Routing trägt zu höherer Zufriedenheit bei. Strebe CSAT-Werte von 90 % oder höher an, wobei Spitzenreiter oft Zufriedenheitsraten von über 95 % erreichen.
Dies misst, wie oft Tickets an höhere Support-Stufen eskaliert werden müssen. Niedrigere Eskalationsraten deuten oft auf ein genaueres anfängliches Routing hin. Strebe eine Eskalationsrate unter 20 % an, wobei erstklassige Systeme Raten von 10 % oder weniger erreichen.
Diese Metrik betrachtet, wie viele Tickets Agenten nach der Implementierung der Routing-Lösung effektiv bearbeiten können. Verbessertes Routing sollte die Produktivität steigern. Miss dies, indem du die gelösten Tickets pro Agent pro Tag oder Stunde erfasst, und strebe eine Verbesserung von 10–20 % nach der Implementierung eines neuen Routing-Systems an.
Dies misst den Prozentsatz potenzieller Tickets, die durch Self-Service-Optionen gelöst werden, bevor sie in das Routing-System gelangen. Höhere Raten deuten auf eine effektive Triage vor dem Routing hin. Strebe eine Ablenkungsrate von 20–30 % an, wobei Spitzenreiter Raten von 40 % oder höher erreichen.
Diese Metrik berechnet die durchschnittlichen Kosten für die Lösung jedes Support-Tickets. Effizientes Routing sollte dazu beitragen, diese Kosten im Laufe der Zeit zu senken. Obwohl Benchmarks stark variieren, streben viele Organisationen an, die Kosten pro Ticket nach der Implementierung eines verbesserten Routing-Systems um 10–15 % zu senken.
Das richtige Claude-Modell wählen
Die Wahl des Modells hängt von den Abwägungen zwischen Kosten, Genauigkeit und Antwortzeit ab.
Viele Kunden haben festgestellt, dass claude-haiku-4-5-20251001 ein ideales Modell für das Ticket-Routing ist, da es das schnellste und kosteneffizienteste Modell der Claude-4-Familie ist und dennoch hervorragende Ergebnisse liefert. Wenn dein Klassifizierungsproblem tiefes Fachwissen, eine große Anzahl von Absichtskategorien oder komplexes Schlussfolgern erfordert, kannst du dich für das größere Sonnet-Modell entscheiden.
Einen starken Prompt erstellen
Ticket-Routing ist eine Art von Klassifizierungsaufgabe. Claude analysiert den Inhalt eines Support-Tickets und ordnet es anhand des Problemtyps, der Dringlichkeit, der erforderlichen Expertise oder anderer relevanter Faktoren vordefinierten Kategorien zu.
Schreibe einen Prompt zur Ticketklassifizierung. Der anfängliche Prompt sollte den Inhalt der Nutzeranfrage enthalten und sowohl die Begründung als auch die Absicht zurückgeben.
Hier ist ein Beispiel für einen Klassifizierungs-Prompt zum Ticket-Routing:
def classify_support_request(ticket_contents):
    # Definiere den Prompt für die Klassifizierungsaufgabe
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Hier sind die wichtigsten Bestandteile dieses Prompts:
- Die Prompt-Vorlage ist ein Python-f-String, sodass
ticket_contentsin die<request>-Tags eingefügt werden kann. - Der Prompt gibt Claude eine klar definierte Rolle als Klassifizierungssystem, das den Ticketinhalt sorgfältig analysiert, um die Kernabsicht und die Bedürfnisse des Kunden zu ermitteln.
- Der Prompt weist Claude zur korrekten Ausgabeformatierung an, in diesem Fall, seine Begründung und Analyse innerhalb von
<reasoning>-Tags anzugeben, gefolgt vom passenden Klassifizierungslabel innerhalb von<intent>-Tags. - Der Prompt legt die gültigen Absichtskategorien fest: „Support, Feedback, Complaint“, „Order Tracking“ und „Refund/Exchange“.
- Der Prompt enthält einige Beispiele (auch bekannt als Few-Shot-Prompting), um zu veranschaulichen, wie die Ausgabe formatiert sein soll, was Genauigkeit und Konsistenz verbessert.
Wenn Claude seine Antwort in separate XML-Tag-Abschnitte aufteilt, kannst du reguläre Ausdrücke verwenden, um Begründung und Absicht unabhängig voneinander aus der Ausgabe zu extrahieren. So kannst du gezielte nächste Schritte im Ticket-Routing-Workflow erstellen, etwa indem du nur die Absicht verwendest, um zu entscheiden, an welche Person das Ticket weitergeleitet wird.
Deinen Prompt bereitstellen
Es ist schwer zu wissen, wie gut dein Prompt funktioniert, ohne ihn in einer Test-Produktionsumgebung bereitzustellen und Evaluierungen durchzuführen.
Erstelle die Bereitstellungsstruktur. Beginne damit, die Methodensignatur für das Wrappen des Aufrufs an Claude zu definieren. Erweitere die Methode, die du zuvor zu schreiben begonnen hast und die ticket_contents als Eingabe entgegennimmt, sodass sie nun ein Tupel aus reasoning und intent als Ausgabe zurückgibt. Wenn du eine bestehende Automatisierung mit traditionellem ML hast, solltest du stattdessen dieser Methodensignatur folgen.
import re

# Erstelle eine Instanz des Claude API-Clients
client = anthropic.Anthropic()

# Lege das Standardmodell fest
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Definiere den Prompt für die Klassifizierungsaufgabe
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Sende den Prompt an die API, um die Support-Anfrage zu klassifizieren.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Verwende Pythons Bibliothek für reguläre Ausdrücke, um `reasoning` zu extrahieren.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Extrahiere auf die gleiche Weise auch den `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Dieser Code:
- Erstellt eine Client-Instanz mit deinem API-Key.
- Definiert eine Funktion
classify_support_request, die einenticket_contents-String entgegennimmt. - Sendet
ticket_contentsmithilfe desclassification_promptzur Klassifizierung an Claude. - Gibt
reasoningundintentdes Modells zurück, die aus der Antwort extrahiert wurden.
Da der gesamte Begründungs- und Absichtstext vor dem Parsen generiert werden muss, setzt das Beispiel stream=False (den Standardwert).
Deinen Prompt evaluieren
Prompting erfordert oft Tests und Optimierung, um produktionsreif zu sein. Um die Einsatzbereitschaft deiner Lösung zu bestimmen, evaluiere die Leistung anhand der Erfolgskriterien und Schwellenwerte, die du zuvor festgelegt hast.
Um deine Evaluierung durchzuführen, benötigst du Testfälle, auf denen du sie ausführen kannst. Der Rest dieses Leitfadens geht davon aus, dass du bereits deine Testfälle entwickelt hast.
Eine Evaluierungsfunktion erstellen
Die Beispiel-Evaluierung für diesen Leitfaden misst Claudes Leistung anhand von drei Schlüsselmetriken:
- Genauigkeit
- Kosten pro Klassifizierung
Je nachdem, welche Faktoren für dich wichtig sind, musst du Claude möglicherweise auch auf anderen Achsen bewerten.
Um dies zu bewerten, ändere zunächst das Skript, um eine Funktion hinzuzufügen, die die vorhergesagte Absicht mit der tatsächlichen Absicht vergleicht und den Prozentsatz korrekter Vorhersagen berechnet. Füge dann Funktionen zur Kostenberechnung und Zeitmessung hinzu.
import re

# Erstelle eine Instanz des Claude API-Clients
client = anthropic.Anthropic()

# Lege das Standardmodell fest
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Definiere den Prompt für die Klassifizierungsaufgabe
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Verwende Pythons Bibliothek für reguläre Ausdrücke, um `reasoning` zu extrahieren.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Extrahiere auf ähnliche Weise auch den `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Prüfe, ob die Vorhersage des Modells korrekt ist.
    correct = actual_intent.strip() == intent.strip()

    # Gib reasoning, intent, correct und usage zurück.
    return reasoning, intent, correct, usage
Hier ist eine Aufschlüsselung der Änderungen:
- Die Methode
classify_support_requestnimmt nunactual_intentaus den Testfällen entgegen und vergleicht es mit Claudes Absichtsklassifizierung, um zu bewerten, ob sie übereinstimmen. - Die Methode extrahiert Nutzungsstatistiken für den API-Aufruf, um die Kosten auf Grundlage der verwendeten Input- und Output-Token zu berechnen.
Deine Evaluierung durchführen
Eine ordnungsgemäße Evaluierung erfordert klare Schwellenwerte und Benchmarks, um zu bestimmen, was ein gutes Ergebnis ist. Das vorangehende Skript gibt die Laufzeitwerte für Genauigkeit, Antwortzeit und Kosten pro Klassifizierung zurück, aber du benötigst dennoch klar festgelegte Schwellenwerte. Zum Beispiel:
- Genauigkeit: 95 % (bei 100 Tests)
- Kosten pro Klassifizierung: durchschnittlich 50 % Reduzierung (über 100 Tests) gegenüber der aktuellen Routing-Methode
Mit diesen Schwellenwerten kannst du schnell und einfach in großem Umfang und mit unparteiischer Empirie feststellen, welche Methode für dich am besten ist und welche Änderungen möglicherweise vorgenommen werden müssen, um deinen Anforderungen besser zu entsprechen.
Leistung verbessern
In komplexen Szenarien kann es hilfreich sein, zusätzliche Strategien zur Leistungsverbesserung über die standardmäßigen Prompt-Engineering-Techniken und Strategien zur Implementierung von Guardrails hinaus in Betracht zu ziehen. Hier sind einige gängige Szenarien:
Eine taxonomische Hierarchie für Fälle mit mehr als 20 Absichtskategorien verwenden
Mit wachsender Anzahl von Klassen steigt auch die Anzahl der erforderlichen Beispiele, was den Prompt möglicherweise unhandlich macht. Als Alternative kannst du die Implementierung eines hierarchischen Klassifizierungssystems mit einer Mischung von Klassifikatoren in Betracht ziehen.
- Organisiere deine Absichten in einer taxonomischen Baumstruktur.
- Erstelle eine Reihe von Klassifikatoren auf jeder Ebene des Baums, um einen kaskadierenden Routing-Ansatz zu ermöglichen.
Du könntest zum Beispiel einen Klassifikator auf oberster Ebene haben, der Tickets grob in „Technical Issues“ (Technische Probleme), „Billing Questions“ (Abrechnungsfragen) und „General Inquiries“ (Allgemeine Anfragen) einteilt. Jede dieser Kategorien kann dann ihren eigenen Unterklassifikator haben, um die Klassifizierung weiter zu verfeinern.
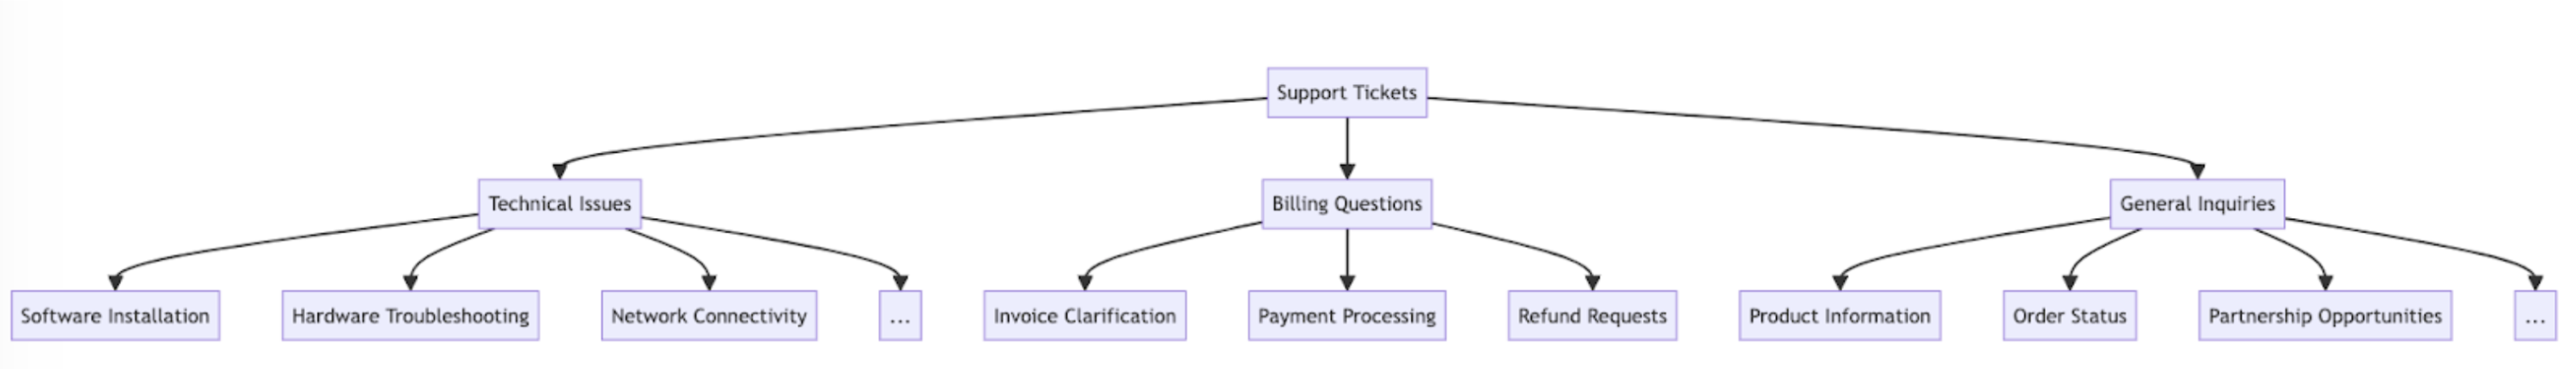
-
Vorteile – mehr Nuancen und Genauigkeit: Du kannst für jeden übergeordneten Pfad unterschiedliche Prompts erstellen, was eine gezieltere und kontextspezifischere Klassifizierung ermöglicht. Dies kann zu verbesserter Genauigkeit und einer nuancierteren Behandlung von Kundenanfragen führen.
-
Nachteile – erhöhte Latenz: Beachte, dass mehrere Klassifikatoren zu erhöhter „latency“ (Latenz) führen können, und Anthropic empfiehlt, diesen Ansatz mit dem schnellsten Modell, Haiku, zu implementieren.
Vektordatenbanken und Ähnlichkeitssuche verwenden, um stark variierende Tickets zu verarbeiten
Obwohl das Bereitstellen von Beispielen der effektivste Weg zur Leistungsverbesserung ist, kann es schwierig sein, genügend Beispiele in einen einzigen Prompt aufzunehmen, wenn Support-Anfragen stark variieren.
In diesem Szenario könntest du eine Vektordatenbank einsetzen, um Ähnlichkeitssuchen in einem Datensatz von Beispielen durchzuführen und die relevantesten Beispiele für eine bestimmte Anfrage abzurufen.
Dieser Ansatz, der im Klassifizierungsrezept ausführlich beschrieben wird, hat nachweislich die Leistung von 71 % Genauigkeit auf 93 % Genauigkeit verbessert.
Erwartete Grenzfälle gezielt berücksichtigen
Hier sind einige Szenarien, in denen Claude Tickets möglicherweise falsch klassifiziert (es kann weitere geben, die für deine Situation spezifisch sind). Erwäge in diesen Szenarien, im Prompt explizite Anweisungen oder Beispiele dafür bereitzustellen, wie Claude den Grenzfall behandeln soll:
Kunden äußern Bedürfnisse oft indirekt. Zum Beispiel kann „Ich warte jetzt schon seit über zwei Wochen auf mein Paket“ eine indirekte Anfrage zum Bestellstatus sein.
- Lösung: Stelle Claude einige echte Kundenbeispiele für diese Art von Anfragen zur Verfügung, zusammen mit der zugrunde liegenden Absicht. Du kannst noch bessere Ergebnisse erzielen, wenn du für besonders nuancierte Ticketabsichten eine Klassifizierungsbegründung angibst, damit Claude die Logik besser auf andere Tickets übertragen kann.
Wenn Kunden Unzufriedenheit äußern, priorisiert Claude möglicherweise das Eingehen auf die Emotion gegenüber der Lösung des zugrunde liegenden Problems.
- Lösung: Gib Claude Anweisungen, wann die Kundenstimmung priorisiert werden soll und wann nicht. Das kann etwas so Einfaches sein wie „Ignoriere alle Kundenemotionen. Konzentriere dich ausschließlich auf die Analyse der Absicht der Kundenanfrage und darauf, welche Informationen der Kunde möglicherweise erfragt."
Wenn Kunden in einer einzigen Interaktion mehrere Probleme vorbringen, kann Claude Schwierigkeiten haben, das Hauptanliegen zu identifizieren.
- Lösung: Kläre die Priorisierung der Absichten, damit Claude die extrahierten Absichten besser einordnen und das Hauptanliegen identifizieren kann.
Claude in deinen übergeordneten Support-Workflow integrieren
Eine ordnungsgemäße Integration erfordert, dass du einige Entscheidungen darüber triffst, wie dein Claude-basiertes Ticket-Routing-Skript in die Architektur deines übergeordneten Ticket-Routing-Systems passt. Es gibt zwei Möglichkeiten, dies zu tun:
- Push-basiert: Das von dir verwendete Support-Ticketsystem (zum Beispiel Zendesk) löst deinen Code aus, indem es ein Webhook-Ereignis an deinen Routing-Dienst sendet, der dann die Absicht klassifiziert und das Ticket weiterleitet.
- Dieser Ansatz ist besser web-skalierbar, erfordert aber, dass du einen öffentlichen Endpunkt bereitstellst.
- Pull-basiert: Dein Code ruft die neuesten Tickets nach einem festgelegten Zeitplan ab und leitet sie zum Zeitpunkt des Abrufs weiter.
- Dieser Ansatz ist einfacher zu implementieren, führt aber möglicherweise zu unnötigen Aufrufen an das Support-Ticketsystem, wenn die Abruffrequenz zu hoch ist, oder ist möglicherweise zu langsam, wenn die Abruffrequenz zu niedrig ist.
Für beide Ansätze musst du dein Skript in einen Dienst einbetten. Die Wahl des Ansatzes hängt davon ab, welche APIs dein Support-Ticketsystem bereitstellt.
Besuche das Klassifizierungs-Cookbook für weiteren Beispielcode und detaillierte Anleitungen zur Evaluierung.
Beginne mit dem Erstellen und Evaluieren deines Workflows in der Claude Console.
Was this page helpful?