針對成本與智慧進行最佳化
在 Claude Platform 上平衡成本與智慧,並提供提示快取、effort、模型選擇、預算與多模型策略的實測結果。
當工作負載從原型進入正式環境時,成本便成為首要的設計限制。能力最強的模型在大規模使用時可能過於昂貴,而最便宜的模型在品質上可能不足。妥善管理成本意味著了解每個成本槓桿如何影響輸出品質,因為有些槓桿會以品質作為交換,有些則不會。Claude Platform 讓您直接控制這種取捨。您可以為每個請求選擇模型、「effort」(投入程度)等級與架構,這讓您幾乎可以將工作負載放在「cost-to-intelligence frontier」(成本與智慧前緣)上的任何位置。
成本與智慧通常被描繪成一條前緣,其中一方可以換取另一方。本頁的第一組槓桿透過在不影響品質的情況下削減成本,將工作負載推向該前緣;只有第二組槓桿會沿著前緣移動:
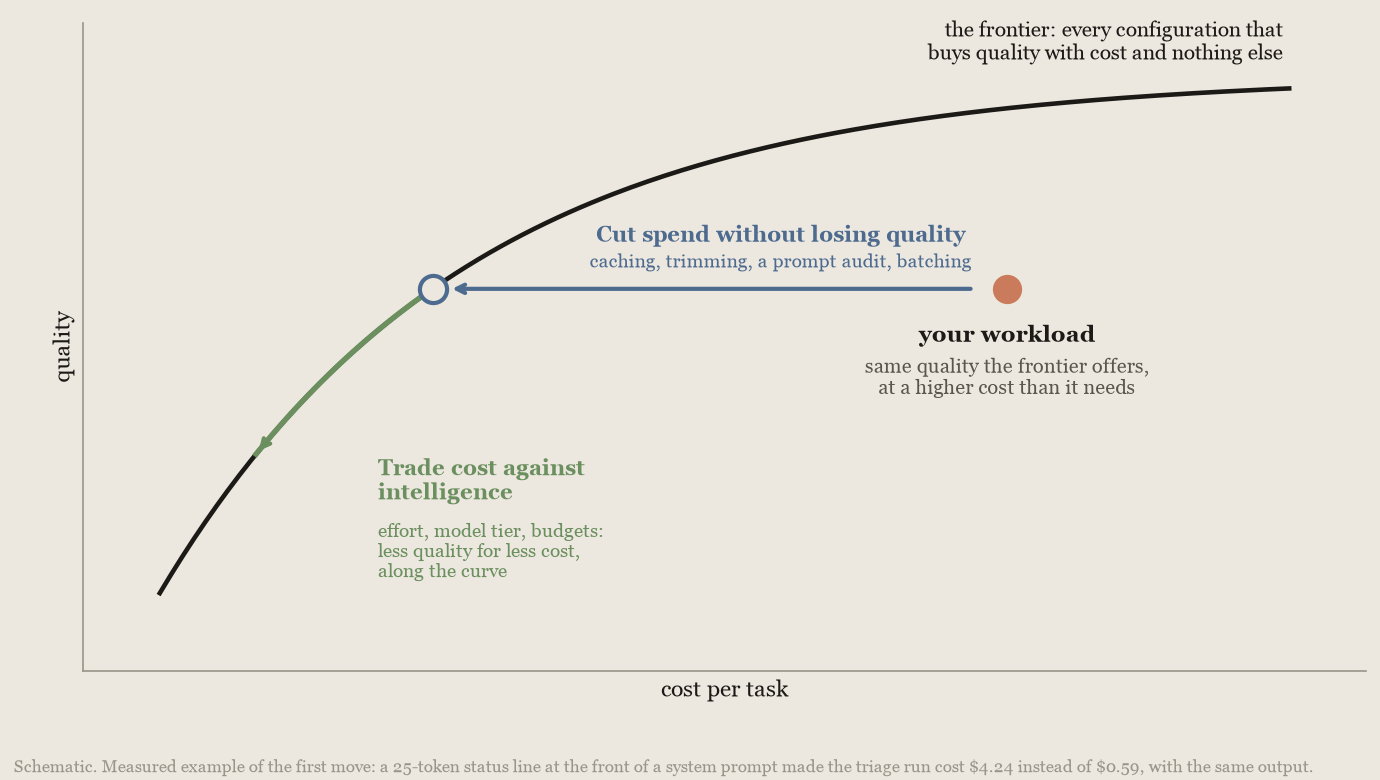
槓桿分為兩類:
- 免費收益(Free wins)在不影響品質的情況下削減支出:「prompt caching」(提示快取)、token 衛生、針對您正在執行的模型進行提示稽核、對可等待最多 24 小時的工作以五折進行批次處理,以及作為最後防線的工作區支出限制。
- 取捨:以成本換取智慧,包括模型選擇、effort、輸出上限與任務預算、經過時間時鐘,以及多模型架構。
每個槓桿都附有實測結果以及何時划算的規則。在 Anthropic 的測量中,提示快取是遙遙領先的最大槓桿:在本指南的基準測試中,它將代理迴圈成本降低了 2.7 到 5.3 倍,並將一個小型分類代理的帳單削減了 83%,若再加上輸入修剪則為 88%。多模型槓桿的適用範圍較窄;第二個模型在兩種形態下划算:「advisor」(顧問)與「orchestrator」(協調者)。
從這裡開始
找出與您情況相符的那一列。
| 您的情況 | 該怎麼做 | 參考位置 |
|---|---|---|
| 任何工作負載、任何模型 | 開啟提示快取並精簡不必要的 token;兩者都是免費的 | 快取重複的上下文 · 精簡 token |
| 使用者會在輪次之間等待 | 當大約每 20 個輪次中有 1 個是在 5 分鐘到 1 小時之間的暫停之後,且很少有間隔超過 1 小時時,請使用 1 小時快取期限。在 Claude Fable 5.1 上,當暫停持續數分鐘時,請讓 5 分鐘快取保持溫熱;當暫停接近 1 小時時,再購買 1 小時期限。在 Claude Opus 5.5 上,若每 20 個輪次中只有一兩個是在最長約半小時的暫停之後,請改為讓 5 分鐘快取保持溫熱 | 選擇快取期限 |
| 成本過高,但品質沒問題 | 在您目前的模型上逐步調低 effort | 調整 effort |
| 您未使用最新模型 | 升級;在 Anthropic 的測量中,每個較新的模型解決的任務至少與前一個模型一樣多,而且每個已解決任務的成本通常更低 | 升級模型 |
| 您正在選擇或切換模型 | 以每個完成任務的成本比較,而非每個 token 的成本 | 比較模型 |
| 品質不夠好 | 如果您調低過 effort,請將其恢復;否則請以 low effort 試用更高一級的模型 | 調整 effort · 比較模型 |
嘗試以 stop_reason: max_tokens 結束 | 提高 max_tokens;在預設 effort 下測量的 14,000 個輪次中,設為 64,000 時只有 2 個輪次不夠用,而設為 128,000 並未增加每個已解決任務的成本 | 設定預算 |
| 您可以檢查輸出(測試、驗證器) | 以低 effort 執行所有工作,再以 high 重新執行失敗的項目;在所測量的程式碼基準測試中,通過率維持不變,成本約減半 | 重新執行失敗項目 |
| 代理迴圈中有少數成本極高的執行 | 設定任務預算(beta;請查看支援表以了解適用的模型)、Claude Managed Agents 工作階段預算,以及工作區支出限制 | 設定預算 |
| 您希望代理執行更快完成 | 告訴模型時間很重要,並向它顯示經過的時間;在 DRACO、HLE 與內部物理題組上,執行時間減少 33% 到 69%,每個任務的成本降低 28% 到 54%,分數最多降低 1.9 分 | 向模型顯示經過時間 |
| 較低成本的模型只在困難決策上卡住 | 加入前緣顧問。只有當顧問的定價遠高於執行者,且確實會被諮詢時才划算,因此請先單獨以低 effort 估算顧問模型的成本,並測量諮詢率 | 顧問策略 |
| 工作量超出單一上下文視窗 | 將工作切分後委派給較便宜的工作者 | 協調者策略 |
這些結果來自 Anthropic 內部測試(參考的基準測試),僅供方向參考,並非保證,因此請使用四步驟方法在您自己的工作負載上進行測量。
在不損失品質的情況下削減支出
提示快取、token 衛生、批次處理,以及針對您目前模型的提示稽核,都能在不降低輸出品質的情況下降低您的支出。有兩點需要注意:批次處理以延遲換取折扣,而上下文編輯(一種 token 衛生槓桿)在本節測量的執行中花費超過其節省。
快取重複的上下文
為何快取優先
在使用任何其他槓桿之前先開啟提示快取,因為代理任務的每個輪次都會重新傳送整個不斷增長的對話:系統提示、工具定義,以及每個先前的輪次。一個 40 輪次的任務會將其第一個輪次傳送 40 次,因此任務成本大致隨輪次數的平方增長。快取不會停止重新傳送,但每次重新傳送的成本約為十分之一且處理更快:前綴以快取讀取費率計費,即輸入價格的十分之一,而每個輪次只需為新增的內容支付 1.25 倍的快取寫入費率。
良好狀態的樣貌。在一整天的真實流量中,代理迴圈從快取讀取的輸入中位數為 84%,而前 10% 的「harness」(執行框架),無論是否為程式碼類,讀取 94% 或更多17。在任務深處,建構良好的迴圈只需為不到 1% 的輸入支付全價。低於約 80% 時,請尋找破壞快取的因素(請參閱什麼會破壞快取)。
在 Anthropic 的實測執行中,快取讀取通常是任務成本中最大的單一組成部分,使快取的價值超過大多數模型選擇決策。Anthropic 對 DeepResearch Bench II7 的執行分別在有快取與無快取的情況下定價:
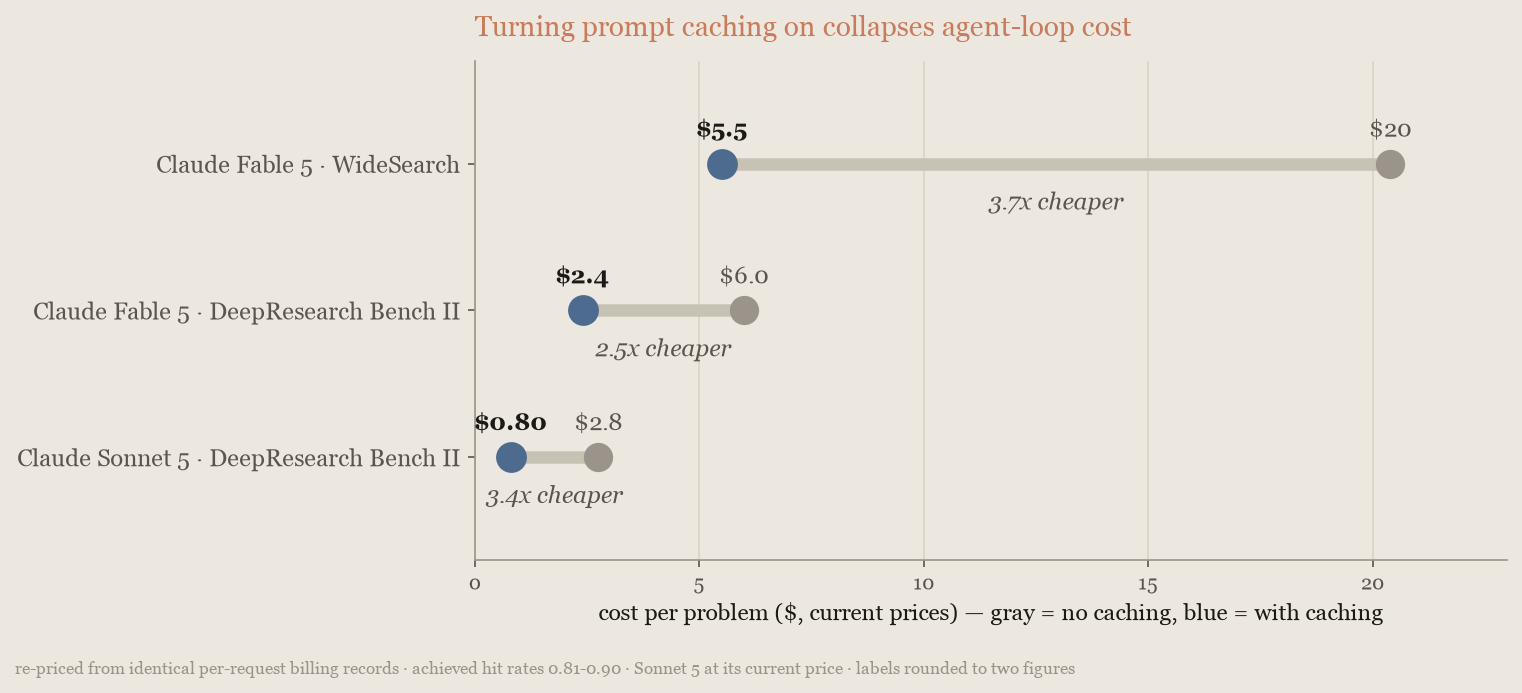
快取的預設存留時間為 5 分鐘,而代理迴圈的輪次間隔僅數秒,因此折扣適用於每個輪次的大多數 token。快取圖表中的執行從快取讀取了 79% 到 90% 的輸入 token。節省幅度隨回合深度而異,因為較短的迴圈重新讀取較少,但在所測量的每個模型與基準測試上,快取始終是最大的單一槓桿。
選擇快取期限
如果您的迴圈在輪次之間需要等待使用者,請使用 1 小時快取期限。它的寫入成本較高(輸入價格的 2 倍,而非 1.25 倍)。無論使用哪種期限,快取未命中時都會以寫入價格而非讀取價格對整個前綴計費,因此只要每個工作階段中有幾個輪次發生在 5 分鐘到 1 小時的暫停之後,較長的期限就會划算。
要做出決定,請計算對話中連續請求之間的間隔:
- 每 20 個間隔中有超過約 1 個落在 5 分鐘到 1 小時之間,且超過 1 小時的間隔很少:使用 1 小時期限。在 Claude Opus 5.5 上,若每 20 個間隔中只有 1 或 2 個落在該範圍內,且沒有任何間隔超過約半小時,請改為使用下文所述的「keep-alive」(保持連線)請求,讓 5 分鐘快取保持溫熱。
- 輪次之間僅相隔數秒:維持 5 分鐘預設值。在沒有任何暫停時,它在 Claude Sonnet 5 上比 1 小時設定便宜 15%,在 Claude Opus 5.5 上便宜約 15% 到 18%。
- 超過 1 小時的間隔很常見:維持預設值。超過 1 小時的間隔會讓兩種期限都過期,而 1 小時設定接著會以較高的寫入價格重新寫入前綴,因此每遇到一次這樣的間隔就會多花錢。在您超過 5 分鐘的暫停中,如果約 60% 以上也超過 1 小時,請維持預設值;只有當至少約 40% 的長暫停在 1 小時內結束時,1 小時期限才划算。
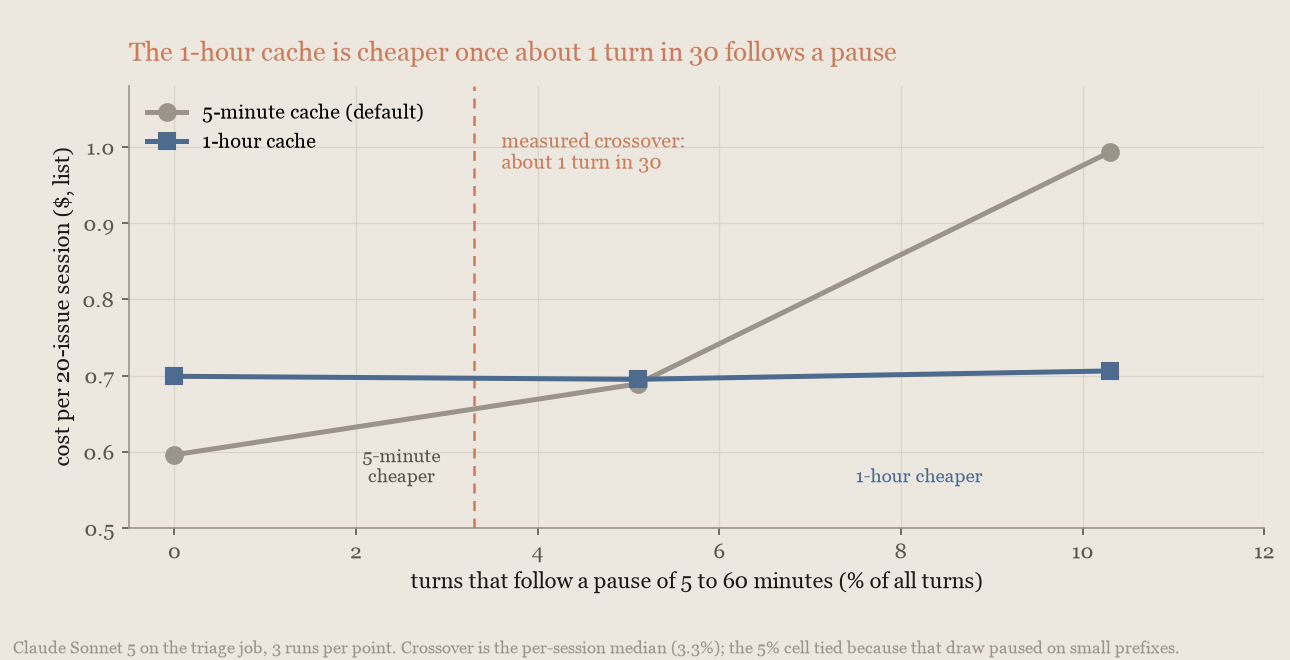
Anthropic 測量了精簡輸入與上下文 token 中的分類工作,並在部分輪次之前插入暫停,以模擬使用者的延遲16。在 Claude Sonnet 5 與 Claude Opus 5.5 上,一旦約每 30 個輪次中有 1 個是在暫停之後,1 小時快取就成為較便宜的設定,因此「每 20 個中有 1 個」的規則保留了餘裕;而且超過交叉點後差距會迅速擴大,因為在 5 分鐘設定下,每個暫停後的輪次都會重新寫入整個前綴。所有目前的模型都使用相同的快取寫入倍數,而除了 Claude Fable 5.1、Claude Mythos 5.1 與 Claude Opus 5.5 之外的所有模型也使用相同的讀取價格,因此其他模型的交叉點也落在相同範圍內;Fable 5.1 的情況將在下文說明。在每個測試組合中,準確度都維持在執行間的雜訊範圍內。在 1 小時設定下,暫停後的輪次保持了溫熱快取的延遲(在 Claude Sonnet 5 與 Claude Opus 5 上測量,未在 Claude Opus 5.5 上測量)。下圖繪製了 Claude Sonnet 5 上每個工作階段的成本與暫停輪次比例的關係:
Anthropic 也測量了讓 5 分鐘快取保持溫熱的額外請求。在 Claude Sonnet 5 上,當每 20 個輪次中有 1 個是在暫停之後時,這些請求比 1 小時期限便宜約 8%,但在每 20 個中有 2 個時成本大致相同;在前一代 Opus 模型 Claude Opus 5 上,它們沒有帶來可測量的節省。當每個輪次之前都有 6 分鐘以上的暫停時,它們在兩個模型上的成本都更高。由於 Claude Sonnet 5 的節省在每 20 個輪次中有 2 個時就已消失,因此在 Claude Sonnet 5 與 Claude Opus 5 上請改用 1 小時期限。
在 Claude Fable 5.1 上,最便宜的設定則不同。它的快取讀取成本為輸入價格的 0.025 倍(每百萬 token $0.25),而快取寫入仍維持標準倍數,因此重新讀取前綴的「keep-alive」(保持連線)請求很便宜,1 小時期限的寫入溢價反而是較大的開銷。Anthropic 以相同的三種設定在 Claude Fable 5.1 上測量了分類工作19。只要暫停只有數分鐘,讓 5 分鐘快取保持熱度的做法,每個工作階段的成本就比 1 小時快取低 13% 到 20%;只有在暫停接近 45 分鐘時,1 小時快取才勝出,每個工作階段約便宜 12 美分。在 Claude Fable 5.1 上,若使用者只離開數分鐘,請讓 5 分鐘快取保持熱度;若暫停接近 1 小時,則購買 1 小時期限:
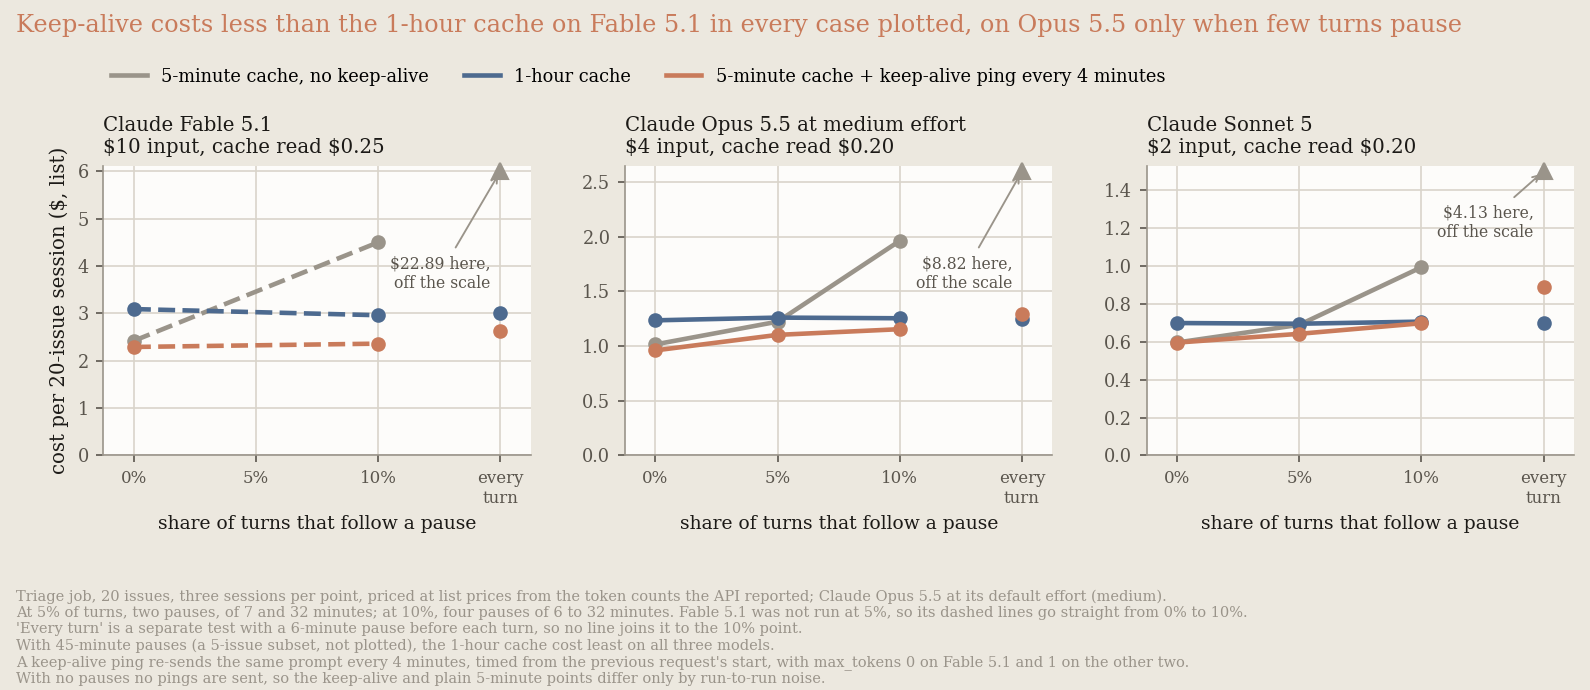
在快取讀取成本為輸入價格 0.05 倍的 Claude Opus 5.5 上,當 5% 或 10% 的輪次是在 6 到 32 分鐘的暫停之後時,保持連線請求比 1 小時期限便宜 8% 到 13%(在預設 effort medium 下;在 high 下便宜 10% 到 18%),但當每個輪次之前都有暫停時則更貴:在 6 分鐘暫停時約貴 4% 到 6%,在 45 分鐘暫停時則上升到貴 50% 以上。因此在 Claude Opus 5.5 上,當每 20 個輪次中只有一兩個是在最長約半小時的暫停之後時,請讓 5 分鐘快取保持溫熱,否則請遵循本節開頭的清單。這些測量以 max_tokens: 1 傳送保持連線請求。對於下文所述的 max_tokens: 0 請求,Anthropic 在 Claude Opus 5.5 上的發布前 API 測試顯示,它會寫入快取,且下一個請求會讀取該快取;至於它是否會刷新現有項目,則未在 Opus 5.5 上測量。
若要讓快取保持溫熱,請在前一個請求開始後的 4 分鐘內,以及之後每隔 4 分鐘,再次傳送前一個請求並將 max_tokens 設為 0,若有設定 stream 則將其移除。請從請求的開始時間起算,而非從其回應的結束時間起算:快取的 5 分鐘存留時間是從寫入或刷新該項目的請求開始時起算,因此回應生成所花費的時間也會計入。這就是預熱請求:它會刷新快取的存留時間、不生成任何內容,且只以快取讀取計費。請勿更改前綴的任何一個位元組,也不要使用 max_tokens: 1,因為它會無故取樣一個 token。除了請求主體之外,也請重新傳送請求的標頭:如果您的請求帶有 anthropic-beta 標頭(例如用於任務預算),保持連線請求也需要相同的標頭,否則重新傳送的主體中受 beta 限制的欄位會被拒絕。當請求設定了 thinking.type: "enabled"(Claude Fable 5.1 上預設的自適應思考則沒問題)、結構化輸出或強制工具選擇時,max_tokens: 0 請求會被拒絕(其限制);在這些工作負載上,請改為購買 1 小時期限。當 max_tokens: 0 請求帶有頂層 compaction 參數時也會被拒絕,因此請勿將來自隨需壓縮的壓縮請求作為保持連線請求重新傳送。
# 在最後一個請求開始後的 4 分鐘內(產生回應所花的時間會計入
# 快取的存留時間),重新傳送該請求,並將 max_tokens 設為
# 0,同時移除 stream(max_tokens: 0 的請求無法串流)。請傳送與
# 原始請求相同的標頭,包括任何 anthropic-beta 標頭。
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
開啟快取
設定幾乎不費工夫。自動快取會為您放置斷點;否則,隨 Claude Code 提供的 Claude API skill 可以透過一個提示為現有整合加入快取。以下摘錄顯示該 skill 將其加入產生這些測量結果的 harness:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...這些斷點放置遵循明確快取斷點中的標準模式。
什麼會破壞快取
在任務期間有幾件事可能破壞您的快取。任何每個請求都會變動的內容(例如時間戳記或佇列位置)若放在穩定前綴之前,會使每個請求都變成完整的快取寫入:在修剪輸入與上下文 token的分類執行中,系統提示開頭的一行 25 個 token 的狀態列使每次執行花費 $4.24 而非 $0.59,比關閉快取執行還多。請將每個請求變動的文字放在最新的使用者輪次中。
快取是依序(工具、系統提示、訊息)對請求進行的位元組精確前綴比對,因此任何位置的變更都會使其後的所有內容失效。在請求之間變更 effort 或思考設定,會使從該點開始的快取失效,在某些模型上還會使其前面的工具與系統提示失效;對系統提示的任何編輯都會使從該點開始的快取失效;設定或變更輸出格式會使整個對話的快取失效;新增、移除或重新排序工具定義則會使全部快取失效。提示快取頁面列出了這些情況,但輸出格式除外,該情況由結構化輸出說明。在最新的模型上,請使用對話中途的系統訊息(附加到 messages 的 {"role": "system"} 訊息)來變更指示,而不是編輯頂層的 system 欄位:快取的前綴會保持完整。請查看該頁面以了解哪些模型支援此功能。在支援的模型上,逐訊息變更 effort 也會讓快取的前綴保持完整。在 Claude Fable 5.1 與 Claude Mythos 5.1 上風險最高,因為快取遭破壞時會以輸入價格的 1.25 倍重新寫入前綴,而非以 0.025 倍讀取。在 100,000 個 token 的前綴上,一個快取遭破壞的輪次在這些模型上的成本是 $1.25 而非 $0.03,為讀取的 50 倍;在 Claude Opus 5.5 上成本是 $0.50 而非 $0.02,為 25 倍;在其他目前的模型上則為 12.5 倍。
Anthropic 在分類代理的長工作階段上測量了這一點18。在工作階段中途進行的 effort 變更與新增工具分別重寫了 39,000 與 60,000 個快取 token,這些工作階段每個花費 $0.95。相同的兩項變更若在壓縮後的第一個請求上進行則花費 $0.75,若在觸發壓縮的請求上進行則花費 $0.92,因為壓縮的摘要過程隨後以快取寫入價格重新處理了 81,000 token 的上下文:該摘要過程花費 $0.21,相較之下當相同變更晚一個請求進行時為 $0.04,每個組別的準確度都在執行間雜訊範圍內:
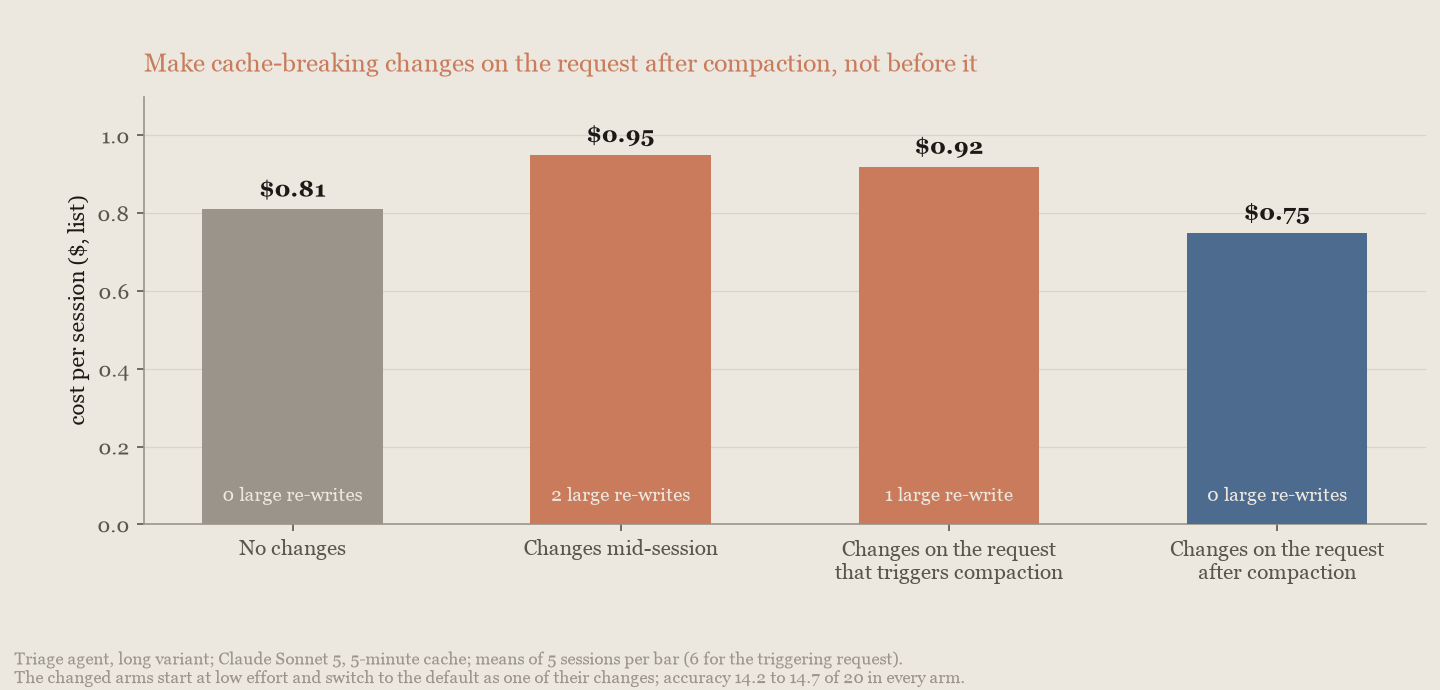
中途變更任務預算會使任何包含預算值的快取前綴失效,因此請在第一個請求上設定一次。每次上下文編輯都會使前綴從其清除的點起失效,而下一個請求需付費重新快取其後的所有內容,因此請以少數大批次而非許多小批次進行清除。在 Claude Fable 5.1 與 Claude Mythos 5.1 上,這些每個 token 的成本都是讀取價格的 50 倍,因此在那裡最為重要。請在自然斷點進行每項會使快取失效的變更,然後確認快取讀取沒有下降;如果下降了,快取診斷會顯示前綴在何處分歧。
精簡輸入與上下文 token
大多數代理請求都帶有對答案毫無影響的 token。精簡這些 token 很少會損及輸出品質,不過在實測中,並非這裡的每個槓桿都能省錢。有兩個地方值得檢查:
- 輸入精簡。 網頁擷取工具中的動態過濾可將樣板內容排除在擷取的頁面之外,圖片縮放可將視覺輸入調整為適當大小,而搭配延遲載入的工具搜尋只在需要時才載入工具定義(本節稍後會進行測量)。程式化工具呼叫讓 Claude 透過程式碼執行多個工具呼叫,只有過濾後的結果會進入上下文;其文件指出,在代理搜尋基準測試中,輸入 token 減少了 24%,分數也更高。管理工具上下文比較了工具搜尋、程式化工具呼叫、提示快取與上下文編輯。
- 上下文生命週期。 上下文編輯會清除過時的工具結果,而自動壓縮及其閾值可避免長迴圈一路攜帶完整的歷史記錄。
這些槓桿會與快取以及彼此相互影響,因此請依淨效果來評估,並使用快取診斷確認每次變更後快取前綴仍然有效。Anthropic 以一個問題分類代理進行測量,該代理需處理來自公開儲存庫、附有螢幕截圖的 20 份真實錯誤報告;另外也在同一工作的較長版本(token 數為 2.6 倍)上進行了測量。在開啟快取的情況下,輸入精簡(圖片縮放與工具搜尋)讓短執行的成本再降低 26%,長執行再降低 21%。
延遲未使用的工具定義
附加到請求的每個工具定義在每個輪次都是輸入,而幾個 MCP 伺服器加起來就有數百個。Anthropic 以分類代理自己的兩個工具加上來自公開 MCP 伺服器的真實工具定義目錄(總計最多 502 個工具)執行該代理,全部載入或將額外的工具標記為 defer_loading 置於工具搜尋之後:
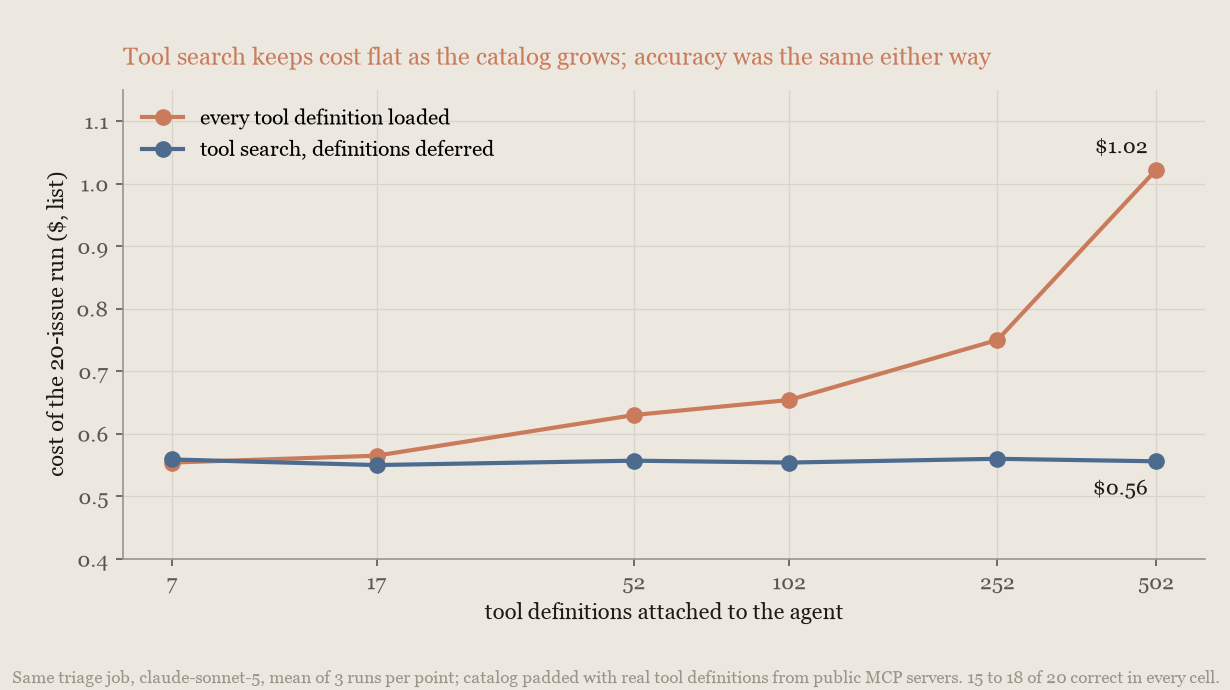
在每個定義都載入的情況下,隨著目錄增長,執行成本幾乎翻倍,與每個請求上的 schema token 同步。使用工具搜尋時,在每個目錄大小下都保持平穩,在 502 個工具時少 45%。無論哪種方式,每個儲存格的準確度都是 20 個中的 15 到 18 個,且模型從未呼叫錯誤的工具,因此在此規模下目錄耗費的是金錢而非正確性。透過 MCP 連接器提供的工具也是如此:附加公開 GitHub MCP 伺服器時,延遲其工具集(default_config: {defer_loading: true})在相同準確度下將執行成本削減 20%。
將資料檔案排除在提示之外
當模型必須對表格進行計算時,請使用 Files API 上傳它,並讓模型以程式碼執行查詢它,而非將其貼入。Anthropic 對一份 1,862 列的公開 CSV 提出了 25 個彙總問題15(加總、過濾計數、分組,以及一個日期過濾),答案由 pandas 計算:
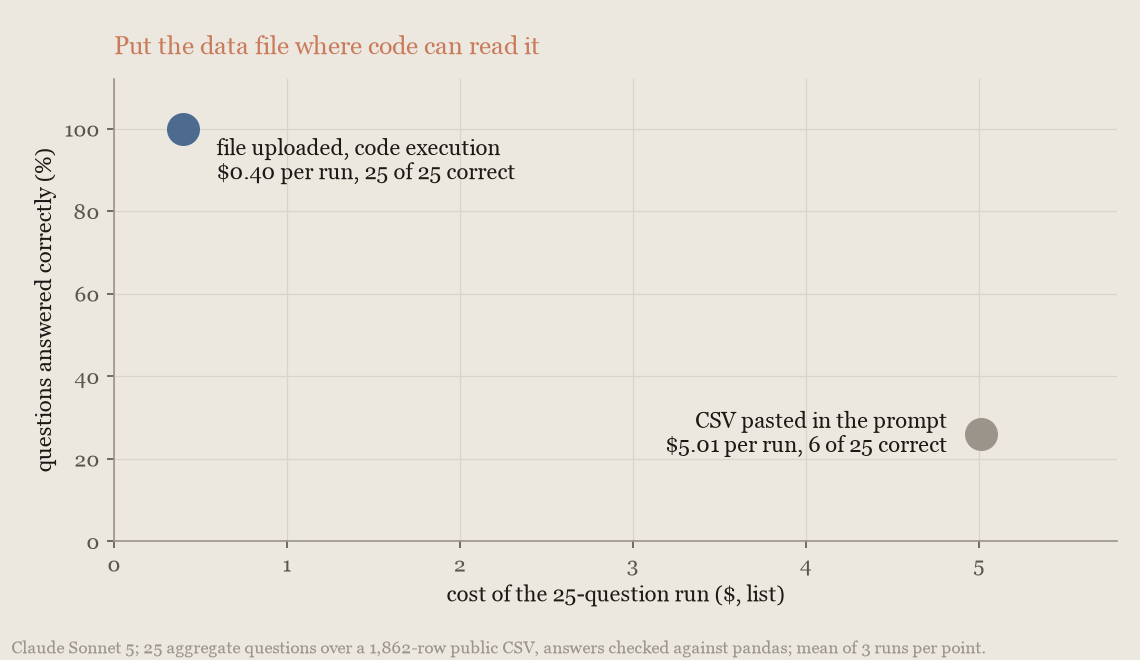
貼入提示時,該表格在每個請求上約為 91,000 個輸入 token,而 Claude Sonnet 5 正確回答了 25 題中的 6 題。上傳並使用程式碼執行時,它回答了全部 25 題,且執行成本約為十二分之一。Claude Opus 5 顯示相同的模式。
管理上下文生命週期
上下文槓桿只在工作階段長到需要它們時才划算:
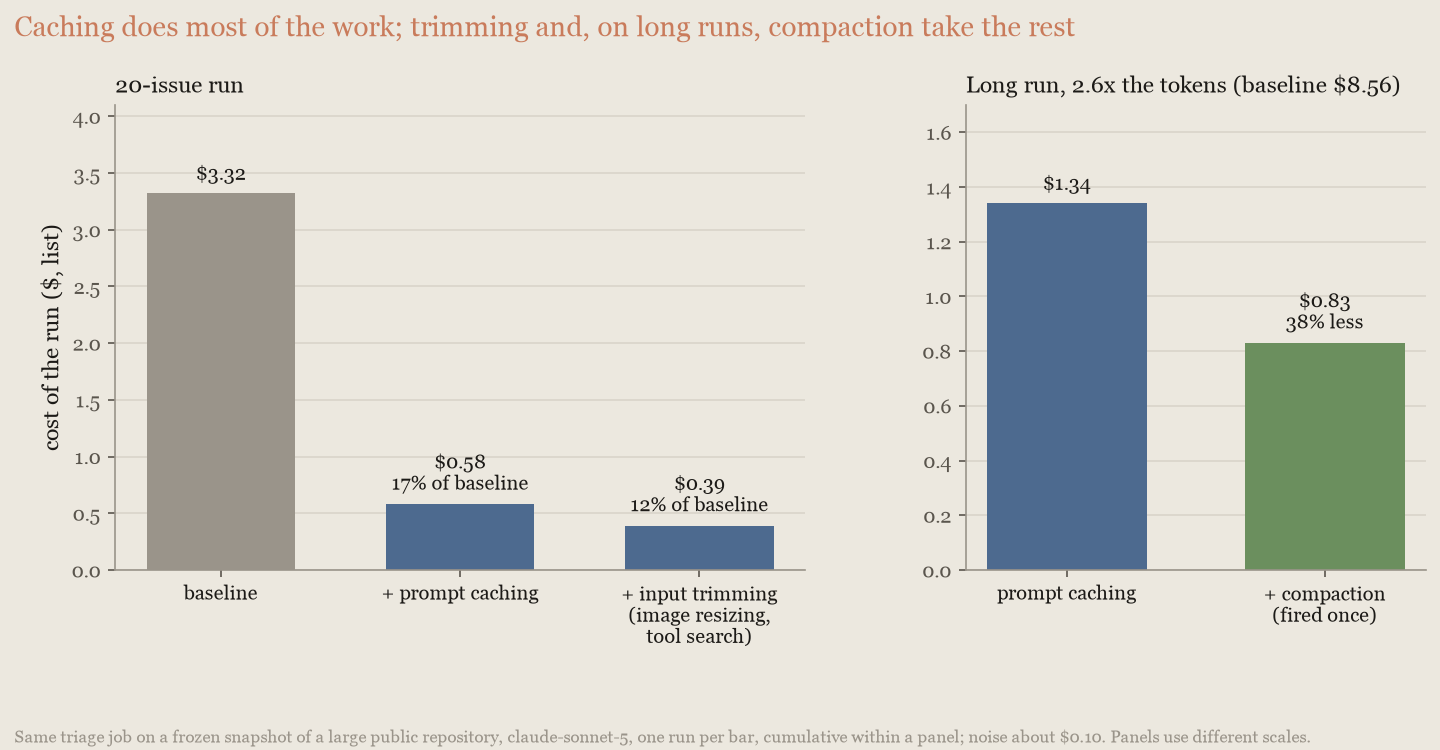
在 20 個問題的執行上它們沒有任何節省,而上下文編輯多花了 74%。在長執行上,修剪節省了 39%,壓縮節省了 32%,而上下文編輯沒有改變任何東西。修剪是您自己撰寫的幾行程式碼:在每個任務邊界,將大型過時的工具結果替換為一行摘錄。它的快取效果良好,因為編輯位於對話的尾端,下一個任務無論如何都會在那裡新增內容:邊界後第一個請求的快取讀取為 89%,邊界之間的請求為 81%。就整個執行而言,修剪與上下文編輯的快取效果大致相同。修剪較便宜,是因為上下文編輯會在任務中途重寫修剪所刪除的內容(約佔差距的三分之二),也因為它使上下文保持約一半大小(另外三分之一)。如果您使用上下文編輯,請以少數大批次清除。改編自 harness 的修剪程式碼:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # 限制單行結果的長度,讓擷取內容保持簡短
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extract批次處理可以等待的工作
Batch API 對請求的每個 token(包括快取的 token)提供 50% 折扣,代價是結果會在 24 小時內的任何時間送達。將每個沒有人在等待的請求透過批次路由,其餘的保留互動路徑。對於無人看管的代理工作,批次處理是僅次於快取的第二大免費槓桿:評估執行、回填,以及排程工作,例如token 修剪測量中問題分類代理的定期執行。它可與本頁除互動性之外的所有內容結合,但不適用於 Claude Managed Agents 工作階段,其設計上即為互動式(請參閱 Claude Managed Agents 定價)。
針對目前模型稽核提示
每一代模型對提示的回應方式不同,因此提示會累積為您不再使用的模型所撰寫的文字。常見的情況是為了彌補較舊模型而加入的過度具體指令:「驗證兩次」、「盡可能徹底」、強制的逐步程序,或手工打造的推理草稿區。較新的模型會逐字遵循這些指令,產生額外的工具回合與額外的撰寫,因此帳單上升而準確度沒有提升。針對您現在執行的模型稽核提示,並在每次更換模型時再次稽核,是一項免費收益。
稽核只需一個指令。隨 Claude Code 提供的 Claude API skill 有一個 prompt-audit 指令,可讀取專案的提示與請求程式碼,並報告哪些是為不同模型撰寫的。這段縮短的摘錄顯示它針對包含這些模式的客服台提示與請求程式碼執行:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.該指令隨後以 diff 形式提出其編輯(顯示一個區塊),並列出它刻意保留不動的內容:退款期限、語氣要求與品質標準。您審查的是一個修補,而非重寫。
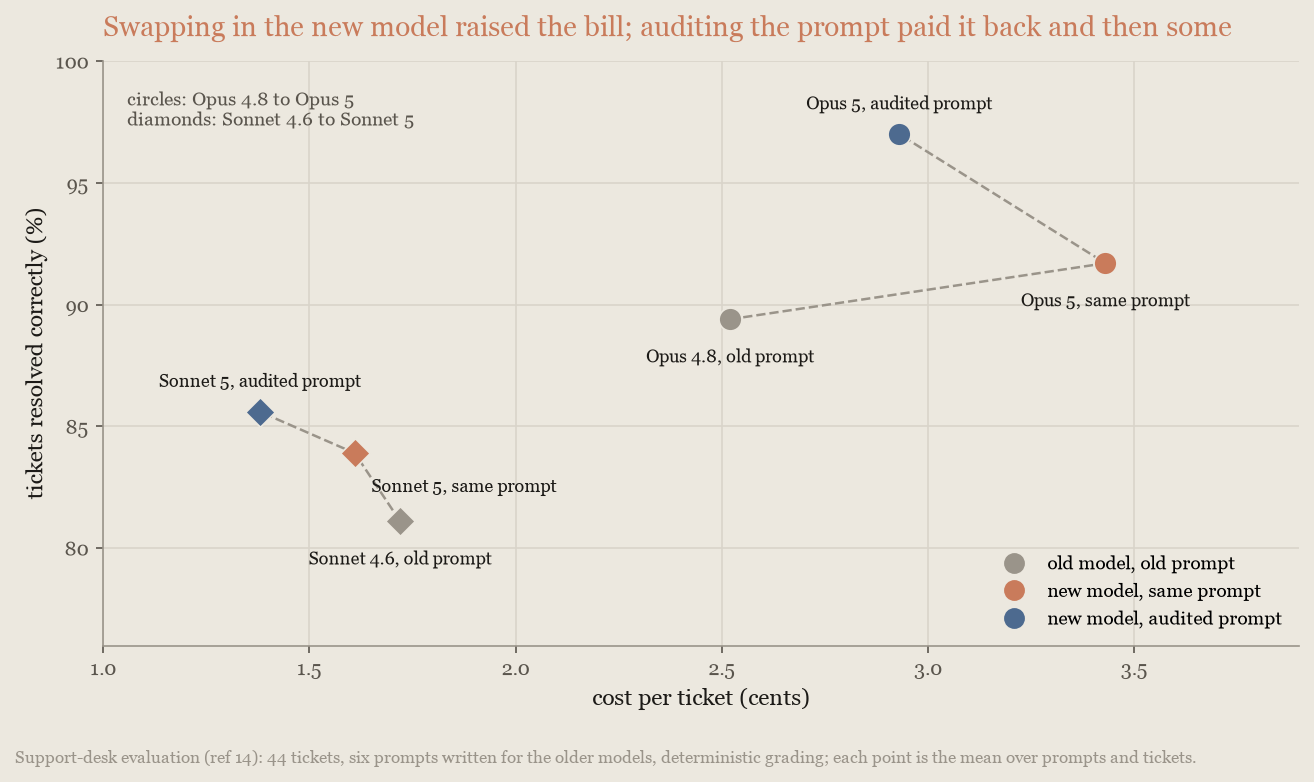
效果是可測量的。在一項客服台評估14中,為 Claude Opus 4.8 撰寫的提示在 Claude Opus 5 上每張工單多花 36%,而準確度沒有變化。對相同提示執行稽核後,Opus 5 既比未稽核版本便宜(14%)又更準確(97% 的工單,從 92% 上升,增幅超出雜訊範圍)。在 Claude Sonnet 4.6 到 Claude Sonnet 5 的遷移中,稽核在相同準確度下削減了 14%:
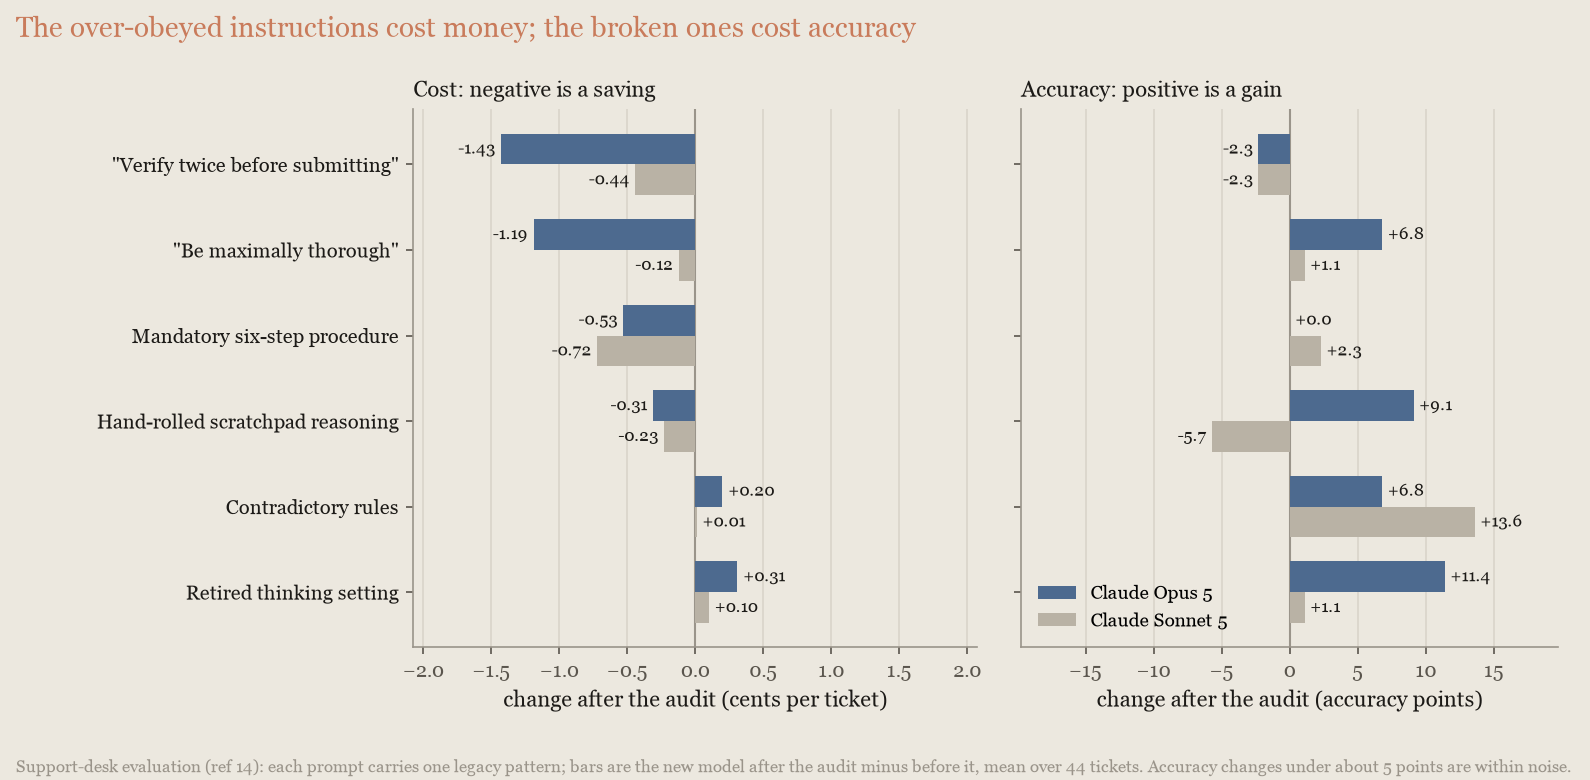
兩種過時文字有不同的代價。新模型過於字面遵循的指令耗費金錢:移除「驗證兩次」將 Opus 5 每張工單的成本削減三分之一,移除「盡可能徹底」幾乎同樣多。不再適合模型的文字則耗費準確度:已淘汰的思考設定、相互矛盾的規則,以及與模型自身思考衝突的手工草稿區,移除後各自在 Opus 5 上恢復了 7 到 11 個百分點:
相同的模式往往也出現在工具描述與 skill 中,這些也值得稽核。
在成本與智慧之間取捨
這些槓桿決定單一模型在成本與智慧之間的位置:模型選擇、effort、以更高設定重新執行失敗項目、模型運作時所受的預算與上限,以及模型是否能看到已經過了多少時間。請先在目前的模型上進行 effort 掃描(調整 effort)。依成本與能力由低到高,目前的模型為 Claude Haiku 4.5、Claude Sonnet 5、Claude Opus 5.5 與 Claude Fable 5.1(「frontier model」(前沿模型));模型概覽列出了完整的模型陣容與價格。
以每個任務的成本比較模型
價格表是以每個 token 撰寫的,而以每個 token 來看,前緣模型看起來很昂貴:Claude Fable 5.1 的每 token 價格是 Claude Sonnet 5 的數倍。然而您支付的是完成的任務,因此請以每個完成任務的成本比較模型。能力更強的模型以更少的工作完成任務:更少的輪次、更少的搜尋、更少重新讀取自己的上下文,以及更少的回溯。每 token 的溢價往往被各方面都做得更少所抵銷。
Anthropic 在 SWE-bench Pro3 子集上測量了這一點,依客戶計費方式定價:
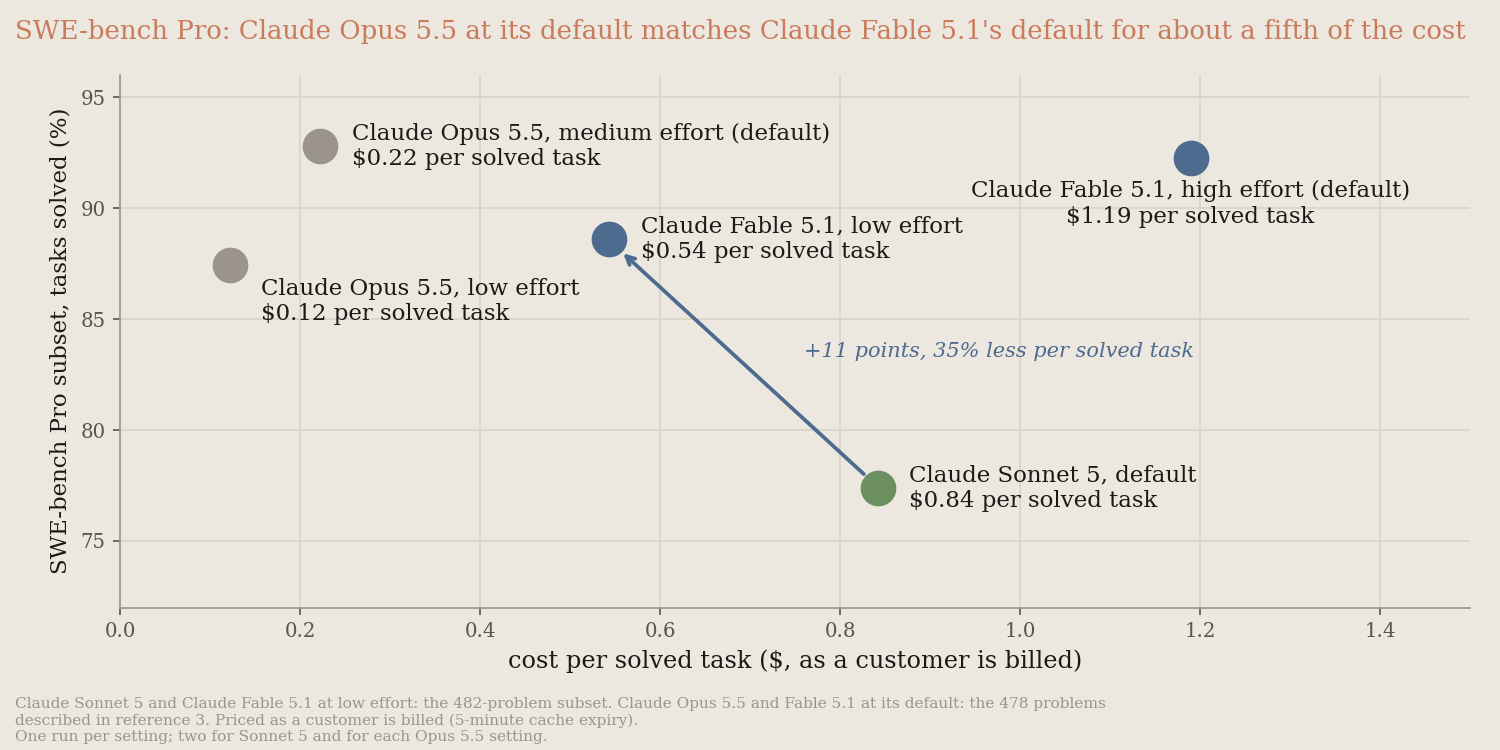
Claude Fable 5.1 在 low effort 下解決了 88.6% 的任務,每個已解決任務的成本為 $0.54;相較之下,Claude Sonnet 5 在預設設定下解決了 77.4%,成本為 $0.84:儘管每 token 價格高出五倍,卻多了 11 個百分點,且每個已解決任務的成本低 35%。不過,它並非總是勝出。在同一個子集上(Claude Opus 5.5 與 Claude Fable 5.1 在此子集上都已大致飽和,且其分數無法與公開排行榜比較),Opus 5.5 在其預設的 medium 下與 Fable 5.1 的預設設定表現相當(92.8% 對 92.3%,在執行間的雜訊範圍內),而每個已解決任務的成本約為五分之一($0.22 對 $1.19)。在 low 下,Opus 5.5 以 $0.12 解決了 87.4%。這些數據使用參考文獻 3 中所述的 478 個問題。而在長時間的研究迴圈中,前沿模型做的工作反而更多,而非更少:在 DeepResearch Bench II7 上,Fable 5.1 在 low 下的分數比 Sonnet 5 高 10 分(66% 對 56%),每個任務的成本約為四倍($4.66 對 $1.20),因為它會在更大的上下文上執行更長的研究迴圈。在相同基準下,Claude Opus 5 在預設設定下得分 71%,每個任務 $6.71,高於 Fable 5.1 的預設設定(65%,$7.12),因此在研究工作上,Fable 5.1 同樣只有在 low 下才物有所值。
對於大多數代理工作負載,請從預設 effort(medium)的 Claude Opus 5.5 開始,並將 Claude Fable 5.1 用於高要求的推理與長時程代理工作,或在 Claude Opus 5.5 以較高 effort 執行時您的評估仍未達標時使用。如前所述,在 SWE-bench Pro 子集上,Opus 5.5 在預設設定下與 Fable 5.1 的預設設定表現相當,而每個已解決任務的成本約為五分之一。在顧問策略中的程式設計基準測試上,它得分 86.6%,而 Fable 5.1 在 medium 下為 84.2%(單次 Fable 5.1 執行),每次嘗試的成本不到三分之一($0.84 對 $2.68)。在圖表判讀基準測試 Chartography13 上,Opus 5.5 在 low 下得分 68.7,每張圖表約 $0.03;相較之下,Fable 5.1 在 low 下得分 62.5,成本 $0.15,Claude Opus 5 在 low 下得分 49,成本 $0.16。在另一端,Claude Haiku 4.5 回答 GPQA Diamond9 問題的每題成本約為 Claude Opus 5.5 的五分之一,準確度為 63%,而 Opus 5.5 為 92%,且在長時間的程式設計任務上落後更多。它適合輸出可檢查的大量工作,而非長時間的代理迴圈。
排名會因工作負載而翻轉,而沒有任何價目表能告訴您會往哪個方向翻轉。請以您自己流量上每個完成任務的成本為每個候選方案計價,包括預設 effort 的 Claude Opus 5.5,以及降低 effort 的前沿模型。
為您工作負載的尾端定價,而非中位數:在您最困難的十分之一任務上比較模型,而非典型任務。在典型任務上每個模型看起來都相似,最便宜的看起來最好,但帳單是由較便宜模型失敗的任務決定的,因為失敗的任務仍會對其 token 計費,然後是重試,然後是失敗在下游造成的任何代價。即使沒有任何失敗,尾端也是錢花掉的地方。在一次 20 題的 WideSearch1 執行中,兩個問題佔了 43% 的支出:
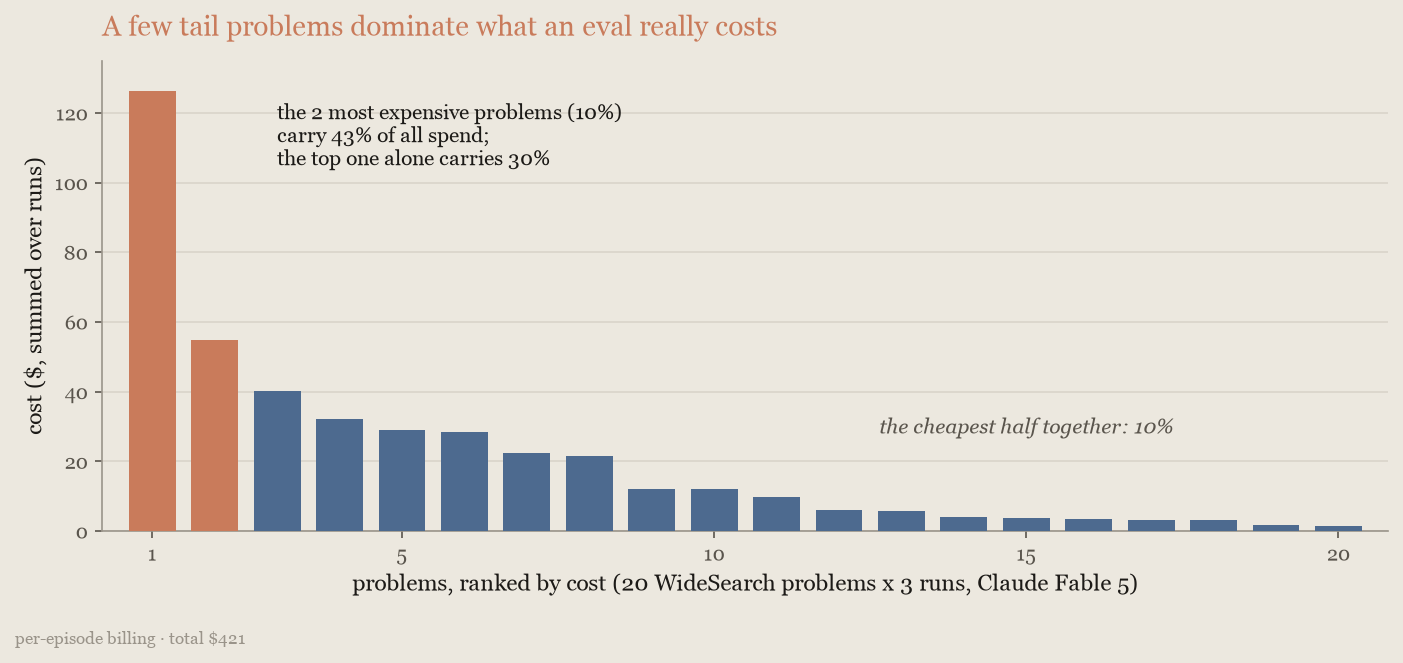
多模型策略的存在是為了將前緣智慧花在該尾端上,而不必為其餘部分支付前緣費率。
升級模型
如果您使用的模型落後一兩個版本,最便宜的槓桿就是更換模型字串。Anthropic 在 SWE-bench Pro3 子集上,以相同的 harness 執行了近期的 Claude Opus、Claude Sonnet 與 Claude Fable 模型,每個模型都使用其出廠預設值並以定價表價格計算成本,另外也在 Terminal-Bench 320 上再次執行了 Opus 系列:
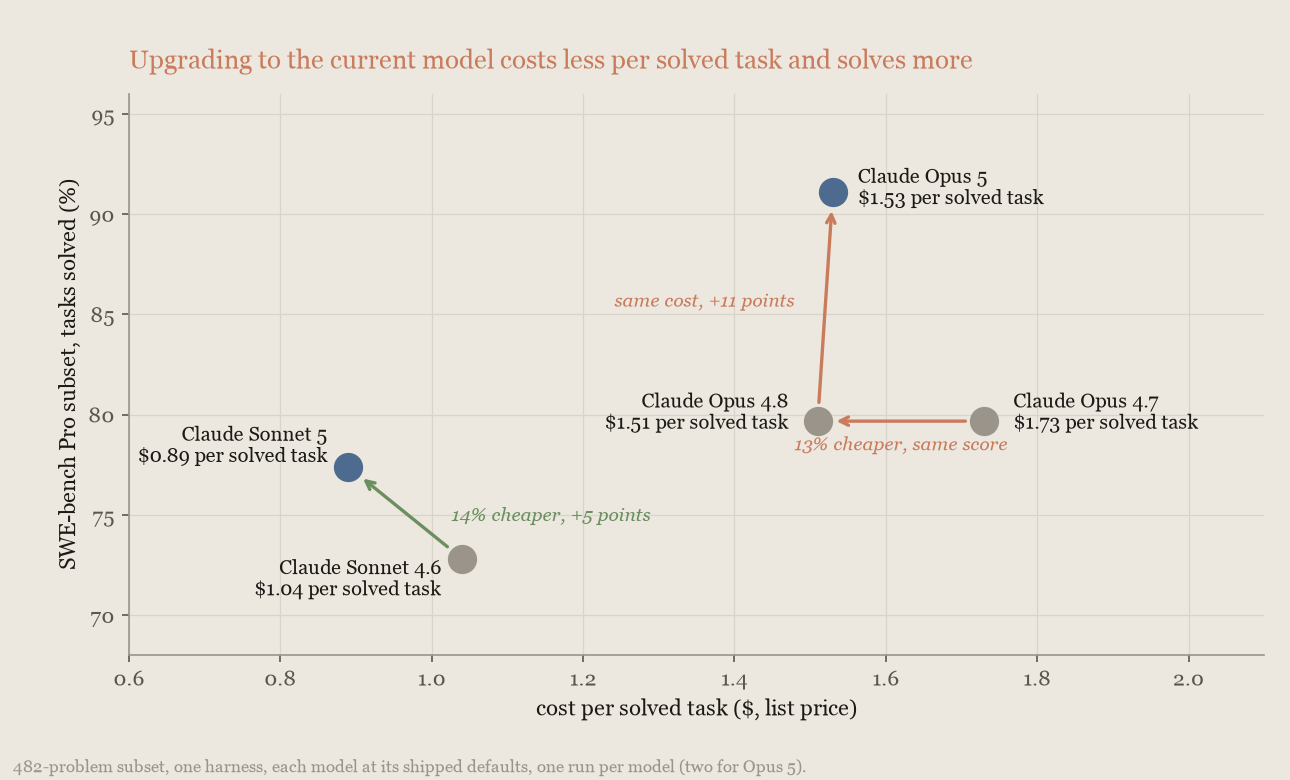
Anthropic 對 Claude Opus 4.7、Opus 4.8 與 Opus 5 的每 token 定價相同,因此它們之間的差異完全來自每個模型在每個任務上的工作量:依客戶實際的計費方式計算,Claude Opus 4.8 解決的任務比例與 Claude Opus 4.7 相同,每個已解決任務的成本卻低了 14%;而 Claude Opus 5 又多解決了 12 個百分點的任務,每個已解決任務的成本則高出 21%。在此基準測試上,low effort 的 Claude Opus 5 表現優於預設設定的 Opus 4.8,每個已解決任務的成本卻只有後者的約 30%,因此最便宜的升級方式,是以較低的設定使用新模型。Sonnet 5 的節省來自其較低的每 token 價格,這足以抵銷它相較於 Sonnet 4.6 在每個任務上多用的 token:每個已解決任務的成本低 15%,還多解決 5 個百分點。前緣層級也以同樣的方式受益:Claude Fable 5.1 以每個已解決任務低 43% 的成本,達到與 Claude Fable 5 相同的分數,其中大部分來自較低的快取讀取價格。但升級不一定都能省錢:在 DeepResearch Bench II7 上,同樣的升級在 high 時每個任務的成本高出 41%(在 low 時高出 79%),換來的是在所有組別中都沒有問題的任務上多 2 到 3 分(參考文獻 7),因為新模型在該基準測試上每個任務做了更多工作。兩者的輸入與輸出價格相同,快取讀取則便宜 4 倍,因此在認定升級能省錢之前,請先在您自己的工作負載上進行測量。
在更困難的工作上,差距會進一步擴大。在 Terminal-Bench 320 上,任務困難到帳單主要由通過率而非 token 數決定:Claude Opus 4.7、Opus 4.8 與 Opus 5 每個任務各花費 $8 到 $15,但分別只解決了 7%、15% 與 41% 的任務,因此沿著版本往上,每個已解決任務的成本從 $183 降至 $63,再降至 $28。Claude Opus 5 在已接近飽和的程式碼子集上相較於 Opus 4.8 的 21% 溢價,到了舊模型大多失敗的 Terminal-Bench 3 上,反而變成了 56% 的節省:您的工作負載越是難倒舊模型,升級後每個結果能節省的成本就越多。
請以每個已解決任務的成本進行比較,而非每個 token 的成本:相同的文字在 Claude Opus 4.7 及更新版本上大約會多耗用 30% 的 token,因此若以每 token 比較,較新的模型必然會顯得更昂貴。
調整 effort
「Effort」(投入程度)是讓模型適應您任務最直接的方式。effort 參數控制模型進行多少思考、工具呼叫和自我驗證,而high(大多數模型的預設值)適合要求嚴苛的任務;Claude Opus 5.5 預設為 medium。成本會隨所有這些活動增加,準確度卻只隨您任務實際需要的部分提升。在模型的能力上限以下,最高的 effort 等級等於是在為任務從未用到的深度付費。
在研究與知識工作基準測試(WideSearch1、DeepWideSearch6、BrowseComp4 和 GDPval2,皆使用 Claude Fable 5)上,準確度對成本的曲線幾乎是平的。low 損失 1 到 3 分,換得每項任務成本降低三分之一到一半。medium 以預設值約 70% 到 87% 的成本,達到與預設值相同的準確度。在這四項測試中,預設值相較於 medium 都沒有帶來任何可測量的提升。在 DeepWideSearch 上,low 也以低 29% 的成本,追平了搭配 Claude Sonnet 5 工作者的協調器。換言之,降低 effort 勝過了變更架構。
較低的 effort 設定通常也更快,這在「latency」(延遲)是限制條件時很重要。在這些執行中,low 在 DeepWideSearch 上每個問題耗時 4.5 分鐘,預設值則為 7.9 分鐘。語料庫基準測試的輸入無法放入任何單一「context window」(上下文視窗);在這項測試上,Fable 5.1 在 low、medium 和 high 下每回合分別耗時 15.2、17.5 和 19.9 小時。
長時程程式設計才是 effort 真正能換來準確度的地方。在 SWE-bench Pro3 上,以 high 為基準,Claude Opus 5.5 在其預設值 medium 下分數約低 2.5 分,成本約為 70%;在 low 下約低 8 分,成本約為三分之一;xhigh 分數約高 1.4 分,成本為 high 的 2.5 倍:這是真正的取捨,而以較高 effort 重新執行失敗的任務能將其轉回節省。下圖繪製了研究和知識工作基準測試以及 SWE-bench Pro 的準確度對成本關係:
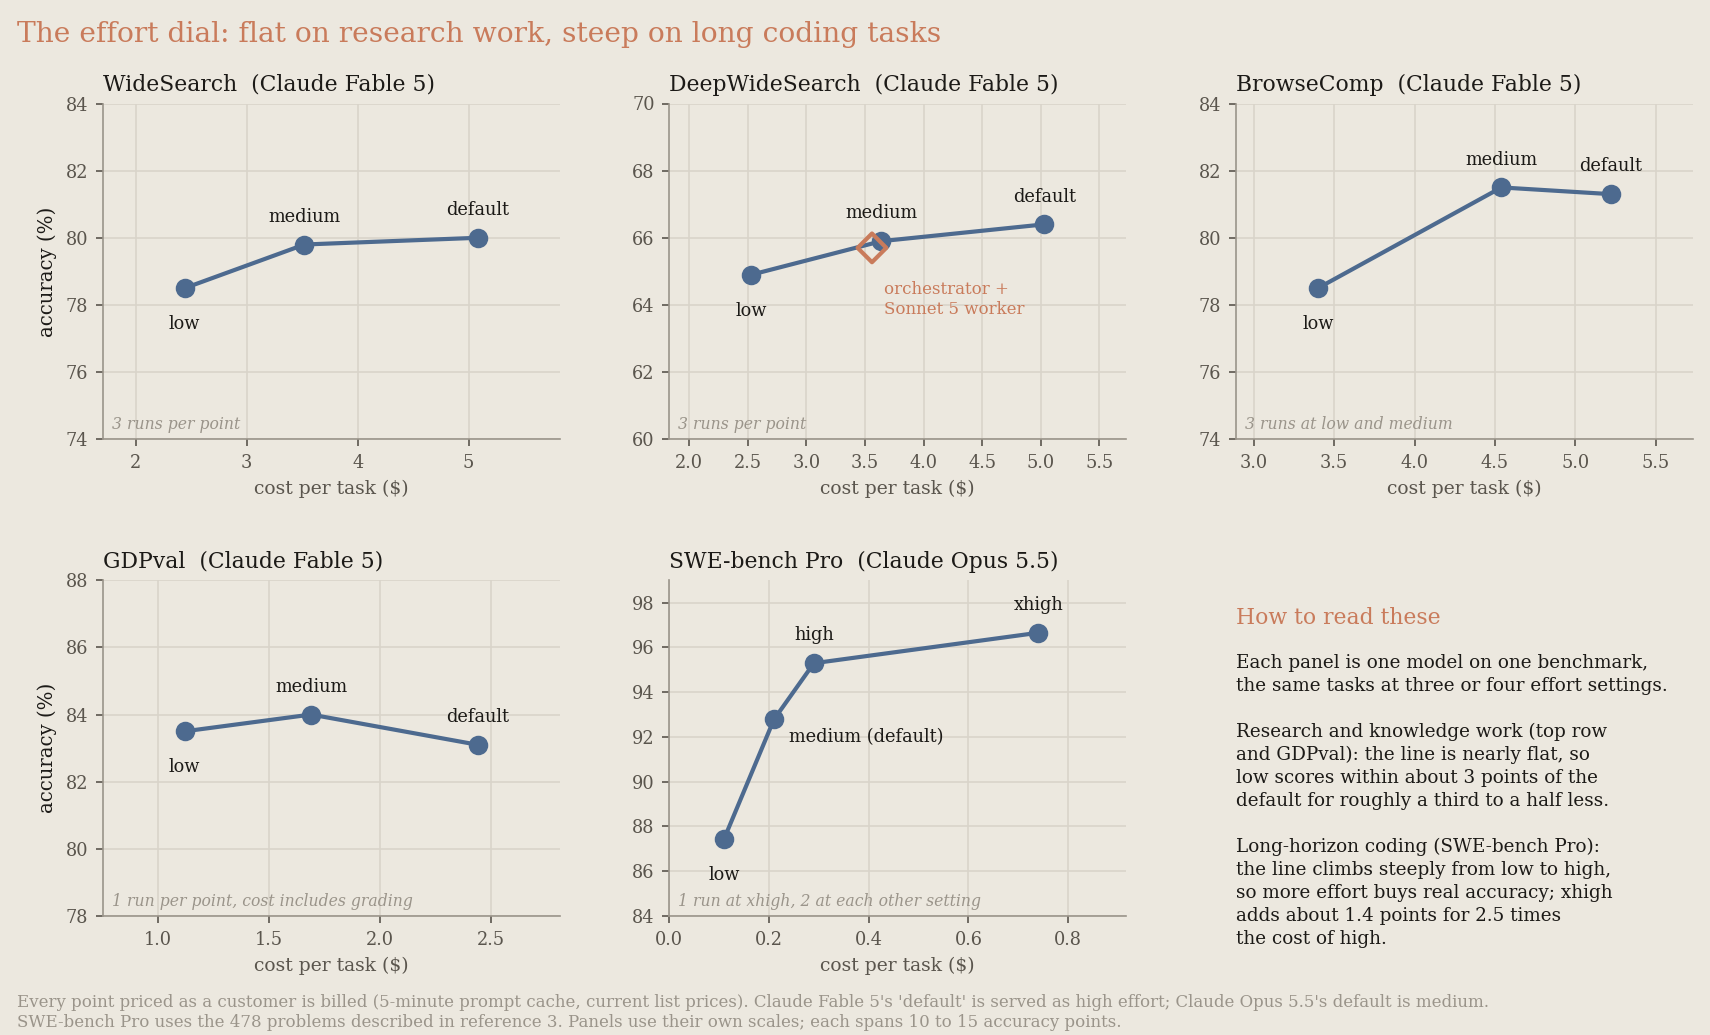
由此得出兩個結論。第一,在加入第二個模型之前,請先為您自己的工作負載繪製這條曲線。在這些內部測量中,有一個多模型配置看起來比預設的單一模型便宜,實際成本卻高於同一模型在較低 effort 下的成本。第二,這條曲線是任何多模型策略都必須超越的單一模型基準線,因此在您自己的工作負載上進行測量的步驟 2 會跨 effort 等級建立基準線。
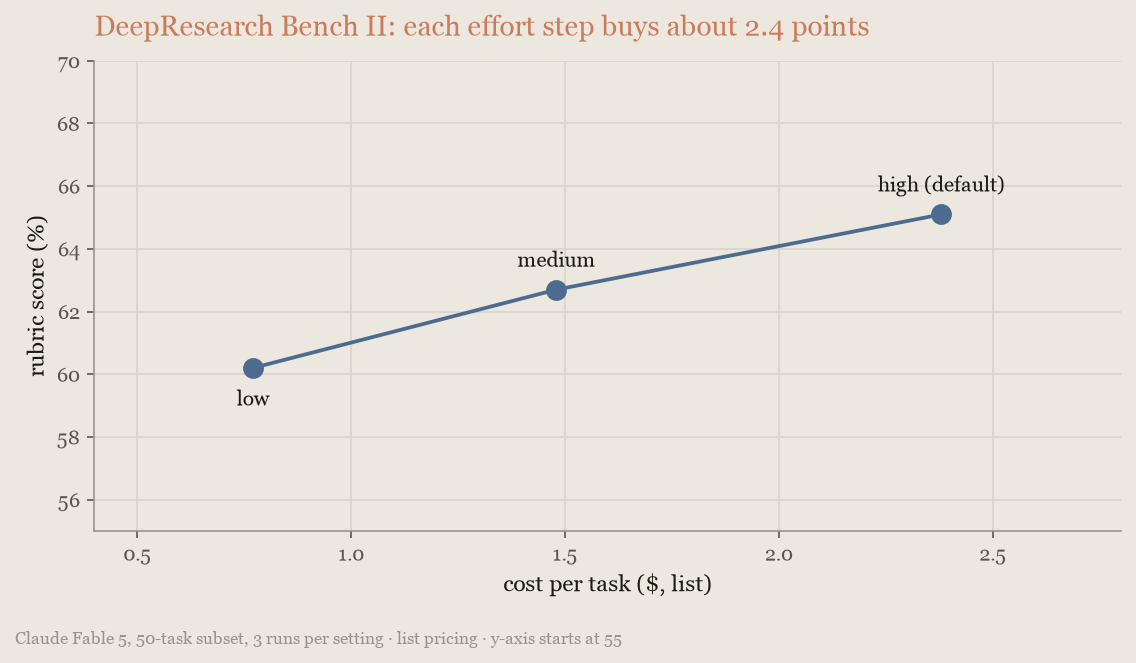
困難的工作不一定需要高 effort。在 DeepResearch Bench II7 上,Claude Fable 5.1 在 low、medium 和 high 下的得分幾乎相同,每項任務的成本卻從 $4.66 上升到 $7.12。因此在這種情況下,提高 effort 並不會明顯提升輸出品質。在所有組別中都完整無誤的 21 項任務上(參考文獻 7),Claude Fable 5 在各 effort 等級間同樣持平;不過圖表依據的是 33 項任務(排除了各模型自身被中斷的嘗試),在這個基礎上它呈上升趨勢。請在您實際部署的模型上測量曲線,而不是沿用您上次測量的模型:
僅憑任務描述無法判斷您的工作負載屬於哪一類,因此請在您自己的流量樣本上掃描兩到三個 effort 等級,再從曲線讀出答案。請在不同的工作階段中測試每個等級:在工作階段中途變更頂層 effort 會使快取失效(請參閱快取重複的上下文),並扭曲比較結果。如需參數詳細資訊,請參閱 Effort。
以較高 effort 重新執行失敗任務
當任務的結果可被檢查時,effort 曲線上最便宜的策略並不是固定設定:以低設定執行每項任務,並只以較高設定重新執行失敗的任務。
Anthropic 根據調整 effort 中 SWE-bench Pro3 子集的 effort 執行結果,逐一任務計算了此策略。Claude Opus 5.5 在 low 下有 13% 的任務失敗;將這些任務以 high 重新執行後,約 97% 通過,每個任務約 $0.17,相較之下全部以 high 執行則為 95.3%、$0.29:通過率略高,成本僅略高於一半(已計入失敗的低成本嘗試)。改從 medium 開始,則以約 $0.24 解決約 97% 的任務。這小幅提升大多來自第二次嘗試(將一次 high 執行的失敗任務以 high 重新執行,分數大致相同,但花費更多),因此請為了節省而使用此策略,而非為了提升:
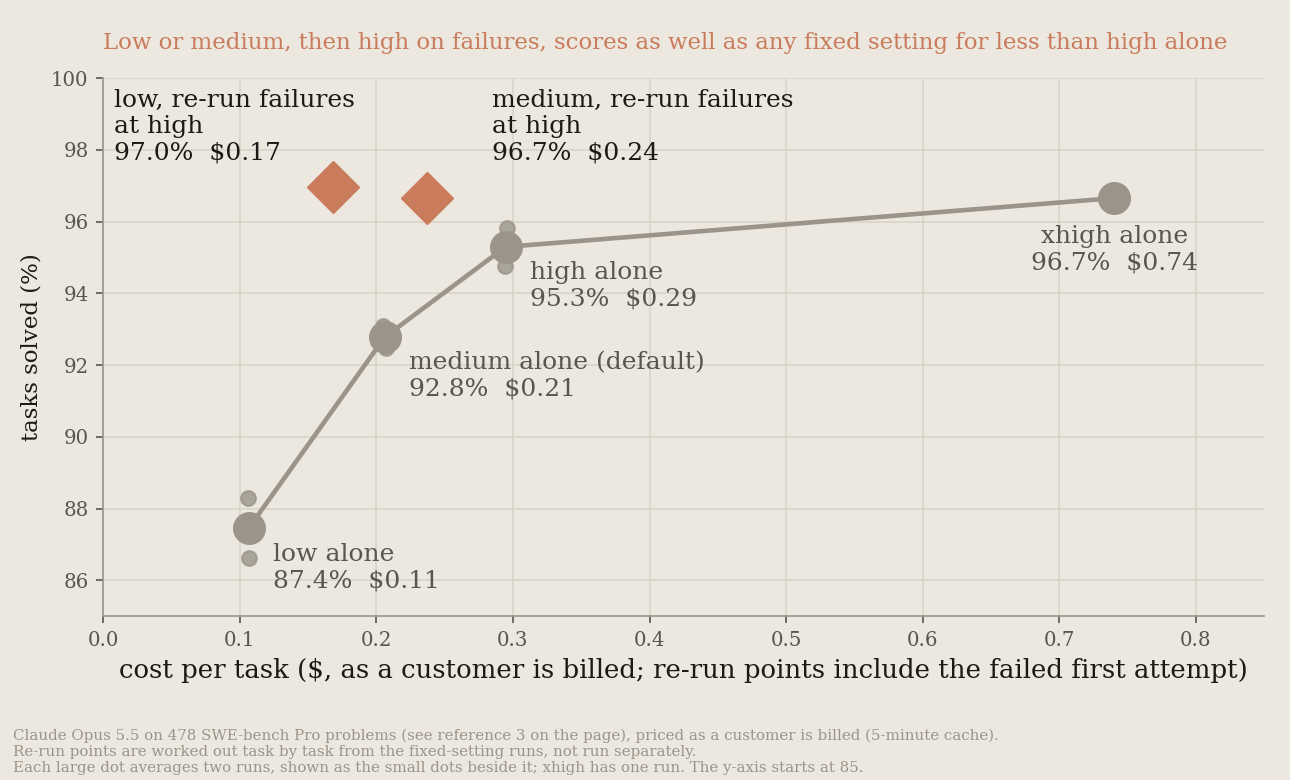
有兩個條件適用。第一,您需要一個失敗訊號(此處為基準測試自己的測試);一個會放行不良工作的檢查器會讓那些失敗漏過。第二,每個第一輪失敗都需要兩次執行的實際時間,因此節省是以失敗任務上的延遲為代價換來的。
設定預算與輸出上限
大多數代理式任務執行都很便宜,但少數會在搜尋、重複驗證與過度測試上花費中位數成本的許多倍。任務預算針對的就是這個長尾。模型會看到整個任務的即時 token 倒數並自我調節,削減低價值的搜尋、跳過多餘的驗證,並收尾而非陷入螺旋。
Anthropic 在 SWE-bench Pro3 上使用 Claude Fable 5.1,測量了隨著預算收緊時的通過率與每項任務成本:
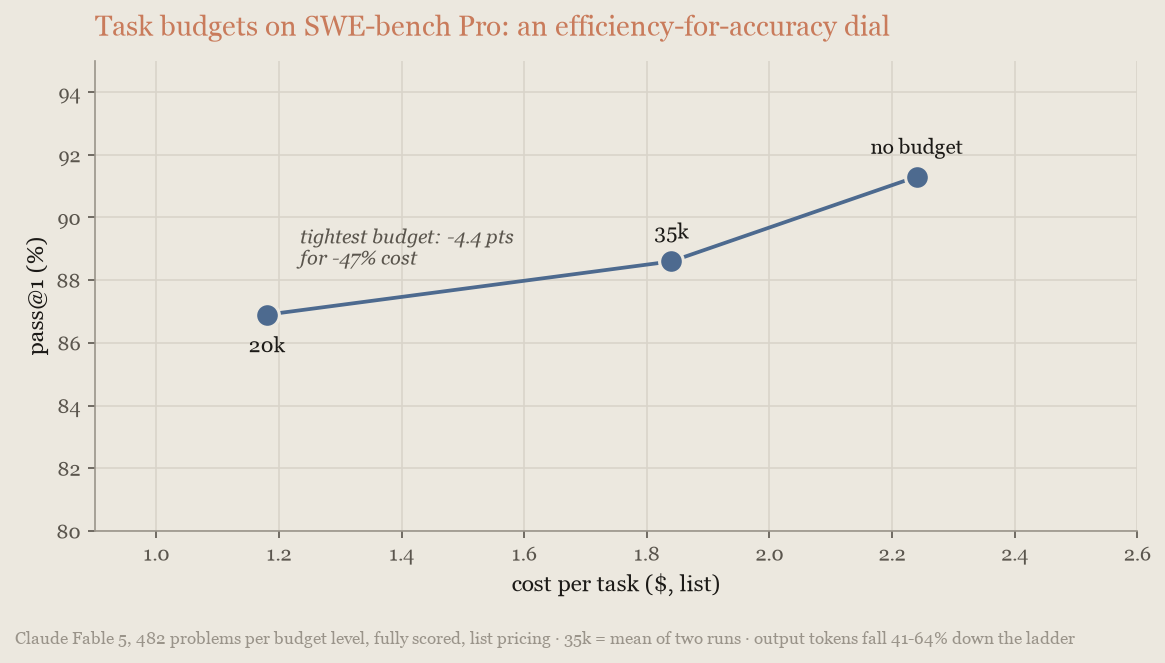
寬鬆的預算以約 3 分的通過率(處於執行間雜訊的邊緣)將每項任務成本削減了 44%,而允許的最緊預算則以 6 分的代價削減了 58%。預算在此換來了效率,其通過率代價隨著預算收緊而增加。
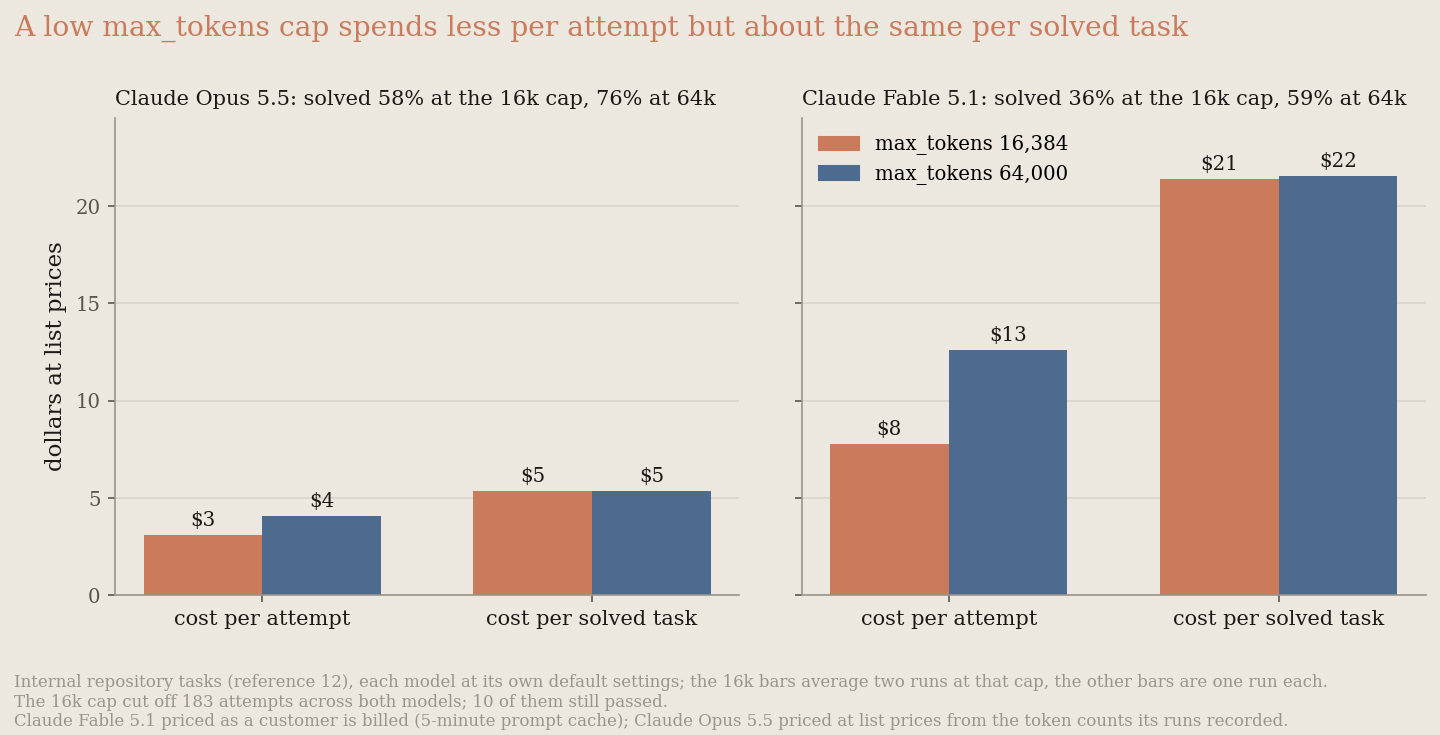
三種控制項做三種不同的工作。任務預算能省錢,因為模型看得到它。max_tokens 是安全上限:降低它會削減每次嘗試的成本,但不會降低每項已解決任務的成本。在 Claude Managed Agents 上,工作階段預算是兩者背後的硬性金額停止點。三者都要設定:任務預算、高的 max_tokens,以及針對您永遠不想在帳單上看到的執行所設的工作階段上限,並以工作區支出限制作為最後的防線。
- 任務預算在最新的模型上處於 beta 階段(beta 標頭
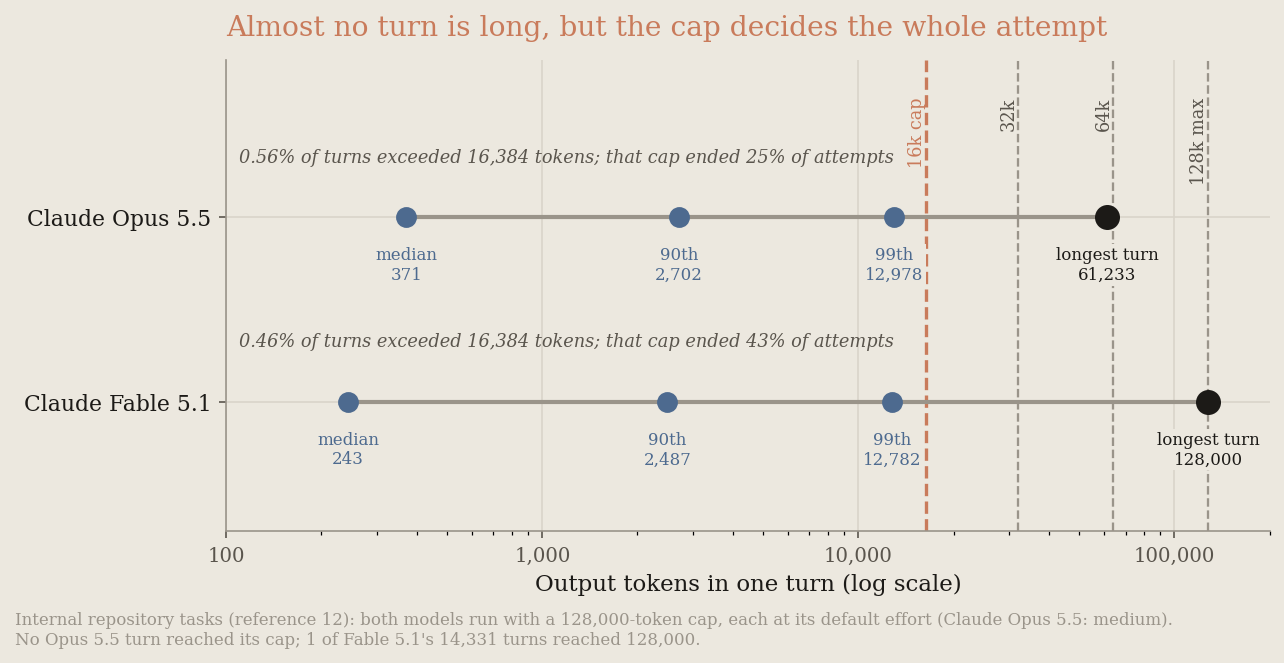
task-budgets-2026-03-13);請查看支援表以了解是哪些模型。從接近您迴圈第 90 百分位數的 token 用量開始,然後收緊(選擇預算說明了如何收集該分佈)。低於目前 20,000 token 下限的預算會被拒絕,而非常緊的預算可能產生類似拒絕的行為。請在第一個請求上設定一次預算,因為任務中途的變更會使快取失效。預算是建議性的,引導模型而非停止它,因此請在您的工作負載上驗證遵循情況。 max_tokens限制單一回應的長度,且模型看不到它,因此降低它並不會讓模型節約。需要更多空間的輪次會被捨棄,但仍會計費。在一項內部儲存庫任務基準測試12上,16,384 token 的上限截斷了約四分之一的 Claude Opus 5.5 嘗試和 43% 的 Claude Fable 5.1 嘗試,兩者皆使用其預設 effort。在 66 次被截斷的 Opus 5.5 嘗試中只有 1 次仍然通過,在 117 次被截斷的 Fable 嘗試中只有 9 次通過。被截斷的執行每次嘗試花費較少,但換來的解決數也按比例減少,因此每個已解決任務的成本與 64,000 時大致相同(Fable 5.1 為 $21 對 $22;Opus 5.5 的差距在 1% 以內)。在 64,000 時,約 14,000 個預設 effort 的 Claude Fable 5.1 輪次中仍有 2 個被截斷(Claude Opus 5.5 則沒有),而 Fable 5.1 解決了 58.5% 的任務,而非 36.3%(在參考文獻 12 所述的 SWE-bench Pro3 子集另一個切分上則沒有差異:兩種上限下皆為 100 個中的 94 個)。重試被截斷的嘗試很少有幫助:在相同上限下,大多數會再次失敗;而在較高上限下,您還要為浪費掉的嘗試付費。對於代理式工作,請將max_tokens設為 64,000;若單次被截斷的嘗試代價高昂,則設為最大值 128,000;在 128,000 時,Fable 5.1 以相同的每個已解決任務成本解決了 60.0% 的任務。對如此大的回應請使用「streaming」(串流),將stop_reason: max_tokens視為失敗,並透過模型看得到的 effort 和任務預算來省錢。- Claude Managed Agents 上的工作階段預算是硬性停止點。工作階段預算是對單一工作階段依 token、搜尋與工作階段時間的定價費率所設的金額上限。達到上限時,工作階段會以
stop_reason: budget_reached暫停;提高預算即可恢復。它由平台強制執行,適用於任何有定價的模型,包括尚未提供任務預算的模型,並可與建議性的任務預算結合使用。部署會將相同的欄位套用到每次執行。
要求更短的答案。在 Claude Sonnet 5 上,輸出 token 的成本是輸入 token 的五倍,而在代理迴圈中,模型寫出的每個 token 都會在之後的每個輪次作為輸入回來,因此您會為一個長答案一再付費。Anthropic 在三種最終答案指令下執行了分類工作,每種執行三次,使用相同的模型與工具。原始版本要求兩行:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>較短的變體要求一行:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.較長的變體要求一份包含五個帶標題章節的備忘錄:問題摘要、證據、重複檢查、建議標籤與後續步驟。對於其中一個議題(一個在跳過問題後永遠不會送出的排隊提示),前兩種答案為:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.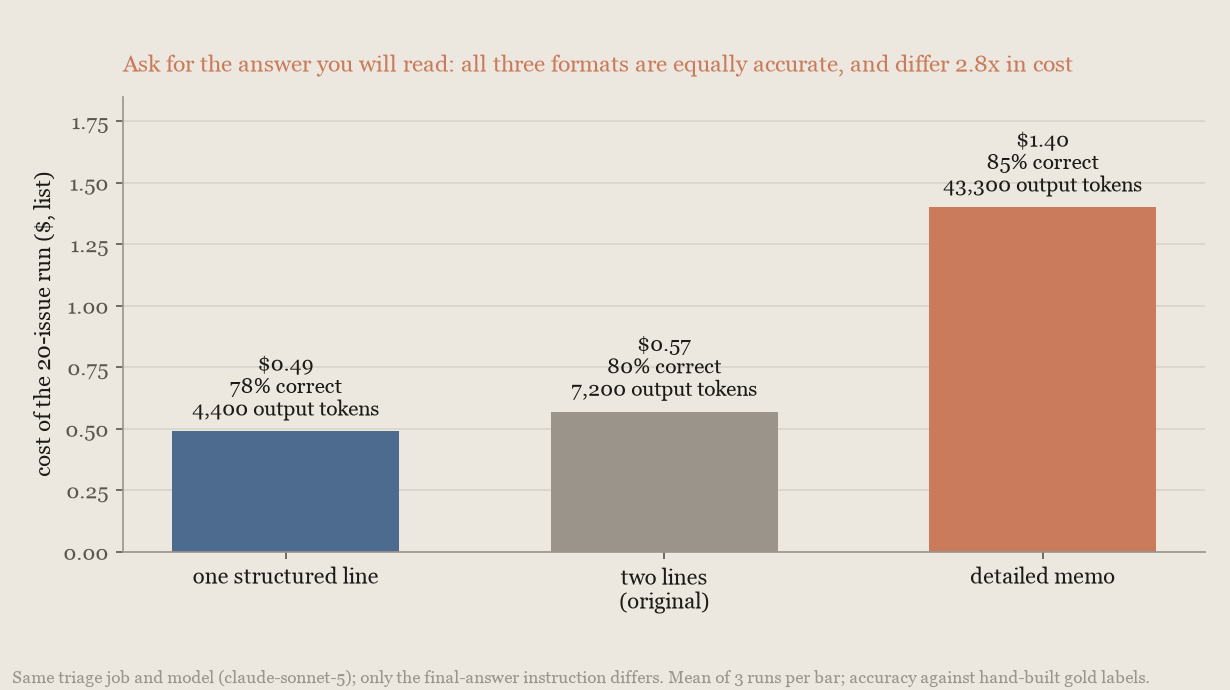
單行答案比兩行原始版本少用了 39% 的輸出 token,每次執行成本低 14%。備忘錄使用了六倍的輸出 token,成本是單行答案的 2.8 倍。三者對照標準標籤的得分都在彼此的執行間雜訊範圍內,因此這些格式在您付出的費用上的差異遠大於它們答對內容的差異。要求您會閱讀的答案,而不是看起來很周全的答案。
在較低的 max_tokens 上限下,兩個模型每次嘗試花費較少,但解決的任務也成比例地減少,因此每項已解決任務的成本幾乎不變:
幾乎每個輪次都遠低於任一上限就結束了。罕見的長輪次才是較高上限所換來的:
向模型顯示經過時間
代理迴圈中的模型看不到時鐘。任務預算會向模型顯示還剩多少 token,但預設情況下,請求中沒有任何內容會顯示工作已經花了多久。兩個小變更就能提供這個訊號。在「system prompt」(系統提示)中加入一段兩句話的指示,說明時間很重要;並從第二個請求開始,在模型的每個輪次之前傳送經過時間。
Anthropic 使用 high effort 的 Claude Fable 5.1,在兩個公開基準測試 DRACO21 和 HLE22,以及一組改編自公開 CritPt 基準測試23、包含 70 道研究等級物理問題的內部題組上,同時測量了這兩項變更。本頁將該題組稱為物理題組。三者各以兩種形式執行:單一代理,以及由主導代理啟動同一模型的輔助代理並行工作的團隊。若分數變化的 95% 區間落在 Anthropic 於執行前設定的界限內,即視為在容許範圍內:DRACO 為 1.5 分,HLE 為 2.5 分。下圖繪製了每種配置的分數對每個任務成本。第二列長條顯示每種配置的時間相對於 high effort 單一代理的比率(不含重試等待)。第三列顯示兩項變更造成的分數變化及其 95% 區間:
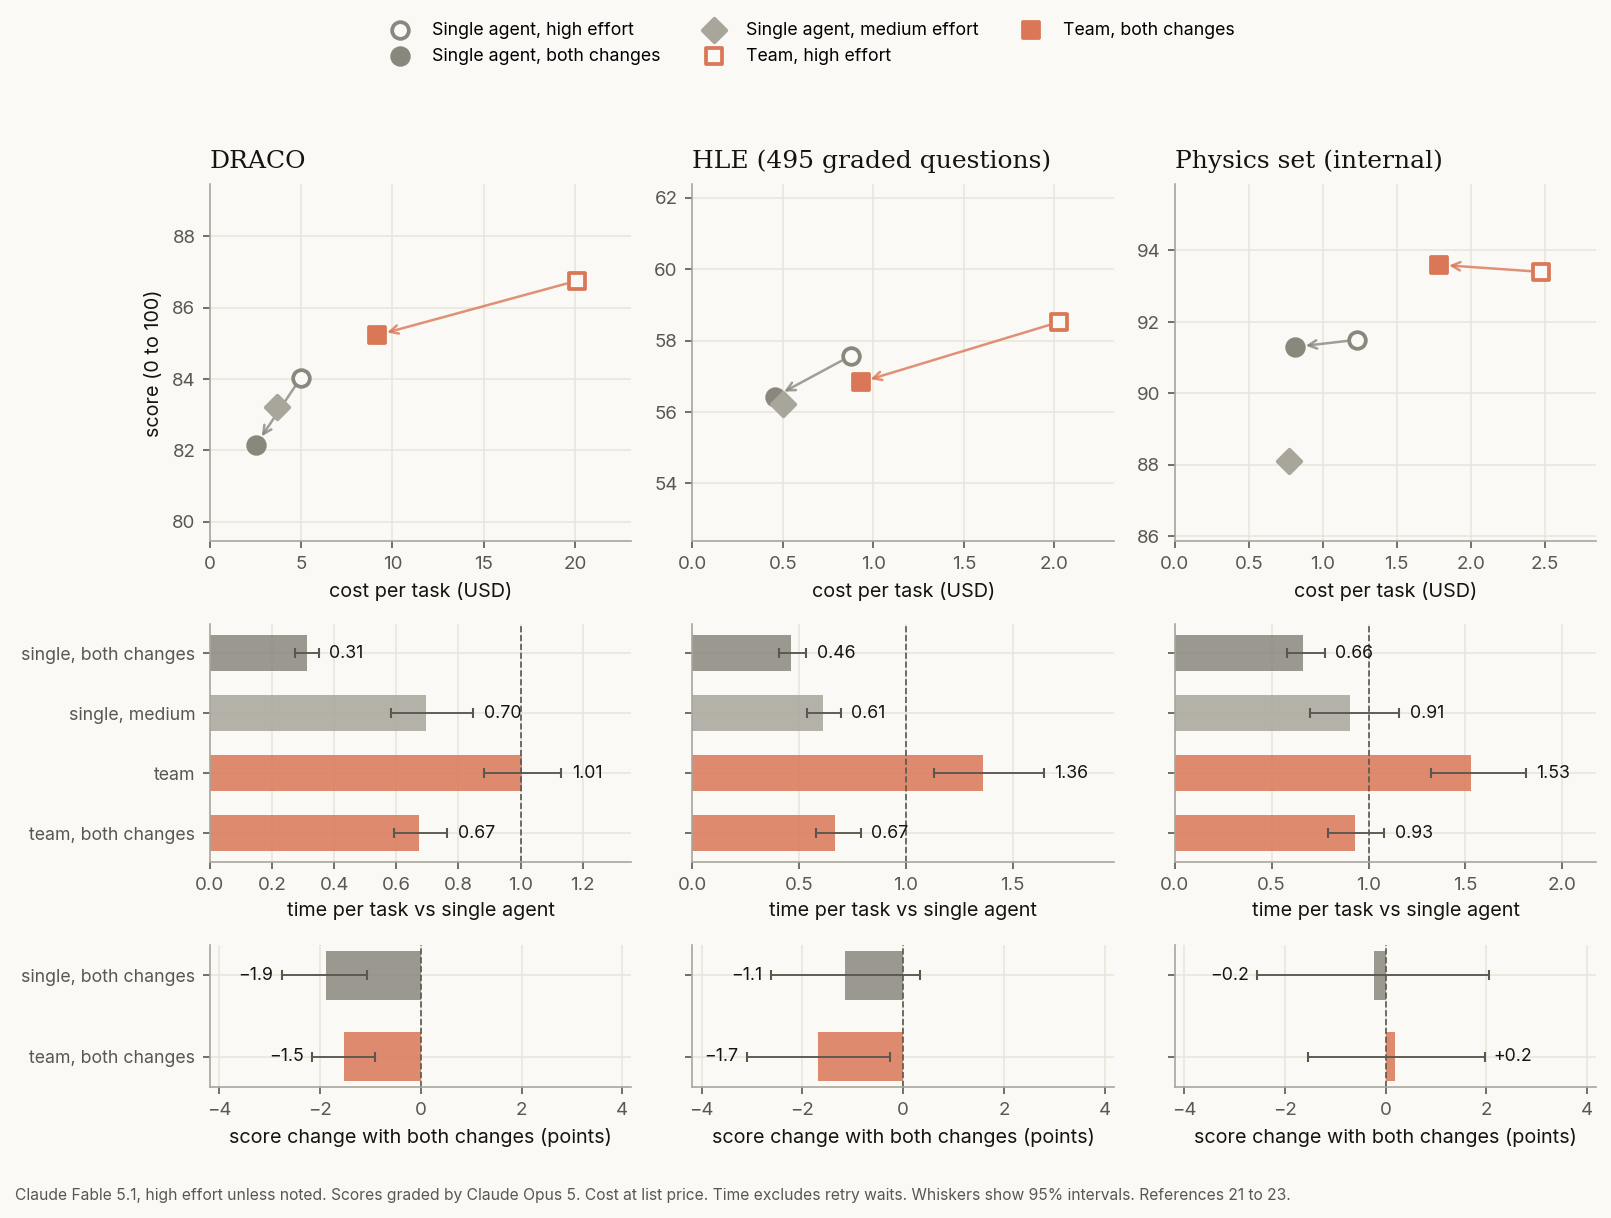
搭配代理團隊。 團隊做的工作比單一代理多,因此預設成本較高。在 DRACO 上,團隊的成本是單一代理的 4.0 倍,耗時大致相同(95% 區間為少 12% 到多 13%)。在每個代理上加入指示和時鐘後,團隊的完成時間減少 33%,每個任務成本降低 54%。其分數低 1.5 分(95% 區間為低 0.9 到 2.1 分),而該區間的遠端(低 2.1 分)超出了 1.5 分的容許範圍。在 HLE 上,團隊的完成時間減少 51%,每個任務成本降低 54%。其分數低 1.7 分(95% 區間為低 0.3 到 3.1 分),而該區間的遠端(低 3.1 分)超出了 2.5 分的容許範圍。在物理題組23上,團隊的完成時間減少 39%。其每個任務成本降低 28%,而這項節省取決於提示快取在請求之間過期的頻率。若沒有過期,節省將為 23%。其分數高 0.2 分(95% 區間為低 1.5 到高 2.0 分)。
在 DRACO 上,主導代理每次嘗試啟動的輔助代理中位數為 4 個,因此 DRACO 的結果呈現的是並行工作的團隊。在 HLE 和物理題組上,主導代理啟動的輔助代理中位數為 0 個,因此這些團隊執行中至少有一半只有主導代理。這些團隊結果主要呈現的是主導代理本身的行為,而非並行輔助代理的效果。
搭配單一代理。 在物理題組23上,相同的變更使單一代理的時間減少 34%,每個任務成本降低 34%。其分數低 0.2 分(95% 區間為低 2.5 到高 2.1 分)。在物理題組上,較低的 effort 等級節省了成本,但未明顯節省時間。在 medium effort 下,單一代理每個任務的成本比 high 低 37%,時間少 9%(95% 區間為少 30% 到多 16%)。其分數低 3.4 分(95% 區間為低 0.4 到 6.8 分),且區間接近零。在 high effort 下套用兩項變更時,單一代理的耗時比 medium effort 少 27%(95% 區間為少 5% 到少 44%)。其每個任務成本高 6%(95% 區間為低 12% 到高 27%),分數高 3.2 分(95% 區間為低 0.1 到高 6.5 分)。
在 HLE 上,相同的變更使單一代理的時間減少 54%,每個任務成本降低 48%。其分數低 1.1 分(95% 區間為低 2.6 到高 0.3 分),而該區間的遠端(低 2.6 分)略微超出 2.5 分的容許範圍。在 medium effort 下,單一代理每個任務的成本比 high 低 43%,耗時少 39%,分數低 1.3 分(95% 區間為低 2.8 到高 0.1 分)。在 high effort 下套用兩項變更時,單一代理的耗時比 medium effort 少 25%(95% 區間為少 12% 到少 35%)。其每個任務成本低 9%(95% 區間為低 21% 到高 6%),分數高 0.2 分(95% 區間為低 1.3 到高 1.7 分)。
在 DRACO 上,相同的變更使單一代理的時間減少 69%,每個任務成本降低 49%。其分數低 1.9 分(95% 區間為低 1.1 到 2.8 分),而該區間的遠端(低 2.8 分)超出了 1.5 分的容許範圍。在 medium effort 下,單一代理每個任務的成本比 high 低 25%,耗時少 30%,分數低 0.7 分(95% 區間為低 0.1 到 1.3 分)。在 high effort 下套用兩項變更時,單一代理的耗時比 medium effort 少 53%(95% 區間為少 42% 到少 63%),每個任務成本低 31%(95% 區間為低 28% 到低 35%)。其分數低 1.2 分(95% 區間為低 0.5 到 1.9 分),而該區間的遠端(低 1.9 分)超出了 1.5 分的容許範圍。
在全部三個題組上,high effort 下套用兩項變更所節省的時間都比 medium effort 更多。在 HLE 和物理題組上,成本沒有明顯差異,而在 DRACO 上成本較低。HLE 上的分數大致相同。在物理題組上分數高 3.2 分,但該區間包含零,因此差異並不明確。所以對單一代理而言,時鐘比降低 effort 等級更能節省時間。不過在 DRACO 上,套用兩項變更的單一代理分數比 medium effort 低 1.2 分(95% 區間為低 0.5 到 1.9 分)。
何時使用。
- 當代理的時間很重要,且可以接受小幅的分數變化時,請同時使用這兩項變更。在所有測量的配置中,無論是團隊還是單一代理,它們都降低了時間和每個任務的成本。
- 採用之前,請先在您自己的任務上檢查分數。在 DRACO 上,團隊的分數低 1.5 分,單一代理低 1.9 分。在 HLE 上,團隊低 1.7 分,單一代理低 1.1 分。在物理題組上,兩者的分數變化都與零沒有明顯差異。
- 如果您已經在考慮降低 effort 等級以節省時間,請將其與時鐘做比較。在
higheffort 下套用兩項變更的單一代理,耗時比mediumeffort 少:DRACO 少 53%,HLE 少 25%,物理題組少 27%。其每個任務成本在 DRACO 上低 31%,在 HLE 和物理題組上則沒有明顯差異。
如何加入。 將此指示放在每個代理的系統提示開頭:
Time matters here: do not spend time that can be avoided, and the earlier a correct result is obtained, the better. The elapsed time so far is shown before each of your turns.第二句話告訴模型時鐘訊息的存在。第一個請求不帶時鐘,而測量的執行使用的正是這段措辭。
接著,在代理第一個請求之後的每個請求之前,附加一則對話中途系統訊息,以整數秒提供經過時間,例如 Elapsed time: 412 seconds。請從任務開始時計算,而非從代理開始時計算。在團隊中,每個代理讀取同一個時鐘,因此輔助代理看到的第一個時鐘已經計入了團隊在該輔助代理啟動前所花的時間。在工具迴圈中,請將訊息放在攜帶工具結果的 user 訊息之後,如放置於工具結果之後所示。如果您改為傳送新的 user 訊息給代理,請將時鐘放在該訊息之後。
請保留先前的時鐘訊息不動。每則訊息都會成為對話歷史的一部分,因此快取的前綴在下一個請求中仍然相符(請參閱與提示快取結合使用)。Anthropic 測量的是這些一般系統訊息,它們對模型保持可見。回合範圍的系統訊息只會向模型顯示最新的時鐘,而 Anthropic 並未測量該形式。
以下範例以兩項變更執行一個代理的工具迴圈。它在工具結果之後加入時鐘,且僅處理用戶端工具:
import time

import anthropic

client = anthropic.Anthropic()

TIME_MATTERS = (
    "Time matters here: do not spend time that can be avoided, and the earlier a "
    "correct result is obtained, the better. The elapsed time so far is shown before "
    "each of your turns."
)


def run_agent(task, system, tools, run_tool, started_at=None):
    """Run one agent's tool loop. In a team, pass the lead's started_at to every helper."""
    if started_at is None:
        # 使用 wall-clock(實際時間)秒數,讓其他程序中的輔助程式能共用主程序的開始時間。
        started_at = time.time()
    messages = [{"role": "user", "content": task}]
    while True:
        # 使用 streaming(串流),因為 128,000 token 的上限對非串流請求而言過大。
        with client.messages.stream(
            model="claude-fable-5-1",
            max_tokens=128000,
            cache_control={"type": "ephemeral"},
            system=TIME_MATTERS + "\n\n" + system,
            tools=tools,
            messages=messages,
        ) as stream:
            response = stream.get_final_message()
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            return response
        results = [
            {
                "type": "tool_result",
                "tool_use_id": block.id,
                "content": run_tool(block.name, block.input),
            }
            for block in response.content
            if block.type == "tool_use"
        ]
        messages.append({"role": "user", "content": results})
        # 系統訊息必須接在使用者回合之後,因此時鐘資訊放在工具結果之後。
        elapsed = int(time.time() - started_at)
        messages.append(
            {"role": "system", "content": f"Elapsed time: {elapsed} seconds"}
)Claude Fable 5.1 支援對話中途系統訊息。支援的模型清單涵蓋了其他模型。在不支援此功能的模型上(例如 Claude Sonnet 5),您可以將同一行放在 user 輪次中最後一個 tool_result 區塊之後的文字區塊中。Anthropic 只測量了系統訊息形式。
在 Claude Managed Agents 上,您可以隨工具結果或使用者訊息傳送 system.message 事件。該訊息適用於該輪次及之後的每個輪次。因此,在平台內建工具(例如網頁搜尋)之後的輪次,看到的是您最後傳送的時鐘,而非目前時間。system.message 也只會送達工作階段的主要執行緒。在多代理工作階段中,那是協調者的執行緒,因此工作者代理永遠看不到您以此方式傳送的時鐘。若要在每個輪次之前、並向團隊中的每個代理顯示目前時間,請在 Messages API 上自行執行代理迴圈。
組合模型
多模型架構適合任務複雜度變化足夠大、以至於不同步驟最好由不同模型處理的工作負載。當您的流量混合了較小模型能可靠處理的例行工作與需要前沿能力的較難步驟時,拆分工作能將前沿智慧保留在重要之處,同時大多數 token 以較小模型的費率計費。當工作負載缺乏這種混合(因為其難度均一,或它是一條相依的鏈)時,單一經過良好調整的模型通常是更好的選擇。每個策略章節都提供了區分這兩種情況的規則。
兩種策略涵蓋了大多數工作負載,它們的差異在於哪個模型掌握主迴圈:
| 策略 | 控制流程 | 前沿模型的角色 | 適合 | 前沿成本隨何者擴展 |
|---|---|---|---|---|
| 顧問 | 較小模型執行迴圈,按需升級 | 被諮詢以提供計畫與修正 | 局部困難的序列工作,例如程式開發代理在少數真正決策之間的許多輪次 | 執行者卡住的頻率 |
| 協調器 | 前沿模型執行迴圈,委派大量工作 | 規劃、分派與綜合 | 可扇出到真正獨立的檔案、文件或案例的工作,尤其是超過一個上下文視窗的量 | 各部分協調的難度 |
顧問策略:升級困難決策
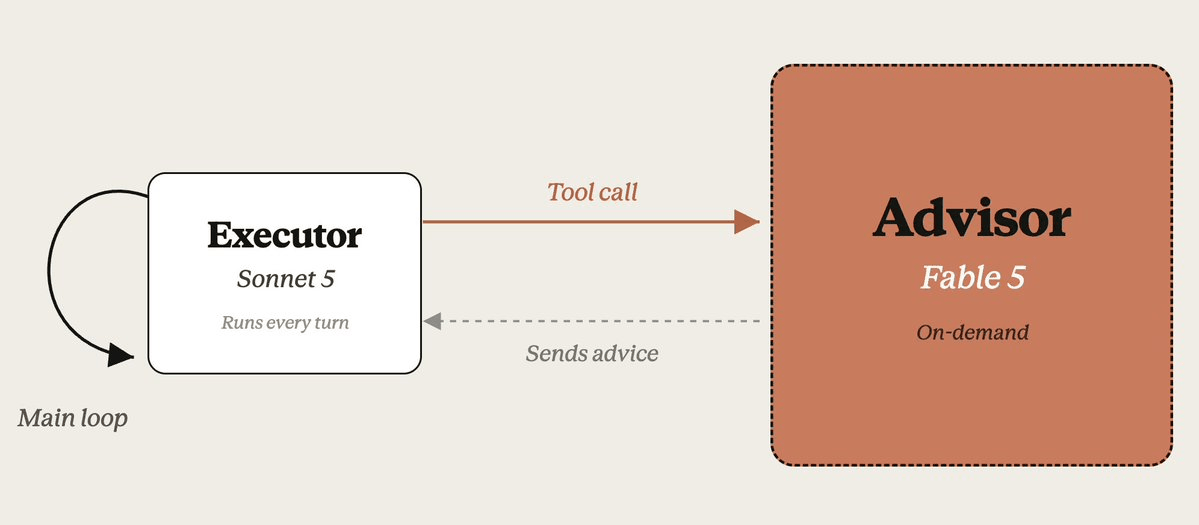
在顧問策略中,較低成本的執行者模型執行代理迴圈並執行大多數輪次。當它遇到需要更深判斷的決策時(例如選擇方法或從失敗中恢復),它會呼叫較高智慧的顧問模型以取得策略指引,然後繼續。大多數 token 以執行者費率計費,只有偶爾的諮詢以顧問費率計費。
要使用它,請將顧問工具加入您的請求。這項 beta 功能在單一 /v1/messages 請求中於伺服器端執行整個策略:執行者發出工具呼叫,Anthropic 執行顧問推論,執行者帶著建議繼續;您無需撰寫任何協調程式碼。在 Claude Managed Agents 上,透過在代理的 multiagent 名冊中加入 advisor 項目來為工作階段提供顧問;工作階段的主執行緒以相同方式諮詢它。Claude Code 也支援它;請參閱使用顧問工具升級困難決策。
決定回報的因素。 顧問只能透過執行者的呼叫看到任務,因此有兩件事決定它能幫多少忙。
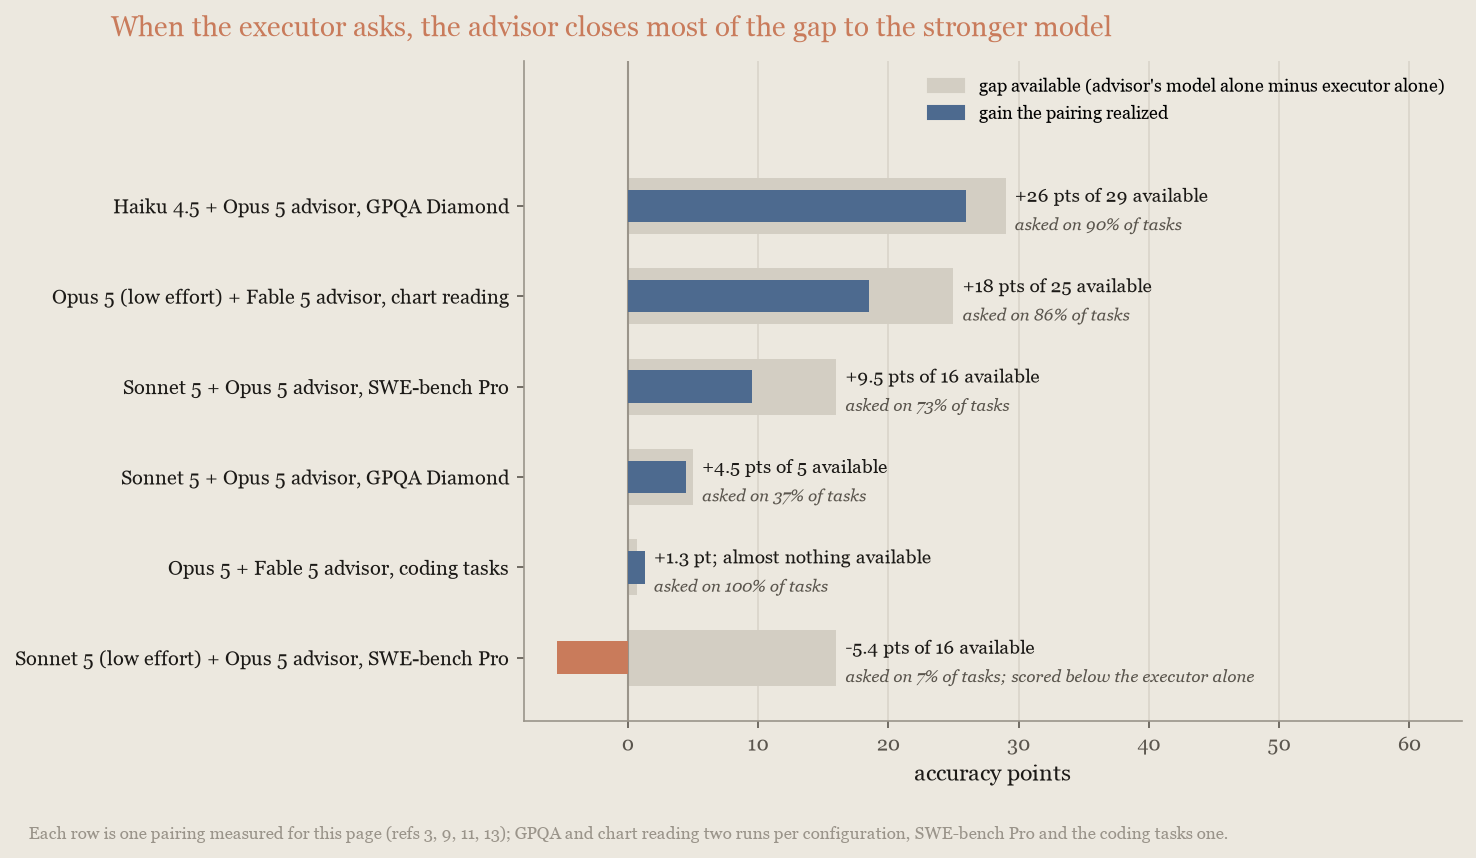
第一是模型之間的差距。顧問只能交付執行者所缺乏的能力:在 GPQA Diamond9 上,Claude Haiku 4.5 執行者從 Claude Opus 5 顧問獲益良多,Claude Sonnet 5 執行者獲得幾分,而前沿執行者幾乎沒有獲益。
第二,也是脆弱的一項,是執行者是否真的會詢問(諮詢率)。低 effort 的執行者可能不再偵測到自己卡住了:一個在預設 effort 下對大多數任務進行諮詢的配對,在降低 effort 後可能降到幾乎不諮詢,然後得分低於執行者單獨運作。該比率也因任務而異:在 DeepSWE10 上,低 effort 的 Sonnet 5 執行者持續詢問並獲得 23 分;在 SWE-bench Pro3 上,同一執行者停止了詢問。當執行者確實詢問時,它能彌補大部分差距。在下圖中執行者持續詢問的配對中,顧問至少彌補了與較強模型之間一半的差距(程式開發配對直接勝過了較強模型),而您只在諮詢時為較強模型付費,這正是成本案例得以成立的原因:
諮詢率會受提示影響。若只有工具內建的描述,執行者會呼叫不足,尤其是在程式設計工作上,因此顧問工具文件提供了一段系統提示,要求在實質工作之前呼叫一次、在完成之前呼叫一次,每個任務約兩到三次呼叫。接下來測量的程式設計配對以 Claude Opus 5 作為執行者時,就是以這個頻率執行,每個任務約諮詢兩次;以 Claude Opus 5.5 作為執行者時,每次嘗試約請求 1.4 次建議,且有 4% 的嘗試沒有收到任何建議。該頁面也說明了如何引導呼叫不足的執行者,以及如何在用戶端限制呼叫次數以控制成本。因此請留意諮詢率:透過提示促成它、測量它,並在它驟降時恢復執行者的 effort。
何時在成本上划算。 當幾次以顧問費率計費的簡短諮詢,取代了在整個任務中執行顧問模型時,顧問就能省錢。當顧問模型的價格遠高於執行者時效果最好,因此最具成本效益的配置是前沿顧問搭配中階執行者。位於範圍頂端的配對可以回收部分建議成本,因為建議也能節省執行者的 token:被告知正確方法的執行者會少走冤枉路。在下方以 Claude Opus 5 作為執行者的程式設計配對中,這項節省抵銷了約一半的建議成本:執行者每次嘗試比單獨使用預設值的 Opus 5 少花 $1.26,而諮詢花費 $2.47。以 Claude Opus 5.5 作為執行者時,建議幾乎沒有節省執行者成本:每次嘗試 $1.36,相較於單獨使用 high 的 Opus 5.5 為 $1.38,而諮詢花費 $1.55。
在一項內部代理式程式設計基準測試11上(以一般 API 代理執行),high 的 Claude Opus 5.5 執行者搭配 Claude Fable 5.1 顧問得分 90.1%,每次嘗試 $2.92。這比單獨使用 high(執行者本身的設定)的 Opus 5.5 高 1.7 分(在每個任務五次嘗試下,此差距處於執行間雜訊的邊緣),花費約為 2.1 倍;相較於預設值 medium 的 Opus 5.5,則是高 3.5 分,花費約為 3.5 倍。它大致落在 Opus 5.5 本身的 effort 曲線上,因此顧問換來的效果與提高 effort 差不多:單獨使用 xhigh 的 Opus 5.5 得分 91.1%,每次嘗試 $4.11(每個任務一次嘗試)。在 8 月,Claude Fable 5.1 顧問搭配 Claude Opus 5 執行者是測量中最準確的配置,每次嘗試 $6.21,略高於 Opus 5.5 配對成本的兩倍。圖表將 Opus 5.5 配對與 Opus 5.5 本身的 effort 曲線,以及 8 月時 Claude Fable 5.1 的曲線進行對照:
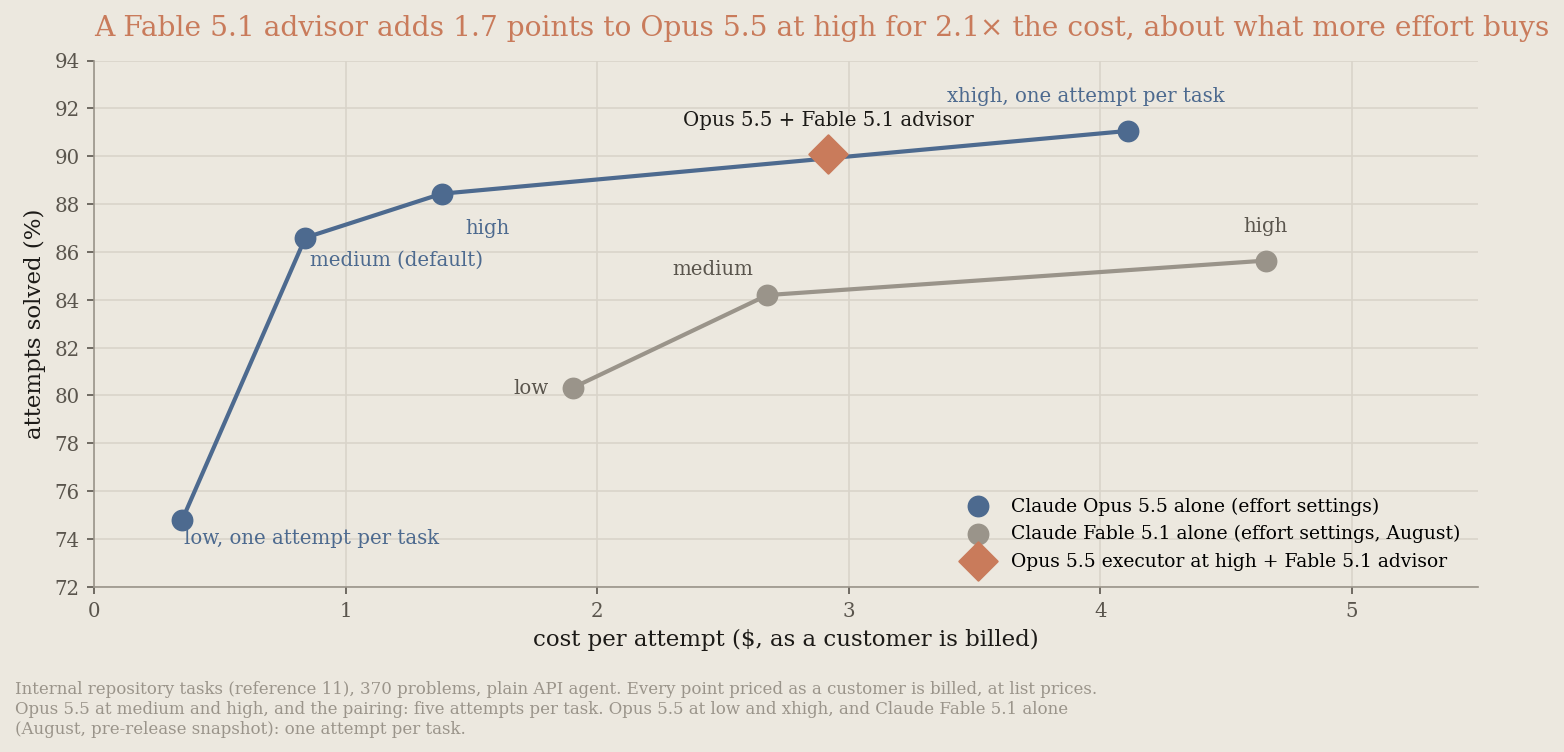
先前透過 Claude Code 的顧問模式進行的測量,也將其顧問配對排在兩個模型單獨使用之上。請將 Claude Opus 5.5 的結果視為一種需要在您的工作負載上測試的模式:顧問以約為執行者單獨成本兩倍的花費換來幾分提升。更大的能力差距並不保證更划算。延遲成本就是諮詢本身:在此基準測試上,每個任務約多出一到兩次前沿模型呼叫,且每次都位於任務的關鍵路徑上。
何時單獨使用較強模型是更好的選擇。 當工作負載的準確度會隨 effort 變化時,在建立配對之前,請先將其與以較低設定單獨使用顧問模型進行比較:顧問只在需要它的任務上計費,但若在大多數任務上都觸發諮詢,成本會高於直接執行較強模型。在 Chartography13 上,low 的 Claude Opus 5.5 執行者搭配 Claude Fable 5.1 顧問,在 300 個任務中只諮詢了 1 次,得分 61.7,比單獨使用 Opus 5.5 低 7 分,超出執行間雜訊,成本則大致相同;在 8 月,Claude Opus 5 執行者幾乎在每個任務上都提出諮詢,該配對在執行間雜訊範圍內追平了單獨使用 medium 的 Fable 5.1(65.0 對 67.5),每個任務成本約為 1.8 倍。請先測量您自己的諮詢率:如果執行者在大多數任務上都提出諮詢,您就是在整個工作負載上支付顧問費率,而直接執行顧問模型是達到相同分數更便宜的方式。
無論配對為何,請先為顧問的模型在低 effort 下單獨運作定價;那是要超越的基準線。在每次模型發布時重新檢查,因為發布會同時改變能力差距與價格比率。
何時適合。 顧問策略適合輪次大多是機械性的、但優秀的計畫很重要的工作負載:程式開發代理、電腦使用與多步驟研究管線。當每個輪次都真正需要前沿能力、當沒有什麼可規劃(單輪問答),或當您的執行者已經接近顧問的能力時,它就不太適合。
協調器策略:委派大量工作
在協調器策略中,前沿模型掌握迴圈。它分解任務、將子任務分派給較低成本的工作者模型,並合併它們的結果。協調器自己的對話記錄保持簡短,因為工作者吸收了 token 密集的探索,因此大多數 token 以工作者費率計費,而計畫與綜合仍來自前沿模型。
要建構一個,請使用 Claude Managed Agents 中的多代理協調:配置一個協調者代理(協調器)與一份工作者代理名冊,每個都有自己的模型。有關搭配前沿協調者與 Claude Sonnet 5 工作者的完整可運作範例,請參閱 Claude Cookbook 食譜協調者模式:大模型負責規劃,小模型負責執行。
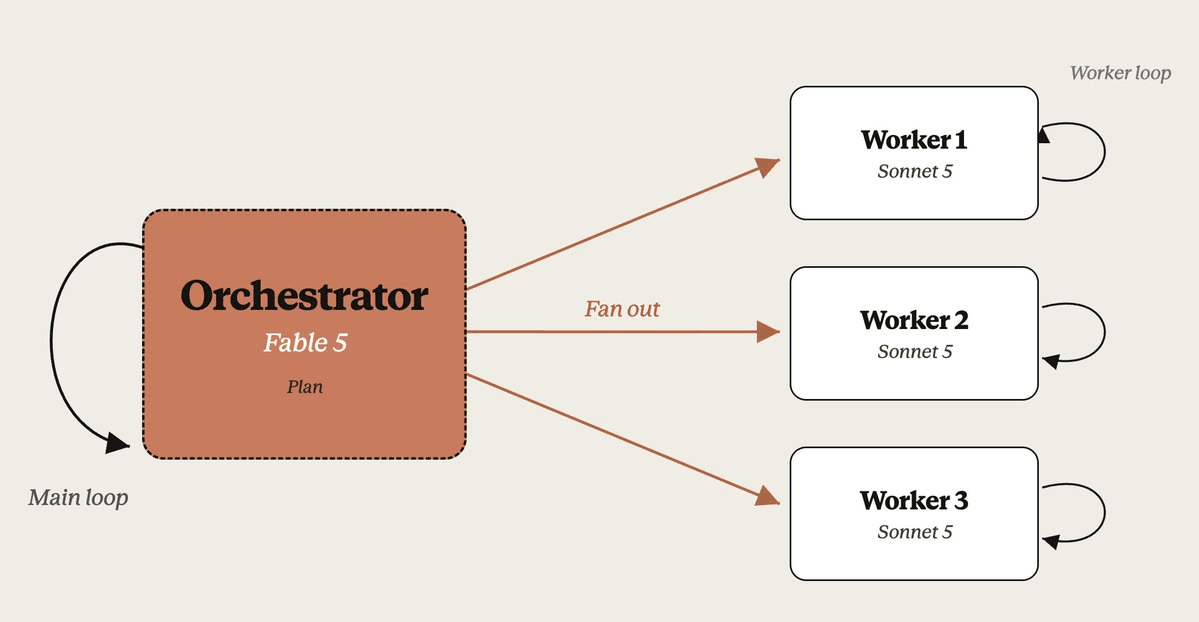
當工作者可以平行執行時,此模式能節省實際時間:在語料庫基準測試8上,協調者以平台文件記載的 25 個並行工作者上限執行時,一個回合約花費 2.3 小時,而單獨運作則為 15 到 20 小時。它只在兩種測量到的情況下省錢。在單一模型能獨自處理的工作上,同一模型在較低 effort 下每次都更便宜。
當工作者平行執行時,時間指示與經過時間時鐘可以縮短執行時間。在 DRACO21 上,一組使用相同模型、具備該指示與時鐘的代理團隊,完成時間減少 33%,每項任務成本降低 54%,分數則低了 1.5 分。該團隊中的每個代理都具備該指示與時鐘。Anthropic 並未測量搭配成本較低工作者時的時鐘效果。在 Claude Managed Agents 上,時鐘只會傳達給協調者,因此工作者永遠看不到它。Anthropic 並未測量只有協調者具備時鐘的團隊。此外,協調者的時鐘只有在緊接您自己的工具結果或訊息之後的輪次中才是最新的。向模型顯示經過時間提供了在 Messages API 上執行代理迴圈的做法。
情況 1:針對例行工作成本長尾的保險。 單獨運作的前沿模型偶爾會在它通常能解決的例行問題上陷入螺旋。因為您無法事先知道會是哪些,少數這樣的執行就主導了帳單。將例行工作交給較低成本工作者的協調者能限制該長尾,因為任何螺旋現在都以工作者費率發生。
Anthropic 在 BrowseComp4 一個刻意簡單的切片上測量了這一點(10 個單獨模型能可靠解決的問題;50 次委派執行與 70 次單獨執行)。Claude Fable 5 協調者搭配一個 Claude Sonnet 5 工作者,平均成本約為 Claude Fable 5 單獨運作的一半,在第 90 百分位數約為三分之一($12 對 $33),而單獨模型最昂貴的單次執行($84)也是錯的:
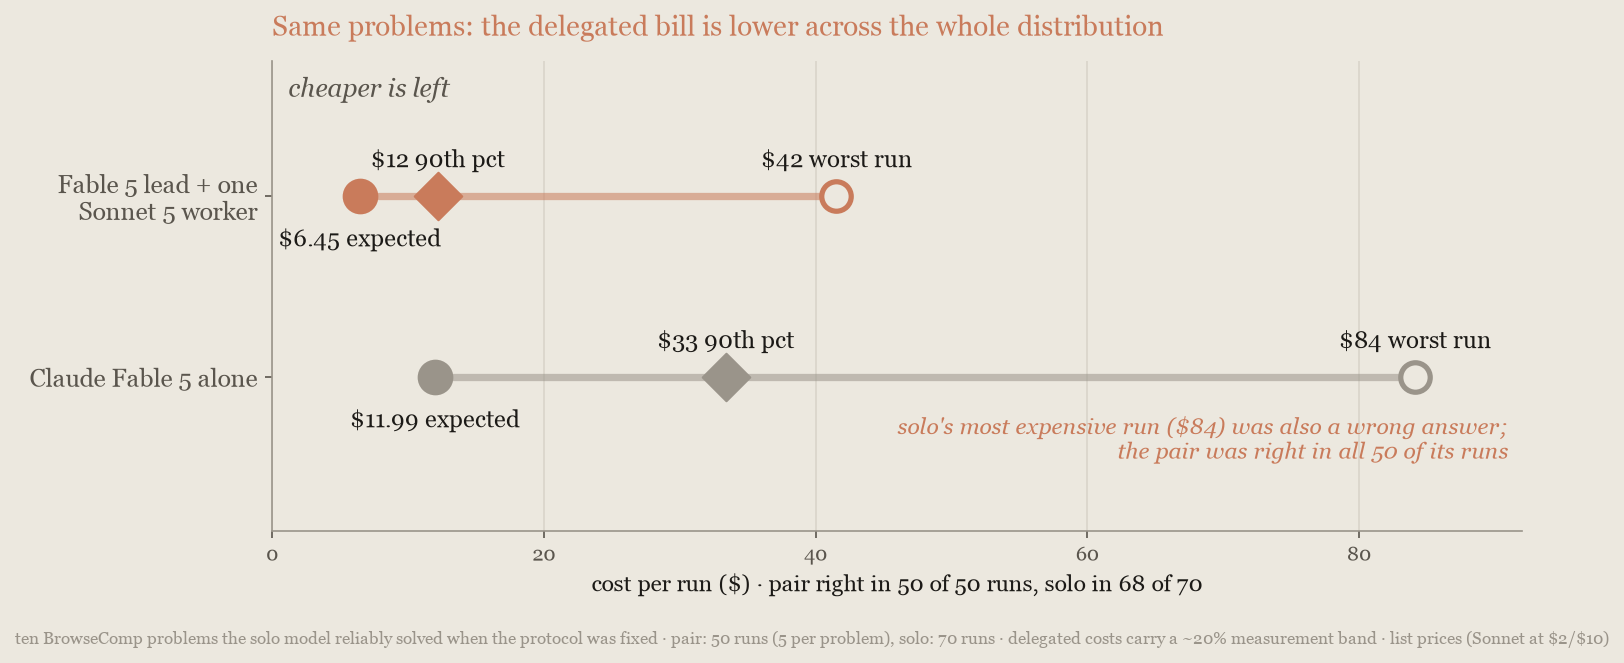
委派在例行、通常可解決的那部分工作上划算,這與工作者是用來處理困難問題的直覺相反。在完整、較難的 BrowseComp 集合上,經濟效益反轉了。如果您的流量在例行任務上有長的成本長尾,這是首先要測量的協調器情況。
情況 2:大於一個上下文視窗的工作。 單獨模型必須序列地處理那麼大的輸入,一次一個上下文視窗,並在每一輪為重新讀取自己的狀態付費。工作者各自讀取自己的分區,平行且以工作者費率進行。仍能放入一個上下文視窗的閱讀密集工作是模型選擇問題,而非委派問題:僅就閱讀成本而言,只有當沒有單一上下文能容納工作時,協調器才會勝出。
Anthropic 為此情況建構了一項基準測試8:一個由 14 個公開 Python 套件組成、含 130 個植入缺陷的 2,160 萬 token 語料庫,對任何上下文視窗都太大。降低 effort 無濟於事,因為帳單就是語料庫讀取本身:Claude Fable 5.1 單獨運作在三種 effort 設定下每回合成本為 $468 到 $552,只有其準確度有變動。協調者配置(Claude Fable 5.1 領導 25 個 Claude Sonnet 5 工作者)的成本約為那些設定的一半(少 47% 到 55%),得分比它們低 10 到 12 分,每回合約 2.3 小時對比 15 到 20 小時,同時直接勝過 Claude Sonnet 5 單獨運作的基準線:
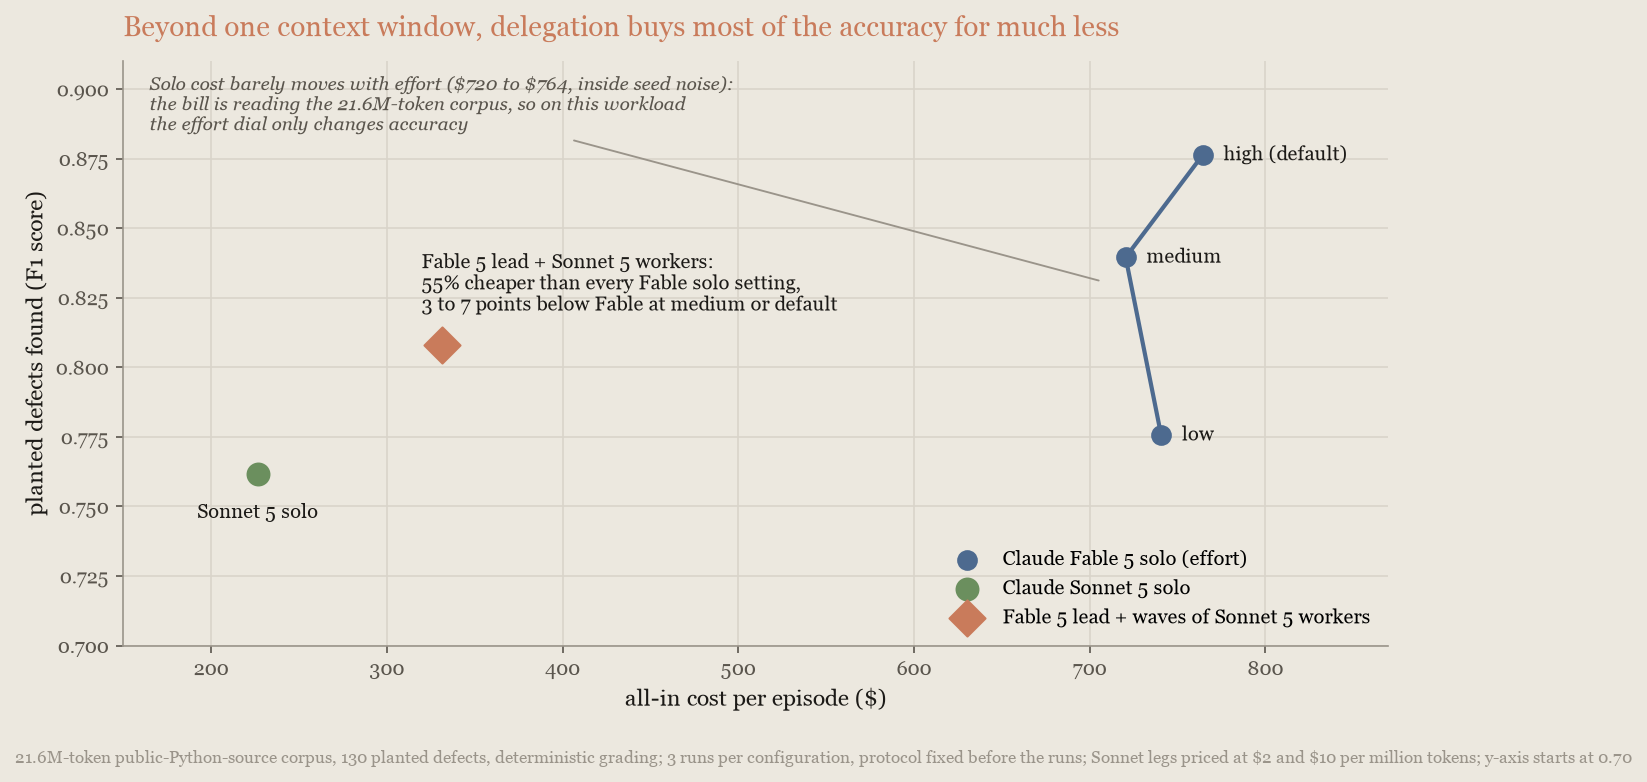
token 帳目顯示了閱讀的規模:協調者配置每回合讀取約 5.6 億個快取 token,約為單獨模型約 3.65 億的一倍半,幾乎全部以 Claude Sonnet 5 的快取讀取費率計費,而整體成本仍約為一半。high effort 下的 Fable 5.1 仍保有最高準確度,成本約為協調者配置的 2.2 倍,因此此處的委派換來了大部分準確度,而非全部。
何時委派不划算。 只有當有大量工作可交付時,協調器才能換來東西:許多獨立的部分,理想上多到一個上下文視窗放不下。當工作是一條相依的鏈,或能放入單一上下文時,協調器要為計畫、交接與合併付費,而單一模型免費就能得到這些。在每個測量到的此類情況中,協調者的模型在較低 effort 下單獨運作都勝出。
界線是任務難度,而非基準測試:在完整、較難的 BrowseComp4 集合上,Claude Fable 5 單獨運作以低 22% 到 30% 的成本達到了協調者配置的準確度。獨立的外部研究報告了相同的模式5。如果工作是一條鏈、能放入一個上下文且沒有長的成本長尾,或單一模型在較低 effort 下已經達到您的標準,就不要建構協調器。
在策略之間選擇
大多數情況歸結為一個問題:工作是拆分成獨立的部分,還是透過一連串相依步驟得出的一個答案?策略表將這兩個答案對應到兩種策略。
如果您不確定,先什麼都不要建構:
- 先在您目前的模型上掃描 effort。這是本頁最便宜的實驗,而大多數工作負載到此為止。
- 如果掃描顯示有差距,為較強模型在低 effort 下單獨運作定價。那是顧問配對必須超越的數字,而本頁上超越它的配對,是那些執行者確實進行了諮詢的配對。
本頁的多模型結果是對照同一模型在較低 effort 下以及下一級模型單獨運作來評判的。那是要在您自己的工作負載上執行的比較,也是第一步是 effort 掃描的原因。
當您確實加入顧問時,它是一個工具定義,而非重新架構。
在您自己的工作負載上進行測量
本頁的數字反映的是測量當時的定價表價格,會隨著模型和價格的變化而改變。您的升級率、任務拆分的乾淨程度以及對話記錄長度,也都會影響這些數字。不過方法保持不變:
- 從正式環境日誌中擷取一些任務,依實際流量加權,並為每項任務撰寫結果檢查,例如測試通過、工單已關閉、列數正確。在分數旁記錄每項任務的成本:將每個回應
usage中的五種計價 token 數量,分別以各自的費率計價,再加總該任務的所有請求(Usage and Cost API 會回報彙總數據)。這五種 token 是:- 未快取的輸入
- 5 分鐘快取寫入(輸入價格的 1.25 倍)
- 1 小時快取寫入(輸入價格的 2 倍)
- 快取讀取
- 輸出
- 跨 effort 等級(而不只是預設值)為各模型層級建立基準線,並繪製分數對支出的關係圖。多模型配置必須超越單一模型的整條曲線。
- 如果曲線顯示存在 effort 無法彌補的差距,請加入適合的多模型策略,並重新執行測試套件。
- 在正式切換之前,先在一部分流量上以影子模式執行勝出的方案,之後也請持續執行測試套件。
以下範例以 Claude Opus 5.5 的定價計算單一請求在步驟 1 中的成本:
# 每百萬 token 價格取自定價頁面;若要改用其他模型,請修改這三個值。
INPUT_PER_MTOK = 4.00  # Claude Opus 5.5
# 在 Claude Opus 5.5 上為輸入價格的 0.05 倍;此倍數因模型而異
CACHE_READ_PER_MTOK = 0.20
OUTPUT_PER_MTOK = 20.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1 小時快取寫入以輸入價格的 2 倍計費,5 分鐘則為 1.25 倍;讀取則以快取讀取價格計費。
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
在代理迴圈中,大部分輸入 token 應該是快取讀取;如果 cache_read_input_tokens 相較於 input_tokens 加上 cache_creation_input_tokens 很小,請檢查快取是否已啟用,以及前綴在請求之間是否保持不變。當啟用顧問工具或「compaction」(壓縮)時,部分 token 只會在 usage.iterations 中回報,而不會出現在頂層總計中,因此請改為加總 usage.iterations,並以顧問模型的費率為 advisor_message 項目計價。
下表依建議嘗試的順序,列出各項調整手段:
| 手段 | 這些執行中的節省 | 品質代價 | 延遲 | 位置 |
|---|---|---|---|---|
| 提示快取 | 在代理迴圈上成本降低 2.7 到 5.3 倍;在分類執行上降低 83% | 無 | 更快 | 快取重複的上下文 |
| 1 小時快取期限 | 當每 20 個輪次中約有 1 個是在 5 分鐘到 1 小時的暫停之後,且很少有超過 1 小時的間隔時,比 5 分鐘預設值更便宜;例外是 Claude Fable 5.1,在暫停只有幾分鐘時,保持 5 分鐘快取溫熱較便宜,而暫停接近 1 小時時則 1 小時期限勝出;以及 Claude Opus 5.5,當每 20 個輪次中只有一兩個是在最長約半小時的暫停之後時,保持 5 分鐘快取溫熱較便宜;沒有暫停時,預設值在 Claude Sonnet 5 上便宜 15%,在 Claude Opus 5.5 上便宜約 15% 到 18% | 無 | 暫停後仍保持溫熱 | 選擇快取期限 |
| 輸入精簡 | 在分類執行上再降低 5 個百分點 | 無 | 無影響 | 精簡輸入與上下文 token |
| 在任務邊界修剪過時的工具結果 | 在長時間分類執行上降低 39%(壓縮為 32%);在短迴圈上無效果 | 未測得 | 無影響 | 精簡輸入與上下文 token |
| 工具搜尋 | 附加 500 個工具定義時降低 45%;使用 GitHub MCP 伺服器時降低 20% | 無 | 無影響 | 精簡輸入與上下文 token |
| 透過程式碼執行處理資料檔案 | 在 25 題資料任務上降低 92% | 有所提升:25 題中答對 25 題,而非 6 題 | 更快 | 精簡輸入與上下文 token |
| Batch API | 50% | 無 | 24 小時內取得結果 | 批次處理可以等待的工作 |
| 針對目前模型稽核提示 | 在兩次測量的遷移中皆降低 14% | 無;其中一次有所提升 | 更快(工具回合較少) | 針對目前模型稽核提示 |
| 升級模型 | Opus 4.8 升級至 Opus 5:多 12 分,每項已解決任務成本高 21%(low 下的 Opus 5 以約 30% 的成本勝過 Opus 4.8)。Sonnet 4.6 升級至 Sonnet 5:每項已解決任務成本低 15%,多 5 分。Fable 5 升級至 Fable 5.1:每項已解決任務成本低 43%,分數大致相同 | 有所提升 | 無影響 | 升級模型 |
| 降低 effort | 知識工作:medium 節省 13% 到 31%,low 節省三分之一到一半;長時間程式設計:medium 約 30%,low 約三分之二,兩者皆相對於 high | 知識工作上 1 到 3 分,長時間程式設計上 2 到 8 分 | 更快 | 調整 effort |
| 重新執行失敗的任務 | 相較於全部以 high 執行約節省 40%,通過率相同或略高 | 無 | 失敗的任務執行兩次 | 以較高 effort 重新執行失敗任務 |
| 任務預算 | 44% 到 58% | 3 到 6 分 | 更快 | 設定預算與輸出上限 |
| 要求更簡短的回答 | 在分類執行上減少 39% 的輸出 token、14% 的成本 | 無 | 更快 | 設定預算與輸出上限 |
提高 max_tokens | 每項已解決任務的成本不變,但能解決更多任務 | 在內部資料集上最多提升 22 分;在公開組合上無差異 | 無影響 | 設定預算與輸出上限 |
| 顧問 | 取決於能力差距與諮詢率;程式設計配對的分數比以 high 單獨執行的 Claude Opus 5.5 高 1.7 分,價格約為 2.1 倍,大約相當於提高 effort 所能換得的效果;搭配 Claude Opus 5.5 時,圖表判讀配對幾乎從未諮詢顧問,分數比單獨執行的 Opus 5.5 低 7 分 | 程式設計上有所提升,圖表判讀上有所下降 | 每項任務約多一到兩次呼叫 | 顧問策略 |
| 協調器 | 相較於前沿模型約降低一半,適用於超過一個上下文視窗的情境與例行長尾情境(後者在 Claude Fable 5 上測量) | 比前沿模型低 10 到 12 分 | 在大型輸入上快得多 | 協調器策略 |
參考的基準測試
除非參考文獻另有說明,否則測量結果均為 Anthropic 內部執行這些基準測試的結果。除非另有註明,成本均以各基準測試執行時有效的定價表價格計算,單位為美元;Claude Sonnet 5 的數據採用每百萬輸入與輸出 token 分別 $2 與 $10 的價格。標示為「notional USD」(名義美元)的圖表是以這些費率對每個請求的 token 數量計價,而非報告實際帳單。
- WideSearch: Wong 等人,"WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025。廣泛的網路研究任務,依多列表格的完整性與準確性評分;200 個問題,每種配置執行 3 次,於 2026 年 8 月 1 日至 2 日執行。成本集中度圖表是另一次 20 個問題的執行,每個問題執行 3 次,於 2026 年 8 月 3 日至 4 日執行,成本依據逐請求計費紀錄計算。
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025。知識工作交付成果依任務評分標準評分;對已發布的黃金集執行 210 項任務,每項任務嘗試一次,於 2026 年 8 月 2 日執行。由 Claude 模型評分,因此絕對分數可能與已發表的結果不同。
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025。為了與 Anthropic 的「evaluation harness」(評估框架)相容而選出的 482 道題目子集;分數無法與公開排行榜比較。這些分數也無法與 Claude Opus 5.5 系統卡中的 SWE-bench Pro 結果比較,後者來自在不同題目集上以
maxeffort 執行的結果。Claude Opus 5.5 的數據在low、medium(其預設值)與high下為兩次執行的平均值,在xhigh下則採用一次執行,全部執行於 2026 年 9 月 19 日至 20 日,每輪上限與 8 月的 Claude Opus 5 執行相同,為 16,384 個 token;此上限截斷了 2 次xhigh嘗試,其他設定則無。Opus 5.5 的執行使用了一個評分容器只能連線至內部套件鏡像的基準測試版本。該版本移除了一道測試需要連線至線上網站的題目,另有三道題目的參考解答在該環境中會失敗,因此 Opus 5.5 的比較,以及與之並列的 Claude Fable 5.1 數據,均使用其餘 478 道題目。升級模型與顧問配對圖表中的 Claude Opus 5 SWE-bench Pro 數據,在其預設 effort 下為兩次執行的平均值,在low下則採用一次執行,全部執行於 2026 年 8 月 4 日。「Escalation」(升級)數據是從 Opus 5.5 的執行中逐項任務得出:先以low執行,再對其失敗的任務以high執行,在各執行配對中解決了 96.4% 至 97.5%,成本約 $0.17;先以medium執行,解決 96.0% 至 97.1%,成本約 $0.24;以high對其自身失敗的任務重新執行,解決 96.9%,成本 $0.31;全部以high執行,解決 94.8% 至 95.8%,成本 $0.29。此子集上的成本依照客戶組織的計量方式計價:每個請求先前的提示以「cache read」(快取讀取)計價,新的 token 則以 5 分鐘快取寫入計價,數據取自執行本身的用量紀錄,並與客戶帳本核對;評估組織本身的計量方式在 2026 年 9 月 10 日之前,對 Claude Opus 5、Claude Fable 5、Claude Opus 4.7 與 Claude Opus 4.8 以 8,192 個 token 為區塊計費快取讀取,使這些模型執行的數據高出 1.4 至 1.8 倍;對於 Claude Fable 5.1、Claude Sonnet 5 與 Claude Sonnet 4.6,兩者最多相差約 9%;對於 Claude Opus 5.5 的數據,兩者在每個 effort 設定下的差距都在 3% 以內。顧問圖表上的 Claude Sonnet 5「executor」(執行者)配對來自此子集上的同一測量系列:Sonnet 加 Opus 5 的配對執行了兩次(2026 年 8 月 7 日與 8 月 8 日,一次執行與一次完全相同的重現),低 effort 配對執行一次(2026 年 8 月 8 日),Claude Sonnet 5 單獨執行兩次(77.4%,為兩個 Pro 列的基準)。「升級模型」中的 Claude Fable 5 數據點是在預設 effort 下三次執行的平均值,執行於 2026 年 8 月 26 日,計價方式相同。Claude Fable 5.1 的任務預算數據是在同一子集上以預設 effort、每個預算執行一次(35,000 個 token 時執行兩次),執行於 2026 年 8 月 26 日,並以同日一次未設預算的執行(92.1%,每項任務 $1.10)作為基準;較早一組以loweffort 執行的測試(2026 年 8 月 21 日)在未設預算時得分 88.6%,每項任務 $0.48。比較模型中的比較,是將該單次執行與同一子集上合併的兩次 Claude Sonnet 5 執行配對;在 Fable 5.1 的預設 effort 下,這組比較的結果相反,每個已解決任務的成本比 Sonnet 5 高 41%。升級階梯是每個模型以其出廠預設值執行一次(Opus 5 與 Sonnet 5 各執行兩次,Fable 5 數據點如上所述),Opus 與 Sonnet 的執行在同一週、於同一框架與組織中進行。 - BrowseComp: Wei 等人,"BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025。Effort 數據使用 500 個問題的切分,每個設定執行一至三次,於 2026 年 8 月 3 日執行,預設數據點合併了 2026 年 7 月 26 日至 27 日的兩次執行。成本保險圖表使用從 26 個問題切片中選出的 10 個可穩定解決的問題,50 次委派執行(2026 年 8 月 1 日至 2 日)與 70 次單獨執行(50 次來自 2026 年 8 月 2 日至 3 日;20 次為 2026 年 7 月 12 日至 13 日及 8 月 1 日的存檔),期望值為每次執行 $6.45 對比 $11.99;委派數據帶有約 20% 的測量區間。
- 代理架構擴展: Kim 等人,"Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025。獨立的外部研究,僅引用其關於委派何時不划算之發現的方向,不引用任何數據。
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025。220 個問題橫跨 15 個領域,每個問題結合多列收集與多跳檢索;在該基準測試的固定列集上測量,每種配置執行 3 次,於 2026 年 8 月 2 日執行(單一工作者團隊數據點於 2026 年 7 月 26 日至 27 日執行)。
- DeepResearch Bench II: Li 等人,"DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026。其橫跨 22 個領域的 132 項研究任務依專家衍生的二元評分標準評分;在橫跨所有主題分層的 50 項任務子集上測量,每項任務嘗試一次,每個設定執行 3 次,於 Claude Managed Agents 上使用平台本身的網路搜尋與擷取工具執行(2026 年 8 月 26 日至 27 日);以沒有任何配置拒絕的 33 項任務評分,並移除被正式環境安全分類器中斷的嘗試;成本為客戶被計費的金額,即平台的請求加上網路搜尋費用。分數為每個模型在 33 項任務基礎上、移除其自身被搶先中止的任務後的平均值;在每個組別中皆乾淨的 21 項任務上,Claude Fable 5.1 在每個 effort 等級上都比 Claude Fable 5 領先 2 至 3 分,且兩個模型在各 effort 間表現持平。快取圖表以未快取費率對每個輸入 token 重新計價相同的請求。Claude Opus 4.6 依該基準測試的評分標準協定進行評判;原始版本使用不同的評判者,而 Anthropic 的評判者可能偏好自家風格。Claude Opus 5 在其預設 effort 下於 2026 年 8 月 28 日在相同介面與子集上執行三次:原始 50 項任務為 68.8%,33 項任務基礎為 70.8%,21 項任務集為 71.1%,每項任務 $6.71(無快取時為 $23.72);其嘗試均未被安全分類器中斷,所使用的安全防護部署比其他模型執行時的版本更新。
- 語料庫缺陷掃描: Anthropic 內部,針對大於一個上下文視窗的工作:來自 14 個公開 Python 套件原始碼的 2,160 萬 token 語料庫,植入 130 個缺陷並採用確定性評分;協定在執行前固定並經內部審查;每種配置執行三次。每種配置均在 Claude Managed Agents 上執行。圖表中的團隊配置是一次由 Claude Fable 5.1 協調者在平台內以其文件記載的 25 個並行 Claude Sonnet 5 工作者上限執行整個掃描的執行,於 2026 年 8 月 30 日執行;其三個回合在額外項目稽核後的 F1 分數為 0.764、0.825 與 0.791(原始為 0.751、0.821 與 0.781),成本為 $225、$234 與 $283。Claude Sonnet 5 單獨配置於 2026 年 8 月 3 日至 4 日執行;Claude Fable 5.1 單獨配置於 2026 年 8 月 24 日至 25 日在平台的上市服務設定下執行,每個 effort 設定三個種子,使用相同的語料庫建置。沙箱映像檔帶有部分語料庫的已安裝副本,Claude Fable 5.1 的最終組裝步驟在 9 個回合中有 7 個與之比對;在不含這些新增項目的情況下重新評分,使受影響的種子變動最多 3 分。絕對 F1 值特定於此語料庫建置,無法跨基準測試比較;配置間的比較為同類比較。
- GPQA Diamond: Rein 等人,"GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023。198 道題目的 Diamond 子集,每種配置執行兩次,執行於 2026 年 8 月 7 日(Claude Opus 5.5:2026 年 9 月 19 日),由模型依據參考答案評分,顧問 token 按請求計量。平台安全檢查在 Claude Sonnet 5 執行者上拒絕了兩道生物學題目,其中一道在 Claude Opus 5 上也被拒絕;排除這些題目後,任何比較的變動都不超過一分。Claude Opus 5.5 的 92% 來自兩次設定
fallbacks: "default"以選擇啟用伺服器端備援的執行,任何最終仍以拒絕結束的嘗試都計為錯誤。在每次執行中,安全檢查標記了六道生物學題目,Claude Opus 5 透過備援回答了其中五道,第六道仍以拒絕結束。Opus 5.5 每道題目的成本包含這些備援回答。若不將拒絕計為錯誤,這些執行的得分為 93%,因為評分者仍會為被拒絕的嘗試指定一個答案選項,而且通常是正確的選項。若將拒絕計為錯誤,Claude Opus 5 的執行得分為 91%(每次執行一次拒絕),關閉備援的兩次 Claude Opus 5.5 執行也是如此,其中 Opus 5.5 每次執行拒絕了五或六道生物學題目。 - DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026。該集合有橫跨五種語言的 113 項原創任務,附有基於程式的驗證器。配對各執行兩次,於 2026 年 8 月 7 日執行,顧問 token 逐請求計量,並使用客戶端顧問迴圈而非顧問工具,會計方式相同。單一模型 effort 掃描為單次執行,依 token 數量計價,為一種考量快取的近似值。每項任務成本為執行總額除以 113。
- 內部代理式程式設計基準測試: Anthropic 內部:370 項儲存庫任務,由儲存庫本身的測試評分。API 數據以 128,000 個 token 的輸出上限測量,每種配置執行一次:Opus 5 單獨以預設 effort 執行於 2026 年 8 月 9 日至 10 日,以
low與medium執行於 2026 年 8 月 10 日;Claude Fable 5.1 單獨以五個明確設定的 effort 值執行於 2026 年 8 月 20 日(圖表顯示其中三個);配對則執行於 2026 年 8 月 24 日至 25 日。Claude Opus 5.5 單獨在全部 370 項任務上執行,時間為 2026 年 9 月 19 日至 20 日:在其預設 effort(medium)與high下每項任務嘗試五次,在low與xhigh下嘗試一次(因一次設定檢查失敗,每個設定計分 370 項中的 369 項)。以high執行的 Claude Opus 5.5 執行者搭配已發布的 Claude Fable 5.1 作為顧問(8 月的執行使用的是發布前快照),在相同日期每項任務嘗試五次;有一項任務未通過設定檢查,因此計分了 1,845 次嘗試。顧問因負載而被拒絕的 279 次嘗試已重新執行,而諮詢逾時的嘗試則予以保留,與 8 月相同。8 月的執行中,配對與 Claude Opus 5 對照組每項任務嘗試五次,其他數據點則嘗試一次。8 月的配對平均每次嘗試約諮詢顧問兩次;Claude Opus 5.5 配對請求了 1.39 次,實際獲得 1.35 次。成本以每次嘗試計算。成本依照客戶組織的計量方式計價:每個代理迴圈請求先前的提示以快取讀取計價,新的 token 以 5 分鐘快取寫入計價,數據取自執行本身的用量紀錄;每次顧問呼叫不使用快取,依其記錄的 token 計價,全部採用定價。Claude Code 數據是 2026 年 7 月 8 日至 23 日對相同任務的執行,每種配置執行一次,成本為近似值。 - 內部儲存庫任務基準測試(上限測量): 另一組約 130 項的 Anthropic 內部儲存庫任務,執行於 2026 年 8 月 20 日(Claude Fable 5.1)與 2026 年 9 月 19 日(Claude Opus 5.5,以其預設 effort
medium),使用單純的 API 代理迴圈,每項任務嘗試一次。Claude Fable 5.1 的執行在明確設定的預設 effort 下,每個上限 135 項任務:16,384 個 token 的數據為兩次執行的平均值(兩次皆為 36.3%);64,000 與 128,000 的數據為單次執行(58.5% 與 60.0%)。有六道題目在每次執行中都遭到安全拒絕,並計為失敗。Claude Opus 5.5 的 16,384 個 token 數據為兩次執行的平均值(分別計分 134 與 135 項任務),其 64,000 與 128,000 的數據為單次執行(各 135 項任務);每次 16,384 個 token 的執行中有兩次嘗試以安全拒絕結束,並計為失敗。SWE-bench Pro 的上限數據是 Claude Fable 5.1 在預設 effort 下每個上限執行一次,執行於 2026 年 8 月 26 日,使用從參考文獻 3 的 482 道題目集中分層抽樣的 100 道題目子集,無法與其分數比較;在預設值下,兩個上限的得分相同。圖表中的每輪分布來自 Claude Opus 5.5 與 Claude Fable 5.1 在 128,000 下的執行:沒有任何 Opus 5.5 的輪次達到上限(最長約 61,000 個 token,且 0.56% 的輪次超過 16,384),而有一個 Fable 5.1 的輪次達到 128,000(0.46% 的輪次超過 16,384)。 - Chartography: Surge AI, "Chartography," 2026。完整發布的 100 道題目集,測量於 2026 年 8 月 6 日與 9 日(Claude Opus 5 單獨)及 2026 年 9 月 20 日(Claude Opus 5.5),使用 Anthropic 在 Claude Managed Agents 上的實作(標準雲端沙箱;顧問配置使用 Managed Agents 顧問)。由 Claude Sonnet 4.6 取代參考評審進行評分,且基準測試在使用工具的情況下執行,因此分數可在此處的各配置之間比較,但無法與已發布的排行榜比較。這些分數也無法與 Claude Opus 5.5 系統卡中的 Chartography 結果比較,後者使用不同的評分者並以
maxeffort 執行。每種配置執行兩次(Claude Opus 5.5 為三次),並合併計算;各次執行之間的差距最多達 10 分。成本為例行執行該代理的客戶實際被收取的費用:每張圖表的第一個請求會從快取讀取代理共用的系統提示與工具,就如同同一代理的另一個工作階段在前 5 分鐘內執行過時一樣。單獨執行一張圖表時,使用 Claude Opus 5 或 Claude Opus 5.5 約多花 $0.03,使用 Claude Fable 5.1 約多花 $0.12。8 月的數據依此方式從執行的用量紀錄重新計價;評估組織本身的計量方式在 2026 年 9 月 10 日之前以 8,192 個 token 為區塊計費 Claude Opus 5 的快取讀取,高估了 Claude Opus 5 的成本。成本不包含沙箱時間,沙箱時間對 8 月執行的成本增加不到 1%。Claude Fable 5.1 單獨執行來自 2026 年 8 月 24 日,採用平台的上市服務設定,每個設定執行兩次;有六次嘗試達到 15 分鐘的工作階段上限而得 0 分,且每次執行中有兩張圖表在安全拒絕後由 Claude Opus 5 回答。搭配 Claude Fable 5.1 顧問的 Claude Opus 5 低 effort 執行者於 2026 年 8 月 30 日在相同設定下執行兩次(63.0 與 67.0,平均 65.0,每張圖表 $0.47;每次執行中有 88% 的任務諮詢了顧問,其 219 則回覆中有 4 則改由 Claude Opus 5 提供,每次都是在正式環境安全過濾器阻止顧問本身的回覆之後)。Claude Opus 5.5 以low執行,關閉伺服器端備援,並由安全分類器判斷每次工具呼叫:單獨執行三次(70、68 與 68),以及設定 Claude Fable 5.1 顧問執行三次(59、63 與 63),其中它在 300 項任務中只有 1 項諮詢了顧問。較早配對的諮詢率比較,來自 2026 年 8 月 10 日至 11 日在 Messages API 上搭配容器工具集重新執行相同配置的結果。 - 客服台提示稽核評估: Anthropic 建構的 44 張客服工單集,採用確定性評分,於 2026 年 8 月初執行並於 2026 年 8 月 8 日報告,使用六個系統提示,每個都在同一個乾淨提示上加入一種在為 Claude Opus 4.8 與 Claude Sonnet 4.6 撰寫的提示中常見的模式。每個圖表數據點為三種情況之一(較舊模型、較新模型使用相同提示、較新模型經稽核後),對六個提示與 44 張工單取平均。Opus 5 的準確度提升有 3 至 8 分的 95% 信賴區間;Sonnet 的準確度差異在雜訊範圍內。
- 資料檔案問題集: Anthropic 建構的 25 個彙總問題集,針對一份公開酒類銷售 CSV 的 1,862 列切片,基準真值由 pandas 計算並採用精確比對評分,在 Claude Sonnet 5 與 Claude Opus 5 上執行,停用思考(上下文內組別在預設值下無法完成),4,000 token 輸出上限,且不使用提示快取,每種配置執行三次,於 2026 年 8 月 19 日執行。檔案組別透過 Files API 上傳 CSV 並使用
code_execution_20260120工具。 - 快取持續時間測量: 精簡輸入與上下文 token 中的 20 個議題分類工作,於 2026 年 8 月 23 日在 Claude Sonnet 5 上執行,並於 2026 年 9 月 19 日與 20 日在 Claude Opus 5.5 上以其預設 effort(
medium)與high執行,在 Messages API 上使用相同的框架(對於 Claude Opus 5.5,則是傳送相同請求主體的移植版本),Claude Opus 5.5 的各組將max_tokens提高至 4,096,並在隨機選取的部分輪次之前插入暫停(兩個模型在全部 20 個議題上皆測試無暫停、5%、10% 以及每輪暫停 6 分鐘,Claude Sonnet 5 另測試每輪暫停 2 分鐘;兩個模型皆在 5 個議題的子集上測試 20 分鐘與 45 分鐘的暫停)。以下 Claude Opus 5 的保持連線數據來自 2026 年 8 月 23 日的同一工作,max_tokens提高至 4,096,除 2 分鐘與 45 分鐘暫停外採用相同排程。每組執行三次,成本依每個回應的usage欄位以定價計算(對於 Claude Opus 5.5,每百萬 token 輸入 $4、5 分鐘寫入 $5、1 小時寫入 $8、快取讀取 $0.20、輸出 $20;Claude Sonnet 5 在 Anthropic 內部組織上執行,其用量計量方式與客戶組織相同),準確度依據相同的黃金標籤計算。本頁的 Claude Opus 5.5 數據涵蓋兩個 effort 等級。交叉點在 Claude Sonnet 5 上約為 3.3% 的輪次,在 Claude Opus 5.5 上為 3.1% 至 3.2%:這是每個工作階段損益平衡比例的中位數,由成本模型依據該工作階段逐輪的上下文大小計算,涵蓋全部 45 個 Claude Sonnet 5 二十議題工作階段,以及每個 effort 等級的 36 個 Claude Opus 5.5 二十議題工作階段(每個暫停排程都在完整工作上、於全部三種快取設定下各執行三次;5 個議題的組別不包含在內)。在 5% 組中,5 分鐘與 1 小時設定在 Claude Sonnet 5 上打平,因為該次抽樣的暫停落在較小的前綴上;在 Claude Opus 5.5 上兩者幾乎打平。本頁的「每 20 輪 1 次」規則高於測得的交叉點。Claude Opus 5.5 在暫停後的首個 token 時間未經測量。Anthropic 於 2026 年 8 月 23 日在 Claude Sonnet 5 與 Claude Opus 5 上,以及在上述執行中於 Claude Opus 5.5 上,測量了刷新 5 分鐘快取的保持連線請求,這些請求一律以max_tokens: 1傳送。在 Claude Sonnet 5 上,當 5% 的輪次暫停時,其成本比 1 小時設定低 7.7%,10% 時則大致相同;在 Claude Opus 5 上,兩種比例下都測不出差異;在兩者上,當每輪之前都暫停 6 分鐘或更久時,其成本都較高。在 Claude Opus 5.5 上,當 5% 與 10% 的輪次暫停時,其成本比 1 小時設定低 8% 至 18%(以 1 小時快取價格重新計費每個保持連線工作階段自身的 token、消除工作階段之間的雜訊後,約低 10% 至 15%),而當每輪之前都暫停時則較高:6 分鐘時高 4% 至 6%,20 分鐘時高 9% 至 10%,45 分鐘時高 56% 至 58%。保持連線在 Claude Opus 5.5 上節省較多,因為每個保持連線請求都以快取讀取價格重新讀取前綴:輸入價格的 0.05 倍,而 Claude Sonnet 5 與 Claude Opus 5 為 0.1 倍;以 Claude Opus 5.5 的價格重新計費 Claude Opus 5 的工作階段,顯示出與 Claude Opus 5.5 幾乎相同的節省幅度。Anthropic 在 Claude Opus 5.5 發布前的 API 測試顯示,max_tokens: 0請求會寫入快取,且下一個請求會讀取該快取;此類請求是否會刷新既有項目,則未在 Opus 5.5 上測量。在 Claude Fable 5.1 上,快取讀取價格為 0.025 倍,即使每輪之前都暫停,保持連線仍較便宜,45 分鐘暫停時除外(參考文獻 19)。 - 正式環境中的快取讀取比例: 截至 2026 年 8 月 23 日的 14 天內彙總的第一方 Claude API 用量,僅限直接 API 產品,排除 Anthropic 內部組織,未識別任何組織。當一個組織日的請求帶有工具定義與工具結果、其提示平均包含 9 個或更多先前工具呼叫、使用了快取,且發出至少 10 個此類請求時,該組織日計為代理迴圈(API 沒有對話識別碼,因此以此代表對話長度):橫跨 106,487 個組織的 303,003 個組織日,快取讀取比例中位數為全部輸入 token 的 84.2%,上四分位數為 91.7%。使用案例標籤(組織宣告的使用案例,否則為其分類的使用案例)涵蓋這些組織日的 74% 與其 token 的 99%;程式設計組織提供 87% 的代理式輸入 token,讀取中位數為 88.5%(在 25 個或更多先前工具呼叫時為 90.9%),上四分位數為 93.4%,約 72% 的程式設計組織日達 80% 或以上;客服、研究與資料代理讀取 84% 至 85%。組織日的前十分位數在程式設計上讀取 95.9% 或以上,在客服、研究、資料與其他代理上為 94.2% 至 94.8%。在 25 個或更多先前工具呼叫時的請求層級拆分來自六小時的樣本:程式設計為 92% 讀取、7% 寫入、不到 1% 未快取。未標籤的組織多為小型,讀取中位數為 11%。沒有工具定義的組織日讀取中位數為 34.6%。一項針對相同時間窗的獨立查詢重建了 10 個或更多請求的對話,而非對組織日評分,得出中位數為 90.2%;差異在於範圍,而非資料。
- 壓縮時機測量: 來自精簡輸入與上下文 token 的分類代理長版本,於 2026 年 8 月 24 日在 Claude Sonnet 5 上以 5 分鐘快取執行,成本依用量欄位以定價表價格計算,每個組別五個工作階段:一個全程使用預設 effort 的無變更組別(每個工作階段 $0.81),以及兩個從低 effort 開始並進行相同兩項破壞快取之變更的組別,即切換至預設 effort 與新增一個工具,分別在工作階段中途的第 12 與第 17 個請求進行($0.95),或在第一次壓縮後的第一個請求一併進行($0.75)。第四個組別有六個工作階段,於 2026 年 8 月 25 日執行,在觸發第一次壓縮的請求上進行相同的兩項變更(每個工作階段 $0.92):該請求的摘要處理將 81,000 token 的上下文寫入快取而非讀取,因此該處理成本為 $0.21,而邊界組別中相同處理為 $0.04。工作階段在第 21 至 25 個請求首次壓縮(21 個工作階段中有 16 個在第 22 個請求),即提示超過 80,000 token 的壓縮觸發點後,且有兩個無變更工作階段在接近結束時第二次壓縮。邊界組別的總額低於無變更組別,反映的是其變更前的低 effort 請求與那些第二次壓縮,而非快取:兩個組別的重新寫入成本差異不到一美分。中途組別每個工作階段支付 $0.23 的快取重新寫入;中途組別與邊界組別之間的差異為 $0.20,95% 信賴區間為 $0.11 至 $0.29。一個中途工作階段在其模型於壓縮後錯誤呼叫搜尋工具並得到空結果後執行成本偏低($0.82);它已納入計算,若不含它,該組別平均為 $0.98。8 月 24 日各組別的準確度平均為 20 個標籤中的 14.2 個,8 月 25 日組別為 14.7 個;快取讀取在無變更時為提示 token 的 91%,中途為 85%,邊界為 91%,在觸發請求上進行變更時為 86%。
- Claude Fable 5.1 上的快取持續時間測量: 與參考文獻 16 相同的 20 個議題分類工作與框架,於 2026 年 8 月 23 日與 8 月 26 日在 Claude Fable 5.1 上市快照上以其上市價格執行(每百萬 token 輸入 $10、5 分鐘寫入 $12.50、1 小時寫入 $20、快取讀取 $0.25、輸出 $50),每個排程三種設定:5 分鐘快取、1 小時快取,以及每 4 分鐘(從前一個請求開始時計時)對未變更的前綴發送
max_tokens: 0請求以保持溫熱的 5 分鐘快取(8 月 23 日的執行以max_tokens: 1傳送保持連線請求;在此處回報的 8 月 26 日各組中,每個保持連線請求都刷新了快取且未計費任何輸出)。排程:在全部 20 個議題上測試無暫停、10% 的輪次暫停以及每輪暫停 6 分鐘,並在 5 個議題的子集上測試 45 分鐘暫停;每組執行三次(8 月 26 日 45 分鐘暫停的保持連線組為六次),成本依每個回應的usage欄位以定價計算,準確度依據相同的黃金標籤計算(20 個標籤中完全正確 12 至 17 個)。8 月 26 日 5 分鐘、1 小時與保持連線設定的每工作階段平均值:無暫停 $2.42、$3.09、$2.29;10% 暫停 $4.50、$2.96、$2.36;每輪暫停 $22.89、$3.01、$2.62;8 月 23 日各組的結果差距在 6% 以內。45 分鐘的數據(每個 5 議題工作階段 $1.68、$0.59 與 $0.71)來自 8 月 26 日一次快取計費事件破壞了當天最初幾組後的乾淨重新執行;8 月 23 日的執行結果為 $1.67、$0.58 與 $0.70。5 分鐘與 1 小時設定之間的交叉點為 3.1% 的輪次,與參考文獻 16 的測量方式相同。 - Terminal-Bench 3: 公開終端代理基準測試的 74 項任務,在 Claude Managed Agents 上執行,使用兩個自訂工具(由評估框架在每項任務自己的容器中執行的 shell 與檔案編輯器)取代平台的內建工具,其他則採用平台對外部帳戶的預設設定,每個模型以
higheffort 執行兩次,時間為 2026 年 8 月 27 日至 28 日。這些執行使用 Terminal-Bench 3.0 版,其分數無法與公開的 Terminal-Bench 排行榜比較,也無法與 Claude Opus 5.5 系統卡中的 Terminal-Bench 4.0 結果比較,後者來自在 Claude Code 中以maxeffort 執行的結果。每項任務的時間限制為基準測試本身的 2.5 倍,讓代理每項任務有 75 分鐘至 20 小時的時間(中位數任務為 5 小時),且每項任務獲得其指定記憶體的三倍,從 6 GiB 到 96 GiB 不等,執行輔助服務的 12 項任務另有額外記憶體。代理沒有一般網際網路存取權:其容器可連線至內部套件鏡像、包含 GitHub 與 Python Package Index 在內的少數下載網站,以及部分任務專用的幾個網站,且其中八項任務完全沒有網路存取權。分數為每個模型 148 次嘗試的原始通過率;單次執行的波動為 5 至 11 分。成本為客戶以定價會被收取的費用,依據執行的用量紀錄以 5 分鐘快取存留時間逐請求重新計價。Claude Opus 4.7 的 148 次嘗試中有 11 次因達到輸出上限而結束。 - DRACO: Perplexity, "DRACO: a Cross-Domain Benchmark for Deep Research Accuracy, Completeness, and Objectivity," arXiv:2602.11685, 2026。其涵蓋 10 個領域的 100 項研究任務依據專家撰寫的評分標準評分,分數為基準測試的正規化分數。所有配置都在 Claude API 上以 Claude Fable 5.1 執行,使用預設的自適應思考、開啟正式環境安全分類器,且
max_tokens為 128,000:以high與mediumeffort 執行的單一代理、以high執行並加上指示與時鐘的單一代理,以及以high執行、有無這兩者的團隊。團隊是由一個主代理透過工具啟動相同模型的輔助代理,數量不設上限。在 DRACO 上,主代理每次嘗試啟動的輔助代理中位數為 4 個。每種配置對每項任務嘗試三次,執行於 2026 年 9 月 8 日至 10 日。達到四小時限制的嘗試會重新執行,並以新的嘗試計分。唯一被排除的嘗試,是以mediumeffort 執行的單一代理在某一項任務上的全部 3 次嘗試,因此該配置涵蓋 99 項任務。該任務在原始執行與重新執行中的每次嘗試都逾時。若依基準測試本身的計分方式將這 3 次嘗試計為 0 分,只會影響與mediumeffort 相關的兩項比較。mediumeffort 相對於high的分數變化會從低 0.7 分變為低 1.7 分,而同時進行兩項變更相對於mediumeffort 的分數變化則會從低 1.2 分變為低 0.2 分。代理使用由評估框架在固定網路索引上託管的搜尋工具與擷取工具。這些工具決定了部分時間,而您的工具執行速度會不同,因此本頁以配置之間的比例呈現時間,而非以分鐘呈現。時間是每項任務的實際經過時間,從任何代理的第一個請求到最後一個請求,減去在速率限制或過載錯誤後等待重試請求的估計時間。這些錯誤來自測試帳戶的共用限制。同一組的所有配置同時開始。較慢的配置在數小時後才完成,因此其部分時間是在不同負載下執行的。每項任務的成本是其請求以公開定價計價,提示快取則依照在每個請求結尾設定快取斷點並使用 5 分鐘快取存留時間的客戶方式計費,僅計算模型 token。框架的工具不會產生額外費用。分數變化是各任務的配對差異,並附有 95% bootstrap 區間。當變化的區間在 DRACO 上保持在 1.5 分以內、在 HLE 上保持在 2.5 分以內時,即視為在容許範圍內。Anthropic 在執行前即設定了這些容許範圍。由 Claude Opus 5 為答案評分。與各集合本身的評分者相比,在每種配置中,Opus 5 在 DRACO 上的評分高 1.9 至 2.4 分,在 HLE 上低 2.2 至 2.9 分(Opus 5 評分了 500 道題目中的 495 道,而基準測試的評分者評分了全部 500 道),在物理題組上低 1.3 至 2.0 分(該集合本身的評分者也使用專家參考解答)。兩個評分者對每項變化的方向看法一致。 - HLE: Phan 等人,"Humanity's Last Exam," arXiv:2501.14249, 2025。由專家撰寫、具有確切答案的問題,依據參考答案評分。在前 500 道題目上測量,搜尋中封鎖了基準測試本身的來源,其餘設定與參考文獻 21 相同。每種配置對每道題目嘗試三次,執行於 2026 年 9 月 8 日至 10 日。Claude Opus 5 將每個答案與參考答案比較,並開啟自適應思考(這是預設值)。在每種配置中,評審評分了 500 道題目中的 495 道,分數涵蓋這 495 道。其餘 5 道的評分請求超過了評審 1M token 的限制。達到四小時限制的嘗試會重新執行,並以新的嘗試計分,因此每種配置都有全部 1,500 次嘗試。若依基準測試本身的計分方式將 5 道未評分的題目計為 0 分,不會改變任何發現。
- 物理題組: 一組包含 70 道研究等級物理題目的內部集合,改編自公開的 CritPt 基準測試:Zhu 等人,"Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark," arXiv:2509.26574, 2025。專家審查者修正了題目敘述。Claude Opus 5 依據未公開的專家參考解答為每個答案評分,因此分數無法與已發布的結果比較。分數是每道題目各次嘗試的平均評分,再對所有題目取平均。在全部 70 道題目上測量,每道題目嘗試四次,執行於 2026 年 9 月 8 日至 9 日。每個代理在沒有網路存取權的沙箱容器中都有 Python 工具、shell 與檔案編輯器,且沒有搜尋或擷取工具。其餘設定與參考文獻 21 相同。執行前並未為物理題組設定分數容許範圍,因此本頁以 95% 區間呈現其分數變化,且不將其描述為在容許範圍內。
後續步驟
本頁最大的免費收益:設定、存留時間與診斷。
在單一模型內以智慧換取延遲與成本。
評估整個 Claude 模型家族的能力、速度與成本。
為代理迴圈提供一個可自我調節的 token 倒數。
為 Managed Agents 工作階段設定硬性的美元上限。
查看每個 Claude 模型目前的每 token 定價。
在可執行的 notebook 中將這些手段逐一套用到一個運作中的代理,並在每個步驟後顯示每項任務的成本。
觀看顧問與協調者模式的逐步講解。
Was this page helpful?