Roteamento de tickets
Este guia explica como aproveitar as capacidades avançadas de compreensão de linguagem natural do Claude para classificar tickets de suporte ao cliente em escala com base na intenção do cliente, urgência, priorização, perfil do cliente e muito mais.
Pré-requisitos
- Uma chave de API do Claude e o SDK Python instalado
- Acesso e familiaridade com seu sistema de tickets de suporte existente
- Um conjunto de amostra de tickets de suporte históricos para testes
Defina se deve usar o Claude para roteamento de tickets
Aqui estão alguns indicadores-chave de que você deve usar um "large language model" (modelo de linguagem grande), ou LLM, como o Claude em vez de abordagens tradicionais de ML para sua tarefa de classificação:
Processos tradicionais de ML exigem conjuntos de dados rotulados massivos. O modelo pré-treinado do Claude pode classificar tickets de forma eficaz com apenas algumas dezenas de exemplos rotulados, reduzindo significativamente o tempo e os custos de preparação de dados.
Uma vez que uma abordagem tradicional de ML foi estabelecida, alterá-la é uma tarefa trabalhosa e intensiva em dados. Por outro lado, à medida que seu produto ou as necessidades dos clientes evoluem, o Claude pode se adaptar facilmente a mudanças nas definições de classes ou a novas classes sem uma extensa rerrotulagem dos dados de treinamento.
Modelos tradicionais de ML frequentemente têm dificuldade com dados não estruturados e exigem extensa engenharia de features. A compreensão avançada de linguagem do Claude permite uma classificação precisa com base no conteúdo e no contexto, em vez de depender de estruturas ontológicas rígidas.
Abordagens tradicionais de ML frequentemente dependem de modelos bag-of-words ou de correspondência simples de padrões. O Claude se destaca em compreender e aplicar regras subjacentes quando as classes são definidas por condições em vez de exemplos.
Muitos modelos tradicionais de ML fornecem pouca visibilidade sobre seu processo de tomada de decisão. O Claude pode fornecer explicações legíveis por humanos para suas decisões de classificação, construindo confiança no sistema de automação e facilitando a adaptação quando necessário.
Sistemas tradicionais de ML frequentemente têm dificuldade com outliers e entradas ambíguas, muitas vezes classificando-os incorretamente ou recorrendo a uma categoria genérica. As capacidades de processamento de linguagem natural do Claude permitem que ele interprete melhor o contexto e as nuances nos tickets de suporte, potencialmente reduzindo o número de tickets mal roteados ou não classificados que exigem intervenção manual.
Abordagens tradicionais de ML normalmente exigem modelos separados ou extensos processos de tradução para cada idioma suportado. As capacidades multilíngues do Claude permitem que ele classifique tickets em vários idiomas sem a necessidade de modelos separados ou extensos processos de tradução, simplificando o suporte para bases de clientes globais.
Construa e implante seu fluxo de trabalho de suporte com LLM
Entenda sua abordagem de suporte atual
Antes de automatizar, é crucial entender seu sistema de tickets existente. Comece investigando como sua equipe de suporte atualmente lida com o roteamento de tickets.
Considere perguntas como:
- Quais critérios são usados para determinar qual SLA/oferta de serviço é aplicada?
- O roteamento de tickets é usado para determinar para qual nível de suporte ou especialista de produto um ticket vai?
- Já existem regras ou fluxos de trabalho automatizados em vigor? Em quais casos eles falham?
- Como são tratados os casos extremos ou tickets ambíguos?
- Como a equipe prioriza os tickets?
Quanto mais você souber sobre como os humanos lidam com determinados casos, melhor você poderá trabalhar com o Claude para realizar a tarefa.
Defina categorias de intenção do usuário
Uma lista bem definida de categorias de intenção do usuário é crucial para uma classificação precisa de tickets de suporte com o Claude. A capacidade do Claude de rotear tickets de forma eficaz dentro do seu sistema é diretamente proporcional a quão bem definidas são as categorias do seu sistema.
Aqui estão alguns exemplos de categorias e subcategorias de intenção do usuário.
- Problema de hardware
- Bug de software
- Problema de compatibilidade
- Problema de desempenho
- Redefinição de senha
- Problemas de acesso à conta
- Consultas sobre cobrança
- Alterações de assinatura
- Consultas sobre funcionalidades
- Perguntas sobre compatibilidade do produto
- Informações de preços
- Consultas sobre disponibilidade
- Perguntas de como fazer
- Assistência no uso de funcionalidades
- Conselhos sobre melhores práticas
- Orientação para solução de problemas
- Relatos de bugs
- Solicitações de funcionalidades
- Feedback geral ou sugestões
- Reclamações
- Consultas sobre status do pedido
- Informações de envio
- Devoluções e trocas
- Modificações de pedidos
- Assistência na instalação
- Solicitações de upgrade
- Agendamento de manutenção
- Cancelamento de serviço
- Consultas sobre privacidade de dados
- Relatos de atividade suspeita
- Assistência com funcionalidades de segurança
- Perguntas sobre conformidade regulatória
- Consultas sobre termos de serviço
- Solicitações de documentação jurídica
- Falhas críticas de sistema
- Problemas urgentes de segurança
- Problemas sensíveis ao tempo
- Solicitações de treinamento sobre o produto
- Consultas sobre documentação
- Informações sobre webinars ou workshops
- Assistência com integração
- Perguntas sobre uso da API
- Consultas sobre compatibilidade com terceiros
Além da intenção, o roteamento e a priorização de tickets também podem ser influenciados por outros fatores, como urgência, tipo de cliente, SLAs ou idioma. Certifique-se de considerar outros critérios de roteamento ao construir seu sistema de roteamento automatizado.
Estabeleça critérios de sucesso
Trabalhe com sua equipe de suporte para definir critérios de sucesso claros com benchmarks, limites e metas mensuráveis.
Aqui estão alguns critérios e benchmarks padrão ao usar LLMs para roteamento de tickets de suporte:
Esta métrica avalia quão consistentemente o Claude classifica tickets semelhantes ao longo do tempo. É crucial para manter a confiabilidade do roteamento. Meça isso testando periodicamente o modelo com um conjunto de entradas padronizadas e buscando uma taxa de consistência de 95% ou superior.
Isso mede quão rapidamente o Claude pode se adaptar a novas categorias ou a padrões de tickets em mudança. Teste isso introduzindo novos tipos de tickets e medindo o tempo que o modelo leva para atingir uma precisão satisfatória (por exemplo, >90%) nessas novas categorias. Busque uma adaptação dentro de 50–100 tickets de amostra.
Isso avalia a capacidade do Claude de rotear com precisão tickets em vários idiomas. Meça a precisão do roteamento em diferentes idiomas, buscando uma queda de no máximo 5–10% na precisão para idiomas não primários.
Isso avalia o desempenho do Claude em tickets incomuns ou complexos. Crie um conjunto de testes de casos extremos e meça a precisão do roteamento, buscando pelo menos 80% de precisão nessas entradas desafiadoras.
Isso mede a imparcialidade do Claude no roteamento entre diferentes perfis demográficos de clientes. Audite regularmente as decisões de roteamento em busca de possíveis vieses, buscando uma precisão de roteamento consistente (dentro de 2–3%) em todos os grupos de clientes.
Em situações em que minimizar a contagem de tokens é crucial, este critério avalia quão bem o Claude se sai com contexto mínimo. Meça a precisão do roteamento com quantidades variadas de contexto fornecido, buscando 90%+ de precisão com apenas o título do ticket e uma breve descrição.
Isso avalia a qualidade e a relevância das explicações do Claude para suas decisões de roteamento. Avaliadores humanos podem pontuar as explicações em uma escala (por exemplo, 1–5), com o objetivo de atingir uma pontuação média de 4 ou superior.
Aqui estão alguns critérios de sucesso comuns que podem ser úteis independentemente de um LLM ser usado ou não:
A precisão do roteamento mede com que frequência os tickets são atribuídos corretamente à equipe ou pessoa apropriada na primeira tentativa. Isso normalmente é medido como uma porcentagem de tickets roteados corretamente em relação ao total de tickets. Os benchmarks do setor frequentemente buscam 90–95% de precisão, embora isso possa variar com base na complexidade da estrutura de suporte.
Esta métrica acompanha quão rapidamente os tickets são atribuídos após serem enviados. Tempos de atribuição mais rápidos geralmente levam a resoluções mais rápidas e maior satisfação do cliente. Os melhores sistemas frequentemente alcançam tempos médios de atribuição inferiores a 5 minutos, com muitos buscando um roteamento quase instantâneo (o que é possível com implementações de LLM).
A taxa de rerroteamento indica com que frequência os tickets precisam ser reatribuídos após o roteamento inicial. Uma taxa mais baixa sugere um roteamento inicial mais preciso. Busque uma taxa de rerroteamento abaixo de 10%, com os sistemas de melhor desempenho alcançando taxas tão baixas quanto 5% ou menos.
Isso mede a porcentagem de tickets resolvidos durante a primeira interação com o cliente. Taxas mais altas indicam roteamento eficiente e equipes de suporte bem preparadas. Os benchmarks do setor normalmente variam de 70–75%, com os melhores desempenhos alcançando taxas de 80% ou superiores.
O tempo médio de atendimento mede quanto tempo leva para resolver um ticket do início ao fim. Um roteamento eficiente pode reduzir significativamente esse tempo. Os benchmarks variam amplamente por setor e complexidade, mas muitas organizações buscam manter o tempo médio de atendimento abaixo de 24 horas para problemas não críticos.
Frequentemente medidas por meio de pesquisas pós-interação, essas pontuações refletem a satisfação geral do cliente com o processo de suporte. Um roteamento eficaz contribui para uma maior satisfação. Busque pontuações de CSAT de 90% ou superiores, com os melhores desempenhos frequentemente alcançando taxas de satisfação de 95%+.
Isso mede com que frequência os tickets precisam ser escalonados para níveis superiores de suporte. Taxas de escalonamento mais baixas frequentemente indicam um roteamento inicial mais preciso. Busque uma taxa de escalonamento abaixo de 20%, com os melhores sistemas alcançando taxas de 10% ou menos.
Esta métrica analisa quantos tickets os agentes conseguem atender de forma eficaz após a implementação da solução de roteamento. Um roteamento aprimorado deve aumentar a produtividade. Meça isso acompanhando os tickets resolvidos por agente por dia ou hora, buscando uma melhoria de 10–20% após a implementação de um novo sistema de roteamento.
Isso mede a porcentagem de tickets potenciais resolvidos por meio de opções de autoatendimento antes de entrar no sistema de roteamento. Taxas mais altas indicam uma triagem pré-roteamento eficaz. Busque uma taxa de deflexão de 20–30%, com os melhores desempenhos alcançando taxas de 40% ou superiores.
Esta métrica calcula o custo médio para resolver cada ticket de suporte. Um roteamento eficiente deve ajudar a reduzir esse custo ao longo do tempo. Embora os benchmarks variem amplamente, muitas organizações buscam reduzir o custo por ticket em 10–15% após a implementação de um sistema de roteamento aprimorado.
Escolha o modelo Claude certo
A escolha do modelo depende dos trade-offs entre custo, precisão e tempo de resposta.
Muitos clientes consideraram o claude-haiku-4-5-20251001 um modelo ideal para roteamento de tickets, pois é o modelo mais rápido e econômico da família Claude 4, ao mesmo tempo em que entrega excelentes resultados. Se o seu problema de classificação exigir profundo conhecimento especializado no assunto, um grande volume de categorias de intenção ou raciocínio complexo, você pode optar pelo modelo Sonnet maior.
Construa um prompt forte
O roteamento de tickets é um tipo de tarefa de classificação. O Claude analisa o conteúdo de um ticket de suporte e o classifica em categorias predefinidas com base no tipo de problema, urgência, expertise necessária ou outros fatores relevantes.
Escreva um prompt de classificação de tickets. O prompt inicial deve conter o conteúdo da solicitação do usuário e retornar tanto o raciocínio quanto a intenção.
Aqui está um exemplo de prompt de classificação para roteamento de tickets:
def classify_support_request(ticket_contents):
    # Define o prompt para a tarefa de classificação
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Aqui estão os principais componentes deste prompt:
- O template do prompt é uma f-string do Python, permitindo que o
ticket_contentsseja inserido nas tags<request>. - O prompt dá ao Claude um papel claramente definido como um sistema de classificação que analisa cuidadosamente o conteúdo do ticket para determinar a intenção central e as necessidades do cliente.
- O prompt instrui o Claude sobre a formatação adequada da saída, neste caso para fornecer seu raciocínio e análise dentro de tags
<reasoning>, seguidos pelo rótulo de classificação apropriado dentro de tags<intent>. - O prompt especifica as categorias de intenção válidas: "Support, Feedback, Complaint", "Order Tracking" e "Refund/Exchange".
- O prompt inclui alguns exemplos (também conhecido como few-shot prompting) para ilustrar como a saída deve ser formatada, o que melhora a precisão e a consistência.
Fazer com que o Claude divida sua resposta em seções separadas de tags XML permite que você use expressões regulares para extrair o raciocínio e a intenção da saída de forma independente. Isso permite criar próximos passos direcionados no fluxo de trabalho de roteamento de tickets, como usar apenas a intenção para decidir para qual pessoa rotear o ticket.
Implante seu prompt
É difícil saber quão bem seu prompt funciona sem implantá-lo em um ambiente de produção de teste e executar avaliações.
Construa a estrutura de implantação. Comece definindo a assinatura do método para encapsular a chamada ao Claude. Estenda o método que você começou a escrever anteriormente, que recebe ticket_contents como entrada, para que agora retorne uma tupla de reasoning e intent como saída. Se você tiver uma automação existente usando ML tradicional, convém seguir essa assinatura de método.
import re

# Cria uma instância do cliente da API do Claude
client = anthropic.Anthropic()

# Define o modelo padrão
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Define o prompt para a tarefa de classificação
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Envia o prompt para a API para classificar a solicitação de suporte.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Usa a biblioteca de expressões regulares do Python para extrair `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Da mesma forma, extrai também o `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Este código:
- Cria uma instância do cliente usando sua chave de API.
- Define uma função
classify_support_requestque recebe uma stringticket_contents. - Envia o
ticket_contentsao Claude para classificação usando oclassification_prompt. - Retorna o
reasoninge ointentdo modelo extraídos da resposta.
Como todo o texto de raciocínio e intenção deve ser gerado antes da análise, o exemplo define stream=False (o padrão).
Avalie seu prompt
O prompting frequentemente requer testes e otimização para estar pronto para produção. Para determinar a prontidão da sua solução, avalie o desempenho com base nos critérios de sucesso e limites que você estabeleceu anteriormente.
Para executar sua avaliação, você precisa de casos de teste nos quais executá-la. O restante deste guia pressupõe que você já desenvolveu seus casos de teste.
Construa uma função de avaliação
A avaliação de exemplo deste guia mede o desempenho do Claude em três métricas principais:
- Precisão
- Custo por classificação
Você pode precisar avaliar o Claude em outros eixos, dependendo de quais fatores são importantes para você.
Para avaliar isso, primeiro modifique o script para adicionar uma função que compara a intenção prevista com a intenção real e calcula a porcentagem de previsões corretas. Em seguida, adicione funcionalidades de cálculo de custo e medição de tempo.
import re

# Cria uma instância do cliente da Claude API
client = anthropic.Anthropic()

# Define o modelo padrão
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Define o prompt para a tarefa de classificação
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Usa a biblioteca de expressões regulares do Python para extrair `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Da mesma forma, extrai também o `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Verifica se a previsão do modelo está correta.
    correct = actual_intent.strip() == intent.strip()

    # Retorna reasoning, intent, correct e usage.
    return reasoning, intent, correct, usage
Aqui está um detalhamento das edições:
- O método
classify_support_requestagora recebe oactual_intentdos casos de teste e o compara com a classificação de intenção do Claude para avaliar se eles correspondem. - O método extrai estatísticas de uso da chamada à API para calcular o custo com base nos tokens de entrada e saída usados.
Execute sua avaliação
Uma avaliação adequada requer limites e benchmarks claros para determinar o que é um bom resultado. O script anterior retorna os valores em tempo de execução para precisão, tempo de resposta e custo por classificação, mas você ainda precisa de limites claramente estabelecidos. Por exemplo:
- Precisão: 95% (em 100 testes)
- Custo por classificação: redução de 50% em média (em 100 testes) em relação ao método de roteamento atual
Ter esses limites permite que você diga de forma rápida e fácil, em escala e com empirismo imparcial, qual método é melhor para você e quais mudanças podem precisar ser feitas para atender melhor aos seus requisitos.
Melhore o desempenho
Em cenários complexos, pode ser útil considerar estratégias adicionais para melhorar o desempenho além das técnicas de engenharia de prompt padrão e das estratégias de implementação de guardrails. Aqui estão alguns cenários comuns:
Use uma hierarquia taxonômica para casos com mais de 20 categorias de intenção
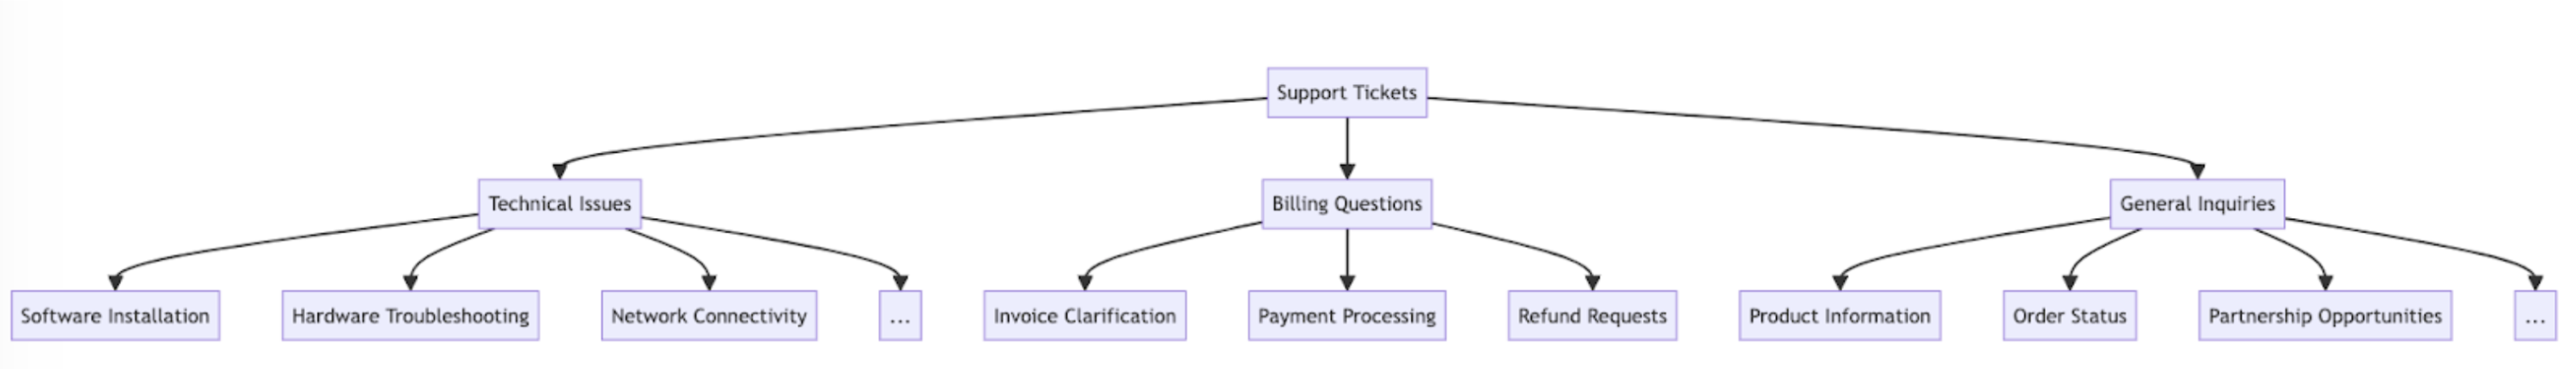
À medida que o número de classes cresce, o número de exemplos necessários também aumenta, potencialmente tornando o prompt difícil de gerenciar. Como alternativa, você pode considerar implementar um sistema de classificação hierárquico usando uma combinação de classificadores.
- Organize suas intenções em uma estrutura de árvore taxonômica.
- Crie uma série de classificadores em cada nível da árvore, permitindo uma abordagem de roteamento em cascata.
Por exemplo, você pode ter um classificador de nível superior que categoriza amplamente os tickets em "Technical Issues", "Billing Questions" e "General Inquiries". Cada uma dessas categorias pode então ter seu próprio subclassificador para refinar ainda mais a classificação.
-
Prós - maior nuance e precisão: Você pode criar prompts diferentes para cada caminho pai, permitindo uma classificação mais direcionada e específica ao contexto. Isso pode levar a uma precisão aprimorada e a um tratamento mais refinado das solicitações dos clientes.
-
Contras - maior latência: Esteja ciente de que múltiplos classificadores podem levar a uma "latency" (latência) maior, e a Anthropic recomenda implementar essa abordagem com o modelo mais rápido, o Haiku.
Use bancos de dados vetoriais e recuperação por busca de similaridade para lidar com tickets altamente variáveis
Apesar de fornecer exemplos ser a maneira mais eficaz de melhorar o desempenho, se as solicitações de suporte forem altamente variáveis, pode ser difícil incluir exemplos suficientes em um único prompt.
Nesse cenário, você pode empregar um banco de dados vetorial para fazer buscas de similaridade a partir de um conjunto de dados de exemplos e recuperar os exemplos mais relevantes para uma determinada consulta.
Essa abordagem, descrita em detalhes na receita de classificação, demonstrou melhorar o desempenho de 71% de precisão para 93% de precisão.
Considere especificamente os casos extremos esperados
Aqui estão alguns cenários em que o Claude pode classificar tickets incorretamente (pode haver outros que sejam exclusivos da sua situação). Nesses cenários, considere fornecer instruções explícitas ou exemplos no prompt de como o Claude deve lidar com o caso extremo:
Os clientes frequentemente expressam necessidades de forma indireta. Por exemplo, "Estou esperando meu pacote há mais de duas semanas" pode ser uma solicitação indireta de status do pedido.
- Solução: Forneça ao Claude alguns exemplos reais de clientes desses tipos de solicitações, junto com qual é a intenção subjacente. Você pode obter resultados ainda melhores se incluir uma justificativa de classificação para intenções de tickets particularmente sutis, para que o Claude possa generalizar melhor a lógica para outros tickets.
Quando os clientes expressam insatisfação, o Claude pode priorizar lidar com a emoção em vez de resolver o problema subjacente.
- Solução: Forneça ao Claude orientações sobre quando priorizar ou não o sentimento do cliente. Pode ser algo tão simples quanto "Ignore todas as emoções do cliente. Concentre-se apenas em analisar a intenção da solicitação do cliente e quais informações o cliente pode estar pedindo."
Quando os clientes apresentam múltiplos problemas em uma única interação, o Claude pode ter dificuldade em identificar a preocupação principal.
- Solução: Esclareça a priorização das intenções para que o Claude possa classificar melhor as intenções extraídas e identificar a preocupação principal.
Integre o Claude ao seu fluxo de trabalho de suporte mais amplo
Uma integração adequada requer que você tome algumas decisões sobre como seu script de roteamento de tickets baseado no Claude se encaixa na arquitetura do seu sistema de roteamento de tickets mais amplo. Há duas maneiras de fazer isso:
- Baseada em push: O sistema de tickets de suporte que você está usando (por exemplo, Zendesk) aciona seu código enviando um evento de webhook para seu serviço de roteamento, que então classifica a intenção e faz o roteamento.
- Essa abordagem é mais escalável na web, mas exige que você exponha um endpoint público.
- Baseada em pull: Seu código busca os tickets mais recentes com base em um cronograma determinado e os roteia no momento da busca.
- Essa abordagem é mais fácil de implementar, mas pode fazer chamadas desnecessárias ao sistema de tickets de suporte quando a frequência de busca é muito alta ou pode ser excessivamente lenta quando a frequência de busca é muito baixa.
Para qualquer uma dessas abordagens, você precisa encapsular seu script em um serviço. A escolha da abordagem depende de quais APIs seu sistema de tickets de suporte fornece.
Visite o cookbook de classificação para mais exemplos de código e orientações detalhadas de avaliação.
Comece a construir e avaliar seu fluxo de trabalho no Claude Console.
Was this page helpful?