Mengoptimalkan biaya dan kecerdasan
Seimbangkan biaya dan kecerdasan di Claude Platform, dengan hasil terukur untuk caching prompt, effort, pilihan model, anggaran, dan strategi multi-model.
Ketika sebuah "workload" (beban kerja) berpindah dari prototipe ke produksi, biaya menjadi batasan desain kelas satu. Model yang paling mumpuni bisa terlalu mahal dalam skala besar, dan model yang paling murah bisa kurang dalam kualitas. Mengelola biaya dengan baik berarti memahami bagaimana setiap tuas biaya memengaruhi kualitas output, karena sebagian tuas mengorbankan kualitas dan sebagian tidak. Claude Platform memberi Anda kendali langsung atas tradeoff tersebut. Anda memilih model, tingkat effort, dan arsitektur untuk setiap permintaan, yang memungkinkan Anda menempatkan beban kerja hampir di mana saja pada "cost-to-intelligence frontier" (frontier biaya-terhadap-kecerdasan).
Biaya dan kecerdasan biasanya digambarkan sebagai sebuah frontier di mana yang satu membeli yang lain. Kelompok tuas pertama di halaman ini menggerakkan beban kerja menuju frontier itu dengan memangkas biaya tanpa menyentuh kualitas; hanya kelompok kedua yang bergerak di sepanjang frontier:
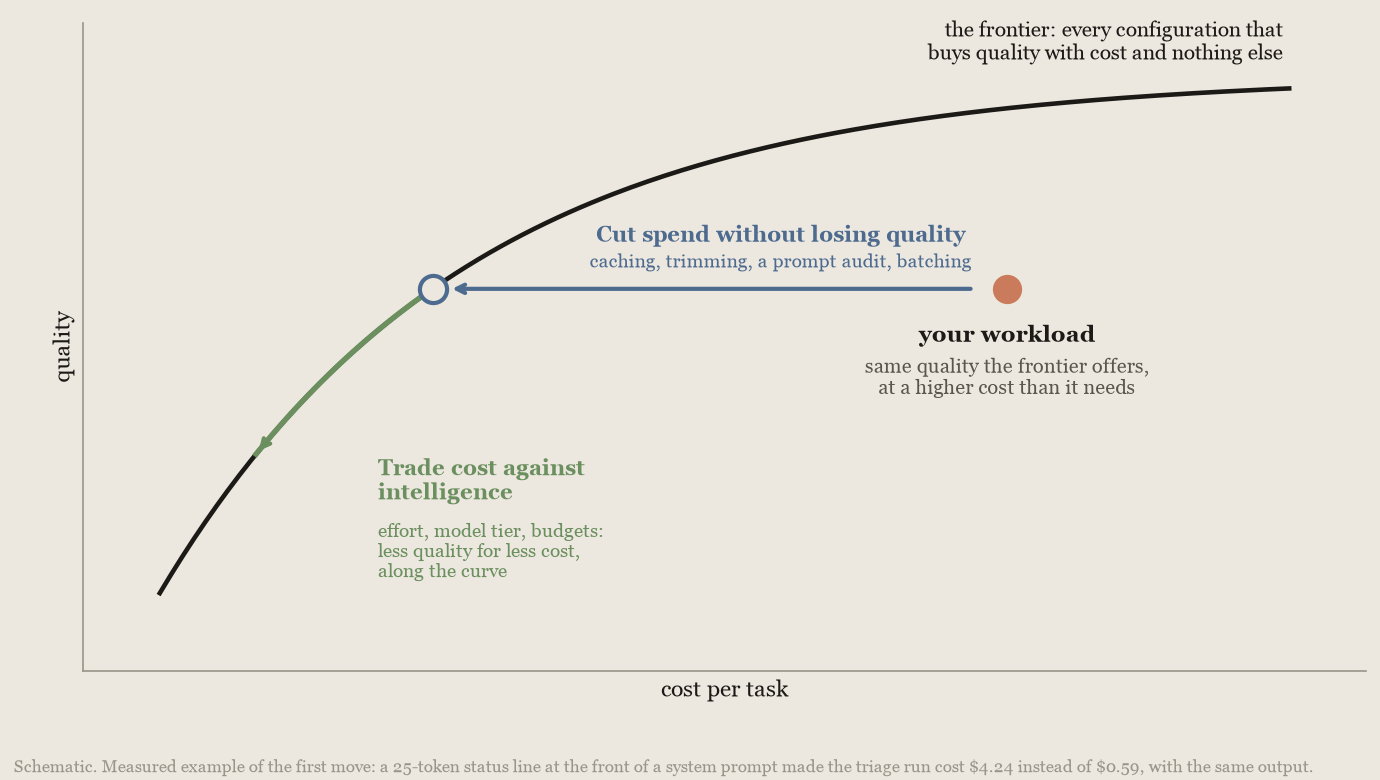
Tuas-tuas ini ada dua jenis:
- Keuntungan gratis (free wins) memangkas pengeluaran tanpa menyentuh kualitas: "prompt caching" (caching prompt), kebersihan token, audit prompt terhadap model yang Anda jalankan, pemrosesan batch dengan diskon 50% untuk pekerjaan yang bisa menunggu hingga 24 jam, dan batas pengeluaran workspace sebagai pengaman terakhir.
- Tradeoff (pertukaran) menukar biaya dengan kecerdasan: pilihan model, effort, batas output dan anggaran tugas, serta arsitektur multi-model.
Setiap tuas disertai hasil terukur dan aturan kapan tuas itu menguntungkan. Dalam pengukuran Anthropic, caching prompt adalah tuas terbesar dengan selisih jauh: ia memangkas biaya loop agen dengan faktor 2,7 hingga 5,3 pada benchmark panduan ini dan memangkas tagihan agen triase kecil sebesar 83%, atau 88% dengan tambahan pemangkasan input. Tuas multi-model lebih sempit; model kedua menguntungkan dalam dua bentuk, advisor dan orchestrator.
Mulai di sini
Cocokkan situasi Anda dengan sebuah baris.
| Situasi Anda | Lakukan ini | Di mana |
|---|---|---|
| Beban kerja apa pun, model apa pun | Aktifkan caching prompt dan pangkas token yang tidak diperlukan; keduanya gratis | Cache konteks berulang · Pangkas token |
| Seseorang menunggu di antara giliran | Gunakan durasi cache 1 jam begitu sekitar 1 dari 20 giliran mengikuti jeda antara 5 menit dan satu jam dan hanya sedikit celah yang melebihi satu jam. Pada Claude Fable 5.1, jaga cache 5 menit tetap hangat selama jeda berlangsung beberapa menit, dan beli durasi 1 jam ketika jeda mendekati satu jam | Pilih durasi cache |
| Biaya terlalu tinggi; kualitas baik | Turunkan effort secara bertahap (sweep) pada model Anda saat ini | Setel effort |
| Anda tidak menggunakan model terbaru | Upgrade; model saat ini menyelesaikan lebih banyak tugas, dengan biaya per tugas terselesaikan dari sekitar 40% lebih rendah hingga sekitar 20% lebih tinggi | Upgrade model |
| Anda sedang memilih atau berganti model | Bandingkan berdasarkan biaya per tugas selesai, bukan per token | Bandingkan model |
| Kualitas tidak cukup baik | Jika Anda menurunkan effort, kembalikan; jika tidak, coba tingkat berikutnya di atas pada effort low | Setel effort · Bandingkan model |
Percobaan berakhir dengan stop_reason: max_tokens | Naikkan max_tokens; 64.000 mencakup semua kecuali 2 dari 14.000 giliran yang diukur pada effort default, dan 128.000 tidak menambah biaya apa pun per tugas terselesaikan | Tetapkan anggaran |
| Anda dapat memeriksa output (tes, verifier) | Jalankan semuanya pada effort rendah dan jalankan ulang kegagalan pada default (high); pada benchmark coding yang diukur, tingkat kelulusan bertahan dengan sekitar setengah biaya | Jalankan ulang kegagalan |
| Loop agen dengan beberapa run yang sangat mahal | Tetapkan anggaran tugas (beta; periksa tabel dukungan untuk model mana), anggaran sesi Claude Managed Agents, dan batas pengeluaran workspace | Tetapkan anggaran |
| Model berbiaya lebih rendah macet hanya pada keputusan sulit | Tambahkan advisor frontier. Ini menguntungkan ketika harganya jauh di atas executor dan benar-benar dikonsultasikan, jadi pertama-tama hitung harga model advisor sendirian pada effort rendah dan ukur tingkat konsultasinya | Strategi advisor |
| Pekerjaan melebihi satu jendela konteks | Delegasikan partisi ke worker yang lebih murah | Strategi orchestrator |
Hasil-hasil ini bersifat internal Anthropic (Benchmark yang dirujuk) dan bersifat arahan, bukan jaminan, jadi ukurlah pada beban kerja Anda sendiri dengan metode empat langkah.
Pangkas pengeluaran tanpa kehilangan kualitas
Caching prompt, kebersihan token, pemrosesan batch, dan audit prompt terhadap model Anda saat ini semuanya menurunkan apa yang Anda bayar tanpa menurunkan kualitas output. Dua catatan berlaku: pemrosesan batch menukar latensi dengan diskonnya, dan context editing, sebuah tuas kebersihan token, berbiaya lebih besar daripada yang dihematnya pada run yang diukur di bagian ini.
Cache konteks berulang
Mengapa caching didahulukan
Aktifkan caching prompt sebelum tuas lain mana pun, karena setiap giliran tugas agentic mengirim ulang seluruh percakapan yang terus bertambah: "system prompt" (prompt sistem), definisi alat, dan setiap giliran sebelumnya. Tugas 40 giliran mengirim giliran pertamanya 40 kali, sehingga biaya tugas tumbuh kira-kira sebanding dengan kuadrat jumlah giliran. Caching tidak menghentikan pengiriman ulang, tetapi setiap pengiriman ulang berbiaya sekitar sepersepuluhnya dan diproses lebih cepat: prefiks ditagih pada tarif cache-read, sepersepuluh harga input, dan setiap giliran membayar tarif cache-write 1,25x hanya untuk apa yang baru.
Seperti apa yang baik itu. Selama satu hari penuh lalu lintas nyata, loop agen membaca median 84% inputnya dari cache, dan 10% harness teratas, coding atau bukan, membaca 94% atau lebih17. Jauh di dalam sebuah tugas, loop yang dibangun dengan baik membayar harga penuh untuk kurang dari 1% inputnya. Di bawah sekitar 80%, cari sesuatu yang merusak cache (lihat Apa yang merusak cache).
Di seluruh run terukur Anthropic, cache read secara rutin merupakan komponen tunggal terbesar dari biaya tugas, membuat caching lebih bernilai daripada sebagian besar keputusan pilihan model. Anthropic menghitung harga run DeepResearch Bench II7 dengan dan tanpa caching:
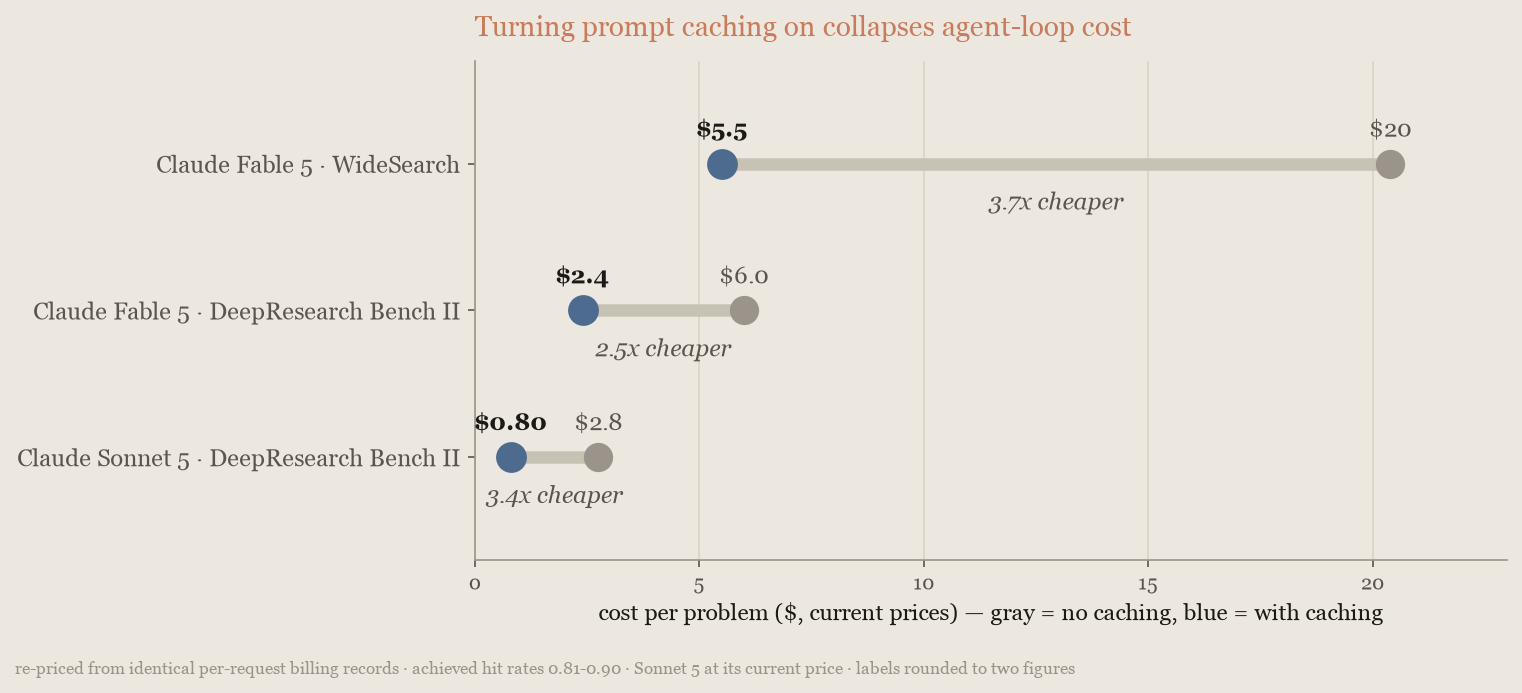
Masa hidup default cache adalah 5 menit dan giliran loop agen berjarak beberapa detik, sehingga diskon berlaku untuk sebagian besar token pada setiap giliran. Run pada grafik caching membaca 79% hingga 90% token inputnya dari cache. Penghematannya bervariasi menurut kedalaman episode, karena loop yang lebih pendek membaca ulang lebih sedikit, tetapi caching tetap menjadi tuas tunggal terbesar pada setiap model dan benchmark yang diukur.
Pilih durasi cache
Jika loop Anda menunggu seseorang di antara giliran, gunakan durasi cache 1 jam. Biaya tulisnya lebih mahal (2x harga input, bukan 1,25x). Miss pada durasi mana pun menagih seluruh prefiks pada harga tulis alih-alih harga baca, sehingga durasi yang lebih panjang menguntungkan begitu beberapa giliran per sesi mengikuti jeda antara 5 menit dan satu jam.
Untuk memutuskan, hitung celah antara permintaan berurutan dalam sebuah percakapan:
- Lebih dari sekitar 1 dari 20 celah jatuh antara 5 menit dan satu jam, dan celah lebih dari satu jam jarang: gunakan durasi 1 jam.
- Giliran tiba berjarak beberapa detik: tetap pada default 5 menit. Ketika tidak ada jeda, biayanya 15% lebih murah daripada pengaturan 1 jam pada Claude Sonnet 5 dan 11% lebih murah pada Claude Opus 5.
- Celah lebih dari satu jam umum terjadi: tetap pada default. Celah lebih dari satu jam membuat kedua durasi kedaluwarsa, dan pengaturan 1 jam kemudian menulis ulang prefiks pada harga tulisnya yang lebih tinggi, sehingga ia rugi pada setiap celah tersebut. Dari jeda Anda yang lebih lama dari 5 menit, jika sekitar 60% atau lebih juga melewati satu jam, tetap pada default; durasi 1 jam hanya menguntungkan ketika setidaknya sekitar 40% jeda panjang berakhir dalam satu jam.
Anthropic mengukur pekerjaan triase dari Pangkas token input dan konteks dengan jeda disisipkan sebelum beberapa giliran untuk mensimulasikan penundaan seseorang16. Pada kedua model yang diukur, cache 1 jam menjadi pengaturan yang lebih murah begitu sekitar 1 dari 30 giliran mengikuti jeda, sehingga aturan 1-dari-20 menyisakan margin, dan selisihnya melebar cepat melewati titik persilangan karena setiap giliran berjeda pada pengaturan 5 menit menulis ulang seluruh prefiks. Setiap model saat ini menggunakan pengali cache-write yang sama, dan setiap model kecuali Claude Fable 5.1 dan Claude Mythos 5.1 menggunakan harga baca yang sama, sehingga titik persilangan berada di rentang yang sama pada model lain; Fable 5.1 adalah kasus yang dibahas berikutnya. Akurasi tetap dalam noise antar-run di setiap sel. Giliran setelah jeda mempertahankan latensi cache-hangatnya pada pengaturan 1 jam. Grafik berikut memplot biaya per sesi terhadap porsi giliran berjeda pada Claude Sonnet 5:
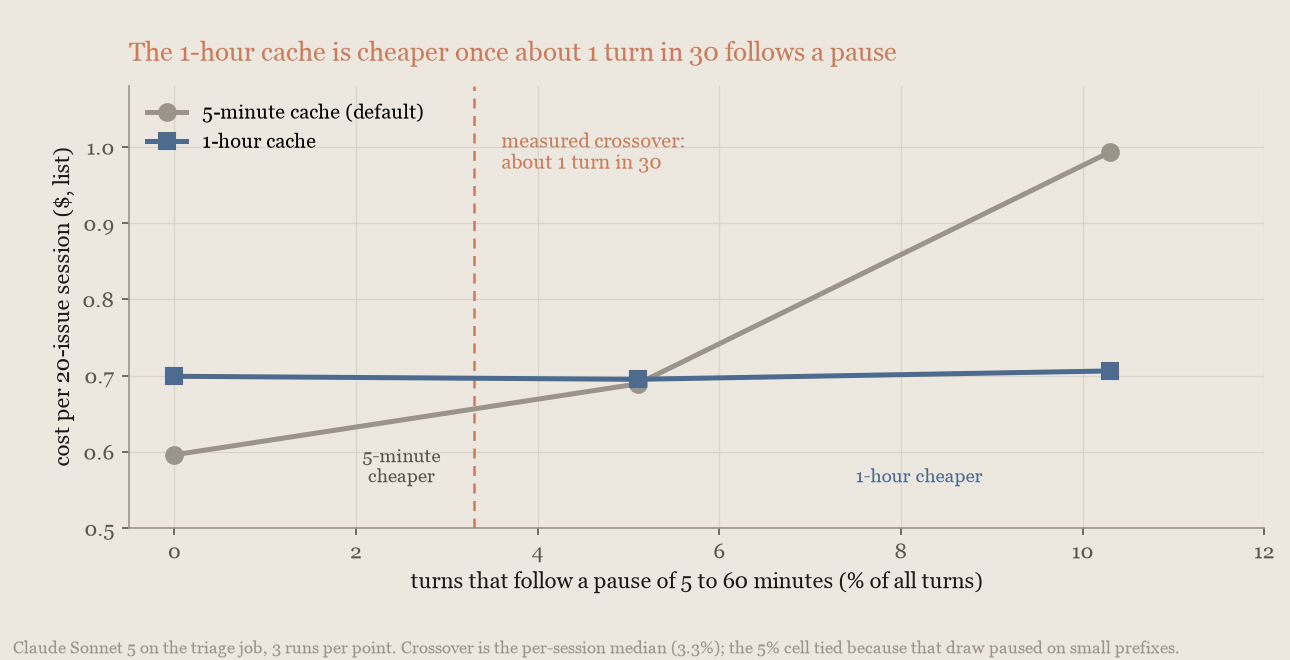
Anthropic juga mengukur permintaan tambahan yang menjaga cache 5 menit tetap hangat. Pada Claude Sonnet 5 dan Claude Opus 5 permintaan itu tidak menghemat apa pun yang terukur dibanding durasi 1 jam pada porsi giliran berjeda berapa pun dan berbiaya lebih mahal dengan jeda sebelum setiap giliran, jadi gunakan durasi itu saja.
Pada Claude Fable 5.1 pengaturan termurahnya berbeda. Cache read-nya berbiaya 0,025x harga input ($0,25 per juta token) sementara cache write-nya mempertahankan pengali standar, sehingga permintaan keep-alive yang membaca ulang prefiks itu murah dan premi tulis durasi 1 jam adalah tagihan yang lebih besar. Anthropic mengukur pekerjaan triase pada Claude Fable 5.1 dengan tiga pengaturan yang sama19. Menjaga cache 5 menit tetap hangat berbiaya 13% hingga 20% lebih murah per sesi daripada cache 1 jam setiap kali jeda berlangsung beberapa menit; hanya dengan jeda mendekati 45 menit cache 1 jam menang, sekitar 12 sen per sesi. Pada Claude Fable 5.1, jaga cache 5 menit tetap hangat selama seseorang pergi beberapa menit, dan beli durasi 1 jam ketika jeda mendekati satu jam:
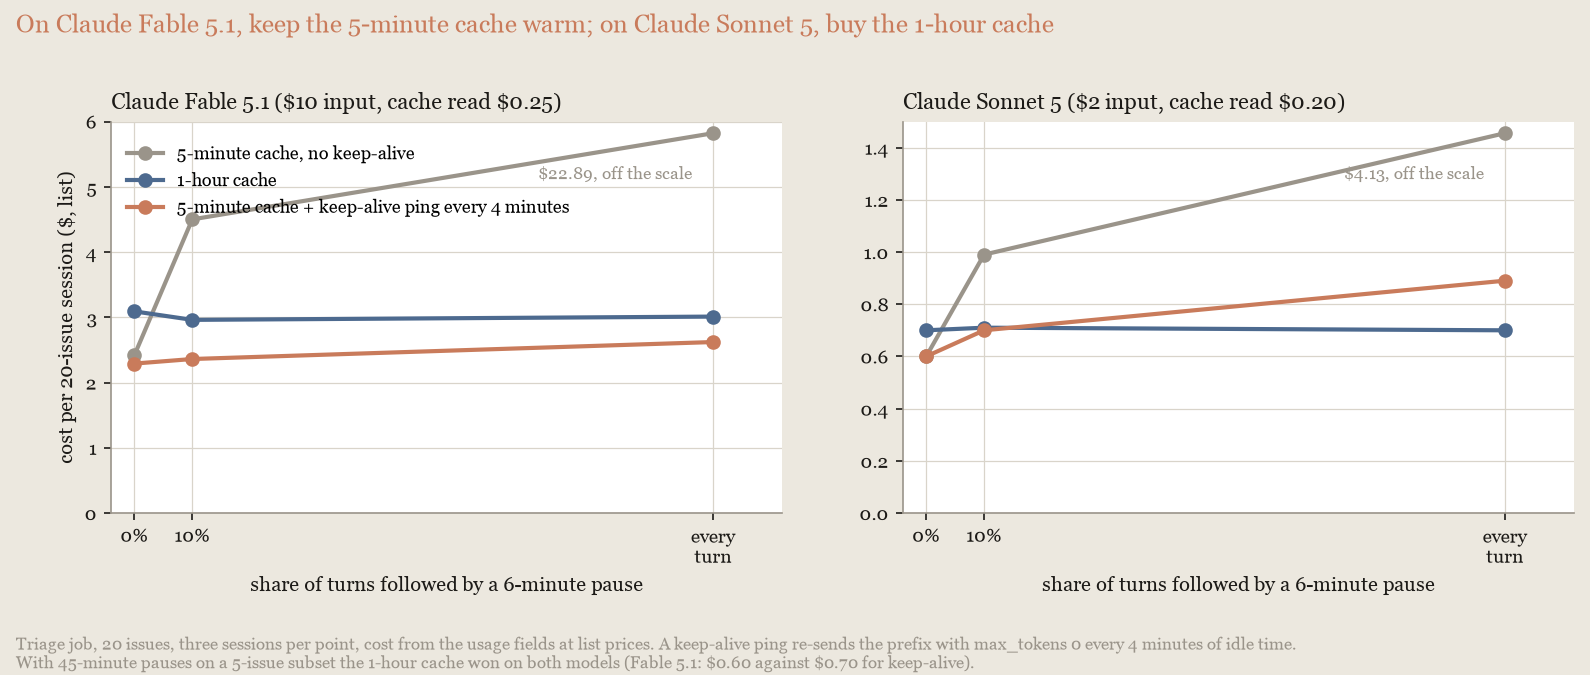
Untuk menjaga cache tetap hangat, kirim lagi permintaan sebelumnya dengan max_tokens disetel ke 0 dalam 4 menit sejak awal permintaan sebelumnya, dan setiap 4 menit setelahnya, dengan menghapus stream jika sebelumnya disetel. Hitung dari awal permintaan, bukan akhir responsnya: masa hidup 5 menit cache berjalan dari awal permintaan yang menulis atau menyegarkan entri, sehingga waktu yang dihabiskan respons untuk menghasilkan output dihitung terhadapnya. Itulah permintaan pre-warming: ia menyegarkan masa hidup cache, tidak menghasilkan apa pun, dan hanya menagih cache read. Jangan ubah satu byte pun dari prefiks, dan jangan gunakan max_tokens: 1, yang mengambil sampel satu token tanpa alasan. Kirim ulang header permintaan serta body-nya: jika permintaan Anda membawa header anthropic-beta (untuk anggaran tugas, misalnya), permintaan keep-alive memerlukan header yang sama, atau field yang dibatasi beta dalam body yang diputar ulang akan ditolak. Permintaan max_tokens: 0 ditolak ketika permintaan menyetel thinking.type: "enabled" (adaptive thinking default pada Claude Fable 5.1 tidak masalah), structured outputs, atau pilihan alat paksa (keterbatasannya); pada beban kerja tersebut, beli durasi 1 jam sebagai gantinya.
# Dalam 4 menit sejak permintaan terakhir dimulai (waktu pembuatan respons dihitung
# terhadap masa berlaku cache), kirim ulang permintaan itu dengan max_tokens diatur ke
# 0, tanpa stream (permintaan max_tokens: 0 tidak dapat streaming). Kirim header
# yang sama dengan permintaan asli, termasuk header anthropic-beta apa pun.
jq '.max_tokens = 0 | del(.stream)' last_request.json | \
  curl https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    --data-binary @-
Aktifkan caching
Penyiapannya butuh sedikit usaha. Caching otomatis menempatkan breakpoint untuk Anda; jika tidak, skill Claude API yang disertakan dengan Claude Code dapat menambahkan caching ke integrasi yang ada dari satu prompt. Kutipan berikut menunjukkan skill tersebut menambahkannya ke harness yang menghasilkan pengukuran ini:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...Penempatan breakpoint tersebut mengikuti pola standar dalam Breakpoint cache eksplisit.
Apa yang merusak cache
Beberapa hal dapat merusak cache Anda selama sebuah tugas. Apa pun yang berubah per permintaan, seperti timestamp atau posisi antrean, yang ditempatkan di depan prefiks stabil mengubah setiap permintaan menjadi cache write penuh: pada run triase di Pangkas token input dan konteks, baris status 25 token di depan prompt sistem berbiaya $4,24 per run alih-alih $0,59, lebih mahal daripada berjalan dengan caching mati. Simpan teks per-permintaan di giliran pengguna terbaru.
Cache adalah pencocokan prefiks byte-persis atas permintaan secara berurutan (alat, lalu prompt sistem, lalu pesan), sehingga perubahan di mana pun membatalkan semua yang ada setelahnya. Mengubah effort atau konfigurasi thinking antar permintaan membatalkan cache dari titik itu ke depan, dan pada beberapa model juga alat dan prompt sistem di depannya; setiap edit pada prompt sistem membatalkan cache dari titik itu ke depan; menyetel atau mengubah format output membatalkan cache untuk seluruh percakapan; menambah, menghapus, atau mengurutkan ulang definisi alat membatalkan semuanya. Halaman caching prompt mencantumkan kasus-kasus ini, kecuali format output, yang dibahas oleh structured outputs. Pada model terbaru, ubah instruksi dengan pesan sistem di tengah percakapan, pesan {"role": "system"} yang ditambahkan ke messages, alih-alih mengedit field system tingkat atas: prefiks yang di-cache tetap utuh. Periksa halaman itu untuk model mana yang mendukungnya. Pada model yang mendukungnya, perubahan effort per-pesan juga membiarkan prefiks yang di-cache tetap utuh. Taruhannya paling tinggi pada Claude Fable 5.1 dan Claude Mythos 5.1: kerusakan menulis ulang prefiks pada 1,25x harga input alih-alih membacanya pada 0,025x, sehingga pada prefiks 100.000 token satu giliran yang rusak berbiaya $1,25 alih-alih $0,03, 50 kali biaya baca, dibanding 12,5 kali ($0,63 alih-alih $0,05) pada Claude Opus 5.
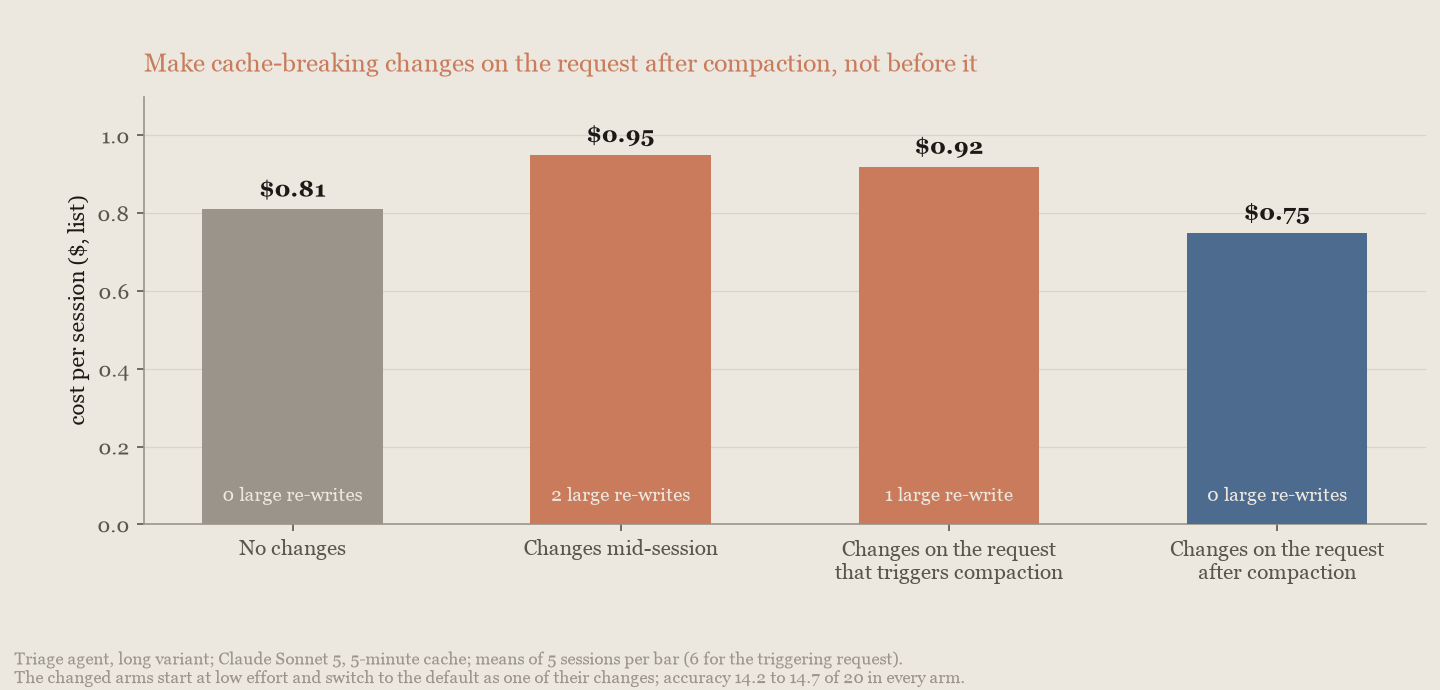
Anthropic mengukur ini pada sesi panjang agen triase18. Perubahan effort dan alat tambahan yang dibuat di tengah sesi menulis ulang 39.000 dan 60.000 token yang di-cache, dan sesi tersebut berbiaya $0,95 per sesi. Dua perubahan yang sama pada permintaan pertama setelah compaction berbiaya $0,75, dan pada permintaan yang memicu compaction $0,92, karena pass peringkasan compaction kemudian memproses ulang konteks 81.000 token pada harga cache-write: pass peringkasan itu berbiaya $0,21, dibanding $0,04 ketika perubahan yang sama datang satu permintaan kemudian, dengan akurasi dalam noise antar-run di setiap arm:
Mengubah anggaran tugas di tengah jalan membatalkan prefiks ter-cache apa pun yang berisi nilai anggaran, jadi tetapkan sekali, pada permintaan pertama. Setiap pass context editing membatalkan prefiks dari titik yang dibersihkannya dan permintaan berikutnya membayar untuk meng-cache ulang semua yang ada setelahnya, jadi bersihkan dalam beberapa batch besar alih-alih banyak batch kecil. Pada Claude Fable 5.1 dan Claude Mythos 5.1 masing-masing ini berbiaya 50 kali harga baca per token, sehingga paling penting di sana. Lakukan setiap perubahan yang membatalkan cache pada jeda alami, lalu konfirmasikan cache read tidak turun; jika turun, diagnostik cache menunjukkan di mana prefiks menyimpang.
Pangkas token input dan konteks
Sebagian besar permintaan agen membawa token yang tidak pernah memengaruhi jawaban. Memangkasnya jarang mengorbankan kualitas output, meskipun tidak setiap tuas di sini menghemat uang ketika diukur. Dua tempat untuk dilihat:
- Pemangkasan input. Dynamic filtering pada alat web fetch menjaga boilerplate keluar dari halaman yang diambil, pengubahan ukuran gambar menyesuaikan ukuran input vision, dan tool search dengan deferred loading memuat definisi alat hanya saat diperlukan (diukur nanti di bagian ini). Programmatic tool calling memungkinkan Claude menjalankan beberapa panggilan alat dari kode sehingga hanya hasil yang difilter masuk ke konteks; dokumentasinya melaporkan 24% lebih sedikit token input pada benchmark pencarian agentic, dengan skor lebih tinggi. Kelola konteks alat membandingkan tool search, programmatic tool calling, caching prompt, dan context editing.
- Siklus hidup konteks. Context editing membersihkan hasil alat yang usang, dan compaction otomatis dengan ambangnya menghentikan loop panjang membawa seluruh riwayatnya ke depan.
Tuas-tuas ini berinteraksi dengan cache dan satu sama lain, jadi nilailah berdasarkan efek bersih, dan gunakan diagnostik cache untuk mengonfirmasi prefiks ter-cache Anda bertahan dari setiap perubahan. Anthropic mengukurnya pada agen triase isu yang mengerjakan 20 laporan bug nyata dengan screenshot dari repositori publik, dan pada varian lebih panjang dari pekerjaan yang sama dengan 2,6 kali token. Dengan caching aktif, pemangkasan input (pengubahan ukuran gambar dan tool search) memangkas 26% lagi dari run pendek dan 21% dari run panjang.
Tunda definisi alat yang tidak digunakan
Setiap definisi alat yang dilampirkan ke permintaan adalah input pada setiap giliran, dan beberapa server MCP bisa berjumlah hingga ratusan. Anthropic menjalankan agen triase dengan dua alatnya sendiri ditambah katalog definisi alat nyata dari server MCP publik, dengan total hingga 502 alat, memuat semuanya atau menandai yang ekstra defer_loading di balik tool search:
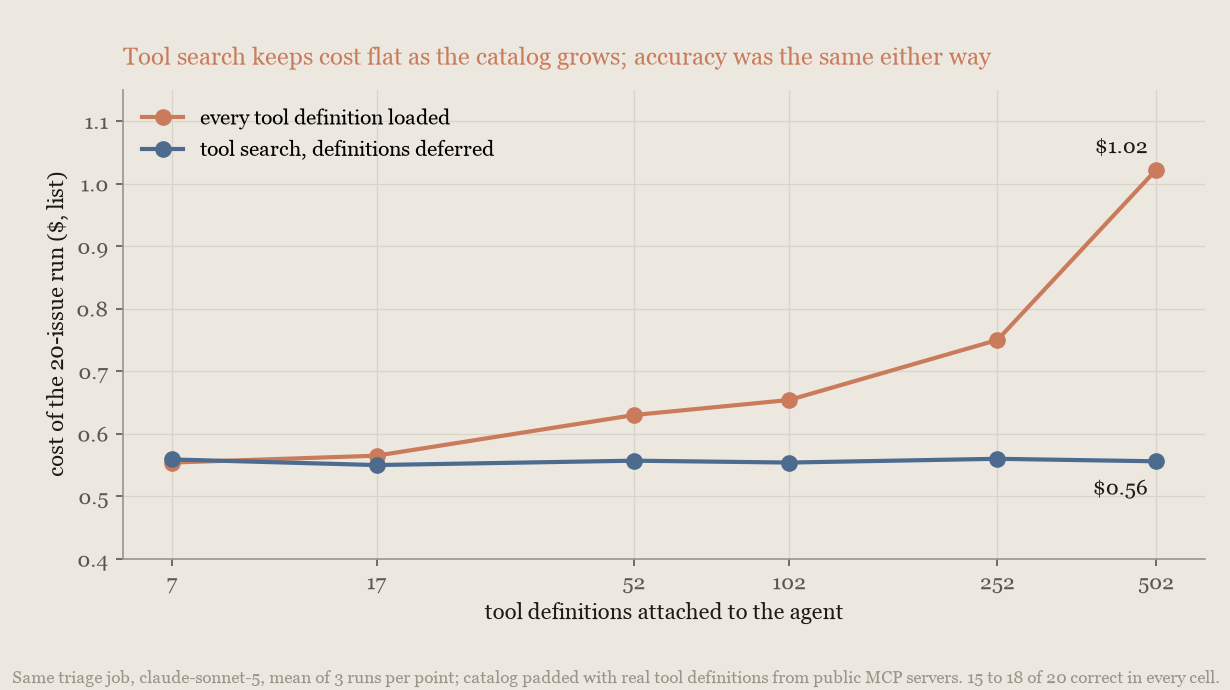
Dengan setiap definisi dimuat, biaya run hampir dua kali lipat seiring katalog bertambah, mengikuti token skema pada setiap permintaan. Dengan tool search biayanya tetap datar pada setiap ukuran katalog, 45% lebih murah pada 502 alat. Akurasi 15 hingga 18 dari 20 di setiap sel dengan cara mana pun, dan model tidak pernah memanggil alat yang salah, jadi pada skala ini katalog memakan uang, bukan ketepatan. Hal yang sama berlaku untuk alat yang datang melalui MCP connector: dengan server MCP GitHub publik terpasang, menunda toolset-nya (default_config: {defer_loading: true}) memangkas run 20% pada akurasi yang sama.
Jauhkan file data dari prompt
Ketika model harus menghitung atas sebuah tabel, unggah dengan Files API dan biarkan model mengkuerinya dengan code execution alih-alih menempelkannya. Anthropic mengajukan 25 pertanyaan agregat15 (jumlah, hitungan terfilter, group-by, dan filter tanggal) atas CSV publik 1.862 baris, dengan jawaban dihitung oleh pandas:
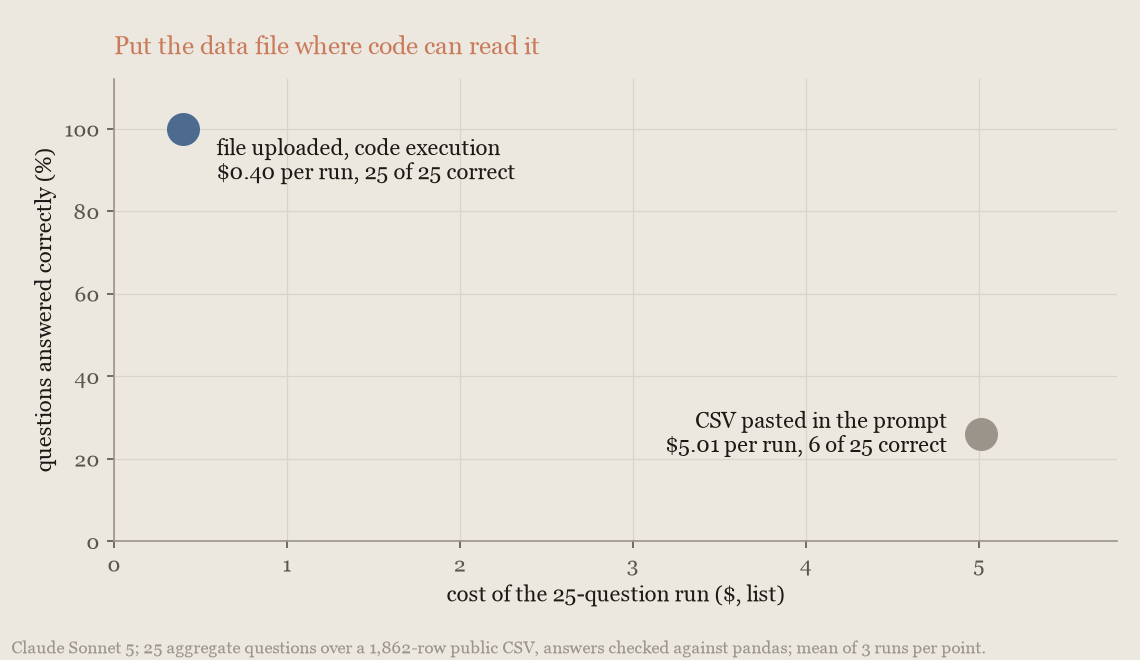
Ditempel ke prompt, tabel itu sekitar 91.000 token input pada setiap permintaan, dan Claude Sonnet 5 menjawab 6 dari 25 pertanyaan dengan benar. Diunggah, dengan code execution, ia menjawab semua 25, dan run berbiaya sekitar seperdua belasnya. Claude Opus 5 menunjukkan pola yang sama.
Kelola siklus hidup konteks
Tuas konteks hanya menguntungkan pada sesi yang cukup panjang untuk membutuhkannya:
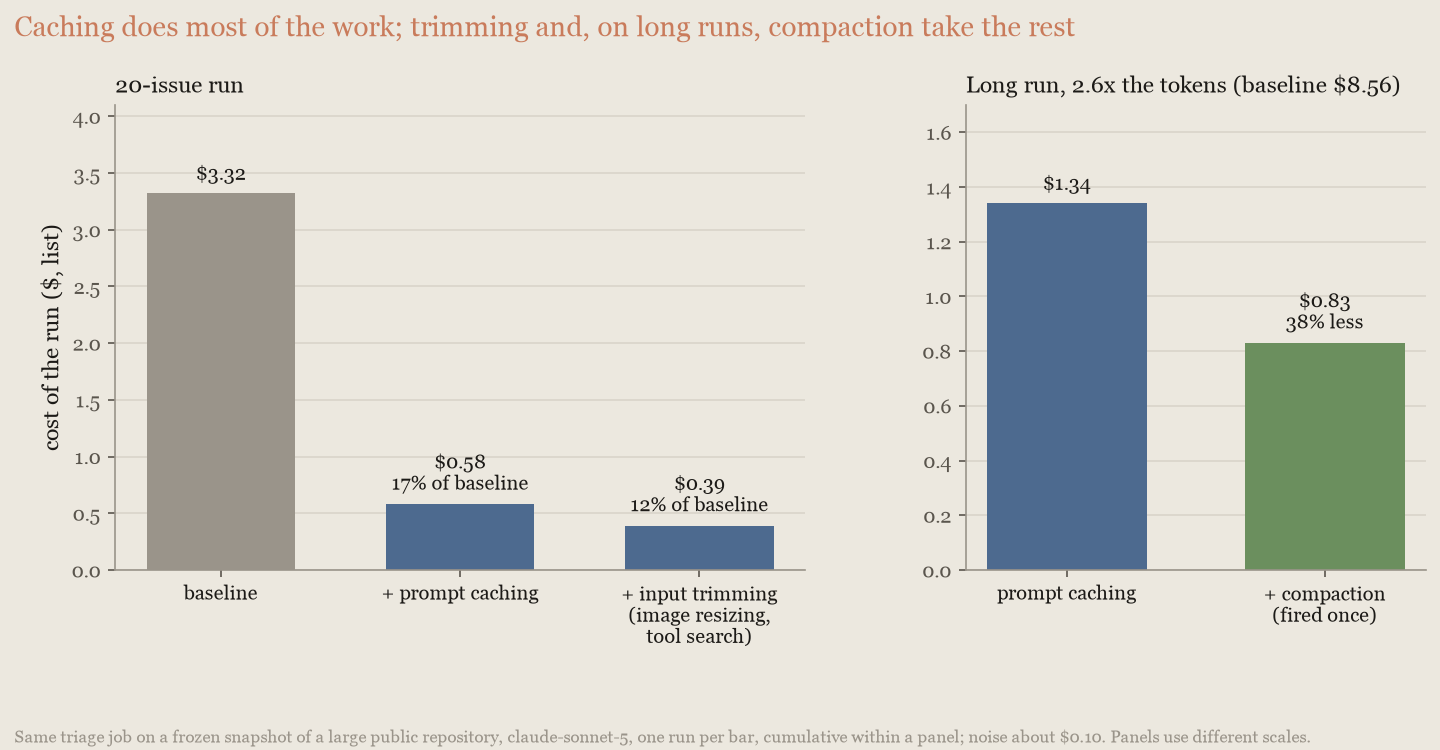
Pada run 20 isu mereka tidak menghemat apa pun, dan context editing berbiaya 74% lebih mahal. Pada run panjang prune menghemat 39% dan compaction 32%, sementara context editing tidak mengubah apa pun. Prune adalah beberapa baris yang Anda tulis sendiri: pada setiap batas tugas, ganti hasil alat usang yang besar dengan ekstrak satu baris. Ia ter-cache dengan baik karena editnya berada di ekor percakapan, tempat tugas berikutnya menambahkan konten baru bagaimanapun juga: 89% cache read pada permintaan pertama setelah batas dan 81% pada permintaan di antara batas. Di seluruh run, prune dan context editing ter-cache kira-kira sama baiknya. Prune lebih murah karena context editing menulis ulang konten di tengah tugas yang dihapus oleh prune (sekitar dua pertiga selisih) dan karena ia menjaga konteks sekitar setengah ukurannya (sepertiga lainnya). Jika Anda menggunakan context editing, bersihkan dalam beberapa batch besar. Prune, diadaptasi dari harness:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # batasi hasil satu baris agar ekstrak tetap singkat
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
block["content"] = extractBatch pekerjaan yang bisa menunggu
Batch API memotong 50% dari setiap token permintaan, termasuk yang ter-cache, dengan imbalan hasil tiba kapan saja dalam 24 jam. Arahkan setiap permintaan yang tidak ditunggu siapa pun melalui batch, dan pertahankan jalur interaktif untuk sisanya. Batching adalah tuas gratis terbesar kedua setelah caching untuk pekerjaan agen tanpa pengawasan: run evaluasi, backfill, dan pekerjaan terjadwal seperti run berulang agen triase isu dari pengukuran pemangkasan token. Ia dapat digabungkan dengan semua yang ada di halaman ini kecuali interaktivitas, tetapi tidak tersedia untuk sesi Claude Managed Agents, yang interaktif secara desain (lihat harga Claude Managed Agents).
Audit prompt terhadap model saat ini
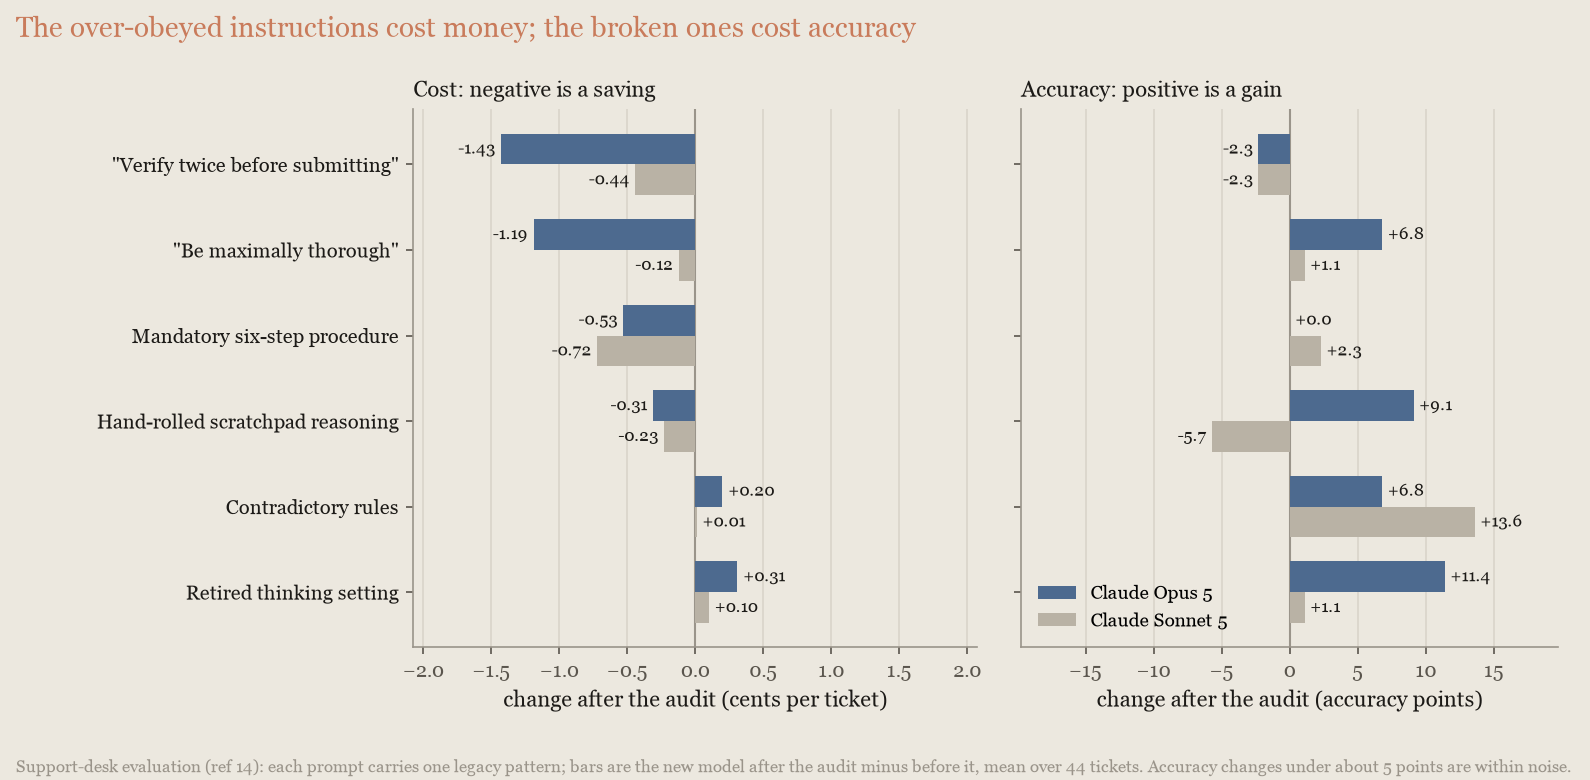
Setiap generasi model merespons prompt secara berbeda, sehingga sebuah prompt mengakumulasi teks yang ditulis untuk model yang tidak lagi Anda gunakan. Kasus yang biasa adalah instruksi terlalu spesifik yang ditambahkan untuk mengompensasi model lama: "verify twice," "be maximally thorough," prosedur langkah-demi-langkah wajib, atau scratchpad penalaran buatan sendiri. Model yang lebih baru mengikutinya secara harfiah, menghasilkan putaran alat ekstra dan tulisan ekstra, sehingga tagihan naik tanpa peningkatan akurasi. Mengaudit prompt terhadap model yang Anda jalankan sekarang, dan lagi setiap kali Anda berganti model, adalah keuntungan gratis.
Audit itu satu perintah. Skill Claude API yang disertakan dengan Claude Code memiliki perintah prompt-audit yang membaca prompt dan kode permintaan sebuah proyek dan melaporkan apa yang ditulis untuk model berbeda. Kutipan yang dipersingkat ini menunjukkannya dijalankan terhadap prompt support-desk dan kode permintaan yang berisi pola-pola tersebut:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.Perintah itu kemudian mengusulkan editnya sebagai diff (satu hunk ditampilkan) dan mencantumkan apa yang sengaja dibiarkannya: jendela refund, persyaratan nada, dan standar kualitas. Anda meninjau sebuah patch, bukan penulisan ulang.
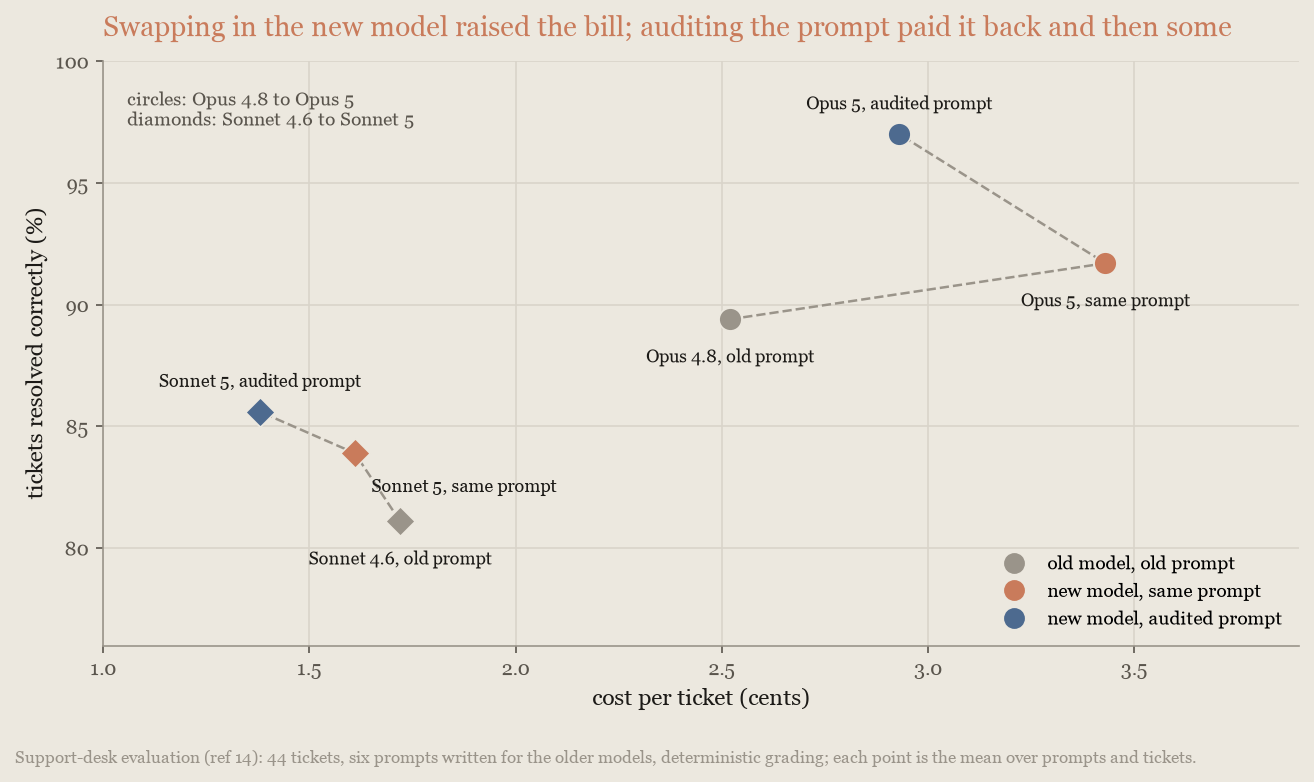
Efeknya terukur. Pada evaluasi support-desk14, prompt yang ditulis untuk Claude Opus 4.8 berbiaya 36% lebih mahal per tiket pada Claude Opus 5 tanpa perubahan akurasi. Menjalankan audit atas prompt yang sama membuat Opus 5 lebih murah daripada versi yang tidak diaudit (sebesar 14%) dan lebih akurat (97% tiket, naik dari 92%, peningkatan di luar noise). Pada migrasi Claude Sonnet 4.6 ke Claude Sonnet 5, audit memangkas 14% pada akurasi yang sama:
Dua jenis teks usang memiliki biaya berbeda. Instruksi yang diikuti model baru terlalu harfiah memakan uang: menghapus "verify twice" memangkas biaya per tiket Opus 5 sepertiga, dan menghapus "be maximally thorough" hampir sebanyak itu. Teks yang tidak lagi cocok dengan model memakan akurasi: pengaturan thinking yang sudah dipensiunkan, aturan yang kontradiktif, dan scratchpad buatan sendiri yang berkonflik dengan thinking model sendiri masing-masing memulihkan 7 hingga 11 poin pada Opus 5 ketika dihapus:
Pola yang sama cenderung muncul dalam deskripsi alat dan skill, yang juga layak diaudit.
Tukar biaya dengan kecerdasan
Tuas-tuas ini menetapkan di mana satu model berada di antara biaya dan kecerdasan: pilihan model, effort, menjalankan ulang kegagalan pada pengaturan lebih tinggi, serta anggaran dan batas tempat ia bekerja. Mulailah dengan sweep effort pada model Anda saat ini (Setel effort). Dari biaya dan kemampuan terendah ke tertinggi, model saat ini adalah Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5, dan Claude Fable 5.1 (model frontier); Ikhtisar model memiliki jajaran lengkap dan harganya.
Bandingkan model berdasarkan biaya per tugas
Daftar harga ditulis per token, dan per token model frontier terlihat mahal: harga per token Claude Fable 5.1 beberapa kali lipat Claude Sonnet 5. Namun Anda membayar untuk tugas yang selesai, jadi bandingkan model berdasarkan biaya per tugas selesai. Model yang lebih mumpuni menyelesaikan tugas dengan lebih sedikit pekerjaan: lebih sedikit giliran, lebih sedikit pencarian, lebih sedikit membaca ulang konteksnya sendiri, dan lebih sedikit mundur. Premi per token sering kali tertutupi oleh melakukan lebih sedikit dari segalanya.
Anthropic mengukur ini pada subset SWE-bench Pro3, dihargai sebagaimana pelanggan ditagih:
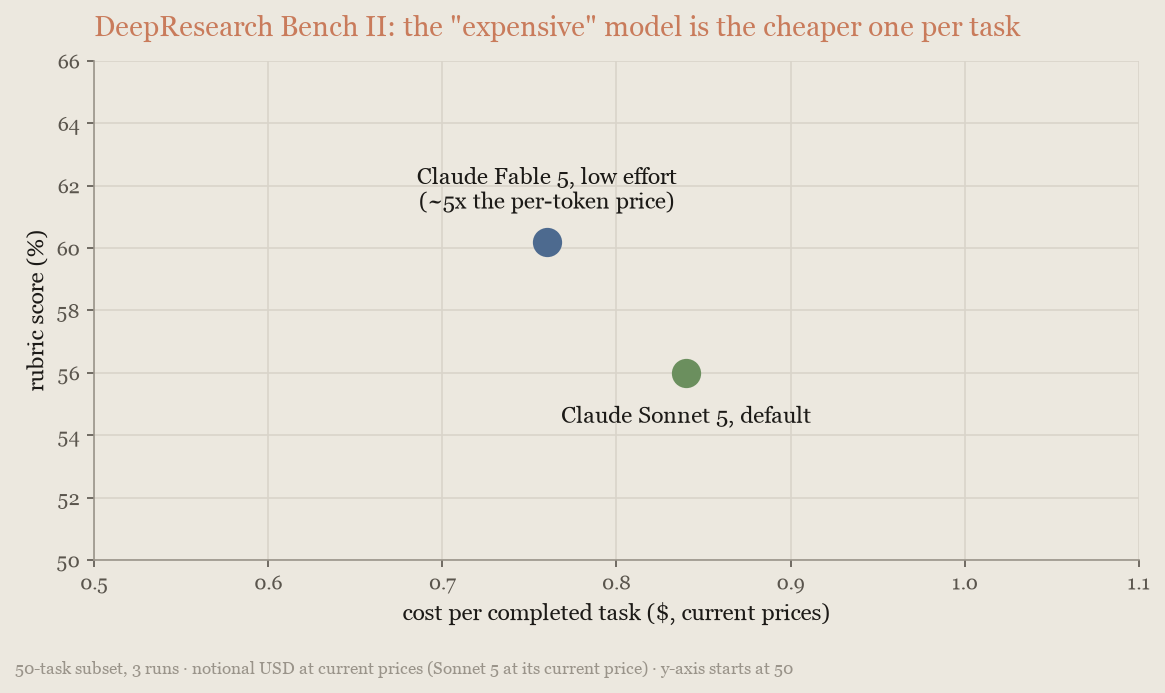
Claude Fable 5.1 pada effort low menyelesaikan 88,6% tugas dengan $0,54 per tugas terselesaikan, dibanding 77,4% dengan $0,84 dari Claude Sonnet 5 pada defaultnya: 11 poin lebih banyak dengan 35% lebih murah per tugas terselesaikan, meskipun harga per tokennya lima kali lebih tinggi. Namun ia tidak selalu menang. Pada subset yang sama, yang sebagian besar dijenuhkan kedua model dan yang skornya tidak sebanding dengan leaderboard publik, Claude Opus 5 sendirian menyamai Claude Fable 5.1 sendirian pada default (91,7% dibanding 92,1%, dalam noise antar-run) dengan sekitar 15% lebih murah per tugas terselesaikan ($1,01 dibanding $1,19), dan Opus 5 pada low menyelesaikan 84,0% dengan $0,25. Dan pada loop riset panjang model frontier melakukan lebih banyak pekerjaan, bukan lebih sedikit: pada DeepResearch Bench II7, Fable 5.1 pada low mencetak 10 poin di atas Sonnet 5 (66% dibanding 56%) dengan sekitar empat kali biaya per tugas ($4,66 dibanding $1,20), karena ia menjalankan loop riset lebih panjang atas konteks lebih besar. Claude Opus 5 pada defaultnya mencetak 71% dengan basis yang sama untuk $6,71 per tugas, di atas Fable 5.1 pada defaultnya (65% untuk $7,12), jadi pada riset pun Fable 5.1 layak harganya hanya pada low.
Untuk sebagian besar beban kerja agen, mulailah dengan Claude Fable 5.1 pada effort low dan naikkan effort di tempat ia meleset. Per token biayanya dua kali Claude Opus 5 pada input tak ter-cache, tetapi setengahnya pada input ter-cache ($0,25 dibanding $0,50 per juta), dan dalam loop agen input ter-cache adalah komponen terbesar. Pada benchmark coding di Strategi advisor, Fable 5.1 pada medium menyamai Opus 5 pada defaultnya dengan sekitar sepertiga biaya per percobaan ($2,91 dibanding $8,50). Pada Chartography13, benchmark pembacaan grafik, Fable 5.1 pada low mencetak 62,5 dengan $0,15 per grafik, dibanding 49 dengan $0,38 dari Opus 5 pada low. Pada subset SWE-bench Pro, Claude Opus 5 pada defaultnya tetap cara lebih murah menuju skor teratas, seperti dicatat sebelumnya. Di ujung lain, Claude Haiku 4.5 menjawab pertanyaan GPQA Diamond9 dengan sekitar sepersepuluh biaya per pertanyaan Opus 5, dengan akurasi 63% dibanding 92% untuk Opus, dan tertinggal jauh lebih banyak pada tugas coding panjang. Ia cocok untuk pekerjaan volume tinggi dengan output yang dapat diperiksa, bukan loop agentic panjang.
Peringkatnya berbalik menurut beban kerja, dan tidak ada daftar harga yang memberi tahu Anda ke arah mana. Hitung harga setiap kandidat dalam biaya per tugas selesai pada lalu lintas Anda sendiri, termasuk Claude Opus 5 dan model frontier pada effort yang dikurangi.
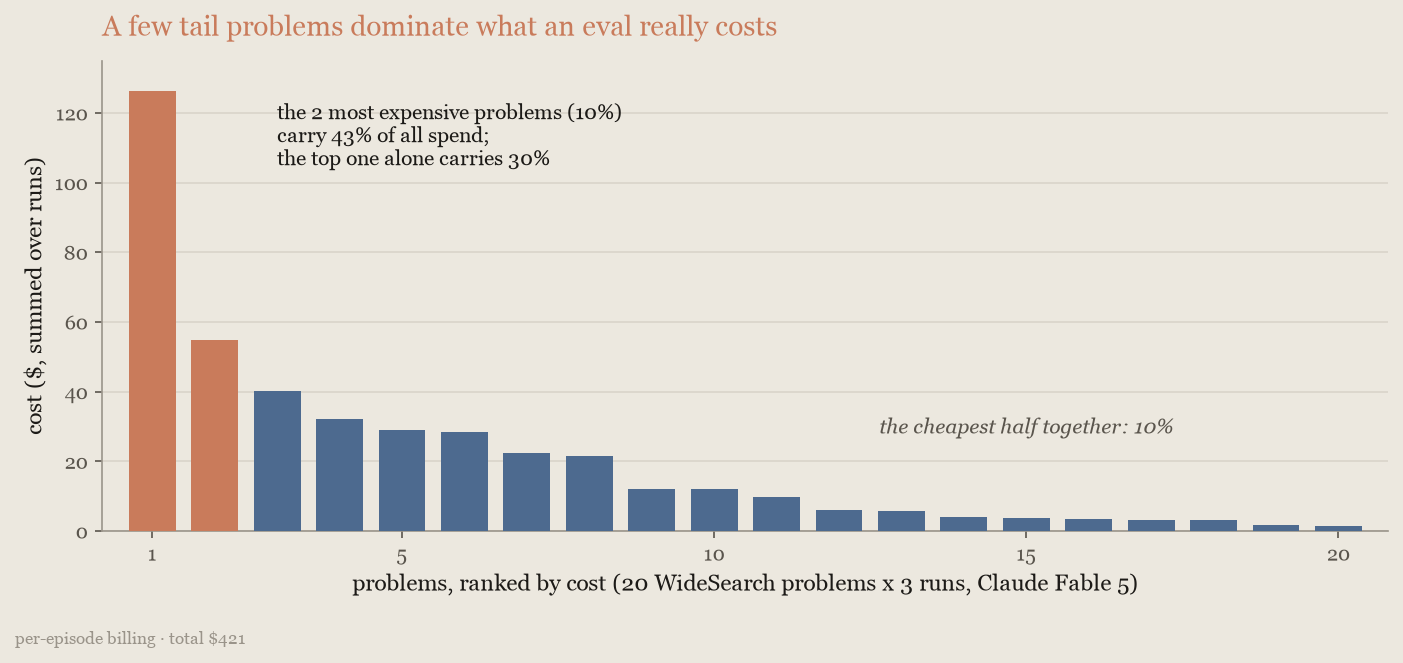
Hitung harga ekor beban kerja Anda, bukan mediannya: bandingkan model pada sepersepuluh tugas tersulit Anda, bukan yang tipikal. Pada tugas tipikal setiap model terlihat serupa dan yang termurah terlihat terbaik, tetapi tagihan ditentukan oleh tugas yang gagal dikerjakan model lebih murah, karena tugas gagal tetap menagih tokennya, lalu percobaan ulangnya, lalu apa pun biaya kegagalan itu di hilir. Ekor juga tempat uang mengalir bahkan ketika tidak ada yang gagal. Pada run WideSearch1 20 soal, dua soal menanggung 43% pengeluaran:
Strategi multi-model ada untuk membelanjakan kecerdasan frontier pada ekor itu tanpa membayar tarif frontier untuk sisanya.
Upgrade model
Jika Anda tertinggal satu atau dua model, tuas termurah adalah string model. Anthropic menjalankan model Claude Opus, Claude Sonnet, dan Claude Fable terbaru melalui harness yang sama pada subset SWE-bench Pro3, masing-masing pada default bawaannya dan dihargai pada tarif daftar, dan menjalankan lini Opus lagi pada Terminal-Bench 320:
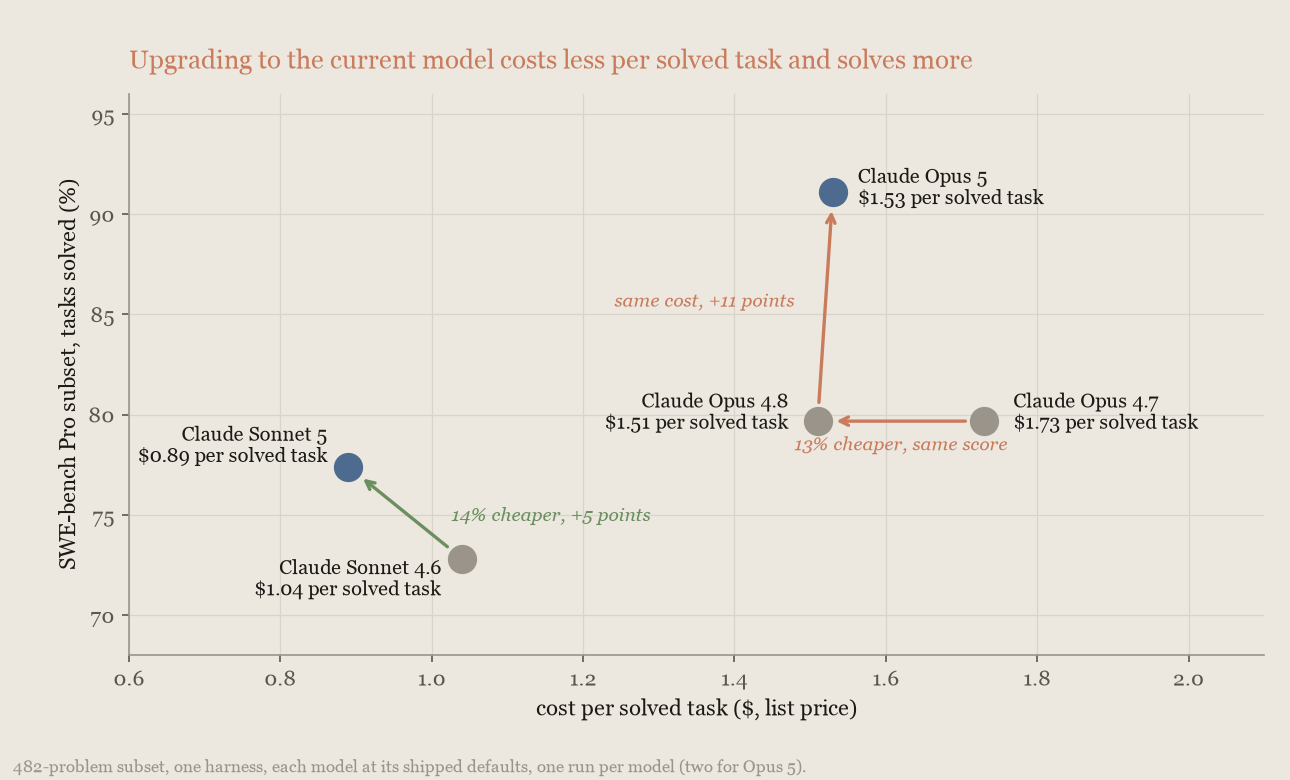
Anthropic menghargai lini Opus secara identik per token di semua versi, sehingga perbedaan apa pun berasal dari seberapa banyak pekerjaan yang dilakukan setiap model per tugas: dihargai sebagaimana pelanggan ditagih, Claude Opus 4.8 menyelesaikan porsi tugas yang sama dengan Claude Opus 4.7 dengan 14% lebih murah per tugas terselesaikan, dan Claude Opus 5 kemudian menyelesaikan 12 poin tugas lebih banyak dengan 21% lebih mahal per tugas terselesaikan. Claude Opus 5 pada effort low mengalahkan default Opus 4.8 pada benchmark ini dengan sekitar 30% biaya per tugas terselesaikannya, jadi upgrade termurah adalah model baru pada pengaturan lebih rendah. Penghematan Sonnet 5 berasal dari harga per tokennya yang lebih rendah, yang lebih dari mengimbangi token ekstra yang digunakannya per tugas dibanding Sonnet 4.6: 15% lebih murah per tugas terselesaikan untuk 5 poin lebih banyak. Tingkat frontier memperoleh keuntungan dengan cara yang sama: Claude Fable 5.1 menyamai skor Claude Fable 5 dengan 43% lebih murah per tugas terselesaikan, sebagian besar dari harga cache-read yang lebih rendah. Arah itu tidak dijamin: pada DeepResearch Bench II7 upgrade yang sama berbiaya 41% lebih mahal per tugas pada high (79% lebih mahal pada low) untuk 2 hingga 3 poin ekstranya pada tugas yang bersih di setiap arm (referensi 7), karena model baru melakukan lebih banyak pekerjaan per tugas di sana. Harga input dan output sama dan cache read 4x lebih murah, jadi ukur upgrade pada beban kerja Anda sendiri sebelum mengasumsikan ia menghemat.
Pada pekerjaan lebih sulit selisihnya melebar. Pada Terminal-Bench 320, di mana tugasnya cukup sulit sehingga tingkat kelulusan alih-alih token yang menentukan tagihan, Claude Opus 4.7, Opus 4.8, dan Opus 5 masing-masing menghabiskan $8 hingga $15 per tugas tetapi menyelesaikan 7%, 15%, dan 41% tugas, sehingga biaya per tugas terselesaikan turun dari $183 ke $63 ke $28 menaiki tangga. Premi 21% yang dibawa Claude Opus 5 atas Opus 4.8 pada subset coding yang jenuh menjadi penghematan 56% pada Terminal-Bench 3, di mana model lama sebagian besar gagal: semakin beban kerja Anda mengalahkan model lama, semakin banyak upgrade menghemat per hasil.
Bandingkan berdasarkan biaya per tugas terselesaikan, bukan per token: teks yang sama berbiaya sekitar 30% lebih banyak token pada Claude Opus 4.7 dan setelahnya, sehingga perbandingan per token membuat model lebih baru terlihat lebih mahal secara konstruksi.
Menyetel effort
Effort adalah cara paling langsung untuk menyetel model terhadap tugas Anda. Parameter effort mengatur seberapa banyak pemikiran, pemanggilan alat, dan verifikasi mandiri yang dilakukan model, dan nilai default-nya (high) cocok untuk tugas yang menuntut. Biaya meningkat seiring semua aktivitas itu; akurasi hanya meningkat seiring bagian yang dibutuhkan tugas Anda. Di bawah batas atas kemampuan model, tingkat effort tertinggi membayar kedalaman yang tidak pernah digunakan oleh tugas.
Pada benchmark riset dan pekerjaan pengetahuan (WideSearch1, DeepWideSearch6, BrowseComp4, dan GDPval2, semuanya dengan Claude Fable 5), kurva akurasi terhadap biaya hampir datar: low mengorbankan 1 hingga 3 poin untuk pengurangan sepertiga hingga setengah biaya per tugas, medium menyamai akurasi default dengan sekitar 70% hingga 87% dari biayanya, dan default tidak memberikan apa pun yang terukur di atas medium pada keempat benchmark tersebut. Pada DeepWideSearch, low juga menyamai orchestrator dengan worker Claude Sonnet 5 dengan biaya 29% lebih rendah: menurunkan effort mengalahkan perubahan arsitektur.
Pengaturan effort yang lebih rendah sering kali lebih cepat, yang penting ketika "latency" (latensi) menjadi kendala. Dalam pengujian ini, low membutuhkan 4,5 menit per masalah pada DeepWideSearch, dibandingkan dengan 7,9 menit pada default. Pada benchmark korpus, yang inputnya tidak muat dalam satu "context window" (jendela konteks) mana pun, Fable 5.1 membutuhkan 15,2, 17,5, dan 19,9 jam per episode pada low, medium, dan high.
Coding jangka panjang adalah tempat effort benar-benar membeli akurasi. Pada SWE-bench Pro3, Claude Opus 5 mengorbankan sekitar 2 poin pada medium untuk setengah biaya dan sekitar 8 poin pada low untuk seperempatnya: sebuah tradeoff nyata, yang diubah kembali menjadi penghematan oleh menjalankan ulang kegagalan pada effort lebih tinggi. Grafik ini memplot akurasi terhadap biaya untuk benchmark riset dan pekerjaan pengetahuan serta untuk SWE-bench Pro:
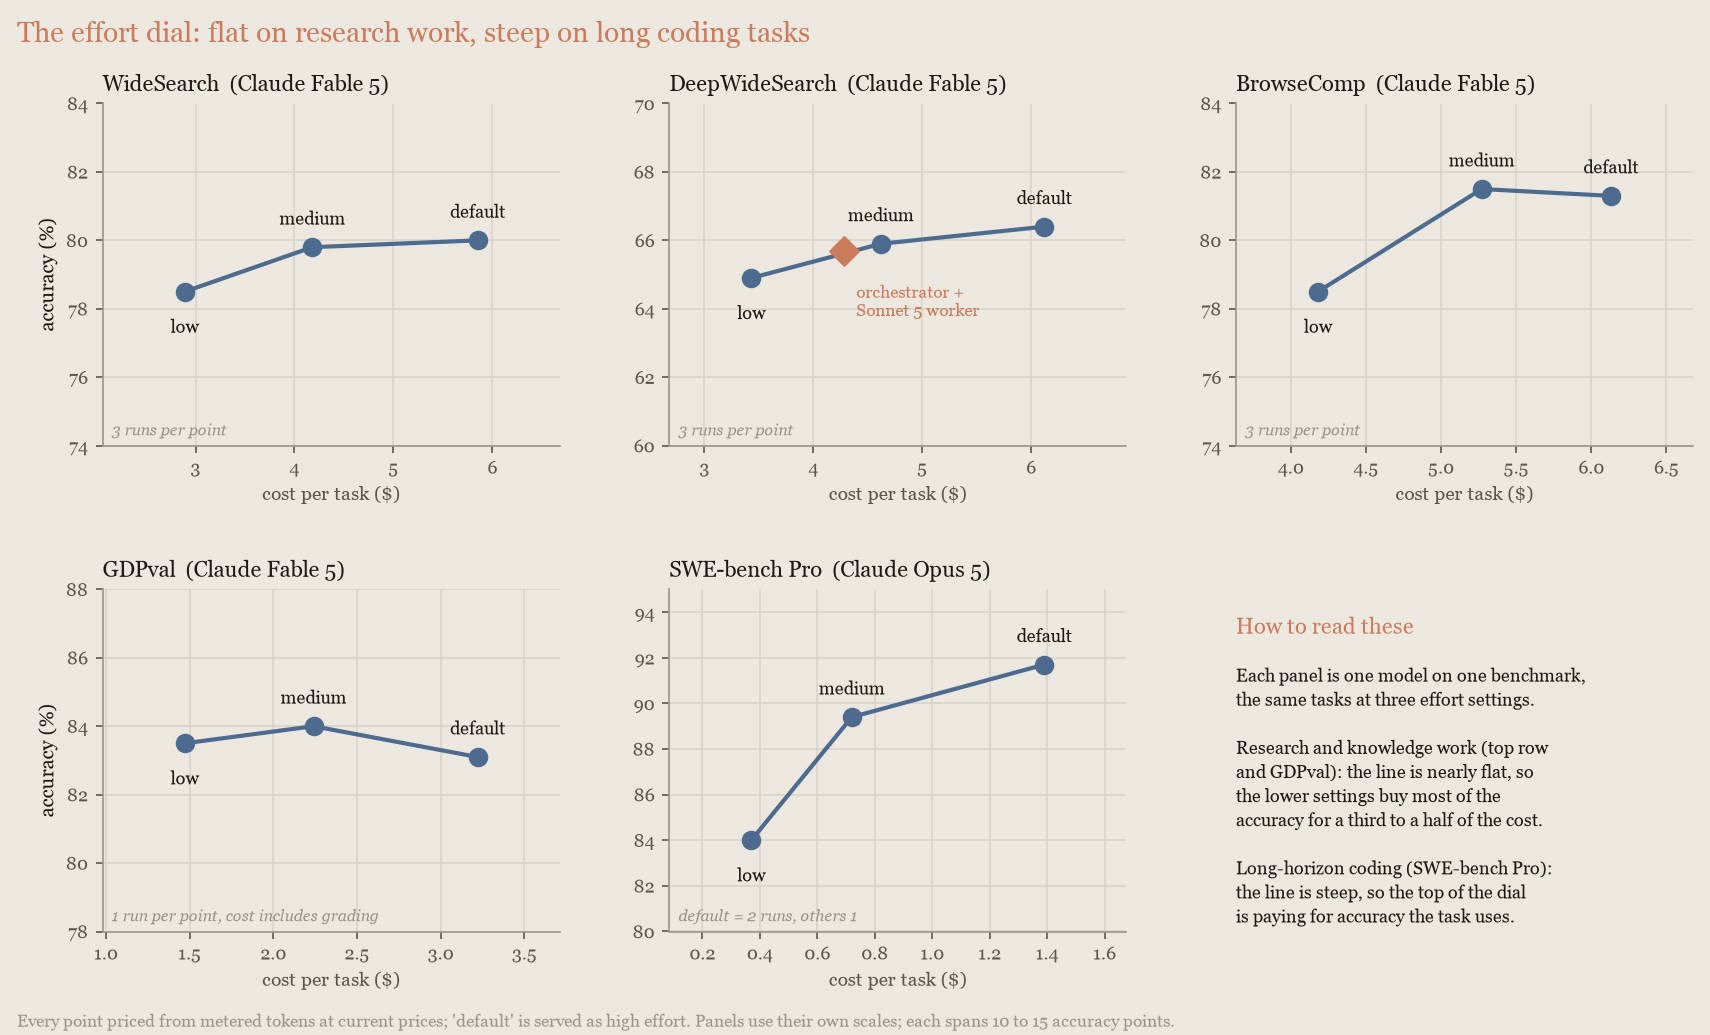
Ada dua konsekuensi. Pertama, gambarlah kurva ini untuk beban kerja Anda sendiri sebelum menambahkan model kedua: dalam pengukuran internal ini, konfigurasi multi-model yang tampak lebih murah daripada model tunggal default ternyata lebih mahal daripada model yang sama pada effort lebih rendah. Kedua, kurva ini adalah baseline model tunggal yang harus dikalahkan oleh strategi multi-model apa pun, sehingga langkah 2 dari mengukur pada beban kerja Anda sendiri membuat baseline di seluruh tingkat effort.
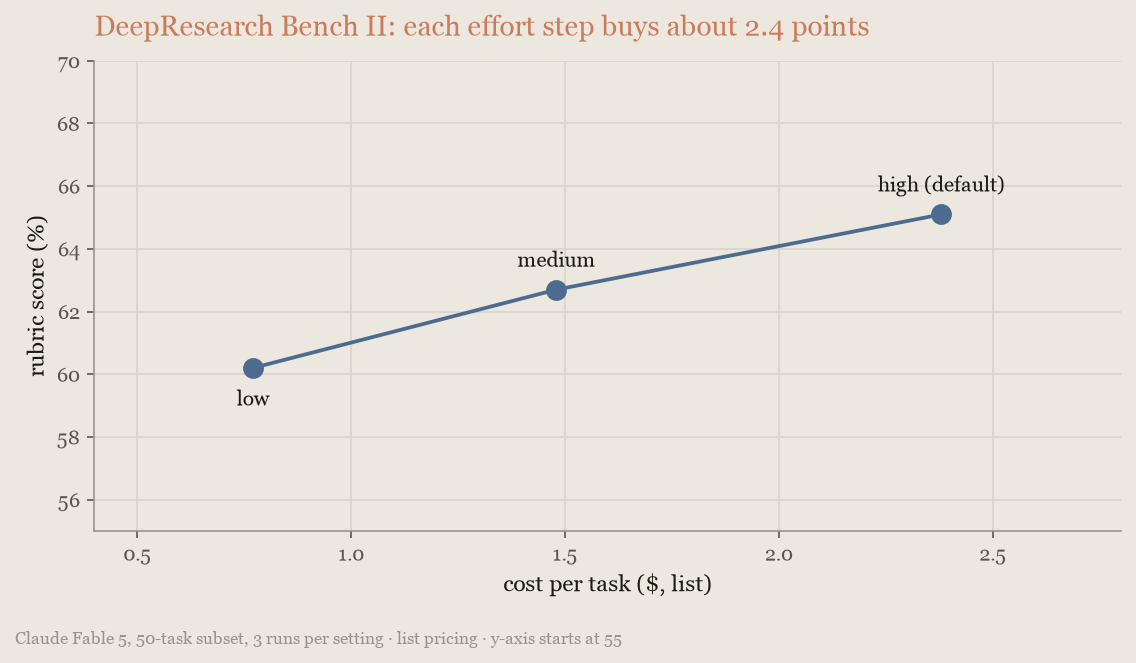
Pekerjaan sulit tidak otomatis membutuhkan effort tinggi. Pada DeepResearch Bench II7, Claude Fable 5.1 mencetak skor yang hampir sama pada low, medium, dan high sementara biaya per tugas naik dari $4,66 menjadi $7,12, sehingga menaikkan effort dalam kasus ini tidak meningkatkan kualitas output secara nyata; pada 21 tugas yang bersih di setiap kelompok (referensi 7), Claude Fable 5 juga datar di seluruh effort, meskipun basis 33 tugas pada grafik, yang membuang upaya terpotong milik masing-masing model, menunjukkannya naik. Ukur kurva pada model yang Anda rilis, bukan model yang terakhir Anda ukur:
Deskripsi tugas saja tidak mengungkapkan jenis beban kerja mana yang Anda miliki, jadi sapu dua atau tiga tingkat effort pada sampel lalu lintas Anda sendiri dan baca jawabannya dari kurva. Uji setiap tingkat dalam sesi terpisah: mengubah effort tingkat atas di tengah sesi membatalkan cache (lihat Cache konteks berulang) dan mendistorsi perbandingan. Untuk detail parameter, lihat Effort.
Menjalankan ulang kegagalan pada effort lebih tinggi
Ketika hasil suatu tugas dapat diperiksa, kebijakan termurah pada kurva effort bukanlah pengaturan tetap: jalankan setiap tugas pada pengaturan rendah dan jalankan ulang hanya yang gagal pada pengaturan lebih tinggi.
Anthropic menghitung kebijakan ini tugas demi tugas dari pengujian effort pada subset SWE-bench Pro3 di Menyetel effort. Dengan Claude Opus 5 pada low, 16% tugas gagal; dengan tugas-tugas itu dijalankan ulang pada default, sekitar 93% lulus dengan biaya sekitar $0,45 masing-masing, dibandingkan 91,7% dengan biaya $0,93 jika menjalankan semuanya pada default: tingkat kelulusan yang sama untuk setengah biaya, termasuk upaya murah yang gagal. Memulai dari medium justru menyelesaikan sekitar 94% dengan biaya sekitar $0,61. Sebagian besar peningkatan kecil itu berasal dari upaya kedua (menjalankan ulang kegagalan default sendiri pada default menghasilkan skor yang kira-kira sama, dengan biaya lebih besar), jadi gunakan kebijakan ini untuk penghematannya, bukan peningkatannya:
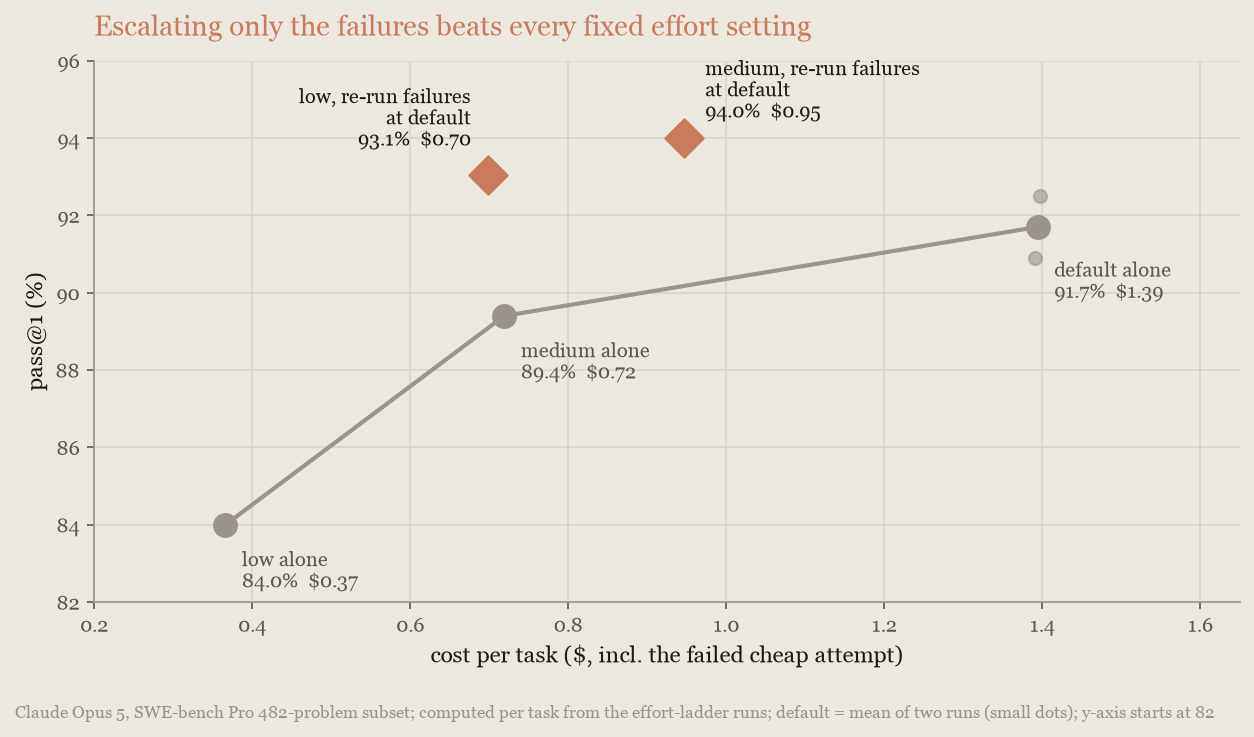
Ada dua syarat. Pertama, Anda membutuhkan sinyal kegagalan (di sini, pengujian milik benchmark itu sendiri); pemeriksa yang meluluskan pekerjaan buruk membiarkan kegagalan itu lolos. Kedua, setiap kegagalan pada putaran pertama memakan waktu nyata setara dua kali pengujian, sehingga penghematan dibayar dengan latensi pada tugas yang gagal.
Menetapkan anggaran dan batas output
Sebagian besar pengujian tugas agentic murah, tetapi sebagian kecil menghabiskan berkali-kali lipat biaya median untuk pencarian, verifikasi ulang, dan pengujian berlebihan. Anggaran tugas menargetkan ekor tersebut. Model melihat hitungan mundur token secara langsung untuk seluruh tugas dan mengatur dirinya sendiri, memangkas pencarian bernilai rendah, melewati verifikasi yang berlebihan, dan menyelesaikan pekerjaan alih-alih berputar tanpa akhir.
Anthropic mengukur tingkat kelulusan dan biaya per tugas pada SWE-bench Pro3 dengan Claude Fable 5.1 saat anggaran diperketat:
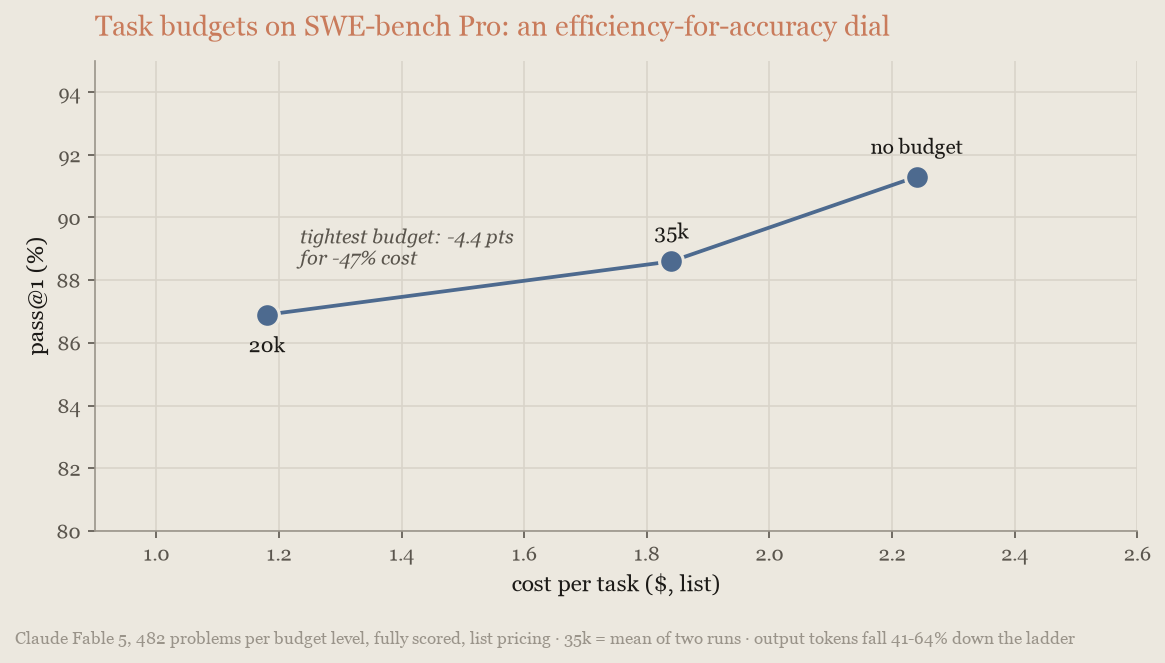
Anggaran yang longgar memangkas biaya per tugas 44% dengan pengorbanan sekitar 3 poin tingkat kelulusan, di tepi noise antar-pengujian, dan anggaran terketat yang diizinkan memangkasnya 58% dengan pengorbanan 6 poin. Anggaran membeli efisiensi di sini, dengan harga berupa tingkat kelulusan yang membesar seiring anggaran diperketat.
Tiga kontrol melakukan tiga pekerjaan berbeda. Anggaran tugas menghemat uang, karena model melihatnya. max_tokens adalah batas pengaman: menurunkannya memangkas biaya per upaya tanpa menurunkan biaya per tugas yang terselesaikan. Pada Claude Managed Agents, anggaran sesi adalah penghentian keras dalam dolar di belakang keduanya. Tetapkan ketiganya: anggaran tugas, max_tokens yang tinggi, dan batas sesi untuk pengujian yang tidak pernah Anda inginkan muncul di tagihan, dengan batas pengeluaran workspace sebagai penahan terakhir.
- Anggaran tugas berada dalam beta (header beta
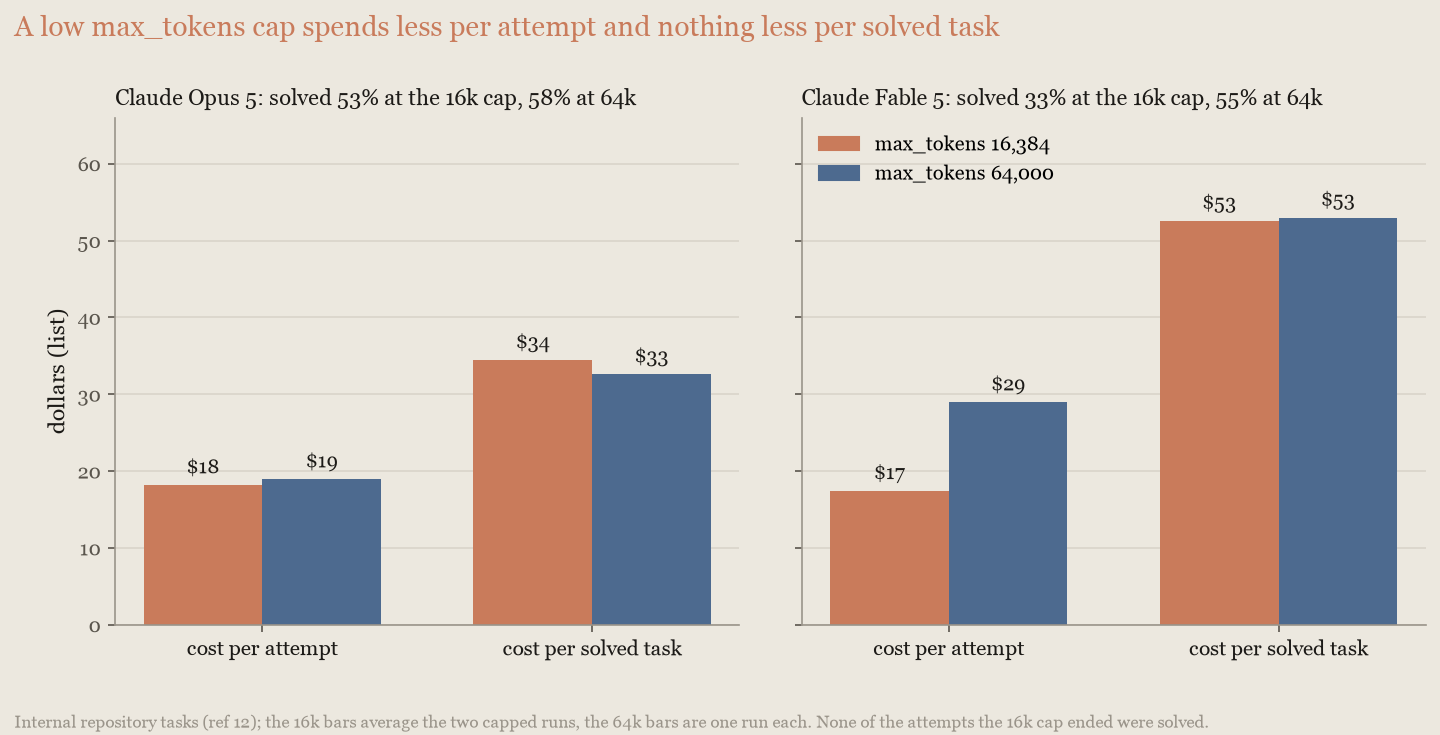
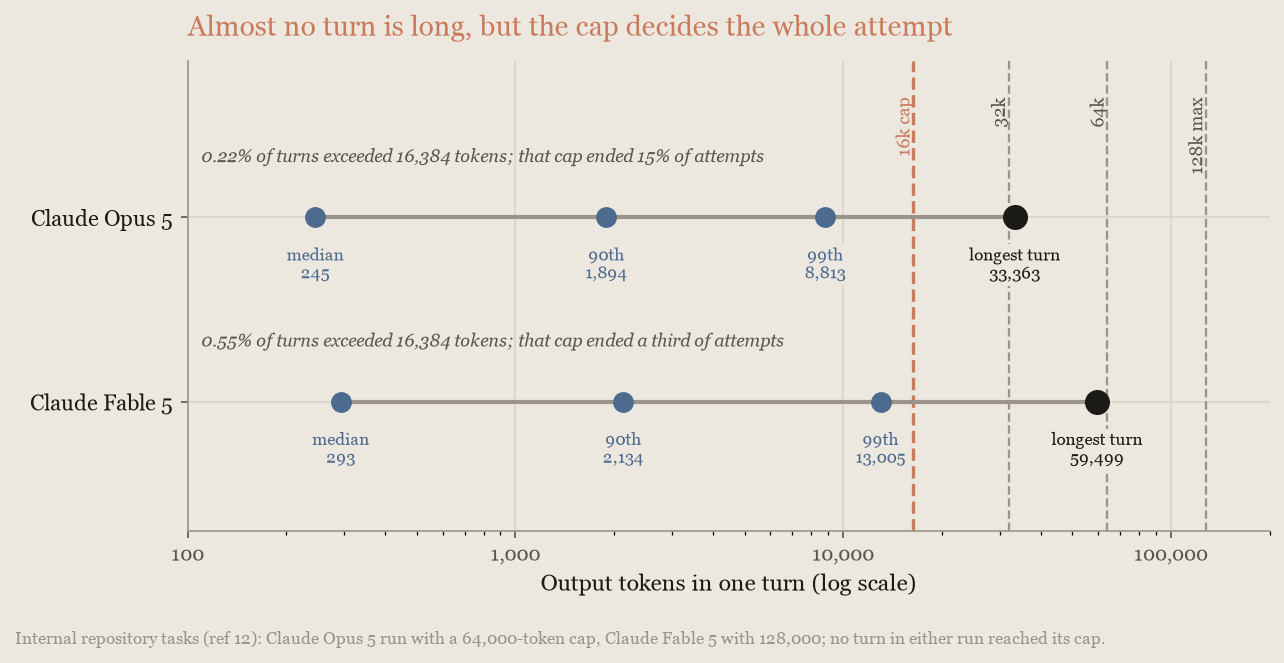
task-budgets-2026-03-13) pada model-model terbaru; periksa tabel dukungan untuk mengetahui model mana. Mulailah di dekat penggunaan token persentil ke-90 dari loop Anda, lalu perketat (Memilih anggaran menunjukkan cara mengumpulkan distribusi tersebut). Anggaran di bawah batas bawah 20.000 token saat ini ditolak, dan anggaran yang sangat ketat dapat menghasilkan perilaku seperti penolakan. Tetapkan anggaran sekali, pada permintaan pertama, karena perubahan di tengah tugas membatalkan cache. Anggaran bersifat anjuran, mengarahkan model alih-alih menghentikannya, jadi verifikasi kepatuhannya pada beban kerja Anda. max_tokensmembatasi satu respons, tanpa terlihat oleh model, sehingga menurunkannya tidak membuat model berhemat. Giliran yang membutuhkan ruang itu dibuang dan tetap ditagih. Pada benchmark tugas repositori internal12, batas 16.384 token mengakhiri 15% upaya Claude Opus 5 dan 43% upaya Claude Fable 5.1 pada effort default, dan hanya 9 dari 117 upaya Fable yang terbatasi masih lulus. Pengujian yang terbatasi menghabiskan lebih sedikit per upaya tetapi membeli penyelesaian yang secara proporsional lebih sedikit, sehingga biaya per tugas yang terselesaikan kira-kira sama dengan pada 64.000 ($21 dibandingkan $22). Pada 64.000, 2 dari sekitar 14.000 giliran pada effort default masih terpotong, dan Fable 5.1 menyelesaikan 58,5% tugas alih-alih 36,3% (pada potongan terpisah dari subset SWE-bench Pro3, yang dijelaskan dalam referensi 12, tidak ada perbedaan: 94 dari 100 pada kedua batas). Mencoba ulang upaya yang terbatasi jarang membantu: pada batas yang sama sebagian besar gagal lagi, dan pada batas lebih tinggi Anda juga membayar upaya yang terbuang. Tetapkanmax_tokenske 64.000 untuk pekerjaan agentic, atau ke 128.000, nilai maksimum, ketika satu upaya yang terpotong berbiaya mahal; pada 128.000 Fable 5.1 menyelesaikan 60,0% dengan biaya per tugas terselesaikan yang sama. Stream respons sebesar itu, perlakukanstop_reason: max_tokenssebagai kegagalan, dan hemat uang dengan effort dan anggaran tugas, yang dapat dilihat oleh model.- Anggaran sesi pada Claude Managed Agents adalah penghentian keras. Anggaran sesi adalah batas dolar pada satu sesi dengan tarif daftar untuk token, pencarian, dan waktu sesi. Pada batas tersebut, sesi dijeda dengan
stop_reason: budget_reached; menaikkan anggaran melanjutkannya. Anggaran ini ditegakkan oleh platform, berfungsi pada model apa pun yang memiliki harga daftar, termasuk model yang belum mendukung anggaran tugas, dan dapat digabungkan dengan anggaran tugas yang bersifat anjuran. Deployment menerapkan field yang sama ke setiap pengujian.
Mintalah jawaban yang lebih pendek. Token output berbiaya lima kali token input pada Claude Sonnet 5, dan dalam loop agen setiap token yang ditulis model kembali sebagai input pada setiap giliran berikutnya, sehingga Anda membayar jawaban panjang berulang kali. Anthropic menjalankan pekerjaan triase dengan tiga instruksi jawaban akhir, masing-masing tiga pengujian, dengan model dan alat yang sama. Versi asli meminta dua baris:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>Varian yang lebih pendek meminta satu:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.Varian yang lebih panjang meminta memo dengan lima bagian berjudul: ringkasan masalah, bukti, pemeriksaan duplikat, label yang direkomendasikan, dan langkah selanjutnya. Untuk satu issue, prompt dalam antrean yang tidak pernah terkirim setelah pertanyaan yang dilewati, dua jawaban pertama adalah:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.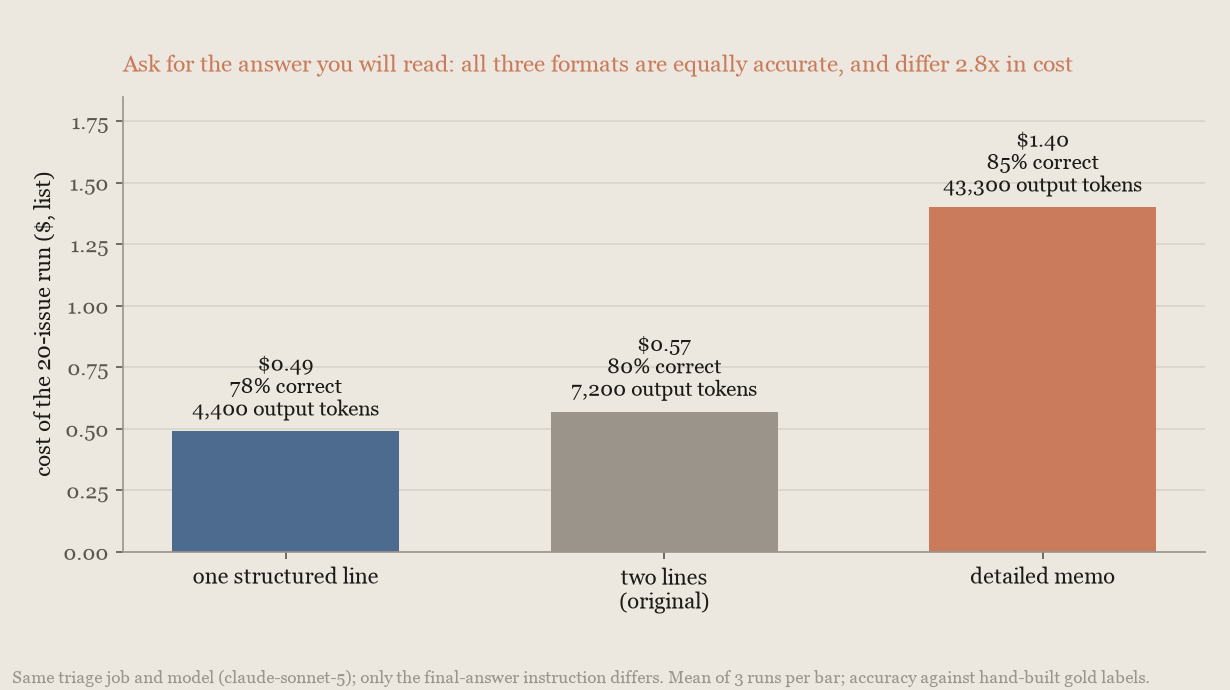
Jawaban satu baris menggunakan 39% lebih sedikit token output daripada versi asli dua baris dan berbiaya 14% lebih rendah per pengujian. Memo menggunakan enam kali token output dan berbiaya 2,8 kali jawaban satu baris. Ketiganya mencetak skor dalam rentang noise antar-pengujian satu sama lain terhadap label gold, sehingga format-format tersebut jauh lebih berbeda dalam apa yang Anda bayar daripada dalam apa yang mereka jawab dengan benar. Mintalah jawaban yang akan Anda baca, bukan yang terlihat menyeluruh.
Pada batas max_tokens yang lebih rendah kedua model menghabiskan lebih sedikit per upaya tetapi menyelesaikan tugas yang secara proporsional lebih sedikit, sehingga biaya per tugas terselesaikan hampir tidak bergerak:
Hampir setiap giliran selesai jauh di bawah kedua batas. Giliran panjang yang langka adalah apa yang dibeli oleh batas lebih tinggi:
Menggabungkan model
Arsitektur multi-model cocok untuk beban kerja yang kompleksitas tugasnya cukup bervariasi sehingga langkah-langkah berbeda paling baik dilayani oleh model berbeda. Ketika lalu lintas Anda mencampur pekerjaan rutin yang ditangani model lebih kecil dengan andal dengan langkah-langkah lebih sulit yang membutuhkan kemampuan frontier, membagi pekerjaan menjaga kecerdasan frontier di tempat yang penting sementara sebagian besar token ditagih dengan tarif model lebih kecil. Ketika beban kerja tidak memiliki campuran itu, karena kesulitannya seragam atau berupa satu rantai yang saling bergantung, satu model yang disetel dengan baik biasanya merupakan pilihan yang lebih baik. Setiap bagian strategi memberikan aturan untuk membedakan kedua kasus tersebut.
Dua strategi mencakup sebagian besar beban kerja, dan keduanya berbeda dalam model mana yang memegang loop utama:
| Strategi | Alur kontrol | Peran model frontier | Cocok untuk | Biaya frontier meningkat seiring |
|---|---|---|---|---|
| Advisor | Model lebih kecil menjalankan loop, mengeskalasi sesuai kebutuhan | Dikonsultasikan untuk rencana dan koreksi | Pekerjaan serial yang sulit di beberapa titik, seperti banyak giliran agen coding di antara beberapa keputusan nyata | Seberapa sering executor macet |
| Orchestrator | Model frontier menjalankan loop, mendelegasikan pekerjaan massal | Merencanakan, mengirim, dan mensintesis | Pekerjaan yang menyebar ke file, dokumen, atau kasus yang benar-benar independen, terutama yang lebih dari satu jendela konteks | Seberapa sulit bagian-bagiannya dikoordinasikan |
Strategi advisor: mengeskalasi keputusan sulit
Dalam strategi advisor, model executor berbiaya lebih rendah menjalankan loop agen dan melakukan sebagian besar giliran. Ketika menemui keputusan yang membutuhkan penilaian lebih dalam, seperti memilih pendekatan atau memulihkan diri dari kegagalan, ia memanggil model advisor berkecerdasan lebih tinggi untuk panduan strategis, lalu melanjutkan. Sebagian besar token ditagih dengan tarif executor, dan hanya konsultasi sesekali dengan tarif advisor.
Untuk menggunakannya, tambahkan alat advisor ke permintaan Anda. Fitur beta ini menjalankan seluruh strategi di sisi server dalam satu permintaan /v1/messages: executor mengeluarkan panggilan alat, Anthropic menjalankan inferensi advisor, dan executor melanjutkan dengan saran tersebut; Anda tidak menulis kode orkestrasi apa pun. Pada Claude Managed Agents, berikan sesi sebuah advisor dengan menambahkan entri advisor ke roster multiagent milik agen; thread utama sesi mengonsultasikannya dengan cara yang sama. Claude Code juga mendukungnya; lihat mengeskalasi keputusan sulit dengan alat advisor.
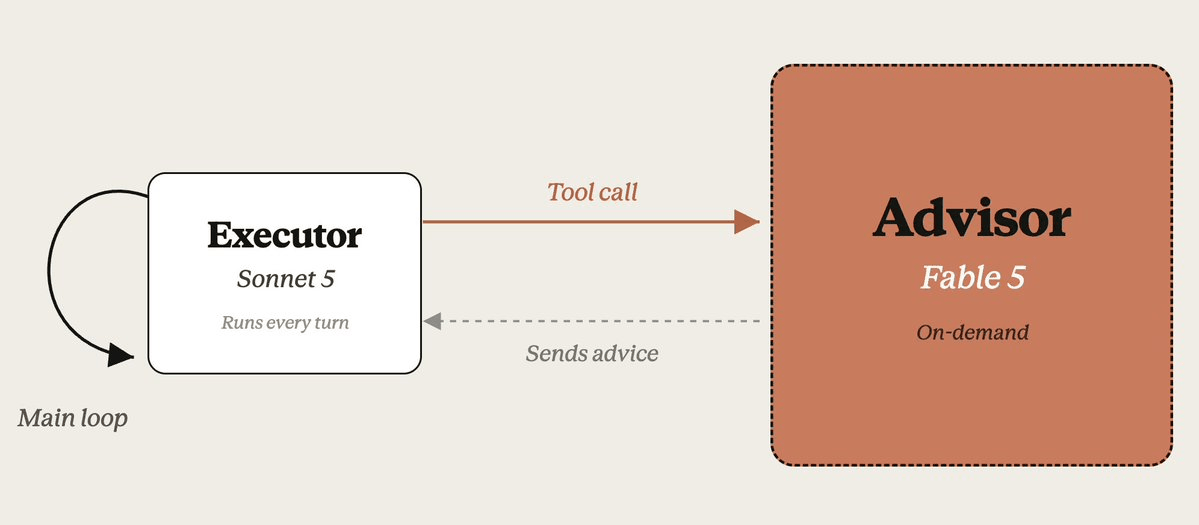
Apa yang menentukan hasilnya. Advisor melihat tugas hanya melalui panggilan executor, sehingga dua hal menentukan seberapa banyak ia membantu.
Yang pertama adalah kesenjangan antara model. Advisor hanya dapat menyerahkan kemampuan yang tidak dimiliki executor: pada GPQA Diamond9 executor Claude Haiku 4.5 memperoleh banyak dari advisor Claude Opus 5, executor Claude Sonnet 5 memperoleh beberapa poin, dan executor frontier hampir tidak memperoleh apa pun.
Yang kedua, dan yang rapuh, adalah apakah executor benar-benar bertanya (tingkat konsultasi). Executor pada effort rendah dapat berhenti mendeteksi bahwa ia macet: pasangan yang berkonsultasi pada sebagian besar tugas pada effort default dapat turun menjadi hampir tidak berkonsultasi sama sekali ketika effort diturunkan, dan kemudian mencetak skor di bawah executor sendirian. Tingkat ini juga bervariasi menurut tugas: pada DeepSWE10 executor Sonnet 5 effort rendah terus bertanya dan memperoleh 23 poin; pada SWE-bench Pro3 executor yang sama berhenti. Ketika executor bertanya, ia memulihkan sebagian besar kesenjangan. Di seluruh pasangan dalam grafik berikut yang executor-nya terus bertanya, advisor menutup setidaknya setengah kesenjangan ke model yang lebih kuat (pasangan coding mengalahkan model yang lebih kuat secara langsung), dan Anda membayar model yang lebih kuat hanya pada konsultasi, yang memungkinkan kasus-kasus biaya tersebut:
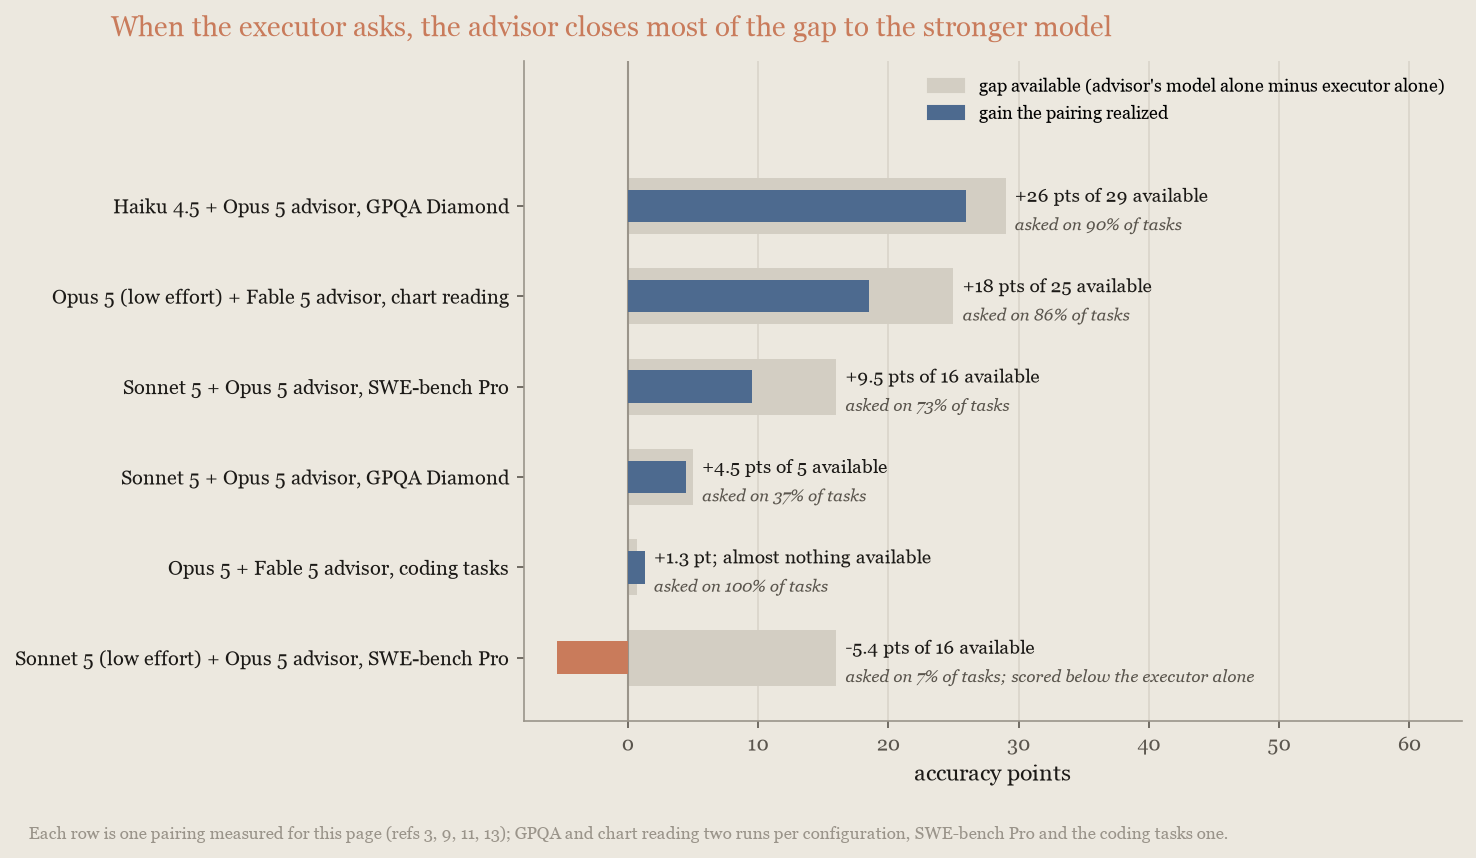
Tingkat konsultasi merespons prompting. Dengan hanya deskripsi bawaan alat, executor kurang memanggil, terutama pada pekerjaan coding, sehingga dokumentasi alat advisor memberikan "system prompt" (prompt sistem) yang meminta satu panggilan sebelum pekerjaan substantif dan satu sebelum menyelesaikan, sekitar dua hingga tiga panggilan per tugas. Pasangan coding yang diukur berikutnya berjalan pada irama itu, sekitar dua konsultasi pada setiap tugas. Halaman itu juga membahas cara mendorong executor yang kurang memanggil dan membatasi panggilan di sisi klien untuk membatasi biaya. Jadi perhatikan tingkat konsultasi: buat prompt untuknya, ukur, dan pulihkan effort executor jika tingkatnya runtuh.
Kapan menguntungkan dari sisi biaya. Advisor menghemat uang ketika beberapa konsultasi singkat, yang ditagih dengan tarif advisor, menggantikan menjalankan model advisor untuk seluruh tugas. Itu bekerja paling baik ketika model advisor berharga jauh di atas executor, sehingga konfigurasi paling hemat biaya adalah advisor frontier di atas executor tingkat menengah. Sebuah pasangan dapat bertahan bahkan di puncak rentang, karena saran juga menghemat token executor: executor yang diberi tahu pendekatan yang tepat menjelajahi lebih sedikit jalan buntu, yang dapat menutupi biaya konsultasi.
Pada benchmark agentic-coding internal11, yang dijalankan dengan agen API biasa, executor Claude Opus 5 dengan advisor Claude Fable 5.1 adalah konfigurasi paling akurat yang diukur, dengan biaya $7,69 per upaya. Ia berada di atas garis yang melalui pengaturan effort masing-masing model: 3,5 poin di atas Opus 5 sendirian pada pengaturan default dengan biaya sedikit lebih rendah, kesenjangan yang memang dipisahkan dari noise oleh lima upaya per tugas, dan sekitar 2,5 poin di atas model advisor sendirian dengan biaya sekitar satu setengah kalinya:
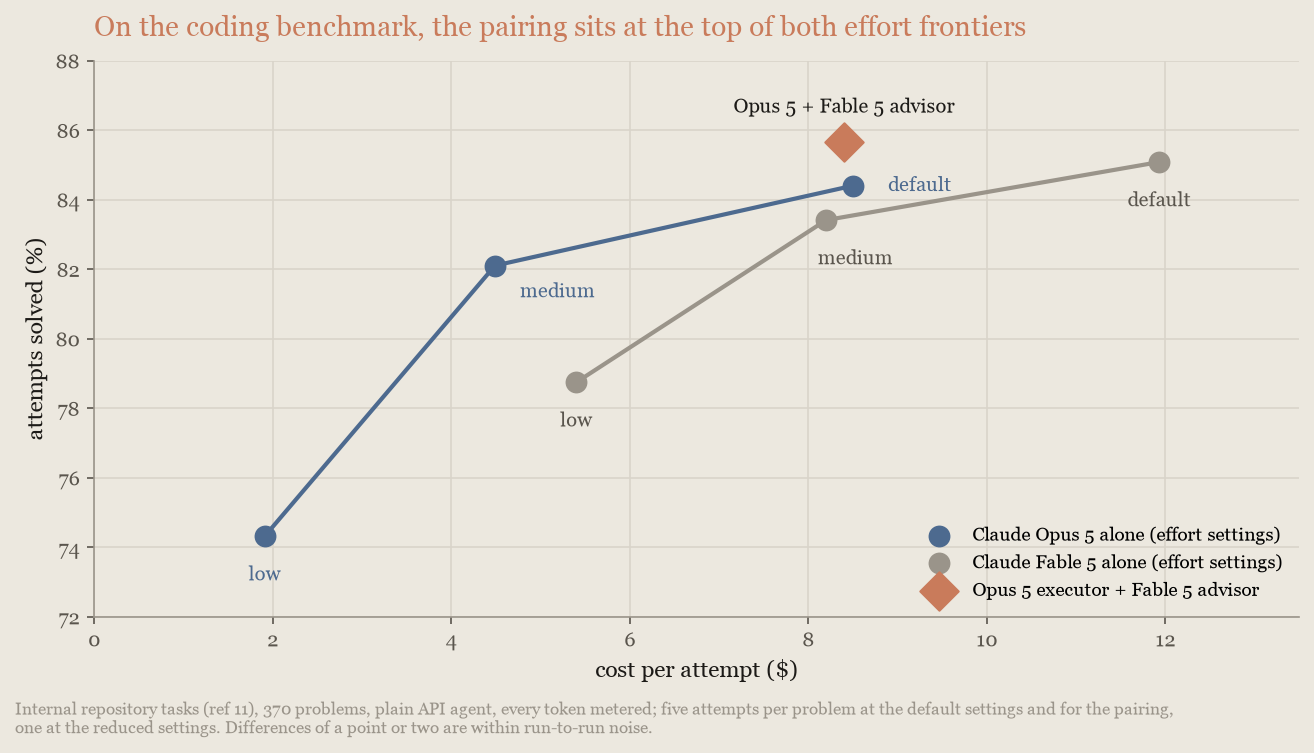
Pengukuran sebelumnya melalui mode advisor Claude Code menghasilkan urutan yang sama. Baca hasil ini sebagai bentuk untuk diuji pada beban kerja Anda: advisor membeli beberapa poin dengan harga kira-kira sama dengan executor itu sendiri. Kesenjangan kemampuan yang lebih lebar tidak menjamin kesepakatan yang lebih baik. Biaya latensinya adalah konsultasi itu sendiri: sekitar dua panggilan model frontier tambahan per tugas pada benchmark ini, masing-masing berada di jalur kritis tugas.
Kapan model yang lebih kuat sendirian adalah langkah yang lebih baik. Ketika akurasi beban kerja merespons effort, bandingkan pasangan tersebut dengan model advisor sendirian pada pengaturan yang dikurangi sebelum membangunnya: advisor dibayar hanya pada tugas yang membutuhkannya, tetapi konsultasi yang terpicu pada sebagian besar tugas berbiaya lebih mahal daripada menjalankan model yang lebih kuat itu sendiri. Pada Chartography13 pasangan yang sama menyamai Claude Fable 5.1 sendirian pada medium dalam rentang noise antar-pengujian (65,0 dibandingkan 67,5) dengan biaya per tugas sekitar 2,6 kali, karena advisor dikonsultasikan pada hampir setiap tugas. Ukur tingkat konsultasi Anda sendiri terlebih dahulu: jika executor bertanya pada sebagian besar tugasnya, Anda membayar tarif advisor di seluruh beban kerja, dan menjalankan model advisor itu sendiri adalah cara yang lebih murah menuju skor yang sama.
Apa pun pasangannya, pertama-tama hitung harga model advisor sendirian pada effort rendah; itulah baseline yang harus dikalahkan. Periksa ulang pada setiap rilis model, karena rilis menggeser baik kesenjangan kemampuan maupun rasio harga.
Kapan cocok. Strategi advisor cocok untuk beban kerja yang gilirannya sebagian besar mekanis tetapi rencana yang sangat baik penting: agen coding, computer use, dan pipeline riset multilangkah. Strategi ini kurang cocok ketika setiap giliran benar-benar membutuhkan kemampuan frontier, ketika tidak ada yang perlu direncanakan (tanya jawab satu giliran), atau ketika executor Anda sudah mendekati kemampuan advisor.
Strategi orchestrator: mendelegasikan pekerjaan massal
Dalam strategi orchestrator, model frontier memegang loop. Ia menguraikan tugas, mengirim subtugas ke model worker berbiaya lebih rendah, dan menggabungkan hasilnya. Transkrip orchestrator sendiri tetap pendek karena worker menyerap eksplorasi yang padat token, sehingga sebagian besar token ditagih dengan tarif worker sementara rencana dan sintesis tetap berasal dari model frontier.
Untuk membangunnya, gunakan orkestrasi multiagen di Claude Managed Agents: konfigurasikan agen koordinator (orchestrator) dan roster agen worker, masing-masing dengan modelnya sendiri. Untuk contoh kerja lengkap dengan koordinator frontier dan worker Claude Sonnet 5, lihat resep Claude Cookbook Coordinator pattern: big models for planning, small models for execution.
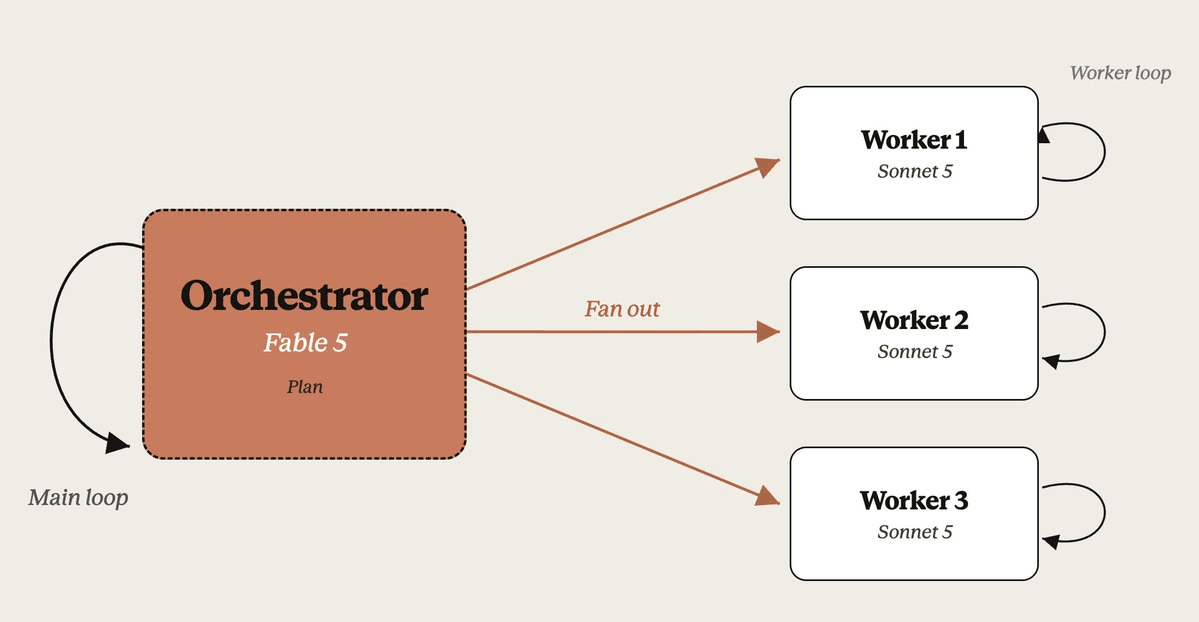
Pola ini menghemat waktu nyata ketika worker dapat berjalan paralel: pada benchmark korpus8, satu episode membutuhkan sekitar 2,3 jam dengan koordinator menjalankan batas terdokumentasi platform sebanyak 25 worker bersamaan, dibandingkan dengan 15 hingga 20 jam secara solo. Pola ini menghemat uang hanya dalam dua situasi yang diukur. Pada pekerjaan yang dapat ditangani satu model sendirian, model yang sama pada effort lebih rendah selalu lebih murah.
Kasus 1: asuransi terhadap ekor biaya pada pekerjaan rutin. Model frontier yang berjalan sendirian sesekali berputar tanpa akhir pada masalah rutin yang biasanya ia selesaikan. Karena Anda tidak dapat mengetahui sebelumnya masalah mana itu, beberapa pengujian seperti itu mendominasi tagihan. Koordinator yang menyerahkan pekerjaan rutin ke worker berbiaya lebih rendah membatasi ekor itu, karena setiap putaran tanpa akhir kini terjadi dengan tarif worker.
Anthropic mengukur ini pada potongan BrowseComp4 yang sengaja dibuat mudah (10 masalah yang diselesaikan model solo dengan andal; 50 pengujian terdelegasi dan 70 pengujian solo). Koordinator Claude Fable 5 dengan satu worker Claude Sonnet 5 berbiaya sekitar setengah dari Claude Fable 5 sendirian secara rata-rata dan sekitar sepertiga pada persentil ke-90 ($12 dibandingkan $33), dan satu pengujian termahal model solo, seharga $84, juga salah:
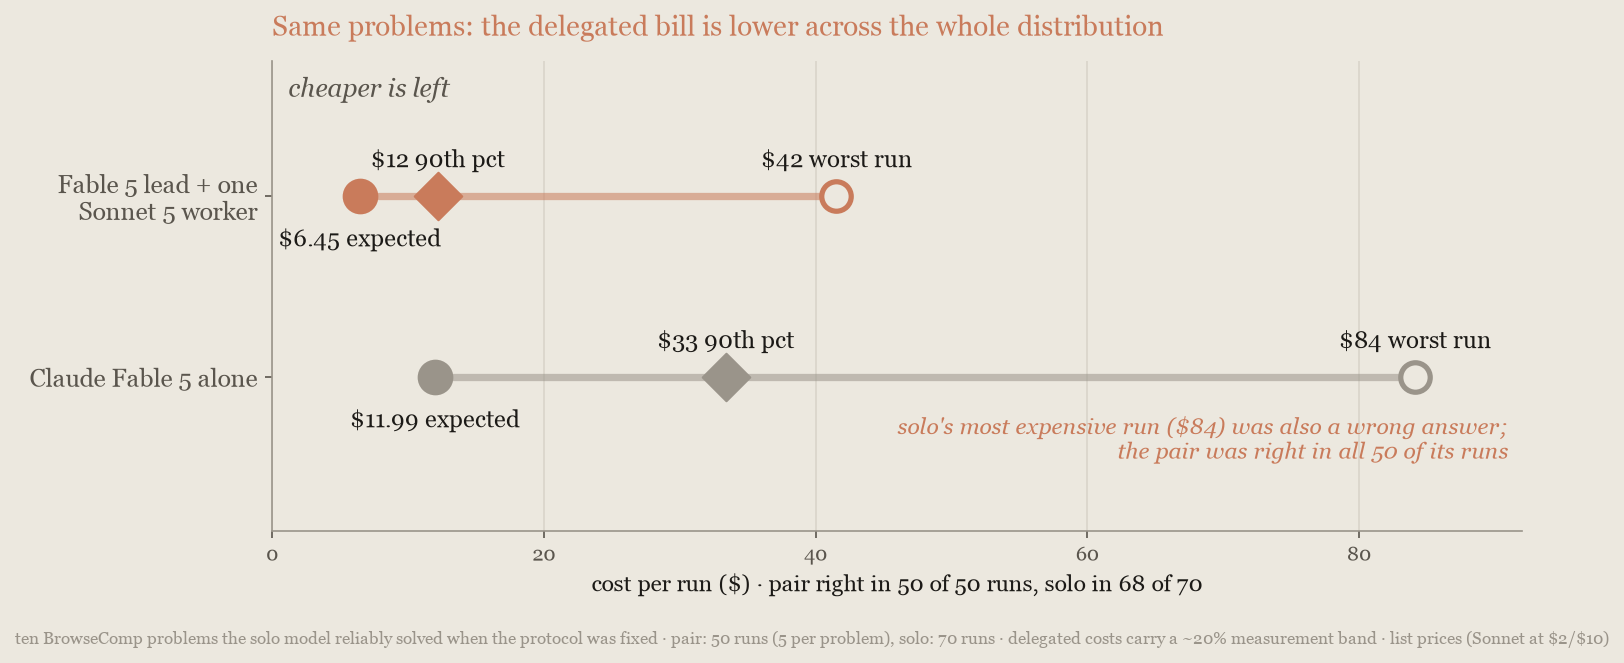
Delegasi menguntungkan pada bagian pekerjaan yang rutin dan biasanya dapat diselesaikan, kebalikan dari intuisi bahwa worker adalah untuk masalah sulit. Pada set BrowseComp lengkap yang lebih sulit, ekonominya berbalik. Jika lalu lintas Anda memiliki ekor biaya panjang pada tugas rutin, inilah kasus orchestrator yang harus diukur terlebih dahulu.
Kasus 2: pekerjaan lebih besar dari satu jendela konteks. Model solo harus mengerjakan input sebesar itu secara serial, satu jendela konteks pada satu waktu, membayar untuk membaca ulang statusnya sendiri pada setiap putaran. Worker masing-masing membaca partisinya sendiri, secara paralel dan dengan tarif worker. Pekerjaan padat bacaan yang masih muat dalam satu jendela konteks adalah masalah pemilihan model, bukan masalah delegasi: dari sisi biaya membaca saja, orchestrator unggul hanya ketika tidak ada satu konteks pun yang dapat menampung pekerjaan tersebut.
Anthropic membangun benchmark untuk kasus ini8: korpus 21,6 juta token dari 14 paket Python publik dengan 130 cacat yang ditanam, terlalu besar untuk jendela konteks mana pun. Menurunkan effort tidak dapat membantu, karena tagihannya adalah pembacaan korpus itu sendiri: Claude Fable 5.1 solo berbiaya $468 hingga $552 per episode di ketiga pengaturan effort, dan hanya akurasinya yang bergerak. Konfigurasi koordinator, pemimpin Claude Fable 5.1 di atas 25 worker Claude Sonnet 5, berbiaya sekitar setengah dari pengaturan-pengaturan itu (47% hingga 55% lebih rendah) dan mencetak skor 10 hingga 12 poin di bawahnya, dalam sekitar 2,3 jam per episode dibandingkan 15 hingga 20, sambil mengalahkan baseline Claude Sonnet 5 solo secara langsung:
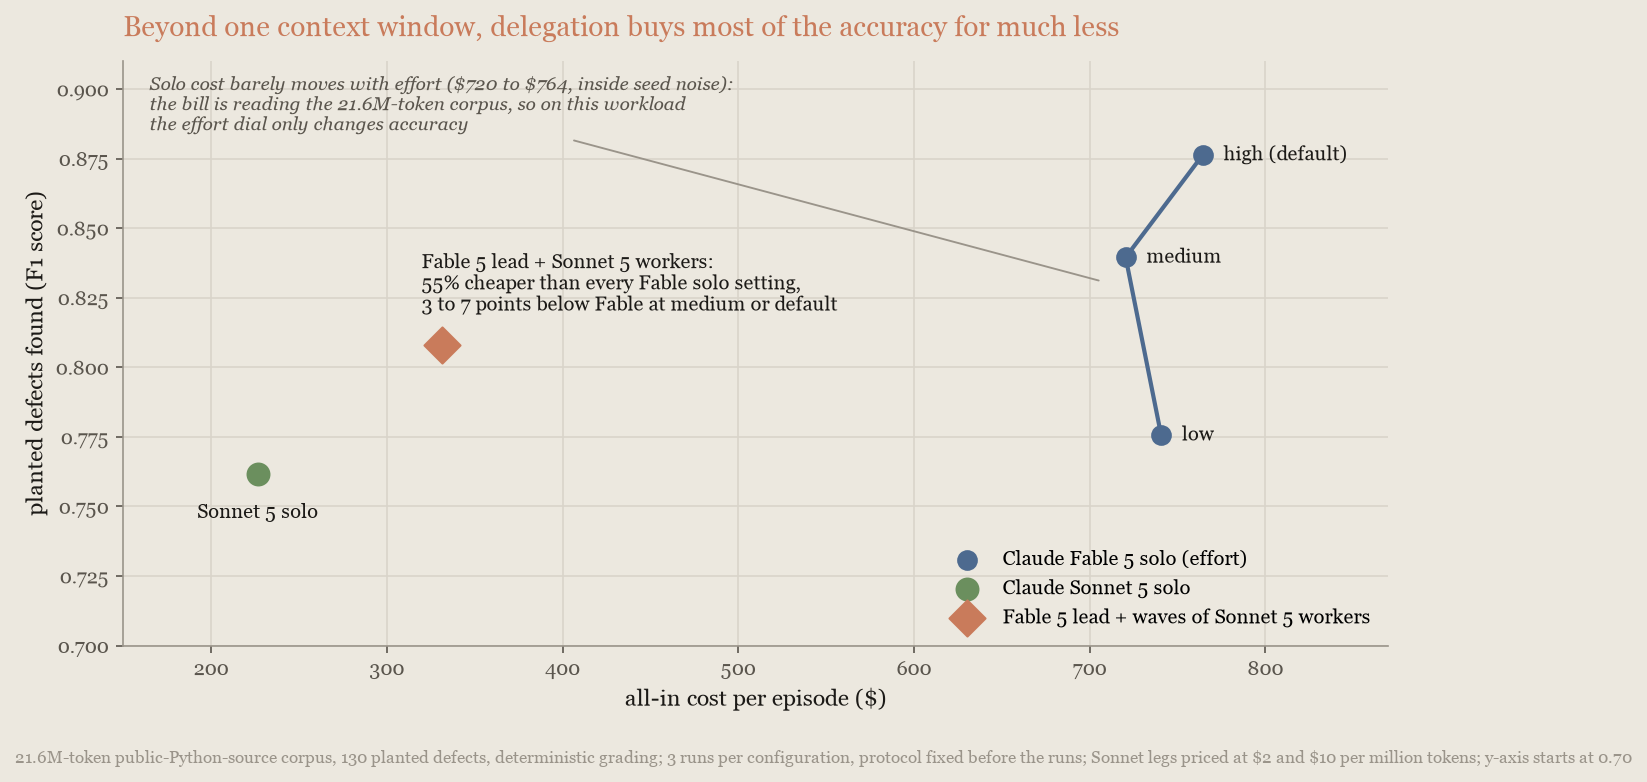
Akuntansi token menunjukkan skala pembacaannya: konfigurasi koordinator membaca sekitar 560 juta token cache per episode, sekitar satu setengah kali dari kira-kira 365 juta milik model solo, hampir semuanya dengan tarif cache-read Claude Sonnet 5, dan tetap berbiaya sekitar setengahnya secara keseluruhan. Fable 5.1 pada effort high masih memegang akurasi puncak, dengan biaya sekitar 2,2 kali konfigurasi koordinator, sehingga delegasi di sini membeli sebagian besar akurasi, bukan semuanya.
Kapan delegasi tidak menguntungkan. Orchestrator membeli sesuatu hanya ketika ada pekerjaan massal untuk diserahkan: banyak bagian independen, idealnya terlalu banyak untuk satu jendela konteks. Ketika pekerjaan berupa satu rantai yang saling bergantung, atau muat dalam satu konteks, orchestrator membayar untuk rencana, penyerahan, dan penggabungan yang diperoleh satu model secara gratis. Dalam setiap kasus seperti itu yang diukur, model koordinator sendirian pada effort lebih rendah unggul.
Batasnya adalah kesulitan tugas, bukan benchmark-nya: pada set BrowseComp4 lengkap yang lebih sulit, Claude Fable 5 sendirian mencapai akurasi konfigurasi koordinator dengan biaya 22% hingga 30% lebih rendah. Pekerjaan eksternal independen melaporkan pola yang sama5. Jika pekerjaan berupa satu rantai, muat dalam satu konteks tanpa ekor biaya panjang, atau satu model pada effort lebih rendah sudah memenuhi standar Anda, jangan membangun orchestrator.
Memilih di antara strategi
Sebagian besar kasus bermuara pada satu pertanyaan: apakah pekerjaan terbagi menjadi bagian-bagian independen, atau berupa satu jawaban yang dicapai melalui rantai langkah yang saling bergantung? Tabel strategi memetakan kedua jawaban ke kedua strategi.
Jika Anda tidak yakin, jangan membangun apa pun dulu:
- Sapu effort pada model Anda saat ini terlebih dahulu. Ini adalah eksperimen termurah di halaman ini, dan sebagian besar beban kerja berakhir di sana.
- Jika sapuan menunjukkan kesenjangan, hitung harga model yang lebih kuat sendirian pada effort rendah. Itulah angka yang harus dikalahkan oleh pasangan advisor, dan pasangan di halaman ini yang mengalahkannya adalah yang executor-nya benar-benar berkonsultasi.
Hasil multi-model di halaman ini dinilai terhadap model yang sama pada effort lebih rendah dan terhadap model satu tingkat di bawahnya yang berjalan sendirian. Itulah perbandingan yang harus dijalankan pada beban kerja Anda sendiri, dan alasan mengapa langkah pertama adalah sapuan effort.
Ketika Anda menambahkan advisor, itu berupa definisi alat, bukan perancangan ulang arsitektur.
Mengukur pada beban kerja Anda sendiri
Angka-angka di halaman ini mencerminkan harga daftar pada saat pengukuran dan akan bergeser seiring perubahan model dan harga. Tingkat eskalasi Anda, seberapa bersih tugas terbagi, dan panjang transkrip juga menggesernya. Metodenya tetap sama:
- Ambil beberapa tugas dari log produksi, dengan bobot seperti lalu lintas nyata, dan tulis pemeriksaan hasil untuk masing-masing: pengujian lulus, tiket ditutup, jumlah baris benar. Catat biaya per tugas di samping skor: hitung harga lima jumlah token berharga dalam
usagesetiap respons dengan tarifnya masing-masing (input tanpa cache, penulisan cache 5 menit dan 1 jam dengan 1,25x dan 2x harga input, pembacaan cache, dan output), dijumlahkan di seluruh permintaan tugas (Usage and Cost API melaporkan agregatnya). - Buat baseline tingkat model di seluruh tingkat effort, bukan hanya default, dan plot skor terhadap pengeluaran. Konfigurasi multi-model harus mengalahkan seluruh kurva model tunggal.
- Jika kurva menunjukkan kesenjangan yang tidak dapat ditutup oleh effort, tambahkan strategi multi-model yang cocok dan jalankan ulang suite.
- Jalankan pemenangnya dalam mode shadow pada potongan lalu lintas sebelum peralihan, lalu biarkan suite terus berjalan.
Contoh berikut menghitung biaya langkah 1 untuk satu permintaan dengan harga daftar Claude Opus 5:
# Harga per juta token dari halaman harga; ubah ketiga nilai ini untuk model lain.
INPUT_PER_MTOK = 5.00  # Claude Opus 5
# 0,1x harga input; 0,025x pada Claude Fable 5.1 dan Claude Mythos 5.1
CACHE_READ_PER_MTOK = 0.50
OUTPUT_PER_MTOK = 25.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # Penulisan cache 1 jam ditagih 2x harga input, 5 menit 1,25x; pembacaan ditagih dengan harga cache-read.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
Dalam loop agen, komponen cache-read biasanya yang terbesar dari kelimanya; jika tidak, periksa bahwa caching aktif. Ketika alat advisor atau compaction diaktifkan, beberapa token hanya dilaporkan dalam usage.iterations dan tidak dalam total tingkat atas, jadi jumlahkan usage.iterations sebagai gantinya, dengan menghitung harga entri advisor_message pada tarif model advisor.
Tabel berikut mencantumkan tuas-tuas dalam urutan untuk dicoba:
| Tuas | Penghematan dalam pengujian ini | Biaya kualitas | Latensi | Di mana |
|---|---|---|---|---|
| Caching prompt | Biaya terpangkas dengan faktor 2,7 hingga 5,3 pada loop agen; 83% pada pengujian triase | Tidak ada | Lebih cepat | Cache konteks berulang |
| Durasi cache 1 jam | Lebih murah daripada default 5 menit begitu sekitar 1 dari 20 giliran mengikuti jeda antara 5 menit dan satu jam dan sedikit celah yang melebihi satu jam, kecuali pada Claude Fable 5.1, di mana menjaga cache 5 menit tetap hangat lebih murah selama jeda berlangsung beberapa menit dan durasi 1 jam menang ketika jeda mendekati satu jam; tanpa jeda, default berbiaya 15% lebih rendah pada Claude Sonnet 5 dan 11% lebih rendah pada Claude Opus 5 | Tidak ada | Tetap hangat setelah jeda | Memilih durasi cache |
| Pemangkasan input | Tambahan 5 poin persentase pada pengujian triase | Tidak ada | Netral | Memangkas token input dan konteks |
| Memangkas hasil alat yang usang pada batas tugas | 39% pada pengujian triase panjang (compaction 32%); tidak ada pada loop pendek | Tidak ada yang terukur | Netral | Memangkas token input dan konteks |
| Tool search | 45% dengan 500 definisi alat terlampir; 20% dengan server MCP GitHub | Tidak ada | Netral | Memangkas token input dan konteks |
| File data melalui eksekusi kode | 92% pada tugas data 25 pertanyaan | Peningkatan, 25 dari 25 alih-alih 6 dari 25 | Lebih cepat | Memangkas token input dan konteks |
| Batch API | 50% | Tidak ada | Hasil dalam 24 jam | Batch pekerjaan yang bisa menunggu |
| Audit prompt terhadap model saat ini | 14% pada kedua migrasi yang diukur | Tidak ada; peningkatan pada salah satunya | Lebih cepat (lebih sedikit putaran alat) | Audit prompt terhadap model saat ini |
| Upgrade model | Opus 4.8 ke Opus 5: 12 poin lebih banyak dengan biaya 21% lebih tinggi per tugas terselesaikan (Opus 5 pada low mengalahkan Opus 4.8 dengan sekitar 30% biayanya); Sonnet 4.6 ke Sonnet 5: 15% lebih rendah per tugas terselesaikan, 5 poin lebih banyak; Fable 5 ke Fable 5.1: 43% lebih rendah per tugas terselesaikan dengan skor kira-kira sama | Peningkatan | Netral | Upgrade model |
| Effort lebih rendah | Pekerjaan pengetahuan: medium 13% hingga 31%, low sepertiga hingga setengah; coding panjang: medium sekitar setengah, low sekitar tiga perempat | 1 hingga 3 poin pada pekerjaan pengetahuan, 2 hingga 8 pada coding panjang | Lebih cepat | Menyetel effort |
| Menjalankan ulang kegagalan | Sekitar setengah, pada tingkat kelulusan yang sama | Tidak ada | Dua pengujian pada tugas yang gagal | Menjalankan ulang kegagalan pada effort lebih tinggi |
| Anggaran tugas | 44% hingga 58% | 3 hingga 6 poin | Lebih cepat | Menetapkan anggaran dan batas output |
| Meminta jawaban lebih pendek | 39% token output, 14% biaya pada pengujian triase | Tidak ada | Lebih cepat | Menetapkan anggaran dan batas output |
Menaikkan max_tokens | Tidak ada per tugas terselesaikan, tetapi lebih banyak tugas terselesaikan | Peningkatan hingga 22 poin pada set internal; tidak ada pada pasangan publik | Netral | Menetapkan anggaran dan batas output |
| Advisor | Bergantung pada kesenjangan kemampuan dan tingkat konsultasi; pasangan coding mencetak 3,5 poin di atas Opus 5 sendirian dan sekitar 2,5 di atas Fable 5.1 sendirian, pasangan pembacaan grafik menyamai model advisor sendirian pada medium dengan harga sekitar 2,6 kali | Peningkatan kecil | Sekitar dua panggilan tambahan per tugas | Strategi advisor |
| Orchestrator | Sekitar setengah dibandingkan model frontier, baik di luar satu jendela konteks maupun pada ekor rutin (yang terakhir diukur pada Claude Fable 5) | 10 hingga 12 poin di bawah model frontier | Jauh lebih cepat pada input besar | Strategi orchestrator |
Benchmark yang dirujuk
Kecuali jika suatu referensi menyatakan sebaliknya, pengukuran adalah hasil eksekusi internal Anthropic atas benchmark-benchmark ini. Kecuali disebutkan lain, biaya dalam USD pada harga daftar yang berlaku saat setiap benchmark dijalankan; angka Claude Sonnet 5 menggunakan $2 dan $10 per juta token input dan output. Grafik berlabel "notional USD" (USD nosional) menghargai jumlah token setiap permintaan pada tarif tersebut alih-alih melaporkan tagihan.
- WideSearch: Wong et al., "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. Tugas riset web luas yang dinilai berdasarkan kelengkapan dan akurasi tabel dengan banyak baris; 200 soal, 3 eksekusi per konfigurasi, dijalankan 1 hingga 2 Agustus 2026. Grafik konsentrasi biaya adalah eksekusi terpisah dengan 20 soal, 3 eksekusi per soal, dijalankan 3 hingga 4 Agustus 2026, dengan biaya dihitung dari catatan penagihan per permintaan.
- GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. Hasil kerja pengetahuan yang dinilai terhadap rubrik tugas; eksekusi 210 tugas dari gold set yang dirilis, satu percobaan per tugas, dijalankan 2 Agustus 2026. Sebuah model Claude yang menilai, sehingga skor absolut mungkin berbeda dari hasil yang dipublikasikan.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Subset 482 soal yang dipilih agar kompatibel dengan harness evaluasi Anthropic; skor tidak dapat dibandingkan dengan leaderboard publik. Claude Opus 5 pada effort default merupakan rata-rata dua eksekusi; pengaturan effort yang dikurangi adalah eksekusi tunggal; semuanya dijalankan 4 Agustus 2026. Angka eskalasi berasal tugas demi tugas dari eksekusi tersebut:
lowterlebih dahulu, lalu default pada kegagalannya, menyelesaikan 92,5% hingga 93,6% di seluruh pasangan eksekusi dengan biaya sekitar $0,45;mediumterlebih dahulu, 93,8% hingga 94,2% dengan biaya sekitar $0,61; default dijalankan ulang pada kegagalannya sendiri, 94,0% dengan biaya $1,06; semuanya pada default, 90,9% hingga 92,5% dengan biaya $0,93. Biaya pada subset ini dihargai sebagaimana organisasi pelanggan diukur: prompt sebelumnya dari setiap permintaan sebagai cache read dan token barunya sebagai cache write 5 menit, dari catatan penggunaan eksekusi itu sendiri, diperiksa terhadap buku besar pelanggan; pengukuran milik organisasi evaluasi sendiri, yang menagih cache dalam halaman 8.192 token, memberikan angka 1,4 hingga 1,8 kali lebih tinggi. Pasangan eksekutor Claude Sonnet 5 pada grafik advisor berasal dari rangkaian pengukuran yang sama pada subset ini: pasangan Sonnet-plus-Opus dijalankan dua kali (7 Agustus dan 8 Agustus 2026, satu eksekusi dan satu replikasi persis), pasangan low-effort sekali (8 Agustus 2026), dan Claude Sonnet 5 sendiri dua kali (77,4%, baseline untuk kedua baris Pro). Titik Claude Fable 5 dalam Upgrade the model adalah rata-rata tiga eksekusi pada effort default, dijalankan 26 Agustus 2026, dihargai dengan cara yang sama. Angka task-budget Claude Fable 5.1 adalah satu eksekusi per anggaran (dua pada 35.000 token) pada subset yang sama dengan effort default, dijalankan 26 Agustus 2026, dengan eksekusi tanpa anggaran pada hari yang sama (92,1%, $1,10 per tugas) sebagai baseline; set sebelumnya pada effortlow, dijalankan 21 Agustus 2026, mencetak 88,6% tanpa anggaran dengan biaya $0,48 per tugas. Perbandingan Bandingkan model memasangkan eksekusi tunggal tersebut dengan dua eksekusi Claude Sonnet 5 yang digabungkan dari subset yang sama; pada effort default Fable 5.1, pasangan tersebut terbaca sebaliknya, 41% lebih mahal per tugas yang terselesaikan dibandingkan Sonnet 5. Tangga upgrade adalah satu eksekusi per model pada default bawaannya (masing-masing dua untuk Opus 5 dan Sonnet 5, dan titik Fable 5 seperti dijelaskan di atas), dengan eksekusi Opus dan Sonnet pada minggu yang sama dalam satu harness dan organisasi. - BrowseComp: Wei et al., "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Angka effort menggunakan potongan 500 soal, satu hingga tiga eksekusi per pengaturan, dijalankan 3 Agustus 2026, dengan titik default menggabungkan dua eksekusi dari 26 hingga 27 Juli 2026. Grafik asuransi biaya menggunakan 10 soal yang terselesaikan secara andal dari irisan 26 soal, 50 eksekusi terdelegasi (1 hingga 2 Agustus 2026) dan 70 eksekusi solo (50 dari 2 hingga 3 Agustus 2026; 20 diarsipkan dari 12 hingga 13 Juli dan 1 Agustus 2026), $6,45 dibandingkan dengan $11,99 per eksekusi secara ekspektasi; angka terdelegasi memiliki rentang pengukuran sekitar 20%.
- Penskalaan arsitektur agen: Kim et al., "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. Studi eksternal independen, dikutip hanya untuk arah temuan tentang kapan delegasi tidak menguntungkan, bukan untuk angka apa pun.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. Ke-220 pertanyaannya mencakup 15 domain, masing-masing menggabungkan pengumpulan banyak baris dengan pengambilan multi-hop; diukur pada set baris tetap benchmark, 3 eksekusi per konfigurasi, dijalankan 2 Agustus 2026 (titik tim pekerja tunggal dijalankan 26 hingga 27 Juli 2026).
- DeepResearch Bench II: Li et al., "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. Ke-132 tugas risetnya di 22 domain dinilai terhadap rubrik biner yang diturunkan dari pakar; diukur pada subset 50 tugas yang distratifikasi di semua tema, satu percobaan per tugas, 3 eksekusi per pengaturan, pada Claude Managed Agents dengan alat web search dan fetch milik platform sendiri (26 hingga 27 Agustus 2026); dinilai pada 33 tugas yang tidak ditolak oleh konfigurasi mana pun, dengan percobaan yang dihentikan lebih awal oleh pengklasifikasi keamanan produksi dihapus; biaya adalah apa yang ditagihkan kepada pelanggan, permintaan platform ditambah biaya web search. Skor adalah rata-rata setiap model pada basis 33 tugas dengan tugas-tugasnya sendiri yang dihentikan lebih awal dihapus; pada 21 tugas yang bersih di setiap kelompok, Claude Fable 5.1 mempertahankan keunggulan 2 hingga 3 poin atas Claude Fable 5 di setiap tingkat effort dan kedua model datar di seluruh effort. Grafik caching menghargai ulang permintaan yang sama dengan setiap token input pada tarif tanpa cache. Claude Opus 4.6 menilai di bawah protokol rubrik benchmark; versi aslinya menggunakan penilai yang berbeda, dan penilai Anthropic mungkin lebih menyukai gaya internal. Claude Opus 5 pada effort defaultnya dijalankan pada permukaan dan subset yang sama, tiga eksekusi, pada 28 Agustus 2026: 68,8% pada 50 tugas mentah, 70,8% pada basis 33 tugas, dan 71,1% pada set 21 tugas, dengan biaya $6,71 per tugas ($23,72 tanpa caching); tidak ada percobaannya yang dihentikan lebih awal oleh pengklasifikasi keamanan, di bawah deployment safeguards yang lebih baru daripada yang digunakan model-model lain.
- Penyisiran cacat korpus: Internal Anthropic, untuk pekerjaan yang lebih besar dari satu jendela konteks: korpus 21,6 juta token dari 14 sumber paket Python publik dengan 130 cacat yang ditanam dan penilaian deterministik; protokol ditetapkan sebelum eksekusi dan ditinjau secara internal; tiga eksekusi per konfigurasi. Setiap konfigurasi dijalankan pada Claude Managed Agents. Konfigurasi tim pada grafik adalah eksekusi di mana koordinator Claude Fable 5.1 menjalankan seluruh penyisiran di dalam platform pada batas terdokumentasinya yaitu 25 pekerja Claude Sonnet 5 secara bersamaan, dijalankan 30 Agustus 2026; tiga episodenya mencetak F1 0,764, 0,825, dan 0,791 setelah audit tambahan (mentah 0,751, 0,821, dan 0,781) dengan biaya $225, $234, dan $283. Konfigurasi solo Claude Sonnet 5 dijalankan 3 hingga 4 Agustus 2026; konfigurasi solo Claude Fable 5.1 dijalankan 24 hingga 25 Agustus 2026, di bawah pengaturan penyajian peluncuran platform, tiga seed per pengaturan effort, pada build korpus yang sama. Image sandbox membawa salinan terinstal dari sebagian korpus, dan langkah perakitan akhir Claude Fable 5.1 membandingkan terhadapnya dalam 7 dari 9 episode; penilaian ulang tanpa tambahan tersebut menggeser seed yang terpengaruh hingga 3 poin. F1 absolut bersifat spesifik untuk build korpus ini, tidak dapat dibandingkan lintas benchmark; perbandingan konfigurasi bersifat setara.
- GPQA Diamond: Rein et al., "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. Subset Diamond 198 pertanyaan, dua eksekusi per konfigurasi, dijalankan 7 Agustus 2026, dinilai oleh model terhadap jawaban referensi, token advisor diukur per permintaan. Pemeriksaan keamanan platform menolak dua pertanyaan biologi pada eksekutor Sonnet dan Opus; mengecualikannya tidak mengubah perbandingan mana pun lebih dari satu poin.
- DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. Set ini memiliki 113 tugas orisinal di lima bahasa dengan verifier berbasis program. Pasangan masing-masing dua eksekusi, dijalankan 7 Agustus 2026, dengan token advisor diukur per permintaan, dan menggunakan loop advisor sisi klien alih-alih alat advisor, dengan akuntansi yang identik. Sapuan effort model tunggal adalah eksekusi tunggal yang dihargai dari jumlah token, sebuah pendekatan yang memperhitungkan cache. Biaya per tugas adalah total eksekusi dibagi 113.
- Benchmark agentic-coding internal: Internal Anthropic: 370 tugas repositori yang dinilai oleh pengujian milik repositori itu sendiri. Angka API diukur dengan batas output 128.000 token, satu eksekusi per konfigurasi: Opus 5 sendiri pada effort default 9 hingga 10 Agustus 2026, Claude Fable 5.1 sendiri pada lima nilai effort yang ditetapkan secara eksplisit 20 Agustus 2026, dan pasangannya 24 hingga 25 Agustus 2026. Percobaan per tugas: lima untuk pasangan dan kontrol Opus-sendiri, satu untuk titik model tunggal; pasangan rata-rata sekitar dua konsultasi advisor per percobaan; biaya adalah per percobaan. Angka Claude Code adalah eksekusi tugas yang sama dari 8 hingga 23 Juli 2026, satu eksekusi per konfigurasi, biaya perkiraan.
- Benchmark tugas repositori internal (pengukuran batas): Set internal Anthropic terpisah berisi sekitar 130 tugas repositori, dijalankan 8 hingga 10 Agustus 2026 (Claude Opus 5) dan 20 Agustus 2026 (Claude Fable 5.1), dengan loop agen API biasa, satu percobaan per tugas. Eksekusi Claude Fable 5.1 adalah 135 tugas per batas pada effort default yang ditetapkan secara eksplisit: angka 16.384 token merupakan rata-rata dua eksekusi (36,3% pada keduanya); angka 64.000 dan 128.000 adalah eksekusi tunggal (58,5% dan 60,0%). Enam soal memicu penolakan keamanan di setiap eksekusi dan dihitung sebagai kegagalan. Angka 16.384 token Opus 5 merupakan rata-rata dua eksekusi dan angka 64.000-nya adalah eksekusi tunggal (124 tugas dinilai). Angka batas SWE-bench Pro adalah satu eksekusi Claude Fable 5.1 per batas pada effort default, dijalankan 26 Agustus 2026, pada subset 100 soal yang distratifikasi dari set 482 soal referensi 3, tidak dapat dibandingkan dengan skornya; kedua batas mencetak skor yang sama pada default. Distribusi per giliran pada grafik berasal dari eksekusi Opus pada 64.000 dan eksekusi Claude Fable 5.1 pada 128.000; tidak ada giliran Opus yang mencapai batasnya, dan satu giliran Fable 5.1 mencapai 128.000 (0,46% dari gilirannya melebihi 16.384).
- Chartography: Surge AI, "Chartography," 2026. Set lengkap 100 pertanyaan yang dirilis, diukur 8 hingga 10 Agustus 2026, dengan implementasi Anthropic pada Claude Managed Agents (sandbox cloud standar; konfigurasi advisor menggunakan advisor Managed Agents). Claude Sonnet 4.6 menilai alih-alih penilai referensi dan benchmark dijalankan dengan alat, sehingga skor dapat dibandingkan antar konfigurasi di sini tetapi tidak dengan leaderboard yang dipublikasikan. Dua eksekusi per konfigurasi, digabungkan; sebaran antar eksekusi adalah 4 hingga 10 poin. Biaya tidak termasuk waktu sandbox, yang menambah kurang dari 1%. Eksekusi solo Claude Fable 5.1 berasal dari 24 Agustus 2026, di bawah pengaturan penyajian peluncuran platform, dua eksekusi per pengaturan; enam percobaan mencapai batas sesi 15 menit dan mendapat skor 0, dan dua grafik per eksekusi dijawab oleh Claude Opus 5 setelah penolakan keamanan. Eksekutor Claude Opus 5 low-effort dengan advisor Claude Fable 5.1 dijalankan dua kali pada 30 Agustus 2026, di bawah pengaturan yang sama (63,0 dan 67,0, rata-rata 65,0, dengan biaya $0,72 per grafik; advisor dikonsultasikan pada 88% tugas di setiap eksekusi, dan 4 dari 219 balasannya berasal dari Claude Opus 5 sebagai gantinya, masing-masing setelah filter keamanan produksi menghentikan balasan advisor itu sendiri). Perbandingan tingkat konsultasi untuk pasangan sebelumnya berasal dari menjalankan ulang konfigurasi yang sama pada Messages API dengan set alat container, 10 hingga 11 Agustus 2026.
- Evaluasi audit prompt support-desk: Set yang disusun Anthropic berisi 44 tiket dukungan dengan penilaian deterministik, dijalankan pada awal Agustus 2026 dan dilaporkan pada 8 Agustus 2026, di bawah enam prompt sistem, masing-masing menambahkan ke prompt bersih yang sama satu pola yang umum dalam prompt yang ditulis untuk Claude Opus 4.8 dan Claude Sonnet 4.6. Setiap titik grafik adalah salah satu dari tiga kasus (model lama, model baru pada prompt yang sama, model baru setelah audit) yang dirata-ratakan atas enam prompt dan 44 tiket. Peningkatan akurasi Opus 5 memiliki interval kepercayaan 95% sebesar 3 hingga 8 poin; perbedaan akurasi Sonnet berada dalam rentang noise.
- Set pertanyaan file data: Set yang disusun Anthropic berisi 25 pertanyaan agregat atas irisan 1.862 baris dari CSV penjualan minuman keras publik, dengan ground truth yang dihitung oleh pandas dan penilaian exact-match, dijalankan pada Claude Sonnet 5 dan Claude Opus 5 dengan thinking dinonaktifkan (kelompok in-context tidak dapat selesai pada default), batas output 4.000 token, dan tanpa caching prompt, tiga eksekusi per konfigurasi, dijalankan 19 Agustus 2026. Kelompok file mengunggah CSV melalui Files API dan menggunakan alat
code_execution_20260120. - Pengukuran durasi cache: Pekerjaan triase 20 isu dari Pangkas token input dan konteks, dijalankan 23 Agustus 2026, pada Claude Sonnet 5 dan Claude Opus 5 pada Messages API dengan harness yang sama, sel Claude Opus 5 dengan
max_tokensdinaikkan menjadi 4.096, dengan jeda disisipkan sebelum bagian giliran yang dipilih secara acak (tidak ada, 5%, 10%, dan setiap giliran pada 6 menit pada semua 20 isu pada kedua model, ditambah setiap giliran pada 2 menit pada Claude Sonnet 5; jeda 20 menit pada subset 5 isu pada kedua model; jeda 45 menit pada subset 5 isu hanya pada Claude Sonnet 5). Tiga eksekusi per sel, biaya dihitung dari fieldusagesetiap respons pada organisasi yang ditagih sebagai pelanggan pada harga daftar, akurasi terhadap label gold yang sama. Titik persilangan adalah sekitar 3,3% giliran pada kedua model: median dari bagian titik impas setiap sesi, dihitung oleh model biaya dari ukuran konteks giliran demi giliran sesi tersebut, atas semua 45 sesi dua puluh isu Claude Sonnet 5 dan 36 sesi Claude Opus 5 dalam analisis (setiap jadwal jeda dijalankan pada pekerjaan penuh, di bawah ketiga pengaturan cache, masing-masing tiga eksekusi; sel 5 isu tidak termasuk di dalamnya). Sel 5% seri pada Claude Sonnet 5 karena jeda pada undian tersebut jatuh pada prefiks kecil. Aturan 1-dari-20 pada halaman ini berada di atas titik persilangan yang terukur. Anthropic mengukur permintaan keep-alive yang menyegarkan cache 5 menit hanya sebagai pembanding. Permintaan tersebut paling baik hanya menyamai pengaturan 1 jam dan lebih mahal dengan jeda sebelum setiap giliran, jadi jangan gunakan pada kedua model ini; pada Claude Fable 5.1 perhitungannya berbalik (referensi 19). - Porsi cache-read dalam produksi: Penggunaan Claude API pihak pertama yang diagregasi untuk 14 hari yang berakhir 23 Agustus 2026, hanya produk API langsung, organisasi internal Anthropic dikecualikan, tidak ada organisasi yang diidentifikasi. Sebuah hari-organisasi dihitung sebagai loop agen ketika permintaannya membawa definisi alat dan hasil alat, promptnya memuat rata-rata 9 atau lebih panggilan alat sebelumnya, caching digunakan, dan organisasi tersebut membuat setidaknya 10 permintaan semacam itu (API tidak memiliki pengidentifikasi percakapan, jadi ini menggantikan panjang percakapan): 303.003 hari-organisasi di 106.487 organisasi, median porsi cache-read 84,2% dari semua token input, kuartil atas 91,7%. Label kasus penggunaan (kasus penggunaan yang dideklarasikan organisasi, atau jika tidak ada, yang diklasifikasikan) mencakup 74% dari hari-organisasi tersebut dan 99% dari tokennya; organisasi coding memasok 87% token input agentic dan membaca median 88,5% (90,9% pada 25 atau lebih panggilan alat sebelumnya), kuartil atas 93,4%, dengan sekitar 72% hari-organisasi coding pada 80% atau lebih; agen dukungan, riset, dan data membaca 84% hingga 85%. Desil teratas hari-organisasi membaca 95,9% atau lebih untuk coding dan 94,2% hingga 94,8% untuk agen dukungan, riset, data, dan lainnya. Pembagian tingkat permintaan pada 25 atau lebih panggilan alat sebelumnya berasal dari sampel enam jam: coding 92% read, 7% write, kurang dari 1% tanpa cache. Organisasi tanpa label, sebagian besar kecil, membaca median 11%. Hari-organisasi tanpa definisi alat membaca median 34,6%. Kueri independen atas jendela yang sama yang merekonstruksi percakapan dengan 10 permintaan atau lebih, alih-alih menilai hari-organisasi, menempatkan median pada 90,2%; perbedaannya adalah cakupan, bukan data.
- Pengukuran waktu compaction: Varian panjang agen triase dari Pangkas token input dan konteks, dijalankan 24 Agustus 2026, pada Claude Sonnet 5 dengan cache 5 menit, biaya dari field usage pada harga daftar, lima sesi per kelompok: kelompok tanpa perubahan pada effort default sepanjang sesi ($0,81 per sesi), dan dua kelompok yang dimulai pada low effort dan membuat dua perubahan pemecah cache yang sama, peralihan ke effort default dan satu alat tambahan, baik di tengah sesi pada permintaan 12 dan 17 ($0,95) atau bersamaan pada permintaan pertama setelah compaction pertama ($0,75). Kelompok keempat berisi enam sesi, dijalankan 25 Agustus 2026, membuat dua perubahan yang sama pada permintaan yang memicu compaction pertama ($0,92 per sesi): tahap peringkasan permintaan tersebut menulis konteks 81.000 token ke cache alih-alih membacanya, sehingga tahap itu berbiaya $0,21 dibandingkan $0,04 untuk tahap yang sama di kelompok batas. Sesi pertama kali mengalami compaction pada permintaan 21 hingga 25 (16 dari 21 sesi pada permintaan 22), setelah prompt melewati pemicu compaction 80.000 token, dan dua sesi tanpa perubahan mengalami compaction kedua kali menjelang akhir. Total kelompok batas yang lebih rendah daripada kelompok tanpa perubahan mencerminkan permintaan low-effort-nya sebelum perubahan dan compaction kedua tersebut, bukan caching: biaya penulisan ulang kedua kelompok berbeda kurang dari satu sen. Kelompok tengah sesi membayar $0,23 per sesi dalam penulisan ulang cache; perbedaan antara kelompok tengah sesi dan kelompok batas adalah $0,20 dengan interval kepercayaan 95% sebesar $0,11 hingga $0,29. Satu sesi tengah sesi berjalan murah ($0,82) setelah modelnya salah memanggil alat pencarian setelah compaction dan mendapat hasil kosong; sesi itu disertakan, dan tanpanya kelompok tersebut rata-rata $0,98. Akurasi rata-rata 14,2 dari 20 label di setiap kelompok 24 Agustus dan 14,7 di kelompok 25 Agustus; cache read adalah 91% token prompt tanpa perubahan, 85% tengah sesi, 91% pada batas, dan 86% dengan perubahan pada permintaan pemicu.
- Pengukuran durasi cache pada Claude Fable 5.1: Pekerjaan triase 20 isu dan harness yang sama seperti referensi 16, dijalankan 23 Agustus dan 26 Agustus 2026, pada snapshot peluncuran Claude Fable 5.1 pada harga peluncurannya ($10 input, $12,50 write 5 menit, $20 write 1 jam, $0,25 cache read, $50 output per juta token), tiga pengaturan per jadwal: cache 5 menit, cache 1 jam, dan cache 5 menit yang dijaga tetap hangat oleh permintaan
max_tokens: 0pada prefiks yang tidak berubah setiap 4 menit waktu idle (eksekusi 23 Agustus melakukan ping denganmax_tokens: 1; setiap ping 26 Agustus menyegarkan cache dan tidak menagih output). Jadwal: tanpa jeda, 10% giliran, dan setiap giliran pada 6 menit pada semua 20 isu, dan jeda 45 menit pada subset 5 isu; tiga eksekusi per sel, biaya dihitung dari fieldusagesetiap respons pada harga daftar, akurasi terhadap label gold yang sama (12 hingga 17 label tepat dari 20). Rata-rata per sesi pada 26 Agustus untuk pengaturan 5 menit, 1 jam, dan keep-alive: tanpa jeda $2,42, $3,09, $2,29; 10% dijeda $4,50, $2,96, $2,36; setiap giliran $22,89, $3,01, $2,62; sel 23 Agustus sesuai dalam rentang 6%. Angka 45 menit ($1,68, $0,59, dan $0,71 per sesi 5 isu) berasal dari eksekusi ulang bersih pada 26 Agustus setelah insiden penagihan cache merusak sel pertama hari itu; eksekusi 23 Agustus memberikan $1,67, $0,58, dan $0,70. Titik persilangan antara pengaturan 5 menit dan 1 jam adalah 3,1% giliran, ukuran yang sama seperti referensi 16. - Terminal-Bench 3: 74 tugas dari benchmark terminal-agent publik, dijalankan pada Claude Managed Agents dengan dua alat kustom, sebuah shell dan editor file yang dijalankan harness evaluasi di container milik setiap tugas sendiri, sebagai pengganti alat bawaan platform, dan selain itu pada pengaturan default platform untuk akun eksternal, dua eksekusi per model pada effort
high, 27 hingga 28 Agustus 2026. Skor adalah tingkat kelulusan mentah atas 148 percobaan per model; eksekusi tunggal berayun 5 hingga 11 poin. Biaya adalah apa yang akan ditagihkan kepada pelanggan pada harga daftar, dihargai ulang permintaan demi permintaan dari catatan penggunaan eksekusi dengan masa hidup cache 5 menit. Claude Opus 4.7 mengakhiri 11 dari 148 percobaannya pada batas outputnya.
Langkah selanjutnya
Keuntungan gratis terbesar di halaman ini: penyiapan, masa hidup, dan diagnostik.
Tukar kecerdasan dengan latensi dan biaya dalam satu model.
Evaluasi kemampuan, kecepatan, dan biaya di seluruh keluarga model Claude.
Berikan loop agen hitung mundur token yang mereka atur sendiri.
Tetapkan batas dolar yang tegas pada sesi Managed Agents.
Lihat harga per token terkini untuk setiap model Claude.
Terapkan tuas-tuas ini satu per satu pada agen yang berfungsi dalam notebook yang dapat dijalankan, dengan biaya per tugas setelah setiap langkah.
Tonton panduan langkah demi langkah tentang pola advisor dan orchestrator.
Was this page helpful?