工单路由
本指南将介绍如何利用 Claude 先进的自然语言理解能力,根据客户意图、紧急程度、优先级、客户画像等因素,大规模地对客户支持工单进行分类。
前提条件
- 一个 Claude API 密钥,并已安装 Python SDK
- 能够访问并熟悉您现有的支持工单系统
- 一组用于测试的历史支持工单样本
确定是否使用 Claude 进行工单路由
以下是一些关键指标,表明您应该在分类任务中使用像 Claude 这样的"large language model"(大型语言模型),即 LLM,而不是传统的机器学习方法:
传统的机器学习流程需要大量已标注的数据集。Claude 的预训练模型只需几十个已标注示例即可有效地对工单进行分类,从而显著减少数据准备的时间和成本。
一旦建立了传统的机器学习方法,对其进行更改将是一项费力且数据密集的工作。另一方面,随着您的产品或客户需求的演进,Claude 可以轻松适应类别定义的变化或新增类别,而无需对训练数据进行大量重新标注。
传统的机器学习模型通常难以处理非结构化数据,并且需要大量的特征工程。Claude 先进的语言理解能力使其能够基于内容和上下文进行准确分类,而不是依赖严格的本体结构。
传统的机器学习方法通常依赖词袋模型或简单的模式匹配。当类别由条件而非示例定义时,Claude 擅长理解并应用其底层规则。
许多传统的机器学习模型几乎无法让人了解其决策过程。Claude 可以为其分类决策提供人类可读的解释,从而建立对自动化系统的信任,并在需要时便于调整。
传统的机器学习系统通常难以处理异常值和模糊输入,经常将其错误分类或默认归入一个兜底类别。Claude 的自然语言处理能力使其能够更好地理解支持工单中的上下文和细微差别,从而有可能减少需要人工干预的错误路由或未分类工单的数量。
传统的机器学习方法通常需要为每种支持的语言建立单独的模型或进行大量的翻译处理。Claude 的多语言能力使其能够对各种语言的工单进行分类,而无需单独的模型或大量的翻译处理,从而简化对全球客户群的支持。
构建并部署您的 LLM 支持工作流
了解您当前的支持方式
在实现自动化之前,了解您现有的工单系统至关重要。首先调查您的支持团队目前是如何处理工单路由的。
请考虑以下问题:
- 使用什么标准来确定适用哪种 SLA/服务方案?
- 工单路由是否用于确定工单应转给哪一级支持或哪位产品专家?
- 是否已有任何自动化规则或工作流?它们在什么情况下会失效?
- 边缘情况或模糊工单是如何处理的?
- 团队如何确定工单的优先级?
您对人工如何处理特定情况了解得越多,就越能更好地与 Claude 协作完成这项任务。
定义用户意图类别
一份定义明确的用户意图类别列表对于使用 Claude 准确分类支持工单至关重要。Claude 在您的系统中有效路由工单的能力,与您系统中类别定义的清晰程度直接成正比。
以下是一些用户意图类别和子类别的示例。
- 硬件问题
- 软件缺陷
- 兼容性问题
- 性能问题
- 密码重置
- 账户访问问题
- 账单咨询
- 订阅变更
- 功能咨询
- 产品兼容性问题
- 价格信息
- 供货情况咨询
- 操作方法问题
- 功能使用协助
- 最佳实践建议
- 故障排除指导
- 缺陷报告
- 功能请求
- 一般反馈或建议
- 投诉
- 订单状态查询
- 物流信息
- 退货与换货
- 订单修改
- 安装协助
- 升级请求
- 维护排期
- 服务取消
- 数据隐私咨询
- 可疑活动报告
- 安全功能协助
- 监管合规问题
- 服务条款咨询
- 法律文件请求
- 关键系统故障
- 紧急安全问题
- 时间敏感问题
- 产品培训请求
- 文档咨询
- 网络研讨会或工作坊信息
- 集成协助
- API 使用问题
- 第三方兼容性咨询
除了意图之外,工单路由和优先级排序还可能受到其他因素的影响,例如紧急程度、客户类型、SLA 或语言。在构建自动路由系统时,请务必考虑其他路由标准。
建立成功标准
与您的支持团队合作,定义明确的成功标准,包括可衡量的基准、阈值和目标。
以下是使用 LLM 进行支持工单路由时的一些标准指标和基准:
该指标评估 Claude 在一段时间内对相似工单进行分类的一致程度。这对于保持路由的可靠性至关重要。可通过定期使用一组标准化输入测试模型来衡量,目标是达到 95% 或更高的一致率。
该指标衡量 Claude 适应新类别或变化的工单模式的速度。可通过引入新的工单类型并测量模型在这些新类别上达到令人满意的准确率(例如 >90%)所需的时间来进行测试。目标是在 50–100 个样本工单内完成适应。
该指标评估 Claude 准确路由多种语言工单的能力。衡量不同语言的路由准确率,目标是非主要语言的准确率下降不超过 5–10%。
该指标评估 Claude 在不寻常或复杂工单上的表现。创建一个边缘情况测试集并衡量路由准确率,目标是在这些具有挑战性的输入上达到至少 80% 的准确率。
该指标衡量 Claude 在不同客户群体之间路由的公平性。定期审核路由决策是否存在潜在偏见,目标是在所有客户群体中保持一致的路由准确率(差异在 2–3% 以内)。
在尽量减少令牌数量至关重要的情况下,该标准评估 Claude 在最少上下文下的表现。衡量在提供不同数量上下文时的路由准确率,目标是仅凭工单标题和简短描述即可达到 90% 以上的准确率。
该指标评估 Claude 对其路由决策所作解释的质量和相关性。人工评分者可以按一定量表(例如 1–5 分)对解释进行评分,目标是达到 4 分或更高的平均分。
以下是一些无论是否使用 LLM 都可能有用的常见成功标准:
路由准确率衡量工单在第一次尝试时被正确分配给相应团队或个人的频率。通常以正确路由的工单占总工单的百分比来衡量。行业基准通常以 90–95% 的准确率为目标,但这可能因支持结构的复杂程度而有所不同。
该指标跟踪工单提交后被分配的速度。更快的分配时间通常会带来更快的解决速度和更高的客户满意度。一流的系统通常能实现平均 5 分钟以内的分配时间,许多系统的目标是近乎即时的路由(这在 LLM 实现中是可能的)。
重新路由率表示工单在初次路由后需要重新分配的频率。较低的比率表明初次路由更准确。目标是将重新路由率控制在 10% 以下,表现最佳的系统可达到 5% 或更低。
该指标衡量在与客户首次互动中解决的工单百分比。较高的比率表明路由高效且支持团队准备充分。行业基准通常在 70–75% 之间,表现最佳者可达到 80% 或更高。
平均处理时间衡量从开始到结束解决一个工单所需的时间。高效的路由可以显著缩短这一时间。基准因行业和复杂程度差异很大,但许多组织的目标是将非关键问题的平均处理时间控制在 24 小时以内。
这些评分通常通过互动后的调查来衡量,反映客户对支持流程的整体满意程度。有效的路由有助于提高满意度。目标是 CSAT 评分达到 90% 或更高,表现最佳者通常能达到 95% 以上的满意率。
该指标衡量工单需要升级到更高级别支持的频率。较低的升级率通常表明初次路由更准确。力争将升级率控制在 20% 以下,一流的系统可达到 10% 或更低。
该指标考察在实施路由解决方案后,客服人员能够有效处理多少工单。改进的路由应能提高生产力。可通过跟踪每位客服人员每天或每小时解决的工单数来衡量,目标是在实施新路由系统后提升 10–20%。
该指标衡量在进入路由系统之前通过自助服务选项解决的潜在工单百分比。较高的比率表明路由前的分流有效。目标是分流率达到 20–30%,表现最佳者可达到 40% 或更高。
该指标计算解决每个支持工单的平均成本。高效的路由应有助于随时间降低这一成本。虽然基准差异很大,但许多组织的目标是在实施改进的路由系统后将单工单成本降低 10–15%。
选择合适的 Claude 模型
模型的选择取决于成本、准确率和响应时间之间的权衡。
许多客户发现 claude-haiku-4-5-20251001 是工单路由的理想模型,因为它是 Claude 4 系列中速度最快、性价比最高的模型,同时仍能提供出色的结果。如果您的分类问题需要深厚的专业领域知识、大量的意图类别或复杂的推理,您可以选择更大的 Sonnet 模型。
构建强大的提示
工单路由是一种分类任务。Claude 会分析支持工单的内容,并根据问题类型、紧急程度、所需专业知识或其他相关因素将其归入预定义的类别。
编写一个工单分类提示。初始提示应包含用户请求的内容,并同时返回推理过程和意图。
以下是一个工单路由分类提示的示例:
def classify_support_request(ticket_contents):
    # 定义分类任务的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""以下是该提示的关键组成部分:
- 提示模板是一个 Python f-string,允许将
ticket_contents插入到<request>标签中。 - 该提示为 Claude 赋予了一个明确定义的角色:一个仔细分析工单内容以确定客户核心意图和需求的分类系统。
- 该提示指示 Claude 采用正确的输出格式,在本例中是在
<reasoning>标签内提供其推理和分析,然后在<intent>标签内给出相应的分类标签。 - 该提示指定了有效的意图类别:"Support, Feedback, Complaint"、"Order Tracking" 和 "Refund/Exchange"。
- 该提示包含了几个示例(即 few-shot prompting,少样本提示),用于说明输出应如何格式化,从而提高准确率和一致性。
让 Claude 将其响应拆分为独立的 XML 标签部分,可以让您使用正则表达式分别从输出中提取推理和意图。这使您能够在工单路由工作流中创建有针对性的后续步骤,例如仅使用意图来决定将工单路由给哪个人。
部署您的提示
如果不将提示部署到测试生产环境中并运行评估,就很难知道它的效果如何。
构建部署结构。首先定义用于封装 Claude 调用的方法签名。扩展您之前开始编写的方法,该方法以 ticket_contents 作为输入,现在让它返回一个由 reasoning 和 intent 组成的元组作为输出。如果您已有使用传统机器学习的自动化流程,则应沿用该方法签名。
import re

# 创建 Claude API 客户端实例
client = anthropic.Anthropic()

# 设置默认模型
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # 定义分类任务的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # 将提示发送到 API 以对支持请求进行分类。
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # 使用 Python 的正则表达式库提取 `reasoning`。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同样,也提取 `intent`。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
这段代码:
- 使用您的 API 密钥创建一个客户端实例。
- 定义一个接收
ticket_contents字符串的classify_support_request函数。 - 使用
classification_prompt将ticket_contents发送给 Claude 进行分类。 - 返回从响应中提取的模型
reasoning和intent。
由于在解析之前必须生成完整的推理和意图文本,因此该示例设置了 stream=False(默认值)。
评估您的提示
提示通常需要经过测试和优化才能投入生产。要确定您的解决方案是否就绪,请根据您之前建立的成功标准和阈值来评估性能。
要运行评估,您需要有可供运行的测试用例。本指南的其余部分假设您已经开发了测试用例。
构建评估函数
本指南的示例评估从三个关键指标衡量 Claude 的表现:
- 准确率
- 单次分类成本
根据对您而言重要的因素,您可能还需要从其他维度评估 Claude。
为此,首先修改脚本,添加一个将预测意图与实际意图进行比较并计算正确预测百分比的函数。然后添加成本计算和时间测量功能。
import re

# 创建 Claude API 客户端实例
client = anthropic.Anthropic()

# 设置默认模型
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # 定义分类任务的提示
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # 使用 Python 的正则表达式库提取 `reasoning`。
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # 同样,也提取 `intent`。
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # 检查模型的预测是否正确。
    correct = actual_intent.strip() == intent.strip()

    # 返回 reasoning、intent、correct 和 usage。
    return reasoning, intent, correct, usage
以下是对这些修改的说明:
classify_support_request方法现在接收来自测试用例的actual_intent,并将其与 Claude 的意图分类进行比较,以评估两者是否匹配。- 该方法提取 API 调用的使用统计信息,以根据所用的输入和输出令牌计算成本。
运行您的评估
一次恰当的评估需要明确的阈值和基准来判断什么是好的结果。上述脚本会返回准确率、响应时间和单次分类成本的运行时数值,但您仍需要明确设定的阈值。例如:
- 准确率: 95%(基于 100 次测试)
- 单次分类成本: 相比当前路由方法平均降低 50%(基于 100 次测试)
有了这些阈值,您就可以快速、轻松地以大规模且客观实证的方式判断哪种方法最适合您,以及可能需要做出哪些更改以更好地满足您的需求。
提升性能
在复杂场景中,除了标准的提示工程技术和护栏实施策略之外,考虑其他策略来提升性能可能会有所帮助。以下是一些常见场景:
对于有 20 个以上意图类别的情况,使用分类层级结构
随着类别数量的增加,所需示例的数量也会增加,这可能会使提示变得臃肿。作为替代方案,您可以考虑使用多个分类器的组合来实现一个层级分类系统。
- 将您的意图组织成分类树结构。
- 在树的每一层创建一系列分类器,从而实现级联路由方式。
例如,您可以有一个顶层分类器,将工单大致分为"Technical Issues"(技术问题)、"Billing Questions"(账单问题)和"General Inquiries"(一般咨询)。然后,每个类别都可以有自己的子分类器来进一步细化分类。
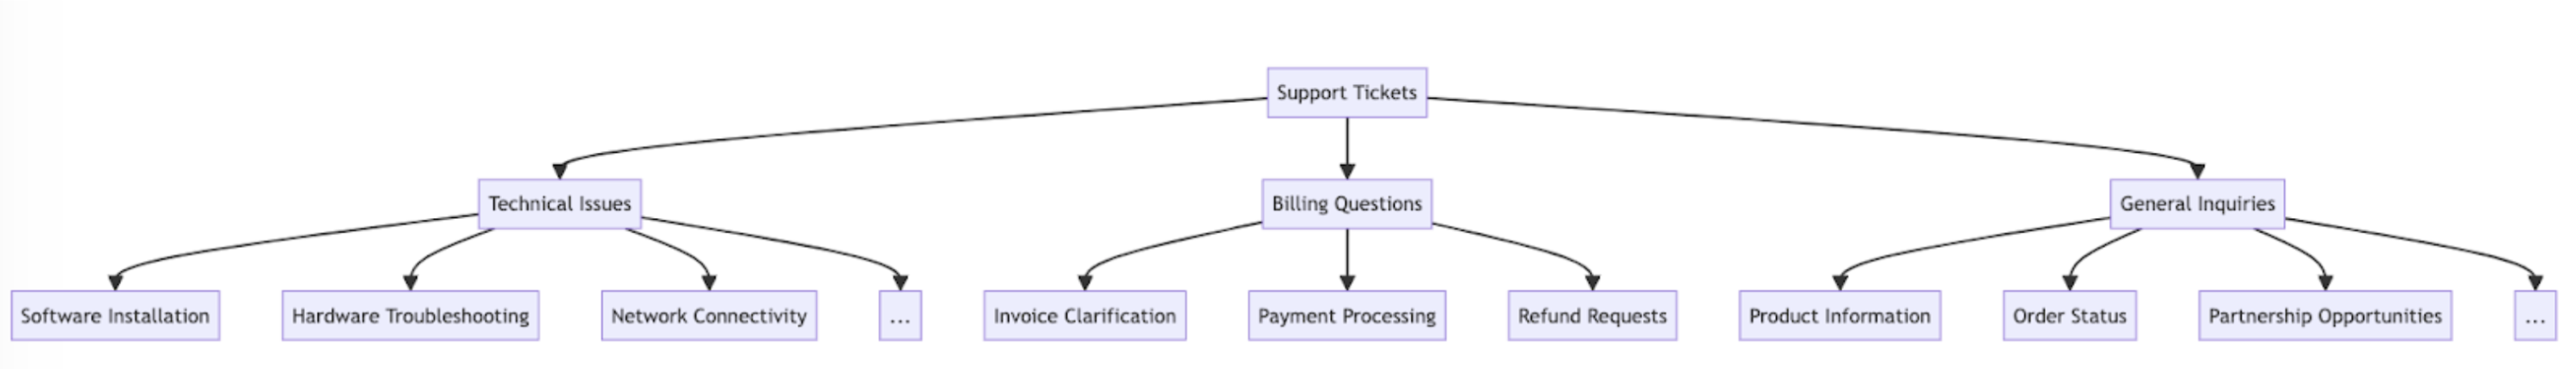
-
优点 - 更细致、更准确: 您可以为每个父路径创建不同的提示,从而实现更有针对性、更贴合上下文的分类。这可以提高准确率,并更细致地处理客户请求。
-
缺点 - 延迟增加: 请注意,多个分类器可能会导致"latency"(延迟)增加,Anthropic 建议使用速度最快的模型 Haiku 来实现此方法。
使用向量数据库和相似度搜索检索来处理高度多变的工单
尽管提供示例是提升性能最有效的方法,但如果支持请求高度多变,则很难在单个提示中包含足够的示例。
在这种情况下,您可以使用向量数据库从示例数据集中进行相似度搜索,并为给定查询检索最相关的示例。
这种方法在分类配方中有详细介绍,已被证明可将准确率从 71% 提升至 93%。
专门考虑预期的边缘情况
以下是一些 Claude 可能会错误分类工单的场景(可能还有其他您特有的情况)。在这些场景中,请考虑在提示中提供明确的说明或示例,告诉 Claude 应如何处理这些边缘情况:
客户经常间接地表达需求。例如,"我已经等我的包裹两个多星期了"可能是对订单状态的间接询问。
- 解决方案: 向 Claude 提供一些此类请求的真实客户示例,以及其背后的意图。如果您为特别微妙的工单意图附上分类理由,效果会更好,这样 Claude 就能更好地将该逻辑推广到其他工单。
当客户表达不满时,Claude 可能会优先处理情绪,而不是解决根本问题。
- 解决方案: 向 Claude 说明何时应优先考虑客户情绪、何时不应。可以简单到"忽略所有客户情绪。只专注于分析客户请求的意图以及客户可能在询问什么信息。"
当客户在一次互动中提出多个问题时,Claude 可能难以识别主要关切。
- 解决方案: 明确意图的优先级,以便 Claude 能够更好地对提取出的意图进行排序并识别主要关切。
将 Claude 集成到您更大的支持工作流中
恰当的集成需要您就基于 Claude 的工单路由脚本如何融入更大的工单路由系统架构做出一些决策。有两种方式可以实现:
- 基于推送: 您使用的支持工单系统(例如 Zendesk)通过向您的路由服务发送 webhook 事件来触发您的代码,然后由路由服务对意图进行分类并路由。
- 这种方式更具 Web 可扩展性,但需要您暴露一个公共端点。
- 基于拉取: 您的代码按给定的时间表拉取最新工单,并在拉取时对其进行路由。
- 这种方式更容易实现,但当拉取频率过高时可能会对支持工单系统产生不必要的调用,而当拉取频率过低时则可能过于迟缓。
无论采用哪种方式,您都需要将脚本封装为一个服务。方式的选择取决于您的支持工单系统提供哪些 API。
访问分类 cookbook,获取更多示例代码和详细的评估指导。
在 Claude Console 上开始构建和评估您的工作流。
Was this page helpful?