Маршрутизация тикетов
В этом руководстве рассматривается, как использовать продвинутые возможности Claude по пониманию естественного языка для масштабной классификации тикетов службы поддержки клиентов на основе намерений клиента, срочности, приоритизации, профиля клиента и многого другого.
Предварительные требования
- Ключ API Claude и установленный Python SDK
- Доступ к вашей существующей системе тикетов поддержки и знакомство с ней
- Выборка исторических тикетов поддержки для тестирования
Определите, стоит ли использовать Claude для маршрутизации тикетов
Вот несколько ключевых признаков того, что для вашей задачи классификации следует использовать «large language model» (большую языковую модель), или LLM, такую как Claude, вместо традиционных подходов машинного обучения (ML):
Традиционные процессы ML требуют огромных размеченных наборов данных. Предобученная модель Claude может эффективно классифицировать тикеты всего на нескольких десятках размеченных примеров, что значительно сокращает время и затраты на подготовку данных.
После того как традиционный подход ML внедрён, его изменение становится трудоёмкой и требующей большого объёма данных задачей. С другой стороны, по мере развития вашего продукта или потребностей клиентов Claude может легко адаптироваться к изменениям в определениях классов или к новым классам без масштабной переразметки обучающих данных.
Традиционные модели ML часто испытывают трудности с неструктурированными данными и требуют обширной инженерии признаков. Продвинутое понимание языка Claude позволяет выполнять точную классификацию на основе содержания и контекста, а не полагаться на строгие онтологические структуры.
Традиционные подходы ML часто опираются на модели «мешка слов» или простое сопоставление шаблонов. Claude превосходно понимает и применяет лежащие в основе правила, когда классы определяются условиями, а не примерами.
Многие традиционные модели ML дают мало информации о процессе принятия решений. Claude может предоставлять понятные человеку объяснения своих решений о классификации, укрепляя доверие к системе автоматизации и облегчая адаптацию при необходимости.
Традиционные системы ML часто испытывают трудности с выбросами и неоднозначными входными данными, нередко классифицируя их неверно или относя к универсальной категории по умолчанию. Возможности Claude по обработке естественного языка позволяют лучше интерпретировать контекст и нюансы в тикетах поддержки, потенциально сокращая количество неверно маршрутизированных или неклассифицированных тикетов, требующих ручного вмешательства.
Традиционные подходы ML обычно требуют отдельных моделей или обширных процессов перевода для каждого поддерживаемого языка. Многоязычные возможности Claude позволяют классифицировать тикеты на различных языках без необходимости в отдельных моделях или обширных процессах перевода, упрощая поддержку глобальной клиентской базы.
Создайте и разверните рабочий процесс поддержки на основе LLM
Изучите ваш текущий подход к поддержке
Прежде чем автоматизировать, крайне важно понять вашу существующую систему тикетов. Начните с изучения того, как ваша команда поддержки в настоящее время выполняет маршрутизацию тикетов.
Рассмотрите такие вопросы, как:
- Какие критерии используются для определения применяемого SLA/предложения услуг?
- Используется ли маршрутизация тикетов для определения того, на какой уровень поддержки или к какому специалисту по продукту направляется тикет?
- Существуют ли уже какие-либо автоматизированные правила или рабочие процессы? В каких случаях они дают сбой?
- Как обрабатываются пограничные случаи или неоднозначные тикеты?
- Как команда приоритизирует тикеты?
Чем больше вы знаете о том, как люди обрабатывают определённые случаи, тем лучше вы сможете работать с Claude над выполнением задачи.
Определите категории намерений пользователей
Чётко определённый список категорий намерений пользователей крайне важен для точной классификации тикетов поддержки с помощью Claude. Способность Claude эффективно маршрутизировать тикеты в вашей системе прямо пропорциональна тому, насколько чётко определены категории вашей системы.
Вот несколько примеров категорий и подкатегорий намерений пользователей.
- Проблема с оборудованием
- Программная ошибка
- Проблема совместимости
- Проблема производительности
- Сброс пароля
- Проблемы с доступом к учётной записи
- Вопросы по выставлению счетов
- Изменения подписки
- Вопросы о функциях
- Вопросы о совместимости продукта
- Информация о ценах
- Вопросы о наличии
- Вопросы «как сделать»
- Помощь в использовании функций
- Советы по лучшим практикам
- Руководство по устранению неполадок
- Отчёты об ошибках
- Запросы функций
- Общие отзывы или предложения
- Жалобы
- Вопросы о статусе заказа
- Информация о доставке
- Возвраты и обмены
- Изменения заказа
- Помощь с установкой
- Запросы на обновление
- Планирование технического обслуживания
- Отмена услуги
- Вопросы о конфиденциальности данных
- Сообщения о подозрительной активности
- Помощь с функциями безопасности
- Вопросы о соответствии нормативным требованиям
- Вопросы об условиях обслуживания
- Запросы юридической документации
- Критические сбои системы
- Срочные проблемы безопасности
- Проблемы, требующие срочного решения
- Запросы на обучение по продукту
- Вопросы о документации
- Информация о вебинарах или семинарах
- Помощь с интеграцией
- Вопросы об использовании API
- Вопросы о совместимости со сторонними решениями
Помимо намерения, на маршрутизацию и приоритизацию тикетов могут также влиять другие факторы, такие как срочность, тип клиента, SLA или язык. Обязательно учитывайте другие критерии маршрутизации при создании вашей автоматизированной системы маршрутизации.
Установите критерии успеха
Совместно с вашей командой поддержки определите чёткие критерии успеха с измеримыми ориентирами, пороговыми значениями и целями.
Вот несколько стандартных критериев и ориентиров при использовании LLM для маршрутизации тикетов поддержки:
Эта метрика оценивает, насколько согласованно Claude классифицирует похожие тикеты с течением времени. Это крайне важно для поддержания надёжности маршрутизации. Измеряйте её, периодически тестируя модель на наборе стандартизированных входных данных и стремясь к уровню согласованности 95% или выше.
Эта метрика измеряет, насколько быстро Claude может адаптироваться к новым категориям или меняющимся шаблонам тикетов. Проверяйте это, вводя новые типы тикетов и измеряя время, необходимое модели для достижения удовлетворительной точности (например, >90%) по этим новым категориям. Стремитесь к адаптации в пределах 50–100 примеров тикетов.
Эта метрика оценивает способность Claude точно маршрутизировать тикеты на нескольких языках. Измеряйте точность маршрутизации для разных языков, стремясь к снижению точности не более чем на 5–10% для неосновных языков.
Эта метрика оценивает работу Claude с необычными или сложными тикетами. Создайте тестовый набор пограничных случаев и измерьте точность маршрутизации, стремясь к точности не менее 80% на этих сложных входных данных.
Эта метрика измеряет справедливость маршрутизации Claude для различных демографических групп клиентов. Регулярно проверяйте решения о маршрутизации на предмет потенциальной предвзятости, стремясь к согласованной точности маршрутизации (в пределах 2–3%) для всех групп клиентов.
В ситуациях, когда минимизация количества токенов крайне важна, этот критерий оценивает, насколько хорошо Claude работает с минимальным контекстом. Измеряйте точность маршрутизации при различном объёме предоставленного контекста, стремясь к точности 90%+ при наличии только заголовка тикета и краткого описания.
Эта метрика оценивает качество и релевантность объяснений Claude своих решений о маршрутизации. Оценщики-люди могут оценивать объяснения по шкале (например, 1–5) с целью достижения средней оценки 4 или выше.
Вот несколько общих критериев успеха, которые могут быть полезны независимо от того, используется ли LLM:
Точность маршрутизации измеряет, как часто тикеты правильно назначаются соответствующей команде или сотруднику с первой попытки. Обычно она измеряется как процент правильно маршрутизированных тикетов от общего числа тикетов. Отраслевые ориентиры часто нацелены на точность 90–95%, хотя это может варьироваться в зависимости от сложности структуры поддержки.
Эта метрика отслеживает, насколько быстро тикеты назначаются после подачи. Более быстрое назначение обычно приводит к более быстрому решению и повышению удовлетворённости клиентов. Лучшие в своём классе системы часто достигают среднего времени назначения менее 5 минут, а многие стремятся к практически мгновенной маршрутизации (что возможно при реализации на основе LLM).
Доля перемаршрутизации показывает, как часто тикеты необходимо переназначать после первоначальной маршрутизации. Более низкий показатель свидетельствует о более точной первоначальной маршрутизации. Стремитесь к доле перемаршрутизации ниже 10%, при этом лучшие системы достигают показателей 5% или ниже.
Эта метрика измеряет процент тикетов, решённых в ходе первого взаимодействия с клиентом. Более высокие показатели свидетельствуют об эффективной маршрутизации и хорошо подготовленных командах поддержки. Отраслевые ориентиры обычно находятся в диапазоне 70–75%, а лучшие исполнители достигают показателей 80% или выше.
Среднее время обработки измеряет, сколько времени требуется для решения тикета от начала до конца. Эффективная маршрутизация может значительно сократить это время. Ориентиры сильно различаются в зависимости от отрасли и сложности, но многие организации стремятся удерживать среднее время обработки менее 24 часов для некритических проблем.
Эти оценки, часто измеряемые с помощью опросов после взаимодействия, отражают общую удовлетворённость клиентов процессом поддержки. Эффективная маршрутизация способствует более высокой удовлетворённости. Стремитесь к показателям CSAT 90% или выше, при этом лучшие исполнители часто достигают уровня удовлетворённости 95%+.
Эта метрика измеряет, как часто тикеты необходимо эскалировать на более высокие уровни поддержки. Более низкая доля эскалаций часто свидетельствует о более точной первоначальной маршрутизации. Стремитесь к доле эскалаций ниже 20%, при этом лучшие в своём классе системы достигают показателей 10% или ниже.
Эта метрика показывает, сколько тикетов агенты могут эффективно обрабатывать после внедрения решения для маршрутизации. Улучшенная маршрутизация должна повысить продуктивность. Измеряйте её, отслеживая количество решённых тикетов на агента в день или в час, стремясь к улучшению на 10–20% после внедрения новой системы маршрутизации.
Эта метрика измеряет процент потенциальных тикетов, решённых с помощью средств самообслуживания до попадания в систему маршрутизации. Более высокие показатели свидетельствуют об эффективной предварительной сортировке. Стремитесь к доле отклонения 20–30%, при этом лучшие исполнители достигают показателей 40% или выше.
Эта метрика рассчитывает среднюю стоимость решения каждого тикета поддержки. Эффективная маршрутизация должна со временем помочь снизить эту стоимость. Хотя ориентиры сильно различаются, многие организации стремятся снизить стоимость одного тикета на 10–15% после внедрения улучшенной системы маршрутизации.
Выберите подходящую модель Claude
Выбор модели зависит от компромиссов между стоимостью, точностью и временем отклика.
Многие клиенты считают claude-haiku-4-5-20251001 идеальной моделью для маршрутизации тикетов, поскольку это самая быстрая и экономичная модель в семействе Claude 4, которая при этом обеспечивает отличные результаты. Если ваша задача классификации требует глубокой предметной экспертизы, большого количества категорий намерений или сложных рассуждений, вы можете выбрать более крупную модель Sonnet.
Создайте сильную подсказку
Маршрутизация тикетов — это разновидность задачи классификации. Claude анализирует содержимое тикета поддержки и классифицирует его по предопределённым категориям на основе типа проблемы, срочности, требуемой экспертизы или других релевантных факторов.
Напишите подсказку (prompt) для классификации тикетов. Начальная подсказка должна содержать содержимое запроса пользователя и возвращать как обоснование, так и намерение.
Вот пример подсказки для классификации при маршрутизации тикетов:
def classify_support_request(ticket_contents):
    # Определяем подсказку для задачи классификации
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Вот ключевые компоненты этой подсказки:
- Шаблон подсказки представляет собой f-строку Python, что позволяет вставлять
ticket_contentsв теги<request>. - Подсказка даёт Claude чётко определённую роль системы классификации, которая тщательно анализирует содержимое тикета, чтобы определить основное намерение и потребности клиента.
- Подсказка инструктирует Claude о правильном форматировании вывода — в данном случае предоставить обоснование и анализ внутри тегов
<reasoning>, а затем соответствующую метку классификации внутри тегов<intent>. - Подсказка указывает допустимые категории намерений: «Support, Feedback, Complaint», «Order Tracking» и «Refund/Exchange».
- Подсказка включает несколько примеров (так называемый few-shot prompting), чтобы проиллюстрировать, как должен быть отформатирован вывод, что повышает точность и согласованность.
То, что Claude разделяет свой ответ на отдельные секции с XML-тегами, позволяет вам использовать регулярные выражения для независимого извлечения обоснования и намерения из вывода. Это позволяет создавать целевые следующие шаги в рабочем процессе маршрутизации тикетов, например использовать только намерение для решения о том, кому направить тикет.
Разверните вашу подсказку
Трудно понять, насколько хорошо работает ваша подсказка, не развернув её в тестовой производственной среде и не проведя оценки.
Создайте структуру развёртывания. Начните с определения сигнатуры метода для обёртки вызова Claude. Расширьте метод, который вы начали писать ранее и который принимает ticket_contents на вход, чтобы теперь он возвращал кортеж из reasoning и intent на выходе. Если у вас уже есть автоматизация на основе традиционного ML, вам следует придерживаться её сигнатуры метода.
import re

# Создаём экземпляр клиента Claude API
client = anthropic.Anthropic()

# Задаём модель по умолчанию
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Определяем подсказку для задачи классификации
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Отправляем подсказку в API для классификации запроса в поддержку.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Используем библиотеку регулярных выражений Python для извлечения `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Аналогично извлекаем `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Этот код:
- Создаёт экземпляр клиента, используя ваш ключ API.
- Определяет функцию
classify_support_request, которая принимает строкуticket_contents. - Отправляет
ticket_contentsв Claude для классификации с использованиемclassification_prompt. - Возвращает
reasoningиintentмодели, извлечённые из ответа.
Поскольку весь текст обоснования и намерения должен быть сгенерирован до разбора, в примере установлено stream=False (значение по умолчанию).
Оцените вашу подсказку
Подсказки часто требуют тестирования и оптимизации, чтобы быть готовыми к производственному использованию. Чтобы определить готовность вашего решения, оцените производительность на основе критериев успеха и пороговых значений, которые вы установили ранее.
Чтобы провести оценку, вам нужны тестовые случаи, на которых её можно запустить. В оставшейся части этого руководства предполагается, что вы уже разработали свои тестовые случаи.
Создайте функцию оценки
Пример оценки в этом руководстве измеряет производительность Claude по трём ключевым метрикам:
- Точность
- Стоимость одной классификации
Вам может потребоваться оценить Claude по другим параметрам в зависимости от того, какие факторы важны для вас.
Чтобы оценить это, сначала измените скрипт, добавив функцию, которая сравнивает предсказанное намерение с фактическим и вычисляет процент правильных предсказаний. Затем добавьте функциональность расчёта стоимости и измерения времени.
import re

# Создаём экземпляр клиента Claude API
client = anthropic.Anthropic()

# Задаём модель по умолчанию
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Определяем подсказку для задачи классификации
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Используем библиотеку регулярных выражений Python для извлечения `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Аналогично извлекаем `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Проверяем, верно ли предсказание модели.
    correct = actual_intent.strip() == intent.strip()

    # Возвращаем reasoning, intent, correct и usage.
    return reasoning, intent, correct, usage
Вот разбор внесённых изменений:
- Метод
classify_support_requestтеперь принимаетactual_intentиз тестовых случаев и сравнивает его с классификацией намерения от Claude, чтобы оценить, совпадают ли они. - Метод извлекает статистику использования для вызова API, чтобы рассчитать стоимость на основе использованных входных и выходных токенов.
Запустите вашу оценку
Правильная оценка требует чётких пороговых значений и ориентиров для определения того, что является хорошим результатом. Приведённый выше скрипт возвращает значения точности, времени отклика и стоимости одной классификации во время выполнения, но вам всё ещё нужны чётко установленные пороговые значения. Например:
- Точность: 95% (из 100 тестов)
- Стоимость одной классификации: снижение в среднем на 50% (по 100 тестам) по сравнению с текущим методом маршрутизации
Наличие этих пороговых значений позволяет вам быстро и легко, в масштабе и с беспристрастным эмпиризмом определить, какой метод лучше всего подходит для вас и какие изменения, возможно, потребуется внести, чтобы лучше соответствовать вашим требованиям.
Повысьте производительность
В сложных сценариях может быть полезно рассмотреть дополнительные стратегии повышения производительности помимо стандартных техник инженерии подсказок и стратегий внедрения защитных механизмов. Вот несколько распространённых сценариев:
Используйте таксономическую иерархию для случаев с 20+ категориями намерений
По мере роста числа классов растёт и количество необходимых примеров, что потенциально делает подсказку громоздкой. В качестве альтернативы вы можете рассмотреть внедрение иерархической системы классификации с использованием комбинации классификаторов.
- Организуйте ваши намерения в виде таксономической древовидной структуры.
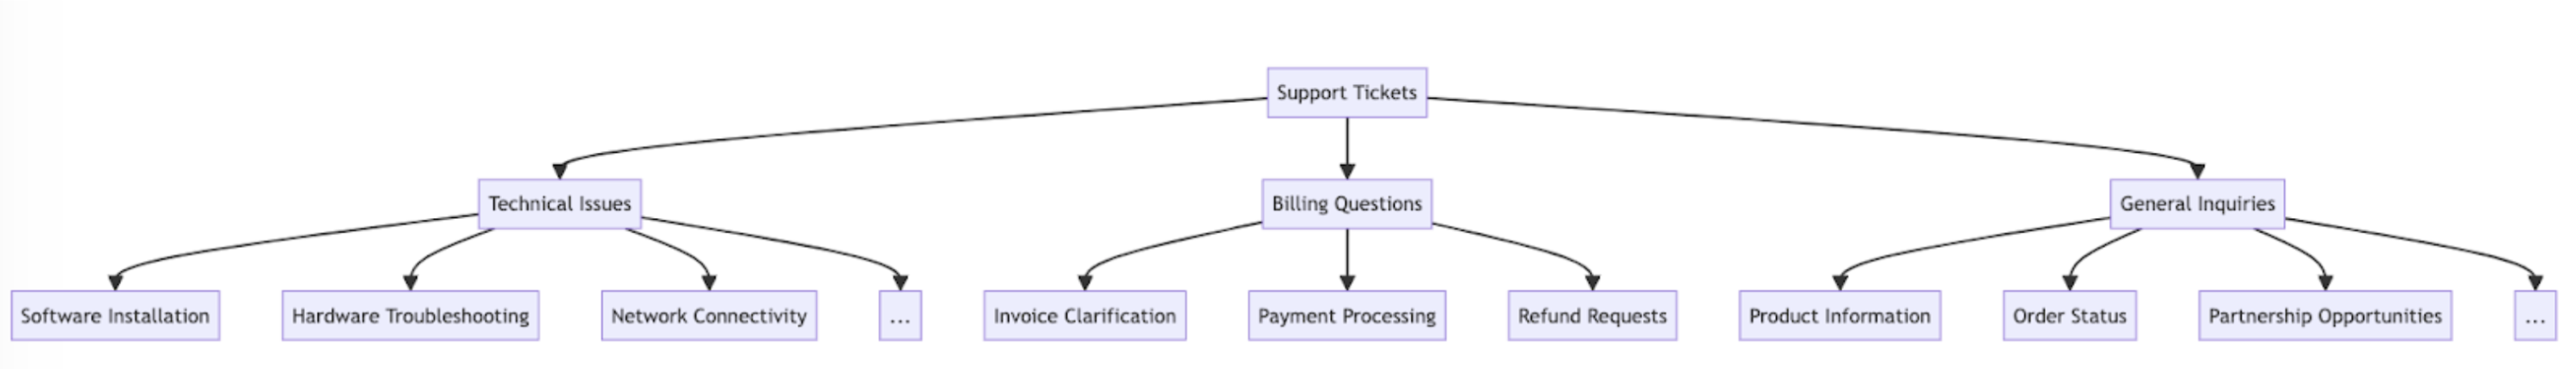
- Создайте серию классификаторов на каждом уровне дерева, обеспечивая каскадный подход к маршрутизации.
Например, у вас может быть классификатор верхнего уровня, который в общих чертах распределяет тикеты по категориям «Technical Issues», «Billing Questions» и «General Inquiries». Каждая из этих категорий затем может иметь собственный подклассификатор для дальнейшего уточнения классификации.
-
Плюсы — больше нюансов и точности: вы можете создавать разные подсказки для каждого родительского пути, что позволяет выполнять более целевую и контекстно-специфичную классификацию. Это может привести к повышению точности и более тонкой обработке запросов клиентов.
-
Минусы — увеличенная задержка: имейте в виду, что несколько классификаторов могут привести к увеличению задержки (latency), и Anthropic рекомендует реализовывать этот подход с самой быстрой моделью — Haiku.
Используйте векторные базы данных и поиск по сходству для обработки сильно варьирующихся тикетов
Несмотря на то что предоставление примеров — самый эффективный способ повысить производительность, если запросы в поддержку сильно варьируются, может быть трудно включить достаточное количество примеров в одну подсказку.
В этом сценарии вы можете использовать векторную базу данных для поиска по сходству в наборе примеров и извлечения наиболее релевантных примеров для данного запроса.
Этот подход, подробно описанный в рецепте классификации, как было показано, повышает производительность с 71% точности до 93% точности.
Специально учитывайте ожидаемые пограничные случаи
Вот несколько сценариев, в которых Claude может неверно классифицировать тикеты (могут быть и другие, уникальные для вашей ситуации). В этих сценариях рассмотрите возможность предоставления в подсказке явных инструкций или примеров того, как Claude должен обрабатывать пограничный случай:
Клиенты часто выражают потребности косвенно. Например, «Я жду свою посылку уже больше двух недель» может быть косвенным запросом о статусе заказа.
- Решение: предоставьте Claude несколько реальных примеров таких запросов от клиентов вместе с указанием лежащего в их основе намерения. Вы можете получить ещё лучшие результаты, если включите обоснование классификации для особенно тонких намерений тикетов, чтобы Claude мог лучше обобщать логику на другие тикеты.
Когда клиенты выражают недовольство, Claude может отдавать приоритет реагированию на эмоции, а не решению лежащей в основе проблемы.
- Решение: дайте Claude указания о том, когда следует отдавать приоритет настроению клиента, а когда нет. Это может быть что-то простое, например: «Игнорируй все эмоции клиента. Сосредоточься только на анализе намерения запроса клиента и на том, какую информацию клиент может запрашивать».
Когда клиенты излагают несколько проблем в одном обращении, Claude может испытывать трудности с определением основной проблемы.
- Решение: уточните приоритизацию намерений, чтобы Claude мог лучше ранжировать извлечённые намерения и определять основную проблему.
Интегрируйте Claude в ваш более широкий рабочий процесс поддержки
Правильная интеграция требует принятия некоторых решений относительно того, как ваш скрипт маршрутизации тикетов на основе Claude вписывается в архитектуру вашей более широкой системы маршрутизации тикетов. Есть два способа сделать это:
- Push-модель: используемая вами система тикетов поддержки (например, Zendesk) запускает ваш код, отправляя событие webhook в ваш сервис маршрутизации, который затем классифицирует намерение и маршрутизирует тикет.
- Этот подход лучше масштабируется в веб-среде, но требует от вас предоставления публичной конечной точки.
- Pull-модель: ваш код запрашивает последние тикеты по заданному расписанию и маршрутизирует их в момент запроса.
- Этот подход проще в реализации, но может приводить к ненужным вызовам системы тикетов поддержки при слишком высокой частоте запросов или быть чрезмерно медленным при слишком низкой частоте запросов.
Для любого из этих подходов вам нужно обернуть ваш скрипт в сервис. Выбор подхода зависит от того, какие API предоставляет ваша система тикетов поддержки.
Посетите cookbook по классификации, чтобы найти больше примеров кода и подробные рекомендации по оценке.
Начните создавать и оценивать ваш рабочий процесс в Claude Console.
Was this page helpful?