Instradamento dei ticket
Questa guida illustra come sfruttare le avanzate capacità di comprensione del linguaggio naturale di Claude per classificare i ticket di assistenza clienti su larga scala in base all'intento del cliente, all'urgenza, alla priorità, al profilo del cliente e altro ancora.
Prerequisiti
- Una chiave API di Claude e il Python SDK installato
- Accesso al tuo sistema di ticketing di assistenza esistente e familiarità con esso
- Un set campione di ticket di assistenza storici per i test
Stabilisci se usare Claude per l'instradamento dei ticket
Ecco alcuni indicatori chiave che suggeriscono di usare un "large language model" (grande modello linguistico), o LLM, come Claude invece degli approcci ML tradizionali per il tuo compito di classificazione:
I processi ML tradizionali richiedono enormi dataset etichettati. Il modello preaddestrato di Claude può classificare efficacemente i ticket con solo poche decine di esempi etichettati, riducendo significativamente i tempi e i costi di preparazione dei dati.
Una volta stabilito un approccio ML tradizionale, modificarlo è un'impresa laboriosa e che richiede molti dati. D'altra parte, man mano che il tuo prodotto o le esigenze dei clienti si evolvono, Claude può adattarsi facilmente ai cambiamenti nelle definizioni delle classi o a nuove classi senza un'estesa rietichettatura dei dati di addestramento.
I modelli ML tradizionali spesso faticano con i dati non strutturati e richiedono un'estesa ingegneria delle feature. La comprensione avanzata del linguaggio di Claude consente una classificazione accurata basata su contenuto e contesto, anziché affidarsi a rigide strutture ontologiche.
Gli approcci ML tradizionali spesso si affidano a modelli bag-of-words o a semplici corrispondenze di pattern. Claude eccelle nel comprendere e applicare le regole sottostanti quando le classi sono definite da condizioni piuttosto che da esempi.
Molti modelli ML tradizionali forniscono poche informazioni sul loro processo decisionale. Claude può fornire spiegazioni leggibili dall'uomo per le sue decisioni di classificazione, creando fiducia nel sistema di automazione e facilitando un facile adattamento se necessario.
I sistemi ML tradizionali spesso faticano con gli outlier e gli input ambigui, classificandoli frequentemente in modo errato o assegnandoli per impostazione predefinita a una categoria generica. Le capacità di elaborazione del linguaggio naturale di Claude gli consentono di interpretare meglio il contesto e le sfumature nei ticket di assistenza, riducendo potenzialmente il numero di ticket instradati erroneamente o non classificati che richiedono un intervento manuale.
Gli approcci ML tradizionali richiedono tipicamente modelli separati o estesi processi di traduzione per ogni lingua supportata. Le capacità multilingue di Claude gli consentono di classificare ticket in varie lingue senza la necessità di modelli separati o estesi processi di traduzione, semplificando l'assistenza per basi di clienti globali.
Costruisci e distribuisci il tuo flusso di lavoro di assistenza basato su LLM
Comprendi il tuo attuale approccio all'assistenza
Prima di automatizzare, è fondamentale comprendere il tuo sistema di ticketing esistente. Inizia indagando su come il tuo team di assistenza gestisce attualmente l'instradamento dei ticket.
Considera domande come:
- Quali criteri vengono utilizzati per determinare quale SLA/offerta di servizio viene applicata?
- L'instradamento dei ticket viene utilizzato per determinare a quale livello di assistenza o specialista di prodotto viene assegnato un ticket?
- Esistono già regole o flussi di lavoro automatizzati? In quali casi falliscono?
- Come vengono gestiti i casi limite o i ticket ambigui?
- Come il team assegna le priorità ai ticket?
Più sai su come gli esseri umani gestiscono determinati casi, meglio potrai lavorare con Claude per svolgere il compito.
Definisci le categorie di intento dell'utente
Un elenco ben definito di categorie di intento dell'utente è fondamentale per una classificazione accurata dei ticket di assistenza con Claude. La capacità di Claude di instradare efficacemente i ticket all'interno del tuo sistema è direttamente proporzionale a quanto sono ben definite le categorie del tuo sistema.
Ecco alcuni esempi di categorie e sottocategorie di intento dell'utente.
- Problema hardware
- Bug software
- Problema di compatibilità
- Problema di prestazioni
- Reimpostazione della password
- Problemi di accesso all'account
- Richieste di fatturazione
- Modifiche all'abbonamento
- Richieste sulle funzionalità
- Domande sulla compatibilità del prodotto
- Informazioni sui prezzi
- Richieste sulla disponibilità
- Domande pratiche (how-to)
- Assistenza nell'uso delle funzionalità
- Consigli sulle best practice
- Guida alla risoluzione dei problemi
- Segnalazioni di bug
- Richieste di funzionalità
- Feedback o suggerimenti generali
- Reclami
- Richieste sullo stato dell'ordine
- Informazioni sulla spedizione
- Resi e cambi
- Modifiche all'ordine
- Assistenza all'installazione
- Richieste di aggiornamento
- Pianificazione della manutenzione
- Annullamento del servizio
- Richieste sulla privacy dei dati
- Segnalazioni di attività sospette
- Assistenza sulle funzionalità di sicurezza
- Domande sulla conformità normativa
- Richieste sui termini di servizio
- Richieste di documentazione legale
- Guasti critici del sistema
- Problemi di sicurezza urgenti
- Problemi con scadenze stringenti
- Richieste di formazione sul prodotto
- Richieste sulla documentazione
- Informazioni su webinar o workshop
- Assistenza all'integrazione
- Domande sull'uso delle API
- Richieste sulla compatibilità con terze parti
Oltre all'intento, l'instradamento e la prioritizzazione dei ticket possono essere influenzati anche da altri fattori come l'urgenza, il tipo di cliente, gli SLA o la lingua. Assicurati di considerare altri criteri di instradamento quando costruisci il tuo sistema di instradamento automatizzato.
Stabilisci i criteri di successo
Collabora con il tuo team di assistenza per definire criteri di successo chiari con benchmark, soglie e obiettivi misurabili.
Ecco alcuni criteri e benchmark standard quando si usano gli LLM per l'instradamento dei ticket di assistenza:
Questa metrica valuta quanto coerentemente Claude classifica ticket simili nel tempo. È fondamentale per mantenere l'affidabilità dell'instradamento. Misurala testando periodicamente il modello con un set di input standardizzati e puntando a un tasso di coerenza del 95% o superiore.
Misura quanto rapidamente Claude può adattarsi a nuove categorie o a pattern di ticket in evoluzione. Testala introducendo nuovi tipi di ticket e misurando il tempo necessario al modello per raggiungere un'accuratezza soddisfacente (ad esempio, >90%) su queste nuove categorie. Punta a un adattamento entro 50–100 ticket campione.
Valuta la capacità di Claude di instradare accuratamente ticket in più lingue. Misura l'accuratezza dell'instradamento tra lingue diverse, puntando a un calo di accuratezza non superiore al 5–10% per le lingue non primarie.
Valuta le prestazioni di Claude su ticket insoliti o complessi. Crea un set di test di casi limite e misura l'accuratezza dell'instradamento, puntando ad almeno l'80% di accuratezza su questi input impegnativi.
Misura l'equità di Claude nell'instradamento tra diverse fasce demografiche di clienti. Verifica regolarmente le decisioni di instradamento per potenziali bias, puntando a un'accuratezza di instradamento coerente (entro il 2–3%) tra tutti i gruppi di clienti.
In situazioni in cui ridurre al minimo il numero di token è fondamentale, questo criterio valuta quanto bene Claude si comporta con un contesto minimo. Misura l'accuratezza dell'instradamento con quantità variabili di contesto fornito, puntando a un'accuratezza del 90%+ con solo il titolo del ticket e una breve descrizione.
Valuta la qualità e la pertinenza delle spiegazioni di Claude per le sue decisioni di instradamento. Valutatori umani possono assegnare un punteggio alle spiegazioni su una scala (ad esempio, 1–5), con l'obiettivo di raggiungere un punteggio medio di 4 o superiore.
Ecco alcuni criteri di successo comuni che possono essere utili indipendentemente dall'uso di un LLM:
L'accuratezza dell'instradamento misura quanto spesso i ticket vengono assegnati correttamente al team o alla persona appropriata al primo tentativo. Viene tipicamente misurata come percentuale di ticket instradati correttamente sul totale dei ticket. I benchmark di settore puntano spesso a un'accuratezza del 90–95%, anche se questo può variare in base alla complessità della struttura di assistenza.
Questa metrica traccia quanto rapidamente i ticket vengono assegnati dopo essere stati inviati. Tempi di assegnazione più rapidi portano generalmente a risoluzioni più veloci e a una maggiore soddisfazione del cliente. I sistemi migliori della categoria raggiungono spesso tempi medi di assegnazione inferiori a 5 minuti, con molti che puntano a un instradamento quasi istantaneo (possibile con implementazioni LLM).
Il tasso di reinstradamento indica quanto spesso i ticket devono essere riassegnati dopo l'instradamento iniziale. Un tasso più basso suggerisce un instradamento iniziale più accurato. Punta a un tasso di reinstradamento inferiore al 10%, con i sistemi più performanti che raggiungono tassi del 5% o meno.
Misura la percentuale di ticket risolti durante la prima interazione con il cliente. Tassi più alti indicano un instradamento efficiente e team di assistenza ben preparati. I benchmark di settore si attestano tipicamente tra il 70–75%, con i migliori che raggiungono tassi dell'80% o superiori.
Il tempo medio di gestione misura quanto tempo occorre per risolvere un ticket dall'inizio alla fine. Un instradamento efficiente può ridurre significativamente questo tempo. I benchmark variano ampiamente per settore e complessità, ma molte organizzazioni puntano a mantenere il tempo medio di gestione sotto le 24 ore per i problemi non critici.
Spesso misurati tramite sondaggi post-interazione, questi punteggi riflettono la soddisfazione complessiva del cliente rispetto al processo di assistenza. Un instradamento efficace contribuisce a una maggiore soddisfazione. Punta a punteggi CSAT del 90% o superiori, con i migliori che raggiungono spesso tassi di soddisfazione del 95%+.
Misura quanto spesso i ticket devono essere inoltrati a livelli di assistenza superiori. Tassi di escalation più bassi indicano spesso un instradamento iniziale più accurato. Punta a un tasso di escalation inferiore al 20%, con i sistemi migliori della categoria che raggiungono tassi del 10% o meno.
Questa metrica esamina quanti ticket gli agenti possono gestire efficacemente dopo l'implementazione della soluzione di instradamento. Un instradamento migliorato dovrebbe aumentare la produttività. Misurala tracciando i ticket risolti per agente al giorno o all'ora, puntando a un miglioramento del 10–20% dopo l'implementazione di un nuovo sistema di instradamento.
Misura la percentuale di potenziali ticket risolti tramite opzioni self-service prima di entrare nel sistema di instradamento. Tassi più alti indicano un triage pre-instradamento efficace. Punta a un tasso di deflessione del 20–30%, con i migliori che raggiungono tassi del 40% o superiori.
Questa metrica calcola il costo medio per risolvere ogni ticket di assistenza. Un instradamento efficiente dovrebbe aiutare a ridurre questo costo nel tempo. Sebbene i benchmark varino ampiamente, molte organizzazioni puntano a ridurre il costo per ticket del 10–15% dopo l'implementazione di un sistema di instradamento migliorato.
Scegli il modello Claude giusto
La scelta del modello dipende dai compromessi tra costo, accuratezza e tempo di risposta.
Molti clienti hanno trovato claude-haiku-4-5-20251001 un modello ideale per l'instradamento dei ticket, poiché è il modello più veloce ed economico della famiglia Claude 4 pur offrendo risultati eccellenti. Se il tuo problema di classificazione richiede una profonda competenza specialistica o un grande volume di categorie di intento, o un ragionamento complesso, puoi optare per il modello Sonnet più grande.
Costruisci un prompt solido
L'instradamento dei ticket è un tipo di compito di classificazione. Claude analizza il contenuto di un ticket di assistenza e lo classifica in categorie predefinite in base al tipo di problema, all'urgenza, alle competenze richieste o ad altri fattori rilevanti.
Scrivi un prompt di classificazione dei ticket. Il prompt iniziale dovrebbe contenere il contenuto della richiesta dell'utente e restituire sia il ragionamento sia l'intento.
Ecco un esempio di prompt di classificazione per l'instradamento dei ticket:
def classify_support_request(ticket_contents):
    # Definisci il prompt per l'attività di classificazione
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
"""Ecco i componenti chiave di questo prompt:
- Il template del prompt è una f-string Python, che consente di inserire
ticket_contentsnei tag<request>. - Il prompt assegna a Claude un ruolo chiaramente definito come sistema di classificazione che analizza attentamente il contenuto del ticket per determinare l'intento principale e le esigenze del cliente.
- Il prompt istruisce Claude sulla corretta formattazione dell'output, in questo caso fornendo il suo ragionamento e la sua analisi all'interno dei tag
<reasoning>, seguiti dall'etichetta di classificazione appropriata all'interno dei tag<intent>. - Il prompt specifica le categorie di intento valide: "Support, Feedback, Complaint", "Order Tracking" e "Refund/Exchange".
- Il prompt include alcuni esempi (ovvero few-shot prompting) per illustrare come dovrebbe essere formattato l'output, il che migliora accuratezza e coerenza.
Far suddividere a Claude la sua risposta in sezioni di tag XML separate ti consente di usare espressioni regolari per estrarre il ragionamento e l'intento dall'output in modo indipendente. Questo ti permette di creare passaggi successivi mirati nel flusso di lavoro di instradamento dei ticket, come usare solo l'intento per decidere a quale persona instradare il ticket.
Distribuisci il tuo prompt
È difficile sapere quanto bene funzioni il tuo prompt senza distribuirlo in un ambiente di produzione di test ed eseguire valutazioni.
Costruisci la struttura di distribuzione. Inizia definendo la firma del metodo che incapsula la chiamata a Claude. Estendi il metodo che hai iniziato a scrivere in precedenza, che prende ticket_contents come input, in modo che ora restituisca una tupla di reasoning e intent come output. Se hai un'automazione esistente che usa ML tradizionale, ti conviene seguire invece quella firma del metodo.
import re

# Crea un'istanza del client dell'API Claude
client = anthropic.Anthropic()

# Imposta il modello predefinito
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Definisci il prompt per l'attività di classificazione
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Invia il prompt all'API per classificare la richiesta di supporto.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Usa la libreria di espressioni regolari di Python per estrarre `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Allo stesso modo, estrai anche `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
Questo codice:
- Crea un'istanza del client usando la tua chiave API.
- Definisce una funzione
classify_support_requestche prende una stringaticket_contents. - Invia
ticket_contentsa Claude per la classificazione usando ilclassification_prompt. - Restituisce il
reasoninge l'intentdel modello estratti dalla risposta.
Poiché l'intero testo del ragionamento e dell'intento deve essere generato prima del parsing, l'esempio imposta stream=False (il valore predefinito).
Valuta il tuo prompt
Il prompting richiede spesso test e ottimizzazione per essere pronto per la produzione. Per determinare la maturità della tua soluzione, valuta le prestazioni in base ai criteri di successo e alle soglie che hai stabilito in precedenza.
Per eseguire la tua valutazione, hai bisogno di casi di test su cui eseguirla. Il resto di questa guida presuppone che tu abbia già sviluppato i tuoi casi di test.
Costruisci una funzione di valutazione
La valutazione di esempio per questa guida misura le prestazioni di Claude lungo tre metriche chiave:
- Accuratezza
- Costo per classificazione
Potresti dover valutare Claude su altri assi a seconda dei fattori che sono importanti per te.
Per valutare ciò, modifica innanzitutto lo script per aggiungere una funzione che confronta l'intento previsto con l'intento effettivo e calcola la percentuale di previsioni corrette. Quindi aggiungi le funzionalità di calcolo dei costi e di misurazione del tempo.
import re

# Crea un'istanza del client della Claude API
client = anthropic.Anthropic()

# Imposta il modello predefinito
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Definisci il prompt per l'attività di classificazione
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Usa la libreria di espressioni regolari di Python per estrarre `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Allo stesso modo, estrai anche `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Verifica se la previsione del modello è corretta.
    correct = actual_intent.strip() == intent.strip()

    # Restituisci reasoning, intent, correct e usage.
    return reasoning, intent, correct, usage
Ecco un'analisi delle modifiche:
- Il metodo
classify_support_requestora prende l'actual_intentdai casi di test e lo confronta con la classificazione dell'intento di Claude per valutare se corrispondono. - Il metodo estrae le statistiche di utilizzo della chiamata API per calcolare il costo in base ai token di input e output utilizzati.
Esegui la tua valutazione
Una valutazione adeguata richiede soglie e benchmark chiari per determinare cosa sia un buon risultato. Lo script precedente restituisce i valori di runtime per accuratezza, tempo di risposta e costo per classificazione, ma hai comunque bisogno di soglie chiaramente stabilite. Ad esempio:
- Accuratezza: 95% (su 100 test)
- Costo per classificazione: riduzione media del 50% (su 100 test) rispetto al metodo di instradamento attuale
Avere queste soglie ti consente di stabilire rapidamente e facilmente su larga scala, e con empirismo imparziale, quale metodo è il migliore per te e quali modifiche potrebbero essere necessarie per adattarsi meglio ai tuoi requisiti.
Migliora le prestazioni
In scenari complessi, può essere utile considerare strategie aggiuntive per migliorare le prestazioni oltre alle tecniche di prompt engineering standard e alle strategie di implementazione dei guardrail. Ecco alcuni scenari comuni:
Usa una gerarchia tassonomica per i casi con più di 20 categorie di intento
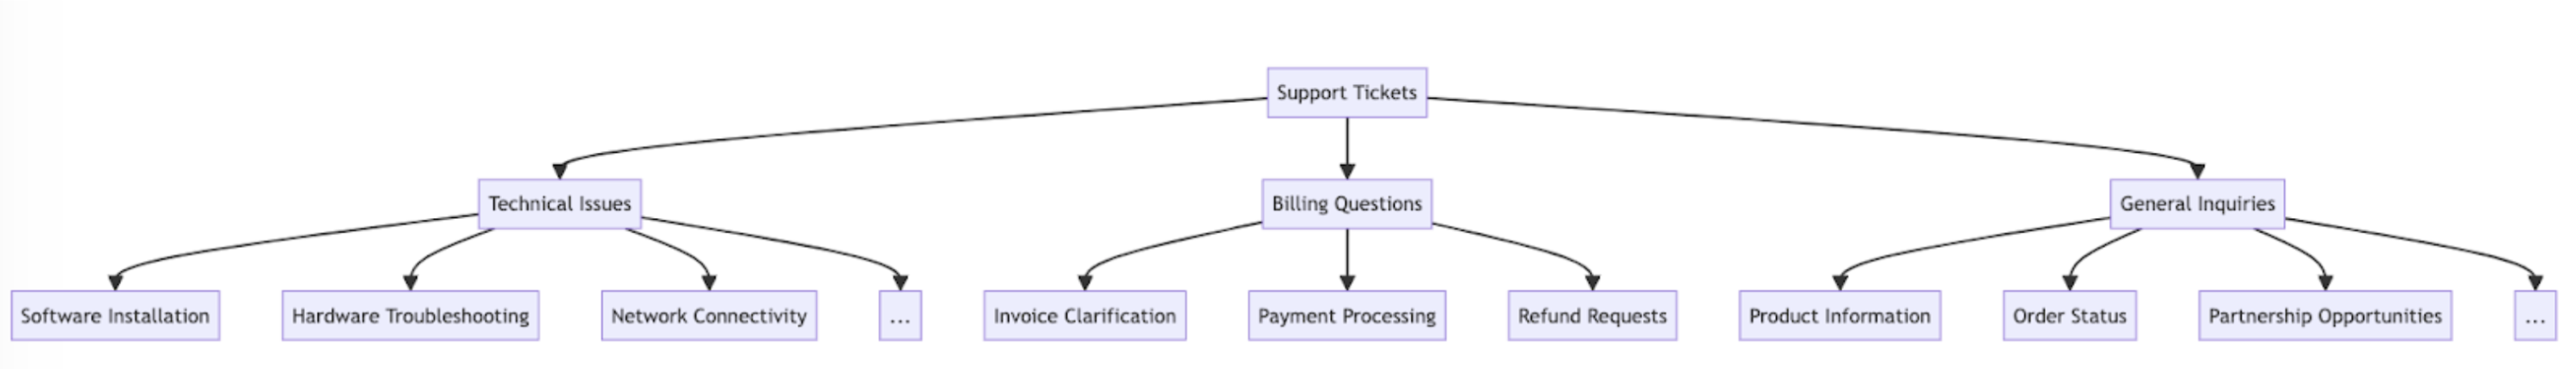
Man mano che il numero di classi cresce, aumenta anche il numero di esempi richiesti, rendendo potenzialmente il prompt ingombrante. In alternativa, puoi considerare l'implementazione di un sistema di classificazione gerarchico usando una combinazione di classificatori.
- Organizza i tuoi intenti in una struttura ad albero tassonomica.
- Crea una serie di classificatori a ogni livello dell'albero, abilitando un approccio di instradamento a cascata.
Ad esempio, potresti avere un classificatore di primo livello che categorizza ampiamente i ticket in "Technical Issues" (problemi tecnici), "Billing Questions" (domande sulla fatturazione) e "General Inquiries" (richieste generali). Ciascuna di queste categorie può poi avere il proprio sotto-classificatore per affinare ulteriormente la classificazione.
-
Pro - maggiore sfumatura e accuratezza: Puoi creare prompt diversi per ogni percorso padre, consentendo una classificazione più mirata e specifica per il contesto. Questo può portare a una maggiore accuratezza e a una gestione più sfumata delle richieste dei clienti.
-
Contro - maggiore latenza: Tieni presente che più classificatori possono portare a una maggiore "latency" (latenza), e Anthropic consiglia di implementare questo approccio con il modello più veloce, Haiku.
Usa database vettoriali e il recupero tramite ricerca per similarità per gestire ticket altamente variabili
Sebbene fornire esempi sia il modo più efficace per migliorare le prestazioni, se le richieste di assistenza sono altamente variabili, può essere difficile includere abbastanza esempi in un singolo prompt.
In questo scenario, potresti impiegare un database vettoriale per eseguire ricerche per similarità da un dataset di esempi e recuperare gli esempi più rilevanti per una determinata query.
Questo approccio, descritto in dettaglio nella ricetta di classificazione, ha dimostrato di migliorare le prestazioni dal 71% al 93% di accuratezza.
Tieni conto specificamente dei casi limite previsti
Ecco alcuni scenari in cui Claude potrebbe classificare erroneamente i ticket (potrebbero essercene altri specifici della tua situazione). In questi scenari, considera di fornire istruzioni esplicite o esempi nel prompt su come Claude dovrebbe gestire il caso limite:
I clienti spesso esprimono le esigenze in modo indiretto. Ad esempio, "Sto aspettando il mio pacco da più di due settimane ormai" potrebbe essere una richiesta indiretta sullo stato dell'ordine.
- Soluzione: Fornisci a Claude alcuni esempi reali di clienti con questo tipo di richieste, insieme all'intento sottostante. Puoi ottenere risultati ancora migliori se includi una motivazione della classificazione per gli intenti dei ticket particolarmente sfumati, in modo che Claude possa generalizzare meglio la logica ad altri ticket.
Quando i clienti esprimono insoddisfazione, Claude potrebbe dare priorità alla gestione dell'emozione rispetto alla risoluzione del problema sottostante.
- Soluzione: Fornisci a Claude indicazioni su quando dare priorità o meno al sentiment del cliente. Può essere qualcosa di semplice come "Ignora tutte le emozioni del cliente. Concentrati solo sull'analisi dell'intento della richiesta del cliente e su quali informazioni il cliente potrebbe chiedere."
Quando i clienti presentano più problemi in una singola interazione, Claude potrebbe avere difficoltà a identificare la preoccupazione principale.
- Soluzione: Chiarisci la prioritizzazione degli intenti in modo che Claude possa ordinare meglio gli intenti estratti e identificare la preoccupazione principale.
Integra Claude nel tuo flusso di lavoro di assistenza più ampio
Una corretta integrazione richiede che tu prenda alcune decisioni su come il tuo script di instradamento dei ticket basato su Claude si inserisce nell'architettura del tuo sistema di instradamento dei ticket più ampio. Ci sono due modi in cui potresti farlo:
- Push-based: Il sistema di ticket di assistenza che stai usando (ad esempio, Zendesk) attiva il tuo codice inviando un evento webhook al tuo servizio di instradamento, che poi classifica l'intento e lo instrada.
- Questo approccio è più scalabile sul web, ma richiede di esporre un endpoint pubblico.
- Pull-based: Il tuo codice recupera i ticket più recenti in base a una pianificazione prestabilita e li instrada al momento del recupero.
- Questo approccio è più facile da implementare ma potrebbe effettuare chiamate non necessarie al sistema di ticket di assistenza quando la frequenza di recupero è troppo alta, oppure potrebbe essere eccessivamente lento quando la frequenza di recupero è troppo bassa.
Per entrambi questi approcci, devi incapsulare il tuo script in un servizio. La scelta dell'approccio dipende da quali API fornisce il tuo sistema di ticketing di assistenza.
Visita il cookbook di classificazione per altro codice di esempio e indicazioni dettagliate sulle valutazioni.
Inizia a costruire e valutare il tuo flusso di lavoro sulla Claude Console.
Was this page helpful?